Al finalizar este capítulo, se espera que el estudiantado pueda:
formular e interpretar un modelo de medias móviles MA(\(q\)) como una combinación finita de innovaciones presentes y pasadas;
derivar la media, la varianza y la función de autocovarianza de un MA(\(q\)), y explicar por qué su ACF poblacional se corta después del rezago \(q\);
utilizar el operador de rezago para escribir modelos AR, MA y ARMA mediante polinomios;
explicar la diferencia entre estacionariedad, causalidad e invertibilidad;
demostrar la representación MA(\(\infty\)) de un proceso AR causal y relacionarla con las raíces del polinomio autorregresivo;
explicar por qué un MA puede ser estacionario sin ser invertible y por qué la invertibilidad es una condición de identificación y recuperación de innovaciones;
formular un modelo ARMA(\(p,q\)) en su forma mínima y reconocer el problema de factores comunes entre los polinomios AR y MA;
derivar la estructura de segundo orden de un ARMA(1,1) y explicar por qué su ACF tiene una cola gobernada por la parte autorregresiva;
utilizar conjuntamente ACF y PACF como herramientas de identificación preliminar de modelos AR, MA y ARMA;
construir pronósticos con parámetros conocidos a partir de la representación causal y calcular la varianza del error de pronóstico;
distinguir entre innovación, residual o innovación reconstruida y error de pronóstico a horizonte \(h\);
interpretar computacionalmente las condiciones de causalidad e invertibilidad mediante raíces, coeficientes de impulso y recursiones de reconstrucción.
En Sección 2.9.1 introdujimos el polinomio autorregresivo y advertimos que la condición usual de raíces estaba relacionada con una representación no anticipativa del proceso. En este capítulo hacemos explícita esa relación. También completaremos el patrón de identificación iniciado en Sección 2.10: los modelos AR tienen PACF con corte y ACF con cola; los MA presentan el comportamiento complementario; los ARMA mixtos suelen presentar cola en ambas funciones (Shumway y Stoffer 2025, secs. 3.1–3.4; Prado et al. 2021, sec. 2.5).
3.2 De la memoria de la serie a la memoria de las perturbaciones
En este capítulo usaremos perturbación como traducción del término inglés shock. En las referencias, shock se utiliza para interpretar el efecto de una realización de la innovación \(\varepsilon_t\) sobre la trayectoria del proceso; por tanto, perturbación no designa una variable distinta. La variable aleatoria del modelo seguirá llamándose innovación\(\varepsilon_t\), mientras que hablaremos de una perturbación cuando queramos enfatizar el efecto que una realización de esa innovación produce y cómo dicho efecto se propaga a través del tiempo (Prado et al. 2021, sec. 2.1).
por lo que una perturbación ocurrida en el pasado puede influir indefinidamente, aunque su efecto disminuya cuando \(|\phi|<1\). Un modelo de medias móviles parte de una idea diferente: el valor actual depende de un número finito de perturbaciones recientes. Por ejemplo,
recuerda únicamente la innovación actual y la inmediatamente anterior.
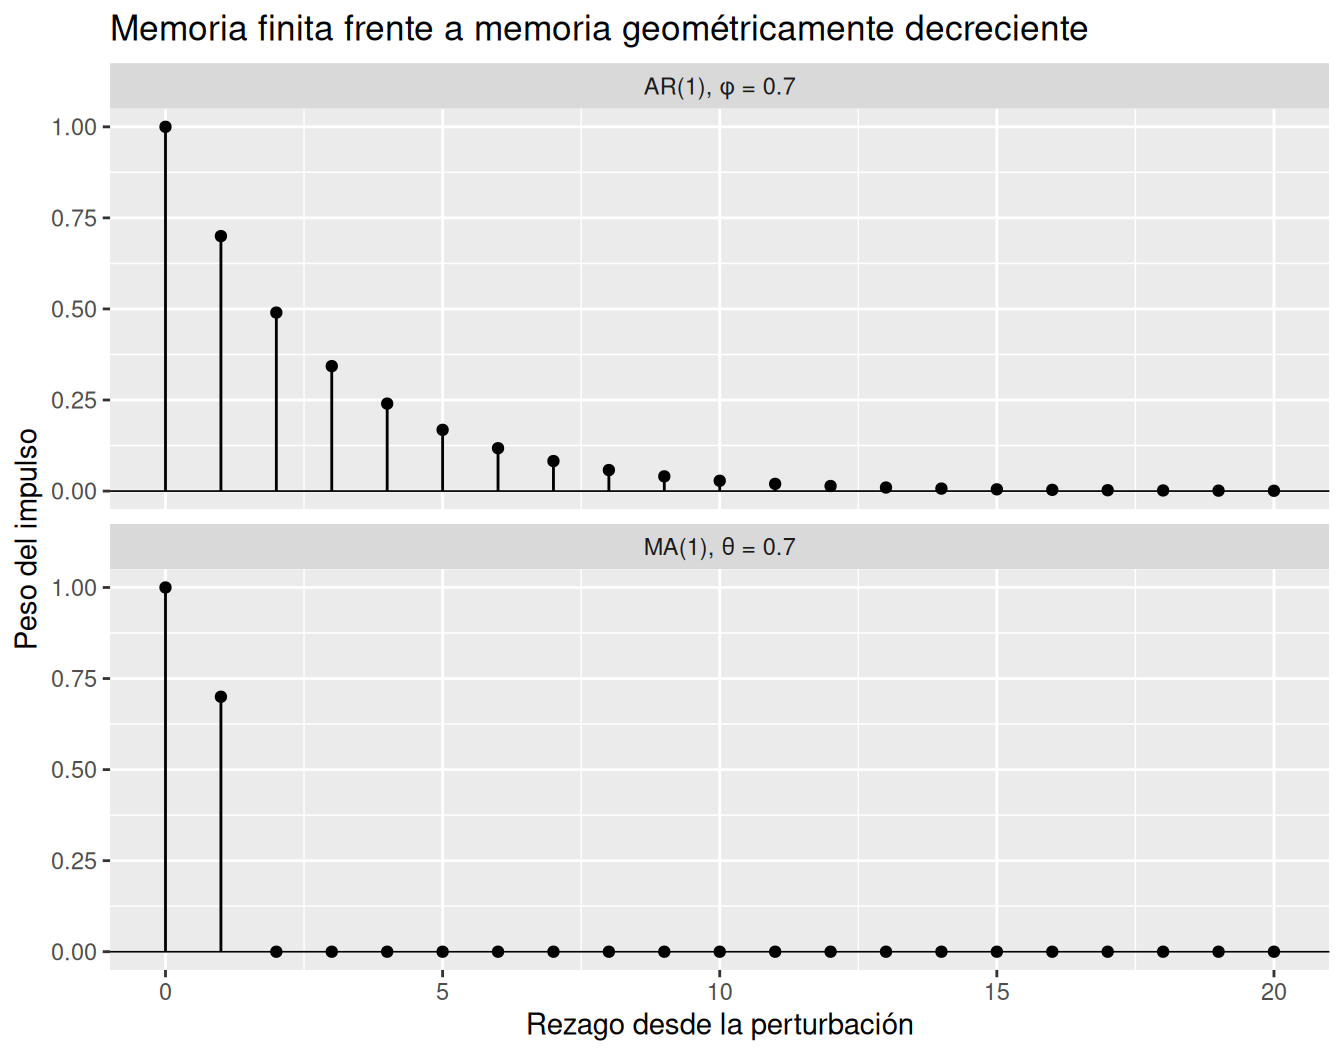
Esta diferencia puede verse como una diferencia en la respuesta a un impulso. Si una innovación unitaria ocurre en el tiempo cero y no hay otras perturbaciones, un MA(1) responde solo durante dos períodos; un AR(1) causal responde durante un número infinito de períodos, con amplitud decreciente.
Figura 3.1: Respuesta de un MA(1) y un AR(1) a una innovación unitaria.
La Figura 3.1 anticipa una conexión central de la semana: la forma en que una perturbación se propaga determina tanto la estructura de autocorrelación como el comportamiento de los pronósticos.
3.3 El operador de rezago y la notación polinomial
Otros textos y programas pueden escribir la parte MA con signos negativos. No existe una diferencia sustantiva si la convención se mantiene consistentemente, pero el signo reportado para cada \(\theta_j\) cambia. En estas notas utilizaremos siempre
\[
\Theta(B)=1+\theta_1B+\cdots+\theta_qB^q.
\]
Para simplificar derivaciones, definiremos con frecuencia el proceso centrado
A diferencia de un AR, un MA finito no requiere una restricción de raíces para ser débilmente estacionario. Es una combinación lineal finita de un ruido blanco; por ello, su media y su estructura de covarianza son invariantes en el tiempo para cualquier conjunto finito de coeficientes \(\theta_1,\ldots,\theta_q\). Si, además, las innovaciones son i.i.d., la representación finita también produce estacionariedad estricta (Prado et al. 2021, secs. 2.5.1–2.5.2; Shumway y Stoffer 2025, sec. 3.1.2).
3.4.1 Media y varianza
Como \(E(\varepsilon_t)=0\),
\[
E(X_t)=0,
\]
y, por tanto,
\[
E(Y_t)=\mu.
\]
Además, debido a que las innovaciones en tiempos distintos no están correlacionadas,
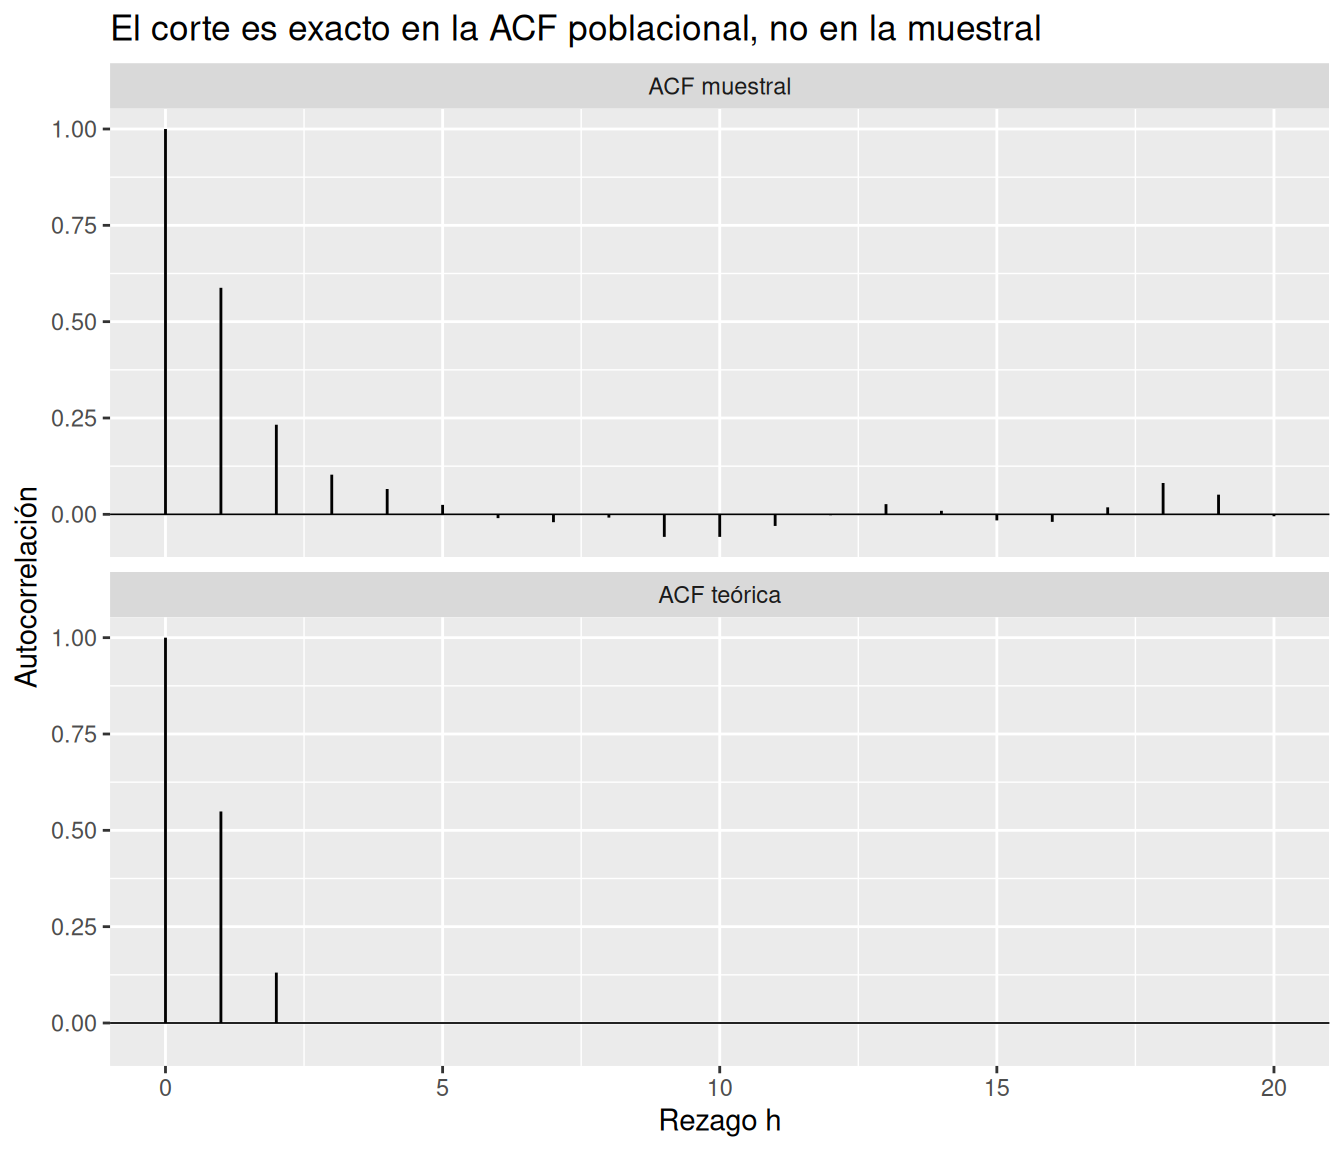
y \(\rho(h)=0\) para \(h>q\). Esta es la razón matemática del corte exacto de la ACF poblacional de un MA(\(q\)) (Prado et al. 2021, sec. 2.5.2).
ImportanteEl corte de la ACF refleja ausencia de innovaciones compartidas
En un MA(\(q\)), dos observaciones separadas por más de \(q\) períodos dependen de conjuntos disjuntos de innovaciones. Bajo ruido blanco, esos conjuntos no comparten covarianza y la autocovarianza es cero. El corte no es una regla gráfica arbitraria: proviene directamente de la representación del proceso.
set.seed(415)theta_ma2 <-c(0.7, 0.2)T_ma2 <-250lag_ma2 <-20y_ma2 <-as.numeric(stats::arima.sim(model =list(ma = theta_ma2),n = T_ma2,sd =1))acf_ma2_teorica <-tibble(h =0:lag_ma2,valor =as.numeric(stats::ARMAacf(ma = theta_ma2,lag.max = lag_ma2 )),Tipo ="ACF teórica")acf_ma2_muestral_obj <- stats::acf( y_ma2,lag.max = lag_ma2,plot =FALSE,demean =TRUE)acf_ma2_muestral <-tibble(h =0:lag_ma2,valor =as.numeric(acf_ma2_muestral_obj$acf),Tipo ="ACF muestral")bind_rows(acf_ma2_teorica, acf_ma2_muestral) |>ggplot(aes(x = h, y = valor)) +geom_hline(yintercept =0, linewidth =0.3) +geom_segment(aes(xend = h, yend =0)) +facet_wrap(~Tipo, ncol =1) +labs(x ="Rezago h",y ="Autocorrelación",title ="El corte es exacto en la ACF poblacional, no en la muestral" )
Figura 3.2: ACF teórica y ACF muestral de un MA(2) con \(\theta_1=0.7\) y \(\theta_2=0.2\).
La Figura 3.2 refuerza una advertencia de la semana 2: el corte es una propiedad poblacional. En una muestra, las autocorrelaciones posteriores a \(q\) no serán exactamente cero.
Al ser gaussianos, tienen las mismas distribuciones finito-dimensionales. En consecuencia, observando únicamente la serie no podemos distinguir cuál de las dos parametrizaciones produjo los datos. Shumway y Stoffer utilizan precisamente este ejemplo para motivar la invertibilidad (Shumway y Stoffer 2025, Example 3.6).
ImportanteInvertibilidad no es estacionariedad
Ambos modelos de Ecuación 3.16 y Ecuación 3.17 son estacionarios. La invertibilidad no se introduce para lograr estacionariedad, sino para escoger una representación identificable y hacer posible reconstruir las innovaciones a partir de la historia observada.
En la práctica, sin embargo, las innovaciones \(\varepsilon_t\) no son observables. Para reconstruirlas a partir de la serie observada \(\{X_t\}\) utilizamos la misma relación recursiva,
pero debemos comenzar con algún valor inicial \(\widehat{\varepsilon}_0\). Este valor inicial es una elección computacional y, en general, no coincide con la innovación \(\varepsilon_0\) que realmente intervino en la generación del proceso.
Por tanto, conviene distinguir entre:
\(\varepsilon_t\): la innovación del proceso, es decir, la perturbación aleatoria que forma parte del modelo generador;
\(\widehat{\varepsilon}_t\): la innovación reconstruida a partir de los datos mediante la recursión anterior.
Definamos el error de reconstrucción en el instante \(t\) como
Este resultado muestra cómo se propaga en el tiempo el error introducido por la elección inicial \(\widehat{\varepsilon}_0\).
Si \(|\theta|<1\), entonces
\[
|d_t|
=
|\theta|^t |d_0|
\longrightarrow 0,
\]
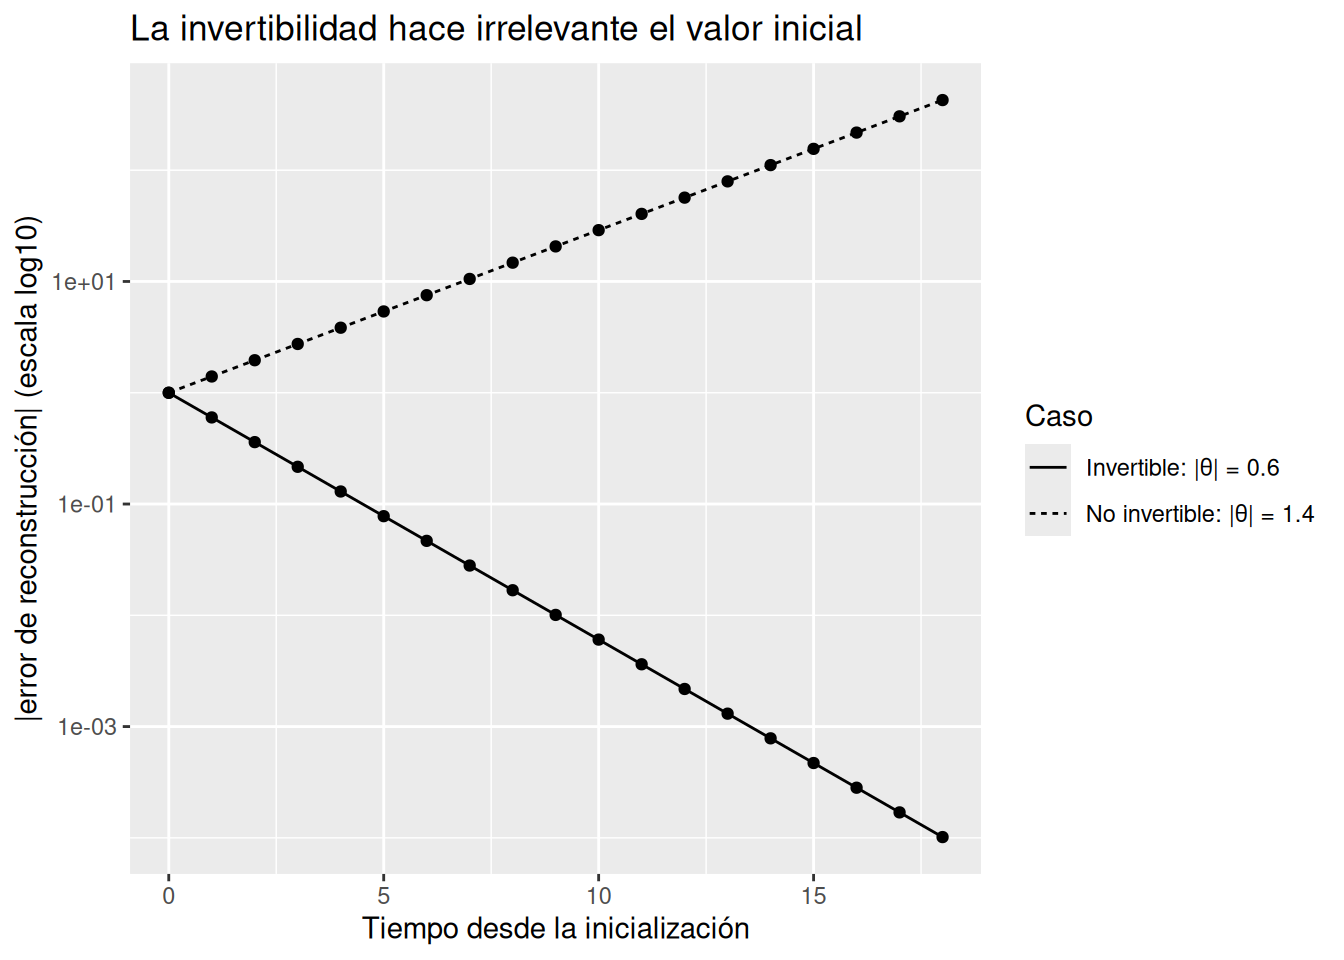
de modo que la influencia de una inicialización incorrecta desaparece geométricamente. Después de suficientes observaciones, las innovaciones reconstruidas prácticamente no dependen del valor escogido para \(\widehat{\varepsilon}_0\).
En cambio, si \(|\theta|>1\), entonces \(|\theta|^t\) crece con \(t\) y cualquier pequeña discrepancia inicial se amplifica. En ese caso, la reconstrucción recursiva de las innovaciones es inestable.
Esta es una interpretación computacional de la invertibilidad del MA(1): cuando \(|\theta|<1\), las innovaciones pueden recuperarse de manera estable a partir del presente y el pasado de la serie, y la influencia de condiciones iniciales arbitrarias desaparece con el tiempo.
error_inicial <-1h_inv <-0:18propagacion_error <-crossing(theta =c(0.6, 1.4),t = h_inv) |>mutate(error_abs =abs((-theta)^t * error_inicial),Caso =if_else( theta <1,"Invertible: |θ| = 0.6","No invertible: |θ| = 1.4" ) )ggplot(propagacion_error, aes(x = t, y = error_abs, linetype = Caso)) +geom_line() +geom_point() +scale_y_log10() +labs(x ="Tiempo desde la inicialización",y ="|error de reconstrucción| (escala log10)",title ="La invertibilidad hace irrelevante el valor inicial" )
Figura 3.4: Propagación de un error inicial al reconstruir innovaciones de un MA(1).
La Figura 3.4 explica por qué la reconstrucción recursiva de innovaciones es estable en el caso invertible.
3.6.4 Invertibilidad de un MA(\(q\))
Para un MA(\(q\)),
\[
X_t=\Theta(B)\varepsilon_t.
\]
El proceso es invertible si existe una expansión unilateral
3.7 Causalidad: una representación no anticipativa
En la semana 2 usamos la condición de raíces del AR para construir una solución estacionaria en términos de innovaciones presentes y pasadas. Esa propiedad recibe el nombre de causalidad.
Un ARMA estacionario es causal si puede escribirse como
En palabras, \(X_t\) depende únicamente de la innovación presente y de innovaciones pasadas, no de innovaciones futuras (Shumway y Stoffer 2025, Definition 3.7 and Property 3.1).
Advertencia“Causalidad” aquí no significa causalidad científica ni causalidad de Granger
En este capítulo, causalidad es una propiedad matemática de representación: el presente se expresa mediante perturbaciones presentes y pasadas. No afirma que una variable cause otra en sentido sustantivo. La causalidad de Granger y la inferencia causal son conceptos distintos.
Si buscamos una solución estacionaria con segundo momento finito, \(\phi^{-k}X_{t+k}\) converge a cero en media cuadrática cuando \(k\to\infty\), pues \(|\phi|>1\). Entonces
pero depende de perturbaciones futuras. Por ello no es causal. En esta representación, \(\varepsilon_t\) sigue siendo un ruido blanco que satisface la ecuación, pero ya no puede interpretarse como la innovación de \(X_t\) respecto de la historia pasada, pues \(X_t\) contiene información sobre valores futuros del ruido. Shumway y Stoffer usan este tipo de situación para motivar la restricción causal de los modelos ARMA (Shumway y Stoffer 2025, sec. 3.1.3).
ImportanteLo que se restringe en el modelo ARMA estándar
La estacionariedad por sí sola no garantiza una representación no anticipativa. En modelación y pronóstico trabajaremos con la solución estacionaria causal, porque permite interpretar las innovaciones como nuevas perturbaciones que llegan secuencialmente y construir pronósticos usando la información pasada.
3.7.3 Causalidad de un AR(\(p\))
Para
\[
\Phi(B)X_t=\varepsilon_t,
\]
si todas las raíces de
\[
\Phi(z)=0
\]
están fuera del círculo unitario, \(1/\Phi(z)\) posee una expansión en serie de potencias convergente sobre el círculo unitario. Entonces
la parte AR transmite información mediante valores pasados de la propia serie;
la parte MA transmite directamente los efectos de innovaciones recientes.
Prado, Ferreira y West presentan esta formulación en su sección dedicada a la estructura ARMA; Shumway y Stoffer la utilizan como base para causalidad, invertibilidad, ACF/PACF y pronóstico (Prado et al. 2021, sec. 2.5.1; Shumway y Stoffer 2025, sec. 3.1.3).
3.8.1 Representación mínima y factores comunes
Antes de hablar de órdenes \(p\) y \(q\), debemos excluir parametrizaciones redundantes. Considere
\[
(1-0.9B)X_t
=
(1-0.9B)\varepsilon_t.
\]
Si cancelamos el factor común,
\[
X_t=\varepsilon_t.
\]
El proceso es simplemente ruido blanco, aunque la ecuación inicial parece un ARMA(1,1). Por ello, llamaremos ARMA(\(p,q\)) en forma mínima a una representación donde \(\Phi(z)\) y \(\Theta(z)\) no tienen factores comunes (Shumway y Stoffer 2025, sec. 3.1.3).
NotaEl orden es una propiedad de la representación mínima
Sin esta convención podríamos inflar artificialmente \(p\) y \(q\) multiplicando ambos lados de la ecuación por el mismo polinomio. La identificación del orden exige eliminar factores comunes antes de interpretar el modelo.
3.8.2 Causalidad e invertibilidad en un ARMA
Para un ARMA en forma mínima:
es causal si todas las raíces de \(\Phi(z)\) están fuera del círculo unitario;
es invertible si todas las raíces de \(\Theta(z)\) están fuera del círculo unitario.
Tabla 3.1: Diferencias entre causalidad e invertibilidad.
Propiedad
Polinomio
Condicion
Representacion
Interpretacion
Causalidad
\(\Phi(z)\)
Raíces fuera del círculo unitario
\(X_t=\sum_{j\geq0}\psi_j\varepsilon_{t-j}\)
El presente depende de perturbaciones presentes y pasadas
Invertibilidad
\(\Theta(z)\)
Raíces fuera del círculo unitario
\(\varepsilon_t=\sum_{j\geq0}\pi_jX_{t-j}\)
Las perturbaciones pueden reconstruirse a partir de la historia observada
3.8.3 Visualización de las raíces en el plano complejo
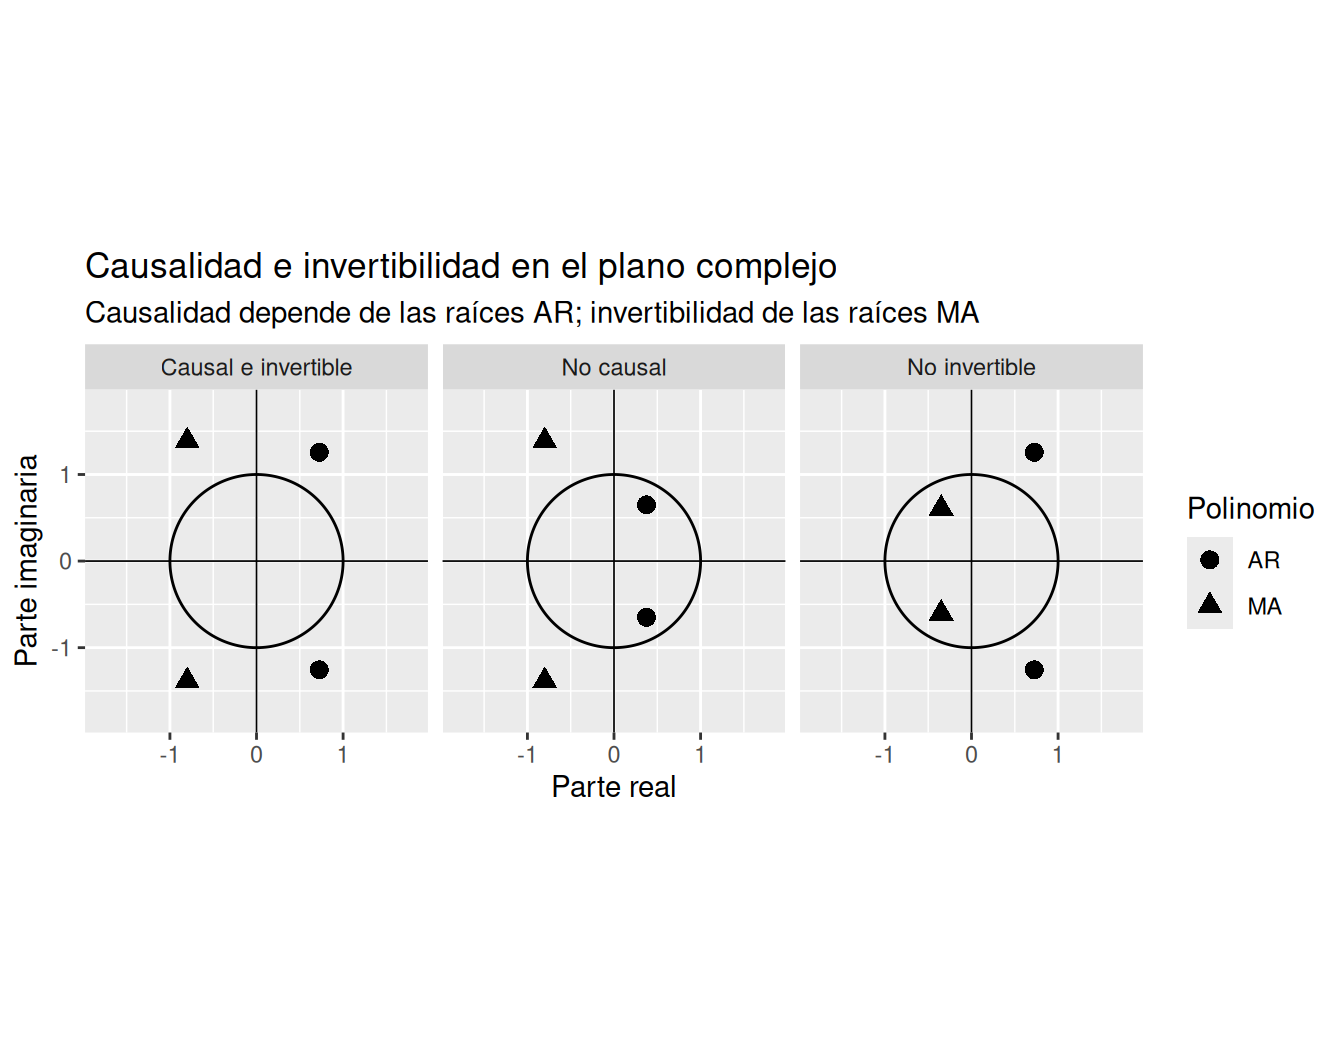
Cuando los polinomios autorregresivo y de medias móviles son de grado al menos dos, pueden tener raíces complejas. Como sus coeficientes son reales, estas raíces aparecen en pares conjugados. En este caso, la representación en el plano complejo permite visualizar directamente las condiciones de causalidad e invertibilidad.
Para construir ejemplos controlados, recordemos que un par de raíces complejas conjugadas de módulo \(r\) y argumento \(\omega\),
\[
z_1 = r e^{i\omega},
\qquad
z_2 = r e^{-i\omega},
\]
Esto permite construir modelos cuyas raíces estén deliberadamente dentro o fuera del círculo unitario.
crear_modelo <-function( modelo, r_ar, omega_ar, r_ma, omega_ma) {tibble(Modelo = modelo,phi1 =2*cos(omega_ar) / r_ar,phi2 =-1/ r_ar^2,theta1 =-2*cos(omega_ma) / r_ma,theta2 =1/ r_ma^2 )}modelos_raices <-bind_rows(crear_modelo(modelo ="Causal e invertible",r_ar =1.45,omega_ar = pi /3,r_ma =1.60,omega_ma =2* pi /3 ),crear_modelo(modelo ="No causal",r_ar =0.75,omega_ar = pi /3,r_ma =1.60,omega_ma =2* pi /3 ),crear_modelo(modelo ="No invertible",r_ar =1.45,omega_ar = pi /3,r_ma =0.70,omega_ma =2* pi /3 ))raices_plot <- modelos_raices |>rowwise() |>mutate(AR =list(polyroot(c(1, -phi1, -phi2)) ),MA =list(polyroot(c(1, theta1, theta2)) ) ) |>ungroup() |>select(Modelo, AR, MA) |>pivot_longer(cols =c(AR, MA),names_to ="Tipo",values_to ="raiz" ) |>unnest_longer(raiz) |>mutate(real =Re(raiz),imag =Im(raiz),modulo =Mod(raiz) )circulo <-tibble(angulo =seq(0, 2* pi, length.out =400),real =cos(angulo),imag =sin(angulo))ggplot() +geom_path(data = circulo,aes(x = real, y = imag),linewidth =0.5 ) +geom_hline(yintercept =0,linewidth =0.3 ) +geom_vline(xintercept =0,linewidth =0.3 ) +geom_point(data = raices_plot,aes(x = real,y = imag,shape = Tipo ),size =3 ) +facet_wrap(~ Modelo) +coord_equal(xlim =c(-1.8, 1.8),ylim =c(-1.8, 1.8) ) +labs(x ="Parte real",y ="Parte imaginaria",title ="Causalidad e invertibilidad en el plano complejo",subtitle ="Causalidad depende de las raíces AR; invertibilidad de las raíces MA",shape ="Polinomio" )
Figura 3.5: Raíces complejas conjugadas de los polinomios AR y MA en tres modelos ARMA(2,2). La causalidad depende de que las raíces AR estén fuera del círculo unitario, mientras que la invertibilidad depende de que las raíces MA estén fuera.
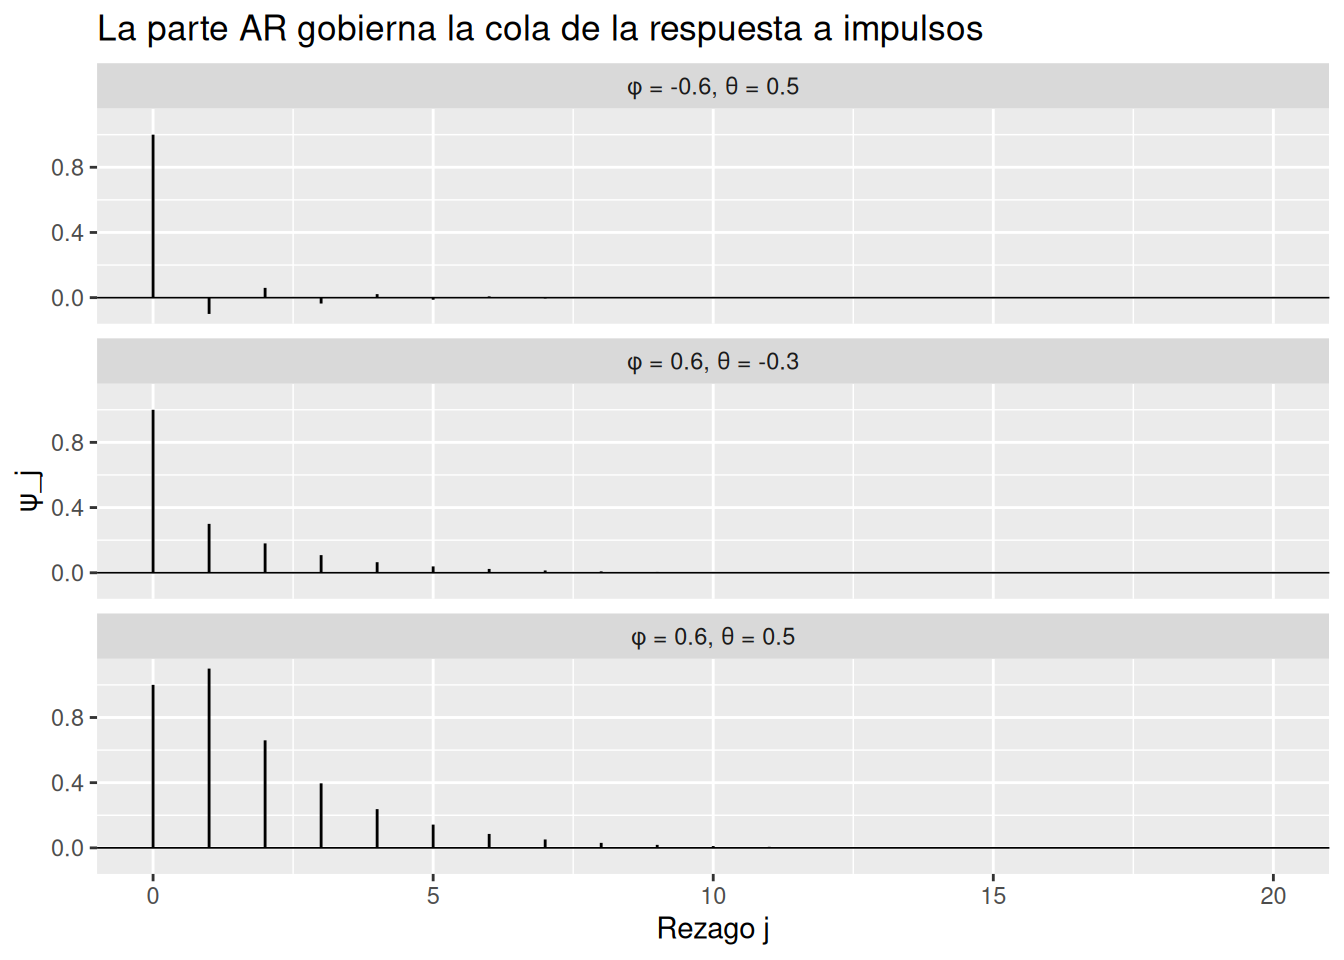
La parte AR determina el comportamiento de la cola de los \(\psi_j\): una vez que se han agotado los términos MA explícitos, la recursión se vuelve homogénea y queda gobernada por las raíces de \(\Phi(z)\).
La ACF de un ARMA(1,1) no se corta. Después del primer rezago, su cola decae con la misma razón geométrica \(\phi\) que aparece en la parte AR. Este es un caso particular de la recurrencia general de la ACF de un ARMA (Prado et al. 2021, sec. 2.5.2; Shumway y Stoffer 2025, secs. 3.2–3.3).
3.10.3 Recurrencia general de la ACF
Para un ARMA(\(p,q\)), una vez superados los rezagos en los que la parte MA participa directamente, la autocovarianza satisface
Tabla 3.2: Patrones poblacionales de ACF y PACF para modelos AR, MA y ARMA.
Modelo
ACF
PACF
Razon
AR(\(p\))
Cola: decaimiento exponencial o sinusoidal amortiguado
Corte después de \(p\)
El AR causal es un MA(\(\infty\))
MA(\(q\))
Corte después de \(q\)
Cola
El MA invertible es un AR(\(\infty\))
ARMA(\(p,q\))
Cola
Cola
Posee representaciones MA(\(\infty\)) y AR(\(\infty\))
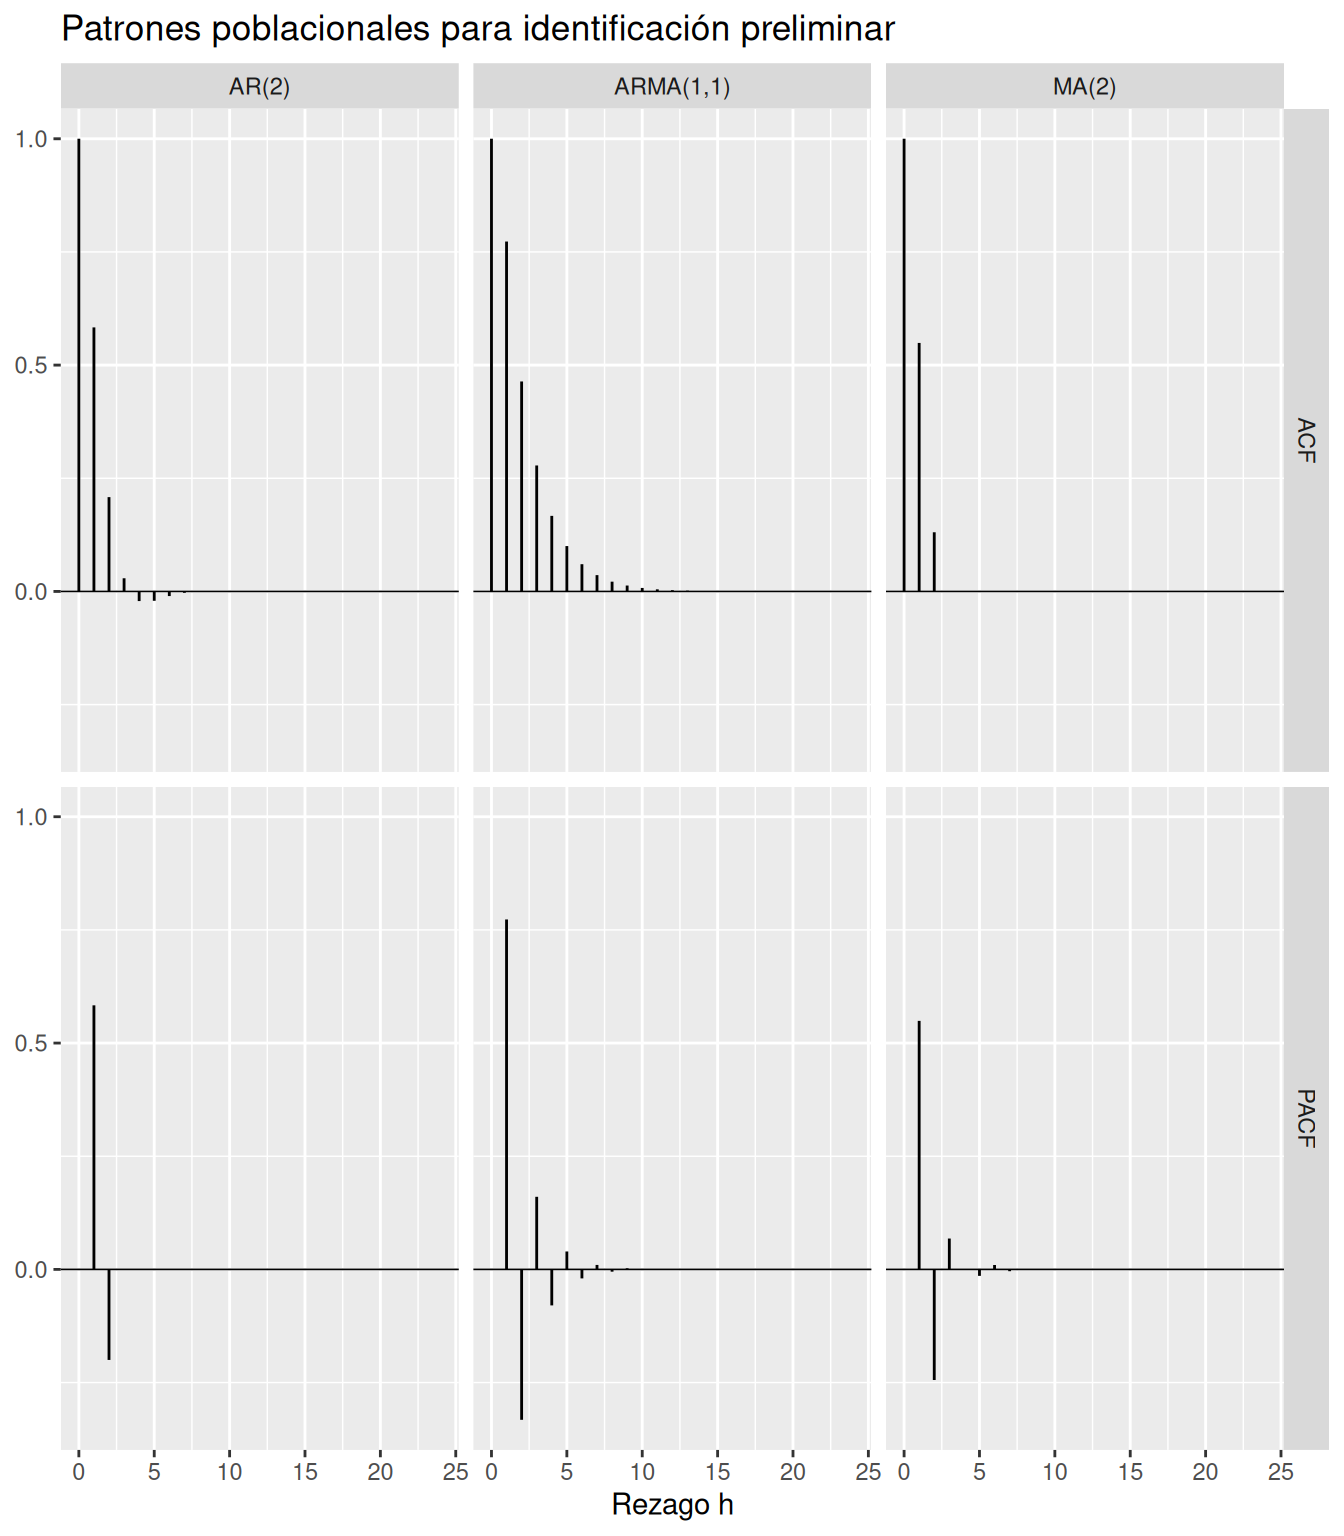
En el caso MA(\(q\)), la PACF no se corta porque un MA invertible puede expresarse como un AR(\(\infty\)). En un ARMA invertible ocurre lo mismo: su representación autorregresiva requiere, en general, infinitos rezagos (Shumway y Stoffer 2025, Example 3.16).
Figura 3.7: ACF y PACF teóricas de un AR(2), un MA(2) y un ARMA(1,1).
AdvertenciaACF y PACF no identifican automáticamente un modelo
Los patrones de la Figura 3.7 son poblacionales. En una muestra, las barras fluctúan y varios modelos pueden producir gráficos parecidos. ACF y PACF sirven para proponer órdenes candidatos; la semana 4 incorporará estimación, criterios de información y diagnóstico residual antes de aceptar un modelo.
3.12 Pronóstico de modelos MA y ARMA
El pronóstico conecta directamente causalidad e invertibilidad. Supongamos que el modelo es causal e invertible y que, idealmente, conocemos toda la historia hasta el tiempo \(T\). Para simplificar, trabajaremos primero con el proceso centrado \(X_t\).
Los términos con \(j<h\) corresponden a innovaciones futuras respecto del tiempo \(T\), mientras los términos con \(j\geq h\) corresponden a innovaciones ocurridas en \(T,T-1,\ldots\). Como las innovaciones futuras tienen media condicional cero,
La invertibilidad es lo que permite expresar, al menos en principio, las innovaciones pasadas mediante la historia observada de la serie (Shumway y Stoffer 2025, sec. 3.4.2).
Después de \(q\) pasos, ninguna innovación incluida en \(Y_{T+h}\) pertenece ya al conjunto de información del tiempo \(T\). La memoria predictiva del MA(\(q\)) es finita.
A horizontes largos se pierde la información específica del presente y la incertidumbre predictiva se aproxima a la variabilidad marginal del proceso (Shumway y Stoffer 2025, Example 3.21).
3.13 Reconstrucción recursiva y pronóstico con parámetros conocidos
En datos reales no observamos directamente las innovaciones \(\varepsilon_t\). Sin embargo, cuando el modelo ARMA es invertible, estas innovaciones pueden reconstruirse aproximadamente a partir del presente y del pasado observado de la serie.
Para ver de dónde surge esta aproximación, consideremos un ARMA(1,1) de media cero,
Si el MA(1) es invertible, \(|\theta|<1\). En ese caso, al aumentar \(m\), el último término pierde importancia y se obtiene la representación infinita
Esta expresión muestra que, en principio, la innovación \(\varepsilon_t\) depende de un pasado infinito de observaciones.
3.13.1 ¿Qué significa entonces “truncar”?
En una muestra real solo disponemos de un número finito de observaciones. Por ejemplo, si observamos
\[
X_1,\ldots,X_T,
\]
no tenemos acceso a toda la historia \(\ldots,X_{-2},X_{-1},X_0\) ni a las innovaciones anteriores al comienzo de la muestra.
Por ello debemos detener, o truncar, la representación anterior en algún punto. Una posibilidad sencilla consiste en fijar artificialmente una innovación inicial, por ejemplo
\[
\widehat{\varepsilon}_0=0,
\]
y, a partir de ella, reconstruir las innovaciones disponibles mediante
y el procedimiento continúa hasta \(\widehat{\varepsilon}_T\).
La palabra truncada se refiere, por tanto, a que estamos ignorando la parte de la representación invertible que depende del pasado anterior al inicio de la muestra. No estamos aproximando la ecuación ARMA en cada instante; estamos aproximando únicamente la información inicial desconocida.
De hecho, al iterar la recursión desde \(\widehat{\varepsilon}_0=0\) se obtiene
Cuando \(|\theta|<1\), esta diferencia desaparece geométricamente. En consecuencia, conforme nos alejamos del inicio de la muestra, la elección arbitraria de \(\widehat{\varepsilon}_0\) tiene cada vez menos influencia sobre las innovaciones reconstruidas.
Nota¿Qué se está truncando?
El término aproximación truncada no significa que se eliminen términos del modelo ARMA. Lo que se trunca es el pasado no observado requerido para reconstruir exactamente las innovaciones.
Al fijar, por ejemplo, \(\widehat{\varepsilon}_0=0\), sustituimos toda la información anterior al comienzo de la muestra por una condición inicial conveniente. La invertibilidad garantiza que el efecto de esta decisión desaparezca a medida que avanzamos en el tiempo.
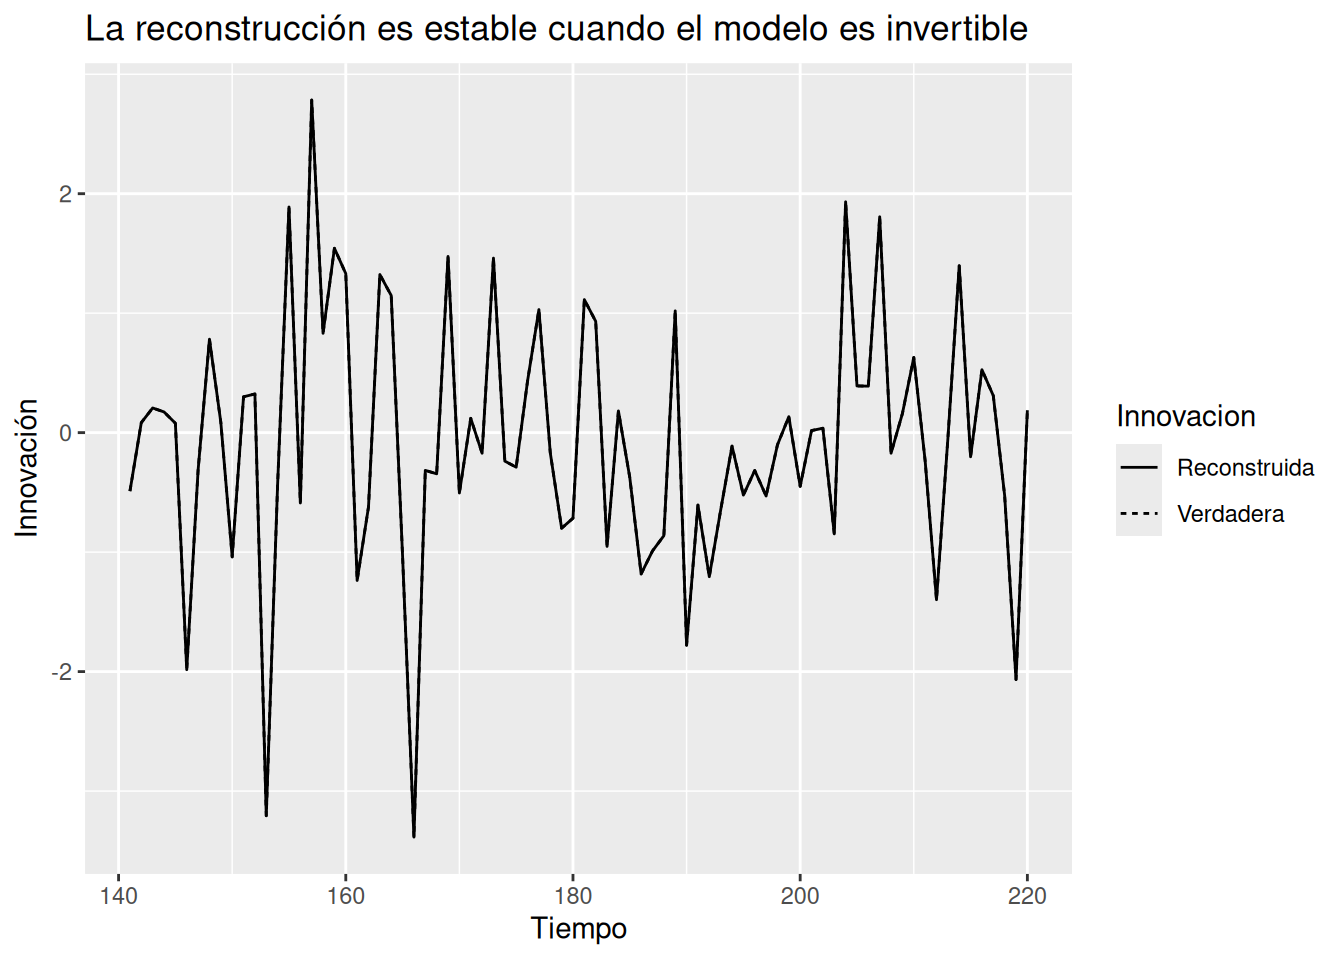
Figura 3.8: Innovaciones verdaderas y reconstruidas en un ARMA(1,1) invertible con parámetros conocidos.
La coincidencia en la Figura 3.8 no significa que las innovaciones sean observadas: en la simulación las conocemos únicamente para verificar el algoritmo. En datos reales se dispone solo de la reconstrucción.
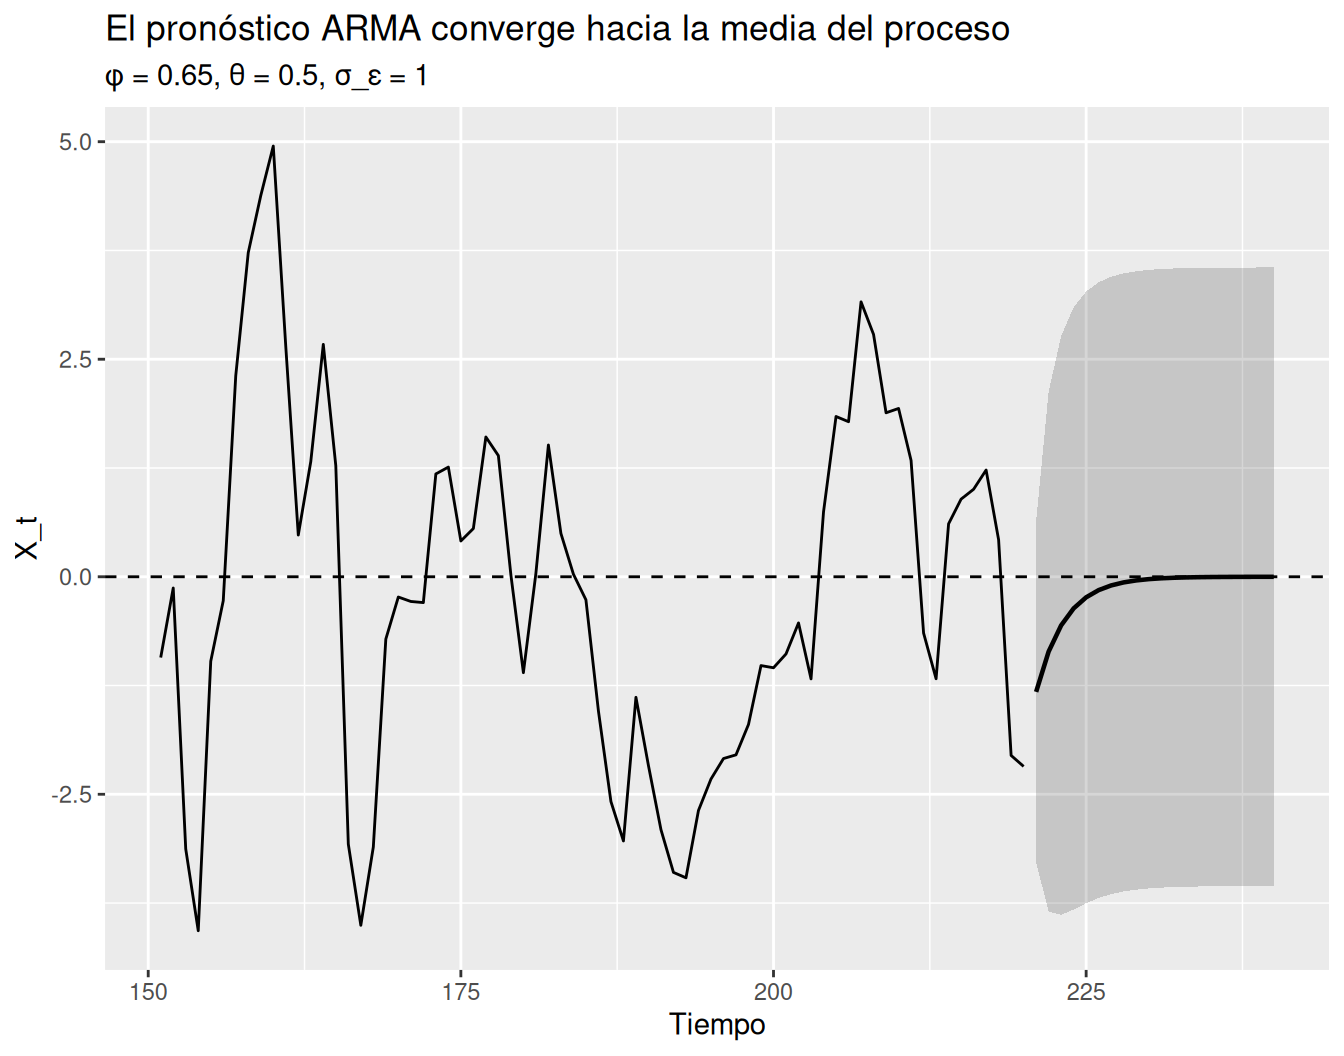
Figura 3.9: Pronóstico de un ARMA(1,1) con parámetros conocidos a partir de la última innovación reconstruida.
En la Figura 3.9 toda la incertidumbre proviene de innovaciones futuras porque tratamos los parámetros como conocidos. La incertidumbre de estimación se incorporará en las semanas 4 y 5.
3.14 Innovación, residual y error de pronóstico
Los tres términos se relacionan, pero no son intercambiables.
Tabla 3.3: Innovación, residual y error de pronóstico: objetos distintos.
Objeto
Notacion
Definicion
Observabilidad
Innovación del modelo
\(\varepsilon_t\)
Perturbación aleatoria que entra en la ecuación ARMA
Latente; no se observa directamente
Residual o innovación reconstruida
\(\widehat\varepsilon_t\)
Estimación de la innovación obtenida a partir de datos, parámetros y condiciones iniciales
Calculable después de especificar o ajustar el modelo
Error de pronóstico a horizonte \(h\)
\(e_T(h)=Y_{T+h}-\widehat Y_{T+h\mid T}\)
Diferencia entre un valor futuro y el pronóstico construido en \(T\)
Solo se observa ex post, cuando \(Y_{T+h}\) se vuelve disponible
Una innovación puede coincidir con un error de pronóstico de un paso en una formulación ideal con información completa y parámetros conocidos, pero en aplicaciones los residuales dependen de la estimación y de la inicialización. A horizontes mayores que uno, el error de pronóstico es una combinación de varias innovaciones futuras, como muestra Ecuación 3.38.
NotaEsta distinción prepara el diagnóstico de la semana 4
Cuando ajustemos modelos ARMA, buscaremos residuales que se comporten aproximadamente como las innovaciones postuladas por el modelo. Diagnosticar residuales no es lo mismo que observar directamente las perturbaciones verdaderas.
3.15 Aplicación: Recruitment revisitada desde AR, MA y ARMA
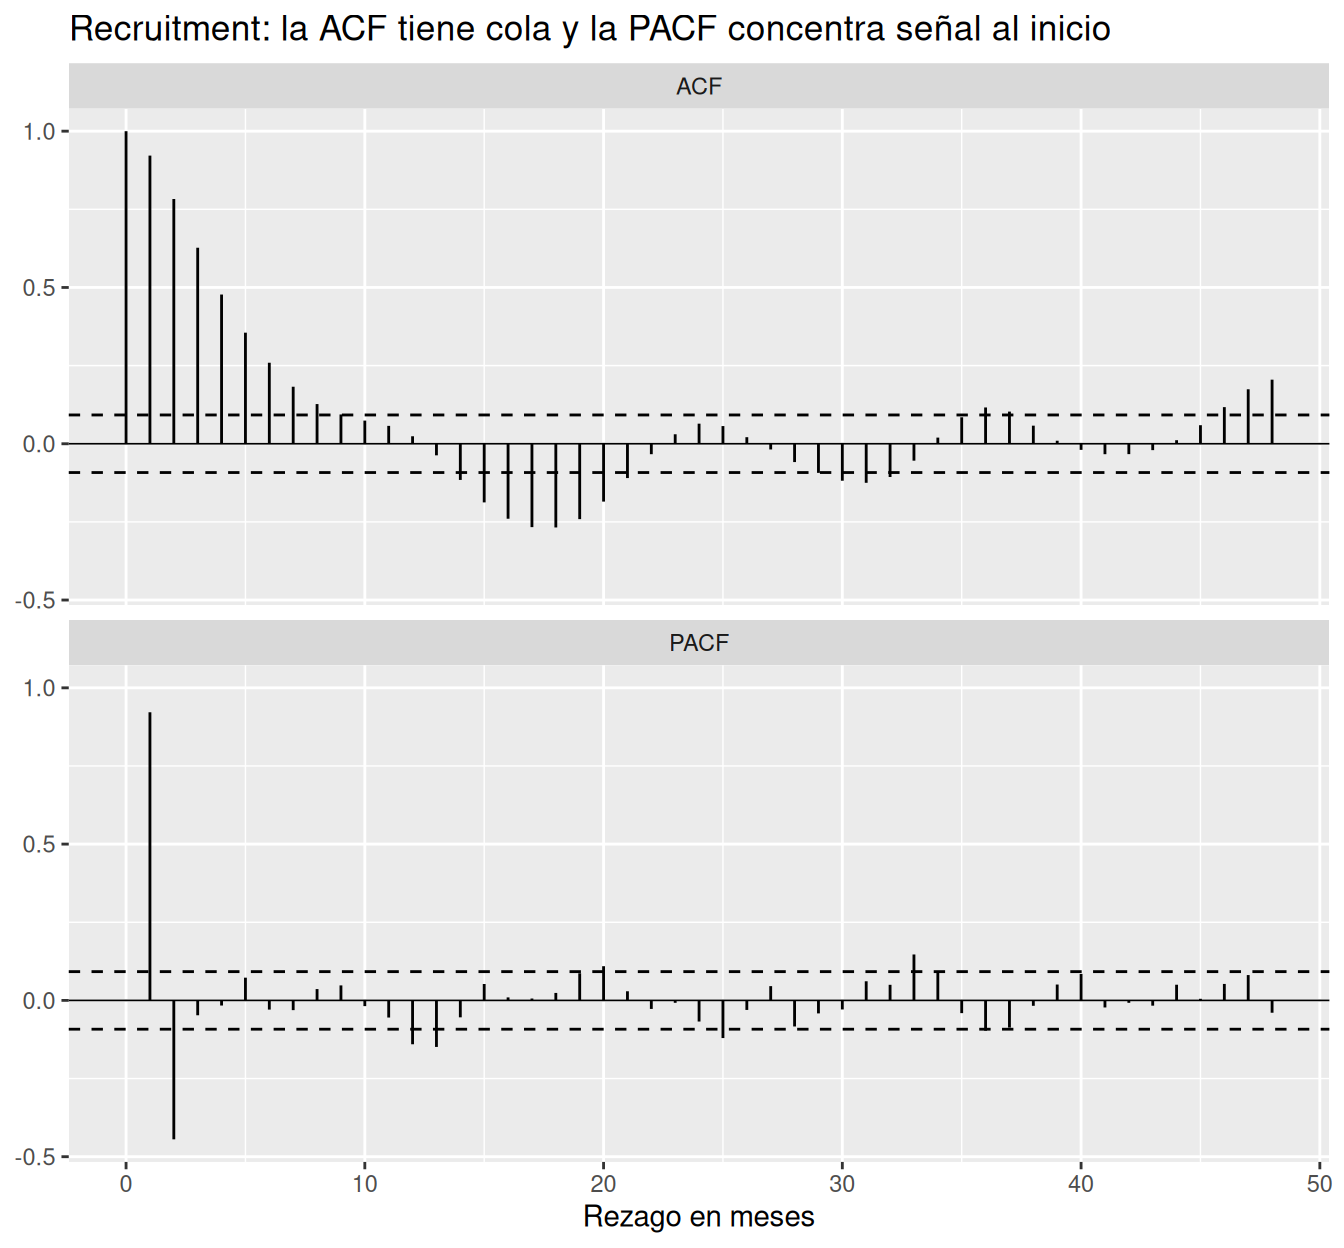
En Sección 2.12 examinamos la serie mensual rec de Shumway y Stoffer. La ACF muestral presenta una cola oscilatoria y la PACF concentra la señal principal en los primeros dos rezagos, patrón que los autores interpretan como compatible con un AR(2) (Shumway y Stoffer 2025, Example 3.17).
Esta semana podemos reinterpretar ese resultado usando la tabla completa de identificación:
un MA(2) puro esperaría una ACF poblacional exactamente nula después del rezago 2;
un ARMA mixto esperaría colas en ACF y PACF;
un AR(2) espera una ACF con cola y una PACF con corte después del segundo rezago.
Volvemos a graficar las dos funciones para comparar la evidencia con estos patrones, sin ajustar todavía modelos candidatos.
if (!requireNamespace("astsa", quietly =TRUE)) {stop("El ejemplo de Recruitment requiere el paquete 'astsa'. ","Instálelo antes de compilar este capítulo." )}rec_env_arma <-new.env()data("rec", package ="astsa", envir = rec_env_arma)rec_obj_arma <- rec_env_arma$recrec_arma <-tibble(t =seq_along(rec_obj_arma),Reclutamiento =as.numeric(rec_obj_arma)) |>as_tsibble(index = t)stopifnot(nrow(rec_arma) >100,!anyNA(rec_arma$Reclutamiento))
lag_rec_arma <-48T_rec_arma <-nrow(rec_arma)banda_rec_arma <-1.96/sqrt(T_rec_arma)acf_rec_arma <- stats::acf( rec_arma$Reclutamiento,lag.max = lag_rec_arma,plot =FALSE,demean =TRUE)pacf_rec_arma <- stats::pacf( rec_arma$Reclutamiento,lag.max = lag_rec_arma,plot =FALSE)acf_pacf_rec_arma <-bind_rows(tibble(h =0:lag_rec_arma,valor =as.numeric(acf_rec_arma$acf),Funcion ="ACF" ),tibble(h =1:lag_rec_arma,valor =as.numeric(pacf_rec_arma$acf),Funcion ="PACF" ))ggplot(acf_pacf_rec_arma, aes(x = h, y = valor)) +geom_hline(yintercept =0, linewidth =0.3) +geom_hline(yintercept =c(-banda_rec_arma, banda_rec_arma),linetype ="dashed" ) +geom_segment(aes(xend = h, yend =0)) +facet_wrap(~Funcion, ncol =1) +labs(x ="Rezago en meses",y =NULL,title ="Recruitment: la ACF tiene cola y la PACF concentra señal al inicio" )
Figura 3.10: ACF y PACF muestrales de Recruitment, reinterpretadas con los patrones AR/MA/ARMA.
La Figura 3.10 es más compatible con la firma preliminar de un AR de orden bajo que con un MA puro de orden bajo. Sin embargo, no utilizaremos esta observación para declarar un modelo definitivo. La semana 4 incorporará estimación, criterios de información y diagnóstico de residuos. Ese paso es necesario porque un ARMA mixto o un modelo mal especificado pueden producir patrones muestrales similares.
3.16 Actividad computacional guiada
3.16.1 Parte A. ACF de modelos MA
Para un MA(1) con \(\theta=0.6\), derive \(\gamma(0)\), \(\gamma(1)\) y \(\rho(1)\).
Simule \(T=300\) observaciones y compare la ACF muestral con la teórica.
Repita con \(\theta=-0.6\) y explique qué cambia.
Para un MA(2) con \((\theta_1,\theta_2)=(0.7,0.2)\), verifique computacionalmente que la ACF teórica es cero después del rezago 2.
obtenga los mismos valores recursivamente usando Ecuación 3.28;
grafique los pesos;
explique qué parte del modelo determina el comportamiento para valores grandes de \(j\).
3.16.5 Parte E. Pronóstico con parámetros conocidos
Para el mismo ARMA(1,1), suponga \(X_T=2\), \(\varepsilon_T=-0.5\) y \(\sigma_\varepsilon=1\).
Calcule \(\widehat X_{T+h\mid T}\) para \(h=1,2,5,10\).
Calcule la varianza del error de pronóstico mediante Ecuación 3.39.
Construya intervalos gaussianos del 95 %.
Compare el límite del pronóstico medio y de la varianza con los resultados teóricos de Sección 3.12.4.
3.17 Puente hacia estimación e inferencia
Hasta aquí tratamos \(\phi_1,\ldots,\phi_p\), \(\theta_1,\ldots,\theta_q\) y \(\sigma_\varepsilon^2\) como conocidos. Esa simplificación permitió separar la estructura probabilística de los problemas inferenciales.
En un AR puro, una vez dados los primeros \(p\) valores, la ecuación se parece a una regresión lineal. En un ARMA con \(q>0\), en cambio, aparecen innovaciones pasadas no observadas:
Esto introduce dos dificultades que serán centrales en la semana 4:
las innovaciones deben reconstruirse o integrarse al construir la verosimilitud;
el tratamiento de condiciones iniciales afecta la diferencia entre aproximaciones condicionales y exactas.
Prado, Ferreira y West muestran explícitamente que la estimación ARMA requiere métodos numéricos y un tratamiento de las innovaciones iniciales más elaborado que en un AR puro (Prado et al. 2021, secs. 2.5.4.2–2.5.4.4). Shumway y Stoffer desarrollan posteriormente máxima verosimilitud, mínimos cuadrados y diagnóstico (Shumway y Stoffer 2025, sec. 3.5).
No desarrollaremos todavía una posterior bayesiana completa. Sin embargo, hay una consecuencia inmediata para la semana 5: si el modelo bayesiano se formula como ARMA causal e invertible, el soporte de la priori o la parametrización debe respetar las regiones correspondientes.
TipLas restricciones estructurales reaparecen en inferencia
Causalidad e invertibilidad no son detalles posteriores al ajuste. Definen qué parametrizaciones representan el modelo que pretendemos estimar y ayudan a evitar soluciones observacionalmente redundantes.
3.18 Síntesis
Las ideas centrales de la semana son las siguientes:
un MA(\(q\)) expresa \(Y_t\) como una combinación finita de innovaciones presentes y pasadas;
todo MA finito con ruido blanco es débilmente estacionario para cualquier conjunto finito de coeficientes; con innovaciones i.i.d. también es estrictamente estacionario;
la ACF poblacional de un MA(\(q\)) se corta después del rezago \(q\) porque observaciones más separadas no comparten innovaciones;
un MA(1) puede tener parametrizaciones observacionalmente equivalentes, lo que motiva imponer invertibilidad;
invertibilidad significa que las innovaciones pueden expresarse como una combinación convergente de observaciones presentes y pasadas;
para un MA(1), la condición de invertibilidad es \(|\theta|<1\);
causalidad significa que el proceso puede expresarse como una combinación convergente de innovaciones presentes y pasadas;
la causalidad de un ARMA en forma mínima depende de las raíces de \(\Phi(z)\); la invertibilidad depende de las raíces de \(\Theta(z)\);
estacionariedad y causalidad no son sinónimos: un AR puede admitir una solución estacionaria no causal que depende de innovaciones futuras;
un ARMA(\(p,q\)) debe expresarse en forma mínima, sin factores comunes entre \(\Phi\) y \(\Theta\);
si un ARMA es causal e invertible, posee tanto una representación MA(\(\infty\)) como una representación AR(\(\infty\));
la cola de la ACF de un ARMA está gobernada por la parte autorregresiva;
para identificación preliminar: AR tiene ACF con cola y PACF con corte; MA tiene ACF con corte y PACF con cola; ARMA mixto suele tener cola en ambas;
la representación causal conduce directamente al pronóstico y a la varianza del error \(h\) pasos adelante;
en un MA(\(q\)), el pronóstico retorna a la media después de \(q\) pasos; en un ARMA causal, la convergencia es gradual y está gobernada por la dinámica AR;
innovación, residual y error de pronóstico son objetos relacionados pero conceptualmente distintos.
En la semana 4 convertiremos estas propiedades estructurales en un procedimiento de modelación: construiremos verosimilitudes, estimaremos parámetros, compararemos órdenes y examinaremos si los residuales se comportan como las innovaciones postuladas por el modelo.
3.19 Ejercicios
3.19.1 Conceptuales
Memoria finita. Explique por qué \(Y_t\) y \(Y_{t-4}\) son incorrelacionados en un MA(3). ¿Qué innovaciones aparecen en cada observación?
Estacionariedad e invertibilidad. Un MA(1) tiene \(\theta=1.5\). ¿Es estacionario? ¿Es invertible bajo la convención de estas notas? Justifique ambas respuestas por separado.
Causalidad. Explique por qué la expresión “el modelo es causal” no debe interpretarse como una afirmación de causalidad científica entre variables.
Solución no causal. Para un AR(1) con \(\phi=1.2\), describa la diferencia entre decir “no existe una solución estacionaria causal” y decir “no existe ninguna solución estacionaria”.
Identificación. Una ACF muestral presenta dos barras grandes y luego valores pequeños, mientras la PACF decae gradualmente. ¿Qué clase de modelo sería un candidato inicial? ¿Por qué la conclusión no es definitiva?
Modelo mixto. Explique intuitivamente por qué en un ARMA(1,1) la parte MA afecta fuertemente los primeros rezagos pero la cola de la ACF termina gobernada por \(\phi\).
Factores comunes. ¿Por qué
\[
(1-0.5B)X_t=(1-0.5B)\varepsilon_t
\]
no debe considerarse genuinamente un ARMA(1,1)?
Innovación frente a residual. Explique por qué \(\widehat\varepsilon_t\) no es exactamente lo mismo que \(\varepsilon_t\) cuando los parámetros son estimados y la muestra es finita.
Indique para qué valores de \(\theta\) se alcanza la igualdad.
No unicidad. Demuestre que \(\theta\) y \(1/\theta\) generan la misma ACF en un MA(1). Luego determine qué ajuste de \(\sigma_\varepsilon^2\) hace iguales sus funciones de autocovarianza.
ACF de un MA(2). Derive \(\gamma(0)\), \(\gamma(1)\), \(\gamma(2)\) y demuestre que \(\gamma(h)=0\) para \(h\geq3\).
ACF general de un MA(\(q\)). Derive Ecuación 3.9 cuidando los índices de las innovaciones compartidas.
Invertibilidad de MA(1). Partiendo de \(\varepsilon_t=X_t-\theta\varepsilon_{t-1}\), derive Ecuación 3.18. Explique por qué la serie converge cuando \(|\theta|<1\).
Error de inicialización. Demuestre ?eq-arma-error-inicializacion. ¿Qué ocurre si \(|\theta|=1\)?
AR(1) no causal. Complete los pasos entre Ecuación 3.21 y Ecuación 3.22 y verifique que la varianza resultante es finita cuando \(|\phi|>1\).
Pesos de un ARMA(1,1). Derive Ecuación 3.30 a partir de la expansión de \((1+\theta B)/(1-\phi B)\).
Varianza de un ARMA(1,1). Utilice los pesos \(\psi_j\) para derivar Ecuación 3.31.
Pronóstico MA(\(q\)). Demuestre Ecuación 3.40 y explique por qué la propiedad no implica que las observaciones futuras sean independientes de toda la historia.
Límite predictivo. Demuestre Ecuación 3.44 para un proceso causal cuyos pesos \(\psi_j\) sean cuadrado-sumables.
3.19.3 Computacionales
Simulación MA(1). Para \(\theta\in\{-0.9,-0.4,0.4,0.9\}\), simule series de tamaño \(T=300\), grafique las ACF y compare \(\widehat\rho(1)\) con el valor teórico.
Tamaño de muestra y corte. Simule 300 realizaciones de un MA(2) con \(T=50\) y otras 300 con \(T=500\). Para cada serie guarde \(\widehat\rho(5)\). Compare las distribuciones de estas estimaciones y explique por qué el corte teórico puede resultar visualmente ambiguo en muestras pequeñas.
calcule las raíces de \(1+\theta_1z+\theta_2z^2\) con polyroot() y determine invertibilidad.
Reconstrucción de innovaciones. Simule un MA(1) invertible y reconstruya \(\varepsilon_t\) usando ?eq-arma-ma1-recursion-innovacion con \(\widehat\varepsilon_0\in\{-10,0,10\}\). Grafique la diferencia entre reconstrucciones a lo largo del tiempo.
Caso no invertible. Repita el ejercicio anterior con \(|\theta|>1\). Explique numéricamente por qué la recursión es inestable.
Causalidad AR(2). Para los dos AR(2) de Sección 2.9.2, use polyroot() para verificar la condición de raíces y calcule los primeros 30 pesos \(\psi_j\). Relacione su forma con las raíces reales o complejas estudiadas en la semana 2.
ARMA(1,1) y ACF. Para \((\phi,\theta)=(0.6,0.5)\):
obtenga \(\rho(1),\ldots,\rho(20)\) con Ecuación 3.35;
verifique con stats::ARMAacf();
simule una muestra y compare la ACF muestral.
ACF/PACF y clasificación. Simule, sin mostrar los parámetros a una segunda persona, una serie AR(2), una MA(2) y una ARMA(1,1). Pídale clasificar cada serie usando ACF/PACF. Después revele los modelos y discutan qué elementos de la muestra dificultaron la identificación.
Pronóstico ARMA(1,1). Implemente una función que reciba \(\phi\), \(\theta\), \(\sigma_\varepsilon\), \(X_T\), \(\widehat\varepsilon_T\) y \(H\), y devuelva la media, varianza e intervalo predictivo gaussiano para \(h=1,\ldots,H\).
Recruitment. Reproduzca Figura 3.10 con máximos rezagos 24, 48 y 72. Para cada gráfico, describa si la evidencia visual parece más compatible con AR, MA o ARMA. No ajuste todavía modelos; señale qué información adicional requeriría una decisión formal.
3.20 Lecturas recomendadas
Para esta semana:
Shumway y Stoffer: secciones 3.1–3.4 para modelos AR, MA y ARMA, causalidad, invertibilidad, ecuaciones en diferencias, ACF/PACF y pronóstico; el Apéndice B.3 desarrolla con mayor formalidad la condición causal (Shumway y Stoffer 2025).
Prado, Ferreira y West: secciones 2.5.1–2.5.4.1 para estructura ARMA, ACF/PACF, inversión de componentes y pronóstico (Prado et al. 2021).
La estimación se pospone deliberadamente. La semana 4 retomará estos mismos modelos para estudiar verosimilitud condicional y exacta, máxima verosimilitud, selección de orden y diagnóstico; la semana 5 incorporará la perspectiva bayesiana para modelos autorregresivos y la propagación de incertidumbre paramétrica hacia el pronóstico.
Prado, Raquel, Marco A. R. Ferreira, y Mike West. 2021. Time Series: Modeling, Computation, and Inference. 2.ª ed. Chapman; Hall/CRC.
Shumway, Robert H., y David S. Stoffer. 2025. Time Series Analysis and Its Applications: With R Examples. 5.ª ed. Springer. https://doi.org/10.1007/978-3-031-70584-7.