set.seed(415)

T_yw <- 144
phi_yw <- c(1.5, -0.75)

x_yw <- as.numeric(stats::arima.sim(
  model = list(ar = phi_yw),
  n = T_yw,
  sd = 1
))

acf_yw <- stats::acf(
  x_yw,
  lag.max = 2,
  plot = FALSE,
  demean = TRUE
)$acf |> as.numeric()

rho1_yw <- acf_yw[2]
rho2_yw <- acf_yw[3]

R_yw <- matrix(
  c(1, rho1_yw,
    rho1_yw, 1),
  nrow = 2,
  byrow = TRUE
)

phi_yw_manual <- solve(R_yw, c(rho1_yw, rho2_yw))

ajuste_yw <- stats::ar.yw(
  x_yw,
  aic = FALSE,
  order.max = 2,
  demean = TRUE
)

ajuste_ml_ar2 <- stats::arima(
  x_yw,
  order = c(2, 0, 0),
  include.mean = FALSE,
  method = "ML"
)4 Estimación frecuentista, selección y diagnóstico de modelos ARMA
CA-0415 Series de Tiempo — Semana 4
4.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
- construir e interpretar la verosimilitud condicional de un modelo AR(\(p\)) gaussiano;
- explicar qué información se pierde o se condiciona al pasar de una verosimilitud exacta a una aproximación condicional;
- derivar los estimadores de Yule–Walker para un modelo AR(\(p\)) y relacionarlos con las ecuaciones de autocovarianza estudiadas en la semana 2;
- explicar la relación entre mínimos cuadrados condicionales y máxima verosimilitud gaussiana en modelos autorregresivos;
- describir por qué la estimación de un ARMA(\(p,q\)) con \(q>0\) es un problema no lineal que requiere reconstruir innovaciones y utilizar optimización numérica;
- interpretar errores estándar e intervalos de confianza aproximados para parámetros estimados;
- calcular e interpretar AIC, AICc y BIC, reconociendo las condiciones bajo las cuales sus valores son comparables;
- distinguir entre la innovación no observable del proceso, la innovación estimada o residual y el residual estandarizado;
- diagnosticar un modelo mediante gráficos de residuales, ACF residual, ACF de residuales al cuadrado y gráficos Q–Q;
- formular e interpretar la prueba portmanteau de Ljung–Box;
- integrar identificación, estimación, selección y diagnóstico como un proceso iterativo de modelación;
- reconocer que un buen ajuste dentro de muestra no equivale a evidencia de superioridad predictiva fuera de muestra.
En Sección 3.17 dejamos pendiente una dificultad esencial. Para un ARMA(\(p,q\)), las innovaciones que aparecen en
\[ \Phi(B)(Y_t-\mu)=\Theta(B)\varepsilon_t \]
no son observables. Hasta ahora tratamos \(\phi_j\), \(\theta_j\) y \(\sigma_\varepsilon^2\) como conocidos para estudiar estructura, causalidad, invertibilidad y pronóstico. En una aplicación real disponemos únicamente de una trayectoria \(y_{1:T}\) y debemos aprender los parámetros a partir de esa trayectoria.
La guía del curso reserva esta semana para verosimilitud condicional y exacta, Yule–Walker, máxima verosimilitud, criterios de información y diagnóstico de residuales. El objetivo es construir un modelo frecuentista de referencia que se retomará en la semana 5 al introducir inferencia bayesiana (Shumway y Stoffer 2025, secs. 3.5 y 3.7; Prado et al. 2021, secs. 2.3.1, 2.3.4 y 2.5.4.2; Hyndman y Athanasopoulos 2021, secs. 5.4 y 9.6).
4.2 De un modelo probabilístico a una función de los parámetros
Considere nuevamente el AR(2)
\[ Y_t = \mu +\phi_1(Y_{t-1}-\mu) +\phi_2(Y_{t-2}-\mu) +\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2). \tag{4.1}\]
Si \(\mu\), \(\phi_1\), \(\phi_2\) y \(\sigma_\varepsilon^2\) fueran conocidos, podríamos simular trayectorias, calcular ACF y PACF, reconstruir pronósticos y cuantificar el error predictivo. Pero una muestra observada no viene acompañada por esos valores.
La inferencia frecuentista comienza con una inversión conceptual:
- cuando simulamos, fijamos parámetros y generamos datos;
- cuando estimamos, fijamos los datos observados y preguntamos qué valores de los parámetros hacen esos datos más compatibles con el modelo.
Para el modelo gaussiano, esa compatibilidad se resume mediante la función de verosimilitud. Si \(\boldsymbol\vartheta\) denota todos los parámetros desconocidos,
\[ L(\boldsymbol\vartheta;y_{1:T}) = p(y_{1:T};\boldsymbol\vartheta), \tag{4.2}\]
considerada como una función de \(\boldsymbol\vartheta\) con los datos \(y_{1:T}\) fijos.
NotaProbabilidad y verosimilitud no son el mismo objeto
La densidad \(p(y_{1:T};\boldsymbol\vartheta)\) puede verse de dos maneras. Si \(\boldsymbol\vartheta\) está fijo y \(Y_{1:T}\) es aleatorio, describe un modelo probabilístico para posibles datos. Una vez observado \(y_{1:T}\), la misma expresión, vista como función de \(\boldsymbol\vartheta\), es una verosimilitud. En el enfoque frecuentista, el parámetro desconocido se trata como fijo; no se le asigna aquí una distribución de probabilidad.
La semana 5 utilizará exactamente la misma verosimilitud como componente del modelo bayesiano. La diferencia será que allí incorporaremos una distribución a priori y obtendremos una distribución posterior para los parámetros.
4.3 Verosimilitud condicional de un AR(\(p\))
Considere el AR(\(p\))
\[ Y_t = c+\phi_1Y_{t-1}+\cdots+\phi_pY_{t-p}+\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2). \tag{4.3}\]
Escribamos
\[ \boldsymbol\beta = (c,\phi_1,\ldots,\phi_p)^\top. \]
Si condicionamos en las primeras \(p\) observaciones, \(y_{1:p}\), entonces para \(t=p+1,\ldots,T\),
\[ Y_t\mid Y_{t-1}=y_{t-1},\ldots,Y_{t-p}=y_{t-p} \sim N\left( c+\sum_{j=1}^{p}\phi_jy_{t-j}, \sigma_\varepsilon^2 \right). \tag{4.4}\]
Por independencia de las innovaciones, la verosimilitud condicional es
\[ L_c(\boldsymbol\beta,\sigma_\varepsilon^2) = \prod_{t=p+1}^{T} \frac{1}{\sqrt{2\pi\sigma_\varepsilon^2}} \exp\left\{ -\frac{1}{2\sigma_\varepsilon^2} \left( y_t-c-\sum_{j=1}^{p}\phi_jy_{t-j} \right)^2 \right\}. \tag{4.5}\]
Definamos el error condicional
\[ e_t(\boldsymbol\beta) = y_t-c-\sum_{j=1}^{p}\phi_jy_{t-j}. \tag{4.6}\]
Entonces la log-verosimilitud condicional puede escribirse como
\[ \ell_c(\boldsymbol\beta,\sigma_\varepsilon^2) = -\frac{T-p}{2}\log(2\pi) -\frac{T-p}{2}\log(\sigma_\varepsilon^2) -\frac{1}{2\sigma_\varepsilon^2} \sum_{t=p+1}^{T}e_t(\boldsymbol\beta)^2. \tag{4.7}\]
Para un valor fijo de \(\sigma_\varepsilon^2\), maximizar Ecuación 4.7 respecto de \(\boldsymbol\beta\) equivale a minimizar
\[ S_c(\boldsymbol\beta) = \sum_{t=p+1}^{T}e_t(\boldsymbol\beta)^2. \tag{4.8}\]
Esta es exactamente la suma de cuadrados de una regresión lineal cuya respuesta es \(Y_t\) y cuyos predictores son \(1,Y_{t-1},\ldots,Y_{t-p}\). Por ello, en un AR puro la máxima verosimilitud condicional gaussiana y los mínimos cuadrados condicionales producen el mismo estimador de los coeficientes (Shumway y Stoffer 2025, sec. 3.5.2; Prado et al. 2021, sec. 2.3.1).
4.3.1 Estimación de la varianza de innovación
Una vez minimizada Ecuación 4.8, la estimación de máxima verosimilitud condicional de la varianza es
\[ \widehat\sigma_{\varepsilon,\text{ML}}^2 = \frac{S_c(\widehat{\boldsymbol\beta})}{T-p}. \tag{4.9}\]
El denominador \(T-p\) surge de maximizar la verosimilitud; no debe confundirse con una corrección de grados de libertad diseñada para obtener un estimador insesgado de la varianza en un modelo lineal.
ImportanteEl MLE de la varianza no es la corrección por grados de libertad
En regresión lineal es frecuente dividir la suma de cuadrados residual por el número de observaciones menos el número de coeficientes estimados. Esa corrección persigue insesgamiento. El estimador de máxima verosimilitud de \(\sigma_\varepsilon^2\) utiliza el denominador que resulta de maximizar la función de verosimilitud. Son criterios distintos y conviene mantenerlos separados.
4.3.2 El caso AR(1) y su relación con regresión
Para
\[ Y_t-\mu = \phi(Y_{t-1}-\mu)+\varepsilon_t, \tag{4.10}\]
podemos escribir
\[ Y_t = \alpha+\phi Y_{t-1}+\varepsilon_t, \qquad \alpha=\mu(1-\phi). \tag{4.11}\]
Al condicionar en \(Y_1=y_1\), la estimación de \((\alpha,\phi)\) se convierte en una regresión de \(y_t\) sobre \(y_{t-1}\) para \(t=2,\ldots,T\). Después recuperamos
\[ \widehat\mu = \frac{\widehat\alpha}{1-\widehat\phi}, \tag{4.12}\]
si \(\widehat\phi\neq1\). Shumway y Stoffer muestran que esta forma explica por qué, para muestras suficientemente grandes, el estimador condicional de \(\phi\) es muy cercano a la autocorrelación muestral en rezago uno y, por tanto, al estimador de Yule–Walker (Shumway y Stoffer 2025, sec. 3.5.2).
4.4 Estimación de Yule–Walker
En Sección 2.9 estudiamos que un AR(\(p\)) estacionario satisface las ecuaciones de autocovarianza
\[ \gamma(h) = \phi_1\gamma(h-1) +\cdots+ \phi_p\gamma(h-p), \qquad h\geq1. \tag{4.13}\]
Para \(h=1,\ldots,p\), estas ecuaciones forman el sistema
\[ \underbrace{ \begin{pmatrix} \gamma(0) & \gamma(1) & \cdots & \gamma(p-1)\\ \gamma(1) & \gamma(0) & \cdots & \gamma(p-2)\\ \vdots & \vdots & \ddots & \vdots\\ \gamma(p-1) & \gamma(p-2) & \cdots & \gamma(0) \end{pmatrix} }_{\Gamma_p} \underbrace{ \begin{pmatrix} \phi_1\\ \phi_2\\ \vdots\\ \phi_p \end{pmatrix} }_{\boldsymbol\phi} = \underbrace{ \begin{pmatrix} \gamma(1)\\ \gamma(2)\\ \vdots\\ \gamma(p) \end{pmatrix} }_{\boldsymbol\gamma_p}. \tag{4.14}\]
Si \(\Gamma_p\) es invertible,
\[ \boldsymbol\phi = \Gamma_p^{-1}\boldsymbol\gamma_p. \tag{4.15}\]
La idea de Yule–Walker es sustituir los momentos poblacionales por sus equivalentes muestrales:
\[ \widehat{\boldsymbol\phi}_{YW} = \widehat\Gamma_p^{-1}\widehat{\boldsymbol\gamma}_p. \tag{4.16}\]
Una vez estimados los coeficientes autorregresivos, todavía falta estimar \(\sigma_\varepsilon^2\), la varianza de las innovaciones. Para ver de dónde surge el estimador, conviene regresar a la ecuación del modelo.
Supongamos, por simplicidad, que el proceso está centrado en cero:
\[ Y_t = \phi_1Y_{t-1} +\cdots+ \phi_pY_{t-p} +\varepsilon_t, \]
donde
\[ E(\varepsilon_t)=0, \qquad \operatorname{Var}(\varepsilon_t)=\sigma_\varepsilon^2, \]
y \(\varepsilon_t\) es incorrelacionada con \(Y_{t-j}\) para todo \(j\geq1\).
Multipliquemos ambos lados de la ecuación del modelo por \(Y_t\) y tomemos esperanza:
\[ E(Y_t^2) = \phi_1E(Y_tY_{t-1}) +\cdots+ \phi_pE(Y_tY_{t-p}) + E(Y_t\varepsilon_t). \]
Como el proceso tiene media cero,
\[ E(Y_t^2)=\gamma(0), \qquad E(Y_tY_{t-j})=\gamma(j), \]
de modo que
\[ \gamma(0) = \phi_1\gamma(1) +\cdots+ \phi_p\gamma(p) + E(Y_t\varepsilon_t). \tag{4.17}\]
El último término requiere un pequeño argumento adicional. A partir del modelo,
\[ Y_t = \phi_1Y_{t-1} +\cdots+ \phi_pY_{t-p} +\varepsilon_t, \]
tenemos
\[ E(Y_t\varepsilon_t) = \sum_{j=1}^p \phi_jE(Y_{t-j}\varepsilon_t) + E(\varepsilon_t^2). \]
Las innovaciones presentes son incorrelacionadas con el pasado, por lo que
\[ E(Y_{t-j}\varepsilon_t)=0, \qquad j=1,\ldots,p. \]
Además,
\[ E(\varepsilon_t^2)=\sigma_\varepsilon^2. \]
Por tanto,
\[ E(Y_t\varepsilon_t) = \sigma_\varepsilon^2. \]
Sustituyendo este resultado en Ecuación 4.17 obtenemos la ecuación de Yule–Walker para el rezago cero:
\[ \gamma(0) = \phi_1\gamma(1) +\cdots+ \phi_p\gamma(p) + \sigma_\varepsilon^2. \tag{4.18}\]
Despejando la varianza de las innovaciones,
\[ \sigma_\varepsilon^2 = \gamma(0) - \sum_{j=1}^p \phi_j\gamma(j). \tag{4.19}\]
Si definimos
\[ \boldsymbol\phi = \begin{pmatrix} \phi_1\\ \vdots\\ \phi_p \end{pmatrix}, \qquad \boldsymbol\gamma_p = \begin{pmatrix} \gamma(1)\\ \vdots\\ \gamma(p) \end{pmatrix}, \]
la expresión anterior puede escribirse de forma compacta como
\[ \sigma_\varepsilon^2 = \gamma(0) - \boldsymbol\phi^\top\boldsymbol\gamma_p. \tag{4.20}\]
El método de Yule–Walker sustituye ahora las cantidades poblacionales por sus versiones muestrales. Así,
\[ \gamma(0) \longrightarrow \widehat\gamma(0), \qquad \boldsymbol\phi \longrightarrow \widehat{\boldsymbol\phi}_{YW}, \qquad \boldsymbol\gamma_p \longrightarrow \widehat{\boldsymbol\gamma}_p, \]
y obtenemos
\[ \widehat\sigma_{\varepsilon,YW}^2 = \widehat\gamma(0) - \widehat{\boldsymbol\phi}_{YW}^{\top} \widehat{\boldsymbol\gamma}_p. \tag{4.21}\]
Estas son precisamente las ecuaciones de Yule–Walker descritas por Shumway y Stoffer y Prado, Ferreira y West (Shumway y Stoffer 2025, sec. 3.5.1; Prado et al. 2021, sec. 2.3.1).
4.4.1 Ejemplo analítico: AR(2)
Para
\[ Y_t = \phi_1Y_{t-1}+\phi_2Y_{t-2}+\varepsilon_t, \]
las primeras dos ecuaciones normalizadas por \(\gamma(0)\) son
\[ \rho(1) = \phi_1+\phi_2\rho(1), \]
\[ \rho(2) = \phi_1\rho(1)+\phi_2. \]
Sustituyendo \(\rho(h)\) por \(\widehat\rho(h)\),
\[ \begin{pmatrix} 1 & \widehat\rho(1)\\ \widehat\rho(1) & 1 \end{pmatrix} \begin{pmatrix} \widehat\phi_1\\ \widehat\phi_2 \end{pmatrix} = \begin{pmatrix} \widehat\rho(1)\\ \widehat\rho(2) \end{pmatrix}. \tag{4.22}\]
Por tanto,
\[ \begin{pmatrix} \widehat\phi_1\\ \widehat\phi_2 \end{pmatrix} = \begin{pmatrix} 1 & \widehat\rho(1)\\ \widehat\rho(1) & 1 \end{pmatrix}^{-1} \begin{pmatrix} \widehat\rho(1)\\ \widehat\rho(2) \end{pmatrix}. \tag{4.23}\]
Observe la conexión conceptual: en la semana 2 utilizamos \(\phi_1\) y \(\phi_2\) para deducir la ACF; ahora utilizamos una ACF muestral para estimar \(\phi_1\) y \(\phi_2\).
| Parametro | Verdadero | Yule–Walker manual | Yule–Walker (R) | Máxima verosimilitud |
|---|---|---|---|---|
| \(\phi_1\) | 1.50 | 1.477 | 1.477 | 1.511 |
| \(\phi_2\) | -0.75 | -0.721 | -0.721 | -0.755 |
La tabla no debe interpretarse esperando igualdad exacta con los parámetros verdaderos. Los estimadores son variables aleatorias: si repitiéramos la simulación obtendríamos valores distintos. Lo relevante es estudiar su distribución muestral, sesgo, variabilidad y comportamiento cuando \(T\) aumenta.
4.4.2 Comportamiento asintótico
Bajo condiciones de regularidad para un AR(\(p\)) causal, los estimadores de Yule–Walker son consistentes y asintóticamente normales. En notación compacta,
\[ \sqrt{T} \left( \widehat{\boldsymbol\phi}_{YW}-\boldsymbol\phi \right) \overset{d}{\longrightarrow} N_p\left( \boldsymbol 0, \sigma_\varepsilon^2\Gamma_p^{-1} \right). \tag{4.24}\]
Este resultado justifica, para muestras grandes, errores estándar e intervalos de confianza aproximados (Shumway y Stoffer 2025, Property 3.7). No obstante, la aproximación puede ser pobre en muestras pequeñas o cerca de la frontera de estacionariedad.
AdvertenciaUn intervalo componente a componente puede salir de la región estacionaria
Un intervalo aproximado de la forma \(\widehat\phi_j\pm1.96\,SE(\widehat\phi_j)\) trata cada coeficiente por separado. La estacionariedad de un AR(\(p\)), en cambio, es una restricción conjunta determinada por las raíces de \(\Phi(z)\). Por ello, los extremos de intervalos marginales no tienen por qué representar modelos estacionarios. Esta dificultad será especialmente relevante en la formulación bayesiana de la semana 5.
4.5 Verosimilitud exacta y condicional
La verosimilitud condicional es atractiva porque convierte un AR en un problema de regresión. Sin embargo, no utiliza el modelo probabilístico para las observaciones iniciales. Una verosimilitud exacta incorpora también esa información.
4.5.1 Derivación completa para un AR(1) estacionario
Considere
\[ Y_t-\mu = \phi(Y_{t-1}-\mu)+\varepsilon_t, \qquad |\phi|<1, \]
con \(\varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2)\). De Ecuación 2.19 sabemos que la distribución marginal estacionaria es
\[ Y_t \sim N\left( \mu, \frac{\sigma_\varepsilon^2}{1-\phi^2} \right). \tag{4.25}\]
En particular,
\[ p(y_1;\mu,\phi,\sigma_\varepsilon^2) = \frac{\sqrt{1-\phi^2}}{\sqrt{2\pi\sigma_\varepsilon^2}} \exp\left\{ -\frac{(1-\phi^2)(y_1-\mu)^2}{2\sigma_\varepsilon^2} \right\}. \tag{4.26}\]
Para \(t\geq2\),
\[ Y_t\mid Y_{t-1}=y_{t-1} \sim N\left( \mu+\phi(y_{t-1}-\mu), \sigma_\varepsilon^2 \right). \]
Por la regla de factorización secuencial,
\[ p(y_{1:T}) = p(y_1) \prod_{t=2}^{T}p(y_t\mid y_{t-1}), \]
y la verosimilitud exacta es
\[ L_E(\mu,\phi,\sigma_\varepsilon^2) = (2\pi\sigma_\varepsilon^2)^{-T/2} (1-\phi^2)^{1/2} \exp\left\{ -\frac{S_E(\mu,\phi)}{2\sigma_\varepsilon^2} \right\}, \tag{4.27}\]
con
\[ S_E(\mu,\phi) = (1-\phi^2)(y_1-\mu)^2 + \sum_{t=2}^{T} \left[ (y_t-\mu)-\phi(y_{t-1}-\mu) \right]^2. \tag{4.28}\]
La verosimilitud condicional en \(y_1\) elimina el primer factor:
\[ L_C(\mu,\phi,\sigma_\varepsilon^2\mid y_1) = (2\pi\sigma_\varepsilon^2)^{-(T-1)/2} \exp\left\{ -\frac{S_C(\mu,\phi)}{2\sigma_\varepsilon^2} \right\}, \tag{4.29}\]
con
\[ S_C(\mu,\phi) = \sum_{t=2}^{T} \left[ (y_t-\mu)-\phi(y_{t-1}-\mu) \right]^2. \tag{4.30}\]
Esta diferencia es pequeña cuando \(T\) es grande y el efecto de una sola observación inicial se diluye, pero puede ser visible en series cortas o muy persistentes (Shumway y Stoffer 2025, sec. 3.5.2).
set.seed(415)
T_ec <- 25
phi_ec <- 0.8
sigma_ec <- 1

x_ec <- as.numeric(stats::arima.sim(
  model = list(ar = phi_ec),
  n = T_ec,
  sd = sigma_ec
))

loglik_exacta_phi <- function(phi, y, sigma = 1) {
  if (abs(phi) >= 1) return(-Inf)

  stats::dnorm(
    y[1],
    mean = 0,
    sd = sigma / sqrt(1 - phi^2),
    log = TRUE
  ) +
    sum(stats::dnorm(
      y[-1],
      mean = phi * y[-length(y)],
      sd = sigma,
      log = TRUE
    ))
}

loglik_cond_phi <- function(phi, y, sigma = 1) {
  sum(stats::dnorm(
    y[-1],
    mean = phi * y[-length(y)],
    sd = sigma,
    log = TRUE
  ))
}

rejilla_phi <- seq(-0.95, 0.95, length.out = 401)

curvas_ec <- tibble(
  phi = rejilla_phi,
  Exacta = map_dbl(phi, loglik_exacta_phi, y = x_ec, sigma = sigma_ec),
  Condicional = map_dbl(phi, loglik_cond_phi, y = x_ec, sigma = sigma_ec)
) |>
  pivot_longer(
    cols = c(Exacta, Condicional),
    names_to = "Verosimilitud",
    values_to = "logLik"
  ) |>
  group_by(Verosimilitud) |>
  mutate(logLik_rel = logLik - max(logLik)) |>
  ungroup()

ggplot(curvas_ec, aes(x = phi, y = logLik_rel, linetype = Verosimilitud)) +
  geom_line(linewidth = 0.8) +
  geom_vline(xintercept = phi_ec, linetype = "dotted") +
  labs(
    x = expression(phi),
    y = "Log-verosimilitud relativa",
    title = "El tratamiento de la observación inicial modifica la verosimilitud",
    linetype = NULL
  )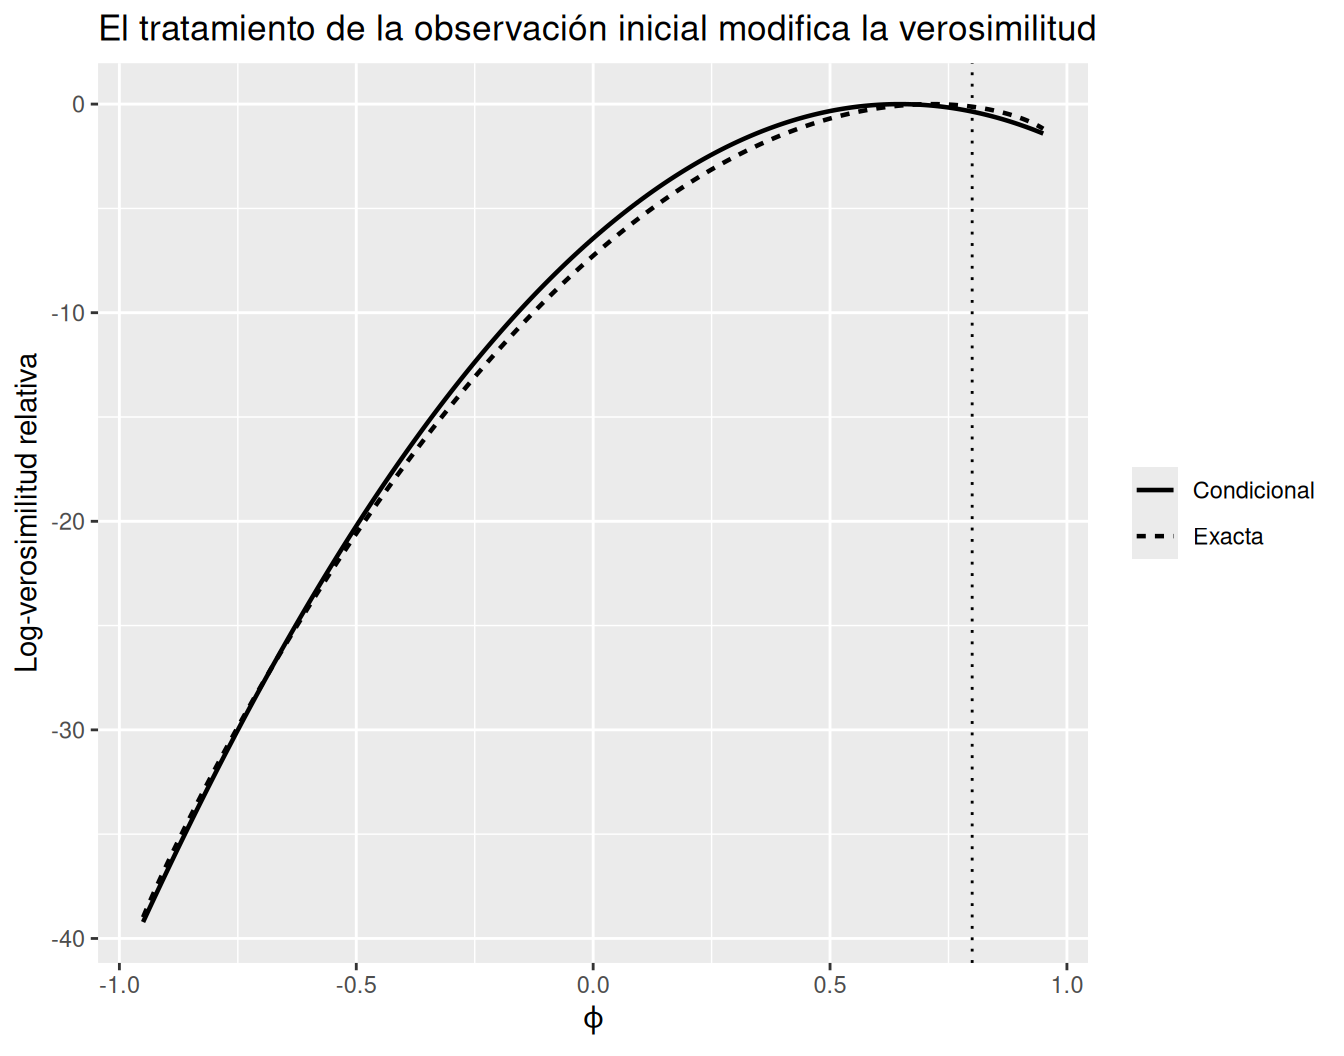
La línea vertical de Figura 4.1 marca el parámetro usado para generar la muestra. El máximo de una muestra particular no tiene por qué coincidir exactamente con ese valor. El punto de la figura es otro: exacta y condicional son funciones distintas porque tratan de manera diferente la información inicial.
4.5.2 ¿Qué significa “exacta” en un ARMA general?
Para un ARMA gaussiano causal e invertible podemos factorizar
\[ p(y_{1:T};\boldsymbol\vartheta) = \prod_{t=1}^{T} p(y_t\mid y_{1:t-1};\boldsymbol\vartheta). \tag{4.31}\]
Sea
\[ \nu_t = y_t-\widehat y_{t\mid t-1} \tag{4.32}\]
la innovación de predicción a un paso y sea
\[ P_t = \operatorname{Var}(Y_t-\widehat Y_{t\mid t-1}\mid Y_{1:t-1}) \tag{4.33}\]
su varianza bajo el modelo. Entonces
\[ \ell(\boldsymbol\vartheta) = -\frac12 \sum_{t=1}^{T} \left[ \log(2\pi) +\log P_t(\boldsymbol\vartheta) +\frac{\nu_t(\boldsymbol\vartheta)^2}{P_t(\boldsymbol\vartheta)} \right]. \tag{4.34}\]
Shumway y Stoffer presentan esta forma de innovaciones de la verosimilitud para ARMA y señalan que las medias y varianzas predictivas pueden calcularse recursivamente (Shumway y Stoffer 2025, sec. 3.5.2). Esta expresión reaparecerá en las semanas 11 y 12: el filtro de Kalman proporciona precisamente una manera general de calcular esas distribuciones predictivas en modelos de espacio-estado.
NotaNo derivaremos todavía el filtro de Kalman
La expresión Ecuación 4.34 muestra la lógica de la verosimilitud exacta, pero esta semana no desarrollaremos el algoritmo general de estado-espacio. Para los ejemplos computacionales utilizaremos implementaciones confiables de R. El objetivo ahora es entender qué se está optimizando y qué papel desempeñan las innovaciones.
4.6 Máxima verosimilitud
El estimador de máxima verosimilitud se define como
\[ \widehat{\boldsymbol\vartheta}_{ML} = \arg\max_{\boldsymbol\vartheta\in\Theta} L(\boldsymbol\vartheta;y_{1:T}), \]
o equivalentemente,
\[ \widehat{\boldsymbol\vartheta}_{ML} = \arg\max_{\boldsymbol\vartheta\in\Theta} \ell(\boldsymbol\vartheta;y_{1:T}). \tag{4.35}\]
En modelos ARMA, \(\Theta\) no es simplemente todo \(\mathbb R^{p+q}\) si pretendemos trabajar con una representación causal e invertible. Las restricciones de raíces estudiadas en la semana 3 determinan la región admisible.
4.6.1 Incertidumbre aproximada del MLE
Bajo condiciones de regularidad y cuando el verdadero parámetro se encuentra en el interior de la región admisible, el MLE suele satisfacer una aproximación asintótica de la forma
\[ \widehat{\boldsymbol\vartheta}_{ML} \approx N\left( \boldsymbol\vartheta_0, \mathcal I_T(\boldsymbol\vartheta_0)^{-1} \right), \tag{4.36}\]
con \(\mathcal I_T\) una matriz de información. En la práctica, la matriz de covarianzas se aproxima a partir de la curvatura de la log-verosimilitud cerca del máximo, por ejemplo mediante la inversa del Hessiano observado.
Para un componente \(\vartheta_j\), un intervalo de confianza aproximado de 95% es
\[ \widehat\vartheta_j \pm 1.96\,SE(\widehat\vartheta_j). \tag{4.37}\]
La interpretación es frecuentista: bajo repetición hipotética del procedimiento de muestreo, aproximadamente 95% de los intervalos construidos de esta manera contendrían al valor verdadero, cuando la aproximación asintótica es adecuada.
4.6.2 Optimización numérica
En un AR puro, la versión condicional se reduce a regresión. En un ARMA mixto, la función objetivo es no lineal y se utiliza una rutina iterativa. De manera esquemática, para minimizar una función \(Q(\boldsymbol\beta)\), Newton–Raphson utiliza
\[ \boldsymbol\beta^{(j+1)} = \boldsymbol\beta^{(j)} - \left[ \nabla^2Q(\boldsymbol\beta^{(j)}) \right]^{-1} \nabla Q(\boldsymbol\beta^{(j)}). \tag{4.38}\]
Gauss–Newton reemplaza la curvatura exacta por una aproximación construida a partir de la linealización local de los errores. Prado, Ferreira y West presentan explícitamente esta estrategia para minimizar sumas de cuadrados condicionales en ARMA (Prado et al. 2021, sec. 2.5.4.2), mientras que Shumway y Stoffer desarrollan Newton–Raphson, scoring y Gauss–Newton en su sección de estimación (Shumway y Stoffer 2025, secs. 3.5.2–3.5.3).
No necesitamos programar aquí el optimizador desde cero. Sí necesitamos comprender tres consecuencias prácticas:
- el algoritmo requiere valores iniciales;
- puede detenerse en soluciones numéricamente problemáticas o regiones casi planas;
- las restricciones de causalidad e invertibilidad deben respetarse durante o después de la optimización.
4.7 ¿Por qué un ARMA es más difícil de estimar?
Considere el modelo centrado
\[ X_t = \sum_{i=1}^{p}\phi_iX_{t-i} + \varepsilon_t + \sum_{j=1}^{q}\theta_j\varepsilon_{t-j}. \tag{4.39}\]
Si
\[ \boldsymbol\beta = (\phi_1,\ldots,\phi_p,\theta_1,\ldots,\theta_q)^\top, \]
podemos escribir recursivamente
\[ \varepsilon_t(\boldsymbol\beta) = x_t - \sum_{i=1}^{p}\phi_ix_{t-i} - \sum_{j=1}^{q}\theta_j\varepsilon_{t-j}(\boldsymbol\beta). \tag{4.40}\]
La suma de cuadrados condicional es
\[ S_c(\boldsymbol\beta) = \sum_{t=p+1}^{T} \varepsilon_t(\boldsymbol\beta)^2, \tag{4.41}\]
tras especificar valores iniciales para las innovaciones no observadas, por ejemplo \(\varepsilon_p=\varepsilon_{p-1}=\cdots=0\). Prado, Ferreira y West enfatizan dos puntos (Prado et al. 2021, sec. 2.5.4.2):
- cuando \(q=0\), Ecuación 4.41 vuelve a ser una regresión lineal;
- cuando \(q>0\), cada residual depende recursivamente de los parámetros y la minimización se vuelve no lineal.
4.7.1 Ejemplo: ARMA(1,1)
Para
\[ X_t = \phi X_{t-1} + \theta\varepsilon_{t-1} + \varepsilon_t, \]
la reconstrucción condicional es
\[ \widehat\varepsilon_t(\phi,\theta) = x_t - \phi x_{t-1} - \theta\widehat\varepsilon_{t-1}(\phi,\theta). \tag{4.42}\]
Si fijamos \(\widehat\varepsilon_1=0\),
\[ \widehat\varepsilon_2 = x_2-\phi x_1, \]
\[ \widehat\varepsilon_3 = x_3-\phi x_2-\theta\widehat\varepsilon_2, \]
y así sucesivamente. Cambiar \((\phi,\theta)\) modifica toda la secuencia de innovaciones reconstruidas. Por eso no existe una matriz de diseño fija como en una regresión lineal ordinaria.
ImportanteLa innovación reconstruida depende del modelo que estamos intentando estimar
En Sección 3.14 distinguimos la innovación verdadera \(\varepsilon_t\) del residual \(\widehat\varepsilon_t\). Aquí aparece la razón computacional: para un ARMA con \(q>0\), reconstruir \(\widehat\varepsilon_t\) exige conocer los parámetros, pero los parámetros se estiman precisamente usando esas reconstrucciones. La estimación resuelve este problema de manera iterativa.
4.7.2 Condiciones iniciales y tamaño de muestra
Cuando \(T\) es grande, condicionar en unos pocos valores iniciales suele tener poca influencia sobre la estimación final. En muestras cortas, la decisión puede importar. Esto explica la diferencia entre:
- mínimos cuadrados condicionales, que fijan o condicionan valores iniciales;
- aproximaciones de mínimos cuadrados no condicionales, que pueden utilizar backcasting para reconstruir innovaciones anteriores al inicio observado;
- máxima verosimilitud exacta, que incorpora el modelo probabilístico completo mediante distribuciones predictivas (Shumway y Stoffer 2025, secs. 3.5.2–3.5.3; Prado et al. 2021, sec. 2.5.4.2).
4.8 Comparación de métodos de estimación
| Metodo | Modelos | Idea | Ventaja | Limitacion |
|---|---|---|---|---|
| Yule–Walker | AR(\(p\)) | Igualar autocovarianzas teóricas y muestrales | Cálculo directo y conexión clara con la ACF | No se extiende de manera eficiente a ARMA generales |
| Mínimos cuadrados condicionales | AR y ARMA | Minimizar errores reconstruidos condicionando valores iniciales | Simple conceptualmente; para AR es regresión lineal | El tratamiento inicial puede importar y con \(q>0\) requiere optimización |
| Máxima verosimilitud condicional | AR y ARMA gaussianos | Maximizar una densidad condicionada en información inicial | Conecta directamente con inferencia basada en verosimilitud | Omite la contribución probabilística de los valores condicionados |
| Máxima verosimilitud exacta | ARMA gaussianos | Usar la distribución conjunta completa o su descomposición predictiva | Aprovecha toda la especificación probabilística | Requiere cálculo y optimización numérica más elaborados |
No existe una regla según la cual estimadores distintos deban coincidir en una muestra finita. Lo esperable es que, bajo condiciones apropiadas y conforme \(T\) aumenta, procedimientos consistentes se concentren alrededor del mismo parámetro verdadero.
4.8.1 Simulación Monte Carlo: variabilidad de los estimadores
La siguiente actividad repite el experimento de estimación muchas veces. El objetivo es observar una propiedad que no puede verse en una sola serie: la distribución muestral del estimador.
set.seed(415)

B_mc <- 200
T_mc <- 100
phi_mc <- c(1.5, -0.75)

estimar_ar2_mc <- function(b) {
  x <- as.numeric(stats::arima.sim(
    model = list(ar = phi_mc),
    n = T_mc,
    sd = 1
  ))

  fit_yw <- stats::ar.yw(
    x,
    aic = FALSE,
    order.max = 2,
    demean = TRUE
  )

  fit_ml <- tryCatch(
    stats::arima(
      x,
      order = c(2, 0, 0),
      include.mean = FALSE,
      method = "ML"
    ),
    error = function(e) NULL
  )

  if (is.null(fit_ml)) {
    return(tibble())
  }

  bind_rows(
    tibble(
      Replicacion = b,
      Metodo = "Yule--Walker",
      Parametro = c("phi1", "phi2"),
      Estimacion = unname(fit_yw$ar)
    ),
    tibble(
      Replicacion = b,
      Metodo = "Máxima verosimilitud",
      Parametro = c("phi1", "phi2"),
      Estimacion = unname(fit_ml$coef[c("ar1", "ar2")])
    )
  )
}

resultados_mc <- map_dfr(seq_len(B_mc), estimar_ar2_mc) |>
  mutate(
    Verdadero = if_else(Parametro == "phi1", phi_mc[1], phi_mc[2]),
    Error = Estimacion - Verdadero
  )

resumen_mc <- resultados_mc |>
  group_by(Metodo, Parametro) |>
  summarise(
    Sesgo = mean(Error),
    DE = sd(Estimacion),
    RMSE = sqrt(mean(Error^2)),
    .groups = "drop"
)| Metodo | Parametro | Sesgo | DE | RMSE |
|---|---|---|---|---|
| Máxima verosimilitud | phi1 | -0.007 | 0.088 | 0.088 |
| Máxima verosimilitud | phi2 | 0.002 | 0.085 | 0.085 |
| Yule–Walker | phi1 | -0.083 | 0.092 | 0.124 |
| Yule–Walker | phi2 | 0.065 | 0.084 | 0.106 |
verdaderos_mc <- tibble(
  Parametro = c("phi1", "phi2"),
  Verdadero = phi_mc
)

ggplot(resultados_mc, aes(x = Estimacion)) +
  geom_histogram(bins = 25) +
  geom_vline(
    data = verdaderos_mc,
    aes(xintercept = Verdadero),
    linetype = "dashed"
  ) +
  facet_grid(Parametro ~ Metodo, scales = "free_x") +
  labs(
    x = "Estimación",
    y = "Frecuencia",
    title = "Los estimadores son variables aleatorias"
  )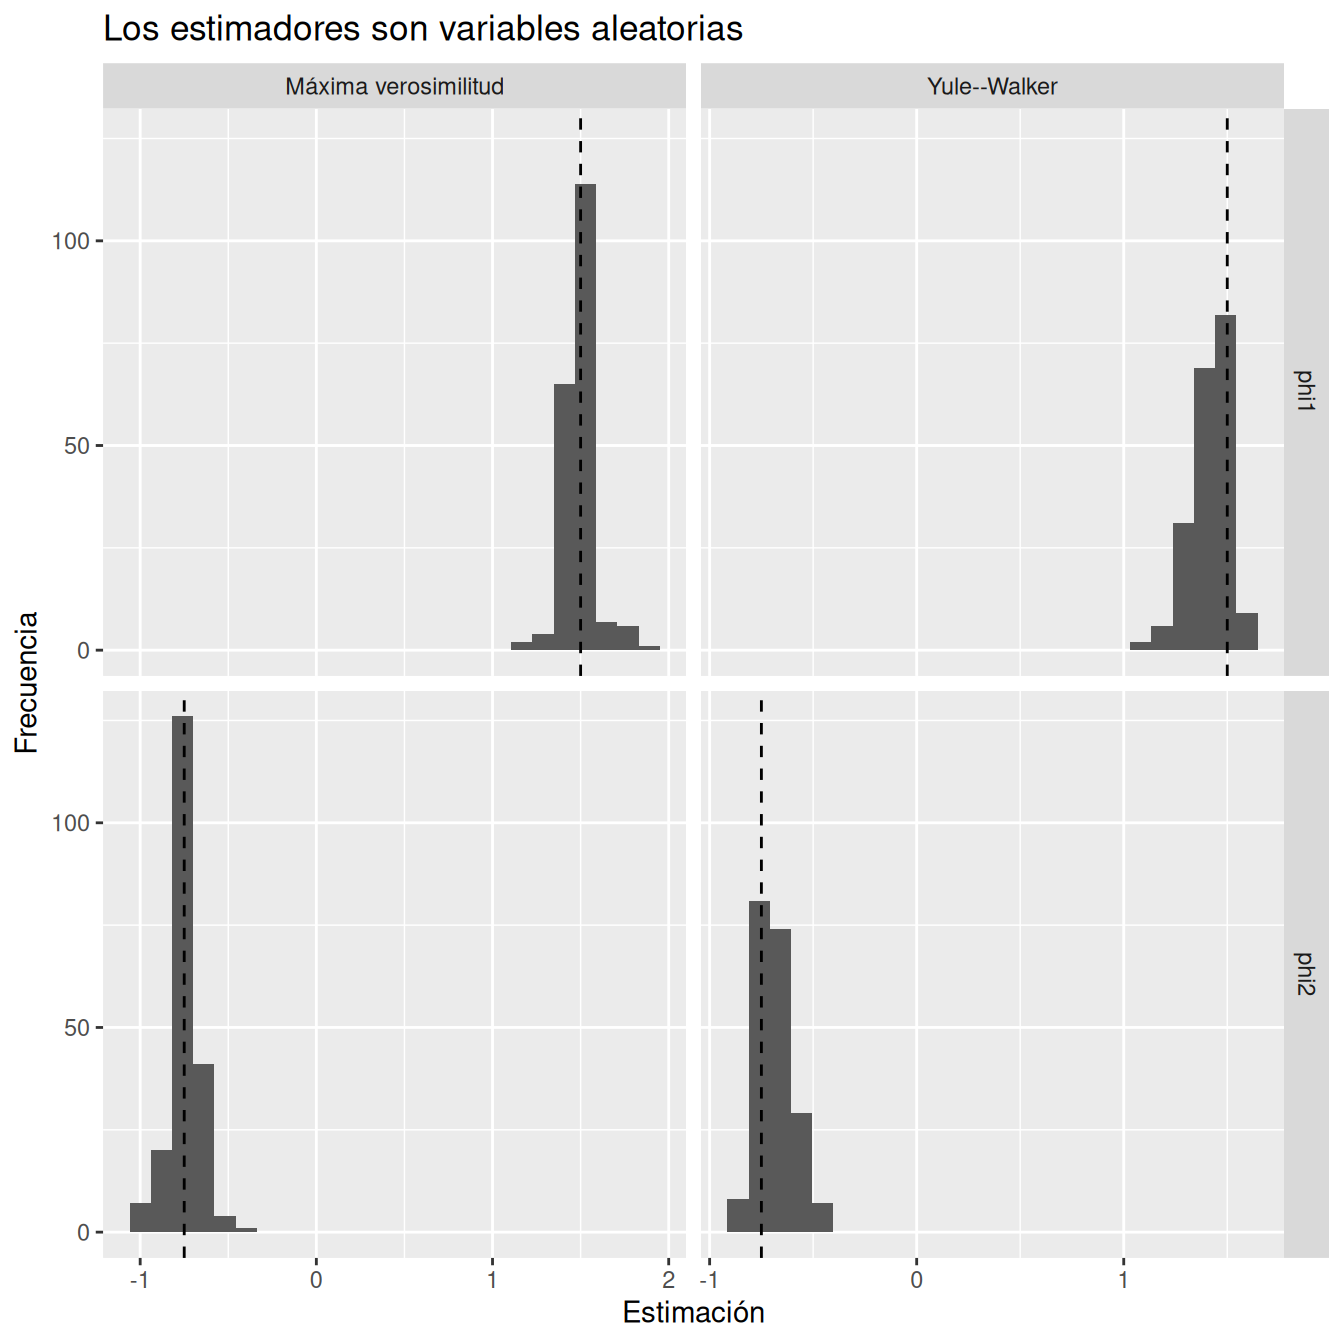
La Figura 4.2 ayuda a interpretar errores estándar: estos intentan resumir la dispersión que observaríamos si repitiéramos el muestreo y la estimación muchas veces bajo el mismo mecanismo generador.
4.9 Selección de modelos mediante criterios de información
La ACF y PACF ayudan a proponer órdenes candidatos, pero rara vez producen una identificación inequívoca en una muestra finita. Una estrategia frecuente consiste en ajustar varios modelos plausibles y comparar el compromiso entre ajuste y complejidad.
Sea
\[ \widehat\ell = \ell(\widehat{\boldsymbol\vartheta}) \]
la log-verosimilitud maximizada y sea \(k\) el número total de parámetros estimados que entran en el cálculo del criterio, incluida la varianza de innovación cuando corresponda.
4.9.1 AIC
El criterio de información de Akaike es
\[ \operatorname{AIC} = -2\widehat\ell+2k. \tag{4.43}\]
El primer término premia un mejor ajuste; el segundo penaliza el número de parámetros. Entre modelos comparables, se prefiere un AIC menor.
4.9.2 AICc
Para muestras finitas se utiliza con frecuencia la corrección
\[ \operatorname{AICc} = \operatorname{AIC} + \frac{2k(k+1)}{T-k-1}, \tag{4.44}\]
si \(T>k+1\). La penalización adicional desaparece conforme \(T\) crece. Hyndman y Athanasopoulos recomiendan AICc en la selección práctica de modelos ARIMA, especialmente cuando el tamaño muestral no es muy grande (Hyndman y Athanasopoulos 2021, sec. 9.6).
4.9.3 BIC
El criterio bayesiano de información es
\[ \operatorname{BIC} = -2\widehat\ell+k\log T. \tag{4.45}\]
A medida que \(T\) crece, BIC penaliza parámetros adicionales más fuertemente que AIC. Aunque su nombre contiene la palabra “bayesiano”, BIC no es una distribución posterior ni convierte el análisis de esta semana en inferencia bayesiana.
| Criterio | Expresion | Rasgo |
|---|---|---|
| AIC | \(-2\widehat\ell+2k\) | Compromiso entre ajuste y complejidad con penalización lineal en \(k\) |
| AICc | \(AIC+2k(k+1)/(T-k-1)\) | Corrige AIC cuando la muestra no es grande respecto del número de parámetros |
| BIC | \(-2\widehat\ell+k\log T\) | Penalización que crece con \(T\) y suele favorecer modelos más parsimoniosos |
4.9.4 ¿Qué significa que dos valores sean comparables?
Para interpretar diferencias de AIC, AICc o BIC, los modelos deben referirse al mismo conjunto de observaciones y utilizar verosimilitudes comparables. En particular:
- no conviene comparar un AIC basado en verosimilitud exacta con otro construido desde una función condicional que eliminó una cantidad distinta de observaciones;
- no deben compararse directamente criterios obtenidos después de transformar la respuesta de maneras incompatibles sin considerar el efecto de la transformación sobre la verosimilitud;
- esta semana, como todos los candidatos son estacionarios y se ajustarán sobre la misma serie mediante máxima verosimilitud, la comparación es directa.
ImportanteAICc no es evaluación fuera de muestra
AICc utiliza los mismos datos con los que se ajusta el modelo. Está diseñado para corregir el optimismo asociado a ajustar más parámetros y tiene una motivación predictiva, pero no sustituye una evaluación temporal fuera de muestra. En la semana 7 compararemos modelos bajo las mismas ventanas de entrenamiento, los mismos horizontes y métricas como MAE, RMSE y MASE.
4.9.5 ¿Debemos escoger automáticamente el mínimo?
No. El criterio de información es una pieza del análisis. Un modelo con AICc ligeramente menor puede presentar residuales claramente autocorrelacionados; en ese caso, la especificación probabilística sigue siendo inadecuada. También puede ocurrir que varios modelos tengan criterios muy cercanos. La modelación razonada combina:
- plausibilidad estructural;
- ACF y PACF;
- estimación estable y restricciones de raíces;
- criterios de información;
- diagnóstico residual;
- posteriormente, evaluación predictiva fuera de muestra.
4.10 De la innovación al residual
En el modelo verdadero,
\[ \varepsilon_t = Y_t-E(Y_t\mid\mathcal F_{t-1}), \tag{4.46}\]
es una innovación no observable porque depende de parámetros desconocidos y del verdadero mecanismo generador. Después de ajustar un modelo, obtenemos una predicción a un paso
\[ \widehat y_{t\mid t-1} \]
y definimos el residual de innovación
\[ \widehat\varepsilon_t = y_t-\widehat y_{t\mid t-1}. \tag{4.47}\]
La distinción respecto de Ecuación 4.46 es importante: \(\widehat\varepsilon_t\) incorpora error de estimación paramétrica, decisiones de inicialización y cualquier error de especificación del modelo.
4.10.1 Residuales estandarizados
Si
\[ \widehat P_t = \widehat{\operatorname{Var}} (Y_t-\widehat Y_{t\mid t-1}\mid Y_{1:t-1}), \]
el residual estandarizado es
\[ r_t = \frac{\widehat\varepsilon_t}{\sqrt{\widehat P_t}}. \tag{4.48}\]
Bajo un modelo gaussiano bien especificado, esperamos que los \(r_t\) se comporten aproximadamente como una secuencia con media cero, varianza uno y sin dependencia temporal sistemática (Shumway y Stoffer 2025, sec. 3.7).
En muchos ajustes ARMA estacionarios, después del período inicial, \(\widehat P_t\) se aproxima a \(\widehat\sigma_\varepsilon^2\). Por ello, una estandarización práctica es
\[ r_t \approx \frac{\widehat\varepsilon_t}{\widehat\sigma_\varepsilon}. \]
4.11 Diagnóstico residual
Un diagnóstico no intenta demostrar que el modelo sea verdadero. Su propósito es buscar evidencia de aspectos de la serie que el modelo todavía no explica.
Un modelo ARMA adecuadamente especificado debería dejar residuales que, al menos en su dependencia lineal, se parezcan al ruido blanco postulado para \(\varepsilon_t\). Por ello, revisaremos cuatro dimensiones.
4.11.1 Trayectoria de los residuales
El primer gráfico debe ser \(\widehat\varepsilon_t\) o \(r_t\) contra el tiempo. Buscamos:
- media aproximadamente cero;
- ausencia de patrones de nivel o tendencia;
- ausencia de agrupamientos muy evidentes de variabilidad;
- observaciones extraordinarias que puedan dominar el ajuste;
- cambios estructurales que cuestionen la hipótesis de parámetros constantes.
Un patrón persistente en este gráfico sugiere que la dependencia temporal no ha sido completamente modelada o que la serie requiere una transformación o una estructura adicional.
4.11.2 ACF residual
Calculemos
\[ \widehat\rho_{\widehat\varepsilon}(h), \qquad h=1,2,\ldots \]
sobre los residuales. Una autocorrelación residual grande indica que queda dependencia lineal predecible después del ajuste. Esa es una señal directa de especificación insuficiente.
Las bandas usuales \(\pm1.96/\sqrt T\) son solo una guía visual. Los residuales de un modelo estimado no son observaciones de ruido blanco puro: comparten incertidumbre porque se utilizaron los mismos datos para estimar parámetros (Shumway y Stoffer 2025, sec. 3.7).
4.11.3 Normalidad
Si la estimación y los intervalos predictivos se justifican bajo innovaciones gaussianas, examinaremos un histograma y, especialmente, un gráfico Q–Q de los residuales estandarizados.
NotaNormalidad y ausencia de autocorrelación responden preguntas diferentes
Para que el pronóstico medio aproveche la información lineal disponible, es esencial que no quede autocorrelación sistemática en los residuales. La normalidad, en cambio, determina qué tan apropiada es la distribución gaussiana utilizada para la verosimilitud, errores estándar e intervalos. Un modelo puede producir buenos pronósticos puntuales y, a la vez, subestimar riesgo de cola si la distribución residual no es gaussiana (Hyndman y Athanasopoulos 2021, sec. 5.4).
4.11.4 Heterocedasticidad y residuales al cuadrado
Una serie puede tener residuales linealmente no-correlacionados y aun así mostrar dependencia en su magnitud. Una exploración sencilla consiste en estudiar
\[ \widehat\varepsilon_t^2 \]
y su ACF. Si los residuales grandes tienden a agruparse, la ACF de \(\widehat\varepsilon_t^2\) puede mostrar estructura aunque la ACF de \(\widehat\varepsilon_t\) sea pequeña.
Esto no constituye por sí solo una prueba formal de heterocedasticidad condicional. Su función esta semana es diagnóstica. En la semana 10 desarrollaremos modelos ARCH y GARCH precisamente para representar esa dependencia en la varianza.
4.12 Prueba de Ljung–Box
Inspeccionar muchas barras de una ACF residual por separado puede ocultar una acumulación de autocorrelaciones pequeñas. Una prueba portmanteau contrasta conjuntamente varios rezagos.
Para un máximo \(H\), consideremos
\[ H_0: \rho_\varepsilon(1) = \rho_\varepsilon(2) = \cdots = \rho_\varepsilon(H) =0. \tag{4.49}\]
El estadístico de Ljung–Box es
\[ Q^* = T(T+2) \sum_{h=1}^{H} \frac{\widehat\rho_{\widehat\varepsilon}(h)^2}{T-h}. \tag{4.50}\]
Bajo la hipótesis nula y de manera asintótica, cuando los residuales provienen de un ARMA(\(p,q\)) estimado,
\[ Q^* \overset{a}{\sim} \chi^2_{H-p-q}, \tag{4.51}\]
como aproximación clásica (Shumway y Stoffer 2025, sec. 3.7).
4.12.1 Interpretación
- Un \(p\)-valor pequeño aporta evidencia de autocorrelación residual conjunta y, por tanto, contra la adecuación del modelo en los rezagos examinados.
- Un \(p\)-valor grande significa que no encontramos evidencia suficiente para rechazar ausencia de autocorrelación hasta \(H\); no prueba que el modelo sea correcto.
- El resultado depende de \(H\). Conviene examinar tanto la ACF como pruebas para varios horizontes razonables.
AdvertenciaNo use Ljung–Box como un semáforo automático
Un modelo no se valida porque \(p>0.05\), ni se vuelve inútil porque una sola elección de \(H\) produzca \(p<0.05\). El diagnóstico combina magnitud y localización de las autocorrelaciones, estabilidad de la varianza, forma distributiva, contexto del problema y comparación con modelos alternativos.
4.13 El ciclo identificación–estimación–diagnóstico
Shumway y Stoffer organizan la construcción de modelos ARIMA como una secuencia que incluye visualización, transformación, identificación de órdenes, estimación, diagnóstico y elección (Shumway y Stoffer 2025, sec. 3.7). Para los modelos estacionarios estudiados hasta esta semana, podemos resumir el flujo como
\[ \boxed{ \text{explorar} \longrightarrow \text{identificar candidatos} \longrightarrow \text{estimar} \longrightarrow \text{comparar} \longrightarrow \text{diagnosticar} \longrightarrow \text{reformular si es necesario} }. \tag{4.52}\]
Este proceso es iterativo. Por ejemplo:
- una PACF sugiere AR(2);
- ajustamos AR(1), AR(2), AR(3) y algunos ARMA plausibles;
- AICc favorece AR(2);
- la ACF residual muestra estructura sistemática en rezagos altos;
- entonces el AR(2) sigue siendo insuficiente y debemos reformular.
La modelación no termina cuando una función de R devuelve coeficientes.
4.14 Aplicación: Recruitment
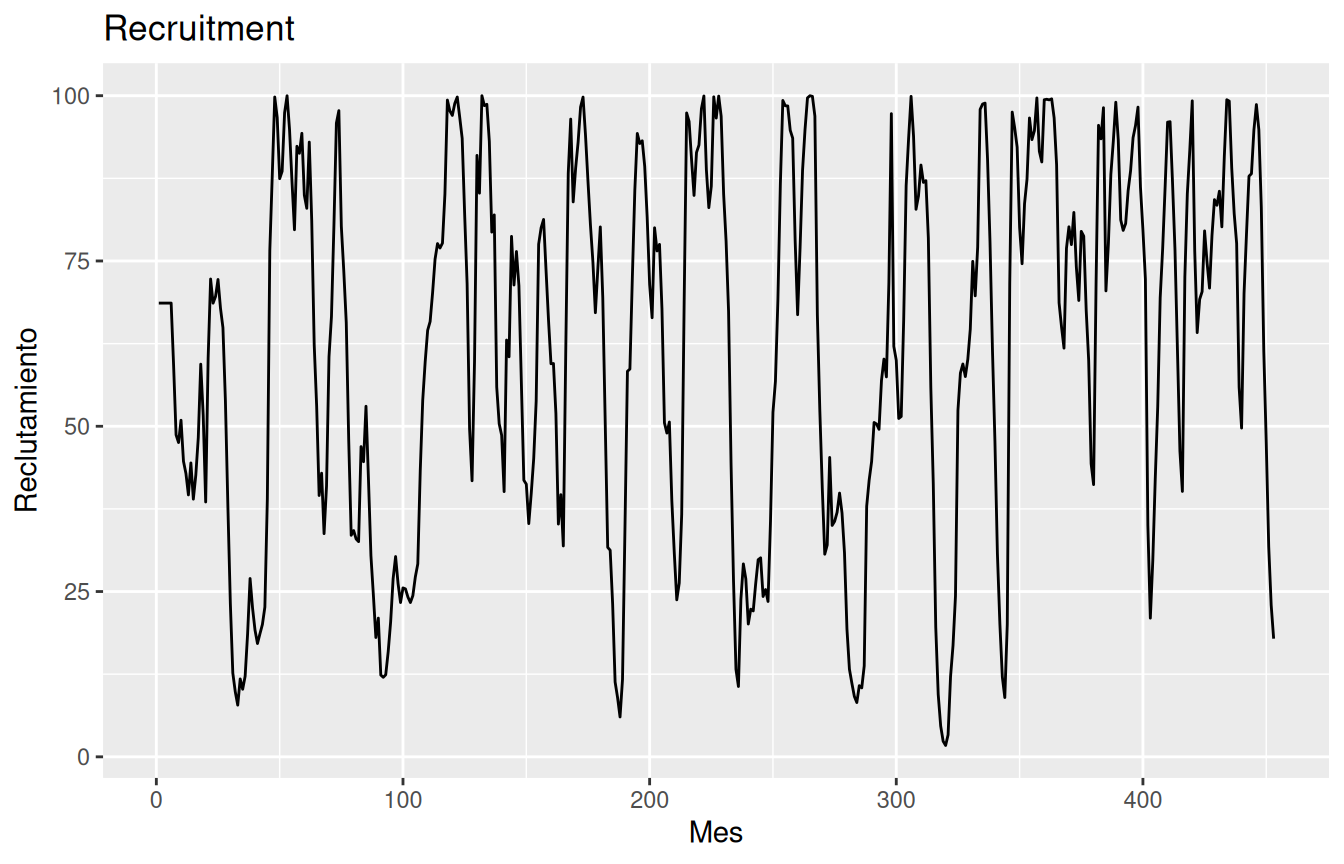
Retomaremos la serie mensual Recruitment, utilizada en Sección 2.12 y Sección 3.15. Esta continuidad es deliberada: primero estudiamos su dependencia, luego comparamos firmas AR/MA/ARMA, y ahora preguntamos si esas hipótesis sobreviven a la estimación y al diagnóstico.
Shumway y Stoffer utilizan esta serie para ilustrar un AR(2) y reportan estimaciones muy similares mediante Yule–Walker y máxima verosimilitud (Shumway y Stoffer 2025, Examples 3.27 y 3.30). En lugar de aceptar ese orden de antemano, aquí lo trataremos como uno de varios candidatos.
4.14.1 Preparación de los datos
if (!requireNamespace("astsa", quietly = TRUE)) {
  stop(
    "El ejemplo de Recruitment requiere el paquete 'astsa'. ",
    "Instálelo antes de compilar este capítulo."
  )
}

rec_env_est <- new.env()
data("rec", package = "astsa", envir = rec_env_est)
rec_obj_est <- rec_env_est$rec

rec_est <- tibble(
  t = seq_along(rec_obj_est),
  Reclutamiento = as.numeric(rec_obj_est)
) |>
  as_tsibble(index = t)

stopifnot(
  nrow(rec_est) > 100,
  !anyNA(rec_est$Reclutamiento),
  all(is.finite(rec_est$Reclutamiento))
)ggplot(rec_est, aes(x = t, y = Reclutamiento)) +
geom_line() +
labs(
x = "Mes",
y = "Reclutamiento",
title = "Recruitment"
)
4.14.2 Yule–Walker, mínimos cuadrados condicionales y máxima verosimilitud
Ajustaremos primero el AR(2) sugerido por la PACF de semanas anteriores. Para separar los métodos:
ar.yw()utiliza Yule–Walker;arima(..., method = "CSS")utiliza suma de cuadrados condicional;arima(..., method = "ML")utiliza máxima verosimilitud con el cálculo de innovaciones implementado enstats.
x_rec <- rec_est$Reclutamiento

rec_yw <- stats::ar.yw(
  x_rec,
  aic = FALSE,
  order.max = 2,
  demean = TRUE
)

rec_css <- stats::arima(
  x_rec,
  order = c(2, 0, 0),
  include.mean = TRUE,
  method = "CSS"
)

rec_ml <- stats::arima(
  x_rec,
  order = c(2, 0, 0),
  include.mean = TRUE,
  method = "ML"
)

extraer_coef <- function(fit, nombre) {
  cf <- fit$coef
  tibble(
    Metodo = nombre,
    Media = if ("intercept" %in% names(cf)) unname(cf["intercept"]) else NA_real_,
    phi1 = unname(cf["ar1"]),
    phi2 = unname(cf["ar2"]),
    sigma2 = fit$sigma2
  )
}

comparacion_rec_metodos <- bind_rows(
  tibble(
    Metodo = "Yule--Walker",
    Media = unname(rec_yw$x.mean),
    phi1 = unname(rec_yw$ar[1]),
    phi2 = unname(rec_yw$ar[2]),
    sigma2 = unname(rec_yw$var.pred)
  ),
  extraer_coef(rec_css, "CSS"),
  extraer_coef(rec_ml, "ML")
)| Método | Media | \(\widehat\phi_1\) | \(\widehat\phi_2\) | \(\widehat\sigma_\varepsilon^2\) |
|---|---|---|---|---|
| Yule–Walker | 62.263 | 1.332 | -0.445 | 94.799 |
| CSS | 61.745 | 1.354 | -0.463 | 89.717 |
| ML | 61.895 | 1.351 | -0.461 | 89.334 |
Las tres columnas de parámetros deberían ser cercanas, pero no idénticas. Esa cercanía tiene una explicación teórica para AR puros: los métodos utilizan casi la misma estructura de dependencia, pero difieren en el tratamiento de valores iniciales y en la función objetivo exacta.
4.14.3 Errores estándar del ajuste ML
| Parametro | Estimacion | Error estándar | Inferior | Superior |
|---|---|---|---|---|
| ar1 | 1.351 | 0.042 | 1.270 | 1.433 |
| ar2 | -0.461 | 0.042 | -0.543 | -0.380 |
| intercept | 61.895 | 4.003 | 54.048 | 69.741 |
Estos intervalos son aproximaciones de Wald. Para los coeficientes AR, su lectura debe acompañarse de una verificación conjunta de las raíces: la estacionariedad no se decide examinando \(\phi_1\) y \(\phi_2\) de manera independiente.
4.14.4 Modelos candidatos
Usaremos el conjunto
\[ \operatorname{AR}(1),\quad \operatorname{AR}(2),\quad \operatorname{AR}(3),\quad \operatorname{MA}(2),\quad \operatorname{ARMA}(1,1). \]
El objetivo no es afirmar que estos cinco modelos agotan todas las posibilidades, sino ilustrar una comparación coherente de candidatos sugeridos por la ACF/PACF y por parsimonia.
especificaciones_rec <- tribble(
  ~Modelo, ~p, ~q,
  "AR(1)", 1L, 0L,
  "AR(2)", 2L, 0L,
  "AR(3)", 3L, 0L,
  "MA(2)", 0L, 2L,
  "ARMA(1,1)", 1L, 1L
)

ajustes_rec <- especificaciones_rec |>
  mutate(
    Ajuste = map2(
      p, q,
      ~ stats::arima(
        x_rec,
        order = c(.x, 0, .y),
        include.mean = TRUE,
        method = "ML"
      )
    )
  )

calcular_criterios <- function(fit, T) {
  ll <- logLik(fit)
  k <- attr(ll, "df")
  aic <- -2 * as.numeric(ll) + 2 * k
  aicc <- if (T > k + 1) {
    aic + 2 * k * (k + 1) / (T - k - 1)
  } else {
    NA_real_
  }
  bic <- -2 * as.numeric(ll) + k * log(T)

  tibble(
    logLik = as.numeric(ll),
    k = k,
    AIC = aic,
    AICc = aicc,
    BIC = bic,
    sigma2 = fit$sigma2
  )
}

criterios_rec <- ajustes_rec |>
  mutate(
    Metricas = map(Ajuste, calcular_criterios, T = length(x_rec))
  ) |>
  select(Modelo, p, q, Metricas) |>
  unnest(Metricas) |>
arrange(AICc)| Modelo | \(p\) | \(q\) | logLik | \(k\) | AIC | AICc | BIC | \(\widehat\sigma_\varepsilon^2\) |
|---|---|---|---|---|---|---|---|---|
| AR(2) | 2 | 0 | -1661.51 | 4 | 3331.02 | 3331.11 | 3347.48 | 89.33 |
| AR(3) | 3 | 0 | -1661.11 | 5 | 3332.22 | 3332.35 | 3352.79 | 89.17 |
| ARMA(1,1) | 1 | 1 | -1672.55 | 4 | 3353.10 | 3353.19 | 3369.56 | 93.82 |
| AR(1) | 1 | 0 | -1715.64 | 3 | 3437.27 | 3437.33 | 3449.62 | 113.57 |
| MA(2) | 0 | 2 | -1795.86 | 4 | 3599.71 | 3599.80 | 3616.18 | 161.90 |
criterios_rec |>
  select(Modelo, AICc, BIC) |>
  pivot_longer(
    cols = c(AICc, BIC),
    names_to = "Criterio",
    values_to = "Valor"
  ) |>
  ggplot(aes(x = reorder(Modelo, Valor), y = Valor)) +
  geom_point(size = 2.5) +
  facet_wrap(~Criterio, scales = "free_y") +
  coord_flip() +
  labs(
    x = NULL,
    y = "Valor del criterio",
    title = "Ajuste frente a complejidad"
  )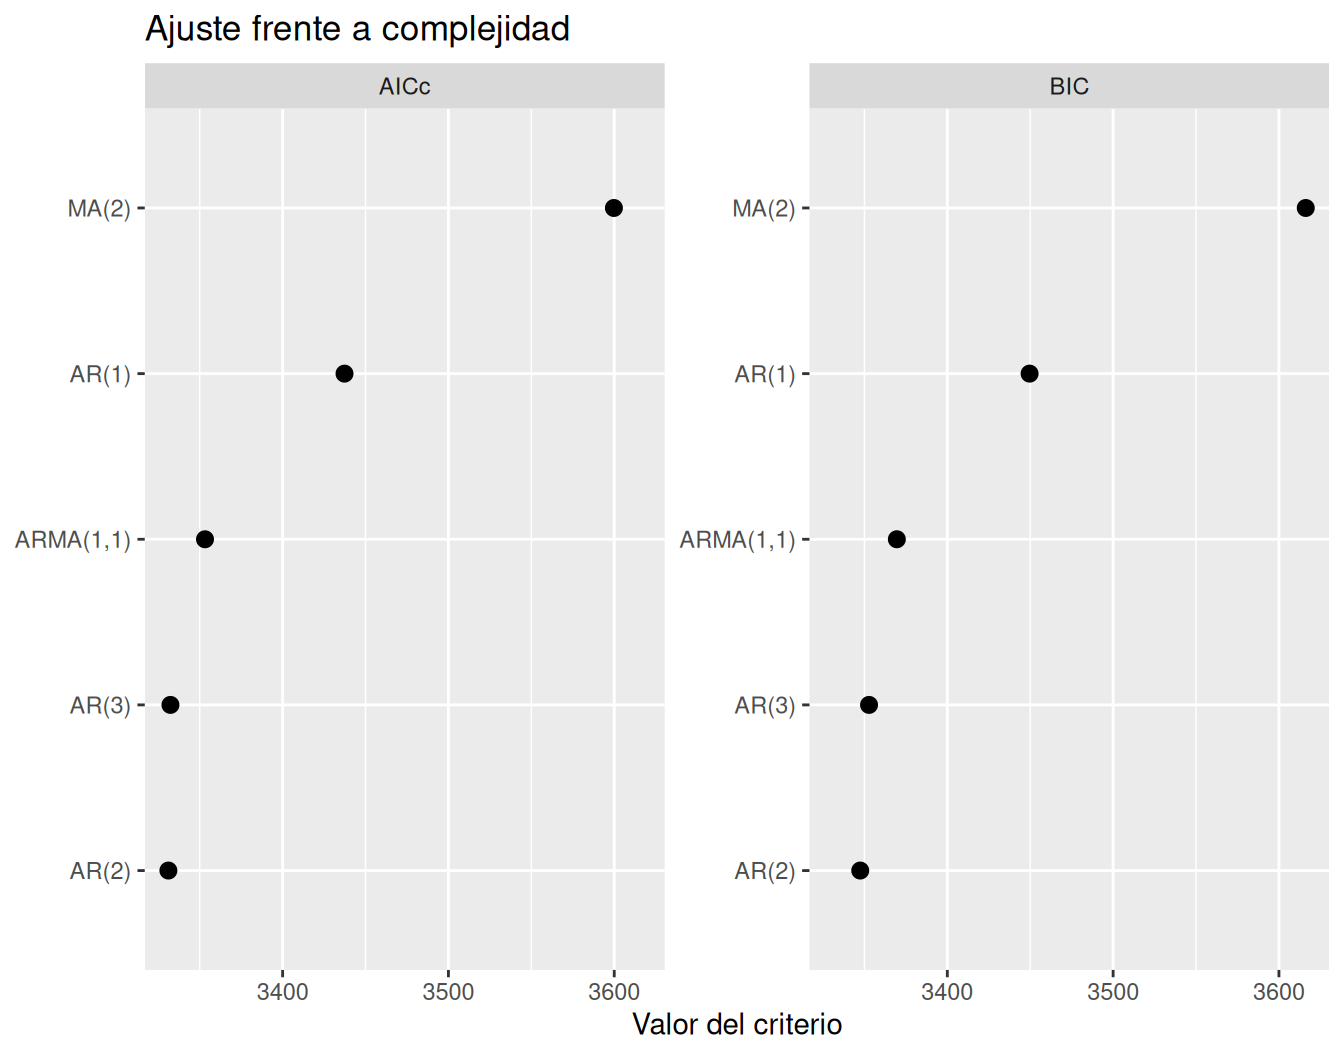
La Tabla 4.7 y la Figura 4.4 deben leerse conjuntamente. Si AICc y BIC favorecen modelos distintos, no hay contradicción: utilizan penalizaciones distintas. Además, una diferencia pequeña entre criterios no debe exagerarse como si revelara un único modelo verdadero.
4.14.5 Verificación de causalidad e invertibilidad de los ajustes
Un optimizador puede devolver coeficientes numéricos, pero seguimos interesados en la estructura de raíces estudiada en la semana 3.
| Modelo | Mín. |raíz AR| | Mín. |raíz MA| | Causal | Invertible |
|---|---|---|---|---|
| AR(1) | 1.081 | NA | Sí | No aplica |
| AR(2) | 1.472 | NA | Sí | No aplica |
| AR(3) | 1.388 | NA | Sí | No aplica |
| MA(2) | NA | 1.281 | No aplica | Sí |
| ARMA(1,1) | 1.138 | 2.389 | Sí | Sí |
Las restricciones estructurales no desaparecen al estimar. Si una solución estuviera en la frontera o fuera de la región causal/invertible, la interpretación, los errores estándar y el comportamiento predictivo requerirían especial cuidado.
4.14.6 Diagnóstico de todos los candidatos con Ljung–Box
Usaremos \(H=20\), una elección común en ejemplos clásicos y razonable para una serie de esta longitud. La elección de \(H\) no es universal y debe adaptarse a la frecuencia y al tamaño muestral.
H_rec <- 20L

lb_rec <- ajustes_rec |>
  mutate(
    Diagnostico = pmap(
      list(Ajuste, p, q),
      function(Ajuste, p, q) {
        e <- residuals(Ajuste) |>
          as.numeric()
        e <- e[is.finite(e)]

        prueba <- stats::Box.test(
          e,
          lag = H_rec,
          type = "Ljung-Box",
          fitdf = p + q
        )

        tibble(
          Q = unname(prueba$statistic),
          gl = unname(prueba$parameter),
          `p-valor` = prueba$p.value
        )
      }
    )
  ) |>
  select(Modelo, Diagnostico) |>
  unnest(Diagnostico)

comparacion_diag_rec <- criterios_rec |>
  select(Modelo, AICc, BIC) |>
  left_join(lb_rec, by = "Modelo") |>
arrange(AICc)| Modelo | AICc | BIC | Q | gl | p-valor |
|---|---|---|---|---|---|
| AR(2) | 3331.109 | 3347.483 | 34.603 | 18 | 0.011 |
| AR(3) | 3332.349 | 3352.795 | 34.273 | 17 | 0.008 |
| ARMA(1,1) | 3353.186 | 3369.561 | 73.605 | 18 | 0.000 |
| AR(1) | 3437.327 | 3449.621 | 237.197 | 19 | 0.000 |
| MA(2) | 3599.802 | 3616.176 | 426.169 | 18 | 0.000 |
Esta tabla ilustra una regla fundamental: selección y diagnóstico responden preguntas distintas. AICc/BIC comparan ajuste penalizado entre candidatos; Ljung–Box pregunta si queda autocorrelación residual conjunta hasta un conjunto de rezagos.
4.14.7 Diagnóstico detallado del candidato con menor AICc
Para evitar decidir manualmente antes de ejecutar el capítulo, el siguiente código identifica el candidato con menor AICc y construye sus diagnósticos.
mejor_nombre_rec <- criterios_rec |>
  slice_min(AICc, n = 1, with_ties = FALSE) |>
  pull(Modelo)

fila_mejor_rec <- ajustes_rec |>
  filter(Modelo == mejor_nombre_rec)

mejor_rec <- fila_mejor_rec$Ajuste[[1]]
p_mejor_rec <- fila_mejor_rec$p[[1]]
q_mejor_rec <- fila_mejor_rec$q[[1]]

resid_mejor_rec <- residuals(mejor_rec) |>
  as.numeric()

resid_mejor_rec[!is.finite(resid_mejor_rec)] <- NA_real_

sigma_mejor_rec <- sqrt(mejor_rec$sigma2)

resid_rec_tbl <- tibble(
  t = seq_along(resid_mejor_rec),
  Residual = resid_mejor_rec,
  Estandarizado = resid_mejor_rec / sigma_mejor_rec
) |>
filter(is.finite(Estandarizado))ggplot(resid_rec_tbl, aes(x = t, y = Estandarizado)) +
geom_hline(yintercept = 0, linewidth = 0.3) +
geom_line() +
labs(
x = "Mes",
y = "Residual estandarizado",
title = paste("Diagnóstico temporal:", mejor_nombre_rec)
)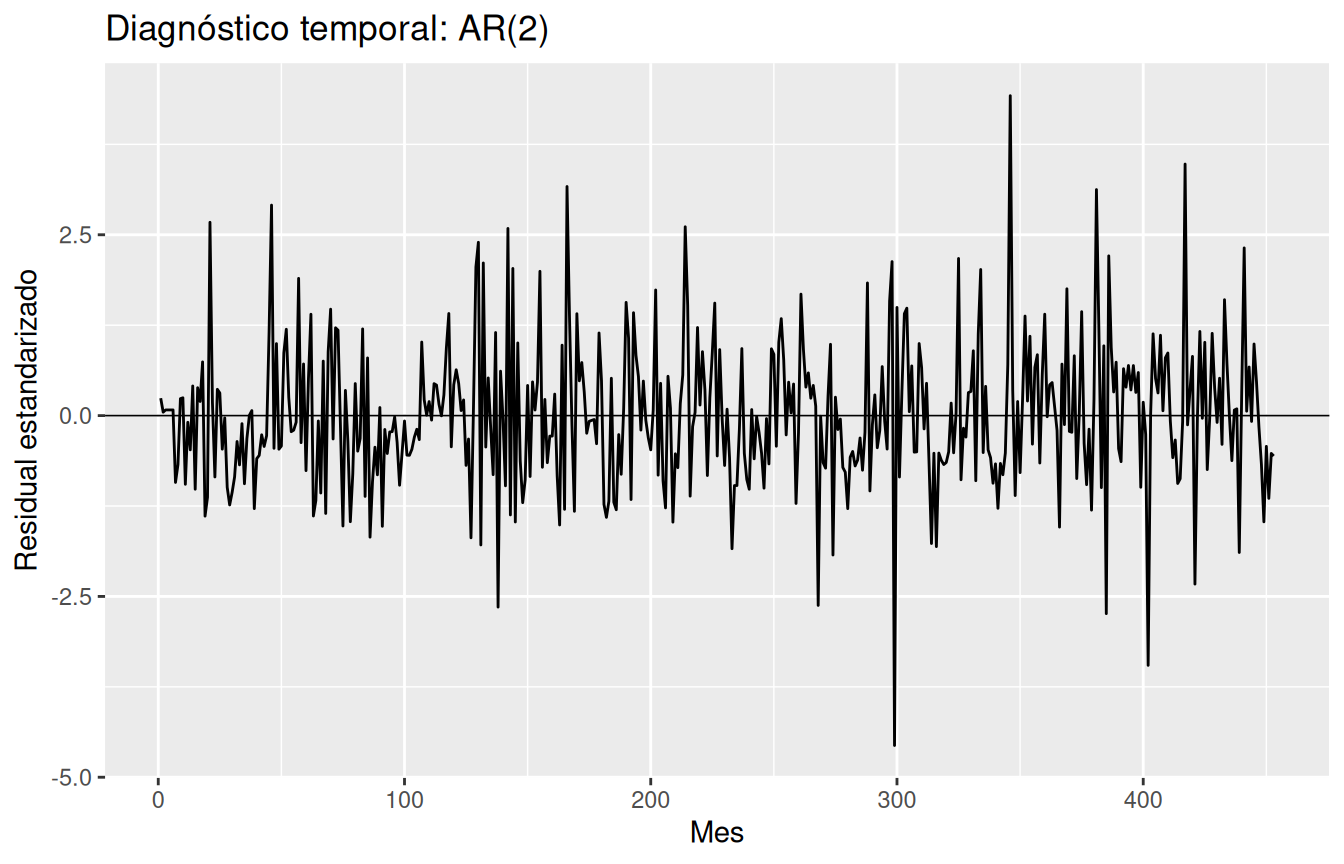
La Figura 4.5 debe examinarse en busca de cambios de nivel, agrupamientos de volatilidad y observaciones inusuales. No basta con que la trayectoria oscile alrededor de cero: todavía debemos revisar dependencia serial.
lag_diag_rec <- 36L

acf_resid_rec <- stats::acf(
  resid_rec_tbl$Estandarizado,
  lag.max = lag_diag_rec,
  plot = FALSE,
  na.action = na.pass
)$acf |> as.numeric()

acf_sq_rec <- stats::acf(
  resid_rec_tbl$Estandarizado^2,
  lag.max = lag_diag_rec,
  plot = FALSE,
  na.action = na.pass
)$acf |> as.numeric()

T_diag_rec <- nrow(resid_rec_tbl)
banda_diag_rec <- 1.96 / sqrt(T_diag_rec)

acf_diag_rec <- bind_rows(
  tibble(
    h = 0:lag_diag_rec,
    ACF = acf_resid_rec,
    Serie = "Residuales"
  ),
  tibble(
    h = 0:lag_diag_rec,
    ACF = acf_sq_rec,
    Serie = "Residuales al cuadrado"
  )
)

ggplot(acf_diag_rec, aes(x = h, y = ACF)) +
  geom_hline(yintercept = 0, linewidth = 0.3) +
  geom_hline(
    yintercept = c(-banda_diag_rec, banda_diag_rec),
    linetype = "dashed"
  ) +
  geom_segment(aes(xend = h, yend = 0)) +
  facet_wrap(~Serie, ncol = 1) +
  labs(
    x = "Rezago",
    y = "ACF",
    title = paste("Dependencia residual:", mejor_nombre_rec)
  )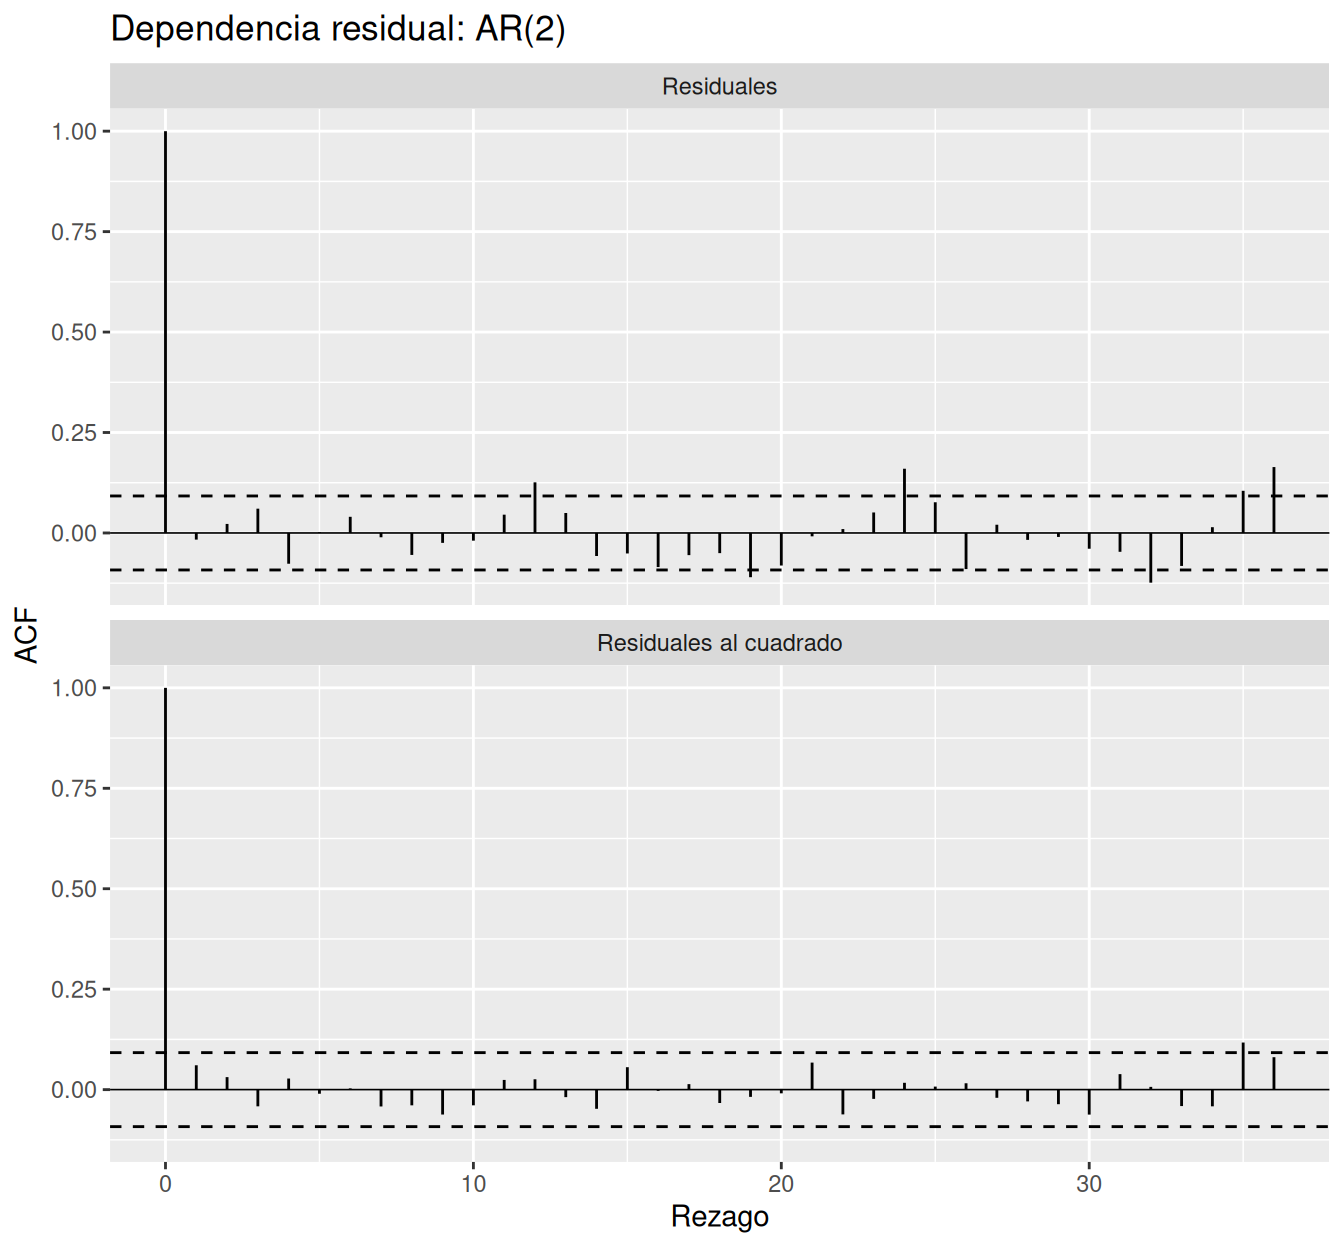
La parte superior de Figura 4.6 busca dependencia lineal no explicada. La parte inferior busca agrupamiento de magnitudes como señal exploratoria de posible heterocedasticidad condicional. Ambas preguntas son diferentes.
ggplot(resid_rec_tbl, aes(sample = Estandarizado)) +
  stat_qq() +
  stat_qq_line() +
  labs(
    x = "Cuantiles normales teóricos",
    y = "Cuantiles residuales",
    title = paste("Forma distributiva:", mejor_nombre_rec)
  )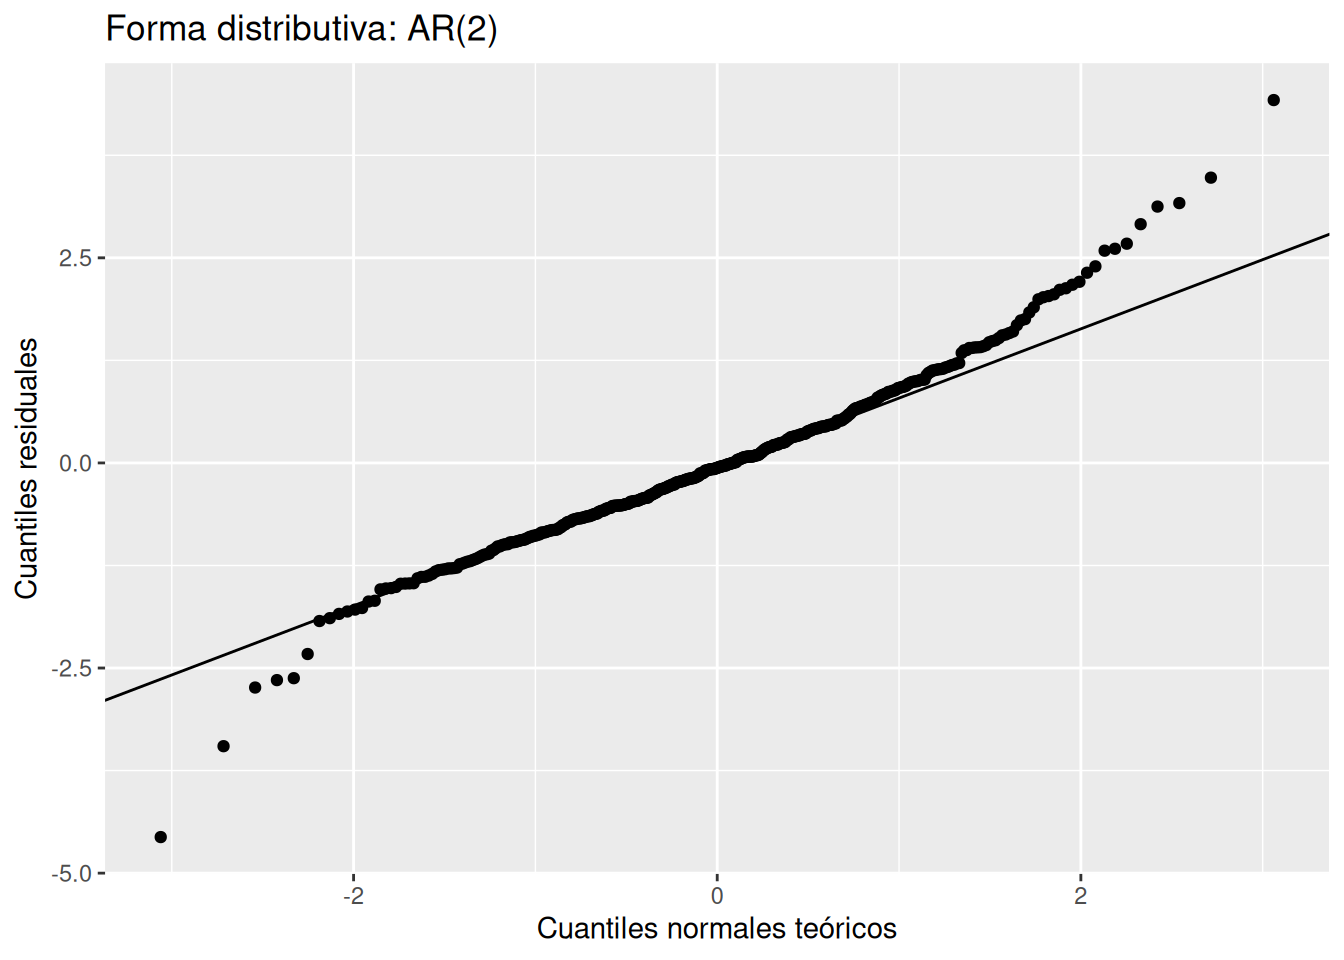
Desviaciones sistemáticas en las colas de Figura 4.7 sugieren que una distribución gaussiana puede representar insuficientemente eventos extremos. Esa observación afecta especialmente intervalos y probabilidades de cola.
4.14.8 Ljung–Box para varios horizontes
horizontes_lb <- 5:30

lb_varios_rec <- map_dfr(horizontes_lb, function(H) {
  prueba <- stats::Box.test(
    resid_rec_tbl$Estandarizado,
    lag = H,
    type = "Ljung-Box",
    fitdf = p_mejor_rec + q_mejor_rec
  )

  tibble(
    H = H,
    p_value = prueba$p.value
  )
})

ggplot(lb_varios_rec, aes(x = H, y = p_value)) +
  geom_hline(yintercept = 0.05, linetype = "dashed") +
  geom_point() +
  geom_line() +
  labs(
    x = "Horizonte H de la prueba",
    y = "p-valor",
    title = paste("Sensibilidad de Ljung--Box al horizonte:", mejor_nombre_rec)
  )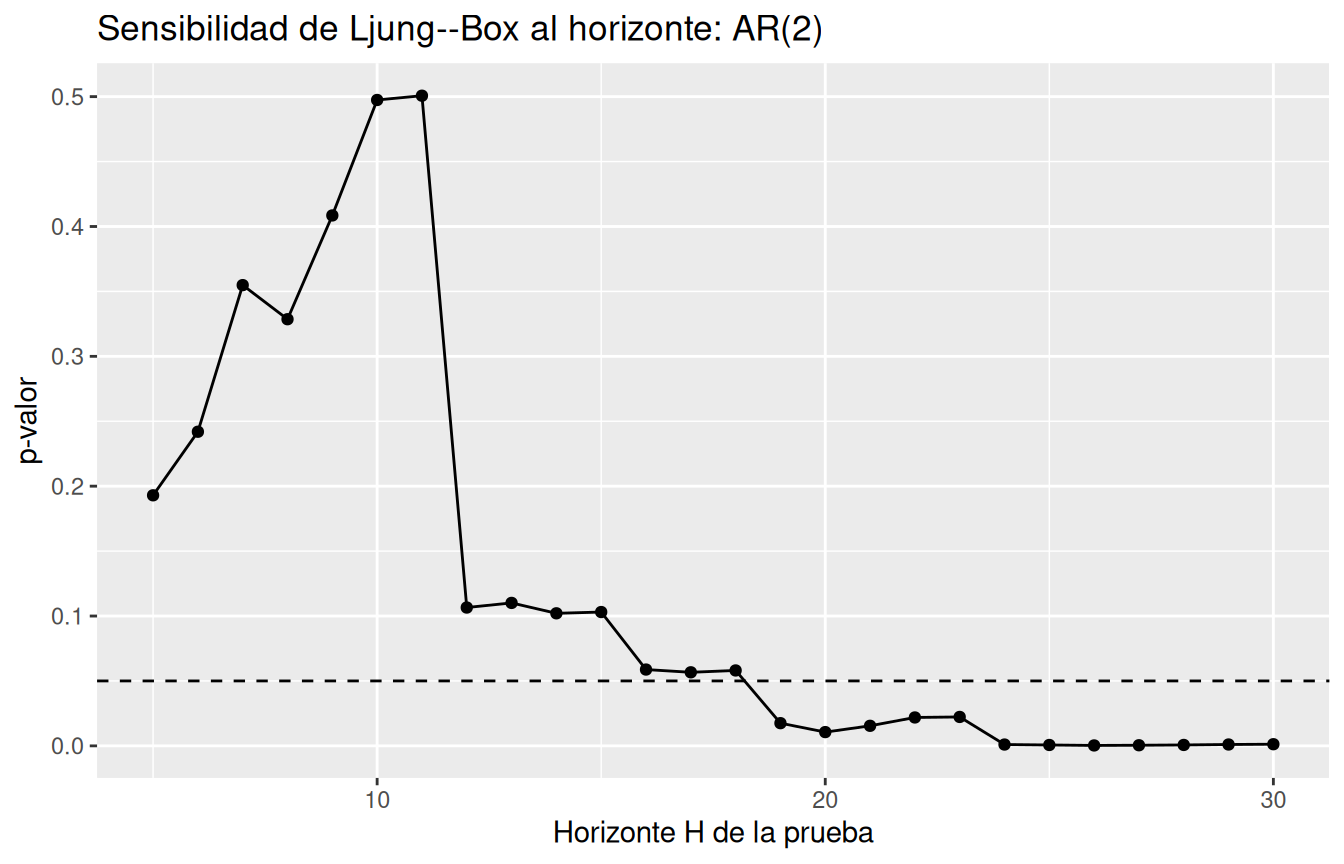
La Figura 4.8 evita convertir una sola elección de \(H\) en una decisión rígida. Un diagnóstico más convincente combina este gráfico con la ubicación concreta de las barras de la ACF.
4.14.9 Observado frente a ajuste a un paso
Como
\[ \widehat\varepsilon_t = y_t-\widehat y_{t\mid t-1}, \]
podemos reconstruir
\[ \widehat y_{t\mid t-1} = y_t-\widehat\varepsilon_t. \tag{4.53}\]
ajuste_un_paso_rec <- tibble(
  t = seq_along(x_rec),
  Observado = x_rec,
  `Ajuste a un paso` = x_rec - resid_mejor_rec
) |>
  pivot_longer(
    cols = c(Observado, `Ajuste a un paso`),
    names_to = "Serie",
    values_to = "Valor"
  ) |>
  filter(is.finite(Valor))

ggplot(ajuste_un_paso_rec, aes(x = t, y = Valor, linetype = Serie)) +
  geom_line() +
  labs(
    x = "Mes",
    y = "Reclutamiento",
    linetype = NULL,
    title = paste("Ajuste dentro de muestra:", mejor_nombre_rec)
  )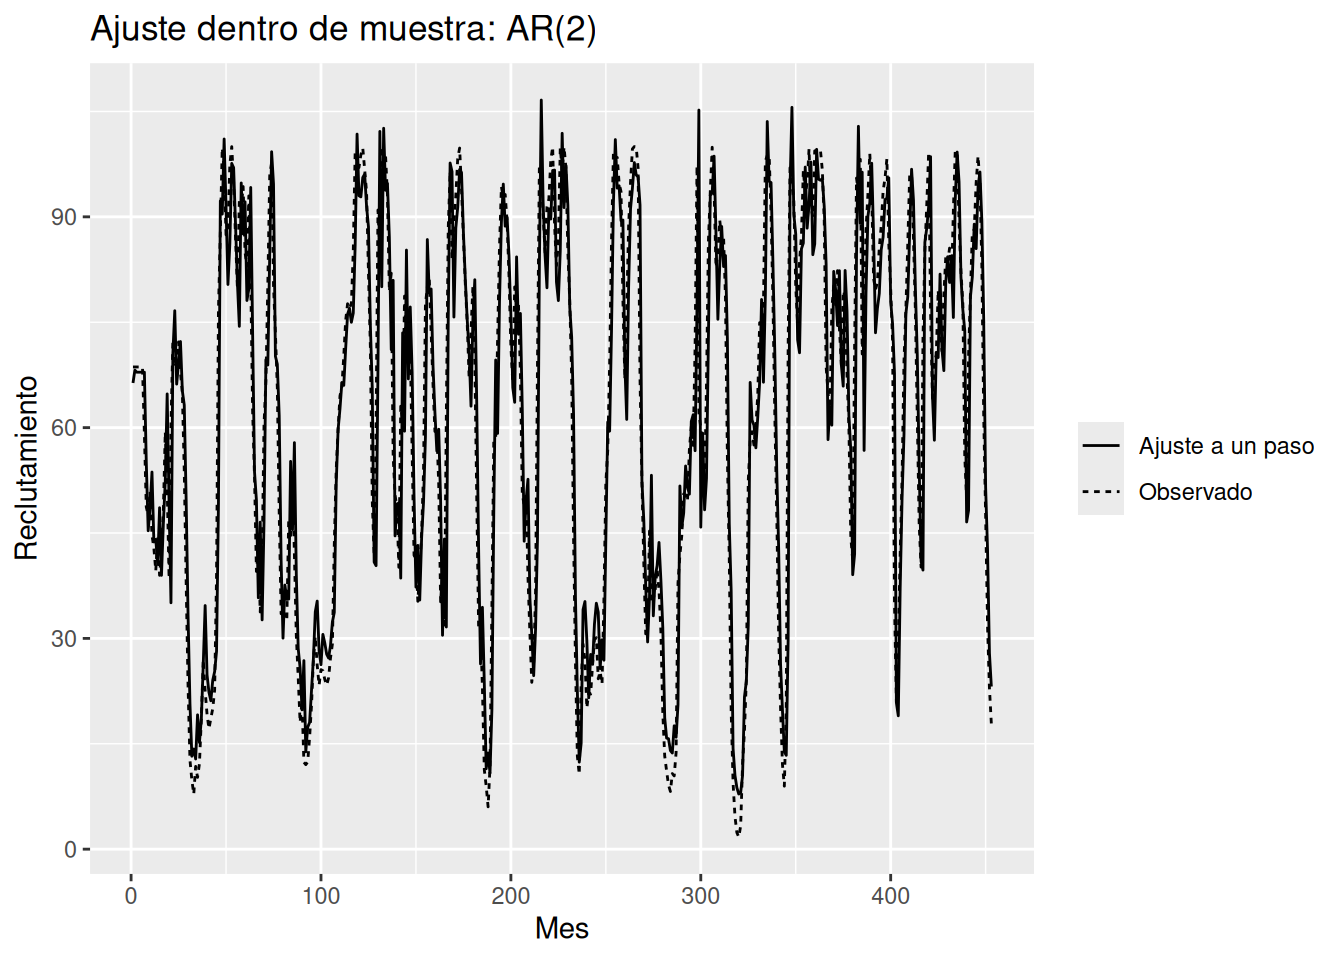
Una coincidencia visual estrecha en Figura 4.9 no garantiza buen pronóstico futuro. El ajuste usa parámetros aprendidos de toda la muestra y se evalúa sobre los mismos datos. La comparación predictiva honesta debe separar temporalmente entrenamiento y evaluación.
4.14.10 Conclusión provisional de la aplicación
El flujo aplicado produce una conclusión provisional, no definitiva:
- ACF/PACF generan un conjunto pequeño de candidatos;
- los parámetros se estiman con una convención común de máxima verosimilitud;
- AICc y BIC comparan ajuste penalizado;
- las raíces verifican que la representación estimada conserva las restricciones estructurales deseadas;
- ACF residual y Ljung–Box buscan dependencia lineal remanente;
- la ACF de residuos al cuadrado explora cambios de magnitud;
- el Q–Q evalúa la adecuación aproximada de la hipótesis gaussiana.
Si el candidato con menor AICc presenta autocorrelación residual clara, no deberíamos declararlo adecuado solo por su criterio de información. Si varios candidatos pasan razonablemente el diagnóstico, la semana 7 proporcionará una comparación adicional mediante desempeño fuera de muestra.
4.15 Una nota sobre selección automática
Algoritmos automáticos pueden recorrer muchos órdenes y minimizar AICc de manera eficiente. Son herramientas útiles, pero no reemplazan el razonamiento estadístico. En particular, una búsqueda automática puede:
- seleccionar un modelo cuya interpretación sea innecesariamente compleja;
- ocultar que varios modelos tienen AICc muy similares;
- devolver una especificación con diagnóstico residual insatisfactorio;
- favorecer un ajuste dentro de muestra que no domina fuera de muestra.
Por ello, incluso cuando posteriormente utilicemos rutinas automáticas para ARIMA, conservaremos la secuencia
\[ \text{modelo candidato} \rightarrow \text{estimación} \rightarrow \text{diagnóstico} \rightarrow \text{evaluación predictiva}. \]
4.16 Actividad computacional guiada
4.16.1 Parte A. Verosimilitud exacta y condicional
- Simule \(T=20\) observaciones de un AR(1) con \(\phi=0.8\) y \(\sigma_\varepsilon=1\).
- Reproduzca Figura 4.1.
- Repita para \(T=200\) manteniendo la misma semilla inicial de cada experimento.
- Compare la distancia entre los máximos exacto y condicional.
- Repita con \(\phi=0.2\) y con \(\phi=0.95\).
- Explique por qué el tratamiento de la observación inicial puede ser más visible cerca de la frontera estacionaria.
4.16.2 Parte B. Yule–Walker
- Simule un AR(2) con \((\phi_1,\phi_2)=(1.5,-0.75)\).
- Calcule \(\widehat\rho(1)\) y \(\widehat\rho(2)\) sin utilizar
ar.yw(). - Resuelva Ecuación 4.22 mediante
solve(). - Compare con
stats::ar.yw(). - Compare con
stats::arima(..., method = "ML"). - Repita 100 veces y describa la variabilidad de cada estimador.
4.16.3 Parte C. Condicional frente a ML en ARMA(1,1)
- Simule \(T=80\) observaciones con \((\phi,\theta)=(0.6,0.4)\).
- Ajuste el modelo con
method = "CSS"ymethod = "ML". - Compare coeficientes, \(\widehat\sigma_\varepsilon^2\) y residuales.
- Repita con \(T=500\).
- Discuta si la diferencia entre métodos parece disminuir con \(T\).
4.16.4 Parte D. Selección y diagnóstico
- Simule una serie ARMA(1,1) de tamaño \(T=250\).
- Ajuste AR(1), AR(2), MA(1), MA(2) y ARMA(1,1) mediante ML.
- Construya una tabla con logLik, \(k\), AIC, AICc y BIC.
- Identifique el candidato preferido por AICc y por BIC.
- Para cada candidato calcule Ljung–Box con \(H=20\) y
fitdf = p + q. - Explique qué haría si el modelo con menor AICc es rechazado fuertemente por Ljung–Box.
4.16.5 Parte E. Recruitment
- Reproduzca Tabla 4.7.
- Cambie el conjunto de candidatos para incluir MA(1), ARMA(2,1) y ARMA(1,2).
- Compare AICc y BIC.
- Verifique raíces de todos los modelos.
- Examine los diagnósticos de los dos mejores modelos según AICc.
- Escriba una recomendación provisional de no más de 200 palabras, separando claramente ajuste, diagnóstico y evidencia predictiva aún pendiente.
4.17 Puente hacia la inferencia bayesiana
La semana 5 no reemplazará la verosimilitud construida aquí. Partiremos, para un AR(\(p\)), de
\[ p(y_{p+1:T}\mid y_{1:p},\boldsymbol\phi,\sigma_\varepsilon^2) \]
y añadiremos una distribución a priori
\[ p(\boldsymbol\phi,\sigma_\varepsilon^2). \]
La posterior será
\[ p(\boldsymbol\phi,\sigma_\varepsilon^2\mid y_{1:T}) \propto p(y_{1:T}\mid\boldsymbol\phi,\sigma_\varepsilon^2) \, p(\boldsymbol\phi,\sigma_\varepsilon^2). \tag{4.54}\]
Tres temas de esta semana reaparecerán inmediatamente:
- restricciones de estacionariedad: ahora deberán incorporarse en el soporte de la priori o en una parametrización apropiada;
- incertidumbre paramétrica: en lugar de resumirla solo mediante errores estándar, la describiremos mediante una distribución posterior;
- pronóstico: la distribución predictiva posterior integrará sobre la incertidumbre de los parámetros, en vez de tratarlos como si fueran exactamente iguales a sus estimaciones puntuales.
4.18 Puente hacia evaluación fuera de muestra
Esta semana evaluamos principalmente adecuación interna. Un residual es un error a un paso construido con un modelo cuyos parámetros fueron aprendidos usando la muestra observada. Esto no responde todavía a la pregunta:
¿qué modelo pronostica mejor observaciones que no participaron en su ajuste?
En la semana 7 construiremos particiones temporales y validación con origen móvil. Allí compararemos modelos bajo:
- las mismas ventanas de entrenamiento;
- los mismos horizontes \(h\);
- los mismos métodos de referencia;
- MAE, RMSE y MASE;
- cobertura y amplitud de intervalos;
- puntuaciones probabilísticas cuando corresponda.
TipUn buen diagnóstico es necesario, pero no suficiente para pronosticar bien
Un modelo con fuerte autocorrelación residual desperdicia información temporal disponible y merece ser reformulado. Sin embargo, entre varios modelos con diagnóstico razonable, la elección final para pronóstico debe apoyarse también en evidencia fuera de muestra.
4.19 Síntesis
Las ideas centrales de la semana son las siguientes:
- la verosimilitud trata los datos observados como fijos y mide su compatibilidad relativa con distintos valores de los parámetros;
- en un AR(\(p\)) gaussiano, condicionar las primeras \(p\) observaciones transforma el problema en una regresión lineal;
- la máxima verosimilitud condicional y los mínimos cuadrados condicionales coinciden para los coeficientes de un AR gaussiano;
- Yule–Walker estima los parámetros AR sustituyendo autocovarianzas poblacionales por autocovarianzas muestrales en las ecuaciones teóricas;
- la verosimilitud exacta modela también la información inicial; en un AR(1) estacionario incorpora la distribución marginal de \(Y_1\);
- para un ARMA general, la verosimilitud exacta puede expresarse como un producto de densidades predictivas a un paso;
- en un ARMA con \(q>0\), las innovaciones reconstruidas dependen recursivamente de los propios parámetros, por lo que la estimación es no lineal;
- máxima verosimilitud requiere optimización numérica y debe respetar causalidad e invertibilidad;
- errores estándar e intervalos de Wald son aproximaciones frecuentistas de gran muestra;
- AIC, AICc y BIC comparan ajuste penalizado, pero solo cuando las verosimilitudes y los datos son comparables;
- AICc no es una evaluación fuera de muestra;
- los residuales de innovación son aproximaciones a las innovaciones teóricas y deben examinarse en tiempo, correlación, magnitud y forma distributiva;
- Ljung–Box contrasta conjuntamente autocorrelaciones residuales hasta un horizonte \(H\);
- un \(p\)-valor grande no demuestra que el modelo sea verdadero;
- la ACF de residuales al cuadrado puede revelar dependencia en la magnitud que una ACF residual ordinaria no detecta;
- identificación, estimación, selección y diagnóstico forman un ciclo iterativo;
- la semana 5 reutilizará esta verosimilitud para construir inferencia bayesiana y la semana 7 añadirá evaluación predictiva fuera de muestra.
4.20 Ejercicios
4.20.1 Conceptuales
Condicionar no es ignorar por accidente. Explique qué significa construir la verosimilitud de un AR(2) condicionando en \(y_1\) y \(y_2\). ¿Qué parte de la distribución conjunta deja de utilizarse?
Exacta frente a condicional. ¿Por qué la diferencia entre ambos enfoques suele disminuir cuando \(T\) aumenta? Mencione una situación en la que podría seguir siendo relevante.
Yule–Walker. Explique por qué Yule–Walker es especialmente natural para modelos AR, pero no produce en general estimadores eficientes para modelos MA o ARMA.
Residual. Distinga con sus propias palabras entre \(\varepsilon_t\), \(\widehat\varepsilon_t\) y un error de pronóstico \(Y_{T+h}-\widehat Y_{T+h\mid T}\).
AICc y diagnóstico. Un AR(3) tiene AICc menor que un AR(2), pero su prueba Ljung–Box produce \(p=0.004\). El AR(2) tiene AICc apenas 1.1 unidades mayor y \(p=0.42\). ¿Qué información aporta cada resultado y qué investigaría antes de decidir?
BIC. Explique por qué BIC puede preferir un modelo más pequeño que AIC aun cuando ambos se calculan con la misma log-verosimilitud.
Normalidad. Un modelo tiene ACF residual satisfactoria, pero un Q–Q muestra colas mucho más pesadas que la normal. ¿Qué aspecto del modelo parece adecuado y qué aspecto merece revisión?
Volatilidad. La ACF de los residuales es pequeña, pero la ACF de los residuales al cuadrado presenta varias autocorrelaciones grandes. ¿Qué tipo de estructura podría estar faltando? ¿En qué semana del curso se desarrollará formalmente?
Ljung–Box. ¿Por qué no es correcto interpretar \(p=0.70\) como “hay 70% de probabilidad de que los residuales sean ruido blanco”?
Ajuste y pronóstico. Explique por qué minimizar AICc sobre toda la serie no es lo mismo que demostrar superioridad de pronóstico fuera de muestra.
4.20.2 Derivaciones
Log-verosimilitud condicional. Derive Ecuación 4.7 a partir de Ecuación 4.4.
MLE de la varianza. Diferencie Ecuación 4.7 respecto de \(\sigma_\varepsilon^2\) y demuestre Ecuación 4.9.
AR(1) como regresión. A partir de Ecuación 4.10, derive Ecuación 4.11 y explique cómo recuperar \(\mu\) desde \((\alpha,\phi)\).
Yule–Walker AR(2). Derive Ecuación 4.22 desde Ecuación 4.13 y obtenga fórmulas cerradas para \(\widehat\phi_1\) y \(\widehat\phi_2\) en términos de \(\widehat\rho(1)\) y \(\widehat\rho(2)\).
Varianza Yule–Walker. Partiendo de
\[ \sigma_\varepsilon^2 = \gamma(0)-\boldsymbol\phi^\top\boldsymbol\gamma_p, \]
derive Ecuación 4.21 por método de momentos.
Verosimilitud exacta AR(1). Utilice Ecuación 4.25 y las densidades condicionales para derivar Ecuación 4.27.
Concentración de la verosimilitud. Para Ecuación 4.27, maximice respecto de \(\sigma_\varepsilon^2\) manteniendo \((\mu,\phi)\) fijos. Obtenga la varianza perfilada como función de \(S_E(\mu,\phi)\).
Factorización predictiva. Demuestre por regla de probabilidad que
\[ p(y_{1:T}) = \prod_{t=1}^{T}p(y_t\mid y_{1:t-1}), \]
adoptando la convención de que para \(t=1\) el condicionamiento es vacío.
- Ljung–Box. Compare el estadístico de Box–Pierce
\[ Q_{BP}=T\sum_{h=1}^{H}\widehat\rho(h)^2 \]
con Ecuación 4.50. ¿Qué corrección introduce Ljung–Box para muestras finitas?
- Criterios. Para dos modelos con la misma log-verosimilitud maximizada pero números de parámetros \(k\) y \(k+1\), derive cuánto aumenta la penalización en AIC y cuánto en BIC.
4.20.3 Computacionales
AR(1) corto y persistente. Simule 500 muestras con \(T=25\) y \(\phi=0.9\). Para cada una, estime \(\phi\) por máxima verosimilitud exacta y condicional. Compare sesgo y RMSE.
Efecto de \(T\). Repita el ejercicio anterior con \(T\in\{25,100,500\}\). Grafique el RMSE contra \(T\) para ambos métodos.
Yule–Walker frente a ML. Para un AR(2) con \((1.5,-0.75)\), compare los dos estimadores en 500 simulaciones para \(T=50\) y \(T=300\). Calcule sesgo y RMSE por parámetro.
Raíces estimadas. En el ejercicio anterior, calcule las raíces de \(1-\widehat\phi_1z-\widehat\phi_2z^2\) para cada réplica. ¿Con qué frecuencia aparecen estimaciones cercanas a la frontera estacionaria?
ARMA(1,1). Simule un ARMA(1,1) con \((\phi,\theta)=(0.7,-0.4)\). Ajuste por CSS y ML. Compare parámetros y residuales para \(T=50\) y \(T=500\).
Criterios de información. Simule datos desde un AR(2) y ajuste AR(\(p\)) para \(p=1,\ldots,6\). Construya AIC, AICc y BIC manualmente a partir de
logLik()y verifique sus cálculos contra funciones disponibles en R cuando proceda.Selección repetida. Repita 200 veces el ejercicio anterior. Registre qué orden selecciona AICc y qué orden selecciona BIC. ¿Con qué frecuencia recuperan \(p=2\)?
Diagnóstico deliberadamente incorrecto. Simule un AR(2) y ajuste solamente un AR(1). Grafique la ACF residual y calcule Ljung–Box. Luego ajuste el AR(2) correcto y compare.
Colas pesadas. Simule un AR(1) cuyas innovaciones sigan una distribución \(t\) estandarizada con pocos grados de libertad. Ajuste un AR(1) gaussiano. Compare ACF residual y Q–Q. ¿Qué parte del modelo recupera adecuadamente y cuál no?
Heterocedasticidad. Simule una serie con media cero e innovaciones incorrelacionadas cuya varianza cambie por bloques. Examine ACF de residuales y de residuales al cuadrado. Explique qué diagnóstico detecta mejor el cambio.
Sensibilidad a \(H\). Para un ajuste dado, calcule Ljung–Box para \(H=5,6,\ldots,40\). Grafique los \(p\)-valores y explique por qué una única elección de \(H\) puede dar una visión incompleta.
Recruitment ampliada. Añada a la aplicación modelos AR(4), ARMA(2,1) y ARMA(1,2). Elabore una tabla conjunta de AICc, BIC, raíces y Ljung–Box. Seleccione dos modelos finalistas y justifique su elección sin usar todavía desempeño fuera de muestra.
Informe de diagnóstico. Para uno de los modelos finalistas de Recruitment, escriba un informe de una página con: especificación, estimaciones, incertidumbre, raíces, AICc/BIC, ACF residual, Ljung–Box, Q–Q, ACF de residuales al cuadrado y una conclusión sobre adecuación.
Preparación para la semana 5. Tome un AR(1) ajustado por ML y construya una rejilla de valores de \(\phi\) dentro de \((-1,1)\). Grafique la log-verosimilitud relativa. Identifique la región de alta verosimilitud y discuta cómo una priori podría modificar esa información cuando \(\phi\) está cerca de uno.
4.21 Lecturas recomendadas
Para esta semana:
- Shumway y Stoffer: sección 3.5 para Yule–Walker, máxima verosimilitud, mínimos cuadrados, optimización y estimación ARMA; sección 3.7 para construcción de modelos y diagnóstico residual, incluida la prueba de Ljung–Box (Shumway y Stoffer 2025).
- Prado, Ferreira y West: sección 2.3.1 para Yule–Walker y máxima verosimilitud en AR; sección 2.3.4 para evaluación del orden; sección 2.5.4.2 para máxima verosimilitud y mínimos cuadrados en ARMA, incluida la reconstrucción recursiva de innovaciones (Prado et al. 2021).
- Hyndman y Athanasopoulos: sección 5.4 para diagnóstico de residuales y capítulo 9, especialmente la sección de estimación y criterios de información para ARIMA (Hyndman y Athanasopoulos 2021).
La semana 5 reutilizará la verosimilitud condicional de los modelos AR y añadirá prioris, restricciones de estacionariedad, simulación posterior y distribución predictiva posterior. La semana 6 incorporará diferenciación, ARIMA y estacionalidad; la semana 7 retomará los modelos ajustados para compararlos mediante evaluación temporal fuera de muestra.