construir_diseno_ar <- function(x, p, inicio = p + 1L) {
  x <- as.numeric(x)
  T <- length(x)

  stopifnot(
    length(p) == 1L,
    p >= 1L,
    inicio >= p + 1L,
    inicio <= T,
    !anyNA(x),
    all(is.finite(x))
  )

  indices <- inicio:T
  y <- x[indices]

  X_lags <- map_dfc(seq_len(p), function(j) {
    tibble(!!paste0("lag", j) := x[indices - j])
  })

  X_tbl <- bind_cols(tibble(intercepto = 1), X_lags)
  X <- as.matrix(X_tbl)

  stopifnot(
    nrow(X) == length(y),
    ncol(X) == p + 1L
  )

  list(y = y, X = X, indices = indices)
}5 Inferencia bayesiana para modelos autorregresivos
CA-0415 Series de Tiempo — Semana 5
5.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
- reutilizar la verosimilitud condicional de un AR(\(p\)) para construir un modelo bayesiano;
- escribir un AR(\(p\)) gaussiano condicionado en sus valores iniciales como una regresión lineal y reconocer qué parte de la inferencia depende de ese condicionamiento;
- distinguir entre una priori de referencia impropia, una priori conjugada propia y una priori general o restringida;
- derivar la posterior normal–inversa-gamma de los coeficientes y de la varianza de innovación bajo una priori conjugada;
- interpretar la estacionariedad como una restricción conjunta sobre los coeficientes AR y calcular su probabilidad posterior mediante las raíces del polinomio autorregresivo;
- generar muestras directas de una posterior disponible en forma cerrada y distinguir esa simulación de un algoritmo MCMC;
- implementar y diagnosticar un algoritmo MCMC sencillo para un AR(1) con restricción de estacionariedad;
- explicar el papel de trazas, autocorrelación de la cadena, \(\widehat R\) y tamaño efectivo de muestra en el diagnóstico de MCMC;
- construir la distribución predictiva posterior mediante simulación de parámetros e innovaciones futuras;
- separar conceptualmente incertidumbre por innovaciones futuras e incertidumbre paramétrica;
- comparar intervalos de pronóstico frecuentistas con intervalos predictivos bayesianos sin confundir sus interpretaciones;
- estudiar la sensibilidad de la posterior a la priori, especialmente cuando \(\phi\) está cerca de uno;
- explicar qué se requiere para comparar órdenes AR desde una perspectiva bayesiana;
- aplicar estas ideas a la serie Recruitment y conectar los resultados con el análisis frecuentista de la semana 4.
La semana 4 terminó con un punto de partida deliberadamente incompleto. Allí construimos una verosimilitud para los parámetros y la utilizamos para obtener estimadores, errores estándar, criterios de información y diagnósticos. En Sección 4.17 anticipamos la siguiente identidad:
\[ p(\boldsymbol\vartheta\mid y_{1:T}) \propto p(y_{1:T}\mid\boldsymbol\vartheta) \,p(\boldsymbol\vartheta), \tag{5.1}\]
donde \(\boldsymbol\vartheta\) representa los parámetros desconocidos. El primer factor ya fue estudiado. La novedad de esta semana es que la incertidumbre sobre los parámetros pasa a describirse mediante una distribución de probabilidad.
La guía bibliográfica del curso asigna esta semana a la inferencia bayesiana para modelos AR y toma como texto conductor a Prado, Ferreira y West: repaso de verosimilitud y Bayes, inferencia básica para AR, simulación posterior, evaluación del orden y sensibilidad a prioris (Prado et al. 2021, secs. 1.5, 2.3.2–2.4.2). El propósito no es convertir cada estimador puntual en una distribución por rutina, sino entender cómo la incertidumbre paramétrica se propaga hacia cantidades estructurales y, sobre todo, hacia el pronóstico.
5.2 De la verosimilitud a la posterior
En Sección 4.3 consideramos el modelo
\[ Y_t = c+\phi_1Y_{t-1}+\cdots+\phi_pY_{t-p}+\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2). \tag{5.2}\]
Condicionado en \(y_{1:p}\), la verosimilitud es
\[ L_c(\boldsymbol\beta,\sigma_\varepsilon^2) \propto (\sigma_\varepsilon^2)^{-(T-p)/2} \exp\left\{ - \frac{1}{2\sigma_\varepsilon^2} \sum_{t=p+1}^T \left( y_t-c-\sum_{j=1}^p\phi_jy_{t-j} \right)^2 \right\}, \tag{5.3}\]
con
\[ \boldsymbol\beta = (c,\phi_1,\ldots,\phi_p)^\top. \]
En el enfoque frecuentista de la semana 4, \(\boldsymbol\beta\) y \(\sigma_\varepsilon^2\) eran parámetros fijos desconocidos. En el enfoque bayesiano especificamos además
\[ p(\boldsymbol\beta,\sigma_\varepsilon^2), \]
y obtenemos
\[ p(\boldsymbol\beta,\sigma_\varepsilon^2\mid y_{1:T}) \propto L_c(\boldsymbol\beta,\sigma_\varepsilon^2) \,p(\boldsymbol\beta,\sigma_\varepsilon^2). \tag{5.4}\]
NotaLa verosimilitud no cambia al cambiar de paradigma
La misma función de verosimilitud utilizada para máxima verosimilitud aparece dentro de Ecuación 5.4. Lo que cambia es el tratamiento de los parámetros y la pregunta inferencial. En Bayes, la posterior describe lo que sabemos sobre los parámetros después de combinar la información previa con los datos.
5.2.1 Una observación sobre el intercepto
Prado, Ferreira y West desarrollan primero la inferencia AR básica para una serie de media cero,
\[ Y_t=\phi_1Y_{t-1}+\cdots+\phi_pY_{t-p}+\varepsilon_t, \]
porque así el vector de regresión contiene únicamente los coeficientes autorregresivos (Prado et al. 2021, sec. 2.3.2). En estas notas mantendremos también la formulación con intercepto de Ecuación 5.2 para conservar continuidad con el capítulo 4.
No hay contradicción. En la forma de regresión, incluir \(c\) consiste simplemente en añadir una columna de unos a la matriz de diseño. Además, la condición de estacionariedad depende de \(\phi_1,\ldots,\phi_p\), no del intercepto.
5.3 El AR(\(p\)) como regresión condicional
Sea
\[ n=T-p \]
el número de observaciones utilizadas después de condicionar en \(y_{1:p}\). Definamos
\[ \mathbf y = \begin{pmatrix} y_{p+1}\\ y_{p+2}\\ \vdots\\ y_T \end{pmatrix}, \qquad \mathbf X = \begin{pmatrix} 1 & y_p & y_{p-1} & \cdots & y_1\\ 1 & y_{p+1} & y_p & \cdots & y_2\\ \vdots & \vdots & \vdots & & \vdots\\ 1 & y_{T-1} & y_{T-2} & \cdots & y_{T-p} \end{pmatrix}. \tag{5.5}\]
Entonces
\[ \mathbf y\mid\boldsymbol\beta,\sigma_\varepsilon^2 \sim N_n(\mathbf X\boldsymbol\beta,\sigma_\varepsilon^2\mathbf I_n). \tag{5.6}\]
Ésta es la conexión central de la semana. Condicionado en los primeros \(p\) valores, un AR(\(p\)) gaussiano es un modelo de regresión lineal. Por tanto, podemos reutilizar la teoría bayesiana de regresión para construir posteriores cerradas bajo prioris de referencia o conjugadas (Prado et al. 2021, secs. 1.5.3 y 2.3.2).
El estimador de mínimos cuadrados es
\[ \widehat{\boldsymbol\beta} = (\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y, \tag{5.7}\]
y la suma de cuadrados residual es
\[ R = (\mathbf y-\mathbf X\widehat{\boldsymbol\beta})^\top (\mathbf y-\mathbf X\widehat{\boldsymbol\beta}). \tag{5.8}\]
Si \(k=p+1\) es la dimensión de \(\boldsymbol\beta\), definimos
\[ \nu=n-k, \qquad s^2=\frac{R}{\nu}. \tag{5.9}\]
La cantidad \(s^2\) será útil en la posterior de referencia.
5.3.1 Construcción explícita de la matriz de diseño
El siguiente código construye \(\mathbf y\) y \(\mathbf X\) sin depender de objetos de sesiones anteriores.
Esta función admite un argumento inicio distinto de \(p+1\). Lo utilizaremos más adelante para comparar órdenes AR utilizando exactamente las mismas observaciones de respuesta, una precaución importante cuando cambia \(p\).
5.4 Inferencia bayesiana de referencia
Una línea base clásica utiliza la priori impropia
\[ p(\boldsymbol\beta,\sigma_\varepsilon^2) \propto \frac{1}{\sigma_\varepsilon^2}. \tag{5.10}\]
Esta priori no representa una distribución de probabilidad normalizable sobre todo el espacio paramétrico. Sin embargo, bajo condiciones regulares y con suficiente información en los datos, induce una posterior propia. Prado, Ferreira y West la utilizan como análisis de referencia para conectar directamente la inferencia bayesiana del AR con la regresión lineal (Prado et al. 2021, sec. 1.5.3.1 y sec. 2.3.2).
Recordemos que, después de condicionar en los primeros \(p\) valores de la serie, el modelo AR(\(p\)) puede escribirse como una regresión lineal gaussiana:
\[ \mathbf y\mid \boldsymbol\beta,\sigma_\varepsilon^2 \sim N_n\!\left( \mathbf X\boldsymbol\beta, \sigma_\varepsilon^2\mathbf I_n \right), \]
donde \(\mathbf y\) contiene las \(n\) observaciones utilizadas como respuestas, \(\mathbf X\) es la matriz de diseño y \(\boldsymbol\beta\) contiene los \(k\) coeficientes del modelo. En nuestra parametrización con intercepto,
\[ \boldsymbol\beta = (c,\phi_1,\ldots,\phi_p)^\top, \qquad k=p+1. \]
La verosimilitud es entonces
\[ p(\mathbf y\mid\boldsymbol\beta,\sigma_\varepsilon^2) \propto (\sigma_\varepsilon^2)^{-n/2} \exp\left\{ -\frac{1}{2\sigma_\varepsilon^2} (\mathbf y-\mathbf X\boldsymbol\beta)^\top (\mathbf y-\mathbf X\boldsymbol\beta) \right\}. \]
Bajo la priori de referencia de la Ecuación Ecuación 5.10,
\[ p(\boldsymbol\beta,\sigma_\varepsilon^2) \propto \frac{1}{\sigma_\varepsilon^2}, \]
la posterior conjunta satisface
\[ p(\boldsymbol\beta,\sigma_\varepsilon^2\mid\mathbf y) \propto (\sigma_\varepsilon^2)^{-(n/2+1)} \exp\left\{ -\frac{ (\mathbf y-\mathbf X\boldsymbol\beta)^\top (\mathbf y-\mathbf X\boldsymbol\beta) }{ 2\sigma_\varepsilon^2 } \right\}. \]
La clave para identificar esta distribución es reescribir la suma de cuadrados alrededor del estimador de mínimos cuadrados
\[ \widehat{\boldsymbol\beta} = (\mathbf X^\top\mathbf X)^{-1} \mathbf X^\top\mathbf y. \]
Por las ecuaciones normales de mínimos cuadrados,
\[ \mathbf X^\top (\mathbf y-\mathbf X\widehat{\boldsymbol\beta}) = \mathbf 0. \]
Por tanto, podemos usar la descomposición
\[ (\mathbf y-\mathbf X\boldsymbol\beta)^\top (\mathbf y-\mathbf X\boldsymbol\beta) = R+ (\boldsymbol\beta-\widehat{\boldsymbol\beta})^\top \mathbf X^\top\mathbf X (\boldsymbol\beta-\widehat{\boldsymbol\beta}), \]
donde
\[ R= (\mathbf y-\mathbf X\widehat{\boldsymbol\beta})^\top (\mathbf y-\mathbf X\widehat{\boldsymbol\beta}) \]
es la suma de cuadrados residual.
Esta identidad separa el error asociado a un valor cualquiera de \(\boldsymbol\beta\) en dos componentes:
- \(R\), que es la suma de cuadrados residual mínima alcanzada por el estimador de mínimos cuadrados;
- un término cuadrático que mide cuánto aumenta el error al alejarnos de \(\widehat{\boldsymbol\beta}\).
Sustituyendo esta expresión en la posterior conjunta obtenemos
\[ p(\boldsymbol\beta,\sigma_\varepsilon^2\mid\mathbf y) \propto (\sigma_\varepsilon^2)^{-(n/2+1)} \exp\left\{ -\frac{R}{2\sigma_\varepsilon^2} \right\} \exp\left\{ -\frac{ (\boldsymbol\beta-\widehat{\boldsymbol\beta})^\top \mathbf X^\top\mathbf X (\boldsymbol\beta-\widehat{\boldsymbol\beta}) }{ 2\sigma_\varepsilon^2 } \right\}. \]
Esta forma permite reconocer las distribuciones posteriores.
5.4.0.1 Posterior de \(\boldsymbol\beta\) condicional en \(\sigma_\varepsilon^2\)
Supongamos momentáneamente que condicionamos en un valor dado de \(\sigma_\varepsilon^2\). Los términos que no dependen de \(\boldsymbol\beta\) pueden tratarse como constantes, por lo que
\[ p(\boldsymbol\beta\mid \sigma_\varepsilon^2,\mathbf y) \propto \exp\left\{ -\frac{1}{2} (\boldsymbol\beta-\widehat{\boldsymbol\beta})^\top \left[ \frac{\mathbf X^\top\mathbf X} {\sigma_\varepsilon^2} \right] (\boldsymbol\beta-\widehat{\boldsymbol\beta}) \right\}. \]
Éste es exactamente el núcleo de una distribución normal multivariada. Así,
\[ \boldsymbol\beta \mid \sigma_\varepsilon^2,\mathbf y \sim N_k\left( \widehat{\boldsymbol\beta}, \sigma_\varepsilon^2(\mathbf X^\top\mathbf X)^{-1} \right). \tag{5.11}\]
La expresión tiene una interpretación importante. La media posterior coincide con el estimador de mínimos cuadrados porque la priori de referencia es plana con respecto a \(\boldsymbol\beta\): no hay contracción hacia ningún valor previo.
La incertidumbre posterior depende de dos elementos:
\[ \sigma_\varepsilon^2 \qquad\text{y}\qquad (\mathbf X^\top\mathbf X)^{-1}. \]
Una mayor varianza de innovación produce mayor incertidumbre sobre los coeficientes, mientras que una matriz de diseño más informativa produce una matriz \((\mathbf X^\top\mathbf X)^{-1}\) más pequeña.
5.4.0.2 Posterior marginal de \(\sigma_\varepsilon^2\)
Para obtener la posterior marginal de \(\sigma_\varepsilon^2\) debemos integrar \(\boldsymbol\beta\):
\[ p(\sigma_\varepsilon^2\mid\mathbf y) = \int p(\boldsymbol\beta,\sigma_\varepsilon^2\mid\mathbf y) \,d\boldsymbol\beta. \]
La integral correspondiente a la parte normal en \(\boldsymbol\beta\) aporta un factor proporcional a
\[ (\sigma_\varepsilon^2)^{k/2}. \]
Por ello,
\[ p(\sigma_\varepsilon^2\mid\mathbf y) \propto (\sigma_\varepsilon^2)^{-\{(n-k)/2+1\}} \exp\left\{ -\frac{R}{2\sigma_\varepsilon^2} \right\}. \]
Definiendo
\[ \nu=n-k, \]
reconocemos el núcleo de una distribución inversa-gamma:
\[ \sigma_\varepsilon^2\mid\mathbf y \sim \operatorname{IG}\left( \frac{\nu}{2}, \frac{R}{2} \right). \tag{5.12}\]
Aquí utilizamos la parametrización
\[ f(v) \propto v^{-(a+1)} \exp\left(-\frac{b}{v}\right), \qquad v>0. \]
Los \(\nu=n-k\) grados de libertad aparecen porque tenemos \(n\) observaciones, pero hemos utilizado \(k\) parámetros para ajustar la media condicional. Es la misma corrección por grados de libertad que aparece en el estimador frecuentista
\[ s^2=\frac{R}{n-k} = \frac{R}{\nu}. \]
En nuestro AR(\(p\)) con intercepto, si utilizamos como respuestas las observaciones \(Y_{p+1},\ldots,Y_T\), entonces
\[ n=T-p, \qquad k=p+1. \]
Por tanto,
\[ \nu = n-k = (T-p)-(p+1) = T-2p-1. \]
Esta contabilidad es importante porque aquí \(p\) representa el orden autorregresivo, mientras que \(k\) representa el número total de coeficientes de regresión.
5.4.0.3 Posterior marginal de \(\boldsymbol\beta\)
La Ecuación Ecuación 5.11 todavía condiciona en un valor específico de \(\sigma_\varepsilon^2\). Desde una perspectiva bayesiana, sin embargo, \(\sigma_\varepsilon^2\) también es desconocida. Debemos integrar esa incertidumbre:
\[ p(\boldsymbol\beta\mid\mathbf y) = \int p(\boldsymbol\beta\mid\sigma_\varepsilon^2,\mathbf y) p(\sigma_\varepsilon^2\mid\mathbf y) \,d\sigma_\varepsilon^2. \]
Una mezcla de distribuciones normales cuya varianza sigue la distribución inversa-gamma de la Ecuación Ecuación 5.12 produce una distribución Student-\(t\) multivariada. En concreto,
\[ \boldsymbol\beta\mid\mathbf y \sim t_{\nu,k}\left( \widehat{\boldsymbol\beta}, s^2(\mathbf X^\top\mathbf X)^{-1} \right), \]
donde
\[ s^2=\frac{R}{\nu}. \]
Por tanto, la matriz de escala es
\[ s^2(\mathbf X^\top\mathbf X)^{-1}. \tag{5.13}\]
También podemos ver directamente de dónde surge la Student-\(t\). Definamos
\[ Q(\boldsymbol\beta) = (\boldsymbol\beta-\widehat{\boldsymbol\beta})^\top \mathbf X^\top\mathbf X (\boldsymbol\beta-\widehat{\boldsymbol\beta}). \]
Al integrar \(\sigma_\varepsilon^2\) obtenemos una densidad proporcional a
\[ p(\boldsymbol\beta\mid\mathbf y) \propto \left[ R+Q(\boldsymbol\beta) \right]^{-n/2}. \]
Como
\[ R=\nu s^2 \]
y
\[ n=\nu+k, \]
podemos reescribirla como
\[ p(\boldsymbol\beta\mid\mathbf y) \propto \left[ 1+ \frac{1}{\nu} (\boldsymbol\beta-\widehat{\boldsymbol\beta})^\top \left\{ s^2(\mathbf X^\top\mathbf X)^{-1} \right\}^{-1} (\boldsymbol\beta-\widehat{\boldsymbol\beta}) \right]^{-(\nu+k)/2}. \]
Éste es precisamente el núcleo de una distribución Student-\(t\) multivariada con \(\nu\) grados de libertad.
NotaMatriz de escala y matriz de covarianza no son lo mismo
En la Ecuación Ecuación 5.13,
\[ s^2(\mathbf X^\top\mathbf X)^{-1} \]
es la matriz de escala de la distribución Student-\(t\), no su matriz de covarianza.
Si \(\nu>2\), la covarianza posterior es
\[ \operatorname{Var} (\boldsymbol\beta\mid\mathbf y) = \frac{\nu}{\nu-2} s^2(\mathbf X^\top\mathbf X)^{-1}. \]
Cuando \(\nu\) es grande,
\[ \frac{\nu}{\nu-2}\approx 1, \]
y la distribución Student-\(t\) se aproxima a una normal multivariada.
El punto conceptual más importante es la diferencia entre la posterior condicional de \(\boldsymbol\beta\) y su posterior marginal.
Si \(\sigma_\varepsilon^2\) fuese conocida, entonces
\[ \boldsymbol\beta \mid \sigma_\varepsilon^2,\mathbf y \]
tendría una distribución normal.
Pero como \(\sigma_\varepsilon^2\) también es desconocida, debemos promediar sobre todos sus valores plausibles según la posterior. Esa incertidumbre adicional genera colas más pesadas, y por eso
\[ \boldsymbol\beta\mid\mathbf y \]
tiene una distribución Student-\(t\) multivariada.
En resumen,
\[ \boxed{ \text{Normal condicional} + \text{inversa-gamma para }\sigma_\varepsilon^2 \Longrightarrow \text{Student-}t\text{ marginal para }\boldsymbol\beta } \]
Este resultado conecta directamente con la estimación frecuentista de la semana anterior: aparecen nuevamente \(\widehat{\boldsymbol\beta}\), la suma de cuadrados residual \(R\), el estimador \(s^2\) y los grados de libertad \(\nu\), pero ahora como parámetros de distribuciones posteriores completas.
ImportantePosterior de referencia no significa “sin supuestos”
El análisis sigue condicionado en \(y_{1:p}\), supone innovaciones gaussianas, una estructura AR de orden fijado y una matriz de diseño de rango completo. Además, la priori Ecuación 5.10 es impropia. “Referencia” no significa que el análisis esté libre de decisiones de modelación.
5.4.1 El caso AR(1) de media cero
Para conectar directamente con el desarrollo de Prado, Ferreira y West, considere
\[ Y_t=\phi Y_{t-1}+\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,v). \tag{5.14}\]
Condicionando en \(y_1\),
\[ \widehat\phi = \frac{\sum_{t=2}^T y_ty_{t-1}} {\sum_{t=2}^T y_{t-1}^2}. \tag{5.15}\]
Con \(p(\phi,v)\propto1/v\), la posterior marginal de \(\phi\) es Student-\(t\) con \(T-2\) grados de libertad y centro \(\widehat\phi\), mientras que \(v\) tiene una posterior inversa-gamma (Prado et al. 2021, Example 1.6). Este resultado es un recordatorio útil: en el caso básico, no necesitamos MCMC para obtener la posterior.
5.5 Priori conjugada propia
Una priori conjugada propia para la regresión normal es
\[ \boldsymbol\beta\mid\sigma_\varepsilon^2 \sim N_k(\mathbf m_0,\sigma_\varepsilon^2\mathbf C_0), \tag{5.16}\]
\[ \sigma_\varepsilon^2 \sim \operatorname{IG}\left( \frac{n_0}{2}, \frac{d_0}{2} \right), \tag{5.17}\]
con \(\mathbf C_0\) definida positiva, \(n_0>0\) y \(d_0>0\). Esta familia es conjugada porque la posterior conserva la misma forma normal–inversa-gamma (Prado et al. 2021, sec. 1.5.3.2).
Definamos
\[ \mathbf C_n = \left( \mathbf C_0^{-1}+\mathbf X^\top\mathbf X \right)^{-1}, \tag{5.18}\]
\[ \mathbf m_n = \mathbf C_n \left( \mathbf C_0^{-1}\mathbf m_0 + \mathbf X^\top\mathbf y \right), \tag{5.19}\]
\[ n_n=n_0+n, \tag{5.20}\]
y
\[ d_n = d_0 + \mathbf y^\top\mathbf y + \mathbf m_0^\top\mathbf C_0^{-1}\mathbf m_0 - \mathbf m_n^\top\mathbf C_n^{-1}\mathbf m_n. \tag{5.21}\]
Entonces
\[ \boldsymbol\beta \mid \sigma_\varepsilon^2,\mathbf y \sim N_k(\mathbf m_n,\sigma_\varepsilon^2\mathbf C_n), \tag{5.22}\]
\[ \sigma_\varepsilon^2\mid\mathbf y \sim \operatorname{IG}\left( \frac{n_n}{2}, \frac{d_n}{2} \right), \tag{5.23}\]
y marginalmente
\[ \boldsymbol\beta\mid\mathbf y \sim t_{n_n}\left( \mathbf m_n, \frac{d_n}{n_n}\mathbf C_n \right). \tag{5.24}\]
5.5.1 ¿De dónde salen las actualizaciones?
El núcleo de la densidad conjunta posterior es
\[ p(\boldsymbol\beta,v\mid\mathbf y) \propto v^{-n/2} \exp\left\{-\frac{1}{2v} (\mathbf y-\mathbf X\boldsymbol\beta)^\top (\mathbf y-\mathbf X\boldsymbol\beta) \right\} \]
\[ \times v^{-k/2} \exp\left\{-\frac{1}{2v} (\boldsymbol\beta-\mathbf m_0)^\top \mathbf C_0^{-1} (\boldsymbol\beta-\mathbf m_0) \right\} \times v^{-(n_0/2+1)} \exp\left(-\frac{d_0}{2v}\right). \tag{5.25}\]
El término cuadrático que depende de \(\boldsymbol\beta\) puede completarse como
\[ (\boldsymbol\beta-\mathbf m_n)^\top \mathbf C_n^{-1} (\boldsymbol\beta-\mathbf m_n) + d_n-d_0. \]
Esta operación produce simultáneamente Ecuación 5.18 a Ecuación 5.21. La actualización tiene una interpretación de precisiones que se suman:
\[ \underbrace{\mathbf C_n^{-1}}_{\text{precisión posterior}} = \underbrace{\mathbf C_0^{-1}}_{\text{precisión previa}} + \underbrace{\mathbf X^\top\mathbf X}_{\text{información de los datos}}. \tag{5.26}\]
NotaLa conjugación es una conveniencia, no una obligación
La elección de Ecuación 5.16 y Ecuación 5.17 permite cálculos cerrados. No implica que toda priori razonable deba tener esa forma. Cuando una restricción estructural o un conocimiento previo no se expresa cómodamente mediante la familia conjugada, puede ser preferible una priori no conjugada y un método de simulación posterior.
5.5.2 Funciones de R para posterior de referencia y conjugada
posterior_referencia_ar <- function(y, X) {
  y <- as.numeric(y)
  X <- as.matrix(X)

  n <- length(y)
  k <- ncol(X)
  XtX <- crossprod(X)
  XtX_inv <- solve(XtX)
  beta_hat <- as.vector(XtX_inv %*% crossprod(X, y))
  resid <- y - as.vector(X %*% beta_hat)
  R <- sum(resid^2)
  nu <- n - k

  if (nu <= 0) {
    stop("Se requieren más observaciones que coeficientes.")
  }

  list(
    beta = beta_hat,
    C = XtX_inv,
    R = R,
    nu = nu,
    s2 = R / nu
  )
}

posterior_conjugada_ar <- function(y, X, m0, C0, n0, d0) {
  y <- as.numeric(y)
  X <- as.matrix(X)
  m0 <- as.numeric(m0)
  C0 <- as.matrix(C0)

  stopifnot(
    ncol(X) == length(m0),
    all(dim(C0) == c(length(m0), length(m0))),
    n0 > 0,
    d0 > 0
  )

  C0_inv <- solve(C0)
  Cn <- solve(C0_inv + crossprod(X))
  mn <- as.vector(Cn %*% (C0_inv %*% m0 + crossprod(X, y)))
  nn <- n0 + length(y)
  dn <- as.numeric(
    d0 +
      crossprod(y) +
      crossprod(m0, C0_inv %*% m0) -
      crossprod(mn, solve(Cn, mn))
  )

  list(m = mn, C = Cn, n = nn, d = dn)
}
La función conjugada utiliza la parametrización de Ecuación 5.17. Por tanto, la media posterior de \(\sigma_\varepsilon^2\) existe cuando \(n_n>2\) y es \(d_n/(n_n-2)\).
5.6 Ejemplo conductor: AR(1) bayesiano
Simularemos un AR(1) estacionario con \(\phi=0.7\) y varianza de innovación uno. Este ejemplo permite comprobar las fórmulas en un entorno donde conocemos el mecanismo generador.
set.seed(415)

T_ar1 <- 100L
phi_ar1 <- 0.7
sigma_ar1 <- 1

x_ar1 <- as.numeric(
  stats::arima.sim(
    model = list(ar = phi_ar1),
    n = T_ar1,
    sd = sigma_ar1
  )
)

stopifnot(
  length(x_ar1) == T_ar1,
  !anyNA(x_ar1),
  all(is.finite(x_ar1))
)

ar1_dat <- tibble(t = seq_along(x_ar1), y = x_ar1) |>
as_tsibble(index = t)ggplot(ar1_dat, aes(x = t, y = y)) +
geom_line() +
labs(
x = "Tiempo",
y = "Y",
title = "Ejemplo conductor: AR(1)"
)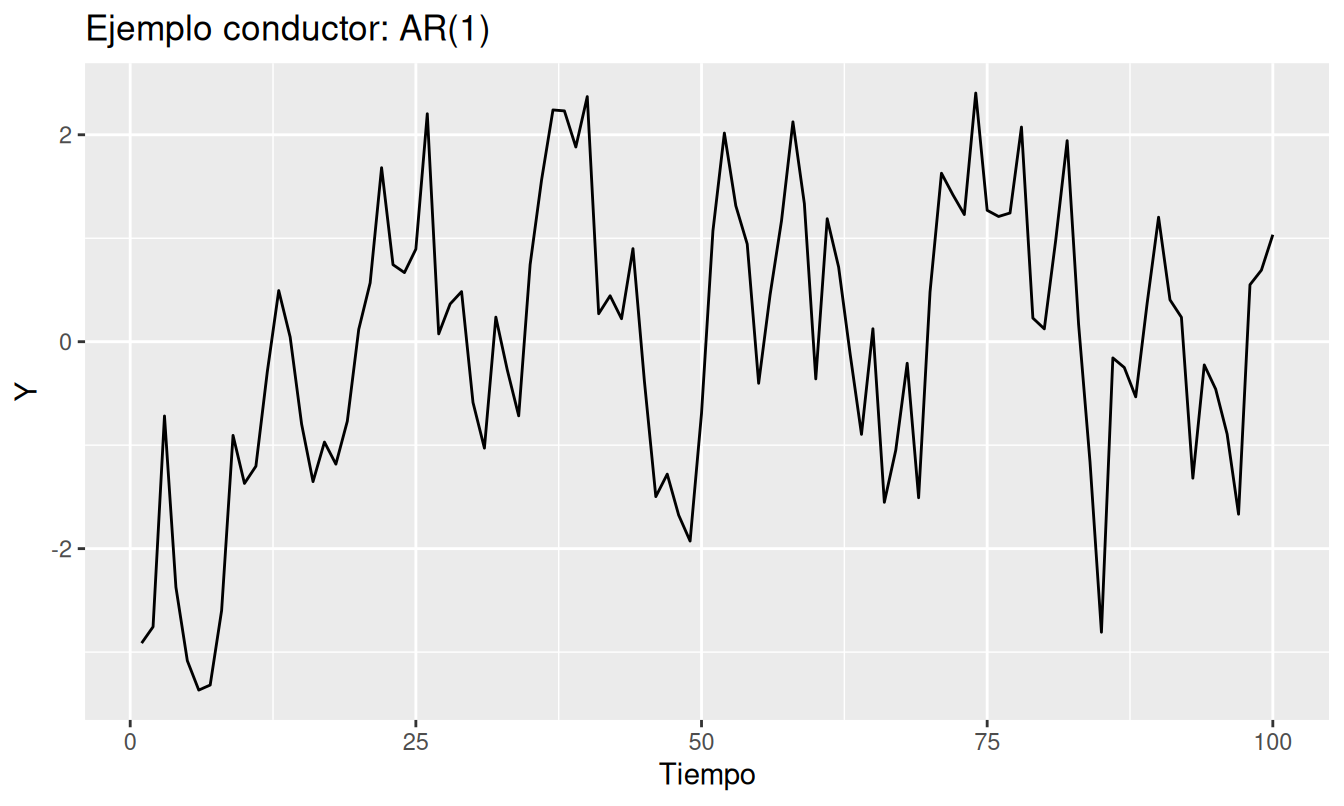
Para separar el mecanismo autorregresivo de la estimación de una media, ajustaremos aquí el modelo de media cero. Así, \(\boldsymbol\beta=\phi\) y la matriz de diseño tiene una sola columna con \(y_{t-1}\).
Y_ar1 <- x_ar1[2:T_ar1]
X_ar1 <- matrix(x_ar1[1:(T_ar1 - 1L)], ncol = 1)
colnames(X_ar1) <- "phi"

post_ref_ar1 <- posterior_referencia_ar(Y_ar1, X_ar1)

M_ar1 <- 5000L
set.seed(416)

v_ref_ar1 <- 1 / rgamma(
  M_ar1,
  shape = post_ref_ar1$nu / 2,
  rate = post_ref_ar1$R / 2
)

z_ref_ar1 <- rnorm(M_ar1)
phi_ref_ar1 <- post_ref_ar1$beta[1] +
  sqrt(v_ref_ar1 * post_ref_ar1$C[1, 1]) * z_ref_ar1

muestras_ref_ar1 <- tibble(
  phi = phi_ref_ar1,
  sigma = sqrt(v_ref_ar1)
)| Parametro | Verdadero | Media | Mediana | Inferior | Superior |
|---|---|---|---|---|---|
| phi | 0.7 | 0.702 | 0.702 | 0.565 | 0.838 |
| sigma | 1.0 | 0.949 | 0.945 | 0.826 | 1.095 |
La tabla no debe leerse como una prueba de que Bayes “recupera” siempre el parámetro verdadero. En una muestra concreta, la posterior refleja la información disponible bajo el modelo y la priori. En simulación, repetir el experimento muchas veces permitiría estudiar propiedades frecuentistas del procedimiento bayesiano, pero ésa es una pregunta distinta.
5.6.1 Priori propia y actualización
Tomemos ahora
\[ \phi\mid v\sim N(0,vC_0), \qquad v\sim\operatorname{IG}(n_0/2,d_0/2), \]
con \(C_0=1\), \(n_0=4\) y \(d_0=4\). La priori es deliberadamente sencilla y no impone todavía \(|\phi|<1\).
m0_ar1 <- 0
C0_ar1 <- matrix(1, nrow = 1, ncol = 1)
n0_ar1 <- 4
d0_ar1 <- 4

post_conj_ar1 <- posterior_conjugada_ar(
  y = Y_ar1,
  X = X_ar1,
  m0 = m0_ar1,
  C0 = C0_ar1,
  n0 = n0_ar1,
  d0 = d0_ar1
)

set.seed(417)

v_conj_ar1 <- 1 / rgamma(
  M_ar1,
  shape = post_conj_ar1$n / 2,
  rate = post_conj_ar1$d / 2
)

phi_conj_ar1 <- post_conj_ar1$m[1] +
  sqrt(v_conj_ar1 * post_conj_ar1$C[1, 1]) * rnorm(M_ar1)

muestras_conj_ar1 <- tibble(
  phi = phi_conj_ar1,
  sigma = sqrt(v_conj_ar1)
)set.seed(418)
v_prior_ar1 <- 1 / rgamma(
M_ar1,
shape = n0_ar1 / 2,
rate = d0_ar1 / 2
)
phi_prior_ar1 <- rnorm(
M_ar1,
mean = m0_ar1,
sd = sqrt(v_prior_ar1 * C0_ar1[1, 1])
)
bind_rows(
tibble(phi = phi_prior_ar1, Distribucion = "Priori"),
tibble(phi = phi_conj_ar1, Distribucion = "Posterior")
) |>
filter(abs(phi) < 3) |>
ggplot(aes(x = phi, linetype = Distribucion)) +
geom_density(linewidth = 0.9) +
geom_vline(xintercept = phi_ar1, linetype = "dashed") +
labs(
x = "phi",
y = "Densidad",
linetype = NULL,
title = "De la incertidumbre previa a la posterior"
)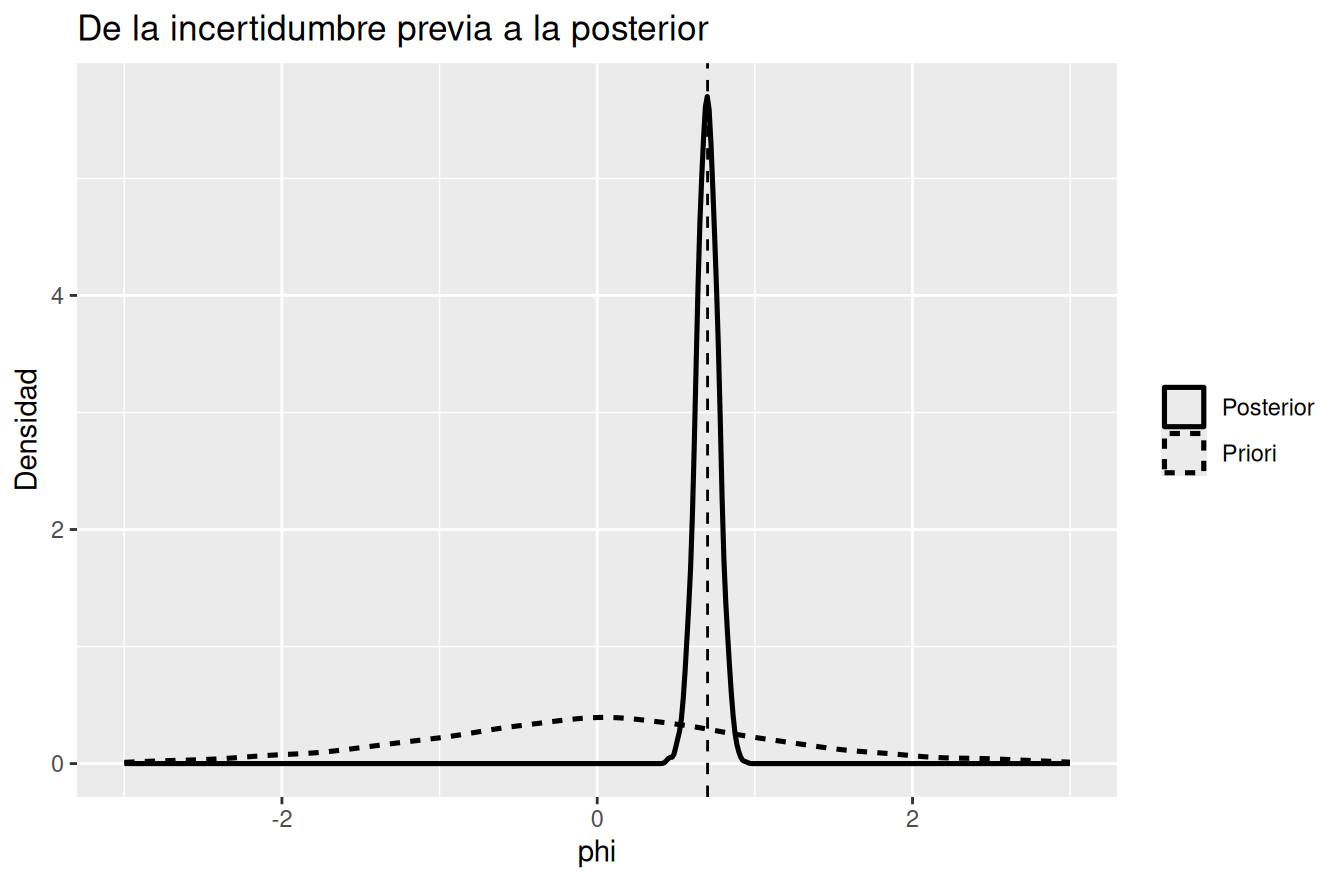
La posterior suele estar mucho más concentrada que la priori cuando la serie contiene información clara sobre la persistencia. Sin embargo, esta figura también revela un problema que todavía no hemos resuelto: una normal para \(\phi\) asigna probabilidad a valores fuera de \((-1,1)\).
5.7 Estacionariedad como restricción probabilística
En Sección 2.9.1 establecimos que un AR(\(p\)) es causal y estacionario bajo la condición usual cuando las raíces de
\[ \Phi(z) = 1-\phi_1z-\cdots-\phi_pz^p \tag{5.27}\]
están fuera del círculo unitario. La inferencia bayesiana convierte esta propiedad estructural en una afirmación probabilística sobre los parámetros.
Hay dos estrategias conceptualmente distintas.
5.7.1 Estrategia A: posterior no restringida y probabilidad posterior de estacionariedad
Podemos obtener muestras
\[ \boldsymbol\phi^{(1)},\ldots,\boldsymbol\phi^{(M)} \sim p(\boldsymbol\phi\mid y) \]
y comprobar las raíces de Ecuación 5.27 para cada muestra. Entonces
\[ \widehat{\Pr}(\text{estacionario}\mid y) = \frac{1}{M} \sum_{m=1}^M I\left\{ \min_j|\zeta_j^{(m)}|>1 \right\}. \tag{5.28}\]
Prado, Ferreira y West utilizan precisamente esta idea para resumir la evidencia posterior de estacionariedad a partir de las raíces inducidas por cada muestra de los coeficientes (Prado et al. 2021, sec. 2.3.3).
es_estacionario_ar <- function(phi, tol = 1e-8) {
  raices <- polyroot(c(1, -as.numeric(phi)))

  if (length(raices) == 0L) {
    return(TRUE)
  }

  all(Mod(raices) > 1 + tol)
}
Para el AR(1), esta comprobación equivale a \(|\phi|<1\).
prob_est_ref_ar1 <- mean(abs(muestras_ref_ar1$phi) < 1)
prob_est_conj_ar1 <- mean(abs(muestras_conj_ar1$phi) < 1)

tibble(
  Analisis = c("Referencia", "Conjugado propio"),
  `Probabilidad posterior de estacionariedad` = c(
    prob_est_ref_ar1,
    prob_est_conj_ar1
  )
) |>
knitr::kable(digits = 4)| Analisis | Probabilidad posterior de estacionariedad |
|---|---|
| Referencia | 1 |
| Conjugado propio | 1 |
5.7.2 Estrategia B: imponer la estacionariedad desde la priori
Otra opción es definir
\[ p(\boldsymbol\phi)=0 \qquad \text{fuera de la región estacionaria}. \tag{5.29}\]
En un AR(1), por ejemplo, una priori truncada sobre \((-1,1)\) asigna probabilidad uno a modelos estacionarios. En un AR(\(p\)), la región es conjunta y su geometría puede ser más complicada.
Prado, Ferreira y West señalan que, en simulación, una aproximación simple consiste en generar desde la posterior no restringida y rechazar los valores no estacionarios cuando la tasa de rechazo es baja (Prado et al. 2021, sec. 2.3.3). Si la posterior no restringida coloca mucha masa fuera de la región estacionaria, ese rechazo se vuelve ineficiente y, más importante, puede ser una señal de que la hipótesis de estacionariedad merece reconsiderarse.
ImportanteImponer estacionariedad y encontrar evidencia de estacionariedad son cosas distintas
Si la priori tiene soporte únicamente en la región estacionaria, entonces la probabilidad posterior de estacionariedad será uno por construcción. Eso no debe reportarse como si los datos hubieran demostrado estacionariedad. La pregunta apropiada cambia: dentro de la clase de modelos estacionarios, ¿qué valores son plausibles después de observar los datos?
5.7.3 Visualización para un AR(2)
Simularemos un AR(2) con coeficientes \((1.5,-0.75)\), ejemplo utilizado en Sección 2.9.2, y superpondremos muestras posteriores sobre la región estacionaria.
set.seed(419)

phi_ar2 <- c(1.5, -0.75)
T_ar2 <- 180L

x_ar2 <- as.numeric(
  stats::arima.sim(
    model = list(ar = phi_ar2),
    n = T_ar2,
    sd = 1
  )
)

D_ar2 <- construir_diseno_ar(x_ar2, p = 2)
post_ref_ar2 <- posterior_referencia_ar(D_ar2$y, D_ar2$X)

M_ar2 <- 4000L
set.seed(420)

v_ref_ar2 <- 1 / rgamma(
  M_ar2,
  shape = post_ref_ar2$nu / 2,
  rate = post_ref_ar2$R / 2
)

Z_ar2 <- matrix(rnorm(M_ar2 * 3L), nrow = M_ar2, ncol = 3L)
A_ar2 <- Z_ar2 %*% chol(post_ref_ar2$C)
beta_draw_ar2 <- sweep(A_ar2 * sqrt(v_ref_ar2), 2, post_ref_ar2$beta, "+")

muestras_ar2 <- tibble(
  c = beta_draw_ar2[, 1],
  phi1 = beta_draw_ar2[, 2],
  phi2 = beta_draw_ar2[, 3]
) |>
  mutate(
    Estacionario = map2_lgl(
      phi1,
      phi2,
      ~ es_estacionario_ar(c(.x, .y))
    )
  )
malla_ar2 <- tidyr::expand_grid(
phi1 = seq(-2.1, 2.1, length.out = 150),
phi2 = seq(-1.3, 1.3, length.out = 150)
) |>
mutate(
Estacionario = map2_lgl(
phi1,
phi2,
~ es_estacionario_ar(c(.x, .y))
)
)
ggplot() +
geom_tile(
data = malla_ar2,
aes(x = phi1, y = phi2, alpha = Estacionario)
) +
scale_alpha_manual(values = c(`FALSE` = 0.08, `TRUE` = 0.28), guide = "none") +
geom_point(
data = muestras_ar2 |> slice_sample(n = 1200),
aes(x = phi1, y = phi2, shape = Estacionario),
alpha = 0.45,
size = 1.2
) +
geom_point(
aes(x = phi_ar2[1], y = phi_ar2[2]),
size = 3
) +
labs(
x = "phi1",
y = "phi2",
shape = "Estacionario",
title = "La restricción es conjunta"
)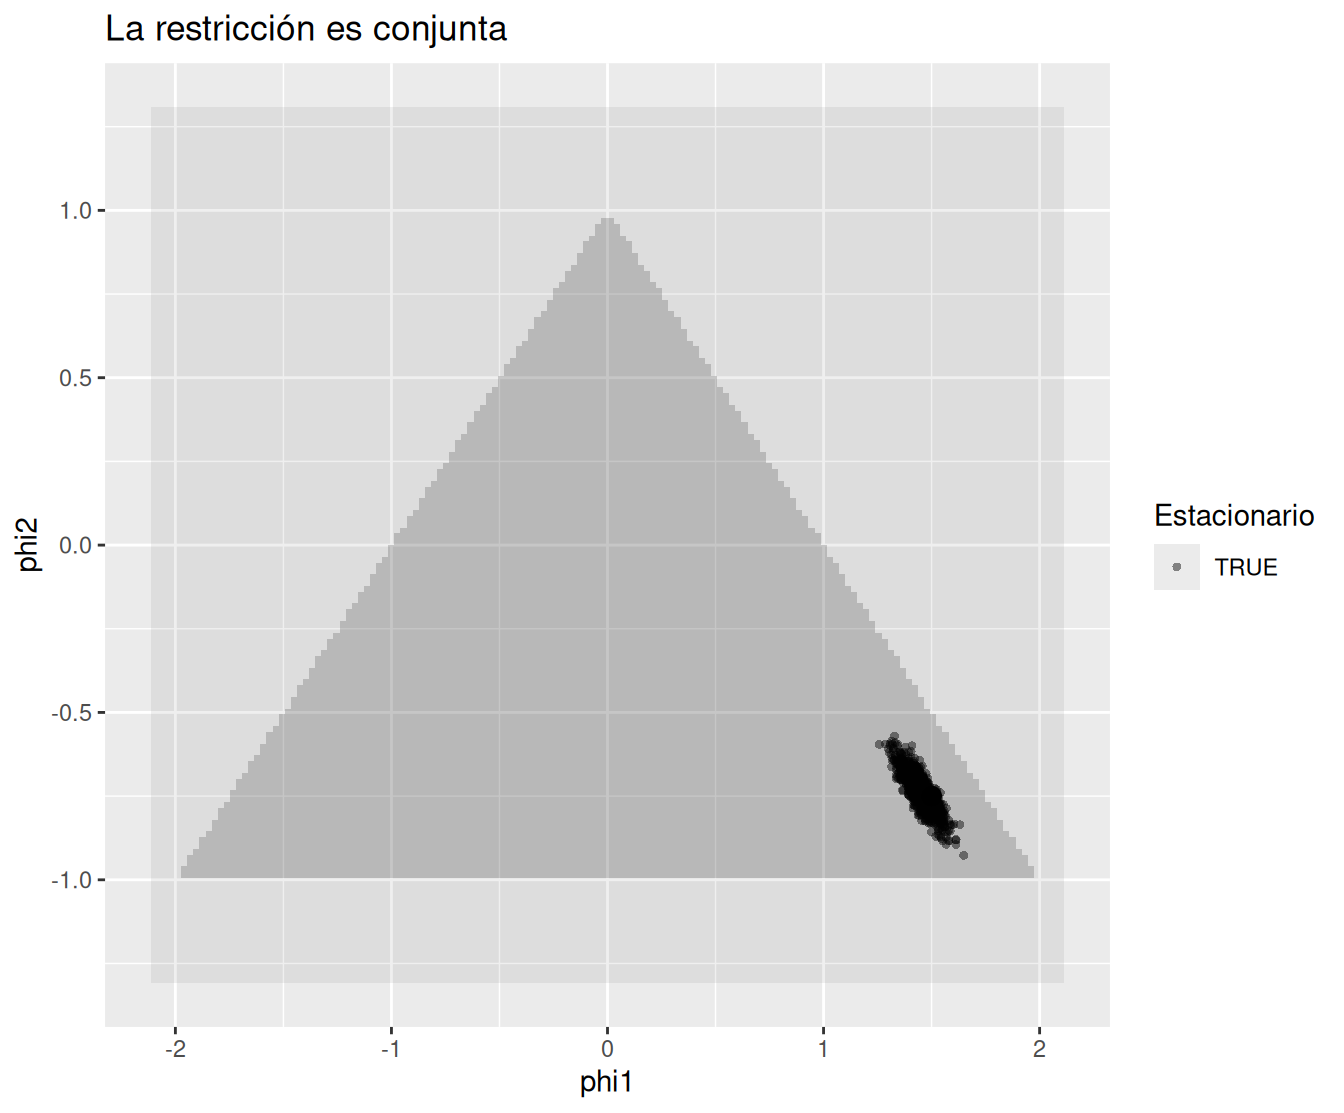
La Figura 5.3 ilustra por qué intervalos marginales separados para \(\phi_1\) y \(\phi_2\) no bastan para decidir estacionariedad. La propiedad se evalúa sobre el vector completo.
5.8 Simulación directa de la posterior
Cuando la posterior tiene forma conocida, podemos generar muestras independientes sin construir una cadena de Markov. Para la posterior de referencia:
- generar
\[ v^{(m)} \sim \operatorname{IG}(\nu/2,R/2); \]
- generar
\[ \boldsymbol\beta^{(m)} \mid v^{(m)},\mathbf y \sim N_k\left( \widehat{\boldsymbol\beta}, v^{(m)}(\mathbf X^\top\mathbf X)^{-1} \right). \]
El procedimiento utilizado en Sección 5.6 y Sección 5.7.3 sigue exactamente esta lógica. Las muestras no forman una cadena y, por tanto, no requieren burn-in ni diagnóstico de convergencia MCMC.
AdvertenciaMonte Carlo no es sinónimo de MCMC
“Monte Carlo” significa aproximar integrales o distribuciones mediante simulación. MCMC es una familia particular de algoritmos Monte Carlo que produce una cadena dependiente cuya distribución estacionaria es la posterior objetivo. Si podemos simular directamente de la posterior, MCMC sería innecesario.
5.9 MCMC cuando la posterior deja de ser cómoda
MCMC se vuelve útil cuando introducimos prioris no conjugadas, restricciones o estructuras para las cuales ya no podemos muestrear directamente de una distribución estándar. El curso asume conocimientos previos de MCMC; aquí nos interesa ver cómo reaparecen en una serie temporal.
Considere de nuevo el AR(1) de media cero
\[ Y_t=\phi Y_{t-1}+\varepsilon_t, \qquad \varepsilon_t\sim N(0,v), \]
pero especifiquemos
\[ \phi\sim N(0,0.7^2)I(-1<\phi<1), \tag{5.30}\]
\[ v\sim\operatorname{IG}(2,1). \tag{5.31}\]
La priori de \(\phi\) impone estacionariedad. Condicionado en \(\phi\), la distribución completa de \(v\) sigue siendo inversa-gamma. En cambio, la condicional de \(\phi\) es una normal truncada multiplicada por la verosimilitud; implementaremos un paso de Metropolis de caminata aleatoria dentro de un Gibbs parcial.
5.9.1 Algoritmo Metropolis-dentro-de-Gibbs
En la iteración \(m\):
- proponer
\[ \phi^*\sim N(\phi^{(m-1)},s_q^2); \]
- aceptar con probabilidad
\[ \alpha = \min\left\{ 1, \frac{ p(\mathbf y\mid\phi^*,v^{(m-1)})p(\phi^*) }{ p(\mathbf y\mid\phi^{(m-1)},v^{(m-1)})p(\phi^{(m-1)}) } \right\}; \tag{5.32}\]
- con el nuevo \(\phi^{(m)}\), generar
\[ v^{(m)} \sim \operatorname{IG}\left( 2+\frac{T-1}{2}, 1+\frac{1}{2} \sum_{t=2}^{T}(y_t-\phi^{(m)}y_{t-1})^2 \right). \tag{5.33}\]
El cociente de propuesta no aparece en Ecuación 5.32 porque la caminata normal es simétrica.
log_posterior_phi_ar1 <- function(phi, v, y, prior_sd = 0.7) {
  if (!is.finite(phi) || abs(phi) >= 1 || v <= 0) {
    return(-Inf)
  }

  e <- y[-1] - phi * y[-length(y)]

  -0.5 * length(e) * log(v) -
    sum(e^2) / (2 * v) +
    dnorm(phi, mean = 0, sd = prior_sd, log = TRUE)
}

mcmc_ar1_estacionario <- function(
    y,
    n_iter = 8000L,
    burn = 2000L,
    phi0 = 0,
    v0 = 1,
    proposal_sd = 0.04,
    a0 = 2,
    b0 = 1,
    cadena = 1L) {

  y <- as.numeric(y)
  stopifnot(n_iter > burn, abs(phi0) < 1, v0 > 0)

  phi <- numeric(n_iter)
  v <- numeric(n_iter)
  phi[1] <- phi0
  v[1] <- v0
  aceptadas <- 0L

  for (m in 2:n_iter) {
    propuesta <- rnorm(1, mean = phi[m - 1L], sd = proposal_sd)

    log_alpha <-
      log_posterior_phi_ar1(propuesta, v[m - 1L], y) -
      log_posterior_phi_ar1(phi[m - 1L], v[m - 1L], y)

    if (log(runif(1)) < log_alpha) {
      phi[m] <- propuesta
      aceptadas <- aceptadas + 1L
    } else {
      phi[m] <- phi[m - 1L]
    }

    e <- y[-1] - phi[m] * y[-length(y)]
    a_post <- a0 + length(e) / 2
    b_post <- b0 + sum(e^2) / 2

    v[m] <- 1 / rgamma(1, shape = a_post, rate = b_post)
  }

  tibble(
    cadena = factor(cadena),
    iteracion = seq_len(n_iter),
    phi = phi,
    sigma = sqrt(v),
    retenida = iteracion > burn,
    tasa_aceptacion = aceptadas / (n_iter - 1L)
  )
}
Generaremos cuatro cadenas a partir de valores iniciales diferentes sobre una serie corta y persistente. Elegimos \(\phi=0.95\) para hacer visible la interacción entre persistencia, frontera de estacionariedad y mezcla de la cadena.
set.seed(421)

T_mcmc <- 70L
phi_mcmc_verdadero <- 0.95

x_mcmc <- as.numeric(
  stats::arima.sim(
    model = list(ar = phi_mcmc_verdadero),
    n = T_mcmc,
    sd = 1
  )
)

inicios_phi <- c(-0.4, 0.2, 0.7, 0.95)

cadenas_ar1 <- map2_dfr(
  inicios_phi,
  seq_along(inicios_phi),
  ~ mcmc_ar1_estacionario(
    y = x_mcmc,
    phi0 = .x,
    v0 = 1,
    cadena = .y
  )
)

cadenas_post <- cadenas_ar1 |>
filter(retenida)ggplot(cadenas_post, aes(x = iteracion, y = phi)) +
geom_line(linewidth = 0.35, alpha = 0.75) +
facet_wrap(~cadena, ncol = 1) +
geom_hline(yintercept = phi_mcmc_verdadero, linetype = "dashed") +
labs(
x = "Iteración",
y = "phi",
title = "Diagnóstico visual de mezcla"
)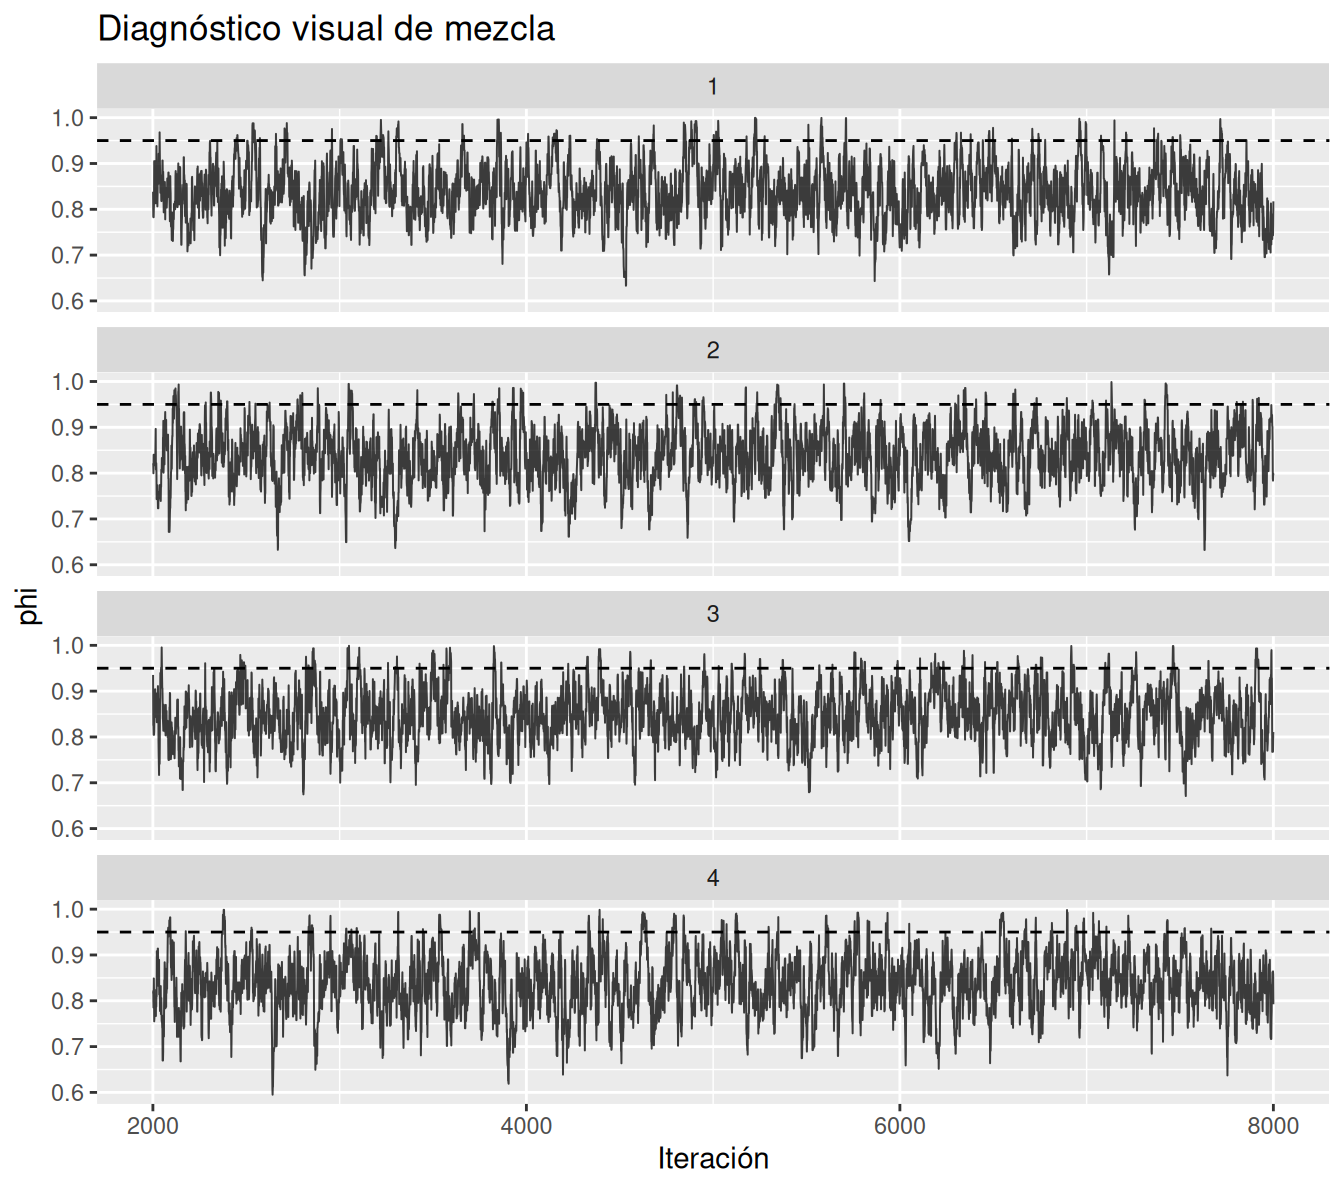
Una buena traza debería explorar repetidamente la región de alta posterior sin tendencias persistentes, cambios de nivel asociados al valor inicial ni cadenas atrapadas en regiones diferentes.
5.10 Diagnóstico de MCMC
El diagnóstico de MCMC responde una pregunta diferente al diagnóstico residual de Sección 4.11:
- diagnóstico del modelo temporal: ¿los residuales son compatibles con los supuestos del modelo?;
- diagnóstico del algoritmo MCMC: ¿la simulación representa de manera razonable la posterior objetivo?
Confundir ambos diagnósticos puede llevar a conclusiones equivocadas. Una cadena que converge perfectamente no convierte un modelo estadístico inadecuado en uno adecuado.
5.10.1 \(\widehat R\) clásico
Con \(M\) cadenas de longitud \(N\), sea \(\bar\theta_m\) la media de la cadena \(m\). Definimos la variabilidad entre cadenas
\[ B = N\,\operatorname{Var}(\bar\theta_1,\ldots,\bar\theta_M), \]
y la variabilidad promedio dentro de cadenas
\[ W = \frac{1}{M}\sum_{m=1}^M s_m^2. \]
Una estimación combinada de la varianza es
\[ \widehat V = \frac{N-1}{N}W+\frac{1}{N}B, \]
y el diagnóstico clásico es
\[ \widehat R = \sqrt{\frac{\widehat V}{W}}. \tag{5.34}\]
Valores cercanos a uno indican que las escalas entre y dentro de cadenas son similares. En aplicaciones modernas se prefieren versiones split y normalizadas por rangos; el cálculo siguiente se presenta para transparentar la idea, no para reemplazar software especializado.
5.10.2 Tamaño efectivo de muestra
Las muestras sucesivas de una cadena están autocorrelacionadas. Una aproximación conceptual es
\[ N_{\text{eff}} \approx \frac{N}{1+2\sum_{h\geq1}\rho_h}, \tag{5.35}\]
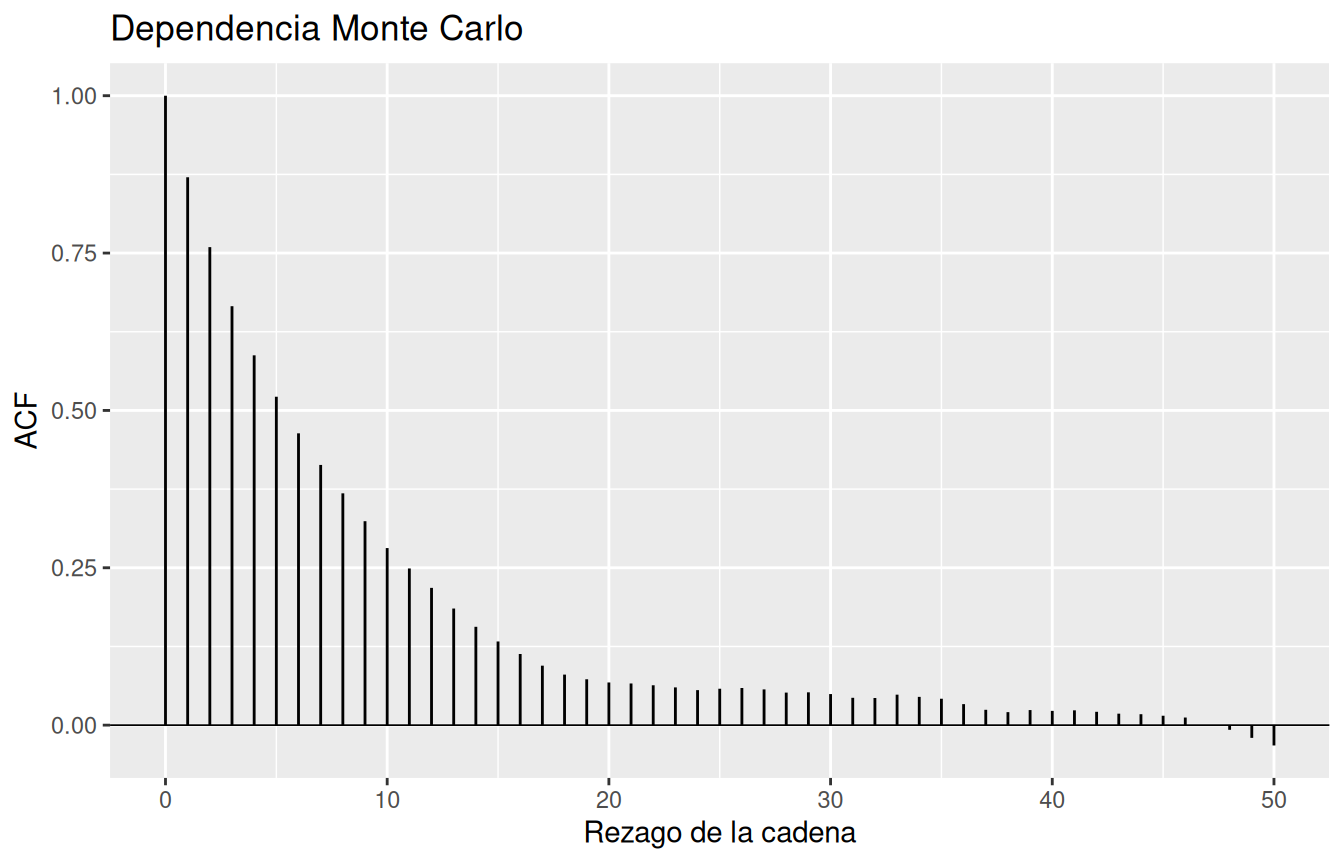
por lo que una cadena larga puede contener mucha menos información Monte Carlo que una muestra independiente del mismo tamaño.
rhat_clasico <- function(datos, variable) {
  wide <- datos |>
    select(cadena, iteracion, {{ variable }}) |>
    pivot_wider(names_from = cadena, values_from = {{ variable }}) |>
    arrange(iteracion)

  mat <- as.matrix(wide |> select(-iteracion))
  N <- nrow(mat)
  M <- ncol(mat)

  medias <- colMeans(mat)
  vars <- apply(mat, 2, var)

  B <- N * var(medias)
  W <- mean(vars)
  Vhat <- ((N - 1) / N) * W + B / N

  sqrt(Vhat / W)
}

ess_aproximado <- function(x, lag_max = 1000L) {
  x <- as.numeric(x)
  lag_max <- min(lag_max, length(x) - 1L)

  ac <- stats::acf(
    x,
    lag.max = lag_max,
    plot = FALSE,
    demean = TRUE
  )$acf |>
    as.numeric()

  rho <- ac[-1]

  if (length(rho) == 0L) {
    return(length(x))
  }

  primer_no_positivo <- which(rho <= 0)[1]

  if (is.na(primer_no_positivo)) {
    usar <- rho
  } else if (primer_no_positivo == 1L) {
    usar <- numeric(0)
  } else {
    usar <- rho[seq_len(primer_no_positivo - 1L)]
  }

  tau <- 1 + 2 * sum(usar)
  length(x) / max(tau, 1)
}| Parametro | Rhat | ESS aproximado | Tasa de aceptación media |
|---|---|---|---|
| phi | 1.003 | 1646.094 | 0.802 |
| sigma | 1.000 | 22796.600 | 0.802 |
phi_cadena_1 <- cadenas_post |>
  filter(cadena == levels(cadena)[1]) |>
  pull(phi)

acf_phi_mcmc <- stats::acf(
  phi_cadena_1,
  lag.max = 50,
  plot = FALSE
)

acf_phi_tbl <- tibble(
  h = 0:50,
  ACF = as.numeric(acf_phi_mcmc$acf)
)

ggplot(acf_phi_tbl, aes(x = h, y = ACF)) +
  geom_hline(yintercept = 0, linewidth = 0.3) +
  geom_segment(aes(xend = h, yend = 0)) +
  labs(
    x = "Rezago de la cadena",
    y = "ACF",
    title = "Dependencia Monte Carlo"
  )
NotaDiagnóstico moderno con
posterior
En un análisis de producción conviene utilizar implementaciones modernas de \(\widehat R\) y ESS, como las del paquete posterior. El siguiente bloque muestra el flujo equivalente y se deja sin ejecutar para no introducir una dependencia obligatoria adicional en la compilación del libro.
library(posterior)

phi_matrix <- cadenas_post |>
  select(cadena, iteracion, phi) |>
  pivot_wider(names_from = cadena, values_from = phi) |>
  arrange(iteracion) |>
  select(-iteracion) |>
  as.matrix()

posterior::rhat(phi_matrix)
posterior::ess_bulk(phi_matrix)
posterior::ess_tail(phi_matrix)
5.10.3 Implementación equivalente con cmdstanr
El algoritmo anterior hace visible cada paso. En aplicaciones más complejas, cmdstanr ofrece una implementación robusta de Hamiltonian Monte Carlo. El siguiente ejemplo expresa directamente la restricción \(-1<\phi<1\) en el parámetro de Stan. El código se presenta como una plantilla y no se ejecuta al compilar estas notas.
library(cmdstanr)
library(posterior)

stan_ar1 <- '
data {
  int<lower=2> T;
  vector[T] y;
}
parameters {
  real<lower=-1, upper=1> phi;
  real<lower=0> sigma;
}
model {
  phi ~ normal(0, 0.7);
  sigma ~ normal(0, 1);

  for (t in 2:T) {
    y[t] ~ normal(phi * y[t - 1], sigma);
  }
}
generated quantities {
  real y_next = normal_rng(phi * y[T], sigma);
}
'

archivo_stan <- cmdstanr::write_stan_file(stan_ar1)
modelo_stan <- cmdstanr::cmdstan_model(archivo_stan)

ajuste_stan <- modelo_stan$sample(
  data = list(T = length(x_mcmc), y = x_mcmc),
  seed = 415,
  chains = 4,
  parallel_chains = 4
)

ajuste_stan$summary(c("phi", "sigma", "y_next"))
TipPara profundizar: Hamiltonian Monte Carlo
El desarrollo detallado de Hamiltonian Monte Carlo (HMC) está fuera del alcance de este capítulo. Para una introducción conceptual especialmente recomendable, véase (Betancourt 2017). Un tratamiento clásico y más detallado aparece en (Neal 2011). Para comprender el algoritmo NUTS (No-U-Turn Sampler), utilizado por Stan para adaptar automáticamente la longitud de las trayectorias de HMC, véase (Hoffman y Gelman 2014).
Quienes estén interesados específicamente en la implementación utilizada por Stan pueden consultar también el Stan Reference Manual, en la sección dedicada a HMC y NUTS.
5.11 Distribución predictiva posterior
El pronóstico bayesiano integra la incertidumbre paramétrica:
\[ p(y_{T+h}\mid y_{1:T}) = \int p(y_{T+h}\mid\boldsymbol\vartheta,y_{1:T}) \,p(\boldsymbol\vartheta\mid y_{1:T}) \,d\boldsymbol\vartheta. \tag{5.36}\]
Para un AR(\(p\)), \(\boldsymbol\vartheta=(\boldsymbol\beta,\sigma_\varepsilon^2)\). La integral rara vez necesita evaluarse analíticamente: una muestra posterior permite construir una muestra predictiva.
Para \(m=1,\ldots,M\):
- generar
\[ (\boldsymbol\beta^{(m)},v^{(m)}) \sim p(\boldsymbol\beta,v\mid y_{1:T}); \]
- generar recursivamente
\[ y_{T+h}^{(m)} = c^{(m)} + \sum_{j=1}^p \phi_j^{(m)}y_{T+h-j}^{(m)} + \varepsilon_{T+h}^{(m)}, \tag{5.37}\]
con
\[ \varepsilon_{T+h}^{(m)}\sim N(0,v^{(m)}). \]
Cuando \(T+h-j\leq T\), se utiliza el valor observado correspondiente; cuando ya hemos avanzado en el futuro, se utiliza el valor simulado en esa misma trayectoria. Prado, Ferreira y West utilizan este mecanismo para producir muestras de la distribución predictiva conjunta y mostrar cómo la incertidumbre en los parámetros se incorpora automáticamente (Prado et al. 2021, sec. 2.3.3).
simular_predictiva_ar <- function(beta_draws, v_draws, historial, h) {
  beta_draws <- as.matrix(beta_draws)
  v_draws <- as.numeric(v_draws)
  historial <- as.numeric(historial)

  M <- nrow(beta_draws)
  p <- ncol(beta_draws) - 1L

  stopifnot(
    length(v_draws) == M,
    length(historial) >= p,
    h >= 1L
  )

  futuros <- matrix(NA_real_, nrow = M, ncol = h)

  for (m in seq_len(M)) {
    historia_m <- historial

    for (hh in seq_len(h)) {
      lags <- rev(tail(historia_m, p))
      media_m <- beta_draws[m, 1] + sum(beta_draws[m, -1] * lags)
      nuevo <- rnorm(1, mean = media_m, sd = sqrt(v_draws[m]))

      futuros[m, hh] <- nuevo
      historia_m <- c(historia_m, nuevo)
    }
  }

  futuros
}
5.11.1 Dos fuentes de incertidumbre
En Ecuación 5.37 hay dos componentes aleatorios:
- incertidumbre de innovación: incluso con parámetros conocidos, las futuras \(\varepsilon_{T+h}\) son desconocidas;
- incertidumbre paramétrica: \(c\), \(\phi_j\) y \(\sigma_\varepsilon^2\) tampoco son conocidos y se integran mediante la posterior.
Podemos aislar ambos efectos en el AR(1) simulado. Primero fijamos los parámetros en estimaciones puntuales y simulamos solamente innovaciones. Luego simulamos parámetros e innovaciones.
h_ar1 <- 20L
M_pred_ar1 <- 4000L

# Predicción plug-in: parámetros fijos en estimaciones de referencia
beta_plugin_ar1 <- matrix(
  c(0, post_ref_ar1$beta[1]),
  nrow = 1
)

# Para reutilizar la función con intercepto, construimos una versión de dos columnas.
set.seed(422)

plugin_draws <- matrix(
  rep(c(0, post_ref_ar1$beta[1]), M_pred_ar1),
  nrow = M_pred_ar1,
  byrow = TRUE
)

v_plugin <- rep(post_ref_ar1$s2, M_pred_ar1)

pred_plugin_ar1 <- simular_predictiva_ar(
  beta_draws = plugin_draws,
  v_draws = v_plugin,
  historial = x_ar1,
  h = h_ar1
)

# Predicción posterior completa
set.seed(423)

v_post_pred_ar1 <- v_ref_ar1[seq_len(M_pred_ar1)]
phi_post_pred_ar1 <- phi_ref_ar1[seq_len(M_pred_ar1)]

beta_post_ar1 <- cbind(
  c = rep(0, M_pred_ar1),
  phi1 = phi_post_pred_ar1
)

pred_full_ar1 <- simular_predictiva_ar(
  beta_draws = beta_post_ar1,
  v_draws = v_post_pred_ar1,
  historial = x_ar1,
  h = h_ar1
)

resumir_pred <- function(mat, tipo) {
  tibble(
    h = seq_len(ncol(mat)),
    Inferior = apply(mat, 2, quantile, probs = 0.025),
    Mediana = apply(mat, 2, median),
    Superior = apply(mat, 2, quantile, probs = 0.975),
    Tipo = tipo
  )
}

pred_comp_ar1 <- bind_rows(
  resumir_pred(pred_plugin_ar1, "Parámetros fijos"),
  resumir_pred(pred_full_ar1, "Posterior completa")
)ggplot(pred_comp_ar1, aes(x = h, y = Mediana, linetype = Tipo)) +
geom_ribbon(
aes(ymin = Inferior, ymax = Superior, group = Tipo),
alpha = 0.16,
inherit.aes = TRUE
) +
geom_line(linewidth = 0.8) +
labs(
x = "Horizonte h",
y = "Y futuro",
linetype = NULL,
title = "¿Qué añade la incertidumbre paramétrica?"
)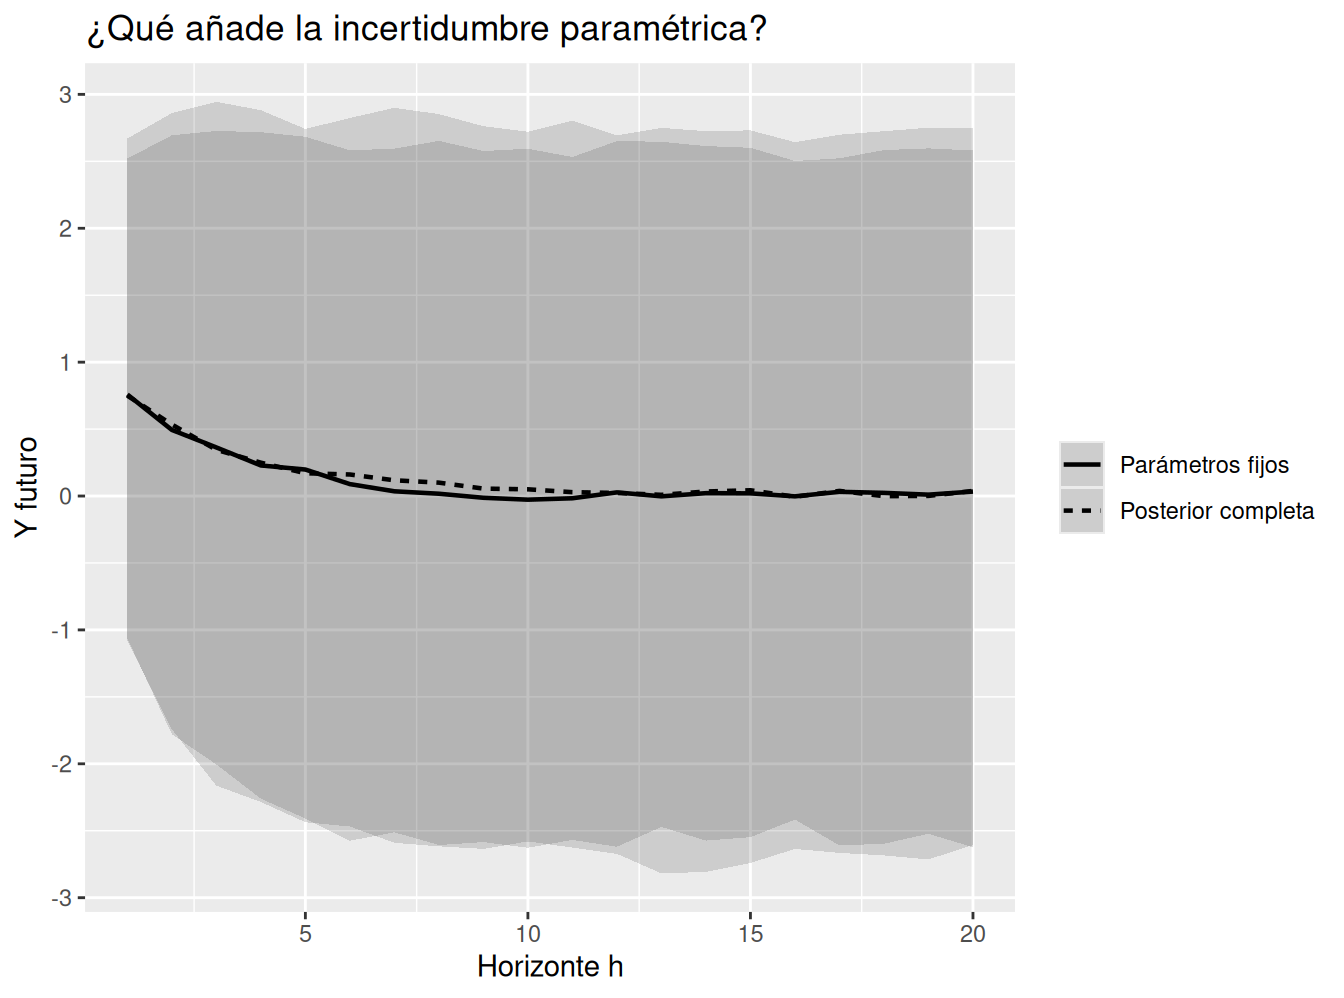
La posterior predictiva completa no tiene por qué ser dramáticamente distinta en toda aplicación. Cuando la muestra es grande y los parámetros están bien determinados, la incertidumbre paramétrica puede ser pequeña frente a la incertidumbre de las innovaciones. En series cortas o muy persistentes, la diferencia puede ser sustancial.
5.12 Intervalos frecuentistas y bayesianos
Es tentador comparar un intervalo frecuentista de pronóstico y un intervalo predictivo bayesiano únicamente por su anchura. Esa comparación es insuficiente porque sus interpretaciones no son idénticas.
En un enfoque frecuentista, un procedimiento de intervalos al \(95\%\) se interpreta por su comportamiento bajo repetición del experimento: en repeticiones hipotéticas, aproximadamente \(95\%\) de los intervalos construidos bajo las condiciones del método deberían cubrir el valor futuro correspondiente.
En un enfoque bayesiano, un intervalo predictivo posterior al \(95\%\) satisface
\[ \Pr\left( L_h\leq Y_{T+h}\leq U_h \mid y_{1:T} \right) =0.95 \tag{5.38}\]
bajo el modelo y la priori especificados.
NotaLa comparación útil es predictiva
Más adelante evaluaremos cobertura, amplitud y puntuaciones probabilísticas fuera de muestra. No basta con afirmar que un intervalo es “mejor” porque es más estrecho. Un intervalo estrecho con mala cobertura puede ser peor que uno moderadamente más ancho y bien calibrado.
5.13 Sensibilidad a la priori: información disponible y persistencia
Un análisis de sensibilidad estudia cuánto cambian las conclusiones posteriores cuando modificamos, dentro de un conjunto razonable de especificaciones, la distribución a priori.
Es importante no confundir dos fenómenos diferentes:
- la sensibilidad de la posterior de \(\phi\) a la priori;
- la sensibilidad de una cantidad predictiva como \(\phi^h\) a cambios en \(\phi\).
Que un proceso sea muy persistente, con \(\phi\) cercano a uno, puede hacer que pequeñas diferencias en \(\phi\) tengan consecuencias importantes para el pronóstico. Sin embargo, esto no implica automáticamente que la posterior de \(\phi\) sea sensible a la priori. Esa sensibilidad depende también de cuánta información aportan los datos.
Prado, Ferreira y West estudian explícitamente la sensibilidad a la elección de prioris para coeficientes autorregresivos. En particular, consideran prioris normales centradas en cero que inducen contracción y comparan las inferencias resultantes con un análisis de referencia (Prado et al. 2021, sec. 2.4.1). Un análisis de sensibilidad puede mostrar diferencias importantes, pero también puede mostrar que las inferencias son relativamente robustas frente a la priori.
5.13.1 ¿Cuándo puede importar la priori?
Para hacer transparente esta idea, consideremos nuevamente un AR(1) de media cero,
\[ Y_t=\phi Y_{t-1}+\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,v), \]
y supongamos momentáneamente que \(v\) es conocida.
Condicionado en un valor inicial \(y_0\), la log-verosimilitud de \(\phi\) basada en \(y_1,\ldots,y_T\) es, salvo una constante,
\[ \ell(\phi) = -\frac{1}{2v} \sum_{t=1}^T (y_t-\phi y_{t-1})^2. \]
Definamos
\[ S_{xx} = \sum_{t=1}^T y_{t-1}^2, \qquad S_{xy} = \sum_{t=1}^T y_ty_{t-1}. \]
El estimador condicional de mínimos cuadrados es
\[ \widehat\phi = \frac{S_{xy}}{S_{xx}}. \]
Para estudiar la forma de la verosimilitud como función de \(\phi\), expandamos
\[ \sum_{t=1}^T (y_t-\phi y_{t-1})^2. \]
Tenemos
\[ \begin{aligned} \sum_{t=1}^T (y_t-\phi y_{t-1})^2 &= \sum_{t=1}^T y_t^2 - 2\phi\sum_{t=1}^T y_ty_{t-1} + \phi^2\sum_{t=1}^T y_{t-1}^2\\ &= \sum_{t=1}^T y_t^2 - 2\phi S_{xy} + \phi^2S_{xx}. \end{aligned} \]
Como
\[ \widehat\phi=\frac{S_{xy}}{S_{xx}}, \]
podemos escribir
\[ S_{xx} (\phi-\widehat\phi)^2 = S_{xx}\phi^2 - 2\phi S_{xy} + S_{xx}\widehat\phi^2. \]
Por tanto,
\[ \sum_{t=1}^T (y_t-\phi y_{t-1})^2 = C^\star+ S_{xx}(\phi-\widehat\phi)^2, \]
donde \(C^\star\) no depende de \(\phi\). Sustituyendo en la log-verosimilitud,
\[ \ell(\phi) = C - \frac{S_{xx}}{2v} (\phi-\widehat\phi)^2, \tag{5.39}\]
donde \(C\) tampoco depende de \(\phi\).
Por tanto, considerada únicamente como función de \(\phi\), la verosimilitud tiene la forma de una densidad normal con centro \(\widehat\phi\) y varianza
\[ \frac{v}{S_{xx}}. \]
Esto sugiere medir la información de los datos sobre \(\phi\) mediante la precisión
\[ \mathcal I_L = \frac{S_{xx}}{v}. \tag{5.40}\]
Cuanto mayor sea \(S_{xx}/v\), más concentrada estará la verosimilitud alrededor de \(\widehat\phi\) y, en consecuencia, menos margen habrá para que la priori modifique la posterior.
Ahora supongamos, antes de imponer la restricción de estacionariedad, una priori normal
\[ \phi\sim N(m_0,s_0^2). \]
Su precisión es
\[ \mathcal I_0 = \frac{1}{s_0^2}. \]
La priori puede escribirse, omitiendo términos que no dependen de \(\phi\), como
\[ p(\phi) \propto \exp\left\{ -\frac{1}{2s_0^2} (\phi-m_0)^2 \right\}. \]
Al multiplicar verosimilitud y priori,
\[ p(\phi\mid\mathbf y) \propto \exp\left\{ -\frac{S_{xx}}{2v} (\phi-\widehat\phi)^2 - \frac{1}{2s_0^2} (\phi-m_0)^2 \right\}. \]
La posterior vuelve a ser normal. Su varianza es
\[ V_1 = \left( \frac{S_{xx}}{v} + \frac{1}{s_0^2} \right)^{-1} = \left( \mathcal I_L+\mathcal I_0 \right)^{-1}, \]
y su media es
\[ m_1 = V_1 \left( \frac{S_{xx}}{v}\widehat\phi + \frac{1}{s_0^2}m_0 \right). \]
Equivalentemente,
\[ m_1 = \frac{ \mathcal I_L\widehat\phi+ \mathcal I_0m_0 }{ \mathcal I_L+\mathcal I_0 }. \tag{5.41}\]
Esta última expresión permite interpretar la media posterior como un promedio ponderado entre dos fuentes de información:
- \(\widehat\phi\), que resume la información aportada por los datos;
- \(m_0\), que representa el centro de la información previa.
Los pesos están determinados por sus respectivas precisiones.
Si
\[ \mathcal I_L\gg\mathcal I_0, \]
los datos dominan y la elección de la priori tiene poco efecto. En cambio, si ambas precisiones son comparables, la posterior puede cambiar de manera apreciable al modificar la priori.
ImportanteUna muestra corta no necesariamente contiene poca información
El tamaño \(T\) no determina por sí solo cuánta información existe sobre \(\phi\). En Ecuación 5.40 la precisión depende de
\[ S_{xx} = \sum_{t=1}^T y_{t-1}^2. \]
Por ejemplo, un proceso AR(1) estacionario muy persistente puede presentar una varianza marginal elevada,
\[ \operatorname{Var}(Y_t) = \frac{v}{1-\phi^2}, \]
y producir valores relativamente grandes de \(S_{xx}\). En tal caso, incluso una muestra que parezca corta puede generar una verosimilitud muy concentrada.
Por esta razón, un experimento de sensibilidad debe examinar la información aportada por la verosimilitud y no solamente el número de observaciones.
5.13.2 Experimento controlado: pocos datos frente a muchos datos
Construiremos ahora un experimento específicamente diseñado para separar el efecto de la cantidad de información.
Simularemos una trayectoria de un AR(1) con
\[ \phi=0.95, \qquad v=1, \]
partiendo de un valor conocido \(Y_0=0\). Compararemos dos conjuntos de datos:
\[ T=10 \qquad\text{y}\qquad T=100. \]
La muestra de tamaño 10 corresponde a la primera parte de la misma trayectoria utilizada para la muestra de tamaño 100. De esta manera, la comparación representa la acumulación progresiva de información y no dos realizaciones independientes del proceso.
Utilizaremos tres prioris normales, todas restringidas posteriormente al intervalo estacionario \((-1,1)\):
- una priori débil centrada en cero;
- una priori que induce contracción hacia cero;
- una priori informativa que favorece alta persistencia.
Estas prioris se eligen deliberadamente para representar creencias previas diferentes. El objetivo del experimento no es afirmar que alguna de ellas sea universalmente preferible, sino estudiar cómo interactúan con la información proporcionada por los datos.
set.seed(424)

phi_sens <- 0.95
v_sens <- 1
T_max_sens <- 100L

simular_ar1_desde <- function(T, phi, v = 1, y0 = 0) {
  y <- numeric(T + 1L)
  y[1] <- y0

  innovaciones <- rnorm(
    T,
    mean = 0,
    sd = sqrt(v)
  )

  for (t in seq_len(T)) {
    y[t + 1L] <- phi * y[t] + innovaciones[t]
  }

  tibble(
    t = 0:T,
    y = y
  )
}

trayectoria_sens <- simular_ar1_desde(
  T = T_max_sens,
  phi = phi_sens,
  v = v_sens,
  y0 = 0
)

escenarios_sens <- tibble(
  Muestra = c("T = 10", "T = 100"),
  T = c(10L, 100L)
)

prioris_sens <- tribble(
  ~Priori, ~media, ~sd,
  "Débil N(0, 1.5²)",            0.0, 1.50,
  "Contracción N(0, 0.3²)",      0.0, 0.30,
  "Persistencia N(0.9, 0.15²)",  0.9, 0.15
)

rejilla_phi <- seq(
  -0.999,
  0.999,
  length.out = 4000
)

delta_phi <- rejilla_phi[2] - rejilla_phi[1]
Antes de calcular las posteriores, examinemos cuánta información aporta cada conjunto de datos.
info_sens <- map2_dfr(
  escenarios_sens$Muestra,
  escenarios_sens$T,
  function(Muestra, T_actual) {

    datos_T <- trayectoria_sens |>
      filter(t <= T_actual)

    y_anterior <- head(datos_T$y, -1)
    y_actual <- tail(datos_T$y, -1)

    Sxx <- sum(y_anterior^2)
    Sxy <- sum(y_actual * y_anterior)

    tibble(
      Muestra = Muestra,
      T = T_actual,
      Sxx = Sxx,
      Precision_datos = Sxx / v_sens,
      phi_hat = Sxy / Sxx
    )
  }
)

knitr::kable(
  info_sens,
  digits = 3,
  col.names = c(
    "Muestra",
    "T",
    "$S_{xx}$",
    "Precisión de los datos",
    "Estimación condicional de $\\phi$"
  )
)| Muestra | T | \(S_{xx}\) | Precisión de los datos | Estimación condicional de \(\phi\) |
|---|---|---|---|---|
| T = 10 | 10 | 33.462 | 33.462 | 0.880 |
| T = 100 | 100 | 863.754 | 863.754 | 0.953 |
La columna correspondiente a la precisión de los datos contiene la cantidad
\[ \frac{S_{xx}}{v} \]
de Ecuación 5.40.
Al pasar de \(T=10\) a \(T=100\), esta cantidad generalmente crecerá de manera sustancial, haciendo que la verosimilitud tenga cada vez mayor peso relativo frente a las prioris.
Para interpretar esta comparación también es útil examinar las precisiones nominales de las tres prioris normales:
\[ \begin{aligned} N(0,1.5^2): && \mathcal I_0 &= \frac{1}{1.5^2} \approx0.44,\\[4pt] N(0,0.3^2): && \mathcal I_0 &= \frac{1}{0.3^2} \approx11.11,\\[4pt] N(0.9,0.15^2): && \mathcal I_0 &= \frac{1}{0.15^2} \approx44.44. \end{aligned} \]
La primera es muy poco informativa en comparación con las otras dos. La segunda expresa una creencia relativamente fuerte en coeficientes próximos a cero, mientras que la tercera concentra la información previa en valores de alta persistencia.
Calculamos ahora las densidades posteriores sobre la rejilla
\[ -1<\phi<1. \]
La normalización dentro de este intervalo equivale a utilizar las tres distribuciones normales anteriores truncadas a la región estacionaria.
curvas_sens <- map2_dfr(
  escenarios_sens$Muestra,
  escenarios_sens$T,
  function(Muestra, T_actual) {

    datos_T <- trayectoria_sens |>
      filter(t <= T_actual)

    y_anterior <- head(datos_T$y, -1)
    y_actual <- tail(datos_T$y, -1)

    loglik <- map_dbl(
      rejilla_phi,
      function(phi) {
        errores <- y_actual - phi * y_anterior

        -0.5 / v_sens * sum(errores^2)
      }
    )

    pmap_dfr(
      prioris_sens,
      function(Priori, media, sd) {

        log_prior <- dnorm(
          rejilla_phi,
          mean = media,
          sd = sd,
          log = TRUE
        )

        # Priori normal restringida a (-1, 1)
        prior_sin_norm <- exp(
          log_prior - max(log_prior)
        )

        dens_prior <- prior_sin_norm /
          sum(prior_sin_norm * delta_phi)

        # Posterior restringida a (-1, 1)
        log_post <- loglik + log_prior

        post_sin_norm <- exp(
          log_post - max(log_post)
        )

        dens_post <- post_sin_norm /
          sum(post_sin_norm * delta_phi)

        tibble(
          phi = rejilla_phi,
          Muestra = Muestra,
          Priori = Priori,
          Dens_prior = dens_prior,
          Dens_post = dens_post
        )
      }
    )
  }
) |>
  mutate(
    Muestra = factor(
      Muestra,
      levels = escenarios_sens$Muestra
    ),
    Priori = factor(
      Priori,
      levels = prioris_sens$Priori
    )
  )
En lugar de mostrar únicamente las posteriores, compararemos en cada panel la priori y la posterior. Esto permite ver directamente cuánto aprendizaje producen los datos y cuánto permanece de la información previa.
curvas_sens |>
  pivot_longer(
    cols = c(Dens_prior, Dens_post),
    names_to = "Distribucion",
    values_to = "Densidad"
  ) |>
  mutate(
    Distribucion = recode(
      Distribucion,
      Dens_prior = "Priori",
      Dens_post = "Posterior"
    )
  ) |>
  ggplot(
    aes(
      x = phi,
      y = Densidad,
      linetype = Distribucion
    )
  ) +
  geom_line(linewidth = 0.8) +
  geom_vline(
    xintercept = phi_sens,
    linetype = "dotted"
  ) +
  facet_grid(
    Priori ~ Muestra,
    scales = "free_y"
  ) +
  scale_linetype_manual(
    values = c(
      Priori = "dashed",
      Posterior = "solid"
    )
  ) +
  labs(
    x = "phi",
    y = "Densidad",
    linetype = NULL,
    title = "La influencia de la priori disminuye al acumular información"
  ) +
  theme(
    legend.position = "bottom"
  )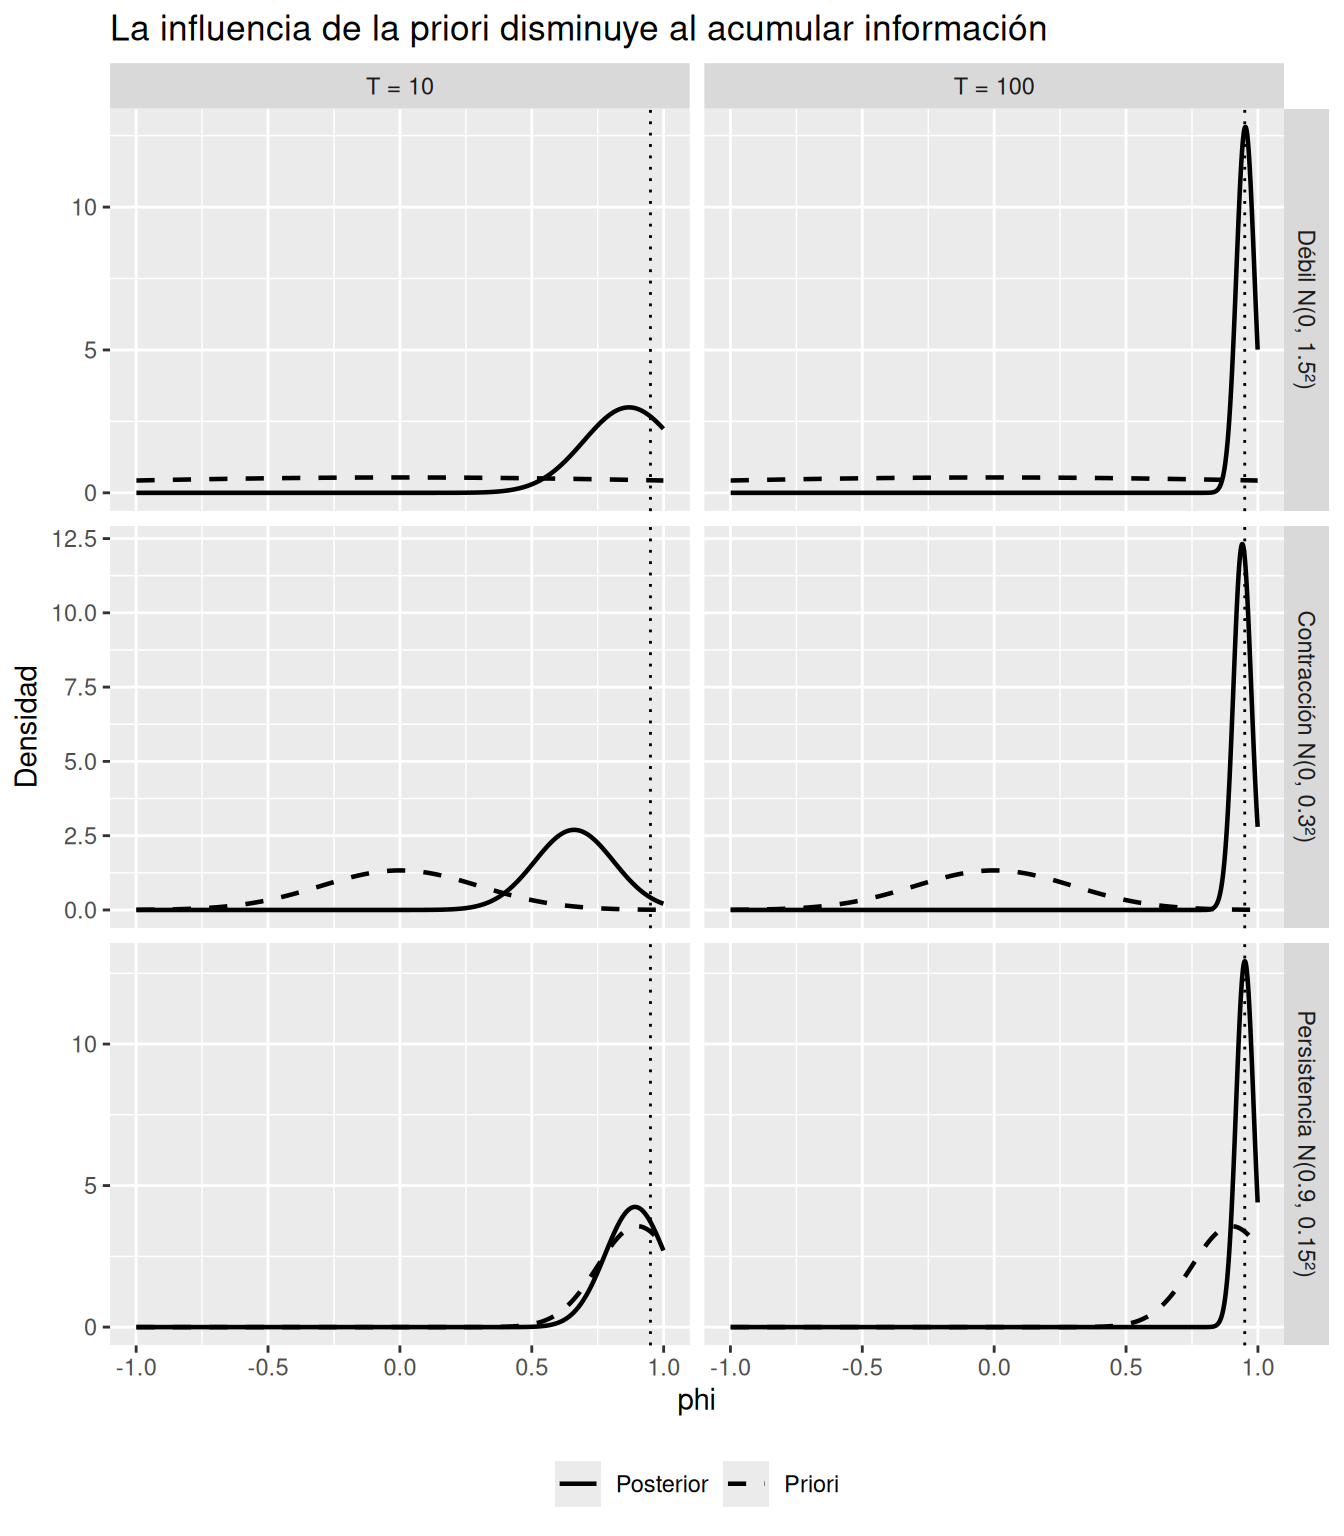
La figura debe interpretarse comparando tanto las curvas dentro de cada panel como las tres filas correspondientes a un mismo tamaño muestral.
Para \(T=10\), la información de la verosimilitud puede ser suficientemente limitada como para que las tres especificaciones previas produzcan posteriores diferentes. La priori de contracción favorece valores menores de \(\phi\), mientras que la priori de persistencia concentra más masa cerca de valores altos del coeficiente.
En cambio, cuando utilizamos \(T=100\), la verosimilitud generalmente se encuentra mucho más concentrada. En consecuencia, las tres posteriores tienden a acercarse entre sí. La información previa continúa formando parte del modelo, pero su influencia relativa disminuye frente a la información aportada por los datos.
La magnitud exacta de estas diferencias depende de la trayectoria simulada. Esto es deliberado: la información observada no está determinada únicamente por \(T\), sino también por los valores concretos de \(y_{t-1}\) que aparecen en \(S_{xx}\).
5.13.3 Resumen posterior
Para cuantificar las diferencias observadas en la figura, calcularemos la media posterior, un intervalo creíble del \(95\%\) y la esperanza posterior de \(\phi^{12}\).
Esta última cantidad permitirá conectar la sensibilidad paramétrica con sus consecuencias predictivas.
| Muestra | Priori | Estimación condicional | Prec. datos | Prec. priori | Media posterior | LI 95% | LS 95% | \(E(\phi^{12}\mid\mathbf y)\) |
|---|---|---|---|---|---|---|---|---|
| T = 10 | Débil N(0, 1.5²) | 0.880 | 33.462 | 0.444 | 0.803 | 0.514 | 0.989 | 0.200 |
| T = 10 | Contracción N(0, 0.3²) | 0.880 | 33.462 | 11.111 | 0.656 | 0.366 | 0.929 | 0.048 |
| T = 10 | Persistencia N(0.9, 0.15²) | 0.880 | 33.462 | 44.444 | 0.857 | 0.660 | 0.991 | 0.266 |
| T = 100 | Débil N(0, 1.5²) | 0.953 | 863.754 | 0.444 | 0.947 | 0.885 | 0.995 | 0.550 |
| T = 100 | Contracción N(0, 0.3²) | 0.953 | 863.754 | 11.111 | 0.938 | 0.874 | 0.992 | 0.494 |
| T = 100 | Persistencia N(0.9, 0.15²) | 0.953 | 863.754 | 44.444 | 0.946 | 0.884 | 0.994 | 0.542 |
La tabla permite comparar directamente la precisión aportada por los datos con la precisión de cada priori.
Cuando estas cantidades son del mismo orden, es razonable esperar que la elección de la priori tenga un efecto perceptible sobre la media y el intervalo creíble posterior. Por el contrario, cuando
\[ \frac{S_{xx}}{v} \gg \frac{1}{s_0^2}, \]
las diferencias entre prioris deberían tener una influencia mucho menor.
Esta comparación pone de manifiesto que hablar simplemente de una muestra “pequeña” o “grande” es insuficiente. Lo relevante es la cantidad de información que la muestra contiene acerca del parámetro de interés.
5.13.4 De la sensibilidad paramétrica a la sensibilidad predictiva
Hasta ahora hemos estudiado cuánto puede cambiar la posterior de \(\phi\) al modificar la priori. Sin embargo, para un problema de pronóstico debemos dar un paso adicional y preguntarnos si esas diferencias tienen consecuencias predictivas relevantes.
Para un AR(1) de media cero,
\[ E(Y_{T+h}\mid Y_T,\phi) = \phi^hY_T. \tag{5.42}\]
La cantidad
\[ \phi^h \]
controla cuánto persiste, \(h\) períodos hacia adelante, el efecto de la última observación.
Cuando \(|\phi|<1\),
\[ \phi^h\longrightarrow0 \qquad \text{cuando} \qquad h\longrightarrow\infty, \]
pero la rapidez con la que ocurre este decaimiento depende fuertemente de \(\phi\).
La derivada de \(\phi^h\) con respecto a \(\phi\) es
\[ \frac{d}{d\phi}\phi^h = h\phi^{h-1}. \tag{5.43}\]
Esta derivada permite medir localmente cuánto cambia \(\phi^h\) ante una pequeña modificación de \(\phi\).
Por ejemplo, para \(h=12\) y \(\phi=0.95\),
\[ 12(0.95)^{11} \approx 6.83. \]
Por tanto, alrededor de \(\phi=0.95\), un cambio relativamente pequeño en el coeficiente puede producir un cambio apreciablemente mayor en la persistencia a doce pasos.
Podemos verlo directamente comparando
\[ 0.93^{12}\approx0.419, \]
\[ 0.95^{12}\approx0.540, \]
y
\[ 0.97^{12}\approx0.694. \]
Aunque los valores \(0.93\), \(0.95\) y \(0.97\) parecen bastante próximos entre sí, sus efectos a doce períodos son sustancialmente diferentes.
Esto permite separar dos preguntas:
- ¿La posterior de \(\phi\) cambia de manera apreciable al modificar la priori?
- Si cambia, esas diferencias modifican de manera relevante el pronóstico?
La primera es una pregunta de sensibilidad inferencial. La segunda es una pregunta de sensibilidad predictiva.
En un curso donde el pronóstico constituye un eje transversal, la segunda es especialmente importante. Una diferencia posterior pequeña en un parámetro no debería juzgarse únicamente por su magnitud numérica; debemos analizar también sus consecuencias sobre las cantidades que finalmente queremos pronosticar.
5.13.5 Distribución posterior de la persistencia
La incertidumbre sobre \(\phi\) induce directamente incertidumbre sobre \(\phi^h\). Si
\[ \phi^{(1)},\ldots,\phi^{(M)} \]
son muestras de la posterior, entonces
\[ \left(\phi^{(1)}\right)^h, \ldots, \left(\phi^{(M)}\right)^h \]
constituyen muestras de la distribución posterior de la persistencia a horizonte \(h\).
En el experimento anterior hemos resumido esta distribución mediante
\[ E(\phi^{12}\mid\mathbf y), \]
pero también podríamos construir intervalos creíbles o visualizar su densidad completa.
Esta transformación es un ejemplo sencillo de una ventaja fundamental de la inferencia bayesiana: una vez que disponemos de muestras posteriores de los parámetros, podemos propagar su incertidumbre hacia prácticamente cualquier cantidad derivada de interés.
Por ejemplo, podemos visualizar las distribuciones posteriores inducidas para \(\phi^{12}\).
persistencia_sens <- curvas_sens |>
  transmute(
    Muestra,
    Priori,
    phi,
    persistencia = phi^12,
    peso = Dens_post * delta_phi
  )

ggplot(
  persistencia_sens,
  aes(
    x = persistencia,
    weight = peso
  )
) +
  geom_density(
    adjust = 1.2,
    linewidth = 0.8
  ) +
  geom_vline(
    xintercept = phi_sens^12,
    linetype = "dotted"
  ) +
  facet_grid(
    Priori ~ Muestra,
    scales = "free_y"
  ) +
  labs(
    x = expression(phi^12),
    y = "Densidad",
    title = "La incertidumbre sobre phi se propaga hacia la persistencia"
  )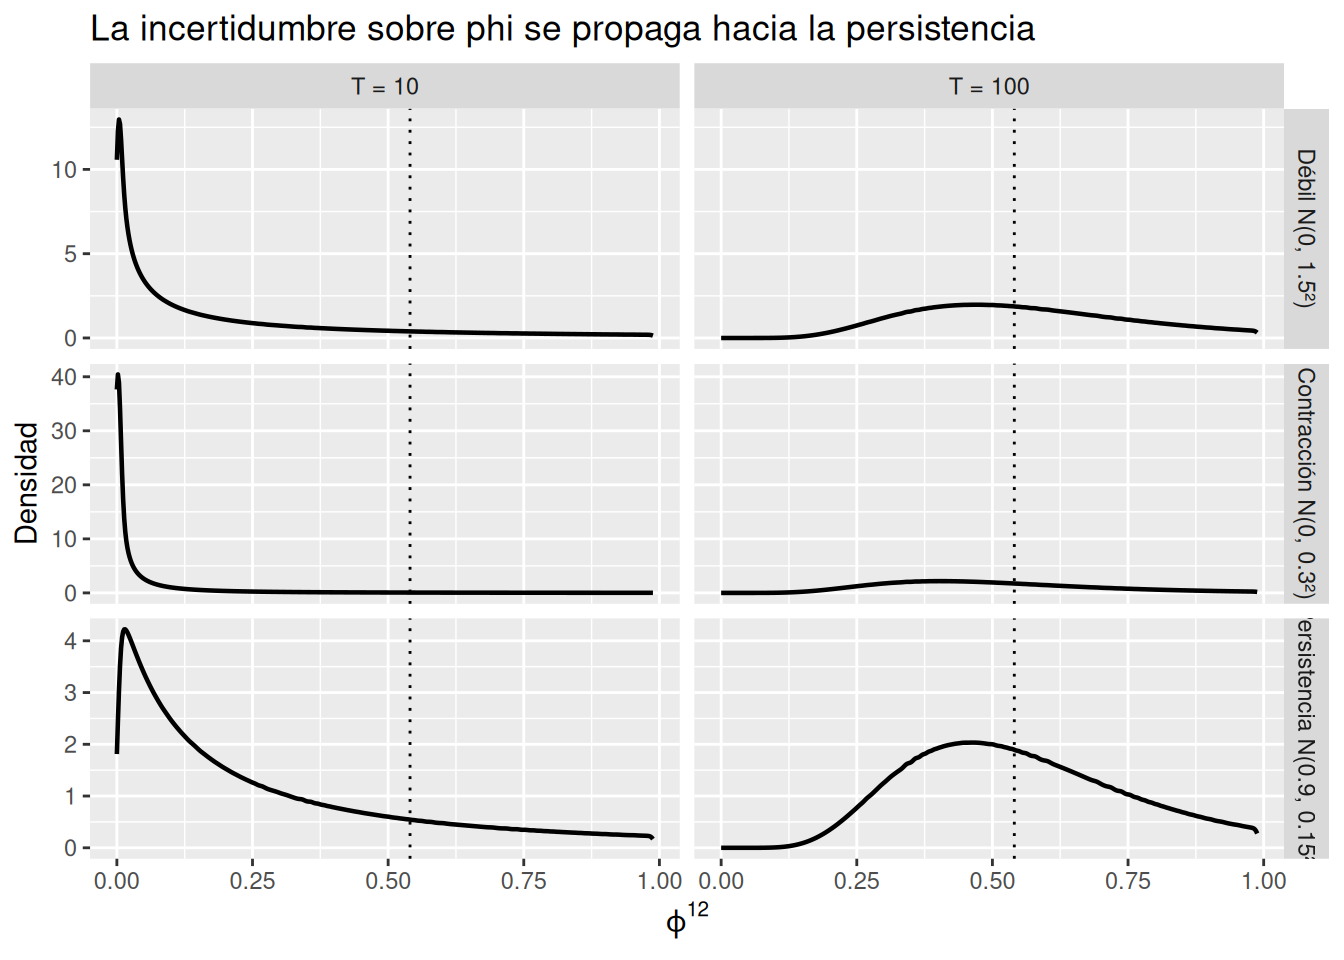
La línea vertical punteada corresponde al valor verdadero
\[ 0.95^{12}. \]
Con menor información, las diferencias entre las distribuciones posteriores de \(\phi\) pueden traducirse en diferencias más visibles en la persistencia a doce pasos. Con mayor información, las distribuciones tienden a concentrarse y a mostrar menor dependencia de la priori.
NotaUn análisis de sensibilidad también puede concluir robustez
El propósito de un análisis de sensibilidad no es producir artificialmente resultados diferentes bajo distintas prioris.
Si varias especificaciones previas razonables generan prácticamente la misma posterior, esto constituye evidencia de que las conclusiones son robustas frente a esas decisiones previas.
De hecho, en el análisis de Prado, Ferreira y West con prioris de contracción para coeficientes AR, la contracción observada no es dramática y las inferencias resultan relativamente robustas frente a las especificaciones consideradas (Prado et al. 2021, sec. 2.4.1).
Por tanto, existen dos conclusiones igualmente válidas de un análisis de sensibilidad:
\[ \boxed{ \text{las conclusiones cambian} \quad\Longrightarrow\quad \text{hay sensibilidad a la priori}, } \]
o bien
\[ \boxed{ \text{las conclusiones cambian poco} \quad\Longrightarrow\quad \text{hay robustez frente a la priori}. } \]
AdvertenciaSensibilidad no significa escoger la priori que produce el resultado preferido
El objetivo es evaluar qué conclusiones dependen fuertemente de decisiones razonables sobre la priori. Si una conclusión cambia mucho entre prioris defendibles, esa dependencia debe comunicarse como parte de la incertidumbre del análisis.
La elección de las prioris debe justificarse por consideraciones sustantivas, teóricas o predictivas, y no por cuál de ellas produce posteriormente el resultado más conveniente.
En síntesis, este experimento muestra que la sensibilidad a la priori depende de la información relativa aportada por los datos y por la distribución previa:
\[ \boxed{ \text{información de los datos} \quad\text{frente a}\quad \text{información de la priori}. } \]
Cuando los datos contienen poca información sobre \(\phi\), distintas prioris razonables pueden generar posteriores diferentes. Conforme se acumula información, la verosimilitud tiende a dominar y las diferencias disminuyen.
Además, cuando \(\phi\) está cerca de uno, diferencias que parecen pequeñas en la escala del parámetro pueden amplificarse al considerar cantidades como \(\phi^h\). Por esta razón, la sensibilidad debe estudiarse no solamente sobre los parámetros, sino también sobre las distribuciones predictivas y otras cantidades relevantes para el objetivo final del análisis.
5.14 Orden del modelo desde una perspectiva bayesiana
En la semana 4 utilizamos AIC, AICc y BIC. Desde una perspectiva bayesiana, podemos tratar el orden \(p\) como una cantidad desconocida y escribir
\[ p(p\mid y) \propto p(y\mid p)p(p), \tag{5.44}\]
con densidad marginal
\[ p(y\mid p) = \int p(y\mid\boldsymbol\beta_p,v,p) \,p(\boldsymbol\beta_p,v\mid p) \,d\boldsymbol\beta_p\,dv. \tag{5.45}\]
Aquí aparece una diferencia crítica respecto de la estimación dentro de un único modelo: para comparar modelos de distinta dimensión se necesitan prioris propias. La priori de referencia \(p(\boldsymbol\beta,v)\propto1/v\) es impropia y sus constantes arbitrarias impiden interpretar directamente Ecuación 5.45 como una probabilidad marginal comparable entre órdenes (Prado et al. 2021, sec. 2.3.4).
Además, si comparamos AR(1), AR(2) y AR(3) mediante verosimilitudes condicionales, debemos utilizar una muestra común. Si \(p^*=3\), podemos condicionar en los primeros tres valores y utilizar \(y_4,\ldots,y_T\) como respuesta para los tres modelos. Prado, Ferreira y West destacan esta precaución cuando comparan órdenes (Prado et al. 2021, sec. 2.3.4).
5.14.1 Tres niveles de comparación
En estas notas distinguiremos:
- exploración estructural: ACF, PACF, raíces y residuales;
- criterios frecuentistas: AICc y BIC, ya desarrollados en Sección 4.9;
- comparación bayesiana formal: probabilidades de modelo o factores de Bayes bajo prioris propias coherentes entre órdenes.
No desarrollaremos reversible-jump MCMC como contenido obligatorio. Prado, Ferreira y West lo presentan como una herramienta avanzada para incertidumbre de dimensión; aquí basta con reconocer qué problema resuelve y qué decisiones previas exige (Prado et al. 2021, sec. 2.7.1).
5.15 Aplicación: Recruitment bajo inferencia bayesiana
Retomaremos por cuarta vez la serie Recruitment. En Sección 2.12 estudiamos su dependencia y una representación AR; en Sección 3.15 contrastamos firmas AR, MA y ARMA; en Sección 4.14 comparamos estimadores, criterios de información y diagnóstico. Ahora preguntamos:
¿qué nos dice una distribución posterior sobre los coeficientes, la estacionariedad y los pronósticos de los modelos AR candidatos?
Shumway y Stoffer utilizan esta serie para ilustrar un AR(2) y muestran la cercanía entre Yule–Walker y estimación por verosimilitud (Shumway y Stoffer 2025, Examples 3.27 y 3.30). En lugar de fijar de antemano \(p=2\), conservaremos AR(1), AR(2) y AR(3) como candidatos.
5.15.1 Preparación de los datos
if (!requireNamespace("astsa", quietly = TRUE)) {
  stop(
    "El ejemplo de Recruitment requiere el paquete 'astsa'. ",
    "Instálelo antes de compilar este capítulo."
  )
}

rec_env_bayes <- new.env()
data("rec", package = "astsa", envir = rec_env_bayes)
rec_obj_bayes <- rec_env_bayes$rec

rec_bayes <- tibble(
  t = seq_along(rec_obj_bayes),
  Reclutamiento = as.numeric(rec_obj_bayes)
) |>
  as_tsibble(index = t)

x_rec_bayes <- rec_bayes$Reclutamiento

stopifnot(
  nrow(rec_bayes) > 100,
  !anyNA(x_rec_bayes),
  all(is.finite(x_rec_bayes))
)ggplot(rec_bayes, aes(x = t, y = Reclutamiento)) +
geom_line() +
labs(
x = "Mes",
y = "Reclutamiento",
title = "Recruitment"
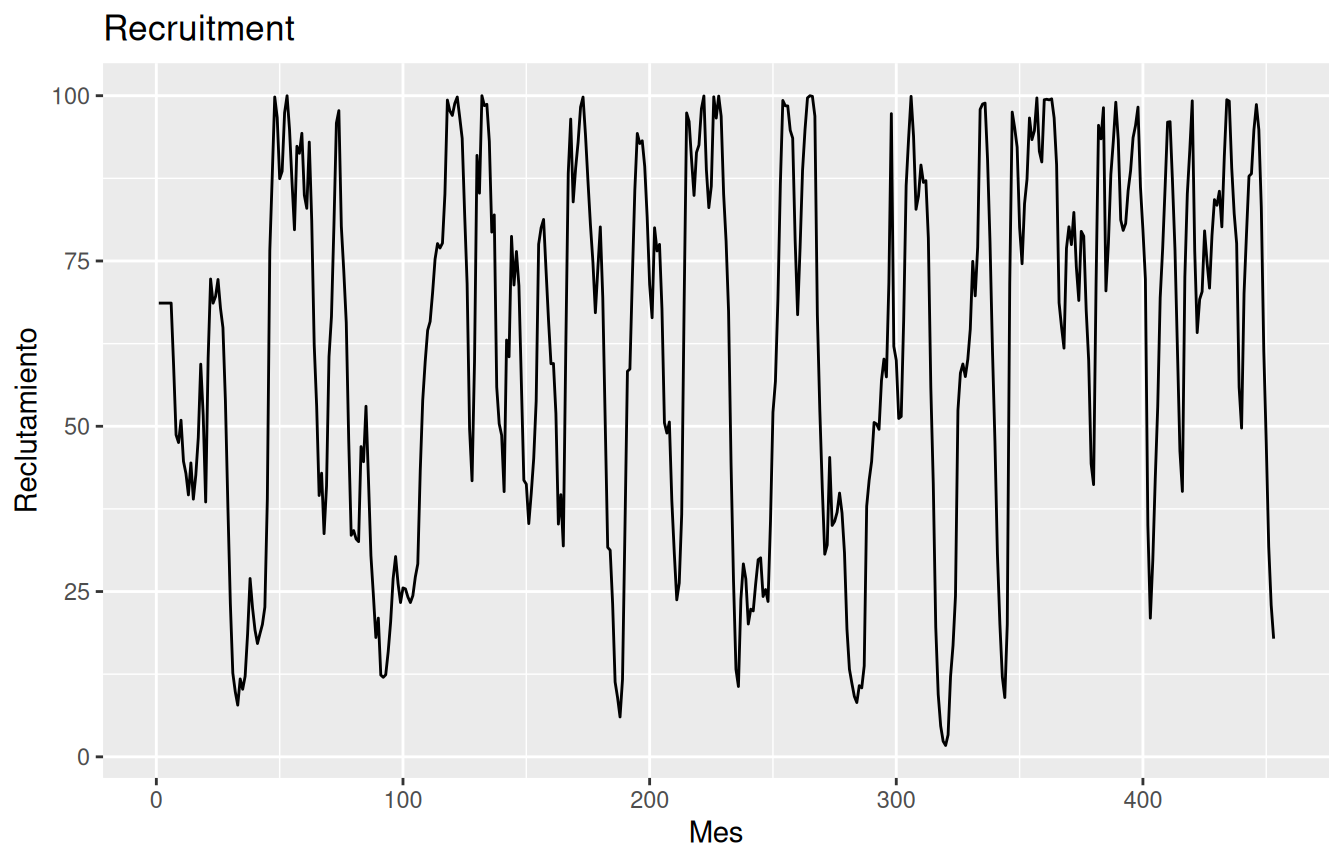
)
5.15.2 Una muestra común para AR(1), AR(2) y AR(3)
Fijamos \(p^*=3\) y utilizamos como respuestas \(y_4,\ldots,y_T\) en los tres modelos. El número de predictores cambia, pero la información temporal evaluada es la misma.
p_max_rec <- 3L
inicio_rec <- p_max_rec + 1L

modelos_rec_bayes <- tibble(p = 1:3) |>
  mutate(
    Diseno = map(
      p,
      ~ construir_diseno_ar(
        x = x_rec_bayes,
        p = .x,
        inicio = inicio_rec
      )
    ),
    Posterior = map(
      Diseno,
      ~ posterior_referencia_ar(.x$y, .x$X)
    )
  )
5.15.3 Muestras posteriores y probabilidad de estacionariedad
muestrear_referencia <- function(post, M = 5000L) {
  k <- length(post$beta)

  v <- 1 / rgamma(
    M,
    shape = post$nu / 2,
    rate = post$R / 2
  )

  Z <- matrix(rnorm(M * k), nrow = M, ncol = k)
  ruido <- Z %*% chol(post$C)
  beta <- sweep(ruido * sqrt(v), 2, post$beta, "+")

  list(beta = beta, v = v)
}

set.seed(425)

modelos_rec_bayes <- modelos_rec_bayes |>
  mutate(
    Muestras = map(Posterior, muestrear_referencia, M = 5000L),
    Prob_estacionaria = map2_dbl(
      Muestras,
      p,
      function(Muestras, p) {
        phis <- Muestras$beta[, 2:(p + 1L), drop = FALSE]
        mean(apply(phis, 1, es_estacionario_ar))
      }
    )
)| Modelo | Probabilidad posterior de estacionariedad |
|---|---|
| AR(1) | 1 |
| AR(2) | 1 |
| AR(3) | 1 |
Esta probabilidad es una propiedad de la posterior no restringida. Si hubiéramos truncado la priori a la región estacionaria, todos los valores de la última columna serían uno por construcción.
5.15.4 AR(2): comparación con máxima verosimilitud
Ajustaremos el mismo AR(2) por máxima verosimilitud para conectar con la semana 4. En el análisis bayesiano de referencia utilizamos la verosimilitud condicional con muestra común; por ello no esperamos coincidencia exacta con el ajuste arima(..., method = "ML"), que utiliza otra convención para la verosimilitud.
rec_ar2_ml_bayes <- stats::arima(
  x_rec_bayes,
  order = c(2, 0, 0),
  include.mean = TRUE,
  method = "ML"
)

fila_ar2_bayes <- modelos_rec_bayes |>
  filter(p == 2L)

muestra_ar2_rec <- fila_ar2_bayes$Muestras[[1]]

beta_ar2_rec <- as_tibble(muestra_ar2_rec$beta)
names(beta_ar2_rec) <- c("c", "phi1", "phi2")

resumen_post_ar2_rec <- beta_ar2_rec |>
  pivot_longer(everything(), names_to = "Parametro", values_to = "Valor") |>
  group_by(Parametro) |>
  summarise(
    Media_post = mean(Valor),
    Mediana_post = median(Valor),
    Inferior = quantile(Valor, 0.025),
    Superior = quantile(Valor, 0.975),
    .groups = "drop"
  )

ml_ar2_tbl <- tibble(
  Parametro = c("phi1", "phi2"),
  Estimacion_ML = unname(rec_ar2_ml_bayes$coef[c("ar1", "ar2")]),
  SE_ML = sqrt(diag(rec_ar2_ml_bayes$var.coef))[c("ar1", "ar2")]
)

comparacion_ar2_rec <- resumen_post_ar2_rec |>
  filter(Parametro %in% c("phi1", "phi2")) |>
  left_join(ml_ar2_tbl, by = "Parametro") |>
  mutate(
    Inferior_ML = Estimacion_ML - 1.96 * SE_ML,
    Superior_ML = Estimacion_ML + 1.96 * SE_ML
)| Parametro | Estimacion_ML | Inferior_ML | Superior_ML | Media_post | Inferior | Superior |
|---|---|---|---|---|---|---|
| phi1 | 1.351 | 1.270 | 1.433 | 1.354 | 1.273 | 1.438 |
| phi2 | -0.461 | -0.543 | -0.380 | -0.463 | -0.547 | -0.381 |
Los intervalos de Wald y los intervalos creíbles pueden ser numéricamente cercanos en muestras grandes, especialmente bajo una priori de referencia. Esa cercanía no elimina su diferencia conceptual.
5.15.5 Posterior conjunta del AR(2) y región estacionaria
muestra_ar2_plot <- beta_ar2_rec |>
  mutate(
    Estacionario = map2_lgl(
      phi1,
      phi2,
      ~ es_estacionario_ar(c(.x, .y))
    )
  ) |>
  slice_sample(n = min(2000L, nrow(beta_ar2_rec)))

rango_phi1 <- range(muestra_ar2_plot$phi1)
rango_phi2 <- range(muestra_ar2_plot$phi2)

malla_rec_ar2 <- expand_grid(
  phi1 = seq(rango_phi1[1] - 0.25, rango_phi1[2] + 0.25, length.out = 150),
  phi2 = seq(rango_phi2[1] - 0.25, rango_phi2[2] + 0.25, length.out = 150)
) |>
  mutate(
    Estacionario = map2_lgl(
      phi1,
      phi2,
      ~ es_estacionario_ar(c(.x, .y))
    )
  )

ggplot() +
  geom_tile(
    data = malla_rec_ar2,
    aes(x = phi1, y = phi2, alpha = Estacionario)
  ) +
  scale_alpha_manual(values = c(`FALSE` = 0.08, `TRUE` = 0.25), guide = "none") +
  geom_point(
    data = muestra_ar2_plot,
    aes(x = phi1, y = phi2, shape = Estacionario),
    alpha = 0.45,
    size = 1.1
  ) +
  labs(
    x = "phi1",
    y = "phi2",
    shape = "Estacionario",
    title = "Recruitment: incertidumbre conjunta de los coeficientes"
  )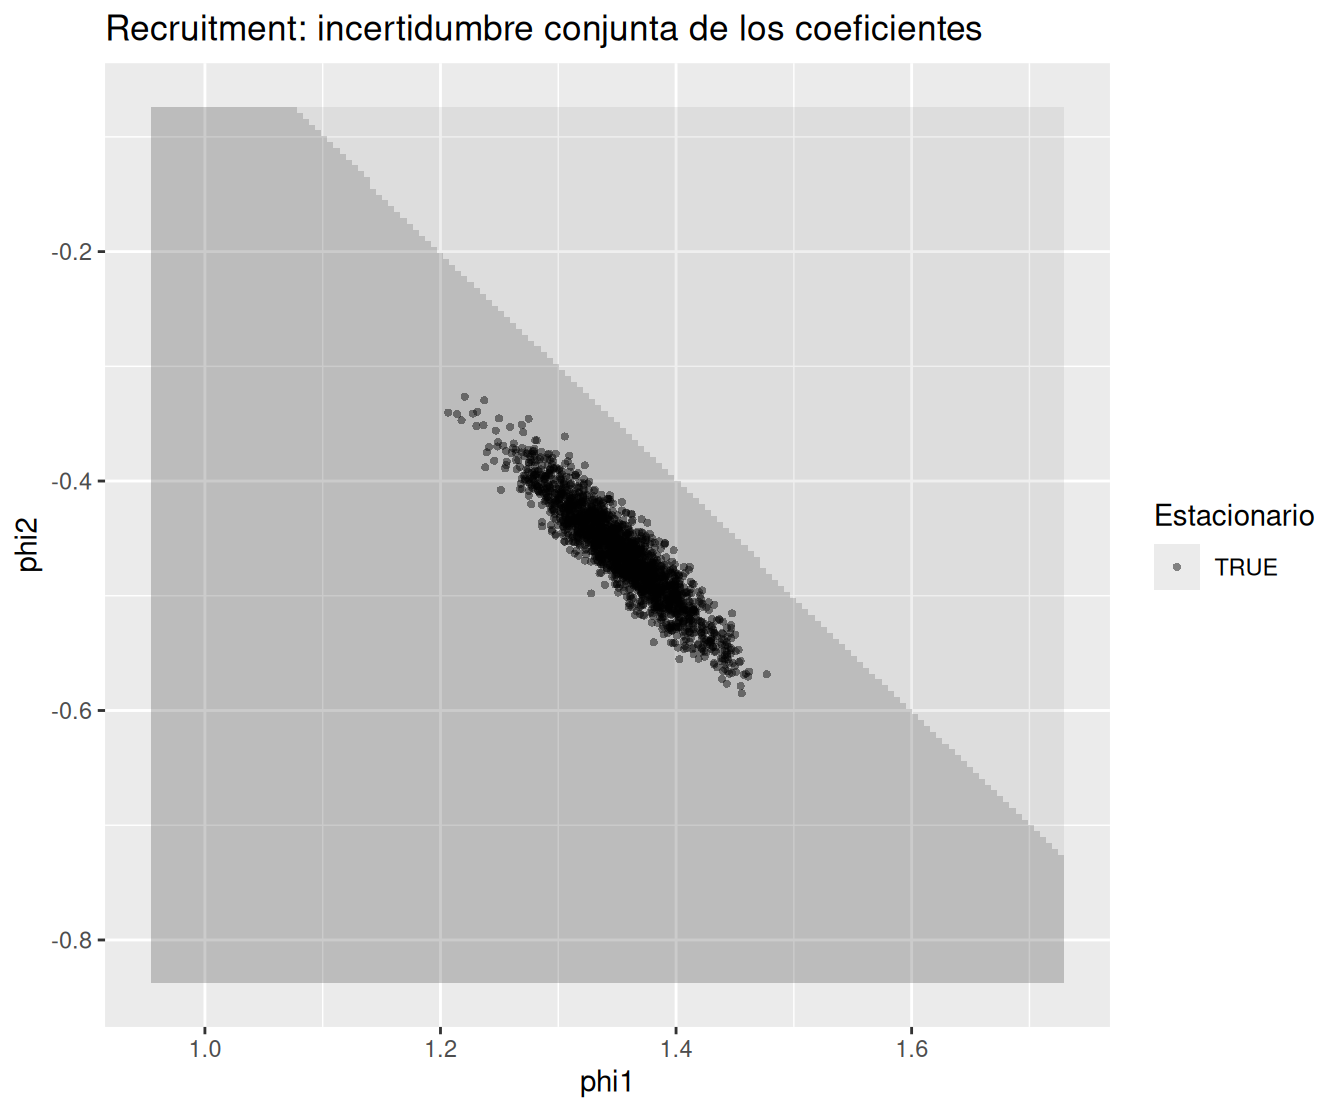
5.15.6 Distribución predictiva posterior para AR(2)
Construiremos un pronóstico a 24 meses con la posterior de referencia del AR(2). Para cada muestra posterior, generamos una trayectoria futura completa.
M_pred_rec <- 4000L
h_rec_bayes <- 24L

set.seed(426)

beta_pred_rec <- muestra_ar2_rec$beta[seq_len(M_pred_rec), , drop = FALSE]
v_pred_rec <- muestra_ar2_rec$v[seq_len(M_pred_rec)]

pred_rec_bayes <- simular_predictiva_ar(
  beta_draws = beta_pred_rec,
  v_draws = v_pred_rec,
  historial = x_rec_bayes,
  h = h_rec_bayes
)

resumen_pred_rec <- tibble(
  h = seq_len(h_rec_bayes),
  Mediana = apply(pred_rec_bayes, 2, median),
  Inferior = apply(pred_rec_bayes, 2, quantile, probs = 0.025),
  Superior = apply(pred_rec_bayes, 2, quantile, probs = 0.975)
)
Para la referencia frecuentista, utilizaremos el AR(2) ML y el error estándar de pronóstico devuelto por predict().
pred_rec_freq <- predict(
  rec_ar2_ml_bayes,
  n.ahead = h_rec_bayes
)

resumen_freq_rec <- tibble(
  h = seq_len(h_rec_bayes),
  Media = as.numeric(pred_rec_freq$pred),
  Inferior = Media - 1.96 * as.numeric(pred_rec_freq$se),
  Superior = Media + 1.96 * as.numeric(pred_rec_freq$se)
)
plot_bayes_rec <- resumen_pred_rec |>
transmute(
h,
Centro = Mediana,
Inferior,
Superior,
Metodo = "Bayesiano"
)
plot_freq_rec <- resumen_freq_rec |>
transmute(
h,
Centro = Media,
Inferior,
Superior,
Metodo = "Frecuentista"
)
bind_rows(plot_bayes_rec, plot_freq_rec) |>
ggplot(aes(x = h, y = Centro)) +
geom_ribbon(aes(ymin = Inferior, ymax = Superior), alpha = 0.18) +
geom_line() +
facet_wrap(~Metodo, ncol = 1) +
labs(
x = "Horizonte h",
y = "Reclutamiento",
title = "Mismo modelo AR(2), dos tratamientos de la incertidumbre"
)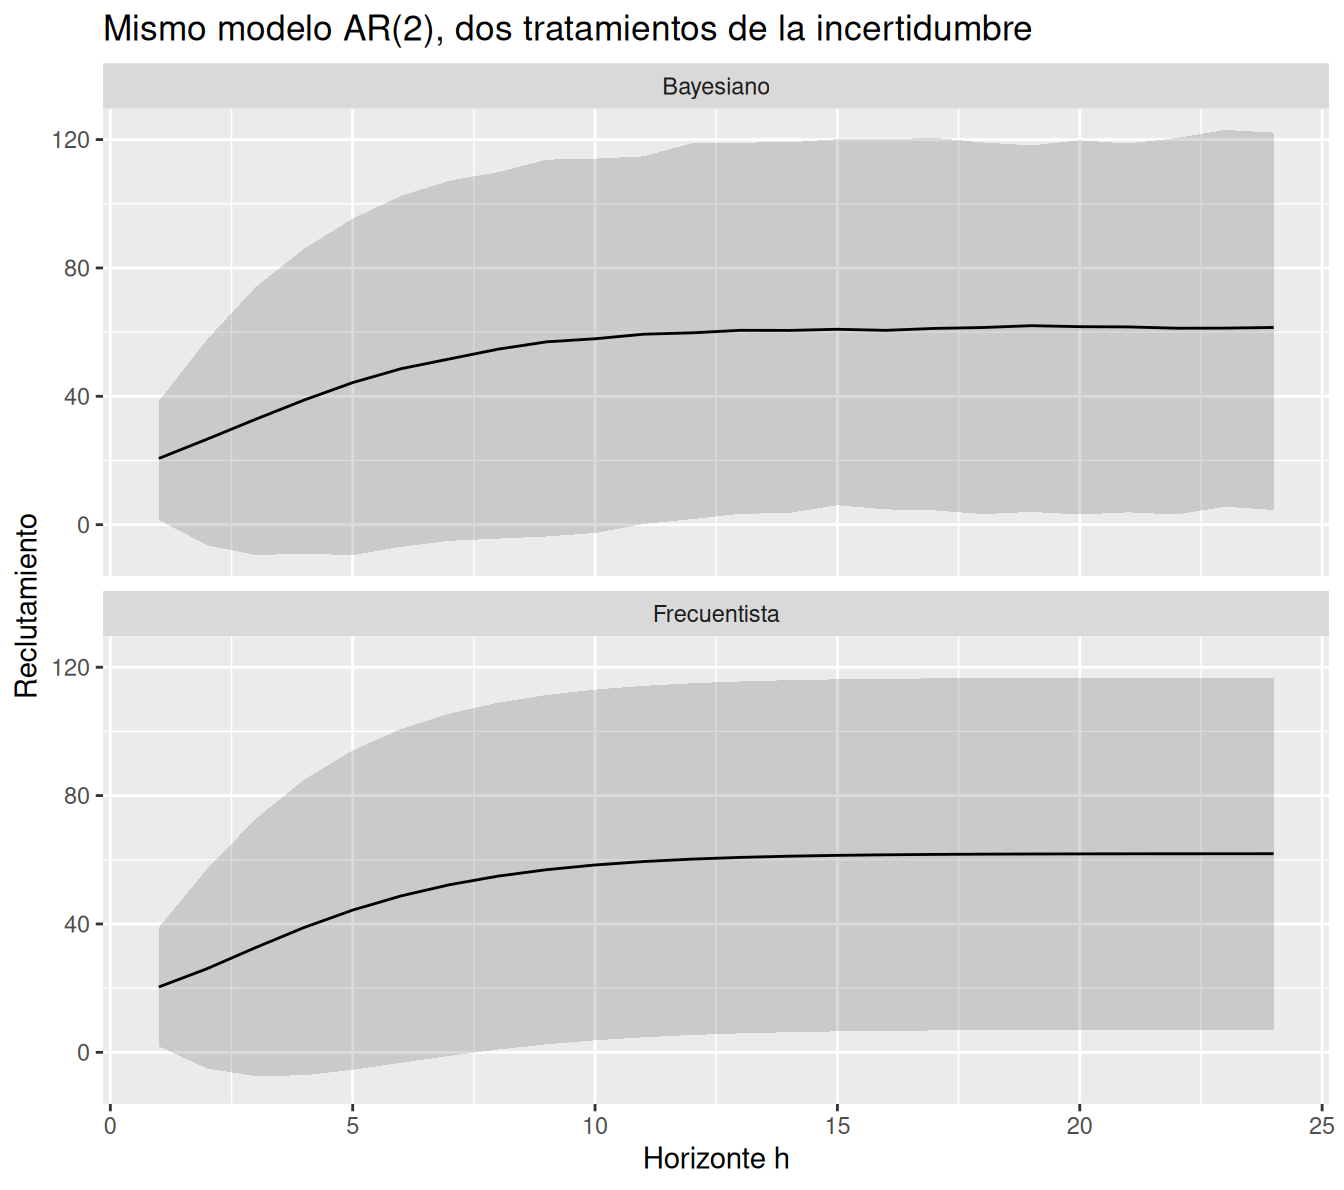
La comparación es deliberadamente descriptiva. No decidiremos todavía cuál método pronostica mejor: para eso necesitamos separar entrenamiento y evaluación, repetir orígenes y estudiar cobertura y errores fuera de muestra, contenidos de la semana 7.
5.15.7 Trayectorias futuras y no solamente bandas
Una ventaja conceptual de la simulación predictiva es que obtenemos una muestra de la trayectoria conjunta
\[ (Y_{T+1},\ldots,Y_{T+h})\mid y_{1:T}, \]
no únicamente marginales separadas por horizonte. Esto permite estudiar máximos, tiempos de cruce, promedios acumulados u otras funciones de todo el futuro.
n_hist_rec <- 60L
n_paths_rec <- 30L

historico_plot_rec <- tibble(
  tiempo = seq_along(x_rec_bayes),
  valor = x_rec_bayes
) |>
  slice_tail(n = n_hist_rec) |>
  mutate(Trayectoria = "Observado")

futuros_plot_rec <- pred_rec_bayes[seq_len(n_paths_rec), , drop = FALSE] |>
  as.data.frame() |>
  mutate(Trayectoria = paste0("Sim ", row_number())) |>
  pivot_longer(
    cols = starts_with("V"),
    names_to = "h_raw",
    values_to = "valor"
  ) |>
  mutate(
    h = as.integer(sub("V", "", h_raw)),
    tiempo = length(x_rec_bayes) + h
  )

ggplot() +
  geom_line(
    data = historico_plot_rec,
    aes(x = tiempo, y = valor),
    linewidth = 0.8
  ) +
  geom_line(
    data = futuros_plot_rec,
    aes(x = tiempo, y = valor, group = Trayectoria),
    alpha = 0.35
  ) +
  geom_vline(xintercept = length(x_rec_bayes), linetype = "dashed") +
  labs(
    x = "Mes",
    y = "Reclutamiento",
    title = "Futuros posibles, no un único futuro"
  )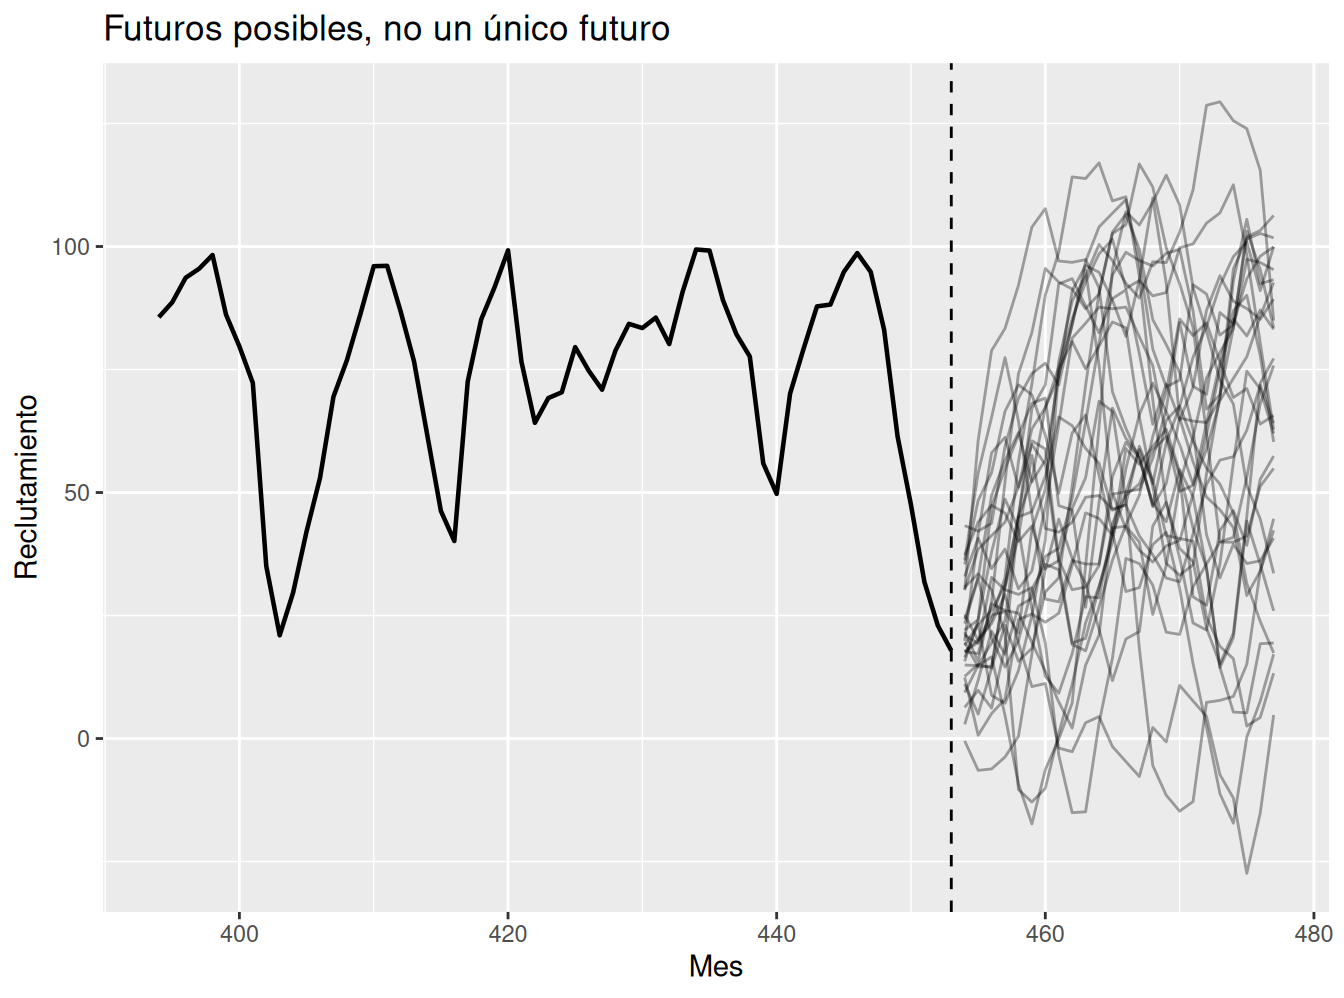
5.15.8 Conclusión provisional de la aplicación
El análisis bayesiano añade capas que no estaban disponibles en la semana 4:
- una distribución conjunta para los coeficientes en lugar de un único vector estimado;
- una probabilidad posterior de estacionariedad bajo una posterior no restringida;
- distribuciones posteriores de funciones no lineales de los parámetros, como raíces y persistencia;
- una distribución predictiva que integra incertidumbre paramétrica e innovaciones futuras;
- un marco explícito para estudiar sensibilidad a prioris.
Pero varias advertencias permanecen:
- la inferencia aquí es condicional en los valores iniciales;
- el orden \(p\) sigue siendo una decisión de modelación;
- la gaussianidad y la estructura AR deben diagnosticarse;
- una posterior precisa no implica buen pronóstico fuera de muestra;
- una priori impropia de referencia no sirve, sin más, para probabilidades formales entre modelos de distinta dimensión.
5.16 Actividad computacional guiada
5.16.1 Parte A. De ML a Bayes
- Simule un AR(1) con \(\phi=0.6\) y \(T=80\).
- Calcule manualmente la verosimilitud condicional sobre una rejilla de valores de \(\phi\) suponiendo \(v\) conocido.
- Multiplique la verosimilitud por una priori normal truncada a \((-1,1)\).
- Normalice numéricamente la posterior y compare su moda con el MLE.
5.16.2 Parte B. Posterior conjugada
- Construya \(\mathbf y\) y \(\mathbf X\) para un AR(2).
- Especifique \(\mathbf m_0\), \(\mathbf C_0\), \(n_0\) y \(d_0\).
- Calcule Ecuación 5.18 a Ecuación 5.21.
- Genere 5,000 muestras directas de \((\boldsymbol\beta,v)\).
- Compare medias posteriores e intervalos creíbles con el ajuste ML.
5.16.3 Parte C. Estacionariedad
- Para cada muestra posterior de un AR(2), calcule las raíces de \(\Phi(z)\).
- Estime Ecuación 5.28.
- Grafique la posterior conjunta de \((\phi_1,\phi_2)\) junto con la región estacionaria.
- Repita con una muestra más corta y compare.
5.16.4 Parte D. MCMC
- Ejecute cuatro cadenas del algoritmo de Sección 5.9.1.
- Cambie la desviación estándar de la propuesta.
- Compare tasa de aceptación, traza, autocorrelación y ESS aproximado.
- Explique por qué una tasa de aceptación alta no garantiza una cadena eficiente.
5.16.5 Parte E. Pronóstico
- Genere una muestra de la predictiva posterior a \(h=12\).
- Compare con una simulación que fija los parámetros en su media posterior.
- Compare anchura de intervalos por horizonte.
- Explique qué fuente de incertidumbre falta en la versión con parámetros fijos.
5.16.6 Parte F. Recruitment
- Compare AR(1), AR(2) y AR(3) usando una muestra común.
- Calcule la probabilidad posterior de estacionariedad para cada orden.
- Para AR(2), compare ML con la posterior de referencia.
- Genere trayectorias futuras a 24 meses.
- Escriba una conclusión que distinga claramente ajuste, inferencia paramétrica y capacidad predictiva.
5.17 Puente hacia ARIMA y estacionalidad
La semana 6 ampliará la familia de modelos en dos direcciones:
- integración: procesos no estacionarios que se vuelven modelables después de diferenciar;
- estacionalidad: dependencia sistemática en rezagos estacionales.
La lógica bayesiana no desaparece. Para un ARIMA, seguimos necesitando una verosimilitud, una priori, una posterior y una predictiva. Sin embargo, las restricciones sobre raíces, la inicialización y la reconstrucción de innovaciones se vuelven más delicadas, por lo que no desarrollaremos en la semana 6 una teoría conjugada completa para cada SARIMA posible.
5.18 Puente hacia evaluación fuera de muestra
La semana 7 retomará una pregunta que este capítulo deja abierta:
¿qué tan bien calibradas y precisas son las distribuciones predictivas cuando se enfrentan a datos que no participaron en el ajuste?
La comparación debe hacerse con las mismas ventanas de entrenamiento, los mismos orígenes y los mismos horizontes. Para pronósticos puntuales utilizaremos MAE, RMSE y MASE; para intervalos estudiaremos cobertura y amplitud; y para distribuciones predictivas podremos utilizar puntuaciones probabilísticas.
ImportanteUna posterior precisa puede producir un pronóstico pobre
La inferencia bayesiana cuantifica incertidumbre condicional en el modelo. Si el orden AR es inadecuado, hay un cambio estructural o la dinámica relevante no está representada, una posterior estrecha no corrige automáticamente el problema. Diagnóstico del modelo y evaluación predictiva siguen siendo necesarios.
5.19 Síntesis
Las ideas centrales de la semana son las siguientes:
- la inferencia bayesiana reutiliza la misma verosimilitud construida en la semana 4 y la combina con una priori;
- condicionado en \(y_{1:p}\), un AR(\(p\)) gaussiano es una regresión lineal;
- una priori de referencia \(p(\boldsymbol\beta,v)\propto1/v\) produce posteriores cerradas, pero es impropia;
- una priori normal–inversa-gamma propia produce una posterior de la misma familia;
- la matriz de precisión posterior suma información previa e información de los datos;
- estacionariedad es una restricción conjunta sobre los coeficientes AR y puede estudiarse muestra a muestra mediante las raíces del polinomio;
- una posterior no restringida permite estimar la probabilidad posterior de estacionariedad;
- una priori restringida impone estacionariedad por construcción y cambia la interpretación;
- si la posterior tiene forma cerrada, podemos simular directamente y no necesitamos MCMC;
- MCMC se vuelve útil con prioris o restricciones no conjugadas y requiere diagnóstico propio;
- diagnóstico MCMC y diagnóstico residual responden preguntas distintas;
- la predictiva posterior integra incertidumbre de parámetros e innovaciones futuras;
- la incertidumbre paramétrica puede ser pequeña con mucha información, pero puede importar mucho en series cortas o persistentes;
- cerca de una raíz unitaria, la sensibilidad de \(\phi^h\) hace especialmente relevante estudiar sensibilidad a la priori;
- comparar órdenes bayesianamente exige prioris propias coherentes y una muestra comparable;
- en Recruitment, la posterior permite extender el análisis frecuentista hacia incertidumbre conjunta, estacionariedad probabilística y trayectorias futuras;
- la semana 6 ampliará la familia hacia ARIMA y SARIMA, y la semana 7 evaluará los pronósticos fuera de muestra.
5.20 Ejercicios
5.20.1 Conceptuales
Misma verosimilitud, distinta inferencia. Explique por qué la función de verosimilitud condicional de un AR(2) puede utilizarse tanto en máxima verosimilitud como en inferencia bayesiana sin cambiar su forma matemática.
Parámetro aleatorio. ¿Qué significa afirmar que \(\phi\) tiene una distribución posterior si, en el mecanismo generador, el valor verdadero de \(\phi\) es fijo?
Referencia. ¿Por qué \(p(\boldsymbol\beta,v)\propto1/v\) se denomina impropia? ¿Qué debe comprobarse antes de utilizar una posterior derivada de una priori impropia?
Conjugación. Explique una ventaja y una limitación de utilizar una priori normal–inversa-gamma.
Estacionariedad. Una posterior no restringida de un AR(1) produce \(\Pr(|\phi|<1\mid y)=0.82\). Interprete este resultado. ¿Cómo cambiaría la interpretación si la priori hubiera sido truncada a \((-1,1)\)?
MCMC. ¿Por qué no tiene sentido calcular \(\widehat R\) para 5,000 muestras independientes obtenidas directamente de una posterior cerrada?
Dos diagnósticos. Un algoritmo MCMC tiene \(\widehat R\) cercano a uno, pero los residuales del modelo presentan autocorrelación fuerte. ¿Qué concluye sobre el algoritmo y sobre el modelo?
Predictiva. Distinga \(p(y_{T+h}\mid\widehat{\boldsymbol\vartheta},y_{1:T})\) de \(p(y_{T+h}\mid y_{1:T})\).
Sensibilidad. ¿Por qué una priori que contrae \(\phi\) hacia cero puede afectar mucho más un AR(1) corto con \(\phi\approx0.98\) que un AR(1) largo con \(\phi\approx0.3\)?
Orden. Explique por qué una priori impropia puede ser útil dentro de un modelo fijado pero problemática para construir probabilidades posteriores sobre modelos de distinta dimensión.
Intervalos. Dos métodos producen intervalos al \(95\%\). Uno es frecuentista y otro bayesiano. Escriba una interpretación correcta de cada uno.
Pronóstico. ¿Por qué una distribución predictiva posterior bien calculada no garantiza buen desempeño fuera de muestra?
5.20.2 Derivaciones
Forma de regresión. Partiendo de Ecuación 5.2, construya explícitamente \(\mathbf y\), \(\mathbf X\) y \(\boldsymbol\beta\) para un AR(2) con \(T=6\).
Posterior de referencia. A partir de la verosimilitud normal y \(p(\boldsymbol\beta,v)\propto1/v\), complete cuadrados en \(\boldsymbol\beta\) y derive ?eq-bayes-ar-beta-ref-cond.
Varianza posterior de referencia. Integre \(\boldsymbol\beta\) en la posterior conjunta y muestre que \(v\mid\mathbf y\) tiene forma inversa-gamma como en ?eq-bayes-ar-sigma-ref.
Actualización conjugada. Complete cuadrados en Ecuación 5.25 y derive Ecuación 5.18 y Ecuación 5.19.
Escala posterior. Demuestre Ecuación 5.21.
AR(1) de referencia. Para Ecuación 5.14, derive Ecuación 5.15 y la suma de cuadrados residual correspondiente.
Predictiva un paso. Suponga parámetros conocidos en un AR(1). Derive
\[ Y_{T+1}\mid y_T,\phi,v \sim N(\phi y_T,v). \]
Luego explique qué integración adicional produce la predictiva posterior.
Persistencia. Calcule la derivada de \(\phi^h\) respecto de \(\phi\). Utilícela para explicar por qué la incertidumbre en \(\phi\) puede amplificarse al estudiar persistencia a horizonte \(h\).
Probabilidad de estacionariedad. Demuestre que para un AR(1), la condición de raíces de Ecuación 5.27 equivale a \(|\phi|<1\).
AR(2). Exprese la probabilidad posterior de estacionariedad como una integral sobre la región de \(\mathbb R^2\) donde las raíces están fuera del círculo unitario. Explique por qué Monte Carlo evita evaluar esa integral de forma analítica.
Aceptación MH. Derive Ecuación 5.32 y explique por qué el cociente de densidades de propuesta se cancela para una caminata normal simétrica.
Orden. Derive Ecuación 5.44 a partir de la regla de Bayes y explique el papel de Ecuación 5.45.
5.20.3 Computacionales
AR(1) moderado. Simule un AR(1) con \(\phi=0.7\) para \(T\in\{30,100,500\}\). Compare la posterior de referencia de \(\phi\) entre tamaños de muestra.
Priori conjugada. Para el ejercicio anterior con \(T=30\), compare tres valores de \(C_0\). Grafique priori y posterior y comente el grado de contracción.
Cobertura posterior en simulación. Simule 500 series AR(1) con \(\phi=0.7\) y \(T=50\). Construya un intervalo creíble de referencia al \(95\%\) para cada serie y estime la frecuencia con que contiene el valor generador.
Estacionariedad posterior. Simule AR(1) con \(\phi\in\{0.5,0.9,0.98\}\) y \(T=40\). Calcule \(\Pr(|\phi|<1\mid y)\) bajo la posterior de referencia.
AR(2) conjunto. Simule un AR(2) con \((\phi_1,\phi_2)=(1.5,-0.75)\). Compare intervalos marginales de los coeficientes con la probabilidad posterior conjunta de estacionariedad.
Rechazo por estacionariedad. Genere muestras de una posterior no restringida de AR(2) y rechace las no estacionarias. Reporte la tasa de aceptación. Repita con una serie cercana a la frontera.
MCMC y escala de propuesta. Ejecute el algoritmo de Sección 5.9.1 con desviaciones de propuesta \(0.005\), \(0.05\) y \(0.4\). Compare tasa de aceptación, trazas, ACF y ESS aproximado.
Valores iniciales MCMC. Ejecute cuatro cadenas desde puntos muy separados. ¿Cuánto tarda en desaparecer visualmente la influencia de los valores iniciales?
Predictiva posterior. Para un AR(1) corto y persistente, compare la anchura de la predictiva plug-in y la posterior completa para \(h=1,\ldots,20\).
Funciones del futuro. A partir de 5,000 trayectorias predictivas a 24 pasos, estime la distribución posterior del máximo futuro y del promedio de los próximos 12 pasos.
Sensibilidad. Reproduzca Sección 5.13 con \(T=100\). ¿Disminuyen las diferencias entre prioris? Explique por qué.
Recruitment AR(1)–AR(3). Calcule medias, desviaciones e intervalos creíbles para todos los coeficientes de los tres órdenes usando una muestra común.
Recruitment y raíces. Para AR(2), obtenga la distribución posterior del módulo mínimo de las raíces. ¿Qué tan lejos está la masa posterior de la frontera unitaria?
Recruitment: futuro conjunto. Utilice las trayectorias predictivas para estimar la probabilidad de que al menos uno de los próximos 12 valores exceda un umbral elegido antes de ver las simulaciones.
Comparación con semana 4. Para Recruitment, elabore una tabla que incluya estimaciones ML, errores estándar, medias posteriores e intervalos creíbles de AR(2). Explique similitudes y diferencias.
Preparación para evaluación temporal. Reserve los últimos 24 meses de Recruitment. Ajuste el AR(2) bayesiano solo al entrenamiento y genere la predictiva posterior. Calcule provisionalmente MAE y cobertura al \(95\%\). No utilice todavía origen móvil; ese procedimiento se formalizará en la semana 7.
5.21 Lecturas recomendadas
Para esta semana:
- Prado, Ferreira y West: sección 1.5 para verosimilitud, inferencia bayesiana, análisis de referencia, conjugación y MCMC; secciones 2.3.2–2.3.4 para inferencia AR, simulación posterior y evaluación del orden; sección 2.4.1 y partes seleccionadas de 2.4.2 para sensibilidad y prioris estructuradas (Prado et al. 2021).
- Shumway y Stoffer: capítulo 3 como apoyo para la estructura AR, estimación clásica y la serie Recruitment. Su tratamiento permite mantener una referencia frecuentista coherente con la semana 4 (Shumway y Stoffer 2025).
La semana 6 extenderá los modelos hacia ARIMA y SARIMA. La semana 7 retomará la predictiva posterior y los modelos frecuentistas para evaluarlos bajo particiones temporales, origen móvil, métricas puntuales y criterios probabilísticos.