n_tend <- 180
phi_tend <- 0.75
beta0_tend <- 15
beta1_tend <- 0.08
c_rw <- 0.08
sigma_tend <- 0.7

eps_det <- rnorm(n_tend, sd = sigma_tend)
x_det <- numeric(n_tend)
x_det[1] <- rnorm(1, sd = sigma_tend / sqrt(1 - phi_tend^2))

for (t in 2:n_tend) {
  x_det[t] <- phi_tend * x_det[t - 1] + eps_det[t]
}

y_det <- beta0_tend + beta1_tend * seq_len(n_tend) + x_det

eps_rw <- rnorm(n_tend, sd = sigma_tend)
y_rw <- numeric(n_tend)
y_rw[1] <- beta0_tend

for (t in 2:n_tend) {
  y_rw[t] <- c_rw + y_rw[t - 1] + eps_rw[t]
}

tendencias_sim <- tibble(
  t = seq_len(n_tend),
  `Tendencia determinista` = y_det,
  `Tendencia estocástica` = y_rw
) |>
  pivot_longer(
    cols = -t,
    names_to = "Modelo",
    values_to = "Y"
)6 Integración, ARIMA y estacionalidad
CA-0415 Series de Tiempo — Semana 6
6.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
- distinguir una tendencia determinista de una tendencia estocástica y explicar por qué ambas requieren tratamientos diferentes;
- reconocer una raíz unitaria en el polinomio autorregresivo y relacionarla con la falta de estacionariedad de un proceso;
- formular e interpretar los operadores de diferencia regular \(\nabla=1-B\) y de diferencia estacional \(\nabla_S=1-B^S\);
- explicar qué significa que una serie sea integrada de orden \(d\), denotada \(I(d)\);
- formular un modelo ARIMA(\(p,d,q\)) como un modelo ARMA para una serie diferenciada;
- distinguir la constante del modelo ARIMA, la media de la serie diferenciada y la deriva inducida en la escala original;
- derivar pronósticos de una caminata aleatoria con deriva y explicar por qué su incertidumbre crece con el horizonte;
- reconstruir pronósticos en la escala original a partir de pronósticos de las diferencias;
- distinguir patrón estacional, dependencia estacionaria en rezagos estacionales y persistencia estacional asociada con raíces unitarias;
- formular e interpretar un modelo SARIMA multiplicativo ARIMA(\(p,d,q\))\(\times\)(P,D,Q)\(_S\);
- utilizar ACF y PACF de una serie adecuadamente diferenciada para proponer órdenes regulares y estacionales;
- utilizar pruebas de raíz unitaria y medidas de fuerza estacional como herramientas auxiliares, sin convertirlas en reglas automáticas de modelación;
- explicar los riesgos de la sobrediferenciación y aplicar el principio de usar el menor número de diferencias compatible con una serie aproximadamente estacionaria;
- comparar modelos ARIMA mediante AICc únicamente cuando la comparación se realiza sobre datos y órdenes de diferenciación compatibles;
- ajustar, diagnosticar y pronosticar con modelos ARIMA y SARIMA mediante
fable; - explicar cómo un ARIMA sencillo puede analizarse bayesianamente reutilizando la inferencia AR de la semana 5 sobre la serie diferenciada;
- conectar el ajuste ARIMA de esta semana con la evaluación fuera de muestra que se desarrollará formalmente en la semana 7.
En Sección 5.17 anticipamos que la inferencia bayesiana para un AR puede reutilizarse cuando una transformación de la serie, en lugar de la serie en niveles, sigue una dinámica autorregresiva. Ese comentario resume la idea central de esta semana. Hasta ahora trabajamos principalmente con procesos estacionarios o con modelos cuya parte estacionaria podía estudiarse directamente. Ahora preguntaremos:
¿qué hacemos cuando \(Y_t\) no parece estacionaria, pero una o más diferencias de \(Y_t\) sí pueden describirse mediante un modelo ARMA?
La guía bibliográfica del curso asigna a esta semana integración, ARIMA y estacionalidad. El texto conductor es Hyndman y Athanasopoulos, con Shumway y Stoffer como referencia para el desarrollo probabilístico y Prado, Ferreira y West como complemento para la formulación ARIMA y su conexión con inferencia bayesiana (Hyndman y Athanasopoulos 2021, chap. 9; Shumway y Stoffer 2025, secs. 3.6–3.9; Prado et al. 2021, secs. 1.4 y 2.6).
El hilo conductor será
\[ \text{serie no estacionaria} \longrightarrow \text{diferenciar lo necesario} \longrightarrow \text{modelar la dinámica estacionaria} \longrightarrow \text{pronosticar} \longrightarrow \text{reintegrar}. \]
6.2 Tendencia determinista y tendencia estocástica
Una trayectoria ascendente no identifica por sí sola el mecanismo que la generó. Dos modelos pueden producir gráficos visualmente parecidos y, sin embargo, implicar pronósticos y estructuras de incertidumbre muy diferentes.
6.2.1 Tendencia determinista
Considere
\[ Y_t=\beta_0+\beta_1t+X_t, \tag{6.1}\]
donde \(\{X_t\}\) es estacionario con media cero. Entonces
\[ E(Y_t)=\beta_0+\beta_1t, \]
y la no estacionariedad de la media está completamente determinada por una función conocida de \(t\) una vez fijados \(\beta_0\) y \(\beta_1\). Si eliminamos la tendencia,
\[ Y_t-(\beta_0+\beta_1t)=X_t, \]
recuperamos un proceso estacionario.
Una perturbación en \(X_t\) se disipa según la dinámica estacionaria de \(X_t\). No cambia permanentemente la trayectoria determinista \(\beta_0+\beta_1t\).
6.2.2 Tendencia estocástica
Considere ahora una caminata aleatoria con deriva:
\[ Y_t=c+Y_{t-1}+\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2). \tag{6.2}\]
Iterando desde \(Y_0\),
\[ Y_t = Y_0+ct+\sum_{j=1}^t\varepsilon_j. \tag{6.3}\]
Por tanto,
\[ E(Y_t)=E(Y_0)+ct, \]
pero además
\[ \operatorname{Var}(Y_t) = \operatorname{Var}(Y_0)+t\sigma_\varepsilon^2 \]
si \(Y_0\) es independiente de las innovaciones. La incertidumbre sobre el nivel crece con el tiempo. Cada innovación entra de forma permanente en todos los niveles posteriores.
ImportanteDos trayectorias con tendencia pueden tener memorias muy distintas
En Ecuación 6.1 una perturbación pertenece al componente estacionario y puede disiparse. En Ecuación 6.2 una innovación cambia permanentemente el nivel de la serie. Por eso, eliminar una tendencia lineal y diferenciar no son operaciones intercambiables.
6.2.3 Simulación comparativa
El siguiente experimento compara una serie con tendencia determinista y errores AR(1) con una caminata aleatoria con deriva. Ambas tienen una pendiente media positiva.
ggplot(tendencias_sim, aes(x = t, y = Y)) +
  geom_line() +
  facet_wrap(~ Modelo, ncol = 1, scales = "free_y") +
  labs(
    x = "Tiempo",
    y = expression(Y[t])
  )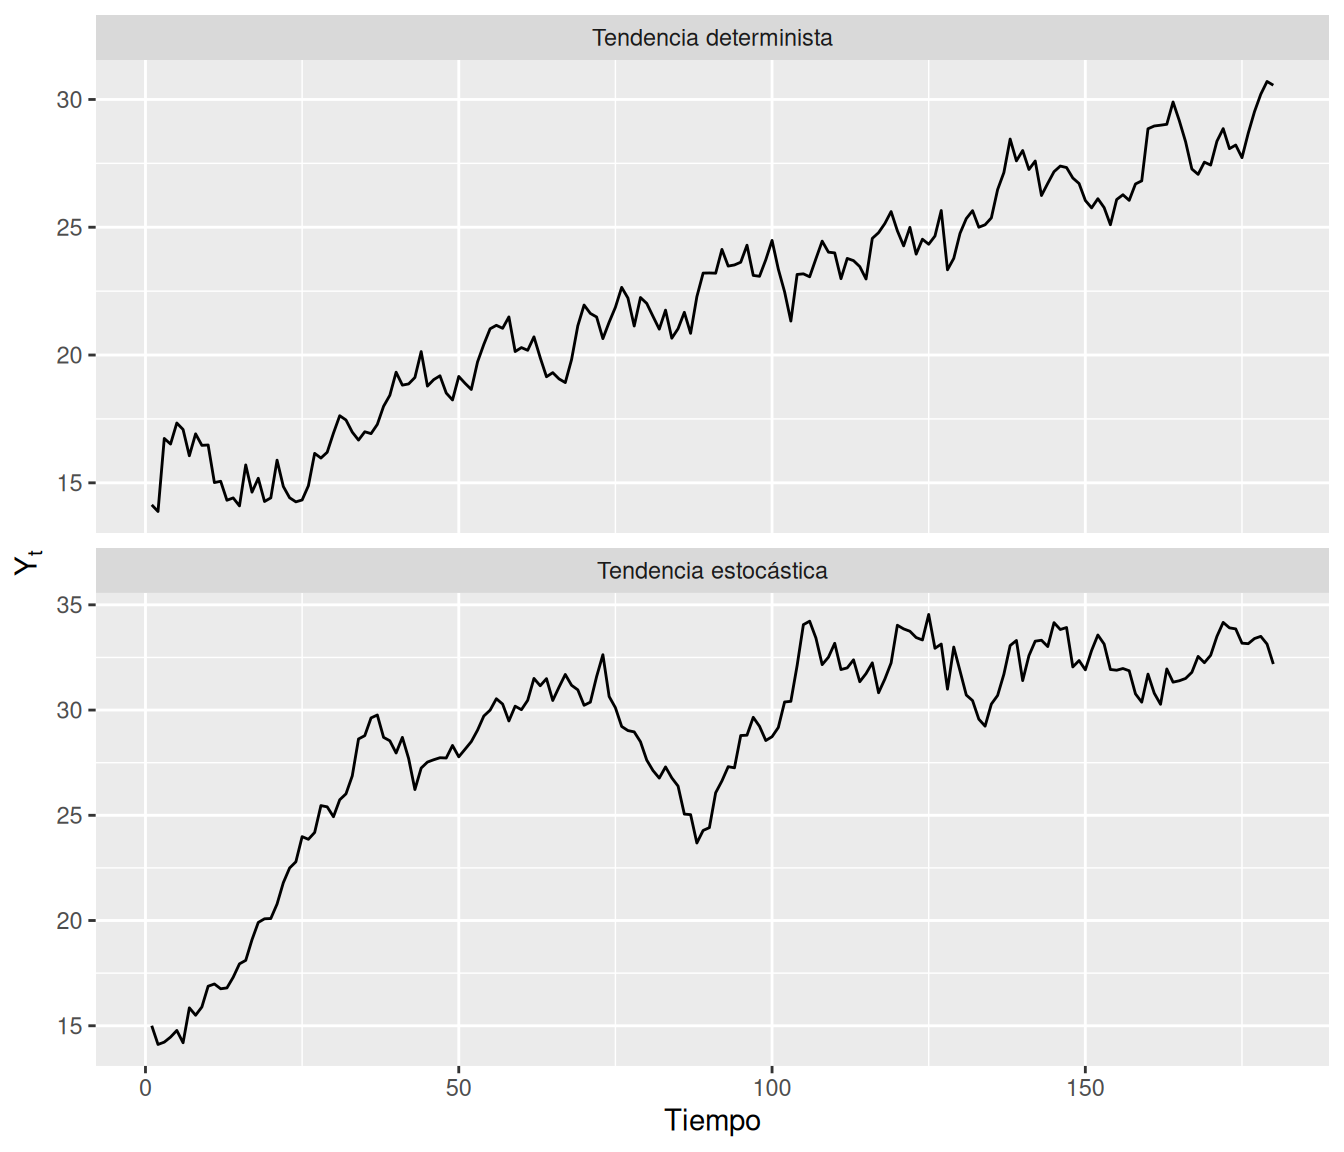
La diferencia se vuelve más clara al aplicar la transformación adecuada. Para la primera serie, restar una tendencia estimada deja una serie aproximadamente estacionaria. Para la segunda, la primera diferencia elimina la acumulación del nivel.
6.3 La raíz unitaria como frontera de la estacionariedad
En la semana 2 estudiamos el AR(1)
\[ Y_t=c+\phi Y_{t-1}+\varepsilon_t. \]
El polinomio autorregresivo es
\[ \Phi(z)=1-\phi z. \]
Su raíz es
\[ z=\frac{1}{\phi}. \]
La condición estacionaria usual \(|\phi|<1\) equivale a que la raíz satisfaga \(|z|>1\). Si \(\phi=1\), entonces
\[ \Phi(z)=1-z, \]
y la raíz es exactamente \(z=1\), sobre el círculo unitario. El modelo se convierte en
\[ Y_t=c+Y_{t-1}+\varepsilon_t, \]
es decir, la caminata aleatoria con deriva de Ecuación 6.2.
Aplicando el operador de diferencia,
\[ (1-B)Y_t=c+\varepsilon_t, \tag{6.4}\]
o equivalentemente
\[ \nabla Y_t=c+\varepsilon_t. \]
La serie en niveles no es estacionaria, pero sus primeras diferencias sí lo son.
NotaUna raíz casi unitaria no es una raíz unitaria
Un AR(1) con \(\phi=0.98\) sigue siendo estacionario porque su raíz está fuera del círculo unitario. Puede parecer extremadamente persistente en muestras finitas, pero sus propiedades probabilísticas de largo plazo no son las mismas que las de \(\phi=1\). Esta cercanía a la frontera es precisamente una de las situaciones en las que la evidencia empírica sobre diferenciación puede ser ambigua.
6.3.1 ¿Por qué la caminata aleatoria no es estacionaria?
Suponga por simplicidad que \(Y_0\) es fijo y \(c=0\). Entonces
\[ Y_t=Y_0+\sum_{j=1}^t\varepsilon_j, \]
de modo que
\[ \operatorname{Var}(Y_t)=t\sigma_\varepsilon^2. \tag{6.5}\]
La varianza depende de \(t\), por lo que no puede existir estacionariedad débil. Además, para \(s<t\),
\[ \operatorname{Cov}(Y_s,Y_t) = s\sigma_\varepsilon^2, \]
que depende de \(s\) y no solamente del rezago \(t-s\).
Esta derivación explica por qué una ACF muestral de una caminata aleatoria suele decaer muy lentamente: no estamos observando la ACF de un proceso estacionario bien definido, sino un resumen muestral de una trayectoria cuya dependencia cambia con el tiempo.
6.4 Diferenciación e integración
El operador de primera diferencia es
\[ \nabla=1-B, \]
y por tanto
\[ \nabla Y_t =(1-B)Y_t =Y_t-Y_{t-1}. \tag{6.6}\]
La diferencia mide el cambio de un período al siguiente. No es simplemente una transformación algebraica: su interpretación depende de la escala temporal. En una serie mensual, \(\nabla Y_t\) mide el cambio respecto del mes anterior; en una serie anual, mide el cambio respecto del año anterior.
Las diferencias de orden \(d\) se definen como
\[ \nabla^dY_t =(1-B)^dY_t. \tag{6.7}\]
Para \(d=2\),
\[ \begin{aligned} \nabla^2Y_t &=(1-B)^2Y_t\\ &=(1-2B+B^2)Y_t\\ &=Y_t-2Y_{t-1}+Y_{t-2}. \end{aligned} \tag{6.8}\]
Así, la segunda diferencia es el cambio del cambio.
6.4.1 Procesos integrados
Diremos que \(\{Y_t\}\) es integrado de orden \(d\), y escribiremos
\[ Y_t\sim I(d), \]
si \(\nabla^dY_t\) es estacionario y \(d\) es el menor entero no negativo con esa propiedad. En particular:
- \(I(0)\) significa que la serie ya es estacionaria;
- \(I(1)\) significa que una primera diferencia es estacionaria;
- \(I(2)\) significa que se requieren dos diferencias regulares.
El término integrado proviene de que recuperar \(Y_t\) a partir de sus diferencias requiere acumular o sumar los cambios. En este sentido, integración es la operación inversa de diferenciación (Hyndman y Athanasopoulos 2021, sec. 9.5; Prado et al. 2021, sec. 2.6).
AdvertenciaDiferenciar lo mínimo necesario
Diferenciar demasiado puede crear autocorrelaciones artificiales y una dinámica que no estaba presente en el proceso original. En la práctica, \(d=0\) o \(d=1\) son muy comunes y \(d=2\) se utiliza con mucha menos frecuencia. La decisión no debe basarse únicamente en que una serie “se vea más plana” después de diferenciar (Hyndman y Athanasopoulos 2021, sec. 9.1; Shumway y Stoffer 2025, secs. 3.6 y 5.1).
6.4.2 Ejemplo: sobrediferenciar ruido blanco
Sea \(Y_t=\varepsilon_t\) ruido blanco. No necesita diferenciación. Sin embargo,
\[ W_t=\nabla Y_t=\varepsilon_t-\varepsilon_{t-1} \]
es un MA(1) con parámetro \(\theta=-1\) bajo nuestra convención
\[ W_t=\eta_t+\theta\eta_{t-1}. \]
En particular,
\[ \rho_W(1)=-\frac{1}{2}, \qquad \rho_W(h)=0, \quad h\ge2. \]
La diferenciación creó una autocorrelación negativa fuerte en una serie que originalmente no tenía dependencia temporal.
n_over <- 400
ruido <- rnorm(n_over)
dif_ruido <- diff(ruido)

sobredif_tbl <- tibble(
  t = seq_along(dif_ruido),
  Diferencia = dif_ruido
) |>
  as_tsibble(index = t)
sobredif_tbl |>
ACF(Diferencia, lag_max = 24) |>
autoplot() +
labs(x = "Rezago", y = "ACF")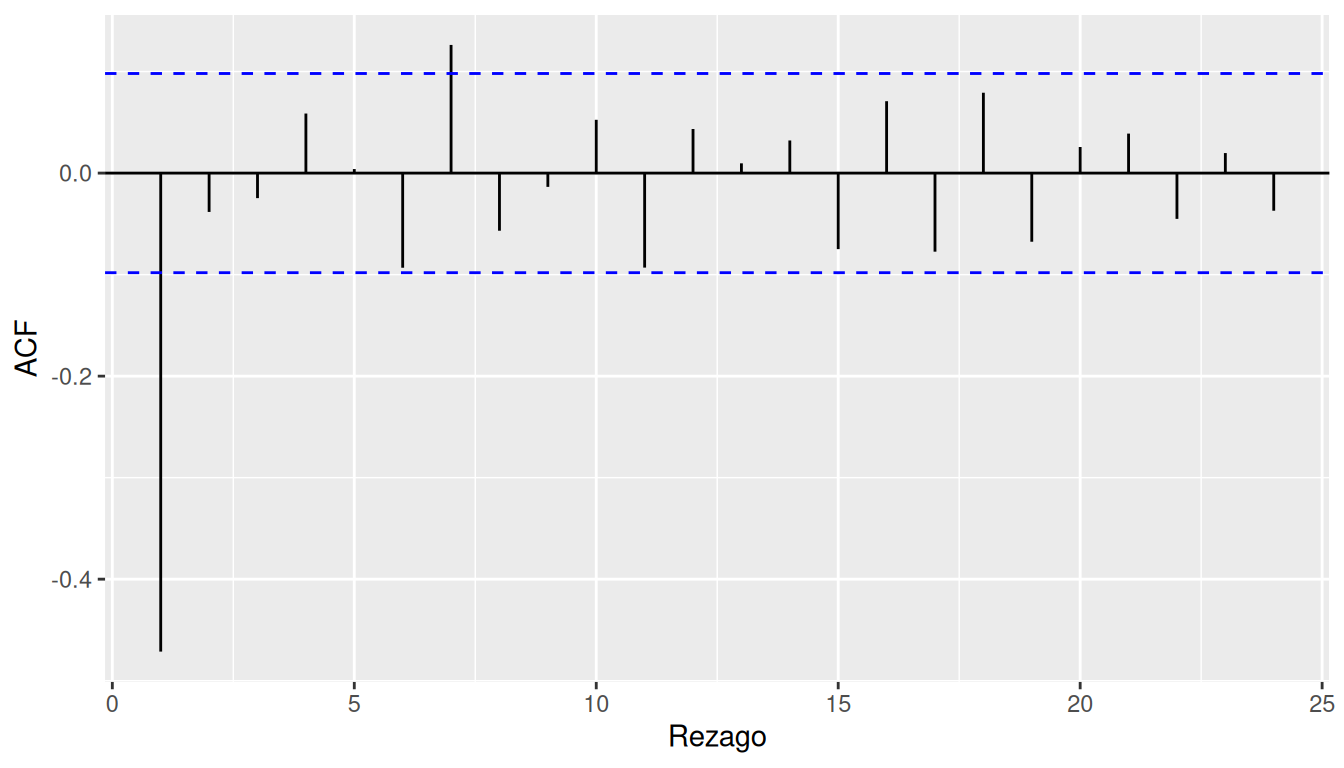
6.5 Pruebas de raíz unitaria como herramienta auxiliar
La inspección de la trayectoria y de la ACF sigue siendo fundamental, pero a veces la decisión entre \(d=0\) y \(d=1\) no es evidente. Una herramienta auxiliar es una prueba de estacionariedad. Hyndman y Athanasopoulos utilizan la prueba de Kwiatkowski–Phillips–Schmidt–Shin (KPSS) como parte del procedimiento para decidir el número de diferencias regulares (Hyndman y Athanasopoulos 2021, sec. 9.1).
Una característica importante de KPSS es que invierte la lógica de pruebas como Dickey–Fuller. En KPSS la hipótesis nula es estacionariedad, mientras que la alternativa incorpora una componente no estacionaria de tipo caminata aleatoria. Por eso, un valor grande del estadístico –y, equivalentemente, un valor \(p\) pequeño– constituye evidencia contra la estacionariedad.
6.5.1 Formulación probabilística de la prueba KPSS
La formulación original escribe la serie como
\[ Y_t = \mu+\beta t+r_t+\varepsilon_t, \tag{6.9}\]
con
\[ r_t=r_{t-1}+u_t, \qquad E(u_t)=0, \qquad \operatorname{Var}(u_t)=\sigma_u^2, \tag{6.10}\]
donde \(\{\varepsilon_t\}\) es un proceso estacionario de media cero. La componente \(r_t\) es una caminata aleatoria latente. La hipótesis nula es
\[ H_0:\ \sigma_u^2=0. \tag{6.11}\]
Si \(\sigma_u^2=0\), entonces \(r_t=r_0\) es constante y puede absorberse en el intercepto. Por tanto, bajo \(H_0\) la serie no contiene una componente de caminata aleatoria. Existen dos versiones usuales:
- estacionariedad alrededor de un nivel (level stationarity): se toma \(\beta=0\) y bajo \(H_0\), \[ Y_t=\mu+\varepsilon_t; \]
- estacionariedad alrededor de una tendencia determinista (trend stationarity): se permite \(\beta\neq0\) y bajo \(H_0\), \[ Y_t=\mu+\beta t+\varepsilon_t. \]
La alternativa es
\[ H_1:\ \sigma_u^2>0, \]
de modo que existe una componente de caminata aleatoria y la serie deja de ser estacionaria alrededor del componente determinista especificado. Esta formulación explica por qué KPSS no contrasta simplemente “estacionaria versus no estacionaria” sin más: primero debemos decidir qué parte determinista –solo un nivel o nivel más tendencia lineal– estamos permitiendo bajo la hipótesis nula. El desarrollo original de la prueba se debe a Kwiatkowski, Phillips, Schmidt y Shin (1992).
6.5.2 Construcción del estadístico
El estadístico se construye en tres pasos.
Paso 1: eliminar la parte determinista. Se ajusta por mínimos cuadrados la regresión correspondiente a la hipótesis nula. En la versión de estacionariedad alrededor de un nivel,
\[ Y_t=\mu+e_t, \]
y en la versión de estacionariedad alrededor de una tendencia,
\[ Y_t=\mu+\beta t+e_t. \]
Sean \(\widehat e_t\) los residuos de esa regresión.
Paso 2: acumular los residuos. Se definen las sumas parciales
\[ S_t = \sum_{j=1}^{t}\widehat e_j, \qquad t=1,\ldots,T. \tag{6.12}\]
Si la serie es estacionaria alrededor del componente determinista especificado, estas sumas parciales fluctúan alrededor de cero a una escala del orden de \(\sqrt{T}\). Si existe una componente persistente de tipo caminata aleatoria, las desviaciones acumuladas tienden a ser mucho mayores.
Paso 3: medir el tamaño global de las sumas parciales. El estadístico KPSS es
\[ \operatorname{KPSS}_T = \frac{ T^{-2}\displaystyle\sum_{t=1}^{T}S_t^2 }{ \widehat\omega^2 }, \tag{6.13}\]
donde \(\widehat\omega^2\) estima la varianza de largo plazo de la perturbación estacionaria \(\varepsilon_t\). Esta varianza de largo plazo es
\[ \omega^2 = \gamma(0)+2\sum_{h=1}^{\infty}\gamma(h), \tag{6.14}\]
si la suma converge, donde \(\gamma(h)=\operatorname{Cov}(\varepsilon_t,\varepsilon_{t-h})\). No es, en general, igual a \(\operatorname{Var}(\varepsilon_t)\): incorpora también la autocovarianza serial. De hecho,
\[ \operatorname{Var} \left( \sum_{t=1}^{T}\varepsilon_t \right) \approx T\omega^2 \]
para \(T\) grande. Esta es la escala natural para normalizar las sumas parciales.
Una estimación habitual de \(\omega^2\) es la estimación de Bartlett–Newey–West
\[ \widehat\omega^2_{\ell} = \widehat\gamma(0) + 2\sum_{h=1}^{\ell} \left(1-\frac{h}{\ell+1}\right) \widehat\gamma(h), \tag{6.15}\]
con
\[ \widehat\gamma(h) = \frac{1}{T} \sum_{t=h+1}^{T} \widehat e_t\widehat e_{t-h}. \]
El parámetro \(\ell\) es el rezago de truncamiento. Si \(\ell=0\), se ignora la autocorrelación de los residuos y \(\widehat\omega^2\) se reduce esencialmente a su varianza muestral. Para errores serialmente correlacionados conviene utilizar \(\ell>0\). La elección de \(\ell\) no es un detalle inocuo: modifica la estimación de la varianza de largo plazo y, por tanto, el valor del estadístico.
Nota¿Por qué aparece el factor \(T^{-2}\)?
Bajo \(H_0\), una suma parcial \(S_t\) es típicamente de orden \(O_p(\sqrt{T})\). Por tanto, \(S_t^2\) es de orden \(O_p(T)\) y al sumar aproximadamente \(T\) términos obtenemos una cantidad de orden \(O_p(T^2)\). El factor \(T^{-2}\) produce entonces un estadístico con una distribución límite no degenerada.
6.5.3 Distribución del estadístico bajo la hipótesis nula
El estadístico KPSS no tiene bajo \(H_0\) una distribución \(t\), \(F\) o \(\chi^2\) convencional. Su distribución límite es una funcional de un movimiento browniano. Esta es la razón por la que los valores críticos se obtienen mediante resultados asintóticos y simulación, en lugar de utilizar una tabla de distribuciones paramétricas estándar.
La idea puede verse con claridad en la versión de estacionariedad alrededor de un nivel. Bajo \(H_0\),
\[ Y_t=\mu+\varepsilon_t, \]
y los residuos son aproximadamente
\[ \widehat e_t = \varepsilon_t-\bar\varepsilon. \]
Por tanto, para \(0\le r\le1\),
\[ S_{\lfloor Tr\rfloor} = \sum_{t=1}^{\lfloor Tr\rfloor}\varepsilon_t - \frac{\lfloor Tr\rfloor}{T} \sum_{t=1}^{T}\varepsilon_t. \tag{6.16}\]
Bajo condiciones regulares para un proceso estacionario, un teorema central funcional implica
\[ \frac{1}{\omega\sqrt{T}} \sum_{t=1}^{\lfloor Tr\rfloor}\varepsilon_t \ \Rightarrow\ W(r), \tag{6.17}\]
donde \(W(r)\) es un movimiento browniano estándar y \(\Rightarrow\) denota convergencia en distribución de procesos estocásticos. En consecuencia,
\[ \frac{S_{\lfloor Tr\rfloor}} {\omega\sqrt{T}} \ \Rightarrow\ B(r) = W(r)-rW(1). \tag{6.18}\]
El proceso \(B(r)\) es un puente browniano: satisface \(B(0)=B(1)=0\). Intuitivamente, la resta de la media muestral obliga a que la suma total de los residuos sea cero y transforma el movimiento browniano límite en un puente browniano.
Como Ecuación 6.13 puede verse como una suma de Riemann de las sumas parciales normalizadas al cuadrado, bajo \(H_0\) de estacionariedad alrededor de un nivel se obtiene
\[ \operatorname{KPSS}_T \ \xrightarrow{d}\ \int_0^1 B(r)^2\,dr. \tag{6.19}\]
Esta distribución es no estándar, pero es universal: después de dividir por una estimación consistente de \(\omega^2\), ya no depende de parámetros desconocidos del proceso estacionario.
Para la hipótesis nula de estacionariedad alrededor de una tendencia lineal, los residuos provienen de una regresión sobre \(1\) y \(t\). El proceso límite es entonces un movimiento browniano al que se le han removido las componentes asociadas al intercepto y a la tendencia. Puede escribirse como el puente browniano de segundo nivel
\[ B_2(r) = W(r) + (2r-3r^2)W(1) + (-6r+6r^2) \int_0^1 W(s)\,ds. \tag{6.20}\]
En este caso,
\[ \operatorname{KPSS}_T \ \xrightarrow{d}\ \int_0^1 B_2(r)^2\,dr. \tag{6.21}\]
Por eso las versiones de estacionariedad alrededor de un nivel y de estacionariedad alrededor de una tendencia utilizan valores críticos diferentes.
Los valores críticos asintóticos tradicionalmente utilizados son:
| Hipótesis nula | 10% | 5% | 2.5% | 1% |
|---|---|---|---|---|
| Estacionariedad alrededor de un nivel | 0.347 | 0.463 | 0.574 | 0.739 |
| Estacionariedad alrededor de tendencia lineal | 0.119 | 0.146 | 0.176 | 0.216 |
Así, en la versión de nivel, si obtenemos por ejemplo \(\operatorname{KPSS}=0.60\), el estadístico supera el valor crítico de 5% (\(0.463\)) y también el de 2.5% (\(0.574\)), pero no el de 1% (\(0.739\)). La evidencia contra la estacionariedad sería entonces fuerte, aunque no suficiente para rechazar al 1%.
ImportanteDistribución muestral y distribución asintótica no son lo mismo
La distribución exacta del estadístico en una muestra finita depende de características del proceso y de la estimación de la varianza de largo plazo. Los valores críticos anteriores corresponden a la distribución límite bajo \(H_0\), no a una distribución exacta para cualquier \(T\). El trabajo original de KPSS estudia por simulación el comportamiento del tamaño y la potencia en muestras finitas.
6.5.4 Interpretación práctica
La dirección de la prueba debe recordarse cuidadosamente:
\[ H_0:\ \text{estacionariedad alrededor del componente determinista elegido}, \]
frente a
\[ H_1:\ \text{presencia de una componente no estacionaria de tipo caminata aleatoria}. \]
Por tanto:
- un estadístico pequeño es compatible con \(H_0\);
- un estadístico grande conduce a rechazar \(H_0\);
- un valor \(p\) pequeño constituye evidencia a favor de diferenciar, siempre que la especificación determinista sea razonable.
No rechazar \(H_0\) no demuestra que el proceso sea estacionario. Solo indica que, con el tamaño muestral y la potencia disponibles, no encontramos evidencia suficiente contra la hipótesis de estacionariedad especificada.
La elección entre la versión de nivel y la versión con tendencia también importa. Una serie con una tendencia lineal determinista pronunciada puede hacer que la versión de nivel rechace estacionariedad aun cuando los residuos alrededor de esa tendencia sean perfectamente estacionarios. En ese caso, la pregunta estadística apropiada puede ser si la serie es estacionaria alrededor de una tendencia, no si es estacionaria alrededor de una constante.
6.5.5 Implementación en feasts
En feasts, unitroot_kpss() devuelve el estadístico y un valor \(p\) aproximado, y permite especificar la parte determinista y la corrección por autocorrelación. Por ejemplo:
features(
  Serie,
  unitroot_kpss,
  type = "mu",
  lags = "short"
)
utiliza una constante como parte determinista, mientras que
features(
  Serie,
  unitroot_kpss,
  type = "tau",
  lags = "short"
)
permite además una tendencia lineal. La documentación de feasts remite a la implementación de urca::ur.kpss(), donde el argumento de rezagos controla la estimación de la varianza de largo plazo.
Por su parte,
features(Serie, unitroot_ndiffs)aplica secuencialmente una prueba de raíz unitaria/estacionariedad para sugerir el número mínimo de diferencias regulares. Por defecto considera \(d=0,1,2\) y continúa diferenciando mientras el valor \(p\) sea menor que el nivel especificado. Esta automatización es útil, pero no convierte la decisión sobre \(d\) en un procedimiento puramente mecánico.
AdvertenciaPersistencia, cambios estructurales y elección del rezago pueden afectar KPSS
Una serie estacionaria pero muy persistente puede producir valores grandes del estadístico en muestras moderadas. De manera similar, un cambio estructural en el nivel o en la tendencia puede parecerse a una violación de estacionariedad y provocar rechazo. Además, la elección del rezago de truncamiento \(\ell\) afecta \(\widehat\omega^2_{\ell}\) y, por tanto, el tamaño y la potencia de la prueba.
Por estas razones, KPSS debe interpretarse junto con la trayectoria temporal, ACF/PACF, conocimiento sustantivo y diagnóstico posterior del modelo.
ImportanteLa prueba no decide el modelo
Una prueba estadística responde a una hipótesis bajo supuestos específicos. No conoce el contexto de la serie, cambios estructurales, intervenciones ni la utilidad predictiva final del modelo. Una decisión razonable sobre \(d\) combina:
- la trayectoria temporal;
- la interpretación de una diferencia;
- el comportamiento de la ACF/PACF;
- una prueba como KPSS;
- el diagnóstico del modelo ajustado;
- y, finalmente, desempeño fuera de muestra.
También existen pruebas, como Dickey–Fuller aumentado, cuya hipótesis nula es una raíz unitaria. No las desarrollaremos esta semana. La inversión de la hipótesis nula cambia sustancialmente la interpretación de un valor \(p\) y es una fuente frecuente de errores.
6.6 Del ARMA al ARIMA
Sea
\[ \Phi(B) = 1-\phi_1B-\cdots-\phi_pB^p \]
y
\[ \Theta(B) = 1+\theta_1B+\cdots+\theta_qB^q. \]
Un proceso \(\{Y_t\}\) sigue un modelo ARIMA(\(p,d,q\)) si
\[ \Phi(B)(1-B)^dY_t = c+\Theta(B)\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2), \tag{6.22}\]
y la parte ARMA que queda después de diferenciar satisface las condiciones de estacionariedad/causalidad e invertibilidad apropiadas (Hyndman y Athanasopoulos 2021, sec. 9.5; Prado et al. 2021, sec. 2.6).
Definiendo
\[ Z_t=\nabla^dY_t, \tag{6.23}\]
Ecuación 6.22 se convierte en
\[ \Phi(B)Z_t = c+\Theta(B)\varepsilon_t, \tag{6.24}\]
que es un ARMA(\(p,q\)) para \(\{Z_t\}\).
Esta equivalencia es más importante que memorizar el nombre ARIMA: el análisis ARMA de las semanas anteriores se aplica a la serie que resulta después de eliminar las raíces unitarias mediante diferenciación.
6.6.1 Casos especiales
| Modelo | Representación ARIMA | Comentario |
|---|---|---|
| Ruido blanco | ARIMA(0,0,0) sin constante | No requiere memoria ni diferenciación |
| AR(\(p\)) | ARIMA(\(p\),0,0) | Semana 2 |
| MA(\(q\)) | ARIMA(0,0,\(q\)) | Semana 3 |
| ARMA(\(p,q\)) | ARIMA(\(p\),0,\(q\)) | Semana 3 |
| Caminata aleatoria | ARIMA(0,1,0) sin constante | \(\nabla Y_t=\varepsilon_t\) |
| Caminata aleatoria con deriva | ARIMA(0,1,0) con constante | \(\nabla Y_t=c+\varepsilon_t\) |
6.6.2 Ejemplo algebraico: ARIMA(1,1,0)
Considere
\[ (1-\phi B)(1-B)Y_t=\varepsilon_t. \tag{6.25}\]
Como
\[ (1-B)Y_t=Y_t-Y_{t-1}, \]
obtenemos
\[ Y_t-Y_{t-1} = \phi(Y_{t-1}-Y_{t-2})+\varepsilon_t. \tag{6.26}\]
Es decir,
\[ \Delta Y_t = \phi\Delta Y_{t-1}+\varepsilon_t. \]
El nivel \(Y_t\) no es estacionario, pero sus cambios siguen un AR(1) estacionario cuando \(|\phi|<1\).
Expandiendo Ecuación 6.26,
\[ Y_t = (1+\phi)Y_{t-1}-\phi Y_{t-2}+\varepsilon_t. \]
Esta última expresión no debe interpretarse como un AR(2) estacionario ordinario: su polinomio contiene por construcción el factor \((1-B)\) y, por tanto, una raíz unitaria.
6.7 Constante, media de las diferencias y deriva
La constante de un ARIMA merece cuidado porque distintas parametrizaciones pueden producir coeficientes con nombres parecidos pero interpretaciones distintas.
Considere nuevamente
\[ \Phi(B)\nabla^dY_t = c+\Theta(B)\varepsilon_t. \]
Sea
\[ \mu_Z=E(\nabla^dY_t). \]
Tomando esperanzas en la parte estacionaria,
\[ \left(1-\sum_{j=1}^p\phi_j\right)\mu_Z=c, \]
y, por tanto,
\[ \mu_Z = \frac{c}{1-\sum_{j=1}^p\phi_j}. \tag{6.27}\]
Entonces:
- si \(d=0\), \(\mu_Z=E(Y_t)\) es la media del proceso estacionario;
- si \(d=1\), \(\mu_Z=E(\Delta Y_t)\) es el cambio promedio de largo plazo y genera una tendencia lineal en los niveles;
- para ARIMA(0,1,0), \(p=0\) y por tanto \(\mu_Z=c\): aquí sí la constante coincide directamente con la deriva por período.
Hyndman y Athanasopoulos señalan que fable::ARIMA() utiliza la parametrización de Ecuación 6.22. Otras implementaciones pueden parametrizar directamente mediante \(\mu_Z\). Por eso, comparar el coeficiente llamado intercept, constant o drift entre paquetes exige verificar la ecuación que usa cada software (Hyndman y Athanasopoulos 2021, sec. 9.7).
AdvertenciaUna constante con \(d>0\) induce tendencia en los pronósticos
Una constante en un modelo integrado no cumple el mismo papel visual que el intercepto de una regresión estática. Para \(d=1\) induce una tendencia lineal de largo plazo. Para diferencias de orden mayor puede inducir tendencias polinómicas peligrosas; por esa razón, implementaciones automáticas suelen restringir la inclusión de constantes cuando \(d\) es grande.
6.8 Pronóstico de una caminata aleatoria con deriva
La caminata aleatoria permite ver con claridad cómo la integración modifica el pronóstico.
Partiendo de
\[ Y_t=c+Y_{t-1}+\varepsilon_t, \]
iteramos \(h\) pasos:
\[ Y_{T+h} = Y_T+hc+\sum_{j=1}^h\varepsilon_{T+j}. \tag{6.28}\]
Condicional en la información disponible \(\mathcal F_T\),
\[ E(Y_{T+h}\mid\mathcal F_T) = Y_T+hc, \tag{6.29}\]
mientras que
\[ \operatorname{Var}(Y_{T+h}\mid\mathcal F_T) = h\sigma_\varepsilon^2. \tag{6.30}\]
Por tanto, la desviación estándar predictiva crece como \(\sqrt h\).
Comparemos esto con un AR(1) estacionario. En ese caso, a medida que \(h\) aumenta, el pronóstico converge hacia la media del proceso y la varianza del error converge hacia la varianza marginal. Para la caminata aleatoria, en cambio:
- el pronóstico no revierte hacia una media fija;
- el nivel futuro hereda el nivel observado \(Y_T\);
- la varianza predictiva crece sin cota con \(h\).
Shumway y Stoffer enfatizan precisamente este contraste entre pronósticos de procesos ARMA estacionarios y modelos integrados (Shumway y Stoffer 2025, secs. 3.4 y 3.6).
6.9 Reintegración de pronósticos
Suponga \(d=1\) y defina
\[ Z_t=\Delta Y_t. \]
Entonces
\[ Y_{T+1}=Y_T+Z_{T+1}, \]
\[ Y_{T+2}=Y_T+Z_{T+1}+Z_{T+2}, \]
y, en general,
\[ Y_{T+h} = Y_T+\sum_{j=1}^hZ_{T+j}. \tag{6.31}\]
Tomando esperanzas condicionales,
\[ \widehat Y_{T+h\mid T} = Y_T+ \sum_{j=1}^h \widehat Z_{T+j\mid T}. \tag{6.32}\]
La reintegración no consiste únicamente en sumar pronósticos puntuales. Para obtener intervalos correctos necesitamos propagar la distribución conjunta de los cambios futuros. En general,
\[ \operatorname{Var} \left( \sum_{j=1}^h Z_{T+j} \mid\mathcal F_T \right) = \sum_{i=1}^h\sum_{j=1}^h \operatorname{Cov} (Z_{T+i},Z_{T+j}\mid\mathcal F_T). \tag{6.33}\]
Los términos cruzados importan porque los errores de pronóstico de un ARMA para las diferencias pueden estar correlacionados entre horizontes. En la caminata aleatoria son particularmente simples porque los incrementos futuros son innovaciones independientes.
NotaLa transformación del modelo y la escala de comunicación pueden ser distintas
Podemos ajustar el modelo a \(\log(Y_t)\), a \(\Delta Y_t\) o a diferencias estacionales y, aun así, comunicar los pronósticos en la escala original. Un paquete de pronóstico puede automatizar parte de esta transformación inversa, pero conceptualmente siempre conviene identificar qué cantidad fue modelada y cómo se reconstruyó el futuro de \(Y_t\).
6.10 Estacionalidad: tres ideas que no deben confundirse
En la semana 1 utilizamos el término estacionalidad para describir patrones que se repiten aproximadamente con un período conocido. Para construir SARIMA necesitamos una distinción más fina.
6.10.1 Patrón estacional determinista
Un patrón estacional determinista puede representarse, por ejemplo, como
\[ Y_t=m_t+X_t, \qquad m_t=m_{t-S}, \tag{6.34}\]
donde \(m_t\) es una función periódica fija y \(X_t\) es estacionario. En este caso, variables indicadoras estacionales o términos de Fourier pueden ser alternativas naturales a la diferenciación. Retomaremos estas ideas en regresión dinámica.
6.10.2 Dependencia estacional estacionaria
Considere
\[ Y_t=\Phi_1Y_{t-S}+\varepsilon_t, \qquad |\Phi_1|<1. \tag{6.35}\]
Este proceso puede ser estacionario. Presenta dependencia fuerte entre observaciones separadas por \(S\) períodos, pero no tiene una raíz unitaria estacional. Su ACF puede mostrar una cola en los múltiplos \(S,2S,3S,\ldots\) que decae geométricamente.
6.10.3 Persistencia estacional o raíz unitaria estacional
Considere ahora
\[ Y_t=Y_{t-S}+\varepsilon_t. \tag{6.36}\]
Entonces
\[ (1-B^S)Y_t=\varepsilon_t. \]
El polinomio \(1-B^S\) tiene sus raíces sobre el círculo unitario. El nivel de una estación depende permanentemente del valor observado en la misma estación anterior. En este caso, una diferencia estacional es una transformación natural.
ImportanteOscilación anual no implica diferencia estacional
Una serie puede exhibir oscilaciones con una periodicidad aproximada y seguir siendo estacionaria. Recruitment, utilizada en las semanas anteriores, es un ejemplo pedagógico útil: Shumway y Stoffer muestran una ACF con ciclos cercanos a 12 meses y una PACF consistente con un AR(2), no con la necesidad automática de una diferencia estacional (Shumway y Stoffer 2025, Example 3.17).
La pregunta correcta no es solamente “¿veo un ciclo anual?”, sino “¿hay evidencia de persistencia estacional no estacionaria que deba eliminarse mediante \(1-B^S\)?”.
6.11 Diferenciación estacional
Para período estacional \(S\), definimos
\[ \nabla_S = 1-B^S, \]
y
\[ \nabla_SY_t = Y_t-Y_{t-S}. \tag{6.37}\]
Una diferencia estacional compara una observación con la misma posición del ciclo anterior. Para una serie mensual con \(S=12\),
\[ \nabla_{12}Y_t = Y_t-Y_{t-12}. \]
Si se requieren \(D\) diferencias estacionales,
\[ \nabla_S^DY_t =(1-B^S)^DY_t. \tag{6.38}\]
En la práctica, \(D=1\) suele ser suficiente cuando existe persistencia estacional (Shumway y Stoffer 2025, sec. 3.9).
6.11.1 Diferencia regular y estacional juntas
Para datos mensuales, aplicar una diferencia regular y una diferencia estacional produce
\[ (1-B)(1-B^{12})Y_t. \]
Expandiendo,
\[ \begin{aligned} (1-B)(1-B^{12})Y_t &=(1-B-B^{12}+B^{13})Y_t\\ &=Y_t-Y_{t-1}-Y_{t-12}+Y_{t-13}. \end{aligned} \tag{6.39}\]
Podemos interpretarla como
\[ (Y_t-Y_{t-12})-(Y_{t-1}-Y_{t-13}), \]
es decir, el cambio de la diferencia anual de un mes al siguiente; o equivalentemente como la diferencia anual del cambio mensual. Los operadores conmutan:
\[ (1-B)(1-B^{12}) = (1-B^{12})(1-B). \]
Hyndman y Athanasopoulos recomiendan examinar primero la diferencia estacional cuando la estacionalidad es fuerte, porque en algunos casos ésta elimina también suficiente tendencia y hace innecesaria una diferencia regular adicional (Hyndman y Athanasopoulos 2021, sec. 9.1).
6.12 Una primera exploración computacional de diferencias estacionales
Utilizaremos las ventas mensuales australianas de medicamentos H02 del conjunto PBS. Este ejemplo aparece en Hyndman y Athanasopoulos y es útil porque combina una varianza que crece ligeramente con el nivel, estacionalidad fuerte y una decisión no completamente obvia sobre cuántas diferencias aplicar (Hyndman y Athanasopoulos 2021, secs. 9.1 y 9.9).
h02 <- PBS |>
  filter(ATC2 == "H02") |>
  summarise(Cost = sum(Cost) / 1e6)

stopifnot(
  nrow(h02) > 100,
  !anyNA(h02$Cost),
  all(is.finite(h02$Cost)),
  all(h02$Cost > 0)
)

h02_transformada <- h02 |>
  mutate(
    log_Cost = log(Cost),
    dif_estacional = difference(log_Cost, 12),
    dif_doble = difference(dif_estacional)
  )
h02_transformada |>
transmute(
Month,
`Ventas (millones)` = Cost,
`Log ventas` = log_Cost,
`Diferencia estacional del log` = dif_estacional,
`Diferencia estacional + regular` = dif_doble
) |>
pivot_longer(
cols = -Month,
names_to = "Transformación",
values_to = "Valor"
) |>
ggplot(aes(x = Month, y = Valor)) +
geom_line() +
facet_wrap(~ Transformación, ncol = 1, scales = "free_y") +
labs(x = NULL, y = NULL)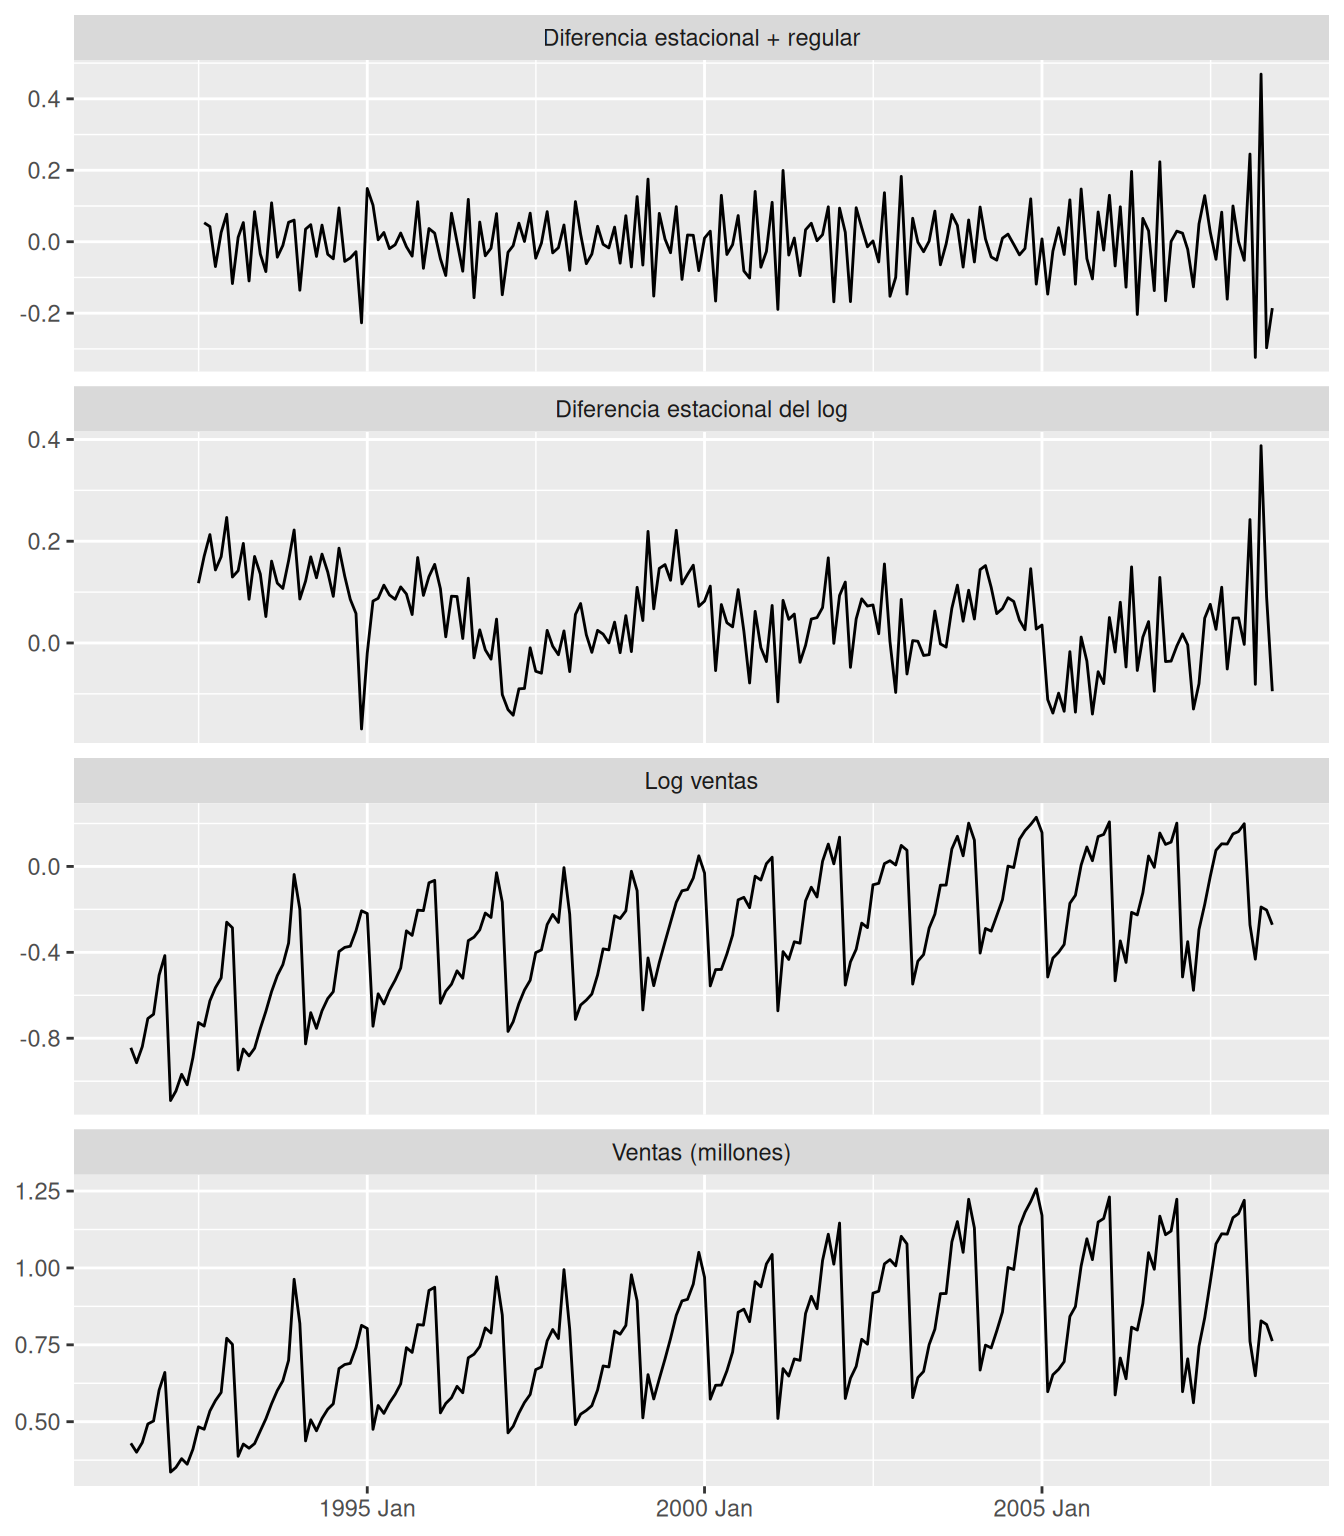
La transformación logarítmica busca estabilizar la dispersión relativa; la diferenciación busca estabilizar la media. Son operaciones conceptualmente distintas.
6.12.1 ¿Cuántas diferencias sugieren las herramientas automáticas?
sugerencia_D_h02 <- h02 |>
  mutate(log_Cost = log(Cost)) |>
  features(log_Cost, unitroot_nsdiffs)

sugerencia_d_despues_D <- h02 |>
  mutate(log_Cost_d12 = difference(log(Cost), 12)) |>
  features(log_Cost_d12, unitroot_ndiffs)

sugerencias_h02 <- tibble(
  Herramienta = c(
    "unitroot_nsdiffs() sobre log(Cost)",
    "unitroot_ndiffs() después de diferencia estacional"
  ),
  Sugerencia = c(
    sugerencia_D_h02$nsdiffs[[1]],
    sugerencia_d_despues_D$ndiffs[[1]]
  )
)

knitr::kable(
  sugerencias_h02,
  caption = "Sugerencias automáticas de diferencias para la serie H02."
)| Herramienta | Sugerencia |
|---|---|
| unitroot_nsdiffs() sobre log(Cost) | 1 |
| unitroot_ndiffs() después de diferencia estacional | 1 |
Nota
unitroot_nsdiffs() no es una prueba KPSS estacional
Aunque el nombre contiene unitroot, la implementación descrita en FPP3 usa una medida de fuerza estacional para sugerir \(D\). unitroot_ndiffs() sí utiliza una secuencia de pruebas KPSS para sugerir \(d\). Conviene conocer esta diferencia antes de interpretar ambos resultados como si provinieran del mismo contraste estadístico (Hyndman y Athanasopoulos 2021, sec. 9.1).
No aceptaremos estas sugerencias sin inspeccionar también las series transformadas y sus ACF/PACF.
h02 |>
  gg_tsdisplay(
    difference(log(Cost), 12),
    plot_type = "partial",
    lag_max = 36
  ) +
  labs(title = "H02: logaritmo con una diferencia estacional")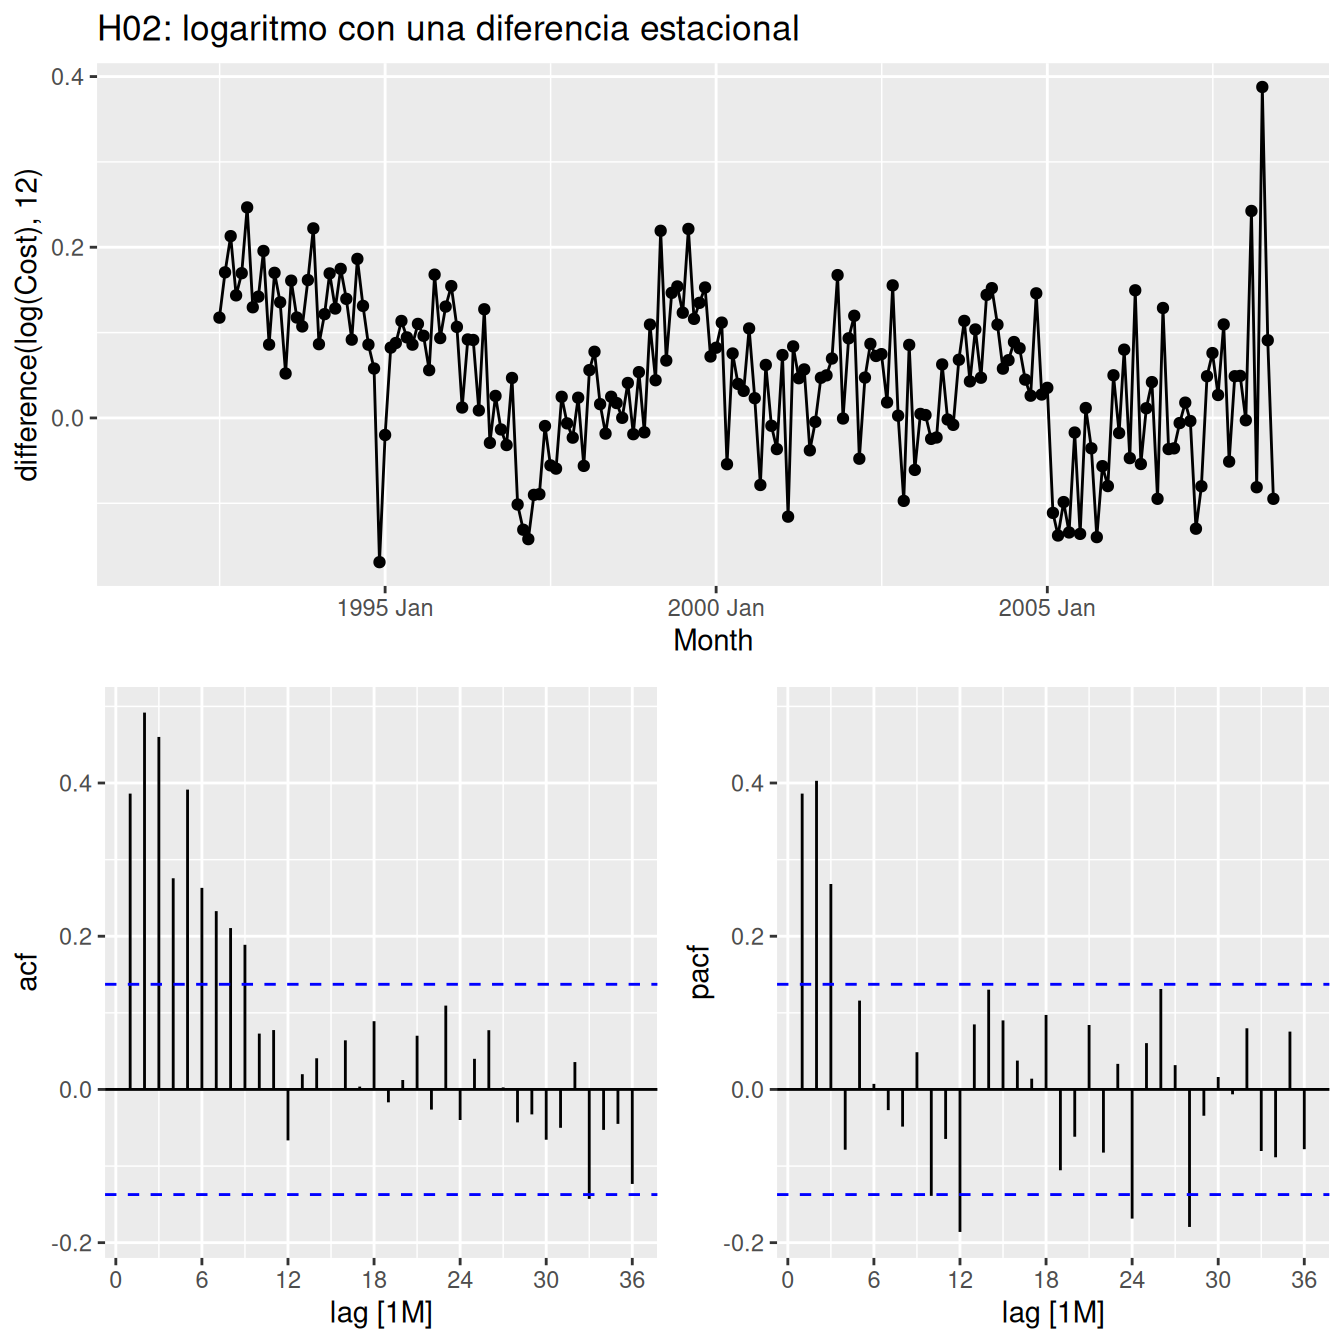
6.13 Modelo SARIMA multiplicativo
Definamos los polinomios no estacionales
\[ \Phi(B) = 1-\phi_1B-\cdots-\phi_pB^p, \]
\[ \Theta(B) = 1+\theta_1B+\cdots+\theta_qB^q, \]
y los polinomios estacionales
\[ \Phi_S(B^S) = 1-\Phi_1B^S-\cdots-\Phi_PB^{PS}, \]
\[ \Theta_S(B^S) = 1+\Theta_1B^S+\cdots+\Theta_QB^{QS}. \]
Un modelo SARIMA multiplicativo se escribe
\[ \Phi(B)\Phi_S(B^S) (1-B)^d(1-B^S)^D Y_t = c+ \Theta(B)\Theta_S(B^S)\varepsilon_t. \tag{6.40}\]
La notación compacta es
\[ \operatorname{ARIMA}(p,d,q)\times(P,D,Q)_S. \]
Los órdenes tienen la siguiente interpretación.
| Símbolo | Interpretación |
|---|---|
| \(p\) | orden AR no estacional |
| \(d\) | número de diferencias regulares |
| \(q\) | orden MA no estacional |
| \(P\) | orden AR estacional |
| \(D\) | número de diferencias estacionales |
| \(Q\) | orden MA estacional |
| \(S\) | período estacional |
La palabra multiplicativo es esencial. No significa que multipliquemos observaciones; significa que los operadores estacionales y no estacionales se multiplican algebraicamente. Esto genera interacciones en rezagos combinados.
6.13.1 Ejemplo: ARIMA(0,1,1)\(\times\)(0,1,1)\(_{12}\)
Sin constante,
\[ (1-B)(1-B^{12})Y_t = (1+\theta B)(1+\Theta B^{12})\varepsilon_t. \tag{6.41}\]
El lado izquierdo es
\[ Y_t-Y_{t-1}-Y_{t-12}+Y_{t-13}. \]
El lado derecho es
\[ \varepsilon_t +\theta\varepsilon_{t-1} +\Theta\varepsilon_{t-12} +\theta\Theta\varepsilon_{t-13}. \]
Por tanto,
\[ \begin{aligned} Y_t ={}&Y_{t-1}+Y_{t-12}-Y_{t-13}\\ &+\varepsilon_t +\theta\varepsilon_{t-1} +\Theta\varepsilon_{t-12} +\theta\Theta\varepsilon_{t-13}. \end{aligned} \tag{6.42}\]
El coeficiente de \(\varepsilon_{t-13}\) no es un parámetro adicional: está restringido a ser el producto \(\theta\Theta\). Esta reducción de parámetros es una de las razones prácticas para utilizar la estructura multiplicativa (Shumway y Stoffer 2025, Example 3.44).
6.14 ACF y PACF en los rezagos estacionales
Después de escoger transformaciones y diferencias, ACF y PACF vuelven a tener el papel estudiado en las semanas 2 y 3. La diferencia es que ahora miramos dos escalas:
- rezagos cortos \(1,2,3,\ldots\) para los órdenes no estacionales \(p\) y \(q\);
- rezagos \(S,2S,3S,\ldots\) para los órdenes estacionales \(P\) y \(Q\).
Como heurística:
| Componente puro | ACF en \(S,2S,\ldots\) | PACF en \(S,2S,\ldots\) |
|---|---|---|
| SAR(\(P\)) | cola | corte aproximado después de \(PS\) |
| SMA(\(Q\)) | corte aproximado después de \(QS\) | cola |
| SARMA(\(P,Q\)) | cola | cola |
AdvertenciaNo leer la tabla de forma mecánica
En un SARIMA multiplicativo, componentes estacionales y no estacionales interactúan. Pueden aparecer señales en rezagos vecinos de \(S\), combinaciones como \(S+1\) y estructuras menos limpias que las de un componente puro. ACF/PACF sirven para generar candidatos, no para demostrar que un único modelo es verdadero.
Shumway y Stoffer recomiendan una estrategia secuencial: buscar primero diferencias que produzcan una serie aproximadamente estacionaria; después estudiar los rezagos estacionales para \(P,Q\); luego los rezagos cortos para \(p,q\); ajustar varios candidatos; diagnosticar; y finalmente utilizar criterios de información para reducir el conjunto (Shumway y Stoffer 2025, sec. 3.9).
6.15 Identificación, estimación y diagnóstico de ARIMA
El ciclo de la semana 4 sigue vigente, pero ahora incluye una etapa previa de transformación y diferenciación:
\[ \boxed{ \text{transformar} \to \text{diferenciar} \to \text{identificar} \to \text{estimar} \to \text{diagnosticar} \to \text{pronosticar} } \]
Una secuencia razonable es:
- graficar la serie y revisar valores atípicos o cambios estructurales;
- considerar una transformación para estabilizar la varianza;
- decidir \(D\) y \(d\) usando el menor número de diferencias razonable;
- estudiar ACF/PACF de la serie ya diferenciada;
- proponer un conjunto pequeño de \((p,q,P,Q)\);
- estimar cada candidato por máxima verosimilitud;
- comparar AICc entre candidatos con los mismos órdenes de diferenciación;
- revisar innovaciones, ACF residual y Ljung–Box;
- reformular si queda dependencia sistemática;
- construir pronósticos y, en la semana 7, evaluar fuera de muestra.
6.15.1 Comparabilidad de AICc cuando cambia la diferenciación
En Sección 4.9.4 enfatizamos que los criterios de información sólo son comparables cuando las verosimilitudes corresponden a la misma variable observada y a un tratamiento compatible de la muestra.
En ARIMA esto tiene una consecuencia práctica importante: cambiar \(d\) o \(D\) cambia la transformación y el número de observaciones sobre las que se calcula la verosimilitud. FPP3 recomienda no usar AICc para escoger el orden de diferenciación. Primero se decide una diferenciación razonable y después AICc puede ayudar a seleccionar \(p,q,P,Q\) dentro de esa representación (Hyndman y Athanasopoulos 2021, sec. 9.6).
La evaluación fuera de muestra no tiene esta restricción: dos modelos con diferentes órdenes de diferenciación pueden compararse mediante errores de pronóstico sobre las mismas observaciones futuras. Esa distinción será central en la semana 7.
6.16 Modelación automática con fable
La función ARIMA() puede seleccionar automáticamente una especificación. En su comportamiento por defecto, el algoritmo combina:
- herramientas para elegir \(d\) y \(D\);
- máxima verosimilitud para estimar parámetros;
- AICc para elegir órdenes AR y MA;
- una búsqueda eficiente sobre el espacio de modelos.
Para una serie datos con variable Y, una especificación automática básica es
ajuste <- datos |>
  model(auto = ARIMA(Y))
Podemos fijar órdenes explícitos con pdq() y PDQ():
ajuste <- datos |>
  model(
    candidato = ARIMA(
      Y ~ pdq(p, d, q) + PDQ(P, D, Q)
    )
  )
En datos regulares, fable puede inferir el período estacional a partir del índice.
ImportanteAutomatizar la búsqueda no automatiza el análisis
El algoritmo automático no sustituye:
- la inspección de la serie;
- la decisión de transformar;
- la interpretación de las diferencias;
- la revisión de observaciones atípicas o quiebres;
- el diagnóstico residual;
- ni la evaluación fuera de muestra.
Un modelo con el AICc mínimo puede seguir dejando autocorrelación residual o ser inferior predictivamente a un modelo más sencillo.
6.17 Aplicación completa: ventas H02
Retomemos la serie h02. Nuestro objetivo es construir una especificación SARIMA justificando cada etapa, no reproducir una receta automática.
6.17.1 Paso 1. Transformación y diferenciación
La trayectoria original muestra una ligera relación entre nivel y variabilidad. Trabajaremos con
\[ X_t=\log(Y_t). \]
El patrón estacional es fuerte, por lo que consideramos
\[ W_t=(1-B^{12})X_t. \]
Como vimos en Figura 6.4, la decisión de añadir además una diferencia regular no es completamente obvia. Esta ambigüedad es pedagógicamente útil: en una aplicación real, diferentes analistas pueden proponer especificaciones cercanas y deben resolver la comparación mediante diagnóstico y evaluación predictiva.
Para mantener comparables los AICc de nuestros candidatos manuales, comenzaremos con \(D=1\) y \(d=0\).
6.17.2 Paso 2. Candidatos a partir de ACF/PACF
Después de la diferencia estacional, FPP3 observa señales compatibles con componentes AR no estacionales y estacionales, pero también muestra que el patrón no identifica un único modelo simple. Utilizaremos un pequeño conjunto de candidatos con el mismo \((d,D)=(0,1)\) (Hyndman y Athanasopoulos 2021, sec. 9.9).
fit_h02 <- h02 |>
  model(
    arima_301_012 = ARIMA(
      log(Cost) ~ 0 + pdq(3, 0, 1) + PDQ(0, 1, 2)
    ),
    arima_301_111 = ARIMA(
      log(Cost) ~ 0 + pdq(3, 0, 1) + PDQ(1, 1, 1)
    ),
    arima_301_011 = ARIMA(
      log(Cost) ~ 0 + pdq(3, 0, 1) + PDQ(0, 1, 1)
    ),
    arima_300_210 = ARIMA(
      log(Cost) ~ 0 + pdq(3, 0, 0) + PDQ(2, 1, 0)
    )
  )
6.17.3 Paso 3. Criterios de información
tabla_ic_h02 <- glance(fit_h02) |>
  select(.model, sigma2, log_lik, AIC, AICc, BIC) |>
  arrange(AICc)

knitr::kable(
  tabla_ic_h02,
  digits = 3,
  caption = "Criterios de información para candidatos H02 con los mismos órdenes de diferenciación d=0 y D=1."
)| .model | sigma2 | log_lik | AIC | AICc | BIC |
|---|---|---|---|---|---|
| arima_301_012 | 0.004 | 250.042 | -486.084 | -485.475 | -463.282 |
| arima_301_111 | 0.004 | 249.430 | -484.860 | -484.251 | -462.057 |
| arima_301_011 | 0.004 | 248.061 | -484.121 | -483.667 | -464.576 |
| arima_300_210 | 0.005 | 243.789 | -475.577 | -475.123 | -456.032 |
Todos estos AICc son comparables porque los candidatos utilizan la misma transformación log(Cost) y los mismos órdenes \(d=0\), \(D=1\). El menor AICc identifica un candidato preferido dentro de este conjunto, no una verdad única.
6.17.4 Paso 4. Parámetros estimados
coef_h02 <- tidy(fit_h02) |>
  arrange(.model, term)

knitr::kable(
  coef_h02,
  digits = 4,
  caption = "Estimaciones por máxima verosimilitud de los candidatos SARIMA para H02."
)| .model | term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|---|
| arima_300_210 | ar1 | 0.0983 | 0.0695 | 1.4140 | 0.1590 |
| arima_300_210 | ar2 | 0.4060 | 0.0611 | 6.6431 | 0.0000 |
| arima_300_210 | ar3 | 0.4311 | 0.0726 | 5.9401 | 0.0000 |
| arima_300_210 | sar1 | -0.4361 | 0.0795 | -5.4867 | 0.0000 |
| arima_300_210 | sar2 | -0.2900 | 0.0780 | -3.7191 | 0.0003 |
| arima_301_011 | ar1 | -0.1060 | 0.1637 | -0.6472 | 0.5183 |
| arima_301_011 | ar2 | 0.5110 | 0.0842 | 6.0680 | 0.0000 |
| arima_301_011 | ar3 | 0.5458 | 0.0972 | 5.6129 | 0.0000 |
| arima_301_011 | ma1 | 0.2923 | 0.1878 | 1.5564 | 0.1213 |
| arima_301_011 | sma1 | -0.6384 | 0.0735 | -8.6865 | 0.0000 |
| arima_301_012 | ar1 | -0.1603 | 0.1636 | -0.9798 | 0.3284 |
| arima_301_012 | ar2 | 0.5481 | 0.0878 | 6.2399 | 0.0000 |
| arima_301_012 | ar3 | 0.5678 | 0.0942 | 6.0275 | 0.0000 |
| arima_301_012 | ma1 | 0.3827 | 0.1895 | 2.0189 | 0.0449 |
| arima_301_012 | sma1 | -0.5222 | 0.0861 | -6.0614 | 0.0000 |
| arima_301_012 | sma2 | -0.1768 | 0.0872 | -2.0286 | 0.0439 |
| arima_301_111 | ar1 | -0.1389 | 0.1669 | -0.8320 | 0.4065 |
| arima_301_111 | ar2 | 0.5370 | 0.0884 | 6.0750 | 0.0000 |
| arima_301_111 | ar3 | 0.5577 | 0.0969 | 5.7565 | 0.0000 |
| arima_301_111 | ma1 | 0.3501 | 0.1929 | 1.8150 | 0.0711 |
| arima_301_111 | sar1 | 0.1946 | 0.1187 | 1.6401 | 0.1026 |
| arima_301_111 | sma1 | -0.7525 | 0.0890 | -8.4590 | 0.0000 |
Además de examinar la magnitud de los coeficientes, debemos verificar que la parte autorregresiva estacionaria y la parte de medias móviles satisfagan las condiciones de estacionariedad e invertibilidad. En los ajustes por máxima verosimilitud, fable::ARIMA() utiliza internamente stats::arima(). Para los coeficientes AR, este procedimiento emplea por defecto una reparametrización basada en autocorrelaciones parciales que mantiene el polinomio autorregresivo dentro de la región de estacionariedad durante la optimización. El tratamiento de los coeficientes MA es ligeramente distinto: no se restringen necesariamente durante la optimización, pero el ajuste final se transforma a una representación invertible. Adicionalmente, durante la selección automática fable descarta candidatos cuyas raíces AR o MA se encuentren demasiado próximas al círculo unitario. Aun así, resulta pedagógicamente útil verificar directamente las raíces del modelo ajustado: la parte AR es estacionaria y la parte MA es invertible cuando las raíces de sus respectivos polinomios característicos tienen módulo estrictamente mayor que uno.
6.17.5 Paso 5. Diagnóstico del candidato con menor AICc
Extraemos el nombre del candidato con menor AICc y usamos ese modelo para el diagnóstico detallado.
mejor_h02_nombre <- tabla_ic_h02 |>
  slice_min(AICc, n = 1, with_ties = FALSE) |>
  pull(.model)

fit_h02_mejor <- fit_h02 |>
  select(all_of(mejor_h02_nombre))
fit_h02_mejor |>
gg_tsresiduals(lag_max = 36)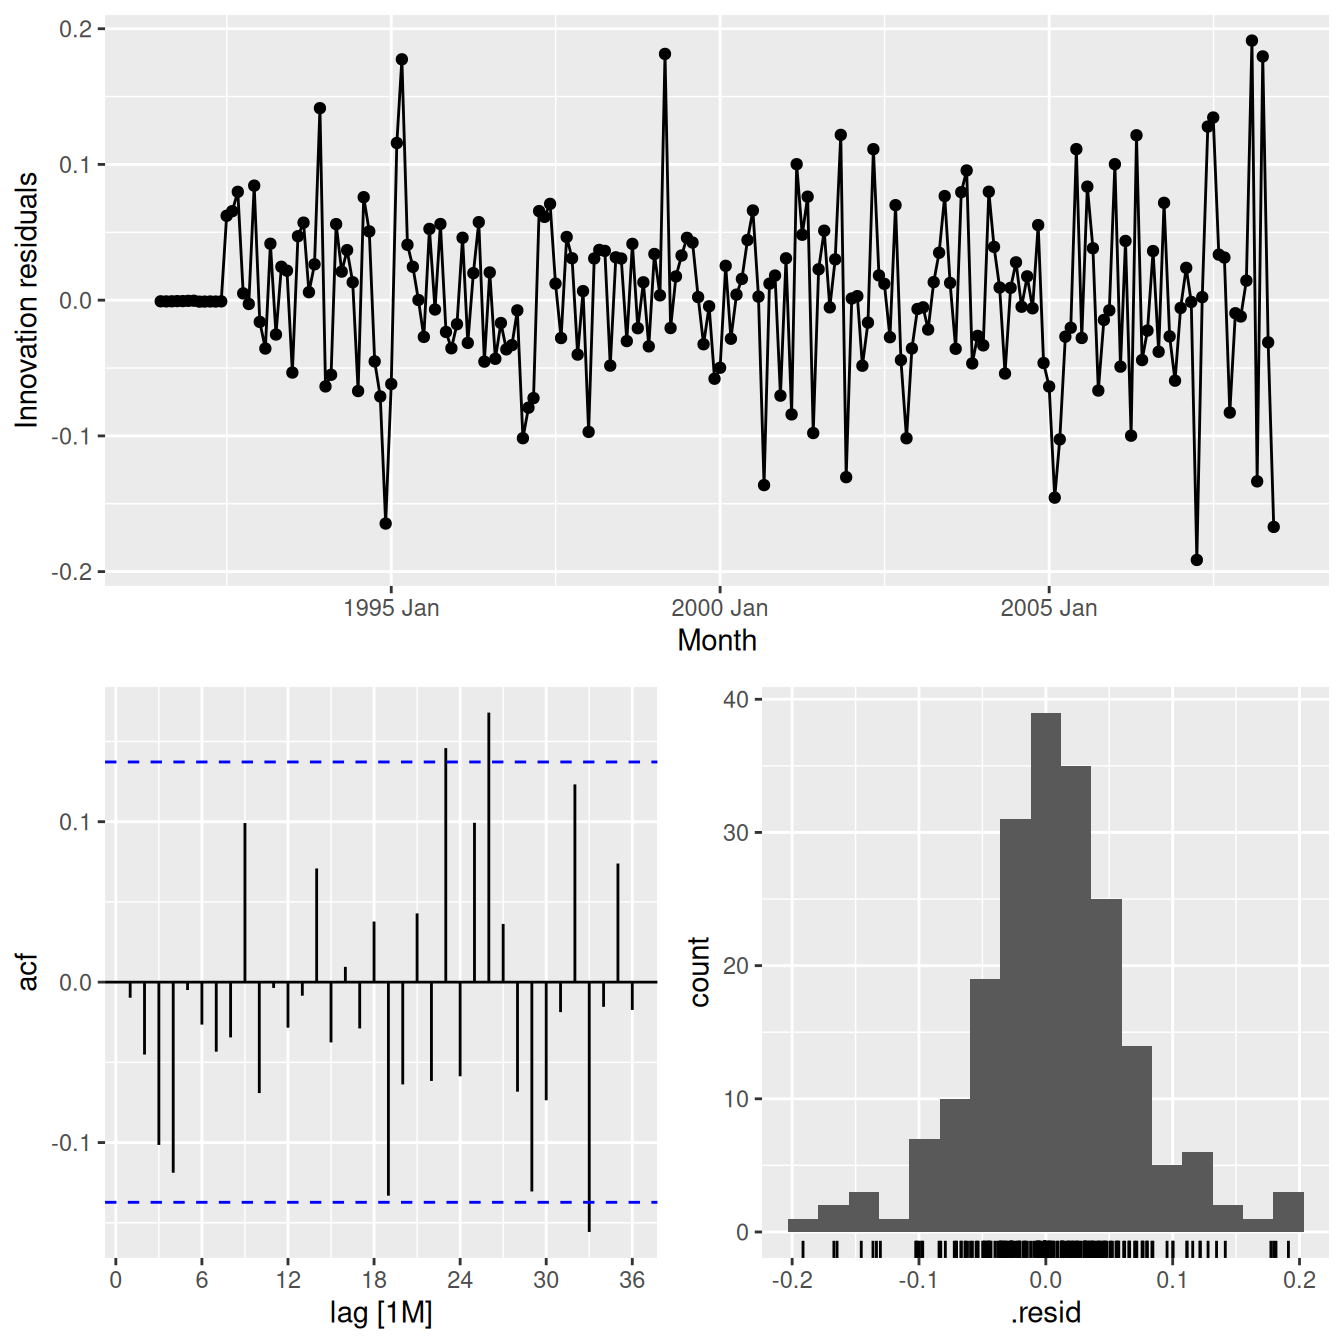
La ausencia de estructura evidente es deseable, pero no basta con una inspección visual. Aplicamos Ljung–Box a las innovaciones.
Como el número de parámetros AR/MA depende del candidato seleccionado, calculamos los grados de libertad a partir de la tabla de coeficientes, excluyendo términos deterministas si los hubiera.
k_h02 <- tidy(fit_h02_mejor) |>
  filter(term != "constant") |>
  nrow()

lb_h02 <- augment(fit_h02_mejor) |>
  features(
    .innov,
    ljung_box,
    lag = 36,
    dof = k_h02
  )

knitr::kable(
  lb_h02,
  digits = 4,
  caption = "Prueba de Ljung--Box para las innovaciones del SARIMA H02 seleccionado."
)| .model | lb_stat | lb_pvalue |
|---|---|---|
| arima_301_012 | 50.712 | 0.0104 |
NotaUn modelo útil puede no superar cada diagnóstico
En el análisis H02 de FPP3, algunos candidatos con buen AICc conservan autocorrelación residual y no superan Ljung–Box en ciertos rezagos. Esto no debe ocultarse. Significa que el modelo es una aproximación incompleta y que los intervalos predictivos pueden estar mal calibrados. El siguiente paso no es declarar que el modelo “es correcto”, sino comparar alternativas y evaluar pronósticos (Hyndman y Athanasopoulos 2021, sec. 9.9).
6.17.6 Paso 6. Comparación con selección automática
Ajustamos también un modelo mediante búsqueda automática de los órdenes AR y MA, pero manteniendo los mismos órdenes de diferenciación que usamos en los candidatos manuales: \(d=0\) y \(D=1\). De esta manera, el AICc del modelo automático sí es comparable con los AICc de la tabla anterior. Además, fijamos la ausencia de constante mediante 0 +, igual que en los candidatos manuales.
fit_h02_auto <- h02 |>
  model(
    auto = ARIMA(
      log(Cost) ~ 0 +
        pdq(p = 0:5, d = 0, q = 0:5) +
        PDQ(P = 0:2, D = 1, Q = 0:2)
    ),
    .safely = FALSE
  )

report(fit_h02_auto)
Series: Cost
Model: ARIMA(3,0,0)(0,1,1)[12]
Transformation: log(Cost)
Coefficients:
ar1 ar2 ar3 sma1
0.1408 0.4165 0.4093 -0.6302
s.e. 0.0716 0.0615 0.0716 0.0728
sigma^2 estimated as 0.004388: log likelihood=247.09
AIC=-484.19 AICc=-483.87 BIC=-467.9El argumento .safely = FALSE es útil en una nota reproducible: si el ajuste falla, model() mostrará el error original en lugar de sustituir silenciosamente el ajuste por un modelo nulo. Esto hace que los problemas de estimación sean visibles en el punto donde ocurren.
resumen_h02_auto <- glance(fit_h02_auto)

knitr::kable(
  resumen_h02_auto |>
    select(.model, sigma2, log_lik, AIC, AICc, BIC),
  digits = 3,
  caption = "Resumen del modelo ARIMA seleccionado automáticamente para H02, condicionado a d=0 y D=1."
)| .model | sigma2 | log_lik | AIC | AICc | BIC |
|---|---|---|---|---|---|
| auto | 0.004 | 247.095 | -484.189 | -483.867 | -467.902 |
Esta búsqueda automática no reemplaza el razonamiento anterior: únicamente recorre de manera sistemática un conjunto de órdenes \((p,q,P,Q)\) una vez fijada la transformación y la diferenciación. Como extensión, ARIMA(log(Cost)) permite que el algoritmo escoja también \(d\) y \(D\). En ese caso puede obtenerse una representación con órdenes de diferenciación distintos y sus AICc no deben mezclarse con los de los modelos con \(d=0\) y \(D=1\). Esa comparación se realizará de manera limpia mediante desempeño fuera de muestra en la semana 7.
6.17.7 Paso 7. Pronóstico
Para visualizar las implicaciones del modelo manual seleccionado, generamos 24 meses de pronóstico.
fc_h02 <- fit_h02_mejor |>
  forecast(h = 24)
fc_h02 |>
autoplot(h02, level = c(80, 95)) +
labs(
x = NULL,
y = "Costo (millones de dólares australianos)",
title = "Pronóstico SARIMA para H02"
)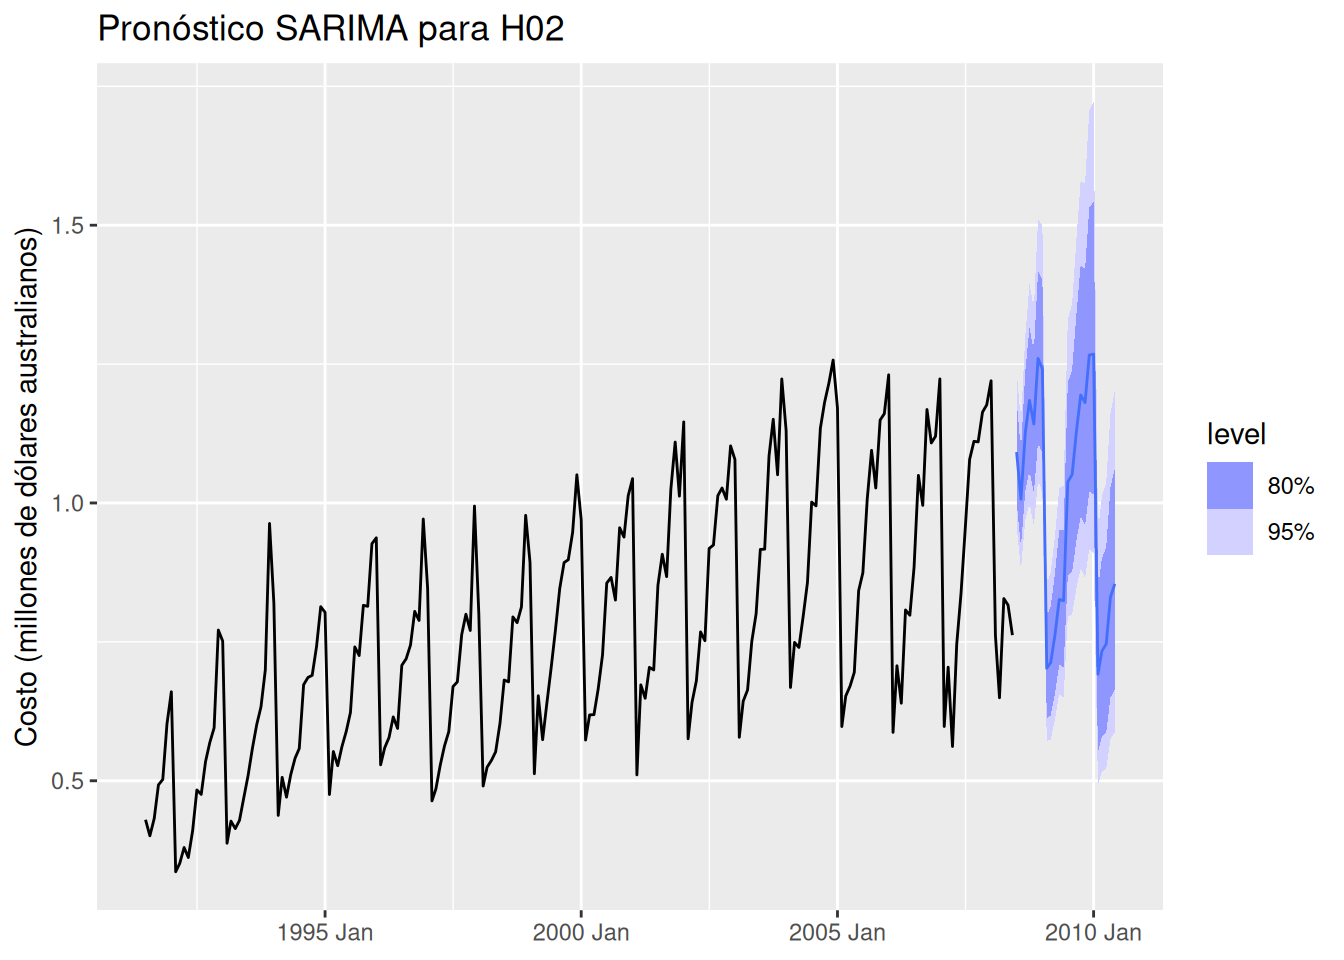
Aunque el modelo fue ajustado a log(Cost), fable conserva la transformación y devuelve la distribución predictiva en la escala de Cost. Conceptualmente, esto combina dos operaciones distintas: invertir el logaritmo e invertir las diferencias estacionales implícitas en el modelo.
6.17.8 Conclusión provisional de H02
La aplicación ilustra varios principios que conviene separar:
- transformar el nivel puede estabilizar la varianza;
- diferenciar puede eliminar tendencia o persistencia estacional;
- ACF/PACF de la serie diferenciada sugieren candidatos, no una respuesta única;
- AICc sirve para comparar órdenes AR/MA cuando la diferenciación es compatible;
- un AICc pequeño no reemplaza diagnóstico residual;
- la selección automática es una herramienta de búsqueda;
- la calidad predictiva todavía no ha sido medida de manera sistemática.
Este último punto es deliberado: la semana 7 cambiará el criterio de comparación desde “¿qué modelo describe mejor la muestra ajustada?” hacia “¿qué modelo pronostica mejor observaciones que no utilizó para estimarse?”.
6.18 Un puente bayesiano: ARIMA como AR sobre las diferencias
Con el objetivo de incluir una formulación bayesiana de ARIMA, no necesitamos construir esta semana un MCMC general para todos los parámetros de un SARIMA. Podemos obtener una conexión más transparente reutilizando exactamente la lógica de la semana 5.
Considere
\[ \Delta Y_t = \phi\Delta Y_{t-1}+\varepsilon_t, \qquad |\phi|<1, \tag{6.43}\]
que corresponde a un ARIMA(1,1,0) sin constante. Defina
\[ Z_t=\Delta Y_t. \]
Entonces
\[ Z_t=\phi Z_{t-1}+\varepsilon_t, \]
que es exactamente el AR(1) de media cero estudiado en Sección 5.4.1.
Condicionado en \(z_1\), la verosimilitud es
\[ p(z_{2:T}\mid z_1,\phi,v) \propto v^{-(T-1)/2} \exp\left \{ -\frac{1}{2v} \sum_{t=2}^T (z_t-\phi z_{t-1})^2 \right\}, \tag{6.44}\]
con \(v=\sigma_\varepsilon^2\).
Si utilizamos la priori de referencia
\[ p(\phi,v)\propto\frac{1}{v}, \]
podemos generar directamente muestras posteriores de \((\phi,v)\) mediante las expresiones derivadas en la semana 5. La novedad aparece en el pronóstico: cada trayectoria futura de \(Z_t\) debe acumularse para regresar a \(Y_t\).
6.18.1 Simulación de un ARIMA(1,1,0)
T_bayes_arima <- 120
phi_true_arima <- 0.65
sigma_true_arima <- 0.8

z_sim <- numeric(T_bayes_arima)
z_sim[1] <- rnorm(
  1,
  sd = sigma_true_arima / sqrt(1 - phi_true_arima^2)
)

for (t in 2:T_bayes_arima) {
  z_sim[t] <-
    phi_true_arima * z_sim[t - 1] +
    rnorm(1, sd = sigma_true_arima)
}

y_sim <- 100 + cumsum(z_sim)

arima_bayes_sim <- tibble(
  t = seq_len(T_bayes_arima),
  Nivel = y_sim,
  Diferencia = z_sim
)
arima_bayes_sim |>
pivot_longer(
cols = c(Nivel, Diferencia),
names_to = "Escala",
values_to = "Valor"
) |>
ggplot(aes(x = t, y = Valor)) +
geom_line() +
facet_wrap(~ Escala, ncol = 1, scales = "free_y") +
labs(x = "Tiempo", y = NULL)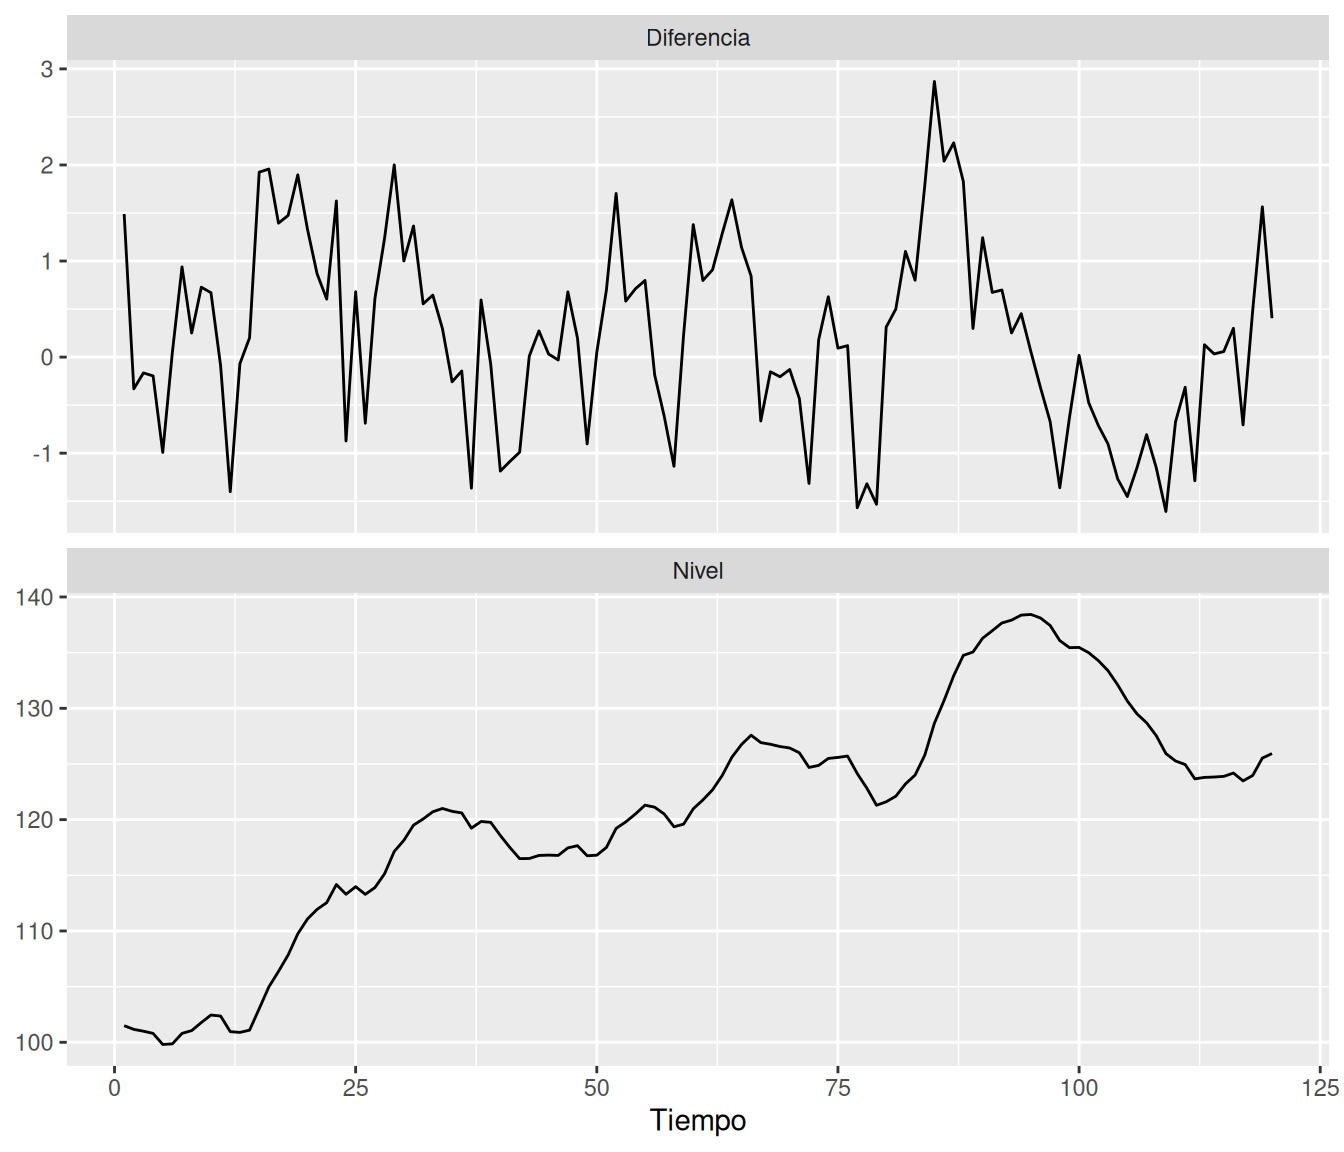
6.18.2 Posterior de referencia para \(\phi\) y \(v\)
Para el AR(1) de media cero sobre \(Z_t\), definimos
\[ S_{xx}=\sum_{t=2}^Tz_{t-1}^2, \qquad S_{xy}=\sum_{t=2}^Tz_{t-1}z_t, \]
y
\[ \widehat\phi=\frac{S_{xy}}{S_{xx}}. \]
La suma de cuadrados residual es
\[ R=\sum_{t=2}^T(z_t-\widehat\phi z_{t-1})^2. \]
Con la priori de referencia, y escribiendo \(n=T-1\) y \(\nu=n-1\),
\[ v\mid z_{1:T} \sim \operatorname{IG}\left(\frac{\nu}{2},\frac{R}{2}\right), \]
y
\[ \phi\mid v,z_{1:T} \sim N\left( \widehat\phi, \frac{v}{S_{xx}} \right). \]
z_resp <- z_sim[-1]
z_lag <- z_sim[-length(z_sim)]

Sxx_arima <- sum(z_lag^2)
Sxy_arima <- sum(z_lag * z_resp)
phi_hat_arima <- Sxy_arima / Sxx_arima
rss_arima <- sum((z_resp - phi_hat_arima * z_lag)^2)

n_arima <- length(z_resp)
nu_arima <- n_arima - 1
M_arima <- 5000

v_draw_arima <- 1 / rgamma(
  M_arima,
  shape = nu_arima / 2,
  rate = rss_arima / 2
)

phi_draw_arima <- rnorm(
  M_arima,
  mean = phi_hat_arima,
  sd = sqrt(v_draw_arima / Sxx_arima)
)

posterior_arima110 <- tibble(
  phi = phi_draw_arima,
  v = v_draw_arima,
  estacionario_diferencias = abs(phi_draw_arima) < 1
)
resumen_arima110 <- posterior_arima110 |>
summarise(
media_phi = mean(phi),
sd_phi = sd(phi),
q025_phi = quantile(phi, 0.025),
q975_phi = quantile(phi, 0.975),
prob_estacionario = mean(estacionario_diferencias),
media_sigma = mean(sqrt(v))
)
knitr::kable(
resumen_arima110,
digits = 4,
caption = "Resumen posterior del componente AR(1) de las diferencias en el ARIMA(1,1,0) simulado."
)| media_phi | sd_phi | q025_phi | q975_phi | prob_estacionario | media_sigma |
|---|---|---|---|---|---|
| 0.6525 | 0.0692 | 0.516 | 0.7861 | 1 | 0.7619 |
La condición \(|\phi|<1\) se refiere a la estacionariedad de las diferencias. El proceso \(Y_t\) continúa siendo integrado por construcción.
6.18.3 Predictiva posterior y reintegración
Para cada muestra \((\phi^{(m)},v^{(m)})\) simulamos recursivamente
\[ Z_{T+h}^{(m)} = \phi^{(m)}Z_{T+h-1}^{(m)} + \varepsilon_{T+h}^{(m)}, \]
con
\[ \varepsilon_{T+h}^{(m)} \sim N(0,v^{(m)}), \]
y reconstruimos
\[ Y_{T+h}^{(m)} = Y_T+ \sum_{j=1}^hZ_{T+j}^{(m)}. \tag{6.45}\]
h_bayes_arima <- 24
n_draw_pred <- 3000

idx_pred <- sample.int(M_arima, n_draw_pred)

trayectorias_y <- matrix(
  NA_real_,
  nrow = n_draw_pred,
  ncol = h_bayes_arima
)

for (m in seq_len(n_draw_pred)) {
  phi_m <- phi_draw_arima[idx_pred[m]]
  v_m <- v_draw_arima[idx_pred[m]]

  z_prev <- tail(z_sim, 1)
  y_prev <- tail(y_sim, 1)

  for (h in seq_len(h_bayes_arima)) {
    z_new <- rnorm(1, mean = phi_m * z_prev, sd = sqrt(v_m))
    y_new <- y_prev + z_new

    trayectorias_y[m, h] <- y_new
    z_prev <- z_new
    y_prev <- y_new
  }
}

pred_bayes_arima <- tibble(
  h = seq_len(h_bayes_arima),
  media = apply(trayectorias_y, 2, mean),
  q025 = apply(trayectorias_y, 2, quantile, probs = 0.025),
  q20 = apply(trayectorias_y, 2, quantile, probs = 0.20),
  q80 = apply(trayectorias_y, 2, quantile, probs = 0.80),
  q975 = apply(trayectorias_y, 2, quantile, probs = 0.975)
)
hist_bayes_arima <- tibble(
t = seq_len(T_bayes_arima),
y = y_sim
)
pred_plot_arima <- pred_bayes_arima |>
mutate(t = T_bayes_arima + h)
ggplot() +
geom_line(
data = hist_bayes_arima,
aes(x = t, y = y)
) +
geom_ribbon(
data = pred_plot_arima,
aes(x = t, ymin = q025, ymax = q975),
alpha = 0.20
) +
geom_ribbon(
data = pred_plot_arima,
aes(x = t, ymin = q20, ymax = q80),
alpha = 0.25
) +
geom_line(
data = pred_plot_arima,
aes(x = t, y = media),
linewidth = 0.8
) +
labs(
x = "Tiempo",
y = expression(Y[t]),
title = "Predictiva posterior reintegrada"
)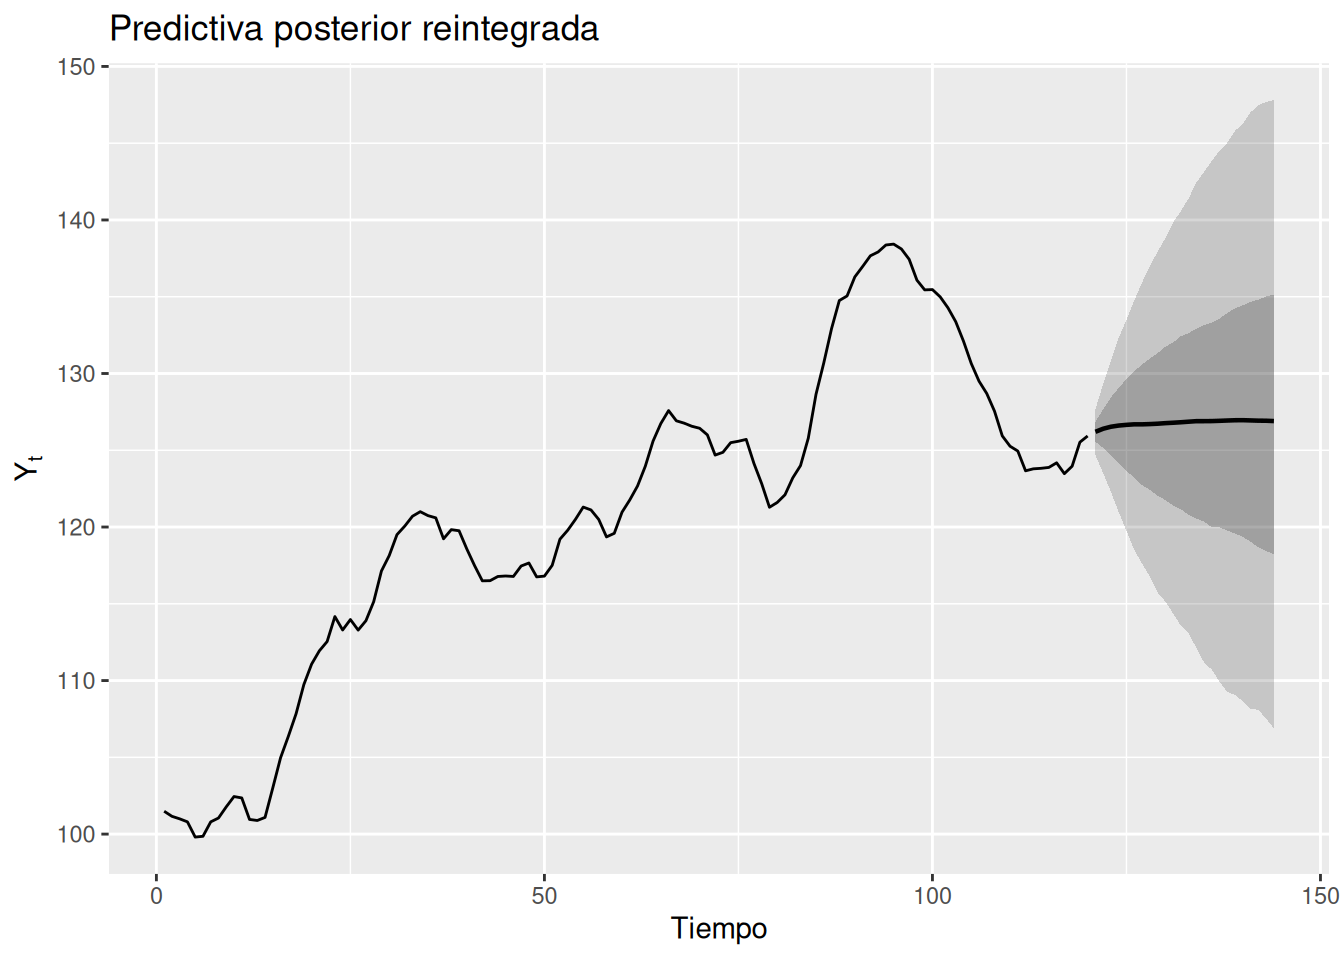
Este algoritmo ilustra la idea esencial de la inferencia bayesiana ARIMA: la incertidumbre sobre parámetros y futuras innovaciones se propaga primero en la dinámica estacionaria de las diferencias y después hacia la escala integrada. Un SARIMA bayesiano completo añade más coeficientes, restricciones de raíces y, en general, cálculo posterior numérico. No desarrollaremos ese problema completo esta semana.
NotaQué queda fijo en este ejemplo bayesiano
Tratamos \(d=1\) y el orden AR(1) de las diferencias como decisiones conocidas. La posterior cuantifica incertidumbre condicional en esa especificación. Una inferencia que también promediara sobre \(d\), \(p\) o modelos estacionales requeriría una capa adicional de comparación o selección de modelos.
6.19 Pronóstico razonado frente a selección automática
Llegados a este punto, podemos distinguir dos usos legítimos de la automatización.
Uso 1: herramienta de búsqueda. Proponemos un modelo a partir de teoría, transformaciones, ACF/PACF y contexto, y utilizamos una búsqueda automática para comprobar si existen candidatos cercanos con menor AICc.
Uso 2: referencia reproducible. En una aplicación con muchas series, un procedimiento automático puede servir como base común, siempre que se diagnostique y se evalúe posteriormente.
Lo que debemos evitar es interpretar
ARIMA(Y)como una conclusión estadística autosuficiente. El algoritmo no conoce la pregunta científica ni la pérdida asociada a errores predictivos específicos.
6.20 Actividad computacional guiada
6.20.1 Parte A. Tendencia determinista frente a estocástica
- Simule una serie de longitud 200 con \(Y_t=0.05t+X_t\), donde \(X_t\) es AR(1) con \(\phi=0.7\).
- Simule una caminata aleatoria con deriva \(c=0.05\) y la misma varianza de innovación.
- Ajuste una tendencia lineal a ambas y compare ACF de los residuales.
- Diferencie ambas y compare ACF de las diferencias.
- Explique por qué ninguna transformación debe escogerse únicamente por el aspecto visual de una gráfica.
6.20.2 Parte B. Raíz casi unitaria
- Simule AR(1) con \(\phi\in\{0.7,0.95,0.99,1\}\).
- Para cada caso, grafique trayectoria y ACF muestral.
- Repita el experimento con varias semillas.
- Discuta la dificultad de distinguir \(\phi=0.99\) de \(\phi=1\) con una muestra corta.
6.20.3 Parte C. Diferenciación y sobrediferenciación
- Simule ruido blanco y calcule su primera diferencia.
- Verifique empíricamente que la ACF en rezago 1 se aproxima a \(-1/2\).
- Simule una caminata aleatoria y compare ACF antes y después de diferenciar.
- Formule una regla práctica que use el menor número posible de diferencias.
6.20.4 Parte D. Estacionalidad
Simule un SAR(1) mensual
\[ Y_t=0.8Y_{t-12}+\varepsilon_t. \]
Simule una caminata estacional
\[ Y_t=Y_{t-12}+\varepsilon_t. \]
Compare ACF y PACF.
Aplique \(\nabla_{12}\) a ambas y explique por qué la misma transformación no es igualmente necesaria en los dos casos.
6.20.5 Parte E. H02
- Reproduzca Figura 6.3.
- Compare visualmente \(D=1,d=0\) con \(D=1,d=1\).
- Proponga dos modelos adicionales con \(D=1,d=0\).
- Compárelos mediante AICc.
- Diagnostique los dos mejores candidatos.
- Compare sus pronósticos a 24 meses sin calcular todavía métricas fuera de muestra.
6.20.6 Parte F. Bayes
- Repita Sección 6.18.1 con \(\phi=0.9\).
- Compare la posterior de \(\phi\) con la obtenida para \(\phi=0.65\).
- Genere trayectorias predictivas a 36 pasos.
- Explique por qué la incertidumbre en niveles aumenta aunque las diferencias sean estacionarias.
6.21 Puente hacia evaluación fuera de muestra
Hasta ahora hemos utilizado tres tipos de evidencia:
- estructura teórica y ACF/PACF;
- criterios de información dentro de muestra;
- diagnóstico de innovaciones.
Ninguna responde directamente a la pregunta
¿qué tan bien habría pronosticado el modelo datos que todavía no estaban disponibles al estimarlo?
En la semana 7 construiremos particiones temporales de entrenamiento y prueba, origen móvil, ventanas expansivas y móviles, y métricas que dependen del horizonte. Entonces podremos comparar bajo las mismas observaciones futuras modelos que incluso tengan diferentes transformaciones u órdenes de diferenciación.
ImportanteAICc y RMSE responden preguntas diferentes
AICc penaliza complejidad a partir de la verosimilitud ajustada. RMSE, MAE o MASE miden errores sobre realizaciones futuras. Un modelo puede tener el menor AICc entre candidatos comparables y no ser el mejor pronosticador en el período de evaluación.
También incorporaremos cobertura y amplitud de intervalos. Esto será especialmente importante para modelos integrados, cuya incertidumbre predictiva puede crecer rápidamente con el horizonte.
6.22 Síntesis
Las ideas centrales de la semana son las siguientes:
- una trayectoria tendencial puede provenir de una tendencia determinista o de una tendencia estocástica;
- una raíz unitaria es una raíz del polinomio autorregresivo sobre el círculo unitario y marca una ruptura con la estacionariedad AR usual;
- la caminata aleatoria es el caso ARIMA(0,1,0), y con constante se convierte en una caminata aleatoria con deriva;
- el operador \(\nabla=1-B\) transforma niveles en cambios de un período;
- \(Y_t\sim I(d)\) cuando \(\nabla^dY_t\) es estacionario y \(d\) es el menor orden que lo logra;
- sobrediferenciar puede crear dependencia artificial;
- un ARIMA(\(p,d,q\)) es un ARMA(\(p,q\)) para \(Z_t=\nabla^dY_t\);
- la constante de un ARIMA no siempre es igual a la deriva: su relación con la media de las diferencias depende de la parte AR;
- reintegrar pronósticos requiere acumular la distribución conjunta de cambios futuros;
- patrón estacional, dependencia estacional estacionaria y raíz unitaria estacional son conceptos diferentes;
- la diferencia estacional \(\nabla_SY_t=Y_t-Y_{t-S}\) es apropiada para persistencia estacional, no para toda oscilación visible;
- los modelos SARIMA multiplicativos combinan operadores regulares y estacionales y generan términos de interacción en rezagos combinados;
- después de diferenciar, ACF/PACF sugieren órdenes regulares y estacionales;
- KPSS,
unitroot_ndiffs()yunitroot_nsdiffs()son auxiliares, no sustitutos del análisis estadístico; - AICc no debe utilizarse ingenuamente para comparar modelos con diferentes órdenes de diferenciación;
- selección automática debe acompañarse de diagnóstico y evaluación;
- H02 muestra que una aplicación real puede dejar ambigüedad residual incluso después de una modelación cuidadosa;
- desde Bayes, un ARIMA puede verse como inferencia sobre una dinámica estacionaria de las diferencias seguida de reintegración de la predictiva posterior;
- la semana 7 reemplazará la comparación puramente dentro de muestra por evaluación predictiva temporal.
6.23 Ejercicios
6.23.1 Conceptuales
Tendencias. Explique la diferencia entre
\[ Y_t=\beta_0+\beta_1t+X_t \]
con \(X_t\) estacionario, y
\[ Y_t=c+Y_{t-1}+\varepsilon_t. \]
¿Qué ocurre con el efecto de una perturbación en cada modelo?
Raíz unitaria. ¿Por qué \(\phi=1\) no es simplemente un valor “muy persistente” del AR(1), sino un caso cualitativamente distinto?
Integración. Interprete \(Y_t\sim I(2)\). ¿Qué cantidad modelaría con un ARMA?
Diferencia. En una serie mensual de desempleo, ¿cómo interpretaría \(\Delta Y_t\)? ¿Y \(\Delta_{12}Y_t\)?
Sobrediferenciación. Explique por qué una ACF con un gran valor negativo en el primer rezago después de diferenciar puede ser una señal de que se aplicó una diferencia innecesaria.
KPSS. ¿Cuál es la hipótesis nula de la prueba KPSS utilizada en FPP3? ¿Qué sugiere un valor \(p\) pequeño?
Automatización. ¿Por qué
unitroot_ndiffs()no elimina la necesidad de inspeccionar la serie?Estacionalidad. Distinga patrón estacional determinista, SAR(1) estacionario y caminata aleatoria estacional.
Recruitment. Una ACF muestra oscilaciones cercanas a 12 meses y la PACF se corta después del rezago 2. ¿Por qué no concluiría automáticamente \(D=1\)?
SARIMA. Interprete cada símbolo en ARIMA(2,1,1)\(\times\)(1,1,1)\(_{12}\).
Multiplicativo. ¿Qué significa que un SARIMA sea multiplicativo? ¿Qué restricción aparece en el coeficiente del rezago 13 en Ecuación 6.42?
AICc. Explique por qué no es recomendable escoger entre ARIMA(1,0,1) y ARIMA(1,1,1) únicamente comparando sus AICc.
Pronóstico. ¿Por qué la varianza del pronóstico de una caminata aleatoria crece con \(h\) mientras que la de un AR(1) estacionario converge a una constante?
Bayes. En Ecuación 6.43, ¿la condición \(|\phi|<1\) hace estacionario a \(Y_t\) o solamente a \(\Delta Y_t\)?
Diagnóstico. Un SARIMA tiene el menor AICc, pero Ljung–Box rechaza ruido blanco. ¿Qué haría antes de usarlo como modelo final?
6.23.2 Derivaciones
Varianza de la caminata aleatoria. A partir de Ecuación 6.3, derive Ecuación 6.5.
Autocovarianza no estacionaria. Para una caminata aleatoria con \(Y_0=0\), demuestre que
\[ \operatorname{Cov}(Y_s,Y_t) =\min(s,t)\sigma_\varepsilon^2. \]
Diferencia segunda. Expanda \((1-B)^2Y_t\) y derive Ecuación 6.8.
Sobrediferenciación. Si \(Y_t=\varepsilon_t\) es ruido blanco con varianza \(\sigma^2\), derive la función de autocovarianza de \(W_t=Y_t-Y_{t-1}\) y demuestre que \(\rho_W(1)=-1/2\).
ARIMA(1,1,0). Expanda Ecuación 6.25 en niveles y muestre que el polinomio AR resultante tiene una raíz unitaria.
Constante. Partiendo de Ecuación 6.24, derive Ecuación 6.27.
Pronóstico con deriva. Derive Ecuación 6.29 y Ecuación 6.30.
Reintegración. Demuestre Ecuación 6.31 por inducción.
Varianza reintegrada. Derive Ecuación 6.33 y explique por qué no se puede, en general, reemplazar por una simple suma de varianzas marginales.
Diferencia estacional. Para \(S=4\), expanda \((1-B)(1-B^4)Y_t\).
Raíces estacionales. Muestre que las raíces de \(1-z^S=0\) tienen módulo uno. Interprete este resultado como una colección de raíces unitarias estacionales.
SARIMA multiplicativo. Expanda
\[ (1-\phi B)(1-\Phi B^{12})Y_t \]
y explique el origen del término en rezago 13.
MA estacional. Para
\[ Y_t=\varepsilon_t+\Theta\varepsilon_{t-12}, \]
derive \(\gamma(0)\), \(\gamma(12)\) y muestre que las demás autocovarianzas no nulas, salvo simetría, desaparecen.
SAR(1). Para Ecuación 6.35, derive la autocorrelación en los rezagos \(kS\) y compare su forma con la de un AR(1) ordinario.
Bayes y reintegración. Condicionado en \((\phi,v)\), escriba la distribución de \(Z_{T+1}\) en Ecuación 6.43 y explique cómo obtener la distribución de \(Y_{T+1}\).
6.23.3 Computacionales
Casi raíz unitaria. Simule 500 trayectorias de longitud 100 para \(\phi=0.95\), \(0.99\) y \(1\). Compare la distribución muestral de la ACF en rezago 1.
KPSS. Aplique
unitroot_kpss()yunitroot_ndiffs()a las simulaciones del ejercicio anterior. Estudie con qué frecuencia sugieren diferenciar.Sobrediferenciación. Simule AR(1) con \(\phi=0.6\). Compare ARIMA ajustados con \(d=0\) y \(d=1\). Examine residuos y AICc dentro de grupos comparables, y discuta por qué no basta con ordenar todos los AICc conjuntamente.
Deriva. Simule una caminata aleatoria con \(c=0.2\). Estime un ARIMA(0,1,0) con y sin constante y compare los pronósticos a 20 pasos.
Reintegración manual. Ajuste un AR(1) a las primeras diferencias de una serie simulada ARIMA(1,1,0). Pronostique las diferencias y reconstruya manualmente los niveles. Compare con
ARIMA().SAR frente a diferencia estacional. Simule \(Y_t=0.8Y_{t-12}+\varepsilon_t\). Ajuste un modelo con \(D=0\) y otro con \(D=1\). Compare diagnóstico y comportamiento de las diferencias.
Caminata estacional. Simule \(Y_t=Y_{t-12}+\varepsilon_t\). Verifique que una diferencia estacional produce aproximadamente ruido blanco.
Doble diferencia. Con H02, compare gráficamente
difference(log(Cost), 12)ydifference(difference(log(Cost), 12)). Argumente si \(d=0\) o \(d=1\) parece más razonable después de \(D=1\).H02 manual. Añada al menos tres candidatos SARIMA con \(d=0,D=1\) a Sección 6.17. Compare AICc y diagnóstico.
H02 automático. Ejecute
ARIMA(log(Cost))y documente la especificación seleccionada. Si sus órdenes de diferenciación difieren de los candidatos manuales, explique por qué no los ordenaría directamente mediante AICc.H02 sin logaritmo. Repita el análisis principal sin transformar
Cost. Compare residuales y pronósticos. Discuta el papel de estabilizar la varianza.Ljung–Box. Para el candidato H02 preferido, calcule Ljung–Box en rezagos 12, 24 y 36 con grados de libertad apropiados. ¿Las conclusiones dependen del horizonte diagnóstico?
Recruitment. Retome
astsa::rec. Compare visualmente su ACF/PACF con la de una serie simulada con raíz unitaria estacional. Explique por qué una periodicidad visible no es suficiente para justificar \(D=1\).Predictiva bayesiana. Repita Sección 6.18.3 con \(T=40\) y \(T=400\). Compare la amplitud de la predictiva posterior a 24 pasos y explique el papel de la incertidumbre paramétrica.
Sensibilidad bayesiana. Reemplace la priori de referencia del ejemplo ARIMA(1,1,0) por una priori normal propia para \(\phi\). Compare posterior y predictiva para una muestra corta.
Preparación para semana 7. Reserve los últimos 24 meses de H02. Ajuste dos modelos candidatos únicamente al período de entrenamiento y genere pronósticos para el bloque reservado. Calcule provisionalmente MAE y RMSE, pero no haga todavía validación con origen móvil. Explique por qué esta comparación sí puede incluir modelos con distintos órdenes de diferenciación.
6.24 Lecturas recomendadas
Para esta semana:
- Hyndman y Athanasopoulos: sección 9.1 para estacionariedad, diferenciación regular, diferenciación estacional y KPSS; secciones 9.5–9.7 para ARIMA, estimación, AICc, constantes y selección automática; sección 9.9 para SARIMA y la aplicación H02 (Hyndman y Athanasopoulos 2021).
- Shumway y Stoffer: capítulo 3, especialmente las secciones sobre modelos integrados, construcción de modelos ARIMA y modelos SARIMA multiplicativos. Su tratamiento complementa FPP3 con derivaciones probabilísticas y una discusión explícita de persistencia estacional (Shumway y Stoffer 2025, secs. 3.6–3.9).
- Prado, Ferreira y West: sección 1.4 para diferenciación y sección 2.6 para la formulación compacta de ARIMA y SARMA. La conexión bayesiana de este capítulo reutiliza la inferencia AR desarrollada en sus secciones 2.3–2.4 y en la semana 5 (Prado et al. 2021).
La semana 7 utilizará estos modelos como candidatos predictivos y formalizará entrenamiento–prueba, origen móvil, MAE, RMSE, MASE, cobertura y evaluación probabilística.