n_train_over <- 55
n_test_over <- 35
n_over <- n_train_over + n_test_over

t_over <- seq_len(n_over)
x_over <- (t_over - 1) / (n_over - 1)

y_over <- 2 + 1.5 * x_over + 0.6 * sin(2 * pi * 3 * x_over) +
  rnorm(n_over, sd = 0.35)

datos_over <- tibble(
  t = t_over,
  x = x_over,
  y = y_over,
  conjunto = if_else(t <= n_train_over, "Entrenamiento", "Prueba")
)

train_over <- datos_over |>
  filter(conjunto == "Entrenamiento")

test_over <- datos_over |>
  filter(conjunto == "Prueba")

fit_over_simple <- lm(y ~ x + sin(2 * pi * 3 * x) + cos(2 * pi * 3 * x),
                      data = train_over)
fit_over_flexible <- lm(y ~ poly(x, 18), data = train_over)

pred_over <- bind_rows(
  datos_over |>
    transmute(
      t,
      conjunto,
      modelo = "Estructura simple",
      observado = y,
      pronostico = predict(fit_over_simple, newdata = datos_over)
    ),
  datos_over |>
    transmute(
      t,
      conjunto,
      modelo = "Polinomio grado 18",
      observado = y,
      pronostico = predict(fit_over_flexible, newdata = datos_over)
    )
)

resumen_over <- pred_over |>
  mutate(error = observado - pronostico) |>
  group_by(modelo, conjunto) |>
  summarise(
    RMSE = sqrt(mean(error^2)),
    MAE = mean(abs(error)),
    .groups = "drop"
)7 Evaluación fuera de muestra y validación temporal
CA-0415 Series de Tiempo — Semana 7
7.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
- distinguir entre ajuste dentro de muestra, diagnóstico residual y evaluación predictiva fuera de muestra;
- definir con precisión el origen del pronóstico, el horizonte, el conjunto de información disponible y el error \(e_{t+h\mid t}\);
- construir una partición temporal entrenamiento–prueba sin utilizar información futura;
- reconocer formas comunes de fuga de información (data leakage) en un experimento de pronóstico;
- utilizar métodos de referencia —media, naïve, naïve estacional y deriva— como puntos de comparación explícitos;
- calcular e interpretar MAE, RMSE y MASE, incluyendo la escala de cada medida y la construcción correcta del denominador de MASE;
- explicar por qué distintas funciones de pérdida implican distintos pronósticos puntuales óptimos;
- distinguir una evaluación con origen fijo de una validación con origen móvil;
- implementar ventanas expansivas y ventanas móviles y explicar cuándo cada diseño puede ser razonable;
- evaluar el desempeño de un método como función del horizonte \(h\);
- estudiar intervalos predictivos mediante cobertura, amplitud y la puntuación de Winkler;
- evaluar cuantiles y distribuciones predictivas completas mediante quantile score y CRPS;
- interpretar el log-score como una extensión para evaluar densidades predictivas;
- diseñar una comparación justa entre procedimientos frecuentistas y bayesianos;
- implementar validación temporal con
stretch_tsibble(),slide_tsibble(),forecast()yaccuracy(); - reevaluar los modelos ARIMA de H02 de la semana 6 utilizando observaciones que no participaron en el ajuste;
- formular un protocolo reproducible de evaluación que pueda reutilizarse en ETS, análisis espectral predictivo, volatilidad y modelos de espacio-estado durante el resto del curso.
En Sección 5.18 y Sección 6.21 dejamos abierta la misma pregunta:
¿qué tan bien pronostica un procedimiento cuando se enfrenta a observaciones que no utilizó para estimarse, seleccionarse ni ajustarse?
Hasta la semana 6 usamos criterios de información, inspección de innovaciones y pruebas de diagnóstico para decidir si un modelo era una representación razonable de la muestra observada. Esas herramientas siguen siendo necesarias, pero responden a preguntas diferentes. Esta semana cambia deliberadamente la unidad de análisis: el objeto principal deja de ser solamente el modelo ajustado y pasa a ser el procedimiento de pronóstico completo, incluyendo la información disponible en cada fecha, las decisiones de selección y la forma en que se cuantifica la incertidumbre.
La guía bibliográfica del curso asigna esta semana a evaluación fuera de muestra y validación temporal, con Hyndman y Athanasopoulos como texto conductor (Hyndman y Athanasopoulos 2021, chap. 5). En particular, utilizaremos sus secciones sobre métodos de referencia, evaluación puntual, evaluación distribucional y validación cruzada para series temporales (Hyndman y Athanasopoulos 2021, secs. 5.2, 5.8–5.10). La comparación bayesiana retoma la distribución predictiva posterior estudiada en la semana 5 (Prado et al. 2021, secs. 2.2–2.4).
El flujo de trabajo que utilizaremos a partir de esta semana será
\[ \boxed{ \text{definir pregunta y horizonte} \longrightarrow \text{elegir referencia} \longrightarrow \text{separar información} \longrightarrow \text{ajustar} \longrightarrow \text{pronosticar} \longrightarrow \text{evaluar} \longrightarrow \text{repetir en varios orígenes} }. \]
7.2 Del ajuste al desempeño predictivo
Suponga que disponemos de una serie
\[ y_{1:T}=(y_1,\ldots,y_T). \]
Si ajustamos un modelo a esas mismas \(T\) observaciones, podemos estudiar sus valores ajustados, sus innovaciones y su verosimilitud. También podemos comparar modelos mediante AIC, AICc o BIC cuando la comparación está bien definida. Sin embargo, ninguna de esas cantidades constituye por sí misma una observación de cómo se comportaría el procedimiento ante un valor que todavía no estaba disponible.
Hyndman y Athanasopoulos enfatizan que la precisión predictiva debe evaluarse con pronósticos genuinos, es decir, con observaciones no utilizadas al ajustar el método (Hyndman y Athanasopoulos 2021, sec. 5.8). Un modelo puede ajustar muy bien la muestra de entrenamiento y, aun así, pronosticar mal.
7.2.1 Residual e error de pronóstico no son sinónimos
En un modelo temporal, una innovación o residual de un paso dentro de la muestra suele escribirse como
\[ \widehat\varepsilon_t = y_t-\widehat y_{t\mid t-1}, \tag{7.1}\]
pero el modelo, sus parámetros o incluso su orden pueden haber sido seleccionados utilizando observaciones posteriores a \(t\). En cambio, un error de pronóstico genuinamente fuera de muestra es
\[ e_{t+h\mid t} = y_{t+h}-\widehat y_{t+h\mid t}, \tag{7.2}\]
donde todo lo que intervino en \(\widehat y_{t+h\mid t}\) debe haber sido determinado utilizando únicamente información disponible hasta el origen \(t\).
Hay dos diferencias conceptuales importantes (Hyndman y Athanasopoulos 2021, sec. 5.8):
- los residuales se calculan sobre observaciones utilizadas para ajustar o seleccionar el modelo, mientras que los errores de pronóstico se calculan sobre observaciones reservadas para evaluación;
- los residuales habituales son de un paso, mientras que los errores de pronóstico pueden corresponder a cualquier horizonte \(h\geq1\).
ImportanteUn residual pequeño no es una garantía predictiva
Un procedimiento suficientemente flexible puede reducir fuertemente el error dentro de muestra. Eso no implica que haya aprendido estructura estable. La evaluación fuera de muestra pregunta si esa estructura se mantiene cuando el procedimiento enfrenta información nueva.
7.2.2 Una ilustración de sobreajuste
El siguiente experimento no pretende modelar una serie compleja. Su único objetivo es mostrar que aumentar flexibilidad siempre puede mejorar o mantener el ajuste dentro de muestra, pero no necesariamente el desempeño posterior.
knitr::kable(
  resumen_over,
  digits = 3,
  caption = "Error dentro de muestra y fuera de muestra en una ilustración de sobreajuste."
)| modelo | conjunto | RMSE | MAE |
|---|---|---|---|
| Estructura simple | Entrenamiento | 3.540000e-01 | 2.810000e-01 |
| Estructura simple | Prueba | 3.990000e-01 | 3.250000e-01 |
| Polinomio grado 18 | Entrenamiento | 2.870000e-01 | 2.270000e-01 |
| Polinomio grado 18 | Prueba | 2.201835e+09 | 8.914402e+08 |
ggplot() +
  geom_line(
    data = datos_over,
    aes(x = t, y = y),
    linewidth = 0.4,
    colour = "gray35"
  ) +
  geom_point(
    data = datos_over,
    aes(x = t, y = y),
    size = 1,
    colour = "gray35"
  ) +
  geom_line(
    data = pred_over,
    aes(x = t, y = pronostico, colour = modelo, linetype = modelo),
    linewidth = 0.8
  ) +
  facet_wrap(~ conjunto, ncol = 1, scales = "free_y") +
  labs(
    x = "Tiempo",
    y = expression(Y[t]),
    colour = "Modelo",
    linetype = "Modelo"
  ) +
  theme(
    legend.position = "bottom"
  )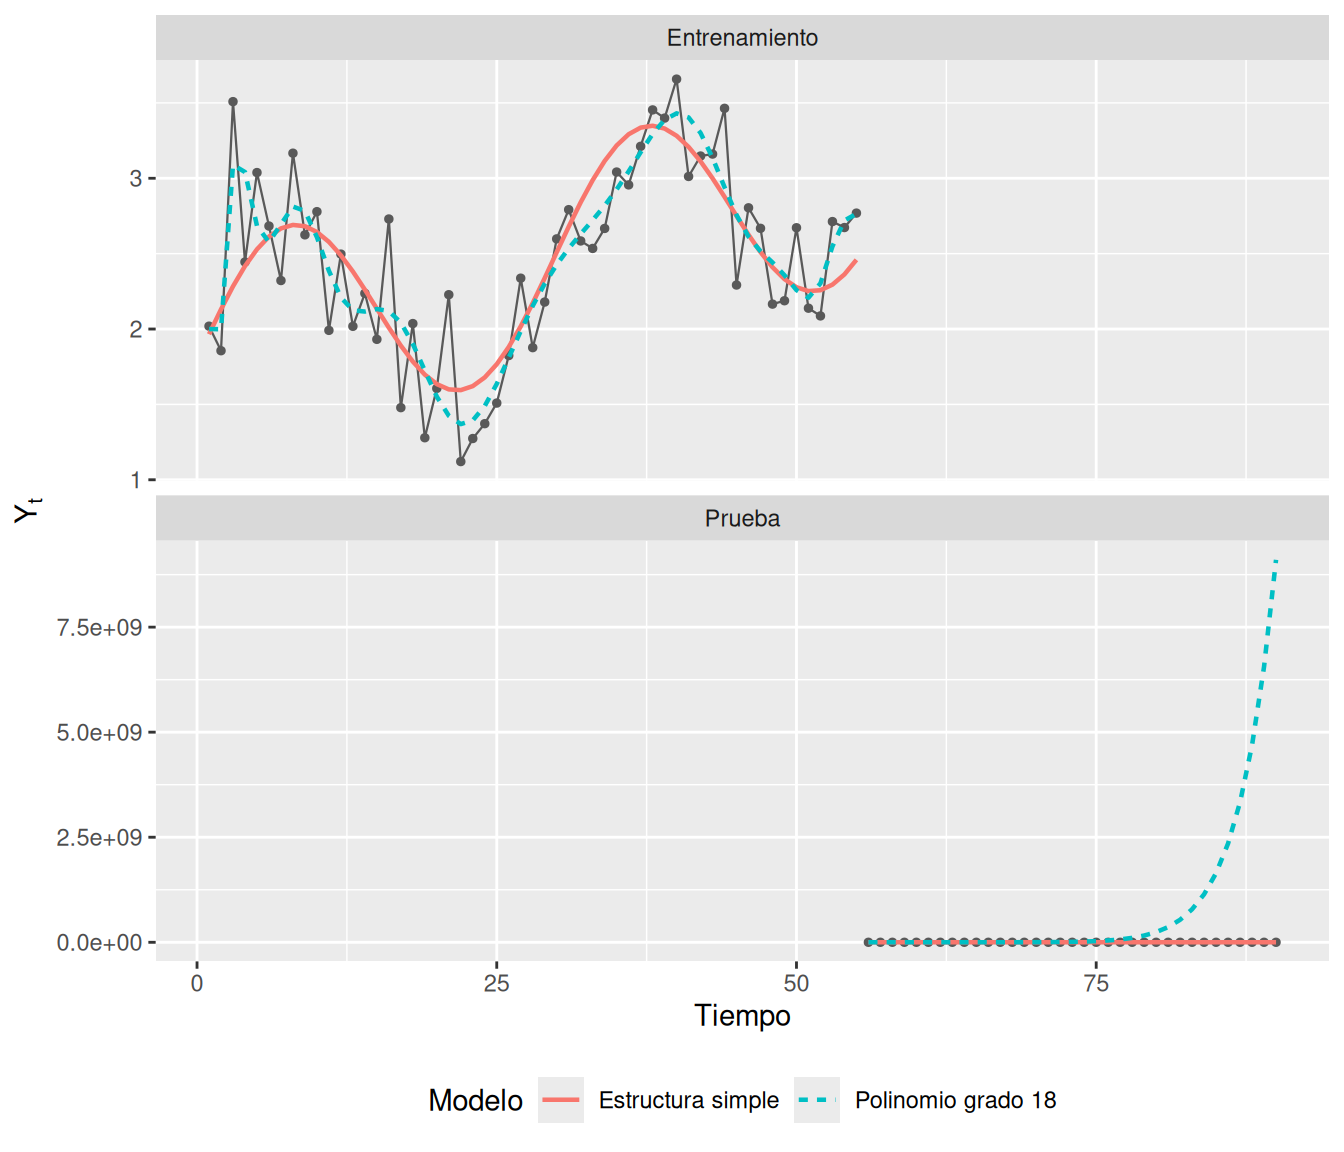
El ejemplo es intencionalmente extremo. En problemas reales el sobreajuste puede ser mucho menos visible: aparecer como una diferencia pequeña entre órdenes ARIMA, una selección excesiva de covariables, una búsqueda demasiado amplia de hiperparámetros o una distribución predictiva excesivamente estrecha.
7.3 El experimento de pronóstico
7.3.1 Origen, horizonte e información disponible
Sea \(\mathcal F_t\) la información disponible inmediatamente después de observar \(y_t\). Un pronóstico emitido en el origen \(t\) para \(h\) períodos hacia adelante puede escribirse como
\[ \widehat y_{t+h\mid t} = g_h(\mathcal F_t), \tag{7.3}\]
donde \(g_h\) representa el procedimiento completo utilizado para producir el pronóstico.
La palabra procedimiento es importante. \(g_h\) puede incluir:
- una transformación;
- una decisión de diferenciación;
- selección de orden;
- estimación de parámetros;
- construcción de la distribución predictiva;
- inversión de transformaciones;
- cálculo del pronóstico puntual.
Si cualquiera de esas etapas usa información posterior a \(t\), entonces Ecuación 7.3 ya no representa el pronóstico que realmente habría podido emitirse en ese momento.
7.3.2 Partición entrenamiento–prueba
La forma más sencilla de evaluación temporal consiste en escoger un único origen \(T_0<T\) y separar
\[ \underbrace{y_1,\ldots,y_{T_0}}_{\text{entrenamiento}} \qquad\vert\qquad \underbrace{y_{T_0+1},\ldots,y_T}_{\text{prueba}}. \tag{7.4}\]
El conjunto de entrenamiento se utiliza para especificar y estimar el método. El conjunto de prueba se utiliza después para medir la calidad de los pronósticos (Hyndman y Athanasopoulos 2021, sec. 5.8). El tamaño del conjunto de prueba debe ser compatible con el horizonte máximo que realmente interesa.
fig_holdout <- tibble(
  t = 1:40,
  conjunto = if_else(t <= 28, "Entrenamiento", "Prueba")
)ggplot(fig_holdout, aes(x = t, y = 1, fill = conjunto)) +
geom_tile(height = 0.7) +
geom_vline(xintercept = 28.5, linetype = 2) +
scale_y_continuous(NULL, breaks = NULL) +
labs(x = "Tiempo", fill = NULL)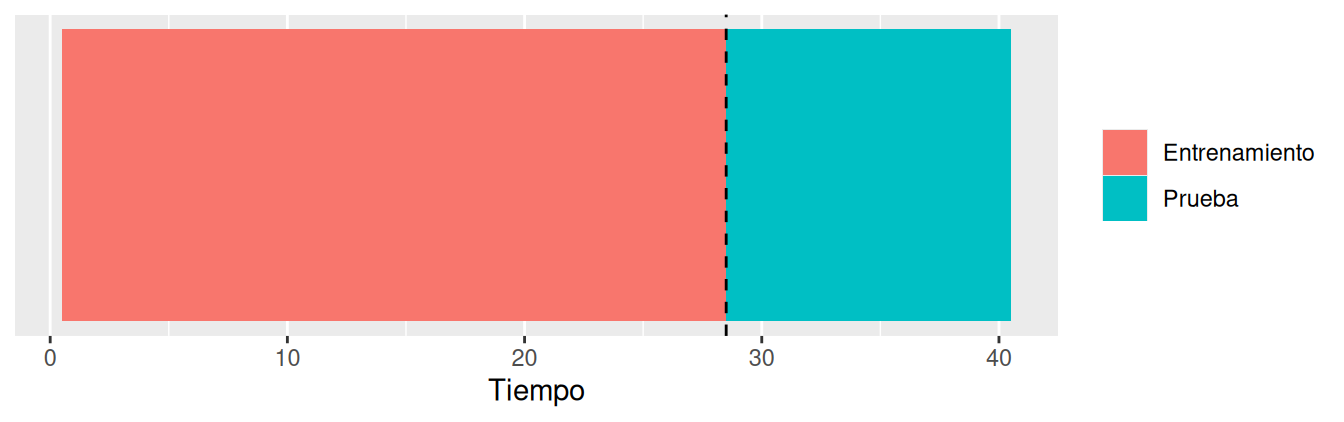
7.3.3 Fuga de información
Hay fuga de información cuando alguna decisión supuestamente tomada en el origen \(t\) utiliza directa o indirectamente valores posteriores a \(t\). Ejemplos frecuentes incluyen:
- estimar una transformación usando toda la serie antes de dividirla;
- escoger \(d\), \(D\), \(p\), \(q\), \(P\) o \(Q\) después de inspeccionar el período de prueba;
- estandarizar con media y desviación estándar calculadas usando observaciones futuras;
- seleccionar covariables por su correlación con el período de prueba;
- escoger hiperparámetros porque produjeron el menor RMSE en el mismo bloque que luego se reporta como evaluación final;
- imputar un dato faltante del entrenamiento utilizando observaciones futuras que todavía no existían en el origen evaluado.
NotaConocimiento estructural no es fuga de información
Conocer de antemano que la serie es mensual, que diciembre ocurre una vez por año o que un indicador institucional se publica con determinado rezago no constituye fuga. El problema aparece cuando se utilizan realizaciones futuras para adaptar el procedimiento que supuestamente debía operar sin ellas.
7.3.4 Entrenamiento, validación y prueba final
Si el período llamado “prueba” se consulta repetidamente para escoger modelos, deja de funcionar como una evaluación final independiente. Una estrategia más rigurosa es distinguir:
\[ \text{entrenamiento} \longrightarrow \text{validación temporal} \longrightarrow \text{prueba final}. \]
La validación ayuda a escoger entre procedimientos. El bloque final se utiliza una sola vez para estimar el desempeño que se espera encontrar en datos realmente nuevos. En series cortas puede no ser posible reservar tres bloques grandes; en esos casos la validación con origen móvil permite reutilizar el pasado de manera más eficiente, pero el principio de no entrenar con el futuro permanece.
7.4 Métodos de referencia
Un método complejo no debe evaluarse en el vacío. Necesitamos una referencia que responda a la pregunta:
¿cuánto ganamos respecto de una estrategia simple que ya captura una característica básica de la serie?
Hyndman y Athanasopoulos utilizan cuatro referencias especialmente útiles (Hyndman y Athanasopoulos 2021, sec. 5.2).
7.4.1 Método de la media
Para cualquier \(h\geq1\),
\[ \widehat y_{T+h\mid T}=\bar y_T = \frac{1}{T}\sum_{t=1}^T y_t. \tag{7.5}\]
Es una referencia natural para una serie estable alrededor de un nivel aproximadamente constante.
7.4.2 Método naïve
\[ \widehat y_{T+h\mid T}=y_T. \tag{7.6}\]
Este procedimiento es el pronóstico óptimo bajo una caminata aleatoria sin deriva. Por eso puede ser una referencia difícil de superar para algunos niveles financieros y económicos.
7.4.3 Método naïve estacional
Si el período estacional es \(S\),
\[ \widehat y_{T+h\mid T} = \text{última observación disponible de la misma estación}. \tag{7.7}\]
En datos mensuales, cada enero futuro se pronostica inicialmente mediante el enero observado más reciente, y así sucesivamente. Para H02 será nuestra referencia principal porque la estacionalidad es muy marcada.
7.4.4 Método con deriva
El método de deriva extrapola la pendiente promedio entre la primera y la última observación:
\[ \widehat y_{T+h\mid T} = y_T +h\frac{y_T-y_1}{T-1}. \tag{7.8}\]
7.4.5 Implementación en fable
Retomamos desde ahora la serie H02 utilizada en la semana 6.
h02 <- PBS |>
  filter(ATC2 == "H02") |>
  summarise(Cost = sum(Cost) / 1e6)

stopifnot(
  nrow(h02) > 100,
  !anyNA(h02$Cost),
  all(is.finite(h02$Cost)),
  all(h02$Cost > 0)
)

h_holdout <- 24
n_h02 <- nrow(h02)

h02_train <- h02 |>
  slice_head(n = n_h02 - h_holdout)

h02_test <- h02 |>
  slice_tail(n = h_holdout)
particion_h02 <- bind_rows(
h02_train |>
as_tibble() |>
summarise(
conjunto = "Entrenamiento",
inicio = min(Month),
fin = max(Month),
n = n()
),
h02_test |>
as_tibble() |>
summarise(
conjunto = "Prueba",
inicio = min(Month),
fin = max(Month),
n = n()
)
)
knitr::kable(
particion_h02,
caption = "Partición temporal utilizada en la aplicación H02. Los últimos 24 meses quedan reservados para evaluación."
)| conjunto | inicio | fin | n |
|---|---|---|---|
| Entrenamiento | 1991 Jul | 2006 Jun | 180 |
| Prueba | 2006 Jul | 2008 Jun | 24 |
En FPP3, H02 cubre julio de 1991 a junio de 2008, y una evaluación natural reserva los últimos dos años (Hyndman y Athanasopoulos 2021, sec. 9.9). El código anterior construye esa separación por posición, por lo que no depende de escribir manualmente las fechas.
fit_bench_h02 <- h02_train |>
  model(
    Media = MEAN(Cost),
    Naive = NAIVE(Cost),
    `Naive estacional` = SNAIVE(Cost),
    Deriva = RW(Cost ~ drift())
  )

fc_bench_h02 <- fit_bench_h02 |>
  forecast(h = h_holdout)
fc_bench_h02 |>
autoplot(h02, level = NULL) +
labs(
x = NULL,
y = "Costo (millones de dólares australianos)",
colour = "Método"
)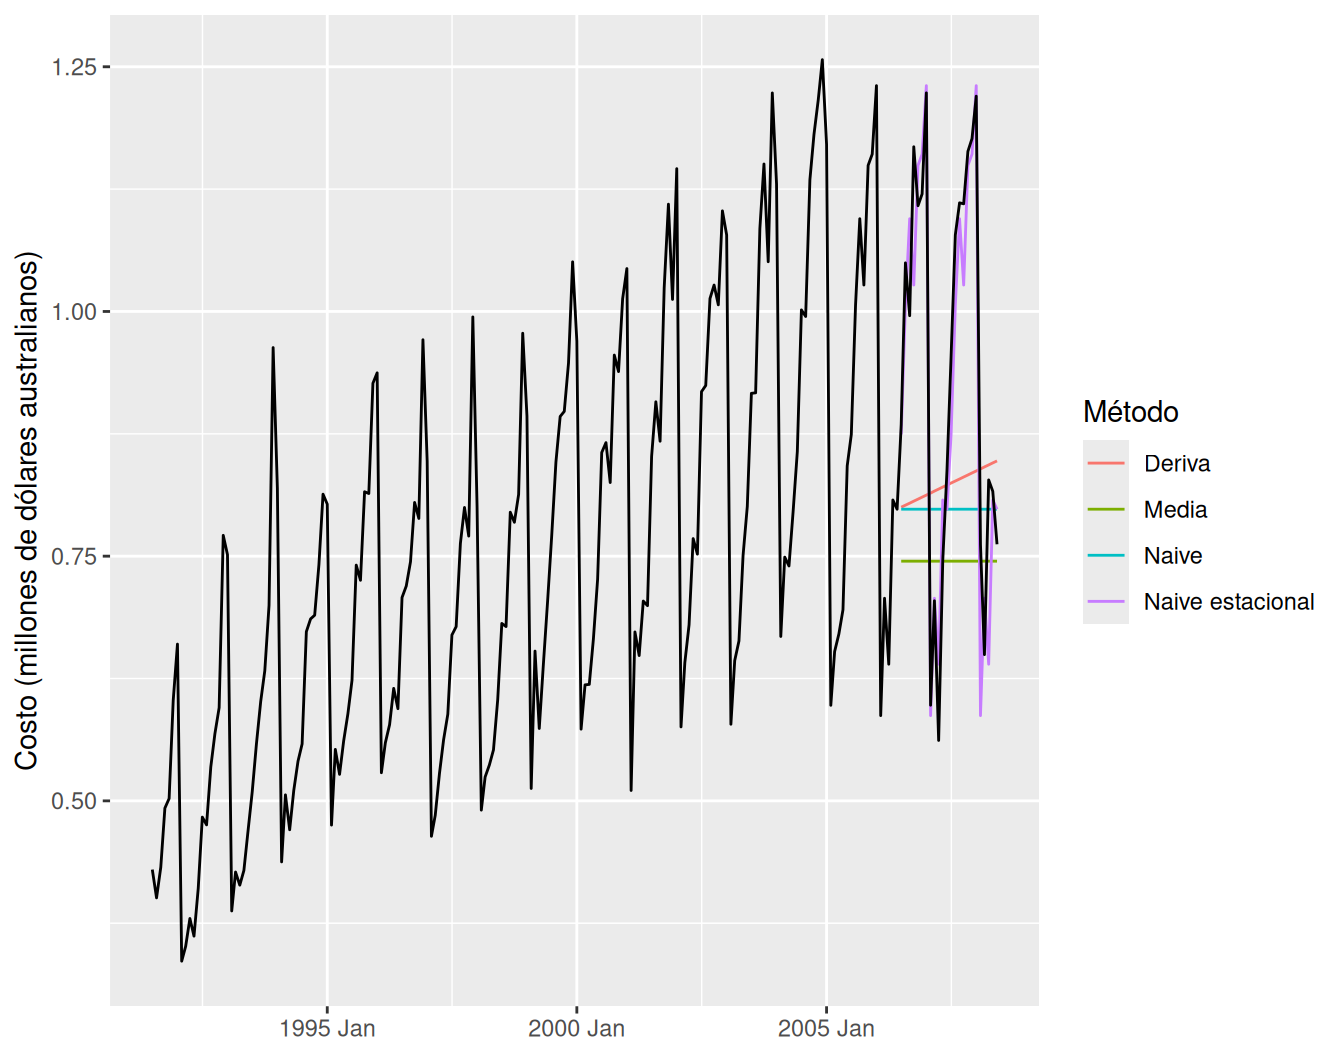
En una serie claramente estacional, una referencia no estacional puede ser demasiado débil. La comparación relevante debe incluir al menos un método sencillo que capture la estructura más obvia de los datos.
7.5 Evaluación de pronósticos puntuales
Sea \(\mathcal E\) el conjunto de pares origen–objetivo que decidimos evaluar. Para cada elemento disponemos de un error Ecuación 7.2. Tres medidas serán centrales en este curso.
7.5.1 MAE
\[ \operatorname{MAE} = \frac{1}{N} \sum_{j=1}^N |e_j|. \tag{7.9}\]
MAE se expresa en las mismas unidades de la variable observada. Si \(Y_t\) está en millones de dólares, MAE también.
7.5.2 RMSE
\[ \operatorname{RMSE} = \sqrt{ \frac{1}{N} \sum_{j=1}^N e_j^2 }. \tag{7.10}\]
El cuadrado da mayor peso a errores grandes. RMSE también queda en las unidades originales y puede ser útil cuando errores extremos son especialmente costosos (Hyndman y Athanasopoulos 2021, sec. 5.8).
7.5.3 MASE
MAE y RMSE no son directamente comparables entre series con escalas distintas. MASE escala el error mediante el desempeño dentro del entrenamiento de un método naïve apropiado (Hyndman y Athanasopoulos 2021, sec. 5.8).
Para una serie no estacional,
\[ q_j = \frac{e_j} { \displaystyle \frac{1}{T-1} \sum_{t=2}^{T}|y_t-y_{t-1}| }, \tag{7.11}\]
y
\[ \operatorname{MASE} = \frac{1}{N}\sum_{j=1}^N |q_j|. \tag{7.12}\]
Para una serie estacional de período \(S\),
\[ q_j = \frac{e_j} { \displaystyle \frac{1}{T-S} \sum_{t=S+1}^{T}|y_t-y_{t-S}| }. \tag{7.13}\]
Por tanto, en una serie mensual como H02, el denominador se construye con errores naïve estacionales de un paso calculados solamente en el entrenamiento.
Una interpretación útil es:
- MASE \(<1\): el error absoluto promedio del método evaluado es menor que el error absoluto promedio del benchmark naïve usado para escalar;
- MASE \(>1\): el método evaluado es peor bajo esa comparación promedio.
La interpretación debe hacerse con cuidado: MASE no afirma que el modelo gane en cada fecha ni que el benchmark utilizado sea necesariamente el método final correcto.
ImportanteEl denominador de MASE también puede filtrar información futura
Si el factor de escala de MASE se calcula con toda la serie, incluyendo el período de prueba, el resultado deja de representar exactamente el experimento que habría podido realizarse en el origen. El denominador debe provenir del entrenamiento correspondiente.
7.5.4 Por qué no usaremos MAPE como medida principal
El error porcentual
\[ p_t=100\frac{e_t}{y_t} \]
produce MAPE al promediar \(|p_t|\). Aunque es libre de unidades, presenta problemas cuando \(y_t\) es cero o cercano a cero y requiere una escala cuyo cero tenga interpretación de razón. FPP3 discute además dificultades de medidas porcentuales aparentemente “simétricas” (Hyndman y Athanasopoulos 2021, sec. 5.8). Por esas razones, el curso utilizará principalmente MAE, RMSE y MASE.
7.6 La función de pérdida importa
MAE y RMSE no son dos números intercambiables. Cada uno corresponde a una función de pérdida distinta y, por tanto, a un pronóstico puntual óptimo distinto.
7.6.1 Pérdida cuadrática y media predictiva
Sea \(Y\) una cantidad futura con distribución condicional dada la información actual y considere una acción puntual \(a\). Bajo pérdida cuadrática,
\[ L_2(a) = E[(Y-a)^2\mid\mathcal F_t]. \]
Usando
\[ Y-a = (Y-EY)+(EY-a), \]
obtenemos
\[ E[(Y-a)^2\mid\mathcal F_t] = \operatorname{Var}(Y\mid\mathcal F_t) + \{E(Y\mid\mathcal F_t)-a\}^2. \tag{7.14}\]
El primer término no depende de \(a\). Por tanto,
\[ a_2^* = E(Y\mid\mathcal F_t). \tag{7.15}\]
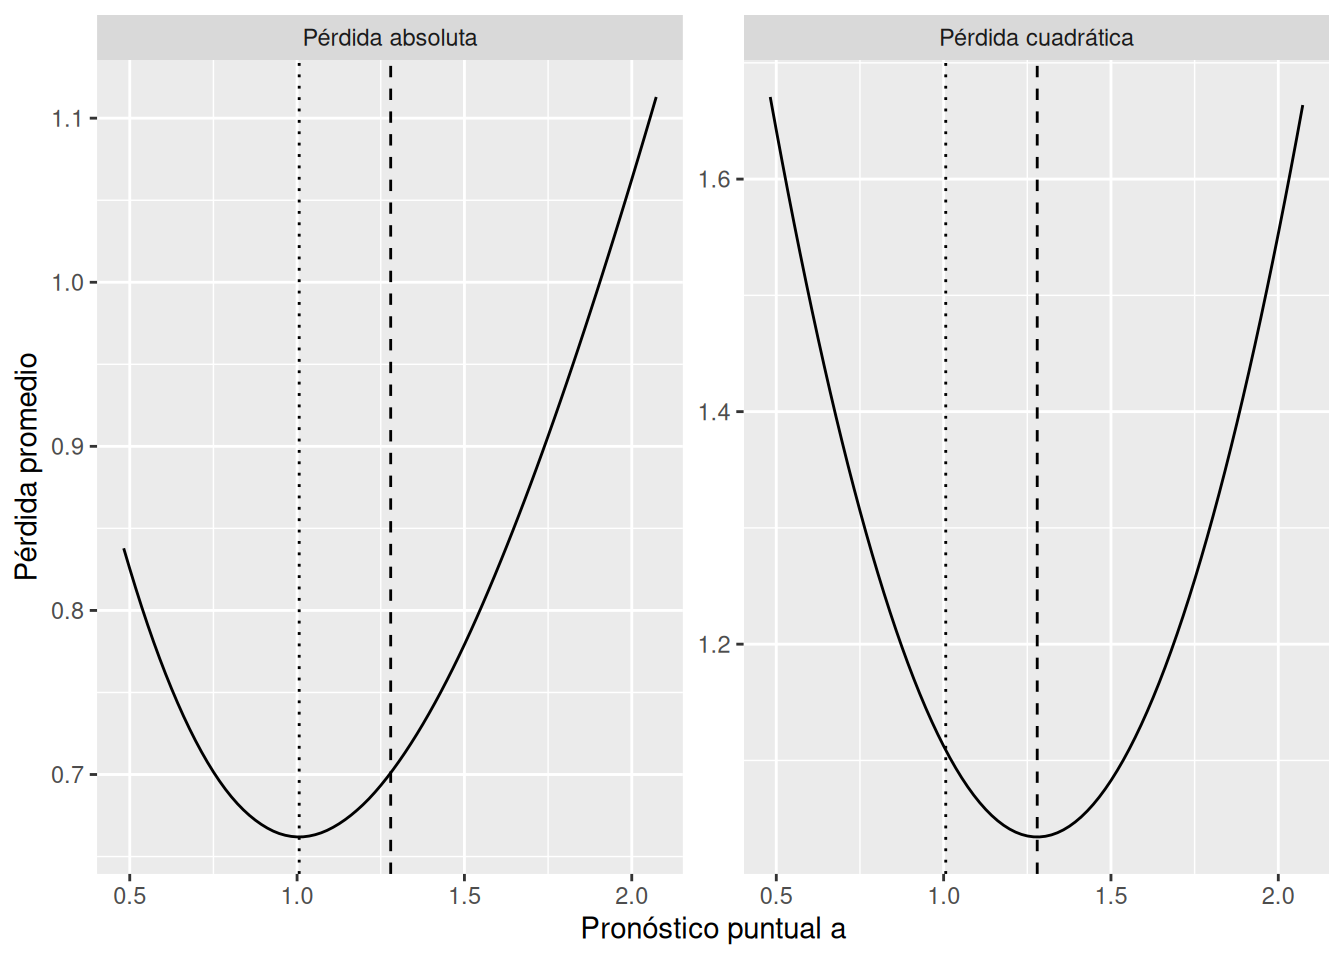
La media predictiva minimiza el error cuadrático esperado.
7.6.2 Pérdida absoluta y mediana predictiva
Bajo pérdida absoluta,
\[ L_1(a) = E[|Y-a|\mid\mathcal F_t]. \]
Si la distribución condicional es continua con CDF \(F\), la derivada respecto de \(a\) puede escribirse como
\[ \frac{dL_1(a)}{da} = F(a)-\{1-F(a)\} = 2F(a)-1. \tag{7.16}\]
Un mínimo satisface \(F(a)=1/2\). Por tanto, cualquier mediana predictiva es una solución:
\[ a_1^* = \operatorname{Mediana}(Y\mid\mathcal F_t). \tag{7.17}\]
Esto explica por qué Hyndman y Athanasopoulos señalan que minimizar RMSE favorece la media y minimizar MAE favorece la mediana (Hyndman y Athanasopoulos 2021, sec. 5.8). En distribuciones simétricas ambas pueden coincidir; en distribuciones sesgadas pueden diferir de manera importante.
7.6.3 Simulación con una distribución sesgada
z_loss <- rlnorm(25000, meanlog = 0, sdlog = 0.7)

a_grid <- seq(
  quantile(z_loss, 0.15),
  quantile(z_loss, 0.85),
  length.out = 90
)

loss_grid <- tibble(
  a = a_grid,
  `Pérdida absoluta` = map_dbl(a_grid, ~ mean(abs(z_loss - .x))),
  `Pérdida cuadrática` = map_dbl(a_grid, ~ mean((z_loss - .x)^2))
) |>
  pivot_longer(
    cols = -a,
    names_to = "perdida",
    values_to = "riesgo_empirico"
  )

media_loss <- mean(z_loss)
mediana_loss <- median(z_loss)ggplot(loss_grid, aes(x = a, y = riesgo_empirico)) +
geom_line() +
geom_vline(xintercept = media_loss, linetype = 2) +
geom_vline(xintercept = mediana_loss, linetype = 3) +
facet_wrap(~ perdida, scales = "free_y") +
labs(
x = "Pronóstico puntual a",
y = "Pérdida promedio"
)
NotaNo existe una métrica universalmente correcta
La métrica debe guardar relación con el objetivo predictivo. Si errores grandes tienen consecuencias desproporcionadas, RMSE puede ser informativa. Si interesa una pérdida lineal robusta a algunos errores extremos, MAE puede ser más interpretable. En el proyecto final conviene declarar la métrica principal antes de mirar cuál modelo resulta favorecido.
7.7 Una única partición entrenamiento–prueba
Una evaluación con origen fijo es fácil de interpretar. Ajustamos todos los procedimientos con el mismo entrenamiento y los enfrentamos al mismo bloque futuro.
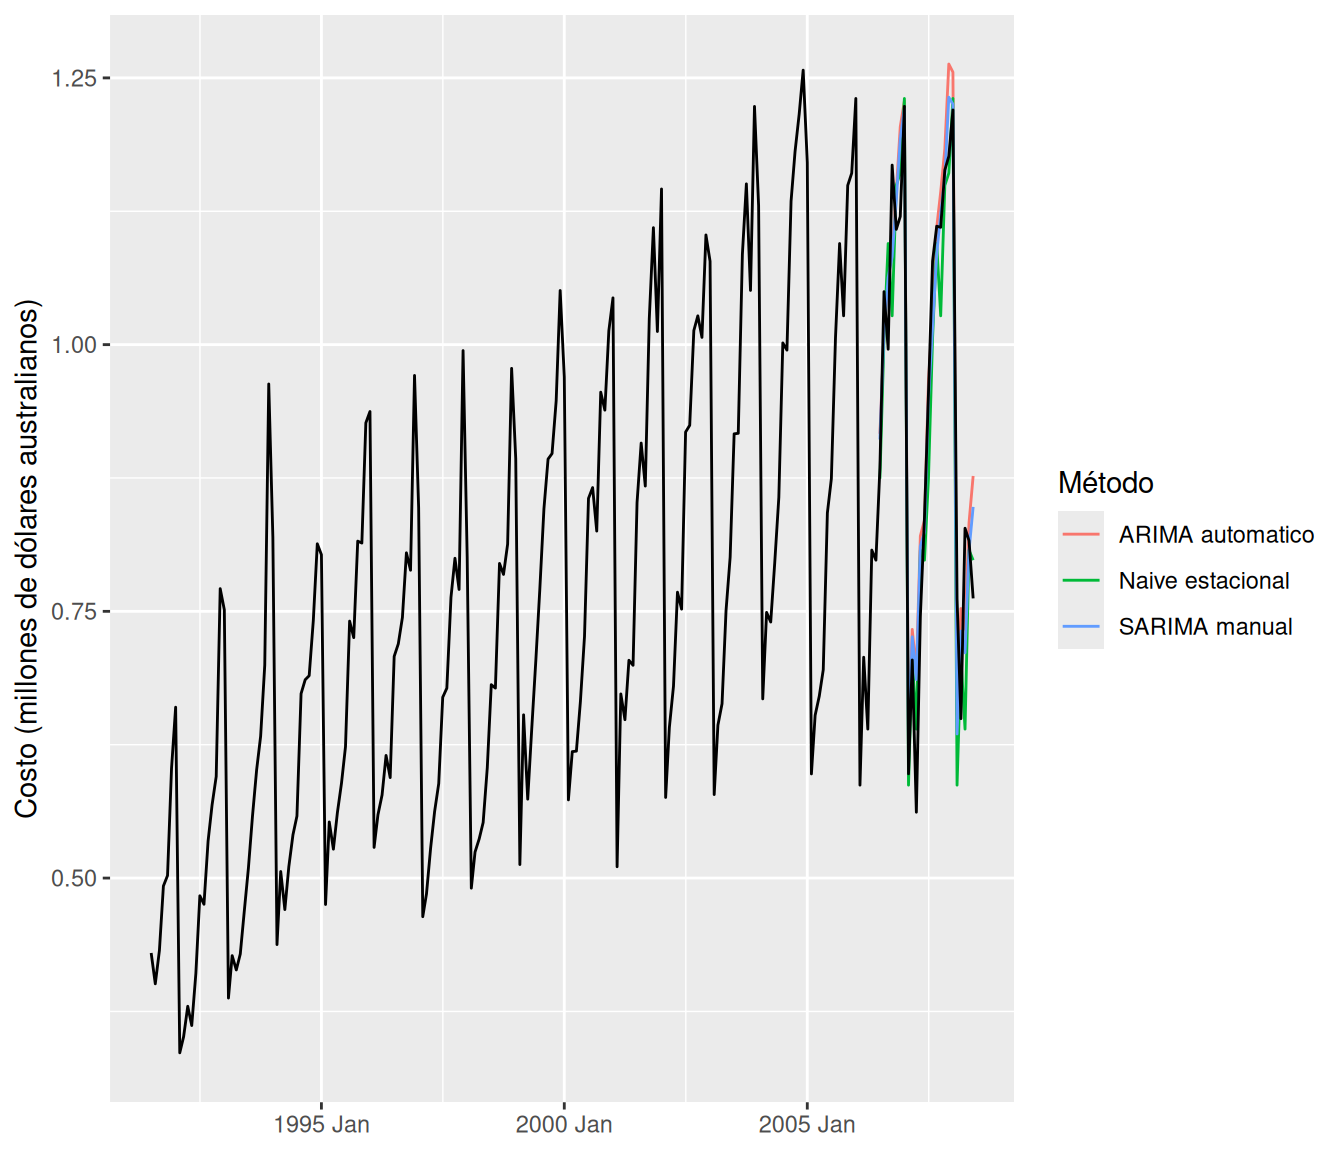
En H02 compararemos tres estrategias:
- naïve estacional, como referencia;
- SARIMA manual ARIMA(3,0,1)\(\times\)(0,1,2)\(_{12}\) sobre \(\log(\text{Cost})\), modelo central de la aplicación de la semana 6 y de FPP3;
- ARIMA automático, permitiendo que
ARIMA(log(Cost))seleccione el orden utilizando solamente el entrenamiento.
La especificación manual está fijada antes de mirar el bloque de prueba. El procedimiento automático también se ejecuta sin acceso a ese bloque.
fit_h02_holdout <- h02_train |>
  model(
    `Naive estacional` = SNAIVE(Cost),
    `SARIMA manual` = ARIMA(
      log(Cost) ~ 0 + pdq(3, 0, 1) + PDQ(0, 1, 2)
    ),
    `ARIMA automatico` = ARIMA(log(Cost))
  )

fc_h02_holdout <- fit_h02_holdout |>
  forecast(h = h_holdout)
fc_h02_holdout |>
autoplot(h02, level = NULL) +
labs(
x = NULL,
y = "Costo (millones de dólares australianos)",
colour = "Método"
)
7.7.1 MAE, RMSE y MASE con accuracy()
acc_h02_holdout <- fc_h02_holdout |>
  accuracy(h02) |>
  select(.model, .type, RMSE, MAE, MASE, RMSSE)

knitr::kable(
  acc_h02_holdout |>
    arrange(RMSE),
  digits = 4,
  caption = "Evaluación puntual de H02 sobre los últimos 24 meses."
)| .model | .type | RMSE | MAE | MASE | RMSSE |
|---|---|---|---|---|---|
| SARIMA manual | Test | 0.0621 | 0.0483 | 0.8082 | 0.8640 |
| ARIMA automatico | Test | 0.0667 | 0.0542 | 0.9071 | 0.9277 |
| Naive estacional | Test | 0.0754 | 0.0555 | 0.9287 | 1.0491 |
accuracy() empareja las fechas pronosticadas con los valores observados y, cuando corresponde, utiliza la parte de entrenamiento para construir medidas escaladas (Hyndman y Athanasopoulos 2021, sec. 5.8).
7.7.2 Verificación manual de MASE
Para hacer explícita la escala, calculamos primero el MAE naïve estacional dentro del entrenamiento:
escala_mase_h02 <- h02_train |>
  as_tibble() |>
  mutate(error_snaive = Cost - dplyr::lag(Cost, 12)) |>
  summarise(
    escala = mean(abs(error_snaive), na.rm = TRUE)
  ) |>
  pull(escala)

errores_h02_holdout <- fc_h02_holdout |>
  as_tibble() |>
  select(.model, Month, .mean) |>
  left_join(
    h02_test |>
      as_tibble() |>
      transmute(Month, observado = Cost),
    by = "Month"
  ) |>
  mutate(error = observado - .mean)

mase_manual_h02 <- errores_h02_holdout |>
  group_by(.model) |>
  summarise(
    MAE_manual = mean(abs(error)),
    RMSE_manual = sqrt(mean(error^2)),
    MASE_manual = mean(abs(error)) / escala_mase_h02,
    .groups = "drop"
)knitr::kable(
mase_manual_h02,
digits = 4,
caption = "Cálculo manual de MAE, RMSE y MASE para verificar que la escala de MASE procede exclusivamente del entrenamiento."
)| .model | MAE_manual | RMSE_manual | MASE_manual |
|---|---|---|---|
| ARIMA automatico | 0.0542 | 0.0667 | 0.9071 |
| Naive estacional | 0.0555 | 0.0754 | 0.9287 |
| SARIMA manual | 0.0483 | 0.0621 | 0.8082 |
7.7.3 Limitaciones de un único corte
Una sola partición tiene ventajas: es transparente, barata computacionalmente y se parece a un despliegue real en una fecha concreta. Sin embargo, su conclusión puede depender mucho del lugar exacto donde se colocó el corte.
Si el bloque de prueba coincide con una recesión, un cambio de política, un período de baja volatilidad o una revisión de datos, el resultado puede ser poco representativo de otros momentos. Además, una única partición produce relativamente pocos errores de cada horizonte.
La respuesta natural es repetir el experimento en varios orígenes.
7.8 Validación con origen móvil
7.8.1 Definición
Sea
\[ t_1<t_2<\cdots<t_K \]
una secuencia de orígenes. En el origen \(t_k\) ajustamos el procedimiento usando solamente la información disponible hasta \(t_k\) y generamos pronósticos para uno o varios horizontes.
Para un horizonte fijo \(h\), obtenemos errores
\[ e_{t_1+h\mid t_1}, \ldots, e_{t_K+h\mid t_K}. \tag{7.18}\]
Las métricas se calculan promediando estos errores. Este diseño suele denominarse evaluación con origen móvil o rolling forecasting origin (Hyndman y Athanasopoulos 2021, sec. 5.10).
origenes_demo <- tibble(
  fila = 1:6,
  fin_train = 18 + 3 * (fila - 1)
)

fig_rolling <- map_dfr(seq_len(nrow(origenes_demo)), function(i) {
  fin_i <- origenes_demo$fin_train[i]
  tibble(
    fila = i,
    t = 1:38,
    estado = case_when(
      t <= fin_i ~ "Entrenamiento",
      t <= fin_i + 4 ~ "Evaluación",
      TRUE ~ "No utilizado"
    )
  )
})ggplot(fig_rolling, aes(x = t, y = factor(fila), fill = estado)) +
geom_tile() +
labs(
x = "Tiempo",
y = "Origen",
fill = NULL
)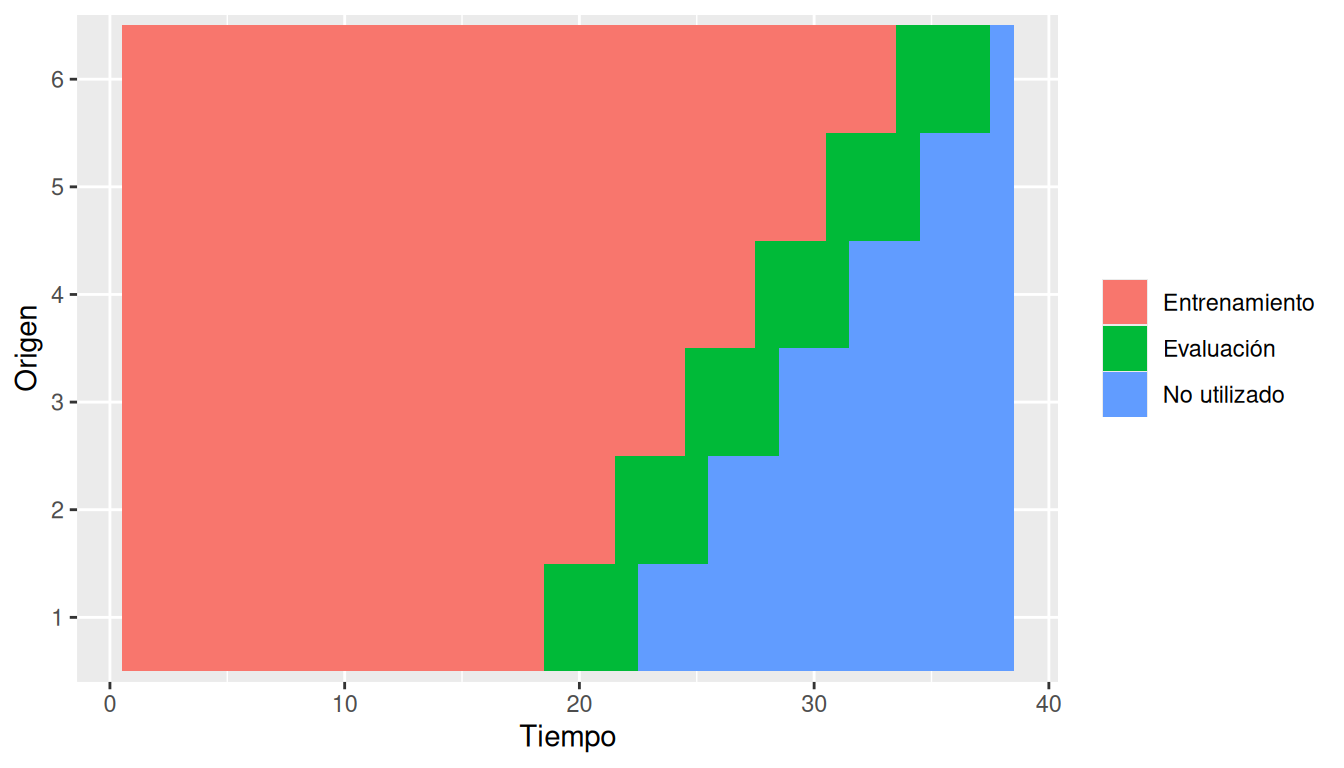
7.8.2 Ventana expansiva
En una ventana expansiva,
\[ \mathcal T_k = \{1,\ldots,t_k\}. \]
Cada nuevo origen conserva todo el historial anterior. Es razonable cuando creemos que los parámetros representan una dinámica relativamente estable y que observaciones antiguas todavía contienen información útil.
En tsibble, stretch_tsibble() construye este diseño. Los argumentos principales son el tamaño inicial .init y el incremento .step.
7.8.3 Ventana móvil de tamaño fijo
En una ventana móvil de longitud \(W\),
\[ \mathcal T_k = \{t_k-W+1,\ldots,t_k\}. \]
Las observaciones antiguas salen del entrenamiento cuando entra información nueva. Este diseño puede ser preferible cuando se sospechan cambios estructurales o evolución gradual de la relación temporal.
slide_tsibble(.size = W) implementa este tipo de ventanas.
NotaExpansiva frente a móvil es una decisión del procedimiento
No debemos escoger retrospectivamente la ventana que produzca el menor error sobre el mismo conjunto final y luego reportar ese resultado como si la elección hubiera sido previa. La longitud y el tipo de ventana también son hiperparámetros y, si se optimizan, necesitan una capa de validación.
7.8.4 Preparación de ventanas H02
Para asegurar que cada origen tenga disponibles 12 observaciones futuras reales, construiremos ventanas solamente hasta \(T-12\). Usaremos 120 meses como tamaño inicial y moveremos el origen tres meses cada vez. El salto de tres meses reduce el costo computacional sin alterar la lógica del procedimiento.
h_cv <- 12
init_cv <- 120
step_cv <- 3

h02_cv_base <- h02 |>
  slice_head(n = nrow(h02) - h_cv)

h02_cv_exp <- h02_cv_base |>
  stretch_tsibble(
    .init = init_cv,
    .step = step_cv
  )

h02_cv_mov <- h02_cv_base |>
  slide_tsibble(
    .size = init_cv,
    .step = step_cv
  )
resumen_ventanas <- tibble(
diseño = c("Expansiva", "Móvil"),
filas_generadas = c(nrow(h02_cv_exp), nrow(h02_cv_mov)),
numero_ventanas = c(n_distinct(h02_cv_exp$.id), n_distinct(h02_cv_mov$.id))
)
knitr::kable(
resumen_ventanas,
caption = "Número de ventanas generadas para H02 bajo dos diseños temporales."
)| diseño | filas_generadas | numero_ventanas |
|---|---|---|
| Expansiva | 3900 | 25 |
| Móvil | 3000 | 25 |
No ajustaremos ambos diseños en el análisis principal para evitar duplicar el costo computacional. Utilizaremos ventana expansiva y dejaremos la comparación con ventana móvil como actividad.
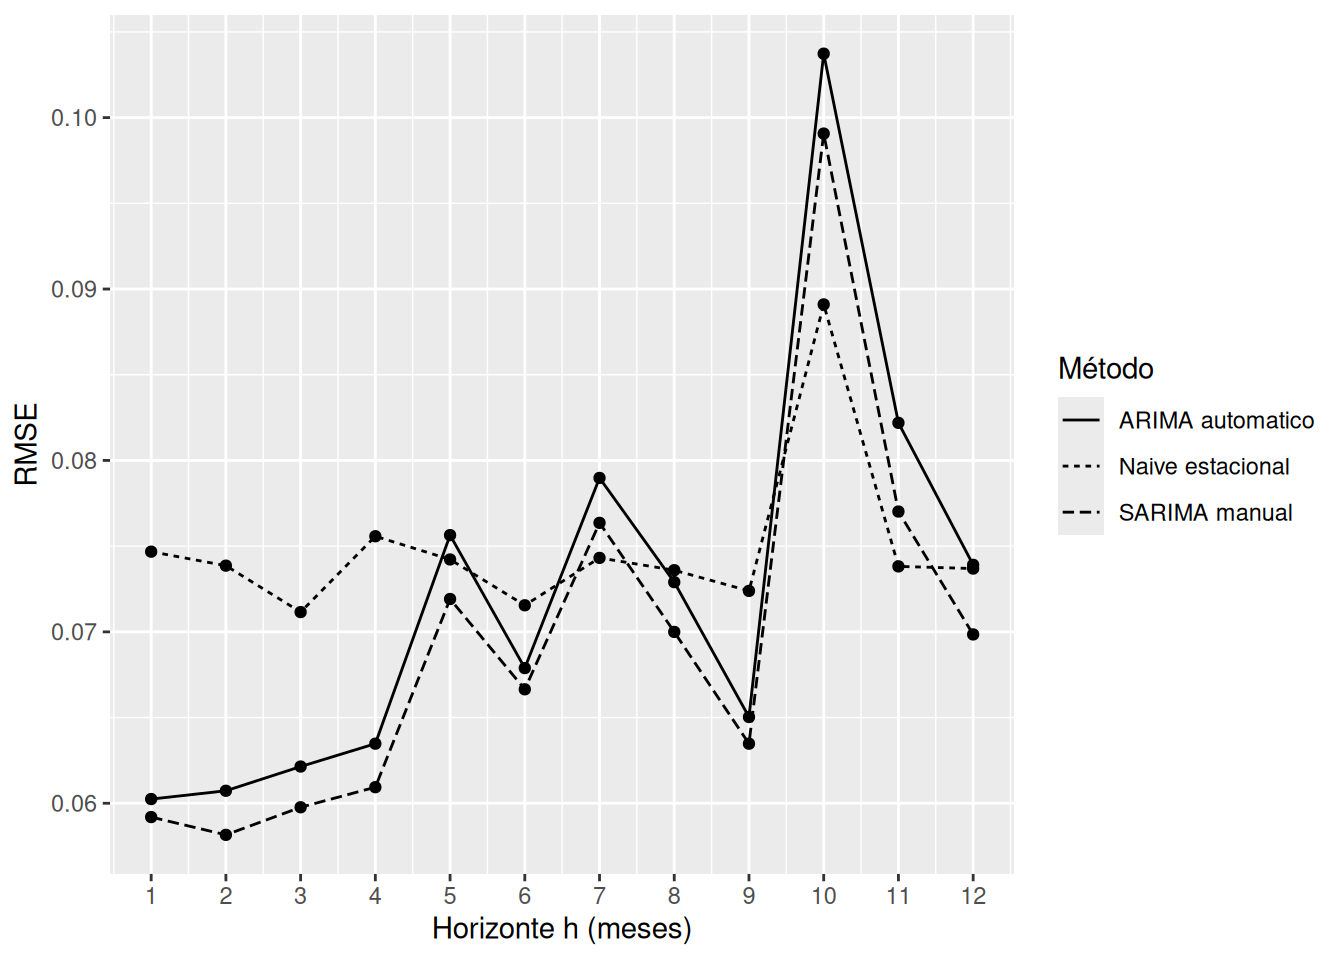
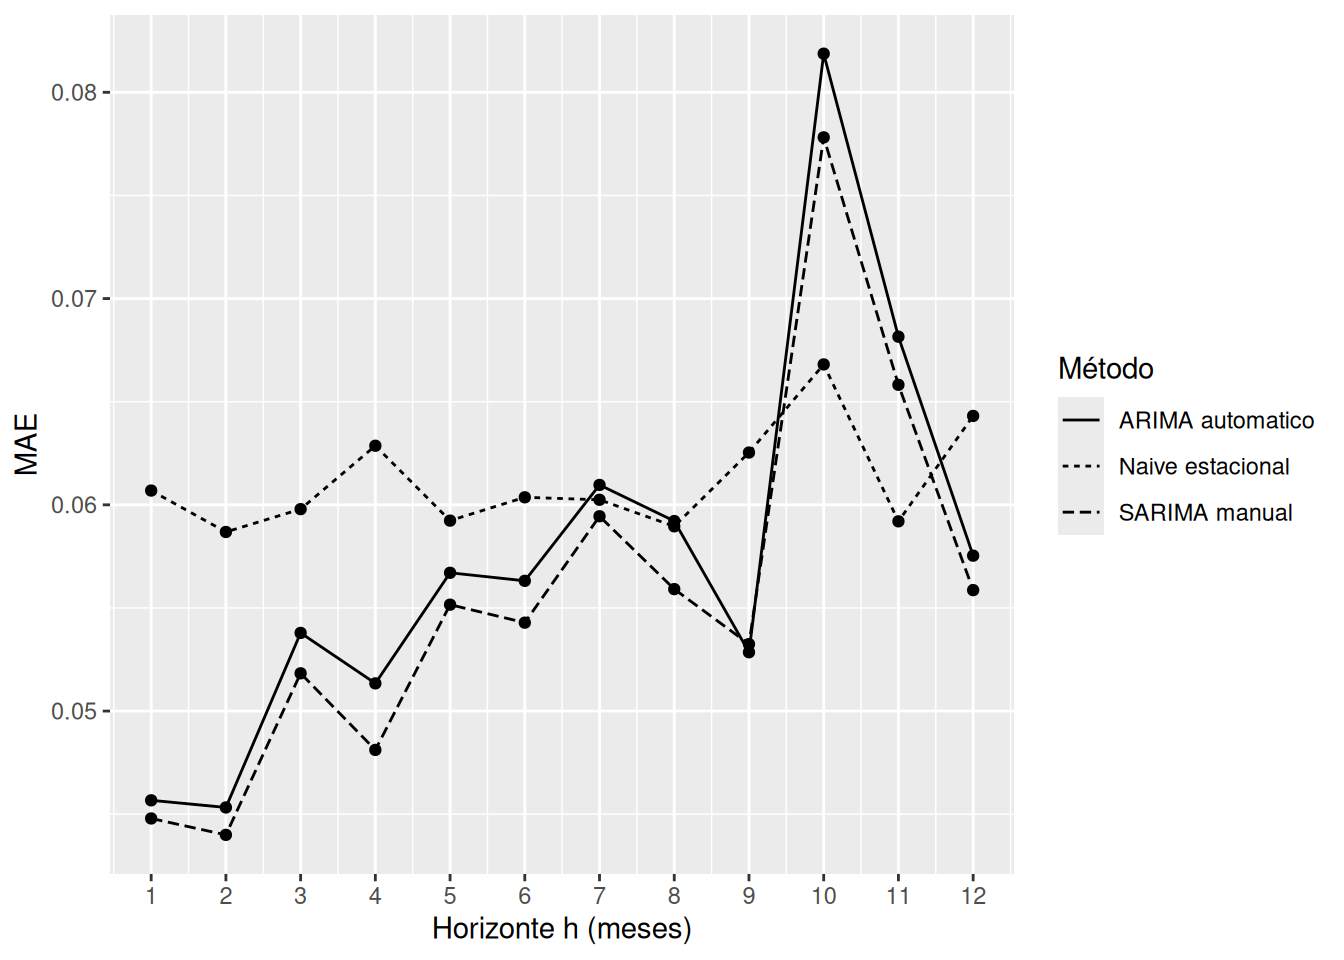
7.9 El desempeño depende del horizonte
Una media global puede ocultar una diferencia sustantiva. Un método podría ser excelente a un mes y mediocre a doce meses, mientras otro muestra el patrón contrario.
Para cada \(h\) definimos, por ejemplo,
\[ \operatorname{RMSE}(h) = \sqrt{ \frac{1}{K_h} \sum_{k=1}^{K_h} e_{t_k+h\mid t_k}^2 }, \tag{7.19}\]
con definiciones análogas para MAE\((h)\) y MASE\((h)\).
7.9.1 Validación temporal de tres procedimientos en H02
En cada origen repetiremos el procedimiento completo. Esto tiene una consecuencia crucial para ARIMA(log(Cost)): el orden automático vuelve a seleccionarse usando únicamente la ventana correspondiente. No seleccionamos el orden una sola vez usando toda la serie.
fit_h02_cv <- h02_cv_exp |>
  model(
    `Naive estacional` = SNAIVE(Cost),
    `SARIMA manual` = ARIMA(
      log(Cost) ~ 0 + pdq(3, 0, 1) + PDQ(0, 1, 2)
    ),
    `ARIMA automatico` = ARIMA(log(Cost))
  )

fc_h02_cv <- fit_h02_cv |>
  forecast(h = h_cv) |>
  group_by(.id, .model) |>
  mutate(h = row_number()) |>
  ungroup() |>
  as_fable(
    response = "Cost",
    distribution = Cost
  )
Siguiendo la estrategia de FPP3, añadimos explícitamente la variable h para resumir el error por horizonte (Hyndman y Athanasopoulos 2021, sec. 5.10). Para RMSE y MAE bastaría con llamar accuracy() sobre el objeto de validación. Para MASE y RMSSE haremos un paso adicional: cada error se escalará con el benchmark calculado en su propia ventana de entrenamiento. Esto evita utilizar para todos los orígenes una única escala construida con un período posterior.
escalas_h02_cv <- h02_cv_exp |>
  as_tibble() |>
  group_by(.id) |>
  arrange(Month, .by_group = TRUE) |>
  mutate(dif_snaive = Cost - lag(Cost, 12)) |>
  summarise(
    escala_MASE = mean(abs(dif_snaive), na.rm = TRUE),
    escala_RMSSE2 = mean(dif_snaive^2, na.rm = TRUE),
    .groups = "drop"
  )

errores_h02_cv <- fc_h02_cv |>
  as_tibble() |>
  select(.id, .model, Month, h, .mean) |>
  left_join(
    h02 |>
      as_tibble() |>
      transmute(Month, observado = Cost),
    by = "Month"
  ) |>
  left_join(escalas_h02_cv, by = ".id") |>
  mutate(
    error = observado - .mean,
    abs_escalado = abs(error) / escala_MASE,
    sq_escalado = error^2 / escala_RMSSE2
  )
acc_h02_cv_h <- errores_h02_cv |>
group_by(h, .model) |>
summarise(
RMSE = sqrt(mean(error^2)),
MAE = mean(abs(error)),
MASE = mean(abs_escalado),
RMSSE = sqrt(mean(sq_escalado)),
.groups = "drop"
)ggplot(acc_h02_cv_h, aes(x = h, y = RMSE, linetype = .model)) +
geom_line() +
geom_point() +
scale_x_continuous(breaks = 1:h_cv) +
labs(
x = "Horizonte h (meses)",
y = "RMSE",
linetype = "Método"
)
ggplot(acc_h02_cv_h, aes(x = h, y = MAE, linetype = .model)) +
  geom_line() +
  geom_point() +
  scale_x_continuous(breaks = 1:h_cv) +
  labs(
    x = "Horizonte h (meses)",
    y = "MAE",
    linetype = "Método"
  )
acc_h02_cv_global <- errores_h02_cv |>
  group_by(.model) |>
  summarise(
    RMSE = sqrt(mean(error^2)),
    MAE = mean(abs(error)),
    MASE = mean(abs_escalado),
    RMSSE = sqrt(mean(sq_escalado)),
    .groups = "drop"
  ) |>
  arrange(RMSE)

knitr::kable(
  acc_h02_cv_global,
  digits = 4,
  caption = "Resumen global de evaluación temporal de H02, agregando los horizontes de 1 a 12 meses."
)| .model | RMSE | MAE | MASE | RMSSE |
|---|---|---|---|---|
| SARIMA manual | 0.0702 | 0.0555 | 0.9434 | 0.9894 |
| ARIMA automatico | 0.0732 | 0.0575 | 0.9765 | 1.0315 |
| Naive estacional | 0.0750 | 0.0611 | 1.0407 | 1.0580 |
La tabla global es útil, pero debe interpretarse junto con las curvas por horizonte. Al promediar \(h=1,\ldots,12\) estamos asignando implícitamente un peso a cada horizonte. Si una aplicación valora mucho más \(h=1\) que \(h=12\), ese objetivo debería reflejarse en el diseño de evaluación y definirse antes de inspeccionar los resultados.
7.10 Evaluación de intervalos predictivos
Un pronóstico puntual no describe la incertidumbre. Dos modelos pueden tener medias predictivas casi idénticas y dispersiones radicalmente distintas.
Sea
\[ I_{t,h}^{(1-\alpha)} = [\ell_{t,h},u_{t,h}] \]
un intervalo predictivo nominal de nivel \(1-\alpha\).
7.10.1 Cobertura empírica
Para \(N\) pronósticos,
\[ \widehat C_{1-\alpha} = \frac{1}{N} \sum_{j=1}^N \mathbf 1\{\ell_j\le y_j\le u_j\}. \tag{7.20}\]
Una cobertura cercana al nivel nominal es deseable cuando el experimento tiene suficientes casos. Sin embargo, la cobertura sola puede engañar: un intervalo extremadamente ancho puede cubrir casi todo.
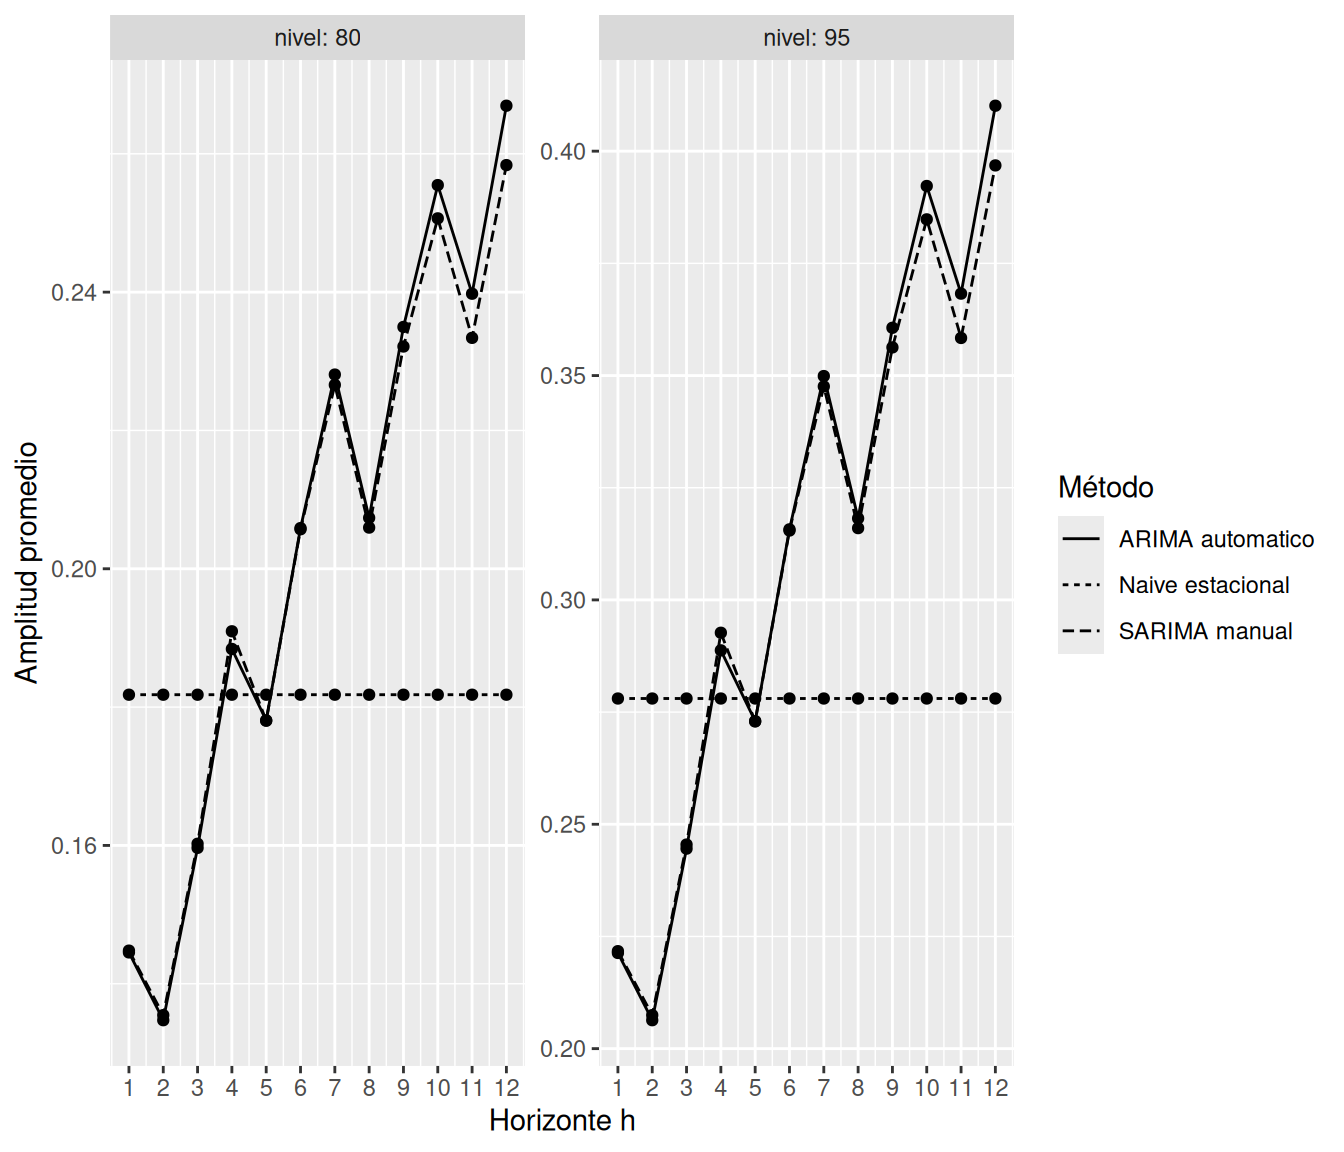
7.10.2 Amplitud promedio
\[ \widehat A_{1-\alpha} = \frac{1}{N} \sum_{j=1}^N (u_j-\ell_j). \tag{7.21}\]
Entre dos métodos con calibración similar, intervalos más estrechos son más informativos. La evaluación debe considerar simultáneamente calibración y agudeza.
7.10.3 Puntuación de Winkler
La puntuación de Winkler combina ambos aspectos. Para un intervalo central \(100(1-\alpha)\%\),
\[ W_{\alpha,t} = (u_{\alpha,t}-\ell_{\alpha,t}) + \begin{cases} \dfrac{2}{\alpha}(\ell_{\alpha,t}-y_t), & y_t<\ell_{\alpha,t},\\[1.2ex] 0, & \ell_{\alpha,t}\le y_t\le u_{\alpha,t},\\[1.2ex] \dfrac{2}{\alpha}(y_t-u_{\alpha,t}), & y_t>u_{\alpha,t}. \end{cases} \tag{7.22}\]
Si la observación cae dentro del intervalo, el score es simplemente su amplitud. Si cae fuera, aparece una penalización proporcional a la distancia de la observación respecto del intervalo. Menor es mejor (Hyndman y Athanasopoulos 2021, sec. 5.9).
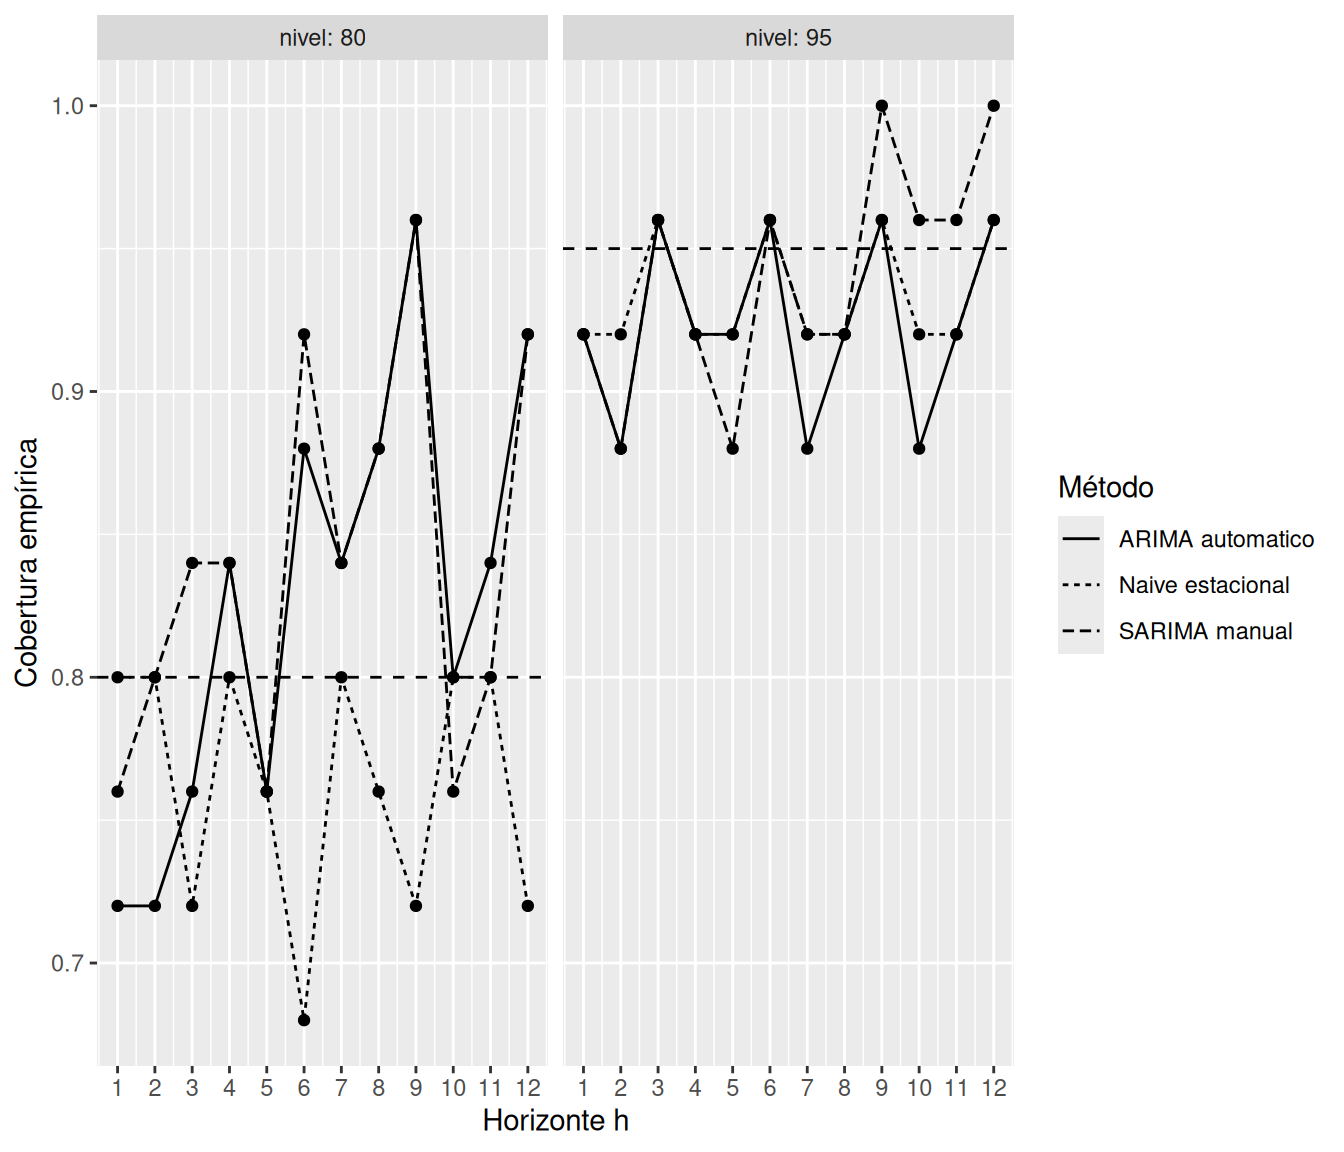
7.10.4 Cobertura y amplitud para H02
Construimos intervalos 80% y 95% para cada pronóstico de la validación temporal.
intervalos_h02_cv <- bind_rows(
  fc_h02_cv |>
    hilo(level = 80) |>
    select(.id, .model, Month, h, `80%`) |>
    fabletools::unpack_hilo(`80%`, names_sep = "_") |>
    transmute(
      .id,
      .model,
      Month,
      h,
      nivel = 80,
      inferior = `80%_lower`,
      superior = `80%_upper`
    ) |>
    as_tibble(),
  fc_h02_cv |>
    hilo(level = 95) |>
    select(.id, .model, Month, h, `95%`) |>
    fabletools::unpack_hilo(`95%`, names_sep = "_") |>
    transmute(
      .id,
      .model,
      Month,
      h,
      nivel = 95,
      inferior = `95%_lower`,
      superior = `95%_upper`
    ) |>
    as_tibble()
) |>
  left_join(
    h02 |>
      as_tibble() |>
      transmute(Month, observado = Cost),
    by = "Month"
  ) |>
  mutate(
    cubierto = observado >= inferior & observado <= superior,
    amplitud = superior - inferior
  )
resumen_intervalos_h02 <- intervalos_h02_cv |>
group_by(.model, nivel) |>
summarise(
cobertura = mean(cubierto),
amplitud_media = mean(amplitud),
n = n(),
.groups = "drop"
)
knitr::kable(
resumen_intervalos_h02,
digits = 3,
caption = "Cobertura empírica y amplitud promedio de intervalos predictivos para H02 bajo validación temporal."
)| .model | nivel | cobertura | amplitud_media | n |
|---|---|---|---|---|
| ARIMA automatico | 80 | 0.827 | 0.204 | 300 |
| ARIMA automatico | 95 | 0.923 | 0.312 | 300 |
| Naive estacional | 80 | 0.763 | 0.182 | 300 |
| Naive estacional | 95 | 0.933 | 0.278 | 300 |
| SARIMA manual | 80 | 0.840 | 0.202 | 300 |
| SARIMA manual | 95 | 0.940 | 0.310 | 300 |
cobertura_h02_h <- intervalos_h02_cv |>
  group_by(.model, nivel, h) |>
  summarise(
    cobertura = mean(cubierto),
    .groups = "drop"
  )

nominal_h02 <- tibble(
  nivel = c(80, 95),
  nominal = c(0.80, 0.95)
)

ggplot(cobertura_h02_h, aes(x = h, y = cobertura, linetype = .model)) +
  geom_line() +
  geom_point() +
  geom_hline(
    data = nominal_h02,
    aes(yintercept = nominal),
    inherit.aes = FALSE,
    linetype = 2
  ) +
  facet_wrap(~ nivel, labeller = label_both) +
  scale_x_continuous(breaks = 1:h_cv) +
  labs(
    x = "Horizonte h",
    y = "Cobertura empírica",
    linetype = "Método"
  )
amplitud_h02_h <- intervalos_h02_cv |>
  group_by(.model, nivel, h) |>
  summarise(
    amplitud = mean(amplitud),
    .groups = "drop"
  )

ggplot(amplitud_h02_h, aes(x = h, y = amplitud, linetype = .model)) +
  geom_line() +
  geom_point() +
  facet_wrap(~ nivel, labeller = label_both, scales = "free_y") +
  scale_x_continuous(breaks = 1:h_cv) +
  labs(
    x = "Horizonte h",
    y = "Amplitud promedio",
    linetype = "Método"
  )
7.10.5 Winkler con accuracy()
winkler_h02 <- map_dfr(c(80, 95), function(niv) {
  fc_h02_cv |>
    accuracy(
      h02,
      measures = list(Winkler = winkler_score),
      level = niv,
      by = ".model"
    ) |>
    mutate(nivel = niv)
}) |>
  select(.model, nivel, Winkler)

knitr::kable(
  winkler_h02 |>
    arrange(nivel, Winkler),
  digits = 4,
  caption = "Puntuación de Winkler para intervalos de H02. Menor es mejor."
)| .model | nivel | Winkler |
|---|---|---|
| Naive estacional | 80 | 0.2580 |
| SARIMA manual | 80 | 0.2614 |
| ARIMA automatico | 80 | 0.2716 |
| Naive estacional | 95 | 0.3368 |
| SARIMA manual | 95 | 0.3652 |
| ARIMA automatico | 95 | 0.3857 |
Cobertura, amplitud y Winkler responden preguntas relacionadas, pero no idénticas. Una presentación responsable no debe reportar sólo la cantidad que favorece al modelo elegido.
7.11 Evaluación probabilística
7.11.1 Cuantiles predictivos
Sea \(f_{p,t}\) el cuantil predictivo de probabilidad \(p\). FPP3 utiliza el quantile score
\[ Q_{p,t} = \begin{cases} 2(1-p)(f_{p,t}-y_t), & y_t<f_{p,t},\\[1ex] 2p(y_t-f_{p,t}), & y_t\ge f_{p,t}. \end{cases} \tag{7.23}\]
Un valor menor es mejor (Hyndman y Athanasopoulos 2021, sec. 5.9). Cuando \(p=0.5\),
\[ Q_{0.5,t}=|y_t-f_{0.5,t}|, \]
de modo que la evaluación de la mediana predictiva coincide con pérdida absoluta.
La asimetría de Ecuación 7.23 es deliberada. Para un cuantil alto, subestimar una realización extrema debe recibir más penalización que sobreestimarla ligeramente.
7.11.2 CRPS
Cuando interesa evaluar la distribución predictiva completa \(F\), una regla particularmente útil es el Continuous Ranked Probability Score:
\[ \operatorname{CRPS}(F,y) = \int_{-\infty}^{\infty} \left [ F(z)-\mathbf 1\{y\le z\} \right]^2 \,dz. \tag{7.24}\]
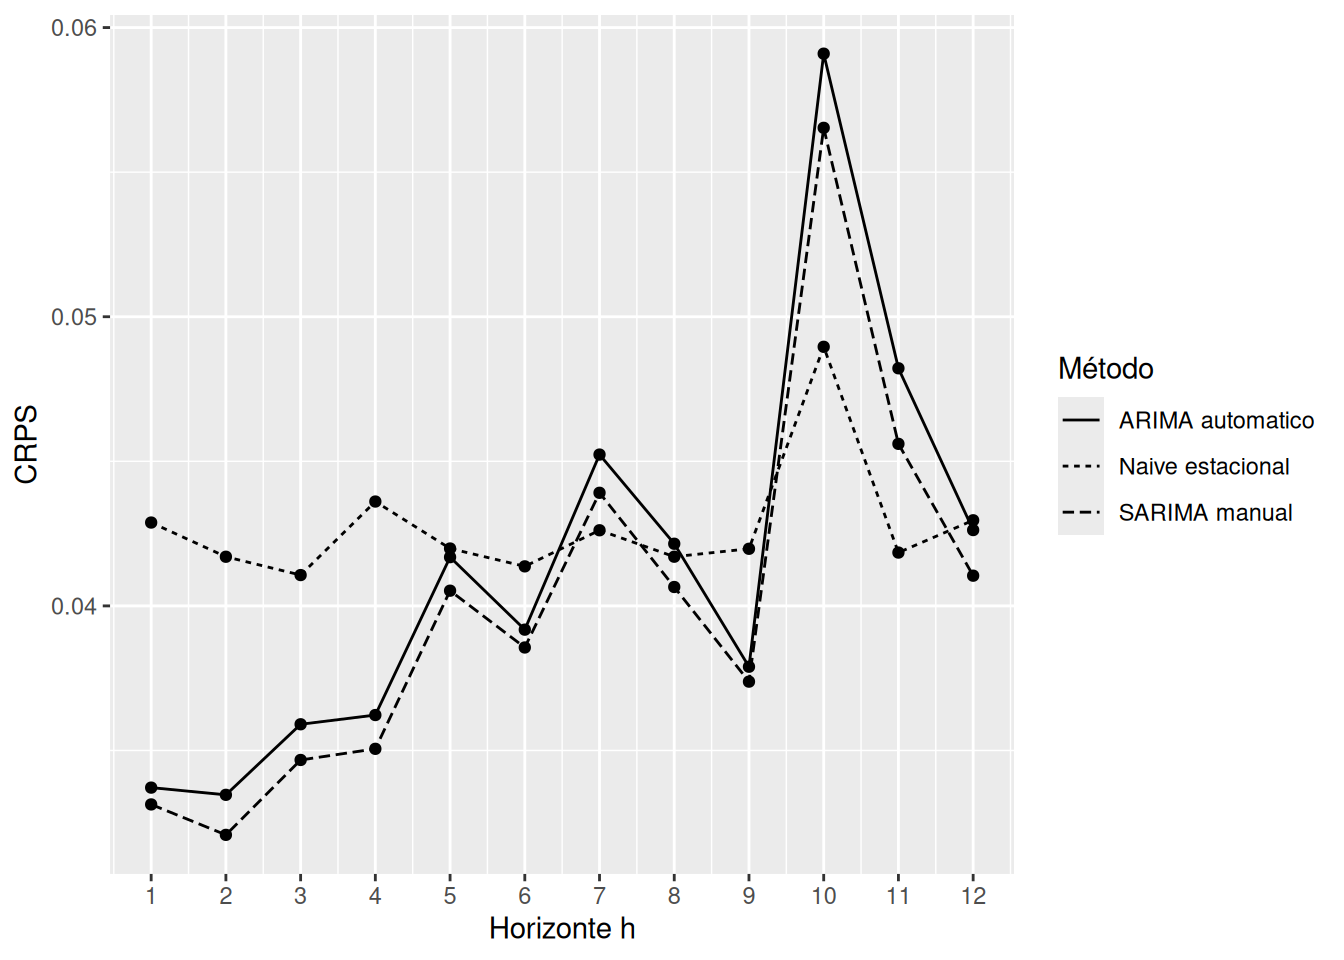
Con la normalización de Ecuación 7.23, CRPS puede interpretarse como la integración de los quantile scores sobre todos los niveles \(p\in(0,1)\) (Hyndman y Athanasopoulos 2021, sec. 5.9). Tiene unidades de la variable observada y, al igual que MAE, valores menores indican mejor desempeño.
La ventaja conceptual frente a una evaluación puramente puntual es que una distribución demasiado concentrada puede recibir una penalización severa cuando la observación cae en sus colas, mientras una distribución excesivamente dispersa pierde agudeza.
7.11.3 CRPS para H02
El cálculo del CRPS sobre todos los orígenes y horizontes es relativamente costoso.
crps_h02 <- fc_h02_cv |>
  accuracy(
    h02,
    measures = list(CRPS = CRPS),
    by = ".model"
  ) |>
  select(.model, CRPS) |>
  arrange(CRPS)

crps_h02_h <- fc_h02_cv |>
  accuracy(
    h02,
    measures = list(CRPS = CRPS),
    by = c("h", ".model")
)knitr::kable(
crps_h02,
digits = 4,
caption = "CRPS promedio en la validación temporal de H02. Menor es mejor."
)| .model | CRPS |
|---|---|
| SARIMA manual | 0.0399 |
| ARIMA automatico | 0.0413 |
| Naive estacional | 0.0427 |
También podemos estudiar CRPS por horizonte.
ggplot(crps_h02_h, aes(x = h, y = CRPS, linetype = .model)) +
  geom_line() +
  geom_point() +
  scale_x_continuous(breaks = 1:h_cv) +
  labs(
    x = "Horizonte h",
    y = "CRPS",
    linetype = "Método"
  )
7.11.4 Extensión: log-score
Si un método produce una densidad predictiva \(f_t(\cdot)\), definimos
\[ LS_t = -\log f_t(y_t). \tag{7.25}\]
Menor es mejor. El score penaliza fuertemente a una distribución que asigne densidad muy pequeña a la realización observada. Esto lo hace útil para estudiar colas, pero también sensible a especificaciones distribucionales pobres.
No utilizaremos el log-score como métrica principal en la aplicación H02 porque fabletools proporciona de forma directa y homogénea las medidas anteriores para nuestros modelos. Queda como herramienta complementaria para modelos en los que la densidad predictiva esté disponible de forma explícita, especialmente en las semanas de volatilidad y modelos de espacio-estado.
7.11.5 Reglas de puntuación propias
Una regla de puntuación distribucional es propia si, en esperanza, una persona que realmente cree en una distribución \(F\) no puede mejorar su score reportando deliberadamente otra distribución \(G\neq F\). Esta propiedad es importante porque evita recompensar estrategias como inflar artificialmente los intervalos para aumentar cobertura.
Winkler, quantile score, CRPS y log-score se utilizan precisamente porque evalúan la distribución o partes de ella combinando calibración y precisión de una manera coherente.
7.12 Comparación justa entre procedimientos
Cuando dos procedimientos se comparan, deben enfrentarse al mismo experimento. Como mínimo, conviene igualar:
- la variable objetivo y su escala final;
- los orígenes de pronóstico;
- los horizontes;
- las observaciones utilizadas para evaluar;
- la disponibilidad de covariables en cada origen;
- la política de reestimación de parámetros;
- la regla sobre selección de orden o hiperparámetros;
- la definición de la métrica;
- el tratamiento de datos faltantes y revisiones.
Una comparación ARIMA–ETS, frecuentista–bayesiana o GARCH–SV puede ser válida aunque los modelos tengan estructuras muy diferentes. Lo que debe mantenerse comparable es el problema predictivo.
ImportanteAICc y evaluación fuera de muestra cumplen funciones distintas
AICc compara especificaciones a partir de la verosimilitud ajustada y una corrección por complejidad. Un error fuera de muestra compara realizaciones futuras con pronósticos genuinos. En H02, modelos con diferentes órdenes de diferenciación no deben mezclarse ingenuamente mediante AICc, pero sí pueden compararse sobre el mismo conjunto de prueba (Hyndman y Athanasopoulos 2021, sec. 9.9).
7.13 Comparación frecuentista y bayesiana
En la semana 5 construimos distribuciones predictivas posteriores integrando sobre incertidumbre paramétrica , Sección 5.11. La evaluación fuera de muestra no cambia por ser bayesiano el procedimiento. La realización futura \(y_{t+h}\) debe enfrentarse a la distribución que realmente se habría reportado en el origen \(t\).
7.13.1 Diseño común
Para una secuencia de orígenes \(t_1,\ldots,t_K\), suponga que un procedimiento frecuentista produce
\[ F^{(F)}_{t_k,h} \]
y uno bayesiano produce
\[ F^{(B)}_{t_k,h}. \]
Ambos deben evaluarse contra el mismo \(y_{t_k+h}\). No sería justo, por ejemplo, reestimar uno en cada origen y mantener el otro fijo, salvo que esa diferencia forme parte explícita de los procedimientos que queremos comparar.
7.13.2 Ejemplo didáctico: AR(1) a un paso
Consideremos
\[ Y_t=\phi Y_{t-1}+\varepsilon_t, \qquad \varepsilon_t\overset{\text{iid}}{\sim}N(0,\sigma_\varepsilon^2), \tag{7.26}\]
con media cero conocida para mantener el ejemplo compacto.
Compararemos:
- una referencia frecuentista plug-in: sustituye \(\phi\) y \(\sigma_\varepsilon^2\) por estimadores condicionales y usa una normal para \(Y_{t+1}\);
- una predictiva bayesiana conjugada que integra \(\phi\) y \(\sigma_\varepsilon^2\).
Esta referencia frecuentista es deliberadamente simple. No representa todos los posibles intervalos frecuentistas, algunos de los cuales también incorporan incertidumbre paramétrica.
Para Bayes usaremos
\[ \phi\mid\sigma_\varepsilon^2 \sim N(m_0,\sigma_\varepsilon^2C_0), \qquad \sigma_\varepsilon^2 \sim IG(a_0,b_0). \tag{7.27}\]
Si \(x_i=y_{i-1}\) y \(z_i=y_i\), la posterior conjugada satisface
\[ C_n = \left(C_0^{-1}+\sum x_i^2\right)^{-1}, \]
\[ m_n = C_n \left( C_0^{-1}m_0+\sum x_i z_i \right), \]
\[ a_n=a_0+\frac{n}{2}, \]
y
\[ b_n = b_0+\frac{1}{2} \left( \sum z_i^2 +\frac{m_0^2}{C_0} -\frac{m_n^2}{C_n} \right). \tag{7.28}\]
La predictiva a un paso es Student-\(t\) con \(2a_n\) grados de libertad, localización
\[ m_n y_t, \]
y escala al cuadrado
\[ \frac{b_n}{a_n} \left(1+y_t^2C_n\right). \tag{7.29}\]
El factor \(1+y_t^2C_n\) muestra explícitamente cómo la incertidumbre sobre \(\phi\) se incorpora a la dispersión predictiva.
n_ar_eval <- 95
phi_ar_eval <- 0.85
sigma_ar_eval <- 1

y_ar_eval <- numeric(n_ar_eval)
y_ar_eval[1] <- rnorm(
  1,
  sd = sigma_ar_eval / sqrt(1 - phi_ar_eval^2)
)

for (tt in 2:n_ar_eval) {
  y_ar_eval[tt] <-
    phi_ar_eval * y_ar_eval[tt - 1] + rnorm(1, sd = sigma_ar_eval)
}
comparar_ar1_origen <- function(y, t,
m0 = 0,
C0 = 1,
a0 = 2.5,
b0 = 1) {
x <- y[1:(t - 1)]
z <- y[2:t]
n <- length(z)
# Frecuentista plug-in
phi_hat <- sum(x * z) / sum(x^2)
residuos <- z - phi_hat * x
s2_hat <- sum(residuos^2) / (n - 1)
mu_f <- phi_hat * y[t]
sd_f <- sqrt(s2_hat)
# Bayes conjugado
Cn <- 1 / (1 / C0 + sum(x^2))
mn <- Cn * (m0 / C0 + sum(x * z))
an <- a0 + n / 2
bn <- b0 + 0.5 * (
sum(z^2) + m0^2 / C0 - mn^2 / Cn
)
df_b <- 2 * an
mu_b <- mn * y[t]
scale_b <- sqrt((bn / an) * (1 + y[t]^2 * Cn))
observado <- y[t + 1]
tibble(
origen = t,
observado = observado,
metodo = c("Frecuentista plug-in", "Bayes conjugado"),
centro = c(mu_f, mu_b),
inferior95 = c(
mu_f + qnorm(0.025) * sd_f,
mu_b + qt(0.025, df = df_b) * scale_b
),
superior95 = c(
mu_f + qnorm(0.975) * sd_f,
mu_b + qt(0.975, df = df_b) * scale_b
)
)
}
resultados_ar_eval <- map_dfr(
25:(n_ar_eval - 1),
~ comparar_ar1_origen(y_ar_eval, .x)
) |>
mutate(
error = observado - centro,
cubierto95 = observado >= inferior95 & observado <= superior95,
amplitud95 = superior95 - inferior95
)resumen_ar_eval <- resultados_ar_eval |>
group_by(metodo) |>
summarise(
MAE = mean(abs(error)),
RMSE = sqrt(mean(error^2)),
cobertura95 = mean(cubierto95),
amplitud95 = mean(amplitud95),
.groups = "drop"
)
knitr::kable(
resumen_ar_eval,
digits = 3,
caption = "Comparación fuera de muestra a un paso entre una predictiva frecuentista plug-in y una predictiva bayesiana conjugada para un AR(1) simulado."
)| metodo | MAE | RMSE | cobertura95 | amplitud95 |
|---|---|---|---|---|
| Bayes conjugado | 0.705 | 0.889 | 0.914 | 3.458 |
| Frecuentista plug-in | 0.703 | 0.888 | 0.914 | 3.424 |
ggplot(resultados_ar_eval, aes(x = origen, y = amplitud95, linetype = metodo)) +
  geom_line() +
  labs(
    x = "Origen",
    y = "Amplitud del intervalo 95%",
    linetype = "Método"
  )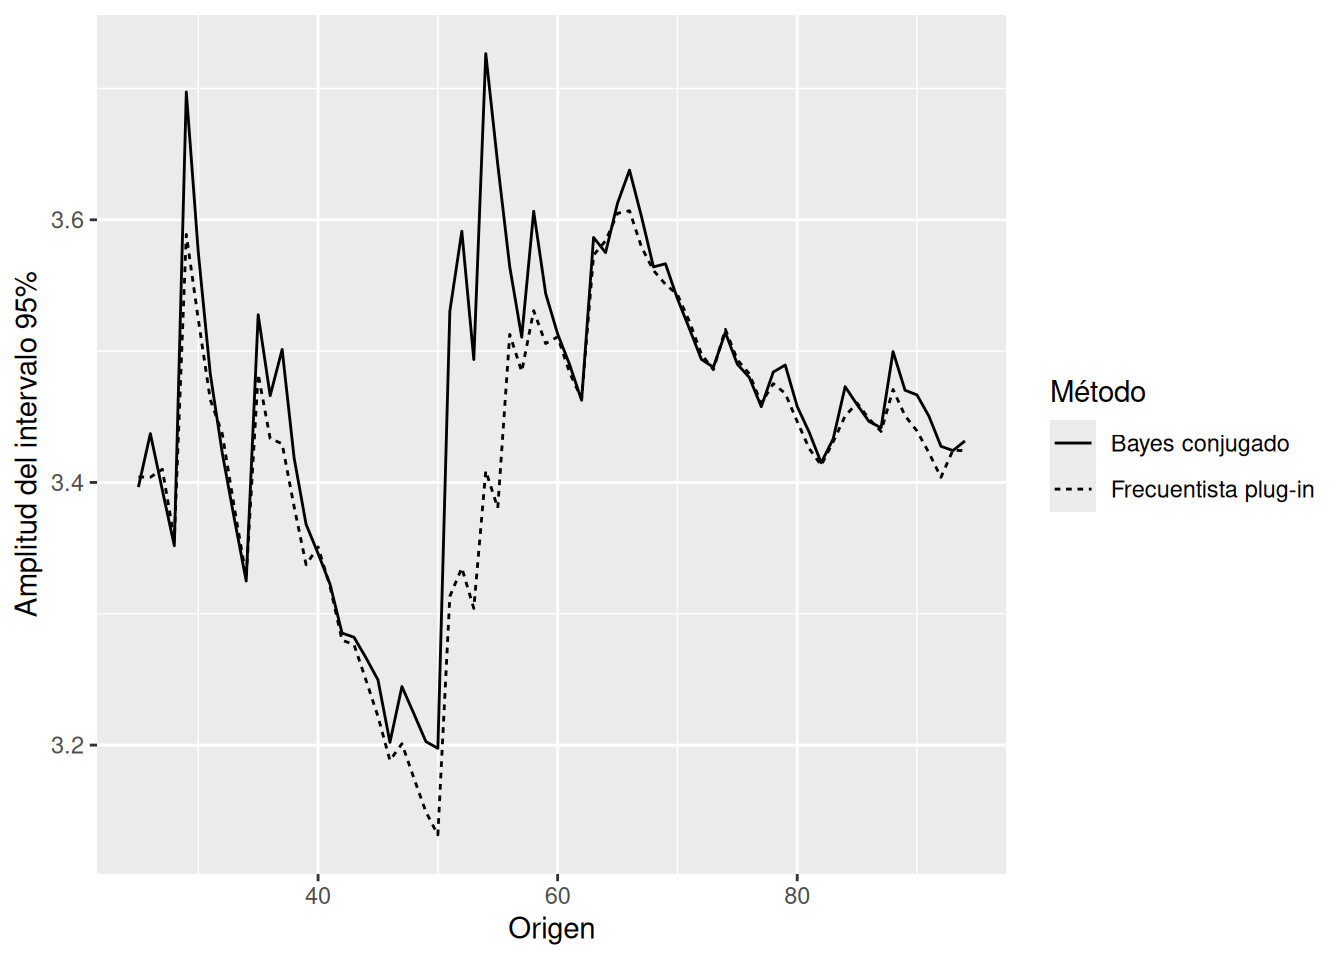
A medida que crece el entrenamiento, la incertidumbre paramétrica suele perder peso relativo frente a la innovación futura. Por eso las diferencias entre una predictiva integrada y una referencia plug-in pueden reducirse con muestras grandes. Con muestras cortas o parámetros muy persistentes, esa diferencia puede ser más visible.
AdvertenciaNo interpretar este ejemplo como una competencia universal Bayes–frecuentismo
El resultado depende de la priori, de la especificación, del tamaño muestral y de qué procedimiento frecuentista se utilice. El objetivo es mostrar cómo diseñar la comparación, no declarar un enfoque globalmente superior.
7.14 Aplicación integral: H02 revisitada
La aplicación H02 permite cerrar lo iniciado en la semana 6.
7.14.1 Lo que sabíamos antes de evaluar
En Sección 6.17 desarrollamos la aplicación de H02. En particular:
- estabilizamos la variabilidad mediante \(\log(\text{Cost})\);
- usamos una diferencia estacional;
- propusimos modelos a partir de ACF/PACF;
- comparamos candidatos compatibles mediante AICc;
- diagnosticamos innovaciones;
- generamos pronósticos.
FPP3 también señala para H02 que los modelos con buen AICc no necesariamente ocupan exactamente el mismo orden cuando se comparan por RMSE de prueba (Hyndman y Athanasopoulos 2021, sec. 9.9). Esta es precisamente la diferencia entre seleccionar una representación dentro de muestra y evaluar su consecuencia predictiva.
7.14.2 Lo que añade la semana 7
Ahora disponemos de cuatro capas de evidencia:
- diagnóstico estructural: ¿la especificación tiene sentido para la serie?;
- ajuste: ¿qué tan compatible es con los datos de entrenamiento?;
- pronóstico puntual: ¿qué tan grandes son MAE, RMSE y MASE?;
- pronóstico distribucional: ¿cómo se comportan cobertura, amplitud, Winkler y CRPS?
Ninguna capa debe sustituir automáticamente a las demás.
7.14.3 Tabla de síntesis predictiva
Construimos una tabla que reúna medidas puntuales y probabilísticas bajo el mismo diseño expansivo.
resumen_h02_integral <- acc_h02_cv_global |>
  left_join(
    crps_h02,
    by = ".model"
  ) |>
  left_join(
    winkler_h02 |>
      filter(nivel == 80) |>
      select(.model, Winkler80 = Winkler),
    by = ".model"
  ) |>
  left_join(
    resumen_intervalos_h02 |>
      filter(nivel == 80) |>
      select(
        .model,
        Cobertura80 = cobertura,
        Amplitud80 = amplitud_media
      ),
    by = ".model"
  ) |>
  arrange(RMSE)

knitr::kable(
  resumen_h02_integral,
  digits = 4,
  caption = "Síntesis de desempeño fuera de muestra de H02 bajo los mismos orígenes y horizontes."
)| .model | RMSE | MAE | MASE | RMSSE | CRPS | Winkler80 | Cobertura80 | Amplitud80 |
|---|---|---|---|---|---|---|---|---|
| SARIMA manual | 0.0702 | 0.0555 | 0.9434 | 0.9894 | 0.0399 | 0.2614 | 0.8400 | 0.2019 |
| ARIMA automatico | 0.0732 | 0.0575 | 0.9765 | 1.0315 | 0.0413 | 0.2716 | 0.8267 | 0.2037 |
| Naive estacional | 0.0750 | 0.0611 | 1.0407 | 1.0580 | 0.0427 | 0.2580 | 0.7633 | 0.1818 |
La tabla no debe convertirse en un ranking automático. Si un procedimiento tiene menor RMSE pero peor CRPS, la diferencia indica que sus pronósticos puntuales y su cuantificación de incertidumbre están contando historias distintas. La decisión depende del objetivo de la aplicación.
7.14.4 Un resultado negativo también informa
Puede ocurrir que un ARIMA cuidadosamente construido no supere de forma importante al naïve estacional. Eso no vuelve inútil al análisis. Significa que, bajo los orígenes y horizontes estudiados, la estructura adicional no produjo una mejora predictiva suficientemente grande.
En pronóstico, una conclusión valiosa puede ser:
el modelo estructuralmente más elaborado no demuestra una ventaja estable sobre una referencia simple para el horizonte de interés.
Esa conclusión es mucho más informativa que seleccionar siempre el modelo con más parámetros o el menor AICc.
7.15 Auditoría de un protocolo de evaluación
Antes de aceptar una comparación, conviene responder explícitamente las siguientes preguntas:
- Objetivo: ¿qué variable y qué horizonte queremos pronosticar?
- Información: ¿qué datos habrían estado disponibles en cada origen?
- Referencia: ¿qué benchmark simple es razonable para esta serie?
- Ventana: ¿expansiva o móvil? ¿con qué tamaño inicial?
- Reestimación: ¿se vuelven a estimar los parámetros en cada origen?
- Selección: si el orden o hiperparámetros son automáticos, ¿se vuelven a seleccionar dentro de cada ventana?
- Transformaciones: ¿se estiman sin utilizar el futuro?
- Horizontes: ¿se reporta el desempeño por \(h\) y no solamente agregado?
- Punto: ¿qué pérdida justifica MAE, RMSE o la métrica principal?
- Incertidumbre: ¿se evalúan cobertura y amplitud o un score distribucional?
- Comparabilidad: ¿todos los métodos enfrentan exactamente las mismas realizaciones?
- Prueba final: ¿el conjunto final permaneció realmente sin usar durante el desarrollo?
- Reproducibilidad: ¿código, semillas, ventanas y versiones de datos permiten repetir el experimento?
Esta lista servirá como referencia transversal para las semanas siguientes.
7.16 Actividad computacional guiada
7.16.1 Parte A. Residuos frente a errores reales
- Ajuste un ARIMA a una serie de entrenamiento.
- Obtenga las innovaciones dentro de muestra con
augment(). - Genere pronósticos para un bloque de prueba.
- Calcule los errores fuera de muestra.
- Compare la desviación estándar de las innovaciones y el RMSE de prueba.
- Explique por qué no deben coincidir necesariamente.
7.16.2 Parte B. Métodos de referencia
Con una serie mensual estacional:
- ajuste
MEAN(),NAIVE(),SNAIVE()yRW(... ~ drift()); - reserve al menos un año de prueba;
- compare MAE, RMSE y MASE;
- argumente cuál benchmark debería conservarse para comparaciones posteriores.
7.16.3 Parte C. Función de pérdida
- simule una distribución simétrica y otra sesgada;
- estime su media y mediana;
- calcule pérdida absoluta y cuadrática para una rejilla de pronósticos puntuales;
- verifique empíricamente Ecuación 7.15 y Ecuación 7.17.
7.16.4 Parte D. Origen móvil
Con H02:
- cambie
.step = 3por.step = 1; - compare el número de ventanas y el tiempo de cómputo;
- estudie si las curvas RMSE\((h)\) cambian de forma importante;
- explique por qué usar más orígenes aumenta información pero también costo computacional.
7.16.5 Parte E. Ventana móvil
- utilice
slide_tsibble(.size = 120, .step = 3); - ajuste los mismos tres procedimientos de Sección 7.9.1;
- compare RMSE, MASE y CRPS con la ventana expansiva;
- discuta si dar peso cero a observaciones antiguas parece razonable para H02.
7.16.6 Parte F. Intervalos
- calcule cobertura y amplitud para niveles 80% y 95%;
- identifique si algún modelo logra cobertura alta solamente mediante intervalos muy anchos;
- compare la conclusión con la puntuación de Winkler.
7.16.7 Parte G. Bayes y frecuentismo
- cambie la longitud inicial del ejemplo AR(1) de 25 a 15;
- cambie \(C_0\) para producir una priori más concentrada;
- compare MAE, cobertura y amplitud;
- explique cuáles cambios reflejan información previa y cuáles reflejan simplemente mayor incertidumbre muestral.
7.17 Buenas prácticas computacionales
7.17.1 Evitar objetos construidos con toda la serie
Una mala práctica sería
# NO hacer esto para una evaluación genuina:
modelo_completo <- h02 |> model(ARIMA(log(Cost)))
y después pretender evaluar retrospectivamente cómo ese modelo habría pronosticado años anteriores sin volver a ejecutar la selección y el ajuste en cada origen.
La alternativa correcta es incorporar el procedimiento dentro del objeto de ventanas:
h02_cv_exp |>
  model(auto = ARIMA(log(Cost))) |>
  forecast(h = 12)
7.17.2 Controlar dimensiones y faltantes
Cuando la validación produce miles de filas, conviene comprobar:
stopifnot(
  n_distinct(h02_cv_exp$.id) > 5,
  !anyNA(h02_cv_exp$Cost),
  h_cv >= 1,
  init_cv > 2 * h_cv
)
Para datos con faltantes, debe decidirse si el procedimiento habría conocido ese faltante en el origen y qué regla de filtrado o imputación habría podido aplicar en ese momento.
7.17.3 Costo computacional
Si tenemos \(K\) orígenes, \(M\) métodos y cada ajuste requiere costo \(C\), una validación puede requerir aproximadamente \(K\times M\) ajustes. Repetir búsqueda automática, MCMC o filtros con parámetros desconocidos puede ser considerablemente más costoso que un único ajuste.
En el resto del curso usaremos estrategias como:
- aumentar
.stepdurante exploración; - reducir el número de candidatos antes de una evaluación final;
- fijar semillas para procedimientos estocásticos;
- separar código pedagógico corto de evaluaciones computacionalmente intensivas;
- utilizar exactamente los mismos orígenes al comparar métodos.
7.18 Interpretación estadística de las diferencias de desempeño
Una tabla de RMSE contiene estimaciones, no constantes poblacionales. Los errores de pronóstico de distintos orígenes pueden ser dependientes y, para pronósticos de varios pasos, las ventanas de evaluación se superponen. Por tanto, una diferencia pequeña en RMSE no debe interpretarse automáticamente como evidencia contundente de superioridad estable.
En este capítulo no desarrollaremos pruebas formales de igualdad de capacidad predictiva. El principio operativo será más modesto:
- inspeccionar la magnitud de las diferencias, no solamente el orden;
- estudiar estabilidad por horizonte y por período;
- comprobar si una ventaja aparece repetidamente o depende de pocos episodios;
- evitar afirmaciones fuertes cuando el número de orígenes es pequeño.
Esta cautela será especialmente importante en el proyecto final, donde una diferencia de tercera cifra decimal puede no tener relevancia práctica.
7.19 Síntesis
Las ideas centrales de la semana son las siguientes:
- el diagnóstico dentro de muestra y la evaluación predictiva responden preguntas distintas;
- un error genuino de pronóstico debe definirse respecto de un origen y un horizonte;
- una partición entrenamiento–prueba respeta el orden temporal y no permite que el futuro intervenga en el ajuste;
- la fuga de información puede ocurrir en transformaciones, selección de órdenes, escalamiento, covariables e imputación;
- todo método sofisticado debe compararse con una referencia razonable;
- MAE y RMSE están en las unidades originales y corresponden a pérdidas distintas;
- MASE utiliza una escala construida con errores naïve del entrenamiento y permite comparaciones entre escalas;
- bajo pérdida cuadrática, la media predictiva es óptima; bajo pérdida absoluta, la mediana es óptima;
- un único holdout es simple pero puede depender fuertemente de la fecha de corte;
- la validación con origen móvil repite el experimento de pronóstico utilizando siempre sólo el pasado;
- las ventanas expansivas conservan toda la historia; las móviles descartan observaciones antiguas;
- la capacidad predictiva debe estudiarse como función del horizonte;
- cobertura sin amplitud puede premiar intervalos inútilmente anchos;
- Winkler combina amplitud y penalización por falta de cobertura;
- quantile score evalúa cuantiles con penalizaciones asimétricas coherentes;
- CRPS evalúa la distribución predictiva completa;
- el log-score es una extensión útil cuando la densidad predictiva está explícitamente disponible;
- la comparación frecuentista–bayesiana debe usar los mismos orígenes, horizontes y realizaciones;
- en H02, AICc, diagnóstico residual y evaluación fuera de muestra son capas complementarias, no criterios intercambiables;
- a partir de esta semana, todo modelo nuevo del curso deberá acompañarse de un protocolo explícito de evaluación temporal.
7.20 Ejercicios
7.20.1 Conceptuales
Residual frente a error. Explique dos diferencias entre \(\widehat\varepsilon_t\) y \(e_{t+h\mid t}\).
Origen. ¿Qué significa el subíndice \(t+h\mid t\) en \(\widehat y_{t+h\mid t}\)?
Holdout. ¿Por qué una partición aleatoria 80/20 suele ser inapropiada para evaluar un pronóstico temporal?
Fuga. Dé tres ejemplos de fuga de información que no consistan simplemente en “incluir la observación futura como predictor”.
Benchmark. Explique por qué un modelo ARIMA para una serie mensual fuertemente estacional debería compararse con
SNAIVE()y no solamente conMEAN().MAE frente a RMSE. ¿Cuál penaliza relativamente más un error extremo? Explique usando las funciones de pérdida.
MAPE. ¿Qué problema aparece cuando \(y_t\) es cero o cercano a cero?
MASE. Interprete MASE \(=0.75\) y MASE \(=1.20\).
MASE estacional. ¿Por qué el denominador de Ecuación 7.13 usa \(y_t-y_{t-S}\) en lugar de \(y_t-y_{t-1}\)?
Horizonte. Un modelo A gana en RMSE para \(h=1,2\), pero B gana para \(h=6,\ldots,12\). ¿Qué información adicional necesita para decidir cuál es más útil?
Cobertura. Un modelo tiene cobertura 99% para intervalos nominales 95%. ¿Puede concluir que sus intervalos son mejores? Explique.
Winkler. ¿Por qué un intervalo más estrecho no siempre obtiene un mejor score?
CRPS. ¿Qué añade CRPS respecto de evaluar solamente la media predictiva?
Ventanas. Dé un contexto en que una ventana móvil sea más defendible que una expansiva.
Selección automática. Si
ARIMA()se usa como procedimiento automático, ¿por qué debe ejecutarse nuevamente en cada origen?Bayes. Explique por qué una posterior bien concentrada no garantiza buen desempeño predictivo fuera de muestra.
Comparación justa. ¿Sería válida una comparación si el modelo A se reestima mensualmente y el modelo B una sola vez al inicio? ¿En qué caso sí podría serlo?
Prueba final. Explique por qué revisar muchas veces el error del conjunto de prueba puede convertirlo de hecho en un conjunto de validación.
7.20.2 Derivaciones
Pérdida cuadrática. Derive Ecuación 7.14 y demuestre Ecuación 7.15.
Pérdida absoluta. Para una distribución continua, derive Ecuación 7.16 y muestre que una mediana minimiza la pérdida absoluta esperada.
RMSE por horizonte. A partir de Ecuación 7.2, escriba la fórmula de RMSE\((h)\) para \(K\) orígenes.
MASE. Muestre que MASE es invariante ante multiplicar toda la serie y todos los pronósticos por una constante no nula.
Winkler. Para un intervalo 80%, escriba explícitamente la penalización aplicada cuando \(y_t<\ell_t\). ¿Cuál es el valor de \(2/\alpha\)?
Winkler y cuantiles. Usando los cuantiles \(\alpha/2\) y \(1-\alpha/2\), verifique algebraicamente la relación entre el score de intervalo y dos quantile scores indicada en FPP3.
CRPS. Explique por qué Ecuación 7.24 vale cero solamente cuando una distribución degenerada coloca toda su masa exactamente en la realización observada. ¿Por qué esto no implica que debamos pronosticar distribuciones degeneradas antes de observar \(y\)?
AR(1) bayesiano. Derive la media y la varianza de la predictiva de \(Y_{t+1}\) condicionada en \(\phi\), \(\sigma_\varepsilon^2\) y \(Y_t\); después explique qué incertidumbre adicional aparece al integrar la posterior.
AR(1) conjugado. Partiendo de Ecuación 7.27, derive \(C_n\) y \(m_n\) en Ecuación 7.28.
7.20.3 Computacionales
Corte sensible. Con H02, repita la evaluación fija reservando 12, 24 y 36 meses. Compare el orden de los modelos según RMSE.
Benchmark estacional. Calcule manualmente los 24 pronósticos de
SNAIVE(Cost)y verifique que coincidan confable.MASE manual. Reproduzca Sección 7.7.2 sin usar
accuracy().Pérdida. Cambie la distribución lognormal de Sección 7.6.3 por una \(t_3\). Compare media, mediana, MAE y RMSE.
Más orígenes. Cambie
.step = 3por.step = 1en H02 y calcule el incremento relativo del número de ventanas.Menos historia. Cambie
.init = 120por.init = 60. ¿Qué ocurre con la estabilidad de las métricas en los primeros orígenes?Ventana móvil. Compare ventanas móviles de 60, 120 y 180 meses. ¿Hay evidencia de que observaciones antiguas perjudiquen el pronóstico de H02?
Horizonte. Para cada modelo H02, identifique el horizonte con mayor RMSE y el de menor RMSE. Discuta si la diferencia tiene una explicación temporal.
Cobertura. Para H02, calcule cobertura 50%, 80%, 90% y 95%. Grafique cobertura empírica frente a nominal.
Winkler. Verifique manualmente Ecuación 7.22 para diez pronósticos elegidos al azar y compare con
winkler_score().Quantile score. Calcule los scores para \(p=0.1\), \(0.5\) y \(0.9\) y explique cómo cambia la penalización de errores de signo opuesto.
CRPS. Compare la ordenación de los modelos H02 por RMSE y por CRPS. Identifique cualquier desacuerdo y explique qué aspecto adicional evalúa CRPS.
ARIMA automático. Registre el orden seleccionado por
ARIMA(log(Cost))en cada origen. ¿Es estable la especificación o cambia a través del tiempo?Selección congelada. Compare dos procedimientos: (a) seleccionar ARIMA automáticamente en cada origen; (b) seleccionar una sola vez en la primera ventana y conservar el orden, pero reestimar parámetros. ¿Qué pregunta responde cada uno?
Sin logaritmo. Repita la validación H02 con
ARIMA(Cost). Compare punto, cobertura y CRPS con la versión logarítmica.Bayes AR(1). Repita Sección 7.13.2 con \(\phi=0.98\). Estudie cómo cambia cobertura y amplitud en los primeros orígenes.
Priori. En Sección 7.13.2 cambie \(C_0\) a 0.05 y 20. Compare desempeño temprano y tardío.
Proyecto. Escriba un protocolo de evaluación para la serie de su proyecto: variable objetivo, horizonte, benchmark, tamaño inicial, tipo de ventana, métrica puntual principal, métrica probabilística y regla para selección de hiperparámetros.
7.21 Lecturas recomendadas
Para esta semana:
- Hyndman y Athanasopoulos: sección 5.2 para métodos de referencia; sección 5.8 para entrenamiento–prueba, errores, MAE, RMSE y MASE; sección 5.9 para quantile score, Winkler y CRPS; sección 5.10 para validación con origen móvil y evaluación por horizonte (Hyndman y Athanasopoulos 2021).
- Hyndman y Athanasopoulos: sección 9.9 para reinterpretar la aplicación H02 desde una perspectiva fuera de muestra y observar por qué los criterios de información y el RMSE de prueba no tienen que ordenar los modelos de la misma forma (Hyndman y Athanasopoulos 2021).
- Prado, Ferreira y West: capítulo 2, especialmente pronóstico e inferencia bayesiana AR, para conectar la distribución predictiva posterior con las reglas de evaluación de esta semana (Prado et al. 2021, secs. 2.2–2.4).
- Shumway y Stoffer: capítulo 3 para mantener la conexión con pronóstico ARMA/ARIMA clásico y con la diferencia entre estructura del modelo y desempeño predictivo (Shumway y Stoffer 2025, secs. 3.4–3.7).
La semana 8 utilizará este protocolo para evaluar suavizamiento exponencial y modelos ETS bajo los mismos principios de referencia, origen, horizonte y comparación fuera de muestra.