Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
17 de agosto de 2026
2.1 Panorama de la semana
En la semana anterior introdujimos tres formas de tratar datos agrupados: pooling completo, ausencia de pooling y pooling parcial. El modelo de interceptos variables apareció entonces como una primera forma de representar probabilísticamente la dependencia entre observaciones del mismo grupo.
Esta semana estudiamos ese modelo con mayor profundidad. La pregunta central es:
¿Cómo se modela e interpreta la heterogeneidad entre grupos?
La respuesta requiere separar tres ideas que a menudo se mezclan:
la variación dentro de los grupos, representada por la desviación estándar residual \(\sigma\);
la variación entre grupos, representada por la desviación estándar \(\tau_\alpha\) de los interceptos;
la incertidumbre sobre ambas cantidades y sobre cada intercepto particular \(\alpha_j\).
Esta separación conduce directamente al coeficiente de correlación intraclase (ICC) y al shrinkage. El ICC resume, bajo el modelo gaussiano de interceptos variables, cuánto de la variación marginal corresponde al nivel grupal y qué correlación induce el grupo entre dos unidades. El shrinkage describe cómo la información de cada grupo y la información de la población de grupos se combinan para aprender \(\alpha_j\).
Gelman y Hill presentan el pooling parcial como un promedio adaptativo entre la información propia del grupo y la distribución poblacional, con mayor contracción cuando los grupos contienen menos información (Gelman y Hill 2007, 251-59). McElreath interpreta el mismo mecanismo como regularización adaptativa y muestra que, en promedio, puede mejorar la predicción especialmente en grupos pequeños (McElreath 2020, 401-13). BDA desarrolla la estructura normal jerárquica que permite ver algebraicamente de dónde surge este promedio ponderado (Gelman et al. 2013, 113-23).
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
escribir el modelo nulo gaussiano de interceptos variables en forma jerárquica y en forma de componentes;
distinguir la distribución de las observaciones de la distribución poblacional de los interceptos;
derivar la media, la varianza y la covarianza marginal de dos observaciones del mismo grupo;
derivar e interpretar el ICC para el modelo nulo gaussiano;
obtener una distribución posterior del ICC, en lugar de tratarlo como una única estimación puntual;
derivar el promedio posterior condicional de un intercepto grupal y reconocer el factor de shrinkage;
explicar cómo \(n_j\), \(\sigma\) y \(\tau_\alpha\) determinan la magnitud de la contracción;
relacionar algebraicamente el factor de shrinkage con el ICC;
diferenciar predicción para grupos existentes de predicción para grupos nuevos;
ajustar un modelo de interceptos variables en brms, realizar diagnósticos MCMC básicos y efectuar comprobaciones predictivas globales y por grupo;
reconocer por qué pocos grupos implican mayor incertidumbre en la heterogeneidad entre grupos;
resumir en los datos del proyecto el número de grupos, los tamaños grupales y las fuentes preliminares de variación dentro y entre grupos.
2.2 Problema motivador: mismos centros, nueva pregunta
Retomemos la situación de la semana 1. Observamos una respuesta continua en varios centros:
\[
i=1,\ldots,n_j,
\qquad
j=1,\ldots,J.
\]
La semana anterior la pregunta era principalmente estructural: ¿debemos ignorar los centros, estimarlos por separado o compartir información entre ellos?
Ahora suponemos que el modelo de pooling parcial es una representación inicial razonable y hacemos preguntas más específicas:
¿cuánto difieren los centros entre sí?
¿cuánto varían las personas dentro de un mismo centro?
¿qué tan semejantes esperamos que sean dos personas del mismo centro?
¿cuánto debe confiar una estimación grupal en su propia media observada?
¿cómo cambia esa confianza si un centro aporta 5 observaciones en lugar de 50?
¿qué debemos simular si queremos predecir una observación en un centro que nunca estuvo en la muestra?
Estas preguntas apuntan a cantidades diferentes. Conviene no reducir todo el análisis a “estimar un efecto aleatorio”.
ImportanteTres niveles de incertidumbre
En un modelo jerárquico debemos distinguir entre:
variación de observaciones alrededor de su grupo;
heterogeneidad real de los parámetros entre grupos;
incertidumbre posterior acerca de esas cantidades.
Una desviación estándar grupal grande no es lo mismo que una gran incertidumbre acerca de la desviación estándar grupal.
2.3 Modelo nulo de interceptos variables
Comenzamos sin predictores para aislar la estructura de dependencia. El modelo generativo es
Usaremos la convención de que \(\mathcal N(\mu,\sigma^2)\) se parametriza con varianza en las ecuaciones. En brms y Stan, normal(mu, sigma) usa desviación estándar.
Los parámetros tienen interpretaciones distintas:
Parámetro
Nivel
Interpretación
\(\alpha_j\)
grupo observado
media esperada de la respuesta en el grupo \(j\)
\(\mu_\alpha\)
población de grupos
media de la distribución poblacional de interceptos
\(\tau_\alpha\)
población de grupos
desviación estándar entre los interceptos
\(\sigma\)
observación dentro de grupo
desviación estándar residual alrededor de \(\alpha_j\)
————
————
————
El énfasis en distinguir \(\tau_\alpha\) de \(\sigma\) es central. En el ejemplo lineal multinivel de Bayesian Workflow, la desviación estándar del intercepto variable representa variación entre personas, mientras la desviación estándar residual representa variación dentro de personas una vez incorporados los predictores (Gelman et al. 2026, 280-83).
Esta forma conecta con la notación clásica de modelos mixtos, en la cual \(u_j\) suele denominarse un efecto aleatorio de intercepto. Hox et al. escriben el modelo vacío (nulo) como una suma de un intercepto global, un error de nivel grupal y un error de nivel individual (Hox et al. 2018, 12-13).
En estas notas preferiremos hablar de interceptos variables y de desviaciones grupales, pero señalaremos la terminología tradicional cuando sea útil para leer la literatura.
2.4 De la jerarquía a la distribución marginal
La jerarquía permite derivar propiedades marginales de \(Y_{ij}\). Estas propiedades explican por qué la agrupación induce dependencia incluso cuando los errores \(\varepsilon_{ij}\) son independientes.
2.4.1 Media marginal
Como
\[
Y_{ij}
=
\mu_\alpha+u_j+\varepsilon_{ij},
\]
y
\[
E(u_j)=0,
\qquad
E(\varepsilon_{ij})=0,
\]
tenemos
\[
E(Y_{ij})=\mu_\alpha.
\]
2.4.2 Varianza marginal
Por independencia entre \(u_j\) y \(\varepsilon_{ij}\),
Al integrar la incertidumbre sobre \(\alpha_j\), las observaciones del mismo grupo quedan correlacionadas porque comparten el mismo componente \(u_j\).
2.5 Coeficiente de correlación intraclase
El coeficiente de correlación intraclase del modelo nulo gaussiano se obtiene dividiendo la covarianza de dos observaciones del mismo grupo por su desviación estándar marginal:
Hox et al. derivan esta expresión a partir del modelo vacío y señalan dos interpretaciones equivalentes en este caso: proporción de la variación total correspondiente al nivel grupal y correlación esperada entre dos unidades tomadas del mismo grupo (Hox et al. 2018, 12-13). Gelman y Hill presentan la misma razón de varianzas al discutir la variación individual y grupal en el modelo de interceptos variables (Gelman y Hill 2007, 258).
2.5.1 Interpretación como proporción de varianza
En el modelo nulo,
\[
\rho
=
\frac{\text{varianza entre grupos}}
{\text{varianza marginal total}}.
\]
Por ejemplo, \(\rho=0.30\) significa que, bajo este modelo, 30% de la varianza marginal de la respuesta corresponde a heterogeneidad entre interceptos de grupo y 70% a heterogeneidad dentro de los grupos.
Esta interpretación depende del modelo. El ICC no es una propiedad inmutable del archivo de datos.
2.5.2 Interpretación como correlación
Si elegimos dos unidades distintas del mismo grupo,
\[
\operatorname{Corr}(Y_{ij},Y_{i'j})=\rho.
\]
Un ICC cercano a cero implica poca semejanza marginal inducida por el intercepto compartido. Un ICC alto implica que conocer el grupo aporta mucha información acerca del nivel de una observación.
2.5.3 Casos límite
Si \(\tau_\alpha\rightarrow0\),
\[
\rho\rightarrow0,
\]
y los grupos dejan de diferir en su intercepto. El modelo se aproxima al pooling completo.
Si \(\sigma\rightarrow0\) mientras \(\tau_\alpha>0\),
\[
\rho\rightarrow1,
\]
y las observaciones de un mismo grupo quedan casi completamente determinadas por su intercepto común.
AdvertenciaEl ICC no decide por sí solo si necesitamos un modelo multinivel
Un ICC pequeño no implica automáticamente que el agrupamiento sea irrelevante. Su importancia depende de la pregunta, del tamaño de los grupos, del diseño, de los predictores y del estimando. Tampoco existe un umbral universal de ICC que determine cuándo “usar” o “no usar” un modelo multinivel.
2.5.4 ICC condicional después de incorporar predictores
describe la correlación inducida por el intercepto compartido condicionalmente en los predictores incluidos. Las componentes de varianza pueden cambiar al incorporar covariables.
Por eso no conviene interpretar el ICC de un modelo nulo como si fuera una constante física de la población. El modelo determina qué variación se atribuye a cada componente.
2.6 ICC bayesiano: una distribución, no un único número
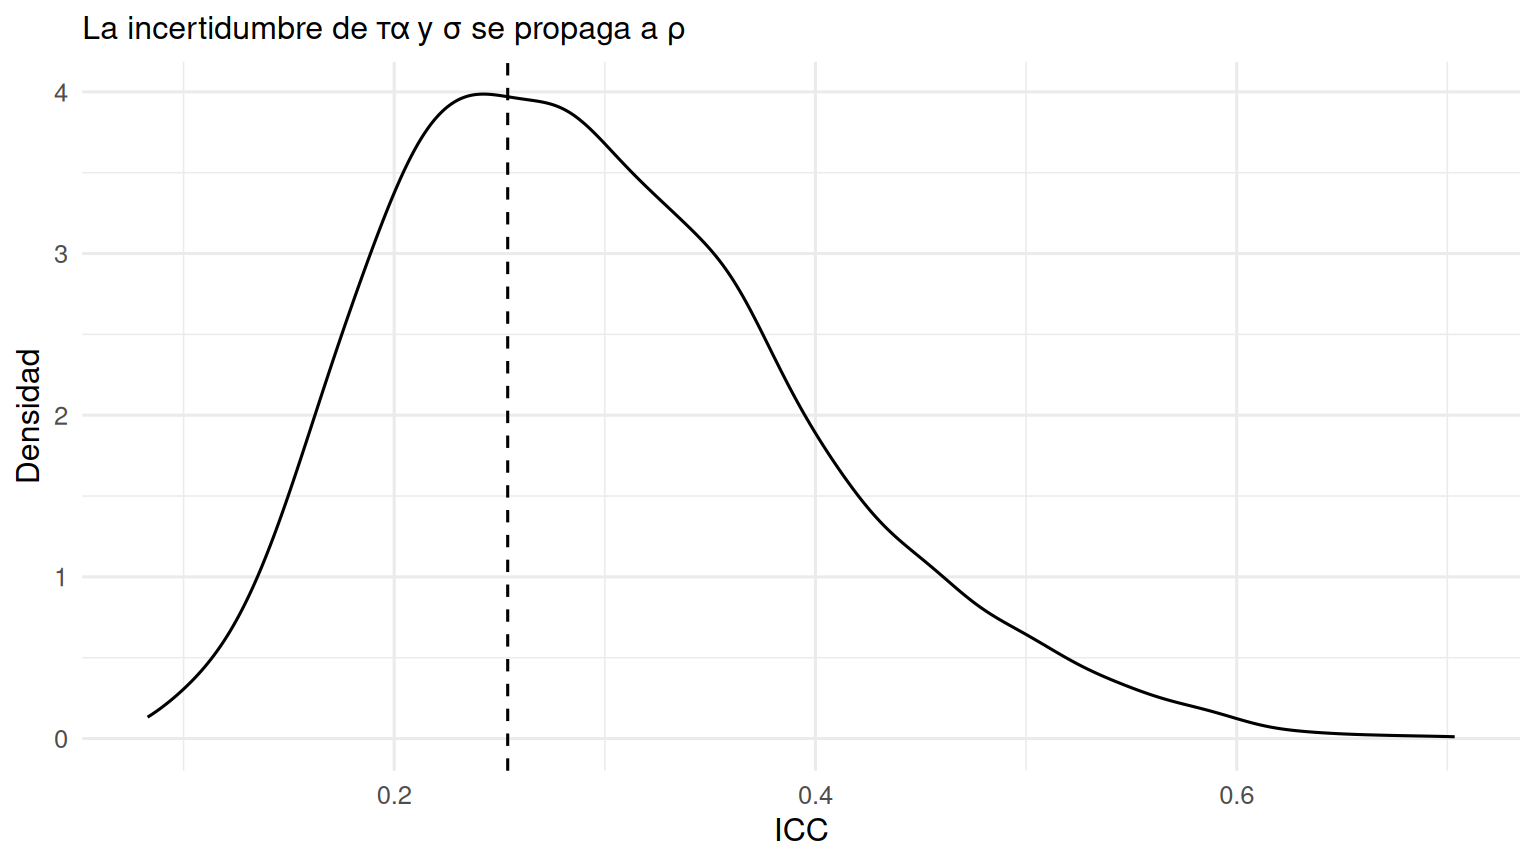
En un análisis bayesiano, \(\tau_\alpha\) y \(\sigma\) tienen distribuciones posteriores. El ICC es entonces una cantidad derivada:
Cada draw posterior produce un valor posible de \(\rho\). La colección
\[
\rho^{(1)},\ldots,\rho^{(S)}
\]
aproxima la distribución posterior del ICC.
Esta forma de proceder tiene una ventaja conceptual importante: la incertidumbre acerca de las componentes de varianza se propaga automáticamente a la incertidumbre acerca del ICC.
BDA enfatiza que sustituir componentes jerárquicos desconocidos por estimaciones puntuales ignora incertidumbre que puede ser considerable, especialmente cuando la población de grupos es pequeña (Gelman et al. 2013, 113-23).
2.7 ¿De dónde sale el shrinkage?
La palabra shrinkage describe la contracción de una estimación grupal hacia la distribución poblacional. En el modelo normal, el mecanismo puede verse de manera exacta cuando condicionamos en los hiperparámetros.
Supongamos provisionalmente que \(\mu_\alpha\), \(\tau_\alpha\) y \(\sigma\) son conocidos.
Tenemos entonces una verosimilitud normal para \(\bar y_j\) y una distribución normal para \(\alpha_j\). La distribución posterior condicional es normal:
BDA desarrolla esta estructura para el modelo normal jerárquico de medias intercambiables (Gelman et al. 2013, 113-19). Gelman y Hill presentan la estimación multinivel del coeficiente grupal como un promedio ponderado entre la estimación propia del grupo y el promedio poblacional (Gelman y Hill 2007, 258-59).
NotaQué es elaboración pedagógica
La notación \(w_j\) y la derivación paso a paso de Ecuación 2.2 y Ecuación 2.3 se presentan aquí como una elaboración pedagógica del modelo normal conjugado. En el ajuste bayesiano completo no fijamos \(\mu_\alpha\), \(\tau_\alpha\) y \(\sigma\); integramos su incertidumbre mediante draws posteriores.
2.7.1 ¿Qué controla la magnitud de la contracción?
El peso \(w_j\) es el peso de la media observada del grupo. Por tanto, \(1-w_j\) mide cuánta influencia tiene el centro de la distribución poblacional.
2.7.1.1 Tamaño del grupo
Cuando \(n_j\) crece,
\[
w_j\rightarrow1.
\]
La media del grupo se estima con más precisión y el grupo depende menos de la distribución poblacional.
Cuando \(n_j\) es pequeño, \(w_j\) disminuye y aumenta el pooling.
2.7.1.2 Variación residual
Si \(\sigma\) es grande, las observaciones dentro de un grupo son ruidosas y
\[
w_j
\downarrow.
\]
La media observada \(\bar y_j\) contiene menos información precisa acerca de \(\alpha_j\), de modo que la jerarquía tiene mayor influencia.
2.7.1.3 Heterogeneidad entre grupos
Si \(\tau_\alpha\) es grande,
\[
w_j
\uparrow.
\]
Una población muy heterogénea hace plausible que un grupo se encuentre lejos de \(\mu_\alpha\). La estimación se contrae menos.
Si \(\tau_\alpha\) es pequeña, la población de interceptos está concentrada y la contracción es mayor.
McElreath muestra gráficamente estos patrones: los grupos pequeños se contraen más y la regularización es especialmente útil en términos de error promedio cuando hay poca información por grupo (McElreath 2020, 405-13).
2.8 Relación entre ICC y shrinkage
El ICC y el shrinkage no son la misma cantidad, pero están algebraicamente relacionados.
Esta identidad muestra que, para el modelo nulo normal y condicionando en los hiperparámetros, el peso que recibe la información del grupo depende de dos cosas:
el tamaño del grupo \(n_j\);
la magnitud de la dependencia intraclase \(\rho\).
Algunas consecuencias:
si \(\rho\rightarrow0\), entonces \(w_j\rightarrow0\): los datos no apoyan diferencias persistentes entre grupos y el pooling es fuerte;
si \(\rho\rightarrow1\), entonces \(w_j\rightarrow1\): las diferencias entre grupos dominan la variación residual y hay poca contracción;
para un \(\rho\) fijo, \(w_j\) aumenta con \(n_j\).
ImportanteShrinkage no equivale a multiplicar por el ICC
El peso de la información grupal no es simplemente \(\rho\). Incluso con el mismo ICC, dos grupos con tamaños distintos pueden experimentar grados muy diferentes de contracción.
2.9 Shrinkage como regularización adaptativa
El shrinkage puede parecer extraño si se compara la mediana posterior de \(\alpha_j\) con la media observada \(\bar y_j\). ¿Por qué no reproducir exactamente la media de cada grupo?
Porque el objetivo no es memorizar la muestra. El modelo intenta aprender parámetros latentes y realizar predicciones.
Los grupos con poca información producen estimaciones no agrupadas de alta varianza. El modelo jerárquico utiliza la población de grupos para estabilizarlas. McElreath describe esta propiedad como regularización adaptativa: la fuerza de la regularización se aprende conjuntamente con el modelo y no tiene que ser igual para todos los grupos (McElreath 2020, 408-13).
Esto produce una distinción importante:
un modelo sin pooling puede ajustarse más estrechamente a medias grupales observadas;
un modelo con pooling parcial puede sacrificar parte de ese ajuste dentro de la muestra para reducir error de estimación y mejorar generalización.
El shrinkage no garantiza que cada estimación grupal esté más cerca del verdadero \(\alpha_j\) en cada conjunto de datos. Su beneficio es probabilístico y promedio, no una promesa determinista grupo por grupo (McElreath 2020, 412-13).
2.10 El modelo bayesiano completo
Hasta ahora condicionamos varias derivaciones en hiperparámetros conocidos. En un análisis real, debemos aprenderlos.
A diferencia de la derivación conjugada condicional, aquí \(\tau_\alpha\) y \(\sigma\) no se sustituyen por valores puntuales. Sus incertidumbres se propagan a los \(\alpha_j\), al ICC, al grado de shrinkage y a las predicciones.
2.10.1 Sobre las previas para componentes de escala
Las desviaciones estándar son positivas y, con pocos grupos, pueden estar débilmente identificadas por los datos. McElreath advierte que estimar componentes de variación con pocos grupos puede requerir regularización más informativa (McElreath 2020, 406-7). Gelman y Hill también señalan que con pocos grupos la principal dificultad se encuentra en aprender la variación entre grupos (Gelman y Hill 2007, 275-76).
La semana 6 estudiará este problema con detalle. Por ahora conservamos tres principios:
expresar la previa en una escala sustantivamente interpretable;
evitar previas absurdamente amplias por defecto;
examinar qué datos puede generar el modelo antes de condicionarlo en las observaciones.
2.11 Laboratorio reproducible en R
El laboratorio tiene tres objetivos:
visualizar la descomposición dentro/entre grupos;
estimar la distribución posterior del ICC;
conectar el tamaño grupal con la magnitud posterior del shrinkage.
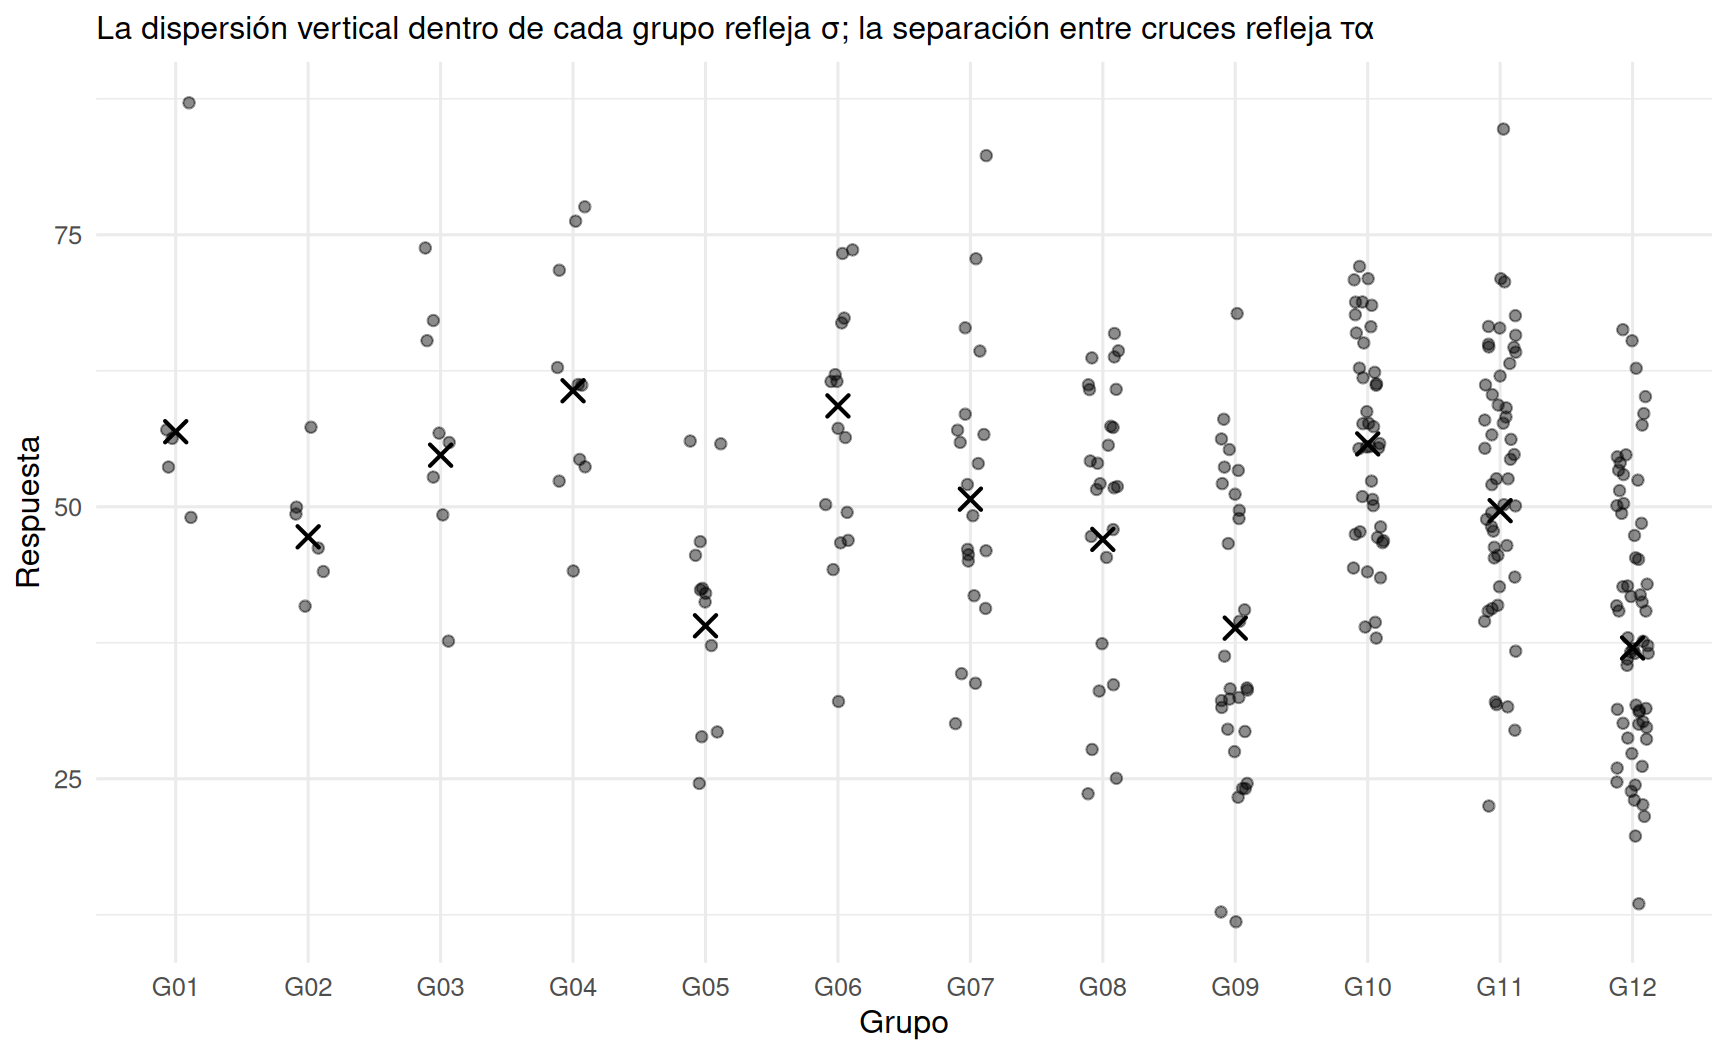
ggplot( datos,aes(x = grupo, y = y)) +geom_jitter(width =0.12,height =0,alpha =0.45 ) +geom_point(data = parametros_grupo,aes(y = alpha_real),shape =4,size =3,stroke =1.1 ) +labs(x ="Grupo",y ="Respuesta",subtitle ="La dispersión vertical dentro de cada grupo refleja σ; la separación entre cruces refleja τα" ) +theme_minimal(base_size =12)
Figura 2.1: Datos simulados por grupo. Las cruces indican los interceptos verdaderos del proceso generador y los puntos muestran la variación residual dentro de cada grupo.
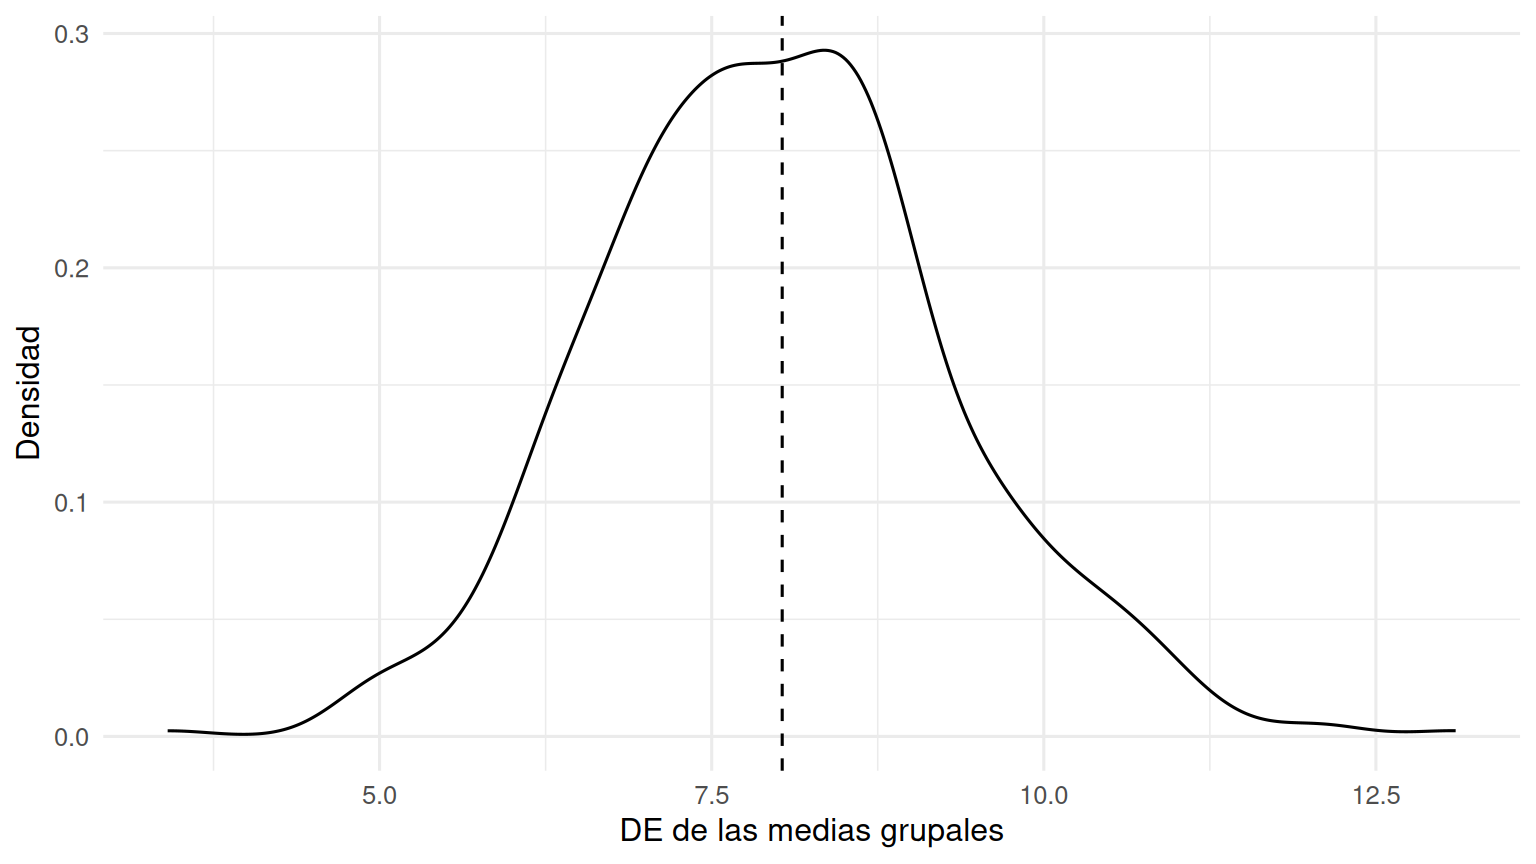
La figura permite distinguir dos escalas de variación. No debemos usar el rango de las medias observadas como estimación directa de \(\tau_\alpha\): las medias contienen error muestral, especialmente en grupos pequeños.
2.11.3 Comprobación predictiva previa
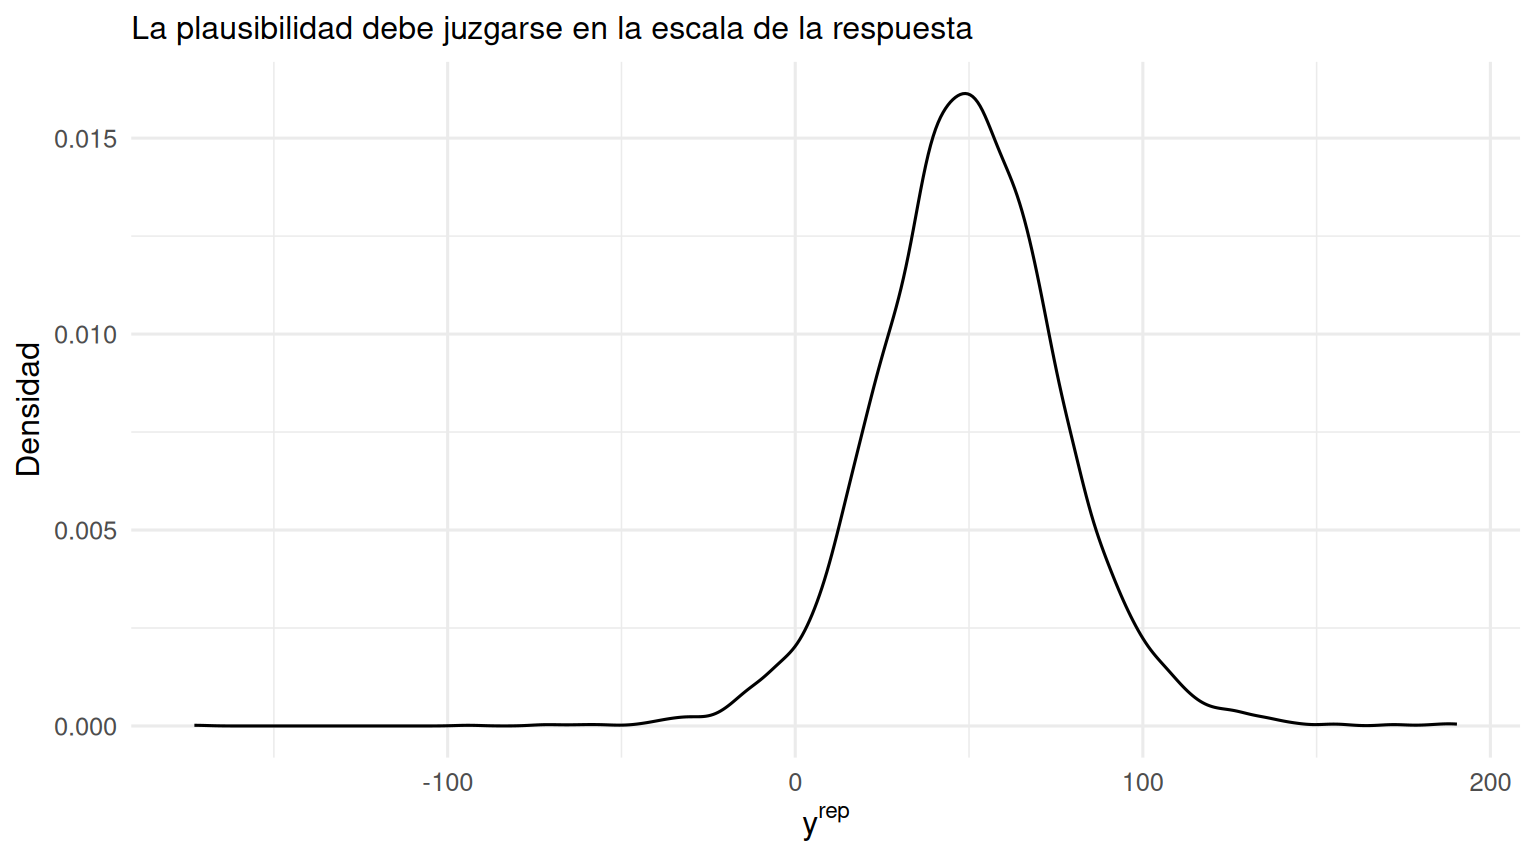
Antes de ajustar el modelo, simulamos de las previas propuestas. Hacemos la simulación manualmente para mostrar la jerarquía completa.
ggplot( prior_pred,aes(x = y_rep)) +geom_density() +labs(x =expression(y^rep),y ="Densidad",subtitle ="La plausibilidad debe juzgarse en la escala de la respuesta" ) +theme_minimal(base_size =12)
Figura 2.2: Distribución predictiva previa para una observación de un grupo genérico bajo las previas pedagógicas del ejemplo.
Esta comprobación no pretende agotar la especificación de previas. Su función es impedir que una previa aparentemente “débil” en la escala de parámetros implique observaciones absurdas en la escala de datos.
2.11.4 Ajustar el modelo nulo de interceptos variables
prior_null <-c(prior(normal(50, 20), class ="Intercept"),prior(normal(0, 10), class ="sd", group ="grupo"),prior(exponential(0.1), class ="sigma"))fit_null <-brm( y ~1+ (1| grupo),data = datos,family =gaussian(),prior = prior_null,chains =4,iter =2000,warmup =1000,seed =1653,backend ="cmdstanr",control =list(adapt_delta =0.95),file ="_fits/semana02_nulo",file_refit ="on_change",refresh =0)
En la parametrización interna de brms, el intercepto de nivel poblacional y la desviación grupal se representan por separado. La distribución normal jerárquica de los coeficientes grupales es parte de la estructura del modelo (Bürkner 2017, 2-4).
2.11.5 Diagnóstico MCMC mínimo
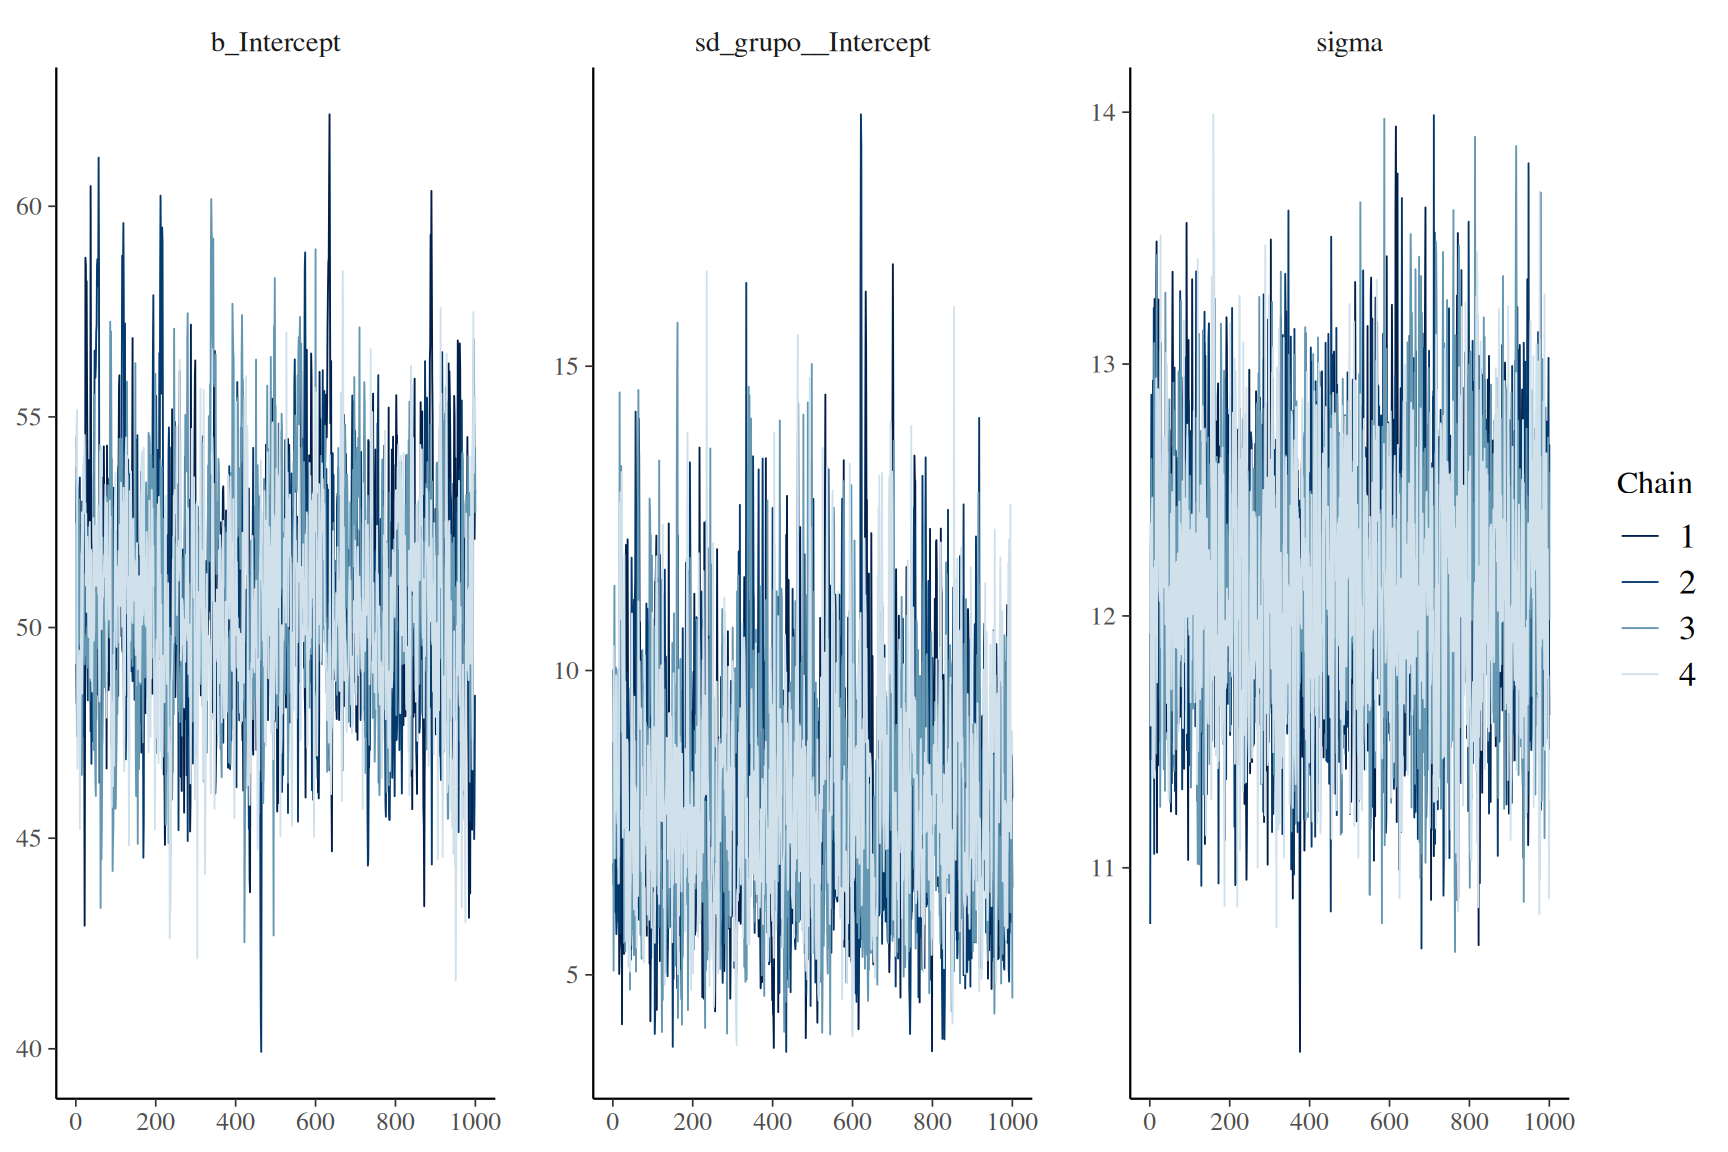
Antes de interpretar el modelo, examinamos algunos parámetros principales.
Figura 2.3: Trazas MCMC para el intercepto poblacional y las dos componentes de escala del modelo nulo.
En esta semana el diagnóstico es deliberadamente básico. La semana 7 desarrollará \(\widehat R\), ESS, divergencias, profundidad del árbol y parametrizaciones centradas/no centradas.
Por ahora exigimos como mínimo:
\(\widehat R\) muy cercano a 1;
tamaños efectivos razonables;
cadenas que exploran regiones semejantes;
ausencia de divergencias post-warmup.
AdvertenciaConvergencia no implica adecuación
Un algoritmo puede muestrear correctamente de una distribución posterior correspondiente a un modelo sustantivamente inadecuado. Los diagnósticos computacionales y las comprobaciones del modelo responden preguntas diferentes.
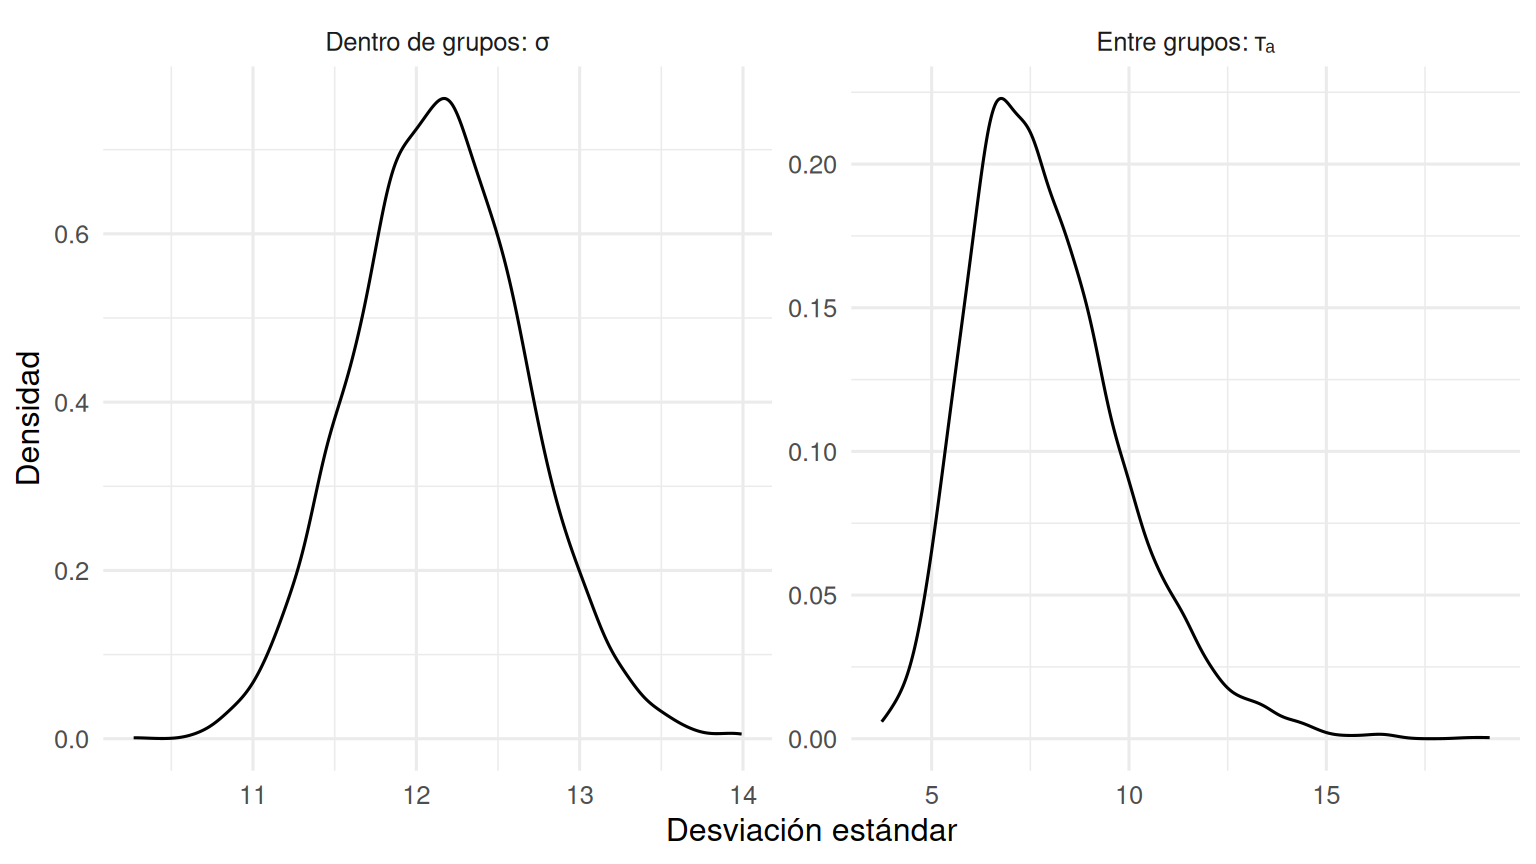
2.11.6 Distribución posterior de las componentes de variación
Figura 2.4: Distribuciones posteriores de la desviación estándar entre grupos y de la desviación estándar residual.
No debemos comparar únicamente las medianas de \(\tau_\alpha\) y \(\sigma\). La incertidumbre posterior de \(\tau_\alpha\) suele ser mayor porque su información efectiva proviene principalmente del número de grupos \(J\), no del número total de filas.
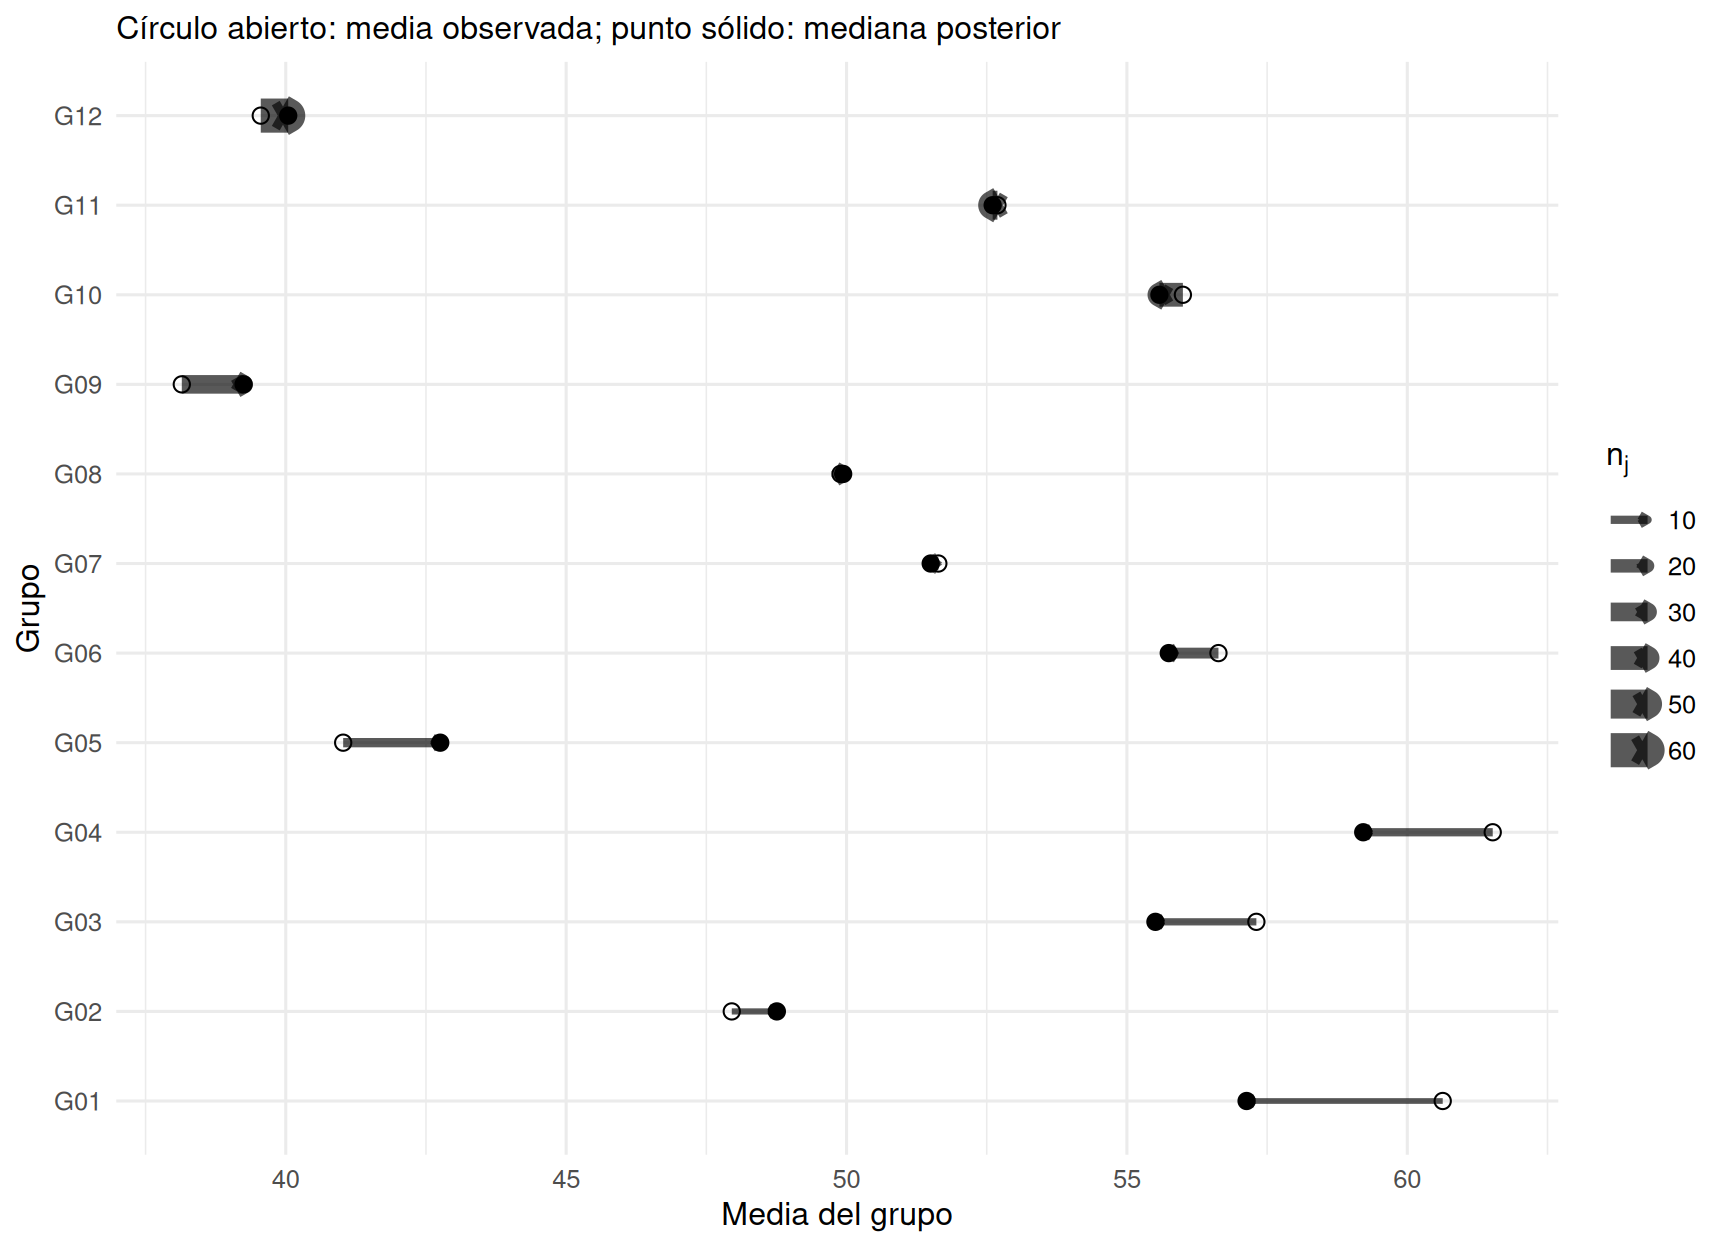
resumen_alpha |>arrange(n) |>mutate(grupo =factor( grupo,levels = grupo ) ) |>ggplot() +geom_segment(aes(x = media_observada,xend = alpha_post,y = grupo,yend = grupo,linewidth = n ),arrow = grid::arrow(length = grid::unit(0.12, "cm") ),alpha =0.65 ) +geom_point(aes(x = media_observada,y = grupo ),shape =1,size =2.5 ) +geom_point(aes(x = alpha_post,y = grupo ),size =2.5 ) +scale_linewidth_continuous(name =expression(n[j]) ) +labs(x ="Media del grupo",y ="Grupo",subtitle ="Círculo abierto: media observada; punto sólido: mediana posterior" ) +theme_minimal(base_size =12)
Figura 2.6: Shrinkage por grupo. Cada flecha parte de la media observada y termina en la mediana posterior de la media grupal. Los grupos se ordenan por tamaño.
No esperamos que la longitud de una flecha dependa únicamente de \(n_j\). También depende de cuán lejos está \(\bar y_j\) del centro poblacional y de los valores plausibles de \(\tau_\alpha\) y \(\sigma\).
2.11.10 Distribución posterior del peso de shrinkage
En vez de sustituir \(\tau_\alpha\) y \(\sigma\) por estimaciones puntuales, podemos calcular un \(w_j\) para cada draw posterior:
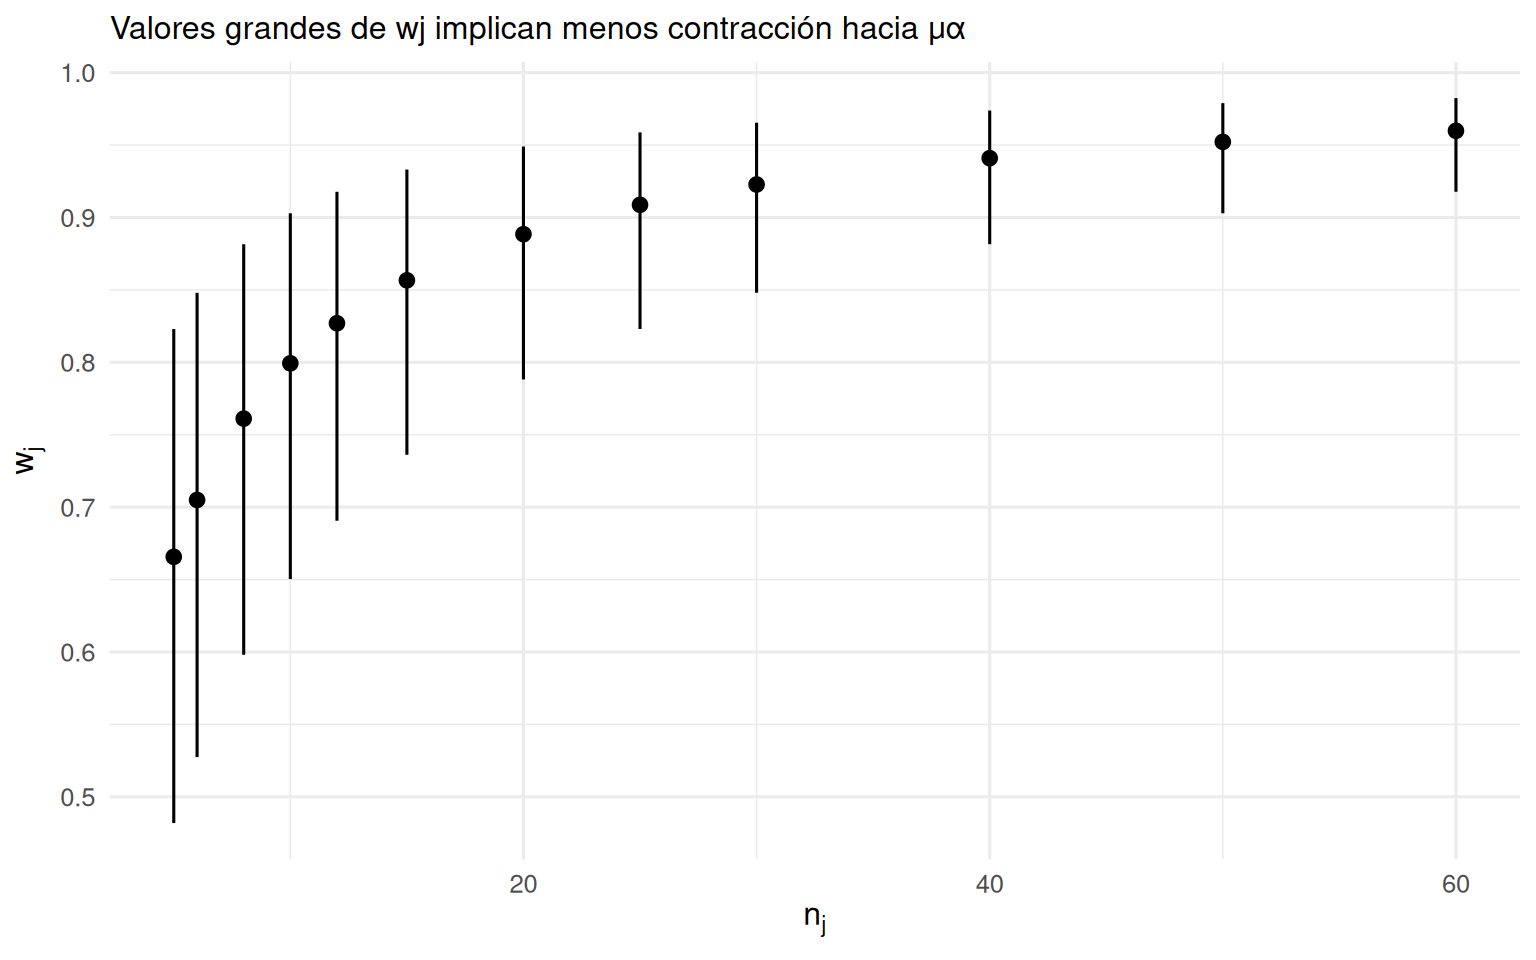
ggplot( resumen_pesos,aes(x = n, y = w_mediana)) +geom_linerange(aes(ymin = w_q05,ymax = w_q95 ) ) +geom_point(size =2.2) +labs(x =expression(n[j]),y =expression(w[j]),subtitle ="Valores grandes de wj implican menos contracción hacia μα" ) +theme_minimal(base_size =12)
Figura 2.7: Peso posterior de la información propia del grupo, wj, según el tamaño del grupo. Los intervalos reflejan incertidumbre posterior en τα y σ.
La figura hace visible una idea central: el shrinkage también tiene incertidumbre. Con pocos grupos, la posterior de \(\tau_\alpha\) puede ser amplia y, por tanto, la cantidad de pooling compatible con los datos también puede ser incierta.
2.12 Comprobación predictiva posterior
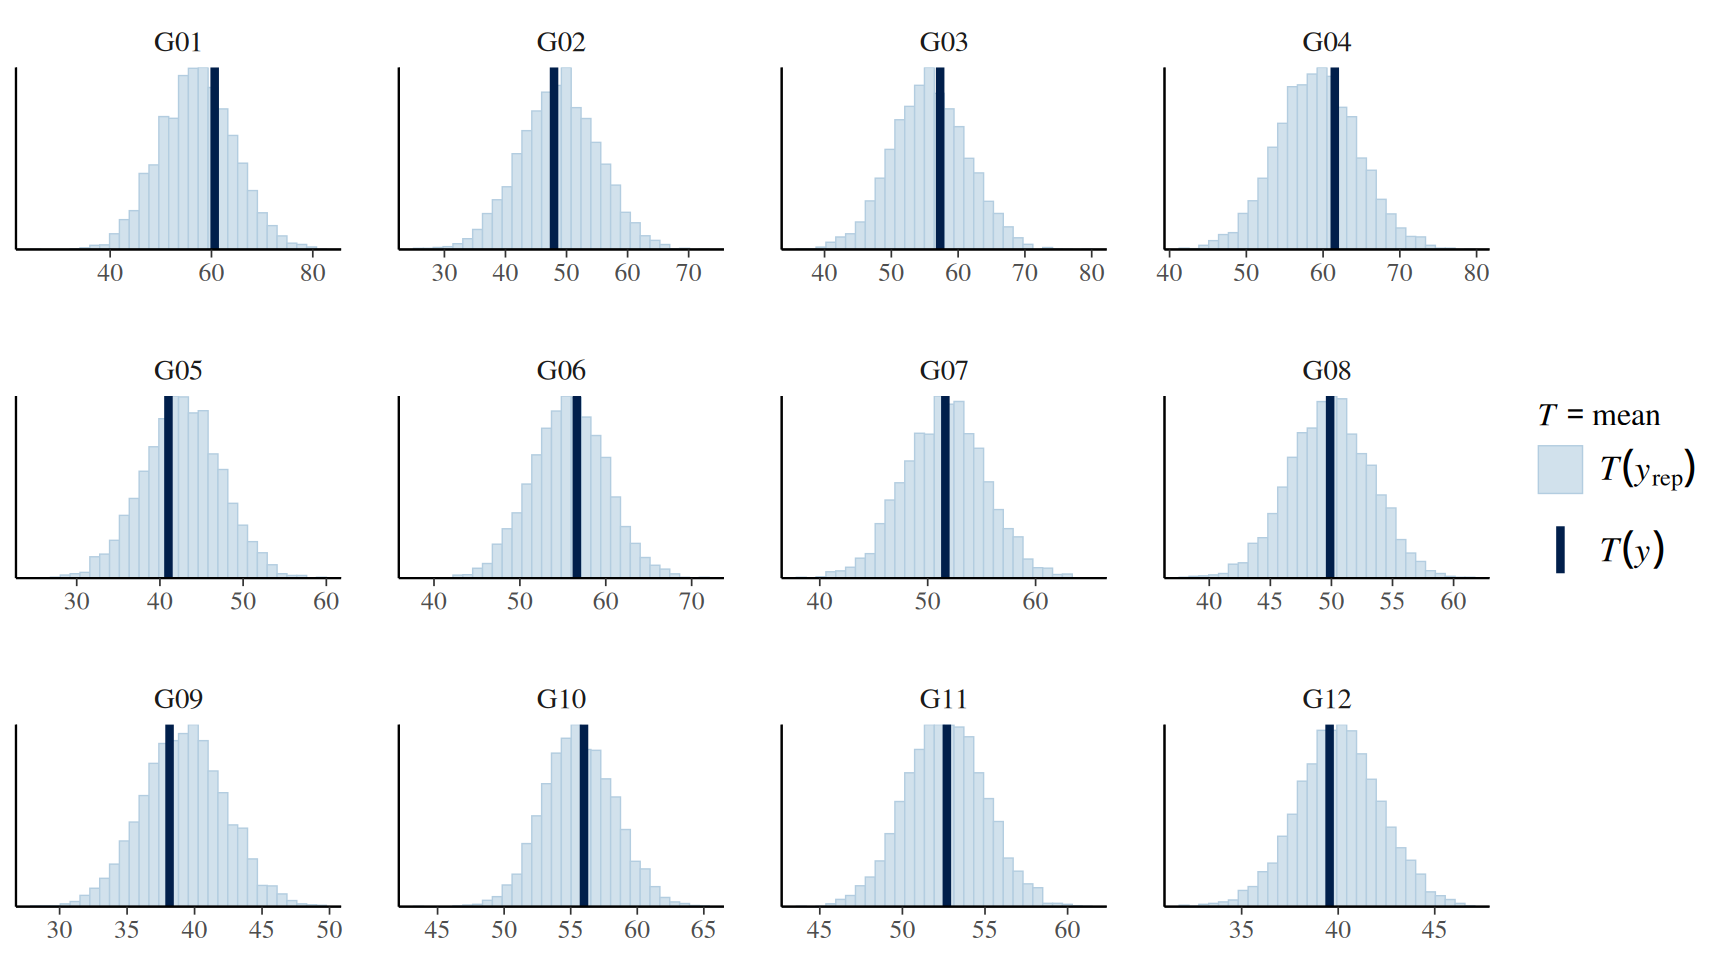
El modelo no debe evaluarse únicamente mediante sus parámetros. Simulamos nuevos conjuntos de datos desde la distribución predictiva posterior y preguntamos si reproducen características relevantes de lo observado.
es que podemos predecir para grupos que no participaron en el ajuste.
Gelman y Hill distinguen entre nuevas observaciones de un grupo existente y observaciones de grupos nuevos (Gelman y Hill 2007, 272-75). McElreath desarrolla la misma distinción al mostrar que la predicción multinivel requiere decidir si condicionamos en los coeficientes de los grupos observados o generamos un nuevo coeficiente desde la población de grupos (McElreath 2020, 426-31).
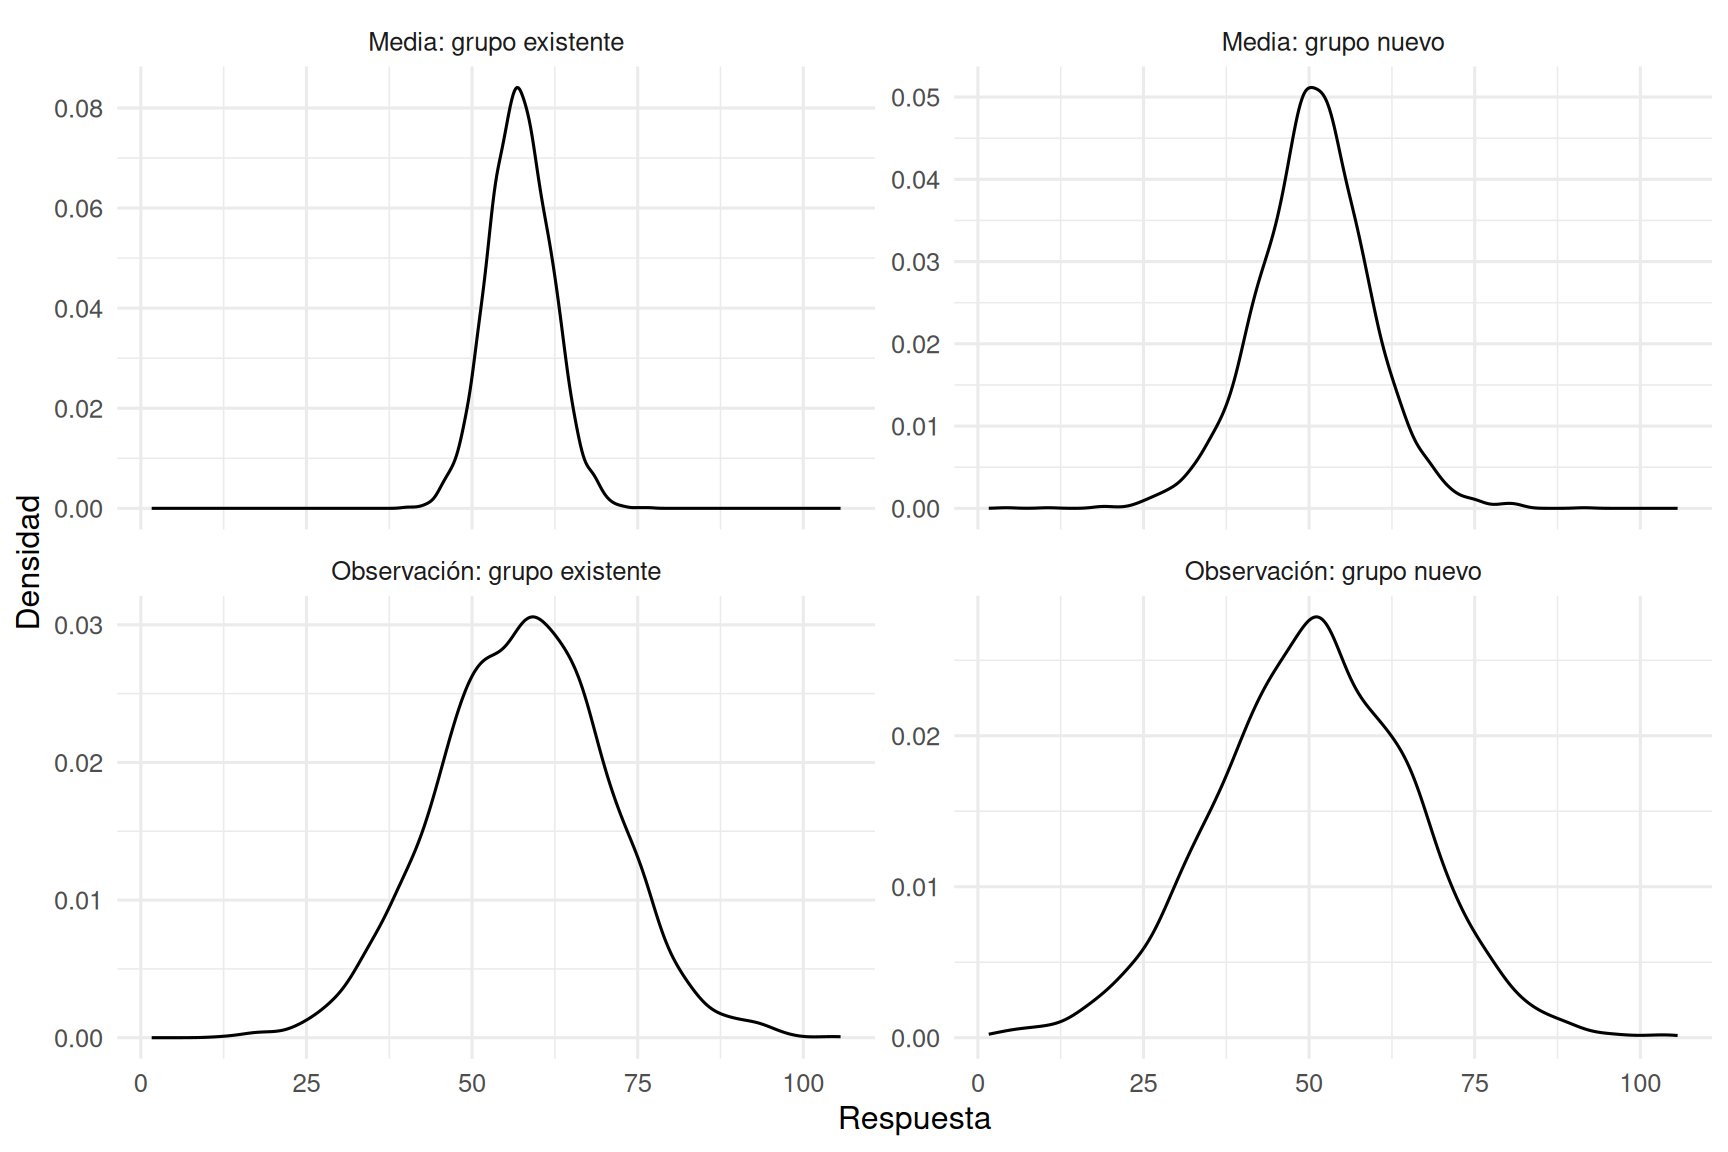
Conviene separar cuatro cantidades.
2.13.1 1. Media esperada de un grupo existente
Para un grupo observado \(j\),
\[
E(\tilde Y\mid\alpha_j)=\alpha_j.
\]
Usamos la posterior de su \(\alpha_j\).
2.13.2 2. Nueva observación de un grupo existente
Además de la incertidumbre en \(\alpha_j\), aparece variación residual:
Figura 2.11: Cuatro distribuciones predictivas distintas: media u observación, para un grupo existente o para un grupo nuevo.
ImportanteLa unidad predictiva debe declararse
“Predecir un dato nuevo” es ambiguo en un modelo multinivel. Siempre debemos especificar si el nuevo dato pertenece a un grupo ya observado o a un grupo que también debe ser generado desde la población de grupos.
2.14 Introducir un predictor sin cambiar todavía la lógica
La pendiente \(\beta\) es común a todos los grupos y el intercepto sigue variando.
Ahora:
\(\sigma\) describe variación residual después de condicionar en\(x\);
\(\tau_\alpha\) describe heterogeneidad residual entre interceptos después de condicionar en\(x\);
el ICC calculado con estas componentes es condicional a la estructura del modelo.
No desarrollaremos todavía el significado de centrar \(x\), separar asociaciones dentro/entre grupos ni incorporar predictores grupales. Esos son los temas de la semana 3.
2.15 Aplicación: heterogeneidad entre personas en sleepstudy
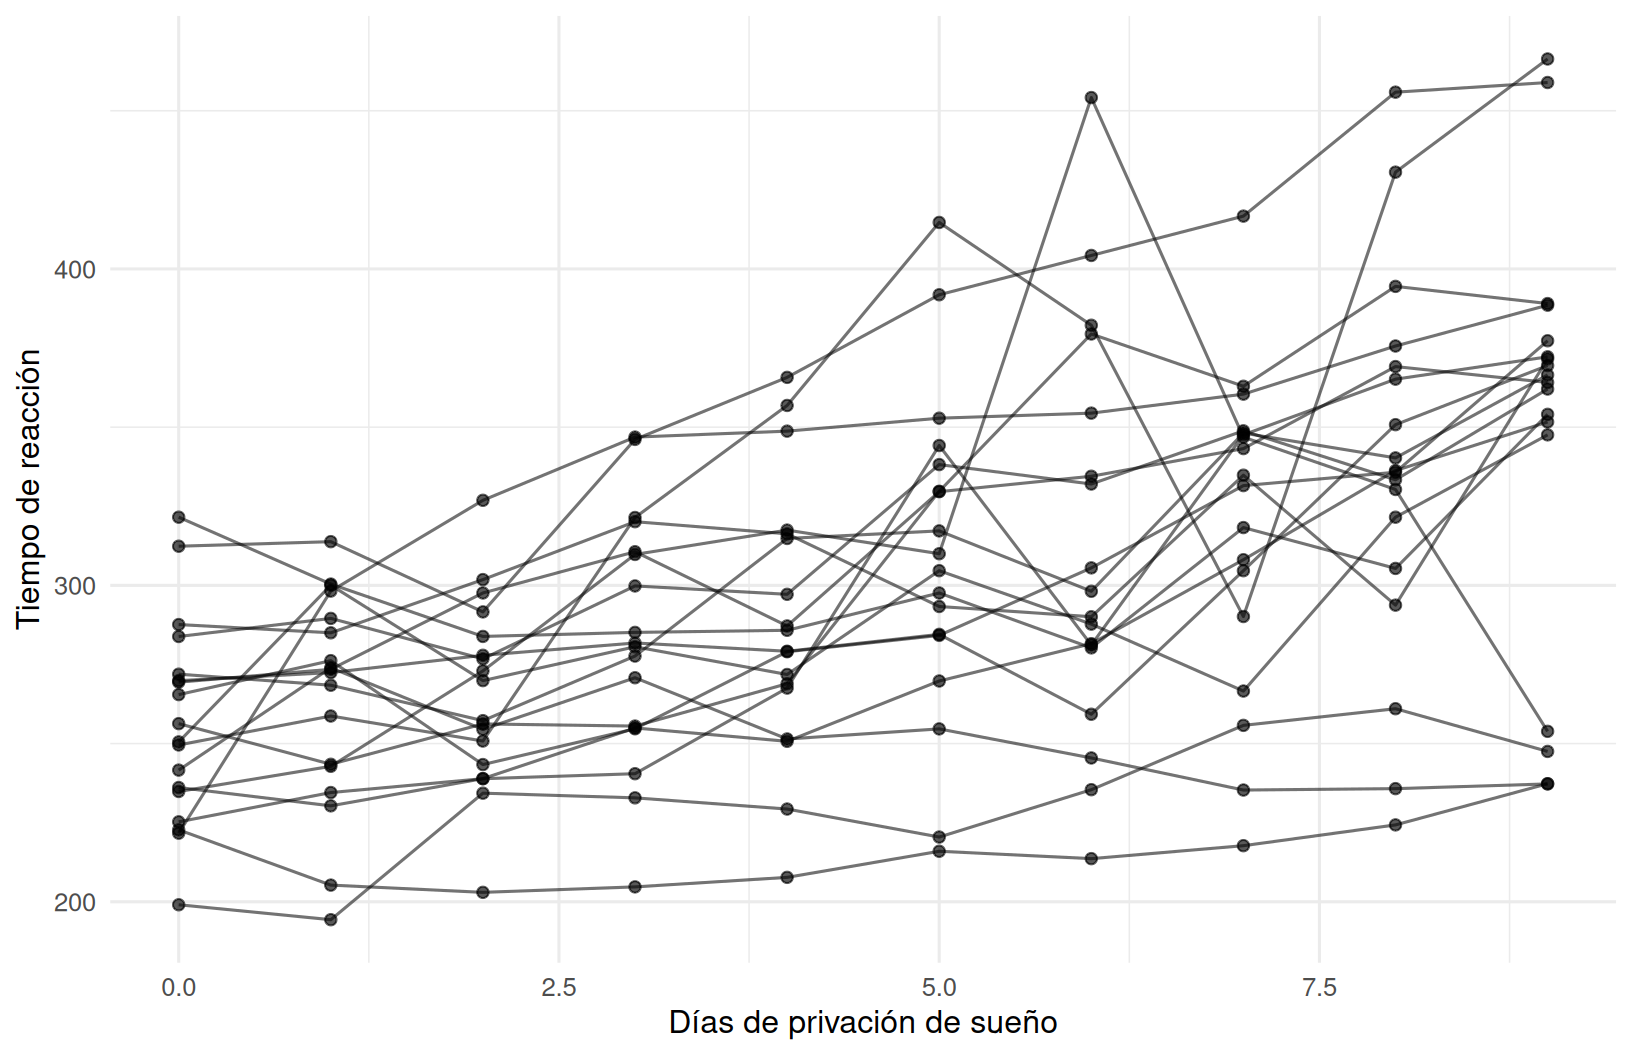
Como aplicación corta usaremos sleepstudy, el conjunto de datos empleado también en el estudio de caso de Bayesian Workflow. La respuesta Reaction mide tiempo de reacción y Days representa días de privación de sueño. Hay observaciones repetidas dentro de sujetos.
Esta aplicación se utiliza aquí solo para estudiar interceptos variables. No pretende ser todavía un análisis longitudinal completo. En particular, permitiremos un intercepto por sujeto pero mantendremos una pendiente común para Days; las pendientes variables y la dependencia residual se tratarán más adelante.
ggplot( sleep,aes(x = Days,y = Reaction,group = Subject )) +geom_line(alpha =0.55) +geom_point(alpha =0.65) +labs(x ="Días de privación de sueño",y ="Tiempo de reacción" ) +theme_minimal(base_size =12)
Figura 2.12: Trayectorias observadas de tiempo de reacción por sujeto. En esta semana modelaremos diferencias de intercepto, manteniendo una pendiente poblacional común.
Siguiendo la especificación pedagógica de Bayesian Workflow para este modelo, usamos previas explícitas para el intercepto, la pendiente, la desviación estándar entre personas y la desviación estándar residual (Gelman et al. 2026, 280-82):
La pendiente Days describe el cambio medio esperado por día bajo el supuesto de que todos los sujetos comparten la misma pendiente. La heterogeneidad entre sujetos en su nivel basal queda representada por sd_Subject__Intercept.
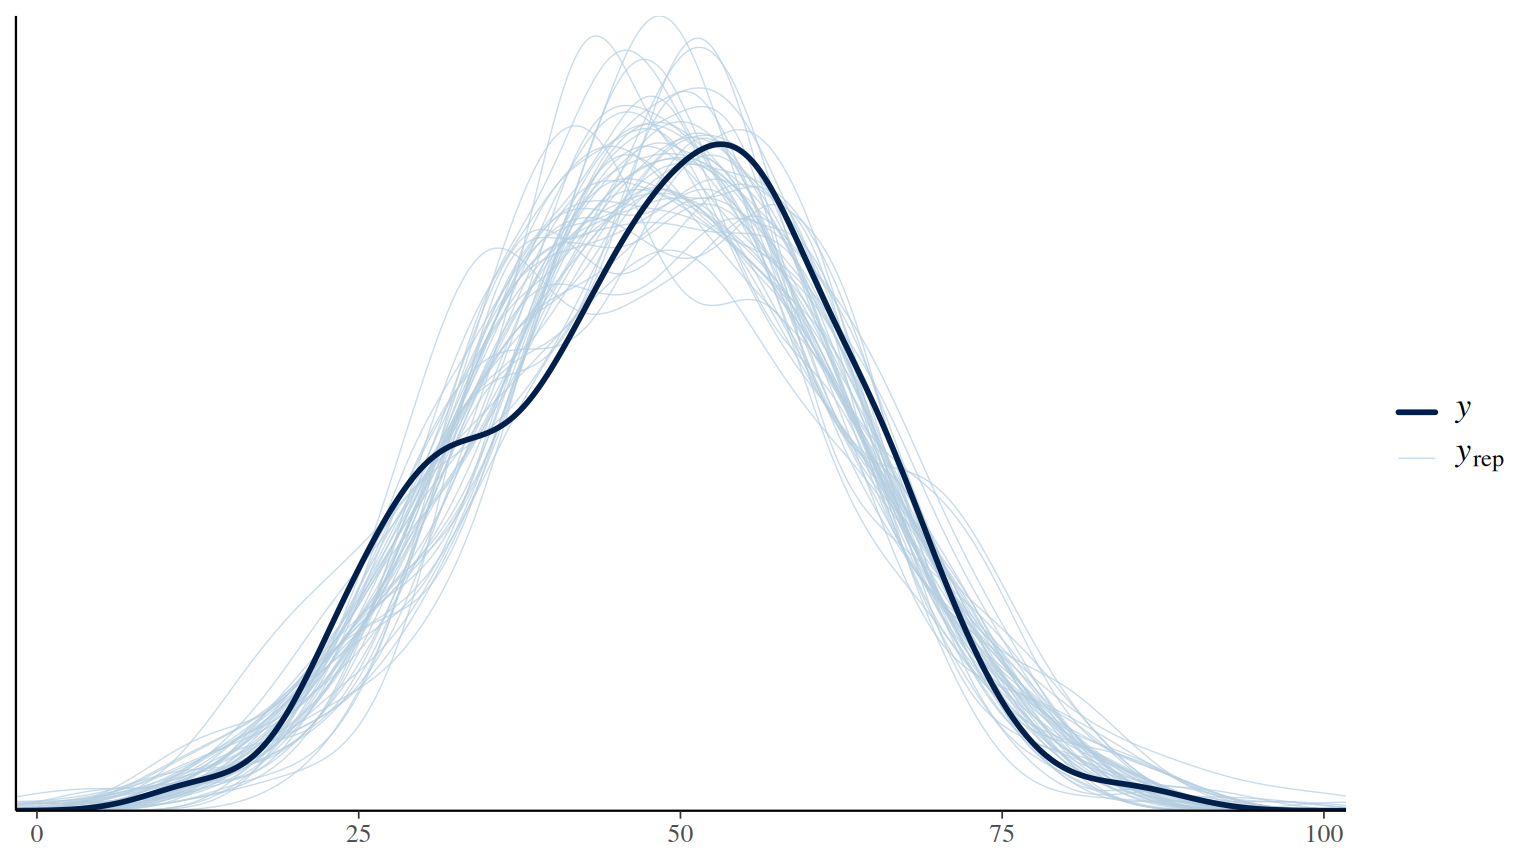
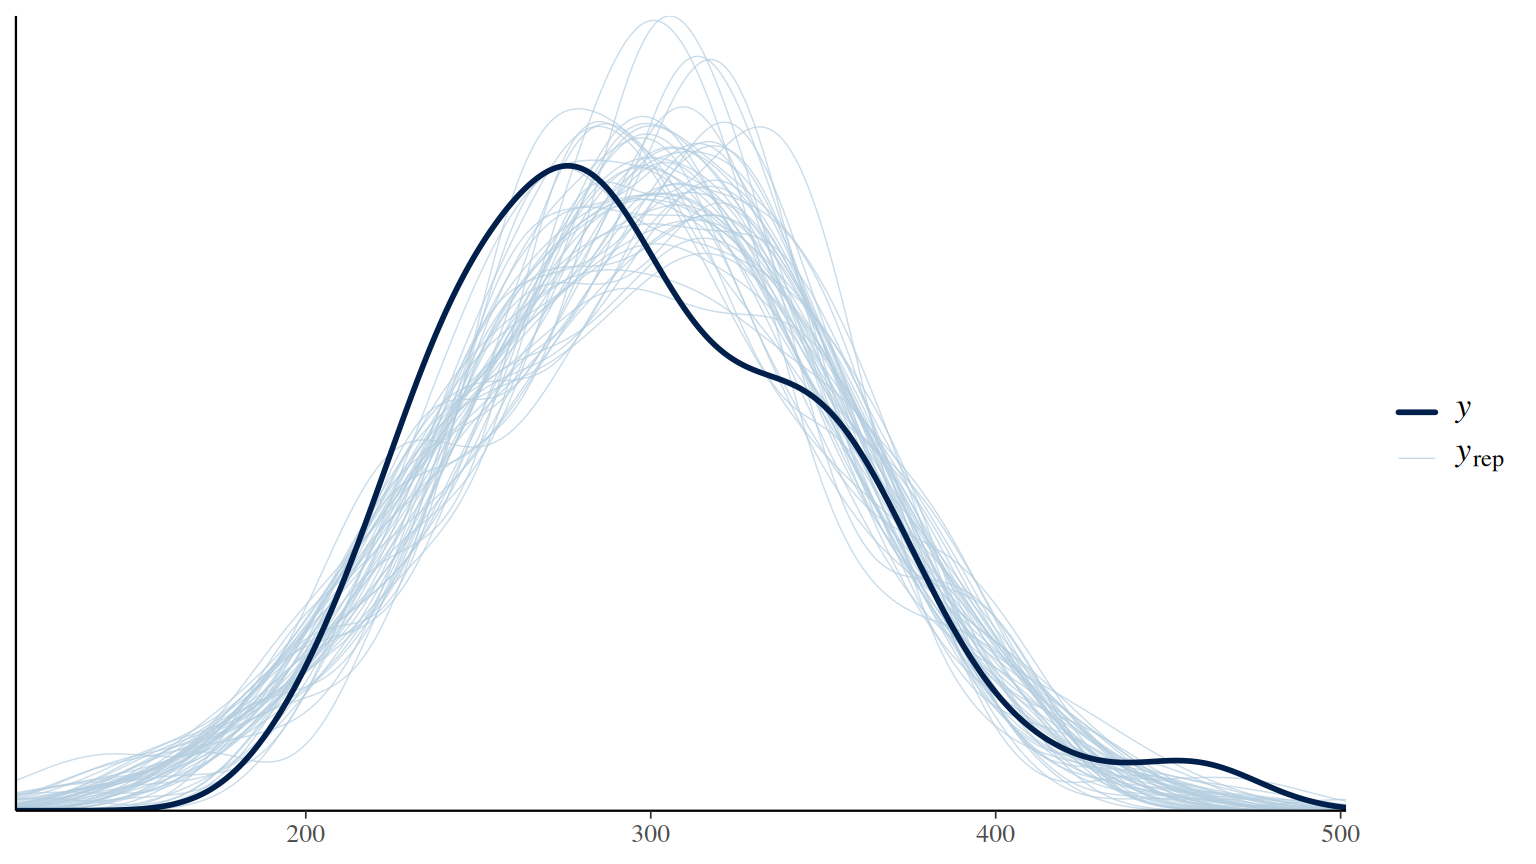
Figura 2.13: Comprobación predictiva posterior global del modelo de interceptos variables para sleepstudy.
Este PPC global no debe cerrar el análisis. La figura de trayectorias sugiere que la asociación con Days también podría variar entre sujetos. Esa observación motiva naturalmente la semana de pendientes variables.
AdvertenciaNo adelantemos la conclusión longitudinal
El modelo Reaction ~ Days + (1 | Subject) es útil para estudiar heterogeneidad de interceptos, pero no demuestra que una pendiente común ni errores condicionalmente independientes sean suficientes. Más adelante ampliaremos la estructura.
2.16 Perspectiva frecuentista y terminología
En la literatura frecuentista, el modelo
\[
Y_{ij}
=
\mu_\alpha+u_j+\varepsilon_{ij}
\]
se denomina con frecuencia modelo de intercepto aleatorio. Los \(u_j\) pueden predecirse mediante BLUP/EBLUP y esas predicciones también muestran contracción hacia cero, equivalente a contraer los interceptos hacia \(\mu_\alpha\).
La diferencia principal para nuestros propósitos no es que el shrinkage sea exclusivamente bayesiano. También surge en el modelo mixto frecuentista. La ventaja pedagógica del enfoque bayesiano aquí es que podemos tratar de forma unificada:
incertidumbre de \(\tau_\alpha\) y \(\sigma\);
incertidumbre de cada \(\alpha_j\);
posterior del ICC;
posterior de la cantidad de pooling;
predicción para nuevos grupos.
El curso seguirá usando la terminología frecuentista cuando facilite la lectura de la literatura, pero organizará la inferencia alrededor del modelo generativo y las distribuciones predictivas.
2.17 ¿Cuántos grupos necesitamos?
No existe un número mágico de grupos a partir del cual un modelo multinivel “se vuelve válido”.
Gelman y Hill señalan que incluso grupos con muy pocas observaciones pueden contribuir información al modelo; la dificultad principal cuando \(J\) es pequeño es aprender la variación entre grupos con precisión (Gelman y Hill 2007, 275-76).
Esto conduce a una regla conceptual importante:
el número total de observaciones y el número de grupos informan componentes diferentes del modelo.
Cientos de observaciones dentro de tres grupos pueden estimar con precisión ciertos aspectos de la variación dentro de grupos, pero siguen proporcionando muy poca información directa para caracterizar una población de interceptos.
Con pocos grupos debemos prestar atención especial a:
la prior de \(\tau_\alpha\);
la incertidumbre posterior de \(\tau_\alpha\);
la sensibilidad del ICC;
el propósito de inferir o predecir para grupos nuevos;
la posibilidad de que el modelo sea más ambicioso que la información disponible.
No interpretaremos “pocos grupos” como una prohibición automática. Lo trataremos como un problema de información e identificación.
2.18 Errores frecuentes de interpretación
“El ICC es el porcentaje de observaciones que son iguales dentro de un grupo.”
No. En el modelo nulo gaussiano es una razón de componentes de varianza y también la correlación marginal esperada de dos observaciones distintas del mismo grupo.
“Si el ICC es pequeño, puedo ignorar el agrupamiento.”
No necesariamente. La relevancia depende del estimando, el diseño, los tamaños grupales y la estructura completa del modelo.
“Shrinkage significa sesgar artificialmente todas las medias hacia la media global.”
El shrinkage es consecuencia del modelo jerárquico y combina dos fuentes de información. En escenarios compatibles con la estructura poblacional, funciona como regularización.
“Los grupos pequeños siempre se contraen la misma distancia.”
No. El tamaño afecta el peso \(w_j\), pero la distancia observada a \(\mu_\alpha\), la variación residual, la heterogeneidad entre grupos y la incertidumbre posterior también importan.
“Si dos grupos tienen el mismo\(n_j\), tienen exactamente el mismo shrinkage.”
Condicionalmente en hiperparámetros conocidos tienen el mismo peso\(w_j\), pero no necesariamente la misma distancia de contracción, porque sus medias observadas pueden estar a distancias diferentes de \(\mu_\alpha\).
“La media posterior de un grupo debe coincidir con su media observada si el modelo ajusta bien.”
No. Un modelo jerárquico bien ajustado puede contraer sistemáticamente estimaciones grupales. La reproducción exacta de medias observadas no es el objetivo.
“El ICC es una propiedad fija del conjunto de datos.”
No. Cambia con la familia, los predictores y la estructura del modelo. Debe interpretarse en relación con la especificación utilizada.
“Tener 1000 observaciones compensa tener solamente tres grupos.”
No para todos los parámetros. \(\tau_\alpha\) depende de la variación observada entre grupos, y la información relevante para esa distribución poblacional está limitada por \(J\).
“\(\widehat R=1\) valida la existencia de heterogeneidad entre grupos.”
No. \(\widehat R\) diagnostica el muestreo, no el supuesto sustantivo de una distribución poblacional de interceptos.
grupos grandes dependen más de su propia información;
grupos pequeños reciben mayor regularización;
mayor ruido residual aumenta el pooling;
mayor heterogeneidad real entre grupos disminuye el pooling;
el ICC y el shrinkage están relacionados, pero no son equivalentes;
la incertidumbre sobre las componentes de varianza debe propagarse;
predecir un grupo nuevo exige generar un nuevo parámetro grupal desde la distribución poblacional.
La próxima semana incorporará predictores individuales y grupales y mostrará por qué una asociación observada entre todos los datos puede mezclar comparaciones dentro y entre grupos.
Repita el experimento con una segunda semilla y explique por qué no debe esperarse que el intervalo cubra siempre el valor verdadero en cada simulación particular.
Construya dos diseños con aproximadamente el mismo número total de observaciones:
Diseño A: pocos grupos grandes;
Diseño B: muchos grupos pequeños.
Mantenga el mismo proceso generador.
Ajuste el mismo modelo a ambos diseños.
Compare la incertidumbre posterior de \(\sigma\).
Compare la incertidumbre posterior de \(\tau_\alpha\).
Compare la incertidumbre posterior del ICC.
Explique por qué el número total de filas no resume por sí solo la información jerárquica.
2.20.2.3 Ejercicio 7. Predicción para un grupo nuevo
Usando fit_null:
obtenga draws de la media esperada de G01;
obtenga draws de una nueva observación de G01;
obtenga draws de la media de G_nuevo;
obtenga draws de una observación de G_nuevo;
compare las cuatro desviaciones estándar posteriores;
explique de dónde proviene cada componente adicional de incertidumbre.
2.20.3 Ejercicio de interpretación de salida
Un modelo produce el siguiente resumen hipotético:
Cantidad
Mediana posterior
Intervalo 90%
\(\mu_\alpha\)
72
[68, 76]
\(\tau_\alpha\)
9
[4, 16]
\(\sigma\)
18
[16, 20]
ICC
0.20
[0.05, 0.45]
Responda:
¿qué describe \(\tau_\alpha=9\) que no describe \(\sigma=18\)?
¿por qué el intervalo del ICC puede ser relativamente ancho?
¿sería correcto afirmar que “exactamente 20% de la variación pertenece a los grupos”?
¿qué esperaría sobre el shrinkage de un grupo con \(n_j=4\) comparado con uno de \(n_j=60\)?
¿qué información adicional necesitaría para juzgar si la distribución normal de interceptos es adecuada?
2.21 Lecturas para profundizar
Para esta semana se recomienda priorizar:
Gelman y Hill, cap. 12, especialmente §§12.2–12.5 y §§12.8–12.9: pooling parcial, componentes de variación, predicción y tamaños de grupo (Gelman y Hill 2007, 251-76).
Gelman et al., BDA3, §§5.3–5.5: análisis bayesiano completo de modelos jerárquicos normales y propagación de incertidumbre (Gelman et al. 2013, 108-23).
Como complemento:
Hox, Moerbeek y van de Schoot, cap. 2: modelo vacío, componentes de varianza e ICC (Hox et al. 2018, 8-19).
Gelman et al., Bayesian Workflow, §17.2: previas y especificación en brms de modelos lineales multinivel (Gelman et al. 2026, 280-83).
Bürkner: estructura general de parámetros poblacionales y grupales en brms(Bürkner 2017, 2-5).
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, John B. Carlin, Hal S. Stern, David B. Dunson, Aki Vehtari, y Donald B. Rubin. 2013. Bayesian Data Analysis. 3.ª ed. Chapman & Hall/CRC.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. 2.ª ed. Chapman & Hall/CRC.