5Semana 5. Modelos anidados, cruzados y ANOVA jerárquico
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
7 de septiembre de 2026
5.1 Panorama de la semana
En las primeras cuatro semanas hemos construido modelos multinivel alrededor de una idea recurrente: la dependencia entre observaciones surge porque algunas unidades comparten componentes del proceso generador. Empezamos con un único factor de agrupamiento, incorporamos interceptos variables, predictores medidos en distintos niveles y, finalmente, pendientes variables e interacciones entre niveles.
Hasta ahora la estructura de agrupamiento ha sido relativamente simple. Una observación pertenecía a un grupo principal y ese grupo podía representarse mediante una jerarquía clara. Sin embargo, muchas aplicaciones reales no admiten un único árbol de pertenencias. Una calificación puede depender simultáneamente de la persona evaluada y del evaluador; un estudiante puede estar asociado con una escuela primaria y con una escuela secundaria; una medición industrial puede depender tanto de una máquina como del operario que la utiliza.
Gelman y Hill presentan estas situaciones como extensiones de los modelos multinivel a estructuras no anidadas y muestran que varios factores de agrupamiento pueden contribuir aditivamente al predictor lineal (Gelman y Hill 2007, sec. 13.5). Hox, Moerbeek y van de Schoot dedican un capítulo completo a estructuras de clasificación cruzada y enfatizan que, cuando dos jerarquías aparentemente plausibles son incompatibles entre sí, la estructura suele ser cruzada (Hox et al. 2018, cap. 9). McElreath formula la misma idea desde una perspectiva generativa: cada tipo de agrupamiento recibe su propia población de coeficientes y, por tanto, su propio mecanismo de pooling parcial (McElreath 2020, sec. 13.3).
La pregunta orientadora de la semana es:
¿Cómo representamos la dependencia cuando las observaciones comparten varias unidades de agrupamiento y esas unidades no forman necesariamente una jerarquía simple?
Esta pregunta conduce a tres extensiones importantes:
modelos estrictamente anidados con tres o más niveles;
modelos con factores de agrupamiento cruzados;
ANOVA jerárquico, entendido como una organización de fuentes de variación mediante lotes de coeficientes parcialmente agrupados.
ImportanteDos significados distintos de ‘jerárquico’
Conviene separar dos usos del término jerárquico.
Jerarquía de los datos: una estructura de pertenencia como estudiante \(\subset\) aula \(\subset\) escuela.
Jerarquía probabilística: parámetros específicos de grupos generados a partir de una distribución poblacional.
Un modelo con factores cruzados puede no tener una jerarquía estricta en los datos y, al mismo tiempo, ser un modelo bayesiano jerárquico porque sus coeficientes están organizados mediante distribuciones poblacionales.
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
identificar la unidad de observación y enumerar todos los factores de agrupamiento relevantes para una respuesta;
distinguir estructuras anidadas, cruzadas, parcialmente cruzadas y de pertenencia múltiple;
formular un modelo gaussiano de tres niveles con interceptos variables;
derivar la varianza y la covarianza inducidas por una estructura estrictamente anidada;
explicar por qué, con varios niveles de agrupamiento, no existe necesariamente un único ICC que describa toda la dependencia;
formular un modelo con dos o más factores de agrupamiento cruzados;
derivar una expresión general para la covarianza entre dos observaciones a partir de las unidades que comparten;
distinguir el hecho de que dos factores estén cruzados de la inclusión de una interacción entre esos factores;
traducir estructuras anidadas y cruzadas a fórmulas de brms sin ocultar la estructura probabilística;
interpretar los parámetros de escala asociados con distintas fuentes de heterogeneidad;
explicar ANOVA como una organización de coeficientes en lotes o fuentes de variación, en lugar de reducirla a una colección de pruebas \(F\);
relacionar ANOVA jerárquico con pooling parcial y regularización de comparaciones entre niveles;
distinguir desviaciones estándar de superpoblación y de población finita para una fuente de variación;
reconocer problemas de identificación cuando una fuente contiene pocos niveles o cuando una interacción de celdas no puede distinguirse del error residual;
especificar previas regularizadoras para varios componentes de variación, respetando la escala de la respuesta;
ajustar en brms modelos anidados y cruzados usando cmdstanr como backend;
diagnosticar el muestreo MCMC y diferenciar advertencias computacionales de incertidumbre sustantiva en componentes de variación;
realizar comprobaciones predictivas globales y sensibles a cada factor de agrupamiento;
construir un resumen ANOVA bayesiano mediante distribuciones posteriores de las magnitudes de heterogeneidad;
describir la estructura de agrupamiento del proyecto del curso antes de fijar una fórmula del modelo.
5.2 Problema motivador: centros, personas y evaluadores
Supongamos que una institución evalúa proyectos desarrollados por personas pertenecientes a distintos centros. Cada persona pertenece a un único centro, pero cada proyecto es calificado por varios evaluadores y cada evaluador revisa proyectos de varios centros.
La unidad de observación es una calificación individual. Para cada calificación \(i\) podemos identificar:
el centro \(c[i]\);
la persona \(p[i]\);
el evaluador \(e[i]\).
La relación persona–centro es anidada:
\[
\text{persona}\subset\text{centro}.
\]
La relación persona–evaluador no lo es. Un evaluador puede calificar a muchas personas y una persona puede recibir calificaciones de varios evaluadores. Los dos factores están cruzados.
La respuesta de dos observaciones será más parecida si comparten una o varias de esas unidades. El modelo no necesita decidir que “evaluador es nivel 2” y “centro es nivel 3”. Lo esencial es identificar qué componente de variación comparte cada par de observaciones.
NotaPregunta generativa antes que nomenclatura
Antes de decidir si un conjunto de datos tiene dos, tres o cuatro niveles, conviene preguntar:
Para generar dos observaciones, ¿qué cantidades latentes serían reutilizadas por ambas?
La respuesta a esa pregunta suele revelar la estructura de dependencia con mayor claridad que una numeración mecánica de niveles.
5.3 Estructuras de pertenencia antes de formular el modelo
5.3.1 Factores anidados
Diremos que un factor \(B\) está anidado en un factor \(A\) si cada nivel de \(B\) pertenece a un único nivel de \(A\).
Si el aula 12 pertenece a la escuela 3, todas las observaciones asociadas con esa aula comparten también la escuela 3. La pertenencia puede representarse mediante un árbol.
West, Welch y Gałecki describen los datos de tres niveles mediante unidades dentro de “clusters of clusters”, mientras que Hox et al. presentan la extensión de dos a tres niveles como conceptualmente directa, aunque advierten que el número de parámetros y las exigencias informativas pueden crecer con rapidez (Hox et al. 2018, sec. 2.3).
5.3.2 Factores cruzados
Dos factores \(A\) y \(B\) están cruzados cuando niveles de \(A\) pueden aparecer junto con múltiples niveles de \(B\) y viceversa.
Un ejemplo típico es
\[
\text{persona}\times\text{evaluador}.
\]
No existe una asignación única “evaluador dentro de persona” ni “persona dentro de evaluador”. Hox et al. ilustran esta idea con estudiantes asociados simultáneamente con escuelas primarias y secundarias: cada estudiante está anidado en una escuela primaria y en una secundaria, pero las escuelas primarias y secundarias están cruzadas entre sí (Hox et al. 2018, sec. 9.2).
5.3.3 Cruzamiento completo y parcial
Un diseño cruzado no necesita contener todas las combinaciones posibles.
Si hubiera \(P\) personas y \(E\) evaluadores, un diseño completamente cruzado tendría observaciones para las \(P\times E\) combinaciones. En la práctica, cada persona puede ser evaluada solo por una pequeña fracción de los evaluadores. La estructura sigue siendo cruzada si no existe una relación de anidamiento unívoca.
Esta distinción es importante:
\[
\boxed{
\text{“no observamos todas las celdas”}
\neq
\text{“los factores están anidados”.}
}
\]
La conectividad del diseño importa para la identificación. Si diferentes subconjuntos de evaluadores calificaran conjuntos completamente disjuntos de personas, sería difícil separar algunas fuentes de variación. Por tanto, además de clasificar la estructura, conviene inspeccionar qué niveles están conectados mediante observaciones compartidas.
5.3.4 Pertenencia múltiple: una extensión
En algunas aplicaciones, una unidad puede pertenecer simultáneamente a varios grupos del mismo tipo. Un paciente podría ser atendido por un equipo compuesto por varios profesionales o un estudiante podría haber recibido instrucción de varios docentes durante el período que genera la respuesta.
Los pesos \(w_{ih}\) describen cuánto contribuye cada grupo a la observación \(i\). Esta semana usaremos esta estructura únicamente como extensión conceptual; el laboratorio principal se concentrará en anidamiento y clasificación cruzada.
5.4 Modelos estrictamente anidados de tres niveles
Considere estudiantes \(i\) dentro de aulas \(j\) dentro de escuelas \(k\). Para simplificar la notación, escribimos \(j(k)\) para recordar que el aula \(j\) pertenece a una escuela específica.
Un modelo de interceptos variables en tres niveles es
Esta segunda forma hace explícito que el intercepto del aula se construye alrededor de un intercepto de escuela, que a su vez se construye alrededor de un promedio poblacional. La primera forma hace más transparente la descomposición de la variación.
5.4.1 Varianza marginal de una observación
Al marginalizar sobre los términos de aula y escuela,
Si \(k\neq k'\), no comparten ni el término de escuela ni el de aula y, bajo este modelo,
\[
\operatorname{Cov}(y_{ijk},y_{i'j'k'})=0.
\]
ImportanteYa no hay un único ICC
En un modelo de dos niveles con intercepto variable, una sola correlación intraclase resume la dependencia inducida por el agrupamiento.
Con tres niveles, la correlación depende de qué unidades comparten las dos observaciones. Dos estudiantes de la misma aula comparten más componentes que dos estudiantes de aulas diferentes de la misma escuela.
Por eso es más informativo describir la estructura de covarianza que buscar un único número llamado “el ICC”.
5.5 De la jerarquía al cruce
Gelman y Hill presentan un ejemplo con tratamientos y aeropuertos en el cual cada observación está asociada con una condición experimental y un aeropuerto. Su modelo no anidado tiene la forma (Gelman y Hill 2007, sec. 13.5)
Aquí hay dos mecanismos de pooling parcial simultáneos:
las personas se regularizan hacia la media poblacional según \(\tau_P\) y la información disponible para cada persona;
los evaluadores se regularizan hacia la media poblacional según \(\tau_E\) y la información disponible para cada evaluador.
McElreath enfatiza esta idea en su ejemplo de actores y bloques: agregar un segundo tipo de agrupamiento equivale a agregar otra población de interceptos variables, con su propia escala de heterogeneidad (McElreath 2020, sec. 13.3).
5.5.1 Covarianza en un modelo con dos factores cruzados
donde \(I\{\cdot\}\) vale 1 si la condición es verdadera y 0 en caso contrario.
Esto produce cuatro situaciones:
Relación entre observaciones
Covarianza inducida
misma persona, mismo evaluador
\(\tau_P^2+\tau_E^2\)
misma persona, evaluadores distintos
\(\tau_P^2\)
personas distintas, mismo evaluador
\(\tau_E^2\)
personas y evaluadores distintos
\(0\)
La última fila no afirma que las respuestas sean sustantivamente independientes en el mundo real. Afirma únicamente que este modelo no introduce ninguna fuente adicional de dependencia entre esas observaciones.
5.6 Una regla general para entender la dependencia
La estructura anterior se generaliza de manera natural. Suponga que cada observación \(i\) está asociada con \(M\) factores de agrupamiento y que el modelo aditivo de interceptos variables es
Esta fórmula es una derivación pedagógica del modelo aditivo con componentes independientes. No es una afirmación de que todas las estructuras de dependencia puedan reducirse a interceptos variables independientes. Más adelante en el curso aparecerán pendientes variables, dependencia temporal, heterocedasticidad y otras estructuras que modifican esta expresión.
5.6.1 Extensión a pertenencia múltiple
Si un factor usa pesos \(w_{ih}\),
\[
u_i^{(G)}=\sum_h w_{ih}u_h,
\]
entonces su contribución a la covarianza de dos observaciones es
Ahora dos observaciones pueden compartir parcialmente una fuente de variación, no solo compartirla o no compartirla.
5.7 Anidamiento y cruce en brms
La sintaxis de brms permite representar varios factores de agrupamiento mediante términos separados. Bürkner describe el predictor lineal de un modelo multinivel como una combinación de efectos poblacionales y uno o más vectores de coeficientes grupales; cada factor de agrupamiento puede tener su propia distribución jerárquica (Bürkner 2017).
5.7.1 Dos factores cruzados
Para persona y evaluador:
formula_cruzada <- y ~1+ (1| persona) + (1| evaluador)
Suponga aulas con identificadores que se repiten entre escuelas. Una representación explícita es
formula_anidada <- y ~1+ (1| escuela) + (1| escuela:aula)
Esto introduce una fuente de variación entre escuelas y otra entre combinaciones escuela–aula.
También existe la abreviatura
y ~1+ (1| escuela/aula)
que expande a los términos correspondientes. En estas notas preferiremos inicialmente la forma explícita porque mantiene visible qué distribuciones jerárquicas estamos introduciendo.
5.7.3 Identificadores globalmente únicos
Si cada aula tiene un identificador globalmente único, por ejemplo aula_id = A001, A002, ..., entonces puede escribirse
y ~1+ (1| escuela) + (1| aula_id)
porque la variable aula_id ya codifica la pertenencia única. Esto no convierte aula y escuela en factores cruzados: la estructura sustantiva sigue siendo anidada.
AdvertenciaLa fórmula no sustituye la inspección de la estructura
Dos fórmulas pueden parecer plausibles y, sin embargo, corresponder a procesos generadores distintos. Antes de escribir (1 | grupo) conviene verificar:
cuántos niveles tiene el factor;
si sus identificadores son globalmente únicos;
cuántos grupos superiores contiene cada nivel inferior;
qué combinaciones entre factores están realmente observadas.
5.8 Cruzamiento no es interacción
Esta distinción es fundamental.
Suponga dos factores cruzados \(A\) y \(B\). Un modelo aditivo es
\[
y_{ijk}
=
\alpha+a_j+b_k+\varepsilon_{ijk}.
\]
Aquí \(A\) y \(B\) están cruzados porque la estructura de los datos permite combinaciones entre niveles de ambos factores. Sin embargo, el modelo afirma que las diferencias entre niveles de \(A\) son aditivas respecto de las diferencias entre niveles de \(B\).
Una interacción agrega desviaciones específicas de la combinación:
\[
\boxed{
\text{factores cruzados}
\neq
\text{interacción entre factores}.
}
\]
Cruzamiento describe una relación de pertenencia o diseño.
Interacción describe una estructura del predictor lineal: la combinación \(A\times B\) tiene una desviación adicional que no se explica por los efectos aditivos de \(A\) y \(B\).
5.8.1 Replicación e identificación de la interacción
Si hay varias observaciones por celda \((j,k)\), la variabilidad \(c_{jk}\) puede distinguirse de la variabilidad residual dentro de la celda.
Si existe exactamente una observación por cada combinación \(A\times B\), un modelo con un término libre para cada celda y un error residual separado puede quedar débilmente identificado o no identificado por la verosimilitud: no hay replicación dentro de la celda para separar ambas fuentes. Las previas pueden regularizar, pero no crean información que el diseño no contiene.
Esta observación conecta el diseño experimental con la identificación del modelo y será importante al interpretar ANOVA jerárquico.
5.9 ANOVA como modelo jerárquico
El análisis de varianza suele enseñarse mediante sumas de cuadrados, grados de libertad, cuadrados medios y pruebas \(F\). Esa tradición es útil para entender diseños experimentales, pero no es la organización central que usaremos en este curso.
Gelman y Hill proponen interpretar ANOVA como una manera de organizar fuentes de variación. Cada fila de una tabla ANOVA puede verse como un lote (batch) de coeficientes relacionados (Gelman y Hill 2007, cap. 22). Bayesian Data Analysis desarrolla la misma idea: los coeficientes se agrupan en lotes intercambiables, cada uno con su propia escala poblacional (Gelman et al. 2013, secs. 15.6-15.7).
La pregunta principal deja de ser “¿qué fila tiene un valor \(p\) menor que 0.05?” y pasa a ser:
¿Cuánta heterogeneidad se asocia con cada fuente y con qué incertidumbre?
5.9.2 Diseños desbalanceados
Gelman y Hill señalan que el enfoque multinivel de ANOVA se extiende de manera natural a diseños desbalanceados: no se requiere que todas las celdas tengan el mismo número de observaciones para formular el modelo (Gelman y Hill 2007, sec. 22.4).
Esto no significa que el desbalance sea irrelevante. Celdas con poca información tendrán posteriores más amplias y, bajo un modelo jerárquico, mayor shrinkage. El punto es que la inferencia se construye desde el modelo generativo y no desde identidades algebraicas que exigen balance perfecto.
5.10 ANOVA, pooling parcial y multiplicidad
Suponga que el factor \(A\) tiene muchos niveles. Un enfoque sin pooling estima un parámetro independiente para cada uno:
\[
a_1,\ldots,a_J.
\]
En el modelo jerárquico,
\[
a_j\sim\mathcal N(0,\tau_A^2).
\]
Los niveles con poca información reciben mayor regularización hacia la distribución conjunta; los niveles muy bien medidos cambian menos. La misma lógica se aplica simultáneamente a los otros lotes.
Esta estructura cambia el problema de las comparaciones múltiples. En lugar de realizar numerosas comparaciones aisladas y corregir cada una después, modelamos los coeficientes conjuntamente y derivamos de la posterior las comparaciones que sean sustantivamente relevantes. Gelman y Hill discuten cómo el pooling parcial puede reducir la sobreinterpretación de patrones extremos que aparecen por variación muestral (Gelman y Hill 2007, sec. 21.8).
AdvertenciaPooling parcial no significa selección automática
El modelo jerárquico no convierte los coeficientes pequeños en cero ni decide automáticamente qué niveles “importan”. Regulariza las estimaciones y propaga incertidumbre.
Si una comparación concreta es sustantivamente relevante, se calcula directamente a partir de la posterior, por ejemplo
\[
P(a_j-a_{j'}>\Delta\mid y)
\]
o un intervalo posterior para \(a_j-a_{j'}\).
5.11 Superpoblación y población finita
Una fuente frecuente de confusión en ANOVA jerárquico es interpretar todas las desviaciones estándar como si describieran la misma cantidad.
describe la escala de la distribución generadora de niveles potenciales del factor \(A\). Es relevante cuando queremos generalizar más allá de los niveles observados o predecir un nivel nuevo bajo el supuesto de intercambiabilidad.
5.11.2 Desviación estándar de población finita
Para los niveles efectivamente observados, en cada muestra posterior podemos calcular
Esta cantidad describe la dispersión de esos niveles observados.
Gelman y Hill enfatizan que \(\tau_A\) y \(s_A\) son cantidades distintas, no dos estimadores rivales del mismo parámetro (Gelman y Hill 2007, sec. 21.2). Con pocos niveles, puede ocurrir que los \(a_j\) observados estén bastante bien estimados y, por tanto, \(s_A\) sea relativamente preciso, mientras que \(\tau_A\) continúe siendo muy incierto porque hay poca información para caracterizar una población más amplia.
Este contraste será especialmente visible en factores con muy pocos niveles, como tres máquinas o cuatro tratamientos.
5.12 Previas para varias fuentes de heterogeneidad
La semana 6 estará dedicada específicamente a construcción y comprobación de previas. Aquí mantendremos una estrategia sencilla y explícita.
Las escalas deben juzgarse en la escala de la respuesta. Una previa normal(0, 10) sobre una desviación estándar significa algo muy distinto si la respuesta varía entre 0 y 1 que si varía alrededor de 500.
En brms, los parámetros de clase sd y sigma están restringidos a valores no negativos. Por tanto,
set_prior("normal(0, 8)", class ="sd")
induce la parte positiva de esa distribución normal.
Bayesian Workflow subraya que previas aparentemente débiles sobre parámetros individuales pueden combinarse para generar predicciones conjuntas muy fuertes o poco plausibles; por eso conviene juzgarlas también mediante simulación predictiva previa (Gelman et al. 2026).
NotaMás componentes no implica previas más difusas
Al agregar fuentes de variación no conviene compensar la complejidad usando previas cada vez más anchas. Cada componente adicional amplía el espacio de predicciones posibles. La regularización es especialmente importante cuando algunos factores tienen pocos niveles.
5.13 Laboratorio reproducible en R
El laboratorio seguirá dos aplicaciones complementarias.
Datos simulados: centros, personas y evaluadores. Esto nos permite conocer el proceso generador y comprobar si el modelo recupera las fuentes de heterogeneidad.
Datos Machines: trabajadores y máquinas en un diseño cruzado con replicación. Esto permite construir un ANOVA jerárquico y distinguir efectos principales, interacción de celda y error residual.
Habrá ocho centros, entre 8 y 14 personas por centro y doce evaluadores. Cada persona será evaluada por entre dos y cuatro evaluadores elegidos sin reemplazo.
# A tibble: 4 × 5
  inferior  superior  anidado min_superiores max_superiores
  <chr>     <chr>     <lgl>            <int>          <int>
1 persona   centro    TRUE                 1              1
2 evaluador centro    FALSE                7              8
3 persona   evaluador FALSE                2              4
4 evaluador persona   FALSE               15             29
Esperamos que cada persona aparezca en un único centro, mientras que los evaluadores aparezcan en varios centros y las personas estén asociadas con varios evaluadores.
La función no sustituye el conocimiento sustantivo. Solo verifica una propiedad de los identificadores observados.
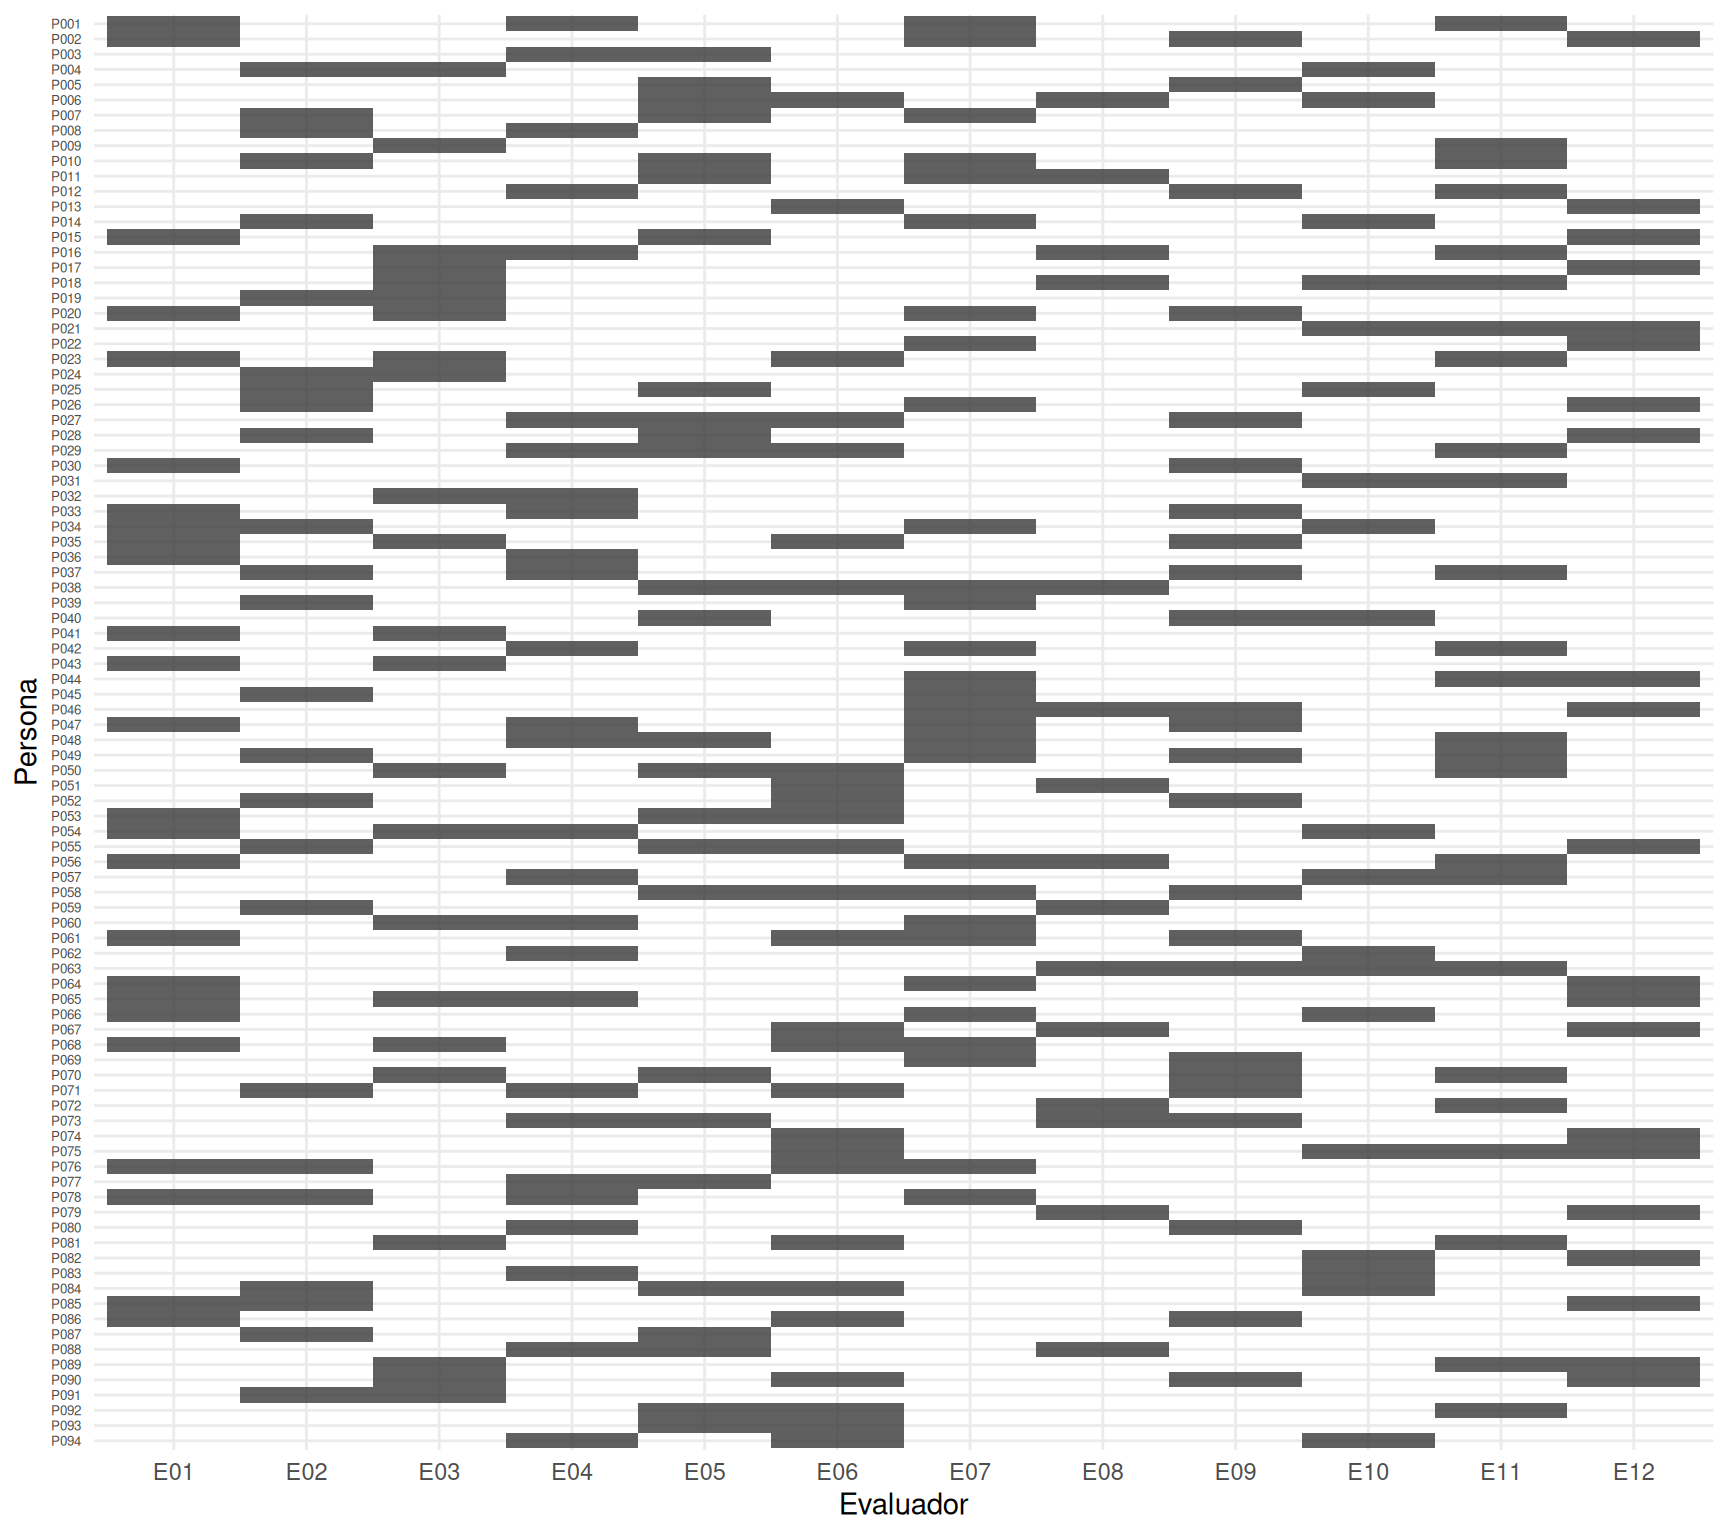
5.13.3 Visualizar la clasificación cruzada
Una matriz de incidencias permite ver rápidamente qué pares persona–evaluador están observados.
Figura 5.1: Combinaciones persona–evaluador observadas en los datos simulados. La ausencia de una estructura por bloques estrictos revela la clasificación cruzada.
No todas las combinaciones están presentes, pero tampoco podemos ordenar evaluadores dentro de personas o personas dentro de evaluadores. Es un diseño parcialmente cruzado.
5.13.4 Comprobación predictiva previa por simulación directa
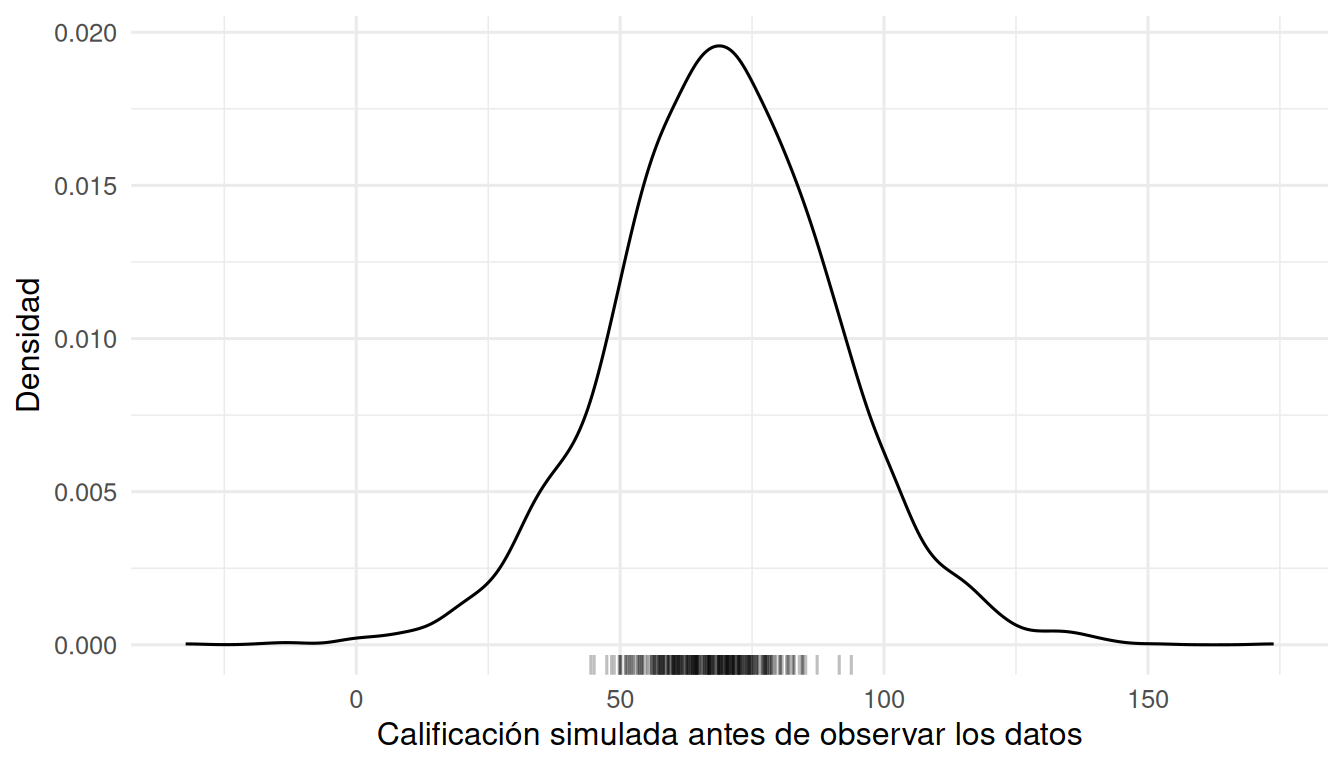
Antes de ajustar, consideremos previas ilustrativas para una respuesta cuya escala plausible está aproximadamente entre 40 y 100:
ggplot(prior_s5, aes(x = y_rep)) +geom_density() +geom_rug(data = datos_s5, aes(x = y), inherit.aes =FALSE, alpha =0.25) +labs(x ="Calificación simulada antes de observar los datos",y ="Densidad" ) +theme_minimal(base_size =12)
Figura 5.2: Distribución predictiva previa aproximada para una observación genérica bajo las previas propuestas.
La banda de valores observados se muestra únicamente como referencia pedagógica. En una comprobación previa auténtica realizada antes de recolectar datos, la plausibilidad debe juzgarse mediante conocimiento sustantivo y la escala de medición.
5.13.5 Ajustar un modelo que omite evaluador
Comenzamos deliberadamente con una representación incompleta:
En estos datos persona es un identificador globalmente único. Por eso (1 | persona) ya representa la heterogeneidad entre personas y cada persona puede vincularse a su centro mediante (1 | centro). Si los identificadores personales se repitieran entre centros, crearíamos un identificador compuesto o usaríamos explícitamente centro:persona.
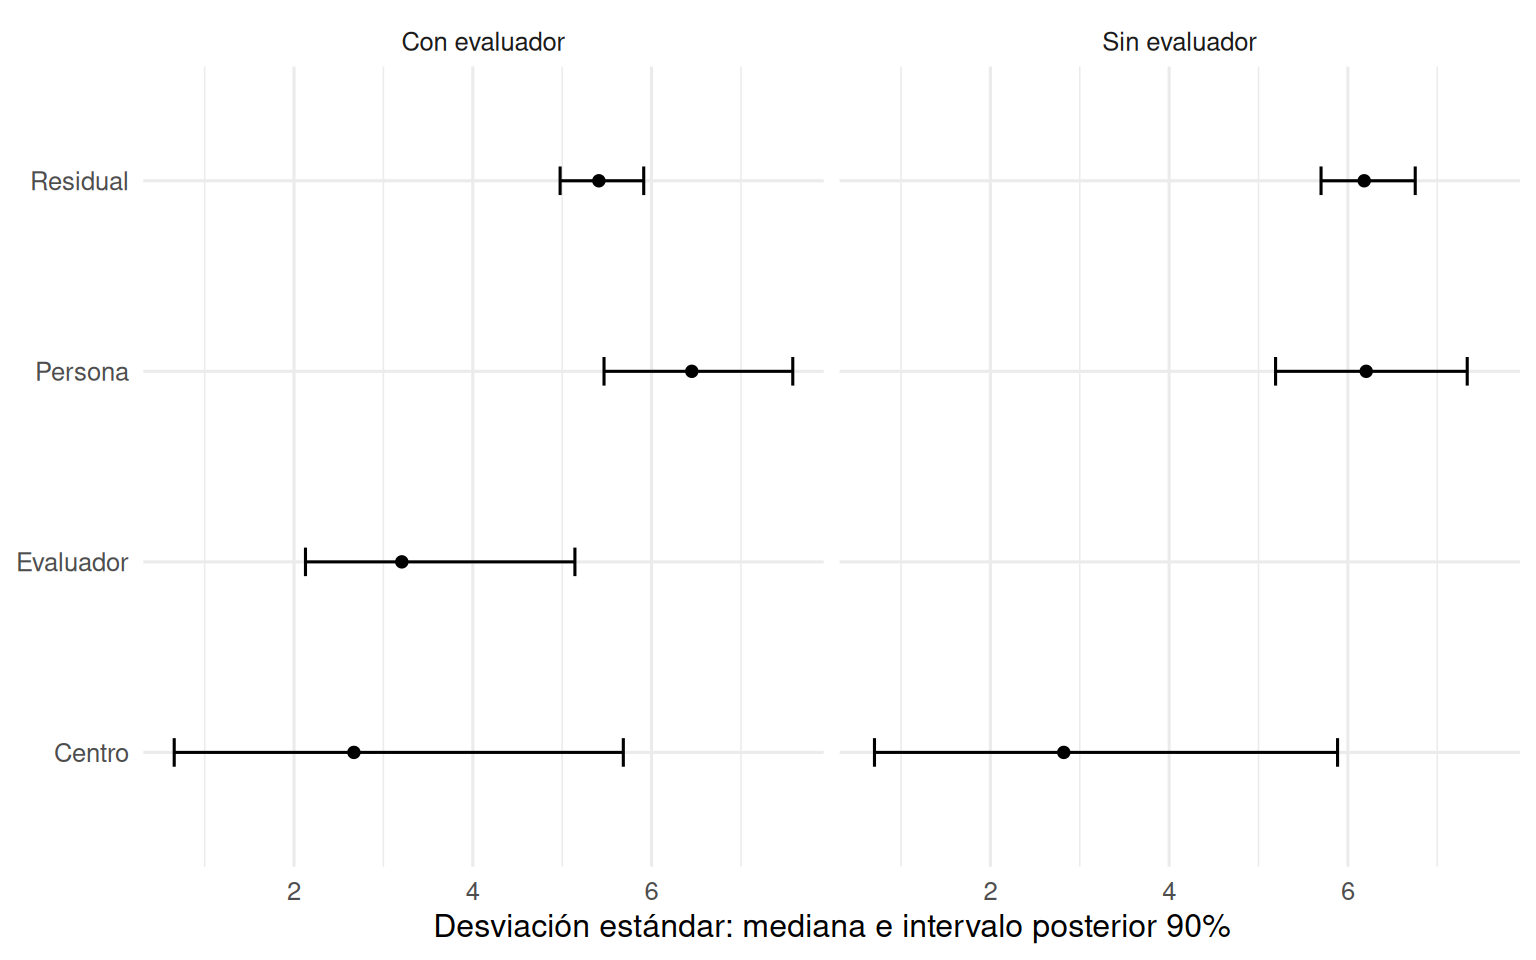
Figura 5.3: Posterior de las desviaciones estándar bajo el modelo que omite evaluador y el modelo que representa las tres fuentes de agrupamiento.
El propósito de esta comparación no es seleccionar automáticamente un modelo mediante una cifra. Sabemos por construcción que el proceso generador contiene evaluadores. La comparación sirve para examinar qué componente absorbe la variación cuando omitimos una fuente real de dependencia. Dependiendo del patrón de asignación, esa variación puede trasladarse al residual o distorsionar otras escalas grupales.
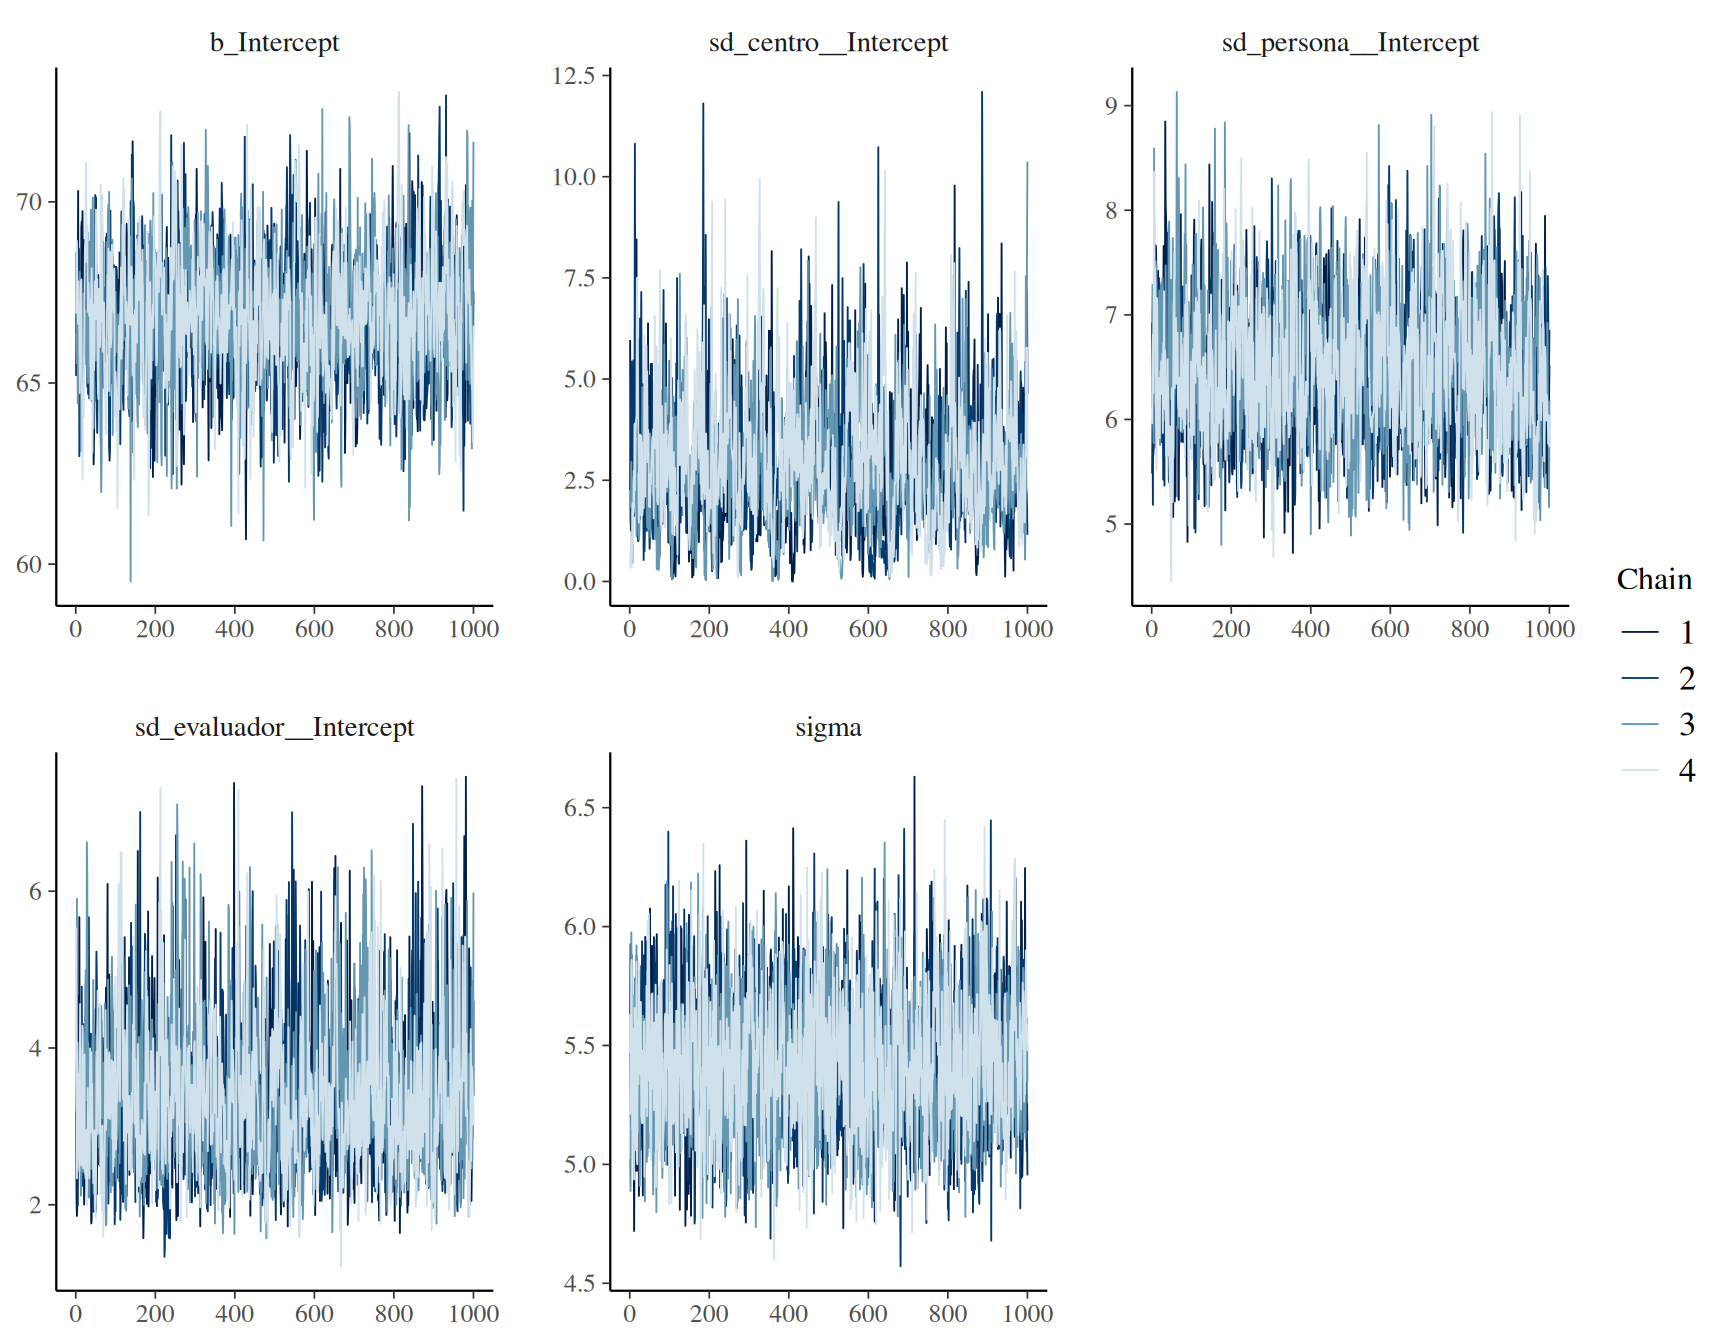
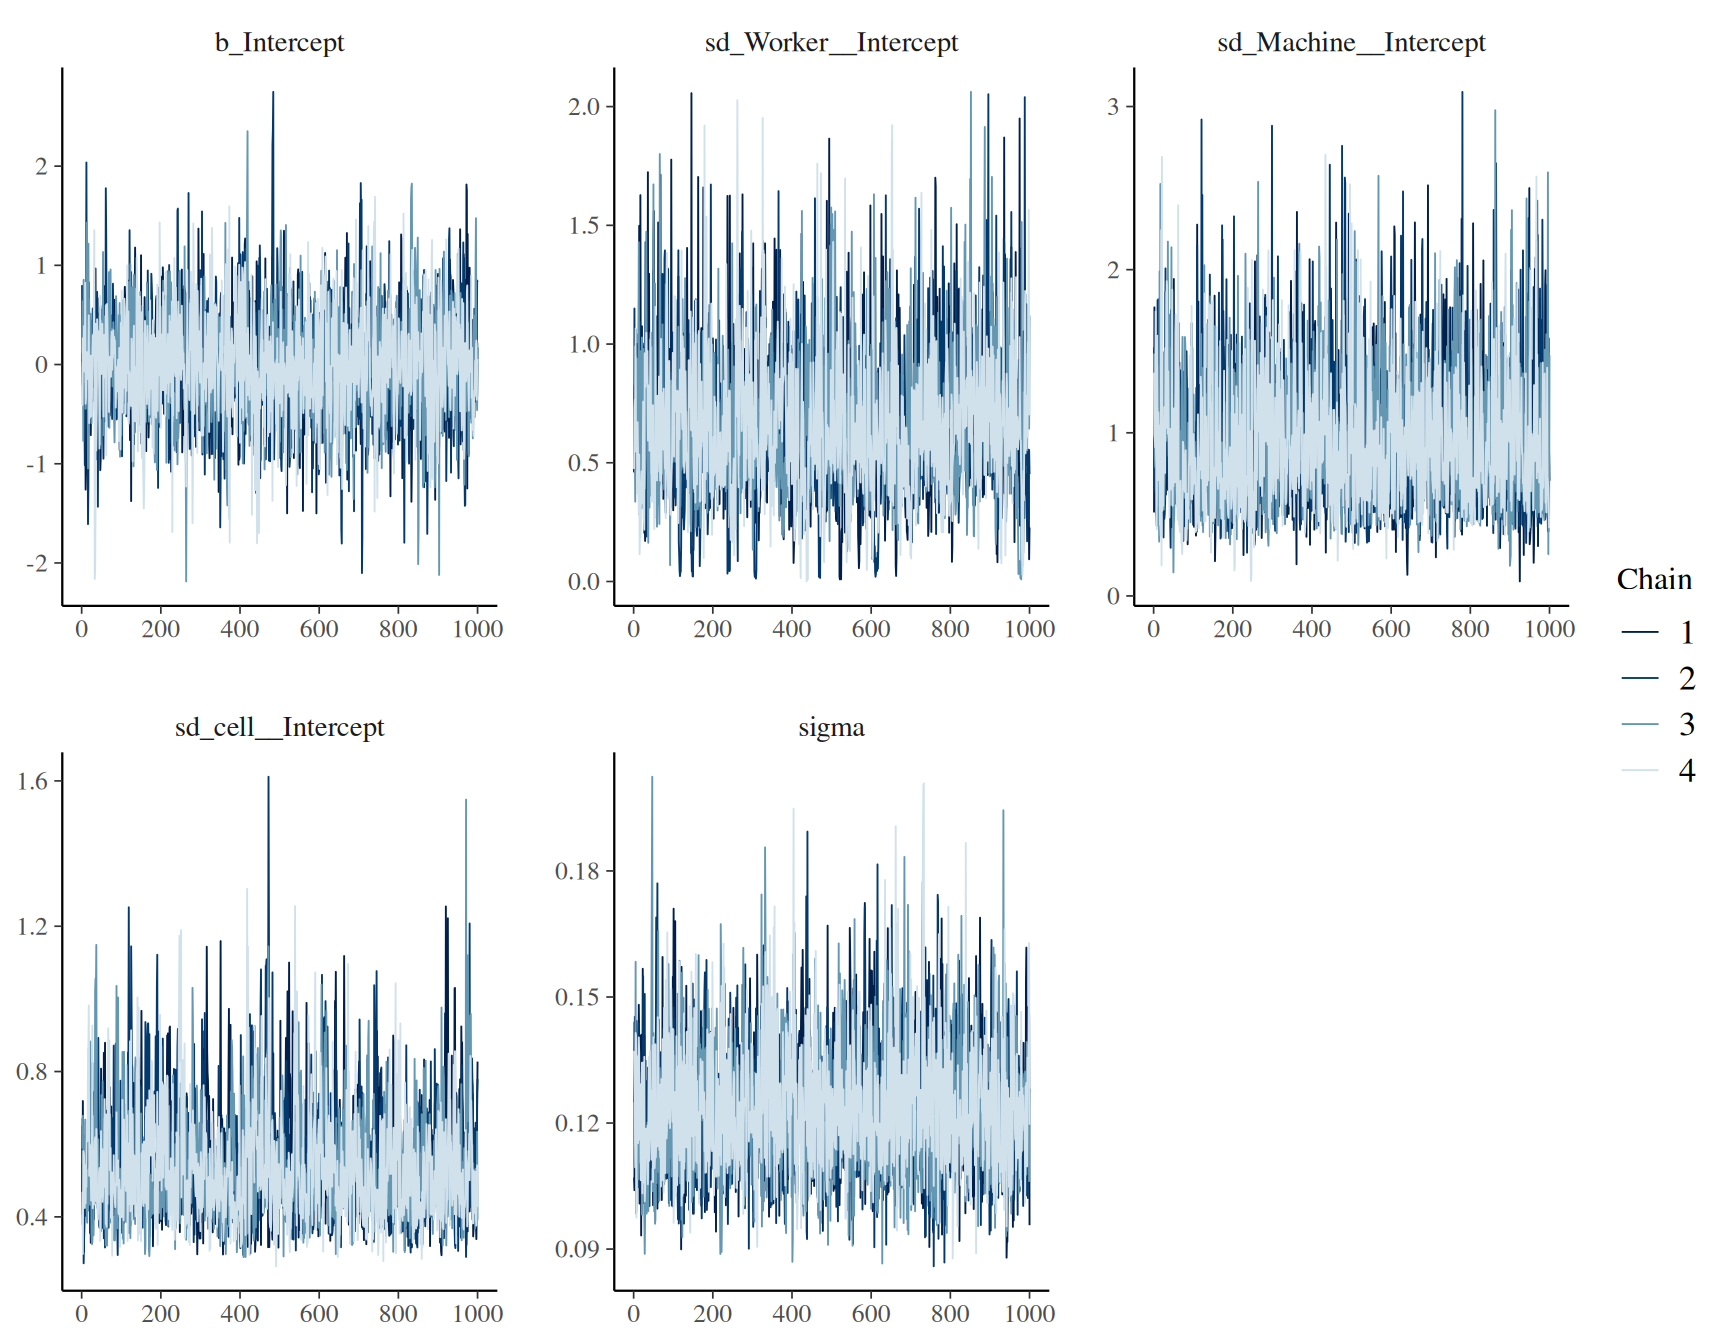
5.13.8 Diagnóstico MCMC básico
Comenzamos con \(\widehat R\), ESS y trazas para los parámetros poblacionales y las escalas principales.
Una posterior amplia para sd_centro__Intercept, por ejemplo, no es por sí sola una falla computacional. Con solo ocho centros, puede existir incertidumbre real sobre la distribución de centros aun cuando las cadenas mezclen adecuadamente. En la semana 7 distinguiremos con mayor detalle geometría posterior, divergencias, profundidad del árbol y parametrizaciones centrada y no centrada.
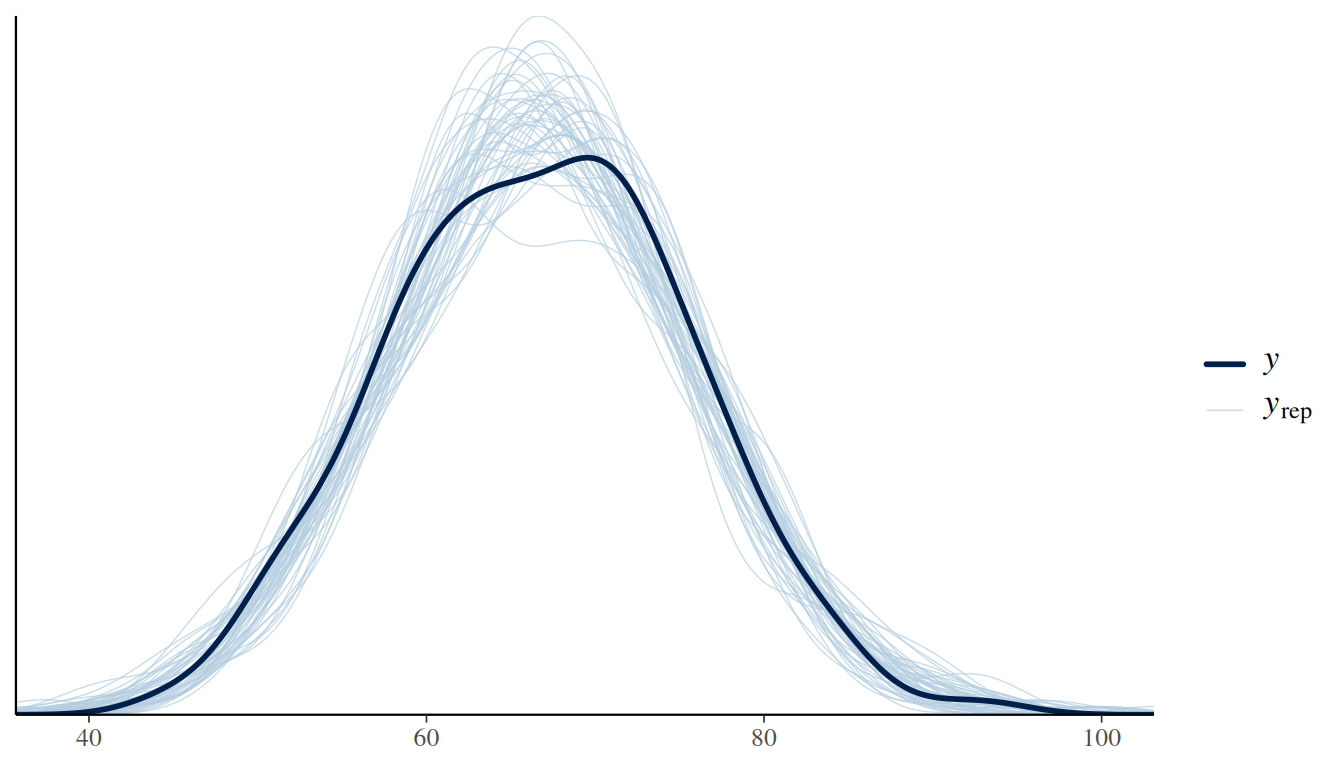
Figura 5.5: Comprobación predictiva posterior global del modelo cruzado.
Una comprobación global puede detectar problemas de localización, dispersión o forma marginal, pero no garantiza que el modelo reproduzca la heterogeneidad entre factores.
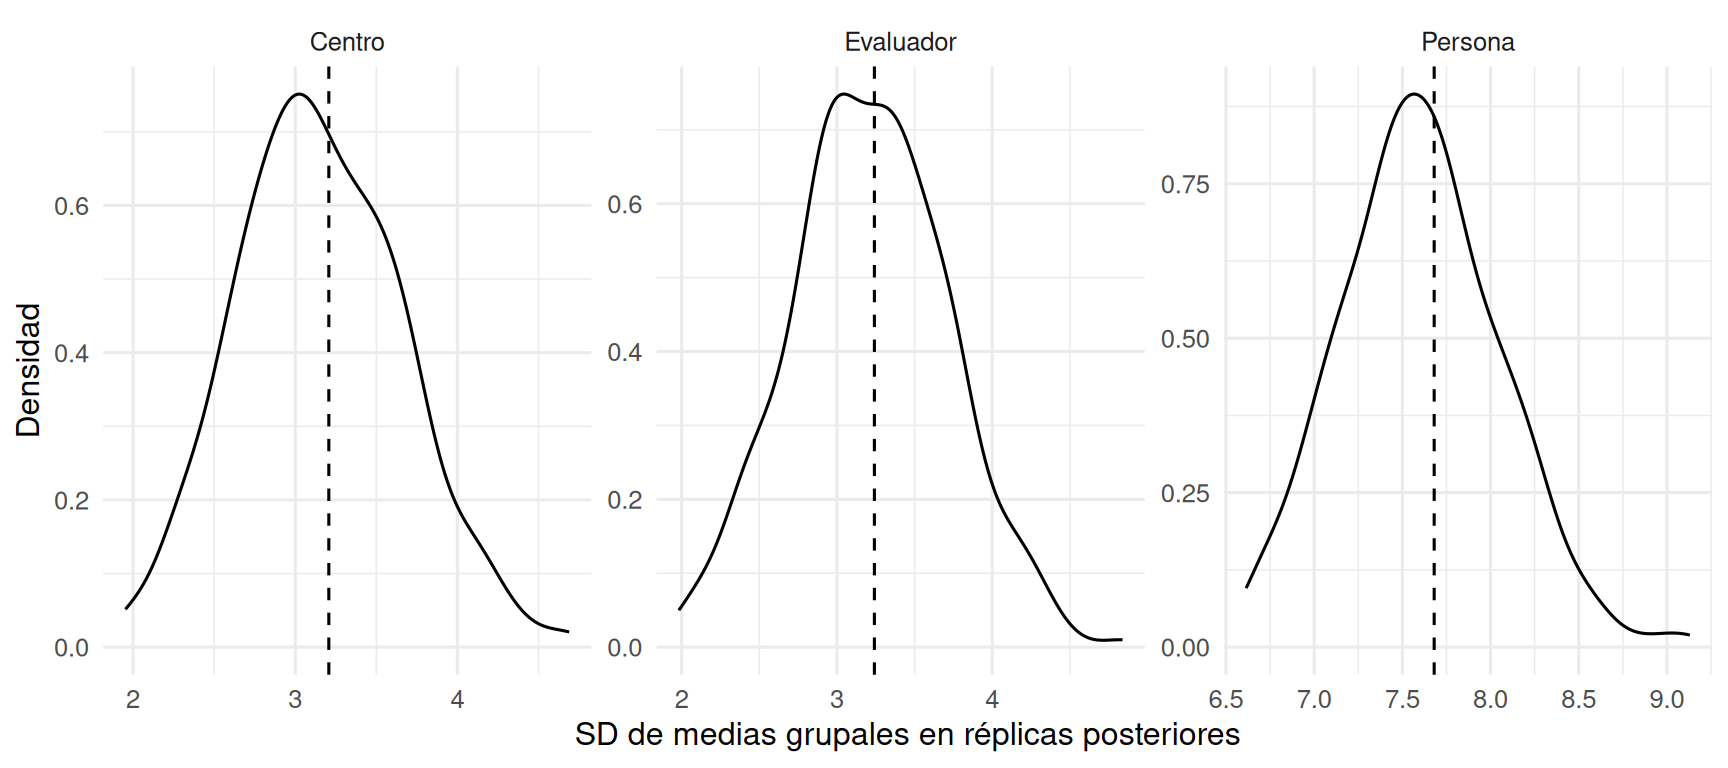
es decir, la desviación estándar de las medias observadas por grupo. No es un estimador directo de \(\tau_G\); es un estadístico predictivo que combina heterogeneidad real, tamaños de grupo y ruido muestral.
Figura 5.6: Comprobaciones predictivas posteriores de la dispersión de medias por centro, persona y evaluador. La línea vertical corresponde al estadístico observado.
Ahora la comprobación está alineada con la estructura que queremos evaluar: el modelo debe reproducir simultáneamente la heterogeneidad observada entre centros, personas y evaluadores.
5.14 Aplicación: trabajadores y máquinas
Para estudiar ANOVA jerárquico utilizaremos el conjunto Machines del paquete nlme. La respuesta es una puntuación de productividad, observada para combinaciones de trabajador y máquina con replicación dentro de las celdas.
La estructura es especialmente útil porque trabajador y máquina son factores cruzados. Además, las observaciones repetidas dentro de una combinación trabajador–máquina permiten separar una desviación específica de la celda de la variabilidad residual.
machines_s5 |>count(Worker, Machine, name ="replicas")
# A tibble: 18 × 3
   Worker Machine replicas
   <ord>  <fct>      <int>
 1 6      A              3
 2 6      B              3
 3 6      C              3
 4 2      A              3
 5 2      B              3
 6 2      C              3
 7 4      A              3
 8 4      B              3
 9 4      C              3
10 1      A              3
11 1      B              3
12 1      C              3
13 3      A              3
14 3      B              3
15 3      C              3
16 5      A              3
17 5      B              3
18 5      C              3
La tabla de conteos debe revisarse antes de formular el componente de interacción. Si cada celda contiene replicaciones, el diseño aporta información para distinguir heterogeneidad entre celdas y variabilidad residual dentro de las celdas.
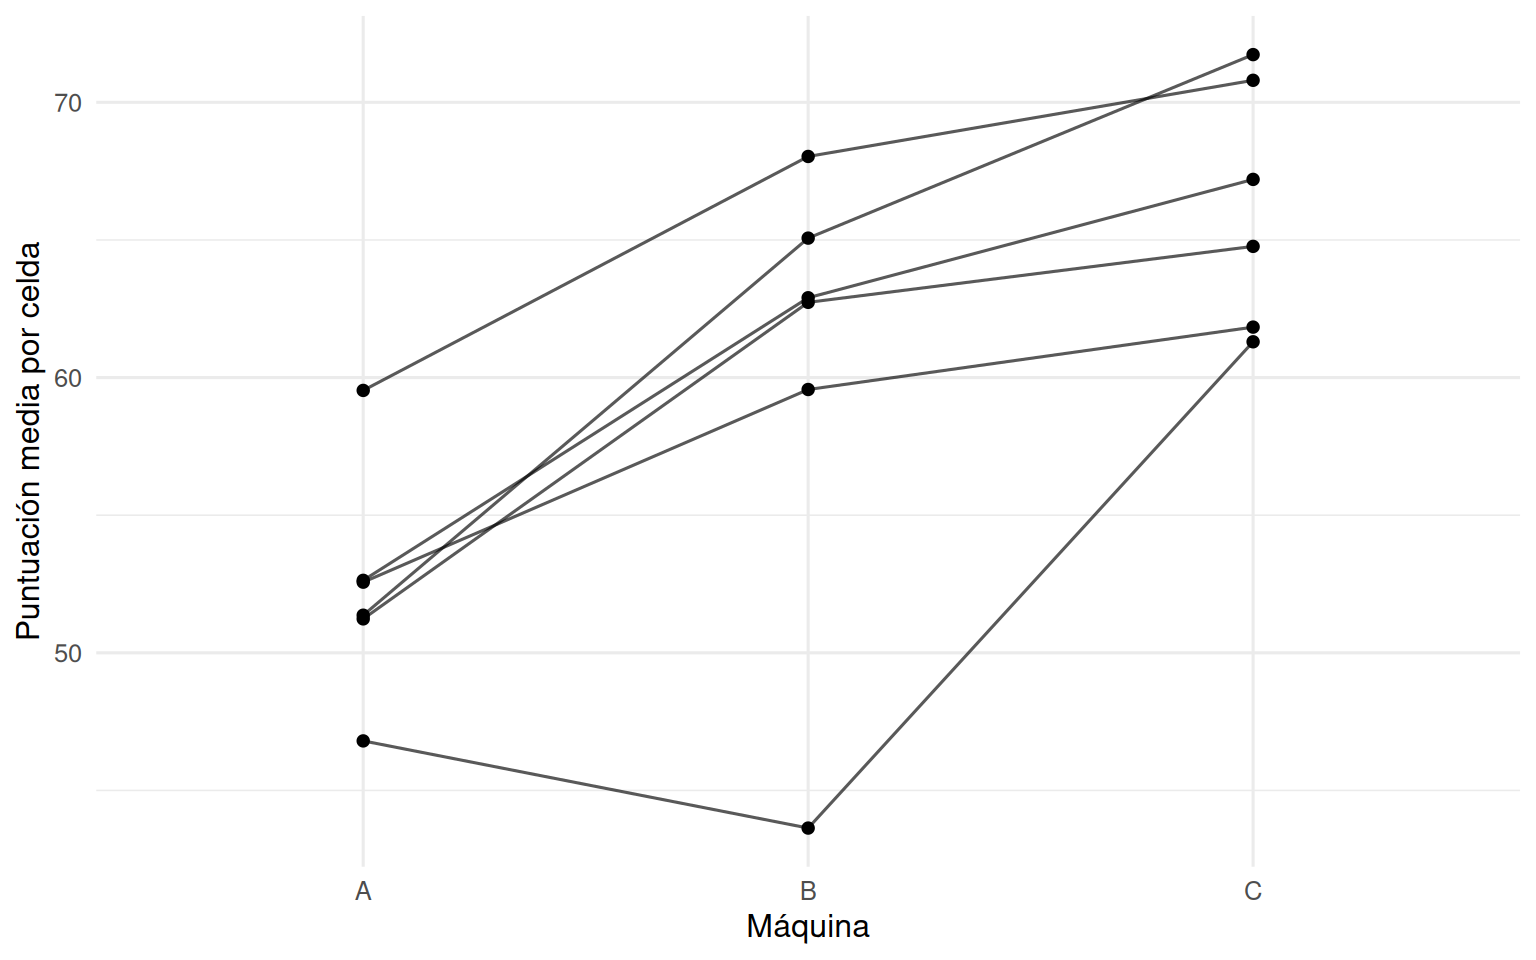
Figura 5.7: Puntuaciones medias por combinación de trabajador y máquina. Líneas no paralelas sugieren que las diferencias entre máquinas pueden variar entre trabajadores.
El gráfico es descriptivo. No necesitamos decidir visualmente si una interacción “existe” o no. Lo usaremos para anticipar qué fuente de variación podría requerir el modelo.
no debe interpretarse como una receta universal para “hacer ANOVA bayesiano”. Es la traducción de un proceso generador concreto: heterogeneidad aditiva de trabajadores, heterogeneidad aditiva de máquinas, desviaciones adicionales por combinación y variación residual entre réplicas de la misma combinación.
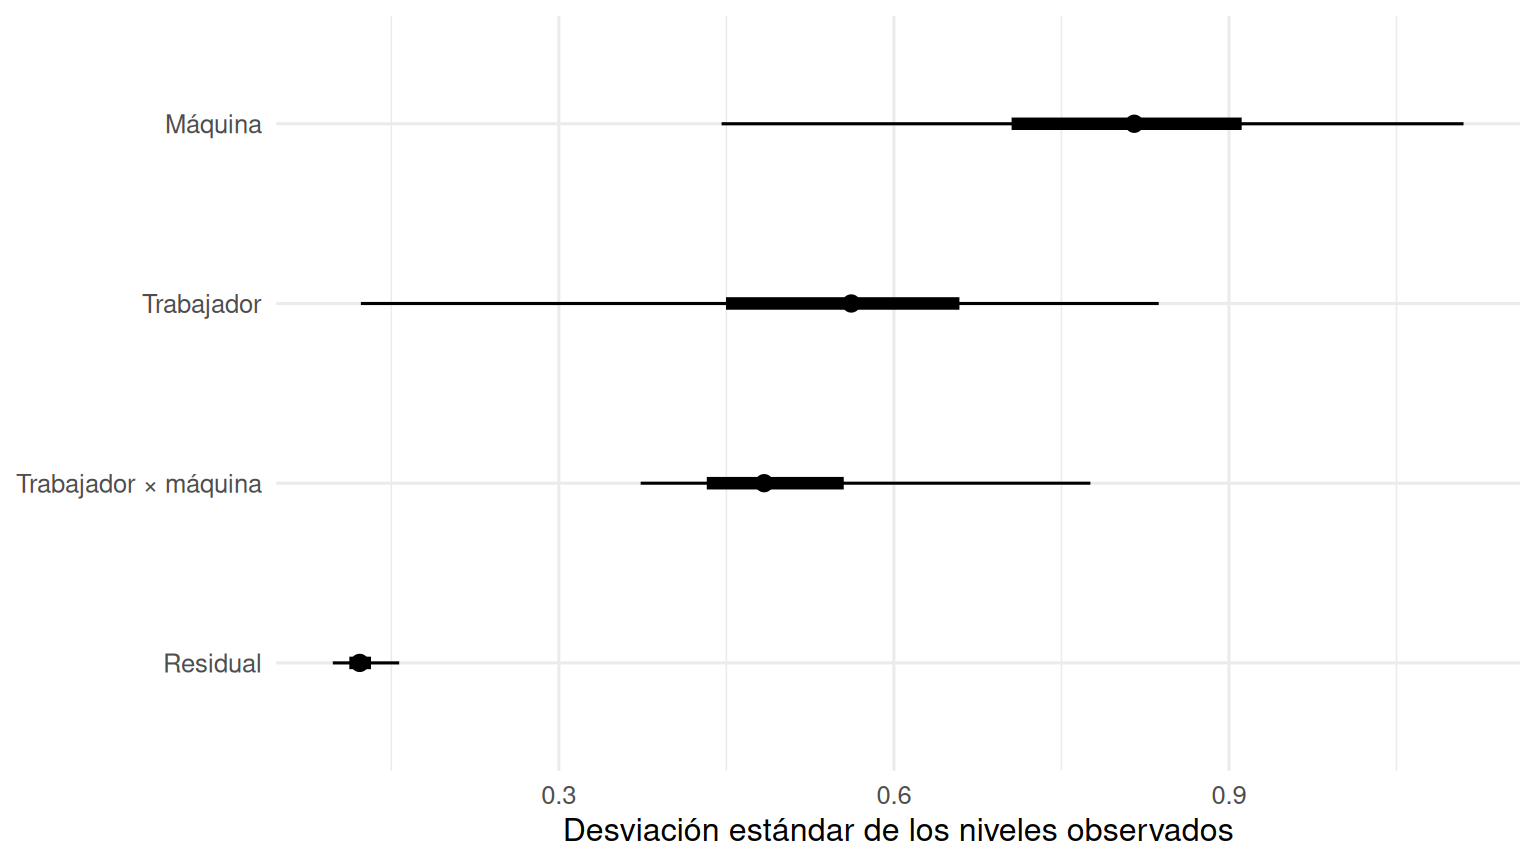
5.14.4 Resumen ANOVA de superpoblación
Para cada muestra posterior extraemos las desviaciones asociadas con trabajador, máquina, celda y residual.
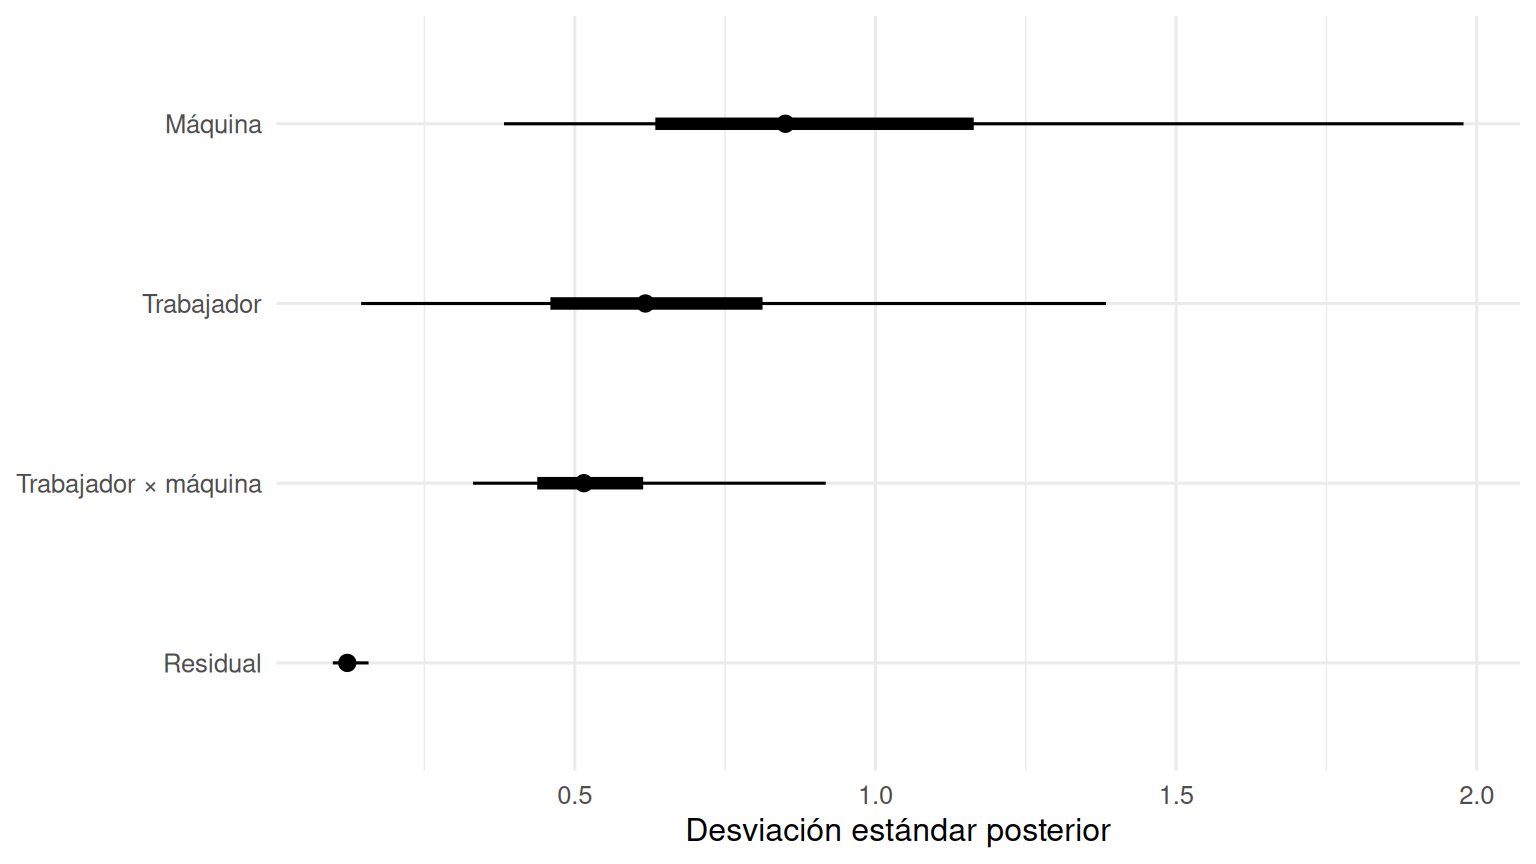
Figura 5.8: Resumen ANOVA jerárquico: desviaciones estándar de superpoblación para las fuentes de variación. Líneas gruesas: intervalo 50%; líneas delgadas: intervalo 95%.
Este gráfico desempeña un papel análogo al ANOVA display de Gelman y Hill: organiza el modelo por fuentes y muestra tanto magnitud como incertidumbre (Gelman y Hill 2007, secs. 22.3-22.4).
No debemos leerlo como una competencia en la que una fuente “gana”. Las fuentes corresponden a aspectos diferentes del proceso generador y pueden ser simultáneamente relevantes.
5.14.5 Resumen de población finita
Ahora calculamos, en cada muestra posterior, la dispersión de los coeficientes de los niveles realmente observados.
Figura 5.9: Dispersión posterior de los niveles observados (población finita) para las fuentes de variación de la aplicación Machines.
El contraste entre las dos figuras es particularmente útil para Machine, porque existen pocos niveles observados. La dispersión de esas máquinas concretas puede estar relativamente bien caracterizada mientras la escala de una población hipotética de máquinas intercambiables continúa siendo incierta.
5.14.6 Comparar el modelo aditivo y el modelo con interacción
No utilizaremos un único criterio escalar para decidir automáticamente cuál modelo conservar. Primero examinaremos qué implicación sustantiva cambia: el modelo aditivo afirma que no existe heterogeneidad adicional de las combinaciones trabajador–máquina, mientras que el modelo ANOVA permite esa fuente.
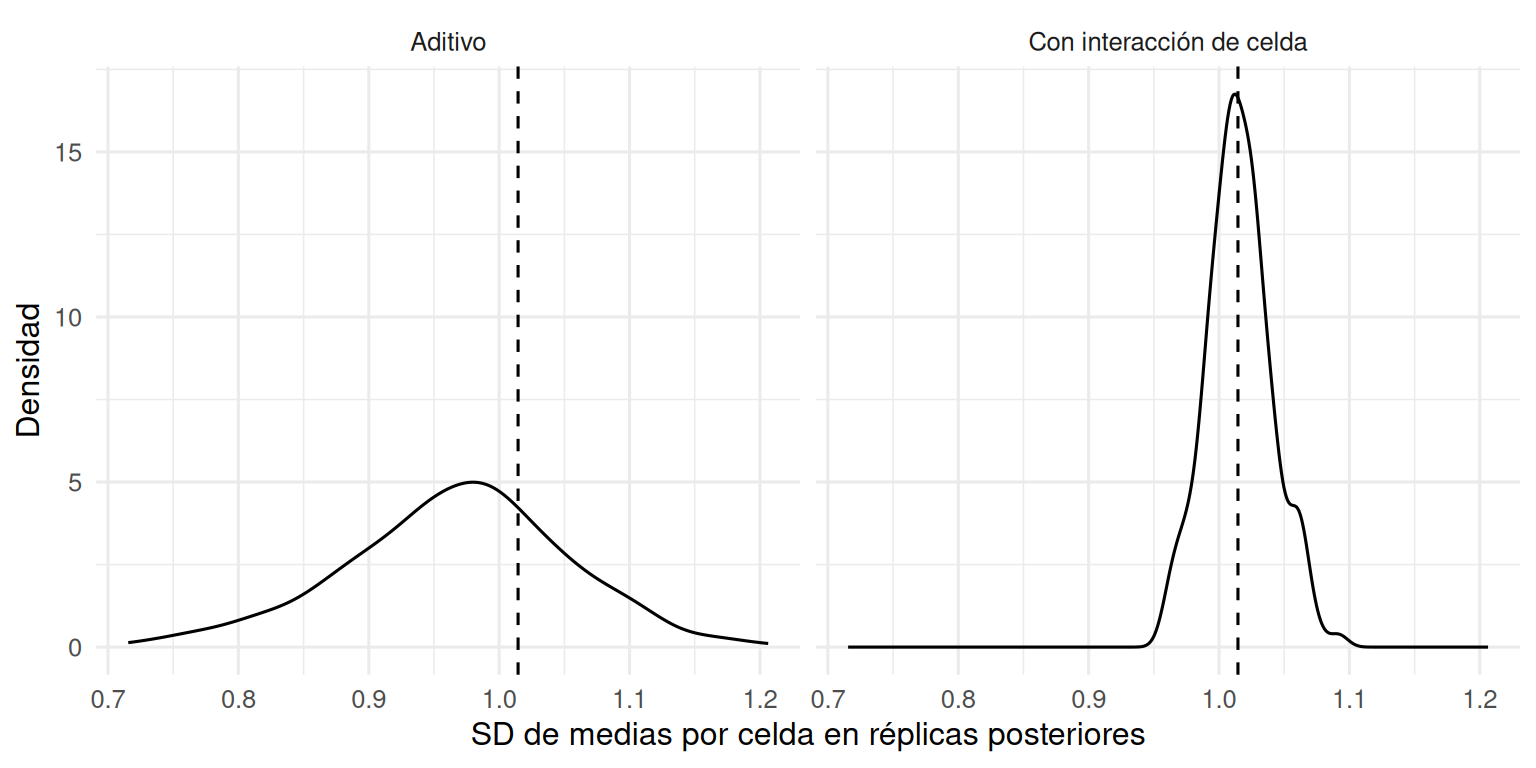
Una manera directa de investigar la necesidad de expansión es comparar comprobaciones predictivas sensibles a las celdas.
ggplot(ppc_celdas_machines_s5, aes(x = T_rep)) +geom_density() +geom_vline(xintercept = T_obs_machines_s5,linetype =2 ) +facet_wrap(~ modelo) +labs(x ="SD de medias por celda en réplicas posteriores",y ="Densidad" ) +theme_minimal(base_size =12)
Figura 5.10: Comprobación predictiva de la dispersión de medias trabajador–máquina bajo el modelo aditivo y el modelo con interacción de celda.
Esta comprobación no mide únicamente \(\tau_{WM}\). Su valor depende también de la heterogeneidad de trabajador y máquina y del número de réplicas por celda. Precisamente por eso es útil: pregunta si el modelo generativo completo reproduce una característica de la estructura observada.
5.14.6.2 Variación residual dentro de celdas
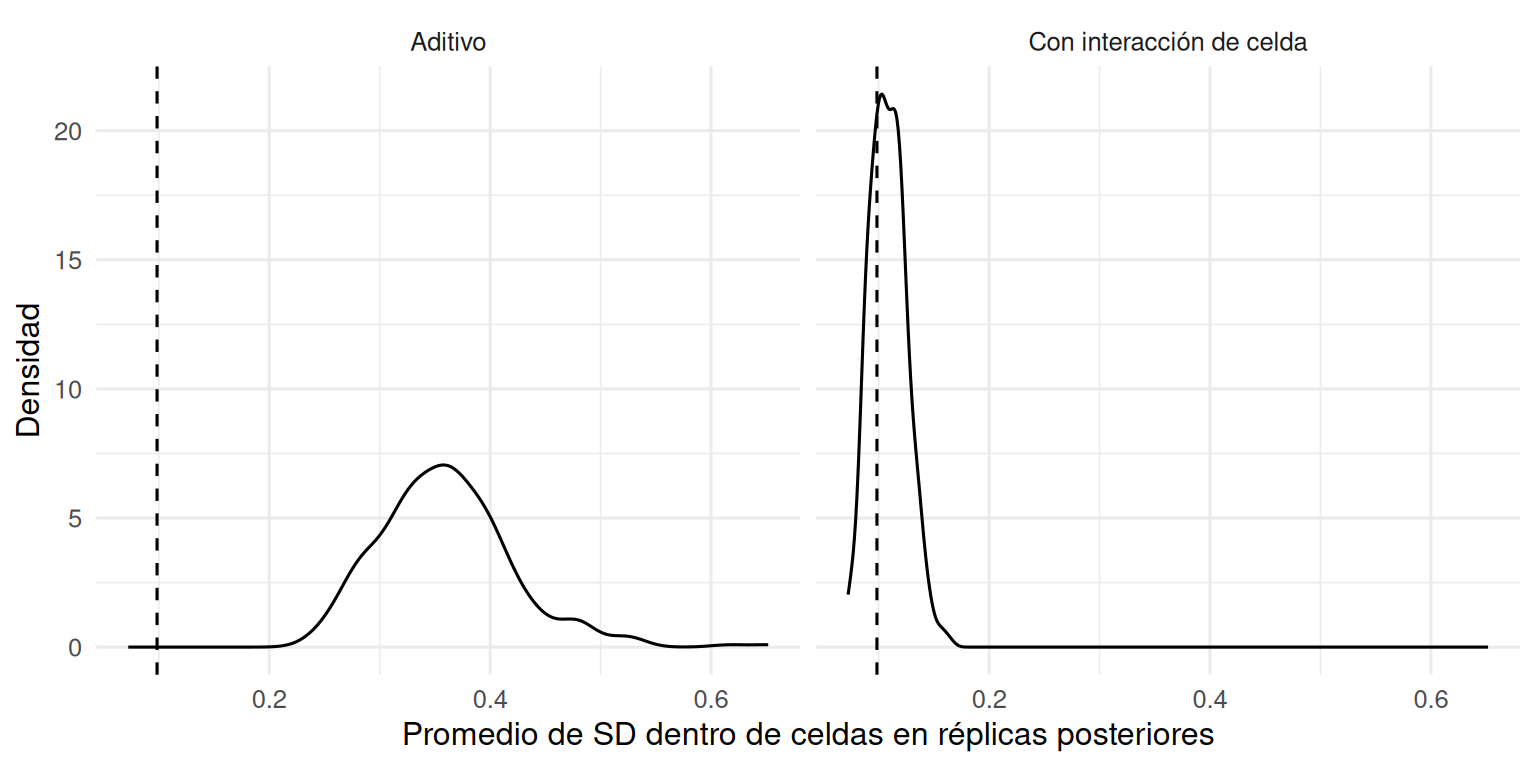
También podemos comprobar la variabilidad dentro de cada combinación trabajador–máquina.
ggplot(ppc_dentro_s5, aes(x = T_rep)) +geom_density() +geom_vline(xintercept = T_dentro_obs_s5,linetype =2 ) +facet_wrap(~ modelo) +labs(x ="Promedio de SD dentro de celdas en réplicas posteriores",y ="Densidad" ) +theme_minimal(base_size =12)
Figura 5.11: Comprobación predictiva de la variación media dentro de las celdas trabajador–máquina.
La combinación de ambas comprobaciones ayuda a distinguir una falta de ajuste en la dispersión entre celdas de una falta de ajuste en el ruido dentro de celdas.
Si sd_Machine__Intercept tiene una posterior más asimétrica o más amplia que otros componentes, debemos preguntar primero cuánta información contiene el diseño sobre una distribución de máquinas. No debemos concluir inmediatamente que Stan “no converge”.
5.15 Interacciones y predicción de combinaciones nuevas
El modelo jerárquico permite distinguir varias preguntas predictivas.
5.15.1 Nueva observación en una combinación observada
Para un trabajador \(j\) y una máquina \(k\) ya observados,
La predicción debe incorporar incertidumbre sobre una nueva desviación de celda.
5.15.3 Nuevo trabajador
Si el trabajador no fue observado,
\[
a_{\text{new}}
\sim
\mathcal N(0,\tau_W^2).
\]
La predicción depende de la inferencia de superpoblación, no de una desviación específica conocida.
Esta distinción muestra por qué la pregunta predictiva debe determinar qué componentes se integran y cuáles se condicionan. Más adelante, al estudiar validación cruzada, la unidad de exclusión deberá corresponder a esa misma pregunta.
5.16 Perspectiva frecuentista y terminología
En la literatura de modelos mixtos es frecuente describir \(a_j\), \(b_k\) y \(c_{jk}\) como efectos aleatorios, mientras que el intercepto general y otros coeficientes no agrupados se denominan efectos fijos. Esa terminología es importante para leer software y artículos, pero puede ocultar dos decisiones diferentes:
qué coeficientes varían entre unidades;
qué distribución utilizamos para describir esa variación.
En este curso preferiremos expresiones como interceptos variables, coeficientes variables y factores de agrupamiento, mencionando “efectos aleatorios” cuando sea útil para conectar con la literatura.
También es frecuente que la tradición frecuentista organice ANOVA mediante pruebas de componentes de varianza o pruebas \(F\) para efectos fijos. Esas herramientas no son el eje de nuestra estrategia. Nuestro interés principal es construir una distribución conjunta para las fuentes de variación, diagnosticar el ajuste, obtener cantidades posteriores interpretables y comprobar las implicaciones predictivas del modelo.
5.17 Errores frecuentes
5.17.1 1. Suponer que todo modelo multinivel debe poder dibujarse como un árbol
Los modelos cruzados son multinivel aunque la estructura de datos no tenga una única jerarquía.
5.17.2 2. Declarar anidamiento porque un factor tiene menos niveles
El número de niveles no define la relación. Anidamiento significa pertenencia unívoca.
5.17.3 3. Tratar como anidados factores que están cruzados
Forzar una jerarquía puede duplicar unidades artificialmente o atribuir dependencia a una estructura que los datos no tienen.
5.17.4 4. Confundir cruzamiento con interacción
Dos factores pueden estar cruzados y el predictor lineal seguir siendo aditivo. La interacción es una decisión adicional del modelo.
5.17.5 5. Ignorar un factor porque no es el foco sustantivo
Un evaluador, centro, lote o período puede ser una fuente importante de dependencia aunque no sea el objeto principal de la investigación.
5.17.6 6. Pensar que una desviación estándar cercana a cero elimina automáticamente el factor
Una posterior concentrada cerca de cero puede indicar poca heterogeneidad, pero una posterior amplia que incluye valores pequeños y grandes indica incertidumbre. Además, el diseño sustantivo puede justificar mantener el factor en la representación generativa.
5.17.7 7. Interpretar cualquier cociente de varianzas como “el ICC”
Con múltiples factores, la correlación entre observaciones depende de cuáles unidades comparten. Debe especificarse el par de observaciones al que se refiere el cociente.
5.17.8 8. Usar identificadores locales como si fueran globales
Si aula = 1 aparece en muchas escuelas, (1 | aula) agrupa todas esas aulas como si fueran la misma unidad. Debe crearse un identificador compuesto o usar escuela:aula.
5.17.9 9. Agregar una interacción de celda sin replicación y asumir que siempre puede separarse del residual
Con una sola observación por celda, la información para separar heterogeneidad de celda y ruido residual puede ser insuficiente.
5.17.10 10. Confundir pocos niveles con una falla del algoritmo
Pocos grupos pueden producir una posterior amplia para \(\tau\) aunque \(\widehat R\), ESS y las trazas sean adecuados.
adapt_delta puede ayudar con divergencias, pero no agrega información al diseño ni identifica un componente débilmente informado.
5.17.12 12. Resumir ANOVA únicamente con pruebas de significancia
Una fuente puede tener una magnitud pequeña pero estimada con precisión, o una magnitud potencialmente importante con gran incertidumbre. La distribución posterior comunica ambas dimensiones.
5.17.13 13. Interpretar la fuente de mayor desviación estándar como “la causa principal”
Los componentes de variación describen heterogeneidad bajo el modelo. No establecen causalidad por sí mismos.
5.17.14 14. Hacer una única comprobación predictiva marginal
Un modelo puede reproducir bien el histograma global de \(y\) y fallar en la dispersión entre evaluadores, escuelas o celdas.
5.17.15 15. Elegir una estructura solo porque produce el menor criterio escalar
La estructura de agrupamiento debe responder al proceso de generación, al diseño y a la pregunta predictiva. La comparación formal de modelos se desarrollará en la semana 14.
5.18 Síntesis
La semana puede resumirse mediante ocho ideas.
1. La dependencia se entiende mediante componentes compartidos.
En un modelo aditivo de interceptos variables, dos observaciones covarían porque reutilizan uno o más términos grupales.
2. Anidamiento y cruzamiento son propiedades de la pertenencia.
Una relación anidada admite una asignación unívoca del nivel inferior al superior. Una relación cruzada no.
3. Tres niveles generan varias correlaciones relevantes.
En estudiantes dentro de aulas dentro de escuelas, compartir aula induce más covarianza que compartir únicamente escuela.
4. Los modelos cruzados no necesitan ordenar los factores en una jerarquía ficticia.
Cada factor puede aportar directamente su propia población de coeficientes al predictor lineal.
5. Cruzamiento e interacción son conceptos distintos.
El primero describe el diseño; la segunda describe una desviación adicional de combinaciones específicas.
6. ANOVA puede entenderse como una organización de lotes de coeficientes.
Cada fuente tiene una distribución de coeficientes y una escala de heterogeneidad. La inferencia se concentra en magnitudes, incertidumbre y predicción, no solo en pruebas \(F\).
7. Superpoblación y población finita responden preguntas diferentes.
\(\tau_m\) describe una distribución generadora de niveles potenciales; \(s_m\) describe la dispersión posterior de los niveles observados.
8. La comprobación predictiva debe respetar la estructura del modelo.
Si el modelo contiene centros, personas, evaluadores o celdas, debemos comprobar características predictivas relacionadas con esas mismas fuentes.
5.19 Ejercicios
5.19.1 Ejercicios conceptuales
5.19.1.1 Ejercicio 1. Clasificar estructuras
Para cada situación, determine si la relación principal es anidada, cruzada, parcialmente cruzada o de pertenencia múltiple. Justifique en términos de pertenencia, no solo mediante el número de niveles.
Pacientes atendidos en un único hospital y hospitales pertenecientes a una única región.
Exámenes calificados por dos docentes, donde cada docente califica exámenes de todos los grupos.
Estudiantes que cambian de escuela durante un estudio longitudinal.
Productos fabricados por varias máquinas y revisados por varios inspectores.
Personas atendidas por equipos en los que tres profesionales contribuyen con porcentajes diferentes de tiempo.
Calcule la correlación entre dos estudiantes de la misma aula.
Calcule la correlación entre dos estudiantes de aulas distintas de la misma escuela.
Explique por qué llamar a una sola de esas cantidades “el ICC” sería ambiguo.
5.19.1.3 Ejercicio 3. Dos factores cruzados
Suponga
\[
y_i=\alpha+u_{p[i]}+v_{e[i]}+\varepsilon_i,
\]
con
\[
\tau_P=6,
\qquad
\tau_E=3,
\qquad
\sigma=5.
\]
Derive la correlación para los siguientes pares:
misma persona y mismo evaluador;
misma persona y evaluadores distintos;
personas distintas y mismo evaluador;
personas y evaluadores distintos.
Interprete cada resultado en términos de componentes compartidos.
5.19.1.4 Ejercicio 4. Cruzamiento versus interacción
Un experimento observa cinco tratamientos en ocho laboratorios, con varias réplicas por combinación.
Explique por qué tratamiento y laboratorio están cruzados.
Escriba un modelo aditivo con interceptos variables para tratamiento y laboratorio.
Escriba una expansión con desviaciones específicas tratamiento–laboratorio.
Explique qué nueva afirmación generativa introduce la interacción.
¿Qué cambiaría si hubiera una sola observación por combinación?
5.19.1.5 Ejercicio 5. Superpoblación y población finita
Un modelo contiene cuatro regiones observadas. Los interceptos regionales están estimados con mucha precisión, pero la posterior de \(\tau_{\text{región}}\) es amplia.
Explique por qué este resultado no es contradictorio. ¿Qué cantidad usaría para describir la dispersión de las cuatro regiones observadas? ¿Qué cantidad usaría para predecir una región nueva?
5.19.1.6 Ejercicio 6. Una jerarquía falsa
Una base contiene las variables escuela, aula y docente. Cada aula pertenece a una escuela, pero algunos docentes enseñan en varias escuelas.
Un analista propone
y ~1+ (1| escuela/aula/docente)
Discuta qué afirmación de pertenencia está imponiendo esa fórmula y proponga una representación más coherente con la descripción del diseño.
5.19.2 Ejercicios computacionales
5.19.2.1 Ejercicio 7. Omitir una fuente cruzada
Use datos_s5.
Ajuste un modelo que incluya solo (1 | persona).
Ajuste un modelo con (1 | centro) + (1 | persona).
Compare esos resultados con fit_s5_cruzado.
Examine cómo cambia la posterior de sigma y de las escalas grupales.
Realice una comprobación predictiva de la dispersión de medias por evaluador para los tres modelos.
Explique cuál patrón se relaciona directamente con la omisión del evaluador.
No utilice un criterio de información como única justificación.
5.19.2.2 Ejercicio 8. Reducir conectividad
Modifique el generador para que cada evaluador trabaje casi exclusivamente en un único centro, dejando solo unas pocas evaluaciones cruzadas entre centros.
Grafique la matriz centro–evaluador.
Ajuste el modelo completo.
Compare la incertidumbre posterior de \(\tau_C\) y \(\tau_E\) con la del diseño original.
Explique por qué la conectividad entre factores afecta la separación de fuentes de variación.
Distinga este problema de una divergencia de HMC.
5.19.2.3 Ejercicio 9. ANOVA jerárquico sin interacción
Use machines_s5.
Ajuste el modelo aditivo.
Obtenga réplicas posteriores.
Construya dos estadísticas predictivas: dispersión de medias por trabajador y dispersión de medias por máquina.
Determine si la ausencia de interacción se manifiesta necesariamente en esas dos estadísticas.
Proponga un estadístico predictivo más sensible a diferencias específicas trabajador–máquina.
5.19.2.4 Ejercicio 10. Población finita y superpoblación
Con fit_machines_anova_s5:
extraiga la posterior de sd_Machine__Intercept;
calcule, en cada dibujo posterior, la desviación estándar de los coeficientes de las máquinas observadas;
grafique ambas distribuciones;
explique por qué difieren en incertidumbre;
discuta cuál de las dos sería más relevante si el objetivo fuera comparar únicamente las máquinas del experimento y cuál si se quisiera generalizar a máquinas nuevas.
5.19.2.5 Ejercicio 11. Sin replicación por celda
A partir de machines_s5, seleccione aleatoriamente una sola observación por combinación Worker–Machine.
Intente ajustar un modelo con (1 | Worker) + (1 | Machine) + (1 | cell).
Examine las posteriores de sd_cell__Intercept y sigma.
Compare con el ajuste que utiliza todas las réplicas.
Explique qué información desapareció al eliminar la replicación.
Discuta si una previa más fuerte puede regularizar el problema y por qué eso no equivale a recuperar información observacional perdida.
5.20 Referencias de la semana
Las referencias principales para esta semana son:
Gelman y Hill, secciones 11.3 y 13.5 para estructuras no anidadas, y capítulo 22 para ANOVA multinivel (Gelman y Hill 2007).
McElreath, sección 13.3 para más de un tipo de agrupamiento y pooling parcial simultáneo (McElreath 2020).
Hox, Moerbeek y van de Schoot, sección 2.3 para tres niveles y capítulo 9 para clasificación cruzada (Hox et al. 2018).
Gelman et al., secciones 15.6–15.7 para la formulación de ANOVA mediante lotes de coeficientes y componentes de variación (Gelman et al. 2013).
Bürkner para la formulación e implementación de modelos multinivel en brms(Bürkner 2017).
Gelman et al. para la integración de previas, comprobación predictiva y expansión de modelos dentro de un flujo bayesiano (Gelman et al. 2026).
Bürkner, Paul-Christian. 2017. “Brms: An r Package for Bayesian
Multilevel Models Using Stan.”Journal of Statistical
Software 80 (1): 1–28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, John B. Carlin, Hal S. Stern, David B. Dunson, Aki
Vehtari, and Donald B. Rubin. 2013. Bayesian Data Analysis. 3rd
ed. Chapman & Hall/CRC.
Gelman, Andrew, and Jennifer Hill. 2007. Data Analysis Using
Regression and Multilevel/Hierarchical Models. Cambridge University
Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026.
Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, and Rens van de Schoot. 2018.
Multilevel Analysis: Techniques and Applications. 3rd ed.
Routledge.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course
with Examples in r and Stan. 2nd ed. Chapman & Hall/CRC.