4Semana 4. Pendientes variables e interacciones entre niveles
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
31 de agosto de 2026
4.1 Panorama de la semana
En las semanas anteriores construimos el modelo multinivel de manera progresiva. Primero identificamos la dependencia inducida por el agrupamiento y contrastamos pooling completo, ausencia de pooling y pooling parcial. Después permitimos que el intercepto variara entre grupos, lo que condujo al ICC y al shrinkage. En la semana 3 incorporamos predictores individuales y grupales y separamos explícitamente asociaciones dentro y entre grupos mediante centrado y descomposición.
Hasta ahora, sin embargo, hemos mantenido una restricción fuerte: una vez fijado el predictor individual, la asociación dentro de los grupos se ha supuesto igual para todos ellos. Por ejemplo, en la aplicación de rendimiento matemático escribimos
donde el intercepto \(\alpha_j\) cambia entre escuelas, pero \(\beta_W\) es común a todas.
Esta semana retiramos esa restricción. La pregunta central es:
¿Qué ocurre cuando la asociación entre una respuesta y un predictor cambia entre grupos?
Gelman y Hill presentan los modelos con interceptos y pendientes variables como la extensión natural del modelo de interceptos variables y subrayan que una pendiente variable puede verse como una interacción entre un predictor continuo y los indicadores de grupo (Gelman y Hill 2007, 237-38, 279-83). McElreath desarrolla la misma idea desde una perspectiva generativa: interceptos y pendientes se conciben como realizaciones conjuntas de una población de coeficientes y el pooling ocurre simultáneamente en ambas dimensiones (McElreath 2020, 437-46).
El paso adicional de esta semana será preguntar si parte de la heterogeneidad de pendientes puede explicarse mediante características observadas de los grupos. Esa pregunta conduce a las interacciones entre niveles.
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
escribir un modelo gaussiano con interceptos y pendientes variables en forma jerárquica y en forma de componentes;
distinguir la pendiente poblacional promedio \(\mu_\beta\) de las pendientes específicas \(\beta_j\);
interpretar \(\tau_\alpha\), \(\tau_\beta\), \(\rho\) y \(\sigma\) sin confundir variación entre grupos con incertidumbre posterior;
representar la matriz de covarianza grupal como \(\Sigma=D R D\) y explicar por qué esa factorización separa escalas y correlaciones;
explicar cómo el pooling parcial se extiende de una a dos dimensiones cuando interceptos y pendientes covarían;
demostrar por qué la correlación entre interceptos y pendientes depende del punto de referencia del predictor;
derivar cómo cambia la varianza entre grupos a lo largo del eje del predictor;
explicar por qué, con pendientes variables, la correlación inducida entre observaciones del mismo grupo ya no se resume mediante un único ICC constante;
distinguir una interacción convencional, una pendiente variable y una interacción entre niveles;
formular una interacción entre niveles como un modelo para la pendiente grupal y obtener la ecuación combinada por sustitución;
interpretar una interacción entre niveles como heterogeneidad sistemática de la pendiente, sin confundirla con la heterogeneidad residual \(\tau_\beta\);
reconocer cuándo una pendiente variable está débilmente identificada debido a poca variación del predictor dentro de los grupos;
justificar por qué normalmente una pendiente variable se acompaña de un intercepto variable y reconocer excepciones sustantivas;
especificar previas explícitas para medias poblacionales, desviaciones estándar grupales, correlación y desviación estándar residual;
realizar una comprobación predictiva previa sobre familias de líneas grupales;
ajustar modelos de pendientes variables en brms usando cmdstanr, diagnosticar el muestreo y realizar comprobaciones predictivas sensibles a la heterogeneidad de pendientes;
distinguir predicción para un grupo observado de predicción para un grupo nuevo;
proponer, para el proyecto del curso, qué coeficientes deberían variar entre grupos y qué variables grupales podrían explicar parte de esa variación.
4.2 Problema motivador: ¿todas las escuelas tienen la misma pendiente?
Retomemos los datos de estudiantes agrupados en escuelas. En la semana 3 usamos
\[
SES^W_{ij}
=
SES_{ij}-\overline{SES}_j
\]
para representar la posición socioeconómica relativa de un estudiante dentro de su escuela. Un modelo con pendiente común es
La interpretación de \(\beta_W\) es clara: para dos estudiantes de la misma escuela, una unidad de diferencia en SES está asociada con \(\beta_W\) unidades de diferencia esperada en rendimiento.
Pero el modelo hace una afirmación adicional que a veces pasa inadvertida:
\[
\boxed{
\text{la misma pendiente }\beta_W\text{ se aplica a todas las escuelas.}
}
\]
Esa restricción podría ser razonable. También podría ser demasiado fuerte. El gradiente socioeconómico dentro de una escuela podría cambiar con su organización, composición, recursos, políticas o cualquier otra característica que modifique la relación entre SES individual y rendimiento.
Esta es la estructura básica de Gelman y Hill en su modelo (13.1) (Gelman y Hill 2007, 279-80). McElreath la presenta como una población conjunta de interceptos y pendientes cuyo modelo regulariza simultáneamente ambos coeficientes y la relación entre ellos (McElreath 2020, 441-43).
Los parámetros tienen papeles diferentes:
Parámetro
Interpretación
\(\alpha_j\)
intercepto del grupo \(j\) en el punto \(x=0\)
\(\beta_j\)
pendiente del predictor en el grupo \(j\)
\(\mu_\alpha\)
intercepto promedio en la población de grupos
\(\mu_\beta\)
pendiente promedio en la población de grupos
\(\tau_\alpha\)
desviación estándar entre interceptos
\(\tau_\beta\)
desviación estándar entre pendientes
\(\rho\)
correlación poblacional entre interceptos y pendientes
\(\sigma\)
desviación estándar residual dentro de los grupos
NotaVariabilidad e incertidumbre siguen siendo conceptos distintos
Una posterior amplia para \(\tau_\beta\) significa que tenemos incertidumbre sobre la magnitud de la heterogeneidad de pendientes. Una posterior concentrada en un valor grande de \(\tau_\beta\) significa que aprendimos con relativa precisión que las pendientes difieren sustancialmente.
4.3.1 Forma de componentes
Es útil separar medias poblacionales y desviaciones grupales:
Esta expresión muestra algo importante: la contribución grupal ya no es una constante \(u_{0j}\). Es
\[
\boxed{
u_{0j}+u_{1j}x_{ij}},
\]
y por tanto cambia con el valor de \(x\).
4.4 La distribución conjunta de coeficientes
Una forma especialmente útil de escribir la matriz de covarianza es
\[
\boxed{
\Sigma=D R D
}
\]
con
\[
D
=
\begin{pmatrix}
\tau_\alpha&0\\
0&\tau_\beta
\end{pmatrix},
\]
y
\[
R
=
\begin{pmatrix}
1&\rho\\
\rho&1
\end{pmatrix}.
\]
La factorización separa dos preguntas:
¿cuánto varían los interceptos y las pendientes? Esto lo describen \(\tau_\alpha\) y \(\tau_\beta\);
¿cómo se asocian ambos tipos de coeficiente? Esto lo describe \(R\) y, en dos dimensiones, \(\rho\).
Esta descomposición es la que utiliza McElreath para construir el modelo de pendientes variables (McElreath 2020, 441-43) y coincide con la parametrización moderna de coeficientes grupales descrita para brms, donde las matrices de covarianza se expresan mediante desviaciones estándar y una matriz de correlación (Bürkner 2017, 3-4). Bayesian Workflow emplea la misma factorización al desarrollar un modelo de interceptos y pendientes variables para el estudio de privación de sueño (Gelman et al. 2026, 281-84).
4.4.1 ¿Qué significa \(\rho\)?
Si \(\rho>0\), grupos con interceptos relativamente altos tienden a tener pendientes relativamente altas.
Si \(\rho<0\), grupos con interceptos relativamente altos tienden a tener pendientes relativamente bajas.
Si \(\rho\approx0\), conocer el intercepto de un grupo aporta poca información lineal sobre su pendiente dentro de la población modelada.
La palabra tienden es esencial. \(\rho\) describe una distribución de grupos; no impone una relación determinista.
4.4.2 Geometría de la población de líneas
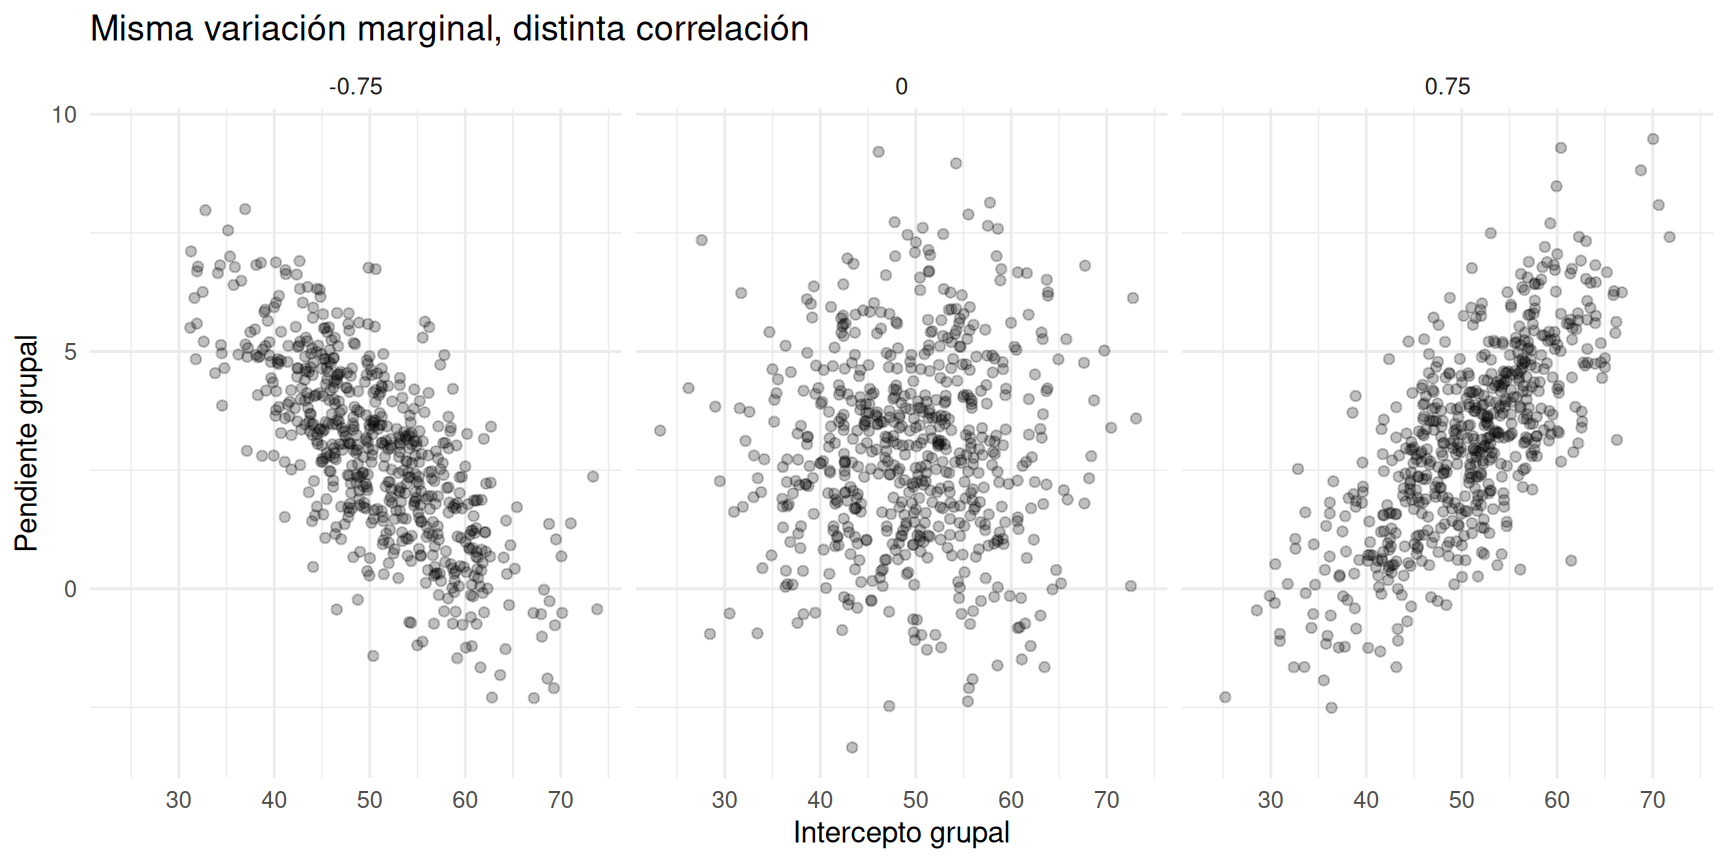
En dos dimensiones, la distribución de \((\alpha_j,\beta_j)\) puede visualizarse como una nube elíptica. Una correlación positiva inclina la nube hacia arriba; una correlación negativa la inclina hacia abajo. La magnitud de \(\tau_\alpha\) y \(\tau_\beta\) determina sus escalas horizontales y verticales.
El siguiente gráfico es puramente geométrico y no depende de un ajuste.
Figura 4.1: Distribuciones bivariadas hipotéticas de interceptos y pendientes para tres valores de correlación. Las escalas marginales son las mismas; solo cambia la asociación entre ambos coeficientes.
4.5 La correlación intercepto–pendiente depende del origen de \(x\)
La interpretación de \(\rho\) exige especial cuidado. Gelman y Hill muestran un ejemplo de regresiones de ingreso sobre estatura donde una correlación extremadamente negativa entre interceptos y pendientes aparece en buena medida porque el intercepto se define en una estatura igual a cero, muy lejos del rango observado. Al reescalar el predictor, la correlación se vuelve mucho más interpretable (Gelman y Hill 2007, 287-89). Hox et al. también muestran que centrar un predictor con pendiente variable cambia la varianza del intercepto, aunque el modelo lineal resultante pueda ser equivalente en ajuste (Hox et al. 2018, 49-50).
La misma familia de rectas puede tener una correlación intercepto–pendiente muy diferente solo porque movimos el punto \(x=0\).
ImportanteUna correlación de coeficientes no es invariante al centrado
Antes de interpretar \(\rho\) sustantivamente, pregunte:
¿qué significa \(x=0\)?;
¿está dentro del rango observado?;
¿sería más clara una referencia como la media global, la media del grupo, el inicio de seguimiento o una dosis clínicamente relevante?
Una correlación extrema puede ser una consecuencia geométrica de un origen poco útil, no necesariamente una relación sustantiva extrema entre procesos.
4.6 La heterogeneidad entre grupos cambia a lo largo de \(x\)
Con interceptos variables, la desviación entre dos grupos era paralela en todo el eje \(x\). Con pendientes variables, la separación entre grupos depende de \(x\).
es la varianza entre las medias de grupo en el valor \(x\).
Varias consecuencias son inmediatas:
\(\tau_\alpha^2\) es la varianza entre grupos en\(x=0\);
\(\tau_\beta^2\) controla cuánto cambia la heterogeneidad al alejarnos del origen;
\(\rho\) determina si inicialmente la dispersión entre grupos aumenta o disminuye al movernos en una dirección del eje;
el punto de centrado del predictor determina dónde se interpreta directamente \(\tau_\alpha\).
Esta es otra razón para no considerar el centrado una operación cosmética.
4.7 ¿Qué ocurre con el ICC?
En la semana 2, con un único intercepto variable, dos observaciones distintas del mismo grupo tenían covarianza \(\tau_\alpha^2\) y el ICC era constante:
Con una pendiente variable, dos observaciones del mismo grupo tomadas en \(x\) y \(x'\) comparten tanto \(u_{0j}\) como \(u_{1j}\). Su covarianza condicional en los valores de los predictores es
NotaNo siempre existe un único ICC que resuma la dependencia
Una vez que la estructura grupal incluye pendientes variables, la similitud entre observaciones del mismo grupo puede depender de sus valores del predictor. El ICC del modelo nulo sigue siendo útil como punto de partida, pero ya no resume toda la estructura de dependencia del modelo ampliado.
4.8 Pooling parcial en dos dimensiones
En un modelo de interceptos variables, cada \(\alpha_j\) se regulariza hacia \(\mu_\alpha\). Con pendientes variables, el objeto que se regulariza es el vector
información de las observaciones del propio grupo;
la distribución poblacional de interceptos;
la distribución poblacional de pendientes;
la correlación entre ambos tipos de coeficiente.
McElreath muestra este mecanismo como shrinkage en dos dimensiones: una pendiente extrema puede contraerse hacia el centro de la población y, si interceptos y pendientes están correlacionados, esa contracción puede ir acompañada de un desplazamiento del intercepto (McElreath 2020, 444-46). Bayesian Workflow ilustra el mismo fenómeno comparando regresiones independientes por persona con los coeficientes obtenidos por un modelo multinivel conjunto de interceptos y pendientes (Gelman et al. 2026, 283-84).
El pooling no tiene por qué ser igualmente fuerte para intercepto y pendiente. Un grupo puede informar bien su nivel medio pero muy poco su gradiente si el predictor casi no varía dentro del grupo.
4.9 Pendientes variables como interacciones
Gelman y Hill señalan una equivalencia conceptual útil: una pendiente variable es una interacción entre el predictor \(x\) y la identidad del grupo (Gelman y Hill 2007, 237-38).
Si tuviéramos \(J\) grupos y usáramos indicadores \(I(g=j)\), un modelo sin pooling podría escribirse con interacciones
\[
x_i I(g_i=j).
\]
Esto produciría una pendiente separada para cada grupo. El modelo multinivel reemplaza esa colección de coeficientes independientes por una distribución poblacional que permite pooling parcial.
Por tanto, los modelos de pendientes variables pueden verse como máquinas de interacciones parcialmente agrupadas: permiten que el efecto de \(x\) cambie con el grupo, pero regularizan esos cambios mediante una estructura común.
La asociación de \(x\) cambia sistemáticamente con \(z\).
4.10.2 Pendiente variable
En un modelo multinivel,
\[
\beta_j
=
\mu_\beta+u_{1j},
\]
\[
u_{1j}
\sim
\mathcal N(0,\tau_\beta^2).
\]
Reconocemos que la asociación entre \(x\) y la respuesta puede diferir entre grupos. En este modelo, esas diferencias se representan mediante \(u_{1j}\), pero no se atribuyen todavía a características observadas de los grupos.
4.10.3 Interacción entre niveles
Sea \(x_{ij}\) un predictor individual y \(z_j\) un predictor grupal. Modelamos la pendiente como
Ahora \(\gamma_{11}\) describe una parte sistemática de la heterogeneidad de pendientes. La parte que no queda explicada por \(z_j\) permanece en \(u_{1j}\).
Hox et al. recomiendan construir el modelo en ecuaciones por nivel y luego sustituir para hacer explícita la interacción entre niveles (Hox et al. 2018, 25-26). Gelman y Hill muestran que un predictor grupal puede entrar en los modelos tanto del intercepto como de la pendiente (Gelman y Hill 2007, 281-83, 379-80).
ImportanteUna interacción entre niveles no elimina automáticamente las pendientes variables
Si incluimos \(x_{ij}z_j\) y mantenemos \(u_{1j}\), estamos diciendo que \(z_j\) explica parte de la heterogeneidad de pendientes y que todavía puede quedar heterogeneidad residual.
Eliminar \(u_{1j}\) impondría la afirmación más fuerte de que, condicional en \(z_j\), todas las diferencias de pendiente entre grupos han desaparecido.
4.12 Cómo interpretar la interacción
En presencia de una interacción, los coeficientes principales son condicionales. Hox et al. enfatizan que los términos que forman una interacción deben interpretarse conjuntamente y que el valor cero de los predictores determina la interpretación de los efectos principales (Hox et al. 2018, 49, 52-53).
\(\gamma_{00}\): media esperada cuando \(x=0\) y \(z=0\);
\(\gamma_{01}\): asociación con \(z\) cuando \(x=0\);
\(\gamma_{10}\): asociación con \(x\) cuando \(z=0\);
\(\gamma_{11}\): cambio en la pendiente de \(x\) por una unidad de cambio en \(z\).
Por eso el centrado es especialmente importante. Si \(z_j\) está centrado en su media,
\[
z_j^*=z_j-\bar z,
\]
entonces \(\gamma_{10}\) representa la pendiente de \(x\) para un grupo con valor promedio de \(z\).
Si \(x_{ij}\) está centrado por grupo, entonces \(x=0\) representa una unidad situada en la media de su propio grupo, y el término \(\gamma_{01}\) compara grupos para unidades en esa posición relativa.
4.13 ¿Puede variar la pendiente sin variar el intercepto?
Gelman y Hill advierten que, en la mayoría de aplicaciones, si hay razones para permitir que una pendiente cambie entre grupos también suele haber razones para permitir que el intercepto cambie (Gelman y Hill 2007, 283-84). Un modelo
obliga a todas las rectas a atravesar exactamente el mismo punto cuando \(x=0\).
Esa restricción puede ser poco plausible.
Sin embargo, no es imposible que tenga sentido. Gelman y Hill dan como ejemplo una colección de experimentos con una condición control verdaderamente común y tratamientos que sí varían entre experimentos. En ese caso, fijar el intercepto y permitir variación en el efecto del tratamiento puede ser una representación razonable (Gelman y Hill 2007, 283-84).
La regla práctica no debe ser “siempre incluya un intercepto variable”, sino:
pregunte qué igualdad sustantiva está imponiendo al fijar el intercepto y si esa igualdad es defendible.
4.14 Información para estimar una pendiente grupal
La estimación de una pendiente depende de disponer de observaciones en distintos valores del predictor. Para el grupo \(j\), una medida básica de la información disponible sobre la pendiente es
En una regresión lineal simple con \(\sigma\) conocida, la desviación estándar del estimador de la pendiente es proporcional a
\[
\frac{\sigma}{\sqrt{S_{xx,j}}}.
\]
Esta expresión no corresponde a la distribución posterior del modelo jerárquico, pero resume una característica estructural que continúa siendo relevante:
un mayor número de observaciones puede aumentar la información disponible para estimar la pendiente;
una mayor dispersión de \(x\) dentro del grupo aumenta la información sobre la pendiente;
un mayor ruido residual reduce la precisión con que puede estimarse;
muchas observaciones concentradas en valores muy similares de \(x\) pueden proporcionar bastante información sobre el nivel medio del grupo, pero poca sobre su pendiente.
El pooling parcial utiliza información de la población de grupos para regularizar las estimaciones grupales, pero no puede compensar completamente la ausencia de variación del predictor dentro de un grupo. Si el diseño observado ofrece poco contraste en \(x\), la pendiente específica de ese grupo estará determinada en mayor medida por la estructura jerárquica y presentará mayor incertidumbre.
4.15 Pocos grupos y correlaciones difíciles
\(\tau_\beta\) y, especialmente, \(\rho\) son propiedades de una población de grupos. Si hay pocos grupos, su posterior puede quedar muy influida por la previa y ser amplia. Además, estimar una correlación requiere aprender simultáneamente dos varianzas y una covarianza.
Esto no significa que exista un número mínimo universal de grupos. La información depende del diseño, de los tamaños de grupo, de la variación de los predictores, de la magnitud de las heterogeneidades y de las previas. La simulación generativa es una forma más adecuada de estudiar un diseño concreto que aplicar una regla rígida de tamaño muestral.
AdvertenciaIdentificación débil no es lo mismo que un problema de MCMC
Una posterior amplia de \(\tau_\beta\) o \(\rho\) puede reflejar que los datos contienen poca información. Una divergencia de HMC es, en cambio, una señal computacional sobre la exploración de la posterior.
Ambos problemas pueden aparecer juntos, pero no deben diagnosticarse como si fueran lo mismo. La semana 7 desarrollará esta distinción con mayor detalle.
4.16 Previas para interceptos, pendientes y correlaciones
El modelo introduce nuevos parámetros y, por tanto, nuevas decisiones de escala.
No existe una elección universal de las escalas \(s\). Deben relacionarse con la unidad de la respuesta y con las escalas de los predictores.
4.16.1 Previa LKJ
En dos dimensiones,
\[
R
=
\begin{pmatrix}
1&\rho\\
\rho&1
\end{pmatrix}.
\]
McElreath usa \(LKJ(2)\) como una previa regularizadora que reduce plausibilidad de correlaciones extremas (McElreath 2020, 442-43). Bayesian Workflow señala que \(LKJ(1)\) es uniforme sobre matrices de correlación y, en el caso bidimensional, induce una marginal uniforme sobre \(\rho\); para \(\eta>1\) la densidad se concentra más cerca de la identidad (Gelman et al. 2026, 282-83).
Para una matriz \(2\times2\), la densidad marginal es proporcional a
\(\eta=1\) no favorece un valor particular de \(\rho\) en dos dimensiones;
\(\eta>1\) regulariza hacia correlaciones moderadas;
valores muy grandes de \(\eta\) pueden imponer una regularización demasiado fuerte si la correlación es sustantivamente importante.
La semana 6 estudiará las previas de forma sistemática. Aquí nos interesa que las previas produzcan familias de rectas plausibles antes de observar los datos.
4.17 Comprobación predictiva previa para una familia de líneas
En un modelo de pendiente fija, una comprobación previa puede concentrarse en el rango de \(y\). Con pendientes variables debemos revisar también:
cuánta dispersión hay entre interceptos;
cuánta dispersión hay entre pendientes;
si aparecen líneas con gradientes absurdamente grandes;
si la correlación genera familias de rectas plausibles;
si las predicciones explotan en los extremos del rango de \(x\).
Bayesian Workflow recomienda evaluar conjuntamente las implicaciones de las previas mediante simulación predictiva, no parámetro por parámetro de manera aislada (Gelman et al. 2026, 89-96, 275-84).
En el laboratorio haremos esta comprobación mediante simulación directa desde las previas antes de ajustar el modelo.
4.18 Laboratorio reproducible en R
El laboratorio sigue una secuencia generativa:
simular una población de grupos con interceptos y pendientes correlacionados;
observar que los grupos aportan cantidades distintas de información sobre sus pendientes;
inspeccionar las implicaciones de las previas antes del ajuste;
comparar un modelo con pendiente común con un modelo de pendientes variables;
visualizar shrinkage simultáneo en interceptos y pendientes;
comprobar empíricamente que la correlación intercepto–pendiente cambia al mover el origen de \(x\);
realizar una comprobación predictiva específicamente sensible a la dispersión de pendientes.
4.18.1 Simular una población de grupos
Usaremos \(J=30\) grupos con tamaños diferentes. El proceso generador tendrá
\[
\mu_\alpha=50,
\qquad
\mu_\beta=3,
\]
\[
\tau_\alpha=8,
\qquad
\tau_\beta=2,
\]
\[
\rho=-0.60,
\qquad
\sigma=6.
\]
Además, permitiremos que la dispersión de \(x\) sea distinta entre grupos. Esto hace que algunos grupos informen mucho mejor su pendiente que otros.
La correlación observada entre los 30 pares simulados no tiene por qué ser exactamente \(-0.60\): los grupos son una muestra finita de la población generadora.
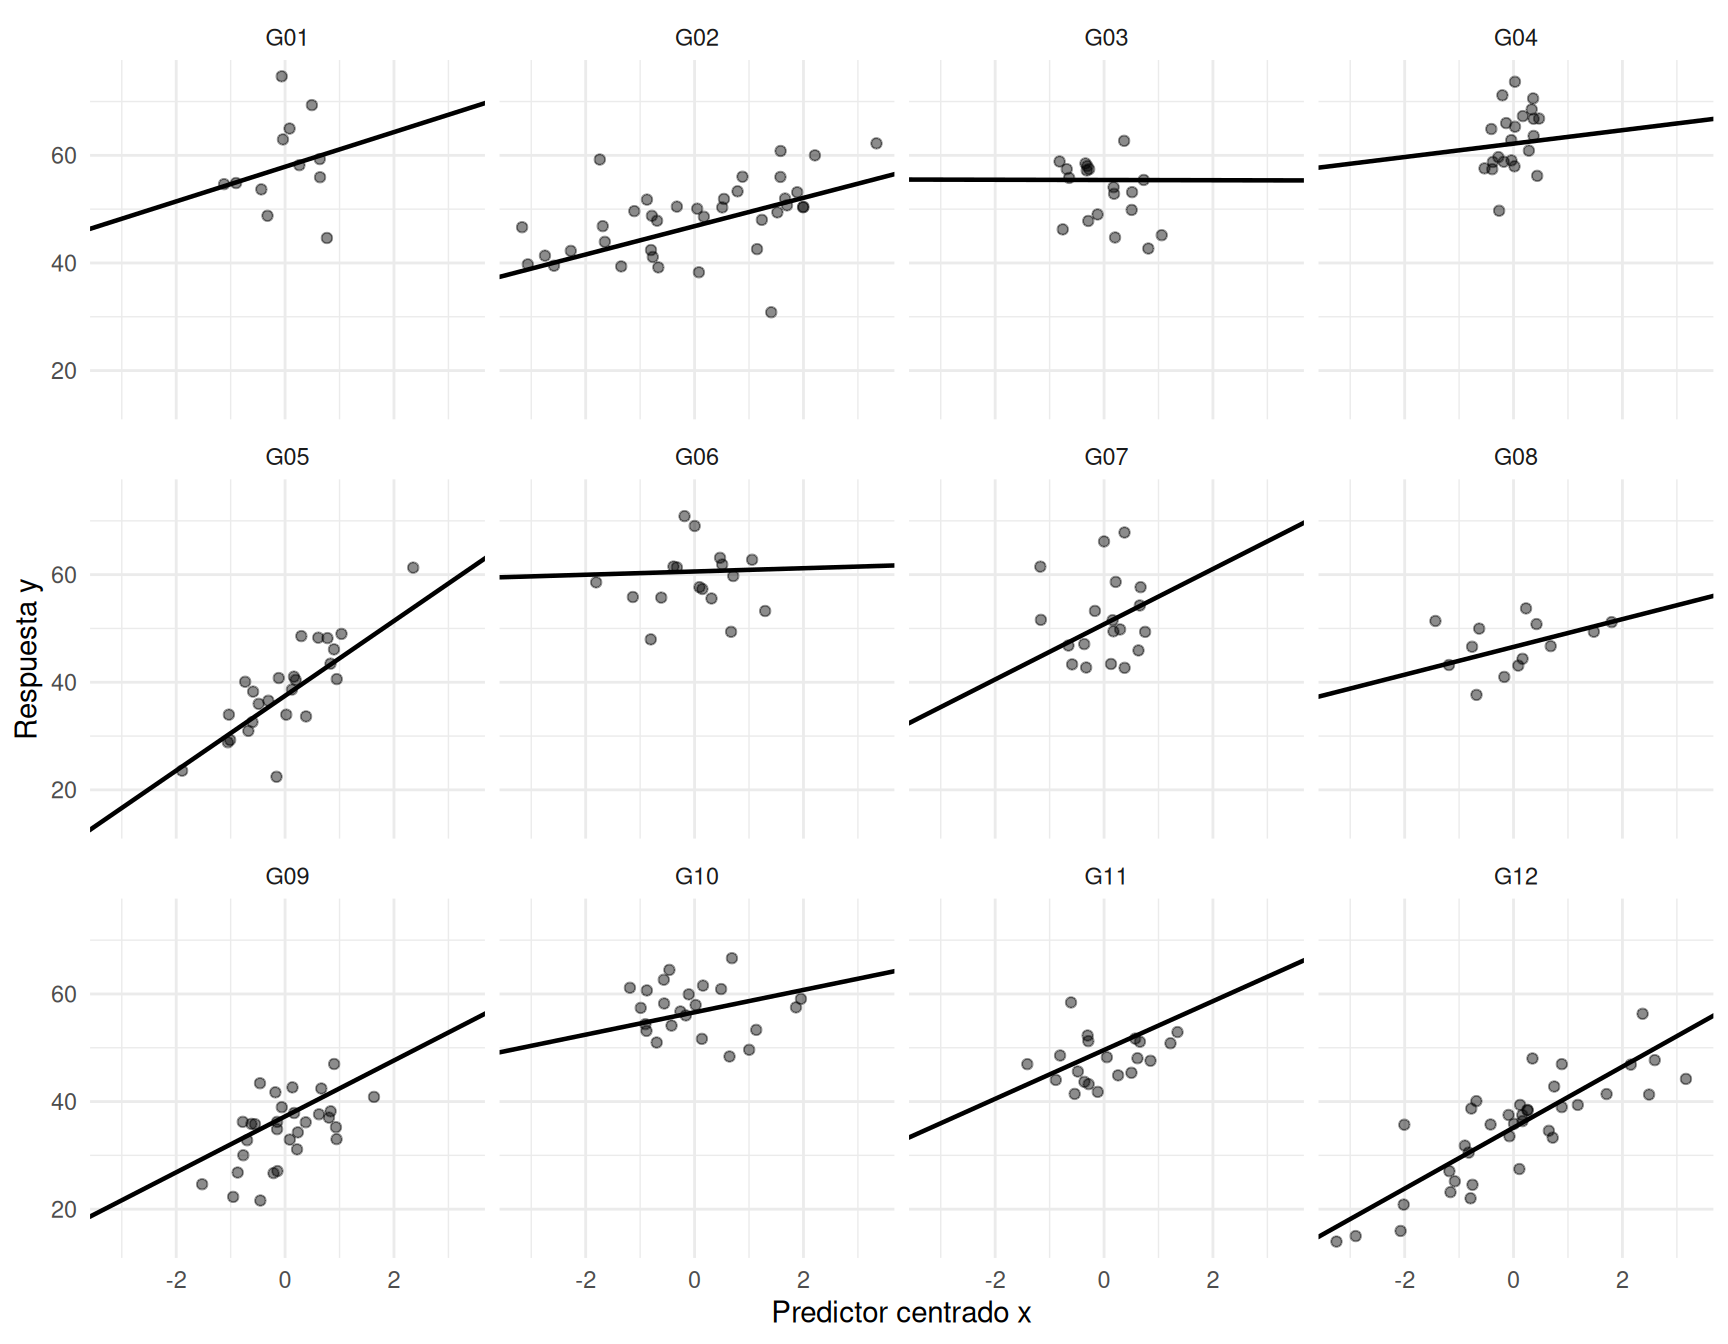
Generamos ahora las observaciones. Dentro de cada grupo hacemos que la media empírica de \(x\) sea exactamente cero para que el intercepto tenga una interpretación simple: respuesta esperada en la posición media del predictor dentro del grupo.
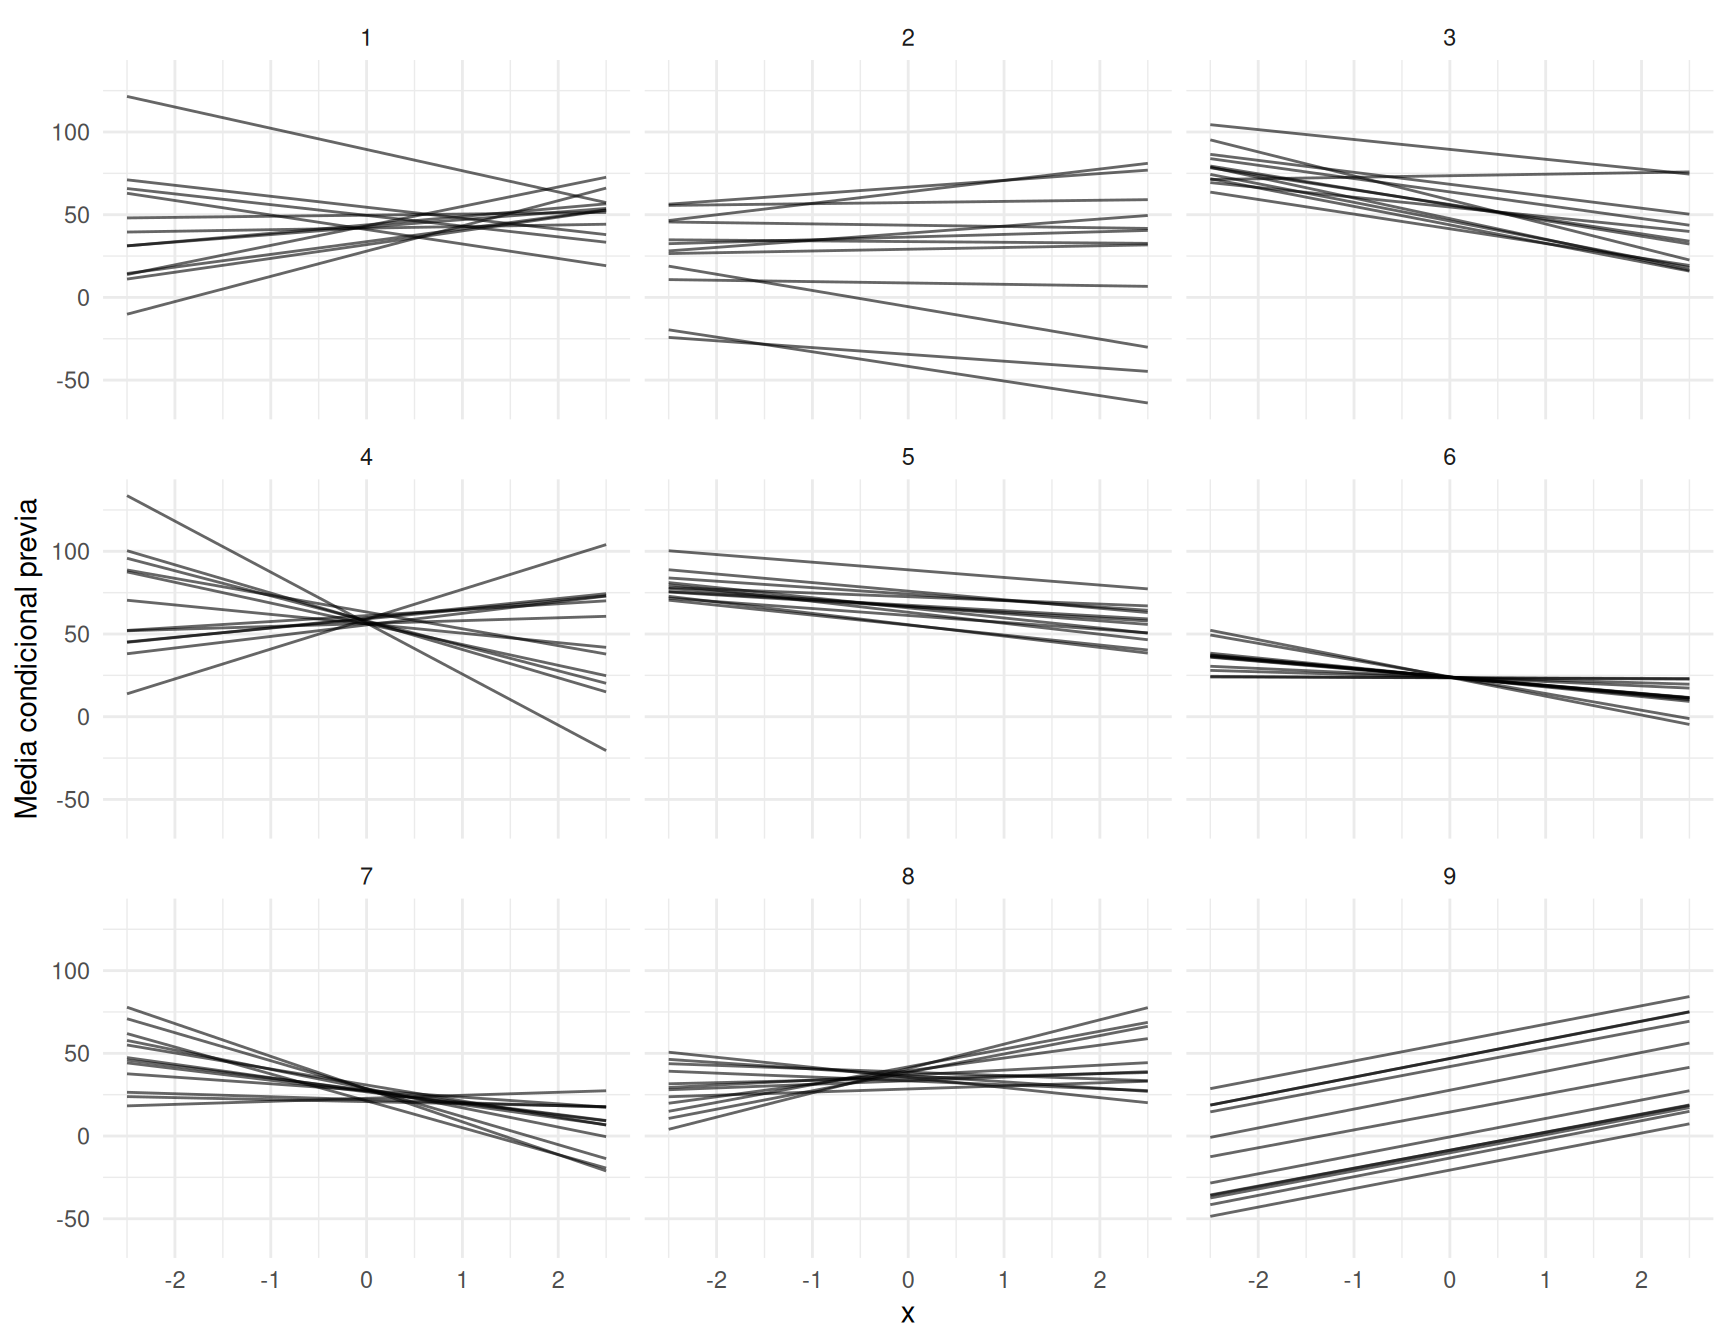
Figura 4.3: Nueve familias de líneas simuladas desde las previas. La comprobación predictiva previa permite evaluar simultáneamente niveles, pendientes, heterogeneidad y correlación antes de usar los datos.
Este gráfico debe leerse como una pregunta científica: ¿son plausibles familias de rectas de esta magnitud en la escala del problema? Si la respuesta fuera no, deberíamos modificar las previas antes de observar la posterior.
4.18.4 Ajustar pendiente común y pendientes variables
Primero ajustamos un modelo que comparte una única pendiente:
\[
\mu_{ij}=\alpha_j+\beta x_{ij}.
\]
prior_sim_fija <-c(prior(normal(50, 15), class ="Intercept"),prior(normal(0, 6), class ="b", coef ="x"),prior(normal(0, 12), class ="sd", group ="grupo"),prior(normal(0, 10), class ="sigma"))fit_sim_fija <-brm( y ~1+ x + (1| grupo),data = sim,family =gaussian(),prior = prior_sim_fija,chains =4,iter =2000,warmup =1000,seed =1653,backend ="cmdstanr",control =list(adapt_delta =0.95),file ="_fits/semana04_sim_pendiente_fija",file_refit ="on_change",refresh =0)
Running MCMC with 4 parallel chains...

Chain 4 finished in 2.5 seconds.
Chain 1 finished in 2.8 seconds.
Chain 2 finished in 2.8 seconds.
Chain 3 finished in 3.2 seconds.

All 4 chains finished successfully.
Mean chain execution time: 2.8 seconds.
Total execution time: 3.3 seconds.
Luego permitimos que la pendiente cambie entre grupos:
prior_sim_var <-c(prior(normal(50, 15), class ="Intercept"),prior(normal(0, 6), class ="b", coef ="x"),prior(normal(0, 12),class ="sd",group ="grupo",coef ="Intercept" ),prior(normal(0, 4),class ="sd",group ="grupo",coef ="x" ),prior(lkj(2), class ="cor", group ="grupo"),prior(normal(0, 10), class ="sigma"))fit_sim_var <-brm( y ~1+ x + (1+ x | grupo),data = sim,family =gaussian(),prior = prior_sim_var,chains =4,iter =2000,warmup =1000,seed =1653,backend ="cmdstanr",control =list(adapt_delta =0.95),file ="_fits/semana04_sim_pendiente_variable",file_refit ="on_change",refresh =0)
Running MCMC with 4 parallel chains...

Chain 4 finished in 6.7 seconds.
Chain 2 finished in 6.9 seconds.
Chain 3 finished in 6.8 seconds.
Chain 1 finished in 7.4 seconds.

All 4 chains finished successfully.
Mean chain execution time: 7.0 seconds.
Total execution time: 7.5 seconds.
La sintaxis
(1+ x | grupo)
indica que brms modelará conjuntamente un intercepto y una pendiente de x por grupo, incluyendo su correlación. Bürkner utiliza la misma estructura de fórmula para representar múltiples coeficientes grupales (Bürkner 2017, 6-7).
Conviene comparar las posteriores con los valores generadores, pero sin esperar recuperación exacta en una sola muestra simulada. La simulación sirve para estudiar qué cantidades están bien informadas y cuáles conservan incertidumbre apreciable.
4.18.6 Shrinkage simultáneo de interceptos y pendientes
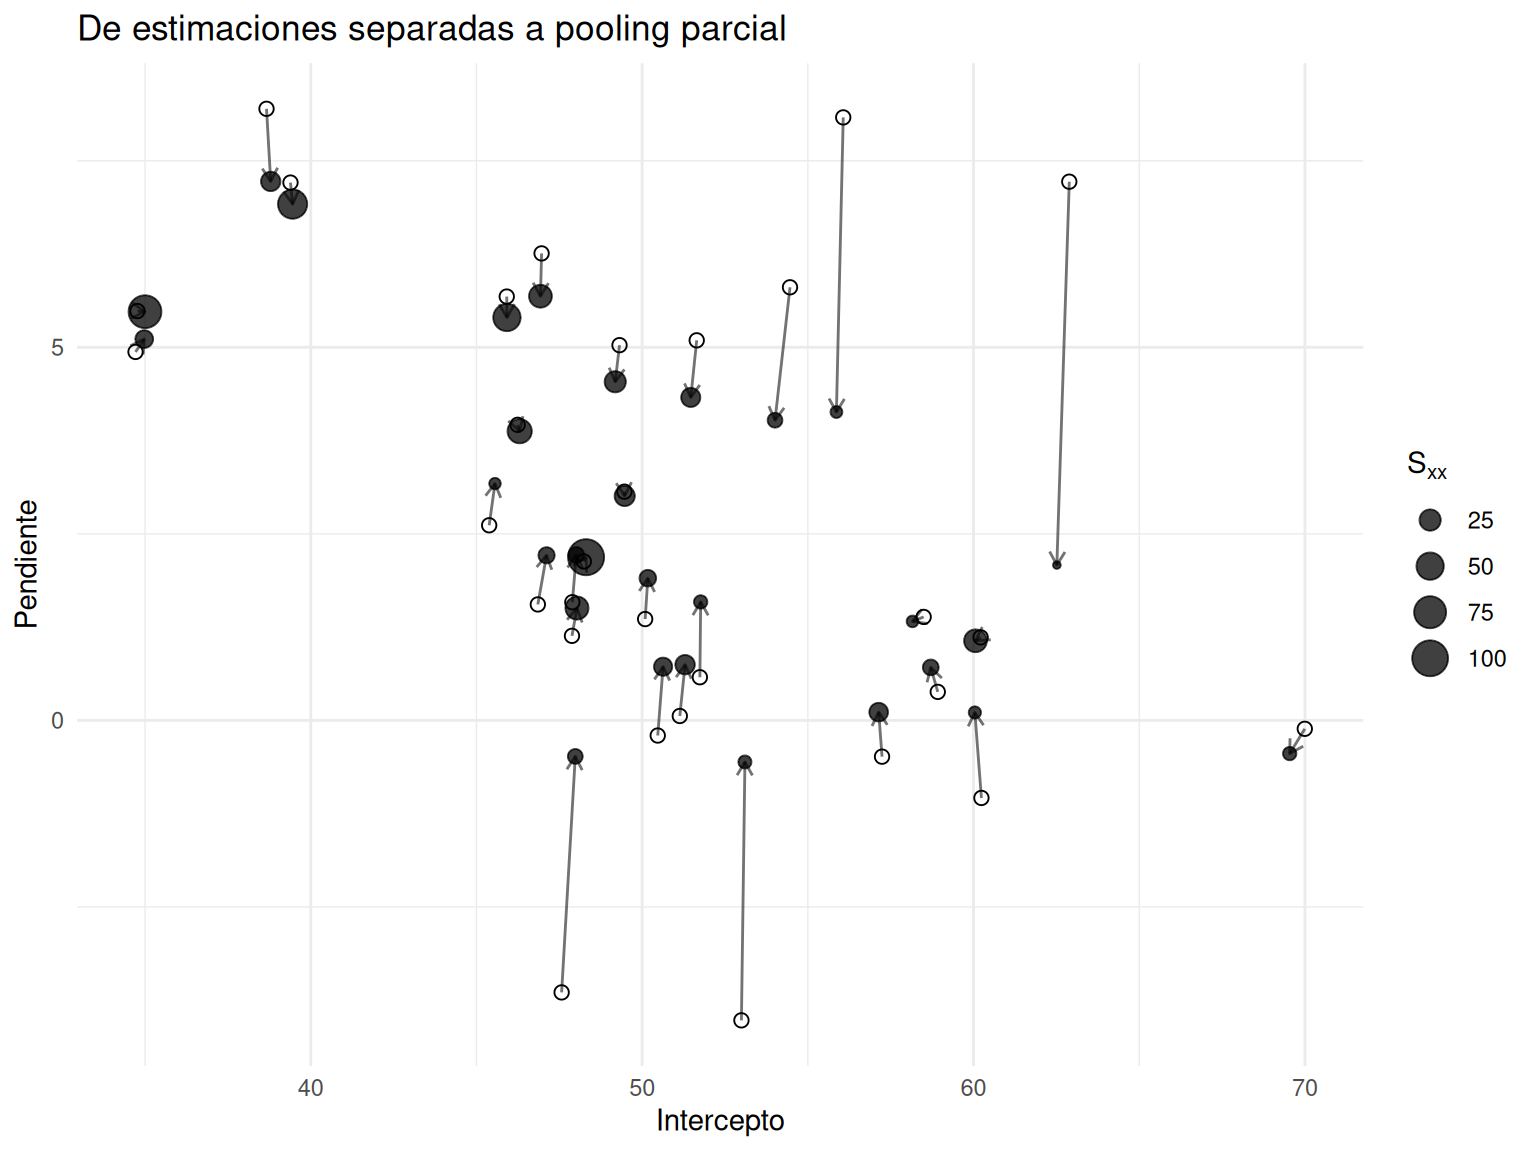
Para visualizar el pooling, estimaremos primero una regresión separada en cada grupo. Estas estimaciones no comparten información.
coef_unpooled <- sim |>group_by(grupo) |>group_modify(~ { m <-lm(y ~ x, data = .x)tibble(alpha_unpooled =unname(coef(m)[1]),beta_unpooled =unname(coef(m)[2]) ) } ) |>ungroup()# coef() es el genérico S3 de stats; brms aporta el método coef.brmsfit.# Con summary = TRUE, el arreglo tiene dimensiones:# nivel del grupo x estadístico resumen x coeficiente.coef_pooled_array <- stats::coef(fit_sim_var, summary =TRUE)$grupocoef_pooled <- tibble::tibble(grupo =factor(dimnames(coef_pooled_array)[[1]],levels = niveles_grupo ),alpha_pooled = coef_pooled_array[, "Estimate", "Intercept"],beta_pooled = coef_pooled_array[, "Estimate", "x"])shrinkage_sim <- coef_unpooled |>left_join(coef_pooled, by ="grupo") |>left_join( info_grupo |>select(grupo, n, Sxx),by ="grupo" )
Figura 4.4: Shrinkage bidimensional. Cada segmento conecta la estimación separada de un grupo con la estimación parcialmente agrupada del modelo multinivel. La dirección del shrinkage puede no ser horizontal ni vertical cuando interceptos y pendientes están correlacionados.
Los grupos con poca información sobre la pendiente pueden mostrar una contracción importante. El tamaño muestral es parte de esa información, pero \(S_{xx,j}\) deja claro que también importa la cobertura del predictor.
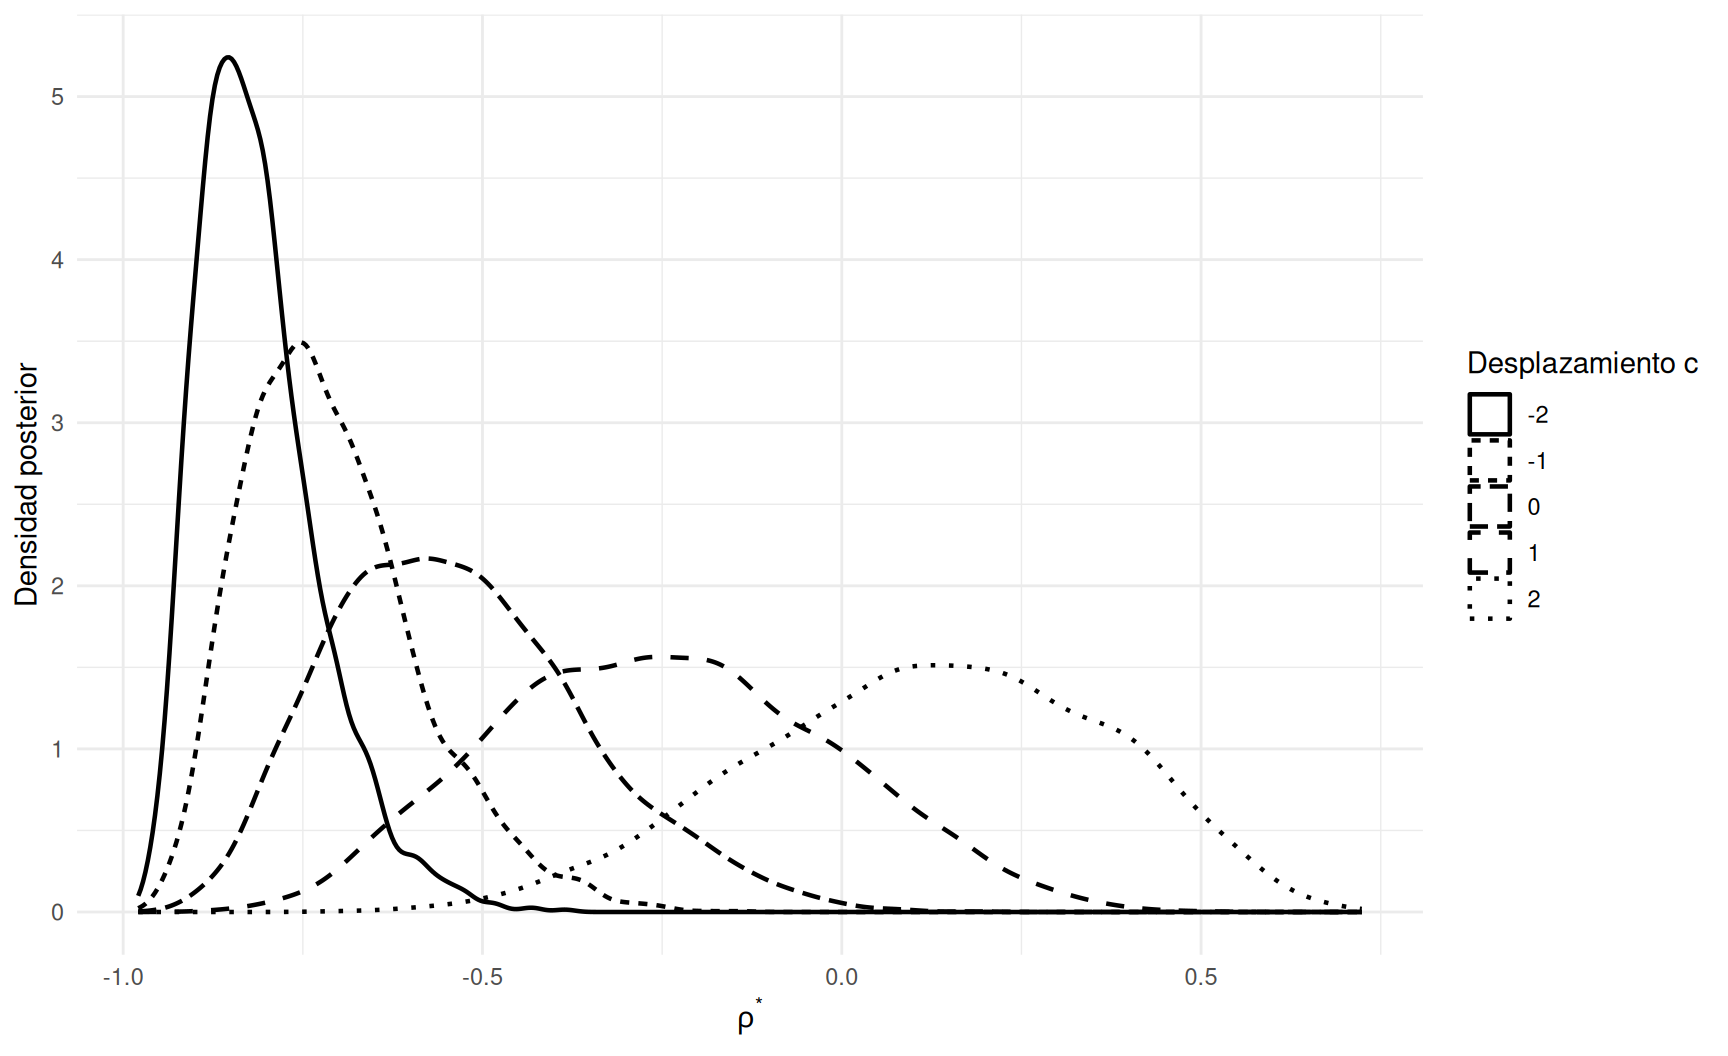
4.18.7 La correlación cambia al mover el origen
No necesitamos volver a ajustar el modelo para estudiar qué ocurriría al redefinir el origen del predictor. Podemos transformar cada draw posterior de \((\tau_\alpha,\tau_\beta,\rho)\) usando las fórmulas de Sección 4.5, sin cambiar las rectas ajustadas.
Figura 4.5: Posterior de la correlación intercepto–pendiente bajo distintos desplazamientos del origen de x. Las rectas predichas son las mismas; cambia la parametrización de los coeficientes.
El mensaje del gráfico es más importante que un valor particular: \(\rho\) debe interpretarse junto con la definición del intercepto.
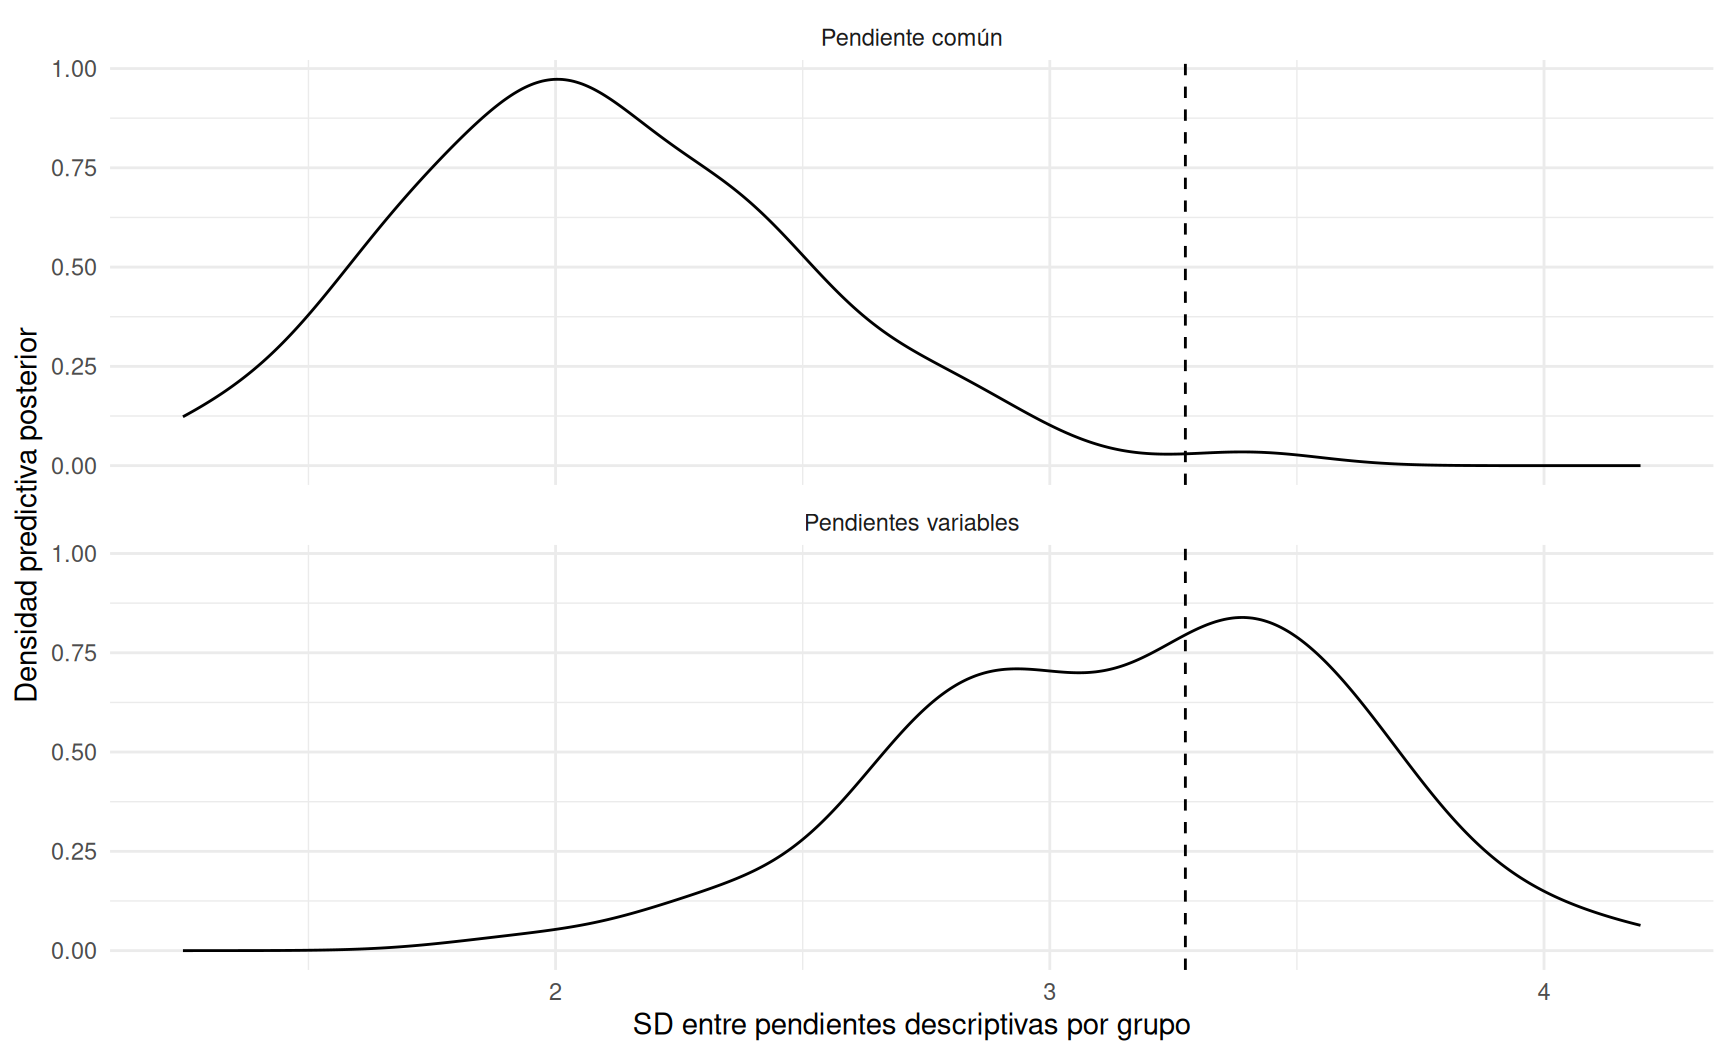
4.18.8 Comprobación predictiva de la heterogeneidad de pendientes
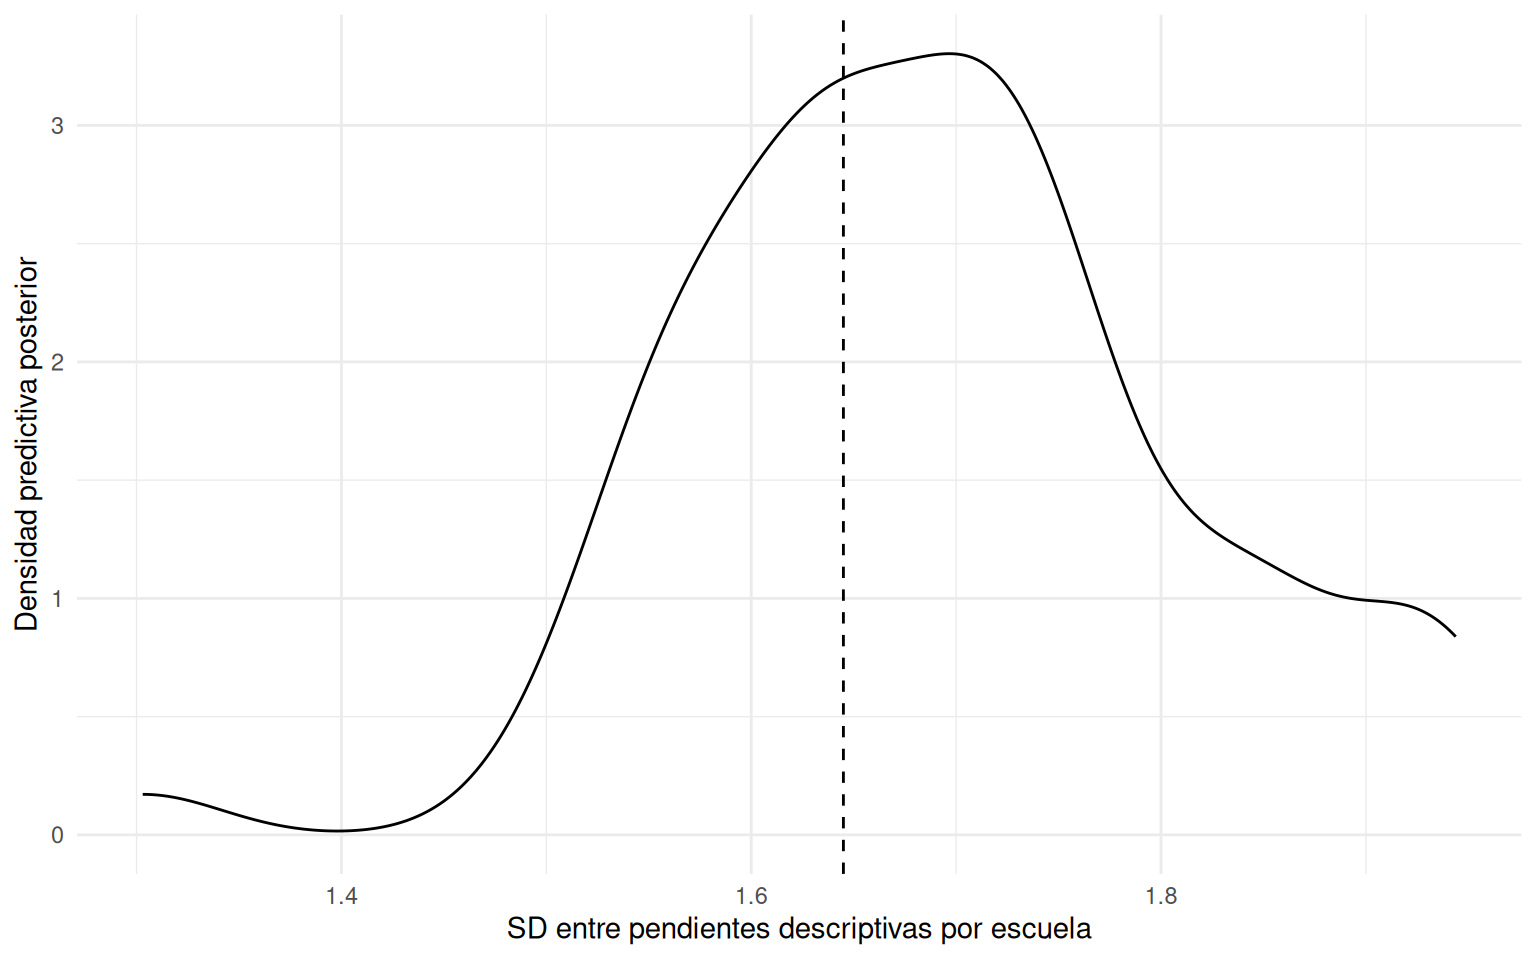
Una superposición global de densidades puede ser casi insensible a que las líneas de los grupos tengan pendientes distintas. Construiremos un estadístico de discrepancia dirigido a la estructura que motivó el modelo.
Como \(x\) tiene media cero dentro de cada grupo, la pendiente OLS descriptiva de un grupo puede calcularse mediante
la dispersión de esas pendientes descriptivas. No la interpretamos como un estimador directo de \(\tau_\beta\), porque contiene ruido muestral. Su función es únicamente comparar el patrón observado con patrones replicados bajo el modelo.
Figura 4.6: Comprobación predictiva dirigida a la heterogeneidad de pendientes. La línea vertical representa la dispersión de pendientes descriptivas observada; las densidades representan réplicas posteriores bajo cada modelo.
Este ejercicio muestra por qué la comprobación predictiva debe diseñarse para el aspecto del modelo que nos interesa. Un modelo puede reproducir razonablemente la distribución marginal de \(y\) y fallar en la dispersión de asociaciones entre grupos.
4.18.9 Diagnóstico MCMC básico del modelo simulado
Antes de interpretar la posterior, revisamos al menos \(\widehat R\), ESS, trazas y divergencias.
No intentaremos solucionar aquí todos los posibles problemas de geometría. Si aparecen divergencias o ESS muy bajos, deben tratarse como una señal para revisar parametrización, escala, previas e identificación. La parametrización centrada/no centrada y los diagnósticos de HMC se desarrollarán explícitamente en la semana 7. McElreath y Bayesian Workflow discuten que las parametrizaciones matemáticamente equivalentes pueden comportarse de manera muy distinta en HMC, especialmente en modelos jerárquicos complejos (McElreath 2020, 447-54; Gelman et al. 2026, 209-35, 281-83).
4.19 Aplicación: heterogeneidad del gradiente socioeconómico entre escuelas
Retomamos MathAchieve del paquete nlme, usado en la semana 3. Los datos contienen estudiantes agrupados en escuelas y permiten mantener la misma interpretación dentro–entre mientras ampliamos la estructura de pendientes.
Trabajaremos con:
MathAch: rendimiento matemático;
SES: nivel socioeconómico individual;
MEANSES: SES promedio de la escuela;
School: identificador de escuela.
Hox et al. utilizan estos datos para mostrar que el centrado por grupo separa la asociación dentro de escuelas de la comparación entre escuelas (Hox et al. 2018, 51-52). Esta semana preguntaremos además si la asociación dentro de las escuelas cambia entre ellas.
La variable ses_wc contiene únicamente variación dentro de escuela. Así, permitir que su pendiente varíe responde directamente a la pregunta de si el gradiente socioeconómico intragrupo cambia entre escuelas.
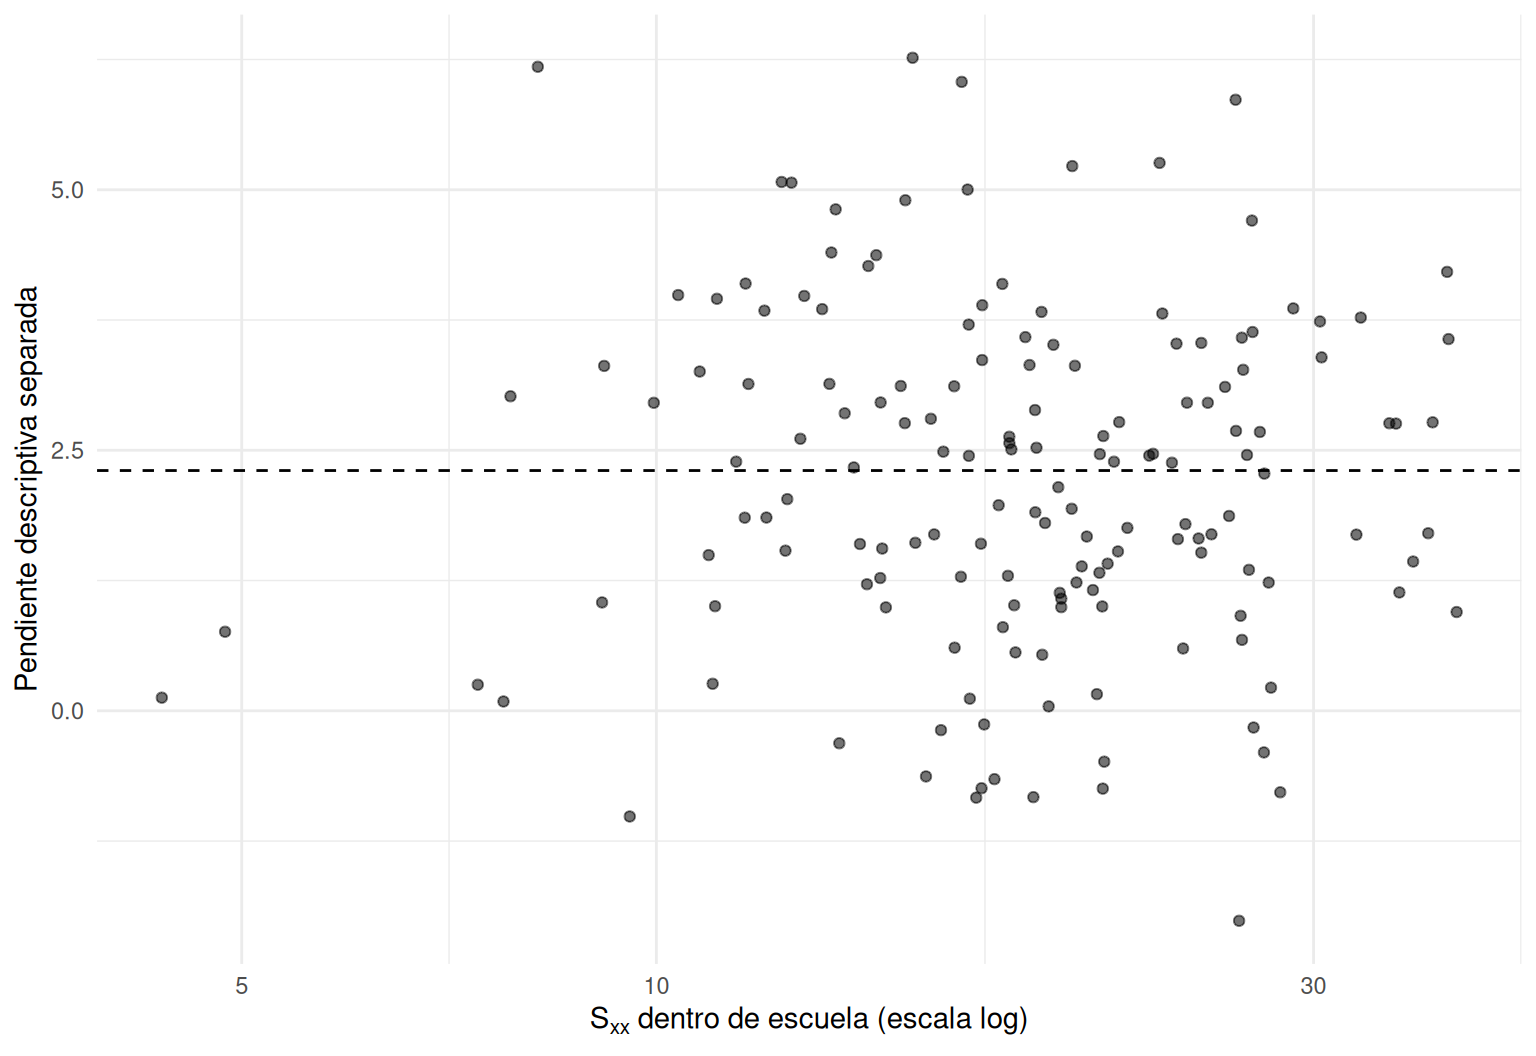
4.19.2 ¿Hay evidencia descriptiva de pendientes diferentes?
No interpretaremos regresiones separadas como estimaciones finales, pero sí pueden servir para explorar la estructura.
pendientes_math_desc <- math |>group_by(School) |>group_modify(~ { m <-lm(MathAch ~ ses_wc, data = .x)tibble(n =nrow(.x),Sxx =sum(.x$ses_wc^2),pendiente =unname(coef(m)[2]) ) } ) |>ungroup()pendientes_math_desc |>summarise(mediana_pendiente =median(pendiente),sd_pendientes =sd(pendiente),q10 =quantile(pendiente, 0.10),q90 =quantile(pendiente, 0.90) )
ggplot( pendientes_math_desc,aes(x = Sxx, y = pendiente)) +geom_point(alpha =0.55) +geom_hline(yintercept =median(pendientes_math_desc$pendiente),linetype =2 ) +scale_x_log10() +labs(x =expression(S[xx] ~"dentro de escuela (escala log)"),y ="Pendiente descriptiva separada" ) +theme_minimal()
Figura 4.7: Pendientes OLS separadas por escuela contra la información Sxx disponible para estimarlas. La gran dispersión en escuelas con poca información ilustra por qué no conviene interpretar estas estimaciones sin pooling.
La variación de estas pendientes combina heterogeneidad real y error de estimación. Precisamente por eso necesitamos un modelo jerárquico.
4.19.3 Modelo 1: pendiente intragrupo variable
Partimos del modelo de la semana 3 y permitimos que la asociación de ses_wc cambie entre escuelas:
\(\mu_\beta\): asociación socioeconómica intragrupo promedio entre las escuelas;
\(\tau_\beta\): heterogeneidad residual entre las pendientes intragrupo;
\(\rho\): asociación entre el rendimiento esperado de un estudiante situado en la media de SES de su escuela y el gradiente socioeconómico dentro de esa escuela.
Esta última interpretación depende de nuestro centrado: como ses_wc = 0 corresponde al SES medio de la escuela, el intercepto está definido justamente en ese punto.
4.19.3.1 Previas para la aplicación
Usaremos previas explícitas en la escala de MathAch:
La menor escala de la previa sobre \(\tau_\beta\) refleja que una desviación estándar de varios puntos de rendimiento por una unidad de SES ya implica heterogeneidad considerable entre gradientes. Esta elección es pedagógica y debe revisarse mediante simulación previa en una aplicación sustantiva real.
prior_math_var <-c(prior(normal(12, 10), class ="Intercept"),prior(normal(0, 5), class ="b", coef ="ses_wc"),prior(normal(0, 5), class ="b", coef ="meanses_gmc"),prior(normal(0, 10),class ="sd",group ="School",coef ="Intercept" ),prior(normal(0, 4),class ="sd",group ="School",coef ="ses_wc" ),prior(lkj(2), class ="cor", group ="School"),prior(normal(0, 10), class ="sigma"))fit_math_var <-brm( MathAch ~1+ ses_wc + meanses_gmc + (1+ ses_wc | School),data = math,family =gaussian(),prior = prior_math_var,chains =4,iter =2000,warmup =1000,seed =1653,backend ="cmdstanr",control =list(adapt_delta =0.95),file ="_fits/semana04_math_pendiente_variable",file_refit ="on_change",refresh =0)
Running MCMC with 4 parallel chains...

Chain 1 finished in 91.9 seconds.
Chain 2 finished in 96.9 seconds.
Chain 4 finished in 97.2 seconds.
Chain 3 finished in 99.2 seconds.

All 4 chains finished successfully.
Mean chain execution time: 96.3 seconds.
Total execution time: 99.4 seconds.
4.19.3.2 Resumen de la heterogeneidad de pendientes
No resumiremos \(\tau_\beta\) mediante una decisión binaria de “cero/no cero”. Nos interesa cuánto gradiente residual permite la posterior, con qué incertidumbre y si esa heterogeneidad ayuda a reproducir los patrones observados.
4.19.3.3 Líneas parcialmente agrupadas por escuela
# El genérico coef() pertenece a stats; el método para objetos brmsfit# es despachado automáticamente como coef.brmsfit.coef_math_array <- stats::coef(fit_math_var, summary =TRUE)$Schoolcoef_math_school <- tibble::tibble(School =factor(dimnames(coef_math_array)[[1]],levels =levels(math$School) ),intercepto = coef_math_array[, "Estimate", "Intercept"],pendiente = coef_math_array[, "Estimate", "ses_wc"])
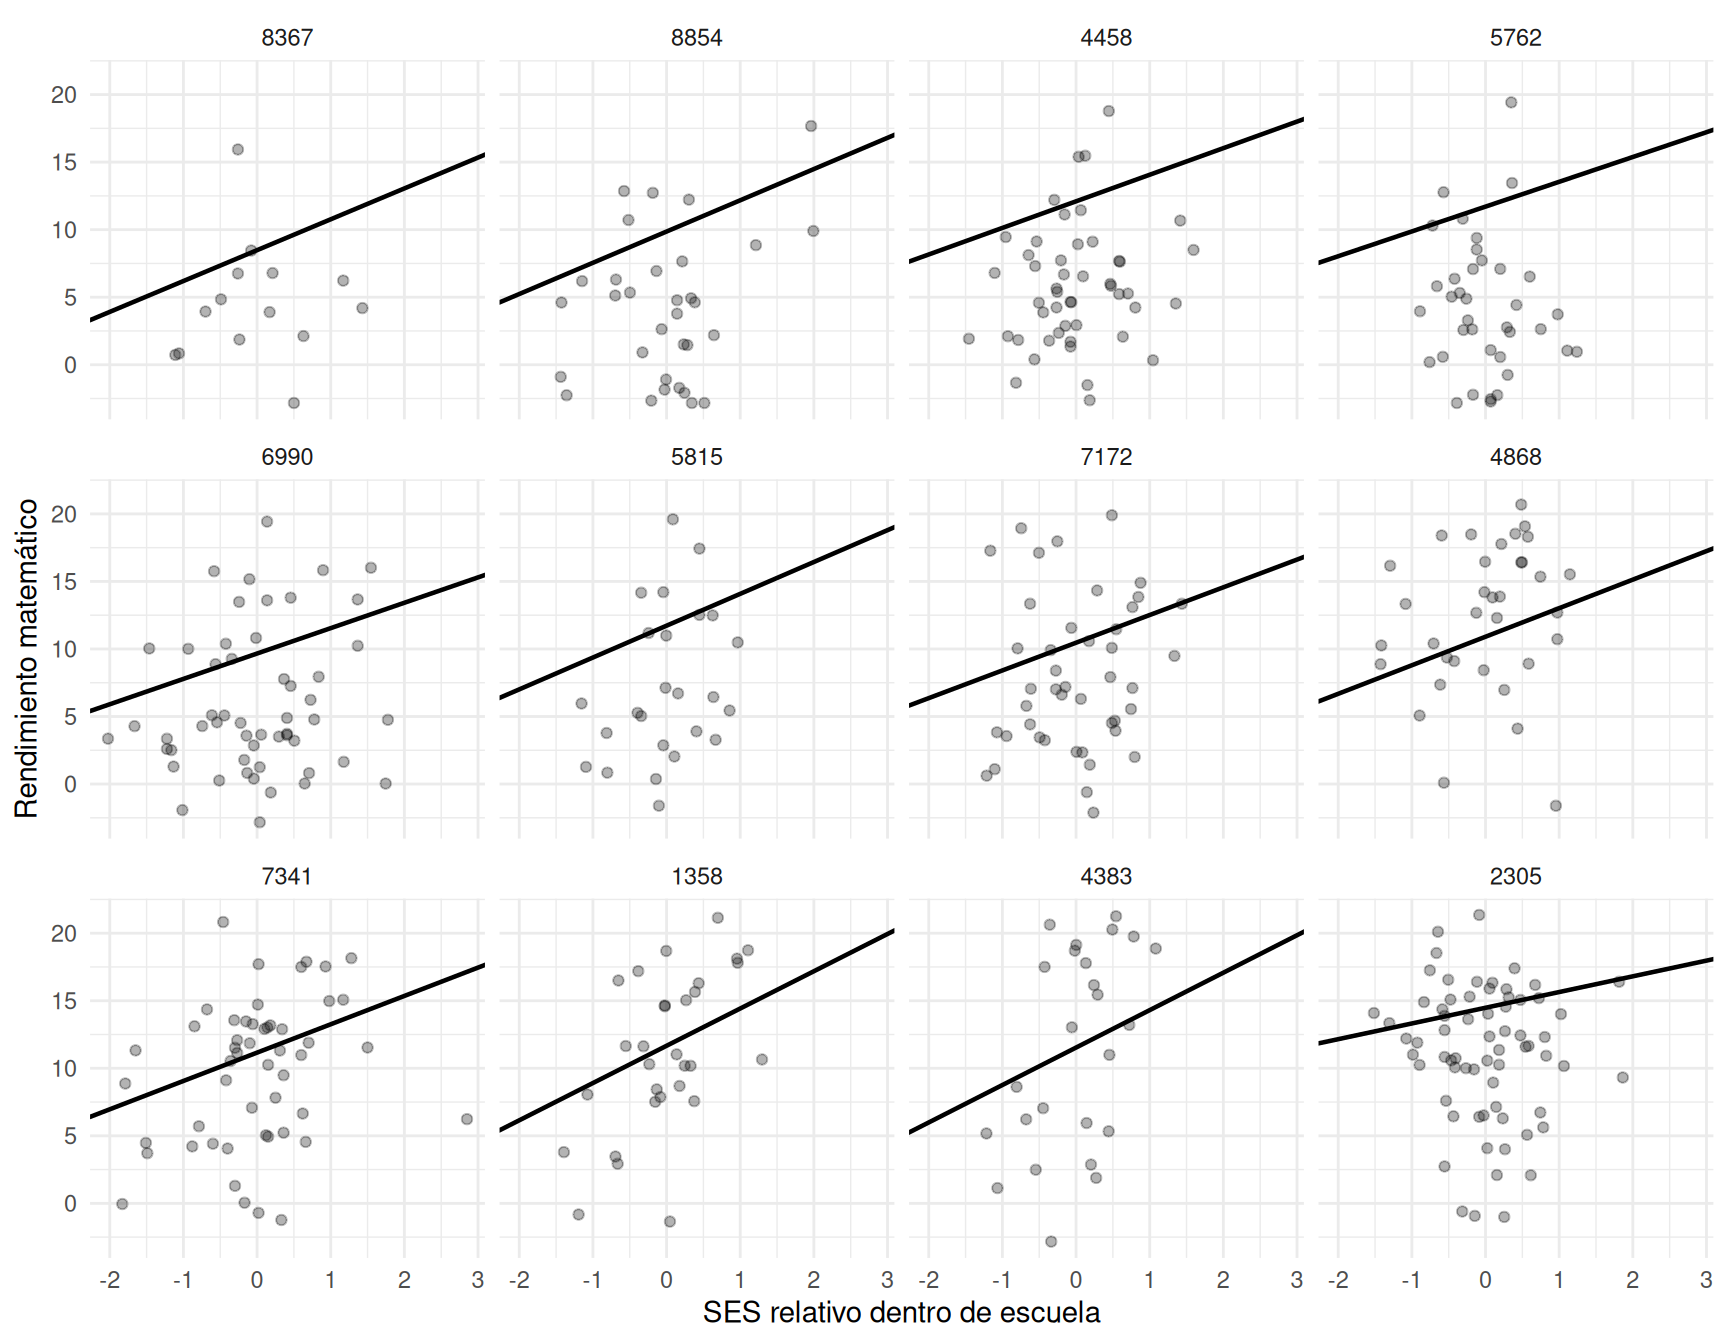
Figura 4.8: Rectas posteriores parcialmente agrupadas para una selección de escuelas. Como ses_wc está centrado por escuela, el intercepto corresponde al rendimiento esperado en el SES medio de cada escuela.
4.19.4 Modelo 2: una interacción entre niveles
El modelo anterior reconoce heterogeneidad, pero no intenta explicarla. Ahora preguntamos si el SES promedio de la escuela está asociado con el gradiente de SES individual.
El * agrega ambos efectos principales y la interacción. Mantener (1 + ses_wc | School) permite que todavía exista heterogeneidad no explicada por meanses_gmc.
4.19.4.1 Previa del término de interacción
Una unidad de ses_wc * meanses_gmc combina dos escalas de SES. Usaremos
\[
\gamma_{11}\sim\mathcal N(0,3^2),
\]
algo más concentrada que las previas de los efectos principales. La elección no es universal: su adecuación depende del rango sustantivo de ambas variables.
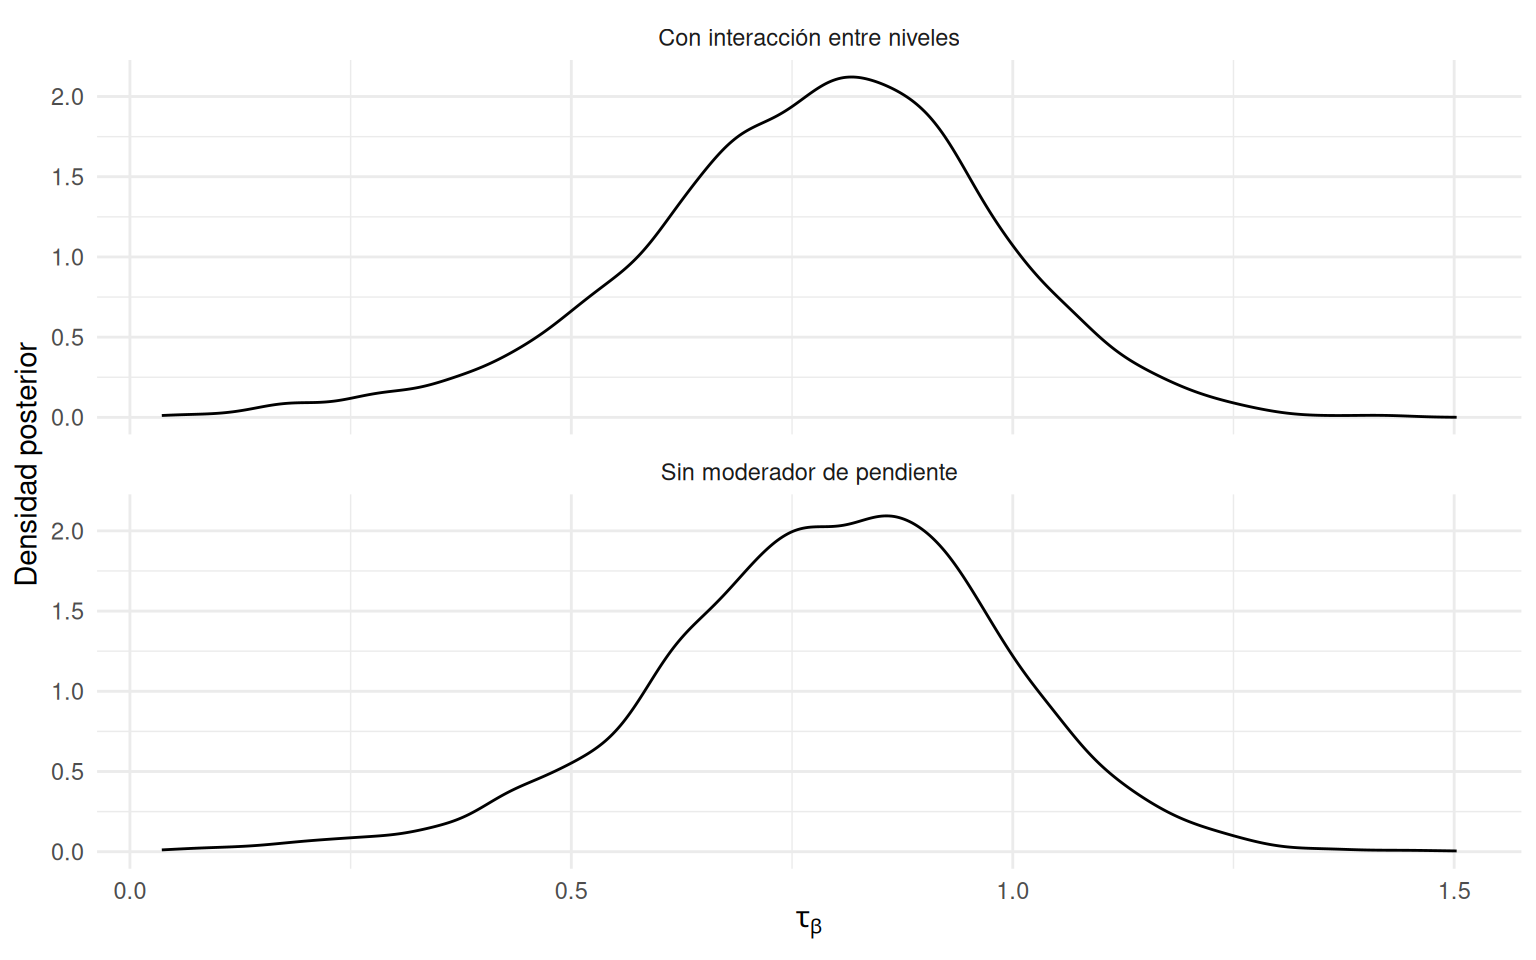
Una manera descriptiva de estudiar lo que aporta el predictor grupal es observar cómo cambia la posterior de \(\tau_\beta\) entre los dos modelos. No es una prueba de significancia ni un criterio automático de selección.
tau_compare <-bind_rows(tibble(modelo ="Sin moderador de pendiente",tau_beta = draws_math_var$sd_School__ses_wc ),tibble(modelo ="Con interacción entre niveles",tau_beta = draws_math_cross$sd_School__ses_wc ))
Figura 4.9: Posterior de la desviación estándar residual entre pendientes antes y después de incluir la interacción entre SES individual relativo y SES medio escolar.
Si la posterior de \(\tau_\beta\) se desplaza hacia valores menores, meanses_gmc está capturando parte de la heterogeneidad que antes quedaba en las pendientes residuales. Si cambia poco, el predictor grupal no parece explicar mucha de esa heterogeneidad bajo esta especificación. En ambos casos puede seguir existiendo incertidumbre considerable.
4.19.6 Visualizar la interacción en la escala de la respuesta
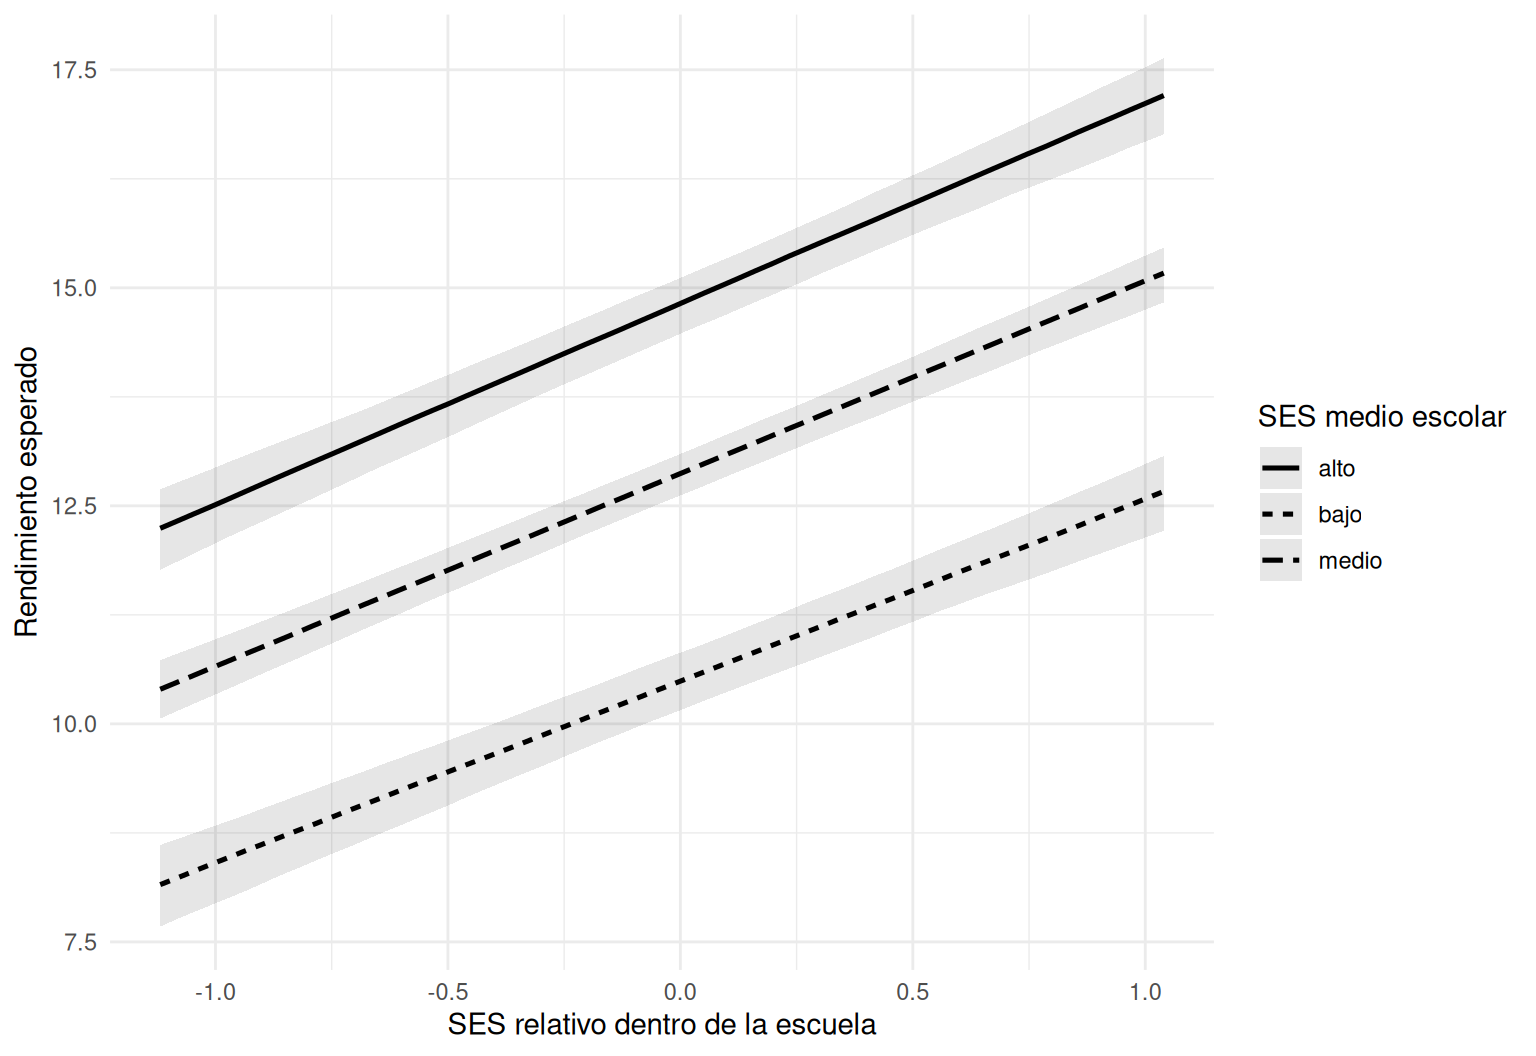
Los coeficientes de interacción suelen entenderse mejor mediante predicciones. Elegimos tres valores del SES medio escolar: percentiles 20, 50 y 80 de la distribución entre escuelas.
ggplot( pred_cross,aes(x = ses_wc, y = mediana, linetype = nivel)) +geom_ribbon(aes(ymin = q05, ymax = q95, group = nivel),alpha =0.12 ) +geom_line(linewidth =0.9) +labs(x ="SES relativo dentro de la escuela",y ="Rendimiento esperado",linetype ="SES medio escolar" ) +theme_minimal()
Figura 4.10: Predicciones poblacionales de rendimiento según SES relativo dentro de la escuela para tres niveles de SES medio escolar. Las diferencias entre pendientes representan la interacción entre niveles.
No debemos interpretar el gráfico causalmente sin supuestos adicionales. El modelo describe cómo cambia una asociación condicional entre niveles.
4.19.7 Comprobaciones predictivas de la aplicación
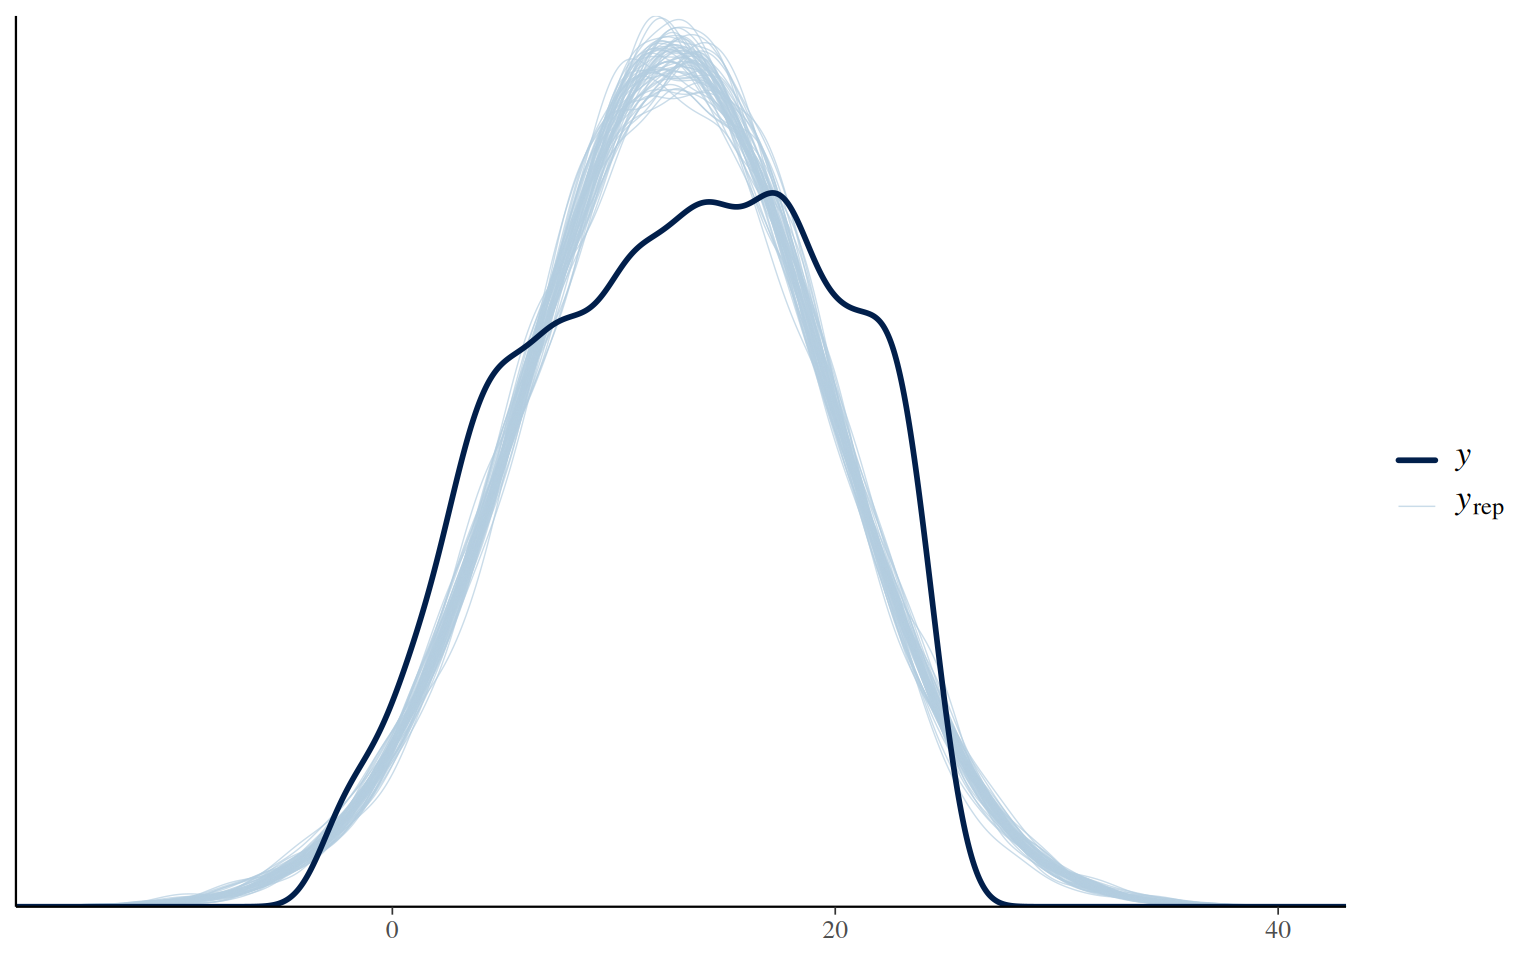
Comprobación predictiva posterior global para el modelo con interacción entre niveles.
Una buena reproducción global no garantiza una buena representación de las pendientes entre escuelas. Por eso repetimos el estadístico dirigido usado en la simulación.
Figura 4.11: Comprobación predictiva posterior de la dispersión de pendientes descriptivas entre escuelas.
La discrepancia utilizada es una elaboración pedagógica para esta clase. No sustituye otras comprobaciones: convendría examinar también medias por escuela, colas de la respuesta, residuos respecto de SES y posibles no linealidades.
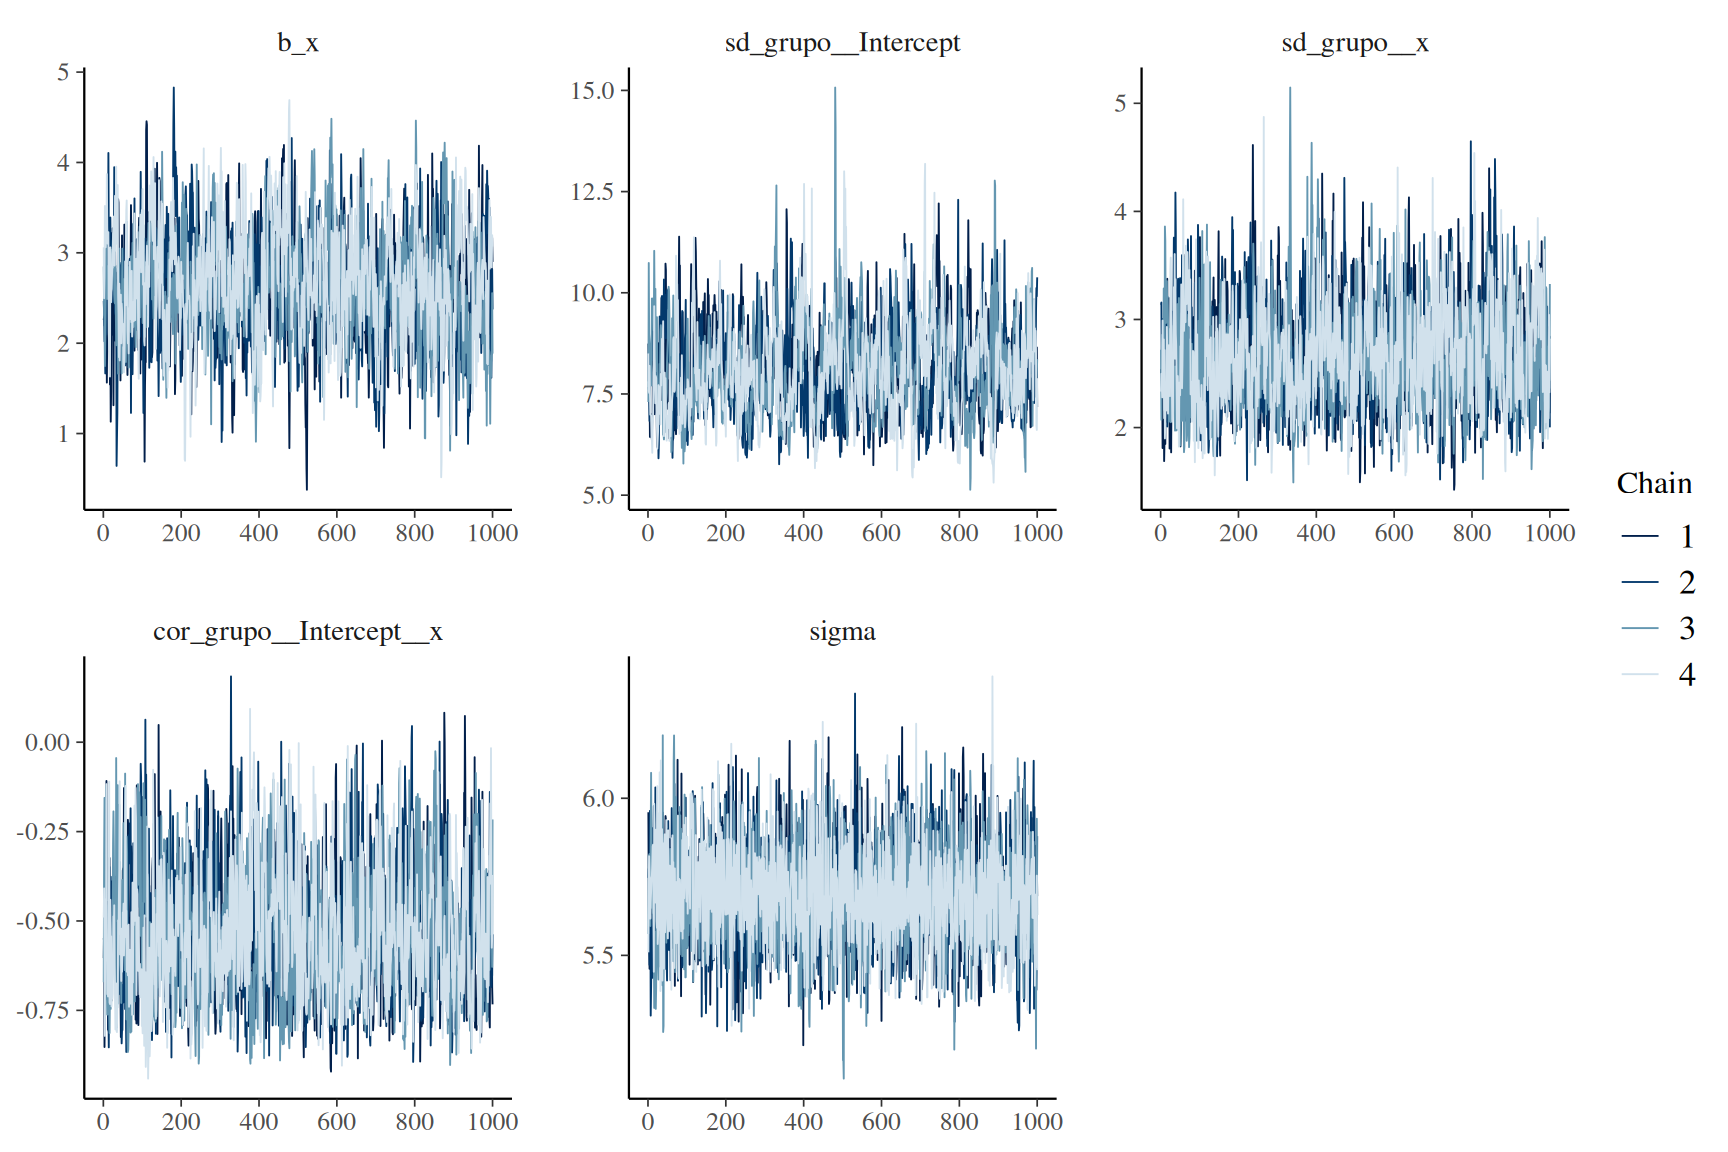
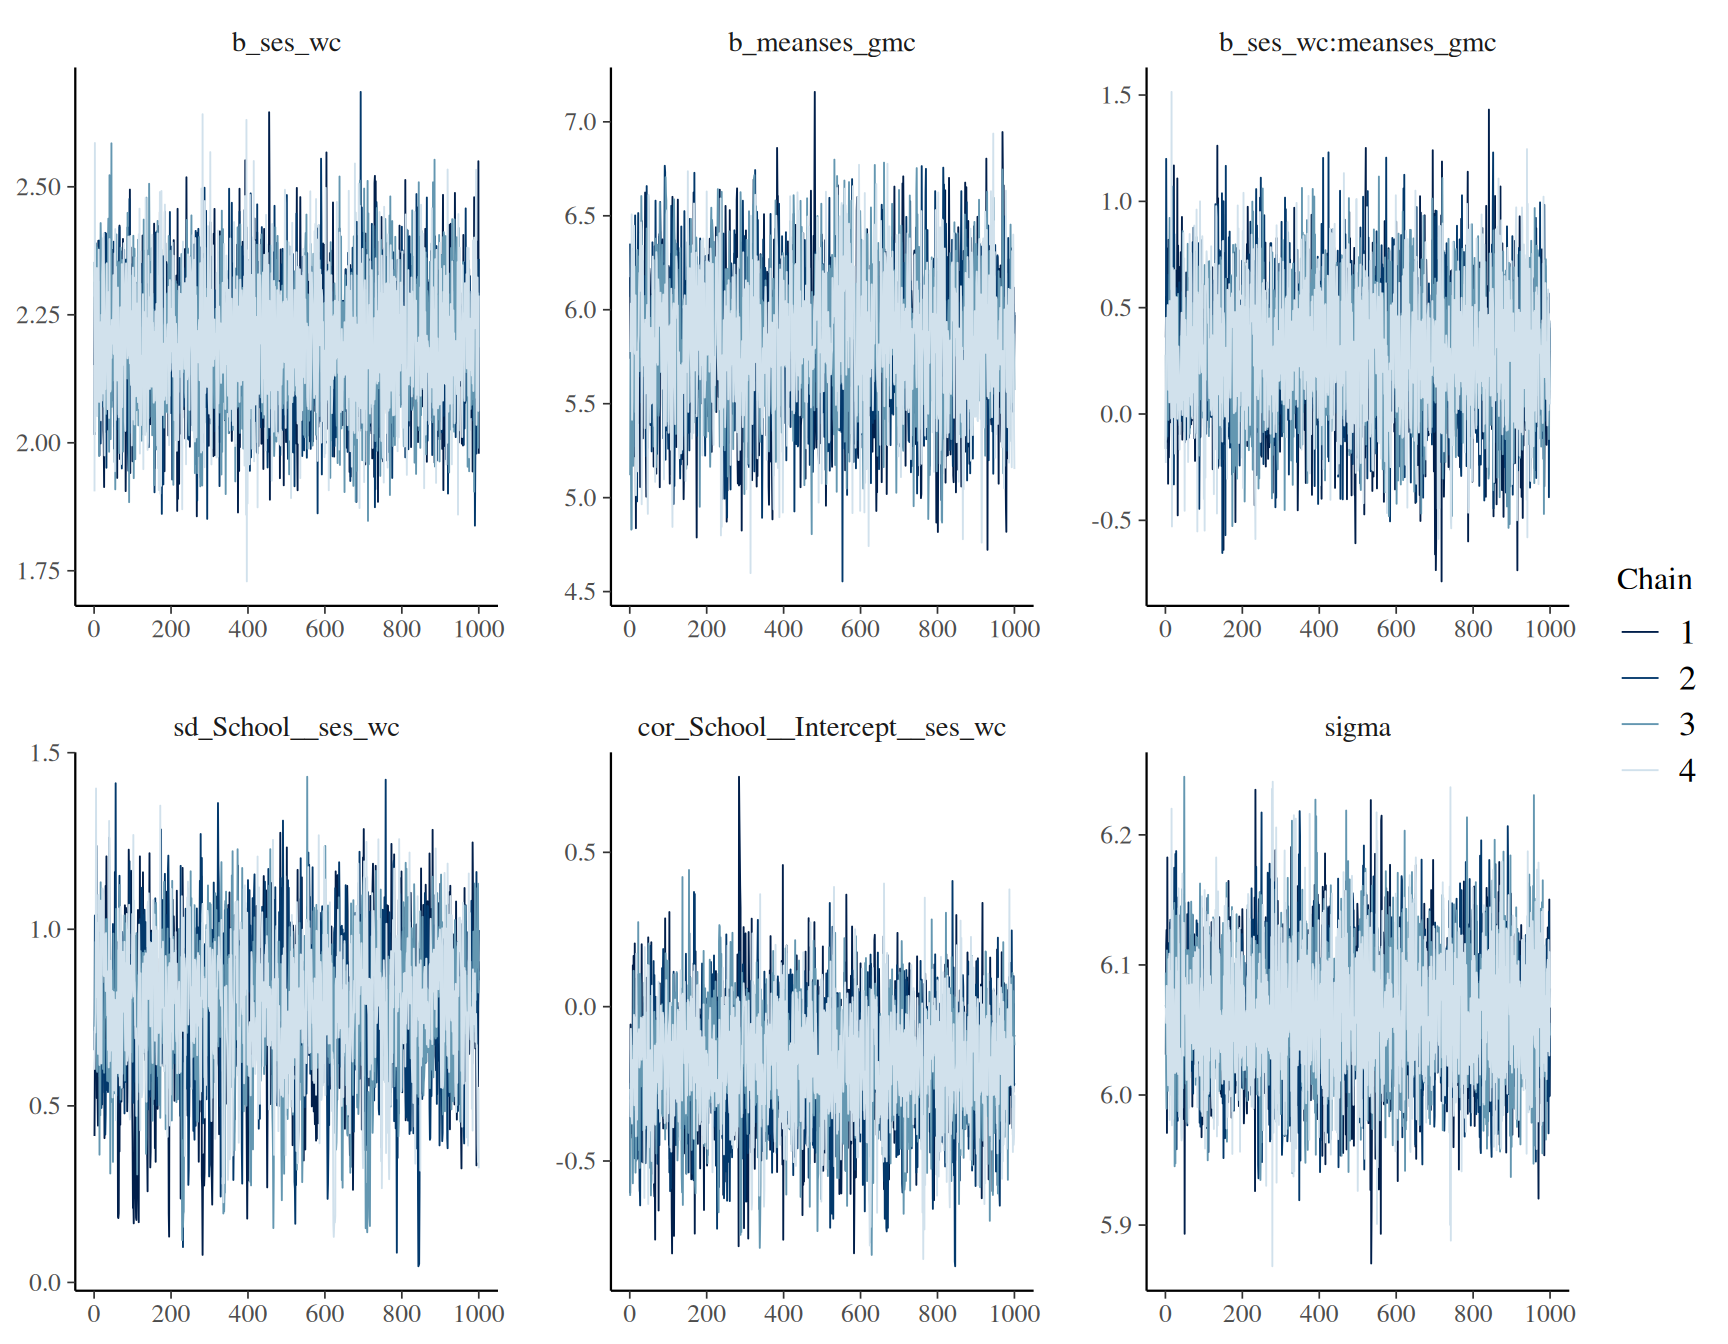
Figura 4.12: Trazas MCMC para parámetros seleccionados del modelo con interacción entre niveles.
Una posterior amplia de cor_School__Intercept__ses_wc no debe “arreglarse” aumentando adapt_delta: si el algoritmo muestrea adecuadamente y la incertidumbre persiste, el problema puede ser simplemente que la correlación está poco identificada por los datos. En cambio, divergencias requieren atención computacional.
4.19.9 Predicción para escuelas existentes y nuevas
La distinción de la semana 2 se vuelve más rica. Para una escuela ya observada, la posterior de su intercepto y su pendiente se ha actualizado con sus propios datos. Para una escuela nueva, debemos generar un par nuevo de coeficientes de la distribución poblacional.
Por tanto, una predicción para una escuela nueva debe propagar incertidumbre sobre:
los coeficientes poblacionales;
\(\tau_\alpha\) y \(\tau_\beta\);
\(\rho\);
la realización nueva de intercepto y pendiente;
y, para una observación futura, también \(\sigma\).
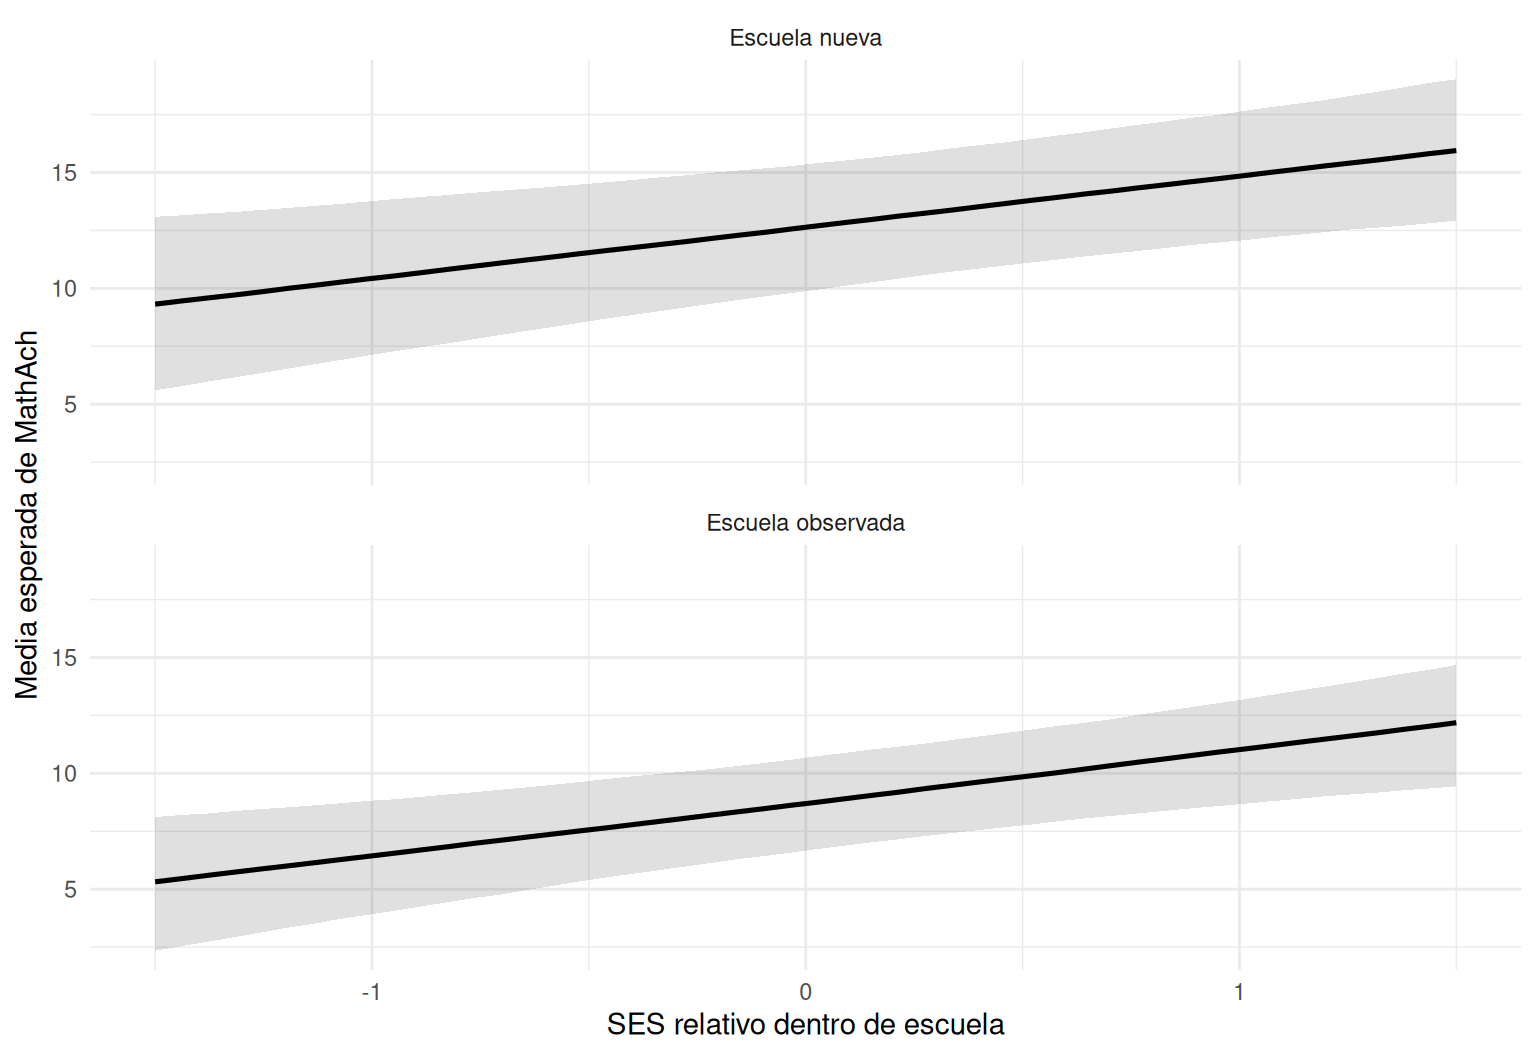
brms puede simular niveles nuevos mediante allow_new_levels = TRUE. Usaremos posterior_epred() para mostrar incertidumbre en la media esperada, sin agregar todavía error residual individual.
ggplot( pred_grupos,aes(x = ses_wc, y = mediana)) +geom_ribbon(aes(ymin = q05, ymax = q95),alpha =0.15 ) +geom_line(linewidth =0.9) +facet_wrap(~ tipo, ncol =1) +labs(x ="SES relativo dentro de escuela",y ="Media esperada de MathAch" ) +theme_minimal()
Figura 4.13: Predicción de la media esperada para una escuela observada y para una escuela nueva. La escuela nueva requiere simular un nuevo intercepto y una nueva pendiente de la distribución poblacional.
El intervalo para un grupo nuevo puede ser mayor porque no contamos con observaciones de esa escuela para actualizar su par \((\alpha,\beta)\). McElreath destaca esta diferencia entre predicciones para clusters existentes y nuevos en su discusión de predicción multinivel (McElreath 2020, 426-31).
4.20 ¿Cuál modelo debemos preferir?
Durante esta semana hemos construido una secuencia de expansiones:
pendiente común;
pendiente variable;
pendiente variable con un predictor grupal que explica parte de su heterogeneidad.
No las trataremos como una competencia donde un único número elige automáticamente el “mejor” modelo.
Cada expansión debe evaluarse preguntando:
¿qué afirmación sustantiva nueva representa?;
¿qué cantidad podemos interpretar ahora que antes no existía?;
¿la posterior de los nuevos parámetros es suficientemente informativa para la pregunta?;
¿el modelo reproduce mejor el aspecto de los datos que motivó la expansión?;
¿la complejidad adicional genera problemas de identificación o de cómputo?;
¿las conclusiones principales son sensibles a las previas razonables?
La comparación predictiva formal mediante PSIS-LOO se desarrollará en la semana 14. En esta etapa damos prioridad a construcción generativa, comprobaciones predictivas dirigidas e interpretación.
4.21 Perspectiva frecuentista y terminología
En la literatura clásica es común encontrar expresiones como:
random intercept;
random slope;
random coefficient model;
fixed effect;
cross-level interaction.
En estas notas preferimos intercepto variable, pendiente variable y coeficiente poblacional, siguiendo la recomendación de hacer explícito que los coeficientes grupales son cantidades modeladas y que podemos describir su incertidumbre (Bürkner 2017, 2-3).
En lme4, una formulación frecuentista conceptualmente paralela sería
La estructura del predictor lineal y de la matriz de covarianza es muy similar. Cambian el marco inferencial, la forma de incorporar información previa, la representación de incertidumbre y los procedimientos de ajuste.
El objetivo del curso no es organizar la modelación alrededor de pruebas secuenciales de componentes aleatorios. La pregunta de si una pendiente debe variar debe comenzar por el mecanismo científico y el diseño, y luego estudiarse mediante inferencia y comprobación del modelo.
4.22 Errores frecuentes de interpretación
4.22.1 1. Interpretar \(\mu_\beta\) como la pendiente de todos los grupos
\(\mu_\beta\) es el centro de la distribución poblacional de pendientes. Si \(\tau_\beta>0\), las pendientes específicas son
\[
\beta_j=\mu_\beta+u_{1j}
\]
y no coinciden exactamente con \(\mu_\beta\).
4.22.2 2. Confundir incertidumbre de \(\beta_j\) con heterogeneidad entre \(\beta_j\)
Un intervalo amplio para una escuela puede deberse a poca información en esa escuela. \(\tau_\beta\) describe la distribución entre pendientes verdaderas bajo el modelo, no la incertidumbre de una escuela particular.
4.22.3 3. Convertir automáticamente todas las pendientes en variables
Cada pendiente variable agrega una nueva desviación estándar grupal y nuevas correlaciones. La estructura debe responder a un mecanismo plausible y a información suficiente en el diseño.
4.22.4 4. Fijar el intercepto sin reconocer la restricción
Una pendiente variable con intercepto común obliga a todas las rectas a coincidir en \(x=0\). Esa igualdad necesita una justificación.
4.22.5 5. Interpretar \(\rho\) sin considerar el centrado
La correlación intercepto–pendiente cambia al mover el origen del predictor. Un valor extremo no debe interpretarse fuera de la parametrización que lo define.
4.22.6 6. Tratar una interacción entre niveles como si explicara toda la heterogeneidad
El término \(\gamma_{11}z_j\) describe heterogeneidad sistemática. Si mantenemos \(u_{1j}\), todavía queda variación residual de pendientes.
4.22.7 7. Eliminar la pendiente variable porque la interacción parece grande
Un predictor grupal puede asociarse fuertemente con la pendiente y aun así dejar heterogeneidad residual importante.
4.22.8 8. Interpretar el coeficiente de interacción de manera aislada
\(\gamma_{11}\) es un cambio de pendiente. Debe interpretarse junto con la escala y el origen de \(x\) y \(z\), idealmente mediante predicciones.
4.22.9 9. Pensar que muchos datos totales garantizan buena información sobre \(\tau_\beta\)
Podemos tener miles de observaciones, pero si hay pocos grupos o escasa variación de \(x\) dentro de ellos, la distribución de pendientes puede seguir estando débilmente informada.
4.22.10 10. Confundir una posterior amplia con una falla computacional
Si las cadenas mezclan bien, no hay divergencias y el ESS es adecuado, una posterior amplia puede ser el resultado correcto de información limitada.
4.22.11 11. Usar una comprobación predictiva global para evaluar heterogeneidad de pendientes
La densidad marginal de \(y\) puede verse bien incluso si el modelo representa mal las relaciones dentro de grupo. La comprobación debe ser sensible a las pendientes.
4.22.12 12. Interpretar asociaciones observacionales como moderación causal
Una interacción estadística entre SES individual y composición escolar no demuestra que cambiar la composición de la escuela causaría un cambio en el gradiente individual.
Su estructura puede entenderse mediante cuatro ideas.
Primera: la heterogeneidad puede afectar relaciones, no solo niveles.\(\tau_\beta\) describe cuánto cambian las pendientes entre grupos.
Segunda: los coeficientes grupales se aprenden conjuntamente. La distribución multivariada permite pooling parcial de interceptos y pendientes, y la correlación puede hacer que información sobre un coeficiente contribuya a regularizar el otro.
Tercera: la parametrización tiene interpretación. El origen de \(x\) define el intercepto y modifica tanto \(\tau_\alpha\) como \(\rho\). Por ello el centrado de la semana 3 es parte integral del modelo de la semana 4.
Cuarta: la heterogeneidad puede modelarse. Si un predictor grupal \(z_j\) explica parte de la variación de pendientes,
Explique por qué cambiar la correlación no implica cambiar las rectas ajustadas.
Dé un ejemplo en que una correlación intercepto–pendiente extrema podría deberse a un origen absurdo del predictor.
4.24.1.3 Ejercicio 3. Interacción, pendiente variable o ambas
Para cada situación, indique si usaría una interacción convencional, una pendiente variable, una interacción entre niveles o una combinación. Justifique.
El efecto de una dosis sobre presión arterial puede cambiar con la edad del paciente.
La asociación entre horas de estudio y rendimiento puede cambiar entre escuelas, sin un moderador escolar específico propuesto todavía.
La asociación entre horas de estudio y rendimiento puede cambiar con el tamaño de la escuela y además quedar heterogeneidad entre escuelas.
El efecto de un tratamiento 0/1 cambia entre 25 hospitales.
La relación entre temperatura y rendimiento de una parcela cambia entre fincas y se sospecha que la altitud de la finca explica parte de la diferencia.
4.24.1.4 Ejercicio 4. Derivar una interacción entre niveles
Cargue MathAchSchool del paquete nlme y agregue Sector a los datos de estudiantes mediante School.
describa el nivel de medición de Sector;
proponga una codificación que dé una interpretación clara a la pendiente principal de ses_wc;
ajuste un modelo donde Sector modere la pendiente de ses_wc y mantenga una pendiente residual variable por escuela;
grafique las pendientes poblacionales por sector;
compare la posterior de \(\tau_\beta\) con la del modelo sin Sector;
interprete la interacción como asociación, no como efecto causal, salvo que pueda defender supuestos adicionales.
4.24.2.6 Ejercicio 12. Predicción para grupos nuevos
A partir de fit_math_cross:
construya una escuela nueva con meanses_gmc en el percentil 20 de la distribución escolar;
obtenga predicciones de la media para una secuencia de ses_wc;
repita para el percentil 80;
compare las distribuciones predictivas de las pendientes nuevas;
explique qué fuentes de incertidumbre no aparecerían si utilizara re_formula = NA y predijera solo la media poblacional.
4.24.3 Ejercicio de interpretación de salida
Un modelo produce el siguiente resumen posterior hipotético:
Cantidad
Mediana posterior
Intervalo 90%
\(\mu_\beta\)
2.4
\([1.9,2.9]\)
\(\tau_\beta\)
1.1
\([0.6,1.8]\)
\(\rho\)
-0.55
\([-0.86,0.03]\)
\(\gamma_{11}\)
0.8
\([0.1,1.5]\)
\(\sigma\)
5.9
\([5.6,6.2]\)
El predictor individual \(x\) está centrado por grupo y el predictor grupal \(z\) está centrado globalmente.
Responda:
¿qué representa \(\mu_\beta\)?
¿qué representa \(\tau_\beta\)?
¿cómo interpretaría \(\gamma_{11}\)?
¿puede afirmarse que \(z\) explica toda la heterogeneidad de pendientes?
¿cómo interpretaría prudentemente la posterior de \(\rho\)?
si redefinimos \(x^*=x-2\), ¿espera que \(\rho\) sea necesariamente igual?
¿qué comprobación predictiva utilizaría para evaluar si el modelo reproduce la heterogeneidad de pendientes?
¿qué diferencia conceptual existe entre predecir la pendiente de un grupo observado y la de un grupo nuevo?
4.25 Lecturas para profundizar
Para esta semana se recomienda priorizar:
Gelman y Hill, §13.1: interceptos y pendientes variables, distribución conjunta y predictores grupales para coeficientes (Gelman y Hill 2007, 279-83).
Gelman y Hill, §13.4: interpretación de la correlación entre interceptos y pendientes y su relación con el reescalamiento del predictor (Gelman y Hill 2007, 287-89).
McElreath, §14.1: construcción generativa de pendientes variables, covarianza, LKJ y shrinkage bidimensional (McElreath 2020, 437-46).
McElreath, §13.5: predicciones multinivel para clusters existentes y nuevos (McElreath 2020, 426-31).
Como complemento:
Hox, Moerbeek y van de Schoot, §§4.2-4.3: centrado de predictores con pendientes variables e interpretación de interacciones, incluidas interacciones entre niveles (Hox et al. 2018, 46-56).
Bayesian Workflow, §17.2: previas para modelos lineales multinivel con interceptos y pendientes variables y visualización del pooling conjunto (Gelman et al. 2026, 280-85).
Bürkner: estructura de los parámetros grupales en brms, factorización de matrices de covarianza y sintaxis de múltiples coeficientes por grupo (Bürkner 2017, 2-7).
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. 2.ª ed. Chapman & Hall/CRC.