simular_ar1 <- function(n, rho, semilla) {
set.seed(semilla)
x <- numeric(n)
x[1] <- rnorm(1)
for (s in 2:n) {
x[s] <- rho * x[s - 1] +
sqrt(1 - rho^2) * rnorm(1)
}
x
}
n_sim <- 4000
sim_ind <- simular_ar1(n_sim, rho = 0.00, semilla = 1653071)
sim_dep <- simular_ar1(n_sim, rho = 0.97, semilla = 1653072)
datos_mc_s7 <- bind_rows(
tibble(
iteracion = seq_len(n_sim),
valor = sim_ind,
serie = "Dependencia baja"
),
tibble(
iteracion = seq_len(n_sim),
valor = sim_dep,
serie = "Dependencia alta"
)
)7 Semana 7. HMC, diagnóstico y parametrización
SP-1653 Modelos Mixtos
7.1 Panorama de la semana
Durante las primeras seis semanas construimos modelos multinivel cada vez más expresivos y examinamos las consecuencias de sus supuestos. La semana anterior el foco estuvo en las distribuciones previas y en la simulación predictiva previa. A partir de esta semana aparece una pregunta adicional: aunque el modelo esté bien formulado, ¿tenemos evidencia de que el algoritmo computacional exploró adecuadamente la distribución posterior?
La pregunta orientadora es:
¿Cómo sabemos si el algoritmo exploró adecuadamente la distribución posterior y qué hacemos cuando los diagnósticos indican dificultades?
En modelos sencillos algunas distribuciones posteriores pueden obtenerse analíticamente. En los modelos mixtos y multinivel que hemos usado, en cambio, la posterior suele ser de dimensión alta y contiene dependencias fuertes entre coeficientes, desviaciones estándar y correlaciones. Por ello trabajamos con simulaciones aproximadas de la posterior. Stan utiliza Hamiltonian Monte Carlo (HMC) y, en particular, el algoritmo No-U-Turn Sampler (NUTS) para explorar espacios continuos de parámetros con ayuda del gradiente de la log densidad (McElreath 2020, chap. 9; Gelman et al. 2013, sec. 12.4).
El hecho de que un ajuste termine sin producir un error de software no implica que la aproximación sea confiable. Bayesian Workflow organiza el flujo computacional alrededor de dos etapas complementarias: obtener simulaciones de la posterior y diagnosticar activamente si esas simulaciones representan adecuadamente la distribución objetivo. Sus capítulos 11 y 12 enfatizan cadenas múltiples, \(\widehat R\), tamaños efectivos de muestra, error Monte Carlo, trazas y diagnósticos específicos de HMC, así como la necesidad de investigar la geometría de la posterior antes de responder mecánicamente a una advertencia (Gelman et al. 2026, chaps. 11-12).
En modelos multinivel esta discusión es especialmente importante. Una desviación estándar grupal cercana a cero puede producir regiones de curvatura muy distinta en la posterior. La parametrización centrada natural,
\[ \alpha_j\sim\mathcal N(\mu_\alpha,\tau_\alpha^2), \]
puede ser estadísticamente equivalente a una parametrización no centrada,
\[ z_j\sim\mathcal N(0,1), \qquad \alpha_j=\mu_\alpha+\tau_\alpha z_j, \]
pero las dos representaciones pueden ser muy diferentes desde el punto de vista de HMC. McElreath desarrolla esta conexión a través del funnel y las transiciones divergentes (McElreath 2020, 420-25). Matsuura dedica su capítulo 9 a separar tres fuentes de dificultades: parámetros no identificados, regularización insuficiente y dependencias posteriores que pueden aliviarse mediante reparametrización.
La secuencia de trabajo de esta semana será:
\[ \boxed{ \text{ajustar} \longrightarrow \text{diagnosticar} \longrightarrow \text{localizar la dificultad} \longrightarrow \text{modificar justificadamente} \longrightarrow \text{volver a ajustar} } \]
La palabra justificadamente es crucial. Aumentar adapt_delta, ampliar max_treedepth o ejecutar más iteraciones puede ser útil en ciertas situaciones, pero ninguna de esas acciones corrige automáticamente un modelo no identificado, una escala mal elegida o una estructura jerárquica con geometría desfavorable. Bayesian Workflow insiste en que una dificultad computacional puede revelar una dificultad de modelación y que modificar el modelo solo hasta conseguir que desaparezcan las advertencias puede alterar la inferencia de manera poco transparente (Gelman et al. 2026, secs. 12.3-12.5).
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
- explicar por qué MCMC permite aproximar cantidades de la distribución posterior y por qué el número bruto de simulaciones no determina por sí solo la precisión;
- interpretar de manera conjunta \(\widehat R\), bulk-ESS, tail-ESS, MCSE, gráficos de trazas y gráficos de rangos;
- describir la idea central de HMC: utilizar gradientes para construir movimientos informados a través de la distribución posterior, evitando el comportamiento de paseo aleatorio;
- explicar, sin necesidad de derivar el algoritmo, el papel práctico del tamaño de paso, la longitud de la trayectoria y la métrica utilizada por HMC;
- describir qué resuelve NUTS y qué ocurre durante la fase de warmup de Stan;
- interpretar una transición divergente y distinguirla de una saturación de
max_treedepth; - explicar qué hace
adapt_delta, cuándo puede ser útil modificarlo y por qué no debe utilizarse como respuesta automática a cualquier advertencia; - definir geometría posterior en términos prácticos como la forma conjunta de la distribución posterior y reconocer cuándo correlaciones fuertes o escalas muy diferentes dificultan el muestreo;
- explicar cómo una estructura jerárquica puede producir una geometría tipo funnel cuando la variación entre grupos es pequeña y la información por grupo es débil;
- demostrar la equivalencia probabilística entre las parametrizaciones centrada y no centrada de un coeficiente grupal normal e interpretar por qué pueden tener comportamientos computacionales diferentes;
- reconocer situaciones en las que centrar predictores, reescalar variables o utilizar una parametrización no centrada puede mejorar el muestreo;
- distinguir dificultad computacional, identificación débil y falta de identificación estadística;
- aplicar un flujo práctico de diagnóstico con
brms,cmdstanr,posteriorybayesplot; - documentar un ajuste computacional de forma reproducible, separando diagnóstico del muestreo, comprobación predictiva e interpretación sustantiva.
7.2 Problema motivador: el mismo modelo, dos comportamientos computacionales
Considere nuevamente un modelo de interceptos variables:
\[ y_{ij}\mid\alpha_j,\sigma \sim \mathcal N(\alpha_j,\sigma^2), \]
\[ \alpha_j\mid\mu_\alpha,\tau_\alpha \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \]
Una forma directa de escribir la segunda línea es
\[ \alpha_j = \mu_\alpha+\varepsilon_j, \qquad \varepsilon_j\sim\mathcal N(0,\tau_\alpha^2). \]
Equivalentemente, podemos introducir una variable estándar \(z_j\):
\[ z_j\sim\mathcal N(0,1), \]
\[ \alpha_j = \mu_\alpha+\tau_\alpha z_j. \tag{7.1}\]
Las dos formulaciones inducen exactamente la misma distribución normal para \(\alpha_j\) condicional en \(\mu_\alpha\) y \(\tau_\alpha\). Por tanto, desde el punto de vista del modelo probabilístico sobre \(\alpha_j\), no hemos cambiado la afirmación sustantiva.
Sin embargo, las coordenadas usadas durante el muestreo sí cambiaron:
- en la parametrización centrada, el algoritmo explora directamente \(\alpha_j\) junto con \(\mu_\alpha\) y \(\tau_\alpha\);
- en la parametrización no centrada, el algoritmo explora \(z_j\), \(\mu_\alpha\) y \(\tau_\alpha\), y obtiene \(\alpha_j\) mediante Ecuación 7.1.
Cuando \(\tau_\alpha\) puede ser muy pequeña y los datos de cada grupo aportan poca información, la escala relevante para los coeficientes grupales cambia con \(\tau_\alpha\). Las dos representaciones anteriores pueden entonces tener comportamientos computacionales muy distintos. Más adelante veremos que esta situación puede producir una geometría con forma de funnel y explicaremos ese fenómeno partiendo del propio modelo jerárquico, antes de introducir el ejemplo abstracto de Neal (McElreath 2020, 420-25; Gelman et al. 2026, sec. 12.3).
La situación plantea una idea central de esta semana:
\[ \boxed{ \text{equivalencia probabilística} \not\Rightarrow \text{equivalencia computacional} } \]
ImportanteLos diagnósticos describen la aproximación computacional
Un buen \(\widehat R\), un ESS grande y ausencia de divergencias son evidencia favorable sobre el muestreo de la posterior definida por el modelo. No demuestran que el modelo sea sustantivamente adecuado ni que sus predicciones reproduzcan los aspectos relevantes de los datos.
Por eso distinguiremos siempre:
- diagnóstico computacional;
- identificación y regularización;
- comprobación predictiva del modelo.
7.3 De la posterior a una aproximación Monte Carlo
Sea \(\theta\) el vector de parámetros y sea
\[ p(\theta\mid y) \]
la distribución posterior. Muchas cantidades de interés pueden escribirse como esperanzas posteriores. Para una función \(h(\theta)\),
\[ \operatorname E[h(\theta)\mid y] = \int h(\theta)p(\theta\mid y)\,d\theta. \]
Si pudiéramos obtener simulaciones independientes
\[ \theta^{(1)},\ldots,\theta^{(S)} \sim p(\theta\mid y), \]
aproximaríamos la esperanza mediante
\[ \widehat{\operatorname E}[h(\theta)\mid y] = \frac{1}{S}\sum_{s=1}^{S}h(\theta^{(s)}). \tag{7.2}\]
El mismo principio permite aproximar cuantiles, probabilidades posteriores y distribuciones predictivas. El problema es que, en modelos complejos, obtener simulaciones independientes de la posterior no suele ser sencillo. MCMC construye una secuencia dependiente que, bajo condiciones apropiadas, visita el espacio de parámetros de acuerdo con la distribución objetivo (Gelman et al. 2013, chaps. 11-12).
7.3.1 Dependencia entre simulaciones
Una cadena de Markov produce valores
\[ \theta^{(1)},\theta^{(2)},\ldots \]
para los cuales el siguiente estado depende del estado actual. Por tanto, dos iteraciones consecutivas pueden contener información redundante. Una cadena con 4000 simulaciones guardadas no necesariamente contiene la misma información Monte Carlo que 4000 simulaciones independientes.
Para una cantidad escalar \(h(\theta)\), una aproximación pedagógica del tamaño efectivo es
\[ S_{\text{eff}} \approx \frac{S} {1+2\sum_{t=1}^{\infty}\rho_t}, \tag{7.3}\]
donde \(\rho_t\) es la autocorrelación en el rezago \(t\). Esta expresión ayuda a entender la idea: autocorrelaciones positivas persistentes reducen la información efectiva. Las implementaciones modernas utilizadas por posterior y Stan emplean estimadores más robustos, incluyendo transformaciones por rangos y versiones diferenciadas para el centro y las colas de la distribución (Gelman et al. 2026, sec. 11.5).
7.3.2 Error estándar Monte Carlo
La posterior tiene incertidumbre porque desconocemos los parámetros. La aproximación numérica añade una segunda fuente: incertidumbre Monte Carlo. Para la media posterior de una cantidad escalar, una relación útil es
\[ \operatorname{MCSE}(\bar h) \approx \frac{\operatorname{sd}(h\mid y)} {\sqrt{S_{\text{eff}}}}. \tag{7.4}\]
La MCSE responde una pregunta computacional:
Si repitiéramos el algoritmo con otra semilla y el mismo modelo, ¿cuánto podría cambiar el resumen numérico únicamente por usar una simulación finita?
No debe confundirse con la desviación estándar posterior. La desviación posterior describe incertidumbre sobre el parámetro; la MCSE describe incertidumbre en nuestra aproximación numérica de un resumen de esa posterior.
NotaMás iteraciones no equivalen a más información sustantiva
Aumentar \(S\) reduce el error Monte Carlo cuando el algoritmo está explorando la distribución correcta. No reduce la incertidumbre posterior debida a pocos datos ni resuelve una falta de identificación.
7.4 Cadenas, valores iniciales y mezcla
Una única trayectoria puede dar una impresión engañosa de estabilidad. Por ello ejecutamos varias cadenas con valores iniciales distintos. Si todas exploran la misma distribución estacionaria, sus distribuciones marginales deberían ser semejantes después de la fase de adaptación.
Bayesian Workflow recomienda utilizar al menos cuatro cadenas independientes como práctica general, precisamente porque múltiples cadenas aumentan la posibilidad de detectar mala adaptación, mezcla deficiente o multimodalidad (Gelman et al. 2026, sec. 11.4).
7.4.1 ¿Qué significa mezclar?
Informalmente, una cadena mezcla bien cuando recorre con suficiente rapidez las regiones relevantes de la posterior, de manera que:
- no queda atrapada durante largos períodos en una región estrecha;
- cadenas iniciadas en puntos diferentes visitan regiones comparables;
- la dependencia serial no destruye la eficiencia de la simulación;
- las cantidades de interés se estiman con error Monte Carlo adecuado al propósito del análisis.
La mezcla es una propiedad de la interacción entre la distribución objetivo, la parametrización y el algoritmo. No existe un único número que la resuma completamente.
7.4.2 Gráficos de trazas
Un gráfico de trazas representa el valor de una cantidad frente a la iteración, separando las cadenas. Puede revelar:
- cadenas ubicadas en regiones distintas;
- desplazamientos lentos;
- períodos largos con poca exploración;
- multimodalidad visible;
- diferencias sistemáticas entre cadenas.
Cuando las cadenas mezclan bien, las trazas suelen superponerse sin patrones persistentes. Cuando existe un problema, las trazas ayudan a formular una hipótesis sobre su causa. Bayesian Workflow señala que estos gráficos son especialmente útiles para investigar problemas, no necesariamente para decorar un informe cuando todos los diagnósticos son favorables (Gelman et al. 2026, sec. 11.4).
7.4.3 Gráficos basados en rangos
Los gráficos de rangos comparan cómo se distribuyen entre cadenas los rangos de las simulaciones combinadas. Si las cadenas exploran la misma distribución, ninguna debería concentrarse sistemáticamente en rangos bajos, medios o altos. Estos gráficos complementan las trazas porque pueden mostrar diferencias distributivas que son difíciles de detectar visualmente en una serie temporal.
7.5 \(\widehat R\): comparar variación entre y dentro de cadenas
El factor potencial de reducción de escala, \(\widehat R\), compara la variación entre cadenas con la variación dentro de las cadenas. La intuición clásica es:
\[ \boxed{ \text{si las cadenas exploran la misma distribución,} \quad \text{variación entre cadenas} \approx \text{variación dentro de cadenas.} } \]
Cuando las cadenas permanecen en regiones diferentes, la variación combinada tiende a exceder la variación observada dentro de cada cadena y \(\widehat R\) se aleja de 1.
Las implementaciones modernas no utilizan simplemente la versión histórica del diagnóstico. Stan y posterior emplean variantes divididas y normalizadas por rangos que son más sensibles a ciertos patrones de no estacionariedad y colas problemáticas. Para un ajuste final, Bayesian Workflow usa como práctica estándar \(\widehat R<1.01\) para todas las cantidades de interés, pero advierte que este umbral no constituye una garantía de que la posterior se haya explorado perfectamente (Gelman et al. 2026, sec. 11.4).
Advertencia\(\widehat R\approx1\) no certifica el ajuste
Es posible que varias cadenas queden atrapadas en la misma región y produzcan \(\widehat R\) aparentemente favorable. También puede existir una región de masa posterior que ninguna cadena encontró. Por ello \(\widehat R\) se interpreta junto con ESS, trazas, diagnósticos de HMC, experimentos con inicialización y conocimiento de la estructura del modelo.
7.6 Tamaño efectivo de muestra: centro y colas
En una distribución posterior no todas las cantidades se estiman con la misma eficiencia. Por eso los resúmenes modernos distinguen al menos:
- bulk-ESS: eficiencia para cantidades asociadas con la región central de la distribución;
- tail-ESS: eficiencia para cuantiles de cola.
Un modelo puede estimar razonablemente bien la media y, sin embargo, tener poca precisión Monte Carlo en un cuantil extremo. Esto importa cuando comunicamos intervalos posteriores, probabilidades de excedencia o predicciones de eventos raros.
Bayesian Workflow utiliza ESS menores que aproximadamente 100 como una señal de preocupación para evaluar convergencia; para el informe final, la cantidad necesaria puede ser mucho mayor y debe determinarse con la MCSE requerida para las cantidades de interés (Gelman et al. 2026, secs. 11.4-11.6, 12.5).
La regla importante no es “ESS debe superar un número mágico”, sino:
\[ \boxed{ \text{la precisión Monte Carlo debe ser suficiente para la decisión inferencial que queremos comunicar.} } \]
7.7 ¿Por qué HMC?
Hasta este punto hemos hablado de cadenas, \(\widehat R\), ESS y MCSE sin depender de un algoritmo MCMC particular. Ahora necesitamos comprender lo suficiente de HMC para interpretar las advertencias que produce Stan.
La comparación más importante es conceptual. Un algoritmo de caminata o paseo aleatorio propone movimientos sin utilizar información sobre la dirección en la que cambia la densidad posterior. En espacios de muchos parámetros esto puede producir desplazamientos cortos y simulaciones muy autocorrelacionadas. HMC, en cambio, utiliza el gradiente de la log posterior para construir movimientos que siguen la forma local de la distribución y pueden recorrer distancias mayores antes de producir una nueva simulación (McElreath 2020, 270-79; Gelman et al. 2013, sec. 12.4).
| Algoritmo | Idea principal | Relevancia para este curso |
|---|---|---|
| Metropolis-Hastings | Proponer un nuevo estado y aceptarlo o rechazarlo | Sirve como contraste: propuestas locales pueden comportarse como un paseo aleatorio |
| Gibbs | Actualizar parámetros o bloques desde distribuciones condicionales | Puede ser eficiente en modelos con condicionales sencillas, pero dependencias fuertes pueden producir movimientos lentos |
| HMC | Utilizar gradientes para construir trayectorias a través de la posterior | Es la base computacional de Stan |
| NUTS | Adaptar automáticamente cuánto debe extenderse una trayectoria HMC | Es la estrategia que utilizaremos mediante Stan, cmdstanr y brms |
Bürkner describe esta ventaja práctica de HMC/NUTS en brms: las simulaciones suelen presentar menor autocorrelación que las producidas por esquemas de paseo aleatorio, aunque cada iteración puede requerir más trabajo computacional porque necesita gradientes (Bürkner 2017).
ImportanteQué necesitamos comprender de HMC
Para utilizar HMC responsablemente no necesitamos derivar las ecuaciones de Hamilton ni implementar el integrador numérico a mano. Sí necesitamos comprender qué significan el gradiente, el tamaño de paso, la longitud de la trayectoria, el warmup y las advertencias que indican que la posterior fue difícil de explorar.
7.8 HMC en términos prácticos
Sea \(\theta\) el vector de parámetros y
\[ \pi(\theta)=p(\theta\mid y) \]
la distribución posterior que queremos explorar. HMC introduce variables auxiliares de momento y construye una trayectoria que combina dos tipos de información:
- la posición actual \(\theta\);
- el gradiente de \(\log \pi(\theta)\), que informa cómo cambia localmente la densidad posterior.
Una forma compacta de representar la construcción es mediante una energía total
\[ H(\theta,r)=U(\theta)+K(r), \]
donde
\[ U(\theta)=-\log \pi(\theta)+C \]
es la energía potencial asociada con la posterior y \(K(r)\) es una energía cinética asociada con el momento auxiliar \(r\). La utilidad de esta representación es práctica: si pudiéramos seguir exactamente una trayectoria de energía constante, podríamos movernos a través de la posterior sin comportarnos como un paseo aleatorio (Gelman et al. 2013, sec. 12.4).
En el computador la trayectoria se aproxima mediante pequeños pasos. Para la interpretación de los diagnósticos basta con retener cuatro ideas.
7.8.1 1. El tamaño de paso controla la resolución numérica
Denotemos el tamaño de paso por \(\epsilon\).
- Un \(\epsilon\) demasiado grande puede ser incapaz de seguir con precisión una región estrecha o muy curva.
- Un \(\epsilon\) más pequeño mejora la resolución numérica, pero exige más trabajo para recorrer una distancia comparable.
Las divergencias aparecen precisamente cuando la aproximación numérica deja de seguir adecuadamente la trayectoria en alguna región de la posterior. Por eso una divergencia contiene información sobre la combinación entre algoritmo y geometría posterior; no es simplemente una advertencia estética.
7.8.2 2. Una trayectoria debe ser suficientemente larga, pero no innecesariamente larga
HMC necesita decidir cuánto avanzar antes de generar la siguiente simulación. Una trayectoria muy corta deja simulaciones consecutivas demasiado próximas. Una trayectoria excesivamente larga desperdicia cómputo e incluso puede comenzar a regresar hacia la región ya recorrida.
NUTS (No-U-Turn Sampler) resuelve este problema construyendo la trayectoria de forma adaptativa y deteniéndola cuando detecta que continuar deja de producir avance útil (McElreath 2020, 274-76). En la práctica, por tanto, no elegimos manualmente un número fijo de pasos HMC para cada iteración.
7.8.3 3. Las escalas de los parámetros importan
Suponga que un parámetro cambia típicamente en centésimas y otro en centenas. Utilizar el mismo concepto de distancia en ambas direcciones sería ineficiente. Stan adapta una métrica —relacionada con la llamada matriz de masa— que permite ajustar las escalas relevantes del movimiento durante warmup (Gelman et al. 2026, secs. 11.3, 12.3).
Esta observación conecta HMC con decisiones de modelación que ya hemos usado:
- centrar predictores puede reducir correlaciones posteriores entre intercepto y pendiente;
- reescalar predictores puede evitar diferencias extremas de escala;
- previas razonables pueden impedir que el modelo asigne masa sustancial a regiones numéricamente problemáticas.
Estas decisiones no se toman para “complacer al sampler”; deben conservar o mejorar la interpretación del modelo y estar justificadas por la escala y el conocimiento del problema.
7.8.4 4. HMC debe recorrer la masa posterior, no solo localizar una moda
Un optimizador busca un punto de alta densidad. MCMC tiene un objetivo diferente: representar la distribución completa. En dimensión alta, una región que concentra mucha masa posterior no tiene por qué coincidir con el punto de máxima densidad. Esta es la razón práctica por la que una cadena que parece haberse “estabilizado” cerca de un valor no es suficiente para concluir que la posterior fue explorada adecuadamente (Gelman et al. 2026, sec. 11.1).
No necesitaremos desarrollar formalmente el concepto de conjunto típico. Para el trabajo aplicado basta con recordar que HMC debe desplazarse por todas las regiones que contribuyen de manera importante a la masa posterior.
7.9 ¿Qué hace Stan durante el warmup?
Las iteraciones iniciales de Stan no se utilizan como simulaciones posteriores. Durante warmup, el algoritmo calibra aspectos necesarios para que HMC/NUTS funcione razonablemente bien, entre ellos:
- el tamaño de paso;
- la métrica o matriz de masa;
- la adaptación necesaria para alcanzar una región representativa de la posterior.
McElreath enfatiza que warmup no es simplemente el antiguo “burn-in”: en Stan es una fase activa de calibración del algoritmo (McElreath 2020, 274-75). Bayesian Workflow recomienda distinguir claramente esta fase de las iteraciones que se conservan para inferencia (Gelman et al. 2026, secs. 11.2-11.4).
En un ajuste usual con brms:
fit <- brm(
  formula = ...,
  data = ...,
  backend = "cmdstanr",
  chains = 4,
  iter = 2000,
  warmup = 1000,
  seed = 1653
)
las primeras 1000 iteraciones de cada cadena corresponden a warmup y las restantes 1000 contribuyen a la muestra posterior.
AdvertenciaReducir warmup no es una optimización inocua
En etapas exploratorias puede tener sentido usar ajustes cortos para detectar errores rápidamente. Para un ajuste que se pretende interpretar, un warmup demasiado corto puede dejar una adaptación deficiente. La solución no es escoger el menor número de iteraciones que permita terminar rápido, sino verificar que el ajuste final produzca simulaciones confiables.
7.10 Diagnósticos específicos de HMC/NUTS
Los diagnósticos generales —\(\widehat R\), ESS, MCSE, trazas y rangos— responden a la pregunta de si las cadenas parecen representar una misma distribución con precisión suficiente. HMC añade información sobre cómo se construyeron las trayectorias.
Para el trabajo del curso daremos prioridad a dos advertencias: divergencias y saturaciones de la profundidad máxima del árbol.
7.10.1 Transiciones divergentes
Una transición divergente indica que la integración numérica acumuló un error suficientemente grande como para que la trayectoria deje de ser confiable. Esto suele ocurrir cuando la posterior contiene regiones estrechas, curvaturas fuertes o escalas que cambian rápidamente (McElreath 2020, 420-23; Gelman et al. 2026, sec. 12.3).
La interpretación práctica es:
Una divergencia sugiere que alguna región relevante de la posterior puede no estar siendo explorada correctamente.
No debemos eliminar las simulaciones divergentes como si fueran valores atípicos. Tampoco debemos concluir que “unas pocas no importan” sin investigar dónde ocurren.
7.10.2 adapt_delta: qué hace y qué no hace
adapt_delta controla el objetivo de aceptación usado por Stan durante la adaptación. Aumentarlo suele conducir a un tamaño de paso más pequeño. Por eso puede reducir divergencias cuando estas se deben a que el paso es demasiado grande para seguir una región difícil.
Por ejemplo:
control = list(adapt_delta = 0.95)o, si el problema persiste después de revisar el modelo,
control = list(adapt_delta = 0.99)Un valor mayor tiene un costo: normalmente exige más evaluaciones del gradiente y aumenta el tiempo de ejecución. Más importante aún, hacer desaparecer divergencias al aumentar adapt_delta no demuestra que la parametrización sea adecuada. En el ejemplo jerárquico de Bayesian Workflow, reducir el tamaño de paso elimina divergencias pero las cadenas continúan mezclando mal; la mejora importante aparece al reparametrizar el modelo (Gelman et al. 2026, sec. 12.3). McElreath muestra el mismo patrón en su discusión del funnel (McElreath 2020, 423-25).
7.10.3 Profundidad máxima del árbol
NUTS construye la trayectoria mediante expansiones sucesivas. treedepth__ registra cuántos niveles fueron necesarios. Si una iteración alcanza repetidamente max_treedepth, el algoritmo estaba intentando construir trayectorias más largas que el límite permitido.
Esto suele ser una señal de ineficiencia más que de fallo numérico directo. Puede aparecer por:
- correlaciones posteriores fuertes;
- escalas mal adaptadas;
- parametrizaciones que obligan a recorrer trayectorias muy largas.
Aumentar max_treedepth permite más trabajo por iteración, pero no elimina la causa. Antes conviene revisar escalas, centrado de predictores y parametrización (Gelman et al. 2026, sec. 12.3).
ImportanteDivergencias y profundidad máxima no significan lo mismo
- Divergencia: la trayectoria numérica dejó de ser confiable en una región; puede comprometer la exploración posterior.
- Profundidad máxima: NUTS necesitó una trayectoria más larga que el límite permitido; suele indicar baja eficiencia.
Ambas requieren investigación, pero la respuesta no es la misma.
7.10.4 Número de pasos leapfrog: diagnóstico secundario
n_leapfrog__ indica cuánto trabajo hizo NUTS en una iteración. Es útil para comparar costo entre ajustes, pero no será un criterio principal de diagnóstico en este curso. Un ajuste puede tener muchos pasos leapfrog y aun así producir una muestra válida; la pregunta es si ese costo se acompaña de buena mezcla y precisión suficiente.
7.11 Geometría posterior: una definición práctica
La expresión geometría posterior puede sonar más abstracta de lo necesario. En estas notas la utilizaremos con un significado simple:
La geometría posterior es la forma que tiene la distribución conjunta de los parámetros que el algoritmo debe recorrer.
Imagine dos parámetros y un gráfico de sus simulaciones posteriores.
- Si la nube es aproximadamente redondeada o elíptica y sus escalas son comparables, HMC suele tener una tarea relativamente sencilla.
- Si la nube es extremadamente alargada, se curva o cambia de anchura de forma abrupta, el mismo tamaño de paso puede no funcionar bien en todas sus regiones.
La geometría no es una propiedad misteriosa adicional al modelo. Surge de la combinación entre verosimilitud, previas y parametrización.
7.11.1 Ejemplo: intercepto y pendiente fuertemente correlacionados
Suponga una regresión
\[ y_i=\alpha+\beta x_i+\varepsilon_i \]
en la que \(x\) toma valores alrededor de 2000. El intercepto \(\alpha\) representa el valor esperado en \(x=0\), muy lejos de la región observada. Cambiar ligeramente \(\beta\) puede exigir una gran compensación en \(\alpha\) para mantener predicciones semejantes cerca de \(x=2000\). La posterior de \((\alpha,\beta)\) puede quedar muy alargada.
Al definir
\[ x_i^*=x_i-2000, \]
el nuevo intercepto representa el valor esperado cerca de los datos. Esta simple reexpresión puede reducir mucho la correlación posterior y mejorar la eficiencia computacional sin cambiar las predicciones del modelo. Bayesian Workflow utiliza este tipo de ejemplo para mostrar que una mejora de parametrización puede ser al mismo tiempo una mejora de interpretación (Gelman et al. 2026, sec. 12.3).
Este ejemplo proporciona la primera regla práctica:
\[ \boxed{ \text{antes de modificar controles de NUTS, revise si las coordenadas del modelo son razonables.} } \]
7.12 Del modelo jerárquico al funnel
La geometría tipo funnel se entiende mejor si comenzamos con un modelo ya conocido, no con un ejemplo abstracto. Considere
\[ \alpha_j\mid\mu_\alpha,\tau_\alpha \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \]
La desviación estándar \(\tau_\alpha\) determina cuánto pueden separarse los interceptos grupales de la media poblacional.
- Si \(\tau_\alpha\) es grande, los \(\alpha_j\) pueden distribuirse en un intervalo amplio.
- Si \(\tau_\alpha\) es pequeña, todos los \(\alpha_j\) deben quedar muy cerca de \(\mu_\alpha\).
Por tanto, la escala permitida para los coeficientes grupales cambia con \(\tau_\alpha\). Cuando los datos de cada grupo son suficientemente informativos, la verosimilitud puede restringir esta relación y la posterior ser fácil de explorar. Cuando hay pocos datos por grupo o mucha incertidumbre, la posterior puede conservar una región en la que \(\tau_\alpha\) se acerca a cero y los coeficientes grupales quedan simultáneamente comprimidos.
Si representamos un coeficiente grupal frente a \(\log(\tau_\alpha)\), la distribución puede verse ancha para valores grandes de \(\tau_\alpha\) y muy estrecha cuando \(\tau_\alpha\) se aproxima a cero. De ahí proviene la forma de embudo o funnel.
7.12.1 ¿Por qué es difícil para HMC?
El problema puede resumirse sin recurrir a más formalismo:
- en la parte ancha, HMC puede recorrer la posterior con pasos relativamente grandes;
- en la parte estrecha, esos mismos pasos pueden ser demasiado grandes y producir errores numéricos;
- reducir mucho el tamaño de paso puede permitir atravesar la parte estrecha, pero vuelve costosa la exploración de la parte ancha.
Esta combinación explica por qué las divergencias suelen concentrarse en la región estrecha de un funnel. Bayesian Workflow muestra además que, cuando la verosimilitud es débil, el problema puede persistir incluso después de aumentar adapt_delta; la reparametrización suele ser una solución más efectiva (Gelman et al. 2026, sec. 12.3). La Figura 12.12 de ese texto ilustra justamente la secuencia centrada → centrada con mayor adapt_delta → no centrada, mostrando que eliminar divergencias no implica necesariamente una buena mezcla.
NotaEl funnel de Neal como ejemplo didáctico
Neal propuso un ejemplo abstracto que hace visible este mecanismo. McElreath utiliza una versión bidimensional:
\[ v\sim\mathcal N(0,3^2), \qquad x\mid v\sim\mathcal N\!\left(0,\exp(2v)\right). \]
Cuando \(v\) disminuye, la desviación estándar condicional \(\exp(v)\) se vuelve muy pequeña y \(x\) queda forzado cerca de cero. Cuando \(v\) aumenta, \(x\) puede ocupar un intervalo mucho más amplio. El ejemplo no introduce una nueva clase de modelo: amplifica la misma dependencia de escala que puede aparecer entre \(\tau_\alpha\) y los coeficientes grupales en un modelo multinivel (McElreath 2020, 420-23).
7.13 Parametrización centrada y no centrada
La solución más importante al funnel jerárquico no consiste en modificar la distribución que queremos modelar, sino en cambiar las coordenadas que utiliza HMC.
7.13.1 Forma centrada
La forma habitual es
\[ \alpha_j\mid\mu_\alpha,\tau_\alpha \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \]
HMC muestrea directamente los \(\alpha_j\). Si \(\tau_\alpha\) cambia mucho, también cambia directamente la escala en la que esos parámetros pueden moverse.
7.13.2 Forma no centrada
Introducimos variables estandarizadas
\[ z_j\sim\mathcal N(0,1) \]
y definimos
\[ \alpha_j=\mu_\alpha+\tau_\alpha z_j. \]
Ahora HMC muestrea los \(z_j\), cuya escala previa permanece fija, y los coeficientes \(\alpha_j\) se obtienen mediante una transformación.
La equivalencia es inmediata:
\[ z_j\sim\mathcal N(0,1) \quad\Longrightarrow\quad \mu_\alpha+\tau_\alpha z_j \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \]
Por tanto, el modelo sobre \(\alpha_j\) no cambió. Cambió la representación computacional.
| Forma | Parámetro que HMC explora directamente | Situación en la que suele ser favorable |
|---|---|---|
| Centrada | \(\alpha_j\) | Datos relativamente informativos para cada grupo |
| No centrada | \(z_j\) y luego \(\alpha_j=\mu_\alpha+\tau_\alpha z_j\) | Pocos datos por grupo, señal grupal débil o \(\tau_\alpha\) cercana a cero |
McElreath y Bayesian Workflow enfatizan que la forma no centrada no es universalmente superior. Con información fuerte por grupo, la parametrización centrada puede ser más eficiente; el caso difícil aparece cuando distintos componentes del mismo modelo tienen cantidades de información muy diferentes (McElreath 2020, 425; Gelman et al. 2026, sec. 12.3).
Matsuura desarrolla esta reparametrización como una herramienta específica para mejorar la exploración de modelos jerárquicos cuando la dependencia entre parámetros produce problemas de convergencia.
Nota¿Qué ocurre en
brms?
En el trabajo aplicado no escribiremos rutinariamente estas transformaciones a mano. brms genera código Stan y utiliza por defecto parametrizaciones no centradas para muchos efectos grupales (Gelman et al. 2026, sec. 5.6). La discusión sigue siendo importante porque explica por qué un modelo jerárquico puede producir advertencias y qué tipo de modificación sería apropiada al trabajar directamente en Stan o en modelos más especializados.
7.14 Un orden práctico para responder a advertencias
La meta del diagnóstico no es conseguir una salida “sin mensajes”. La meta es obtener una aproximación posterior suficientemente confiable y comprender por qué las modificaciones realizadas son apropiadas.
Usaremos el siguiente orden.
7.14.1 Paso 1. Leer la advertencia antes de cambiar controles
Distinga si el problema principal es:
- \(\widehat R\) elevado;
- ESS pequeño;
- divergencias;
max_treedepth;- error numérico o cadenas que no terminaron.
Estas señales no son equivalentes.
7.14.2 Paso 2. Revisar el modelo y las escalas
Antes de aumentar adapt_delta o max_treedepth, compruebe:
- unidades y transformaciones;
- centrado de predictores;
- escalas extremadamente diferentes;
- parámetros redundantes;
- previas excesivamente amplias;
- componentes jerárquicos débilmente informados.
7.14.3 Paso 3. Relacionar la señal con una causa plausible
| Señal principal | Qué puede estar ocurriendo | Primera investigación |
|---|---|---|
| \(\widehat R\) alto o cadenas separadas | mezcla deficiente, multimodalidad, identificación débil | trazas, rangos, inicialización, estructura del modelo |
| ESS bajo sin otras advertencias | autocorrelación alta o muestra insuficiente | trazas, correlaciones posteriores, MCSE |
| Divergencias | regiones estrechas o muy curvas, funnel, escalas problemáticas | estructura jerárquica, pares de parámetros, centrado, previas |
max_treedepth frecuente |
trayectorias demasiado largas | correlaciones, escalas, parametrización |
| Posterior muy sensible a la previa | datos poco informativos | análisis de sensibilidad y pregunta de identificación |
7.14.4 Paso 4. Aplicar una modificación que responda a la causa
Ejemplos:
- centrar o reescalar un predictor;
- usar una parametrización no centrada en un modelo Stan;
- especificar una previa regularizadora solo si es sustantivamente defendible;
- eliminar una redundancia;
- simplificar temporalmente el modelo para aislar el componente problemático;
- aumentar
adapt_deltacuando un tamaño de paso menor sea una respuesta razonable; - ejecutar más iteraciones cuando el único problema sea precisión Monte Carlo insuficiente.
7.14.5 Paso 5. Volver a ajustar y repetir el diagnóstico
Después de cualquier modificación, vuelva a revisar \(\widehat R\), ESS, MCSE, trazas y advertencias de NUTS. No asuma que el cambio resolvió el problema solo porque desapareció un mensaje.
7.14.6 Paso 6. Separar diagnóstico computacional de comprobación del modelo
Un ajuste sin divergencias y con \(\widehat R\) cercano a 1 puede representar perfectamente la posterior de un modelo que describe mal los datos. La comprobación predictiva posterior sigue siendo necesaria.
7.15 Identificación estadística y dificultad computacional
Una dificultad computacional no debe confundirse con falta de identificación.
Considere
\[ y_i \sim \mathcal N\left(a+(b+c)x_i,\sigma^2\right). \tag{7.5}\]
La verosimilitud depende de \(b\) y \(c\) únicamente mediante
\[ \delta=b+c. \]
Si reemplazamos
\[ b^*=b+d, \qquad c^*=c-d, \]
la suma sigue siendo la misma y el modelo para los datos observados no cambia. Los datos pueden informar \(\delta\), pero no distinguir por separado \(b\) y \(c\) sin estructura adicional. Matsuura utiliza esencialmente esta construcción para ilustrar parámetros no identificados.
7.15.1 Una previa propia puede regularizar, pero no determina qué información aportaron los datos
Supongamos que asignamos
\[ b\sim\mathcal N(0,1), \qquad c\sim\mathcal N(0,1). \]
Estas previas pueden hacer que la distribución posterior sea propia y computacionalmente más estable porque restringen los valores plausibles de \(b\) y \(c\). Sin embargo, esto no implica que los datos permitan distinguir claramente ambos coeficientes.
Si la verosimilitud depende principalmente de \(b+c\), distintas parejas de valores de \(b\) y \(c\) pueden ser igualmente compatibles con los datos siempre que produzcan aproximadamente la misma suma. La información necesaria para separar ambos coeficientes proviene entonces parcial o totalmente de las previas. Sería incorrecto afirmar que los datos identificaron por separado a \(b\) y \(c\).
La distinción es importante en modelos multinivel. Una desviación estándar entre grupos puede estar débilmente informada cuando hay pocos grupos o poca información dentro de ellos. Una previa razonable puede restringir valores extremos y facilitar el ajuste, pero no crea información que los datos no contienen.
ImportanteTres preguntas diferentes
- Computación: ¿el algoritmo representó adecuadamente la posterior especificada?
- Identificación: ¿qué combinaciones de parámetros están realmente informadas por los datos y las previas?
- Adecuación: ¿el modelo reproduce los aspectos relevantes de los datos?
Resolver una de estas preguntas no resuelve automáticamente las otras dos.
7.16 Laboratorio reproducible en R
El laboratorio se organiza alrededor de dos objetivos. Primero aislaremos dos ideas que suelen generar confusión —dependencia entre simulaciones y geometría jerárquica— mediante simulaciones sencillas que no dependen de que un ajuste patológico de HMC logre terminar. Después utilizaremos un modelo brms real para practicar el flujo que se aplicará en el proyecto del curso.
- ESS y autocorrelación: mismo número de simulaciones, distinta cantidad de información efectiva.
- Geometría jerárquica: visualizar por qué una escala grupal pequeña comprime los coeficientes y cómo la parametrización no centrada cambia las coordenadas.
- Aplicación con
sleepstudy: revisar \(\widehat R\), ESS, MCSE, trazas y diagnósticos de NUTS en un ajuste conbrmsycmdstanr.
7.16.1 Experimento 1: autocorrelación y tamaño efectivo
Construiremos dos secuencias con la misma distribución marginal normal estándar y el mismo número de elementos. Una será aproximadamente independiente y la otra tendrá dependencia AR(1) fuerte. No son ajustes posteriores reales; el objetivo es aislar el efecto de la dependencia serial.
Ambas series tienen aproximadamente la misma media y desviación estándar.
datos_mc_s7 |>
  group_by(serie) |>
  summarise(
    media = mean(valor),
    sd = sd(valor),
    .groups = "drop"
  )
# A tibble: 2 × 3
serie media sd
<chr> <dbl> <dbl>
1 Dependencia alta -0.170 0.943
2 Dependencia baja -0.00397 1.00 datos_mc_s7 |>
filter(iteracion <= 600) |>
ggplot(aes(x = iteracion, y = valor)) +
geom_line(linewidth = 0.4) +
facet_wrap(~ serie, ncol = 1) +
labs(
x = "Iteración",
y = "Valor simulado"
) +
theme_minimal(base_size = 12)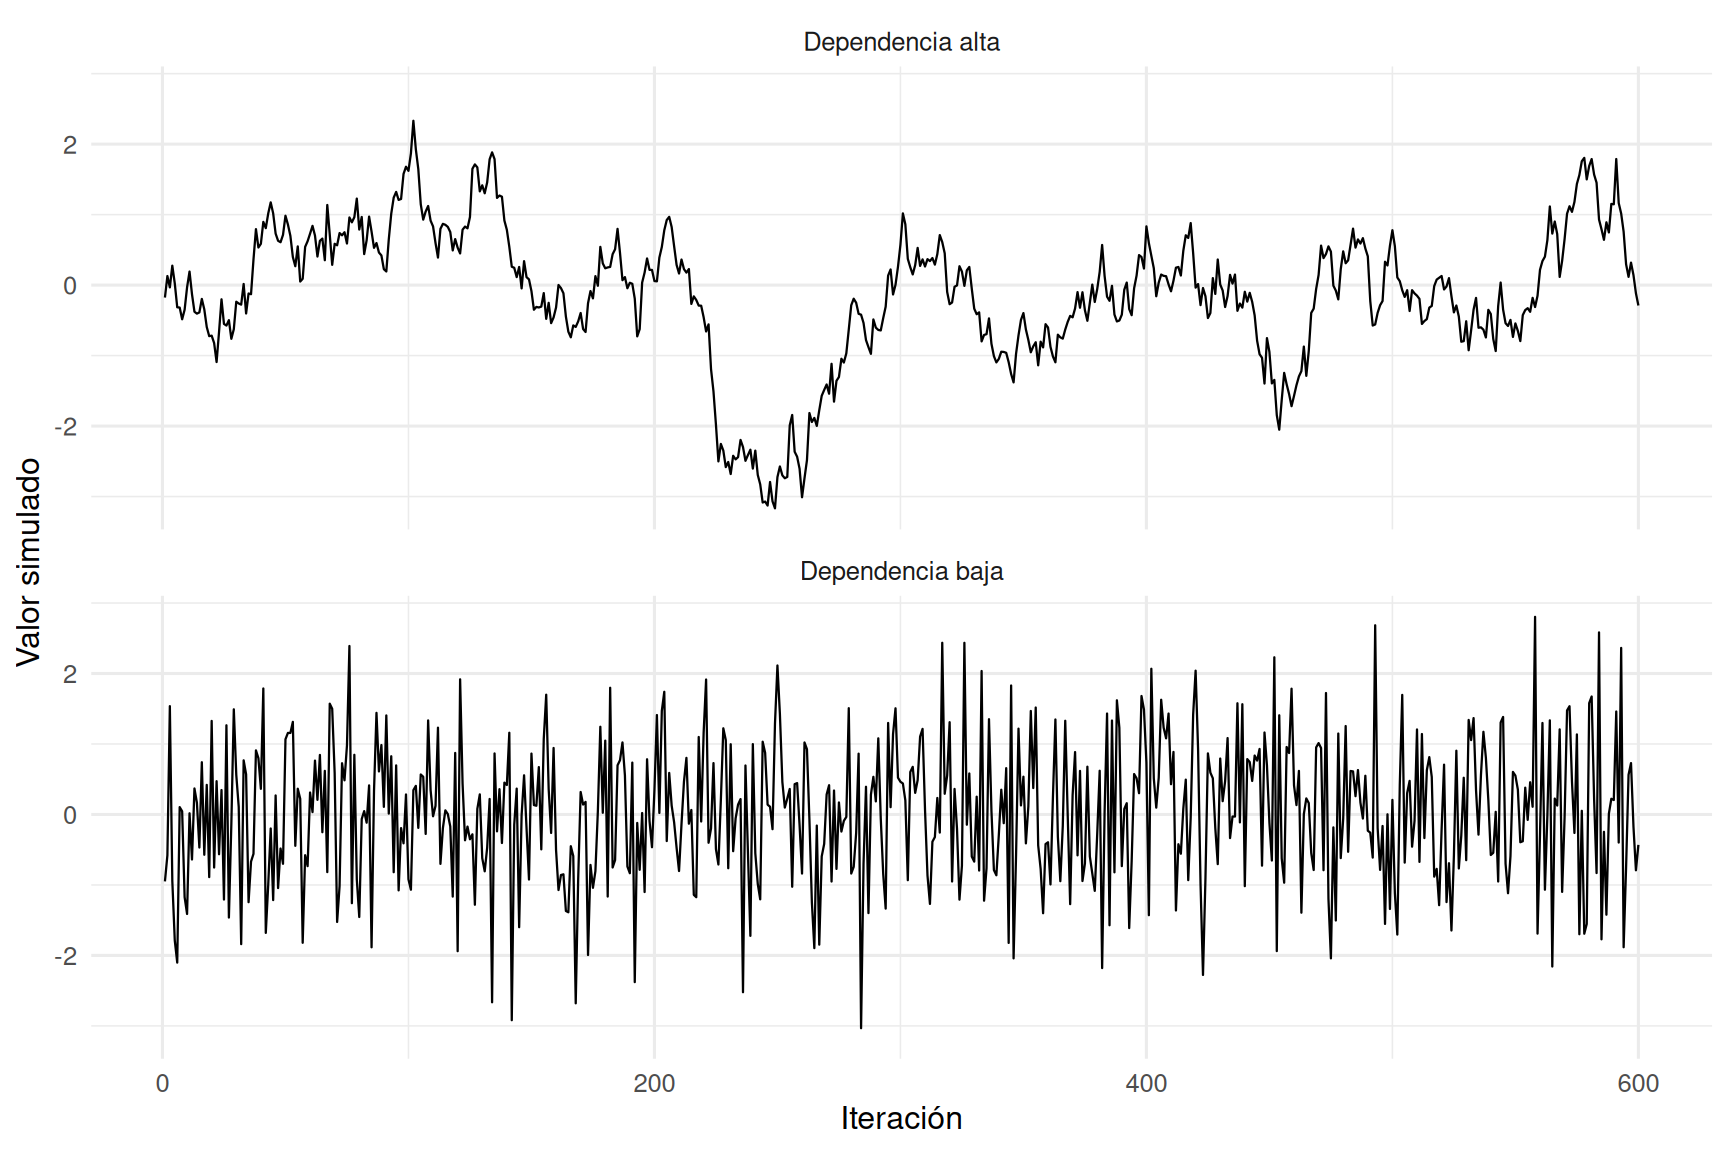
Ahora convertimos cada secuencia en un objeto de posterior y calculamos ESS y MCSE.
draws_ind <- posterior::as_draws_matrix(
  matrix(sim_ind, ncol = 1, dimnames = list(NULL, "theta"))
)

draws_dep <- posterior::as_draws_matrix(
  matrix(sim_dep, ncol = 1, dimnames = list(NULL, "theta"))
)

bind_rows(
  posterior::summarise_draws(
    draws_ind,
    "mean", "sd", "ess_bulk", "ess_tail", "mcse_mean"
  ) |>
    mutate(serie = "Dependencia baja"),
  posterior::summarise_draws(
    draws_dep,
    "mean", "sd", "ess_bulk", "ess_tail", "mcse_mean"
  ) |>
    mutate(serie = "Dependencia alta")
) |>
  select(
    serie,
    variable,
    mean,
    sd,
    ess_bulk,
    ess_tail,
    mcse_mean
  )
# A tibble: 2 × 7
serie variable mean sd ess_bulk ess_tail mcse_mean
<chr> <chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Dependencia baja theta -0.00397 1.00 3835. 3883. 0.0161
2 Dependencia alta theta -0.170 0.943 90.2 201. 0.0992El número bruto de valores es idéntico, pero la serie con dependencia fuerte contiene mucha menos información efectiva para estimar la media. Este resultado motiva el uso de ESS en lugar de reportar únicamente el número total de iteraciones.
7.16.2 Experimento 2: visualizar la geometría jerárquica
En lugar de comenzar con el funnel abstracto de Neal, simularemos directamente una estructura que ya conocemos:
\[ z_j\sim\mathcal N(0,1), \qquad \alpha_j=\mu_\alpha+\tau_\alpha z_j. \]
Para visualizar solamente la relación entre escala y coeficiente tomaremos \(\mu_\alpha=0\) y generaremos muchos pares \((\tau,\alpha)\). Utilizamos una distribución lognormal para \(\tau\) únicamente como dispositivo gráfico: produce valores positivos en un intervalo suficientemente amplio para mostrar la relación.
set.seed(1653073)

n_geom <- 8000

geom_jerarquica_s7 <- tibble(
  log_tau = rnorm(n_geom, mean = -0.5, sd = 1),
  tau = exp(log_tau),
  z = rnorm(n_geom)
) |>
  mutate(
    alpha = tau * z
  )
En coordenadas centradas observamos \(\alpha\) frente a \(\log(\tau)\).
geom_jerarquica_s7 |>
  ggplot(aes(x = log_tau, y = alpha)) +
  geom_point(alpha = 0.16, size = 0.7) +
  coord_cartesian(ylim = c(-12, 12)) +
  labs(
    x = expression(log(tau)),
    y = expression(alpha)
  ) +
  theme_minimal(base_size = 12)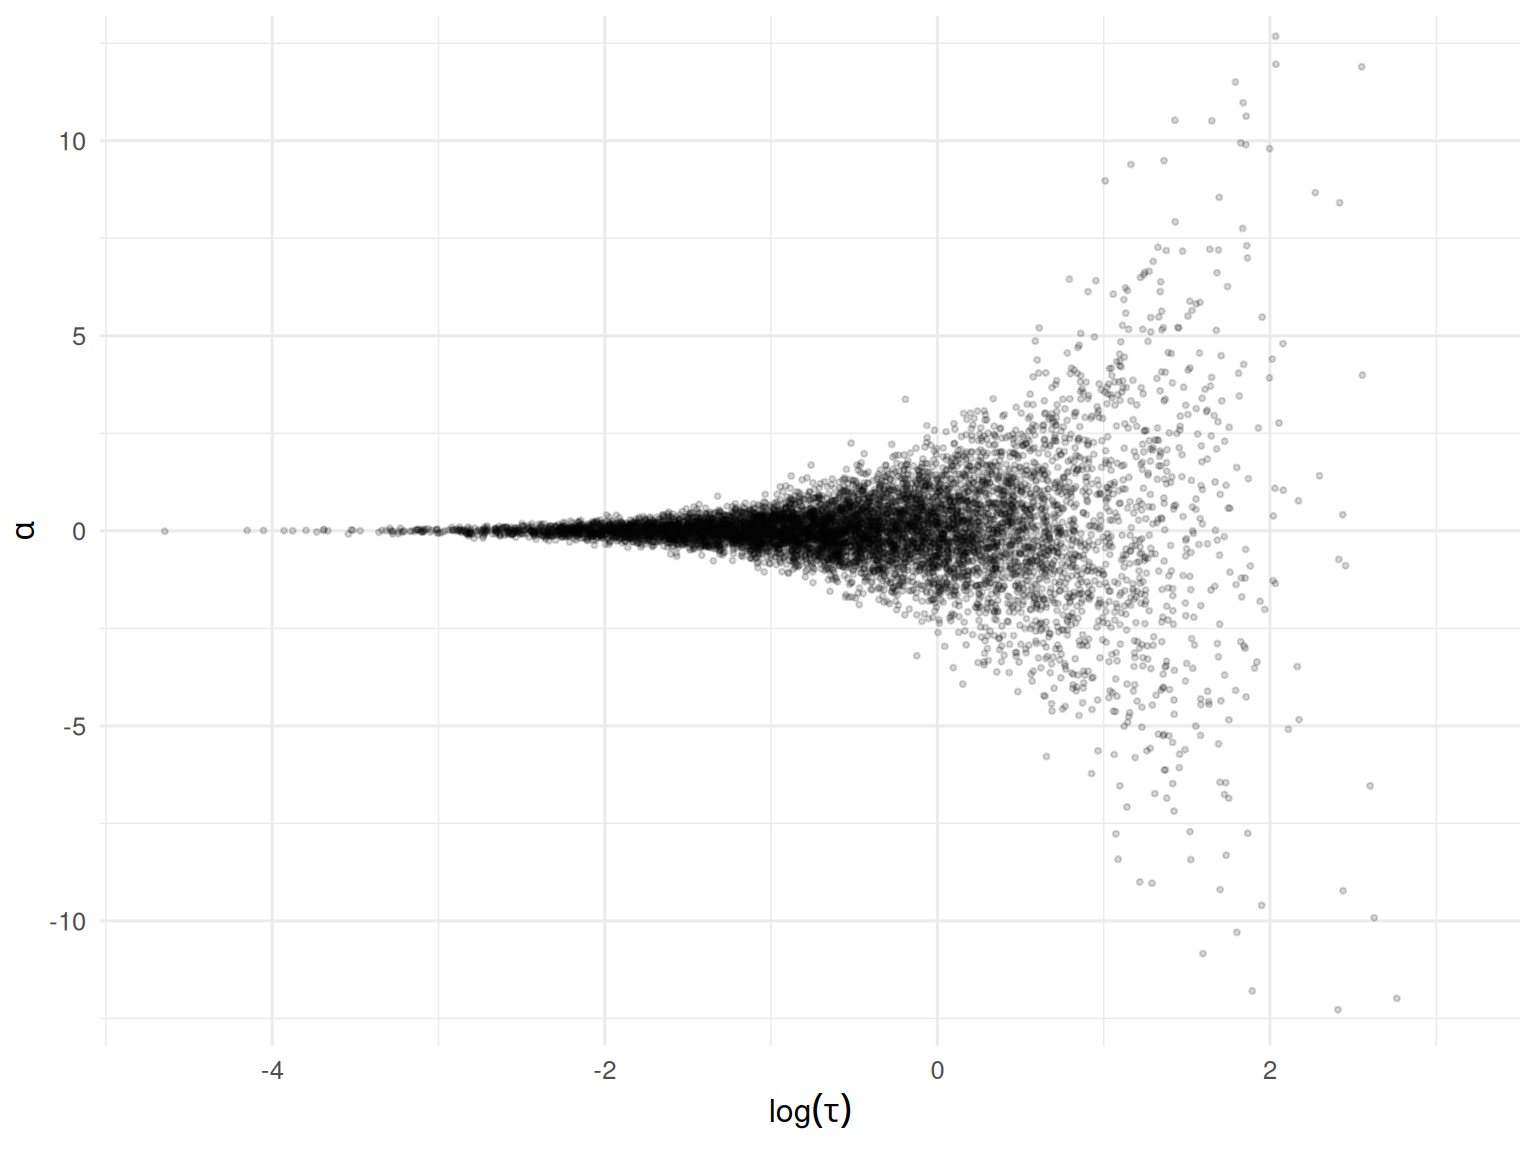
La figura permite leer el mecanismo del funnel directamente:
- a la izquierda, \(\tau\) es pequeña y \(\alpha\) debe quedar muy cerca de cero;
- a la derecha, \(\tau\) es mayor y \(\alpha\) puede ocupar un intervalo más amplio.
No hemos ejecutado HMC. La forma proviene de la estructura probabilística del modelo.
Ahora observemos las coordenadas no centradas, es decir, \(z\) frente a \(\log(\tau)\).
geom_jerarquica_s7 |>
  ggplot(aes(x = log_tau, y = z)) +
  geom_point(alpha = 0.16, size = 0.7) +
  labs(
    x = expression(log(tau)),
    y = "z"
  ) +
  theme_minimal(base_size = 12)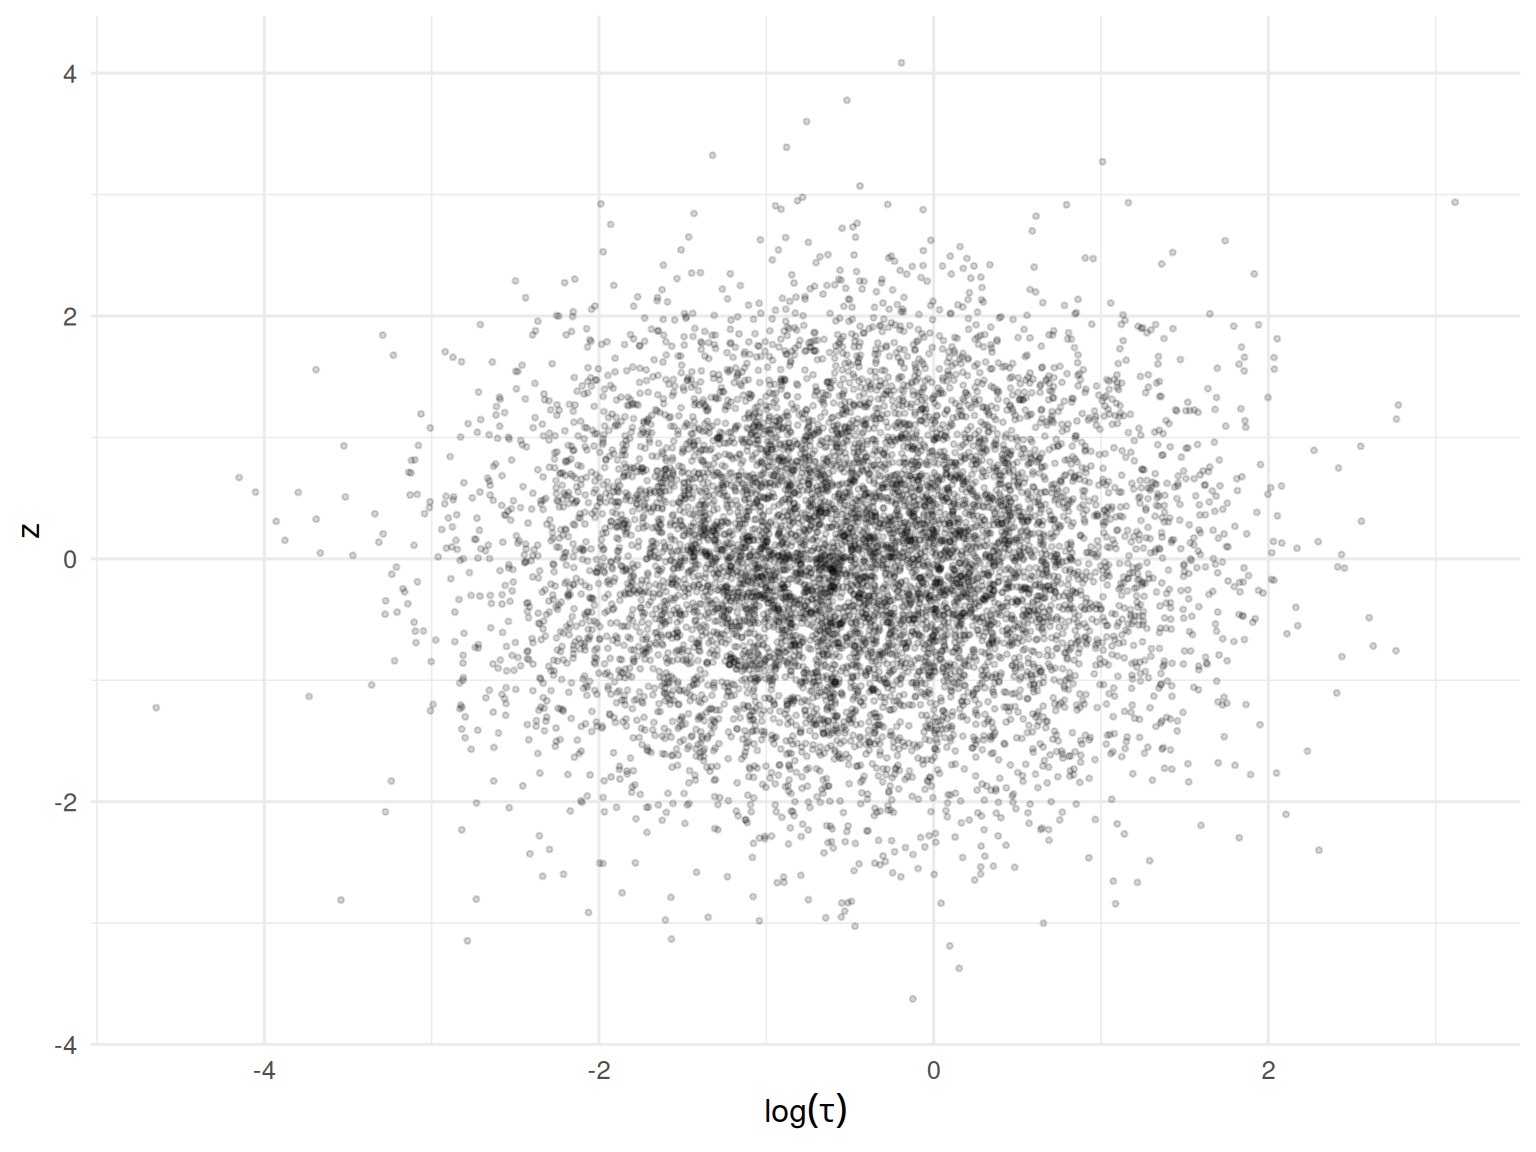
Las dos figuras representan la misma relación jerárquica,
\[ \alpha=\tau z, \]
pero en la segunda HMC exploraría una coordenada \(z\) cuya escala no se comprime cuando \(\tau\) se aproxima a cero. Esta es la intuición que necesitamos para comprender la parametrización no centrada.
7.16.3 Lectura práctica de las dos figuras
Las figuras anteriores deben interpretarse en cuatro pasos:
- \(\tau\) controla la dispersión de los coeficientes grupales;
- si \(\tau\) puede acercarse a cero, la escala de \(\alpha_j\) puede cambiar drásticamente;
- con datos débiles por grupo, la posterior puede conservar esa estructura;
- una parametrización no centrada mueve la escala cambiante a la transformación \(\alpha_j=\mu_\alpha+\tau_\alpha z_j\) y deja a \(z_j\) en una escala fija.
Este es el mensaje práctico del funnel. No es necesario memorizar la forma exacta del ejemplo de Neal para diagnosticar un modelo multinivel.
7.17 Aplicación: diagnóstico de un modelo de trayectorias con sleepstudy
Retomaremos sleepstudy, utilizado en la semana 6 para discutir previas. El objetivo aquí no es volver a elegir las previas desde cero, sino completar un informe computacional reproducible.
Los datos contienen mediciones repetidas de tiempo de reacción durante días de privación de sueño. Utilizaremos interceptos y pendientes variables por sujeto. Para que el intercepto represente una condición dentro del rango observado, centraremos Days en su media.
datos_s7 <- lme4::sleepstudy |>
  as_tibble() |>
  mutate(
    Subject = factor(Subject),
    Days_c = Days - mean(Days)
  )

datos_s7 |>
  summarise(
    n = n(),
    n_subject = n_distinct(Subject),
    min_days = min(Days),
    max_days = max(Days),
    media_days = mean(Days),
    faltantes = sum(is.na(Reaction))
  )
# A tibble: 1 × 6
n n_subject min_days max_days media_days faltantes
<int> <int> <dbl> <dbl> <dbl> <int>
1 180 18 0 9 4.5 0datos_s7 |>
ggplot(
aes(
x = Days,
y = Reaction,
group = Subject
)
) +
geom_line(alpha = 0.45) +
geom_point(alpha = 0.75, size = 1.2) +
labs(
x = "Día de privación de sueño",
y = "Tiempo de reacción (ms)"
) +
theme_minimal(base_size = 12)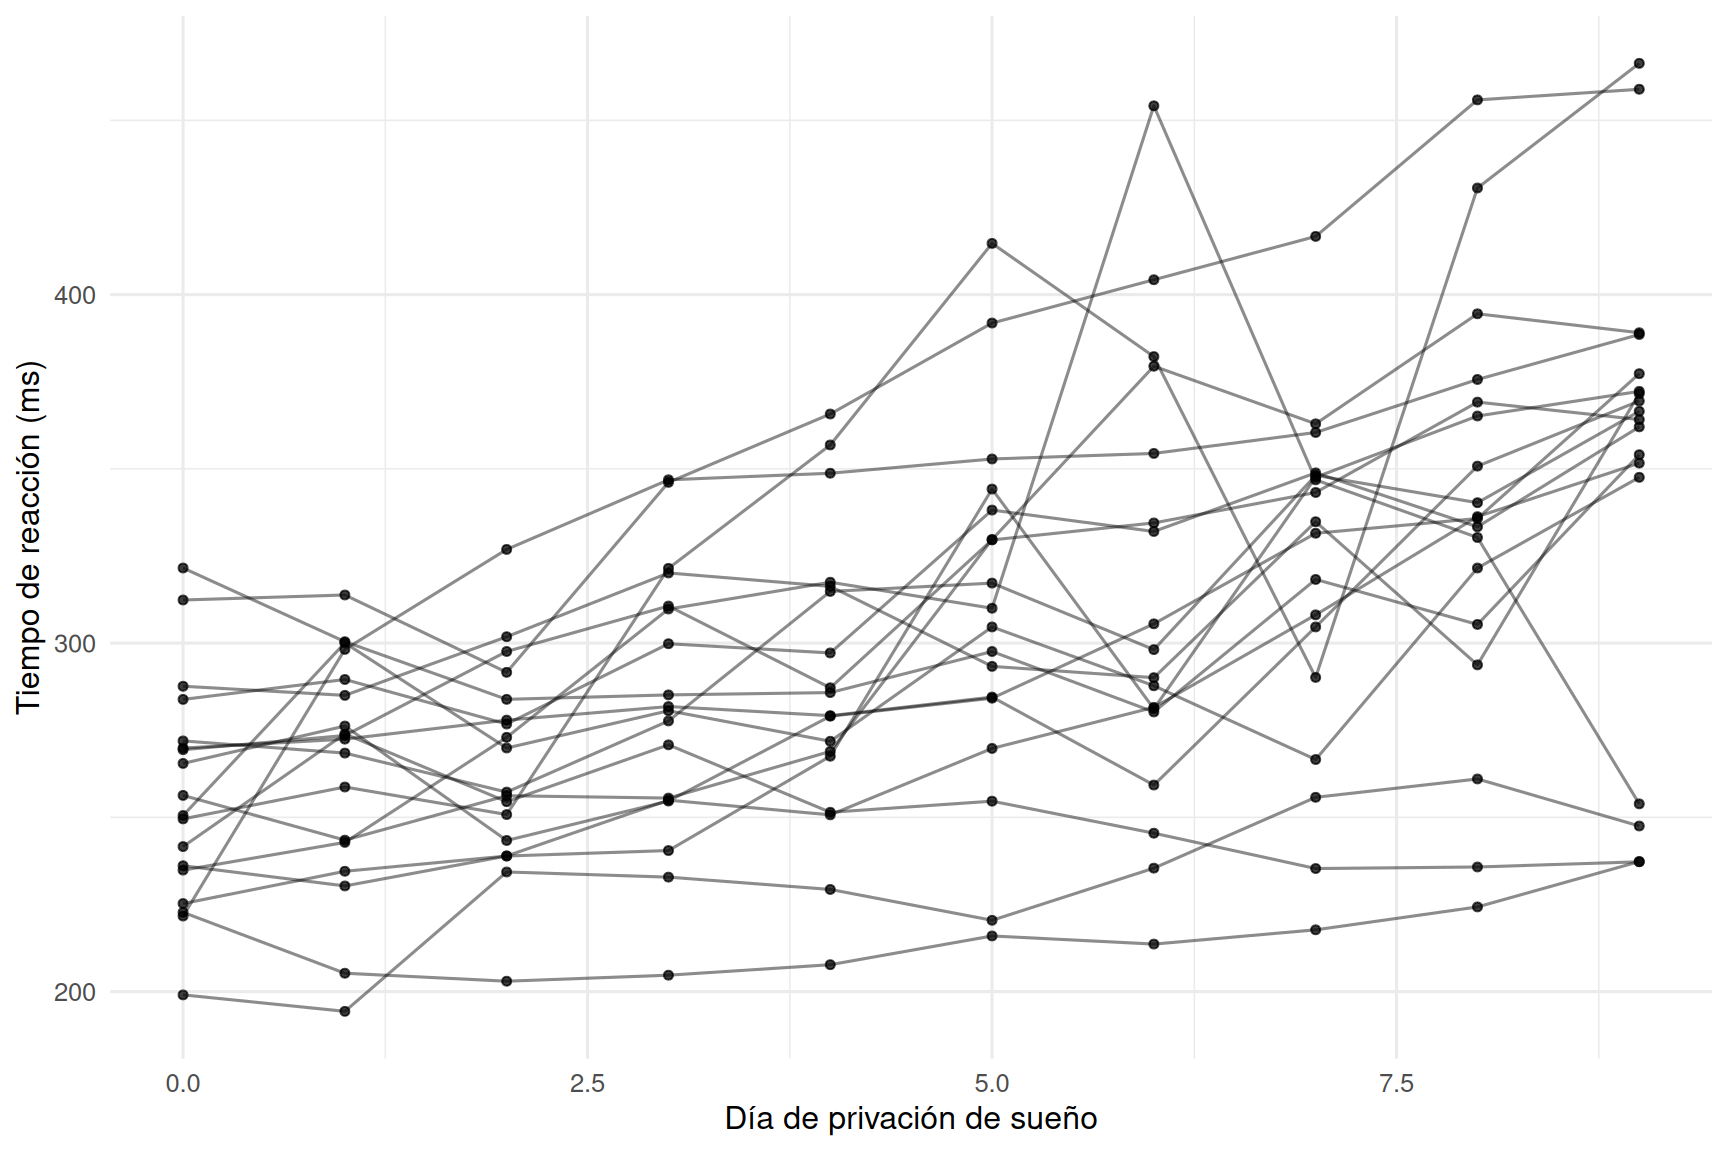
7.17.1 Especificación del modelo
Escribimos
\[ Reaction_{ij} \sim \mathcal N(\mu_{ij},\sigma^2), \]
\[ \mu_{ij} = \alpha_j+\beta_j Days^c_{ij}, \]
con
\[ \begin{pmatrix} \alpha_j\\ \beta_j \end{pmatrix} \sim \mathcal N_2 \left( \begin{pmatrix} \mu_\alpha\\ \mu_\beta \end{pmatrix}, \Sigma \right). \]
En brms:
formula_s7 <- bf(
  Reaction ~ 1 + Days_c + (1 + Days_c | Subject)
)

formula_s7
Reaction ~ 1 + Days_c + (1 + Days_c | Subject) 7.17.2 Previas
Usaremos previas explícitas coherentes con la escala trabajada en la semana 6. Debido al centrado, el intercepto corresponde aproximadamente a la mitad del período de observación, por lo que usamos una previa centrada en una magnitud de reacción plausible para esa región.
priors_s7 <- c(
  prior(normal(300, 100), class = "Intercept"),
  prior(normal(0, 20), class = "b", coef = "Days_c"),
  prior(
    exponential(0.02),
    class = "sd",
    group = "Subject",
    coef = "Intercept"
  ),
  prior(
    exponential(0.05),
    class = "sd",
    group = "Subject",
    coef = "Days_c"
  ),
  prior(lkj(2), class = "cor", group = "Subject"),
  prior(exponential(0.02), class = "sigma")
)

priors_s7
prior class coef group resp dpar nlpar lb ub tag
normal(300, 100) Intercept <NA> <NA>
normal(0, 20) b Days_c <NA> <NA>
exponential(0.02) sd Intercept Subject <NA> <NA>
exponential(0.05) sd Days_c Subject <NA> <NA>
lkj(2) cor Subject <NA> <NA>
exponential(0.02) sigma <NA> <NA>
source
user
user
user
user
user
userEstas previas se utilizan aquí como continuación del ejemplo de la semana 6, no como valores universales para cualquier modelo longitudinal.
7.17.3 Ajuste con brms y cmdstanr
Fijaremos explícitamente las decisiones computacionales que queremos documentar.
fit_s7 <- brm(
  formula = formula_s7,
  data = datos_s7,
  family = gaussian(),
  prior = priors_s7,
  backend = "cmdstanr",
  seed = 1653078,
  chains = 4,
  cores = 4,
  iter = 2500,
  warmup = 1000,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s7_sleepstudy_diagnostico_cmdstanr"
  ),
  file_refit = "on_change"
)
El objeto ajustado contiene simulaciones posteriores y diagnósticos. El orden de revisión importa: primero comprobamos el muestreo; luego interpretamos parámetros y predicciones.
7.18 Diagnóstico general del ajuste sleepstudy
7.18.1 Resumen de brms
summary(fit_s7) Family: gaussian
Links: mu = identity
Formula: Reaction ~ 1 + Days_c + (1 + Days_c | Subject)
Data: datos_s7 (Number of observations: 180)
Draws: 4 chains, each with iter = 2500; warmup = 1000; thin = 1;
total post-warmup draws = 6000
Multilevel Hyperparameters:
~Subject (Number of levels: 18)
Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS
sd(Intercept) 38.51 6.86 27.68 54.15 1.00 1416
sd(Days_c) 6.14 1.32 3.98 9.09 1.00 1971
cor(Intercept,Days_c) 0.61 0.18 0.19 0.88 1.00 2810
Tail_ESS
sd(Intercept) 2815
sd(Days_c) 3229
cor(Intercept,Days_c) 4080
Regression Coefficients:
Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
Intercept 298.27 9.37 279.84 316.66 1.00 1030 1771
Days_c 10.42 1.59 7.23 13.61 1.00 1607 2782
Further Distributional Parameters:
Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
sigma 25.79 1.53 22.97 29.00 1.00 5594 4395
Draws were sampled using sample(hmc). For each parameter, Bulk_ESS
and Tail_ESS are effective sample size measures, and Rhat is the potential
scale reduction factor on split chains (at convergence, Rhat = 1).Este resumen muestra \(\widehat R\) y ESS, pero conviene construir una tabla explícita para los parámetros principales.
variables_clave_s7 <- c(
  "b_Intercept",
  "b_Days_c",
  "sd_Subject__Intercept",
  "sd_Subject__Days_c",
  "cor_Subject__Intercept__Days_c",
  "sigma"
)

draws_s7 <- posterior::as_draws_df(fit_s7)

posterior::subset_draws(
  draws_s7,
  variable = variables_clave_s7
) |>
  posterior::summarise_draws(
    "mean", "sd", "rhat", "ess_bulk", "ess_tail", "mcse_mean", "mcse_sd"
  ) |>
  select(
    variable,
    mean,
    sd,
    rhat,
    ess_bulk,
    ess_tail,
    mcse_mean,
    mcse_sd
  )
# A tibble: 6 × 8
variable mean sd rhat ess_bulk ess_tail mcse_mean mcse_sd
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept 298. 9.37 1.00 1030. 1771. 0.291 0.175
2 b_Days_c 10.4 1.59 1.00 1607. 2782. 0.0397 0.0241
3 sd_Subject__Intercept 38.5 6.86 1.00 1416. 2815. 0.179 0.119
4 sd_Subject__Days_c 6.14 1.32 1.00 1971. 3229. 0.0301 0.0204
5 cor_Subject__Intercep… 0.614 0.175 1.00 2810. 4080. 0.00327 0.00243
6 sigma 25.8 1.53 1.00 5594. 4395. 0.0208 0.0199 La lectura sugerida es:
- ¿hay alguna cantidad con \(\widehat R\) claramente por encima de 1.01?;
- ¿algún bulk-ESS o tail-ESS es pequeño respecto al resto?;
- ¿la MCSE es suficientemente pequeña para los dígitos que pretendemos reportar?;
- ¿los problemas se concentran en parámetros de escala o correlación, como suele ocurrir en modelos jerárquicos?
7.18.2 Gráficos de trazas
bayesplot::mcmc_trace(
  as.array(fit_s7),
  pars = variables_clave_s7
)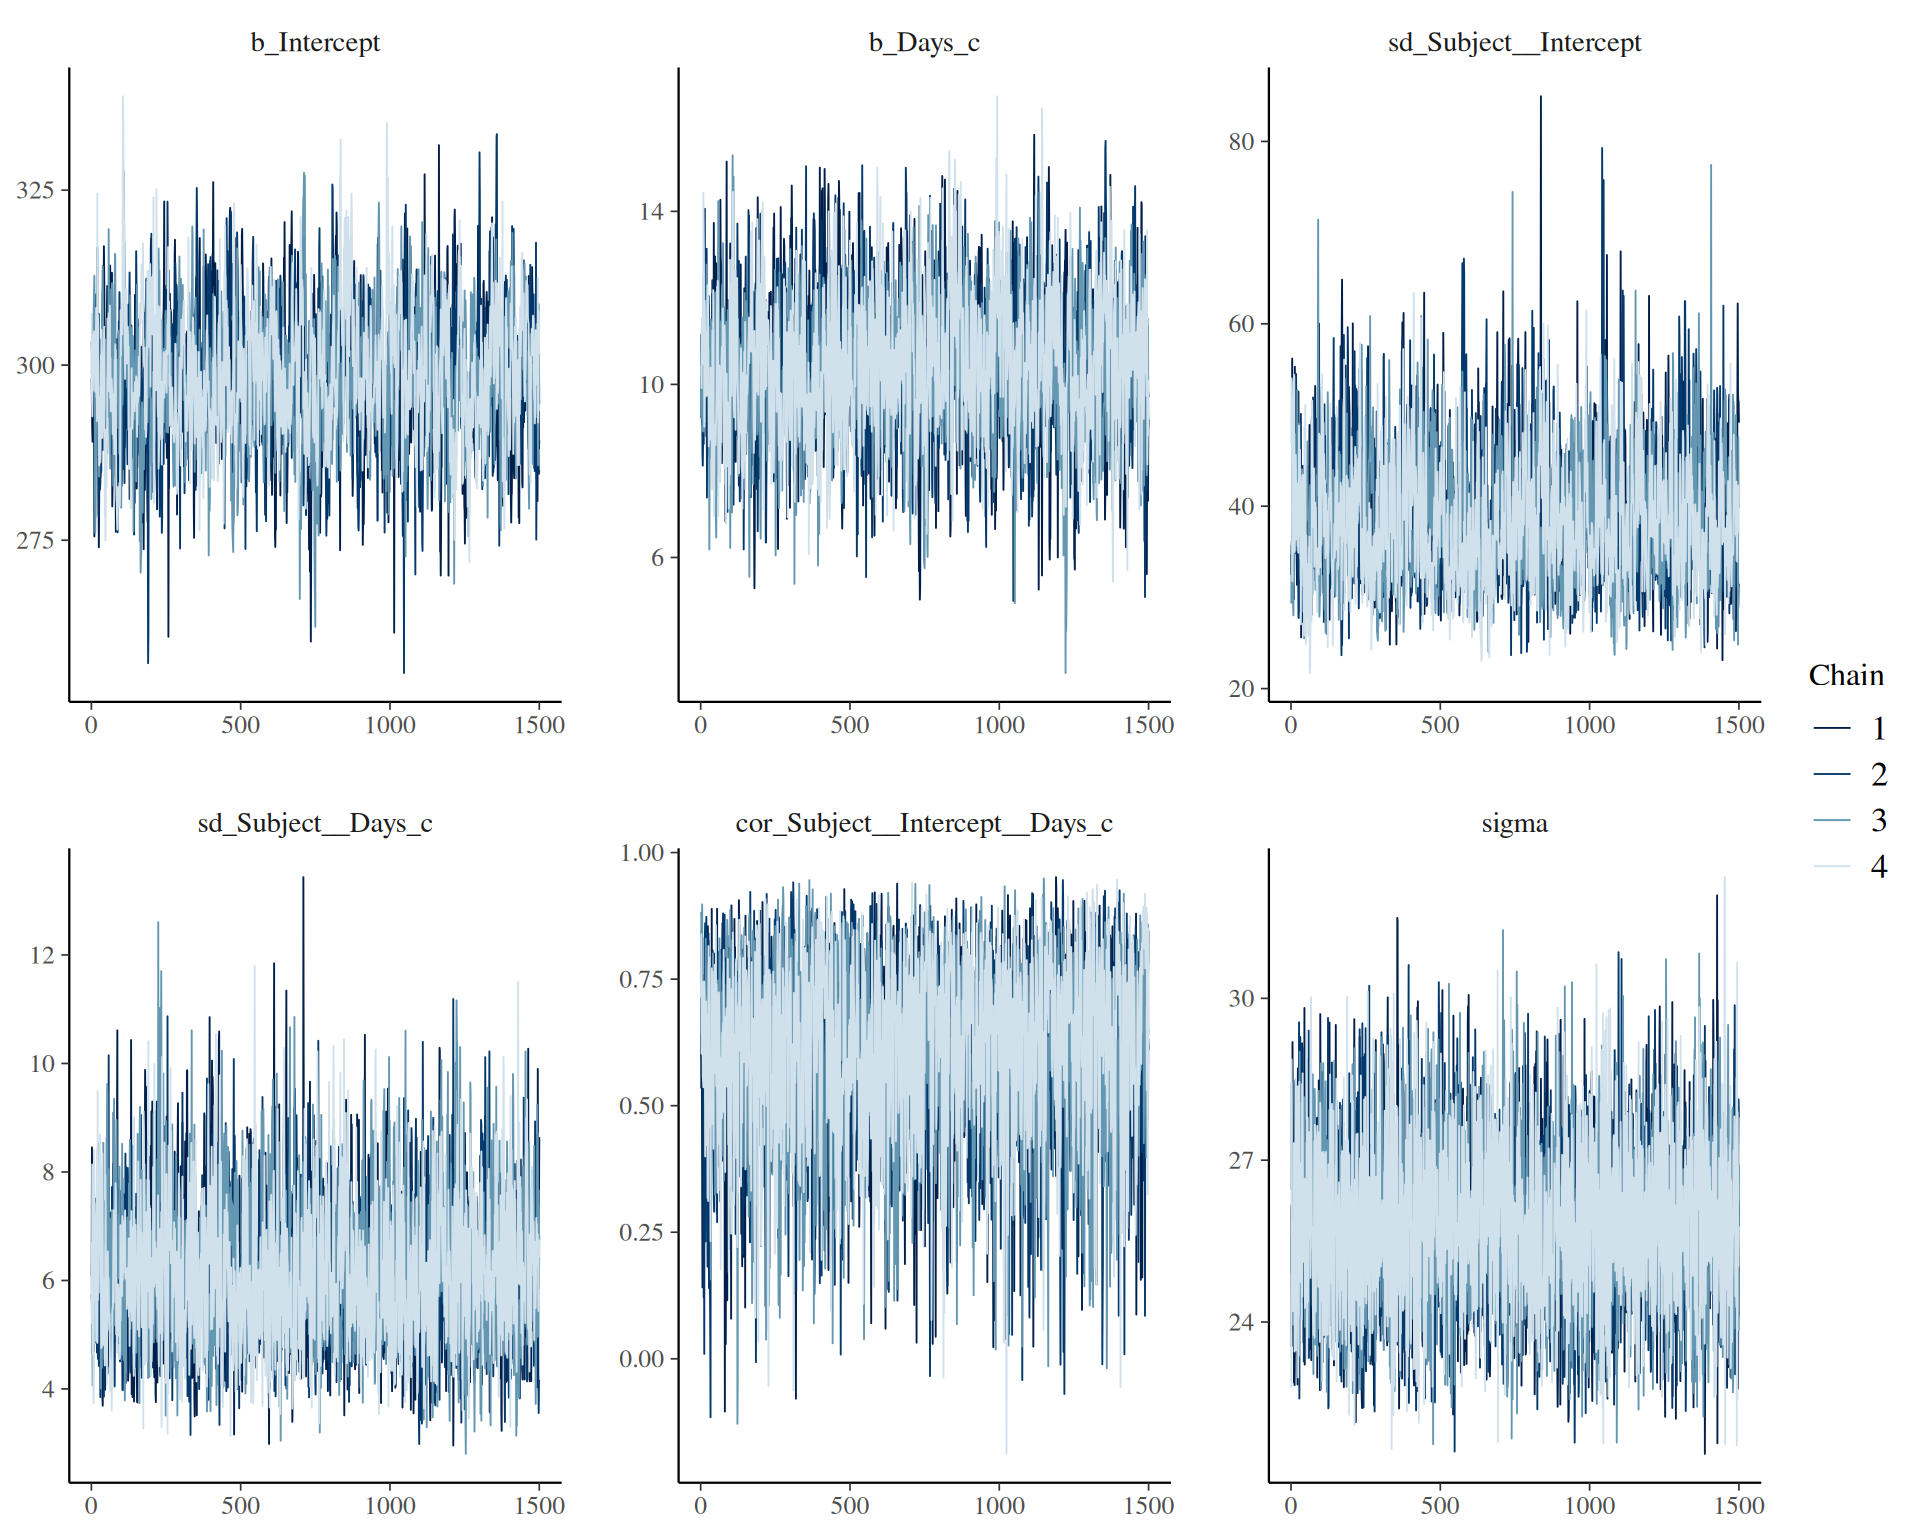
No buscamos una textura visual específica. Buscamos cadenas que recorran regiones semejantes sin desplazamientos persistentes ni separación entre ellas.
7.18.3 Rangos por cadena
bayesplot::mcmc_rank_overlay(
  as.array(fit_s7),
  pars = variables_clave_s7
)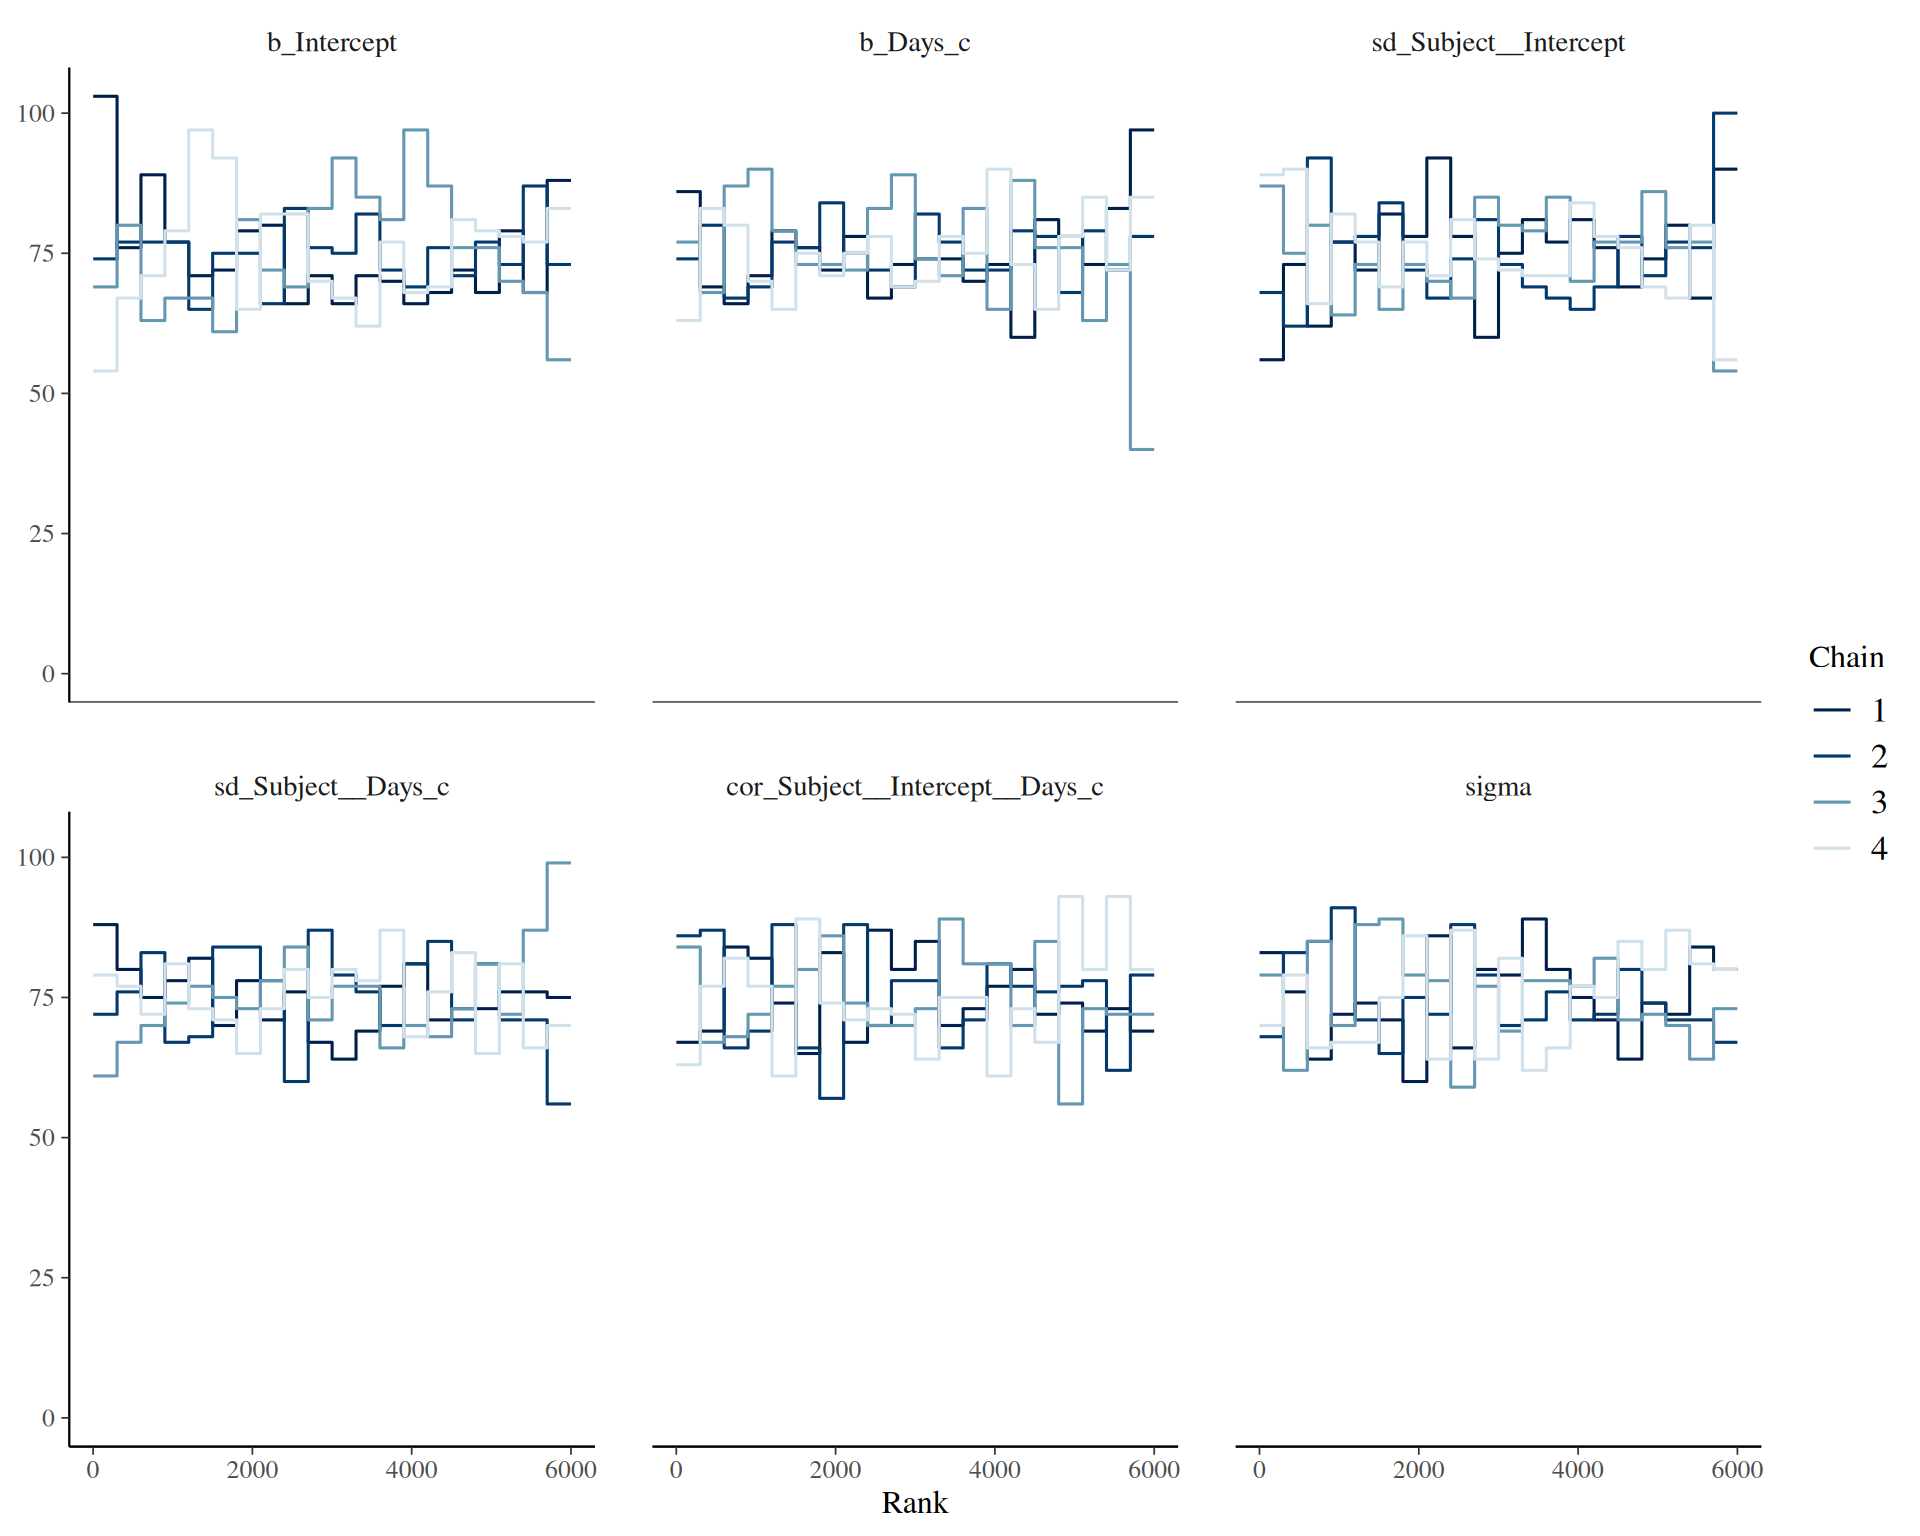
Una concentración sistemática de una cadena en ciertos rangos sugeriría que las cadenas no están explorando la misma distribución marginal.
7.19 Diagnósticos de NUTS en brms
No accederemos directamente a fit_s7$fit$..., porque el tipo interno de ese objeto depende del backend. brms::nuts_params() ofrece una interfaz común y evita depender de que el objeto subyacente sea S4 o CmdStanMCMC.
nuts_s7 <- brms::nuts_params(fit_s7)

nuts_s7 |>
  count(Parameter)
Parameter n
1 accept_stat__ 6000
2 treedepth__ 6000
3 stepsize__ 6000
4 divergent__ 6000
5 n_leapfrog__ 6000
6 energy__ 60007.19.1 Divergencias
n_divergencias_s7 <- sum(
  nuts_s7$Parameter == "divergent__" &
    nuts_s7$Value == 1
)

tibble(
  diagnostico = "Divergencias post-warmup",
  valor = n_divergencias_s7
)
# A tibble: 1 × 2
diagnostico valor
<chr> <int>
1 Divergencias post-warmup 0Una ejecución final deseable no presenta divergencias. Si aparecen, la respuesta no es eliminarlas del archivo de draws. Debemos investigar los parámetros asociados y revisar la geometría.
7.19.2 Profundidad del árbol
Como fijamos max_treedepth = 12, podemos contar cuántas iteraciones alcanzaron ese límite.
profundidades_s7 <- nuts_s7 |>
  filter(Parameter == "treedepth__") |>
  pull(Value)

tibble(
  profundidad_maxima_observada = max(profundidades_s7),
  iteraciones_en_limite = sum(profundidades_s7 >= 12)
)
# A tibble: 1 × 2
profundidad_maxima_observada iteraciones_en_limite
<dbl> <int>
1 6 0Si hubiera muchas saturaciones pero ninguna divergencia, investigaríamos eficiencia y correlación antes de aumentar el límite.
7.19.3 Número de pasos leapfrog
leapfrog_s7 <- nuts_s7 |>
  filter(Parameter == "n_leapfrog__") |>
  pull(Value)

tibble(
  mediana = median(leapfrog_s7),
  q90 = quantile(leapfrog_s7, 0.90),
  q99 = quantile(leapfrog_s7, 0.99),
  maximo = max(leapfrog_s7)
)
# A tibble: 1 × 4
mediana q90 q99 maximo
<dbl> <dbl> <dbl> <dbl>
1 31 63 63 127Estos valores no tienen un umbral universal. Sirven para comparar versiones del mismo modelo o detectar trayectorias inusualmente costosas.
7.20 Un resumen computacional compacto
Construimos una tabla que podría incorporarse al informe del proyecto.
resumen_param_s7 <- posterior::subset_draws(
  draws_s7,
  variable = variables_clave_s7
) |>
  posterior::summarise_draws(
    "rhat", "ess_bulk", "ess_tail", "mcse_mean"
  ) |>
  summarise(
    max_rhat = max(rhat, na.rm = TRUE),
    min_ess_bulk = min(ess_bulk, na.rm = TRUE),
    min_ess_tail = min(ess_tail, na.rm = TRUE),
    max_mcse_media = max(mcse_mean, na.rm = TRUE)
  )

resumen_nuts_s7 <- tibble(
  divergencias = n_divergencias_s7,
  saturaciones_treedepth = sum(profundidades_s7 >= 12),
  profundidad_maxima = max(profundidades_s7),
  mediana_n_leapfrog = median(leapfrog_s7)
)

bind_cols(
  tibble(
    cadenas = 4,
    iteraciones_totales_por_cadena = 2500,
    warmup_por_cadena = 1000,
    adapt_delta = 0.95,
    max_treedepth_configurado = 12
  ),
  resumen_param_s7,
  resumen_nuts_s7
)
# A tibble: 1 × 13
cadenas iteraciones_totales_por_cadena warmup_por_cadena adapt_delta
<dbl> <dbl> <dbl> <dbl>
1 4 2500 1000 0.95
# ℹ 9 more variables: max_treedepth_configurado <dbl>, max_rhat <dbl>,
# min_ess_bulk <dbl>, min_ess_tail <dbl>, max_mcse_media <dbl>,
# divergencias <int>, saturaciones_treedepth <int>, profundidad_maxima <dbl>,
# mediana_n_leapfrog <dbl>Una tabla así debe acompañarse de una interpretación. No basta con escribir “\(\widehat R=1\)”. El informe debería explicar si los diagnósticos son coherentes entre sí y si hubo decisiones correctivas.
7.21 ¿Qué haríamos si el ajuste presentara divergencias?
Supongamos que n_divergencias_s7 > 0. Un flujo razonable sería:
- localizar si las divergencias se concentran en combinaciones de parámetros de escala y coeficientes grupales;
- revisar si el predictor está centrado y razonablemente escalado;
- revisar la previa para desviaciones estándar y correlaciones;
- comprobar si la estructura de pendientes variables está informada por suficientes observaciones dentro de cada grupo;
- probar una parametrización alternativa si trabajamos directamente en Stan;
- aumentar
adapt_deltade manera controlada y volver a diagnosticar; - documentar qué cambio eliminó o redujo el problema y si alteró las cantidades sustantivas de interés.
La conclusión no sería “subimos adapt_delta hasta que Stan dejó de quejarse”. Queremos una explicación de la causa probable y del efecto de la modificación.
7.22 ¿Qué haríamos si solamente el ESS fuera bajo?
Si \(\widehat R\) está cerca de 1, no hay divergencias ni saturaciones importantes y la geometría parece estable, pero el ESS de una cantidad es insuficiente para la precisión requerida, ejecutar más iteraciones puede ser la solución correcta.
Por ejemplo, si estimamos una media posterior con desviación 10 y ESS 100, Ecuación 7.4 sugiere aproximadamente
\[ MCSE \approx \frac{10}{\sqrt{100}} =1. \]
Si necesitamos una precisión Monte Carlo de aproximadamente 0.25, y la eficiencia por iteración se mantiene, necesitaríamos alrededor de
\[ S_{\text{eff}} \approx \left(\frac{10}{0.25}\right)^2 =1600 \]
simulaciones efectivas para esa cantidad.
Esta es una justificación concreta para ejecutar más iteraciones. Es distinta de prolongar indefinidamente una cadena que no mezcla entre modos.
7.23 Comprobación predictiva posterior: un diagnóstico diferente
Una vez que la aproximación computacional es confiable, realizamos una comprobación predictiva mínima.
pp_check(
  fit_s7,
  type = "dens_overlay",
  ndraws = 80
)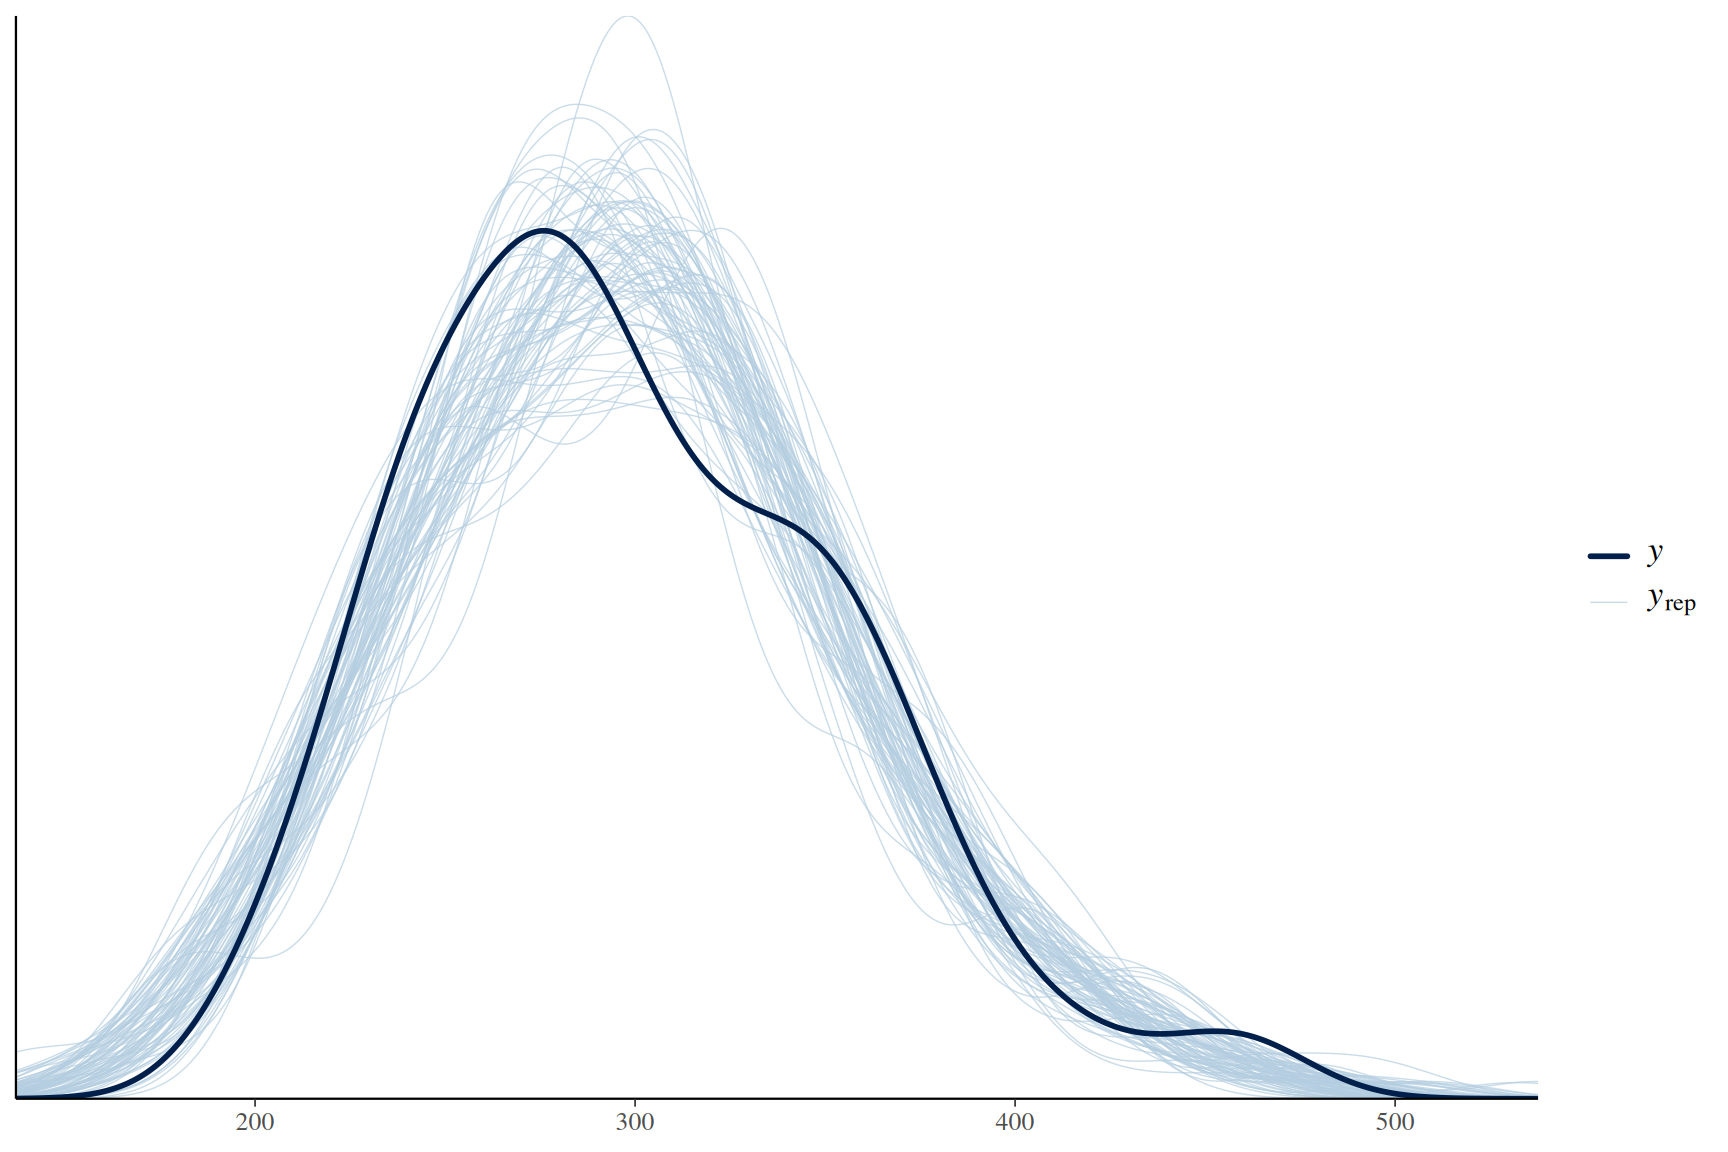
Esta figura responde a una pregunta diferente de \(\widehat R\):
- \(\widehat R\), ESS y divergencias preguntan si aproximamos adecuadamente la posterior del modelo;
- la comprobación predictiva pregunta si ese modelo ajustado reproduce características relevantes de los datos.
Podemos tener un ajuste sin ninguna advertencia de HMC y una comprobación predictiva deficiente. También podemos tener un modelo sustantivamente razonable cuya parametrización inicial produzca divergencias. Ambos problemas deben resolverse, pero no son el mismo problema.
7.24 Predicción y parametrización
Si dos parametrizaciones son verdaderamente equivalentes y ambas se muestrean correctamente, deben producir la misma distribución posterior sobre cantidades observables y, por tanto, las mismas predicciones dentro del error Monte Carlo.
Esta propiedad ofrece una comprobación útil cuando escribimos Stan directamente:
- ajustar forma centrada y no centrada;
- transformar ambas a una cantidad común, por ejemplo \(\alpha_j\);
- comparar resúmenes y predicciones;
- atribuir diferencias sustanciales persistentes a error Monte Carlo, problemas de muestreo o a una implementación que no es realmente equivalente.
La eficiencia puede cambiar mucho aun cuando las predicciones sean las mismas.
7.25 El papel de las previas en el diagnóstico computacional
La semana 6 mostró que una previa se justifica por la escala y el conocimiento disponible. Esta semana añadimos una consecuencia: previas extremadamente amplias pueden permitir regiones de parámetros con geometría difícil y predicciones absurdas.
Esto no significa que debamos escoger una previa porque produce cero divergencias. Una previa más restrictiva añade información al modelo. Bayesian Workflow advierte específicamente contra usar restricciones únicamente para hacer más rápido el algoritmo; si una previa más fuerte se utiliza para mejorar estabilidad, debe ser defendible sustantivamente y conviene evaluar sensibilidad (Gelman et al. 2026, sec. 12.4).
La secuencia correcta es:
\[ \text{conocimiento y escala} \rightarrow \text{previa defendible} \rightarrow \text{comprobación previa} \rightarrow \text{ajuste} \rightarrow \text{diagnóstico computacional}. \]
No debemos invertirla y ajustar la previa hasta que desaparezca una advertencia.
7.26 Problemas computacionales frente a problemas de identificación
Conviene resumir la distinción.
7.26.1 Problema computacional
La posterior está bien definida, pero el algoritmo la recorre de manera ineficiente o poco confiable debido a su geometría. Ejemplos:
- correlación posterior extrema;
- funnel;
- escalas muy diferentes;
- tamaño de paso inadecuado;
- trayectorias demasiado largas.
Una reparametrización puede cambiar radicalmente el rendimiento sin cambiar el modelo sobre las cantidades observables.
7.26.2 Problema de identificación
Diferentes valores de parámetros producen el mismo, o casi el mismo, comportamiento para los datos. Ejemplos:
- parámetros redundantes como \(b\) y \(c\) en Ecuación 7.5;
- intercepto y todos los indicadores de categoría incluidos sin una restricción identificadora;
- componentes de un modelo cuya separación no está sustentada por el diseño o los datos.
Más iteraciones no crean información ausente. Una previa puede regularizar o identificar la posterior en un sentido bayesiano, pero entonces la separación de parámetros depende de esa información previa.
7.26.3 Identificación débil
Entre ambos extremos existe la identificación débil: los datos distinguen formalmente los parámetros, pero solo débilmente. Este régimen es común en modelos multinivel con pocos grupos o pocas observaciones por grupo. Aquí regularización, reparametrización y diseño del estudio interactúan estrechamente.
7.27 Errores frecuentes
7.27.1 1. Declarar “convergencia” porque \(\widehat R=1.00\)
\(\widehat R\) es un diagnóstico necesario pero no suficiente. Debe leerse junto con ESS, trazas, diagnósticos de HMC y estructura del modelo.
7.27.2 2. Reportar únicamente el número bruto de iteraciones
“Usamos 4000 draws” no informa cuántas simulaciones efectivas se obtuvieron ni cuál fue la MCSE.
7.27.3 3. Confundir incertidumbre posterior con MCSE
La primera es parte del resultado inferencial; la segunda es error numérico debido a una simulación finita.
7.27.4 4. Eliminar draws divergentes
Una divergencia no es un dato atípico. Señala que una región de la posterior puede no haberse explorado correctamente.
7.27.5 5. Aumentar adapt_delta automáticamente
Puede ayudar cuando el problema es un tamaño de paso demasiado grande, pero puede ocultar que la geometría necesita reparametrización o que el modelo está débilmente identificado.
7.27.6 6. Aumentar max_treedepth como primera respuesta
Permite trayectorias más largas y costosas. No reduce una correlación posterior causada por un predictor mal centrado.
7.27.7 7. Ejecutar más iteraciones ante multimodalidad severa
Si las cadenas permanecen en modos distintos, duplicar una longitud moderada puede no lograr mezcla entre modos. Primero hay que entender la estructura posterior.
7.27.8 8. Suponer que no centrado siempre es mejor
La eficiencia depende de cuánta información aporta cada grupo. Con datos muy informativos por unidad, la forma centrada puede ser superior.
7.27.9 9. Confundir reparametrización con cambiar el modelo
Una reparametrización correcta conserva la distribución sobre las cantidades sustantivas. Cambiar una previa o eliminar un componente sí cambia el modelo.
7.27.10 10. Usar una previa más fuerte solo para eliminar advertencias
Si una previa modifica la posterior, esa información debe justificarse y comunicarse. La computación no es una justificación sustantiva suficiente.
7.27.11 11. Interpretar falta de identificación como “Stan necesita más tiempo”
Cuando dos parámetros entran solo mediante una combinación redundante, la dificultad es estructural.
7.27.12 12. Diagnosticar solo coeficientes poblacionales
En modelos multinivel los problemas pueden concentrarse en desviaciones estándar, correlaciones o coeficientes de grupos pequeños.
7.27.13 13. Revisar únicamente trazas
Las trazas son útiles, pero no sustituyen \(\widehat R\), ESS y los diagnósticos específicos de HMC.
7.27.14 14. Ignorar la unidad de las variables
Predictores en escalas muy distintas pueden perjudicar la adaptación y producir correlaciones difíciles. Reescalar también mejora la especificación de previas.
7.27.15 15. Confundir ausencia de advertencias con buen modelo
El sampler puede representar perfectamente la posterior de un modelo que falla en las comprobaciones predictivas.
7.27.16 16. Usar acceso directo a objetos internos de brms
Expresiones como fit$fit$diagnostic_summary() dependen del backend y de la clase del objeto interno. Para diagnósticos NUTS en un brmsfit, utilice brms::nuts_params() u otras interfaces documentadas; para un objeto creado directamente con cmdstanr, use sus métodos de CmdStanMCMC.
7.28 Hito del proyecto de curso
Al finalizar esta semana, cada grupo debe poder producir un diagnóstico computacional básico de la primera versión de su modelo. El informe puede ser breve, pero debe permitir reproducir y evaluar las decisiones.
Incluya al menos:
- fórmula del modelo y estructura de agrupamiento;
- versiones de
R,brms,cmdstanry CmdStan; - semilla;
- número de cadenas;
- iteraciones totales y de warmup;
adapt_deltaymax_treedepthsi se modificaron;- máximo \(\widehat R\) entre cantidades relevantes;
- mínimo bulk-ESS y tail-ESS entre cantidades relevantes;
- MCSE para al menos dos cantidades sustantivamente importantes;
- número de divergencias;
- número de iteraciones que alcanzaron la profundidad máxima configurada;
- una figura de trazas o rangos cuando ayude a interpretar un problema;
- descripción de cualquier modificación realizada para mejorar el ajuste;
- evidencia de que la modificación fue una respuesta al problema identificado y no una búsqueda mecánica de advertencias cero;
- una comprobación predictiva posterior mínima, claramente separada del diagnóstico computacional.
Un formato posible para la conclusión es:
Se ejecutaron cuatro cadenas con 1500 simulaciones post-warmup por cadena. Las cantidades principales presentaron \(\widehat R\) cercanos a 1, ESS suficientes para la precisión requerida y MCSE pequeñas frente a la incertidumbre posterior. No se observaron divergencias ni saturaciones de profundidad máxima. Las trazas no mostraron separación persistente entre cadenas. Por separado, la comprobación predictiva indicó […].
El texto debe completarse con los resultados reales del proyecto y no utilizarse como plantilla para afirmar diagnósticos que no se comprobaron.
7.29 Síntesis
Los modelos bayesianos complejos dependen de una capa computacional que debe ser diagnosticada. Las ideas centrales de la semana son:
- MCMC aproxima integrales posteriores mediante simulaciones dependientes.
- El número bruto de iteraciones no mide por sí solo la precisión; ESS y MCSE cuantifican la eficiencia y el error Monte Carlo.
- Varias cadenas permiten comparar exploraciones iniciadas desde regiones diferentes.
- \(\widehat R\) evalúa discrepancias entre y dentro de cadenas; valores cercanos a 1 son evidencia favorable, no una certificación absoluta.
- HMC utiliza gradientes para construir trayectorias que evitan el comportamiento de paseo aleatorio de propuestas locales.
- NUTS adapta la longitud de las trayectorias y Stan adapta durante warmup el tamaño de paso y características de la métrica.
- Las divergencias señalan regiones donde la integración hamiltoniana puede ser poco confiable.
- Alcanzar
max_treedepthrepetidamente señala trayectorias costosas y suele motivar una investigación de geometría y eficiencia. - Un funnel aparece cuando la escala de unos parámetros depende fuertemente de otros, situación frecuente en modelos jerárquicos débilmente informados.
- La parametrización no centrada conserva el modelo probabilístico pero cambia las coordenadas del muestreo.
- La forma no centrada suele ser útil cuando hay poca información por grupo; la centrada puede ser mejor cuando los coeficientes grupales están fuertemente informados por los datos.
- Un problema de identificación no se corrige ejecutando más iteraciones.
- Reescalamiento, regularización y reparametrización pueden mejorar la computación, pero cada modificación debe tener una interpretación estadística clara.
- Un ajuste computacionalmente fiable todavía debe someterse a comprobación predictiva.
El principio operativo puede resumirse así:
\[ \boxed{ \text{una advertencia computacional es información sobre el ajuste, no ruido que debemos silenciar.} } \]
7.30 Ejercicios
7.30.1 Ejercicios conceptuales
7.30.1.1 Ejercicio 1. ESS y MCSE
Dos ajustes producen 4000 draws para un parámetro \(\theta\).
- Ajuste A: \(\operatorname{sd}(\theta\mid y)=4\), ESS = 1600.
- Ajuste B: \(\operatorname{sd}(\theta\mid y)=4\), ESS = 100.
- Aproximar la MCSE de la media posterior en cada caso.
- Explicar por qué el número bruto de draws no permite comparar la precisión Monte Carlo.
- Si el objetivo es reportar la media con error Monte Carlo menor que 0.2, ¿cuál ajuste satisface el objetivo aproximadamente?
7.30.1.2 Ejercicio 2. \(\widehat R\) no es una prueba de validez
Considere cuatro cadenas que producen \(\widehat R=1.001\) para todos los parámetros.
- ¿Qué evidencia aporta este resultado?
- ¿Qué problemas podrían existir todavía?
- Mencione al menos tres diagnósticos adicionales.
- ¿Podemos concluir a partir de \(\widehat R\) que el modelo reproduce adecuadamente los datos? Explique.
7.30.1.3 Ejercicio 3. Divergencias y adapt_delta
Un modelo presenta 180 divergencias entre 4000 iteraciones post-warmup. Una persona propone cambiar únicamente adapt_delta de 0.8 a 0.999.
- ¿Por qué ese cambio puede reducir divergencias?
- ¿Por qué 180 divergencias sugieren investigar el modelo antes de confiar en esa modificación?
- Enumere tres causas estructurales posibles.
- Describa qué resultados compararía después de la modificación.
7.30.1.4 Ejercicio 4. Profundidad del árbol
Dos modelos no presentan divergencias.
- Modelo A: 0 de 4000 iteraciones alcanzan
max_treedepth. - Modelo B: 3500 de 4000 iteraciones alcanzan
max_treedepth.
- ¿Por qué no son computacionalmente equivalentes?
- ¿Qué investigaría en el modelo B?
- ¿Por qué aumentar el límite puede no ser la mejor primera acción?
- ¿Qué papel podrían tener el centrado y el reescalamiento?
7.30.1.5 Ejercicio 5. Centrada versus no centrada
Para
\[ \alpha_j\sim\mathcal N(\mu,\tau^2), \]
- escribir la parametrización no centrada;
- demostrar que induce la misma distribución marginal condicional para \(\alpha_j\);
- explicar por qué la geometría puede ser distinta;
- indicar qué forma espera que funcione mejor con dos observaciones muy ruidosas por grupo;
- indicar por qué su respuesta al punto anterior no constituye una regla universal.
7.30.1.6 Ejercicio 6. Identificación
Considere
\[ y_i\sim\mathcal N(a+b x_i+c x_i,\sigma^2). \]
- Demuestre que la verosimilitud depende de \(b\) y \(c\) solo por su suma.
- Proponga una reparametrización identificada usando \(\delta=b+c\).
- Explique por qué aumentar el número de iteraciones no identifica \(b\) y \(c\) por separado.
- Explique qué cambia si se asignan previas muy informativas y distintas a \(b\) y \(c\).
7.30.1.7 Ejercicio 7. Computación versus comprobación predictiva
Para cada afirmación, indique si corresponde principalmente a diagnóstico computacional, identificación o comprobación predictiva.
- Las cadenas tienen \(\widehat R=1.3\).
- El modelo reproduce medias globales pero no la variación entre grupos.
- Dos coeficientes solo aparecen en el predictor como \(\beta_1+\beta_2\).
- Hay divergencias concentradas cuando \(\tau\) se aproxima a cero.
- El tail-ESS de un cuantil de interés es 40.
- Las réplicas posteriores nunca producen la asimetría observada.
7.30.2 Ejercicios computacionales
7.30.2.1 Ejercicio 8. ESS bajo autocorrelación
Simule procesos AR(1) estacionarios con
\[ \rho\in\{0,0.5,0.9,0.99\} \]
y \(S=5000\).
- Calcule bulk-ESS para cada serie usando
posterior. - Grafique ESS contra \(\rho\).
- Compare MCSE de la media.
- Explique por qué la distribución marginal puede ser casi idéntica mientras la precisión Monte Carlo cambia drásticamente.
7.30.2.2 Ejercicio 9. Diagnóstico guiado de un ajuste con divergencias
Considere el siguiente resumen de un modelo jerárquico ajustado con cuatro cadenas:
- \(\max(\widehat R)=1.004\);
- bulk-ESS mínimo = 950;
- tail-ESS mínimo = 720;
- 27 divergencias de 4000 iteraciones post-warmup;
- ninguna saturación de
max_treedepth.
- Explique por qué \(\widehat R\) y ESS no bastan para declarar confiable el ajuste.
- Enumere tres aspectos del modelo que revisaría antes de modificar
adapt_delta. - Explique qué información obtendría al volver a ajustar con un
adapt_deltamoderadamente mayor. - Si las divergencias desaparecen pero el ESS de una desviación estándar grupal cae drásticamente, ¿qué investigaría?
- Redacte un párrafo de diagnóstico que podría incluirse en un informe reproducible.
7.30.2.3 Ejercicio 10. Reconocer el funnel sin ajustar HMC
Simule pares
\[ z_s\sim\mathcal N(0,1), \qquad \log(\tau_s)\sim\mathcal N(-0.5,1), \qquad \alpha_s=\tau_s z_s, \]
para \(s=1,\ldots,10000\).
- Grafique \(\alpha_s\) contra \(\log(\tau_s)\).
- Grafique \(z_s\) contra \(\log(\tau_s)\).
- Explique por qué la primera representación cambia de anchura y la segunda no.
- Relacione este patrón con un modelo de interceptos variables.
- Explique por qué la segunda representación puede facilitar HMC cuando la información de cada grupo es débil.
7.30.2.4 Ejercicio 11. Centrado de un predictor y correlación posterior
Simule una regresión donde \(x\) se encuentre alrededor de 2000:
\[ x_i\in[1990,2010]. \]
Ajuste dos modelos equivalentes:
- con \(x\) original;
- con \(x_c=x-2000\).
Compare:
- correlación posterior entre intercepto y pendiente;
- ESS;
- saturaciones de profundidad;
- tiempo de ejecución;
- predicciones en la escala original.
Explique por qué las predicciones pueden coincidir aunque el costo computacional sea distinto.
7.30.2.5 Ejercicio 12. Informe reproducible con brms
Seleccione uno de los modelos de las semanas 2–6 y produzca automáticamente una tabla con:
- versión de
brms; - versión de
cmdstanr; - versión de CmdStan;
- número de cadenas;
- \(\widehat R\) máximo para parámetros seleccionados;
- bulk-ESS mínimo;
- tail-ESS mínimo;
- divergencias;
- profundidad máxima observada;
- número de saturaciones del límite configurado.
Añada una interpretación de no más de 150 palabras.
7.30.2.6 Ejercicio 13. Sensibilidad entre prior y computación
Tome un modelo jerárquico con pocos grupos y compare dos previas sustantivamente defendibles para \(\tau\).
- Realice comprobación predictiva previa para ambas.
- Ajuste ambos modelos.
- Compare divergencias y ESS.
- Compare la posterior de \(\tau\) y las predicciones para un grupo nuevo.
- Si una previa mejora el cómputo pero cambia las predicciones, explique por qué no es correcto elegirla únicamente por el diagnóstico computacional.
7.30.2.7 Ejercicio 14. Criticar una respuesta de software o IA
Se proporciona la siguiente recomendación:
“Stan reportó divergencias. Aumente
adapt_deltaa 0.999 ymax_treedeptha 20. Si las advertencias desaparecen, el modelo convergió.”
Redacte una crítica técnica que:
- identifique al menos cuatro problemas con la recomendación;
- proponga un flujo de diagnóstico mejor;
- distinga divergencias, profundidad del árbol e identificación;
- explique qué evidencia sería necesaria antes de interpretar la posterior.
7.31 Referencias de la semana
Las lecturas centrales para esta unidad son:
- McElreath, Statistical Rethinking, capítulo 9 para la intuición de MCMC, HMC, NUTS y warmup, y sección 13.4 para divergencias, el funnel y parametrización no centrada (McElreath 2020, chap. 9, pp. 420-425).
- Gelman et al., Bayesian Workflow, capítulo 11 para inicialización, warmup, cadenas, \(\widehat R\), ESS y MCSE; capítulo 12 para el flujo práctico de diagnóstico, divergencias, profundidad del árbol, geometría posterior y reparametrización (Gelman et al. 2026, chaps. 11-12).
- Gelman et al., Bayesian Data Analysis, capítulo 11 para evaluación de simulaciones iterativas y capítulo 12, especialmente secciones 12.4–12.5, para HMC y su aplicación a modelos jerárquicos (Gelman et al. 2013, chaps. 11-12).
- Matsuura, Bayesian Statistical Modeling with Stan, R, and Python, capítulo 9, especialmente secciones 9.1–9.3 para no identificación, previas débilmente informativas y reparametrización de modelos jerárquicos.
- Bürkner para la conexión entre
brms, Stan y HMC/NUTS, y para la implementación práctica de modelos multinivel bayesianos (Bürkner 2017).