3Semana 3. Predictores individuales y grupales; centrado
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
24 de agosto de 2026
3.1 Panorama de la semana
En las dos primeras semanas construimos la lógica básica del modelado multinivel. Primero identificamos la dependencia inducida por el agrupamiento y comparamos pooling completo, ausencia de pooling y pooling parcial. Después estudiamos el modelo de interceptos variables, la separación de variabilidad dentro y entre grupos, el ICC y el shrinkage.
Esta semana incorporamos predictores y aparece una dificultad conceptual nueva. Un predictor medido en las unidades individuales puede variar simultáneamente dentro de los grupos y entre los grupos. Por ejemplo, el nivel socioeconómico de un estudiante varía entre estudiantes de una misma escuela, pero las escuelas también difieren en su composición socioeconómica promedio.
La pregunta central es:
¿Cómo distinguimos una asociación que ocurre dentro de los grupos de una diferencia que ocurre entre grupos?
Esta pregunta no se resuelve mediante una operación mecánica de preprocesamiento. El centrado es útil cuando hace explícita la comparación estadística que deseamos estudiar. Gelman y Hill muestran que restar una referencia apropiada puede convertir un intercepto o un efecto principal difícil de interpretar en una cantidad sustantivamente significativa (Gelman y Hill 2007, 55-57). En modelos multinivel, Hox et al. enfatizan además que el centrado respecto de la media del grupo puede separar información dentro y entre grupos y, por tanto, cambiar la pregunta que responde el modelo (Hox et al. 2018, 46-52).
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
distinguir predictores individuales de predictores grupales según la unidad en la que varían;
explicar por qué un predictor individual puede contener simultáneamente información dentro y entre grupos;
diferenciar centrado respecto de una referencia sustantiva, centrado respecto de la media global y centrado respecto de la media del grupo;
demostrar algebraicamente cómo cambia el intercepto cuando se centra un predictor en una constante común;
explicar por qué el centrado global es una reparametrización de la parte lineal del modelo, mientras que el centrado por grupo puede cambiar la comparación estadística;
derivar la descomposición \[x_{ij}=(x_{ij}-\bar x_j)+\bar x_j;\]
interpretar por separado una asociación dentro de grupos, \(\beta_W\), y una asociación entre grupos, \(\beta_B\);
derivar e interpretar la asociación contextual \(\delta=\beta_B-\beta_W\);
reconocer la falacia ecológica y la falacia atomística como errores de inferencia entre niveles;
justificar una estrategia de centrado a partir de la pregunta científica y no de una regla automática;
ajustar en brms un modelo con separación explícita dentro–entre utilizando cmdstanr como backend;
realizar diagnósticos MCMC básicos y comprobaciones predictivas que evalúen no solo la distribución marginal de la respuesta sino también la relación respuesta–predictor;
aplicar estas ideas a datos reales de estudiantes agrupados en escuelas;
documentar, para los predictores del proyecto del curso, el nivel de variación y la comparación que se pretende estimar.
3.2 Problema motivador: estudiantes dentro de escuelas
Supongamos que queremos estudiar el rendimiento matemático de estudiantes agrupados en escuelas. Para el estudiante \(i\) de la escuela \(j\), observamos
\[
y_{ij}=\text{puntaje de matemática},
\]
\[
x_{ij}=\text{nivel socioeconómico del estudiante}.
\]
Una regresión con interceptos variables podría comenzar como
La pendiente \(\beta\) parece sencilla: cambio esperado en el rendimiento asociado con una unidad adicional de nivel socioeconómico. Pero ¿qué unidades estamos comparando realmente?
Considere dos comparaciones distintas:
Dentro de una escuela: comparar dos estudiantes de la misma escuela que difieren en nivel socioeconómico.
Entre escuelas: comparar escuelas cuya composición socioeconómica promedio es diferente.
Estas comparaciones no tienen por qué producir la misma asociación. El mecanismo que relaciona diferencias entre estudiantes de la misma escuela con su rendimiento puede ser distinto del mecanismo que relaciona la composición de una escuela con el rendimiento promedio de sus estudiantes.
ImportanteUna sola variable puede contener dos tipos de comparación
El hecho de que \(x_{ij}\) esté medido en el nivel individual no implica que su coeficiente represente exclusivamente una comparación individual. Si las medias \(\bar x_j\) varían entre grupos, el predictor sin descomponer contiene información tanto dentro como entre grupos.
Este punto es central en la discusión de Hox et al. sobre centrado: cuando una variable individual se sustituye por su desviación respecto de la media grupal y se incorpora además la media del grupo, el modelo separa explícitamente las fuentes de variación (Hox et al. 2018, 50-52).
3.3 ¿En qué nivel vive un predictor?
La palabra “nivel” se refiere a la unidad sobre la cual una cantidad puede variar.
3.3.1 Predictor individual
Un predictor \(x_{ij}\) es de nivel individual si puede tomar valores distintos para dos unidades del mismo grupo.
Ejemplos:
nivel socioeconómico de cada estudiante;
edad de cada paciente;
dosis recibida por cada parcela;
tiempo en una base longitudinal, cuando las mediciones están agrupadas en personas.
3.3.2 Predictor grupal
Un predictor \(z_j\) es de nivel grupal si su valor es común a todas las unidades del grupo \(j\).
Ejemplos:
sector de la escuela;
tipo de hospital;
región geográfica;
política institucional;
una característica del centro medida directamente a nivel del centro.
Gelman y Hill escriben un modelo con predictores individuales y grupales como dos regresiones conectadas. Para el ejemplo del radón, un predictor de vivienda entra en el modelo de observaciones y el nivel de uranio del condado entra en el modelo de los interceptos de condado (Gelman y Hill 2007, 265-69). En nuestra notación:
es una variable grupal aunque se construya a partir de mediciones individuales. Una vez calculada, toma el mismo valor para todas las observaciones del grupo.
Esto distingue dos ideas:
nivel de medición original: dónde se observó la variable;
nivel de variación del predictor usado en el modelo: dónde cambia la cantidad que entra en el predictor lineal.
NotaEl archivo de datos no define el nivel
Una variable grupal suele repetirse en todas las filas de un grupo para facilitar el análisis. Esa repetición física en una tabla larga no la convierte en una variable individual.
3.4 Centrar es cambiar el punto de referencia
Antes de discutir medias grupales, estudiemos el caso más simple: restar una misma constante a todas las observaciones.
La pendiente no cambia. Cambia el significado del intercepto:
\(\alpha\) es el valor esperado cuando \(x=0\);
\(\alpha^*\) es el valor esperado cuando \(x=c\).
Gelman y Hill utilizan precisamente esta lógica para mostrar que el centrado puede volver interpretables los efectos principales y el intercepto, especialmente cuando hay interacciones (Gelman y Hill 2007, 55-57).
Entonces \(x_{ij}^{G}=0\) corresponde a una unidad con el valor promedio del predictor en el conjunto de observaciones. Con tamaños grupales desiguales, esta media pondera a los grupos según el número de observaciones. El promedio no ponderado de las medias grupales, \(J^{-1}\sum_j\bar x_j\), puede ser distinto. Cualquiera puede ser una referencia válida, pero debe declararse: cambiar una constante común modifica principalmente el punto de referencia del intercepto y de los predictores grupales centrados.
\(\alpha_j\) representa ahora el valor esperado en el grupo \(j\) para una unidad cuyo predictor está en la media global.
Hox et al. enfatizan que esta elección da una interpretación clara al intercepto y, cuando las pendientes varían, también fija el punto del eje \(x\) en el cual se interpreta la variabilidad de interceptos (Hox et al. 2018, 47-50).
3.4.2 Centrado respecto de una referencia sustantiva
La media global no siempre es la mejor referencia. Podríamos usar
\[
x_{ij}^{R}=x_{ij}-c,
\]
donde \(c\) es:
una dosis clínicamente relevante;
la edad de ingreso a un estudio;
el año inicial de una política;
un valor normativo;
un punto de corte definido por la disciplina.
La pregunta correcta no es “¿debo centrar?”, sino:
¿En qué valor del predictor quiero que el intercepto y, eventualmente, otros coeficientes sean interpretados?
3.4.3 Centrado y estandarización no son lo mismo
Centrar cambia el origen de la escala. Estandarizar cambia además la unidad:
\[
z_{ij}
=
\frac{x_{ij}-\bar x}{s_x}.
\]
La estandarización puede ser útil para comparar escalas o facilitar la computación, pero también cambia la unidad en la que se interpreta la pendiente. No debe usarse como sustituto automático de una decisión de modelado.
3.5 Una sutileza bayesiana: reparametrizar también exige pensar en las previas
En la parte de verosimilitud, sustituir \(x\) por \(x-c\) y transformar el intercepto de manera correspondiente no cambia las predicciones posibles del modelo lineal. Es una reparametrización algebraica.
En un análisis bayesiano completo, sin embargo, el modelo incluye también las distribuciones previas. Si escribimos
la previa inducida para \(\alpha^*\) depende conjuntamente de \(\alpha\) y \(\beta\). Por ello, asignar sin más las mismas previas independientes a \((\alpha,\beta)\) y a \((\alpha^*,\beta)\) no produce necesariamente modelos bayesianos idénticos.
AdvertenciaEquivalencia de la media no implica equivalencia automática de la previa
Cuando comparamos parametrizaciones centradas y no centradas, debemos separar dos afirmaciones:
la estructura de la media puede ser algebraicamente equivalente;
el modelo bayesiano completo será exactamente equivalente solo si las previas se transforman de forma coherente.
Esta observación será especialmente importante más adelante en el curso, cuando las previas desempeñen un papel mayor en modelos débilmente identificados.
3.6 Centrado respecto de la media del grupo
Ahora cambiamos de operación. Para cada grupo \(j\), definimos
la pendiente \(\beta_W\) compara unidades que difieren en su posición relativa dentro de su propio grupo.
Para estudiantes:
\(x_{ij}^{W}>0\): el estudiante tiene SES por encima del promedio de su escuela;
\(x_{ij}^{W}<0\): está por debajo del promedio de su escuela;
\(x_{ij}^{W}=0\): coincide con el promedio de su escuela.
Esta es la lógica que Hox et al. ilustran con el “efecto del estanque” (frog pond effect): la posición relativa de una persona en su contexto puede ser científicamente relevante (Hox et al. 2018, 50-51).
3.6.2 Lo que se pierde al usar solo \(x_{ij}-\bar x_j\)
El centrado por grupo elimina la información sobre diferencias en la media de \(x\) entre grupos. Dos escuelas con composiciones socioeconómicas muy diferentes pueden contener estudiantes con el mismo valor de \(x_{ij}^{W}=0\): ambos son “promedio” dentro de su escuela, aunque sus SES absolutos sean distintos.
Por ello, si queremos estudiar simultáneamente comparaciones dentro y entre grupos, debemos reincorporar la media grupal como predictor.
Ahora los dos coeficientes responden preguntas distintas.
3.7.2 Interpretación de \(\beta_W\)
\(\beta_W\) es la diferencia esperada en \(y\) asociada con una unidad adicional de \(x\) al comparar dos unidades del mismo grupo, manteniendo fija la media grupal.
En el ejemplo educativo:
Entre estudiantes de la misma escuela, ¿cuánto difiere el rendimiento esperado cuando el SES individual difiere en una unidad?
3.7.3 Interpretación de \(\beta_B\)
\(\beta_B\) describe la diferencia esperada asociada con una unidad adicional en la media grupal del predictor.
En el ejemplo educativo:
¿Cuánto difiere el rendimiento esperado entre escuelas cuya composición media de SES difiere en una unidad, comparando estudiantes en la misma posición relativa dentro de sus respectivas escuelas?
En ese caso, una sola pendiente para el predictor centrado globalmente representa adecuadamente ambas fuentes de variación en la media. Pero esa igualdad es un supuesto, no una identidad empírica.
ImportanteUn predictor sin descomponer impone una restricción
Usar una sola pendiente para un predictor que varía dentro y entre grupos equivale, en la estructura de la media, a tratar la asociación dentro y la asociación entre grupos como si fueran la misma. La descomposición dentro–entre permite que los datos y las previas informen esas cantidades por separado.
3.8 Asociación contextual
Otra parametrización muy útil parte del predictor centrado globalmente:
Si \(\delta>0\), la asociación entre grupos es más positiva que la asociación dentro de grupos.
Si \(\delta<0\), la asociación entre grupos es menos positiva —o más negativa— que la asociación dentro de grupos.
Si \(\delta=0\), las dos asociaciones coinciden en la estructura de la media.
Hox et al. muestran esta diferencia con los datos High School & Beyond. En su parametrización con SES centrado por escuela, el coeficiente de la media escolar contiene la asociación entre escuelas; cuando usan SES centrado globalmente junto con la media escolar, el coeficiente adicional de la media escolar corresponde al contraste contextual (Hox et al. 2018, 51-52).
AdvertenciaContextual no significa automáticamente causal
La cantidad \(\beta_B-\beta_W\) describe una diferencia de asociaciones bajo el modelo. Interpretarla como un efecto causal del contexto requiere supuestos adicionales sobre selección, confusión, medición y mecanismo de asignación. Esta semana usaremos deliberadamente el término asociación contextual.
3.9 Falacia ecológica y falacia atomística
La separación entre niveles también protege contra conclusiones que cambian de nivel sin justificación.
3.9.1 Falacia ecológica
La falacia ecológica consiste en trasladar al nivel individual una relación observada entre agregados. Hox et al. recuerdan el ejemplo clásico discutido por Robinson: una correlación muy alta entre variables agregadas por región puede coexistir con una correlación individual mucho menor (Hox et al. 2018, 2-4).
En nuestro contexto, observar que escuelas con mayor SES promedio tienen mayor rendimiento promedio no demuestra que, dentro de cada escuela, estudiantes con mayor SES tengan exactamente la misma asociación con el rendimiento.
3.9.2 Falacia atomística
La falacia atomística comete el error inverso: usar una relación individual para concluir automáticamente algo sobre grupos o contextos.
Por ejemplo, una asociación positiva entre SES y rendimiento dentro de escuelas no implica que las escuelas con mayor SES promedio deban diferir entre sí en la misma magnitud.
3.9.3 La solución no es escoger “el nivel correcto”
El objetivo del modelado multinivel no es decidir que un nivel es real y el otro irrelevante. Es representar simultáneamente las comparaciones científicamente pertinentes en los niveles presentes en los datos.
3.10 Modelo bayesiano completo para la descomposición dentro–entre
No existe un valor universal para \(s_0\), \(s_W\), \(s_B\), \(s_\tau\) o \(s_\sigma\). Deben elegirse en la escala del problema. Esta semana usamos previas moderadamente regularizadoras y hacemos una comprobación predictiva previa; la especificación sistemática de previas será el tema central de la semana 6.
Bürkner describe en brms la separación entre parámetros poblacionales y parámetros grupales y la distribución normal multivariada usada para los coeficientes grupales (Bürkner 2017, 2-5). En nuestro modelo de esta semana solo varía el intercepto, por lo que la estructura grupal es unidimensional.
3.11 Laboratorio reproducible en R
El laboratorio tiene cinco metas:
generar datos donde \(\beta_W\) y \(\beta_B\) sean deliberadamente distintos;
visualizar qué comparaciones representan las dos pendientes;
contrastar un predictor sin centrar, uno centrado globalmente y una descomposición dentro–entre;
estimar la asociación contextual a partir de draws posteriores;
comprobar el modelo tanto globalmente como respecto de la estructura respuesta–predictor.
3.11.1 Simular un predictor con variación dentro y entre grupos
Usaremos \(J=30\) grupos. Cada grupo tendrá su propia media de \(x\) y un intercepto residual que no queda explicado por esa media.
# A tibble: 1 × 5
  grupos n_min n_mediana n_max     N
   <int> <int>     <dbl> <int> <int>
1     30    18        32    42   911
En un análisis real no conocemos \(\bar x_j\) poblacional. La estimamos con la media observada del grupo. Construimos las variables que realmente entrarían en el modelo.
3.11.2 Visualizar la comparación dentro de los grupos
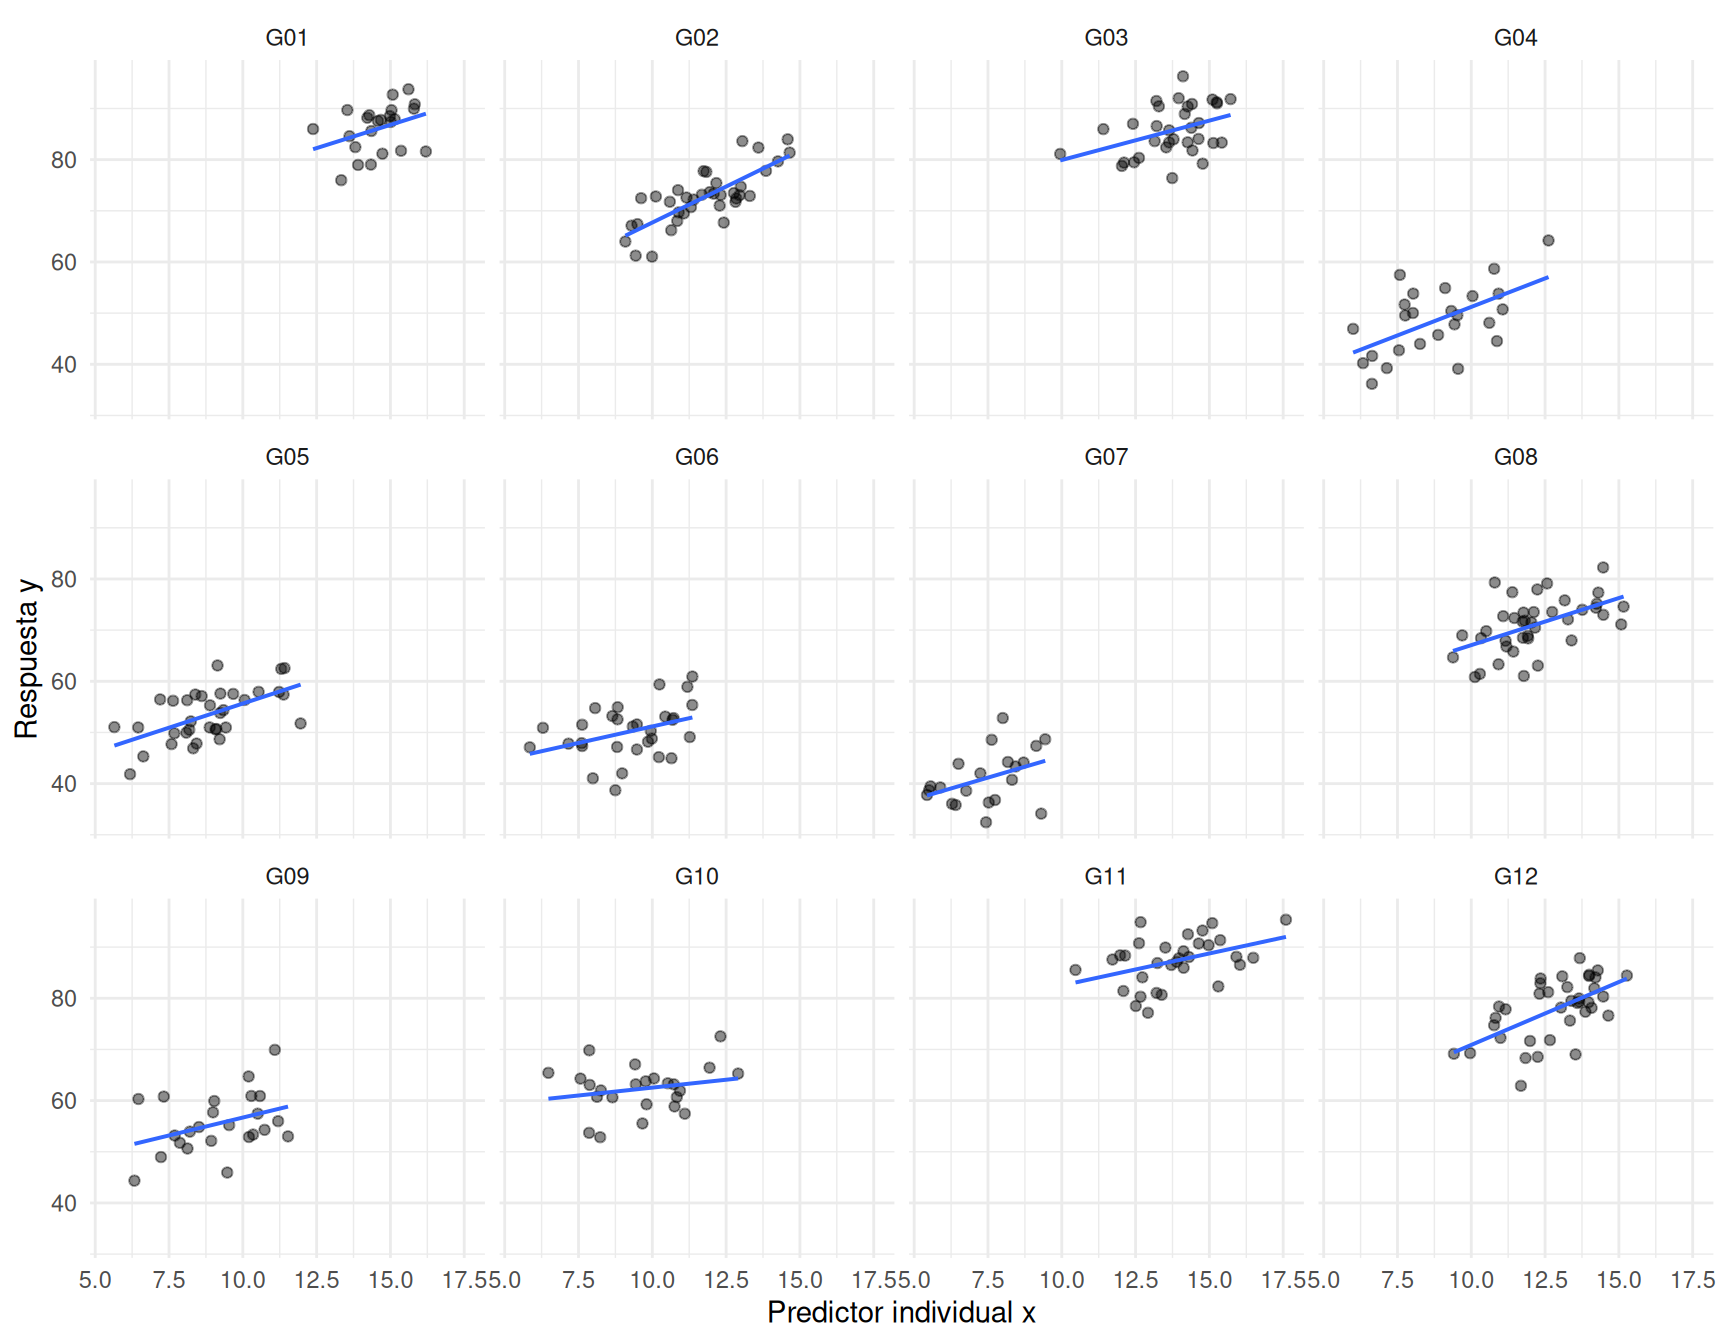
Seleccionamos algunos grupos para que el gráfico sea legible. Cada línea se estima descriptivamente dentro del grupo; no es todavía el modelo jerárquico.
seleccion <- niveles_grupo[1:12]sim |>filter(grupo %in% seleccion) |>ggplot(aes(x = x, y = y, group = grupo)) +geom_point(alpha =0.45) +geom_smooth(method ="lm", se =FALSE, linewidth =0.7) +facet_wrap(~ grupo, ncol =4) +labs(x ="Predictor individual x",y ="Respuesta y" ) +theme_minimal()
Figura 3.1: Relación entre el predictor y la respuesta dentro de una selección de grupos. Las líneas descriptivas muestran comparaciones intragrupo; la posición horizontal y vertical de los grupos puede diferir considerablemente.
3.11.3 Visualizar la comparación entre grupos
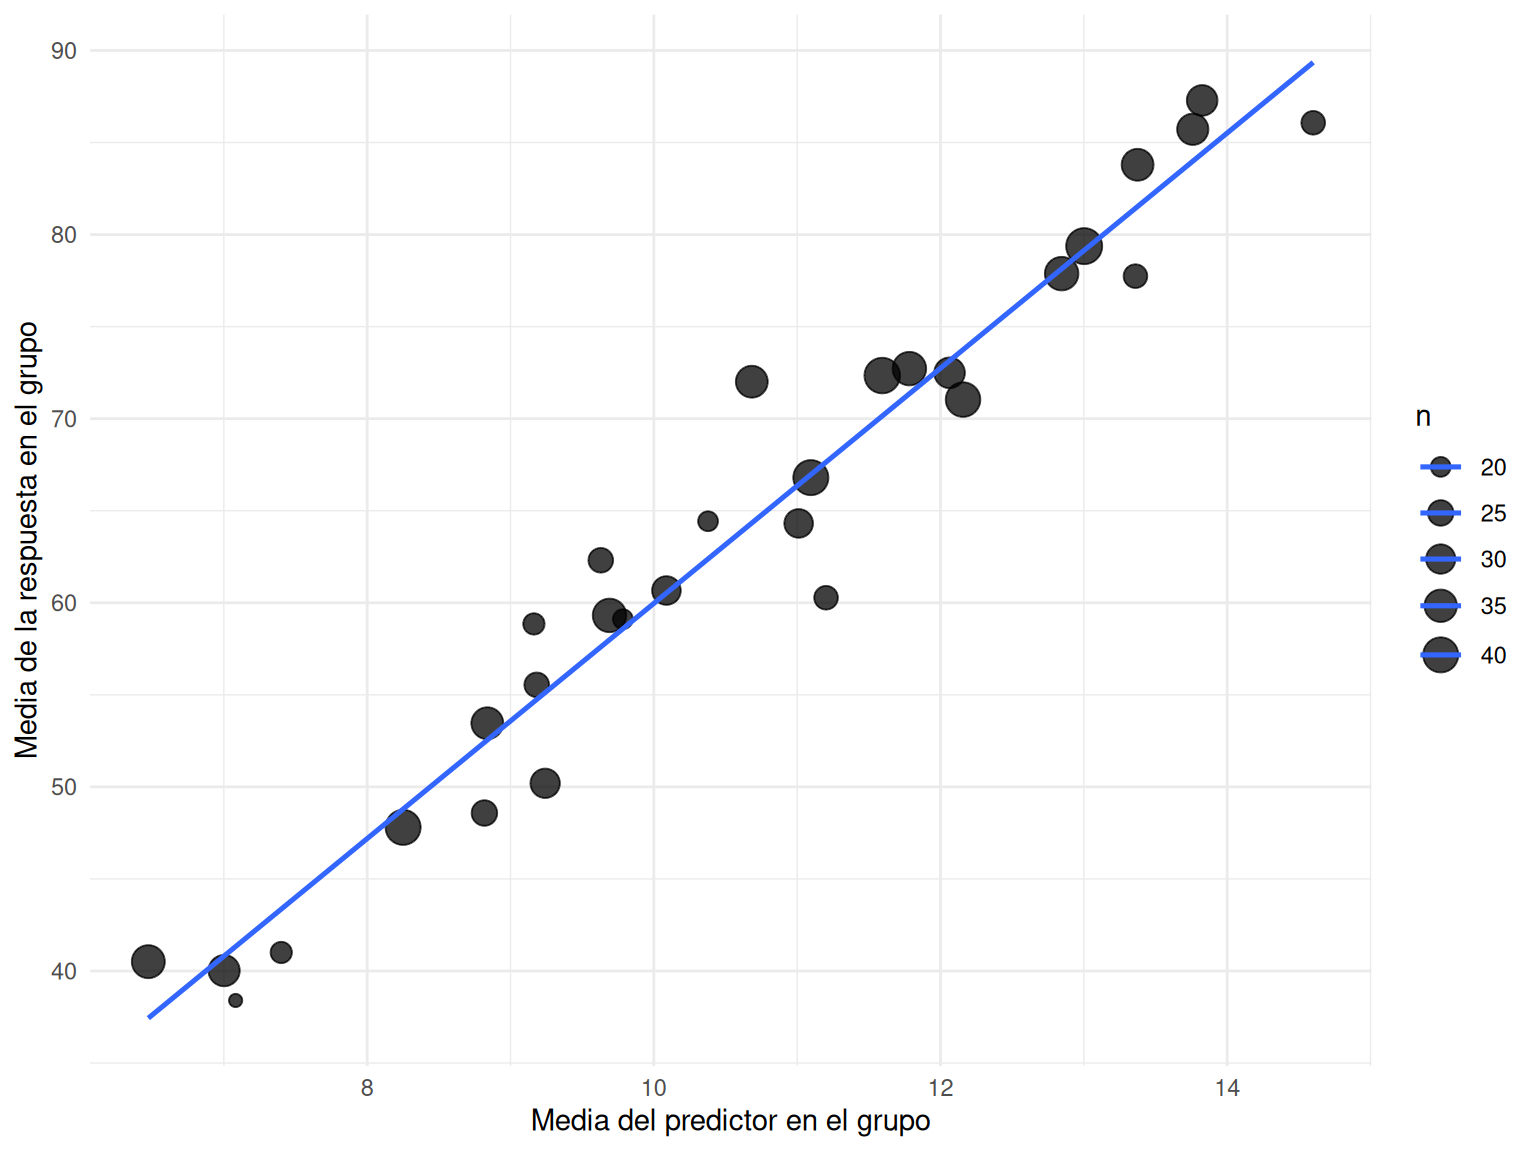
Ahora reducimos cada grupo a su par de medias observadas \((\bar x_j,\bar y_j)\). Este gráfico responde una pregunta distinta.
resumen_grupo <- sim |>group_by(grupo) |>summarise(n =n(),xbar =mean(x),ybar =mean(y),.groups ="drop" )ggplot( resumen_grupo,aes(x = xbar, y = ybar, size = n)) +geom_point(alpha =0.75) +geom_smooth(aes(group =1),method ="lm",se =FALSE,linewidth =0.9 ) +scale_size_continuous(range =c(2, 6)) +labs(x ="Media del predictor en el grupo",y ="Media de la respuesta en el grupo",size ="n" ) +theme_minimal()
Figura 3.2: Medias observadas por grupo. La pendiente descriptiva entre grupos no tiene por qué coincidir con la asociación dentro de grupos.
Los dos gráficos no son versiones redundantes de la misma relación. El primero compara unidades dentro de grupos; el segundo compara agregados de grupos.
3.12 Tres especificaciones para el mismo predictor
Ajustaremos tres modelos:
sin centrar\[
y_{ij}\sim\mathcal N(\alpha_j+\beta x_{ij},\sigma^2);
\]
Los dos primeros usan una única pendiente y, por tanto, no separan \(\beta_W\) de \(\beta_B\). El tercero permite estimarlas por separado.
3.12.1 Previas para la simulación
La respuesta fue generada alrededor de 60 y su variación relevante está en decenas, no en miles. Usaremos previas que admiten un rango amplio de relaciones sin ser extremadamente difusas.
prior_raw <-c(prior(normal(0, 50), class ="Intercept"),prior(normal(0, 5), class ="b"),prior(normal(0, 10), class ="sd", group ="grupo"),prior(normal(0, 10), class ="sigma"))prior_centered <-c(prior(normal(60, 15), class ="Intercept"),prior(normal(0, 5), class ="b"),prior(normal(0, 10), class ="sd", group ="grupo"),prior(normal(0, 10), class ="sigma"))
En brms, las previas normal(0, 10) sobre parámetros de clase sd y sigma se restringen al soporte positivo correspondiente.
3.12.2 Comprobación predictiva previa sin ajustar el modelo
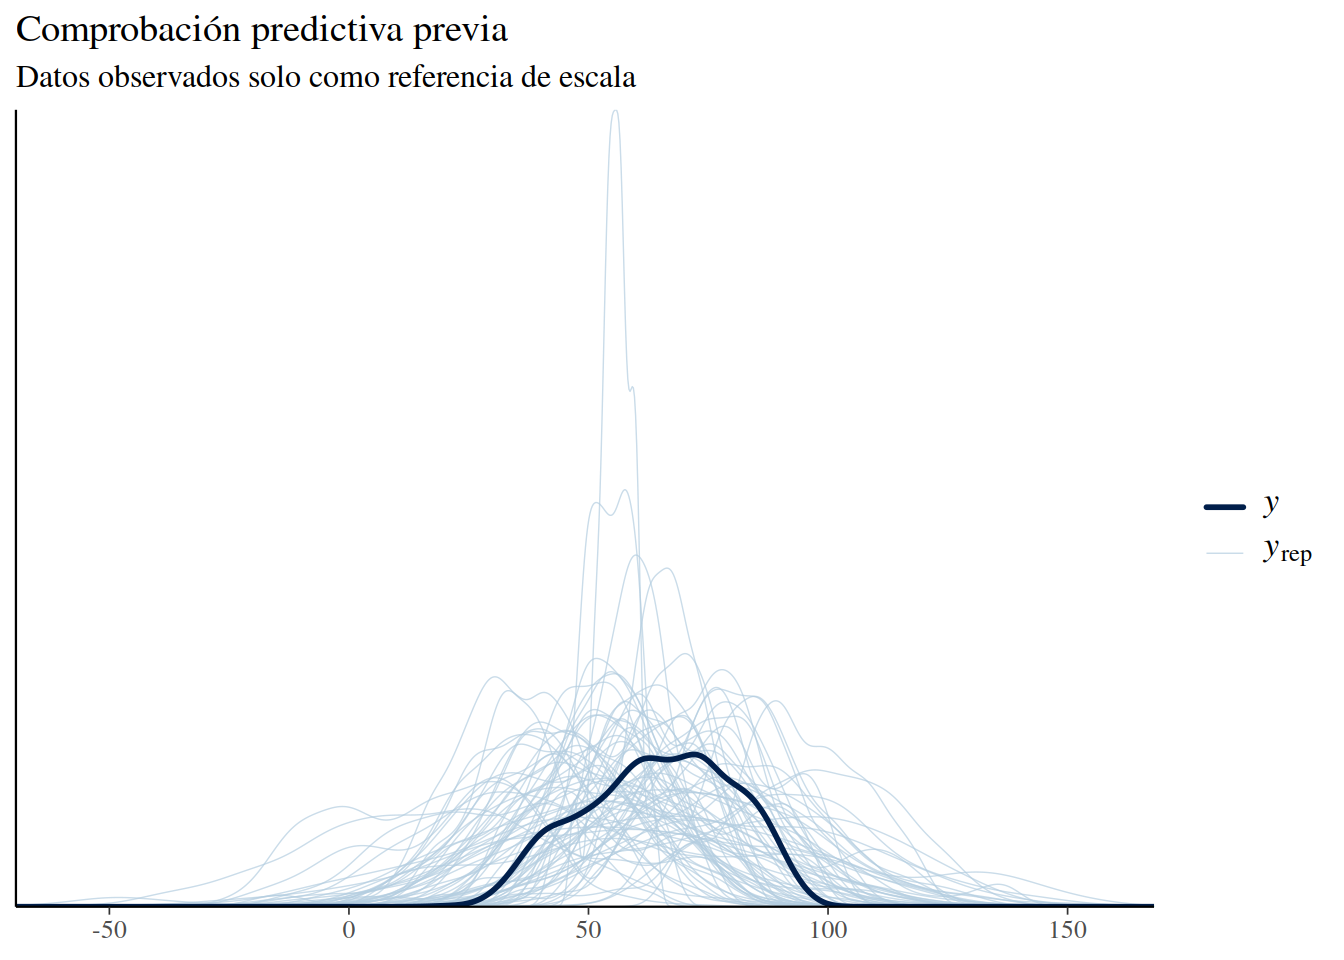
Antes de usar los datos para aprender los parámetros, simulamos directamente desde las previas del modelo dentro–entre. Esto evita compilar un ajuste adicional solo para esta comprobación.
La comprobación predictiva previa no busca “ajustar” los datos observados. Sirve para verificar si la especificación previa permite respuestas en escalas científicamente plausibles y si excluye valores que realmente consideramos posibles.
Running MCMC with 4 parallel chains...

Chain 1 finished in 1.9 seconds.
Chain 4 finished in 1.8 seconds.
Chain 3 finished in 1.9 seconds.
Chain 2 finished in 2.0 seconds.

All 4 chains finished successfully.
Mean chain execution time: 1.9 seconds.
Total execution time: 2.1 seconds.
En este modelo el intercepto corresponde a \(x=0\). Como el predictor se concentra alrededor de 10, el intercepto requiere extrapolación y no es la cantidad más natural para comunicar.
Los modelos con una sola pendiente resumen en un solo coeficiente dos fuentes de variación que el proceso generador hizo deliberadamente diferentes. El modelo dentro–entre tiene parámetros que corresponden directamente a las dos comparaciones de interés.
3.13.1 La asociación contextual como cantidad derivada
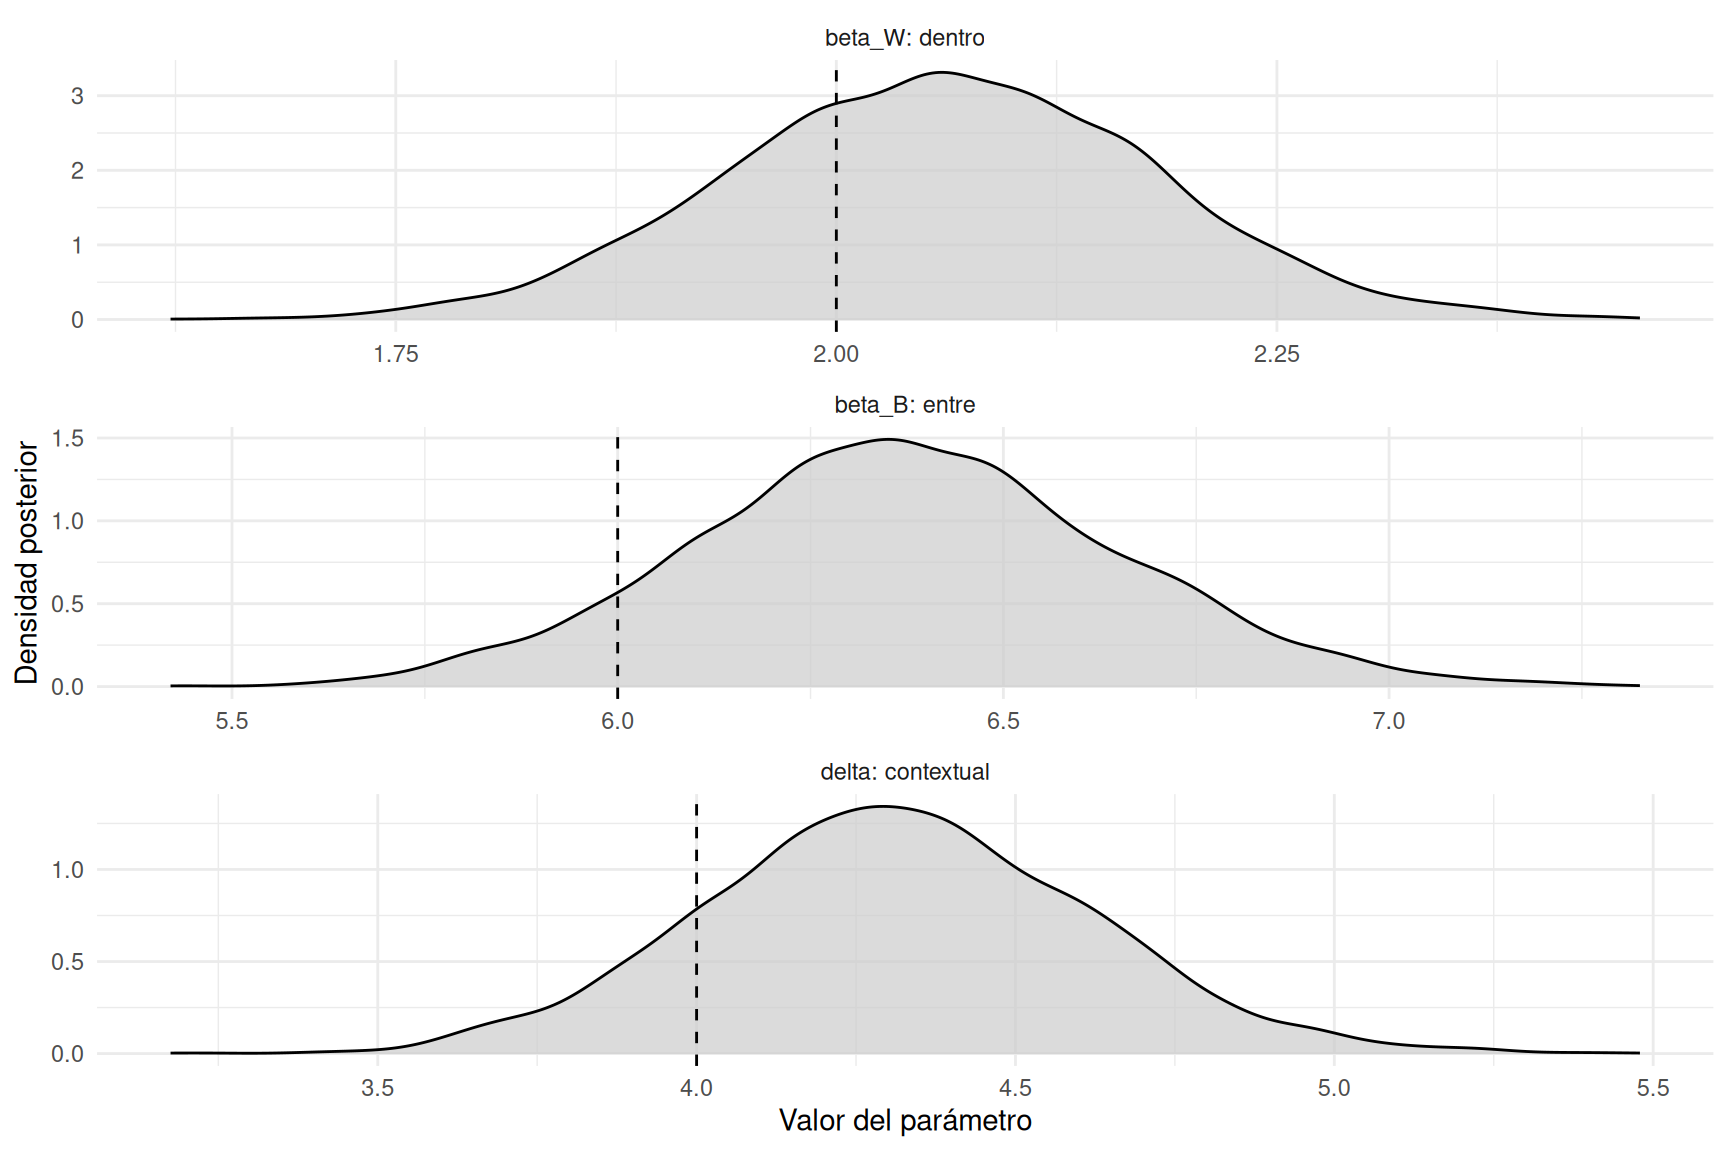
No necesitamos ajustar un cuarto modelo para obtener \(\delta\). Podemos calcularla para cada draw posterior:
\[
\delta^{(s)}
=
\beta_B^{(s)}-\beta_W^{(s)}.
\]
Esto propaga automáticamente la dependencia posterior entre ambas pendientes.
Figura 3.3: Distribuciones posteriores de la asociación dentro de grupos, la asociación entre grupos y su diferencia contextual. Las líneas verticales indican los valores usados para generar los datos.
3.14 Diagnóstico MCMC mínimo
El objetivo de esta semana no es desarrollar todavía toda la teoría de HMC; eso corresponde a la semana 7. Sin embargo, no interpretaremos una posterior antes de revisar indicadores básicos.
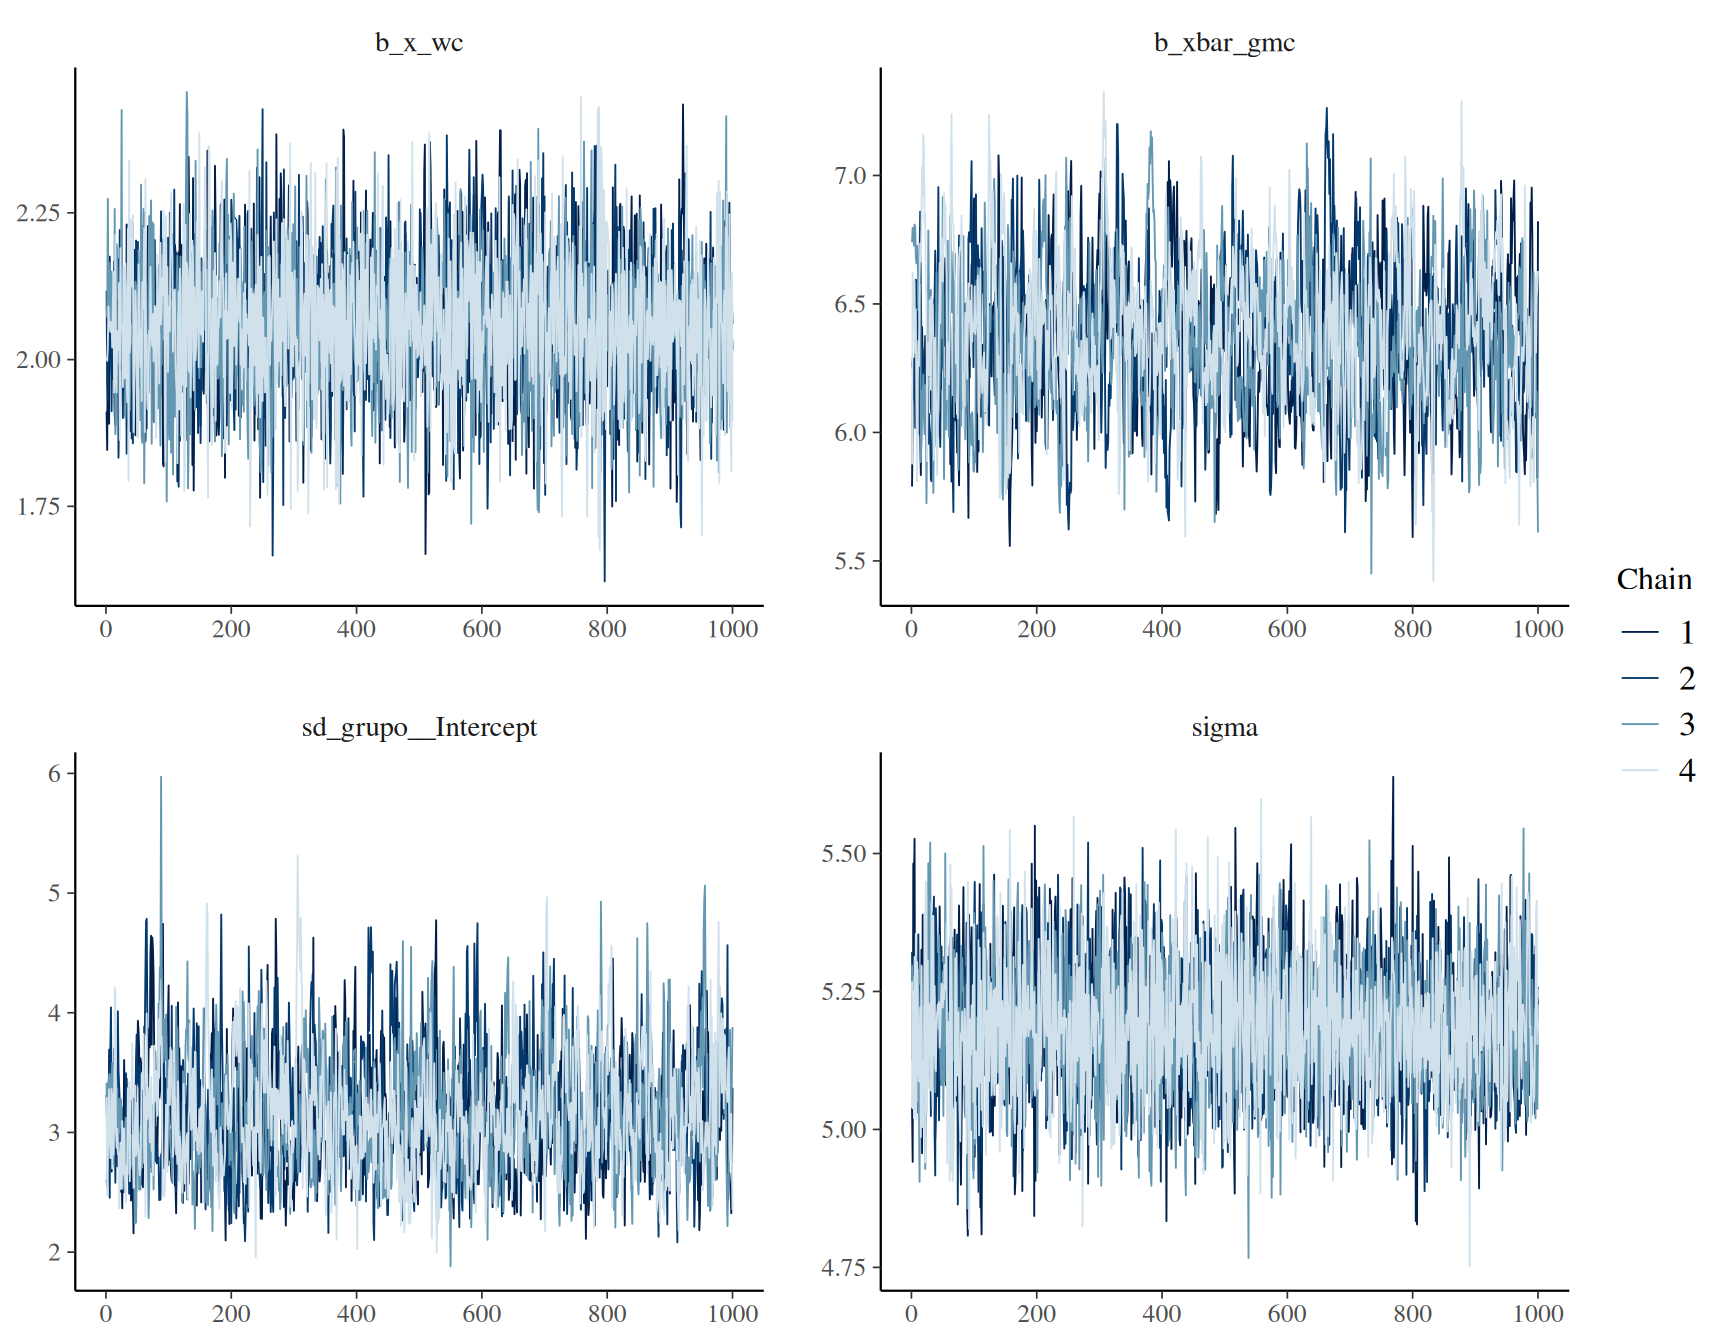
Figura 3.4: Trazas MCMC para los dos coeficientes de interés y las escalas principales del modelo dentro–entre.
Una ausencia de divergencias, valores de \(\widehat R\) cercanos a 1, tamaños efectivos razonables y trazas bien mezcladas apoyan la estabilidad computacional del ajuste. Ninguno de estos diagnósticos demuestra que la descomposición dentro–entre sea científicamente correcta; esa es una cuestión de modelado.
3.15 Comprobación predictiva posterior
3.15.1 Comprobación global
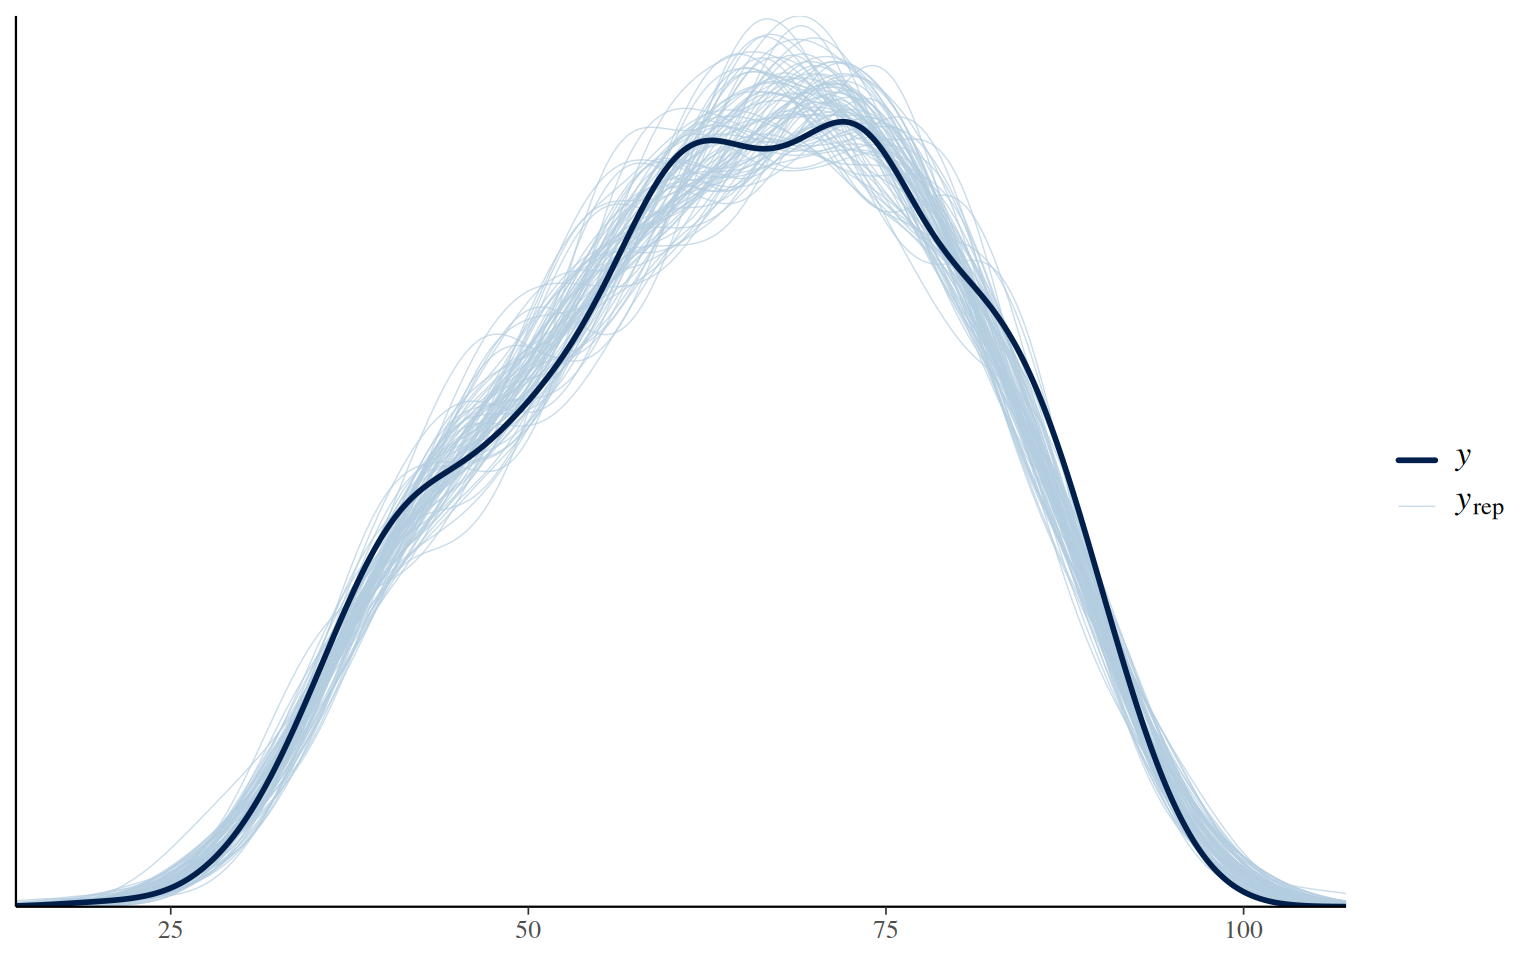
pp_check( fit_wb,type ="dens_overlay",ndraws =80)
Comprobación predictiva posterior global para el modelo dentro–entre.
Una comprobación global puede detectar problemas obvios en ubicación, dispersión, colas o multimodalidad. Pero puede ocultar un problema central de esta semana: reproducir bien la distribución marginal de \(y\) no garantiza reproducir su relación con \(x\).
3.15.2 Comprobar la relación dentro de grupos
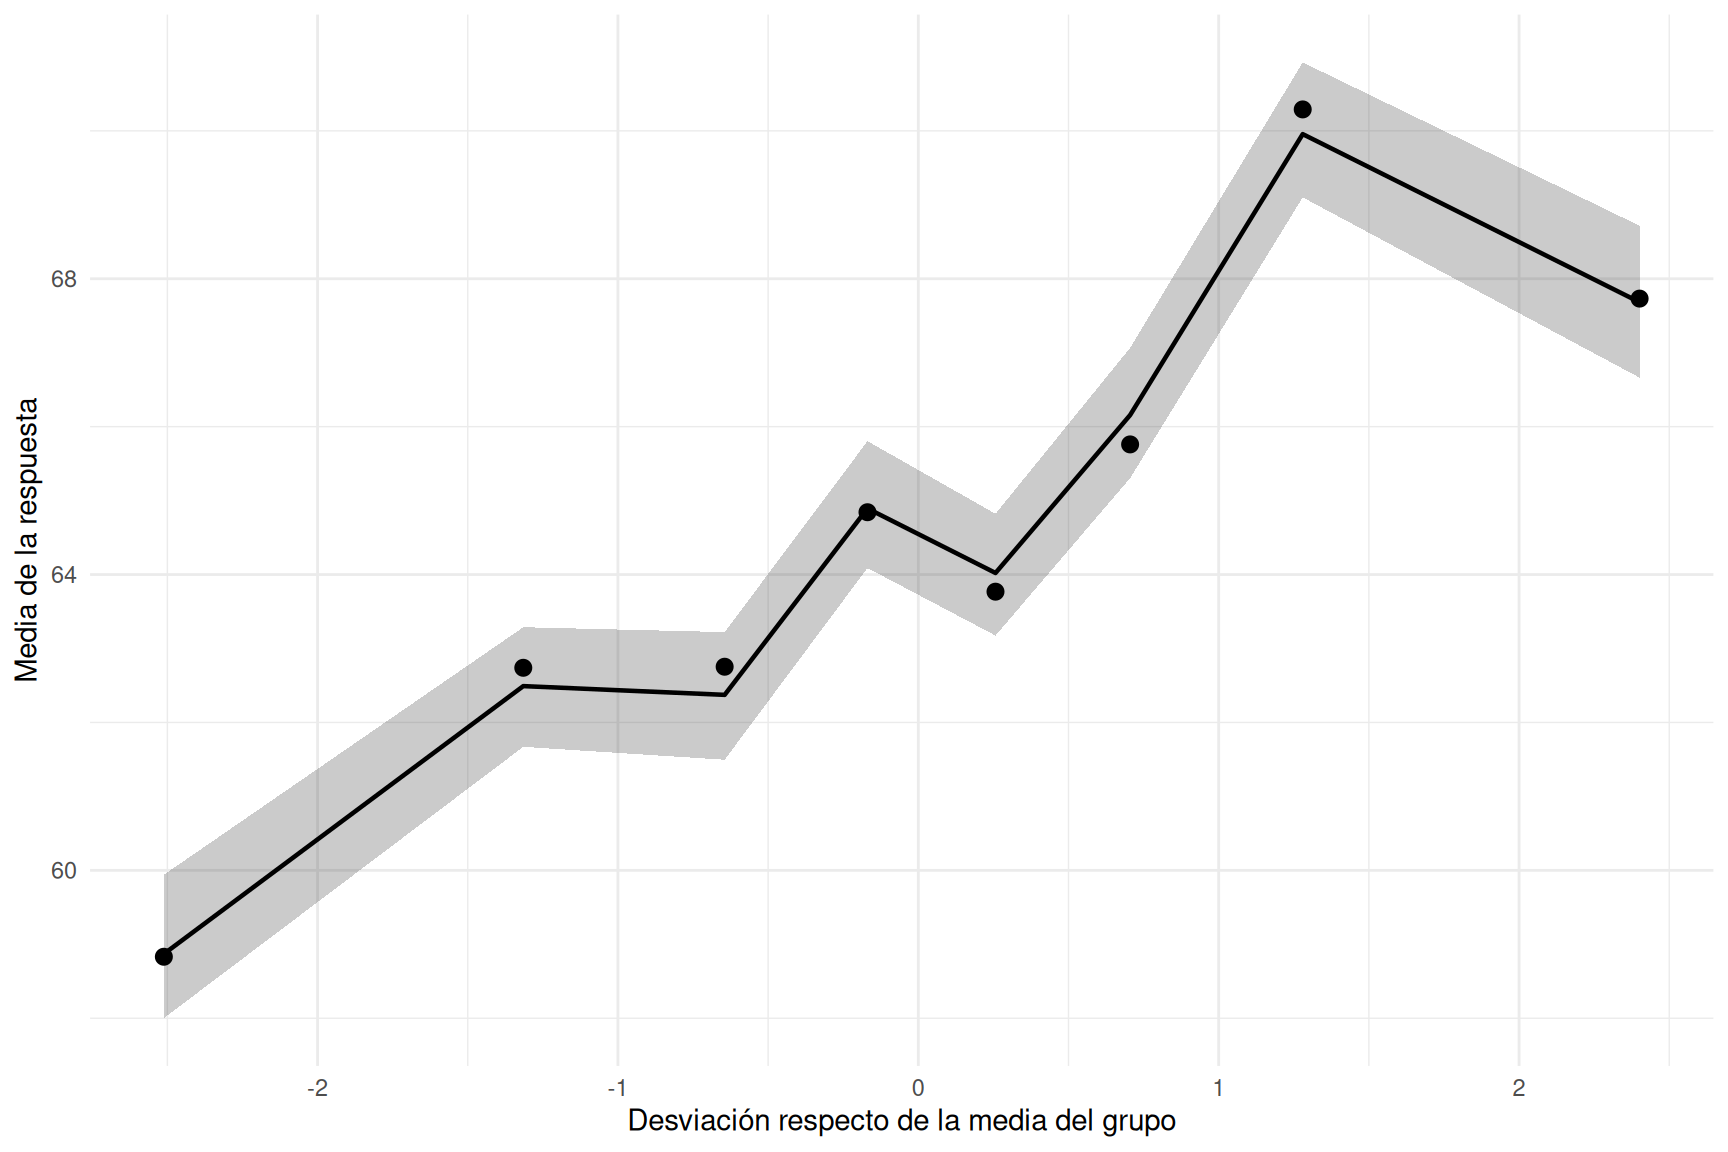
Dividimos \(x_{ij}^{W}\) en intervalos y comparamos la media observada de \(y\) con las medias generadas por la posterior predictiva.
set.seed(1653)yrep_wb <-posterior_predict( fit_wb,ndraws =300)sim_ppc <- sim |>mutate(bin_wc =cut_number(x_wc, n =8) )indices_bin <-split(seq_len(nrow(sim_ppc)), sim_ppc$bin_wc)rep_bins <- purrr::imap_dfr( indices_bin,function(idx, etiqueta) {tibble(draw =seq_len(nrow(yrep_wb)),bin_wc = etiqueta,yrep_media =rowMeans( yrep_wb[, idx, drop =FALSE] ) ) })pred_bin <- rep_bins |>group_by(bin_wc) |>summarise(pred_mediana =median(yrep_media),pred_q05 =quantile(yrep_media, 0.05),pred_q95 =quantile(yrep_media, 0.95),.groups ="drop" )obs_bin <- sim_ppc |>group_by(bin_wc) |>summarise(x_media =mean(x_wc),y_media =mean(y),.groups ="drop" )ppc_bin <-left_join( obs_bin, pred_bin,by ="bin_wc")ggplot( ppc_bin,aes(x = x_media)) +geom_ribbon(aes(ymin = pred_q05,ymax = pred_q95 ),alpha =0.25 ) +geom_line(aes(y = pred_mediana),linewidth =0.8 ) +geom_point(aes(y = y_media),size =2.5 ) +labs(x ="Desviación respecto de la media del grupo",y ="Media de la respuesta" ) +theme_minimal()
Comprobación predictiva posterior de la relación entre la desviación individual respecto de la media grupal y la respuesta. Los intervalos muestran el 90% de las medias predictivas por intervalo del predictor; los puntos muestran las medias observadas.
3.15.3 Comprobar las medias entre grupos
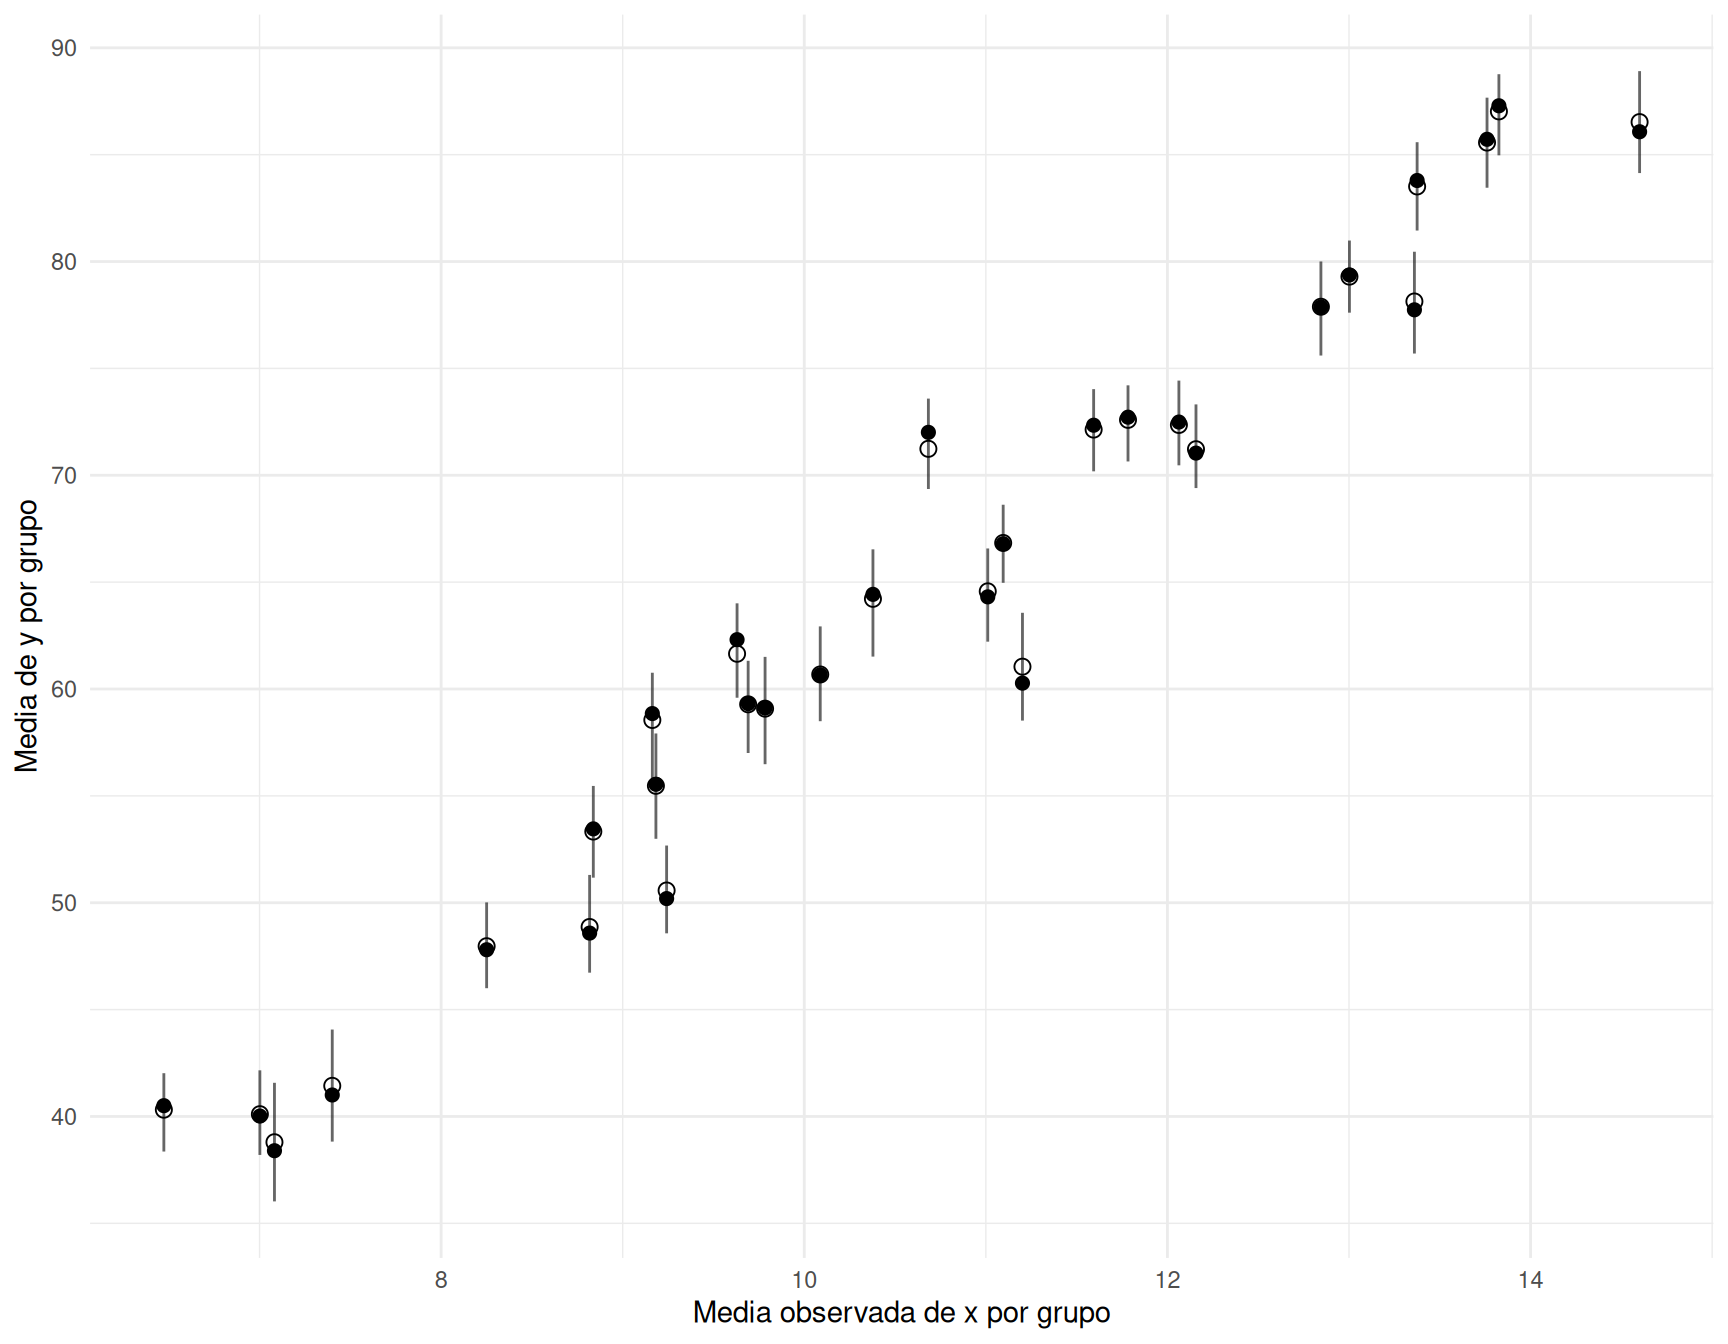
También debemos verificar que el modelo reproduzca razonablemente la relación entre composición grupal y respuesta promedio.
Relación observada y predictiva entre la media del predictor y la media de la respuesta por grupo. Cada barra resume la distribución posterior predictiva de la media del grupo.
La comprobación por niveles es deliberada: un modelo puede reproducir bien la distribución global de la respuesta y aun así representar mal la variación dentro de grupos o la variación entre grupos.
3.16 Aplicación: SES y rendimiento matemático
Usaremos los datos MathAchieve incluidos en el paquete nlme. Contienen 7185 estudiantes en 160 escuelas y corresponden al ejemplo High School & Beyond que Hox et al. emplean para discutir centrado y efectos contextuales (Hox et al. 2018, 51-52).
Nuestro objetivo no es reproducir exactamente las estimaciones frecuentistas de su Tabla 4.2. Ajustaremos una versión bayesiana con la misma idea estructural:
La media global de ses_wc es aproximadamente cero porque sus medias son cero dentro de cada escuela. Más importante aún, su interpretación es intragrupo.
3.16.2 Exploración gráfica
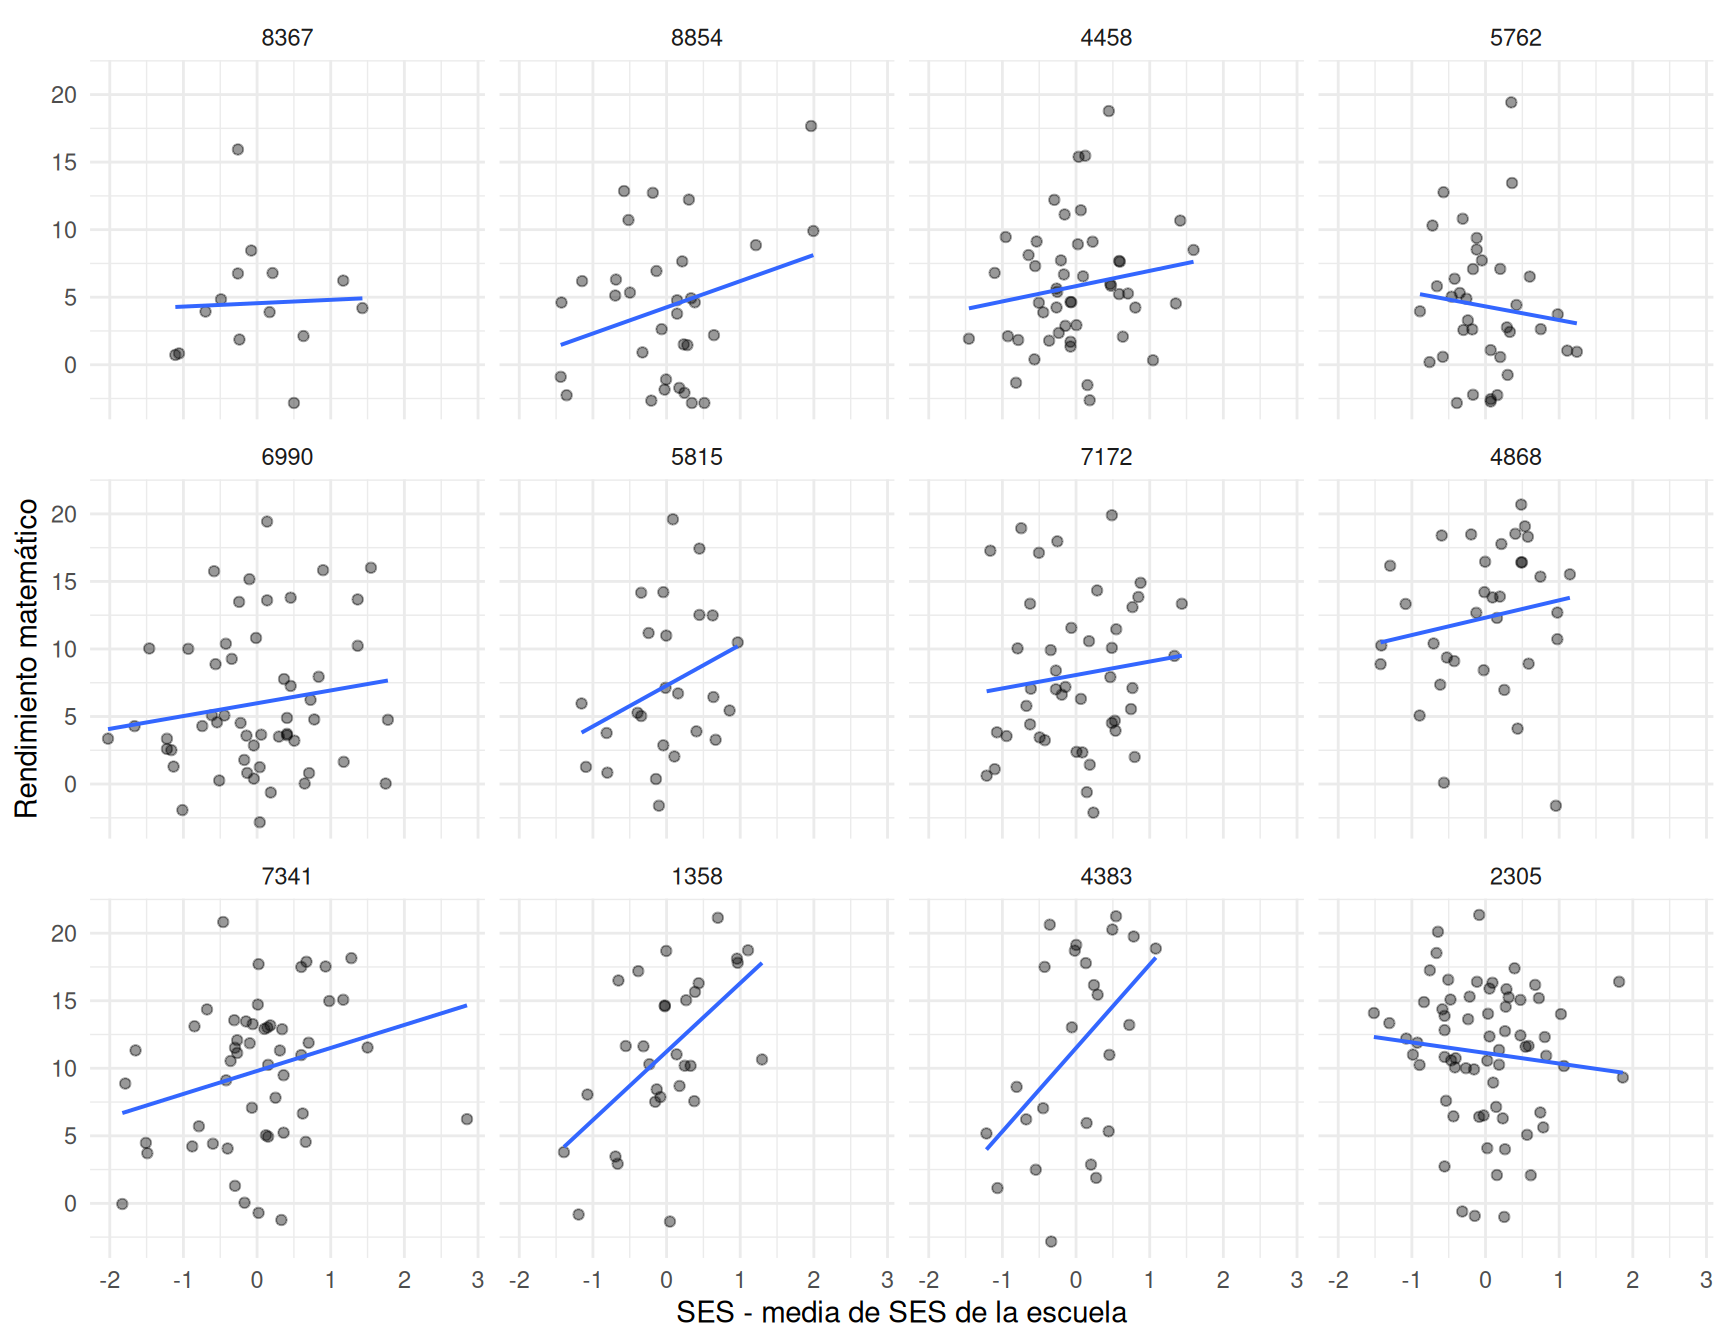
escuelas_muestra <-levels(math$School)[1:12]math |>filter(School %in% escuelas_muestra) |>ggplot(aes(x = ses_wc, y = MathAch)) +geom_point(alpha =0.4) +geom_smooth(method ="lm", se =FALSE, linewidth =0.7) +facet_wrap(~ School, ncol =4) +labs(x ="SES - media de SES de la escuela",y ="Rendimiento matemático" ) +theme_minimal()
Figura 3.5: Rendimiento matemático contra SES centrado por escuela para una selección de escuelas. El eje horizontal representa posición socioeconómica relativa dentro de cada escuela.
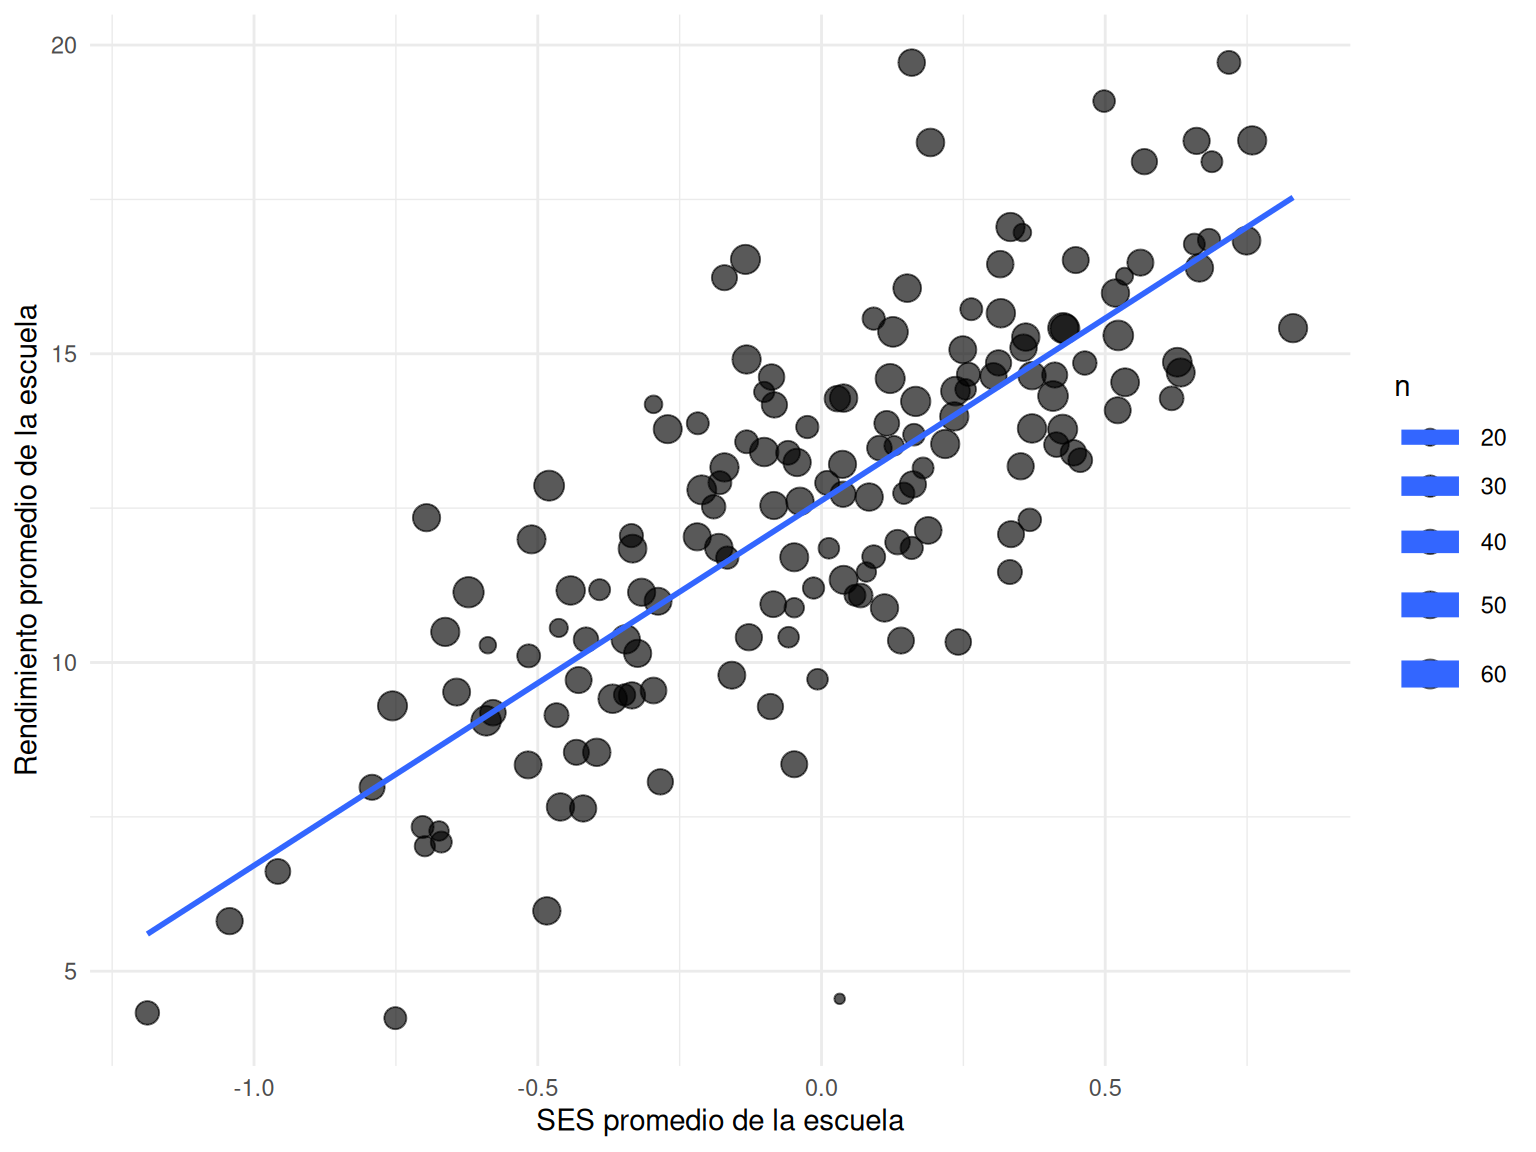
math_school <- math |>group_by(School) |>summarise(n =n(),meanses =first(MEANSES),math_mean =mean(MathAch),.groups ="drop" )ggplot( math_school,aes(x = meanses,y = math_mean,size = n )) +geom_point(alpha =0.65) +geom_smooth(aes(group =1),method ="lm",se =FALSE ) +scale_size_continuous(range =c(1.5, 5)) +labs(x ="SES promedio de la escuela",y ="Rendimiento promedio de la escuela",size ="n" ) +theme_minimal()
Figura 3.6: Rendimiento matemático promedio y SES promedio por escuela. Este gráfico representa una comparación entre escuelas, no entre estudiantes de la misma escuela.
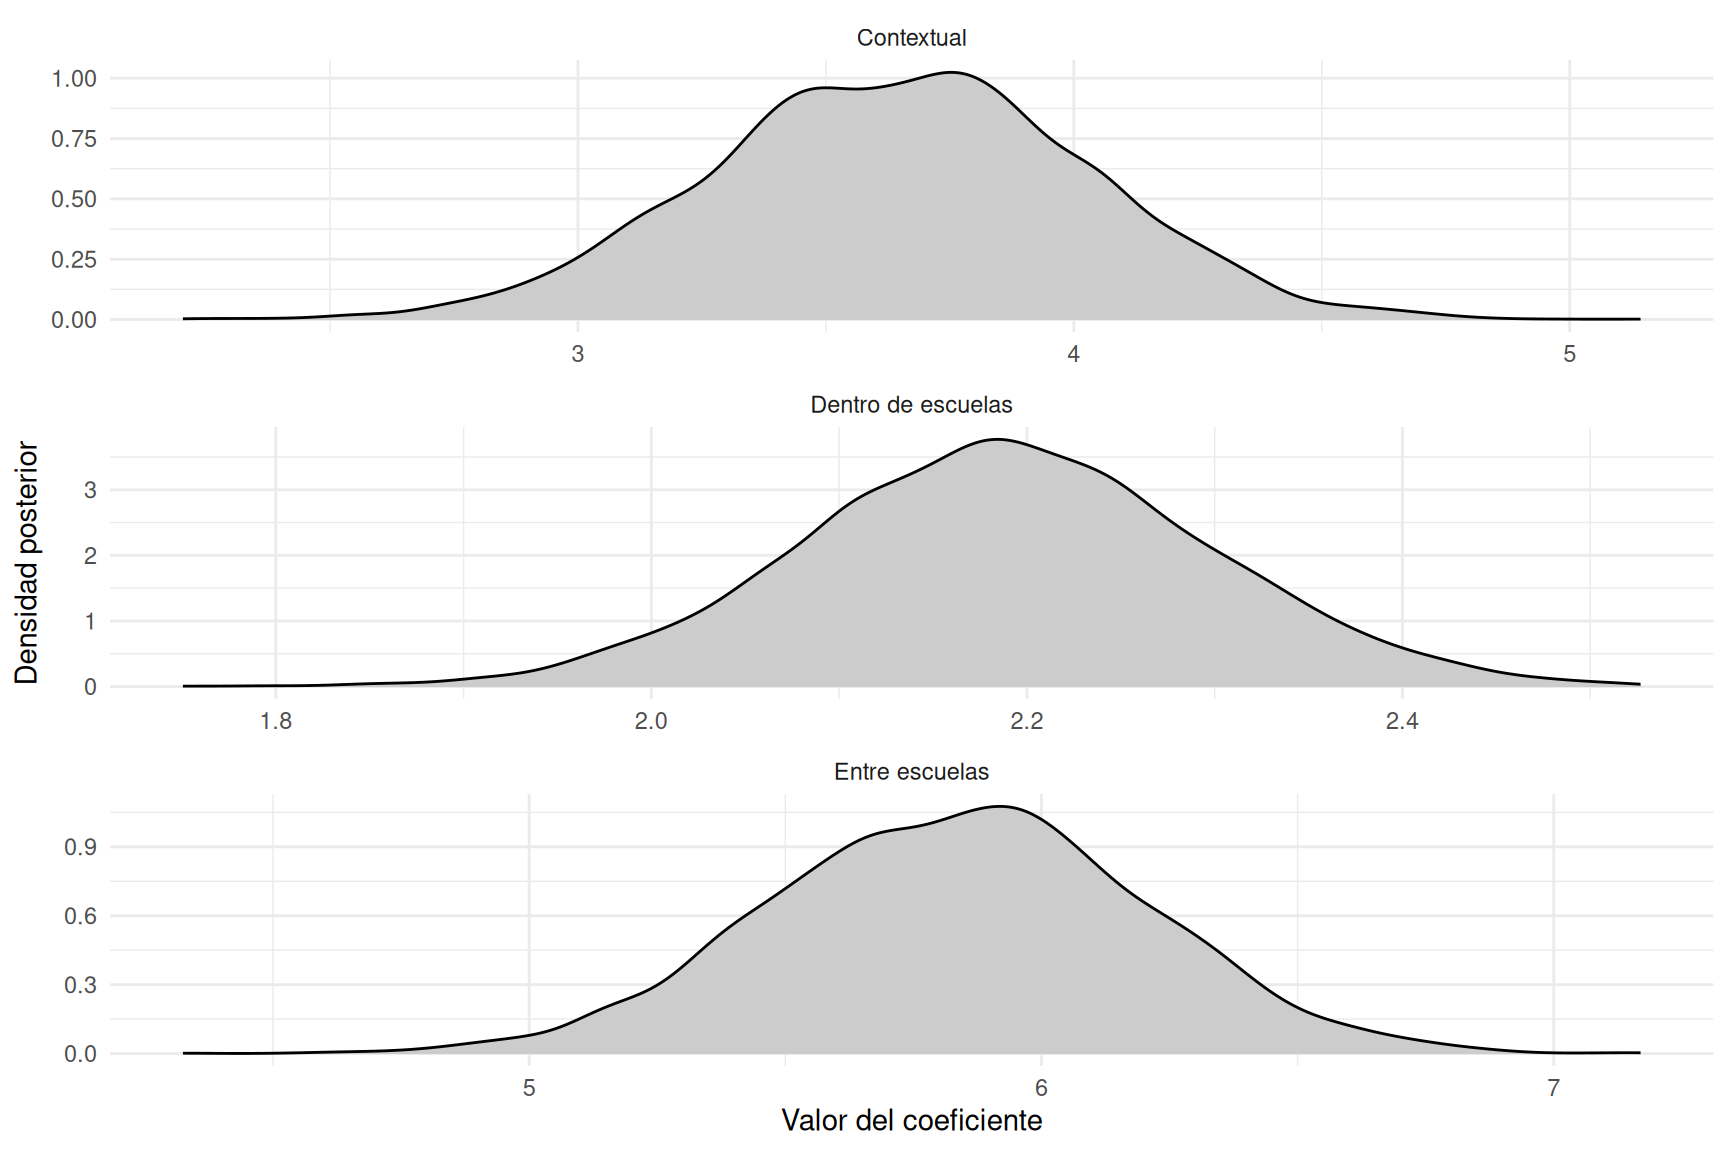
Figura 3.7: Distribuciones posteriores de las asociaciones dentro de escuelas, entre escuelas y contextual para los datos de rendimiento matemático.
El interés principal no es decidir si un coeficiente “es significativo”, sino describir la magnitud y la incertidumbre de las comparaciones que el modelo define.
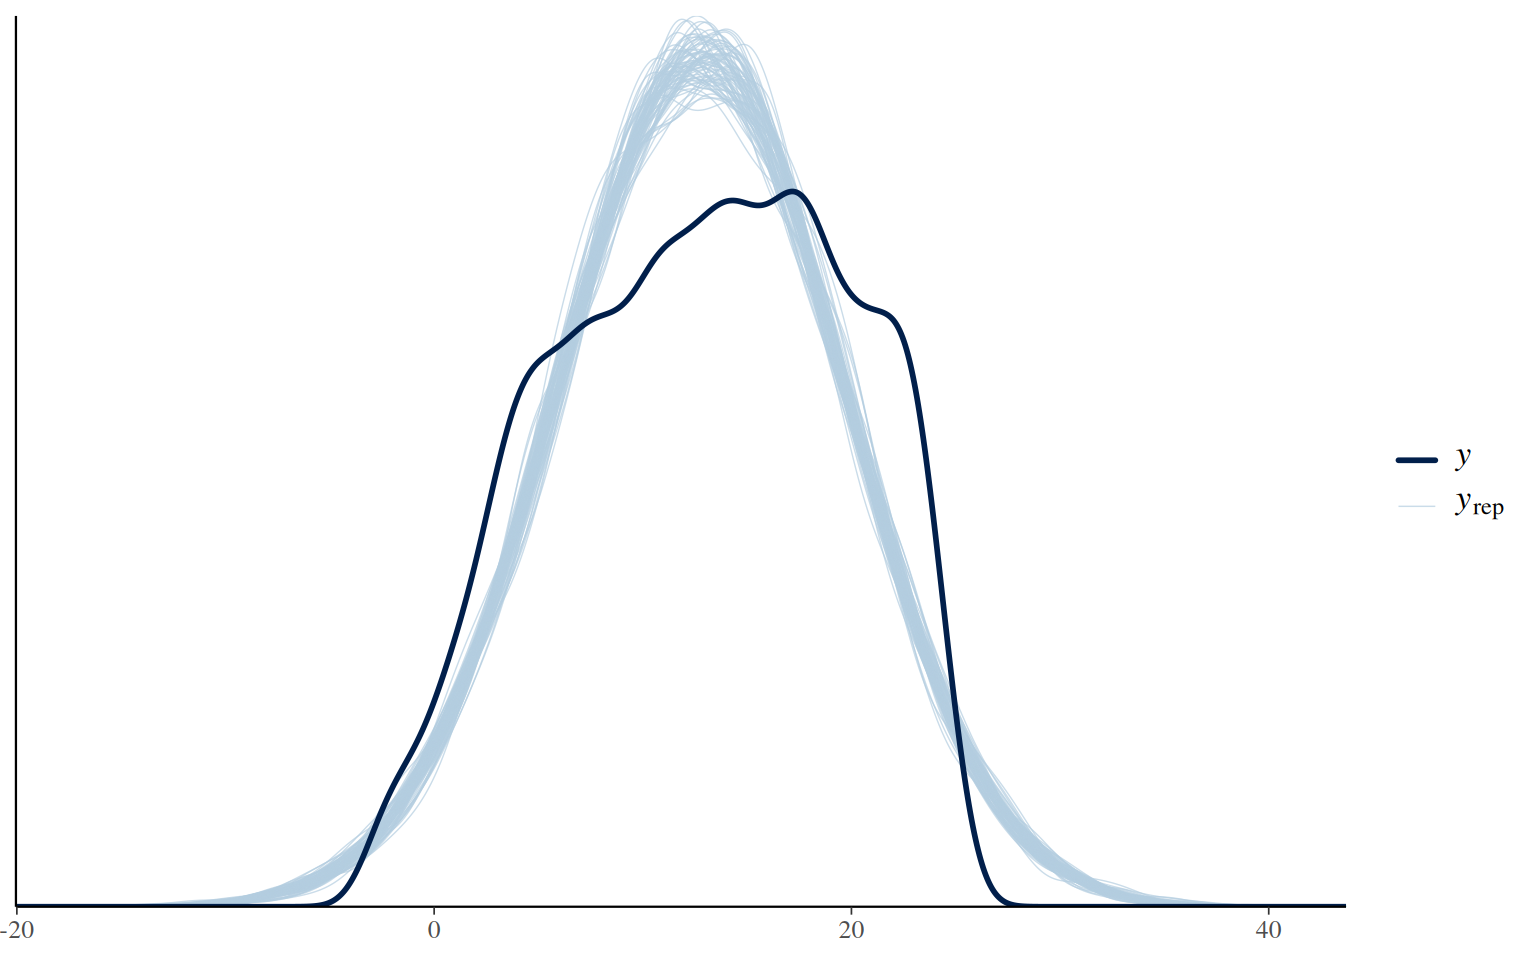
Comprobación predictiva posterior global para el modelo de rendimiento matemático.
Una extensión natural sería comprobar por separado escuelas con composiciones socioeconómicas bajas, medias y altas, o examinar si la relación con ses_wc presenta curvatura. No añadiremos complejidad automáticamente: una expansión debe responder a una discrepancia predictiva o a una hipótesis sustantiva.
3.17 Cómo elegir una estrategia de centrado
No existe una receta universal. Las siguientes preguntas son más útiles que una lista de reglas.
3.17.1 1. ¿Qué significa \(x=0\)?
Si cero ya es una referencia sustantiva importante, puede no ser necesario centrar.
Si cero es imposible o está muy lejos de los datos, una referencia más interpretable puede mejorar el significado del intercepto.
3.17.2 2. ¿La pregunta es dentro del grupo, entre grupos o ambas?
Pregunta dentro: \(x_{ij}-\bar x_j\) puede ser la variable natural.
Pregunta entre: \(\bar x_j\) es la cantidad relevante.
Pregunta dentro y entre: incluir ambas componentes explícitamente.
3.17.3 3. ¿El predictor participa en una interacción?
Cuando hay interacciones, los efectos principales se interpretan en el valor cero de las otras variables. Gelman y Hill y Hox et al. destacan que una referencia razonable puede volver esas cantidades mucho más claras (Gelman y Hill 2007, 55-57; Hox et al. 2018, 48-53).
La semana 4 profundizará esta idea con pendientes variables e interacciones entre niveles.
3.17.4 4. ¿El predictor varía dentro de todos los grupos?
Si en muchos grupos casi no hay variación dentro, la información para \(\beta_W\) puede ser débil aunque el conjunto de datos tenga muchas filas. Nuevamente, el número total de observaciones no resume toda la información del modelo.
3.17.5 5. ¿La media grupal es una cantidad observada sin error?
No necesariamente. Cuando \(\bar x_j\) se calcula con pocos individuos, puede ser una estimación ruidosa de una característica grupal latente. En esta semana la tratamos como predictor calculado; el error de medición y la propagación de incertidumbre se retomarán más adelante.
3.18 Centrado de variables categóricas
Una variable indicadora puede escribirse como 0/1 y, en principio, también puede centrarse. Sin embargo, la decisión de codificación tiene consecuencias interpretativas.
el intercepto corresponde directamente al grupo A. Si restamos la media de \(x\), el intercepto representa una combinación promedio de categorías, lo cual puede ser útil en interacciones, pero menos natural para una comparación simple.
Por ello, no aplicaremos “centrar todas las variables” como procedimiento automático. Para predictores categóricos, la codificación debe escogerse para que los contrastes tengan una interpretación clara.
3.19 Perspectiva frecuentista y terminología
En la literatura frecuentista es común describir \(\beta_W\) y \(\beta_B\) como efectos fijos y a \(u_j\) como efecto aleatorio. Estas notas prefieren:
coeficientes poblacionales para \(\beta_W\) y \(\beta_B\);
interceptos variables o desviaciones grupales para \(u_j\).
La distinción es terminológica, no una diferencia en la estructura lineal del modelo.
Hox et al. presentan la separación dentro–entre en el contexto de modelos multinivel estimados por máxima verosimilitud (Hox et al. 2018, 50-52). La contribución bayesiana en estas notas consiste en tratar todas las cantidades desconocidas mediante una distribución posterior, incorporar previas explícitas y propagar la incertidumbre al contraste contextual \(\beta_B-\beta_W\).
3.20 Errores frecuentes de interpretación
“Centrar siempre mejora el modelo.”
No. Centrar en una constante común puede mejorar interpretación y, a veces, computación, pero no añade información. Centrar por grupo puede cambiar la pregunta estadística.
“Si resto la media global, obtengo un efecto dentro de grupos.”
No. El predictor centrado globalmente todavía contiene variación dentro y entre grupos.
“Si uso\(x_{ij}-\bar x_j\), ya controlé por el contexto.”
No. Esa variable representa la posición relativa dentro del grupo. Para estudiar diferencias entre contextos debe incorporarse una variable grupal apropiada, por ejemplo \(\bar x_j\).
“El coeficiente de la media grupal siempre es el efecto contextual.”
Depende de la parametrización. En el modelo dentro–entre, el coeficiente de \(\bar x_j\) es \(\beta_B\). El contraste contextual es \(\beta_B-\beta_W\). En una parametrización con \(x\) centrado globalmente más \(\bar x_j\), el coeficiente adicional de la media grupal puede corresponder directamente a ese contraste.
“Si\(\beta_B>\beta_W\), el contexto causa el resultado.”
No. Esa diferencia es una asociación contextual. La interpretación causal requiere supuestos adicionales.
“Una variable repetida en todas las filas es de nivel individual.”
No. Si su valor es constante dentro de cada grupo, es un predictor grupal aunque esté almacenado en formato largo.
“La media del grupo es conocida exactamente.”
Solo como resumen de la muestra observada. Si pretende representar una característica poblacional del grupo, puede contener error de medición o muestreo.
“La pendiente del modelo sin descomponer es el efecto individual.”
No necesariamente. Si el predictor tiene variación entre grupos, una única pendiente mezcla o restringe comparaciones que pueden diferir.
“Grand-mean centering y group-mean centering son dos maneras equivalentes de hacer lo mismo.”
No. El primero resta una única constante común; el segundo resta una constante distinta en cada grupo y elimina la variación entre grupos del predictor centrado.
“Una reparametrización lineal produce exactamente la misma posterior aunque cambie las previas sin pensarlo.”
No. La equivalencia algebraica de la media no garantiza equivalencia del modelo bayesiano completo si las previas no se transforman coherentemente.
centrar globalmente no elimina la variación entre grupos;
centrar por grupo produce una variable puramente intragrupo;
agregar la media grupal permite recuperar y modelar la comparación entre grupos;
una sola pendiente para un predictor con variación dentro y entre grupos puede imponer una restricción fuerte;
asociaciones individuales y agregadas no deben intercambiarse sin justificación;
la decisión de centrado debe estar guiada por la comparación científica;
en Bayes, las previas forman parte de la parametrización y deben revisarse cuando cambia la escala o el origen de los predictores;
la comprobación predictiva debe examinar las estructuras que motivaron el modelo, no solo la distribución global de la respuesta.
La próxima semana permitiremos que la pendiente misma varíe entre grupos y estudiaremos cómo predictores grupales pueden explicar parte de esa heterogeneidad mediante interacciones entre niveles.
3.22 Ejercicios
3.22.1 Ejercicios conceptuales
3.22.1.1 Ejercicio 1. Reparametrización por centrado global
Considere
\[
y_i=\alpha+\beta x_i+\varepsilon_i.
\]
Defina \(x_i^*=x_i-c\).
Derive el valor de \(\alpha^*\) para que \[y_i=\alpha^*+\beta x_i^*+\varepsilon_i\] produzca la misma media condicional.
Explique qué cantidad representa \(\alpha^*\).
¿Cambia la pendiente?
En un modelo bayesiano, explique por qué asignar independientemente \[\alpha\sim\mathcal N(0,10^2)\] y \[\alpha^*\sim\mathcal N(0,10^2)\] no garantiza modelos completamente equivalentes.
3.22.1.2 Ejercicio 2. Descomposición dentro–entre
Para tres grupos se observan los siguientes valores de \(x\):
Grupo A: \(2,4,6\);
Grupo B: \(8,10,12\);
Grupo C: \(14,16,18\).
Calcule \(\bar x_j\) para cada grupo.
Calcule \(x_{ij}-\bar x_j\).
Verifique que las desviaciones suman cero dentro de cada grupo.
Calcule la media global.
Verifique para cada observación que \[x_{ij}-\bar x_{\cdot\cdot}
=(x_{ij}-\bar x_j)+(\bar x_j-\bar x_{\cdot\cdot}).\]
Explique qué información desaparece si el modelo usa solamente \(x_{ij}-\bar x_j\).
3.22.1.3 Ejercicio 3. Interpretar \(\beta_W\), \(\beta_B\) y \(\delta\)
Suponga que una posterior produce aproximadamente
\[
\beta_W=1.5,
\qquad
\beta_B=4.0.
\]
Interprete \(\beta_W\).
Interprete \(\beta_B\).
Calcule \(\delta\).
Interprete \(\delta\) sin lenguaje causal.
Explique qué restricción impondría un modelo con una única pendiente \(\beta\) para \(x_{ij}\).
3.22.1.4 Ejercicio 4. Falacias de nivel
Para cada afirmación, indique si contiene una falacia ecológica, una falacia atomística o ninguna de las dos, y justifique.
“Las provincias con mayor ingreso medio tienen menor mortalidad; por tanto, una persona con mayor ingreso necesariamente tiene el mismo gradiente de mortalidad.”
“Dentro de empresas, trabajadores con más experiencia tienen mayor salario; por tanto, las empresas con fuerza laboral más experimentada deben tener exactamente la misma diferencia salarial promedio.”
“El modelo estima por separado una asociación dentro de hospitales y una asociación entre hospitales.”
“Los países con mayor consumo promedio de un alimento tienen mayor esperanza de vida, por lo que aumentar el consumo de una persona causará el mismo cambio.”
3.22.1.5 Ejercicio 5. ¿Dónde centrar?
Para cada situación, proponga una referencia y justifique si usaría centrado global, una referencia sustantiva, centrado por grupo o una descomposición dentro–entre.
Edad de pacientes agrupados en hospitales.
Tiempo desde el inicio del tratamiento en mediciones repetidas.
SES de estudiantes en escuelas cuando interesa el efecto de composición escolar.
Temperatura de parcelas agrupadas en fincas cuando cero grados tiene significado físico.
Indicador 0/1 de tratamiento administrado a personas dentro de clínicas.
3.22.2 Ejercicios computacionales
3.22.2.1 Ejercicio 6. Cuando \(\beta_W=\beta_B\)
Modifique la simulación del laboratorio para usar
\[
\beta_W=\beta_B=3.
\]
Simule un nuevo conjunto de datos.
Ajuste el modelo con una pendiente única y el modelo dentro–entre.
Compare las posteriores de \(\beta_W\) y \(\beta_B\).
Calcule la posterior de \(\delta\).
Compare las predicciones de ambos modelos.
Discuta si la mayor complejidad del modelo dentro–entre aporta algo importante en este escenario.
3.22.2.2 Ejercicio 7. Invertir la asociación entre niveles
Construya un proceso generador con
\[
\beta_W>0,
\qquad
\beta_B<0.
\]
Simule al menos 20 grupos.
Produzca un gráfico de relaciones dentro de grupos.
Produzca un gráfico de medias por grupo.
Ajuste el modelo dentro–entre.
Explique por qué una regresión que ignore los niveles puede ser difícil de interpretar.
Relacione el resultado con la falacia ecológica.
3.22.2.3 Ejercicio 8. Tamaño de grupo y precisión de la media grupal
Use un proceso generador fijo, pero compare dos diseños:
diseño A: \(n_j=5\) para todos los grupos;
diseño B: \(n_j=50\) para todos los grupos.
En ambos casos use el mismo número de grupos.
Calcule las medias observadas \(\bar x_j\).
Compare su error respecto de las medias verdaderas usadas en la simulación.
Ajuste el modelo dentro–entre.
Compare la incertidumbre posterior de \(\beta_B\).
Explique por qué tratar \(\bar x_j\) como predictor sin error puede ser más problemático en el diseño A.
3.22.2.4 Ejercicio 9. Extender la aplicación MathAchieve
Partiendo de fit_math:
cargue MathAchSchool con data("MathAchSchool", package = "nlme") y agregue Sector como predictor grupal mediante una unión por School;
centre o codifique el predictor de manera que el intercepto conserve una interpretación clara;
explique si Sector puede explicar variación dentro de escuelas;
compare las componentes de variación grupal antes y después de incorporarlo;
realice una comprobación predictiva por sector;
no use un único criterio escalar para declarar un modelo “ganador”; discuta qué nueva pregunta permite contestar el modelo extendido.
3.22.3 Ejercicio de interpretación de salida
Un modelo bayesiano produce el siguiente resumen hipotético:
Cantidad
Mediana posterior
Intervalo 90%
\(\beta_W\)
1.8
[1.2, 2.4]
\(\beta_B\)
5.1
[3.6, 6.8]
\(\delta=\beta_B-\beta_W\)
3.3
[1.6, 5.1]
\(\tau_\alpha\)
2.4
[1.4, 3.8]
\(\sigma\)
6.0
[5.7, 6.3]
Responda:
¿qué comparación representa \(\beta_W\)?
¿qué comparación representa \(\beta_B\)?
¿qué aporta \(\delta\) que no aporta cada coeficiente por separado?
¿puede concluirse que el contexto causa una diferencia de 3.3 unidades?
¿qué tipo de comprobación predictiva sería especialmente relevante para evaluar \(\beta_B\)?
¿por qué un gráfico global de densidades de \(y\) podría ser insuficiente?
3.23 Lecturas para profundizar
Para esta semana se recomienda priorizar:
Gelman y Hill, §4.2: centrado, elección del punto de referencia e interpretación de coeficientes, especialmente con interacciones (Gelman y Hill 2007, 55-57).
Gelman y Hill, §12.6: incorporación e interpretación de predictores grupales (Gelman y Hill 2007, 265-69).
Hox, Moerbeek y van de Schoot, §4.2: centrado global, centrado por grupo y separación dentro–entre (Hox et al. 2018, 46-52).
Como complemento:
Hox, Moerbeek y van de Schoot, §1.1: agregación, desagregación, falacia ecológica y falacia atomística (Hox et al. 2018, 2-4).
Gelman y Hill, §21.4: comparaciones predictivas como herramienta general de interpretación de modelos (Gelman y Hill 2007, 466-72).
Bürkner: estructura de parámetros poblacionales y grupales en brms y uso de Stan para inferencia bayesiana multinivel (Bürkner 2017, 2-5).
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.