simular_prior_jerarquico <- function(
n_draws,
sd_mu_alpha,
sd_mu_beta,
sd_tau_alpha,
sd_tau_beta,
sd_sigma,
eta_lkj,
semilla
) {
set.seed(semilla)
rho <- 2 * rbeta(n_draws, eta_lkj, eta_lkj) - 1
tibble(
draw = seq_len(n_draws),
mu_alpha = rnorm(n_draws, 0, sd_mu_alpha),
mu_beta = rnorm(n_draws, 0, sd_mu_beta),
tau_alpha = abs(rnorm(n_draws, 0, sd_tau_alpha)),
tau_beta = abs(rnorm(n_draws, 0, sd_tau_beta)),
sigma = abs(rnorm(n_draws, 0, sd_sigma)),
rho = rho,
z_alpha = rnorm(n_draws),
z_beta = rnorm(n_draws)
) |>
mutate(
alpha_nuevo = mu_alpha + tau_alpha * z_alpha,
beta_nuevo = mu_beta + tau_beta * (
rho * z_alpha + sqrt(1 - rho^2) * z_beta
)
) |>
select(-z_alpha, -z_beta)
}6 Semana 6. Previas y comprobación predictiva previa
SP-1653 Modelos Mixtos
6.1 Panorama de la semana
Durante las primeras cinco semanas construimos modelos multinivel cada vez más ricos. Partimos de datos agrupados y pooling parcial, incorporamos interceptos y pendientes variables, distinguimos asociaciones dentro y entre grupos y extendimos la estructura a factores anidados y cruzados. En todos esos modelos aparecieron distribuciones previas. Hasta ahora, sin embargo, las usamos principalmente para completar una formulación bayesiana y para estabilizar el ajuste. Esta semana cambia el foco: la especificación de previas se convierte en un objeto de análisis en sí mismo.
La pregunta orientadora es:
¿Cómo se especifican previas razonables para un modelo jerárquico y cómo comprobamos sus consecuencias antes de utilizar los datos para actualizarlo?
Una distribución previa no es un apéndice añadido después de escribir la verosimilitud. Forma parte del modelo generativo. En un modelo multinivel, además, no existe una única previa: hay previas para coeficientes poblacionales, parámetros de escala, correlaciones y, mediante la jerarquía, para los coeficientes específicos de los grupos. Las consecuencias de estas elecciones aparecen conjuntamente en la distribución de datos que el modelo considera posibles antes de observar la respuesta.
Bayesian Workflow organiza esta idea alrededor de dos principios que serán centrales en el capítulo. Primero, la escala y el propósito del parámetro deben guiar la especificación de la previa. Segundo, las implicaciones de un conjunto de previas se entienden mejor mediante simulación predictiva previa que inspeccionando aisladamente cada densidad (Gelman et al. 2026, secs. 5.6-5.10). El mismo libro dedica su capítulo 17 a mostrar este proceso en modelos de regresión lineal y multinivel, utilizando los datos sleepstudy como estudio de caso (Gelman et al. 2026, cap. 17).
Bayesian Data Analysis aporta una advertencia especialmente importante para modelos jerárquicos: cuando hay pocos grupos, una previa aparentemente no informativa para una desviación estándar grupal puede producir una posterior con colas poco plausibles y, por tanto, demasiado poco pooling. El ejemplo de tres escuelas de su sección 5.7 muestra cómo una previa débilmente informativa puede regularizar esa región sin imponer un valor preciso al parámetro (Gelman et al. 2013, 128-32).
McElreath conecta esta discusión con la idea de regularización: una previa puede restringir configuraciones extremas que producirían sobreajuste, y un modelo multinivel puede verse como una forma de regularización adaptativa porque parte de la intensidad de esa regularización se estima a partir de la población de grupos (McElreath 2020, 214-16, 401-15).
La secuencia de trabajo de esta semana será:
\[ \boxed{ \text{escala y conocimiento} \longrightarrow \text{previas} \longrightarrow \text{datos simulados} \longrightarrow \text{revisión} \longrightarrow \text{ajuste} } \]
Esta secuencia prepara directamente la semana 7. Allí estudiaremos HMC, divergencias y parametrización con más detalle. Aquí mencionaremos la relación entre regularización y computación solo cuando sea necesaria para comprender por qué una previa excesivamente amplia puede crear regiones difíciles de explorar.
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
- explicar por qué una distribución previa es parte del modelo generativo y no solamente una penalización computacional;
- distinguir previas informativas, débilmente informativas, regularizadoras, impropias y excesivamente difusas;
- derivar la distribución predictiva previa como una integral sobre los parámetros del modelo;
- explicar por qué una previa débilmente informativa debe definirse en relación con la escala del problema y no mediante una familia universal;
- relacionar el centrado y la estandarización de predictores con la interpretación y especificación de previas;
- especificar previas razonables para un intercepto y para coeficientes poblacionales a partir de unidades sustantivas;
- distinguir parámetros sin restricción de parámetros positivos y seleccionar familias apropiadas para desviaciones estándar;
- explicar por qué una previa excesivamente amplia para una desviación estándar jerárquica puede inducir poco pooling y predicciones implausibles;
- representar una matriz de covarianza como \(\Sigma=DRD\) y asignar previas separadas a escalas y correlaciones;
- explicar la función de \(\operatorname{LKJ}(\eta)\) y el efecto cualitativo de \(\eta\) sobre matrices de correlación;
- reconocer que previas marginalmente razonables pueden producir una distribución predictiva conjunta poco razonable;
- distinguir una comprobación predictiva previa de una comprobación predictiva posterior;
- diseñar estadísticas o gráficos predictivos previos que respondan a aspectos sustantivos del modelo multinivel;
- revisar una especificación previa cuando sus implicaciones predictivas sean absurdas sin utilizar los datos para “afinar” el resultado posterior deseado;
- realizar un análisis de sensibilidad con dos o más especificaciones previas sustantivamente defendibles;
- inspeccionar en
brmsqué clases de parámetros requieren previas medianteget_prior(); - especificar previas explícitas para
Intercept,b,sd,corysigmaenbrms; - simular desde la distribución predictiva previa con
sample_prior = "only"usandocmdstanrcomo backend; - comparar una especificación excesivamente amplia con una débilmente informativa mediante cantidades predictivas, no solo mediante densidades de parámetros;
- preparar para el proyecto del curso una tabla de parámetros, unidades, previas, justificación y comprobaciones predictivas previas.
6.2 Problema motivador: dos previas, un mismo modelo
Retomemos el modelo con interceptos y pendientes variables de la semana 4. Para una respuesta continua,
\[ y_{ij}\mid \alpha_j,\beta_j,\sigma \sim \mathcal N(\alpha_j+\beta_jx_{ij},\sigma^2), \]
con
\[ \begin{pmatrix} \alpha_j\\ \beta_j \end{pmatrix} \sim \mathcal N_2\!\left( \begin{pmatrix} \mu_\alpha\\ \mu_\beta \end{pmatrix}, \Sigma \right), \]
\[ \Sigma = D R D, \qquad D= \begin{pmatrix} \tau_\alpha&0\\ 0&\tau_\beta \end{pmatrix}. \]
El modelo describe la estructura probabilística, pero todavía no está completamente especificado. Necesitamos distribuciones para
\[ \mu_\alpha, \quad \mu_\beta, \quad \tau_\alpha, \quad \tau_\beta, \quad R, \quad \sigma. \]
Considere dos propuestas hipotéticas para una respuesta estandarizada y un predictor aproximadamente en el intervalo \([-2,2]\).
Propuesta A: extremadamente amplia
\[ \mu_\alpha\sim\mathcal N(0,10^2), \qquad \mu_\beta\sim\mathcal N(0,10^2), \]
\[ \tau_\alpha,\tau_\beta,\sigma \sim \operatorname{HalfNormal}(0,10^2), \]
\[ R\sim \operatorname{LKJ}(1). \]
Propuesta B: débilmente informativa en la escala estandarizada
\[ \mu_\alpha\sim\mathcal N(0,1^2), \qquad \mu_\beta\sim\mathcal N(0,0.7^2), \]
\[ \tau_\alpha\sim\operatorname{HalfNormal}(0,0.8^2), \qquad \tau_\beta\sim\operatorname{HalfNormal}(0,0.5^2), \]
\[ \sigma\sim\operatorname{HalfNormal}(0,1^2), \qquad R\sim\operatorname{LKJ}(2). \]
Las dos propuestas parecen “permitir muchos valores”. Pero esa descripción es demasiado vaga. La pregunta útil es otra:
¿Qué respuestas, diferencias entre grupos y familias de rectas produce cada especificación antes de observar los datos?
La propuesta A puede generar interceptos, pendientes y desviaciones estándar que son enormes en una escala donde la respuesta tiene orden de magnitud uno. La propuesta B también deja una región amplia de posibilidades, pero declara poco plausibles configuraciones que producirían respuestas de decenas de desviaciones estándar.
ImportanteUna previa se juzga en la escala de sus consecuencias
La etiqueta “débil” no depende solo de que una desviación estándar numérica sea grande. Una Normal(0, 10) puede ser extremadamente restrictiva para un coeficiente medido en miles de unidades y absurdamente difusa para un coeficiente en escala logit o para una respuesta estandarizada.
La pregunta no es “¿esta previa es ancha?”, sino “¿qué magnitudes del fenómeno considera plausibles?”.
6.3 La distribución previa dentro del modelo generativo
Sea \(\theta\) el conjunto de todos los parámetros del modelo. En forma compacta,
\[ y\mid\theta\sim p(y\mid\theta), \]
\[ \theta\sim p(\theta). \]
La distribución conjunta antes de observar los datos es
\[ p(y,\theta)=p(y\mid\theta)p(\theta). \]
La distribución predictiva previa para una réplica \(\tilde y\) se obtiene marginalizando los parámetros:
\[ p(\tilde y) = \int p(\tilde y\mid\theta)p(\theta)\,d\theta. \tag{6.1}\]
En un modelo multinivel, \(\theta\) puede contener cientos o miles de coeficientes específicos de grupo, pero la lógica no cambia. Si distinguimos parámetros poblacionales \(\phi\) y coeficientes grupales \(b\),
\[ p(\tilde y) = \iint p(\tilde y\mid b,\phi) \,p(b\mid\phi) \,p(\phi) \,db\,d\phi. \]
La simulación correspondiente tiene una secuencia clara:
- simular hiperparámetros y parámetros poblacionales \(\phi\) desde sus previas;
- simular coeficientes grupales \(b\) desde su distribución poblacional condicional;
- simular respuestas \(\tilde y\) desde el modelo de datos;
- repetir muchas veces y resumir las propiedades de las réplicas.
Bayesian Workflow enfatiza que una formulación probabilística completa del proceso de datos es necesaria para realizar simulación predictiva y comprobación del modelo. Especificar únicamente una función de verosimilitud puede ser suficiente para algunas tareas inferenciales, pero no necesariamente para simular réplicas completas de los datos bajo los supuestos del modelo (Gelman et al. 2026, sec. 5.5)..
6.3.1 La previa no es la posterior sin datos
Después de observar \(y\), la distribución posterior es
\[ p(\theta\mid y) \propto p(y\mid\theta)p(\theta). \]
La previa y la posterior desempeñan papeles distintos. La primera expresa restricciones y posibilidades antes de utilizar la información de la respuesta observada; la segunda combina esas restricciones con la información aportada por los datos bajo el modelo.
Por ello una comprobación predictiva previa pregunta:
¿Qué tipo de datos puede producir el modelo antes de condicionar en la respuesta observada?
Una comprobación predictiva posterior pregunta:
Después del ajuste, ¿qué tipo de réplicas produce el modelo condicionado en los datos observados?
Ambas son útiles, pero diagnostican cosas distintas. La primera se concentra en especificación; la segunda, que estudiaremos de forma más amplia en la semana 13, se concentra en la adecuación del modelo ajustado.
6.4 ¿Qué significa “débilmente informativa”?
No existe una frontera matemática única entre una previa “informativa” y una “débilmente informativa”. La distinción es contextual.
Una previa informativa intenta representar conocimiento relativamente específico sobre un parámetro. Una previa débilmente informativa suele perseguir un objetivo más modesto: excluir regiones que son claramente incompatibles con el problema, manteniendo una zona amplia de valores plausibles. Una previa regularizadora reduce la probabilidad de configuraciones extremas que podrían conducir a sobreajuste o inestabilidad. Estas categorías se traslapan.
Bayesian Workflow presenta las previas débilmente informativas como restricciones suaves que descartan regiones irrazonables sin pretender describir con alta precisión el conocimiento experto (Gelman et al. 2026, sec. 5.6). McElreath enfatiza su conexión con regularización y muestra cómo una previa demasiado estrecha también puede producir subajuste (McElreath 2020, 214-16).
NotaRegularizar no significa obligar a cero
Una previa centrada en cero para un coeficiente puede regularizar magnitudes grandes sin afirmar que el coeficiente es exactamente cero. Del mismo modo, una previa concentrada cerca de valores pequeños para una desviación estándar grupal permite heterogeneidad; simplemente exige más información para sostener heterogeneidad extrema.
6.4.1 Previas impropias y simulación predictiva previa
Una densidad impropia, por ejemplo una distribución “uniforme” sobre toda la recta real, no integra a uno. En algunos problemas puede utilizarse para obtener una distribución posterior propia, pero no constituye por sí misma una distribución de probabilidad válida sobre el parámetro.
Esto tiene una consecuencia directa para la simulación predictiva previa: para simular parámetros y, a partir de ellos, posibles conjuntos de datos antes de observar la respuesta, necesitamos distribuciones previas propias para los parámetros que participan en la simulación. Bayesian Workflow señala que una previa impropia impide definir una distribución conjunta propia para parámetros y datos y, por tanto, no permite obtener una distribución predictiva previa completa (Gelman et al. 2026, sec. 5.5).
6.5 El problema de “hacer la previa muy ancha”
Una estrategia común consiste en intentar “no influir” usando escalas enormes. Esa estrategia puede fallar por razones sustantivas, estadísticas y computacionales.
6.5.1 Consecuencias sustantivas
Si una respuesta representa una calificación de 0 a 100, una previa que asigna probabilidad apreciable a medias de \(\pm 10^6\) no es neutral: afirma que resultados físicamente imposibles o conceptualmente absurdos son plausibles antes de ver los datos.
6.5.2 Consecuencias jerárquicas
En un modelo de interceptos variables,
\[ \alpha_j\sim\mathcal N(\mu_\alpha,\tau_\alpha^2), \]
una previa que permite con facilidad valores gigantes de \(\tau_\alpha\) permite también que los grupos sean casi independientes entre sí. Esto afecta directamente la intensidad del pooling.
Bayesian Data Analysis ilustra este punto con tres escuelas. Con muy pocos grupos, una previa uniforme extremadamente débil sobre \(\tau\) produce una posterior con una cola derecha irrazonablemente larga; una half-Cauchy con escala elegida a partir de la magnitud plausible de los efectos reduce esa cola sin distorsionar la región de alta verosimilitud (Gelman et al. 2013, 128-32).
La lección del ejemplo no es “use half-Cauchy siempre”. La lección es:
\[ \boxed{ \text{si los datos informan poco sobre una escala jerárquica, la previa puede ser decisiva.} } \]
6.5.3 Consecuencias computacionales
Las previas muy anchas pueden colocar masa en regiones de geometría posterior difícil. La semana 7 estudiará este fenómeno con más profundidad. Por ahora basta con distinguir dos preguntas:
- ¿la previa permite configuraciones sustantivamente absurdas?;
- ¿la parametrización y la geometría resultante dificultan el muestreo?
Una misma modificación de la previa puede ayudar en ambos sentidos, pero un problema computacional no debe confundirse con un problema de identificación sustantiva.
6.6 La escala viene antes que la familia
Antes de elegir entre normal, Student-\(t\), exponencial o cualquier otra familia, debemos conocer qué significa una unidad del parámetro.
Considere
\[ y_i\sim\mathcal N(\alpha+\beta x_i,\sigma^2). \]
El intercepto \(\alpha\) representa la respuesta esperada cuando \(x=0\). La pendiente \(\beta\) tiene unidades
\[ \frac{\text{unidades de }y}{\text{unidad de }x}. \]
La desviación estándar residual \(\sigma\) está en las mismas unidades de \(y\).
6.6.1 El intercepto depende del punto de referencia
Si \(x=0\) no tiene interpretación sustantiva, especificar una previa para \(\alpha\) puede ser difícil. Si centramos
\[ x_i^c=x_i-c, \]
entonces
\[ y_i = \alpha_c+\beta x_i^c+\varepsilon_i, \]
con
\[ \alpha_c=\alpha+\beta c. \]
Ahora la previa de \(\alpha_c\) se refiere a la respuesta esperada en \(x=c\). Esta es una de las razones por las que el centrado de la semana 3 no fue una operación mecánica: cambia la cantidad a la que asignamos una previa directa.
6.6.2 Reescalar un predictor cambia la pendiente
Si definimos
\[ x_i^*=\frac{x_i-c}{s_x}, \]
entonces
\[ y_i=\alpha^*+\beta^*x_i^*+\varepsilon_i, \]
con
\[ \beta^*=s_x\beta. \]
Una Normal(0, 1) para \(\beta^*\) no tiene el mismo contenido que una Normal(0, 1) para \(\beta\). El valor numérico de la escala de la previa solo puede interpretarse junto con las unidades del predictor.
ImportanteEstandarizar ayuda, pero no elimina la justificación
Con respuestas y predictores estandarizados es más sencillo construir previas de orden uno. Sin embargo, “usar Normal(0,1)” no se convierte por ello en una regla universal. La plausibilidad depende todavía del tipo de respuesta, del rango relevante del predictor y de las transformaciones usadas por el modelo.
6.7 Previas para coeficientes poblacionales
6.7.1 Interceptos
Para un intercepto \(\alpha\), una estrategia útil es traducir una afirmación predictiva a una distribución. Si, por ejemplo, en el punto de referencia del predictor consideramos que la media de una respuesta continua probablemente se encuentra alrededor de 70 y que valores por debajo de 30 o por encima de 110 serían sorprendentes, una posibilidad pedagógica es
\[ \alpha\sim\mathcal N(70,20^2). \]
Esta especificación no es correcta por ser normal. Es defendible solo si el rango que induce coincide razonablemente con el conocimiento sustantivo y con la escala de medición.
6.7.2 Pendientes
Para una pendiente, conviene preguntar cuánto puede cambiar la respuesta cuando el predictor se mueve una cantidad interpretable.
Si \(x\) está medido en días y consideramos poco plausible un cambio medio mayor que 40 milisegundos por día, una previa
\[ \beta\sim\mathcal N(0,20^2) \]
coloca aproximadamente 95% de su masa entre \(-40\) y \(40\) milisegundos por día. Este es el razonamiento utilizado en el estudio de privación de sueño de Bayesian Workflow (Gelman et al. 2026, sec. 17.1).
La elección de centrar la previa en cero también requiere interpretación. Puede expresar que, antes de ver la respuesta, efectos pequeños son más plausibles que efectos enormes. No implica que la hipótesis científica sea “el efecto es cero”.
6.7.3 Cuando la dirección está conocida
A veces el conocimiento sustantivo permite restringir el signo de un efecto. Sin embargo, la decisión depende del propósito. Bayesian Workflow observa que, si el objetivo es una predicción o decisión que debe incorporar toda la información disponible, una restricción direccional puede ser apropiada; si el objetivo es mostrar qué aporta el conjunto de datos sobre la dirección, puede ser útil evitar codificar esa conclusión de forma demasiado fuerte en la previa (Gelman et al. 2026, sec. 17.1).
No hay una regla única: debe declararse qué conocimiento se incorpora y para qué se utilizará el modelo.
6.8 Previas para parámetros de escala
En modelos gaussianos aparecen varias cantidades positivas:
\[ \sigma>0, \qquad \tau_\alpha>0, \qquad \tau_\beta>0. \]
No tiene sentido asignarles una distribución que trate valores negativos como desviaciones estándar posibles. Entre las familias que pueden ser útiles, según el contexto, están la half-Normal, la half-\(t\) y la exponencial.
6.8.1 Half-Normal
Si
\[ Z\sim\mathcal N(0,s^2), \]
entonces
\[ \tau=|Z| \]
sigue una half-Normal con escala \(s\). La densidad se concentra cerca de cero y decrece con rapidez. Esto puede ser apropiado cuando heterogeneidades pequeñas son plausibles y magnitudes muy grandes deberían recibir poca masa.
6.8.2 Half-Student-\(t\)
Una half-\(t\) tiene colas más pesadas que una half-Normal. Puede reservar más probabilidad para desviaciones estándar grandes sin usar una escala gigantesca. La half-Cauchy es el caso particular con un grado de libertad; BDA3 la utiliza en su ejemplo de tres escuelas como previa débilmente informativa contextual (Gelman et al. 2013, sec. 5.7).
6.8.3 Exponencial
Una exponencial
\[ \tau\sim\operatorname{Exponential}(\lambda) \]
tiene media \(1/\lambda\) y decrece monótonamente desde cero. Bayesian Workflow la utiliza repetidamente para parámetros de escala en su estudio de sleepstudy, precisamente porque permite expresar una magnitud típica sin introducir colas tan extremas como algunas alternativas (Gelman et al. 2026, secs. 17.1-17.2).
NotaLa familia no determina por sí sola la regularización
Una Exponential(0.001) tiene media 1000 y puede ser mucho más difusa que una half-\(t\) con una escala pequeña. El parámetro de escala o tasa debe justificarse en las unidades del problema.
6.8.4 ¿Debe excluirse exactamente cero?
Las distribuciones continuas sobre \([0,\infty)\) asignan probabilidad cero al punto exacto \(\tau=0\), aunque su densidad pueda ser máxima cerca de cero. Esto no impide representar una heterogeneidad prácticamente nula.
Si la pregunta científica requiere una probabilidad explícita de “varianza exactamente cero”, se necesita otro tipo de modelo, por ejemplo una mezcla con masa puntual. Esa no será nuestra estrategia en este curso: describiremos la incertidumbre sobre la magnitud de \(\tau\) y sus consecuencias predictivas.
6.9 Previas para matrices de covarianza y correlación
Con interceptos y pendientes variables,
\[ \Sigma = \begin{pmatrix} \tau_\alpha^2 & \rho\tau_\alpha\tau_\beta\\ \rho\tau_\alpha\tau_\beta & \tau_\beta^2 \end{pmatrix}. \]
La factorización
\[ \Sigma=DRD \]
separa dos problemas:
- las magnitudes de la heterogeneidad, contenidas en \(D\);
- la dependencia entre coeficientes, contenida en \(R\).
Bürkner describe esta misma parametrización para los coeficientes grupales de brms, con previas separadas para desviaciones estándar y matrices de correlación (Bürkner 2017, 3-4). Bayesian Workflow adopta la misma separación porque facilita la interpretación y la especificación (Gelman et al. 2026, sec. 5.6).
6.9.1 La previa LKJ
Para una matriz de correlación \(R\) de dimensión \(K\), la familia LKJ puede escribirse de forma proporcional como
\[ p(R\mid\eta) \propto \det(R)^{\eta-1}, \qquad \eta>0, \]
sobre el espacio de matrices de correlación definidas positivas.
En términos cualitativos:
- \(\eta=1\) es uniforme sobre el espacio de matrices de correlación válidas;
- \(\eta>1\) concentra progresivamente más masa cerca de la matriz identidad;
- \(0<\eta<1\) favorece configuraciones más cercanas a los bordes del espacio.
Para una matriz \(2\times2\),
\[ R= \begin{pmatrix} 1&\rho\\ \rho&1 \end{pmatrix}, \]
y
\[ \det(R)=1-\rho^2. \]
Por tanto,
\[ p(\rho\mid\eta) \propto (1-\rho^2)^{\eta-1}, \qquad -1<\rho<1. \tag{6.2}\]
En el caso de una matriz de correlación de dimensión \(2\times2\), el único parámetro de correlación es \(\rho\). Por ello, cuando \(\eta = 1\), la distribución LKJ induce una distribución uniforme para \(\rho\) en el intervalo \((-1,1)\).
La situación cambia en matrices de mayor dimensión. Las distintas correlaciones no pueden tomar valores arbitrarios de manera independiente, porque en conjunto deben formar una matriz de correlación definida positiva. Esta restricción conjunta modifica las distribuciones marginales de cada correlación. En consecuencia, aunque \(\eta = 1\) corresponde a una distribución uniforme sobre el espacio de matrices de correlación admisibles, cada correlación individual ya no tiene necesariamente una distribución uniforme en \((-1,1)\) (Gelman et al. 2026, 84-85, 282-83).
McElreath utiliza \(\operatorname{LKJ}(2)\) como una previa regularizadora que reduce la plausibilidad de correlaciones cercanas a \(-1\) o \(1\) en un modelo de pendientes variables (McElreath 2020, 442-43).
AdvertenciaLKJ no significa correlaciones independientes
En una matriz grande no podemos asignar una previa independiente a cada correlación y esperar que la matriz resultante sea siempre válida. La condición de definición positiva impone restricciones conjuntas. LKJ define una distribución sobre matrices completas válidas, no una colección de densidades univariadas independientes.
6.10 Las previas deben entenderse conjuntamente
Supongamos una regresión con muchos coeficientes,
\[ \eta_i = \alpha+ \sum_{k=1}^K \beta_k x_{ik}, \]
y previas independientes
\[ \beta_k\sim\mathcal N(0,s^2). \]
Aunque cada \(\beta_k\) parezca moderadamente regularizado, la variación del predictor lineal puede crecer al aumentar \(K\). Bajo una simplificación en la que los \(x_{ik}\) son fijos,
\[ \operatorname{Var}(\eta_i\mid x_i) = \sum_{k=1}^K x_{ik}^2s^2 \]
si los coeficientes son independientes y tienen la misma varianza previa.
Por tanto, previas marginales razonables no garantizan predicciones conjuntas razonables. Bayesian Workflow muestra este fenómeno y advierte que previas individualmente débiles pueden combinarse para inducir una previa fuerte o extraña sobre cantidades predictivas, especialmente en modelos de alta dimensión (Gelman et al. 2026, sec. 8.5, cap. 17).
En un modelo multinivel ocurre algo adicional: \(\tau_\alpha\), \(\tau_\beta\) y \(R\) se combinan para producir una población de rectas. Ninguno de esos parámetros debe evaluarse solo.
6.11 Comprobación predictiva previa
La comprobación predictiva previa consiste en estudiar realizaciones de Ecuación 6.1 y preguntar si representan escenarios que el modelo debería considerar posibles antes de usar la respuesta observada para actualizar los parámetros.
Bayesian Workflow la define como una forma de evaluar las implicaciones pre-datos de un modelo generativo (Gelman et al. 2026, sec. 5.9). La simulación es especialmente útil porque la interacción entre distribuciones previas y modelo de datos puede ser difícil de anticipar analíticamente.
6.11.1 No buscamos que los datos simulados se parezcan exactamente a los observados
Una comprobación predictiva previa no es una prueba de ajuste. Si obligamos a que las simulaciones previas reproduzcan estrechamente los datos observados, corremos el riesgo de utilizar los datos dos veces: primero para diseñar la previa y luego para construir la posterior.
La comparación adecuada se hace con conocimiento que podría haberse expresado antes de observar la respuesta específica:
- límites físicos o administrativos;
- órdenes de magnitud;
- rangos históricamente plausibles;
- signos o direcciones conocidas;
- variación típica entre individuos o grupos;
- formas cualitativas imposibles o absurdas.
Cuando trabajamos con un conjunto de datos conocido en clase, podemos reconstruir este proceso ocultando deliberadamente los resúmenes de la respuesta hasta terminar la especificación previa.
6.11.2 Qué mirar en un modelo multinivel
Una única densidad marginal de \(\tilde y\) puede ocultar problemas. Conviene diseñar comprobaciones sensibles a la estructura del modelo.
Para un modelo de interceptos y pendientes variables, podemos revisar:
- el rango global de respuestas simuladas;
- la media y desviación estándar global;
- la dispersión de medias entre grupos;
- la dispersión dentro de los grupos;
- la diferencia entre el grupo con mayor y menor media;
- la distribución de pendientes específicas de grupo;
- familias completas de líneas \(\alpha_j+\beta_jx\);
- la frecuencia de trayectorias con magnitudes o signos imposibles;
- la diferencia entre predicciones para grupos existentes y grupos nuevos;
- cantidades derivadas directamente ligadas a la pregunta sustantiva.
TipComprobar la estructura, no solo la respuesta marginal
Si el modelo contiene una desviación estándar entre grupos, una comprobación previa debería mirar alguna cantidad que dependa de la variación entre grupos. Si contiene pendientes variables, debería mirar familias de trayectorias o dispersión de pendientes. Una densidad global de \(y\) puede ser insuficiente.
6.12 Revisar previas mediante iteración
Una primera especificación previa rara vez es definitiva. El flujo razonable es iterativo:
- proponer previas a partir de escala, conocimiento y propósito;
- simular parámetros y datos;
- identificar implicaciones implausibles o restricciones excesivas;
- modificar una o más previas con una justificación explícita;
- repetir la simulación;
- documentar la especificación elegida y alternativas relevantes.
Cambiar una previa porque produce demasiadas respuestas imposibles es una corrección del modelo. Cambiarla porque “la posterior no dio el efecto que queríamos” es una práctica distinta y problemática.
6.12.1 Sensibilidad previa
Incluso después de elegir una especificación razonable, algunos parámetros pueden estar débilmente informados por los datos. Conviene entonces comparar varias previas defendibles.
Sea \(p_1(\theta)\) la previa principal y \(p_2(\theta)\) una alternativa plausible. Ajustamos
\[ p_1(\theta\mid y) \propto p(y\mid\theta)p_1(\theta), \]
y
\[ p_2(\theta\mid y) \propto p(y\mid\theta)p_2(\theta). \]
Si las conclusiones sustantivas cambian de manera importante, esa sensibilidad es parte del resultado y no un defecto que deba ocultarse. Puede indicar que la información de los datos es limitada para esa cantidad.
6.13 Prior, verosimilitud y cantidad de información
La influencia de una previa no es una propiedad fija de la distribución. Depende también de la información de los datos y de la complejidad del modelo.
Una Normal(0, 1) puede dominar un problema con cinco grupos y observaciones ruidosas, y ser casi irrelevante para un coeficiente estimado con cientos de miles de observaciones informativas. McElreath muestra este patrón al discutir regularización: con más datos, una misma previa moderada suele tener menos efecto sobre la posterior (McElreath 2020, 214-16).
En un modelo multinivel, diferentes parámetros pueden encontrarse en situaciones muy distintas:
- \(\mu_\alpha\) puede estar bien identificado por muchos datos;
- \(\tau_\beta\) puede estar débilmente identificado porque hay poca variación del predictor dentro de cada grupo;
- \(\rho\) puede estar débilmente identificado porque existen pocos grupos;
- \(\sigma\) puede estar muy bien estimado por replicación abundante dentro de grupo.
Por eso no basta con afirmar que “el conjunto de datos es grande”. La cantidad relevante de información depende del parámetro.
6.14 Implementación de previas en brms
En brms, la fórmula determina qué parámetros aparecen en el modelo y get_prior() permite inspeccionar las clases a las que podemos asignar distribuciones previas. Bürkner documenta esta separación entre parámetros poblacionales, desviaciones estándar grupales y matrices de correlación y recomienda inspeccionar las clases disponibles antes de fijar previas (Bürkner 2017, 8-10).
Considere
Reaction ~ 1 + Days + (1 + Days | Subject)En este modelo aparecen, entre otras, las clases:
Intercept: intercepto poblacional;b: coeficientes poblacionales distintos del intercepto;sd: desviaciones estándar de coeficientes variables;cor: matriz de correlación de coeficientes variables del mismo factor de agrupamiento;sigma: desviación estándar residual gaussiana.
La sintaxis exacta de las previas predeterminadas puede cambiar entre versiones de brms. Por esa razón, no vamos a memorizar valores predeterminados. Los inspeccionaremos programáticamente y sustituiremos los parámetros sustantivamente importantes por previas explícitas.
AdvertenciaEl artículo de
brms de 2017 no documenta necesariamente los valores predeterminados actuales
Bürkner (2017) es una referencia importante para la estructura del paquete y su parametrización, pero los valores predeterminados han evolucionado. En el laboratorio usaremos get_prior() sobre la versión instalada y no atribuiremos sus valores actuales al artículo original.
6.14.1 Especificación explícita
Una especificación puede escribirse, por ejemplo, como
priors <- c(
  prior(normal(250, 100), class = "Intercept"),
  prior(normal(0, 20), class = "b", coef = "Days"),
  prior(exponential(0.02), class = "sd", group = "Subject", coef = "Intercept"),
  prior(exponential(0.05), class = "sd", group = "Subject", coef = "Days"),
  prior(lkj(2), class = "cor", group = "Subject"),
  prior(exponential(0.02), class = "sigma")
)
Esta elección sigue la escala del estudio sleepstudy presentada por Bayesian Workflow, con una modificación deliberada: usamos LKJ(2) en lugar de una distribución uniforme sobre la correlación para expresar una regularización moderada de correlaciones extremas (Gelman et al. 2026, 280-83).
6.14.2 Muestreo únicamente desde la previa
Con
sample_prior = "only"brms ejecuta el modelo sin utilizar la respuesta para actualizar los parámetros y produce muestras de la distribución previa y de la predictiva previa. Seguiremos usando explícitamente
backend = "cmdstanr"para mantener la convención de las semanas anteriores.
El objeto ajustado puede pasarse a posterior_predict() para simular respuestas. En esta etapa esas respuestas son predictivas previas, no posteriores.
6.15 Laboratorio reproducible en R
El laboratorio tendrá dos partes.
- Experimento simulado en escala estandarizada. Compararemos una especificación excesivamente amplia con una débilmente informativa y observaremos sus consecuencias sobre familias de rectas y respuestas.
- Aplicación
sleepstudy. Inspeccionaremos las clases de previas debrms, ajustaremos el modelo únicamente a la previa, revisaremos predicciones y solo después incorporaremos la respuesta observada.
6.15.1 Experimento 1: consecuencias predictivas de dos especificaciones
Trabajaremos con un predictor \(x\) aproximadamente estandarizado en \([-2,2]\) y una respuesta también en una escala de orden uno. No simularemos primero un conjunto de datos observado. Nuestro objetivo inicial es estudiar qué mundos considera posibles cada conjunto de previas.
6.15.1.1 Función de simulación generativa
Para una matriz \(2\times2\), podemos simular la correlación LKJ usando el hecho de que
\[ \frac{\rho+1}{2}\sim\operatorname{Beta}(\eta,\eta). \]
Esta relación es específica de la dimensión dos y se obtiene de Ecuación 6.2. Luego construimos dos coeficientes grupales correlacionados mediante variables normales estándar.
La construcción
\[ \beta_j = \mu_\beta+ au_\beta \left( \rho z_{0j} +\sqrt{1-\rho^2}\,z_{1j} \right) \]
junto con
\[ \alpha_j=\mu_\alpha+\tau_\alpha z_{0j} \]
produce
\[ \operatorname{Cor}(\alpha_j,\beta_j)=\rho. \]
6.15.1.2 Simular las dos propuestas
n_prior <- 6000L

prior_amplia_s6 <- simular_prior_jerarquico(
  n_draws = n_prior,
  sd_mu_alpha = 10,
  sd_mu_beta = 10,
  sd_tau_alpha = 10,
  sd_tau_beta = 10,
  sd_sigma = 10,
  eta_lkj = 1,
  semilla = 1653061
) |>
  mutate(especificacion = "Excesivamente amplia")

prior_regular_s6 <- simular_prior_jerarquico(
  n_draws = n_prior,
  sd_mu_alpha = 1,
  sd_mu_beta = 0.7,
  sd_tau_alpha = 0.8,
  sd_tau_beta = 0.5,
  sd_sigma = 1,
  eta_lkj = 2,
  semilla = 1653062
) |>
  mutate(especificacion = "Débilmente informativa")

prior_s6 <- bind_rows(
  prior_amplia_s6,
  prior_regular_s6
)
Antes de generar respuestas, comparemos parámetros de escala.
prior_s6 |>
  group_by(especificacion) |>
  summarise(
    q50_tau_alpha = median(tau_alpha),
    q95_tau_alpha = quantile(tau_alpha, 0.95),
    q50_tau_beta = median(tau_beta),
    q95_tau_beta = quantile(tau_beta, 0.95),
    q50_sigma = median(sigma),
    q95_sigma = quantile(sigma, 0.95),
    .groups = "drop"
  )
# A tibble: 2 × 7
especificacion q50_tau_alpha q95_tau_alpha q50_tau_beta q95_tau_beta q50_sigma
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Débilmente in… 0.544 1.59 0.343 0.983 0.665
2 Excesivamente… 6.84 19.2 6.72 19.2 6.83
# ℹ 1 more variable: q95_sigma <dbl>Los números son informativos, pero todavía no responden la pregunta principal: ¿qué datos producen?
6.15.1.3 Familias de rectas para grupos nuevos
Para cada muestra previa consideramos un grupo nuevo y calculamos
\[ \mu_j(x)=\alpha_j+\beta_jx. \]
x_grid_s6 <- seq(-2, 2, length.out = 81)

lineas_prior_s6 <- prior_s6 |>
  group_by(especificacion) |>
  slice_sample(n = 120) |>
  ungroup() |>
  select(draw, especificacion, alpha_nuevo, beta_nuevo) |>
  crossing(x = x_grid_s6) |>
  mutate(
    mu = alpha_nuevo + beta_nuevo * x
  )
lineas_prior_s6 |>
ggplot(aes(x = x, y = mu, group = interaction(especificacion, draw))) +
geom_line(alpha = 0.12) +
facet_wrap(~ especificacion, scales = "free_y") +
labs(
x = "Predictor estandarizado x",
y = "Media condicional simulada"
) +
theme_minimal(base_size = 12)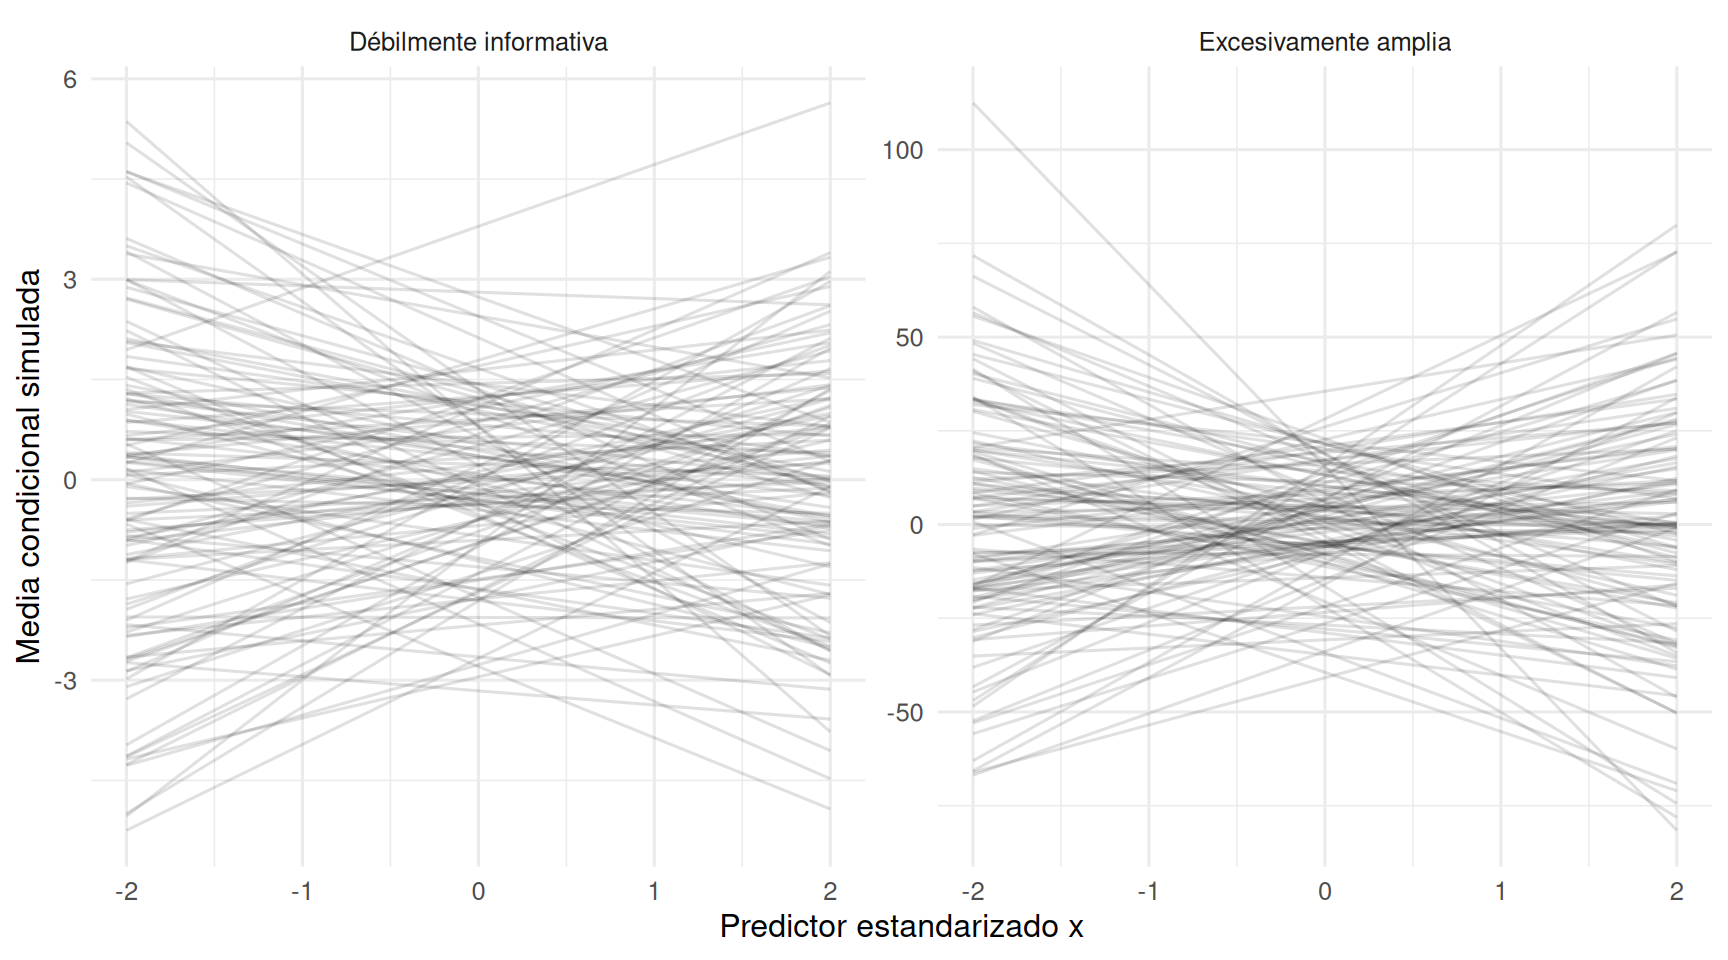
El uso de escalas verticales independientes permite ver la geometría de cada conjunto de rectas. Para comparar magnitudes debemos usar la misma escala.
lineas_prior_s6 |>
  ggplot(aes(x = x, y = mu, group = interaction(especificacion, draw))) +
  geom_line(alpha = 0.10) +
  facet_wrap(~ especificacion) +
  coord_cartesian(ylim = c(-30, 30)) +
  labs(
    x = "Predictor estandarizado x",
    y = "Media condicional simulada"
  ) +
  theme_minimal(base_size = 12)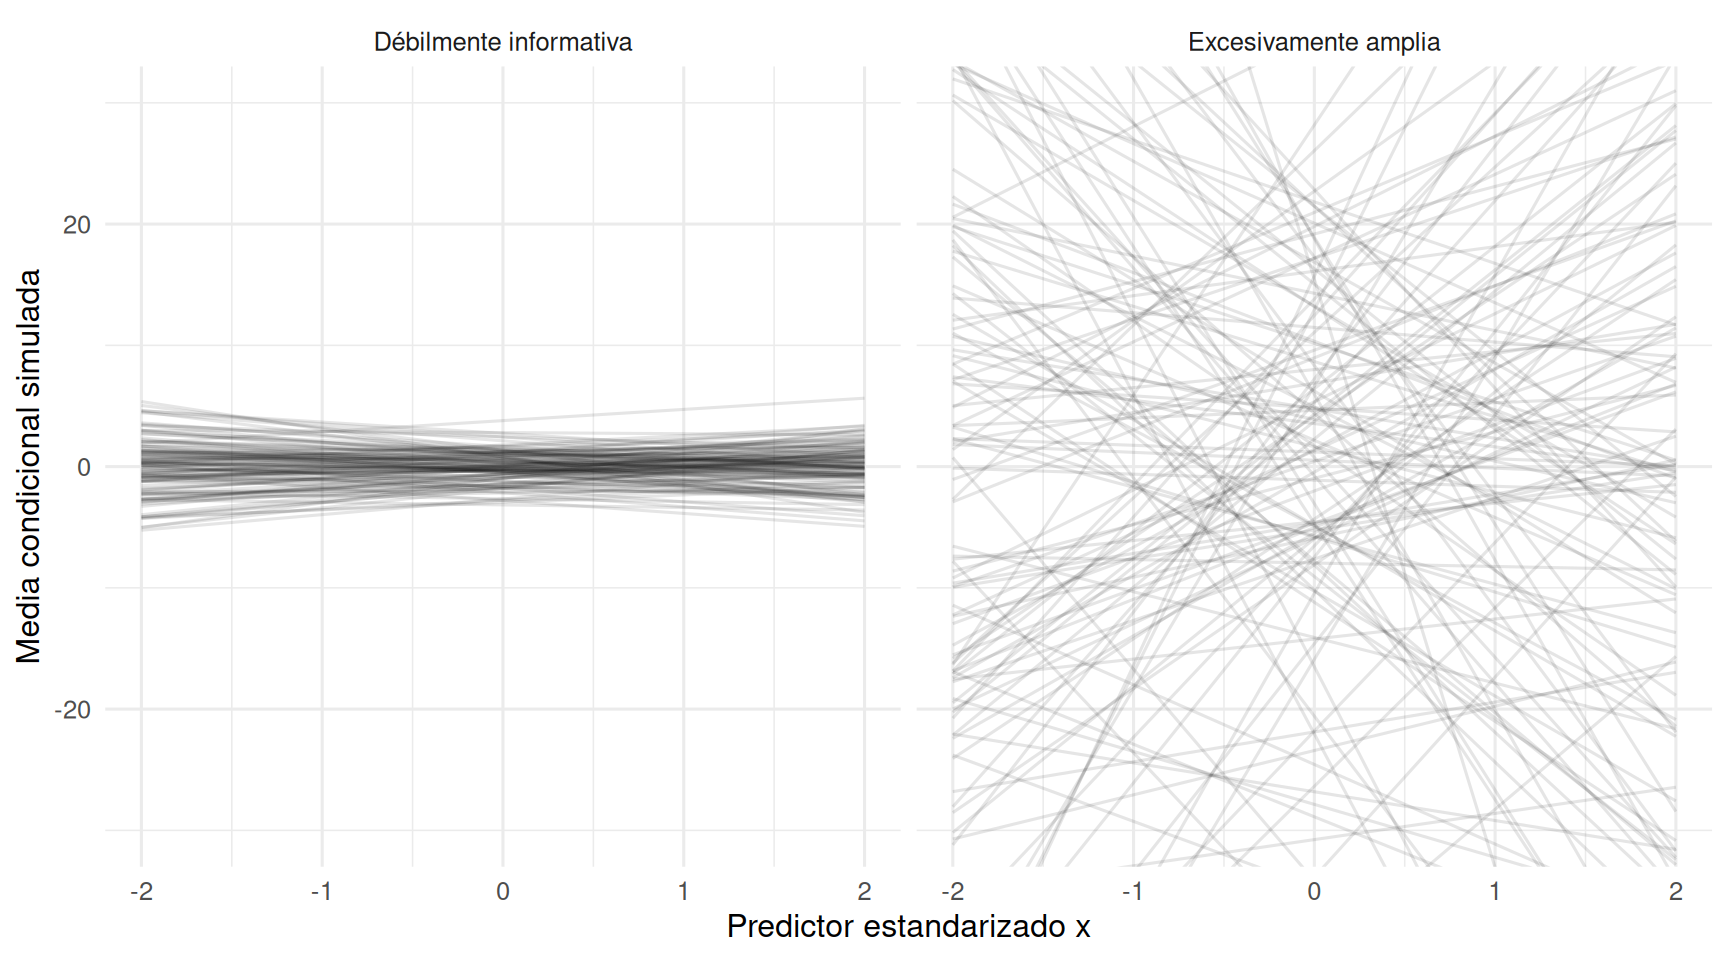
El recorte del eje es deliberado: muchas trayectorias de la especificación amplia quedan fuera de la ventana. Eso mismo es una señal de que “ancha” no equivale a “inocua”.
6.15.1.4 Distribución predictiva previa de la respuesta
Simularemos una respuesta para tres valores del predictor: \(-2\), \(0\) y \(2\).
set.seed(1653063)

prior_pred_s6 <- prior_s6 |>
  select(
    draw,
    especificacion,
    alpha_nuevo,
    beta_nuevo,
    sigma
  ) |>
  crossing(x = c(-2, 0, 2)) |>
  mutate(
    mu = alpha_nuevo + beta_nuevo * x,
    y_rep = rnorm(n(), mu, sigma)
  )

prior_pred_s6 |>
  group_by(especificacion, x) |>
  summarise(
    q01 = quantile(y_rep, 0.01),
    q10 = quantile(y_rep, 0.10),
    mediana = median(y_rep),
    q90 = quantile(y_rep, 0.90),
    q99 = quantile(y_rep, 0.99),
    .groups = "drop"
  )
# A tibble: 6 × 7
especificacion x q01 q10 mediana q90 q99
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Débilmente informativa -2 -5.80 -2.98 -0.0157 2.92 5.60
2 Débilmente informativa 0 -4.09 -1.97 -0.0188 1.92 4.25
3 Débilmente informativa 2 -5.72 -3.02 -0.0297 2.99 5.70
4 Excesivamente amplia -2 -81.8 -41.2 -0.451 40.1 79.6
5 Excesivamente amplia 0 -44.1 -21.1 0.279 21.6 43.5
6 Excesivamente amplia 2 -79.2 -39.8 0.715 41.3 82.1 prior_pred_s6 |>
mutate(x = factor(x)) |>
ggplot(aes(x = y_rep, group = x, linetype = x)) +
geom_density(linewidth = 0.8) +
facet_wrap(~ especificacion, scales = "free_x") +
labs(
x = "Respuesta predictiva previa",
y = "Densidad",
linetype = "x"
) +
theme_minimal(base_size = 12)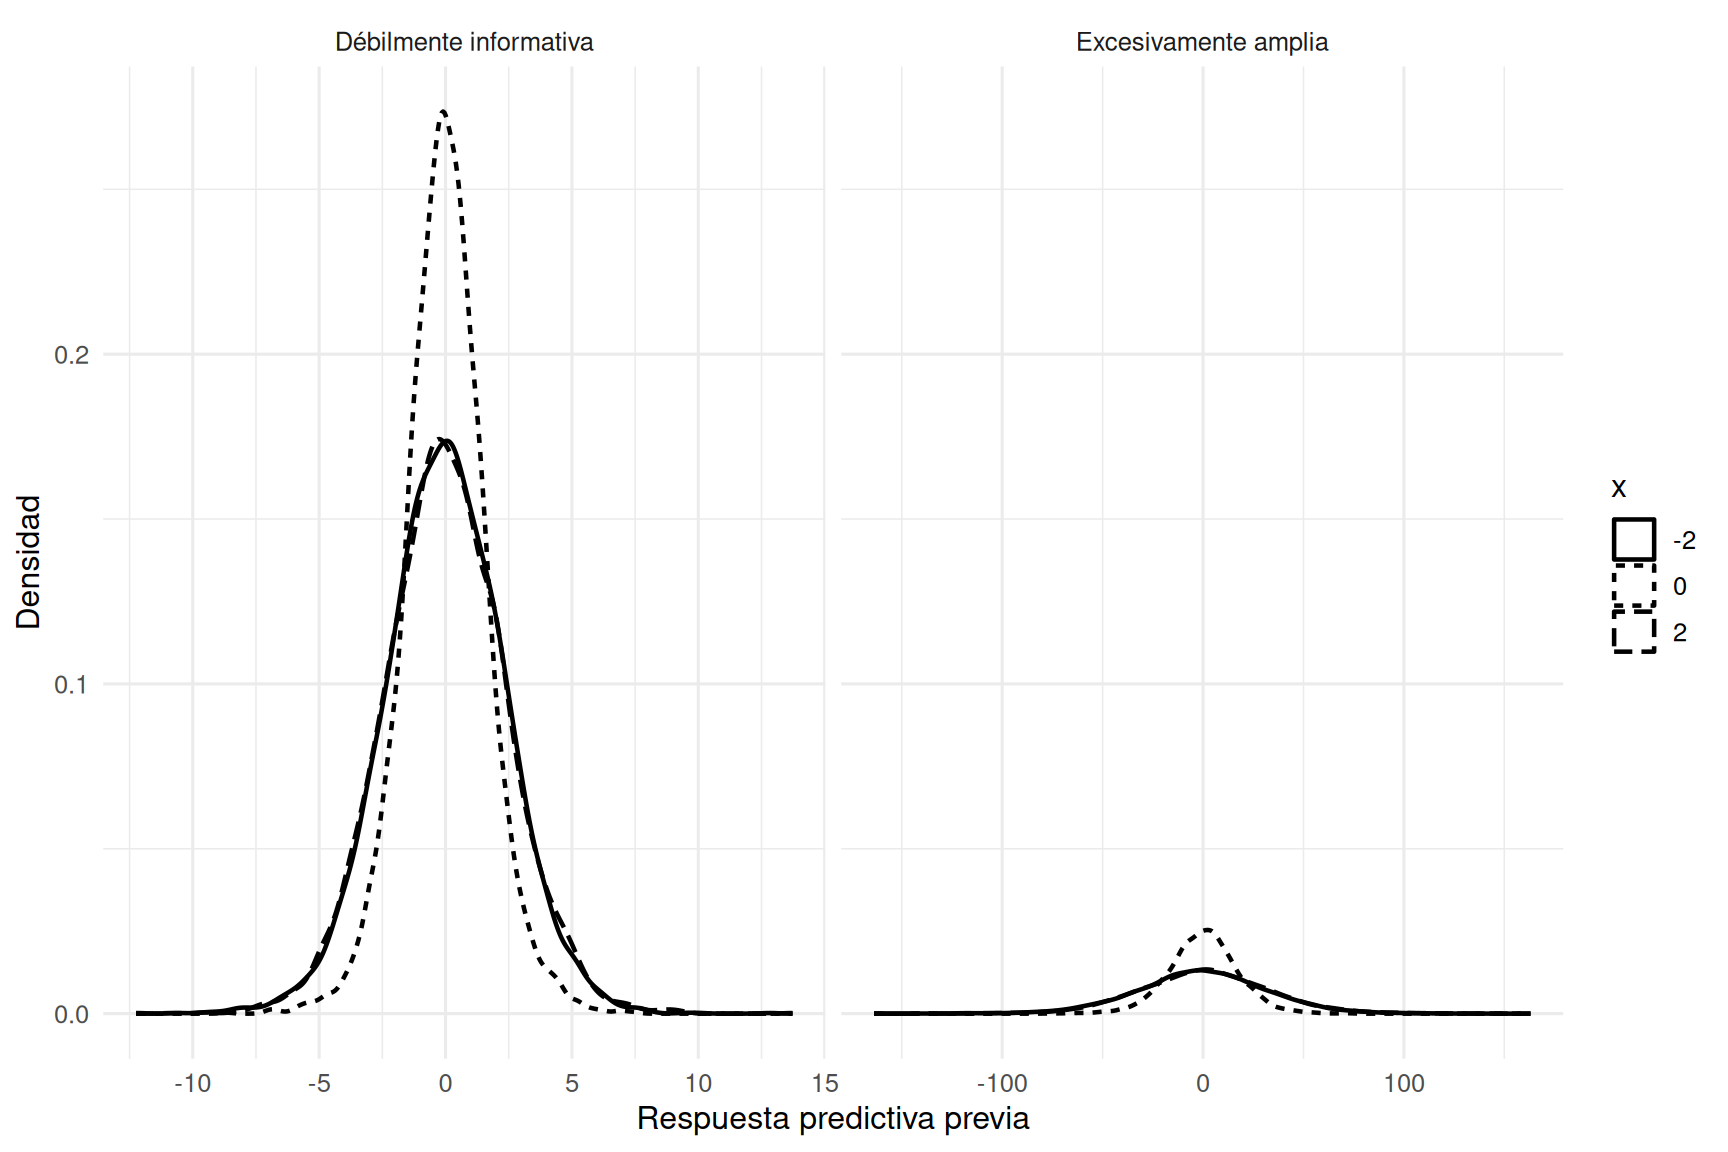
La especificación débilmente informativa no intenta anticipar la muestra observada. Su función es mantener la mayor parte de la distribución en magnitudes compatibles con una respuesta estandarizada, permitiendo al mismo tiempo heterogeneidad sustancial entre grupos.
6.15.2 Experimento 2: familias de previas para parámetros positivos
Las formas de las familias positivas son más fáciles de comparar mediante simulación. Usaremos tres distribuciones ilustrativas con parámetro de escala de orden uno. No están igualadas en media ni en cuantiles; el propósito es comparar cualitativamente concentración y colas.
set.seed(1653064)

n_pos <- 50000L

previas_positivas_s6 <- bind_rows(
  tibble(
    familia = "Half-Normal(0, 1)",
    valor = abs(rnorm(n_pos, 0, 1))
  ),
  tibble(
    familia = "Half-t(3, 0, 1)",
    valor = abs(rt(n_pos, df = 3))
  ),
  tibble(
    familia = "Exponential(1)",
    valor = rexp(n_pos, rate = 1)
  )
)
previas_positivas_s6 |>
filter(valor <= 6) |>
ggplot(aes(x = valor, linetype = familia)) +
geom_density(linewidth = 0.9) +
labs(
x = "Parámetro de escala",
y = "Densidad",
linetype = "Previa"
) +
theme_minimal(base_size = 12)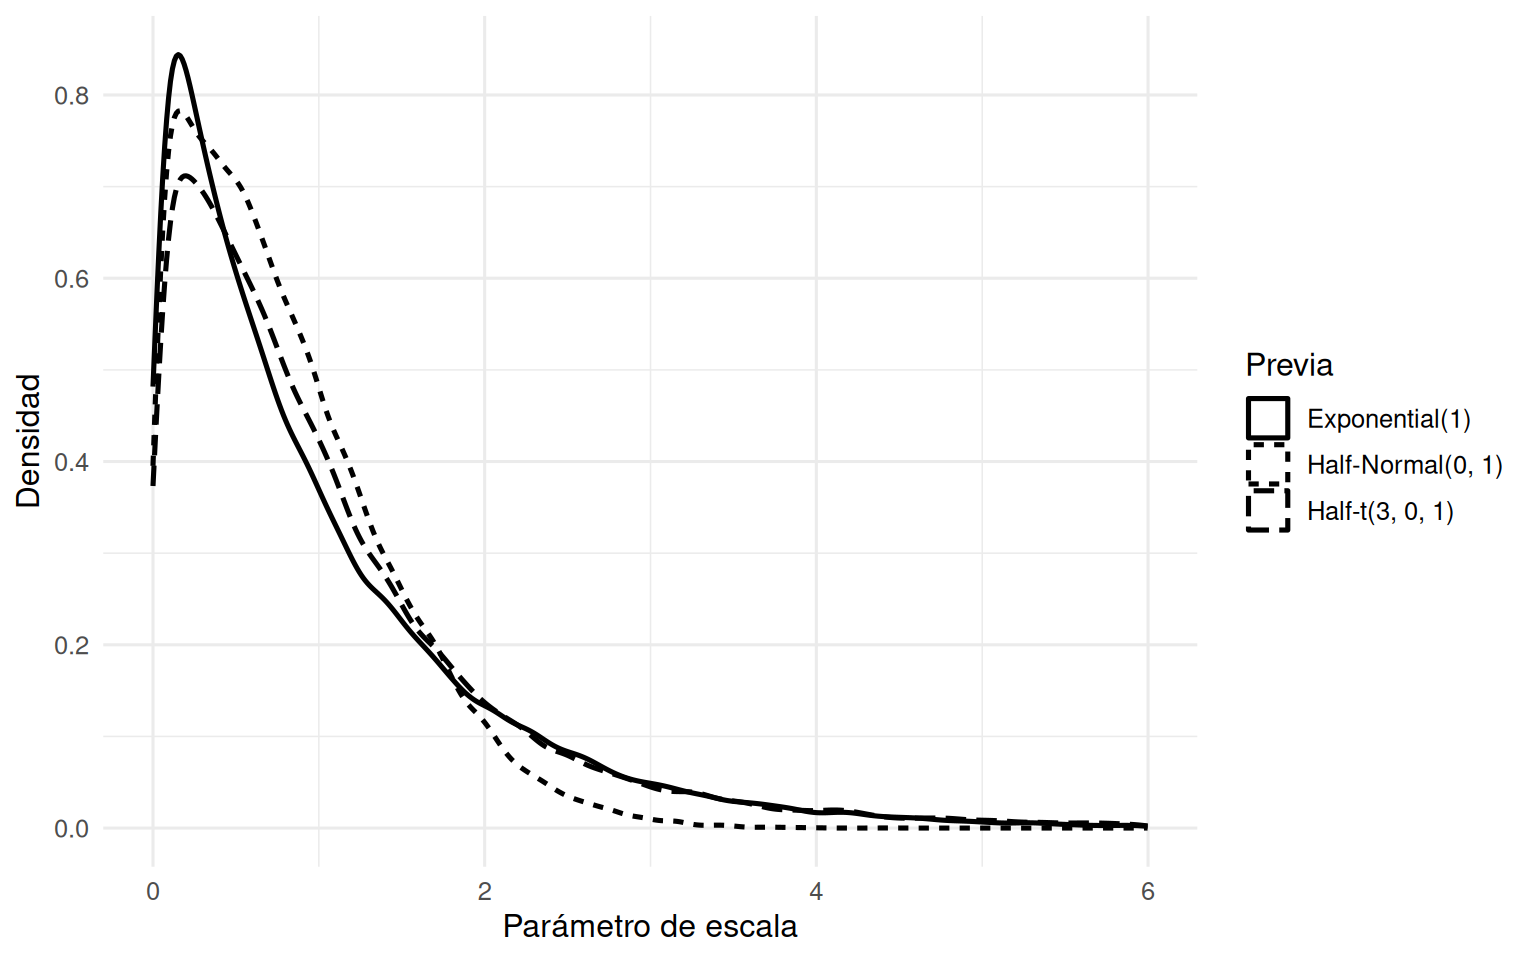
La figura no permite elegir una familia por sí sola. Después debemos multiplicar estas magnitudes por las unidades reales de \(y\) y comprobar qué heterogeneidad producen en los datos simulados.
6.15.3 Experimento 3: visualizar la familia LKJ en dimensión dos
Para \(K=2\), Ecuación 6.2 permite simular \(\rho\) directamente.
set.seed(1653065)

n_lkj <- 40000L

lkj_s6 <- map_dfr(
  c(1, 2, 4),
  function(eta_val) {
    tibble(
      eta = factor(eta_val),
      rho = 2 * rbeta(n_lkj, eta_val, eta_val) - 1
    )
  }
)
lkj_s6 |>
ggplot(aes(x = rho, linetype = eta)) +
geom_density(linewidth = 0.9) +
labs(
x = expression(rho),
y = "Densidad",
linetype = expression(eta)
) +
theme_minimal(base_size = 12)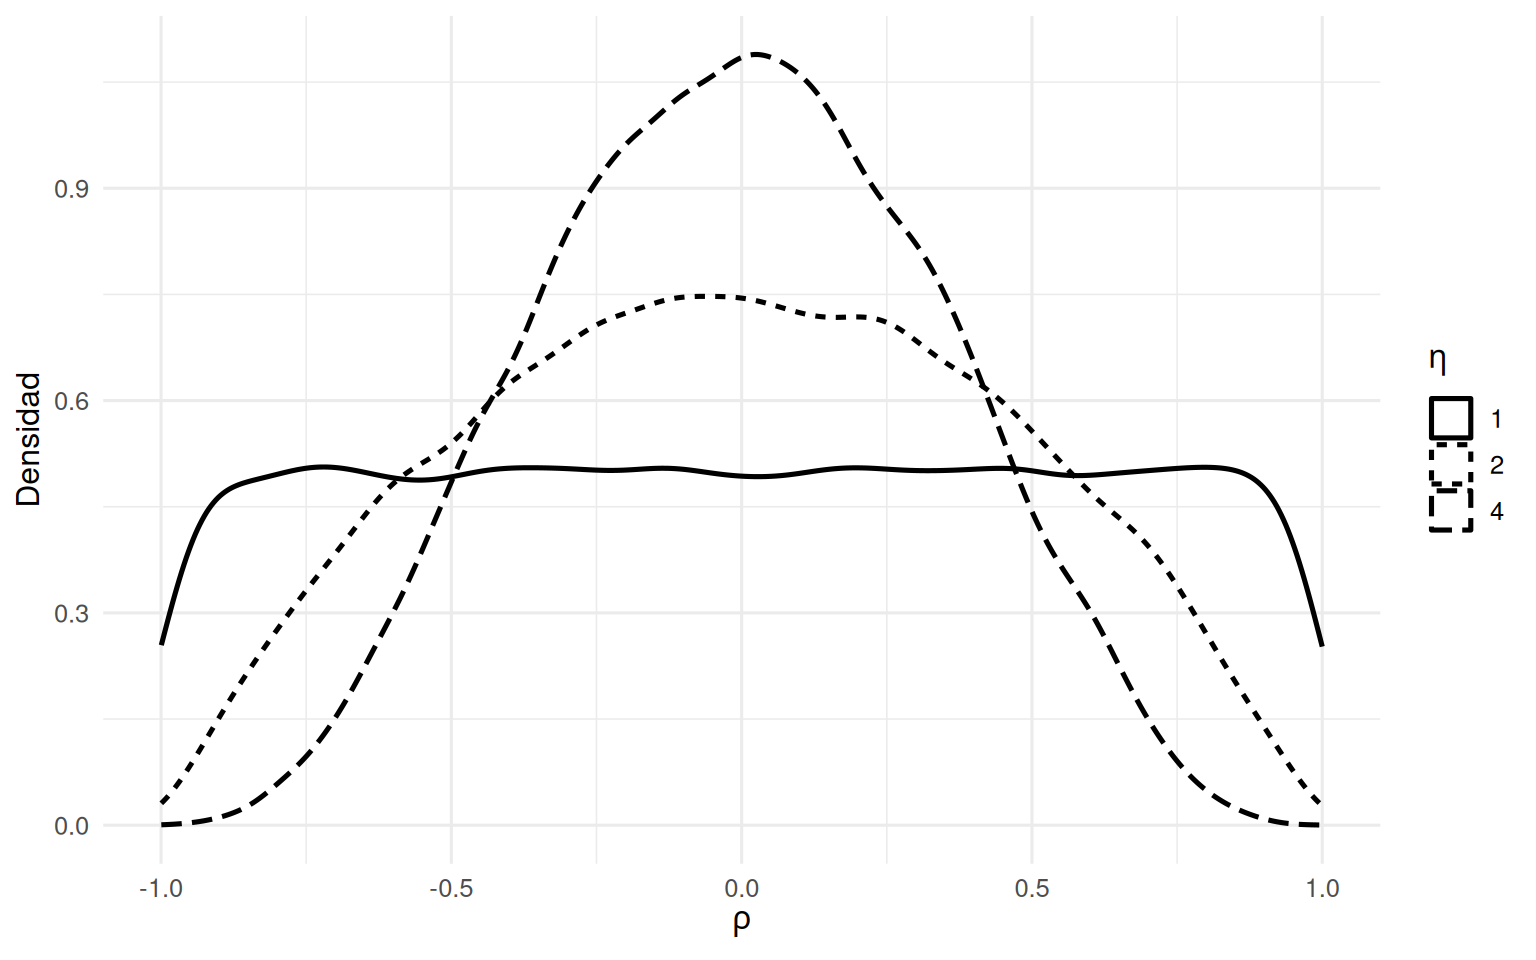
La figura reproduce cualitativamente la regularización descrita por McElreath para \(\operatorname{LKJ}(\eta)\) (McElreath 2020, 442-43). No debe extrapolarse literalmente a matrices de mayor dimensión: allí la marginal de cada correlación depende también de \(K\) (Gelman et al. 2026, 84-85).
6.16 Aplicación: especificación previa en sleepstudy
Los datos sleepstudy contienen tiempos de reacción medidos repetidamente durante varios días de privación de sueño. Bayesian Workflow utiliza este ejemplo en su capítulo 17 para ilustrar la especificación de previas en regresión lineal y multinivel (Gelman et al. 2026, cap. 17). Aquí lo retomamos porque la estructura del modelo ya es familiar y podemos concentrarnos en las previas.
6.16.1 Preparar los datos sin inspeccionar todavía la respuesta
data("sleepstudy", package = "lme4")

datos_s6 <- sleepstudy |>
  as_tibble() |>
  mutate(
    Subject = factor(Subject)
  )

# Información de diseño que podemos conocer sin resumir Reaction.
tibble(
  n_observaciones = nrow(datos_s6),
  n_sujetos = nlevels(datos_s6$Subject),
  dia_min = min(datos_s6$Days),
  dia_max = max(datos_s6$Days),
  faltantes_days = sum(is.na(datos_s6$Days)),
  faltantes_subject = sum(is.na(datos_s6$Subject)),
  faltantes_reaction = sum(is.na(datos_s6$Reaction))
)
# A tibble: 1 × 7
n_observaciones n_sujetos dia_min dia_max faltantes_days faltantes_subject
<int> <int> <dbl> <dbl> <int> <int>
1 180 18 0 9 0 0
# ℹ 1 more variable: faltantes_reaction <int>Por ahora evitamos summary(Reaction), histogramas o medias observadas. Supondremos que, por conocimiento de la escala del experimento, los tiempos de reacción se miden en milisegundos y valores típicos de cientos de milisegundos son plausibles. Esta reconstrucción pedagógica imita una especificación pre-datos.
6.16.2 Modelo de interceptos y pendientes variables
Usaremos
\[ Reaction_{ij} \sim \mathcal N(\mu_{ij},\sigma^2), \]
\[ \mu_{ij} = \alpha_j+\beta_j Days_{ij}, \]
con
\[ \begin{pmatrix} \alpha_j\\ \beta_j \end{pmatrix} \sim \mathcal N_2\!\left( \begin{pmatrix} \mu_\alpha\\ \mu_\beta \end{pmatrix}, D R D \right). \]
Las unidades son:
| Parámetro | Unidades | Interpretación previa |
|---|---|---|
| \(\mu_\alpha\) | ms | reacción promedio poblacional en Days = 0 |
| \(\mu_\beta\) | ms/día | cambio promedio por un día adicional |
| \(\tau_\alpha\) | ms | heterogeneidad entre interceptos individuales |
| \(\tau_\beta\) | ms/día | heterogeneidad entre pendientes individuales |
| \(\rho\) | sin unidades | asociación poblacional entre interceptos y pendientes |
| \(\sigma\) | ms | variación residual dentro de persona alrededor de su trayectoria |
6.16.3 Inspeccionar las clases de previas en brms
formula_s6 <- bf(
  Reaction ~ 1 + Days + (1 + Days | Subject)
)

previas_disponibles_s6 <- get_prior(
  formula = formula_s6,
  data = datos_s6,
  family = gaussian()
)

previas_disponibles_s6 |>
  filter(class %in% c("Intercept", "b", "sd", "cor", "sigma")) |>
  select(prior, class, coef, group, lb, ub)
prior class coef group lb ub source
(flat) b (unknown)
(flat) b Days (unknown)
lkj(1) cor (unknown)
(flat) cor Subject (unknown)
student_t(3, 288.7, 59.3) Intercept (unknown)
student_t(3, 0, 59.3) sd 0 (unknown)
(flat) sd Subject (unknown)
(flat) sd Days Subject (unknown)
(flat) sd Intercept Subject (unknown)
student_t(3, 0, 59.3) sigma 0 (unknown)La salida debe leerse como una descripción de la versión instalada de brms. La usaremos para identificar nombres y clases, no para adoptar automáticamente los valores predeterminados.
6.16.4 Dos especificaciones previas para comparar
Primero definimos una versión deliberadamente demasiado amplia.
priors_s6_amplia <- c(
  prior(normal(250, 1000), class = "Intercept"),
  prior(normal(0, 200), class = "b", coef = "Days"),
  prior(exponential(0.005), class = "sd", group = "Subject", coef = "Intercept"),
  prior(exponential(0.01), class = "sd", group = "Subject", coef = "Days"),
  prior(lkj(1), class = "cor", group = "Subject"),
  prior(exponential(0.005), class = "sigma")
)
La segunda especificación sigue las magnitudes utilizadas en el estudio de caso de Bayesian Workflow para sleepstudy, con \(\operatorname{LKJ}(2)\) como regularización moderada adicional para correlaciones extremas (Gelman et al. 2026, 276-83).
priors_s6_regular <- c(
  prior(normal(250, 100), class = "Intercept"),
  prior(normal(0, 20), class = "b", coef = "Days"),
  prior(exponential(0.02), class = "sd", group = "Subject", coef = "Intercept"),
  prior(exponential(0.05), class = "sd", group = "Subject", coef = "Days"),
  prior(lkj(2), class = "cor", group = "Subject"),
  prior(exponential(0.02), class = "sigma")
)
No debemos interpretar estas distribuciones como “las previas correctas para cualquier estudio longitudinal”. Están justificadas por la escala concreta de esta respuesta y por el rango de Days.
6.16.5 Ajustar únicamente la especificación amplia
fit_s6_prior_amplia <- brm(
  formula = formula_s6,
  data = datos_s6,
  family = gaussian(),
  prior = priors_s6_amplia,
  sample_prior = "only",
  backend = "cmdstanr",
  seed = 1653066,
  chains = 4,
  cores = 4,
  iter = 1500,
  warmup = 750,
  control = list(adapt_delta = 0.95),
  refresh = 0,
  file = file.path("_fits", "s6_prior_amplia_cmdstanr"),
  file_refit = "on_change"
)
6.16.6 Ajustar únicamente la especificación regularizada
fit_s6_prior_regular <- brm(
  formula = formula_s6,
  data = datos_s6,
  family = gaussian(),
  prior = priors_s6_regular,
  sample_prior = "only",
  backend = "cmdstanr",
  seed = 1653067,
  chains = 4,
  cores = 4,
  iter = 1500,
  warmup = 750,
  control = list(adapt_delta = 0.95),
  refresh = 0,
  file = file.path("_fits", "s6_prior_regular_cmdstanr"),
  file_refit = "on_change"
)
En ambos casos la estructura de diseño de sleepstudy fija los valores de Days y la pertenencia de las observaciones a Subject, pero Reaction no se utiliza para actualizar los parámetros.
6.16.7 Simular respuestas desde ambas predictivas previas
set.seed(1653068)

ypred_amplia_s6 <- posterior_predict(
  fit_s6_prior_amplia,
  ndraws = 300
)

ypred_regular_s6 <- posterior_predict(
  fit_s6_prior_regular,
  ndraws = 300
)

resumen_yrep_s6 <- bind_rows(
  tibble(
    especificacion = "Excesivamente amplia",
    minimo = apply(ypred_amplia_s6, 1, min),
    maximo = apply(ypred_amplia_s6, 1, max),
    media = rowMeans(ypred_amplia_s6),
    sd = apply(ypred_amplia_s6, 1, sd)
  ),
  tibble(
    especificacion = "Débilmente informativa",
    minimo = apply(ypred_regular_s6, 1, min),
    maximo = apply(ypred_regular_s6, 1, max),
    media = rowMeans(ypred_regular_s6),
    sd = apply(ypred_regular_s6, 1, sd)
  )
)

resumen_yrep_s6 |>
  group_by(especificacion) |>
  summarise(
    q05_min = quantile(minimo, 0.05),
    mediana_min = median(minimo),
    mediana_media = median(media),
    mediana_sd = median(sd),
    mediana_max = median(maximo),
    q95_max = quantile(maximo, 0.95),
    .groups = "drop"
  )
# A tibble: 2 × 7
especificacion q05_min mediana_min mediana_media mediana_sd mediana_max
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Débilmente informati… -920. -139. 254. 144. 622.
2 Excesivamente amplia -5798. -1798. 326. 810. 2428.
# ℹ 1 more variable: q95_max <dbl>Las cantidades minimo y maximo son deliberadamente sensibles a colas. No son estadísticas universales; sirven aquí porque tiempos de reacción negativos muy grandes o de decenas de segundos revelarían inmediatamente una especificación poco razonable para este contexto.
6.16.8 Visualizar predicciones previas sin usar todavía Reaction
Convertimos una muestra a formato largo.
set.seed(1653069)

id_draws_s6 <- sample(seq_len(nrow(ypred_regular_s6)), 40)

prior_long_s6 <- bind_rows(
  as_tibble(ypred_amplia_s6[id_draws_s6, , drop = FALSE]) |>
    mutate(draw = row_number(), especificacion = "Excesivamente amplia"),
  as_tibble(ypred_regular_s6[id_draws_s6, , drop = FALSE]) |>
    mutate(draw = row_number(), especificacion = "Débilmente informativa")
) |>
  pivot_longer(
    cols = starts_with("V"),
    names_to = "observacion",
    values_to = "Reaction_rep"
  )
prior_long_s6 |>
ggplot(aes(x = Reaction_rep, group = interaction(especificacion, draw))) +
geom_density(alpha = 0.16) +
facet_wrap(~ especificacion, scales = "free_x") +
labs(
x = "Tiempo de reacción simulado antes del ajuste (ms)",
y = "Densidad"
) +
theme_minimal(base_size = 12)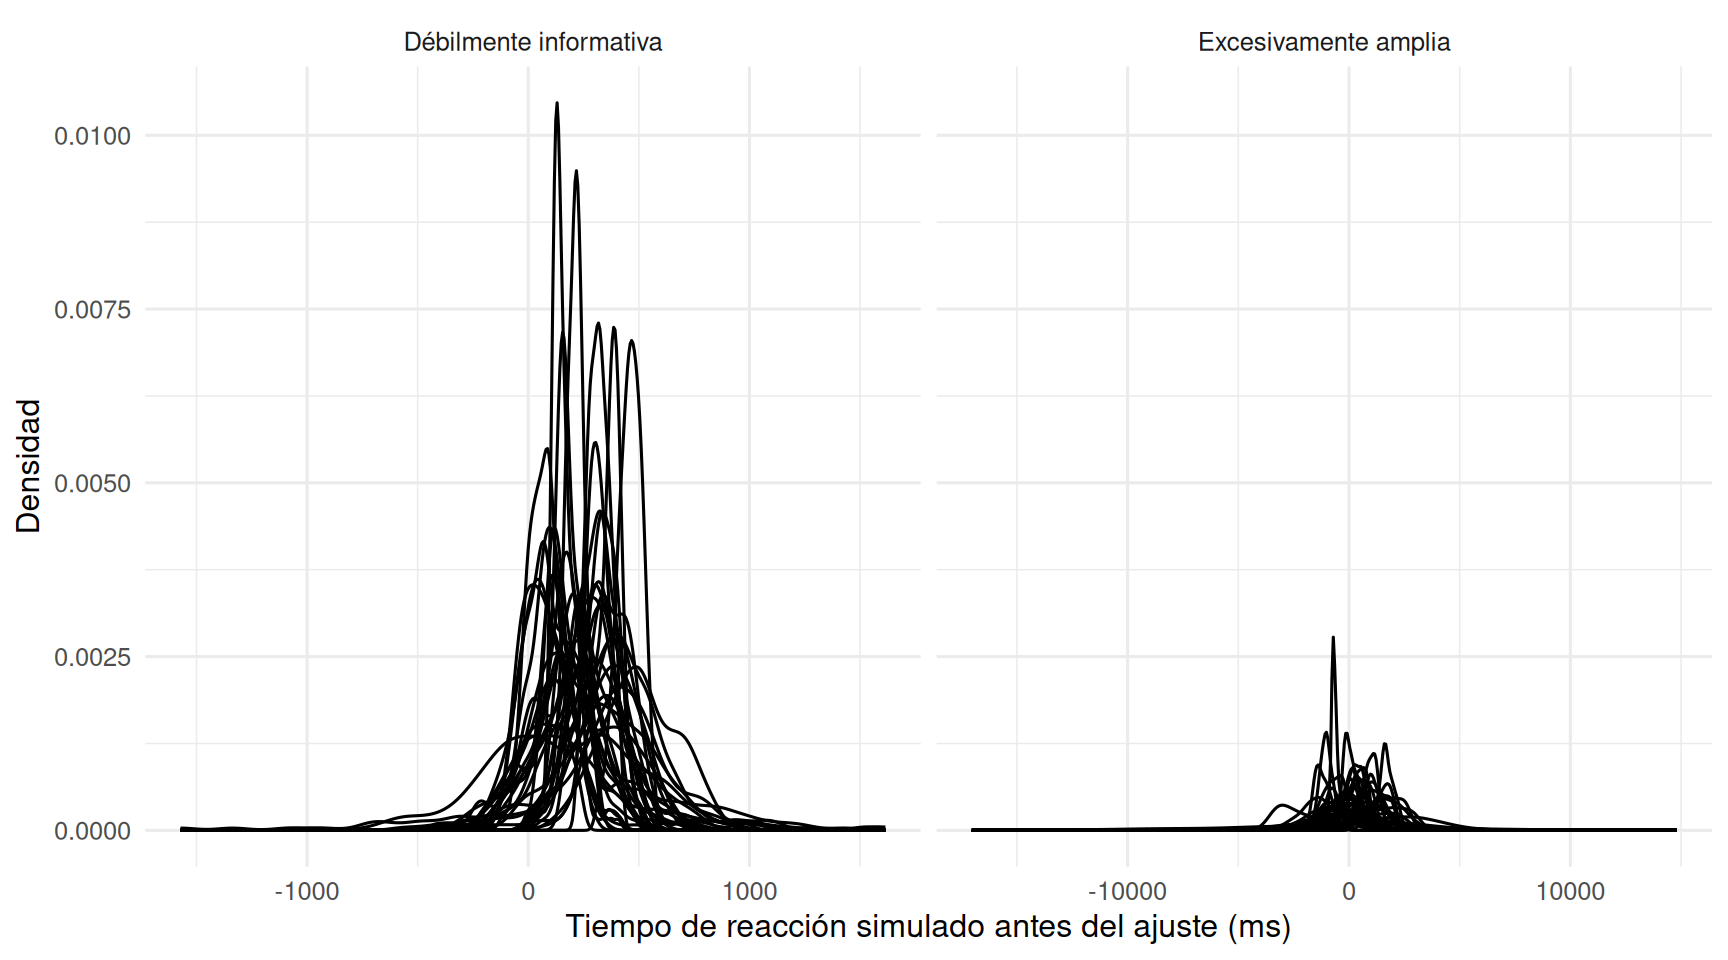
La figura responde una pregunta más útil que dibujar únicamente normal(0, 20) para la pendiente: muestra cómo se combinan intercepto, pendiente, heterogeneidad entre personas, correlación y error residual.
6.16.9 Comprobación previa sensible a la estructura grupal
Una distribución marginal puede ocultar una heterogeneidad entre personas excesiva. Construiremos una estadística predictiva: la desviación estándar de las medias individuales en cada réplica.
sd_medias_por_sujeto <- function(yrep, sujeto) {
  split(yrep, sujeto) |>
    vapply(mean, numeric(1)) |>
    sd()
}

sd_entre_amplia_s6 <- apply(
  ypred_amplia_s6,
  1,
  sd_medias_por_sujeto,
  sujeto = datos_s6$Subject
)

sd_entre_regular_s6 <- apply(
  ypred_regular_s6,
  1,
  sd_medias_por_sujeto,
  sujeto = datos_s6$Subject
)

heterogeneidad_prior_s6 <- bind_rows(
  tibble(
    especificacion = "Excesivamente amplia",
    sd_medias = sd_entre_amplia_s6
  ),
  tibble(
    especificacion = "Débilmente informativa",
    sd_medias = sd_entre_regular_s6
  )
)
heterogeneidad_prior_s6 |>
ggplot(aes(x = sd_medias, linetype = especificacion)) +
geom_density(linewidth = 0.9) +
labs(
x = "DE de las medias simuladas por sujeto (ms)",
y = "Densidad",
linetype = "Previa"
) +
theme_minimal(base_size = 12)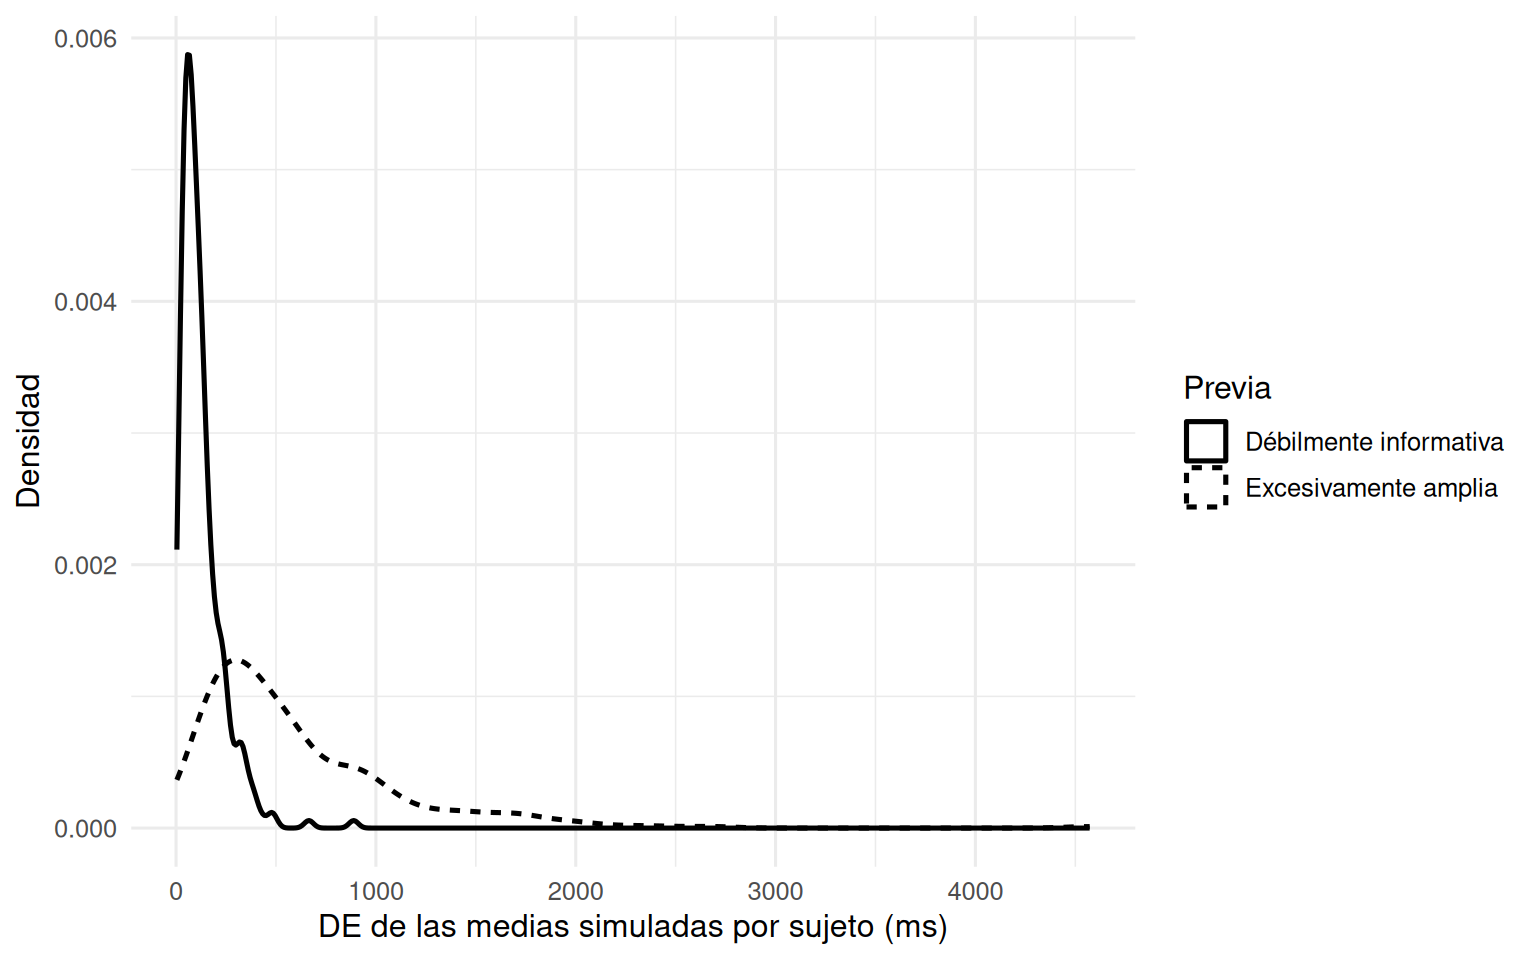
Esta figura ilustra un principio general: la estadística de comprobación debe corresponder al componente del modelo que queremos entender.
6.16.10 Comprobación previa de trayectorias individuales
Otra cantidad informativa es la trayectoria esperada de un sujeto nuevo. Extraeremos parámetros poblacionales y de variación del ajuste previo regularizado y generaremos nuevas trayectorias por simulación directa.
draws_prior_regular_s6 <- as_draws_df(fit_s6_prior_regular)

vars_trayectoria_s6 <- c(
  "b_Intercept",
  "b_Days",
  "sd_Subject__Intercept",
  "sd_Subject__Days",
  "cor_Subject__Intercept__Days"
)

stopifnot(all(vars_trayectoria_s6 %in% names(draws_prior_regular_s6)))

set.seed(1653070)

trayectorias_s6 <- draws_prior_regular_s6 |>
  select(all_of(vars_trayectoria_s6)) |>
  slice_sample(n = 150) |>
  mutate(
    draw = row_number(),
    z0 = rnorm(n()),
    z1 = rnorm(n()),
    alpha_nuevo =
      b_Intercept + sd_Subject__Intercept * z0,
    beta_nuevo =
      b_Days +
      sd_Subject__Days * (
        cor_Subject__Intercept__Days * z0 +
          sqrt(1 - cor_Subject__Intercept__Days^2) * z1
      )
  ) |>
  select(draw, alpha_nuevo, beta_nuevo) |>
  crossing(Days = 0:9) |>
  mutate(
    mu = alpha_nuevo + beta_nuevo * Days
  )
trayectorias_s6 |>
ggplot(aes(x = Days, y = mu, group = draw)) +
geom_line(alpha = 0.14) +
labs(
x = "Día de privación de sueño",
y = "Media de reacción simulada para un sujeto nuevo (ms)"
) +
theme_minimal(base_size = 12)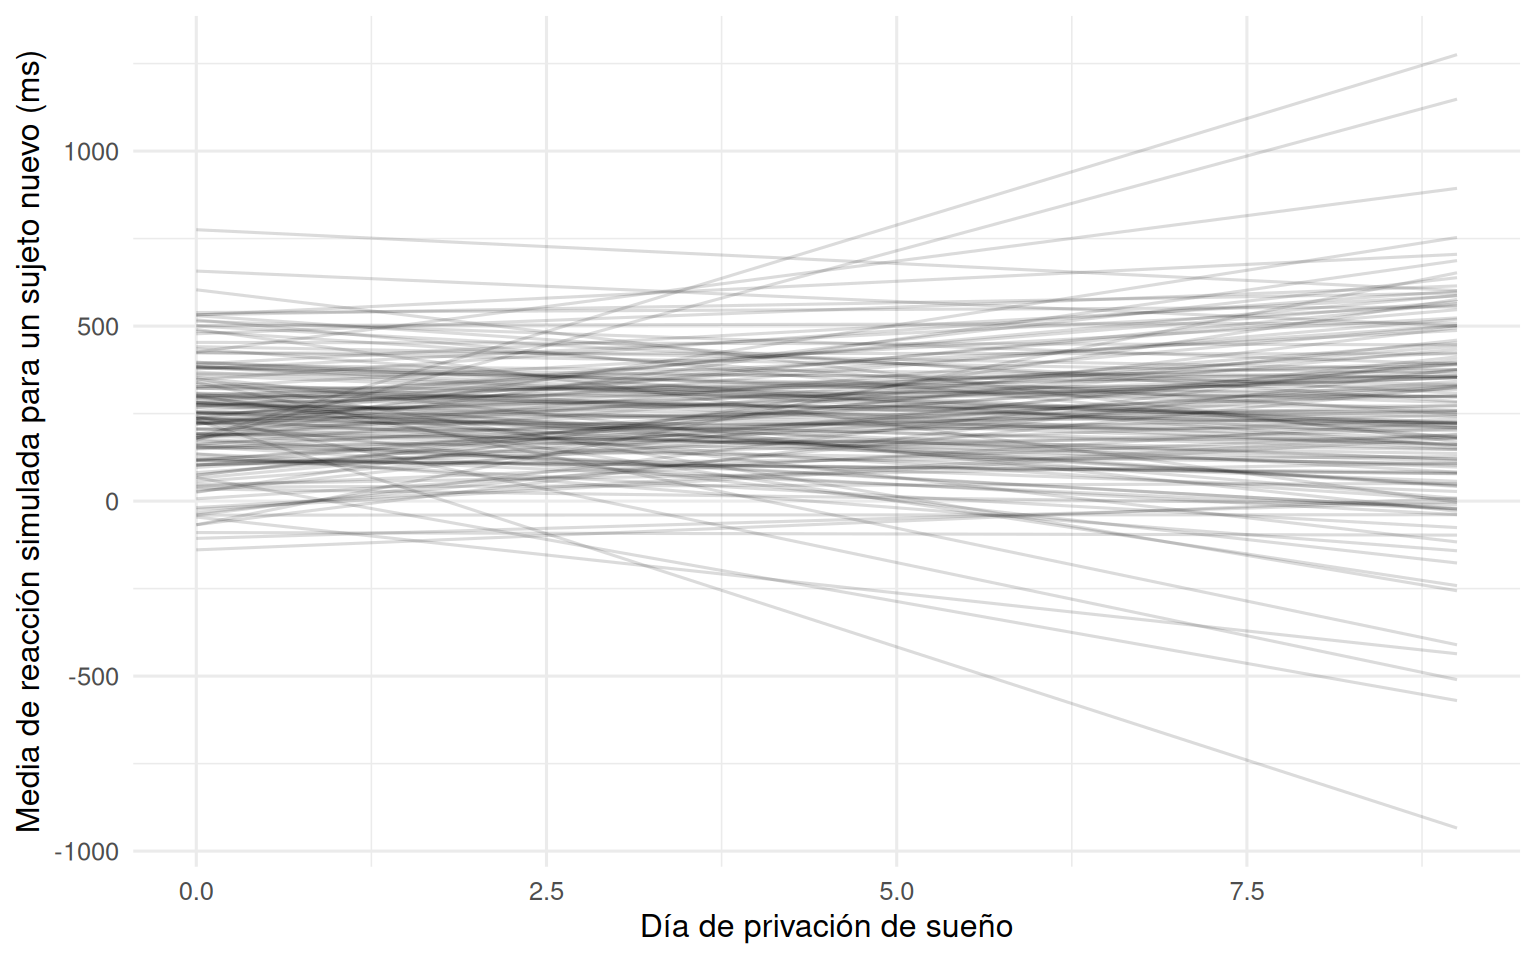
La figura expresa simultáneamente la previa para la pendiente poblacional, la heterogeneidad de pendientes y la correlación entre coeficientes. Es mucho más informativa que considerar esos tres componentes por separado.
6.16.11 Incorporar finalmente los datos observados
Una vez que la distribución predictiva previa es defendible en términos de escala y estructura, utilizamos Reaction para obtener la posterior.
Primero podemos inspeccionar la respuesta, ahora sí como parte de la etapa de análisis observacional.
datos_s6 |>
  summarise(
    min = min(Reaction),
    q25 = quantile(Reaction, 0.25),
    mediana = median(Reaction),
    media = mean(Reaction),
    q75 = quantile(Reaction, 0.75),
    max = max(Reaction),
    sd = sd(Reaction)
  )
# A tibble: 1 × 7
min q25 mediana media q75 max sd
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 194. 255. 289. 299. 337. 466. 56.3 datos_s6 |>
ggplot(aes(x = Days, y = Reaction, group = Subject)) +
geom_line(alpha = 0.45) +
geom_point(size = 1.3, alpha = 0.75) +
labs(
x = "Día de privación de sueño",
y = "Tiempo de reacción (ms)"
) +
theme_minimal(base_size = 12)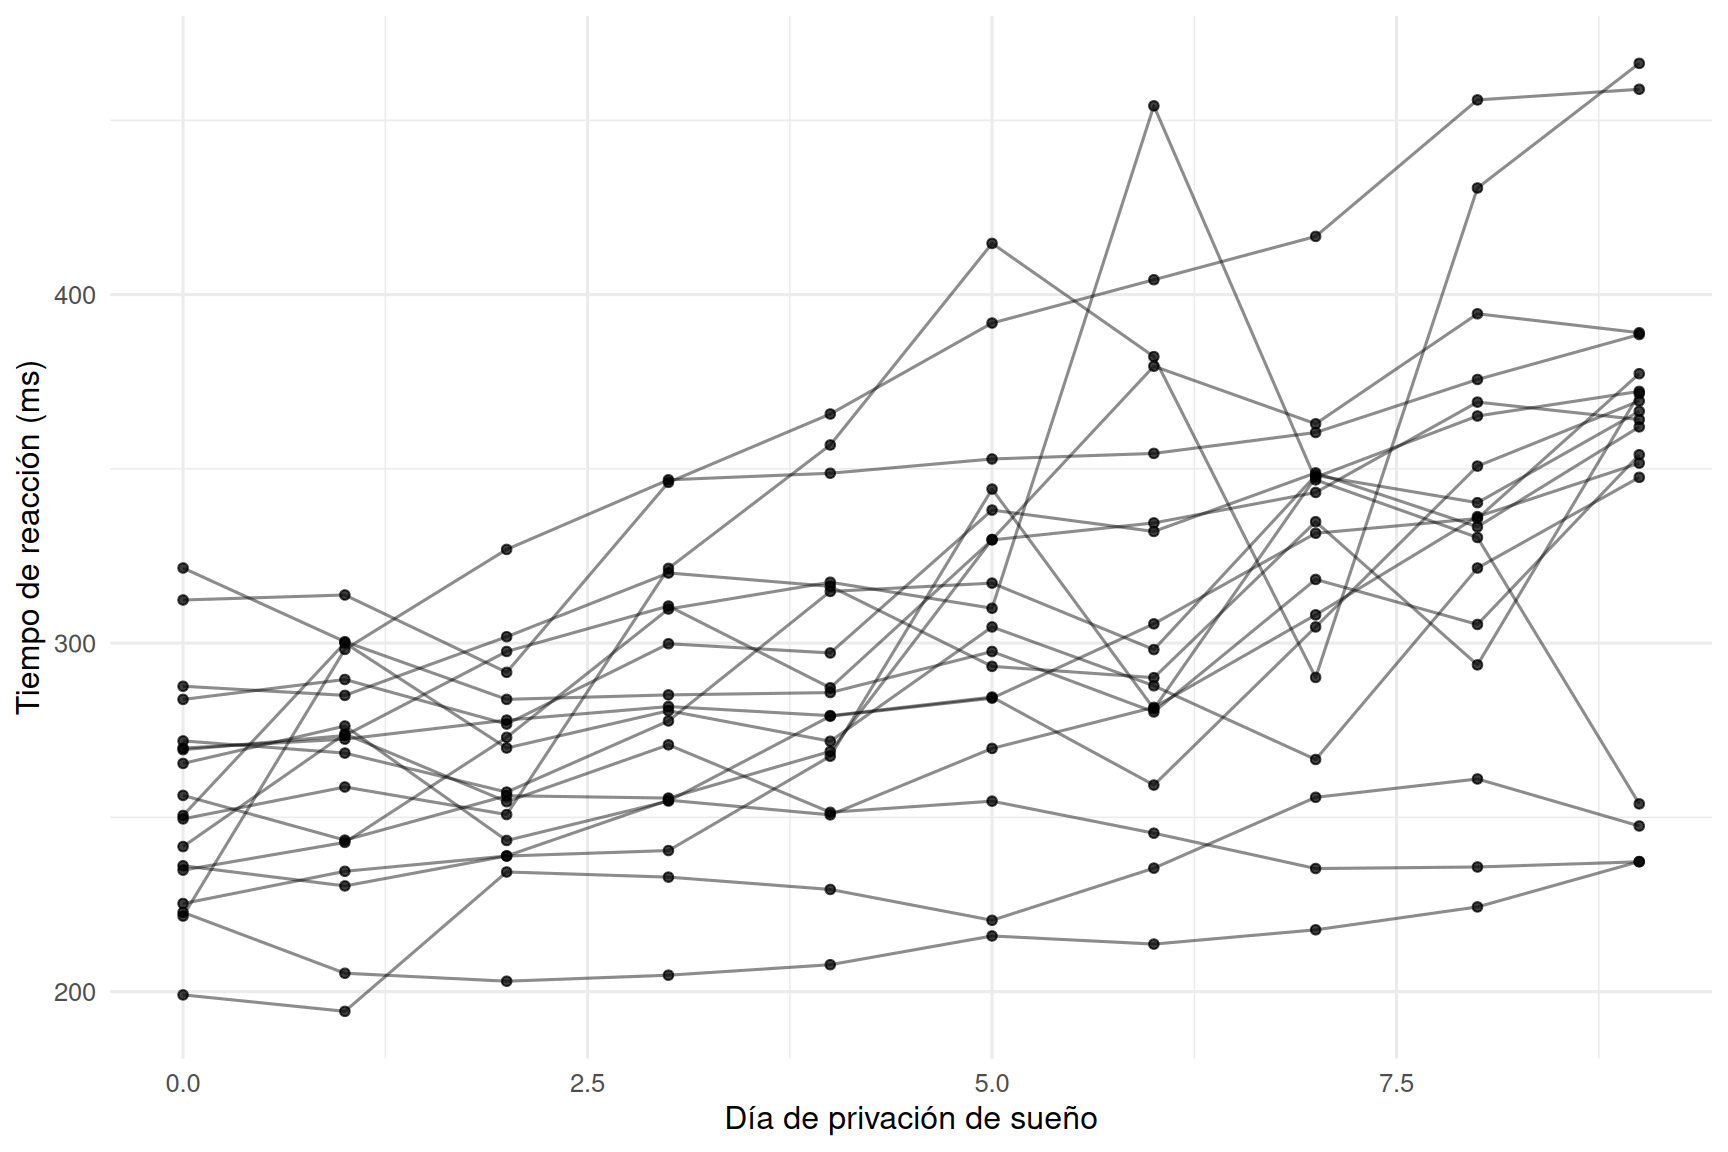
6.16.12 Ajustar el modelo con la previa principal
fit_s6 <- brm(
  formula = formula_s6,
  data = datos_s6,
  family = gaussian(),
  prior = priors_s6_regular,
  backend = "cmdstanr",
  seed = 1653071,
  chains = 4,
  cores = 4,
  iter = 2500,
  warmup = 1000,
  control = list(adapt_delta = 0.95),
  refresh = 0,
  file = file.path("_fits", "s6_sleepstudy_regular_cmdstanr"),
  file_refit = "on_change"
)
El objetivo de esta semana no es estudiar exhaustivamente HMC. No obstante, ningún resumen posterior debe interpretarse sin una comprobación mínima de que el muestreo fue adecuado.
6.16.13 Diagnóstico MCMC básico
summary(fit_s6) Family: gaussian
Links: mu = identity
Formula: Reaction ~ 1 + Days + (1 + Days | Subject)
Data: datos_s6 (Number of observations: 180)
Draws: 4 chains, each with iter = 2500; warmup = 1000; thin = 1;
total post-warmup draws = 6000
Multilevel Hyperparameters:
~Subject (Number of levels: 18)
Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
sd(Intercept) 26.28 6.58 15.26 40.70 1.00 3760 4303
sd(Days) 6.45 1.42 4.16 9.66 1.00 2832 3807
cor(Intercept,Days) 0.07 0.27 -0.44 0.59 1.00 2214 3233
Regression Coefficients:
Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
Intercept 251.25 7.15 237.00 265.26 1.00 4056 4360
Days 10.34 1.70 7.01 13.72 1.00 3148 3748
Further Distributional Parameters:
Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
sigma 25.92 1.55 23.08 29.11 1.00 6281 4998
Draws were sampled using sample(hmc). For each parameter, Bulk_ESS
and Tail_ESS are effective sample size measures, and Rhat is the potential
scale reduction factor on split chains (at convergence, Rhat = 1).# Evitamos acceder directamente al objeto interno del backend, porque su
# clase puede diferir entre rstan y cmdstanr (y también entre ajustes
# recuperados desde caché). brms ofrece un extractor común para los
# diagnósticos de NUTS.
nuts_s6 <- brms::nuts_params(fit_s6)
divergencias_s6 <- sum(
nuts_s6$Value[nuts_s6$Parameter == "divergent__"]
)
profundidad_s6 <- max(
nuts_s6$Value[nuts_s6$Parameter == "treedepth__"]
)
tibble(
diagnostico = c(
"Número total de divergencias",
"Profundidad máxima observada del árbol"
),
valor = c(divergencias_s6, profundidad_s6)
)# A tibble: 2 × 2
diagnostico valor
<chr> <dbl>
1 Número total de divergencias 0
2 Profundidad máxima observada del árbol 7Nos interesan, como mínimo:
- valores de \(\widehat R\) próximos a 1;
- tamaños efectivos de muestra razonables;
- ausencia de divergencias;
- ausencia de advertencias sistemáticas de profundidad máxima del árbol.
La interpretación detallada de estas cantidades corresponde a la semana 7.
6.16.14 Comparar previa y posterior para parámetros clave
Construiremos un resumen común para las muestras previas y posteriores.
draws_post_s6 <- as_draws_df(fit_s6)

vars_clave_s6 <- c(
  "b_Intercept",
  "b_Days",
  "sd_Subject__Intercept",
  "sd_Subject__Days",
  "cor_Subject__Intercept__Days",
  "sigma"
)

extraer_largo <- function(draws, origen) {
  draws |>
    select(all_of(vars_clave_s6)) |>
    pivot_longer(
      everything(),
      names_to = "parametro",
      values_to = "valor"
    ) |>
    mutate(origen = origen)
}

prior_post_s6 <- bind_rows(
  extraer_largo(draws_prior_regular_s6, "Previa"),
  extraer_largo(draws_post_s6, "Posterior")
)
prior_post_s6 |>
ggplot(aes(x = valor, linetype = origen)) +
geom_density(linewidth = 0.8) +
facet_wrap(~ parametro, scales = "free", ncol = 2) +
labs(
x = NULL,
y = "Densidad",
linetype = NULL
) +
theme_minimal(base_size = 11)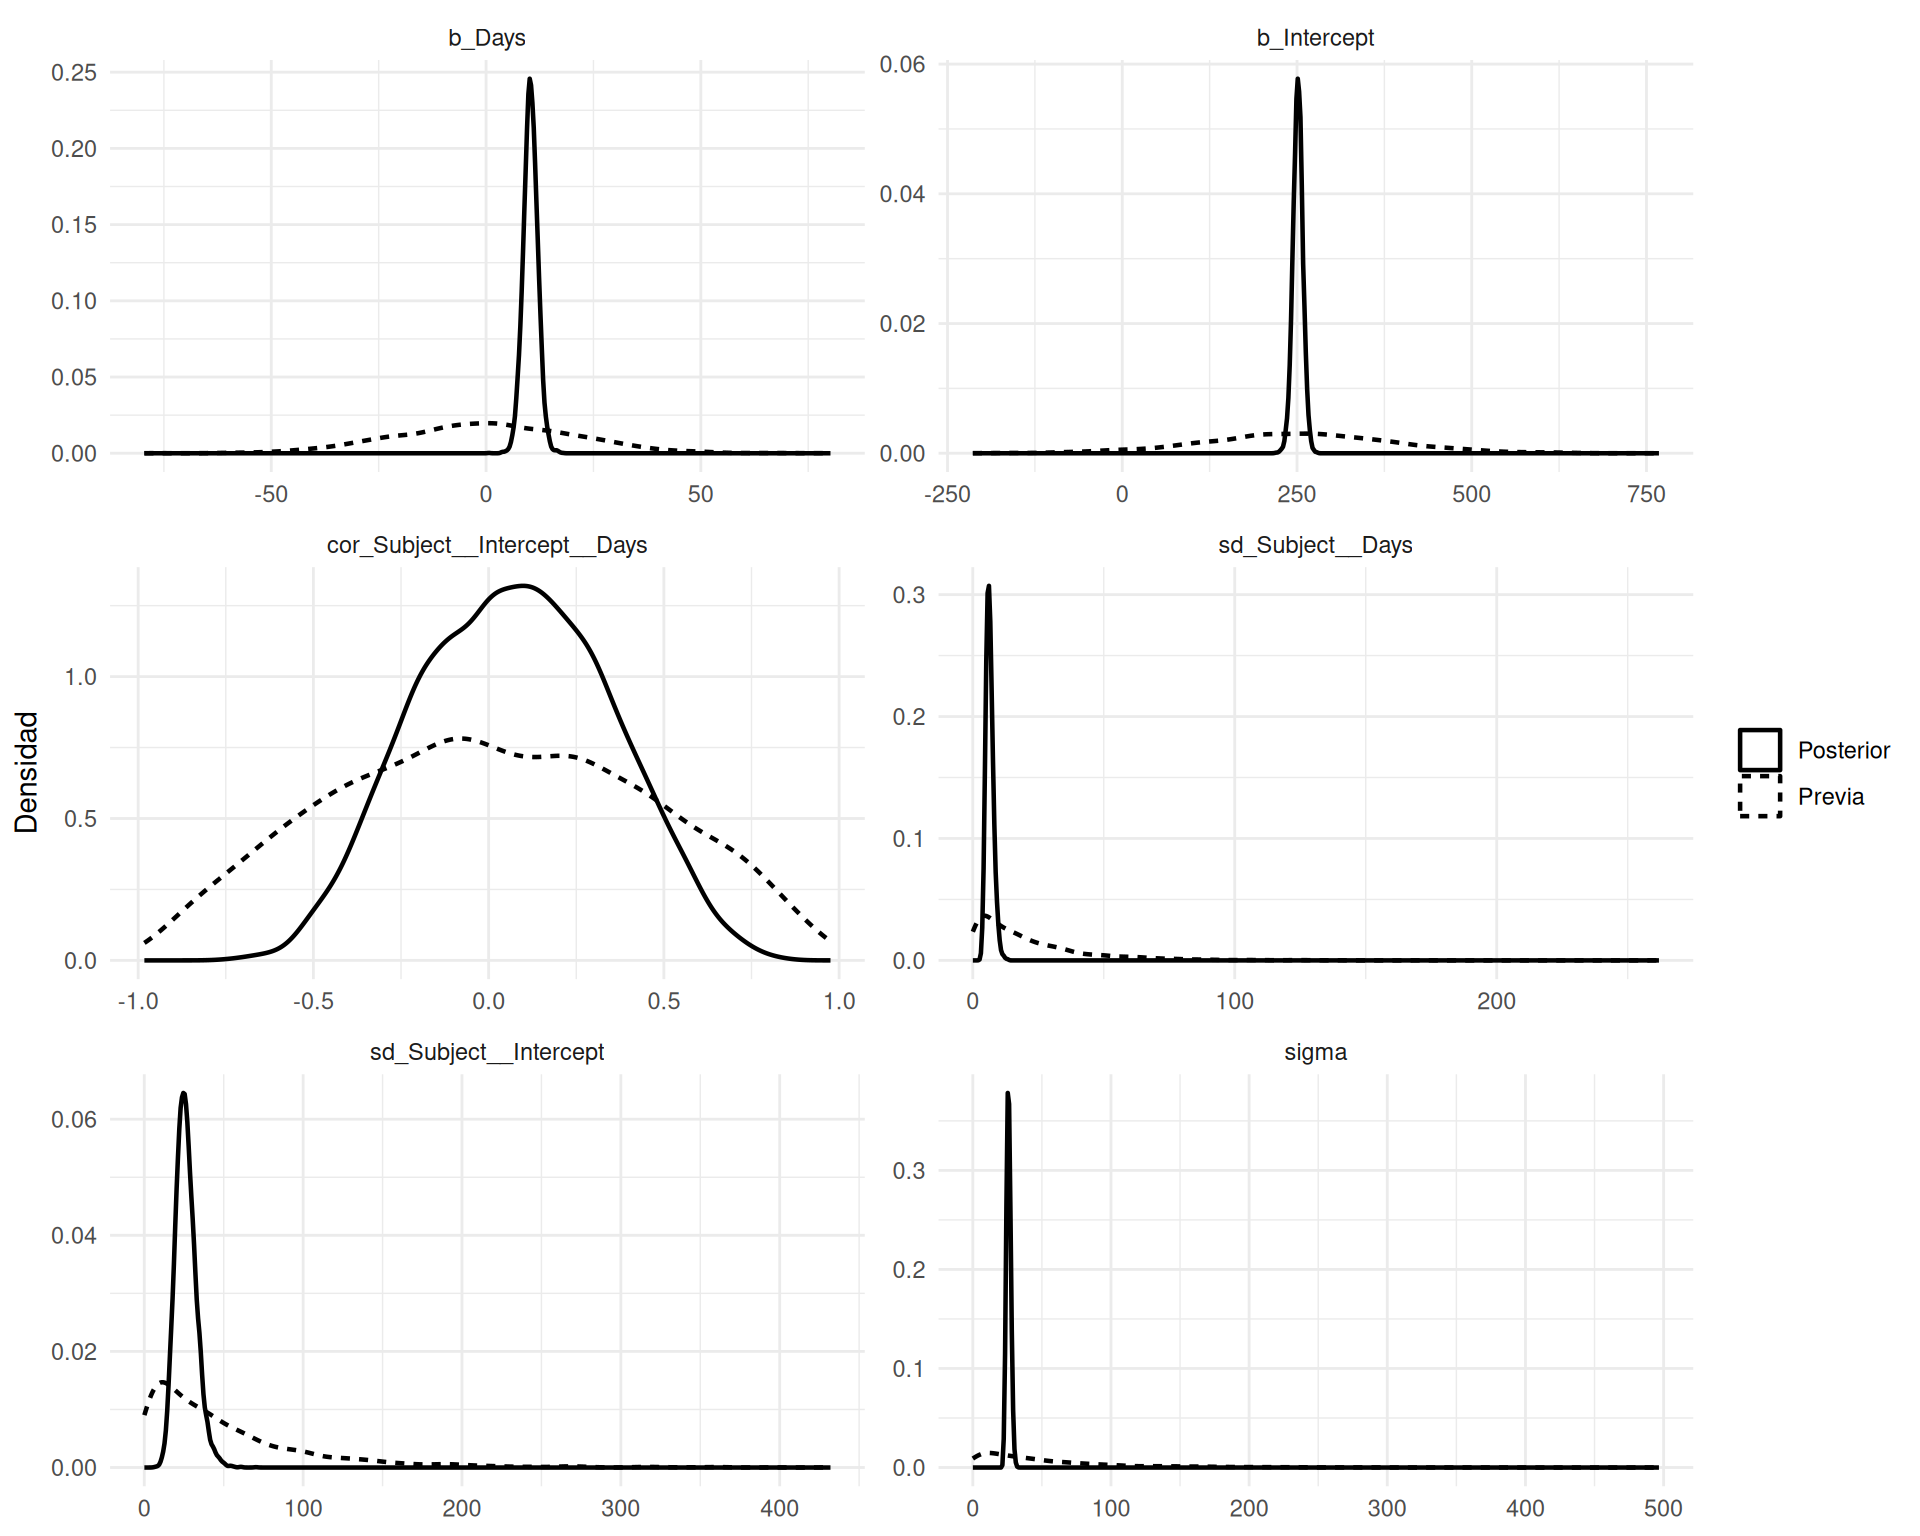
sleepstudy. Una posterior similar a la previa puede reflejar poca información de los datos para ese parámetro.
Esta comparación no debe resumirse diciendo que “la previa tuvo” o “no tuvo” efecto de manera global. Es perfectamente posible que los datos informen mucho sobre \(\mu_\beta\) y \(\sigma\), pero bastante menos sobre \(\rho\).
6.16.15 Resumen posterior interpretable
draws_post_s6 |>
  select(all_of(vars_clave_s6)) |>
  pivot_longer(
    everything(),
    names_to = "parametro",
    values_to = "valor"
  ) |>
  group_by(parametro) |>
  summarise(
    media = mean(valor),
    mediana = median(valor),
    q025 = quantile(valor, 0.025),
    q975 = quantile(valor, 0.975),
    .groups = "drop"
  )
# A tibble: 6 × 5
parametro media mediana q025 q975
<chr> <dbl> <dbl> <dbl> <dbl>
1 b_Days 10.3 10.3 7.01 13.7
2 b_Intercept 251. 251. 237. 265.
3 cor_Subject__Intercept__Days 0.0713 0.0723 -0.440 0.586
4 sd_Subject__Days 6.45 6.29 4.16 9.66
5 sd_Subject__Intercept 26.3 25.6 15.3 40.7
6 sigma 25.9 25.8 23.1 29.1 El resumen sirve para describir cantidades, pero la comparación previa-posterior añade una pregunta distinta: ¿cuánto de esta concentración procede de los datos y cuánto estaba ya codificado en la previa?
6.16.16 Comprobación predictiva posterior mínima
La comprobación posterior se desarrollará con mucha más profundidad en la semana 13. Aquí incluimos una comprobación global solo para cerrar el ciclo iniciado con la simulación previa.
pp_check(
  fit_s6,
  type = "dens_overlay",
  ndraws = 60
)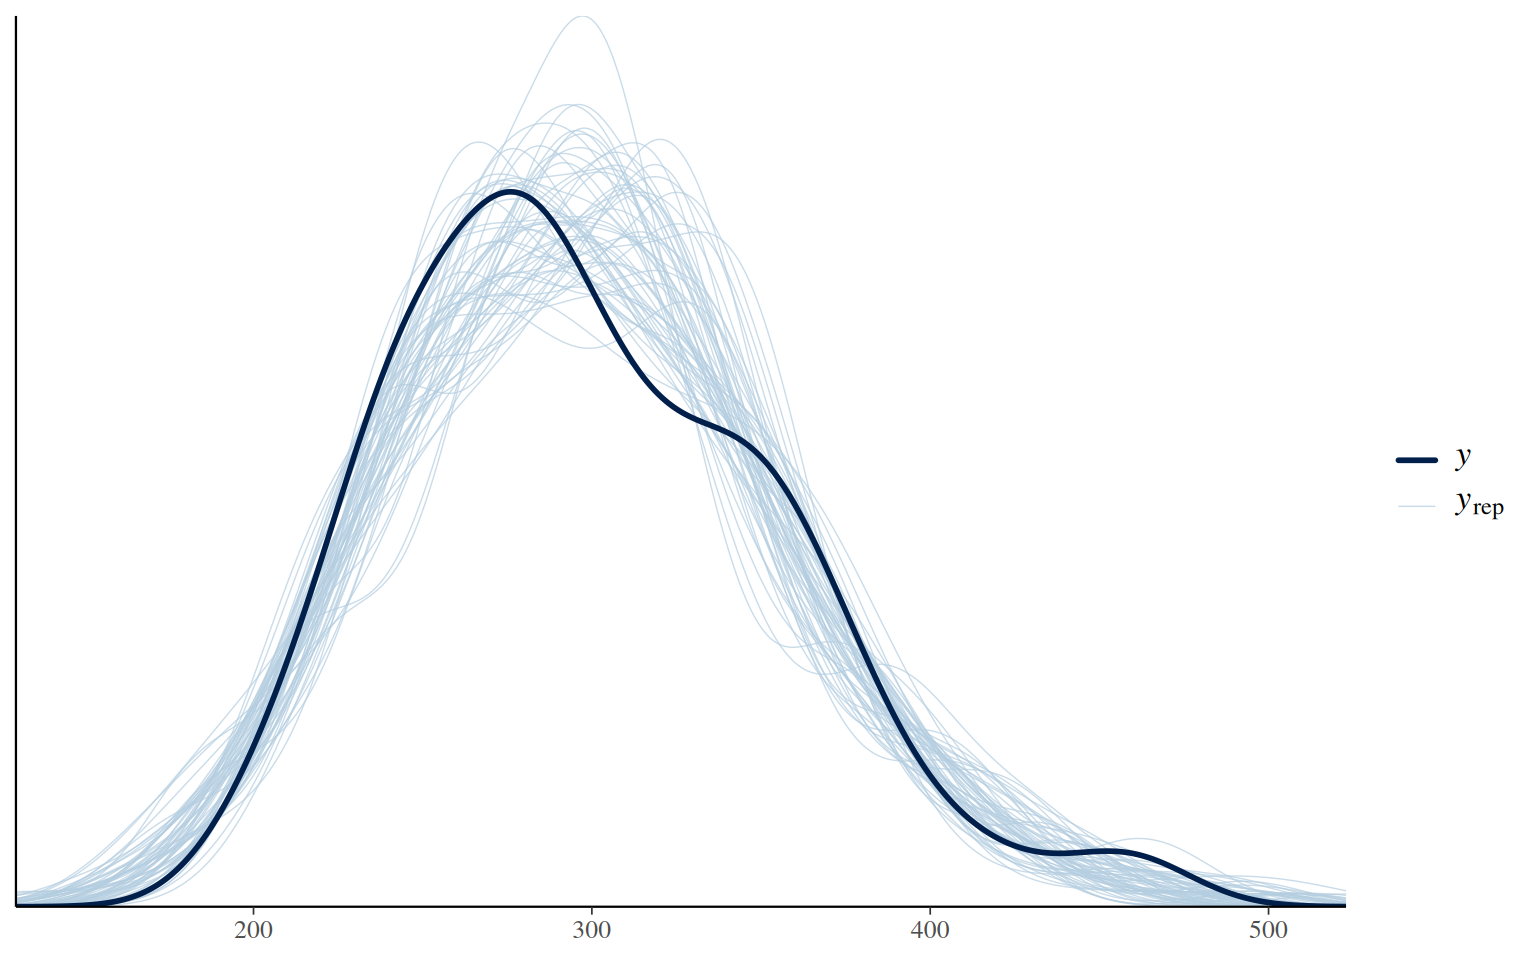
sleepstudy. Esta figura responde una pregunta distinta de la comprobación predictiva previa.La predictiva previa preguntaba si el modelo podía producir datos plausibles antes de usar Reaction. La predictiva posterior pregunta si, después de condicionarse en Reaction, las réplicas reproducen aspectos relevantes del conjunto observado.
6.16.17 Análisis de sensibilidad de la previa
Para ilustrar sensibilidad, mantendremos la misma verosimilitud y estructura jerárquica y modificaremos únicamente dos componentes que suelen ser débiles: la escala de la pendiente variable y la correlación.
Definimos una alternativa más regularizadora:
\[ \tau_\beta\sim\operatorname{Exponential}(0.10), \]
cuya media previa es 10 ms/día, y
\[ R\sim\operatorname{LKJ}(4). \]
El resto de las previas permanece igual.
priors_s6_tight <- c(
  prior(normal(250, 100), class = "Intercept"),
  prior(normal(0, 20), class = "b", coef = "Days"),
  prior(exponential(0.02), class = "sd", group = "Subject", coef = "Intercept"),
  prior(exponential(0.10), class = "sd", group = "Subject", coef = "Days"),
  prior(lkj(4), class = "cor", group = "Subject"),
  prior(exponential(0.02), class = "sigma")
)
fit_s6_tight <- brm(
formula = formula_s6,
data = datos_s6,
family = gaussian(),
prior = priors_s6_tight,
backend = "cmdstanr",
seed = 1653072,
chains = 4,
cores = 4,
iter = 2500,
warmup = 1000,
control = list(adapt_delta = 0.95),
refresh = 0,
file = file.path("_fits", "s6_sleepstudy_tight_cmdstanr"),
file_refit = "on_change"
)6.16.17.1 Comparar parámetros sensibles
resumir_sensibilidad <- function(fit, especificacion) {
  as_draws_df(fit) |>
    select(
      b_Days,
      sd_Subject__Days,
      cor_Subject__Intercept__Days
    ) |>
    pivot_longer(
      everything(),
      names_to = "parametro",
      values_to = "valor"
    ) |>
    group_by(parametro) |>
    summarise(
      especificacion = especificacion,
      mediana = median(valor),
      q10 = quantile(valor, 0.10),
      q90 = quantile(valor, 0.90),
      q025 = quantile(valor, 0.025),
      q975 = quantile(valor, 0.975),
      .groups = "drop"
    )
}

bind_rows(
  resumir_sensibilidad(fit_s6, "Principal"),
  resumir_sensibilidad(fit_s6_tight, "Más regularizadora")
)
# A tibble: 6 × 7
parametro especificacion mediana q10 q90 q025 q975
<chr> <chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Days Principal 10.3 8.20 12.5 7.01 13.7
2 cor_Subject__Intercept__Da… Principal 0.0723 -0.288 0.433 -0.440 0.586
3 sd_Subject__Days Principal 6.29 4.80 8.30 4.16 9.66
4 b_Days Más regulariz… 10.4 8.32 12.4 7.04 13.5
5 cor_Subject__Intercept__Da… Más regulariz… 0.0642 -0.248 0.375 -0.394 0.525
6 sd_Subject__Days Más regulariz… 6.18 4.72 8.22 4.10 9.54 Una comparación útil debe separar al menos tres posibles situaciones:
- insensibilidad: las distribuciones posteriores son prácticamente iguales;
- sensibilidad moderada: cambian anchura o colas, pero la interpretación sustantiva principal permanece;
- sensibilidad importante: cantidades centrales o conclusiones predictivas cambian de forma relevante.
En el tercer caso debemos reportar la sensibilidad y reconocer que el conjunto de datos no determina por sí solo la cantidad de interés.
6.16.17.2 Comparar gráficamente la correlación
bind_rows(
  as_draws_df(fit_s6) |>
    transmute(
      rho = cor_Subject__Intercept__Days,
      especificacion = "Principal"
    ),
  as_draws_df(fit_s6_tight) |>
    transmute(
      rho = cor_Subject__Intercept__Days,
      especificacion = "Más regularizadora"
    )
) |>
  ggplot(aes(x = rho, linetype = especificacion)) +
  geom_density(linewidth = 0.9) +
  labs(
    x = expression(rho),
    y = "Densidad posterior",
    linetype = "Previa"
  ) +
  theme_minimal(base_size = 12)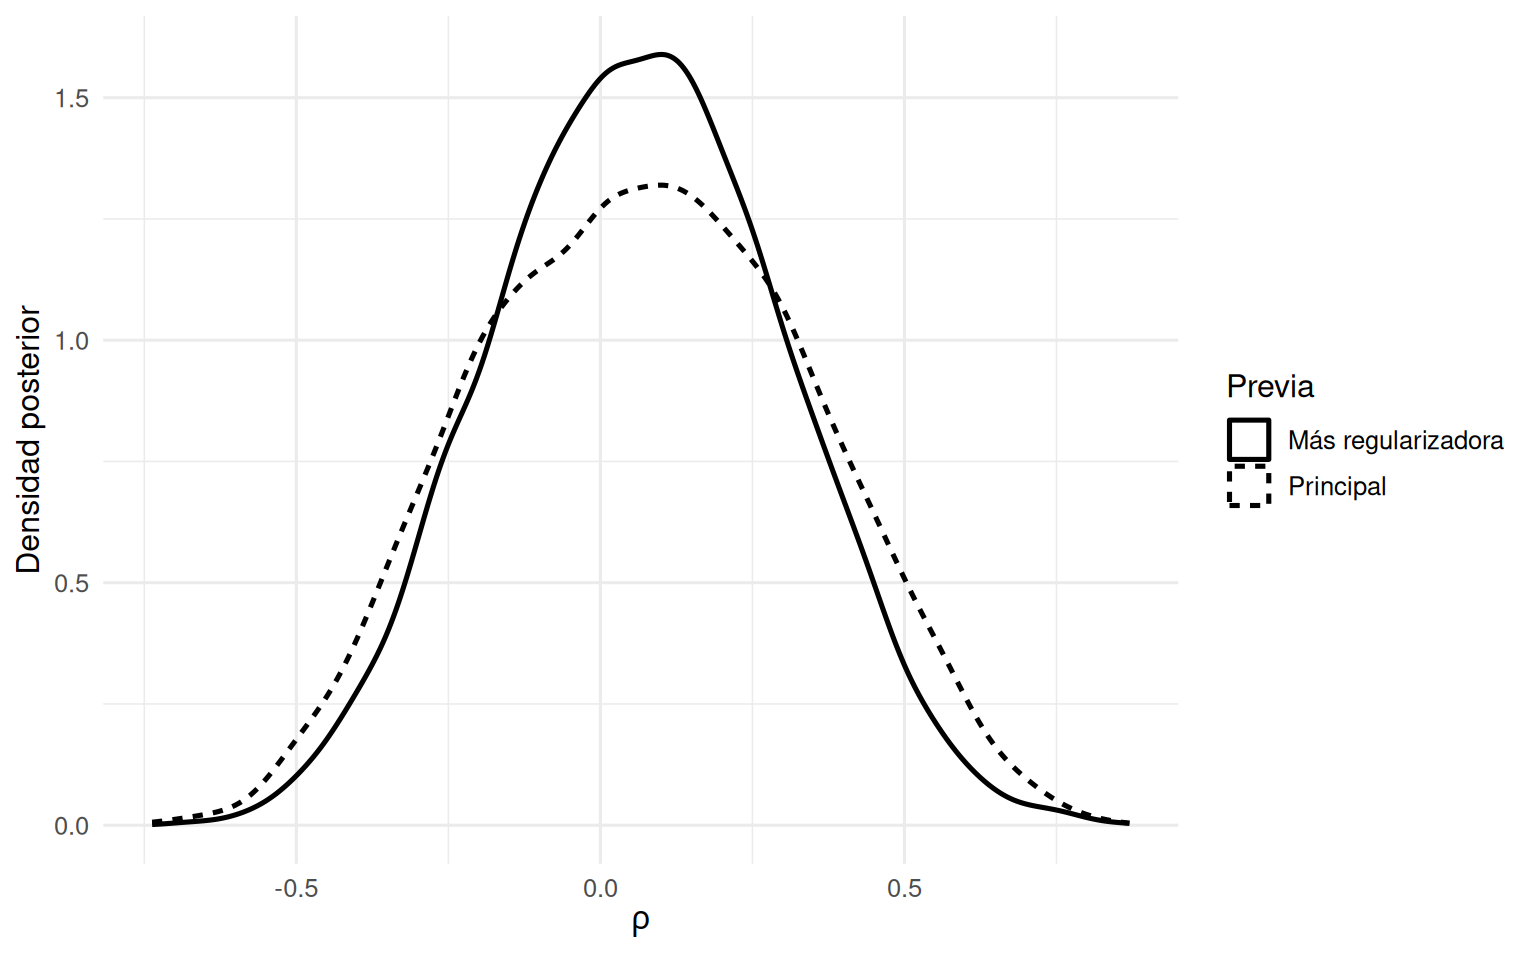
La correlación suele disponer de menos información efectiva que el promedio de la pendiente porque se estima a partir de la población de sujetos, no directamente de las 180 observaciones como si fueran independientes. Esta es una razón para revisar sensibilidad en parámetros jerárquicos incluso cuando el tamaño total de la base parece grande.
6.16.18 Una tabla de previas como parte del análisis
Una práctica reproducible es documentar cada parámetro antes de ajustar el modelo. Para el modelo principal de sleepstudy, una tabla mínima sería:
| Parámetro | Papel en el modelo | Unidades | Previa principal | Justificación |
|---|---|---|---|---|
| \(\mu_\alpha\) | intercepto poblacional | ms | \(\mathcal N(250,100^2)\) | tiempos de reacción de orden de cientos de ms; deja un rango amplio |
| \(\mu_\beta\) | pendiente poblacional | ms/día | \(\mathcal N(0,20^2)\) | cambios de más de unas decenas de ms/día son progresivamente menos plausibles |
| \(\tau_\alpha\) | DE entre interceptos | ms | \(\operatorname{Exponential}(0.02)\) | permite heterogeneidad sustancial, pero reduce masa en escalas enormes |
| \(\tau_\beta\) | DE entre pendientes | ms/día | \(\operatorname{Exponential}(0.05)\) | heterogeneidad de pendientes en orden de decenas de ms/día es posible |
| \(R\) | correlación de coeficientes | — | \(\operatorname{LKJ}(2)\) | modesta regularización hacia correlaciones menos extremas |
| \(\sigma\) | DE residual | ms | \(\operatorname{Exponential}(0.02)\) | variación residual positiva con escala del orden de decenas de ms |
La columna “justificación” es tan importante como la distribución. Una tabla que contiene únicamente código de brms no documenta por qué una previa es apropiada.
TipUna prueba sencilla de documentación
Otra persona debería poder leer la tabla de previas y responder:
- qué significa cada parámetro;
- en qué unidades está expresado;
- qué magnitudes son consideradas ordinarias o extremas;
- qué conocimiento o decisión de regularización motivó la distribución.
6.17 Errores frecuentes
6.17.1 1. Elegir una previa solo porque “se usa mucho”
Una half-Normal, half-\(t\) o exponencial puede ser razonable o absurda según la escala. La familia no reemplaza la justificación.
6.17.2 2. Confundir “ancha” con “no informativa”
Una previa muy ancha puede asignar gran masa a predicciones físicamente imposibles y generar problemas especialmente serios en parámetros de escala jerárquicos.
6.17.3 3. Especificar previas sin revisar las unidades
Normal(0, 1) tiene significados muy distintos para metros, milisegundos, log-odds y respuestas estandarizadas.
6.17.4 4. Olvidar que el centrado cambia el intercepto
Si cambia el punto \(x=0\), cambia la cantidad a la que se aplica la previa del intercepto. Las previas deben revisarse después de transformar predictores.
6.17.5 5. Usar la misma previa para todas las pendientes por conveniencia
Los coeficientes pueden tener unidades distintas. Una previa común solo es defendible si la escala de los predictores hace comparables esas magnitudes o si existe una justificación jerárquica adicional.
6.17.6 6. Usar una distribución normal sin reconocer la restricción positiva
Las desviaciones estándar son no negativas. En brms, la clase sd está restringida a valores positivos; una previa normal centrada en cero sobre esa clase induce efectivamente su parte positiva. La interpretación debe hacerse en ese espacio restringido.
6.17.7 7. Interpretar una previa para \(\tau\) como una previa directa para cada coeficiente grupal
La distribución de \(\tau\) controla la dispersión de la población de coeficientes. Los \(\alpha_j\) o \(\beta_j\) tienen además su propia distribución condicional dada esa escala.
6.17.8 8. Tratar \(\operatorname{LKJ}(1)\) como correlaciones marginalmente uniformes en cualquier dimensión
La uniformidad marginal directa ocurre en el caso \(2\times2\). En dimensiones mayores, la restricción de definición positiva modifica las marginales (Gelman et al. 2026, 84-85).
6.17.9 9. Mirar solo densidades de parámetros
Una colección de densidades previas que parece razonable puede combinarse para producir predicciones absurdas. La comprobación predictiva previa estudia el modelo conjunto.
6.17.10 10. Comparar la predictiva previa con los datos y exigir coincidencia estrecha
La predictiva previa no es una prueba de ajuste al conjunto observado. Debe ser suficientemente amplia para representar incertidumbre pre-datos, pero no tan amplia que acepte escenarios indefendibles.
6.17.11 11. Ajustar la previa hasta obtener una posterior deseada
Revisar una previa por sus implicaciones generativas es parte del modelado. Modificarla porque cambia una conclusión sustantiva en la dirección preferida introduce una forma de selección no declarada.
6.17.12 12. Cambiar muchas previas a la vez en un análisis de sensibilidad
Si todas las distribuciones cambian simultáneamente, resulta difícil identificar qué componente explica las diferencias. Para aprender del modelo, conviene variar primero los componentes potencialmente sensibles.
6.17.13 13. Suponer que una base con muchas filas informa igualmente todos los parámetros
La correlación entre interceptos y pendientes depende principalmente del número y calidad de los grupos; una desviación estándar de pendiente depende de la variación del predictor dentro de grupos. El tamaño total \(n\) no resume toda la información.
6.17.14 14. Confundir sensibilidad con error
Si dos previas razonables producen posteriors sustantivamente distintas, el resultado indica dependencia de supuestos. La respuesta apropiada es comunicarla, no ocultarla.
6.17.15 15. Intentar arreglar una previa absurda aumentando adapt_delta
adapt_delta cambia el comportamiento del algoritmo HMC; no convierte una especificación sustantivamente incoherente en un buen modelo. La semana 7 separará con más detalle las soluciones de modelado y las soluciones computacionales.
6.17.16 16. Adoptar sin inspección las previas predeterminadas del software
Los predeterminados son decisiones generales del paquete. Pueden ser útiles como punto de partida, pero deben revisarse en la escala del problema. Además, pueden cambiar entre versiones.
6.18 Síntesis
La semana 6 cambia la pregunta de “¿cómo ajustamos este modelo?” a “¿qué modelo estamos realmente proponiendo antes de mirar la respuesta?”. Las ideas principales pueden resumirse así:
- Una distribución previa forma parte del modelo generativo. Junto con el modelo de datos determina una distribución predictiva previa.
- Una previa débilmente informativa no es simplemente una distribución muy ancha. Debe excluir regiones claramente incompatibles con la escala del problema sin imponer precisión injustificada.
- La escala precede a la familia. El significado de
Normal(0, 1),Exponential(1)o cualquier otra distribución depende de las unidades y de la parametrización. - Centrar y reescalar predictores cambia la interpretación de interceptos y pendientes y, por tanto, cambia las previas que resultan naturales.
- Los parámetros positivos, como \(\sigma\) y \(\tau\), requieren previas que respeten su soporte. Half-Normal, half-\(t\) y exponencial son posibilidades, no recetas universales.
- Con pocos grupos, una previa excesivamente débil para una desviación estándar jerárquica puede permitir colas irreales y reducir demasiado el pooling (Gelman et al. 2013, sec. 5.7).
- La factorización \(\Sigma=DRD\) permite razonar por separado sobre magnitudes de heterogeneidad y correlaciones.
- La familia LKJ define una distribución válida sobre matrices de correlación. Valores de \(\eta>1\) regularizan hacia matrices menos extremas; su interpretación marginal depende de la dimensión.
- Las previas deben entenderse conjuntamente. Parámetros individualmente razonables pueden combinarse para generar predicciones poco plausibles.
- La comprobación predictiva previa consiste en simular parámetros y datos antes de actualizar con la respuesta y contrastar sus consecuencias con conocimiento sustantivo.
- En modelos multinivel, las comprobaciones deben ser sensibles a la estructura: dispersión entre grupos, trayectorias, pendientes y cantidades predictivas grupales.
- El análisis de sensibilidad compara especificaciones alternativas que ya son defendibles. Si la posterior cambia de manera importante, esa dependencia de supuestos debe formar parte de la comunicación.
brmspermite inspeccionar las clases de parámetros conget_prior(), especificar previas explícitas y simular solo desde la previa consample_prior = "only".- El flujo recomendado no es una lista de previas, sino una iteración entre conocimiento, parametrización, simulación, crítica y ajuste.
La idea central puede condensarse en una pregunta que conviene hacer antes de cada ajuste:
Si estas distribuciones representan realmente lo que el modelo considera posible antes de observar la respuesta, ¿estoy dispuesto a defender los datos que generan?
6.19 Ejercicios
6.19.1 Ejercicios conceptuales
6.19.1.1 Ejercicio 1. Misma previa numérica, distintas unidades
Considere dos regresiones gaussianas:
\[ y_i=\alpha+\beta_1x_{1i}+\varepsilon_i, \]
\[ y_i=\alpha+\beta_2x_{2i}+\varepsilon_i, \]
con \(y\) medido en milisegundos. \(x_1\) representa edad en años y \(x_2\) edad en días.
Una persona propone
\[ \beta_1,\beta_2\sim\mathcal N(0,10^2). \]
- Explique por qué las dos previas no expresan el mismo conocimiento sustantivo.
- Derive la relación entre los coeficientes cuando \(x_2=365.25x_1\).
- Proponga una forma de transformar la previa de \(\beta_1\) para obtener una previa coherente para \(\beta_2\).
6.19.1.2 Ejercicio 2. Intercepto y centrado
Un modelo usa
\[ y_{ij}=\alpha_j+\beta x_{ij}+\varepsilon_{ij}, \]
con edad \(x\) medida en años y observada solo entre 50 y 80 años.
- ¿Qué representa \(\alpha_j\)?
- ¿Por qué puede ser difícil especificar una previa sustantiva para \(\alpha_j\)?
- Centre edad en 65 años y derive el nuevo intercepto.
- Explique cómo cambiaría su estrategia de previa.
6.19.1.3 Ejercicio 3. Pocos grupos y una previa para \(\tau\)
Considere
\[ y_{ij}\sim\mathcal N(\alpha_j,\sigma^2), \qquad \alpha_j\sim\mathcal N(\mu_\alpha,\tau^2), \]
con solo \(J=4\) grupos.
Compare conceptualmente estas dos previas:
\[ \tau\sim\operatorname{HalfNormal}(0,5^2), \]
\[ \tau\sim\operatorname{HalfNormal}(0,500^2). \]
Suponga que la respuesta normalmente varía entre 0 y 20. Discuta sus consecuencias para:
- diferencias posibles entre grupos;
- intensidad del pooling;
- distribución predictiva previa;
- sensibilidad posterior esperada.
6.19.1.4 Ejercicio 4. LKJ y dimensión
Explique por qué no es correcto afirmar:
“\(R\sim\operatorname{LKJ}(1)\) significa que cada correlación individual es Uniforme\((-1,1)\), sin importar cuántos coeficientes variables tenga el modelo.”
Su respuesta debe distinguir el caso \(K=2\) del caso \(K>2\) y mencionar la restricción de definición positiva.
6.19.1.5 Ejercicio 5. ¿Previa o posterior predictive check?
Para cada una de las siguientes preguntas, indique si corresponde principalmente a una comprobación predictiva previa, posterior o a ambas. Justifique.
- ¿El modelo asigna probabilidad apreciable a tiempos negativos antes de observar datos?
- ¿Las réplicas del modelo ajustado reproducen la asimetría de los datos?
- ¿Las previas permiten diferencias entre escuelas de cientos de desviaciones estándar?
- ¿El modelo ajustado reproduce la dispersión de medias entre grupos?
- ¿La combinación de 30 coeficientes con previas independientes produce predicciones extremas?
6.19.1.6 Ejercicio 6. Sensibilidad no es búsqueda de significancia
Un análisis produce una posterior para \(\beta\) cuya mediana es positiva, pero el intervalo de 95% incluye cero. La persona analista prueba varias previas hasta encontrar una cuyo intervalo queda completamente por encima de cero y reporta solo esa versión.
- Explique por qué esto no constituye un análisis de sensibilidad adecuado.
- Describa cómo debería definirse un conjunto de previas alternativas antes de comparar resultados.
- ¿Qué debería comunicarse si las conclusiones cambian entre alternativas razonables?
6.19.2 Ejercicios computacionales
6.19.2.1 Ejercicio 7. Construir una comprobación predictiva previa desde cero
Use el modelo
\[ y_{ij}\sim\mathcal N(\alpha_j+\beta_jx_{ij},\sigma^2) \]
con 15 grupos y \(x\in[-2,2]\).
- Proponga previas para \(\mu_\alpha\), \(\mu_\beta\), \(\tau_\alpha\), \(\tau_\beta\), \(\rho\) y \(\sigma\).
- Simule al menos 2000 conjuntos de parámetros.
- Genere familias de rectas para cinco grupos nuevos por conjunto.
- Defina dos estadísticas predictivas sensibles a la heterogeneidad entre grupos.
- Revise al menos una de sus previas y documente la razón.
6.19.2.2 Ejercicio 8. Reescalamiento y previas
Simule una regresión con predictor x_m medido en metros. Cree x_cm = 100 * x_m.
- Ajuste conceptualmente la previa de la pendiente para que los dos modelos expresen exactamente el mismo conocimiento.
- Verifique mediante simulación predictiva previa que las distribuciones de \(y\) son equivalentes.
- Muestre qué ocurre si usa la misma
normal(0, 1)para ambas pendientes sin transformar.
6.19.2.3 Ejercicio 9. Comparar familias para una desviación estándar
Para una respuesta cuya escala plausible es aproximadamente 0–100, compare:
\[ \tau\sim\operatorname{HalfNormal}(0,10^2), \]
\[ \tau\sim\operatorname{Half}t_3(0,10), \]
\[ \tau\sim\operatorname{Exponential}(0.1). \]
- Simule 100000 valores de cada previa.
- Compare medianas y cuantiles 90%, 95% y 99%.
- Para \(\alpha_j\sim\mathcal N(50,\tau^2)\), simule diferencias entre dos grupos.
- Discuta qué distribución asigna más masa a heterogeneidades extremas.
6.19.2.4 Ejercicio 10. get_prior() y valores predeterminados
Elija uno de los modelos de las semanas 2–5.
- Use
get_prior()para identificar todas las clases de parámetros. - Guarde la salida junto con
packageVersion("brms"). - Indique qué previas aparecen explícitamente y cuáles deben ser reemplazadas por decisiones propias.
- Construya una tabla con parámetro, clase de
brms, unidades y previa propuesta.
El objetivo es documentar la versión del software, no memorizar sus predeterminados.
6.19.2.5 Ejercicio 11. Predictiva previa global versus grupal
Con el modelo sleepstudy de este capítulo:
- simule 500 réplicas desde la previa principal;
- calcule la desviación estándar global de
Reactionen cada réplica; - calcule la desviación estándar de las medias por
Subject; - calcule la desviación estándar de las pendientes estimadas por sujeto mediante las cantidades latentes del modelo;
- explique qué aspecto del modelo detecta cada estadística y cuál podría ocultar problemas de heterogeneidad.
6.19.2.6 Ejercicio 12. Sensibilidad de \(\tau_\beta\)
Ajuste el modelo sleepstudy con estas tres previas para la desviación estándar de pendientes:
\[ \tau_\beta\sim\operatorname{Exponential}(0.02), \]
\[ \tau_\beta\sim\operatorname{Exponential}(0.05), \]
\[ \tau_\beta\sim\operatorname{Exponential}(0.10). \]
Mantenga todas las demás decisiones fijas.
- Compare previa y posterior de \(\tau_\beta\).
- Compare la posterior de \(\mu_\beta\).
- Compare predicciones para un sujeto nuevo.
- Determine qué conclusión es más sensible y explique por qué.
6.19.2.7 Ejercicio 13. Un ejemplo de previa conjunta problemática
Simule una regresión estandarizada con \(K=5,20,50\) predictores independientes y
\[ \beta_k\sim\mathcal N(0,1). \]
Para cada \(K\):
- simule el predictor lineal \(\eta=X\beta\) para una matriz \(X\) con columnas estandarizadas;
- compare la desviación estándar y los extremos de \(\eta\);
- explique por qué una previa idéntica para cada coeficiente no conserva una previa idéntica sobre predicciones al aumentar \(K\);
- proponga una estrategia de regularización dependiente de \(K\) y compruébela mediante simulación.
6.20 Referencias de la semana
Las lecturas centrales para esta unidad son:
- Gelman et al., Bayesian Data Analysis, sección 5.7 para previas débilmente informativas sobre parámetros de varianza jerárquicos (Gelman et al. 2013, 128-32).
- Gelman et al., Bayesian Workflow, capítulo 5 para construcción del modelo, previas y comprobación predictiva previa; capítulo 6 para experimentación mediante simulación; y capítulo 17 para el estudio de especificación de previas en regresión lineal y multinivel (Gelman et al. 2026, chaps. 5-6, 17).
- McElreath, Statistical Rethinking, capítulo 7 para regularización y capítulos 13–14 para regularización adaptativa, coeficientes variables y matrices de correlación (McElreath 2020, chaps. 7, 13-14).
- Bürkner, para la estructura de las previas en
brms, la separación entre desviaciones estándar y correlaciones y la sintaxis general de especificación (Bürkner 2017).