Al finalizar este capítulo, se espera que el estudiantado pueda:
explicar la idea de memoria decreciente que subyace al suavizamiento exponencial;
derivar la representación de promedio ponderado del suavizamiento exponencial simple (SES) y describir el papel del parámetro \(\alpha\);
interpretar SES como una actualización del nivel proporcional al error de pronóstico más reciente;
distinguir entre el nivel \(\ell_t\), la tendencia local \(b_t\) y el componente estacional \(s_t\);
formular e interpretar el método lineal de Holt;
explicar el problema de extrapolar indefinidamente una tendencia local y derivar el pronóstico con tendencia amortiguada;
formular los métodos de Holt–Winters con estacionalidad aditiva y multiplicativa;
decidir conceptualmente cuándo una representación estacional aditiva o multiplicativa es razonable;
distinguir un algoritmo de suavizamiento exponencial de un modelo estadístico ETS;
interpretar la notación ETS\((E,T,S)\) y los componentes de error, tendencia y estacionalidad;
demostrar la equivalencia entre SES y el modelo de innovaciones ETS\((A,N,N)\) para los pronósticos puntuales;
explicar por qué una formulación probabilística permite construir distribuciones e intervalos predictivos;
describir el papel de los estados iniciales y de los parámetros de suavizamiento en la estimación;
explicar cómo la verosimilitud de un modelo ETS se construye secuencialmente a partir de las innovaciones;
seleccionar y diagnosticar modelos ETS mediante fable, sin tratar la selección automática como sustituto de la interpretación estadística;
comparar ETS con métodos de referencia y ARIMA bajo una partición entrenamiento–prueba;
evaluar ETS mediante validación con origen móvil usando MAE, RMSE, MASE, cobertura y amplitud de intervalos;
reconocer a ETS como un primer puente intuitivo hacia los modelos de espacio-estado que se estudiarán formalmente en las semanas 11–13.
En Sección 7.19 establecimos que una comparación predictiva responsable debe fijar el origen, el horizonte, los métodos de referencia y la información disponible antes de observar el período de evaluación. Esta semana aplicaremos ese protocolo a una familia de métodos cuya lógica es distinta de ARIMA.
En un ARIMA describimos la dinámica mediante rezagos de la serie y de sus innovaciones. En suavizamiento exponencial adoptaremos otra perspectiva: resumiremos el pasado mediante componentes que evolucionan en el tiempo, como un nivel local, una pendiente local y un patrón estacional. La guía bibliográfica del curso asigna esta semana a suavizamiento exponencial y modelos ETS, con Hyndman y Athanasopoulos como texto conductor (Hyndman y Athanasopoulos 2021, chap. 8). Petris, Petrone y Campagnoli proporcionan un complemento importante al mostrar cómo los algoritmos clásicos de suavizamiento pueden conectarse con modelos dinámicos (Petris et al. 2009, sec. 3.1).
8.2 De los métodos de referencia a la memoria decreciente
Suponga que una serie no presenta una tendencia sistemática ni un patrón estacional claro. Dos métodos de referencia de Sección 7.4 representan extremos conceptuales.
El método naïve utiliza solamente la observación más reciente:
Ambas reglas pueden ser inadecuadas cuando la estructura cambia gradualmente. El primer método descarta casi todo el pasado; el segundo conserva observaciones antiguas con el mismo peso que observaciones recientes.
El suavizamiento exponencial propone una solución intermedia:
conservar todo el pasado, pero reducir geométricamente su influencia conforme envejece.
Esta idea es fundamental. El adjetivo exponencial no se refiere a que la serie observada tenga que crecer exponencialmente. Se refiere a la forma de los pesos asignados a observaciones pasadas(Hyndman y Athanasopoulos 2021, sec. 8.1).
8.3 Suavizamiento exponencial simple
El suavizamiento exponencial simple (SES, simple exponential smoothing) está diseñado para series cuyo comportamiento puede resumirse mediante un nivel que evoluciona, sin una tendencia o estacionalidad que deban extrapolarse explícitamente.
8.3.1 Forma recursiva
Sea \(\ell_t\) el nivel estimado después de observar \(y_t\). La ecuación de actualización es
Por tanto, SES genera una función de pronóstico plana. Esto no significa que el nivel histórico haya sido constante: \(\ell_t\) puede cambiar cada vez que llega una nueva observación. Significa que, una vez fijado el origen \(t\), no extrapolamos una pendiente ni un patrón estacional hacia \(t+h\).
El parámetro \(\alpha\) controla la rapidez de adaptación:
si \(\alpha\) es cercano a uno, \(\ell_t\) reacciona con fuerza a la observación nueva;
si \(\alpha\) es pequeño, el nivel cambia lentamente y conserva mayor memoria del pasado;
si \(\alpha=1\), entonces \(\ell_t=y_t\) y SES coincide con el pronóstico naïve.
8.3.2 ¿De dónde salen los pesos exponenciales?
La interpretación más importante se obtiene expandiendo recursivamente Ecuación 8.3. Primero,
Al agregar el peso \((1-\alpha)^t\) asignado al estado inicial \(\ell_0\), los pesos de Ecuación 8.5 suman exactamente uno.
NotaEl estado inicial también tiene peso
En muestras cortas no debemos omitir el término \((1-\alpha)^t\ell_0\). La representación como promedio infinito es una aproximación útil cuando \(t\) es grande y \((1-\alpha)^t\) es despreciable, pero la recursión real debe comenzar con algún valor inicial.
8.3.3 Visualización de los pesos
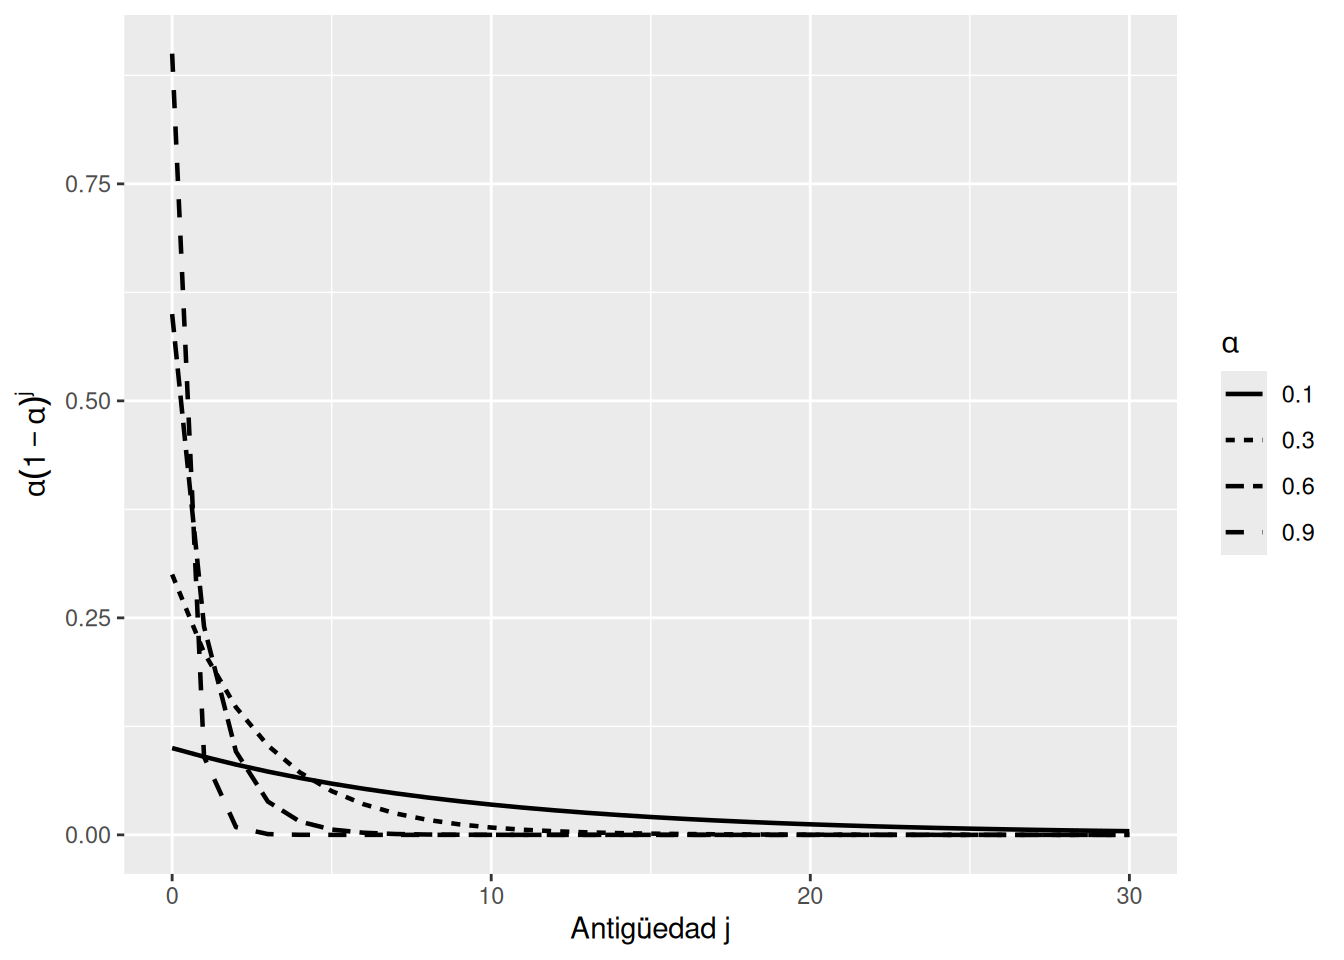
El siguiente gráfico muestra cuánto peso recibe una observación situada \(j\) períodos en el pasado.
Figura 8.1: Pesos geométricos del suavizamiento exponencial simple para cuatro valores de alpha. Valores grandes de alpha concentran la memoria en las observaciones más recientes.
8.3.4 Respuesta ante un cambio de nivel
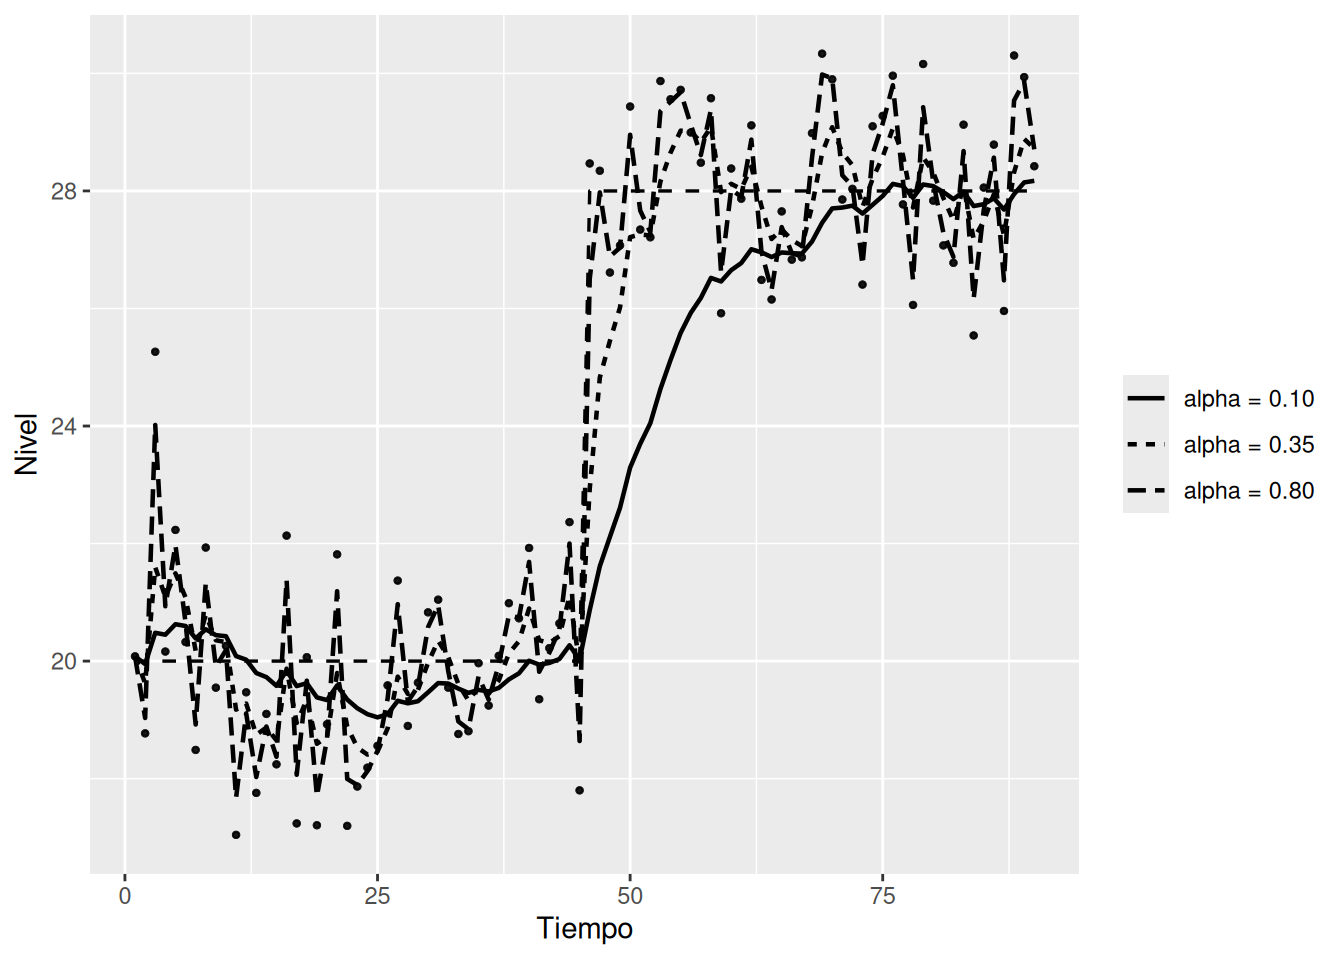
Para hacer visible el compromiso entre estabilidad y adaptación, simularemos una serie cuyo nivel cambia abruptamente. No suponemos que SES sea el modelo verdadero; la simulación se utiliza únicamente para estudiar la recursión.
Figura 8.2: Respuesta del nivel suavizado ante un cambio abrupto. Un alpha pequeño produce mayor suavización pero una adaptación más lenta.
Un valor grande de \(\alpha\) no es universalmente mejor. Permite adaptación rápida, pero también transmite con mayor intensidad el ruido de cada observación al estado actualizado. El valor apropiado debe determinarse en función de los datos y del objetivo predictivo.
8.4 La forma de corrección por innovación
La recursión de SES puede reescribirse de una forma que será esencial más adelante. El pronóstico de un paso antes de observar \(y_t\) es
La “nueva información” es la parte de \(y_t\) que no estaba anticipada por \(\ell_{t-1}\). Esta estructura aparecerá nuevamente en los modelos de espacio-estado y en el filtro de Kalman, aunque todavía no desarrollaremos formalmente ese filtro.
ImportanteSuavizar no significa ajustar una curva a toda la muestra
\(\ell_t\) es un estado actualizado secuencialmente. No es el valor de una curva global estimada una sola vez utilizando todos los tiempos. La distinción será importante cuando estudiemos filtrado y suavizamiento retrospectivo en modelos de espacio-estado.
8.5 Estimación en SES: parámetros y estado inicial
Para ejecutar SES debemos conocer al menos
\[
\alpha
\quad\text{y}\quad
\ell_0.
\]
Una forma clásica de estimarlos es minimizar la suma de cuadrados de los errores de un paso:
La dependencia de \(e_t\) respecto de \(\alpha\) y \(\ell_0\) es recursiva, por lo que el problema se resuelve numéricamente (Hyndman y Athanasopoulos 2021, sec. 8.1).
Dos mensajes son importantes:
\(\alpha\)se estima; no debe escogerse únicamente por apariencia gráfica;
\(\ell_0\) también forma parte del ajuste y puede tener efecto importante en muestras cortas.
Más adelante reemplazaremos la minimización de SSE por la estimación mediante verosimilitud dentro de un modelo probabilístico ETS.
8.6 Tendencia local: método de Holt
SES produce pronósticos planos. Si una serie muestra una tendencia persistente durante el intervalo de interés, necesitamos un segundo estado que describa la pendiente local.
con \(0\leq\alpha\leq1\) y \(0\leq\beta^*\leq1\) en la parametrización clásica.
8.6.1 Interpretación del nivel
Antes de observar \(y_t\), el nivel esperado a partir del estado anterior sería
\[
\ell_{t-1}+b_{t-1}.
\]
La ecuación Ecuación 8.12 combina ese valor extrapolado con la observación nueva. Por ello, \(\ell_t\) no es simplemente una media suavizada de \(y_t\); incorpora la pendiente que se esperaba entre \(t-1\) y \(t\).
8.6.2 Interpretación de la tendencia
La cantidad
\[
\ell_t-\ell_{t-1}
\]
es el cambio reciente del nivel estimado. Ecuación 8.13 combina ese cambio con la pendiente previa \(b_{t-1}\).
Por tanto, \(b_t\) es una pendiente que evoluciona. No debe interpretarse como el coeficiente fijo de una regresión lineal global.
8.6.3 Ejemplo: uso de internet
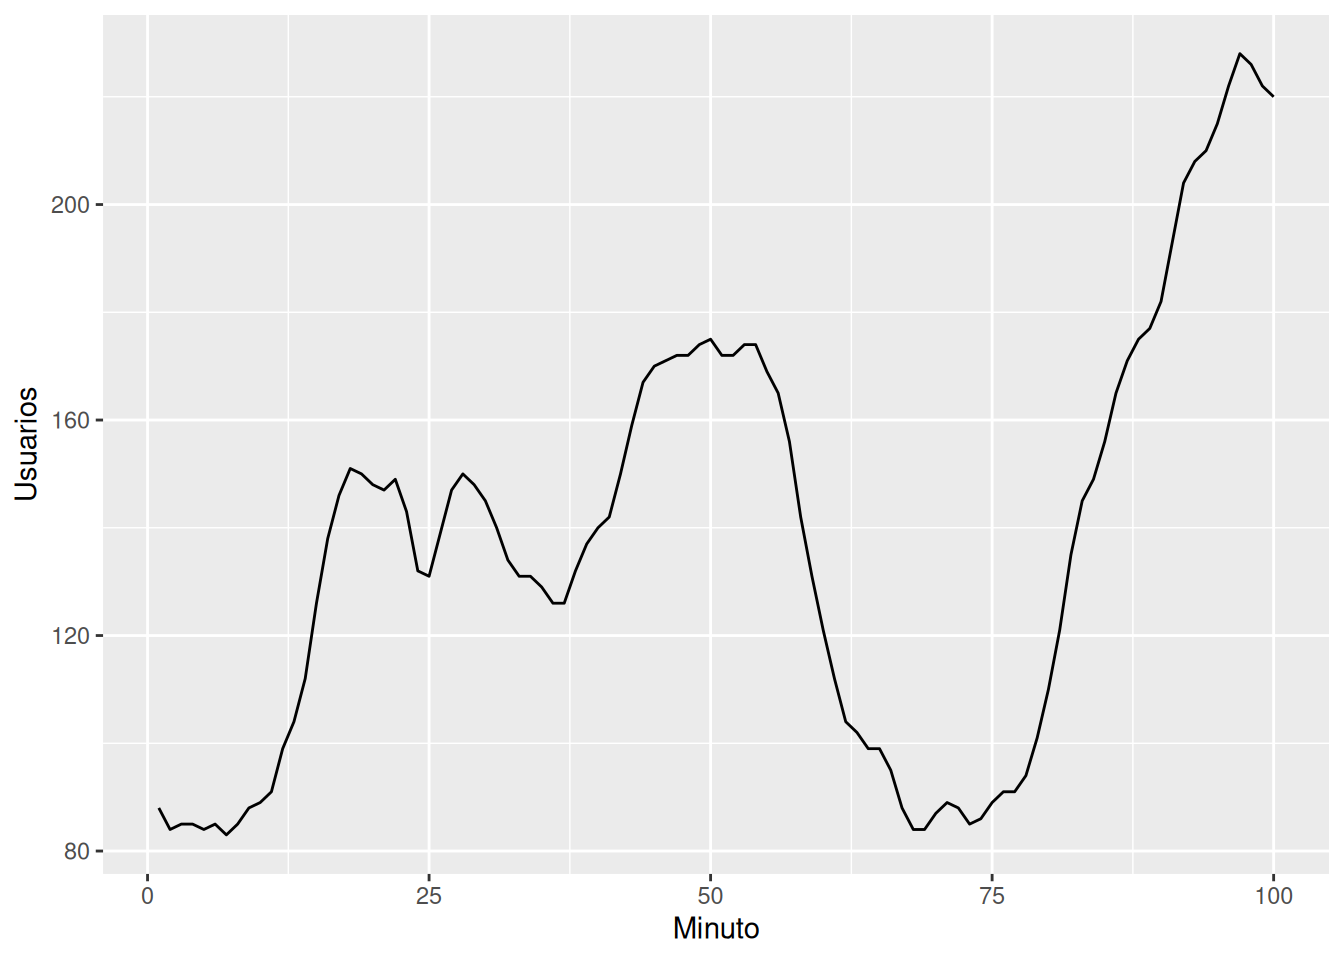
Utilizamos la serie WWWusage, incluida en R, para comparar SES, Holt y Holt con tendencia amortiguada. La serie no es estacional y presenta cambios claros en su nivel y pendiente.
Figura 8.3: Número de usuarios conectados a un servidor en 100 minutos. La pendiente local cambia durante la serie, por lo que un pronóstico de nivel constante puede ser demasiado restrictivo.
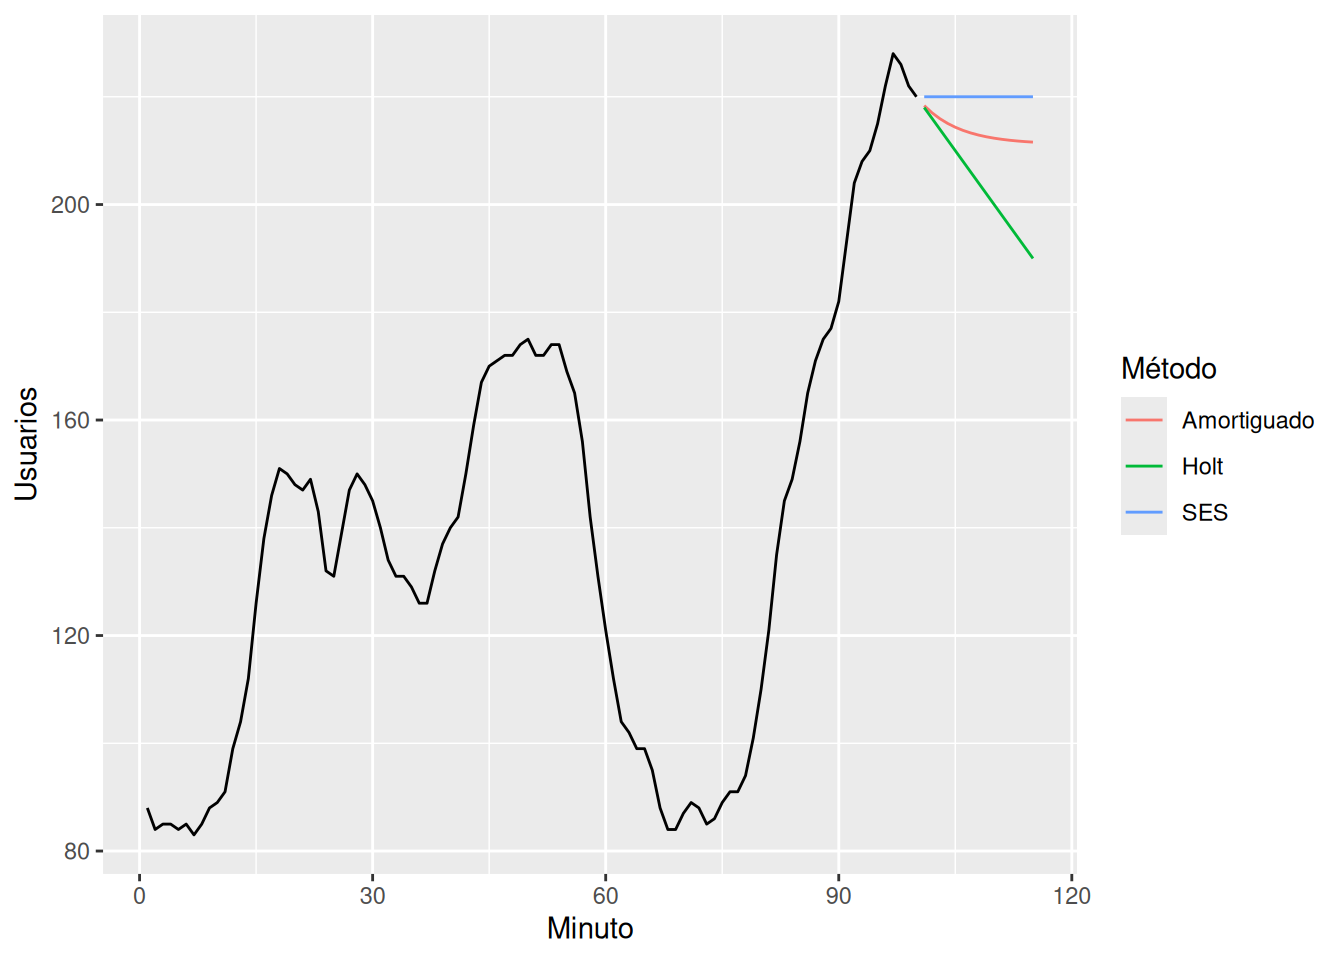
Ajustamos tres especificaciones de error aditivo para aislar el efecto del componente de tendencia.
Figura 8.4: Pronósticos de SES, Holt y Holt amortiguado para la serie de uso de internet. SES produce una trayectoria plana; Holt prolonga la pendiente; el método amortiguado reduce gradualmente el efecto de la pendiente.
No debemos seleccionar el método mirando solamente cuál extensión gráfica parece más plausible. Siguiendo Sección 7.8, podemos comparar pronósticos de un paso con orígenes sucesivos.
knitr::kable( acc_www,digits =3,caption ="Evaluación de un paso con origen móvil para tres métodos de suavizamiento no estacionales.")
Tabla 8.1: Evaluación de un paso con origen móvil para tres métodos de suavizamiento no estacionales.
.model
RMSE
MAE
MASE
Amortiguado
3.064
2.563
0.566
Holt
3.286
2.850
0.630
SES
5.685
4.600
1.017
La tabla debe leerse como evidencia específica para esta serie, este horizonte y este diseño de validación. No establece un orden universal entre los tres métodos.
8.7 Tendencia amortiguada
El pronóstico de Holt en Ecuación 8.11 mantiene la pendiente \(b_t\) indefinidamente. Para un horizonte grande,
\[
\widehat y_{t+h\mid t}=\ell_t+h b_t
\]
puede producir extrapolaciones poco plausibles, especialmente cuando \(b_t\) representa solamente una tendencia local reciente.
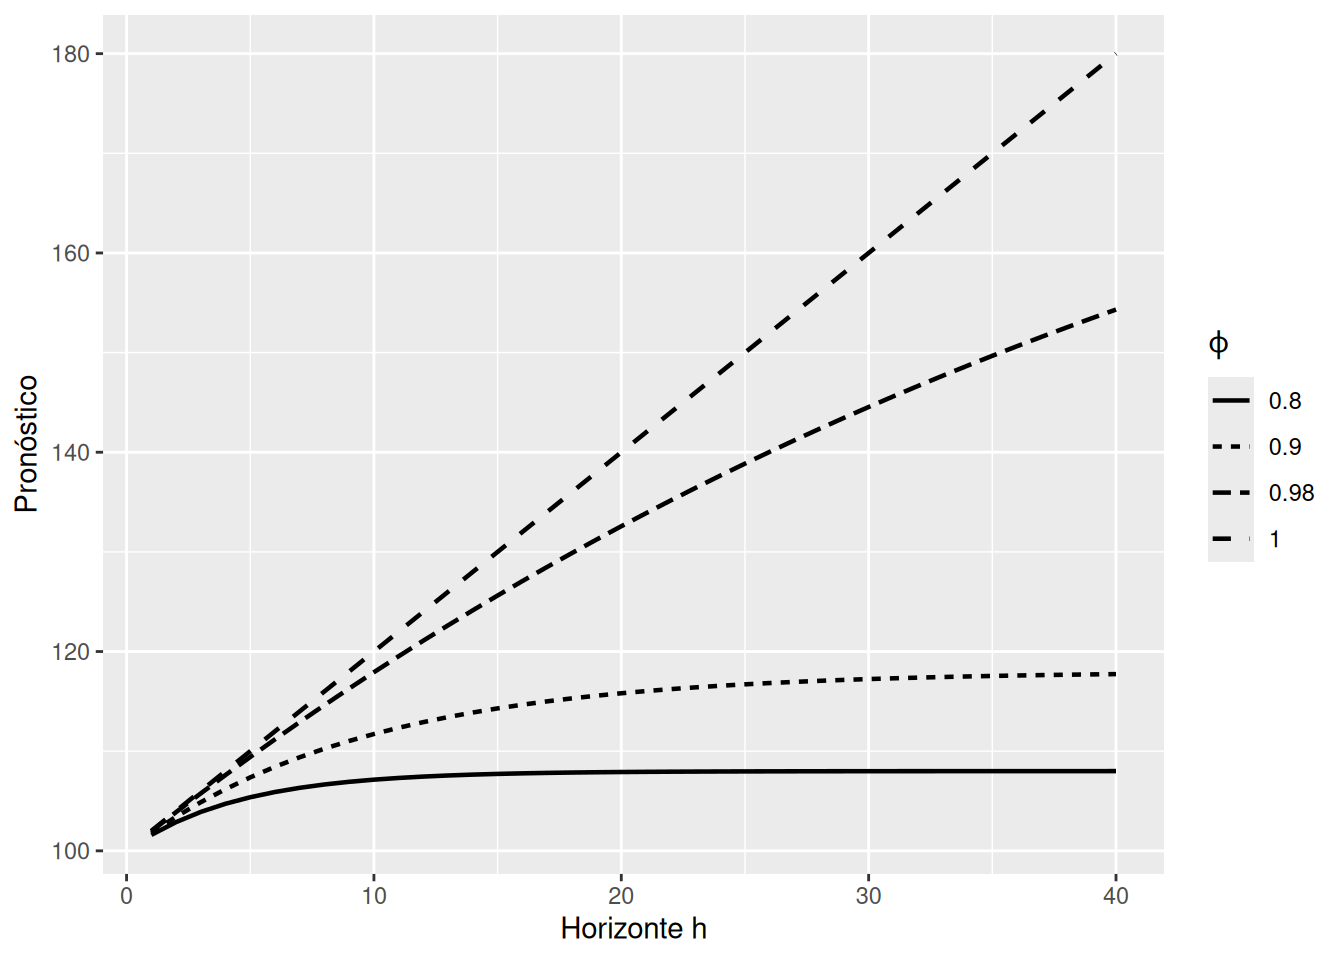
El método amortiguado no obliga a que la serie futura se vuelva constante en realidad. Lo que hace es evitar que la pendiente estimada hoy se extrapole sin reducción para siempre.
Figura 8.5: Efecto del amortiguamiento sobre una misma pendiente local. Cuando phi es menor que uno, la contribución acumulada de la tendencia se estabiliza conforme aumenta el horizonte.
8.8 Incorporación de la estacionalidad: Holt–Winters
Sea \(m\) el período estacional. Para datos mensuales con estacionalidad anual, \(m=12\); para datos trimestrales, \(m=4\).
El método de Holt–Winters agrega un estado \(s_t\) que describe el patrón estacional. Existen dos formas principales.
8.8.1 Estacionalidad aditiva
La formulación aditiva es adecuada cuando las oscilaciones estacionales tienen una amplitud aproximadamente constante en las unidades originales de la serie (Hyndman y Athanasopoulos 2021, sec. 8.3).
El índice \(k\) asegura que, para horizontes superiores a un ciclo estacional, reutilicemos la posición estacional correspondiente del último ciclo estimado.
La ecuación de nivel utiliza una observación desestacionalizada,
\[
y_t-s_{t-m},
\]
y la ecuación estacional compara la observación nueva con el nivel y tendencia que habrían sido esperados sin estacionalidad.
8.8.2 Estacionalidad multiplicativa
Cuando la amplitud estacional crece o disminuye aproximadamente en proporción con el nivel, una representación multiplicativa puede ser más natural:
Aquí \(s_t\) es un factor relativo, no una desviación en las unidades de \(y_t\).
AdvertenciaLa multiplicación exige cuidado con la escala
Una formulación multiplicativa no es adecuada cuando los datos pueden ser negativos y puede ser problemática cuando contienen ceros. Además, “la amplitud parece aumentar” no basta para elegirla: una transformación como el logaritmo o Box–Cox puede ofrecer otra representación razonable. La decisión debe considerar interpretación, ajuste y desempeño predictivo.
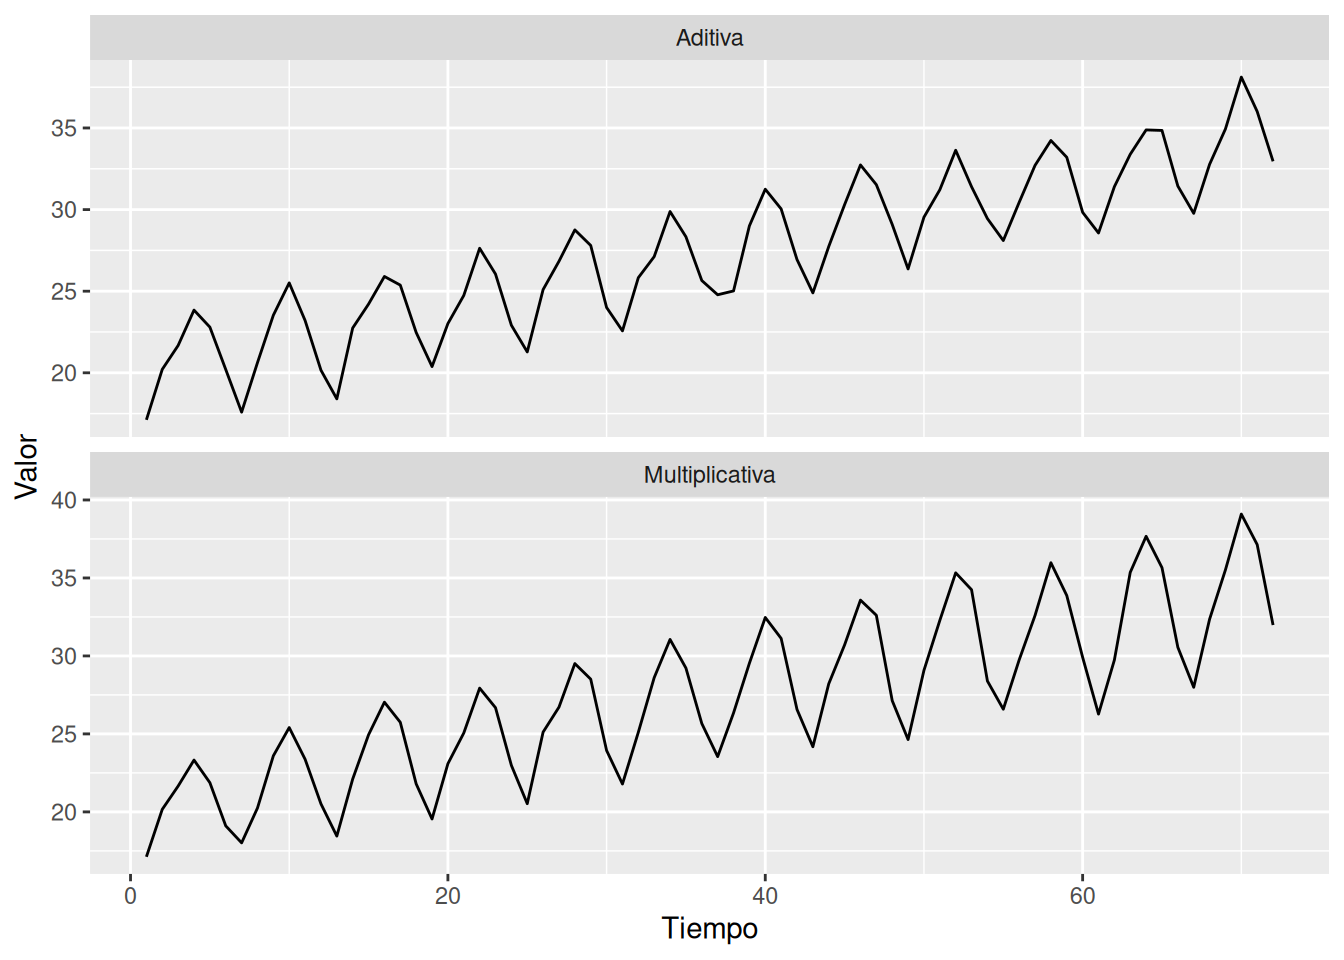
8.8.3 Aditivo y multiplicativo no significan “pequeño” y “grande”
La distinción se refiere a cómo cambia la amplitud estacional con el nivel.
Figura 8.6: Dos mecanismos estacionales simulados. En el caso aditivo la amplitud permanece aproximadamente constante; en el multiplicativo aumenta junto con el nivel.
8.9 Taxonomía de los métodos de suavizamiento
Antes de introducir ETS conviene separar dos clasificaciones.
Tabla 8.2: Taxonomía de métodos de suavizamiento exponencial según tendencia y estacionalidad.
Tendencia
Sin estacionalidad (N)
Estacionalidad aditiva (A)
Estacionalidad multiplicativa (M)
Ninguna (N)
SES: (N,N)
(N,A)
(N,M)
Aditiva (A)
Holt: (A,N)
Holt-Winters aditivo: (A,A)
Holt-Winters multiplicativo: (A,M)
Aditiva amortiguada (Ad)
Holt amortiguado: (Ad,N)
(Ad,A)
Holt-Winters amortiguado: (Ad,M)
Esta clasificación todavía describe algoritmos que generan pronósticos puntuales. No especifica una distribución para \(Y_t\).
8.10 Del algoritmo al modelo estadístico
El paso conceptual decisivo consiste en preguntar:
¿qué proceso probabilístico podría generar observaciones de manera compatible con estas recursiones?
Los métodos de suavizamiento producen pronósticos puntuales. Un modelo estadístico debe especificar, además, cómo surge la incertidumbre alrededor de esos pronósticos. Esto permite construir verosimilitudes, distribuciones predictivas e intervalos (Hyndman y Athanasopoulos 2021, secs. 8.5–8.7).
La formulación ETS utiliza modelos de espacio-estado de innovaciones. Cada modelo contiene:
una ecuación de observación, que relaciona \(Y_t\) con los estados anteriores y una innovación;
ecuaciones de estado, que actualizan nivel, tendencia y estacionalidad después de observar la innovación.
La notación es
\[
\operatorname{ETS}(E,T,S),
\tag{8.27}\]
con
\(E\in\{A,M\}\): error aditivo o multiplicativo;
\(T\in\{N,A,A_d\}\): sin tendencia, tendencia aditiva o tendencia aditiva amortiguada;
\(S\in\{N,A,M\}\): sin estacionalidad, estacionalidad aditiva o multiplicativa.
ImportanteMétodo y modelo no son sinónimos
Por ejemplo, SES es un método de pronóstico. ETS\((A,N,N)\) y ETS\((M,N,N)\) son dos modelos probabilísticos que pueden generar el mismo tipo de pronóstico puntual de SES, pero implican estructuras de incertidumbre diferentes.
8.11 ETS\((A,N,N)\): SES como modelo de innovaciones
Hemos recuperado exactamente la recursión SES de Ecuación 8.3.
Esta derivación muestra que el suavizamiento puede verse como una actualización dirigida por una innovación aleatoria. La ecuación de observación especifica la distribución de esa innovación y convierte al algoritmo en un modelo probabilístico.
8.11.1 Distribución predictiva de un paso
Condicionalmente a los parámetros y al estado \(\ell_t\),
sino de una distribución para la observación futura.
Para horizontes mayores, la incertidumbre se propaga porque las innovaciones futuras también modifican los estados futuros. Este principio será central en modelos de espacio-estado.
por lo que la innovación mide un error relativo. Si el nivel crece, una innovación del mismo tamaño relativo genera una desviación absoluta mayor.
ETS\((A,N,N)\) y ETS\((M,N,N)\) pueden producir pronósticos puntuales de tipo SES, pero no producen la misma distribución predictiva. En el modelo multiplicativo, la escala de la incertidumbre depende del nivel.
8.13 Holt en forma de innovaciones
El mismo principio permite reescribir Holt. Defina el error de un paso como
Nota\(\beta^*\) y \(\beta\) no son necesariamente el mismo parámetro numérico
En las ecuaciones clásicas del método de Holt hemos usado \(\beta^*\). En la representación de innovaciones es conveniente usar \(\beta=\alpha\beta^*\). Cuando un programa reporta parámetros ETS, debemos verificar qué parametrización utiliza antes de interpretar directamente el número.
Esta equivalencia es un ejemplo concreto de por qué el lenguaje de estados será útil: nivel y tendencia pueden actualizarse conjuntamente utilizando la misma innovación observada.
8.14 Verosimilitud mediante innovaciones
Una de las ventajas de la formulación probabilística es que podemos estimar los parámetros mediante máxima verosimilitud (Hyndman y Athanasopoulos 2021, sec. 8.6).
8.14.1 Error aditivo
Suponga que, dados los estados iniciales y los parámetros, el modelo produce un pronóstico de un paso
para un vector \(\theta\) que contiene parámetros de suavizamiento, estados iniciales y parámetros de escala.
La log-verosimilitud aditiva contiene el término
\[
-\frac{1}{2\sigma^2}
\sum_{t=1}^{T}e_t^2.
\]
Por ello, bajo normalidad y para una especificación aditiva, maximizar la verosimilitud está estrechamente relacionado con minimizar SSE (Hyndman y Athanasopoulos 2021, sec. 8.6).
8.14.2 ¿Por qué el error multiplicativo cambia el problema?
Con error multiplicativo,
\[
Y_t=\mu_t(1+\varepsilon_t),
\]
y entonces
\[
\varepsilon_t=\frac{y_t}{\mu_t}-1.
\]
Si \(\varepsilon_t\sim N(0,\sigma^2)\) y \(\mu_t\neq0\), el cambio de variable introduce
Aparece el factor \(1/|\mu_t|\). Por ello, la estimación por verosimilitud de un modelo con error multiplicativo no equivale simplemente a minimizar una suma de cuadrados de errores absolutos.
Esta diferencia es una de las razones por las que conviene distinguir el algoritmo de suavizamiento del modelo estadístico que lo sustenta.
8.15 Parámetros, estados iniciales y selección
Un modelo ETS puede involucrar:
\(\alpha\): actualización del nivel;
\(\beta\) o \(\beta^*\): actualización de la tendencia;
\(\gamma\): actualización estacional;
\(\phi\): amortiguamiento;
\(\ell_0\): nivel inicial;
\(b_0\): tendencia inicial;
estados estacionales iniciales;
\(\sigma^2\) u otro parámetro de escala asociado con las innovaciones.
La estimación no consiste, por tanto, en ajustar únicamente dos o tres coeficientes. Los estados iniciales también deben determinarse.
Dentro del marco ETS, modelos diferentes pueden compararse mediante criterios de información como AIC, AICc y BIC (Hyndman y Athanasopoulos 2021, sec. 8.6). La lógica es la misma estudiada en Sección 4.9: recompensar ajuste mediante la verosimilitud, pero penalizar complejidad.
Aquí \(k\) debe contabilizar los parámetros estimados pertinentes, incluidos los estados iniciales que forman parte del ajuste ETS.
AdvertenciaAICc no reemplaza la evaluación temporal
AICc compara modelos mediante ajuste penalizado dentro de la muestra utilizada para estimarlos. La semana 7 mostró por qué esto no sustituye una comparación de errores genuinamente fuera de muestra. En este capítulo utilizaremos ambos tipos de evidencia.
8.16 Ajuste con fable
La función ETS() permite fijar componentes concretos o dejar que el procedimiento considere combinaciones compatibles con la serie.
Por ejemplo,
# SES con error aditivoETS(y ~error("A") +trend("N") +season("N"))# Holt con error aditivoETS(y ~error("A") +trend("A") +season("N"))# Holt amortiguadoETS(y ~error("A") +trend("Ad") +season("N"))# Selección automáticaETS(y)
La selección automática es útil, pero debemos interpretar qué estructura fue elegida, verificar las innovaciones y evaluar el pronóstico fuera de muestra.
8.16.1 Restricciones y estabilidad
No toda combinación algebraicamente imaginable es igualmente apropiada. Los modelos con componentes multiplicativos requieren cuidado con ceros, valores negativos y estados cercanos a cero. Además, existen regiones de parámetros que producen dinámicas no admisibles.
Por estas razones, una implementación automática moderna impone restricciones de parámetros y descarta ciertas combinaciones problemáticas. En una aplicación conviene evitar dos errores:
asumir que cada parámetro puede optimizarse libremente en toda la recta real;
interpretar que una combinación rechazada numéricamente es simplemente “un fallo del optimizador”.
La estabilidad es parte de la definición práctica del modelo.
8.17 Aplicación: turismo vacacional en Australia
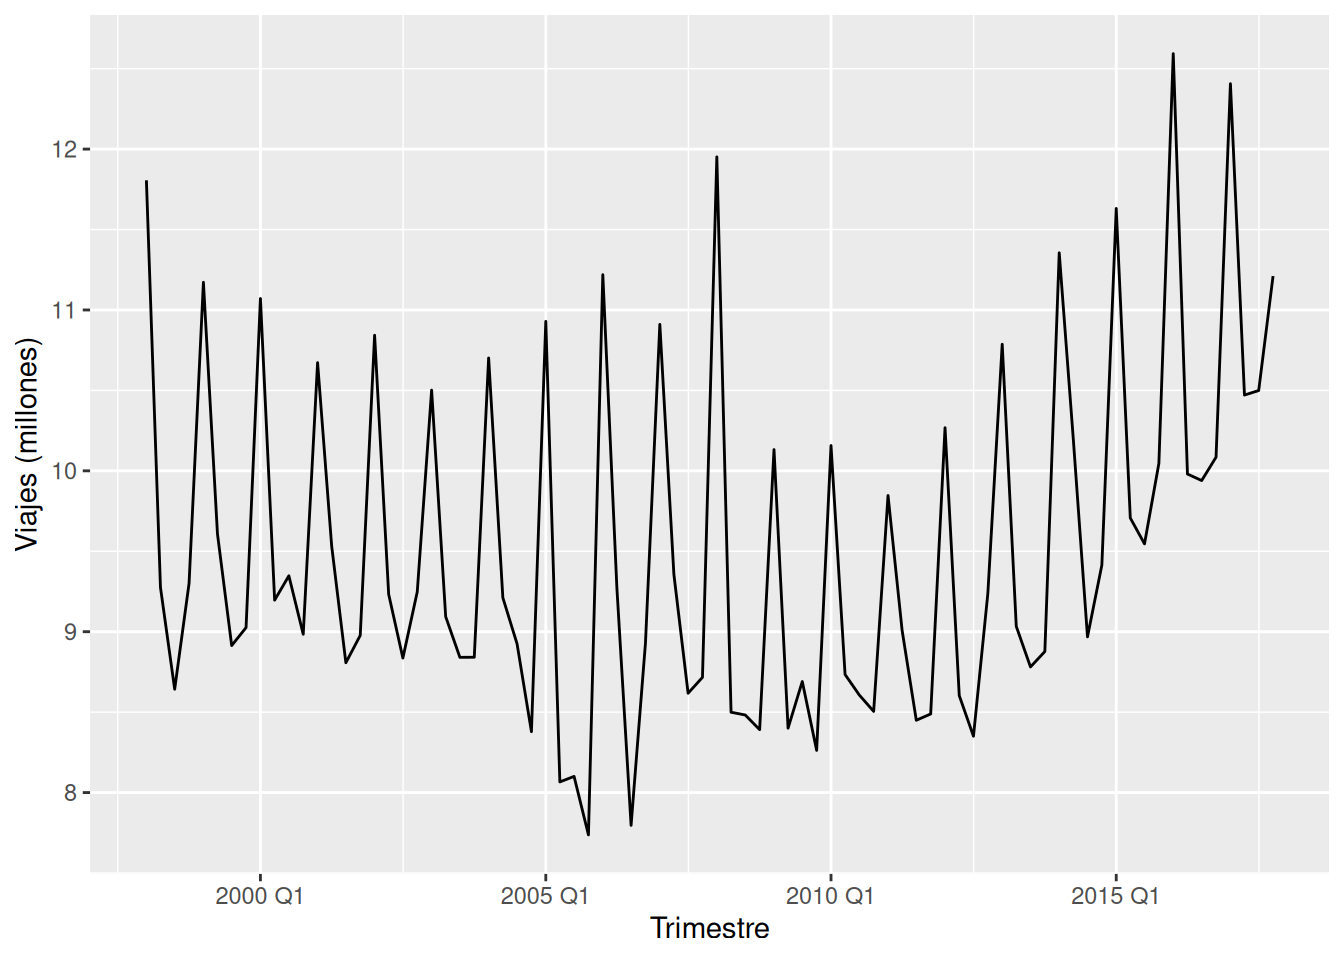
Utilizaremos el conjunto tourism de tsibbledata, que contiene viajes domésticos trimestrales en Australia (O’Hara-Wild et al. 2022). Siguiendo el ejemplo de FPP3, agregaremos los viajes cuyo propósito es vacaciones (Hyndman y Athanasopoulos 2021, secs. 8.3 y 8.6).
Nuestro objetivo será responder cuatro preguntas:
¿qué componentes de nivel, tendencia y estacionalidad parecen necesarios?;
¿qué especificación ETS resulta razonable dentro de muestra?;
¿cómo se compara ETS con una referencia estacional y con ARIMA fuera de muestra?;
En lugar de asumir que glance() siempre contiene exactamente las mismas columnas en todas las versiones del paquete, seleccionamos únicamente las columnas disponibles que necesitamos.
ic_tourism_ets <-glance(fit_tourism_ets) |>select(any_of(c(".model", "log_lik", "AIC", "AICc", "BIC"))) |>arrange(AICc)knitr::kable( ic_tourism_ets,digits =3,caption ="Criterios de información de los candidatos ETS ajustados al período de entrenamiento.")
Tabla 8.4: Criterios de información de los candidatos ETS ajustados al período de entrenamiento.
.model
log_lik
AIC
AICc
BIC
ETS automatico
-83.533
181.066
182.933
196.603
ETS(M,A,M)
-84.120
186.240
189.343
206.216
ETS(M,Ad,M)
-83.360
186.720
190.580
208.915
ETS(A,A,A)
-85.255
188.510
191.613
208.485
El menor AICc identifica el candidato preferido según ese criterio y esa muestra de entrenamiento. Todavía no hemos utilizado el período de prueba.
8.17.4 Parámetros de suavizamiento
param_tourism_ets <-tidy(fit_tourism_ets) |>filter(term %in%c("alpha", "beta", "gamma", "phi")) |>select(.model, term, estimate) |>arrange(.model, term)knitr::kable( param_tourism_ets,digits =4,caption ="Parámetros de suavizamiento estimados para los candidatos ETS.")
Tabla 8.5: Parámetros de suavizamiento estimados para los candidatos ETS.
.model
term
estimate
ETS automatico
alpha
0.2527
ETS automatico
gamma
0.0001
ETS(A,A,A)
alpha
0.2562
ETS(A,A,A)
beta
0.0254
ETS(A,A,A)
gamma
0.0001
ETS(M,A,M)
alpha
0.2466
ETS(M,A,M)
beta
0.0156
ETS(M,A,M)
gamma
0.0001
ETS(M,Ad,M)
alpha
0.2614
ETS(M,Ad,M)
beta
0.0001
ETS(M,Ad,M)
gamma
0.0001
ETS(M,Ad,M)
phi
0.9783
La interpretación debe ser cualitativa y coherente con la parametrización ETS:
\(\alpha\) grande implica actualización rápida del nivel;
\(\beta\) grande implica mayor respuesta de la pendiente a innovaciones recientes;
\(\gamma\) controla cuánto puede actualizarse el patrón estacional;
\(\phi\) cercano a uno implica poco amortiguamiento.
No debemos interpretar un parámetro aislado sin observar la escala del error, los demás estados y el comportamiento predictivo del modelo.
8.17.5 Estados estimados
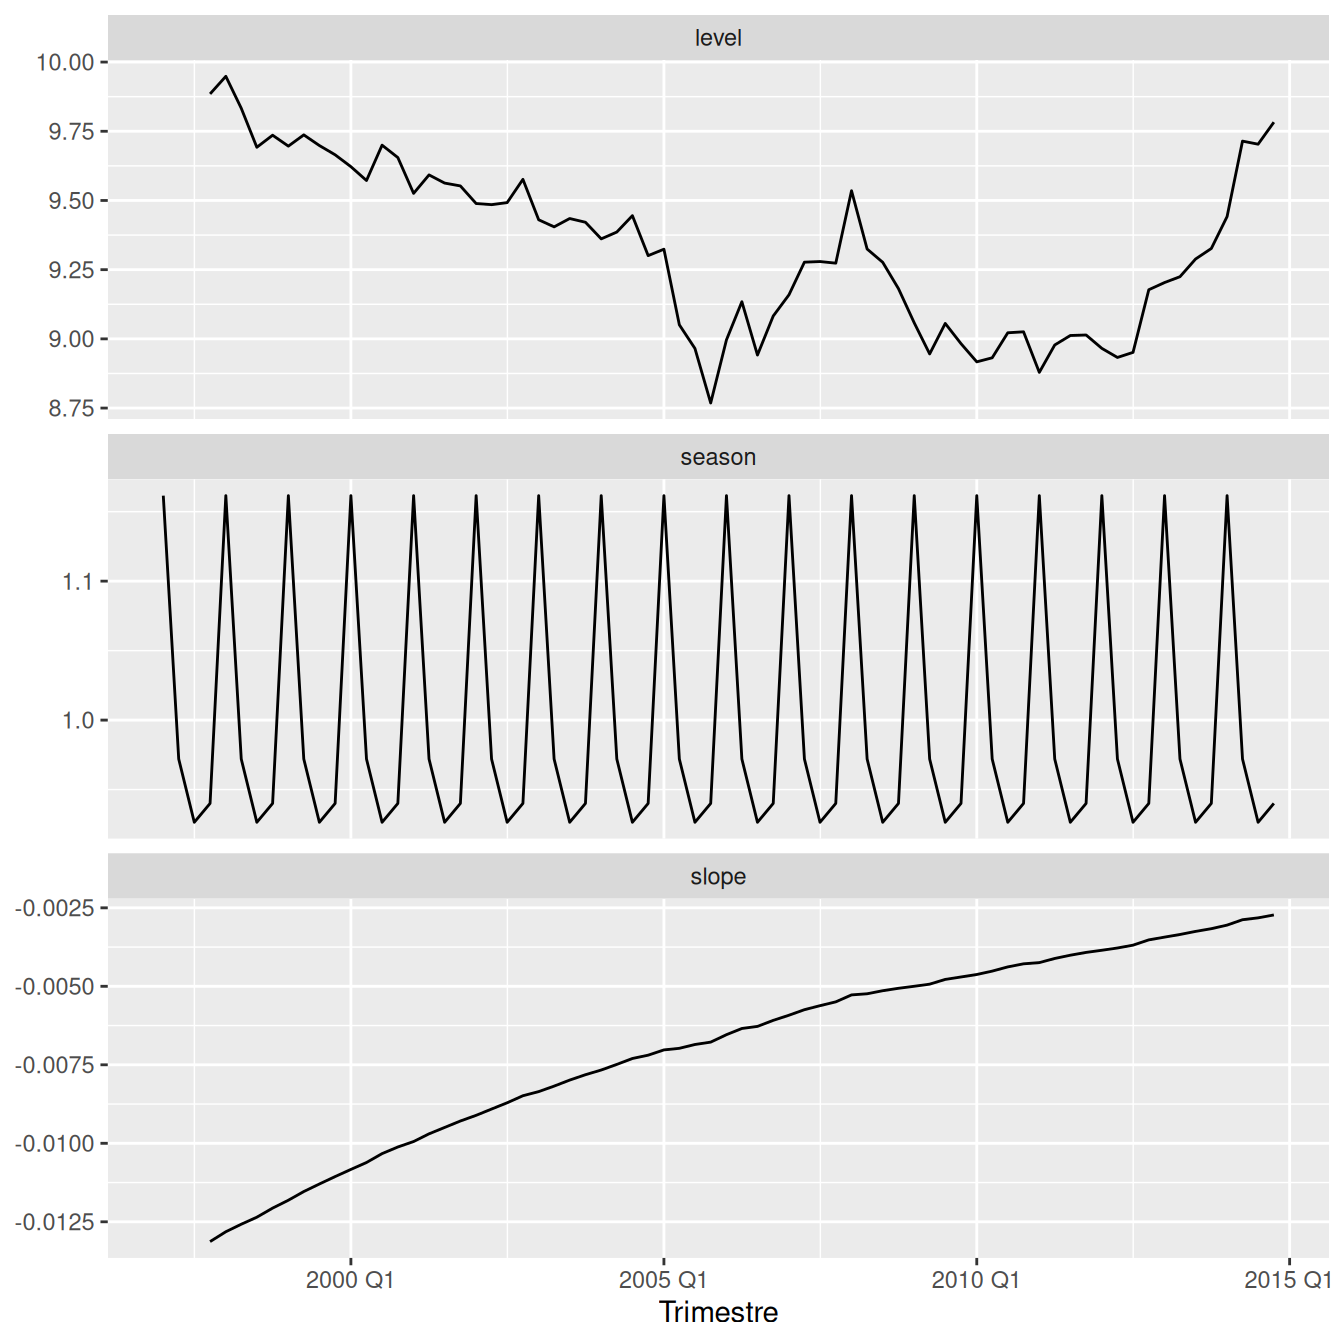
Para visualizar los tres tipos de estado, utilizaremos el candidato ETS\((M,A_d,M)\), cuya especificación contiene nivel, pendiente y estacionalidad.
Figura 8.8: Estados estimados de nivel, pendiente y estacionalidad para un modelo ETS con tendencia amortiguada y estacionalidad multiplicativa. Las escalas se muestran por separado porque los estados tienen interpretaciones diferentes.
NotaEstado no equivale a componente observado
El nivel, la pendiente y la estacionalidad son cantidades internas del modelo. Su significado depende de la especificación aditiva o multiplicativa. En particular, un estado estacional multiplicativo se interpreta como un factor relativo.
8.17.6 Diagnóstico de innovaciones
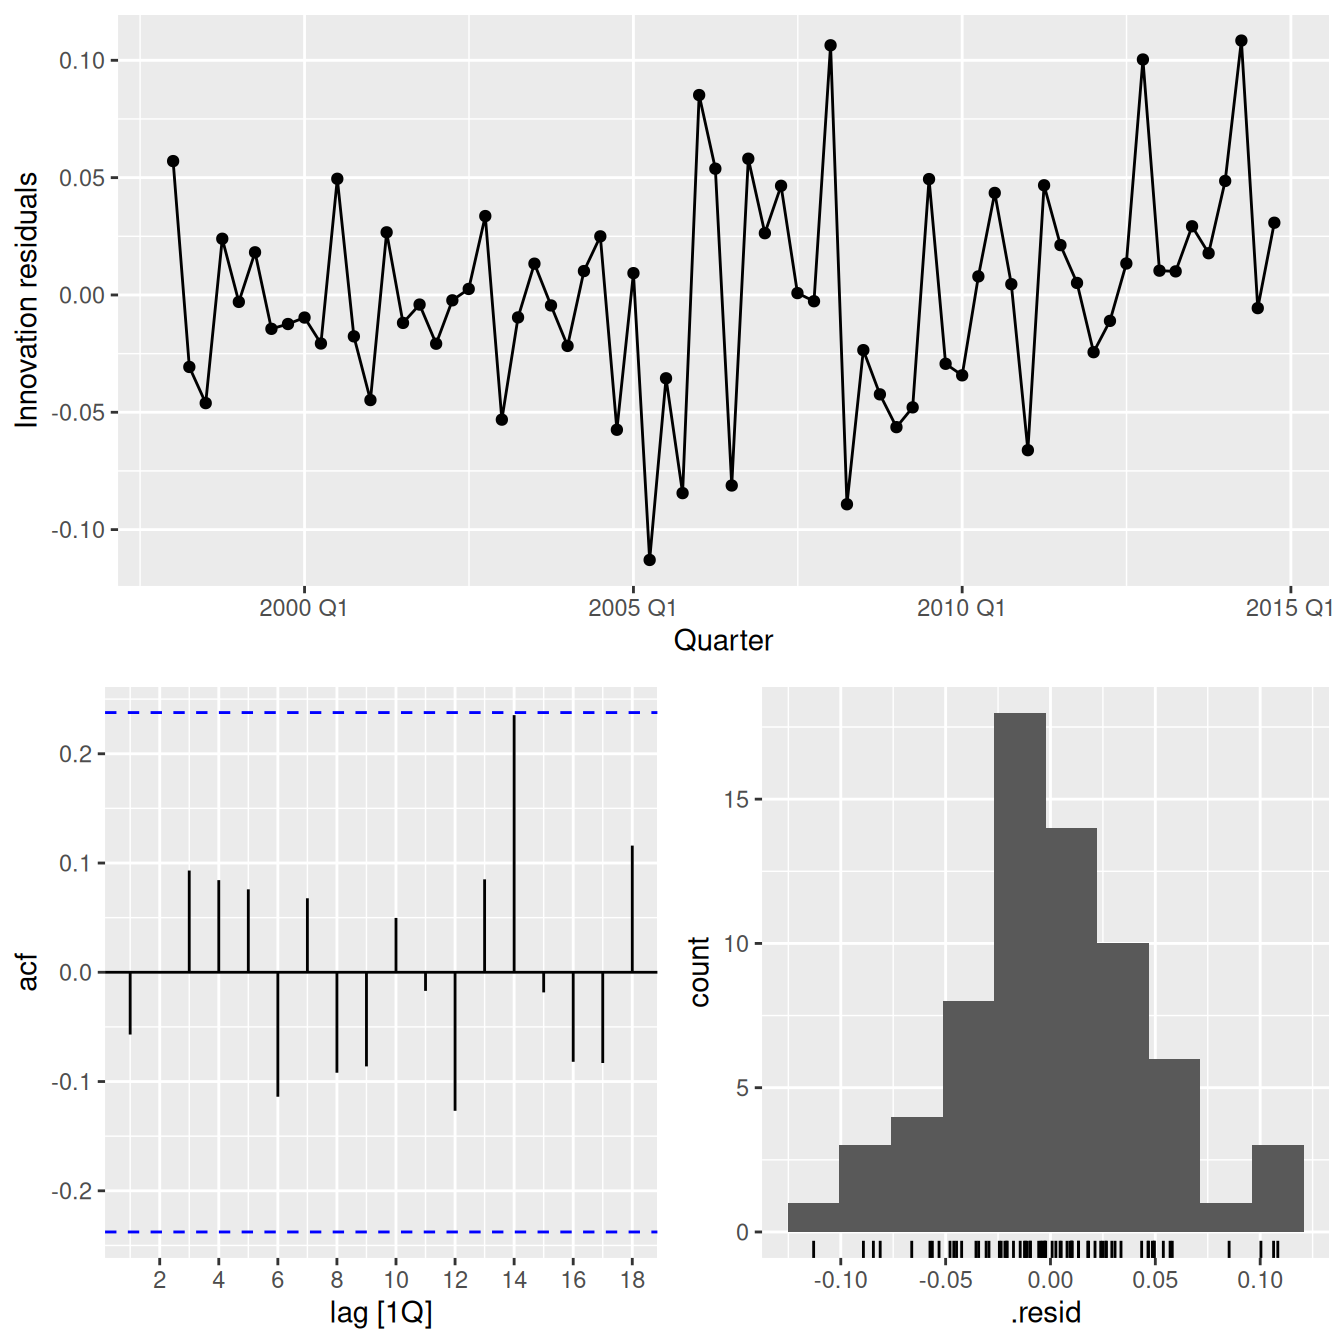
Como en Sección 4.11, un modelo de pronóstico debe dejar innovaciones sin estructura temporal evidente. Utilizaremos el ETS automático del período de entrenamiento.
Figura 8.9: Diagnóstico de innovaciones del ETS automático ajustado al período de entrenamiento.
El diagnóstico tiene dos objetivos distintos:
detectar estructura sistemática que el ETS no capturó;
evitar confundir buen AICc con adecuación automática del modelo.
Una ACF residual con dependencia marcada sugeriría que la estructura de nivel, tendencia y estacionalidad no agota la dinámica temporal de la serie.
8.18 Pronóstico en el período de prueba
Para el holdout compararemos:
naïve estacional;
ETS automático;
un ARIMA estacional cuya diferenciación se fija antes de seleccionar los órdenes AR y MA.
La referencia estacional es especialmente importante porque la serie presenta una periodicidad trimestral fuerte. Para el competidor ARIMA no repetiremos todo el proceso de identificación de la semana 6. A partir del período de entrenamiento fijamos \(d=0\) y \(D=1\): preservamos el nivel no estacional y eliminamos la estacionalidad trimestral mediante una diferencia de período cuatro. Condicionalmente a esa decisión, ARIMA() selecciona \(p,q,P,Q\) dentro de rangos moderados mediante AICc. Esta separación entre elección de la diferenciación y selección de órdenes AR/MA es consistente con Sección 6.15.1.
Además, usamos .safely = FALSE. Por defecto, model() reemplaza un ajuste que falla por un modelo nulo para permitir que los demás modelos continúen. En una nota reproducible preferimos que un error del ARIMA detenga el render y muestre su causa en lugar de producir pronósticos faltantes que luego aparezcan como NaN en las métricas.
fit_tourism_holdout <- tourism_train |>model(`Naive estacional`=SNAIVE(Trips),ETS =ETS(Trips),ARIMA =ARIMA( Trips ~pdq(p =0:3, d =0, q =0:3) +PDQ(P =0:2, D =1, Q =0:2) ),.safely =FALSE )# Hacemos visible la especificación ARIMA seleccionada en entrenamiento.report(fit_tourism_holdout |>select(ARIMA))
fc_tourism_holdout <- fit_tourism_holdout |>forecast(h = h_test_ets)# Una falla silenciosa del ajuste no debe propagarse a tablas o gráficos.fc_tourism_holdout_check <- fc_tourism_holdout |>as_tibble()stopifnot(nrow(fc_tourism_holdout_check) ==3* h_test_ets,!anyNA(fc_tourism_holdout_check$.mean),all(is.finite(fc_tourism_holdout_check$.mean)))
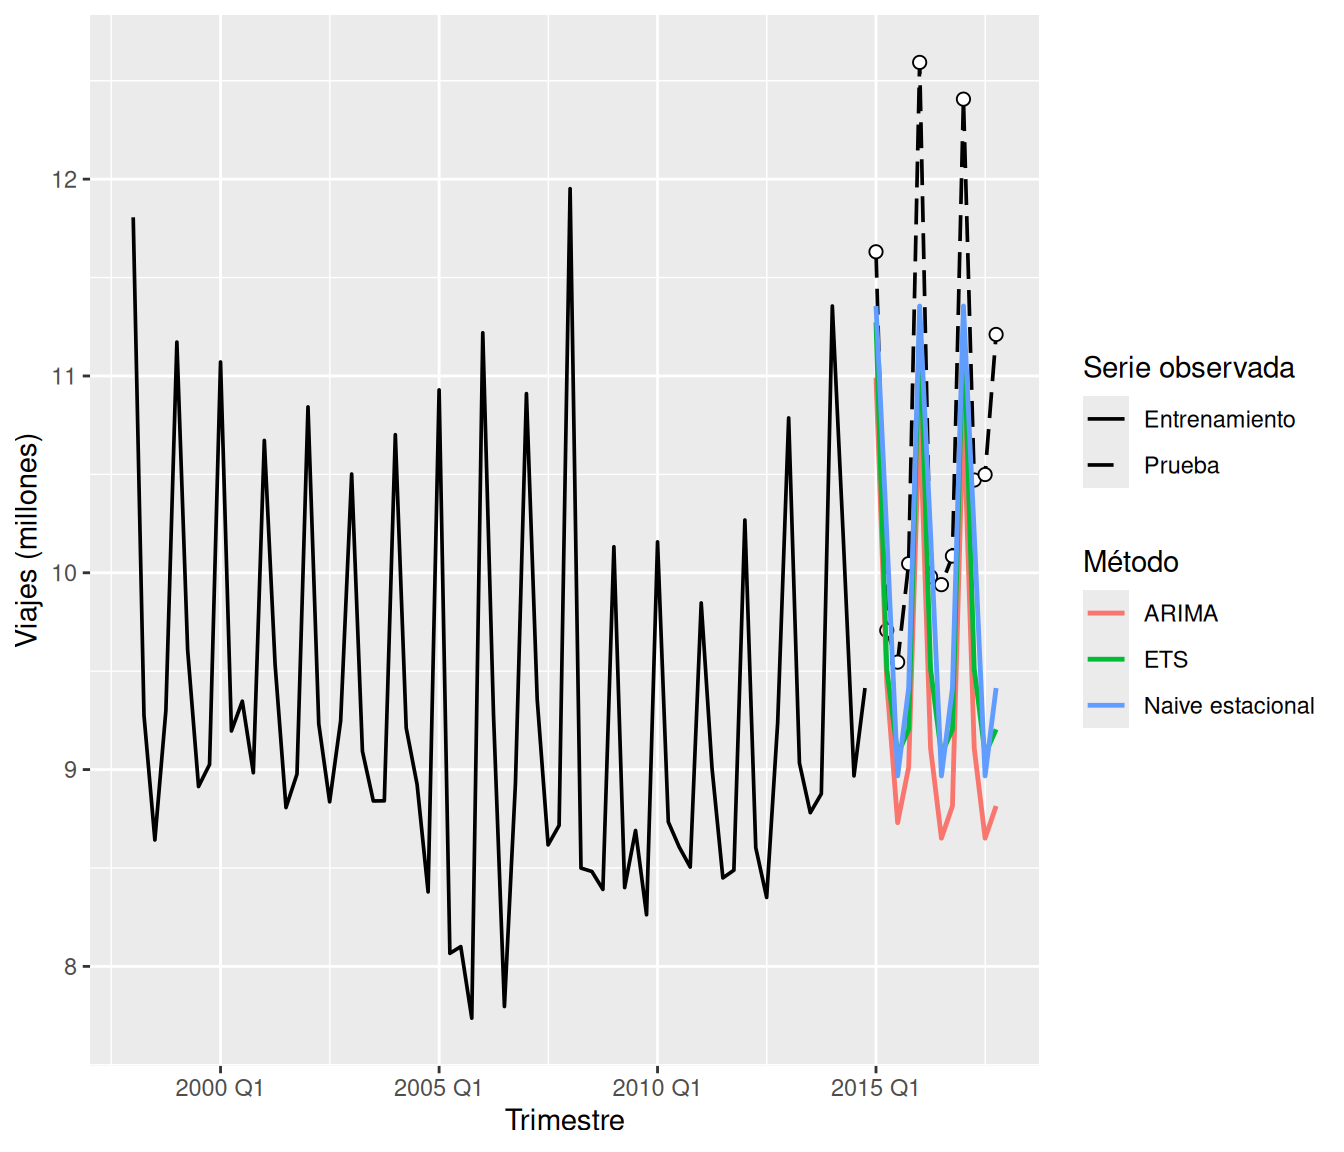
La siguiente figura distingue explícitamente el período de entrenamiento y el período de prueba mediante el tipo de línea. Además, las observaciones de prueba se marcan con puntos para evitar que se confundan con las trayectorias pronosticadas.
Figura 8.10: Pronósticos para los últimos 12 trimestres reservados como prueba. La serie observada cambia de tipo de línea al comenzar la evaluación y las observaciones de prueba se muestran con puntos; esos valores no participaron en el ajuste.
acc_tourism_holdout <- fc_tourism_holdout |>accuracy(aus_holidays) |>select(.model, RMSE, MAE, MASE) |>arrange(RMSE)knitr::kable( acc_tourism_holdout,digits =4,caption ="Desempeño en los 12 trimestres reservados para prueba.")
Tabla 8.6: Desempeño en los 12 trimestres reservados para prueba.
.model
RMSE
MAE
MASE
Naive estacional
0.9476
0.8106
2.0347
ETS
1.0342
0.9099
2.2840
ARIMA
1.3796
1.2605
3.1641
Una sola partición es fácil de interpretar, pero puede depender excesivamente de qué 12 observaciones quedaron al final. Por eso repetiremos la comparación en varios orígenes.
8.19 Validación temporal de ETS, ARIMA y referencia estacional
Utilizaremos ventanas expansivas. Para que cada origen tenga ocho trimestres futuros observables, eliminamos temporalmente los últimos ocho puntos al construir los orígenes y después pronosticamos \(h=8\) en cada uno.
Como en la semana 7, construiremos la escala de MASE usando únicamente la información disponible en cada ventana. Para datos trimestrales, la referencia de escala utiliza rezago cuatro.
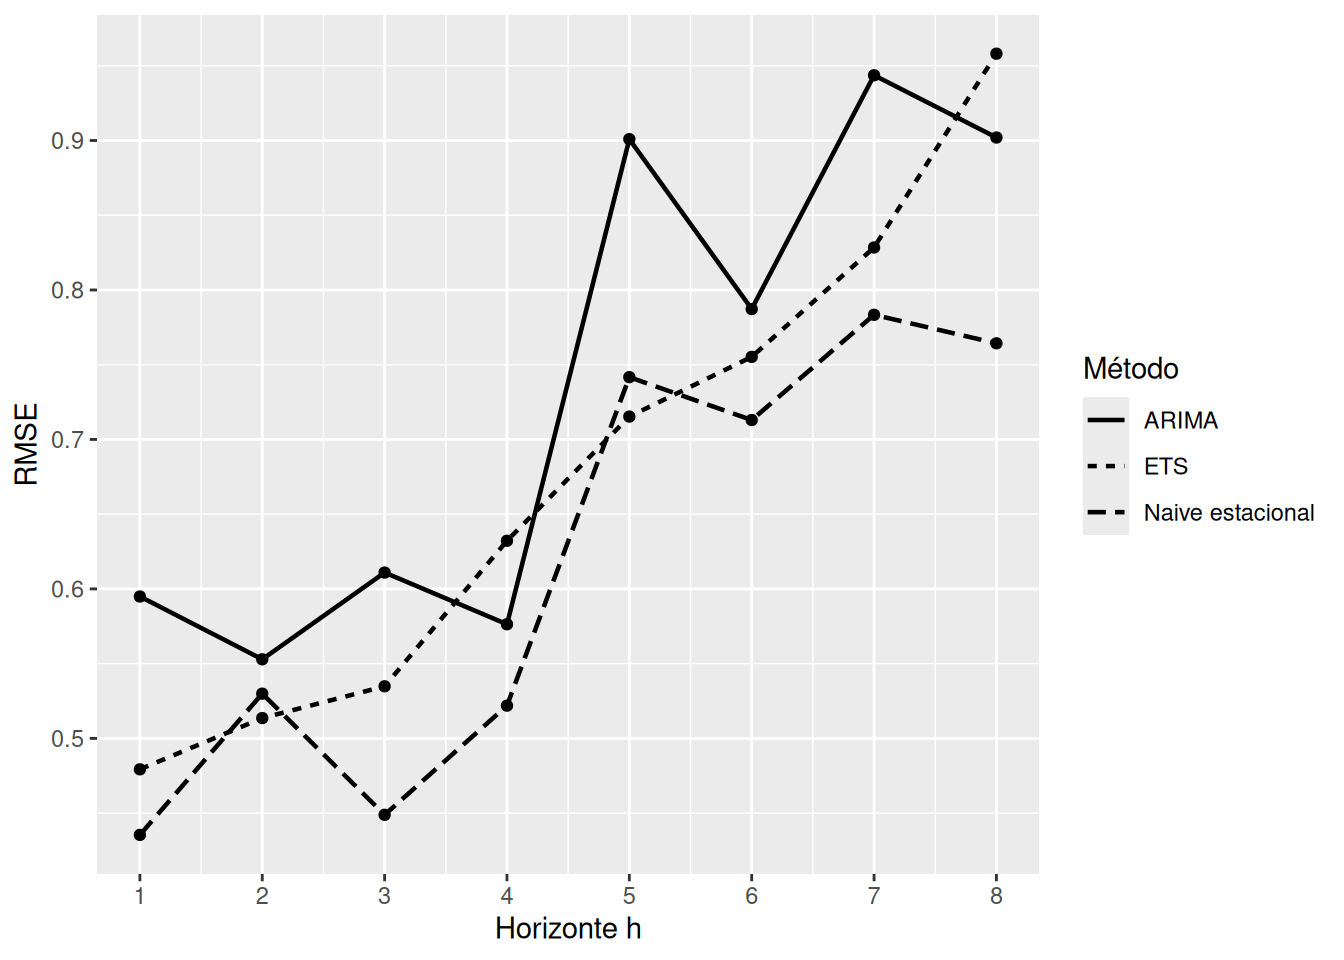
Figura 8.11: RMSE como función del horizonte para ETS, ARIMA y naïve estacional. La comparación utiliza los mismos orígenes y realizaciones futuras.
La figura es más informativa que una sola métrica agregada si la calidad relativa cambia con \(h\). Un método puede responder bien a corto plazo y deteriorarse más rápido que otro.
8.19.2 Intervalos predictivos
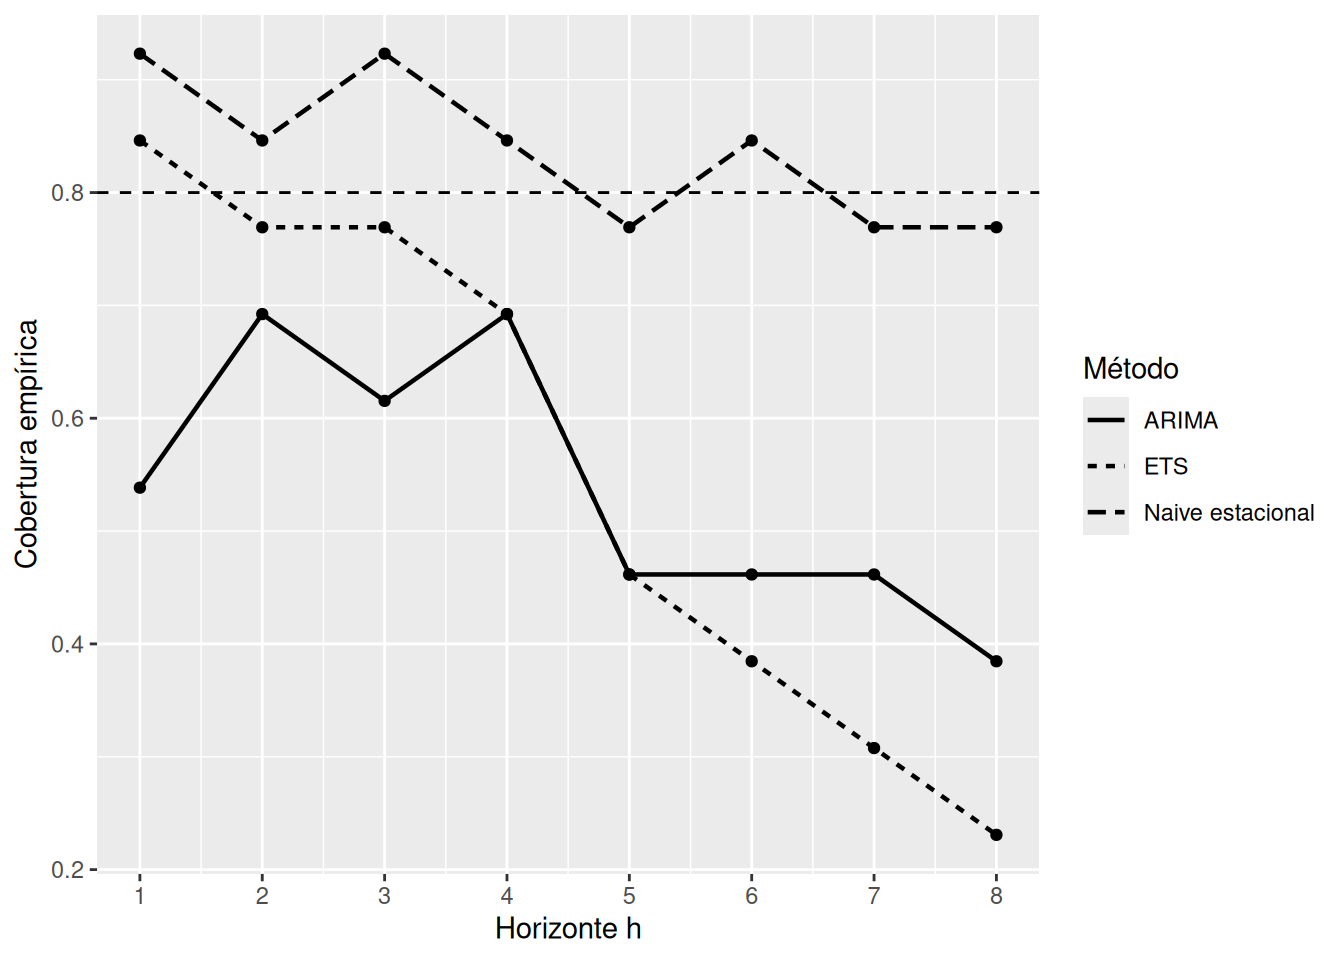
Evaluaremos intervalos centrales de 80%. Como ya discutimos en Sección 7.10, cobertura y amplitud deben leerse conjuntamente.
Figura 8.12: Cobertura empírica de intervalos nominales de 80% según horizonte. La línea horizontal muestra el nivel nominal.
ImportanteNo seleccionar por una sola columna
Un modelo con menor RMSE puede tener intervalos mal calibrados. Otro puede alcanzar alta cobertura porque sus intervalos son demasiado anchos. La conclusión predictiva debe considerar el objetivo de la aplicación y las métricas relevantes.
8.20 Evaluación probabilística: Winkler y CRPS
En Sección 8.19.2 evaluamos los intervalos predictivos mediante dos cantidades complementarias: cobertura empírica y amplitud promedio. La cobertura estudia calibración, mientras que la amplitud estudia agudeza. Sin embargo, analizar ambas cantidades por separado puede dificultar la comparación entre procedimientos.
En la semana 7 introdujimos dos reglas de puntuación que permiten resumir distintos aspectos de la distribución predictiva:
la puntuación de Winkler, dirigida a un intervalo predictivo de nivel especificado;
el CRPS (Continuous Ranked Probability Score), que evalúa la distribución predictiva completa.
En ambos casos, valores menores indican mejor desempeño predictivo. Por tanto, estas medidas complementan, pero no reemplazan, RMSE, MAE, MASE, cobertura y amplitud (Hyndman y Athanasopoulos 2021, sec. 5.9).
8.20.1 Puntuación de Winkler
Para un intervalo predictivo central de nivel \(100(1-\alpha)\%\),
Si la observación futura cae dentro del intervalo, el score coincide con su amplitud. Si queda fuera, se añade una penalización proporcional a la distancia entre la observación y el extremo del intervalo. De esta forma, Winkler evita favorecer automáticamente intervalos muy anchos: aumentar la amplitud puede mejorar cobertura, pero también aumenta directamente el score.
Continuaremos utilizando los intervalos centrales de 80% estudiados en Sección 8.19.2, por lo que en este caso
\[
\alpha=0.20.
\]
Calculamos primero la puntuación promedio sobre todos los orígenes y horizontes.
knitr::kable( winkler_tourism,digits =4,caption ="Puntuación de Winkler promedio para intervalos predictivos de 80% bajo validación temporal. Menor es mejor.")
Tabla 8.9: Puntuación de Winkler promedio para intervalos predictivos de 80% bajo validación temporal. Menor es mejor.
.model
Winkler
Naive estacional
2.0828
ETS
2.7336
ARIMA
2.9359
La puntuación agregada resume todos los errores cometidos por los intervalos, pero puede ocultar diferencias importantes entre horizontes. Por ello, examinamos también
\[
\overline W_\alpha(h),
\]
es decir, el score promedio para cada horizonte \(h\).
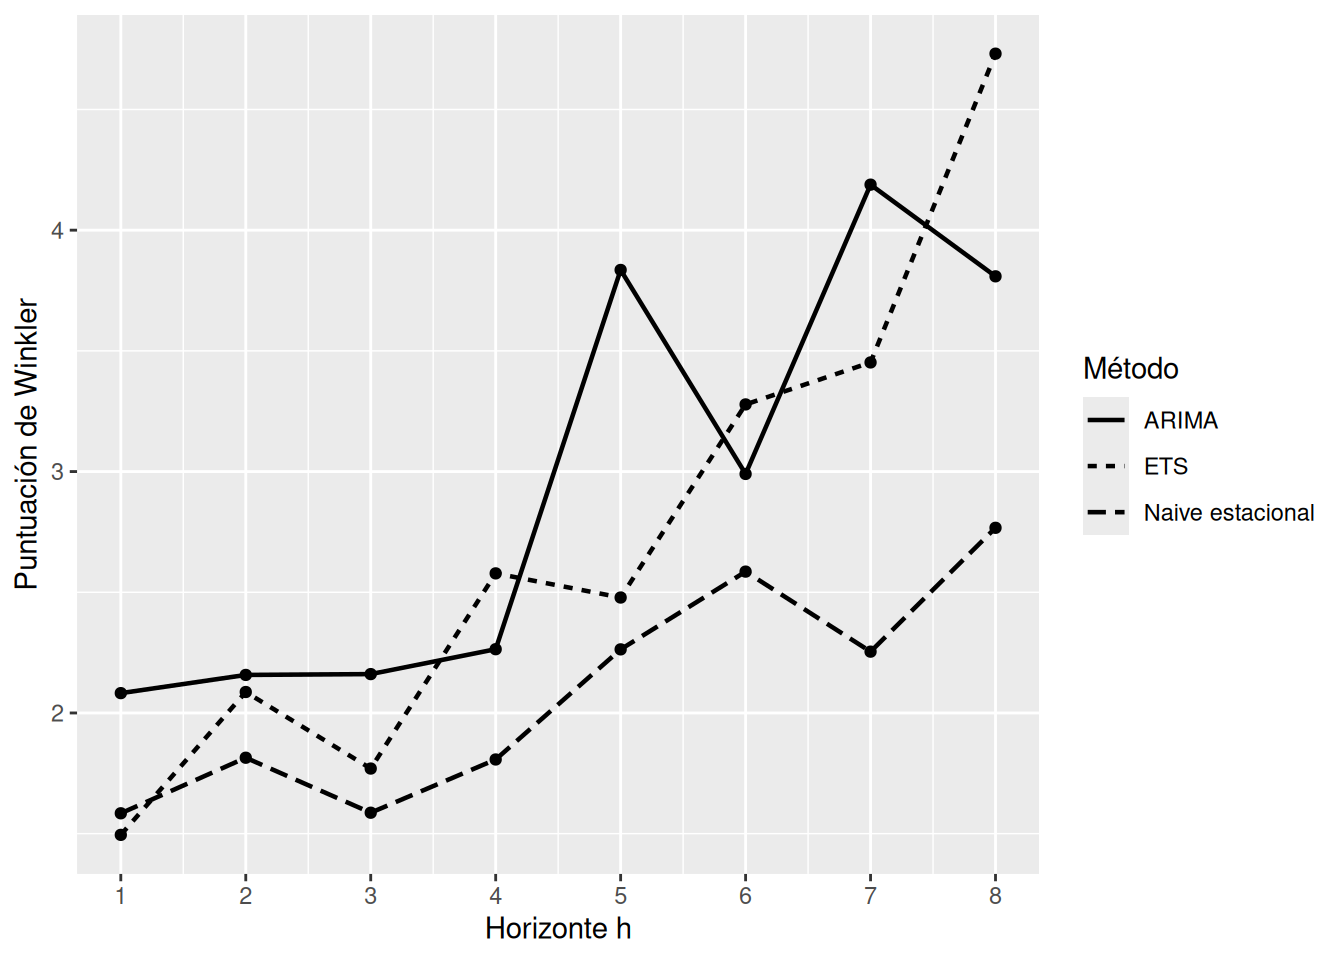
Figura 8.13: Puntuación de Winkler para intervalos predictivos de 80% según horizonte. Valores menores indican una combinación más favorable de calibración y agudeza.
La interpretación debe hacerse conjuntamente con la cobertura de Figura 8.12. Por ejemplo, un método podría producir intervalos relativamente estrechos y obtener un buen Winkler cuando las observaciones quedan dentro de ellos, pero recibir penalizaciones grandes en horizontes donde la cobertura se deteriora.
En consecuencia, Winkler resume el compromiso entre cobertura y amplitud, pero sigue evaluando solamente un intervalo específico de la distribución predictiva.
8.20.2 CRPS
Para evaluar la distribución predictiva completa retomamos el Continuous Ranked Probability Score. Si \(F_{t+h\mid t}\) es la función de distribución predictiva y \(y_{t+h}\) es la realización observada,
El CRPS compara toda la función de distribución predictiva con una distribución degenerada en la observación realizada. Tiene las mismas unidades que la variable pronosticada y, nuevamente, menor es mejor.
Una distribución excesivamente concentrada puede recibir una penalización grande cuando la observación cae lejos de su centro; una distribución demasiado dispersa, por otra parte, pierde agudeza. Por tanto, CRPS evalúa simultáneamente localización e incertidumbre predictiva sin tener que escoger previamente un nivel particular como 80% o 95%.
El cálculo debe realizarse para todas las distribuciones predictivas generadas en cada origen y horizonte. Este es uno de los bloques computacionalmente más costosos del capítulo, por lo que lo almacenamos en caché.
El objeto almacenado en caché contiene tanto la evaluación agregada como la evaluación por horizonte. De esta manera, cambios posteriores en texto, tablas o figuras no obligan a recalcular el CRPS mientras no cambien los pronósticos producidos en ajustar-tourism-cv.
knitr::kable( crps_tourism,digits =4,caption ="CRPS promedio bajo validación temporal para ETS, ARIMA y naïve estacional. Menor es mejor.")
Tabla 8.10: CRPS promedio bajo validación temporal para ETS, ARIMA y naïve estacional. Menor es mejor.
.model
CRPS
Naive estacional
0.3569
ETS
0.4154
ARIMA
0.4426
Al igual que con RMSE y Winkler, el valor agregado puede ocultar heterogeneidad entre horizontes.
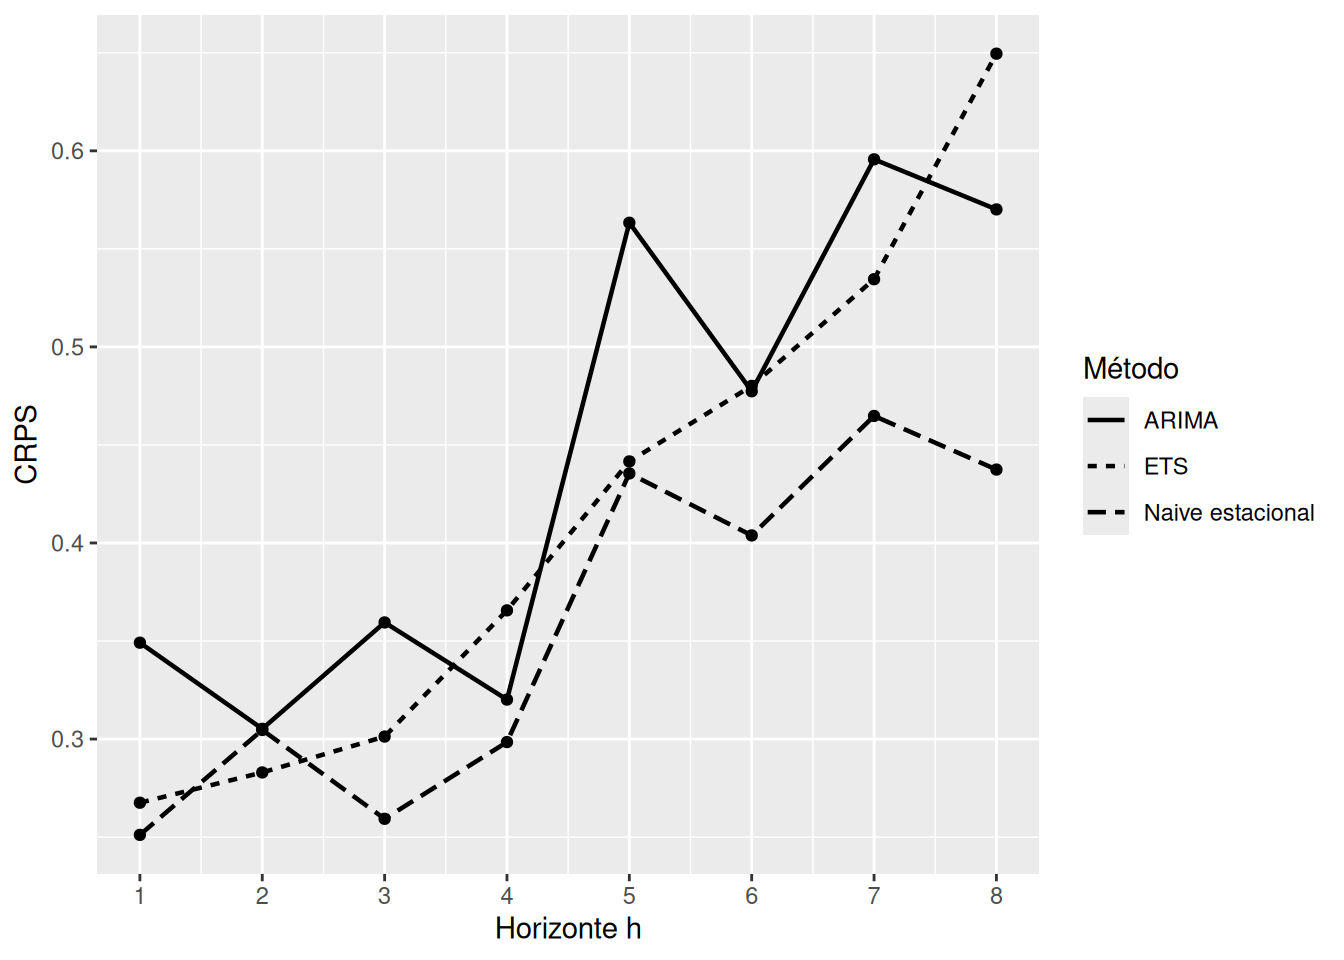
Figura 8.14: CRPS de la distribución predictiva según horizonte para ETS, ARIMA y naïve estacional. Valores menores indican mejor desempeño distribucional.
La figura permite investigar si la distribución predictiva de alguno de los métodos se deteriora más rápidamente conforme aumenta \(h\). Una ordenación distinta a la obtenida mediante RMSE no constituye una contradicción: ambas métricas responden a preguntas diferentes. RMSE evalúa el pronóstico puntual; CRPS evalúa la distribución predictiva completa.
8.20.3 Síntesis de la evaluación predictiva
Podemos finalmente reunir en una misma tabla algunas de las medidas utilizadas en esta aplicación.
resumen_tourism_integral <- acc_tourism_cv_global |>select(.model, RMSE, MAE, MASE) |>left_join( resumen_intervalos_tourism |>select( .model, cobertura_80, amplitud_media ),by =".model" ) |>left_join( winkler_tourism,by =".model" ) |>left_join( crps_tourism,by =".model" ) |>arrange(CRPS)knitr::kable( resumen_tourism_integral,digits =4,caption ="Síntesis del desempeño fuera de muestra para turismo bajo los mismos orígenes y horizontes.")
Tabla 8.11: Síntesis del desempeño fuera de muestra para turismo bajo los mismos orígenes y horizontes.
.model
RMSE
MAE
MASE
cobertura_80
amplitud_media
Winkler
CRPS
Naive estacional
0.6325
0.5197
1.3296
0.8365
1.6502
2.0828
0.3569
ETS
0.6951
0.5726
1.4655
0.5577
1.1324
2.7336
0.4154
ARIMA
0.7500
0.6052
1.5439
0.5385
1.2949
2.9359
0.4426
La tabla debe interpretarse por columnas y no como un concurso en el que un único número determina automáticamente el procedimiento elegido:
RMSE, MAE y MASE evalúan pronósticos puntuales;
cobertura estudia calibración de un intervalo;
amplitud mide su agudeza;
Winkler combina cobertura y amplitud para el intervalo de 80%;
CRPS evalúa la distribución predictiva completa.
En particular, no es necesario que el procedimiento con menor RMSE tenga también el menor Winkler o CRPS. Si ocurre un desacuerdo, la pregunta relevante es qué aspecto del pronóstico explica esa diferencia.
ImportanteComparar bajo el mismo experimento
Todas las columnas de Tabla 8.11 corresponden a los mismos orígenes, horizontes y observaciones futuras. Esta condición es fundamental: una diferencia de score sólo puede atribuirse razonablemente al procedimiento de pronóstico cuando el experimento predictivo es comparable.
Además, no deben compararse directamente las magnitudes numéricas de RMSE, Winkler y CRPS entre sí. Aunque todas están expresadas en la escala de la variable, corresponden a funciones de pérdida diferentes. Su utilidad está en comparar los mismos procedimientos dentro de cada métrica.
8.21 ETS frente a ARIMA
ETS y ARIMA no representan dos versiones del mismo mecanismo. Ambos pueden producir buenos pronósticos, pero organizan la dependencia temporal de maneras diferentes.
comparacion_ets_arima <-tribble(~Aspecto, ~ETS, ~ARIMA,"Representación central", "Estados de nivel, tendencia y estacionalidad", "Rezagos, diferencias e innovaciones","No estacionariedad", "Puede representarse mediante estados evolutivos", "Se maneja típicamente mediante diferenciación","Estacionalidad", "Estado estacional aditivo o multiplicativo", "Operadores AR y MA estacionales y diferenciación estacional","Memoria", "Implícita en recursiones de actualización", "Explícita mediante estructura ARMA","Selección automática", "Combinaciones E-T-S", "Órdenes p-d-q y P-D-Q","Incertidumbre", "Distribución predictiva del modelo de innovaciones", "Distribución predictiva del ARIMA ajustado","Diagnóstico", "Innovaciones", "Innovaciones")knitr::kable( comparacion_ets_arima,caption ="Comparación conceptual entre las representaciones ETS y ARIMA.")
Tabla 8.12: Comparación conceptual entre las representaciones ETS y ARIMA.
Aspecto
ETS
ARIMA
Representación central
Estados de nivel, tendencia y estacionalidad
Rezagos, diferencias e innovaciones
No estacionariedad
Puede representarse mediante estados evolutivos
Se maneja típicamente mediante diferenciación
Estacionalidad
Estado estacional aditivo o multiplicativo
Operadores AR y MA estacionales y diferenciación estacional
Memoria
Implícita en recursiones de actualización
Explícita mediante estructura ARMA
Selección automática
Combinaciones E-T-S
Órdenes p-d-q y P-D-Q
Incertidumbre
Distribución predictiva del modelo de innovaciones
Distribución predictiva del ARIMA ajustado
Diagnóstico
Innovaciones
Innovaciones
Existen relaciones matemáticas importantes entre ciertos modelos de suavizamiento y modelos ARIMA. Por ejemplo, SES está estrechamente vinculado con un ARIMA\((0,1,1)\) bajo una parametrización apropiada. Sin embargo, esa equivalencia parcial no convierte a las familias completas en idénticas.
Para este curso nos interesa una conclusión más operativa:
ETS y ARIMA son candidatos que deben compararse bajo los mismos orígenes, horizontes y datos disponibles, en lugar de escogerse por una regla universal.
La aplicación de Sección 8.19 implementa exactamente esa comparación.
8.22 Pronósticos puntuales y distribuciones predictivas
Una ventaja decisiva del modelo ETS respecto del algoritmo aislado es que podemos trabajar con
\[
p(y_{T+h}\mid y_{1:T},\widehat\theta),
\]
además del pronóstico puntual.
En modelos puramente aditivos, la propagación de innovaciones suele producir expresiones analíticas manejables para la varianza predictiva. En otros modelos, especialmente cuando aparecen componentes multiplicativos, la distribución futura puede ser más compleja y la simulación de trayectorias constituye una alternativa natural (Hyndman y Athanasopoulos 2021, sec. 8.7).
Es importante distinguir tres objetos:
la trayectoria recursiva del método, obtenida al fijar innovaciones futuras en cero;
la media o mediana predictiva, según el modelo y la función de pérdida;
la distribución predictiva completa, que describe incertidumbre y asimetría.
Con componentes multiplicativos, estos objetos no tienen por qué coincidir exactamente debido a la no linealidad. Por eso conviene utilizar directamente las distribuciones generadas por el modelo cuando la meta es evaluar probabilísticamente el pronóstico.
8.23 Perspectiva frecuentista y bayesiana
El ajuste ETS que hemos utilizado es fundamentalmente frecuentista por máxima verosimilitud: los parámetros de suavizamiento y los estados iniciales se estiman y posteriormente se utilizan para construir pronósticos.
La presencia de estados no convierte automáticamente al análisis en bayesiano.
En una formulación bayesiana de un modelo dinámico especificaríamos, por ejemplo,
y actualizaríamos distribuciones completas sobre estados y parámetros conforme llega información nueva. Los modelos lineales dinámicos de Prado, Ferreira y West y de Petris, Petrone y Campagnoli desarrollan precisamente esa lógica (Prado et al. 2021, chap. 4; Petris et al. 2009, chaps. 2–4).
La relación conceptual puede resumirse así:
\[
\text{ETS esta semana}
\quad\longrightarrow\quad
\text{estados + innovación + actualización}
\quad\longrightarrow\quad
\text{DLM y filtro de Kalman en semanas posteriores}.
\]
Petris et al. destacan que algoritmos como el promedio móvil exponencial y Holt pueden verse como procedimientos empíricos que adquieren una justificación probabilística al derivarse de modelos dinámicos (Petris et al. 2009, sec. 3.1.1).
NotaLo que deliberadamente no hacemos esta semana
No construiremos un “ETS bayesiano” mediante MCMC sólo para mantener simetría con semanas anteriores. El objetivo es comprender la formulación de innovaciones y la evaluación predictiva. La inferencia bayesiana de estados latentes y parámetros desconocidos se desarrollará con mayor coherencia en el bloque de modelos lineales dinámicos.
8.24 Inicialización: por qué no es un detalle menor
Las recursiones necesitan comenzar en algún punto. Para SES aparece \(\ell_0\); con tendencia aparece \(b_0\); con estacionalidad necesitamos un conjunto de estados estacionales iniciales.
Una estrategia ingenua sería fijarlos manualmente y olvidarse de ellos. Sin embargo, en muestras cortas pueden afectar apreciablemente:
Esto también explica por qué dos implementaciones aparentemente equivalentes pueden producir resultados ligeramente diferentes si utilizan reglas de inicialización distintas.
8.25 Diagnóstico y límites de la interpretación
Un ETS bien especificado debería producir innovaciones sin dependencia temporal importante. Sin embargo, debemos evitar dos interpretaciones excesivas.
8.25.1 Innovaciones aproximadamente blancas no prueban que el modelo sea verdadero
Como en ARIMA, un buen diagnóstico indica que no encontramos una estructura residual obvia que el modelo haya omitido. No demuestra que la estructura de estados sea el mecanismo verdadero que generó los datos.
8.25.2 Estados suaves no demuestran que exista un “nivel real” único
\(\ell_t\), \(b_t\) y \(s_t\) son estados definidos por el modelo. Dos modelos distintos pueden descomponer la misma serie de formas diferentes y aun producir pronósticos similares.
La utilidad de los estados debe evaluarse por:
interpretación;
coherencia con el dominio;
diagnóstico;
estabilidad;
desempeño predictivo.
8.26 Buenas prácticas computacionales
8.26.1 Verificar positividad antes de usar componentes multiplicativos
stopifnot(all(datos$y >0))
No debemos permitir que una función automática elija una formulación multiplicativa sin haber pensado qué significa en la escala del problema.
8.26.2 No seleccionar con el período de prueba
La siguiente secuencia sería incorrecta:
# NO hacer esto:# 1. ajustar varios ETS a toda la serie;# 2. escoger el que se ve mejor en los últimos años;# 3. declarar esos mismos años como período de prueba.
La selección pertenece al procedimiento de entrenamiento.
8.26.3 Reestimar en cada origen
Cuando evaluamos un procedimiento automático,
datos_cv |>model(ETS(y)) |>forecast(h = h)
la selección y estimación se repiten dentro de cada ventana. Eso representa mucho mejor lo que habría ocurrido históricamente que seleccionar una única especificación con toda la muestra.
8.26.4 Almacenar en caché los bloques costosos
La validación temporal puede requerir decenas o cientos de ajustes. En Quarto con knitr, puede ser útil emplear
#| cache: true
en los chunks cuyo resultado depende únicamente de objetos previos estables. Debemos recordar que, si cambia el código o los datos de los que depende el chunk, la caché debe invalidarse para evitar resultados obsoletos.
8.26.5 No comparar AICc entre respuestas transformadas de forma incompatible
Si dos modelos se ajustan en escalas distintas, por ejemplo uno a \(y_t\) y otro a \(\log y_t\), las verosimilitudes no siempre son directamente comparables sin considerar el Jacobiano y la definición exacta utilizada por el software. La evaluación fuera de muestra en una escala común evita muchas comparaciones ambiguas.
8.27 Actividad computacional guiada
La actividad propone reconstruir progresivamente la aplicación de turismo sin depender de una única llamada automática.
8.27.1 Parte A. SES desde cero
Implemente una función que reciba y, alpha y l0.
Devuelva \(\ell_t\) y los errores de un paso.
Verifique numéricamente Ecuación 8.5 para un tiempo seleccionado.
Calcule SSE para una malla de valores de \(\alpha\).
Explique por qué el valor que minimiza SSE puede cambiar al cambiar \(\ell_0\).
Verifique Ecuación 8.18 usando el \(\widehat\phi\) estimado.
8.27.3 Parte C. Estacionalidad
Ajuste ETS\((A,A,A)\) y ETS\((M,A,M)\) a tourism_train.
Compare los estados estacionales.
Explique por qué sus unidades son diferentes.
Grafique los pronósticos de ambos modelos para 12 trimestres.
8.27.4 Parte D. Selección automática
Ajuste ETS(Trips).
Use report() y tidy() para identificar la estructura seleccionada y los parámetros.
Compare AICc con los candidatos manuales.
Revise las innovaciones con gg_tsresiduals().
Escriba una conclusión que separe selección por AICc de diagnóstico.
8.27.5 Parte E. Evaluación fuera de muestra
Reproduzca la partición entrenamiento–prueba.
Compare naïve estacional, ETS y ARIMA.
Reporte MAE, RMSE y MASE.
Determine si la conclusión cambia según la métrica.
Evite afirmar que un método es “mejor” sin especificar la métrica y el período.
8.27.6 Parte F. Origen móvil
Cambie step_cv_ets de 2 a 1.
Compare el número de ventanas y el tiempo de cómputo.
Reproduzca RMSE\((h)\).
Identifique horizontes en los que la diferencia entre ETS y ARIMA cambia de signo, si los hay.
Explique qué información se pierde al reportar sólo el RMSE agregado.
8.27.7 Parte G. Incertidumbre
Calcule intervalos 80% y 95%.
Compare cobertura y amplitud.
Aplique la puntuación de Winkler estudiada en la semana 7.
Si el tiempo de cómputo lo permite, calcule CRPS.
Discuta si la conclusión basada en el pronóstico puntual coincide con la conclusión distribucional.
8.28 Síntesis
Los principales resultados del capítulo pueden resumirse de la siguiente manera.
SES asigna pesos geométricamente decrecientes al pasado:
\[
w_j=\alpha(1-\alpha)^j.
\]
La actualización de SES puede escribirse como corrección por innovación:
\[
\ell_t=\ell_{t-1}+\alpha e_t.
\]
Holt añade una pendiente local \(b_t\) y produce pronósticos lineales en el horizonte.
El amortiguamiento reemplaza la extrapolación lineal indefinida por
\[
\sum_{j=1}^{h}\phi^j b_t,
\qquad 0<\phi<1.
\]
Holt–Winters añade un estado estacional. La versión aditiva es natural cuando la amplitud estacional es aproximadamente constante; la multiplicativa representa efectos proporcionales al nivel.
Los métodos de suavizamiento son algoritmos de pronóstico. ETS añade una estructura probabilística mediante ecuaciones de observación y estado.
y la recursión SES aparece como consecuencia directa.
La verosimilitud ETS puede construirse secuencialmente con las densidades predictivas de un paso.
Los parámetros de suavizamiento y los estados iniciales forman parte del problema de estimación.
AICc ayuda a seleccionar dentro de muestra, pero no reemplaza la evaluación temporal.
ETS y ARIMA describen la dinámica desde perspectivas diferentes. Deben compararse bajo el mismo experimento predictivo.
La formulación ETS introduce de manera natural las ideas de estado, innovación y actualización secuencial, que retomaremos cuando estudiemos formalmente espacio-estado y filtro de Kalman.
Verosimilitud. Derive Ecuación 8.42 mediante un cambio de variable desde una innovación gaussiana.
SSE y verosimilitud. Explique por qué minimizar SSE puede coincidir con máxima verosimilitud bajo error aditivo gaussiano, pero no necesariamente con error multiplicativo.
AICc. ¿Por qué los estados iniciales estimados deben considerarse al medir la complejidad de un modelo ETS?
8.29.2 Interpretación y modelación
Serie sin tendencia. Proponga un contexto en el que SES sea más razonable que Holt. Justifique.
Tendencia reciente. Una serie creció rápidamente durante los últimos seis meses después de varios años estables. Explique por qué Holt sin amortiguamiento podría producir pronósticos extremos a largo plazo.
Amplitud proporcional. Una serie de ventas duplica su nivel y aproximadamente duplica también la amplitud de sus oscilaciones estacionales. Compare una especificación aditiva y una multiplicativa.
Ceros. ¿Qué problema conceptual y numérico aparece al utilizar error multiplicativo en una serie que contiene ceros?
Innovaciones correlacionadas. Un ETS deja una ACF residual con picos importantes en rezagos 1 y 2. ¿Qué indica esto? ¿Puede concluir inmediatamente que ARIMA resolverá el problema?
AICc versus prueba. Un ETS tiene menor AICc que ARIMA en entrenamiento, pero mayor RMSE en prueba. Explique por qué no hay contradicción.
Cobertura. ETS produce intervalos 80% con cobertura 92% y ARIMA con cobertura 81%. ¿Puede concluir que ETS cuantifica mejor la incertidumbre sin conocer la amplitud? Explique.
Estados. Dos ETS producen niveles \(\ell_t\) distintos pero pronósticos parecidos. ¿Implica esto que uno de los niveles está mal estimado? Discuta.
Bayes. Explique por qué tener estados latentes no convierte automáticamente a ETS en un modelo ajustado bayesianamente.
Puente a Kalman. Compare verbalmente Ecuación 8.9 con la idea “estado previo + corrección × innovación”. ¿Qué elementos esperaría encontrar en un filtro de Kalman?
8.29.3 Computación
SES manual. Escriba una función en R que implemente SES y devuelva niveles, pronósticos de un paso y errores.
Optimización. Use optim() para minimizar Ecuación 8.10 en una serie simulada. Compare el \(\widehat\alpha\) obtenido con ETS().
Sensibilidad al inicio. Repita el ejercicio anterior con tres valores de \(\ell_0\). Compare el resultado para muestras de tamaño 20 y 200.
Uso de internet. Reproduzca Tabla 8.1 utilizando .step = 1. Compare con .step = 2.
Holt largo. Pronostique WWWusage a 50 pasos con Holt y Holt amortiguado. Discuta la diferencia.
Turismo aditivo. Ajuste ETS\((A,A,A)\) a tourism_train y grafique sus estados.
Turismo multiplicativo. Ajuste ETS\((M,A,M)\) y compare su estado estacional con el ejercicio anterior.
Selección automática. Use report() sobre ETS(Trips). Interprete la estructura elegida sin limitarse a repetir sus letras.
Diagnóstico. Use gg_tsresiduals() para el ETS automático. Identifique cualquier rezago que merezca investigación adicional.
Holdout. Cambie el período de prueba de 12 a 8 trimestres. ¿Cambia la comparación ETS–ARIMA–naïve estacional?
MASE. Verifique manualmente el denominador estacional de MASE para una de las ventanas de Sección 8.19.
Origen móvil. Repita Sección 8.19 con .step = 1. Compare RMSE\((h)\).
Ventana móvil. Reemplace stretch_tsibble() por slide_tsibble(.size = 48, .step = 2). Discuta si una ventana móvil tiene sentido económico para esta serie.
Intervalos. Compare cobertura y amplitud de niveles 80% y 95%.
Winkler. Aplique la puntuación de Winkler de la semana 7 a los tres procedimientos de Sección 8.19.
CRPS. Si el tiempo de cómputo lo permite, compare las distribuciones predictivas mediante CRPS.
Transformación. Ajuste modelos ETS a log(Trips) y transforme los pronósticos a la escala original. Discuta cuidadosamente la diferencia entre transformar una media y calcular una media después de la transformación inversa.
Benchmark. Elimine el naïve estacional de la comparación y escriba una crítica metodológica de ese experimento.
Horizonte. Repita la validación para \(h=4\) y \(h=12\). Explique por qué cambiar el horizonte puede cambiar la conclusión.
Informe breve. Redacte una conclusión de máximo 200 palabras sobre la aplicación de turismo que incluya: modelo de referencia, diseño temporal, métrica principal, incertidumbre y una limitación.
8.30 Lecturas recomendadas
Hyndman y Athanasopoulos: capítulo 8 para suavizamiento exponencial, Holt, Holt–Winters, taxonomía ETS, representación de innovaciones, estimación, selección y pronóstico (Hyndman y Athanasopoulos 2021, chap. 8).
Hyndman y Athanasopoulos: capítulo 5 para mantener el protocolo de métodos de referencia, evaluación fuera de muestra y validación temporal utilizado en la aplicación (Hyndman y Athanasopoulos 2021, chap. 5).
Petris, Petrone y Campagnoli: sección 3.1 para la conexión entre métodos empíricos de suavizamiento y modelos dinámicos; capítulos 2–3 para preparar el bloque posterior de espacio-estado (Petris et al. 2009).
Prado, Ferreira y West: capítulo 4 como preparación para la formulación de modelos lineales dinámicos, filtrado, pronóstico y actualización secuencial (Prado et al. 2021, chap. 4).
Shumway y Stoffer: capítulo 6 para el desarrollo clásico de modelos de espacio-estado que retomaremos en las semanas 11 y 12 (Shumway y Stoffer 2025, chap. 6).
La semana 9 cambia de perspectiva y estudia la serie en el dominio de la frecuencia. Volveremos después a las ideas de estado e innovación cuando iniciemos formalmente los modelos de espacio-estado.
Hyndman, Rob J., y George Athanasopoulos. 2021. Forecasting: Principles and Practice. 3.ª ed. OTexts. https://otexts.com/fpp3/.
O’Hara-Wild, Mitchell, Rob Hyndman, Earo Wang, y Rakshitha Godahewa. 2022. tsibbledata: Diverse Datasets for ’tsibble’. https://tsibbledata.tidyverts.org/.
Petris, Giovanni, Sonia Petrone, y Patrizia Campagnoli. 2009. Dynamic Linear Models with R. Springer. https://doi.org/10.1007/b135794.
Prado, Raquel, Marco A. R. Ferreira, y Mike West. 2021. Time Series: Modeling, Computation, and Inference. 2.ª ed. Chapman; Hall/CRC.
Shumway, Robert H., y David S. Stoffer. 2025. Time Series Analysis and Its Applications: With R Examples. 5.ª ed. Springer. https://doi.org/10.1007/978-3-031-70584-7.