n_componentes <- 180
t_componentes <- seq_len(n_componentes)

comp_lenta <- 2.5 * cos(2 * pi * t_componentes / 12)
comp_rapida <- 1.4 * cos(2 * pi * t_componentes / 4 + 0.8)
ruido_componentes <- rnorm(n_componentes, sd = 1)

y_componentes <- comp_lenta + comp_rapida + ruido_componentes

componentes_spec <- tibble(
  t = t_componentes,
  `Componente de periodo 12` = comp_lenta,
  `Componente de periodo 4` = comp_rapida,
  `Serie observada` = y_componentes
) |>
  pivot_longer(
    cols = -t,
    names_to = "componente",
    values_to = "valor"
)9 Análisis espectral
CA-0415 Series de Tiempo — Semana 9
9.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
- distinguir entre una descripción de la dependencia temporal mediante rezagos y una descripción mediante frecuencias;
- convertir correctamente entre frecuencia, frecuencia angular y período;
- explicar la frecuencia de Nyquist y el fenómeno de aliasing;
- formular una regresión armónica con frecuencia conocida e interpretar amplitud y fase;
- definir la densidad espectral de un proceso estacionario y explicar su relación de Fourier con la función de autocovarianza;
- interpretar la densidad espectral como una distribución de la varianza entre frecuencias;
- obtener e interpretar el espectro de modelos de ruido blanco, MA, AR y ARMA;
- explicar cómo raíces autorregresivas complejas se manifiestan como comportamiento oscilatorio tanto en la ACF como en el espectro;
- definir la transformada discreta de Fourier y el periodograma;
- conectar el periodograma con la regresión armónica y reconocer que distintas referencias pueden utilizar normalizaciones diferentes;
- explicar por qué el periodograma crudo no es un estimador consistente de la densidad espectral;
- describir el compromiso sesgo–varianza que surge al suavizar el periodograma;
- explicar el propósito del tapering y su relación con la fuga espectral;
- identificar frecuencias dominantes en una serie real y convertirlas a períodos interpretables;
- comparar una estimación espectral no paramétrica con un espectro paramétrico autorregresivo;
- formular una inferencia bayesiana sencilla para una frecuencia armónica desconocida;
- analizar la sensibilidad de la posterior a una priori uniforme en frecuencia frente a una priori uniforme en período;
- reconocer que detectar una periodicidad dominante no garantiza por sí mismo un buen procedimiento de pronóstico;
- preservar, en cualquier comparación predictiva, la separación temporal entre entrenamiento y prueba establecida en Sección 7.3.
En Sección 2.4 y Sección 3.10.3 describimos dependencia temporal preguntando cuánto se relaciona una observación con otra situada \(h\) períodos antes. Ese punto de vista será llamado dominio temporal. Esta semana utilizaremos una representación equivalente para procesos estacionarios: preguntaremos qué proporción de la variabilidad aparece en oscilaciones lentas, intermedias o rápidas. Ese es el dominio frecuencial.
La guía bibliográfica del curso asigna esta semana al análisis espectral, con Shumway y Stoffer (2025), cap. 4 como referencia principal para teoría clásica y Prado et al. (2021), cap. 3 para regresión armónica, periodograma, teoría espectral y una introducción a inferencia bayesiana sobre frecuencias. El propósito no es desarrollar teoría de medidas espectrales en toda su generalidad, sino comprender la correspondencia entre los dos dominios y usarla para interpretar datos y modelos.
El hilo conductor será
\[ \boxed{ \text{oscilaciones} \longrightarrow \text{frecuencia y período} \longrightarrow \text{densidad espectral} \longrightarrow \text{DFT y periodograma} \longrightarrow \text{suavizamiento} \longrightarrow \text{inferencia sobre frecuencias} \longrightarrow \text{implicaciones predictivas} }. \]
9.2 ¿Por qué mirar una serie desde las frecuencias?
Considere una serie construida a partir de dos oscilaciones y ruido:
\[ Y_t = 2.5\cos(2\pi\nu_1 t) + 1.4\cos(2\pi\nu_2 t+0.8) + \varepsilon_t, \qquad \varepsilon_t\sim N(0,1), \tag{9.1}\]
con
\[ \nu_1=\frac{1}{12}, \qquad \nu_2=\frac{1}{4}. \]
La primera componente completa un ciclo aproximadamente cada 12 observaciones y la segunda cada 4.
componentes_spec |>
  ggplot(aes(x = t, y = valor)) +
  geom_line(linewidth = 0.55) +
  facet_wrap(~ componente, ncol = 1, scales = "free_y") +
  labs(
    x = "Tiempo",
    y = NULL
  )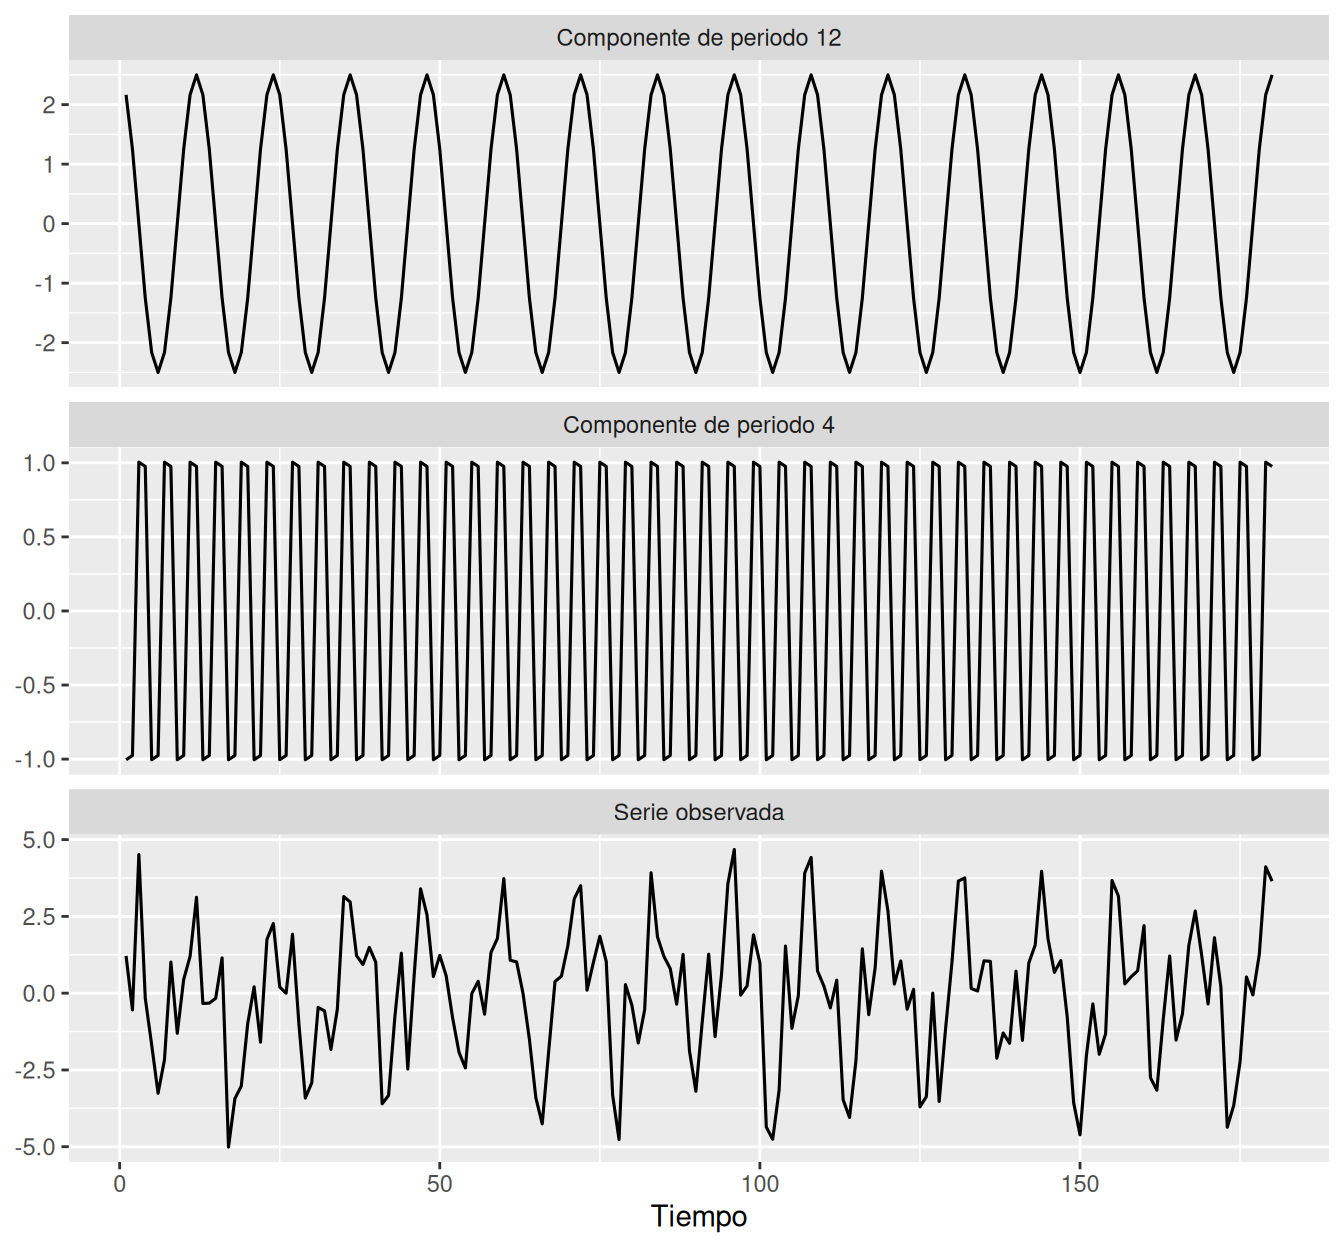
Una inspección temporal puede sugerir que existe comportamiento cíclico, pero separar las dos escalas no siempre es sencillo. El dominio frecuencial reorganiza la misma información de una manera especialmente útil cuando la pregunta científica se refiere a periodicidades.
ImportanteFrecuencia no significa tendencia
Una oscilación periódica no es lo mismo que una tendencia. Una tendencia concentra variación en escalas temporales muy largas y puede provocar gran potencia cerca de frecuencia cero. Por esa razón, antes de interpretar un espectro suele ser necesario pensar si la media es aproximadamente constante o si conviene remover una tendencia determinista.
9.3 Frecuencia, período y fase
9.3.1 Dos convenciones de frecuencia
En la literatura aparecen dos convenciones principales. Para evitar factores de \(2\pi\) implícitos utilizaremos ambas de forma explícita.
Sea
\[ \nu = \text{frecuencia en ciclos por unidad de tiempo}, \]
y defina la frecuencia angular
\[ \omega=2\pi\nu. \tag{9.2}\]
El período correspondiente es
\[ P = \frac{1}{\nu} = \frac{2\pi}{\omega}. \tag{9.3}\]
Por ejemplo, una oscilación anual observada en datos mensuales tiene
\[ P=12\text{ meses}, \qquad \nu=\frac{1}{12}\text{ ciclos/mes}, \qquad \omega=\frac{\pi}{6}\text{ radianes/mes}. \]
| Cantidad | Notación | Interpretación |
|---|---|---|
| Frecuencia | \(\nu\) | Ciclos por unidad de tiempo |
| Frecuencia angular | \(\omega = 2\pi\nu\) | Radianes por unidad de tiempo |
| Período | \(P = 1/\nu = 2\pi/\omega\) | Unidades de tiempo por ciclo |
| Nyquist con muestreo unitario | \(\nu = 1/2\); \(\omega = \pi\) | Máxima frecuencia distinguible sin aliasing |
Shumway y Stoffer (2025), cap. 4 trabaja principalmente con \(\nu\) en ciclos por punto y escribe exponentes de la forma \(e^{-2\pi i\nu t}\). Prado et al. (2021), cap. 3 utiliza con frecuencia \(\omega\) en radianes y exponentes \(e^{-i\omega t}\). Las dos formulaciones son equivalentes mediante Ecuación 9.2.
9.3.2 Amplitud y fase
Una sola componente armónica puede escribirse como
\[ \mu_t = A\cos(2\pi\nu t-\delta), \tag{9.4}\]
con:
- \(A>0\): amplitud;
- \(\nu\): frecuencia;
- \(P=1/\nu\): período;
- \(\delta\): fase.
La amplitud controla el tamaño de la oscilación. La fase desplaza el ciclo horizontalmente sin cambiar su frecuencia.
9.4 Frecuencia de Nyquist y aliasing
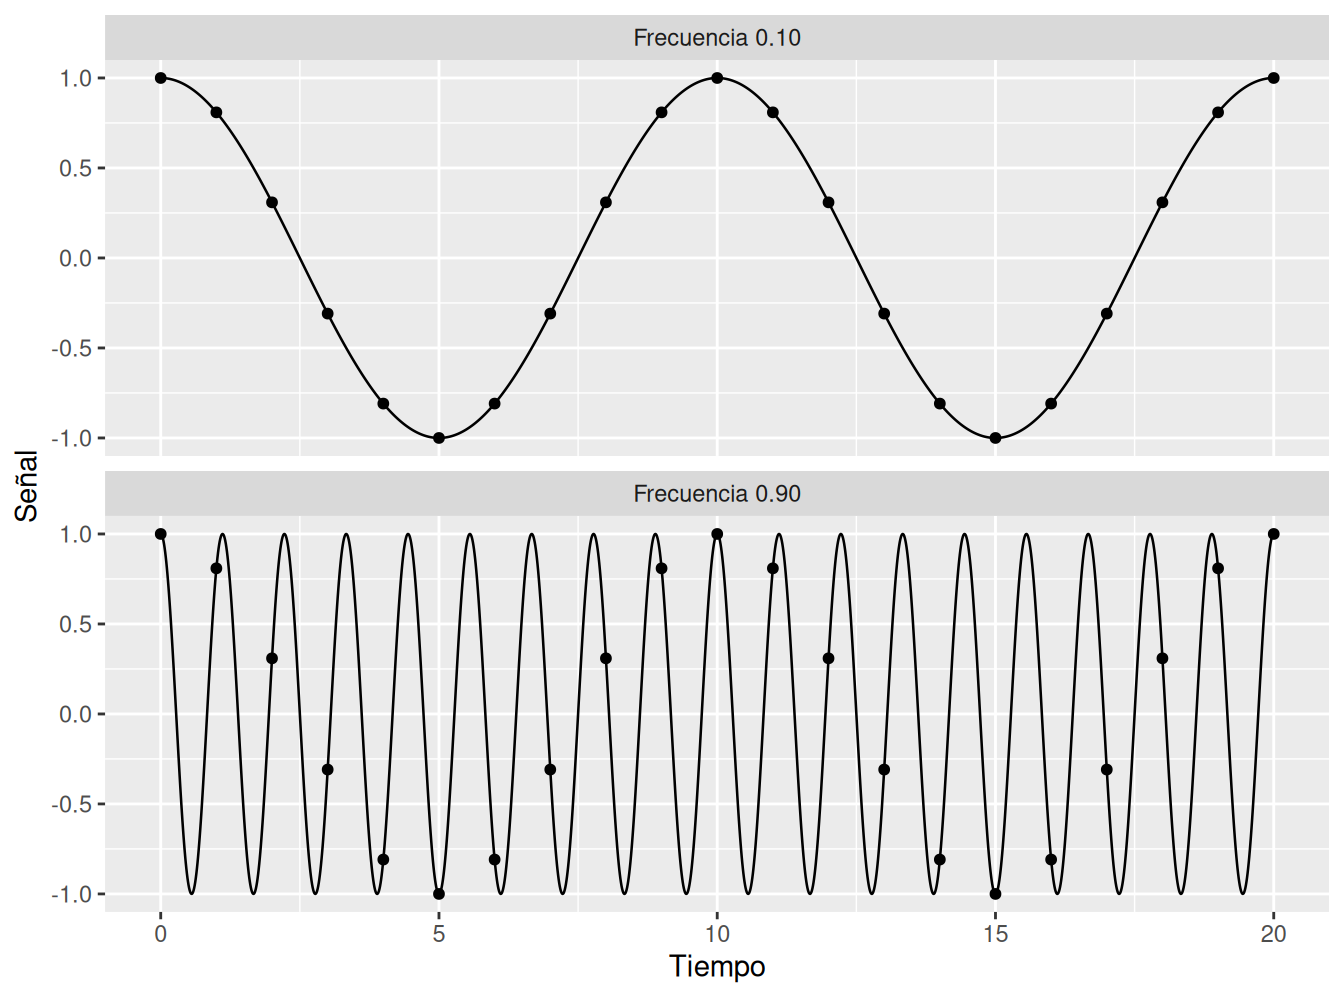
Suponga que observamos una señal únicamente en tiempos enteros
\[ t=0,1,2,\ldots. \]
Para cualquier entero \(t\),
\[ \cos\{2\pi(1-\nu)t\} = \cos(2\pi t-2\pi\nu t) = \cos(2\pi\nu t). \]
Por tanto, las frecuencias \(\nu\) y \(1-\nu\) generan exactamente los mismos valores muestreados. Para series reales con intervalo de muestreo igual a una unidad, la información no redundante puede restringirse a
\[ 0\leq\nu\leq\frac12. \]
La frecuencia
\[ \nu_N=\frac12 \]
se denomina frecuencia de Nyquist o frecuencia de plegamiento. Corresponde a un período de dos observaciones.
alias_cont <- crossing(
  señal = c("Frecuencia 0.10", "Frecuencia 0.90"),
  t = seq(0, 20, length.out = 2001)
) |>
  mutate(
    freq = if_else(señal == "Frecuencia 0.10", 0.10, 0.90),
    valor = cos(2 * pi * freq * t)
  )

alias_muestra <- crossing(
  señal = c("Frecuencia 0.10", "Frecuencia 0.90"),
  t = 0:20
) |>
  mutate(
    freq = if_else(señal == "Frecuencia 0.10", 0.10, 0.90),
    valor = cos(2 * pi * freq * t)
  )
alias_cont |>
ggplot(aes(x = t, y = valor)) +
geom_line(linewidth = 0.45) +
geom_point(
data = alias_muestra,
size = 1.4
) +
facet_wrap(~ señal, ncol = 1) +
labs(
x = "Tiempo",
y = "Señal"
)
NotaLa unidad de tiempo importa
Si una serie se observa cada \(\Delta\) unidades de tiempo, la frecuencia de Nyquist es \(1/(2\Delta)\) ciclos por unidad de tiempo. No existe una frecuencia de Nyquist universal: depende de la resolución de muestreo.
9.5 Regresión armónica
Una primera forma de modelar comportamiento periódico consiste en tratar la frecuencia como conocida y estimar amplitud y fase mediante regresión.
Considere
\[ Y_t = \mu + \alpha_1\cos(2\pi\nu t) + \alpha_2\sin(2\pi\nu t) + \varepsilon_t, \tag{9.5}\]
con
\[ \varepsilon_t\stackrel{\text{iid}}{\sim}N(0,\sigma^2). \]
Para una frecuencia fija \(\nu\), el modelo es una regresión lineal ordinaria en los regresores
\[ \cos(2\pi\nu t) \quad\text{y}\quad \sin(2\pi\nu t). \]
9.5.1 De coeficientes lineales a amplitud y fase
Usando
\[ A\cos(2\pi\nu t-\delta) = A\cos(\delta)\cos(2\pi\nu t) + A\sin(\delta)\sin(2\pi\nu t), \]
obtenemos
\[ \alpha_1=A\cos(\delta), \qquad \alpha_2=A\sin(\delta). \]
Por tanto, la amplitud de la oscilación es
\[ A = \sqrt{\alpha_1^2+\alpha_2^2}, \tag{9.6}\]
mientras que la fase se obtiene a partir del ángulo del vector \((\alpha_1,\alpha_2)\). En principio podríamos pensar en utilizar
\[ \arctan\left(\frac{\alpha_2}{\alpha_1}\right), \]
pero esta expresión no distingue correctamente los cuadrantes y además presenta problemas cuando \(\alpha_1=0\). Por esta razón utilizamos la función de dos argumentos \(\operatorname{atan2}(y,x)\), que determina el ángulo teniendo en cuenta por separado los signos de ambas coordenadas. En nuestro caso,
\[ \delta = \operatorname{atan2}(\alpha_2,\alpha_1). \tag{9.7}\]
Geométricamente, \((\alpha_1,\alpha_2)\) son las coordenadas cartesianas de un vector cuya longitud es \(A\) y cuyo ángulo es \(\delta\):
\[ \alpha_1=A\cos(\delta), \qquad \alpha_2=A\sin(\delta). \]
Así, el paso de \((\alpha_1,\alpha_2)\) a \((A,\delta)\) no es más que una transformación de coordenadas cartesianas a polares. En R, esta operación se implementa como atan2(alpha2, alpha1).
La fase queda definida módulo \(2\pi\). Si \(A=0\), entonces \(\alpha_1=\alpha_2=0\) y la fase no está identificada.
9.5.2 Ejemplo con frecuencia conocida
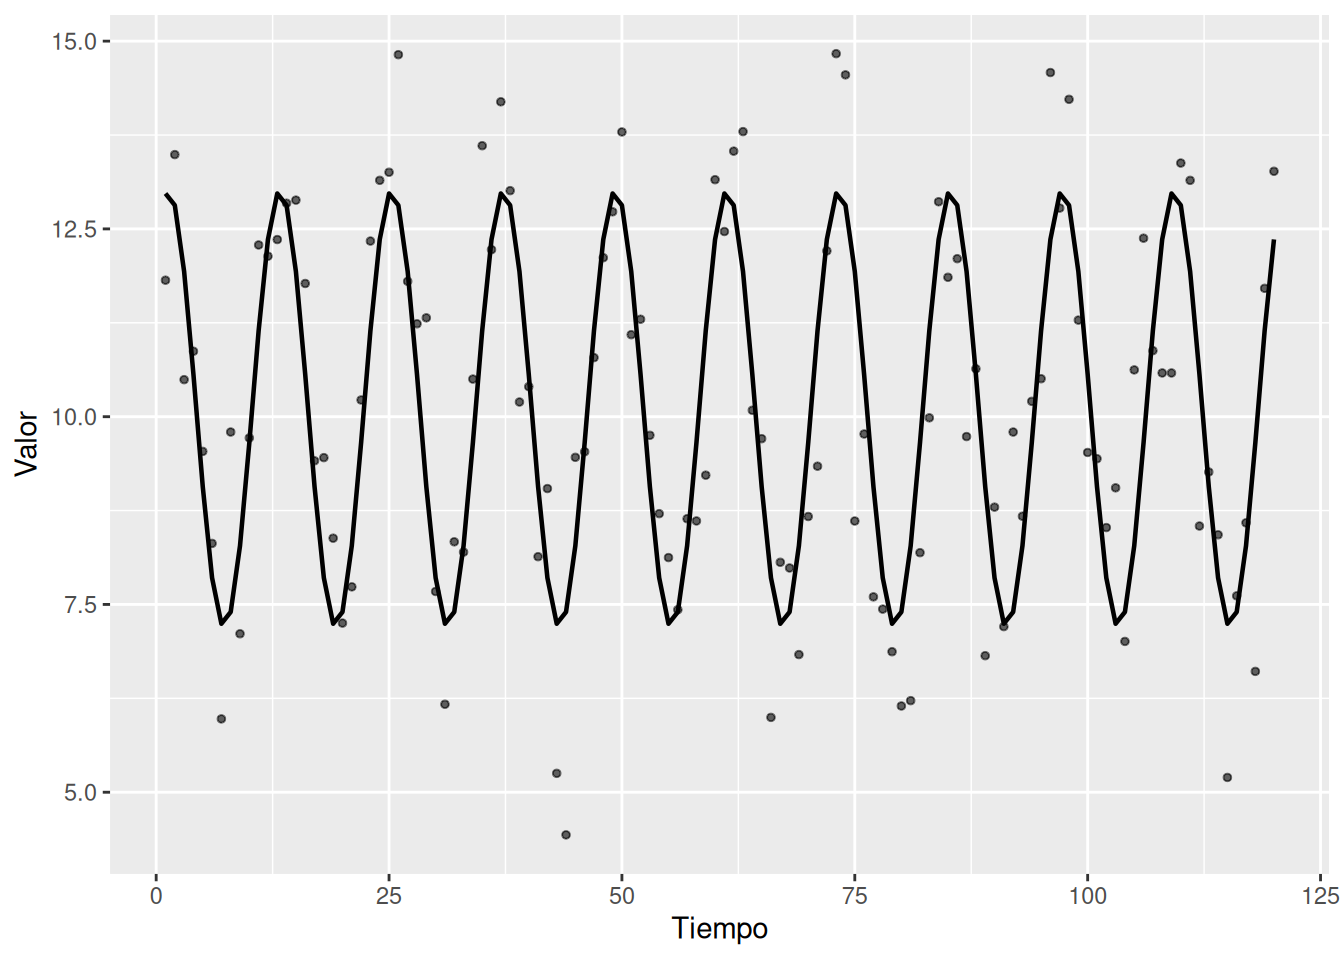
Simulamos una señal con período 12.
n_armonica <- 120
t_armonica <- seq_len(n_armonica)
nu_armonica <- 1 / 12
A_armonica <- 3
fase_armonica <- 0.8
mu_armonica <- 10

y_armonica <-
  mu_armonica +
  A_armonica * cos(2 * pi * nu_armonica * t_armonica - fase_armonica) +
  rnorm(n_armonica, sd = 1.2)

datos_armonica <- tibble(
  t = t_armonica,
  y = y_armonica,
  cos_nu = cos(2 * pi * nu_armonica * t_armonica),
  sin_nu = sin(2 * pi * nu_armonica * t_armonica)
)

fit_armonica <- lm(y ~ cos_nu + sin_nu, data = datos_armonica)

coef_armonica <- coef(fit_armonica)
A_hat_armonica <- sqrt(coef_armonica["cos_nu"]^2 + coef_armonica["sin_nu"]^2)
fase_hat_armonica <- atan2(coef_armonica["sin_nu"], coef_armonica["cos_nu"])

resumen_armonica <- tibble(
  parametro = c("Media", "Amplitud", "Fase", "Periodo"),
  verdadero = c(mu_armonica, A_armonica, fase_armonica, 1 / nu_armonica),
  estimado = c(
    coef_armonica["(Intercept)"],
    A_hat_armonica,
    fase_hat_armonica,
    1 / nu_armonica
  )
)knitr::kable(
resumen_armonica,
digits = 3,
caption = "Parámetros verdaderos y estimados en una regresión armónica con frecuencia conocida."
)| parametro | verdadero | estimado |
|---|---|---|
| Media | 10.0 | 10.107 |
| Amplitud | 3.0 | 2.900 |
| Fase | 0.8 | 0.681 |
| Periodo | 12.0 | 12.000 |
augment_armonica <- datos_armonica |>
  mutate(ajuste = fitted(fit_armonica))

augment_armonica |>
  ggplot(aes(x = t)) +
  geom_point(aes(y = y), size = 1, alpha = 0.6) +
  geom_line(aes(y = ajuste), linewidth = 0.8) +
  labs(
    x = "Tiempo",
    y = "Valor"
  )
Cuando \(\nu\) es desconocida, el problema cambia. Podemos comparar ajustes para muchas frecuencias candidatas. El periodograma permitirá realizar precisamente esa exploración de manera muy eficiente (Prado et al. 2021, secs. 3.1.1–3.1.2).
9.6 Densidad espectral
9.6.1 De la autocovarianza a la frecuencia
Sea \(\{Y_t\}\) un proceso débilmente estacionario con media constante y función de autocovarianza
\[ \gamma(h) = \operatorname{Cov}(Y_{t+h},Y_t). \]
Si
\[ \sum_{h=-\infty}^{\infty} |\gamma(h)|<\infty, \tag{9.8}\]
la densidad espectral puede definirse como la transformada de Fourier
\[ f(\nu) = \sum_{h=-\infty}^{\infty} \gamma(h)e^{-2\pi i\nu h}, \qquad -\frac12\leq\nu\leq\frac12. \tag{9.9}\]
La transformación es invertible:
\[ \gamma(h) = \int_{-1/2}^{1/2} f(\nu)e^{2\pi i\nu h}\,d\nu, \qquad h=0,\pm1,\pm2,\ldots \tag{9.10}\]
(Shumway y Stoffer 2025, sec. 4.2).
La ACF y la densidad espectral contienen, bajo estas condiciones, la misma información de segundo orden. Lo que cambia es la organización de esa información:
- \(\gamma(h)\) y \(\rho(h)\) la organizan por rezago;
- \(f(\nu)\) la organiza por frecuencia.
Esta equivalencia explica por qué un proceso con ACF oscilatoria produce un espectro con potencia concentrada alrededor de determinadas frecuencias.
Nota¿Cómo debe interpretarse la exponencial compleja?
En la expresión
\[ f(\nu) = \sum_{h=-\infty}^{\infty} \gamma(h)e^{-2\pi i\nu h}, \qquad -\frac12\leq \nu\leq\frac12, \]
la exponencial se entiende como la exponencial compleja. Por la fórmula de Euler,
\[ e^{-2\pi i\nu h} = \cos(2\pi\nu h) - i\sin(2\pi\nu h), \]
donde \(i\) es la unidad imaginaria, \(i^2=-1\). Por tanto, formalmente la transformada de Fourier puede escribirse como
\[ f(\nu) = \sum_{h=-\infty}^{\infty} \gamma(h)\cos(2\pi\nu h) - i \sum_{h=-\infty}^{\infty} \gamma(h)\sin(2\pi\nu h). \]
A primera vista esto parece producir una cantidad compleja. Sin embargo, para un proceso estacionario real la función de autocovarianza es par:
\[ \gamma(-h)=\gamma(h). \]
Por otro lado,
\[ \cos(-2\pi\nu h)=\cos(2\pi\nu h), \]
mientras que
\[ \sin(-2\pi\nu h)=-\sin(2\pi\nu h). \]
Así, los términos imaginarios asociados con los rezagos \(h\) y \(-h\) se cancelan. En efecto,
\[ \gamma(h)e^{-2\pi i\nu h} + \gamma(-h)e^{2\pi i\nu h} = 2\gamma(h)\cos(2\pi\nu h). \]
Por esta razón, para una serie real podemos escribir de manera equivalente
\[ \boxed{ f(\nu) = \gamma(0) + 2\sum_{h=1}^{\infty} \gamma(h)\cos(2\pi\nu h) }. \tag{9.11}\]
Esta última expresión deja claro que la densidad espectral es una función real. La notación mediante \(e^{-2\pi i\nu h}\) se utiliza porque es mucho más compacta y porque las exponenciales complejas tienen propiedades algebraicas particularmente convenientes para trabajar con transformadas de Fourier.
Además, bajo la condición de sumabilidad absoluta
\[ \sum_{h=-\infty}^{\infty}|\gamma(h)|<\infty, \]
la serie anterior está bien definida. Como
\[ \left|e^{-2\pi i\nu h}\right|=1, \]
tenemos
\[ \sum_{h=-\infty}^{\infty} \left| \gamma(h)e^{-2\pi i\nu h} \right| = \sum_{h=-\infty}^{\infty}|\gamma(h)| <\infty. \]
Por tanto, la serie de Fourier converge absolutamente; de hecho, bajo esta condición la convergencia es uniforme en \(\nu\).
Finalmente, debe notarse que estamos utilizando \(\nu\) en ciclos por unidad de tiempo. Por eso aparece \(2\pi\nu\). Si utilizáramos directamente la frecuencia angular
\[ \omega=2\pi\nu, \]
la misma transformada se escribiría como
\[ f(\omega) \propto \sum_{h=-\infty}^{\infty} \gamma(h)e^{-i\omega h}, \]
con la constante de normalización correspondiente a la convención elegida.
9.6.2 Propiedades básicas
Como \(\gamma(h)=\gamma(-h)\) para un proceso real estacionario, la densidad espectral es real y par:
\[ f(\nu)=f(-\nu). \tag{9.12}\]
Además,
\[ f(\nu)\geq0. \]
Al poner \(h=0\) en Ecuación 9.10 obtenemos
\[ \gamma(0) = \operatorname{Var}(Y_t) = \int_{-1/2}^{1/2} f(\nu)\,d\nu. \tag{9.13}\]
Por tanto, la varianza total puede entenderse como la suma continua de contribuciones asociadas con distintas frecuencias.
ImportantePotencia en una banda, no “probabilidad de una frecuencia”
La densidad espectral se parece formalmente a una densidad de probabilidad porque es no negativa y su integral produce la varianza. Sin embargo, \(f(\nu)\) no es por sí sola una densidad de probabilidad sobre \(\nu\). Si se normaliza por \(\gamma(0)\), entonces sí puede interpretarse como una distribución relativa de la varianza entre frecuencias.
9.6.3 Forma real mediante la ACF
Usando la simetría de \(\gamma(h)\),
\[ f(\nu) = \gamma(0) + 2\sum_{h=1}^{\infty} \gamma(h)\cos(2\pi\nu h). \tag{9.14}\]
Equivalentemente,
\[ f(\nu) = \gamma(0) \left[ 1 + 2\sum_{h=1}^{\infty} \rho(h)\cos(2\pi\nu h) \right]. \tag{9.15}\]
Esta ecuación ofrece una conexión directa con las semanas 2 y 3: cualquier estructura en la ACF se redistribuye en el dominio frecuencial mediante términos cosenoidales.
9.7 Espectro de modelos conocidos
9.7.1 Ruido blanco
Para ruido blanco con varianza \(\sigma_w^2\),
\[ \gamma(0)=\sigma_w^2, \qquad \gamma(h)=0\quad(h\neq0). \]
Por Ecuación 9.9,
\[ f_W(\nu)=\sigma_w^2. \tag{9.16}\]
El espectro es plano: todas las frecuencias tienen la misma potencia. Esta es la razón del término ruido blanco, por analogía con luz blanca que contiene un rango amplio de frecuencias.
9.7.2 Filtrado lineal y función de transferencia
Suponga que
\[ Y_t = \sum_{j=-\infty}^{\infty}a_jX_{t-j}, \]
con coeficientes absolutamente sumables. La función
\[ A(\nu) = \sum_{j=-\infty}^{\infty} a_je^{-2\pi i\nu j} \tag{9.17}\]
se denomina respuesta en frecuencia del filtro. Si \(X_t\) tiene espectro \(f_X(\nu)\), entonces
\[ f_Y(\nu) = |A(\nu)|^2f_X(\nu). \tag{9.18}\]
(Shumway y Stoffer 2025, sec. 4.2).
El resultado es la contraparte frecuencial de la idea de que multiplicar una variable por \(a\) multiplica su varianza por \(a^2\): aquí la amplificación depende de la frecuencia.
9.7.3 Espectro ARMA
Para un ARMA\((p,q)\) causal,
\[ \phi(B)Y_t = \theta(B)W_t, \]
con
\[ \phi(z)=1-\phi_1z-\cdots-\phi_pz^p, \]
y
\[ \theta(z)=1+\theta_1z+\cdots+\theta_qz^q, \]
la representación lineal tiene función de transferencia
\[ \Psi(z) = \frac{\theta(z)}{\phi(z)}. \]
Como el ruido blanco tiene espectro constante, Ecuación 9.18 produce
\[ f_Y(\nu) = \sigma_w^2 \frac{ |\theta(e^{-2\pi i\nu})|^2 }{ |\phi(e^{-2\pi i\nu})|^2 }. \tag{9.19}\]
Este resultado une directamente la teoría ARMA de Sección 3.8 con el dominio frecuencial (Shumway y Stoffer 2025, sec. 4.2).
| Modelo | Densidad espectral |
|---|---|
| Ruido blanco | \(\sigma_w^2\) |
| MA(1) | \(\sigma_w^2\left|1+\theta e^{-2\pi i\nu}\right|^2\) |
| AR(1) | \(\displaystyle \frac{\sigma_w^2}{\left|1-\phi e^{-2\pi i\nu}\right|^2}\) |
| ARMA\((p,q)\) | \(\displaystyle \sigma_w^2\frac{\left|\theta\left(e^{-2\pi i\nu}\right)\right|^2}{\left|\phi\left(e^{-2\pi i\nu}\right)\right|^2}\) |
9.7.4 Interpretación de algunos espectros
freq_grid_teorico <- seq(0, 0.5, length.out = 1001)

espectros_teoricos <- bind_rows(
  tibble(
    freq = freq_grid_teorico,
    espectro = espectro_arma(freq_grid_teorico, sigma2 = 1),
    modelo = "Ruido blanco"
  ),
  tibble(
    freq = freq_grid_teorico,
    espectro = espectro_arma(freq_grid_teorico, ma = -0.8, sigma2 = 1),
    modelo = "MA(1): theta = -0.8"
  ),
  tibble(
    freq = freq_grid_teorico,
    espectro = espectro_arma(freq_grid_teorico, ar = 0.8, sigma2 = 1),
    modelo = "AR(1): phi = 0.8"
  ),
  tibble(
    freq = freq_grid_teorico,
    espectro = espectro_arma(freq_grid_teorico, ar = c(1.6, -0.9), sigma2 = 1),
    modelo = "AR(2): phi1 = 1.6, phi2 = -0.9"
  )
)
espectros_teoricos |>
ggplot(aes(x = freq, y = espectro)) +
geom_line(linewidth = 0.75) +
facet_wrap(~ modelo, scales = "free_y") +
labs(
x = "Frecuencia (ciclos por observación)",
y = "Densidad espectral"
)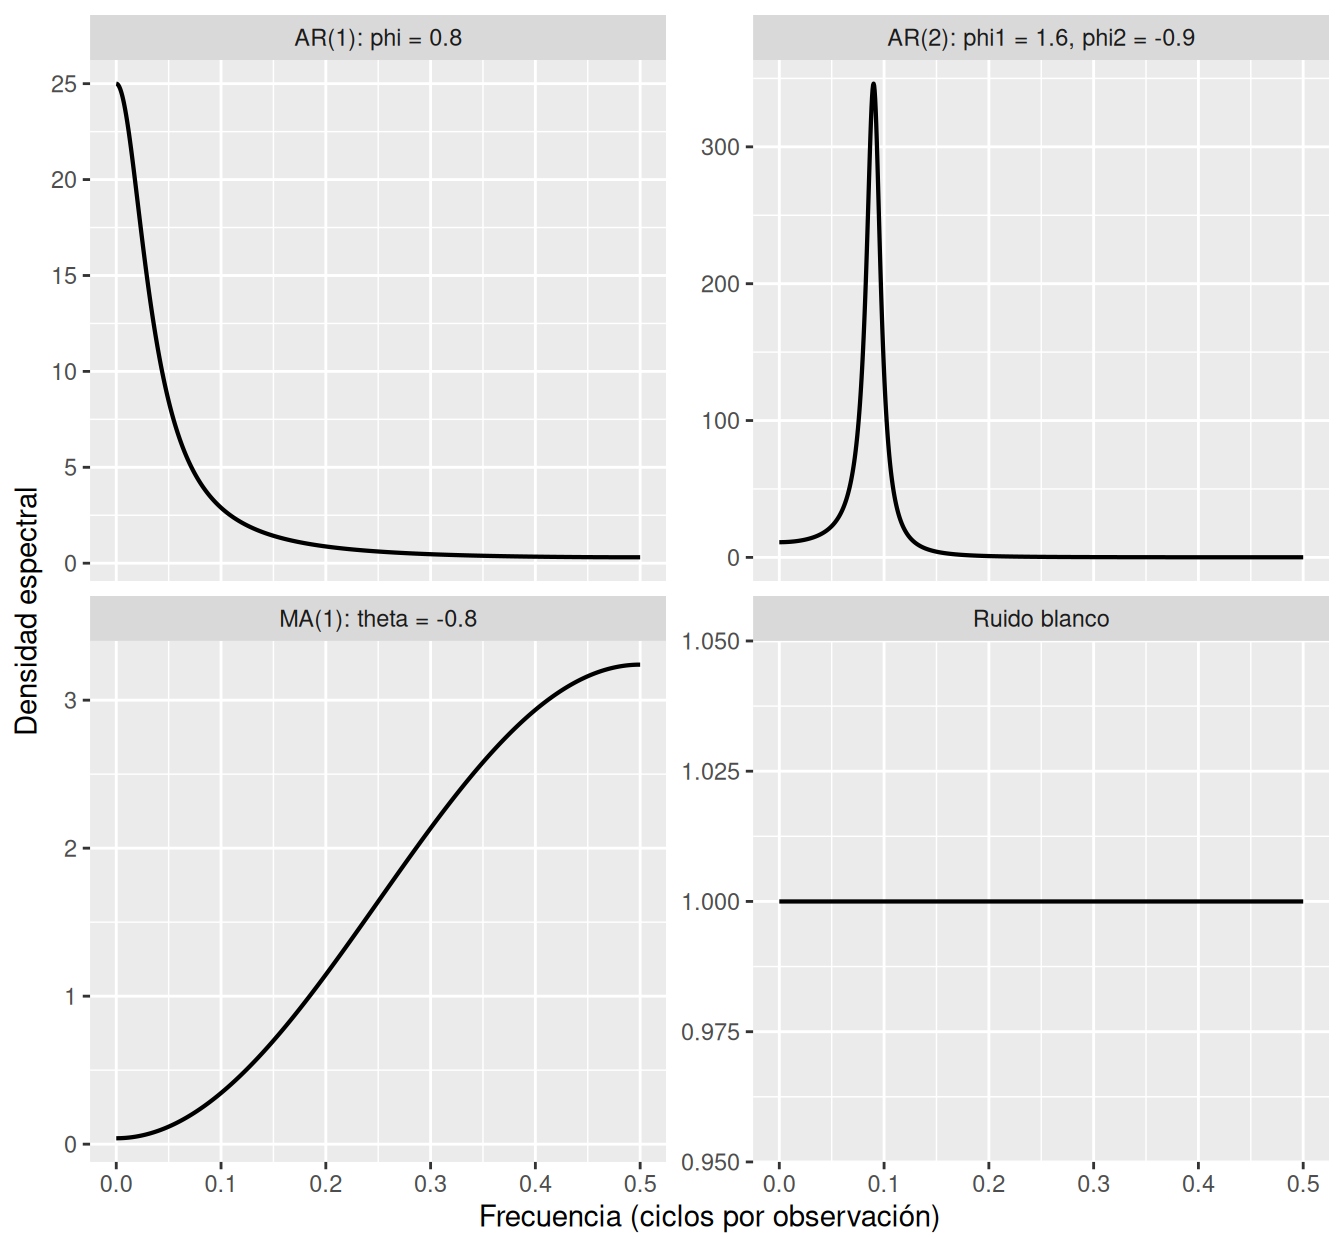
La figura permite reinterpretar resultados ya conocidos.
- En un AR(1) con \(\phi>0\), la ACF decae lentamente y mantiene el mismo signo. El espectro concentra potencia cerca de frecuencia cero: predominan cambios relativamente lentos.
- Un MA(1) con \(\theta<0\) favorece alternancia entre observaciones sucesivas y concentra más potencia hacia frecuencias altas.
- Un AR(2) con raíces complejas exhibe ACF amortiguada y oscilatoria, como estudiamos en Sección 2.9.2. En frecuencia, la misma estructura aparece como un pico interior alrededor de la escala cíclica dominante.
NotaUna raíz compleja no crea una periodicidad determinista perfecta
Un pico espectral de un AR(2) no significa que la serie sea una senoide sin ruido. El modelo sigue siendo estocástico. Las raíces complejas indican una preferencia de variación alrededor de cierta frecuencia y una ACF oscilatoria amortiguada.
9.8 Transformada discreta de Fourier
Hasta ahora \(f(\nu)\) es una propiedad poblacional. Para trabajar con una muestra
\[ y_1,\ldots,y_n, \]
necesitamos cantidades calculables a partir de los datos.
Las frecuencias de Fourier son
\[ \nu_j = \frac{j}{n}, \qquad j=0,1,\ldots,n-1. \tag{9.20}\]
Para una serie centrada, la transformada discreta de Fourier (DFT) bajo la normalización de Shumway y Stoffer (2025), sec. 4.3 es
\[ d(\nu_j) = \frac{1}{\sqrt n} \sum_{t=1}^{n} (y_t-\bar y)e^{-2\pi i\nu_jt}. \tag{9.21}\]
La DFT transforma \(n\) observaciones temporales en \(n\) coeficientes complejos. La transformación es uno a uno: mediante la transformada inversa se puede reconstruir la serie.
9.8.1 Interpretación del coeficiente complejo
Usando
\[ e^{-ix}=\cos x-i\sin x, \]
podemos escribir
\[ d(\nu_j) = \frac{1}{\sqrt n} \sum_{t=1}^{n}(y_t-\bar y)\cos(2\pi\nu_jt) - \frac{i}{\sqrt n} \sum_{t=1}^{n}(y_t-\bar y)\sin(2\pi\nu_jt). \]
La parte real mide asociación con una componente cosenoidal y la parte imaginaria con una componente senoidal. El módulo combina ambas.
9.8.2 Resolución frecuencial
Las frecuencias de Fourier están separadas por
\[ \Delta\nu = \frac{1}{n}. \tag{9.22}\]
Una serie más larga no aumenta la frecuencia de Nyquist si el intervalo de muestreo se mantiene, pero sí permite resolver frecuencias más cercanas porque disminuye \(1/n\).
ImportanteMás observaciones y muestreo más frecuente resuelven problemas distintos
- Aumentar la longitud temporal observada mejora la resolución entre frecuencias cercanas.
- Reducir el intervalo entre observaciones aumenta la frecuencia de Nyquist y permite estudiar oscilaciones más rápidas.
No son efectos equivalentes.
9.9 El periodograma
El periodograma de Shumway y Stoffer se define como
\[ I_{SS}(\nu_j) = |d(\nu_j)|^2. \tag{9.23}\]
Para datos reales existe simetría en la DFT y en el periodograma, por lo que normalmente se estudian únicamente las frecuencias entre cero y Nyquist.
9.9.1 Cálculo mediante FFT
El algoritmo FFT (fast Fourier transform) calcula la DFT eficientemente. R utiliza una normalización distinta de Ecuación 9.21, por lo que en nuestra función periodograma_fft() dividimos fft(x) por \(\sqrt n\) antes de elevar el módulo al cuadrado.
periodo_componentes <- periodograma_fft(y_componentes) |>
  filter(freq > 0)
periodo_componentes |>
ggplot(aes(x = freq, y = periodograma)) +
geom_col(width = 1 / n_componentes) +
geom_vline(
xintercept = c(1 / 12, 1 / 4),
linetype = 2
) +
labs(
x = "Frecuencia (ciclos por observación)",
y = "Periodograma"
)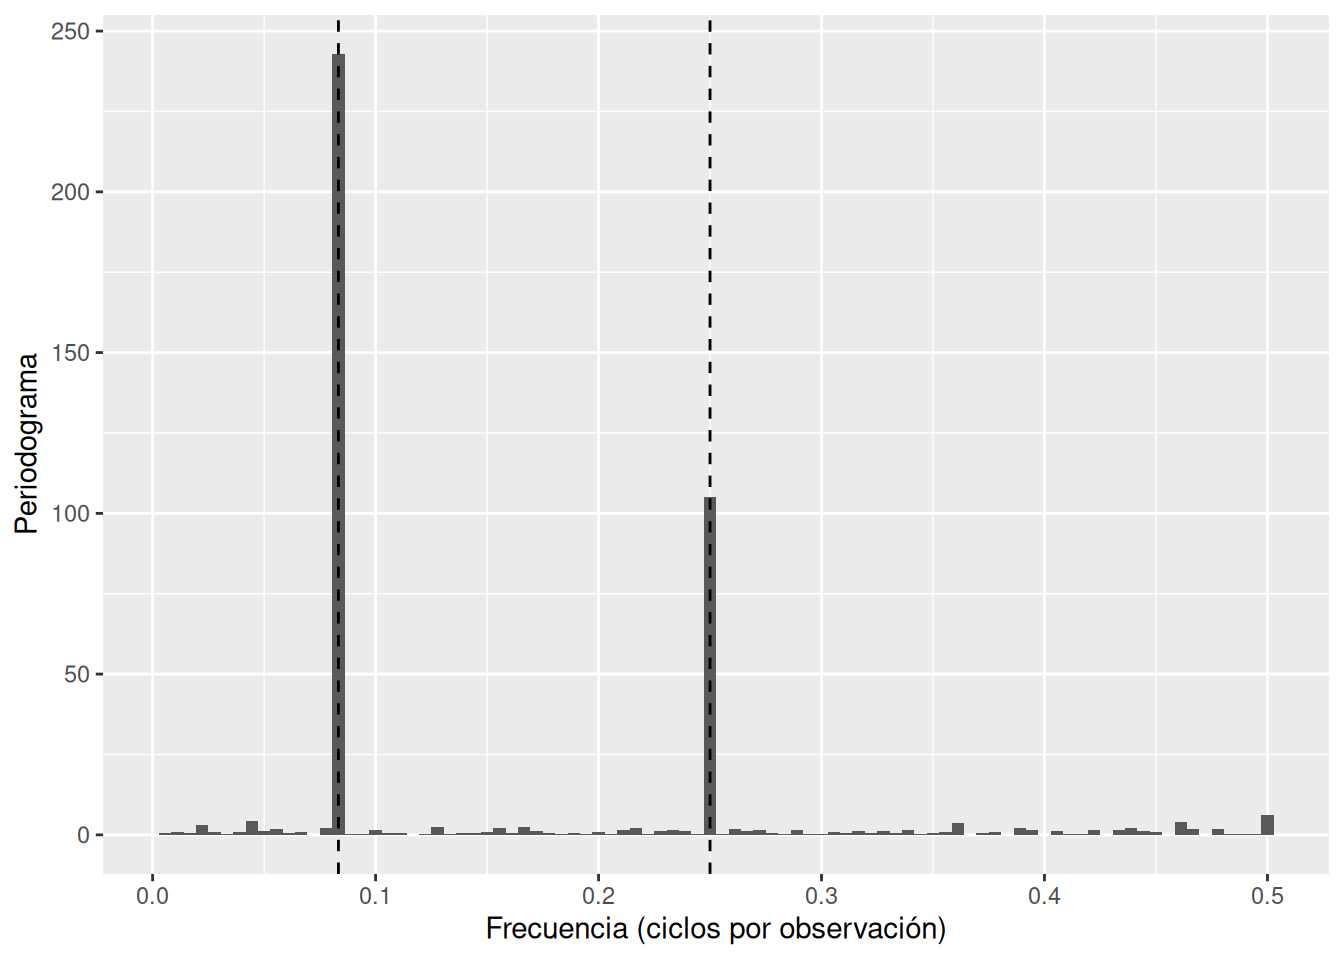
Los picos están cerca de las frecuencias utilizadas para generar la serie. El dominio frecuencial ha separado una estructura que aparecía superpuesta en el gráfico temporal.
9.10 Periodograma y regresión armónica
La conexión con Sección 9.5 es especialmente importante.
Suponga que \(\nu_j=j/n\) es una frecuencia de Fourier interior y que \(y_t\) ha sido centrada. Considere la regresión
\[ y_t = \alpha_{1j}\cos(2\pi\nu_jt) + \alpha_{2j}\sin(2\pi\nu_jt) + \varepsilon_t. \]
Por ortogonalidad de seno y coseno en las frecuencias de Fourier,
\[ \widehat\alpha_{1j} = \frac{2}{n} \sum_{t=1}^n y_t\cos(2\pi\nu_jt), \]
y
\[ \widehat\alpha_{2j} = \frac{2}{n} \sum_{t=1}^n y_t\sin(2\pi\nu_jt). \]
La suma de cuadrados explicada por esa regresión es
\[ SS_{R,j} = \frac{n}{2} \left( \widehat\alpha_{1j}^2 + \widehat\alpha_{2j}^2 \right). \tag{9.24}\]
Con la normalización de Ecuación 9.23,
\[ SS_{R,j} = 2I_{SS}(\nu_j). \tag{9.25}\]
Prado, Ferreira y West definen en su desarrollo de regresión armónica
\[ I_{PFW}(\omega_j) = \frac{n}{2} \left( \widehat\alpha_{1j}^2 + \widehat\alpha_{2j}^2 \right), \tag{9.26}\]
por lo que, en frecuencias interiores,
\[ I_{PFW}(\omega_j) = 2I_{SS}(\nu_j). \tag{9.27}\]
Las dos convenciones producen los mismos picos y la misma ordenación de frecuencias, pero sus ejes verticales difieren por una constante (Prado et al. 2021, secs. 3.1.2, 3.1.6; Shumway y Stoffer 2025, sec. 4.3).
AdvertenciaNo compare alturas de periodogramas sin revisar la normalización
Libros y programas pueden usar factores distintos de \(n\), \(2\), \(2\pi\) o duplicar la potencia en un espectro unilateral. Una frecuencia dominante suele ser estable frente a una multiplicación global, pero una comparación de magnitudes absolutas requiere conocer exactamente la convención utilizada.
9.10.1 Verificación numérica
n_verif <- 120
j_verif <- 10
nu_verif <- j_verif / n_verif
x_verif <- y_armonica - mean(y_armonica)
t_verif <- seq_len(n_verif)

X_verif <- cbind(
  cos = cos(2 * pi * nu_verif * t_verif),
  sin = sin(2 * pi * nu_verif * t_verif)
)

fit_verif <- lm.fit(x = X_verif, y = x_verif)
ssr_verif <- sum((X_verif %*% fit_verif$coefficients)^2)

periodo_verif <- periodograma_fft(x_verif) |>
  filter(j == j_verif) |>
  pull(periodograma)

verificacion_periodo <- tibble(
  cantidad = c("Suma de cuadrados armónica", "2 por periodograma SS"),
  valor = c(ssr_verif, 2 * periodo_verif)
)knitr::kable(
verificacion_periodo,
digits = 6,
caption = "Verificación numérica de la identidad entre regresión armónica y periodograma en una frecuencia de Fourier interior."
)| cantidad | valor |
|---|---|
| Suma de cuadrados armónica | 504.5274 |
| 2 por periodograma SS | 504.5274 |
9.11 Propiedades muestrales del periodograma
9.11.1 Su esperanza se aproxima al espectro
Para una frecuencia de Fourier no nula, el periodograma puede escribirse en términos de autocovarianzas muestrales. Bajo condiciones regulares,
\[ E\{I(\nu_j)\} = \sum_{h=-(n-1)}^{n-1} \left(1-\frac{|h|}{n}\right) \gamma(h)e^{-2\pi i\nu_jh}. \tag{9.28}\]
Cuando \(n\to\infty\) y la autocovarianza decrece suficientemente rápido,
\[ E\{I(\nu_j)\} \longrightarrow f(\nu). \tag{9.29}\]
Este resultado podría sugerir que el periodograma crudo es un estimador satisfactorio. El problema aparece en su varianza.
9.11.2 La varianza no desaparece
Para frecuencias interiores y bajo condiciones regulares, una aproximación fundamental es
\[ I(\nu_j) \ \dot\sim\ \frac{1}{2}f(\nu_j)\chi_2^2. \tag{9.30}\]
Como
\[ \frac{\chi_2^2}{2} \sim \operatorname{Exp}(1), \]
se obtiene aproximadamente
\[ E\{I(\nu_j)\} \approx f(\nu_j), \]
y
\[ \operatorname{Var}\{I(\nu_j)\} \approx f^2(\nu_j). \tag{9.31}\]
La varianza no converge a cero al aumentar \(n\). En consecuencia, el periodograma crudo no es un estimador consistente puntual de la densidad espectral (Shumway y Stoffer 2025, secs. 4.3–4.4; Prado et al. 2021, sec. 3.2.4).
ImportanteMás datos no vuelven lisa una sola ordenada del periodograma
Al aumentar \(n\) obtenemos muchas más frecuencias de Fourier y mejor resolución frecuencial. Sin embargo, cada ordenada interior del periodograma sigue siendo muy variable. La consistencia se obtiene combinando información de frecuencias vecinas, no esperando que una sola ordenada deje de fluctuar.
9.11.3 Experimento Monte Carlo con ruido blanco
Para ruido blanco gaussiano con varianza uno, \(f(\nu)=1\) bajo nuestra convención. Examinaremos la frecuencia \(\nu=0.20\) utilizando tamaños muestrales que la contienen exactamente en la malla de Fourier.
n_mc_spec <- c(100, 500, 1000)
reps_mc_spec <- 800
nu_mc_spec <- 0.20

mc_periodograma <- map_dfr(
  n_mc_spec,
  function(n) {
    t <- seq_len(n)
    c_nu <- cos(2 * pi * nu_mc_spec * t)
    s_nu <- sin(2 * pi * nu_mc_spec * t)

    valores <- replicate(
      reps_mc_spec,
      {
        x <- rnorm(n)
        re <- sum(x * c_nu) / sqrt(n)
        im <- -sum(x * s_nu) / sqrt(n)
        re^2 + im^2
      }
    )

    tibble(
      n = factor(n, levels = n_mc_spec),
      I = valores
    )
  }
)

resumen_mc_periodograma <- mc_periodograma |>
  group_by(n) |>
  summarise(
    media = mean(I),
    varianza = var(I),
    mediana = median(I),
    .groups = "drop"
)knitr::kable(
resumen_mc_periodograma,
digits = 3,
caption = "Media y varianza Monte Carlo de una ordenada del periodograma para ruido blanco con espectro igual a uno."
)| n | media | varianza | mediana |
|---|---|---|---|
| 100 | 0.991 | 0.986 | 0.703 |
| 500 | 0.988 | 0.913 | 0.699 |
| 1000 | 0.956 | 0.958 | 0.649 |
mc_periodograma |>
  ggplot(aes(x = I, linetype = n)) +
  geom_density(linewidth = 0.8) +
  coord_cartesian(xlim = c(0, 6)) +
  labs(
    x = "Ordenada del periodograma",
    y = "Densidad",
    linetype = "n"
  )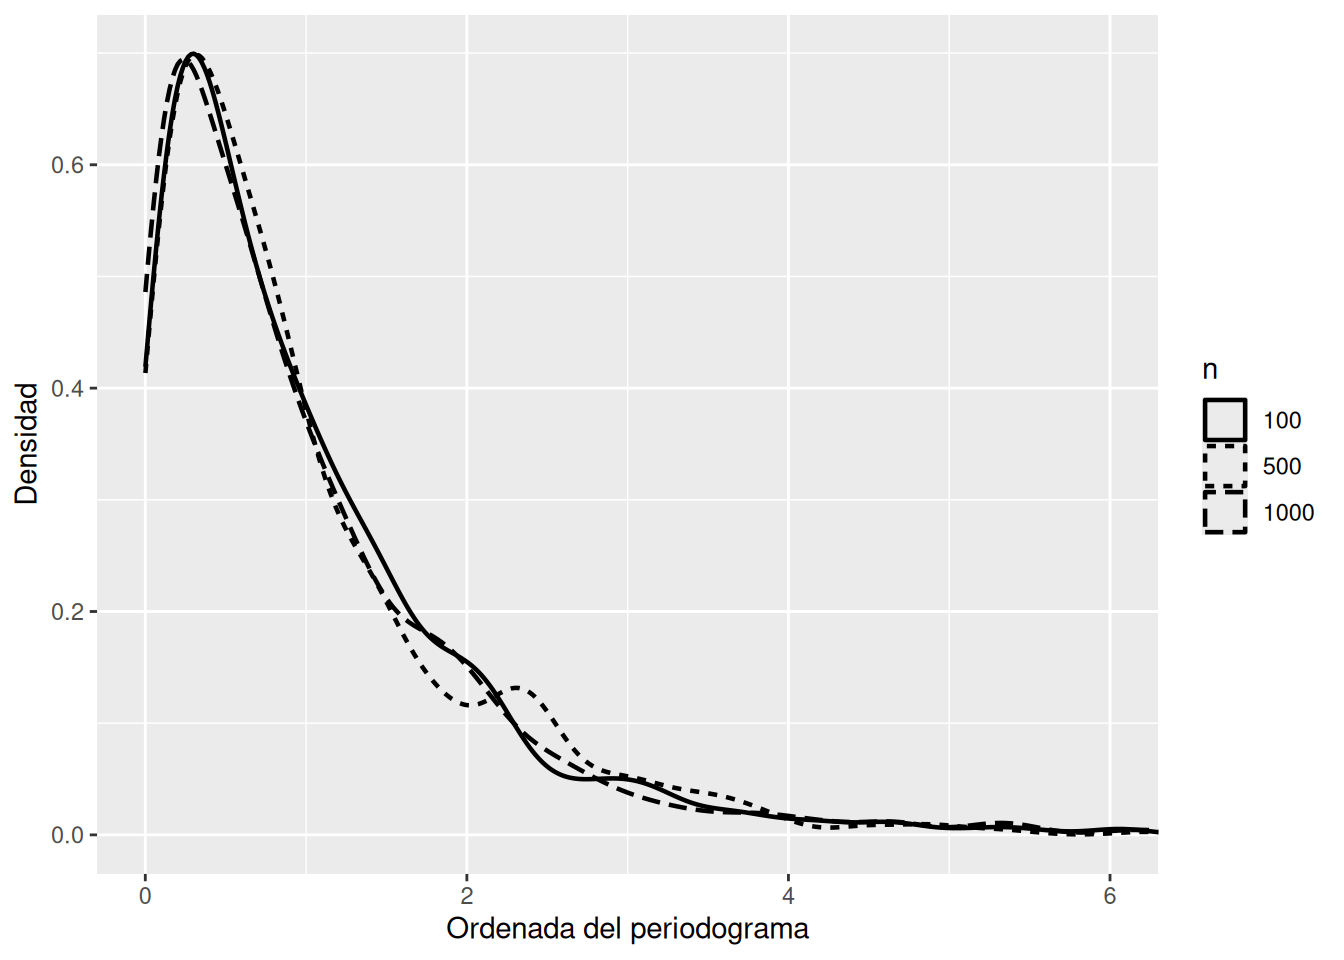
La tabla y la figura muestran que la media se mantiene alrededor de uno, pero la varianza no colapsa al aumentar la longitud de la serie. Ese comportamiento motiva la estimación espectral suavizada.
9.12 Fuga espectral
Una segunda dificultad aparece cuando una frecuencia importante no coincide exactamente con una frecuencia de Fourier.
Si una señal completa un número entero de ciclos dentro de la ventana observada, su energía puede concentrarse fuertemente en una ordenada. Si la frecuencia cae entre dos puntos de la malla, la ventana finita distribuye potencia entre frecuencias cercanas. Este fenómeno se denomina fuga espectral (spectral leakage).
n_leak <- 128
t_leak <- seq_len(n_leak)

nu_en_malla <- 16 / n_leak
nu_fuera_malla <- 0.130

x_en_malla <- cos(2 * pi * nu_en_malla * t_leak)
x_fuera_malla <- cos(2 * pi * nu_fuera_malla * t_leak)

leak_spec <- bind_rows(
  periodograma_fft(x_en_malla) |>
    mutate(caso = "Frecuencia exactamente en la malla"),
  periodograma_fft(x_fuera_malla) |>
    mutate(caso = "Frecuencia entre puntos de la malla")
) |>
  group_by(caso) |>
  mutate(relativo = periodograma / max(periodograma)) |>
  ungroup() |>
  filter(freq > 0, freq < 0.30)
leak_spec |>
ggplot(aes(x = freq, y = relativo)) +
geom_col(width = 1 / n_leak) +
facet_wrap(~ caso, ncol = 1) +
labs(
x = "Frecuencia",
y = "Periodograma relativo"
)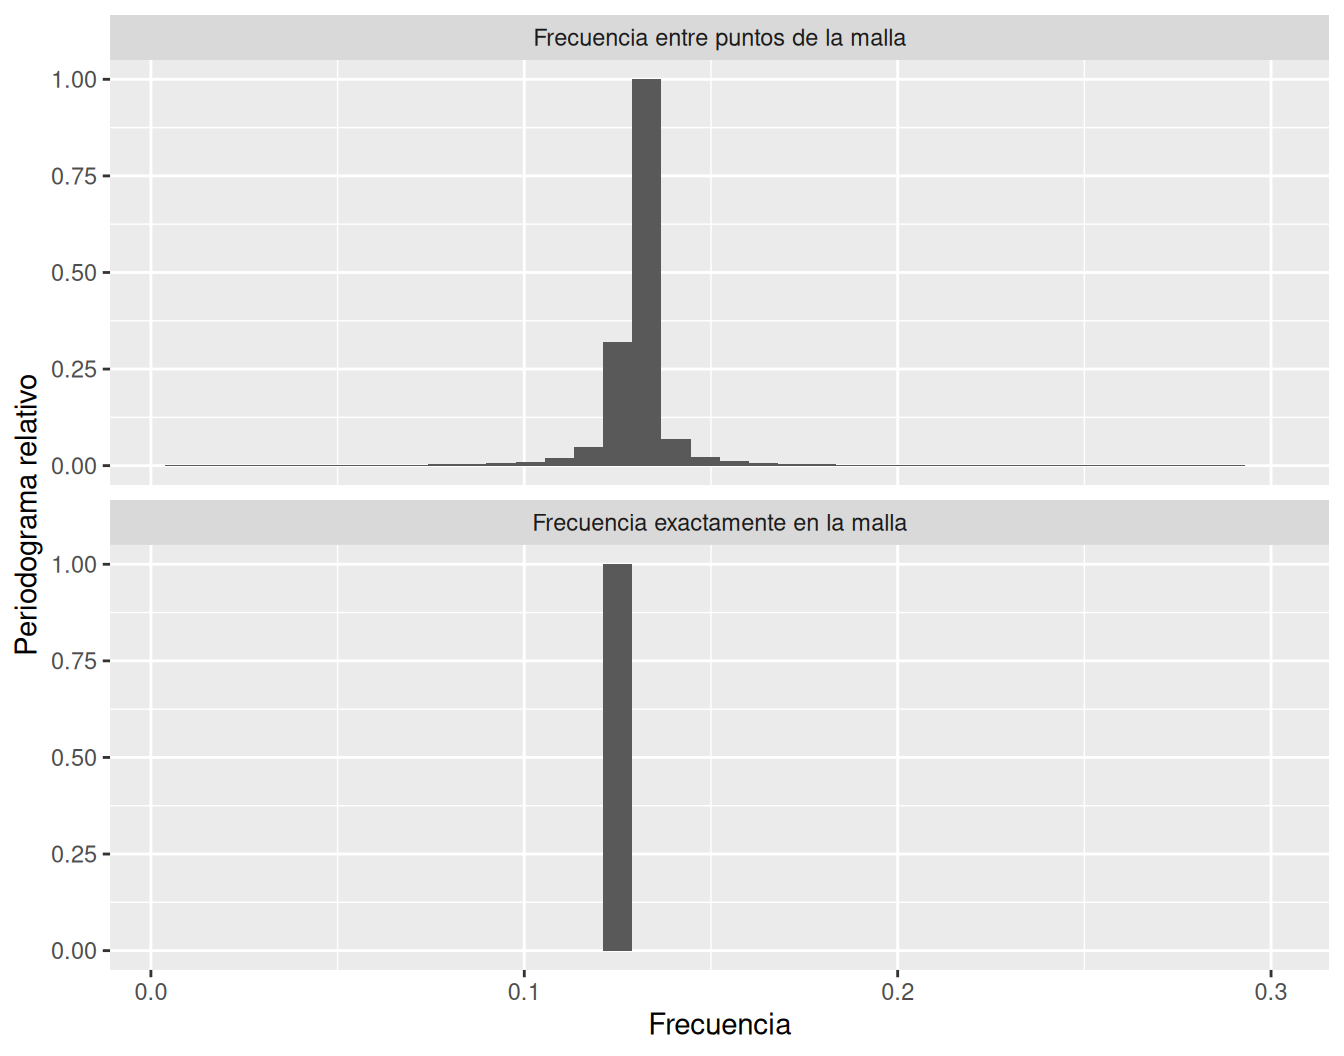
La fuga no debe confundirse con la presencia de muchas frecuencias verdaderas. Parte de la estructura alrededor de un pico puede ser consecuencia de observar solamente una ventana temporal finita.
9.13 Suavizamiento del periodograma
9.13.1 Idea básica
La inconsistencia puntual del periodograma sugiere promediar ordenadas cercanas. Un estimador sencillo es
\[ \widehat f(\nu_j) = \sum_{k=-m}^{m} w_k I(\nu_{j+k}), \tag{9.32}\]
con
\[ w_k\geq0, \qquad \sum_{k=-m}^{m}w_k=1. \]
Si usamos pesos iguales,
\[ w_k=\frac{1}{2m+1}, \]
obtenemos un promedio móvil de \(2m+1\) ordenadas.
El parámetro \(m\) controla un compromiso clásico:
- \(m\) pequeño: poca reducción de varianza y alta resolución;
- \(m\) grande: mayor estabilidad, pero picos estrechos pueden ensancharse o desaparecer.
Este es un problema de sesgo–varianza en el dominio frecuencial (Shumway y Stoffer 2025, sec. 4.4; Prado et al. 2021, sec. 3.2.4).
9.13.2 Simulación con un AR(2) oscilatorio
La ventaja de una simulación es que conocemos el espectro verdadero.
sim_ar2_spec <- arima.sim(
  model = list(ar = c(1.6, -0.9)),
  n = 512,
  sd = 1
)

per_ar2_spec <- periodograma_fft(sim_ar2_spec) |>
  filter(freq > 0)

suave5_ar2 <- suavizar_periodograma(per_ar2_spec, m = 2) |>
  transmute(freq, estimacion = suavizado, metodo = "Promedio de 5 ordenadas")

suave17_ar2 <- suavizar_periodograma(per_ar2_spec, m = 8) |>
  transmute(freq, estimacion = suavizado, metodo = "Promedio de 17 ordenadas")

estimadores_ar2 <- bind_rows(
  per_ar2_spec |>
    transmute(freq, estimacion = periodograma, metodo = "Periodograma crudo"),
  suave5_ar2,
  suave17_ar2
)

teorico_ar2_spec <- tibble(
  freq = per_ar2_spec$freq,
  teorico = espectro_arma(
    per_ar2_spec$freq,
    ar = c(1.6, -0.9),
    sigma2 = 1
  )
)
estimadores_ar2 |>
ggplot(aes(x = freq, y = estimacion)) +
geom_line(alpha = 0.8) +
geom_line(
data = teorico_ar2_spec,
aes(x = freq, y = teorico),
inherit.aes = FALSE,
linewidth = 0.9,
linetype = 2
) +
facet_wrap(~ metodo, ncol = 1, scales = "free_y") +
labs(
x = "Frecuencia",
y = "Espectro"
)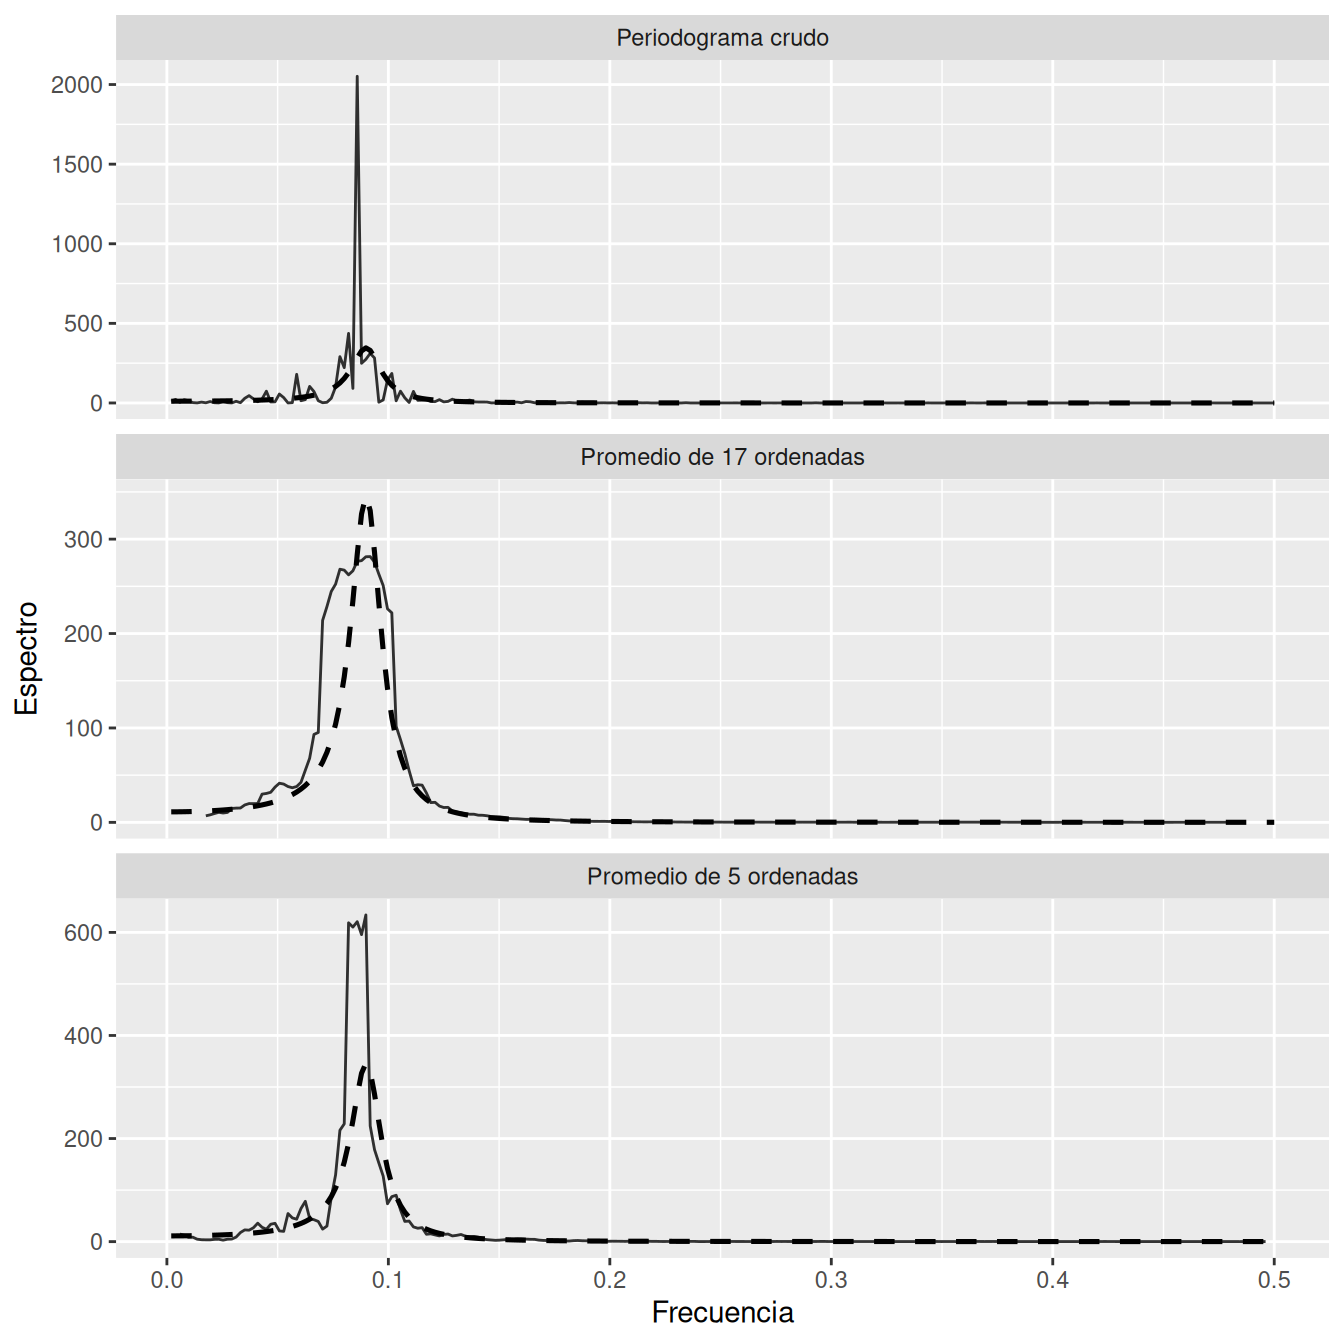
El periodograma crudo localiza la región de máxima potencia, pero fluctúa fuertemente. Un suavizamiento moderado ayuda a recuperar la forma global. Un suavizamiento excesivo reduce variabilidad a costa de resolución.
9.13.3 Tapering: reducir el efecto de los extremos de la muestra
Al calcular la transformada discreta de Fourier (DFT) disponemos solamente de una muestra finita
\[ y_1,y_2,\ldots,y_T. \]
La DFT representa este vector mediante una combinación de ondas seno y coseno cuyas frecuencias son las frecuencias de Fourier. Una forma útil de entender esta representación es imaginar que el bloque observado se repite periódicamente:
\[ \ldots, y_1,\ldots,y_T, y_1,\ldots,y_T, y_1,\ldots \]
Una manera precisa de entender por qué los extremos de la muestra quedan conectados consiste en examinar la transformada inversa.
Sea una muestra de longitud \(T\),
\[ y_1,\ldots,y_T, \]
y considere las frecuencias de Fourier
\[ \nu_k=\frac{k}{T}, \qquad k=0,\ldots,T-1. \]
Usando una normalización simétrica, la transformada discreta de Fourier puede escribirse como
\[ d(\nu_k) = \frac{1}{\sqrt{T}} \sum_{t=1}^{T} y_t e^{-2\pi i\nu_k t}, \]
y la transformada inversa reconstruye exactamente las observaciones mediante
\[ y_t = \frac{1}{\sqrt{T}} \sum_{k=0}^{T-1} d(\nu_k)e^{2\pi i\nu_k t}, \qquad t=1,\ldots,T. \]
La expresión del lado derecho, sin embargo, puede evaluarse para cualquier entero \(t\), no solamente para los tiempos observados. Definamos entonces la secuencia reconstruida
\[ \widetilde y_t = \frac{1}{\sqrt{T}} \sum_{k=0}^{T-1} d(\nu_k)e^{2\pi i\nu_k t}, \qquad t\in\mathbb Z. \]
Ahora evaluemos esta reconstrucción \(T\) períodos después:
\[ \begin{aligned} \widetilde y_{t+T} &= \frac{1}{\sqrt{T}} \sum_{k=0}^{T-1} d(\nu_k) e^{2\pi i\nu_k(t+T)} \\ &= \frac{1}{\sqrt{T}} \sum_{k=0}^{T-1} d(\nu_k) e^{2\pi i\nu_k t} e^{2\pi i\nu_k T}. \end{aligned} \]
Como \(\nu_k=k/T\),
\[ e^{2\pi i\nu_k T} = e^{2\pi i k} = 1 \]
para todo entero \(k\). Por tanto,
\[ \widetilde y_{t+T} = \frac{1}{\sqrt{T}} \sum_{k=0}^{T-1} d(\nu_k)e^{2\pi i\nu_k t} = \widetilde y_t. \]
Hemos demostrado así que
\[ \boxed{ \widetilde y_{t+T}=\widetilde y_t }. \tag{9.33}\]
Es decir, la secuencia definida por la transformada inversa es periódica con período \(T\). En particular, fuera del intervalo observado la reconstrucción continúa como
\[ \ldots, y_1,\ldots,y_T, y_1,\ldots,y_T, y_1,\ldots \]
Esto no significa que estemos suponiendo que el proceso estocástico que generó los datos sea periódico. La periodicidad es una propiedad de la representación discreta construida mediante las frecuencias de Fourier \(\nu_k=k/T\).
Esta observación explica por qué los extremos de una muestra finita son importantes. Al extender periódicamente el bloque observado, el valor final \(y_T\) queda seguido inmediatamente por \(y_1\). Si ambos valores son muy diferentes, aparece una transición artificial
\[ y_T \longrightarrow y_1 \]
en cada unión entre bloques. La representación mediante senos y cosenos debe reproducir también esa transición, lo que puede dispersar potencia entre frecuencias distintas de las que dominan la señal original. Esta es una de las formas de entender la fuga espectral (spectral leakage).
El tapering busca reducir este efecto haciendo que las observaciones cercanas a los extremos tengan menor peso antes de calcular la DFT. De esa forma, el inicio y el final de la ventana transformada quedan más próximos entre sí y la unión periódica artificial resulta menos abrupta.
El tapering busca reducir este problema modificando las observaciones antes de calcular la DFT. En lugar de utilizar directamente \(y_t\), se calcula
\[ y_t^{(a)}=a_t y_t, \qquad t=1,\ldots,T, \]
donde los pesos \(a_t\) forman una ventana que asigna menor peso a las observaciones cercanas a los extremos de la muestra y mayor peso a las observaciones centrales.
Típicamente,
\[ a_t\approx 0 \]
cerca de \(t=1\) y \(t=T\), mientras que \(a_t\) es cercano a uno en la región central. De esta manera, tanto el inicio como el final de la serie transformada se aproximan gradualmente a cero. Al repetir periódicamente el bloque transformado,
\[ y_1^{(a)},\ldots,y_T^{(a)}, y_1^{(a)},\ldots,y_T^{(a)},\ldots, \]
la transición entre \(y_T^{(a)}\) y \(y_1^{(a)}\) suele ser mucho menos abrupta que la transición original entre \(y_T\) y \(y_1\). Esto reduce la fuga de potencia hacia frecuencias alejadas de las componentes dominantes.
Por ejemplo, una ventana tipo coseno asigna pesos pequeños a los extremos y aumenta gradualmente hacia el centro. El principio puede representarse esquemáticamente como
\[ \underbrace{ \text{peso pequeño} }_{\text{inicio}} \quad\longrightarrow\quad \underbrace{ \text{peso grande} }_{\text{centro}} \quad\longrightarrow\quad \underbrace{ \text{peso pequeño} }_{\text{final}}. \]
Es importante notar que el tapering no elimina observaciones. Todas las observaciones continúan participando en el cálculo, pero las situadas cerca de los extremos tienen menor influencia.
Una opción clásica es una ventana cosenoidal centrada. Si
\[ \bar t=\frac{n+1}{2}, \]
podemos utilizar
\[ a_t = \frac12 \left[ 1+ \cos\left( \frac{2\pi(t-\bar t)}{n} \right) \right]. \tag{9.34}\]
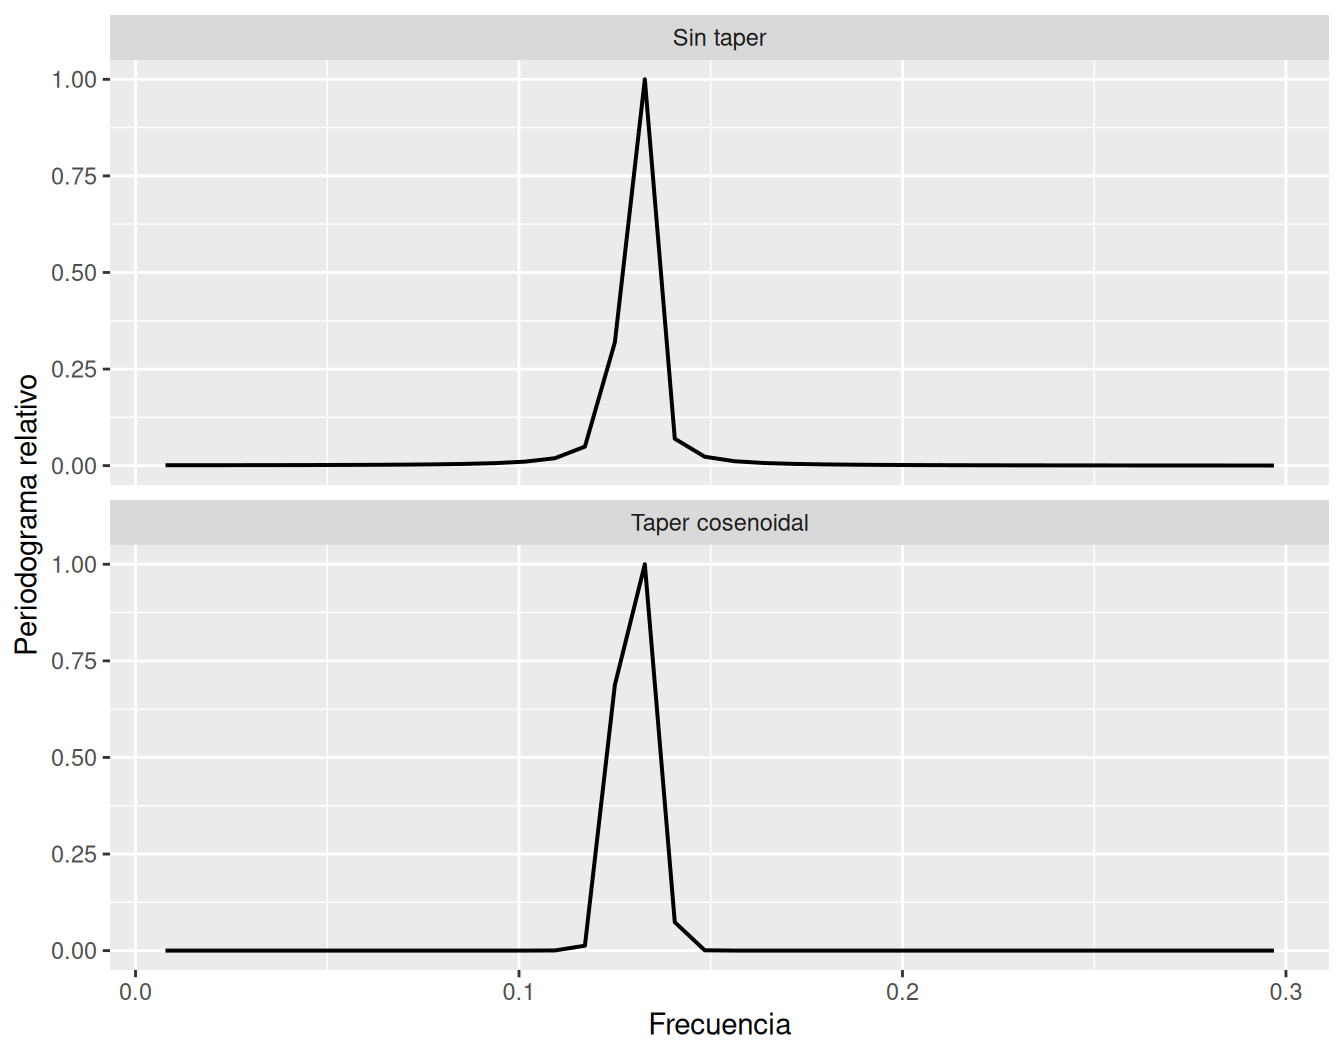
Esta clase de taper da menor peso a observaciones cercanas a los extremos (Shumway y Stoffer 2025, sec. 4.4). Puede disminuir lóbulos laterales debidos a fuga, aunque también ensancha el pico principal. No existe una ventana que mejore simultáneamente todas las propiedades.
t_idx_leak <- seq_len(n_leak)
t_bar_leak <- mean(t_idx_leak)

taper_cos <- 0.5 * (
  1 + cos(2 * pi * (t_idx_leak - t_bar_leak) / n_leak)
)

leak_taper <- bind_rows(
  periodograma_fft(x_fuera_malla) |>
    mutate(metodo = "Sin taper"),
  periodograma_fft(taper_cos * x_fuera_malla) |>
    mutate(metodo = "Taper cosenoidal")
) |>
  group_by(metodo) |>
  mutate(relativo = periodograma / max(periodograma)) |>
  ungroup() |>
  filter(freq > 0, freq < 0.30)
leak_taper |>
ggplot(aes(x = freq, y = relativo)) +
geom_line(linewidth = 0.7) +
facet_wrap(~ metodo, ncol = 1) +
labs(
x = "Frecuencia",
y = "Periodograma relativo"
)
9.13.3.1 El tapering tiene un costo
Reducir la fuga espectral no es gratuito. Al disminuir el peso de las observaciones cercanas a los extremos, también se reduce la cantidad efectiva de información utilizada. En el dominio de la frecuencia, esto modifica la ventana espectral asociada con el estimador.
De manera cualitativa aparece un compromiso:
- una ventana con extremos abruptos puede producir mayor fuga espectral;
- una ventana que disminuye suavemente los extremos reduce esa fuga;
- pero un taper más fuerte puede ensanchar los picos espectrales y dificultar la separación de dos frecuencias muy cercanas.
Por tanto, el objetivo no es hacer los picos tan estrechos como sea posible, sino encontrar un equilibrio entre fuga espectral y resolución en frecuencia.
NotaSuavizar y aplicar taper resuelven problemas distintos
El suavizamiento reduce la variabilidad de las ordenadas combinando frecuencias vecinas. El taper modifica la ventana temporal para controlar fuga espectral. En la práctica suelen utilizarse conjuntamente, pero no son la misma operación.
9.14 Implementación práctica de una estimación espectral
En aplicaciones reales no suele ser necesario programar cada operación desde cero. R incluye stats::spec.pgram(), que calcula un periodograma y permite incorporar suavizamiento y tapering. Por ejemplo:
stats::spec.pgram(
  x,
  spans = c(5, 5),
  taper = 0.1,
  detrend = TRUE,
  demean = TRUE,
  plot = FALSE
)
9.14.1 Ventanas de Daniell y el argumento spans
Una vez calculado el periodograma crudo, podemos reducir su variabilidad promediando ordenadas correspondientes a frecuencias vecinas. Una de las formas más sencillas de hacerlo es mediante una ventana de Daniell.
Sea \(I(\nu_j)\) el periodograma evaluado en las frecuencias de Fourier
\[ \nu_j=\frac{j}{T}. \]
Una ventana de Daniell de ancho
\[ L=2m+1 \]
reemplaza la ordenada \(I(\nu_j)\) por el promedio de las \(L\) ordenadas centradas alrededor de \(\nu_j\):
\[ \widehat f(\nu_j) = \frac{1}{2m+1} \sum_{k=-m}^{m} I(\nu_{j+k}). \tag{9.35}\]
Por ejemplo, si \(m=1\), entonces \(L=3\) y
\[ \widehat f(\nu_j) = \frac{1}{3} \left[ I(\nu_{j-1}) + I(\nu_j) + I(\nu_{j+1}) \right]. \]
Por tanto, cada valor suavizado combina información de la frecuencia de interés y de sus frecuencias vecinas. La idea estadística es que, si la densidad espectral verdadera \(f(\nu)\) cambia suavemente con \(\nu\), las ordenadas cercanas del periodograma contienen información sobre aproximadamente la misma región del espectro. Al promediarlas disminuye la gran variabilidad del periodograma crudo.
Existe aquí el compromiso usual entre varianza y resolución espectral:
- una ventana estrecha utiliza pocas frecuencias vecinas, conserva mayor resolución, pero produce una estimación más irregular;
- una ventana más ancha promedia más ordenadas, reduce la variabilidad, pero puede ensanchar o incluso fusionar picos espectrales cercanos.
En consecuencia, aumentar el grado de suavizamiento no es siempre una mejora. Podemos obtener una curva visualmente más estable a costa de perder capacidad para distinguir frecuencias próximas.
9.14.1.1 Ventana de Daniell modificada
En spec.pgram() se utilizan ventanas de Daniell modificadas. La modificación consiste en asignar la mitad del peso usual a los dos extremos de la ventana antes de normalizar los pesos.
Para el caso más sencillo, \(m=1\), la ventana de Daniell ordinaria utilizaría
\[ \left( \frac13,\frac13,\frac13 \right), \]
mientras que la versión modificada utiliza
\[ \left( \frac14,\frac12,\frac14 \right). \]
Por tanto, el estimador suavizado toma la forma
\[ \widehat f(\nu_j) = \frac14 I(\nu_{j-1}) + \frac12 I(\nu_j) + \frac14 I(\nu_{j+1}). \tag{9.36}\]
La frecuencia central recibe así mayor peso que las dos frecuencias adyacentes.
El argumento spans de spec.pgram() especifica los anchos impares de estas ventanas modificadas. Por ejemplo,
spec.pgram(y, spans = 3)aplica una ventana modificada de ancho tres.
También es posible aplicar varias ventanas sucesivamente. Por ejemplo,
spec.pgram(y, spans = c(3, 3))indica que primero se aplica un suavizador de ancho tres y luego se vuelve a suavizar el resultado con otro suavizador del mismo ancho.
Aplicar dos ventanas sucesivamente equivale a convolucionar sus pesos. En este caso,
\[ \left( \frac14,\frac12,\frac14 \right) * \left( \frac14,\frac12,\frac14 \right) = \left( \frac1{16}, \frac4{16}, \frac6{16}, \frac4{16}, \frac1{16} \right). \]
Por ello, spans = c(3, 3) produce una ventana efectiva más ancha y con una forma más redondeada que spans = 3. Si se aplican repetidamente ventanas de Daniell, los pesos resultantes adquieren progresivamente una forma más acampanada.
ImportanteNo confundir
spans con taper
Los argumentos spans y taper modifican el estimador espectral, pero actúan en etapas diferentes.
tapermodifica las observaciones en el dominio del tiempo antes de calcular la DFT. Su objetivo principal es reducir el efecto de los extremos de la muestra y ayudar a controlar la fuga espectral.spansactúa después de calcular el periodograma, en el dominio de la frecuencia. Su función es promediar ordenadas correspondientes a frecuencias vecinas para reducir la variabilidad del estimador.
Por tanto, tapering y suavizamiento mediante ventanas de Daniell no son dos nombres para la misma operación.
En R, la opción spans controla el suavizamiento mediante una secuencia de ventanas de Daniell modificadas, mientras que taper especifica la proporción de observaciones en los extremos de la serie que serán atenuadas antes de calcular la DFT.
La implementación utiliza además convenciones de escala propias, por lo que no debemos comparar directamente, sin verificar la normalización, las alturas obtenidas con spec.pgram() con las calculadas manualmente a partir del periodograma definido en Ecuación 9.23.
9.15 Aplicación: ciclos en la actividad solar
Utilizaremos sunspot.year, una serie incluida en R con promedios anuales del número de manchas solares. Esta aplicación es especialmente apropiada porque la actividad solar presenta una periodicidad dominante bien conocida en escalas de aproximadamente una década y constituye un ejemplo clásico de análisis espectral (Shumway y Stoffer 2025, chap. 4).
Nuestro objetivo será responder cinco preguntas:
- ¿qué periodicidades sugiere la serie en el dominio temporal?;
- ¿dónde se concentra la potencia en el periodograma?;
- ¿cómo cambia la interpretación después de suavizar?;
- ¿un espectro AR paramétrico identifica una estructura semejante?;
- ¿qué incertidumbre podemos asociar con la frecuencia dominante?
9.15.1 Preparación y verificación de los datos
sunspots_tbl <- tibble(
  Year = as.integer(time(sunspot.year)),
  Sunspots = as.numeric(sunspot.year)
) |>
  as_tsibble(index = Year)

stopifnot(
  nrow(sunspots_tbl) == length(sunspot.year),
  nrow(sunspots_tbl) > 200,
  !anyNA(sunspots_tbl$Sunspots),
  all(is.finite(sunspots_tbl$Sunspots)),
  all(sunspots_tbl$Sunspots >= 0)
)
sunspots_tbl |>
ggplot(aes(x = Year, y = Sunspots)) +
geom_line(linewidth = 0.5) +
labs(
x = "Año",
y = "Manchas solares"
)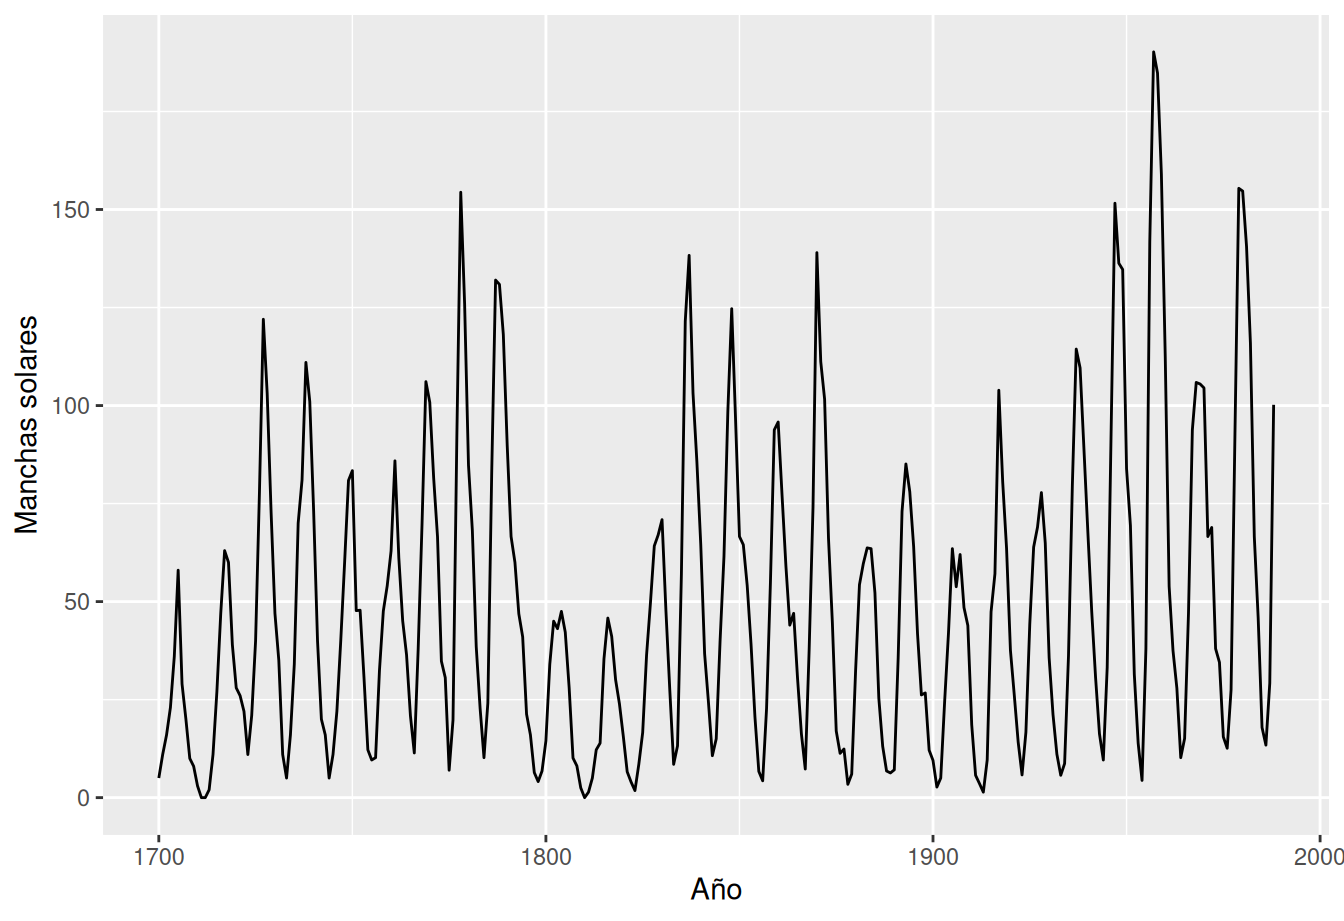
La trayectoria no se parece a una senoide determinista perfecta. La duración de los ciclos y la amplitud de los máximos cambian con el tiempo. El análisis espectral no pretende negar esa complejidad; busca resumir qué escalas periódicas explican una parte importante de la variación.
9.15.2 ACF como punto de partida
sunspots_tbl |>
  ACF(Sunspots, lag_max = 50) |>
  autoplot() +
  labs(
    x = "Rezago (años)",
    y = "ACF"
  )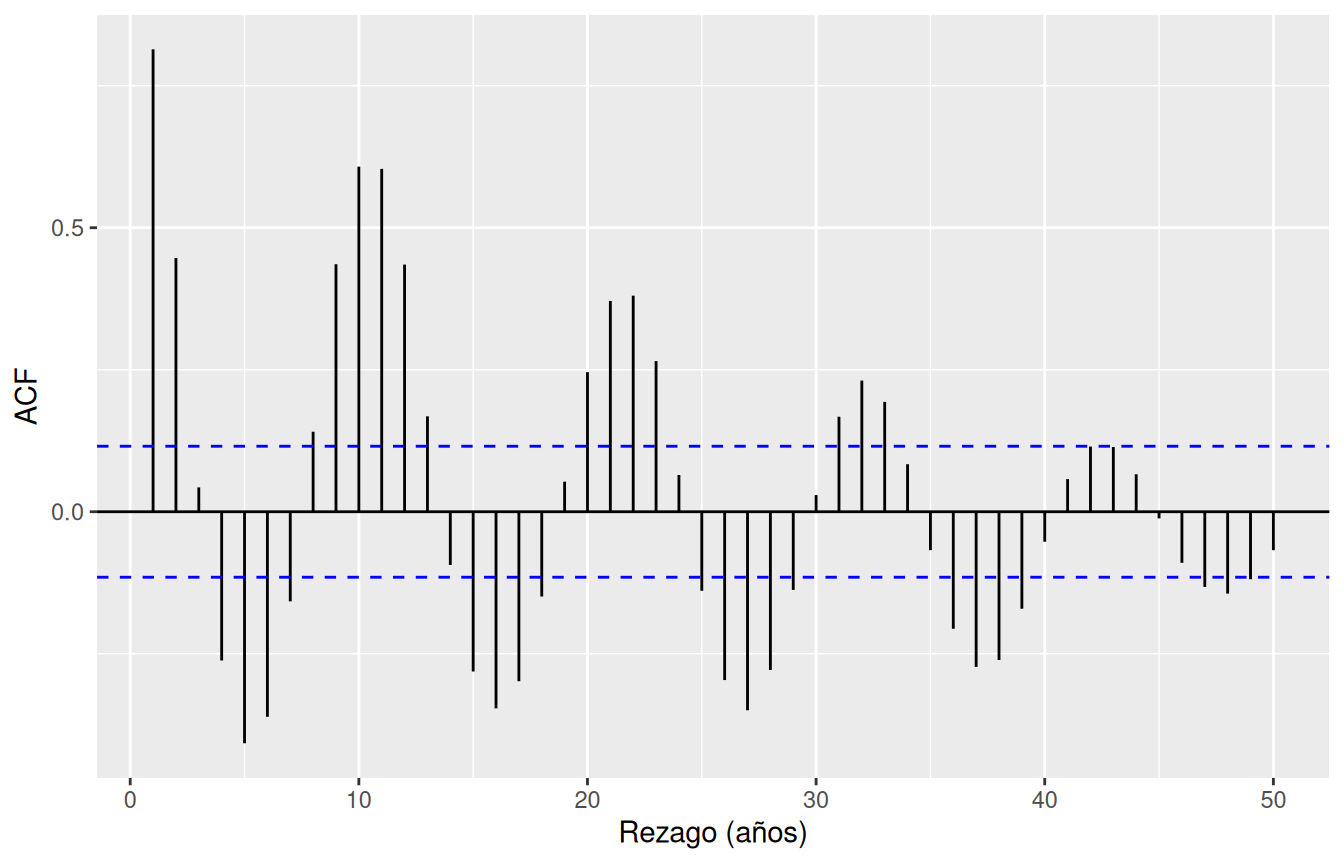
La ACF ya contiene la información cíclica, pero la expresa mediante alternancia a través de rezagos. El espectro reorganizará esa estructura y facilitará identificar la frecuencia dominante.
9.15.3 Periodograma
per_sunspots <- periodograma_fft(sunspots_tbl$Sunspots) |>
  filter(freq > 0)

per_sunspots_suave <- suavizar_periodograma(per_sunspots, m = 2)
per_sunspots |>
ggplot(aes(x = freq, y = periodograma)) +
geom_line(linewidth = 0.55) +
coord_cartesian(xlim = c(0, 0.25)) +
labs(
x = "Frecuencia (ciclos por año)",
y = "Periodograma"
)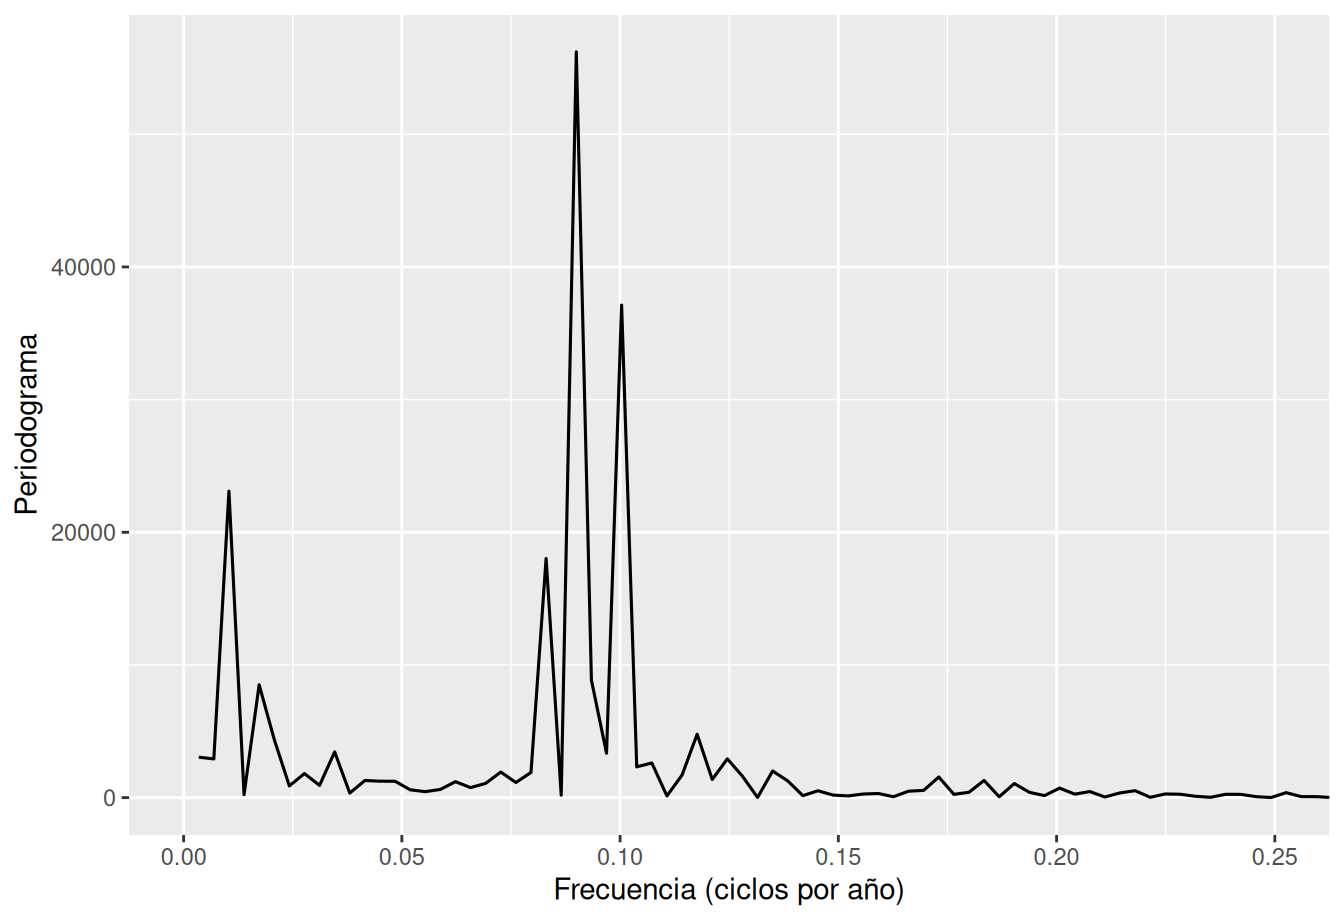
Para interpretar los picos en unidades temporales convertimos frecuencia a período.
picos_sunspots <- per_sunspots_suave |>
  filter(!is.na(suavizado), freq >= 1 / 50, freq <= 0.5) |>
  mutate(
    es_pico =
      suavizado > lag(suavizado, default = -Inf) &
      suavizado > lead(suavizado, default = -Inf)
  ) |>
  filter(es_pico) |>
  slice_max(order_by = suavizado, n = 8, with_ties = FALSE) |>
  transmute(
    frecuencia = freq,
    periodo_anios = 1 / freq,
    espectro_suavizado = suavizado
  ) |>
arrange(desc(espectro_suavizado))knitr::kable(
picos_sunspots,
digits = 3,
caption = "Principales máximos locales del periodograma suavizado de manchas solares."
)| frecuencia | periodo_anios | espectro_suavizado |
|---|---|---|
| 0.097 | 10.321 | 21571.015 |
| 0.076 | 13.136 | 4815.248 |
| 0.024 | 41.286 | 3302.485 |
| 0.121 | 8.257 | 2477.336 |
| 0.035 | 28.900 | 1564.544 |
| 0.042 | 24.083 | 1512.321 |
| 0.048 | 20.643 | 962.266 |
| 0.142 | 7.049 | 826.388 |
La conversión \(P=1/\nu\) es indispensable. Decir que existe un pico en \(\nu\approx0.09\) ciclos por año es matemáticamente correcto, pero el período de aproximadamente once años suele ser mucho más interpretable científicamente.
AdvertenciaUn pico secundario no debe convertirse automáticamente en un “nuevo ciclo”
Los máximos menores pueden deberse a armónicos, fuga espectral, variación temporal de la frecuencia, ruido o estructura real adicional. Identificar una periodicidad científicamente interpretable exige más que ordenar las alturas del periodograma.
9.15.4 Periodograma suavizado
sunspots_suavizados <- bind_rows(
  suavizar_periodograma(per_sunspots, m = 2) |>
    transmute(
      freq,
      espectro = suavizado,
      ventana = "Promedio de 5 ordenadas"
    ),
  suavizar_periodograma(per_sunspots, m = 5) |>
    transmute(
      freq,
      espectro = suavizado,
      ventana = "Promedio de 11 ordenadas"
    )
)
sunspots_suavizados |>
ggplot(aes(x = freq, y = espectro, linetype = ventana)) +
geom_line(linewidth = 0.8, na.rm = TRUE) +
coord_cartesian(xlim = c(0, 0.25)) +
labs(
x = "Frecuencia (ciclos por año)",
y = "Espectro suavizado",
linetype = "Suavizamiento"
)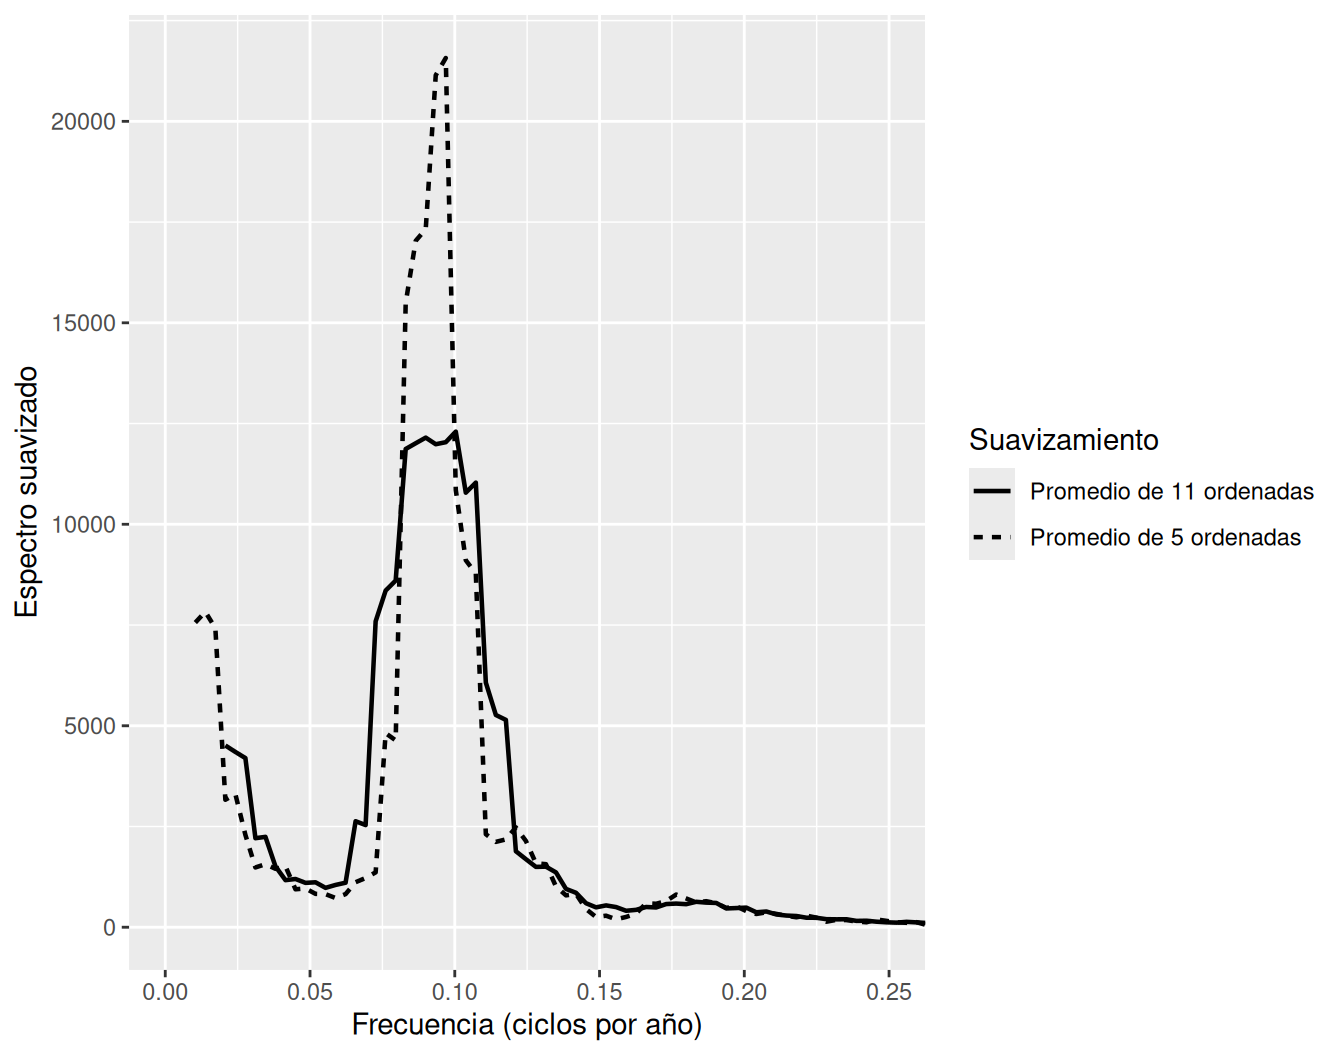
La persistencia del máximo principal bajo distintos grados razonables de suavizamiento aumenta nuestra confianza en que no se trata únicamente de una ordenada extrema aislada. Por otra parte, los picos pequeños son mucho más sensibles a la elección de ventana.
9.16 Espectro paramétrico autorregresivo
Una alternativa al suavizamiento no paramétrico consiste en ajustar un modelo AR suficientemente flexible y utilizar su espectro teórico. Si
\[ Y_t = \phi_1Y_{t-1}+\cdots+\phi_pY_{t-p}+W_t, \]
entonces
\[ f_Y(\nu) = \frac{\sigma_w^2}{ |1-\phi_1e^{-2\pi i\nu}-\cdots-\phi_pe^{-2\pi ip\nu}|^2 }. \tag{9.37}\]
El enfoque impone una forma paramétrica global. La ventaja es que produce un espectro suave. La desventaja es que una elección de orden insuficiente puede perder picos estrechos, mientras que un orden excesivo puede crear estructura espuria.
fit_ar_sunspots <- ar(
  sunspots_tbl$Sunspots,
  aic = TRUE,
  order.max = 30,
  method = "yule-walker",
  demean = TRUE
)

stopifnot(
  fit_ar_sunspots$order >= 1,
  all(is.finite(fit_ar_sunspots$ar)),
  is.finite(fit_ar_sunspots$var.pred),
  fit_ar_sunspots$var.pred > 0
)

freq_ar_sunspots <- seq(0.001, 0.25, length.out = 1200)

espectro_ar_sunspots <- tibble(
  freq = freq_ar_sunspots,
  espectro = espectro_arma(
    freq_ar_sunspots,
    ar = fit_ar_sunspots$ar,
    sigma2 = fit_ar_sunspots$var.pred
  )
)

resumen_ar_sunspots <- tibble(
  cantidad = c("Orden AR seleccionado", "Varianza de innovación estimada"),
  valor = c(fit_ar_sunspots$order, fit_ar_sunspots$var.pred)
)knitr::kable(
resumen_ar_sunspots,
digits = 3,
caption = "Resumen del modelo AR utilizado para construir un espectro paramétrico de manchas solares."
)| cantidad | valor |
|---|---|
| Orden AR seleccionado | 9.000 |
| Varianza de innovación estimada | 267.492 |
no_param_sunspots <- per_sunspots_suave |>
  filter(!is.na(suavizado), freq <= 0.25) |>
  transmute(freq, espectro = suavizado, metodo = "No paramétrico")

param_sunspots <- espectro_ar_sunspots |>
  mutate(metodo = "AR paramétrico")

bind_rows(no_param_sunspots, param_sunspots) |>
  ggplot(aes(x = freq, y = espectro, linetype = metodo)) +
  geom_line(linewidth = 0.8) +
  labs(
    x = "Frecuencia (ciclos por año)",
    y = "Densidad espectral",
    linetype = "Estimador"
  )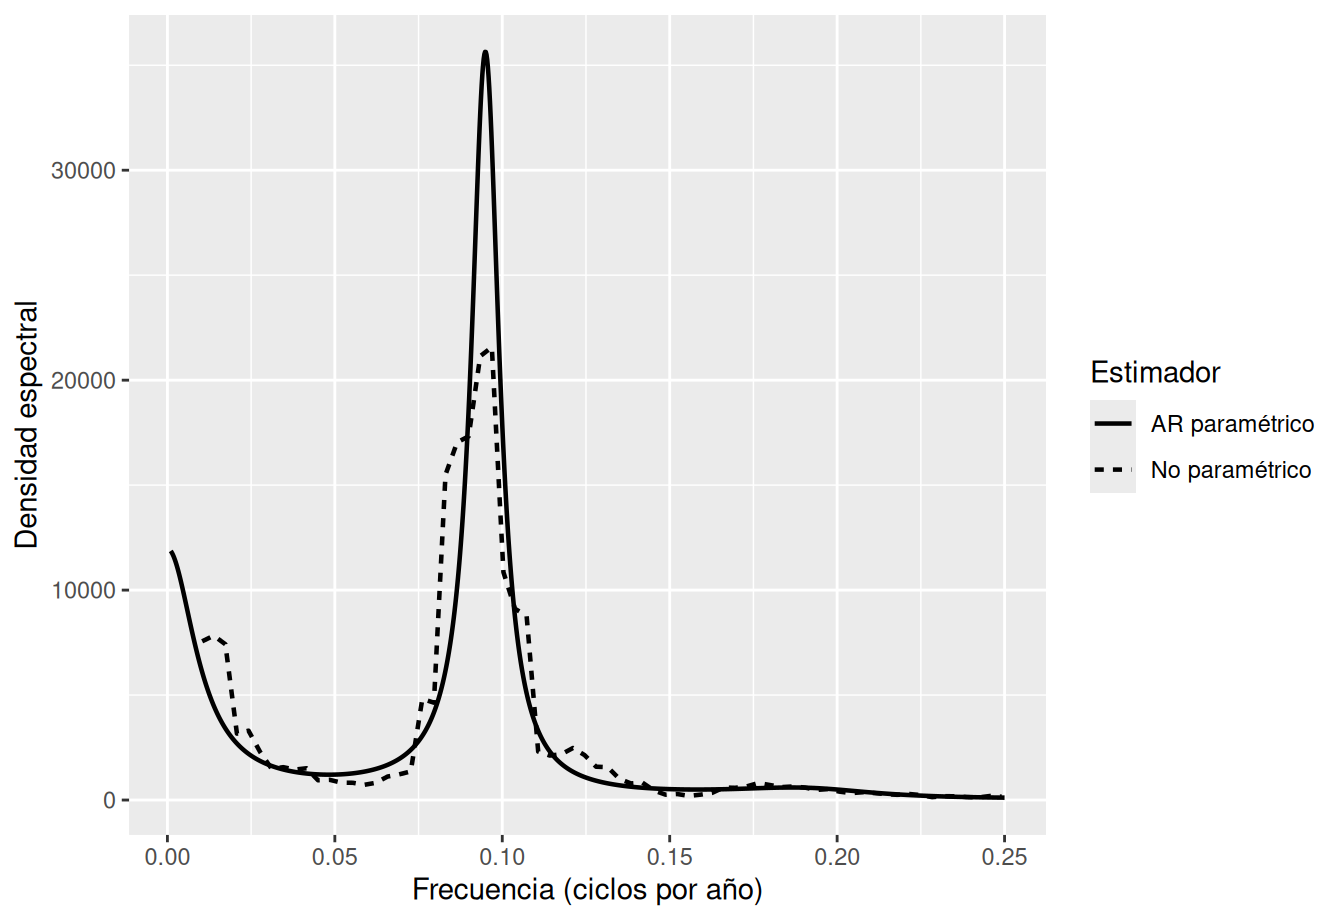
No debemos interpretar la cercanía de ambas curvas como prueba de que el AR seleccionado sea el mecanismo verdadero. La comparación muestra que dos procedimientos distintos atribuyen una parte importante de la variabilidad a una escala temporal semejante.
9.17 Inferencia bayesiana para una frecuencia desconocida
El periodograma también puede conectarse con inferencia sobre una frecuencia armónica.
Considere, después de remover la media,
\[ Y_t = \alpha_1\cos(\omega t) + \alpha_2\sin(\omega t) + \varepsilon_t, \]
con
\[ \varepsilon_t\stackrel{\text{iid}}{\sim}N(0,v). \tag{9.38}\]
Si \(\omega\) es desconocida, queremos inferir
\[ p(\omega\mid y_{1:T}). \]
9.17.1 La frecuencia como parámetro
Para una frecuencia de Fourier, la regresión armónica es ortogonal y la reducción de suma de cuadrados está directamente determinada por el periodograma. Prado et al. (2021), secs. 3.1.1–3.1.2 muestran que, bajo un análisis de referencia en el que se integran los coeficientes armónicos y la varianza, la posterior en las frecuencias de Fourier tiene la forma
\[ p(\omega_j\mid y_{1:T}) \propto p(\omega_j) \left[ 1- \frac{I_{PFW}(\omega_j)}{y^{\mathsf T}y} \right]^{(2-T)/2}, \tag{9.39}\]
para la serie centrada y para frecuencias interiores de Fourier.
Como el exponente \((2-T)/2\) es negativo, una frecuencia que explique una fracción grande de \(y^{\mathsf T}y\) recibe mayor peso posterior. Por Ecuación 9.27,
\[ I_{PFW}=2I_{SS} \]
en las frecuencias interiores.
NotaLa posterior no convierte automáticamente el modelo armónico en un buen modelo global
Una frecuencia puede estar muy concentrada a posteriori dentro de un modelo de una sola senoide y, aun así, ese modelo ser demasiado simple para describir toda la serie. La inferencia siempre es condicional a la estructura asumida.
9.17.2 Priori uniforme en frecuencia versus uniforme en período
Una decisión sutil es qué significa “no informativo”.
Suponga que consideramos períodos entre 2 y 50 años:
\[ 2\leq P\leq50. \]
Esto equivale a
\[ \frac{1}{50} \leq \nu \leq \frac12. \]
Una priori uniforme en frecuencia satisface
\[ p(\nu)\propto1. \tag{9.40}\]
Pero una priori uniforme en período,
\[ p(P)\propto1, \]
no induce una distribución uniforme sobre \(\nu\), porque \(P=1/\nu\). El Jacobiano da
\[ p(\nu) \propto \left|\frac{dP}{d\nu}\right| = \frac{1}{\nu^2}. \tag{9.41}\]
La segunda priori asigna relativamente más peso a frecuencias bajas, es decir, a períodos largos.
9.17.3 Posterior para manchas solares
Calcularemos la posterior únicamente sobre las frecuencias de Fourier comprendidas entre períodos de 2 y 50 años. De esta forma utilizamos directamente la expresión de Ecuación 9.39.
#| label: calcular-posterior-frecuencia-sunspots

y_sun_c <- sunspots_tbl$Sunspots - mean(sunspots_tbl$Sunspots)

n_sun <- length(y_sun_c)
t_sun <- seq_len(n_sun)
sst_sun <- sum(y_sun_c^2)

# Cuadrícula fina de frecuencias:
# períodos entre aproximadamente 2 y 50 años.
#
# Evitamos exactamente nu = 1/2 porque allí sin(2*pi*nu*t) = 0
# para tiempos enteros y la matriz de diseño pierde rango.
grid_nu <- seq(
  from = 1 / 50,
  to = 1 / 2 - 1e-6,
  length.out = 5000
)

log_marginal_armonica <- function(nu) {

  X <- cbind(
    cos = cos(2 * pi * nu * t_sun),
    sin = sin(2 * pi * nu * t_sun)
  )

  XtX <- crossprod(X)
  Xty <- crossprod(X, y_sun_c)

  beta_hat <- solve(XtX, Xty)

  ss_explicada <- as.numeric(
    crossprod(beta_hat, XtX %*% beta_hat)
  )

  proporcion_explicada <- ss_explicada / sst_sun

  # Protección numérica
  proporcion_explicada <- min(
    max(proporcion_explicada, 0),
    1 - 1e-12
  )

  log_det <- as.numeric(
    determinant(XtX, logarithm = TRUE)$modulus
  )

  # Log-verosimilitud marginal de referencia,
  # salvo una constante que no depende de nu.
  -0.5 * log_det +
    ((2 - n_sun) / 2) *
    log1p(-proporcion_explicada)
}

bayes_sun_base <- tibble(
  freq = grid_nu
) |>
  mutate(
    periodo = 1 / freq,
    log_like_ref = map_dbl(
      freq,
      log_marginal_armonica
    )
  )

normalizar_posterior <- function(tabla, log_prior, nombre_prior) {

  tabla |>
    mutate(
      log_prior = .env$log_prior,
      log_post = log_like_ref + log_prior,
      peso = exp(log_post - max(log_post)),
      posterior = peso / sum(peso),
      prior = nombre_prior
    )
}

post_freq_uniforme <- normalizar_posterior(
  bayes_sun_base,
  log_prior = rep(0, nrow(bayes_sun_base)),
  nombre_prior = "Uniforme en frecuencia"
)

post_periodo_uniforme <- normalizar_posterior(
  bayes_sun_base,
  log_prior = -2 * log(bayes_sun_base$freq),
  nombre_prior = "Uniforme en periodo"
)

posterior_sunspots <- bind_rows(
  post_freq_uniforme,
  post_periodo_uniforme
)

resumir_posterior_periodo <- function(tabla) {

  q <- cuantil_ponderado(
    tabla$periodo,
    tabla$posterior,
    probs = c(0.025, 0.5, 0.975)
  )

  tibble(
    media_periodo =
      sum(tabla$periodo * tabla$posterior),

    mediana_periodo = q[2],

    moda_periodo =
      tabla$periodo[which.max(tabla$posterior)],

    inferior_95 = q[1],

    superior_95 = q[3]
  )
}

resumen_posterior_sun <- posterior_sunspots |>
  group_by(prior) |>
  group_modify(
    ~ resumir_posterior_periodo(.x)
  ) |>
ungroup()knitr::kable(
resumen_posterior_sun,
digits = 3,
caption = "Resumen posterior del período dominante bajo dos parametrizaciones de la priori."
)| prior | media_periodo | mediana_periodo | moda_periodo | inferior_95 | superior_95 |
|---|---|---|---|---|---|
| Uniforme en frecuencia | 11.036 | 11.041 | 11.041 | 10.994 | 11.076 |
| Uniforme en periodo | 11.036 | 11.041 | 11.041 | 10.994 | 11.076 |
#| label: fig-spec-sunspots-posterior
#| fig-cap: "Posterior del período dominante de manchas solares bajo una priori uniforme en frecuencia y una priori uniforme en período. Las curvas se muestran en escala relativa y el eje horizontal se restringe a la región que contiene el 99.8% de la masa posterior."
#| fig-alt: "Dos curvas posteriores muy concentradas alrededor de once años y prácticamente superpuestas."
#| fig-height: 5.5

# Límites que contienen aproximadamente el 99.8% de la masa posterior
limites_posterior <- posterior_sunspots |>
  group_by(prior) |>
  summarise(
    inferior = cuantil_ponderado(
      periodo,
      posterior,
      probs = 0.001
    ),
    superior = cuantil_ponderado(
      periodo,
      posterior,
      probs = 0.999
    ),
    .groups = "drop"
  ) |>
  summarise(
    xmin = min(inferior),
    xmax = max(superior)
  )

posterior_sunspots |>
  group_by(prior) |>
  mutate(
    posterior_relativa = posterior / max(posterior)
  ) |>
  ungroup() |>
  arrange(prior, periodo) |>
  ggplot(
    aes(
      x = periodo,
      y = posterior_relativa
    )
  ) +
  geom_line(linewidth = 0.8) +
  facet_wrap(
    ~ prior,
    ncol = 1
  ) +
  coord_cartesian(
    xlim = c(
      limites_posterior$xmin,
      limites_posterior$xmax
    )
  ) +
  labs(
    x = "Período (años)",
    y = "Posterior relativa"
  )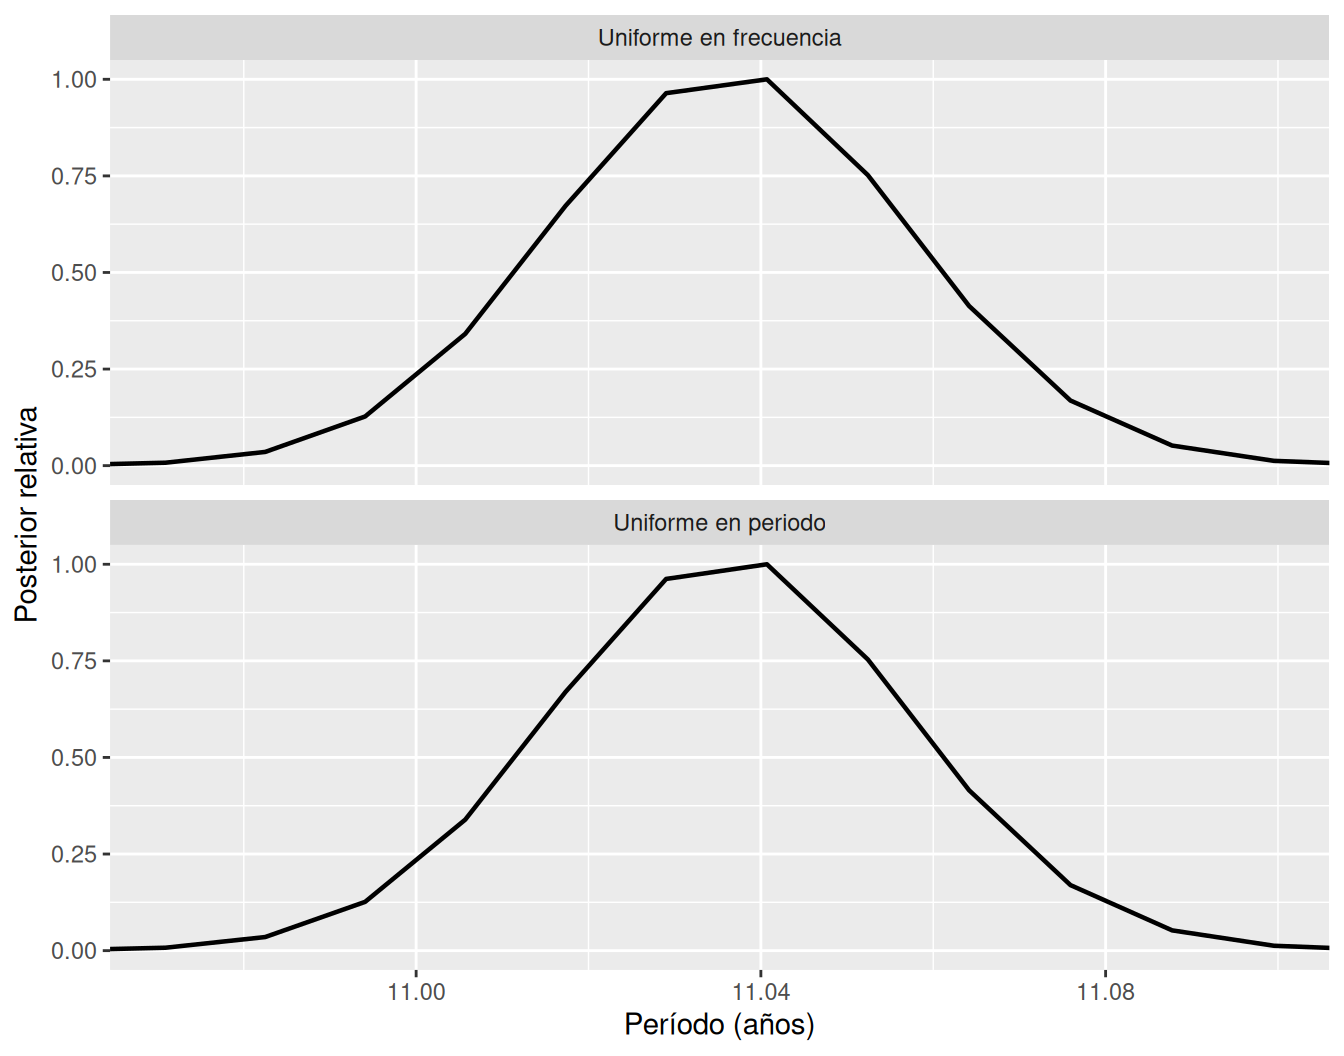
Si ambas posteriores se concentran alrededor de valores semejantes, la evidencia de la muestra domina la diferencia entre estas dos prioris en la región de mayor masa. Si difieren apreciablemente en las colas, eso recuerda que “uniforme” depende de la parametrización elegida.
9.17.4 Frecuencia conocida, estimada e incierta
Conviene distinguir tres escenarios:
- frecuencia conocida: \(\nu\) está fijada por diseño o por conocimiento físico;
- frecuencia estimada: sustituimos \(\nu\) por una estimación puntual, por ejemplo la frecuencia del mayor pico;
- frecuencia incierta: propagamos una distribución posterior sobre \(\nu\).
Los escenarios 2 y 3 pueden producir pronósticos puntuales semejantes cuando la posterior está muy concentrada, pero no representan la misma incertidumbre predictiva. En el tercer caso, la distribución futura debería integrar también sobre la incertidumbre en la frecuencia.
9.18 ¿Detectar un ciclo implica poder pronosticarlo?
No necesariamente. Un periodograma responde principalmente a una pregunta sobre distribución de variabilidad por frecuencias. Un procedimiento de pronóstico debe además describir cómo continuará la dinámica después del origen del pronóstico.
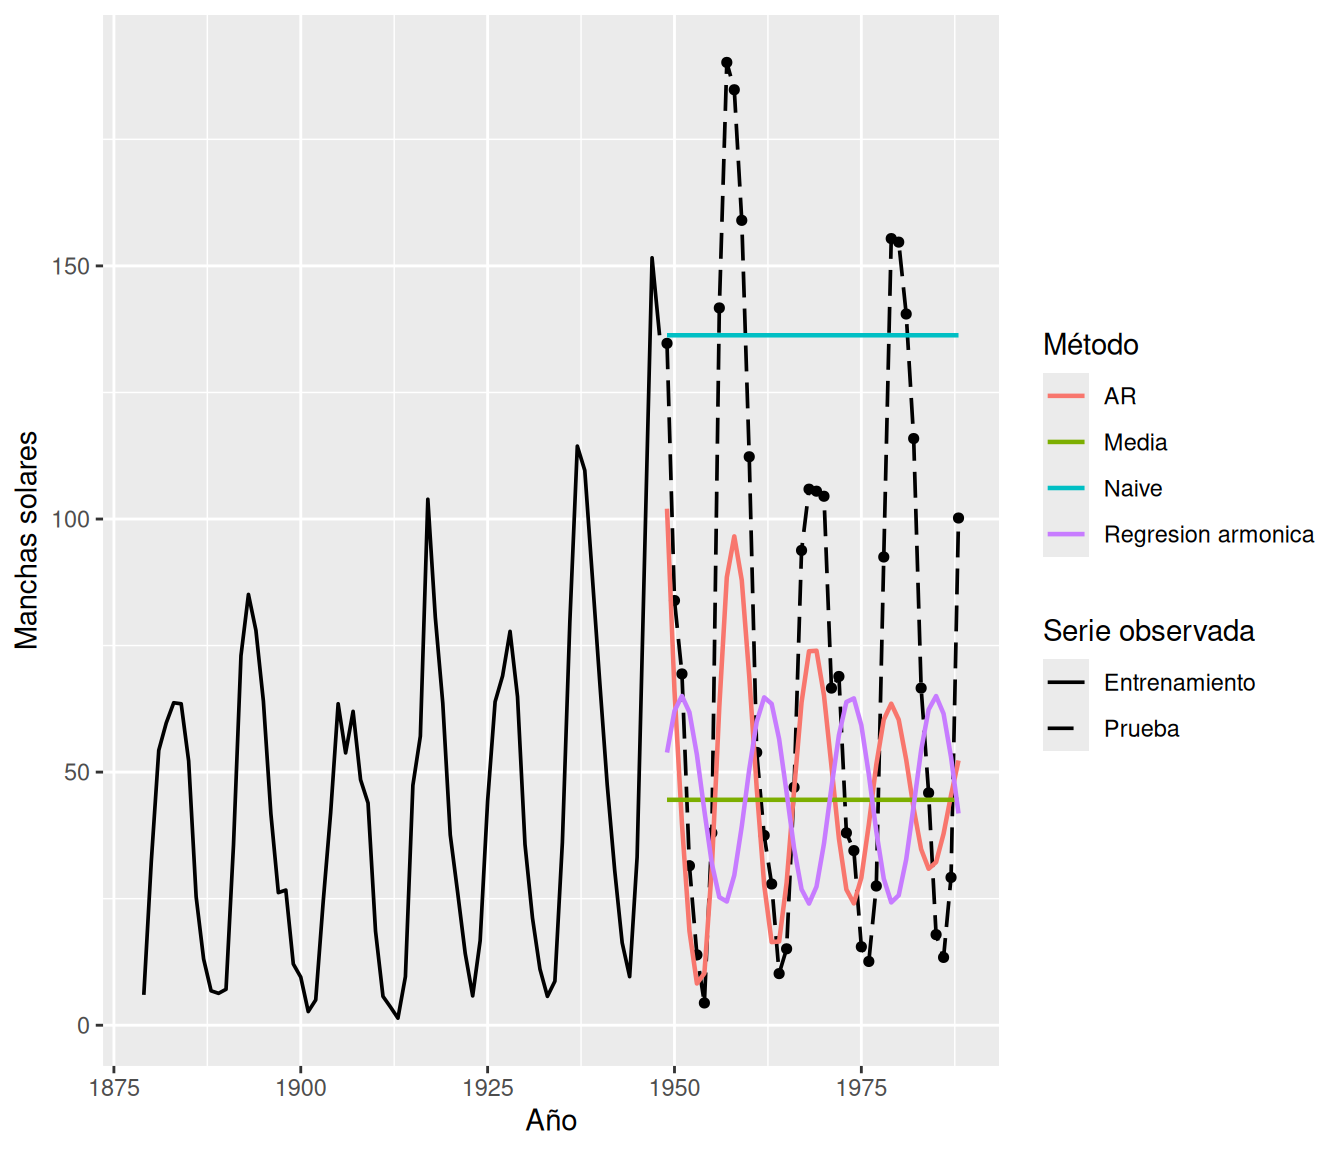
Una regresión armónica con frecuencia fija supone que la misma amplitud, fase y frecuencia continuarán indefinidamente. Para manchas solares esa hipótesis es deliberadamente simplificada: la serie muestra ciclos con amplitud y duración variables.
Realizaremos un experimento pequeño siguiendo el protocolo de Sección 7.7. Reservaremos los últimos 40 años y ajustaremos todo utilizando únicamente el entrenamiento.
9.18.1 Partición temporal
h_test_spec <- 40
n_total_spec <- nrow(sunspots_tbl)
n_train_spec <- n_total_spec - h_test_spec

sunspots_train <- sunspots_tbl |>
  slice_head(n = n_train_spec)

sunspots_test <- sunspots_tbl |>
  slice_tail(n = h_test_spec)

stopifnot(
  nrow(sunspots_train) + nrow(sunspots_test) == n_total_spec,
  max(sunspots_train$Year) < min(sunspots_test$Year)
)
9.18.2 Selección de la frecuencia usando solamente entrenamiento
per_train_sun <- periodograma_fft(sunspots_train$Sunspots) |>
  filter(freq > 0, freq < 0.5) |>
  mutate(periodo = 1 / freq) |>
  filter(periodo >= 2, periodo <= 50)

pico_train_sun <- per_train_sun |>
  slice_max(order_by = periodograma, n = 1, with_ties = FALSE)

nu_hat_train <- pico_train_sun$freq
periodo_hat_train <- 1 / nu_hat_train
La frecuencia se estima antes de observar el bloque de prueba. Elegirla usando toda la serie y luego declarar los últimos años como prueba produciría fuga de información.
9.18.3 Modelos comparados
Compararemos cuatro procedimientos puntuales:
- media histórica del entrenamiento;
- naïve;
- regresión armónica con una frecuencia seleccionada por periodograma;
- modelo AR cuyo orden se selecciona por AIC dentro del entrenamiento.
# Regresión armónica
train_arm_spec <- sunspots_train |>
  mutate(
    t = row_number(),
    cos_nu = cos(2 * pi * nu_hat_train * t),
    sin_nu = sin(2 * pi * nu_hat_train * t)
  )

fit_harm_sun <- lm(
  Sunspots ~ cos_nu + sin_nu,
  data = train_arm_spec
)

future_arm_spec <- sunspots_test |>
  mutate(
    t = n_train_spec + row_number(),
    cos_nu = cos(2 * pi * nu_hat_train * t),
    sin_nu = sin(2 * pi * nu_hat_train * t)
  )

pred_harm_sun <- as.numeric(
  predict(fit_harm_sun, newdata = future_arm_spec)
)

# AR seleccionado únicamente en entrenamiento
fit_ar_train_sun <- ar(
  sunspots_train$Sunspots,
  aic = TRUE,
  order.max = 30,
  method = "yule-walker",
  demean = TRUE
)

pred_ar_train_sun <- as.numeric(
  predict(fit_ar_train_sun, n.ahead = h_test_spec)$pred
)

# Métodos de referencia
pred_mean_sun <- rep(mean(sunspots_train$Sunspots), h_test_spec)
pred_naive_sun <- rep(tail(sunspots_train$Sunspots, 1), h_test_spec)

pronosticos_sun_holdout <- tibble(
  Year = sunspots_test$Year,
  observado = sunspots_test$Sunspots,
  Media = pred_mean_sun,
  Naive = pred_naive_sun,
  `Regresion armonica` = pred_harm_sun,
  AR = pred_ar_train_sun
) |>
  pivot_longer(
    cols = c(Media, Naive, `Regresion armonica`, AR),
    names_to = "metodo",
    values_to = "pronostico"
  )

escala_mase_sun <- mean(abs(diff(sunspots_train$Sunspots)))

accuracy_sun_holdout <- pronosticos_sun_holdout |>
  mutate(error = observado - pronostico) |>
  group_by(metodo) |>
  summarise(
    RMSE = sqrt(mean(error^2)),
    MAE = mean(abs(error)),
    MASE = mean(abs(error)) / escala_mase_sun,
    .groups = "drop"
  ) |>
  arrange(RMSE)

resumen_modelos_holdout <- tibble(
  cantidad = c(
    "Periodo armonico estimado en entrenamiento",
    "Orden AR seleccionado en entrenamiento"
  ),
  valor = c(periodo_hat_train, fit_ar_train_sun$order)
)knitr::kable(
resumen_modelos_holdout,
digits = 3,
caption = "Decisiones de modelación obtenidas exclusivamente con el período de entrenamiento."
)| cantidad | valor |
|---|---|
| Periodo armonico estimado en entrenamiento | 11.318 |
| Orden AR seleccionado en entrenamiento | 9.000 |
serie_sun_periodos <- bind_rows(
  sunspots_train |> mutate(periodo = "Entrenamiento"),
  sunspots_test |> mutate(periodo = "Prueba")
) |>
  filter(Year >= min(sunspots_test$Year) - 70)

ggplot() +
  geom_line(
    data = serie_sun_periodos,
    aes(x = Year, y = Sunspots, linetype = periodo),
    linewidth = 0.65
  ) +
  geom_point(
    data = sunspots_test,
    aes(x = Year, y = Sunspots),
    size = 1.3
  ) +
  geom_line(
    data = pronosticos_sun_holdout,
    aes(x = Year, y = pronostico, colour = metodo),
    linewidth = 0.8
  ) +
  scale_linetype_manual(
    values = c("Entrenamiento" = "solid", "Prueba" = "longdash")
  ) +
  labs(
    x = "Año",
    y = "Manchas solares",
    colour = "Método",
    linetype = "Serie observada"
  )
knitr::kable(
  accuracy_sun_holdout,
  digits = 3,
  caption = "Desempeño puntual en los 40 años reservados como prueba."
)| metodo | RMSE | MAE | MASE |
|---|---|---|---|
| AR | 44.104 | 33.464 | 2.023 |
| Media | 60.616 | 46.761 | 2.827 |
| Regresion armonica | 69.049 | 54.554 | 3.298 |
| Naive | 81.750 | 70.888 | 4.285 |
La tabla no debe interpretarse como un ranking universal. Es un único origen y un horizonte muy largo. Su propósito es ilustrar una idea conceptual: una periodicidad espectral clara puede ser útil para construir un modelo, pero la capacidad de localizar una frecuencia dominante no garantiza que una senoide con amplitud y fase constantes sea una buena extrapolación.
ImportanteEl espectro describe variabilidad; el pronóstico exige evolución futura
Dos modelos pueden reconocer la misma frecuencia dominante y producir pronósticos diferentes porque hacen supuestos distintos sobre amplitud, fase, persistencia y ruido. El dominio frecuencial no reemplaza la evaluación fuera de muestra.
9.18.4 ¿Por qué no comparamos intervalos en este ejemplo?
La regresión armónica anterior trata la frecuencia seleccionada como fija. Un intervalo convencional de lm() ignoraría la incertidumbre asociada con haber estimado esa frecuencia mediante el periodograma. El análisis bayesiano de Sección 9.17.3 muestra precisamente que \(\nu\) puede tratarse como incierta.
Para hacer una comparación distribucional justa habría que definir para todos los procedimientos una distribución predictiva coherente y, en el modelo armónico, integrar sobre amplitud, fase, varianza y frecuencia. Esa extensión es posible, pero desviaría esta semana de su objetivo principal. Conservaremos la comparación puntual y retomaremos distribuciones predictivas completas en los modelos de espacio-estado.
9.19 Perspectivas frecuentista y bayesiana
El dominio frecuencial permite ver con especial claridad la diferencia entre estimación puntual e inferencia distribucional.
En el enfoque frecuentista desarrollado en este capítulo:
- el periodograma identifica regiones de alta potencia;
- el suavizamiento busca estimar \(f(\nu)\) reduciendo la varianza del periodograma;
- un espectro paramétrico se obtiene sustituyendo estimadores de los parámetros ARMA en Ecuación 9.19;
- una frecuencia dominante puede estimarse mediante el máximo de un criterio relacionado con el periodograma.
En el enfoque bayesiano:
- la frecuencia puede tratarse como parámetro incierto;
- la priori debe especificarse en una parametrización concreta;
- la posterior puede ser multimodal cuando varias frecuencias explican porciones importantes de la serie;
- la distribución predictiva debería integrar la incertidumbre de frecuencia junto con la de los demás parámetros.
Prado et al. (2021), chap. 3 desarrolla además aproximaciones de verosimilitud en el dominio frecuencial y métodos bayesianos para densidades espectrales completas. Esos desarrollos son importantes, pero no forman parte del núcleo obligatorio de esta semana.
9.19.1 La aproximación de Whittle como extensión
Para un proceso aproximadamente gaussiano y una muestra larga, las DFT en frecuencias de Fourier distintas se comportan aproximadamente como variables complejas no correlacionadas con varianzas determinadas por el espectro. Esta idea conduce a la verosimilitud de Whittle, cuya forma negativa aproximada para un espectro paramétrico \(f_\theta\) es
\[ -\log L_W(\theta) \approx \sum_j \left[ \log f_\theta(\nu_j) + \frac{I(\nu_j)}{f_\theta(\nu_j)} \right], \tag{9.42}\]
omitiendo constantes y detalles especiales de las frecuencias cero y Nyquist (Shumway y Stoffer 2025, sec. 4.5; Prado et al. 2021, sec. 3.3).
Esta aproximación permite estimar parámetros utilizando el dominio frecuencial y también sirve como base para múltiples métodos bayesianos. No la utilizaremos computacionalmente en esta semana.
9.20 Relación entre dominio temporal y dominio frecuencial
No existen dos series distintas, una “temporal” y otra “espectral”. Son dos representaciones de la misma estructura de segundo orden.
comparacion_dominios <- tribble(
  ~Aspecto, ~Dominio_temporal, ~Dominio_frecuencial,
  "Objeto poblacional", "Autocovarianza gamma(h) o ACF rho(h)", "Densidad espectral f(nu)",
  "Eje", "Rezago h", "Frecuencia nu o periodo P",
  "Periodicidad", "ACF oscilatoria", "Pico espectral",
  "Ruido blanco", "ACF cero fuera del rezago 0", "Espectro plano",
  "ARMA", "Recurrencias y pesos psi", "Cociente de polinomios evaluados sobre el círculo unitario",
  "Muestra", "ACF muestral", "Periodograma y estimadores suavizados",
  "Ventaja típica", "Interpretación de dependencia y pronóstico recursivo", "Identificación de escalas cíclicas"
)

knitr::kable(
  comparacion_dominios,
  caption = "Dos representaciones complementarias de la estructura de segundo orden de una serie estacionaria."
)| Aspecto | Dominio_temporal | Dominio_frecuencial |
|---|---|---|
| Objeto poblacional | Autocovarianza gamma(h) o ACF rho(h) | Densidad espectral f(nu) |
| Eje | Rezago h | Frecuencia nu o periodo P |
| Periodicidad | ACF oscilatoria | Pico espectral |
| Ruido blanco | ACF cero fuera del rezago 0 | Espectro plano |
| ARMA | Recurrencias y pesos psi | Cociente de polinomios evaluados sobre el círculo unitario |
| Muestra | ACF muestral | Periodograma y estimadores suavizados |
| Ventaja típica | Interpretación de dependencia y pronóstico recursivo | Identificación de escalas cíclicas |
Una práctica útil consiste en pasar de un dominio al otro cuando una estructura es difícil de interpretar. Por ejemplo:
- una ACF que oscila puede sugerir buscar un pico espectral;
- un pico espectral puede motivar revisar si la ACF presenta alternancia coherente con ese período;
- un espectro AR con un pico estrecho puede interpretarse examinando las raíces complejas del polinomio autorregresivo.
9.21 Diagnóstico y límites de la interpretación
9.21.1 Un pico no prueba causalidad
Que una serie tenga potencia elevada cerca de una frecuencia no explica qué mecanismo físico, económico o actuarial produce esa periodicidad. El análisis espectral describe estructura estadística.
9.21.2 Un pico no implica periodicidad constante
El espectro clásico resume una estructura estacionaria global. Si la frecuencia dominante cambia con el tiempo, un único espectro puede promediar comportamientos diferentes. En cursos posteriores o proyectos especializados pueden utilizarse espectros locales, modelos autorregresivos con parámetros variables o métodos tiempo–frecuencia.
9.21.3 Un periodograma grande puede acompañar un mal modelo armónico
Prado et al. (2021), sec. 3.1.3 advierte que una frecuencia puede producir un valor grande del periodograma incluso cuando una sola componente armónica es un modelo global pobre. El periodograma es una herramienta de identificación, no una validación completa del modelo.
9.21.4 Desestacionalizar antes de analizar puede remover precisamente la frecuencia de interés
Si la pregunta consiste en estudiar periodicidad anual, remover previamente una estacionalidad anual puede eliminar la señal que queríamos examinar. Toda transformación debe justificarse por la pregunta científica.
9.21.5 Tendencias fuertes contaminan bajas frecuencias
Una tendencia determinista o una raíz unitaria puede producir potencia elevada cerca de cero. La teoría espectral desarrollada aquí supone estacionariedad débil. Antes de interpretar picos muy cercanos a frecuencia cero debemos regresar a las herramientas de estacionariedad y diferenciación estudiadas en las semanas 2 y 6.
9.22 Buenas prácticas computacionales
9.22.1 Verificar la escala de frecuencia
Antes de interpretar un período, confirme la unidad de muestreo. Un pico en \(\nu=0.25\) significa:
- período 4 meses si cada observación es mensual;
- período 4 años si cada observación es anual;
- período 4 días si cada observación es diaria.
9.22.2 No interpretar automáticamente la salida de fft()
fft() devuelve una DFT sin la normalización \(n^{-1/2}\) utilizada en Ecuación 9.21. Además, contiene frecuencias positivas y negativas en un orden propio de la transformación discreta. Conviene construir explícitamente la malla de frecuencias y documentar la escala.
9.22.3 Separar cálculo y visualización
En código reproducible es preferible guardar primero una tabla con columnas como
freq
periodograma
periodo
y después construir las figuras. Esto permite verificar unidades, localizar máximos y construir tablas sin extraer datos de un gráfico.
9.22.4 Usar caché en simulaciones o mallas costosas
El experimento Monte Carlo y algunas evaluaciones bayesianas pueden ser costosos. Como en Sección 8.26.4, los chunks estables pueden utilizar
#| cache: truesiempre que se invalide la caché cuando cambian datos, semillas o código del que dependen.
9.22.5 No confundir resolución con suavizamiento
Aumentar el ancho de una ventana de suavizamiento no crea información nueva entre frecuencias. La resolución básica está condicionada por la longitud temporal de la muestra. Un suavizamiento muy fuerte puede ocultar dos picos próximos que la muestra apenas alcanzaba a distinguir.
9.23 Actividad computacional guiada
La actividad propone reconstruir progresivamente el análisis de manchas solares y relacionarlo con la teoría.
9.23.1 Parte A. Frecuencia y período
- Simule una senoide con período 8 y otra con período 20.
- Grafique ambas en el mismo intervalo temporal.
- Convierta sus períodos a frecuencias y frecuencias angulares.
- Explique cuál corresponde a una oscilación más rápida.
- Verifique numéricamente el aliasing entre \(\nu=0.15\) y \(\nu=0.85\) al muestrear en tiempos enteros.
9.23.2 Parte B. Regresión armónica
- Reproduzca Sección 9.5.2.
- Cambie la fase verdadera y compruebe que la frecuencia no cambia.
- Estime amplitud y fase a partir de los coeficientes seno–coseno.
- Ajuste deliberadamente una frecuencia incorrecta y compare SSE.
- Explique por qué la frecuencia desconocida hace que el problema deje de ser lineal en todos los parámetros simultáneamente.
9.23.3 Parte C. Espectros teóricos
- Reproduzca Figura 9.4.
- Compare AR(1) con \(\phi=0.8\) y \(\phi=-0.8\).
- Compare MA(1) con \(\theta=0.8\) y \(\theta=-0.8\).
- Para el AR(2), calcule las raíces del polinomio y relacione su argumento con el pico espectral.
- Verifique numéricamente que integrar el espectro aproximado sobre \([-1/2,1/2]\) recupera aproximadamente la varianza teórica.
9.23.4 Parte D. DFT y periodograma
- Implemente Ecuación 9.21 mediante una suma explícita, sin
fft(). - Compare el resultado con
fft()después de corregir la normalización. - Verifique Ecuación 9.25 en tres frecuencias de Fourier.
- Simule dos frecuencias muy próximas y estudie qué longitud \(n\) permite separarlas visualmente.
- Repita el ejemplo de fuga espectral para varias frecuencias fuera de la malla.
9.23.5 Parte E. Suavizamiento
- Simule cien realizaciones del AR(2) utilizado en Sección 9.13.2.
- Compare error cuadrático integrado del periodograma crudo y de dos suavizados.
- Explore el compromiso entre ventanas de 5, 11 y 21 ordenadas.
- Aplique el taper cosenoidal de Ecuación 9.34 antes del periodograma.
- Discuta qué detalles se pierden al aumentar el suavizamiento.
9.23.6 Parte F. Manchas solares
- Reproduzca el gráfico temporal y la ACF.
- Calcule el periodograma y convierta los cinco picos mayores a períodos.
- Compare esos picos antes y después del suavizamiento.
- Ajuste modelos AR con distintos órdenes máximos.
- Compare visualmente sus espectros con la estimación no paramétrica.
- Redacte una conclusión que distinga claramente entre “frecuencia dominante” y “ciclo determinista”.
9.23.7 Parte G. Inferencia bayesiana
- Reproduzca Sección 9.17.3.
- Compare la priori uniforme en frecuencia con la uniforme en período.
- Cambie el soporte de 2–50 a 5–20 años.
- Examine si cambia la moda posterior.
- Explique por qué restringir el soporte utilizando información observada en la misma serie puede actuar como una decisión de modelación dependiente de los datos.
9.23.8 Parte H. Pronóstico
- Cambie el holdout de 40 a 30 años.
- Reestime la frecuencia armónica solamente con el nuevo entrenamiento.
- Compare MAE, RMSE y MASE.
- Determine si el modelo con la periodicidad espectral más clara es también el mejor pronosticador en ese experimento.
- Explique qué incertidumbre no está representada por los pronósticos puntuales de la regresión armónica.
9.24 Síntesis
Los resultados principales del capítulo pueden resumirse de la siguiente manera.
Frecuencia y período son inversos:
\[ P=\frac{1}{\nu}. \]
Frecuencia angular y frecuencia en ciclos se relacionan mediante
\[ \omega=2\pi\nu. \]
Con muestreo unitario, la información no redundante de una serie real está entre cero y la frecuencia de Nyquist \(1/2\).
Una regresión armónica con frecuencia conocida es lineal en los coeficientes seno–coseno.
Bajo sumabilidad absoluta de la autocovarianza, ACF y densidad espectral son pares de Fourier:
\[ f(\nu) = \sum_h\gamma(h)e^{-2\pi i\nu h}, \]
\[ \gamma(h) = \int_{-1/2}^{1/2}f(\nu)e^{2\pi i\nu h}\,d\nu. \]
La varianza total es el área bajo el espectro bilateral:
\[ \gamma(0)=\int_{-1/2}^{1/2}f(\nu)\,d\nu. \]
El ruido blanco tiene espectro plano.
Un ARMA\((p,q)\) tiene espectro
\[ f_Y(\nu) = \sigma_w^2 \frac{|\theta(e^{-2\pi i\nu})|^2} {|\phi(e^{-2\pi i\nu})|^2}. \]
Raíces AR complejas producen ACF oscilatoria y concentración espectral alrededor de frecuencias interiores.
La DFT descompone una muestra sobre una base de exponenciales complejas en las frecuencias de Fourier.
El periodograma es el módulo cuadrado de la DFT, pero distintas referencias utilizan normalizaciones distintas.
En las frecuencias de Fourier, el periodograma está directamente relacionado con la suma de cuadrados explicada por una regresión armónica.
Aunque
\[ E\{I(\nu)\}\approx f(\nu), \]
su varianza no desaparece con \(n\), por lo que el periodograma crudo no es un estimador consistente puntual.
El suavizamiento reduce varianza a cambio de resolución; el tapering busca controlar fuga espectral.
El análisis de manchas solares muestra cómo un pico alrededor de una periodicidad aproximada de una década puede aparecer tanto en estimación no paramétrica como paramétrica.
Una inferencia bayesiana sobre frecuencia hace explícita la incertidumbre y muestra que una priori uniforme depende de la parametrización elegida.
Una periodicidad bien identificada no garantiza un buen pronóstico. El desempeño debe evaluarse fuera de muestra bajo el mismo protocolo temporal utilizado en las semanas anteriores.
9.25 Ejercicios
9.25.1 Conceptos
Frecuencia y período. Una serie mensual tiene un ciclo de 18 meses. Calcule \(\nu\) en ciclos por mes y \(\omega\) en radianes por mes.
Nyquist. Una serie se observa cada 15 minutos. ¿Cuál es la frecuencia de Nyquist en ciclos por hora? ¿Cuál es el período más corto distinguible sin aliasing?
Aliasing. Demuestre que, para tiempos enteros, \(\cos\{2\pi(1-\nu)t\}=\cos(2\pi\nu t)\).
Fase. Dos señales tienen la misma amplitud y frecuencia, pero fases distintas. ¿Tienen el mismo período? ¿Tendrían el mismo periodograma ideal si se observaran durante un número entero de ciclos sin ruido?
Ruido blanco. Explique por qué un espectro plano es compatible con ausencia de autocorrelación.
Frecuencias bajas. ¿Por qué una tendencia fuerte puede crear potencia cerca de frecuencia cero aunque no exista un ciclo de período finito bien definido?
AR positivo. Explique por qué un AR(1) con \(\phi\) cercano a uno concentra potencia en frecuencias bajas.
AR negativo. ¿Qué forma cualitativa espera para el espectro de un AR(1) con \(\phi<0\)?
Raíces complejas. Relacione verbalmente la ACF amortiguada de Sección 2.9.2 con un pico interior del espectro.
Pico espectral. ¿Por qué un pico grande no prueba que exista un mecanismo causal periódico?
Periodograma. Explique por qué el aumento de \(n\) mejora la resolución frecuencial aunque no haga consistente una ordenada individual del periodograma.
Suavizamiento. ¿Qué se gana y qué se pierde al aumentar el ancho de una ventana espectral?
Taper. Compare conceptualmente el propósito del tapering con el del suavizamiento.
Pronóstico. Proponga una serie que tenga un pico espectral muy claro pero para la cual extrapolar una senoide con amplitud constante sería poco razonable.
Uniformidad. Explique por qué una priori uniforme sobre \(P\) no puede ser simultáneamente uniforme sobre \(\nu=1/P\).
9.25.2 Derivaciones
Amplitud y fase. A partir de
\[ \alpha_1\cos(2\pi\nu t)+\alpha_2\sin(2\pi\nu t), \]
derive Ecuación 9.6 y Ecuación 9.7.
Espectro MA(1). Para
\[ Y_t=W_t+\theta W_{t-1}, \]
derive
\[ f_Y(\nu) = \sigma_w^2 \{1+\theta^2+2\theta\cos(2\pi\nu)\}. \]
Espectro AR(1). Para
\[ Y_t=\phi Y_{t-1}+W_t, \]
derive
\[ f_Y(\nu) = \frac{\sigma_w^2} {1+\phi^2-2\phi\cos(2\pi\nu)}. \]
Varianza total. Use Ecuación 9.10 con \(h=0\) para demostrar Ecuación 9.13.
Simetría. Muestre que una autocovarianza real y par produce una densidad espectral real y par.
Regresión y periodograma. Demuestre Ecuación 9.25 utilizando la ortogonalidad de seno y coseno en las frecuencias de Fourier.
Distribución asintótica. Si
\[ I(\nu)\dot\sim\frac12f(\nu)\chi_2^2, \]
derive su media y varianza aproximadas.
Promedio de ordenadas. Suponga, idealizadamente, que \(L\) ordenadas vecinas son independientes y tienen distribución \(f\chi_2^2/2\). Calcule la varianza del promedio de las \(L\) ordenadas y explique por qué el suavizamiento puede producir consistencia si \(L\) crece apropiadamente con \(n\).
Cambio de variable de la priori. Si \(P\sim\operatorname{Unif}(a,b)\) y \(\nu=1/P\), derive la densidad inducida de \(\nu\).
Whittle. Partiendo de ordenadas aproximadamente exponenciales con media \(f_\theta(\nu_j)\), derive salvo constantes la forma de Ecuación 9.42.
9.25.3 Interpretación y modelación
Dos picos cercanos. Un periodograma muestra picos en 0.100 y 0.105 ciclos por día. Discuta qué información adicional necesita para saber si la muestra tiene suficiente resolución para distinguirlos.
Pico ancho. ¿Qué diferencias interpretativas existen entre un pico estrecho y uno ancho alrededor de la misma frecuencia central?
Suavizamiento excesivo. Dos investigadores usan ventanas muy diferentes y uno de ellos no observa un pico secundario. Explique por qué esta discrepancia no implica necesariamente un error de programación.
Modelo AR de alto orden. Un AR(30) reproduce muy bien un espectro no paramétrico, pero un AR(4) no. ¿Puede concluir que el proceso verdadero es AR(30)? Justifique.
Serie no estacionaria. Una serie tiene tendencia lineal pronunciada y un periodograma con máximo en la frecuencia positiva más pequeña. ¿Por qué sería prematuro reportar esa frecuencia como un ciclo?
Posterior multimodal. Una posterior de frecuencia tiene dos modos bien separados. ¿Qué riesgo existe al reportar solamente la media posterior de \(\nu\)?
Transformación a período. Si la posterior de \(\nu\) es simétrica, ¿debe ser simétrica la posterior de \(P=1/\nu\)? Explique.
Evaluación. Un modelo armónico tiene menor RMSE que un AR en un holdout, pero el AR tiene menor MAE. ¿Hay contradicción? Relacione su respuesta con Sección 7.6.
Fuga de información. Explique por qué seleccionar la frecuencia usando el periodograma de toda la serie antes de separar entrenamiento y prueba invalida una evaluación predictiva final.
Ciclo variable. Una señal tiene período cercano a 10 años durante la primera mitad y cercano a 14 durante la segunda. ¿Qué podría mostrar un espectro global? ¿Qué limitación tendría esa representación?
9.25.4 Computación
DFT manual. Escriba una función en R que implemente Ecuación 9.21 mediante dos bucles. Compare con
fft().Parseval. Investigue y verifique numéricamente la identidad de Parseval para la normalización utilizada en
periodograma_fft().AR(1). Simule 500 observaciones con \(\phi=0.9\) y compare periodograma, espectro suavizado y espectro teórico.
AR(1) negativo. Repita con \(\phi=-0.9\) y explique el cambio de localización de la potencia.
AR(2). Construya un AR(2) cuyas raíces complejas estén asociadas aproximadamente con un período de 20 observaciones. Verifique el pico espectral mediante simulación.
Resolución. Simule una suma de frecuencias 0.10 y 0.12 para \(n=50\), \(200\) y \(1000\). Compare periodogramas.
Leakage. Mantenga \(n=128\) y mueva una frecuencia gradualmente desde \(16/128\) hasta \(16.5/128\). Describa la evolución de la fuga.
Tapering. Compare el periodograma sin taper y con el taper cosenoidal de Ecuación 9.34. Normalice por el máximo y discuta lóbulos laterales y ancho del pico.
Sunspots. Reproduzca Tabla 9.4 usando un promedio de 11 ordenadas en lugar de 5. ¿Cuáles picos son estables?
Espectro AR. Ajuste
ar()conorder.max = 15,30y50. Compare órdenes seleccionados y espectros resultantes.Priores. Reproduzca la posterior de frecuencia con tres soportes diferentes y compare moda e intervalo creíble del período.
Holdout. Repita Sección 9.18 reservando 30 años. Compare la frecuencia estimada y el orden AR con el experimento original.
Origen móvil. Diseñe una validación con origen móvil para comparar regresión armónica y AR a horizontes \(h=1,5,10\). La frecuencia de la regresión armónica debe reestimarse dentro de cada ventana.
Incertidumbre de frecuencia. Simule frecuencias desde la posterior discreta de Sección 9.17.3, ajuste amplitud y fase condicionalmente y construya una colección de trayectorias futuras. Compare su dispersión con la obtenida al fijar la frecuencia modal.
Informe breve. Redacte una conclusión de máximo 250 palabras sobre manchas solares que incluya: frecuencia dominante, período, efecto del suavizamiento, comparación paramétrica/no paramétrica, incertidumbre bayesiana y una limitación predictiva.
9.26 Lecturas recomendadas
- Shumway y Stoffer: capítulo 4 para comportamiento cíclico, densidad espectral, DFT, periodograma, estimación espectral no paramétrica y espectros paramétricos (Shumway y Stoffer 2025, chap. 4).
- Prado, Ferreira y West: sección 3.1 para regresión armónica, periodograma e inferencia sobre frecuencias; secciones 3.2.1–3.2.4 para representación espectral, relación con autocorrelaciones y estimación no paramétrica (Prado et al. 2021, chap. 3).
- Hyndman y Athanasopoulos: capítulo 5 para mantener el protocolo de evaluación fuera de muestra utilizado en la sección predictiva (Hyndman y Athanasopoulos 2021, chap. 5).
- Las secciones avanzadas sobre verosimilitud de Whittle, densidades espectrales bayesianas no paramétricas y espectros variables en el tiempo pueden utilizarse como extensión de proyecto, pero no forman parte del núcleo obligatorio de esta semana (Prado et al. 2021, sec. 3.3; Shumway y Stoffer 2025, chap. 4).