13  Modelos lineales dinámicos bayesianos

CA-0415 Series de Tiempo — Semana 13

13.1 Objetivos de aprendizaje

Al finalizar este capítulo, la persona estudiante podrá:

  1. Construir la distribución conjunta y la posterior de estados latentes y parámetros estáticos de un modelo lineal dinámico (DLM).
  2. Distinguir inferencia condicionada en parámetros conocidos, estimación por máxima verosimilitud e inferencia bayesiana completa.
  3. Derivar una actualización conjugada normal–inversa-gamma y la distribución predictiva Student-t correspondiente.
  4. Interpretar los factores de descuento como una especificación de incertidumbre de evolución dependiente del tiempo.
  5. Demostrar el paso retrospectivo del algoritmo forward filtering–backward sampling (FFBS) y diferenciarlo del suavizador RTS.
  6. Derivar e implementar un algoritmo de Gibbs para un modelo de nivel local con dos varianzas desconocidas.
  7. Examinar diagnóstico MCMC, sensibilidad a prioris e identificabilidad de componentes de varianza.
  8. Construir y evaluar pronósticos posteriores respetando el orden temporal de la información.

El capítulo conecta Sección 12.6 y Sección 12.7.1 con la regresión dinámica de la semana 14. El filtro de Kalman continúa siendo la herramienta central para los cálculos gaussianos condicionales en los parámetros. La novedad es que ahora los parámetros no se sustituyen necesariamente por estimadores puntuales (Prado et al. 2021, secs. 4.3–4.5; Petris et al. 2009, cap. 4).

13.2 Motivación: ¿qué incertidumbre representa un pronóstico?

En la semana 12, para el modelo de nivel local,

\[ Y_t=x_t+v_t,\qquad x_t=x_{t-1}+w_t, \tag{13.1}\]

se estimaron \(V=\operatorname{Var}(v_t)\) y \(W=\operatorname{Var}(w_t)\) por máxima verosimilitud. Luego se calculó la distribución predictiva condicional a \((\widehat V,\widehat W)\). Esa distribución cuantifica incertidumbre futura del estado y de la observación tratando las varianzas estimadas como si fueran conocidas.

Bajo un enfoque bayesiano especificamos \(p(V,W)\) y obtenemos \(p(V,W\mid y_{1:T})\). Por tanto,

\[ p(y_{T+h}\mid y_{1:T}) =\int p(y_{T+h}\mid y_{1:T},V,W) \,p(V,W\mid y_{1:T})\,dV\,dW. \tag{13.2}\]

La primera distribución dentro de la integral procede del filtro de Kalman y su propagación a \(h\) pasos. La segunda describe incertidumbre paramétrica. En general, la mezcla resultante no es normal, aun cuando las distribuciones predictivas condicionadas sean normales.

Hay tres incertidumbres distintas: (i) estado actual desconocido, (ii) parámetros desconocidos y (iii) perturbaciones futuras. La predicción posterior integra las tres. No se debe afirmar que un intervalo bayesiano siempre será más ancho o tendrá mejor cobertura: sus propiedades dependen del modelo, de la priori y de los datos.

13.3 Formulación jerárquica de un DLM

13.3.1 Modelo y conjunto de información

Utilizamos exactamente las convenciones de Sección 12.3. Para una observación escalar y un estado de dimensión \(p\),

\[ \begin{aligned} Y_t\mid\boldsymbol x_t,\boldsymbol\psi &\sim N(\boldsymbol F_t^\top\boldsymbol x_t,V_t),\\ \boldsymbol x_t\mid\boldsymbol x_{t-1},\boldsymbol\psi &\sim N_p(\boldsymbol G_t\boldsymbol x_{t-1},\boldsymbol W_t),\\ \boldsymbol x_0\mid\boldsymbol\psi &\sim N_p(\boldsymbol m_0,\boldsymbol C_0),\\ \boldsymbol\psi&\sim p(\boldsymbol\psi). \end{aligned} \tag{13.3}\]

Aquí \(\boldsymbol\psi\) reúne los parámetros desconocidos de las matrices \(V_t,\boldsymbol W_t\) u otras partes del modelo. En las secciones iniciales supondremos \(\boldsymbol F_t\) y \(\boldsymbol G_t\) especificadas. Las innovaciones \(v_t\) y \(\boldsymbol w_t\) son independientes entre tiempos y entre sí, y el estado inicial es independiente de las innovaciones condicionalmente a los parámetros.

Precisión importante sobre la priori inicial. Es posible especificar \(\boldsymbol m_0\) y \(\boldsymbol C_0\) de forma fija, o hacerlas depender de \(\boldsymbol\psi\). Ambas son decisiones de modelación legítimas, pero producen modelos jerárquicos distintos. En los ejemplos de varianzas independientes usaremos una priori propia \(x_0\sim N(900,200^2)\), independiente de \(V\) y \(W\); en el ejemplo conjugado haremos \(\operatorname{Var}(x_0\mid\sigma^2)\) proporcional a \(\sigma^2\).

13.3.2 Factorización de la distribución conjunta

Por la propiedad de Markov de los estados y la independencia condicional de las observaciones,

\[ \begin{aligned} p(y_{1:T},\boldsymbol x_{0:T},\boldsymbol\psi) ={}&p(\boldsymbol\psi) \,p(\boldsymbol x_0\mid\boldsymbol\psi)\\ &\times\prod_{t=1}^{T} p(\boldsymbol x_t\mid\boldsymbol x_{t-1},\boldsymbol\psi)\\ &\times\prod_{t=1}^{T} p(y_t\mid\boldsymbol x_t,\boldsymbol\psi). \end{aligned} \tag{13.4}\]

La posterior de interés es

\[ p(\boldsymbol x_{0:T},\boldsymbol\psi\mid y_{1:T}) \propto p(y_{1:T},\boldsymbol x_{0:T},\boldsymbol\psi). \tag{13.5}\]

Dos marginalizaciones tienen finalidades diferentes:

\[ \begin{aligned} p(\boldsymbol\psi\mid y_{1:T}) &\propto p(\boldsymbol\psi) \int p(y_{1:T},\boldsymbol x_{0:T}\mid\boldsymbol\psi) \,d\boldsymbol x_{0:T},\\ p(\boldsymbol x_t\mid y_{1:T}) &=\int p(\boldsymbol x_t,\boldsymbol\psi\mid y_{1:T}) \,d\boldsymbol\psi. \end{aligned} \tag{13.6}\]

La primera integra los estados al aprender parámetros; la segunda integra los parámetros al estimar estados. Si \(\boldsymbol\psi\) fuera conocido, las recursiones gaussianas de Kalman y RTS resolverían analíticamente el segundo problema condicional. Cuando es desconocido, puede necesitarse integración numérica o MCMC (Petris et al. 2009, secs. 4.1–4.2).

13.3.3 Gráfico de dependencias del modelo

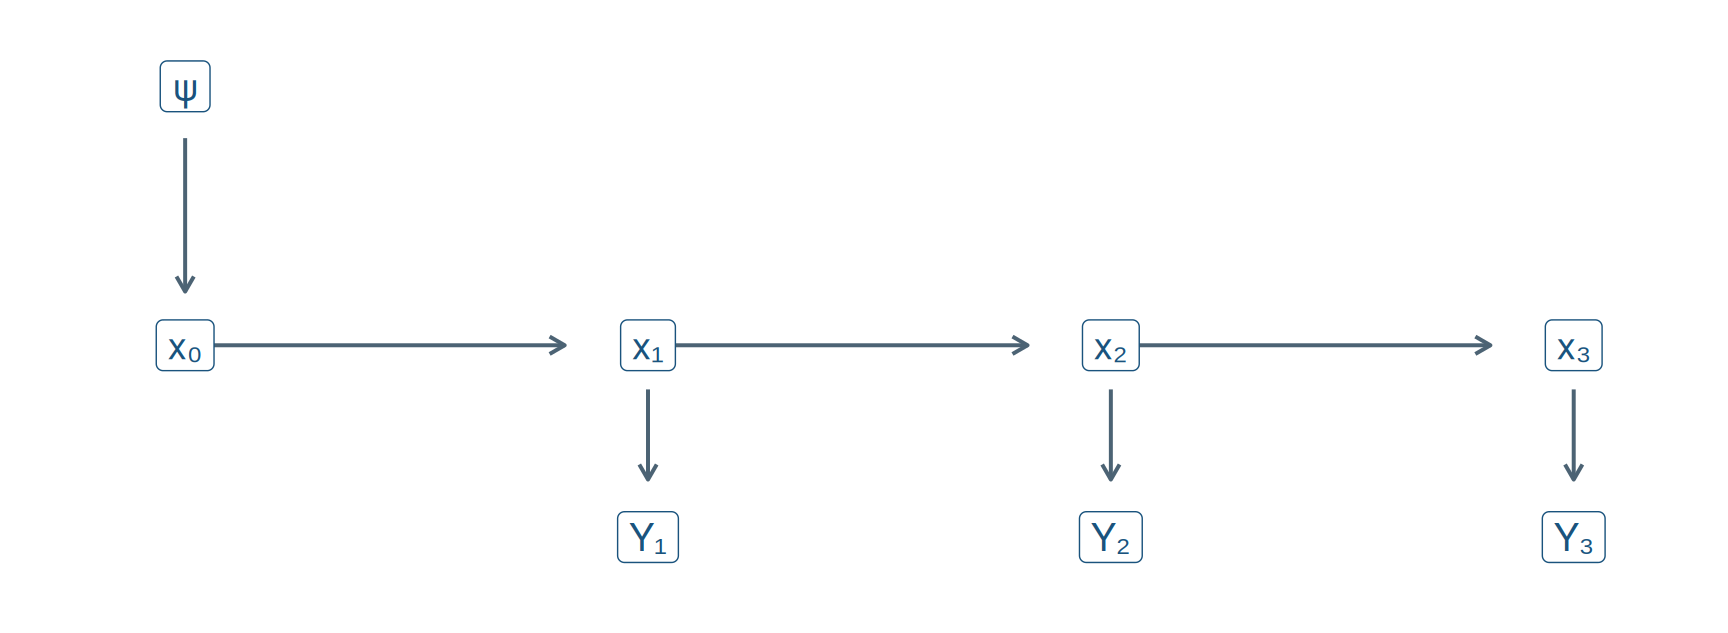
La estructura se puede representar esquemáticamente como

\[ \boldsymbol\psi\longrightarrow \bigl\{\boldsymbol x_0\longrightarrow\boldsymbol x_1 \longrightarrow\cdots\longrightarrow\boldsymbol x_T\bigr\}, \qquad \boldsymbol x_t\longrightarrow Y_t, \]

recordando que \(\boldsymbol\psi\) también determina las distribuciones de todas las transiciones y observaciones. La independencia de \(Y_t\) y \(Y_s\), condicionada en las trayectorias latentes y parámetros, no significa independencia marginal de las observaciones.

nodos_bdlm <- tibble(
  x = c(0, 0, 1.5, 3, 4.5, 1.5, 3, 4.5),
  y = c(2.35, 1, 1, 1, 1, 0, 0, 0),
  etiqueta = c("ψ", "x₀", "x₁", "x₂", "x₃", "Y₁", "Y₂", "Y₃")
)
flechas_bdlm <- tibble(
  x = c(0, 0, 1.5, 3, 1.5, 3, 4.5),
  y = c(2.08, 1, 1, 1, .77, .77, .77),
  xend = c(0, 1.23, 2.73, 4.23, 1.5, 3, 4.5),
  yend = c(1.28, 1, 1, 1, .30, .30, .30)
)

ggplot() +
  geom_segment(data = flechas_bdlm,
               aes(x = x, y = y, xend = xend, yend = yend),
               arrow = grid::arrow(length = grid::unit(2.3, "mm")),
               linewidth = .7, colour = "#4C6374") +
  geom_label(data = nodos_bdlm, aes(x, y, label = etiqueta),
             size = 5, fill = "white", colour = "#1A537D") +
  coord_cartesian(xlim = c(-.6, 5), ylim = c(-.5, 2.8), expand = FALSE) +
  theme_void()
Diagrama de estados encadenados desde x cero hasta x tres, con observaciones Y uno a Y tres y parámetros generales psi.
Figura 13.1: Estructura jerárquica simplificada: evolución de los estados y observaciones condicionales. El parámetro estático ψ determina las distribuciones del sistema; se omiten algunas flechas para conservar la claridad del esquema.

13.4 Inferencia conjugada para una escala de varianza desconocida

13.4.1 Un modelo con escala compartida

Para mostrar con exactitud dónde aparece la conjugación, consideremos

\[ \begin{aligned} Y_t\mid x_t,\sigma^2&\sim N(x_t,\sigma^2),\\ x_t\mid x_{t-1},\sigma^2&\sim N(x_{t-1},q\sigma^2),\\ x_0\mid\sigma^2&\sim N(m_0,c_0\sigma^2),\\ \sigma^2&\sim\operatorname{IG}(a_0,b_0), \end{aligned} \tag{13.7}\]

con \(q>0\) y \(c_0>0\) conocidos. Definimos \(\operatorname{IG}(a,b)\) mediante la densidad

\[ p(z)=\frac{b^a}{\Gamma(a)}z^{-a-1}\exp(-b/z), \qquad z>0, \tag{13.8}\]

por lo que \(\mathbb E(Z)=b/(a-1)\) si \(a>1\). Esta convención es fundamental: \(b\) es una escala, no una tasa gamma de \(Z\); la precisión \(1/Z\) sí tiene distribución gamma con tasa \(b\).

El supuesto clave para la conjugación es que las covarianzas del estado inicial, de observación y de evolución comparten la misma escala \(\sigma^2\). No se debe extrapolar automáticamente el resultado al modelo con dos varianzas libres e independientes.

esquemas_bdlm <- tibble(
  esquema = c("Escala común", "Varianzas independientes"),
  especificacion = c("V = σ², W = qσ², q conocido",
                    "V y W libres con prioris IG independientes"),
  procedimiento = c("Actualización normal–IG y predictiva Student-t",
                    "Gibbs con FFBS para los estados")
)
knitr::kable(esquemas_bdlm)
Tabla 13.1: Dos especificaciones de varianzas para el nivel local y sus consecuencias inferenciales.
esquema especificacion procedimiento
Escala común V = σ², W = qσ², q conocido Actualización normal–IG y predictiva Student-t
Varianzas independientes V y W libres con prioris IG independientes Gibbs con FFBS para los estados

13.4.2 Filtro en unidades de escala

Escribamos las covarianzas como \(C_t=\sigma^2\widetilde C_t\), \(R_t=\sigma^2\widetilde R_t\) y \(Q_t=\sigma^2\widetilde Q_t\). En el nivel local:

\[ \begin{aligned} a_t&=m_{t-1}, &\widetilde R_t&=\widetilde C_{t-1}+q,\\ f_t&=a_t, &\widetilde Q_t&=\widetilde R_t+1,\\ e_t&=y_t-f_t, &A_t&=\frac{\widetilde R_t}{\widetilde Q_t},\\ m_t&=a_t+A_te_t, &\widetilde C_t&=(1-A_t)\widetilde R_t. \end{aligned} \tag{13.9}\]

La ganancia \(A_t\) no depende de \(\sigma^2\): el factor común se cancela en su cociente. Condicionada en \(\sigma^2\), la descomposición predictiva da

\[ p(y_{1:T}\mid\sigma^2) =\prod_{t=1}^T \frac{1}{\sqrt{2\pi\sigma^2\widetilde Q_t}} \exp\left(-\frac{e_t^2}{2\sigma^2\widetilde Q_t}\right). \tag{13.10}\]

Como \(f_t\) y \(\widetilde Q_t\) no dependen de \(\sigma^2\), los términos relevantes en la verosimilitud son

\[ p(y_{1:T}\mid\sigma^2) \propto (\sigma^2)^{-T/2} \exp\left[-\frac{1}{2\sigma^2} \sum_{t=1}^T\frac{e_t^2}{\widetilde Q_t}\right]. \tag{13.11}\]

13.4.3 Posterior y predictiva Student-t

Multiplicando por la priori inversa-gamma obtenemos

\[ \sigma^2\mid y_{1:T}\sim\operatorname{IG}(a_T,b_T), \quad \begin{cases} a_T=a_0+T/2,\\[2pt] b_T=b_0+\dfrac12\displaystyle\sum_{t=1}^T \dfrac{e_t^2}{\widetilde Q_t}. \end{cases} \tag{13.12}\]

A horizonte \(h\), condicionando en \(\sigma^2\),

\[ Y_{T+h}\mid\sigma^2,y_{1:T} \sim N\bigl(f_{T+h\mid T},\sigma^2\widetilde Q_{T+h\mid T}\bigr). \]

La integración de \(\sigma^2\) respecto de su posterior inversa-gamma conduce a

\[ \boxed{ Y_{T+h}\mid y_{1:T} \sim t_{2a_T}\left( f_{T+h\mid T}, \sqrt{\frac{b_T}{a_T}\widetilde Q_{T+h\mid T}} \right), } \tag{13.13}\]

con la segunda componente como parámetro de escala, no desviación estándar. Para \(a_T>1\) su varianza es \(\widetilde Q_{T+h\mid T}\,b_T/(a_T-1)\). La distribución Student-t incorpora incertidumbre sobre \(\sigma^2\), y no se obtiene simplemente reemplazando \(\sigma^2\) por su media en una normal (Prado et al. 2021, sec. 4.3.2; Petris et al. 2009, sec. 4.3).

NotaAlcance de este resultado

La conjugación anterior fija la razón \(W/V=q\). Un DLM con \(V\) y \(W\) desconocidas de forma independiente no conserva, en general, esta posterior unidimensional inversa-gamma después de integrar los estados. Precisamente ese caso motivará FFBS y Gibbs.

13.5 Factores de descuento

13.5.1 ¿Cómo especificar la incertidumbre de evolución?

Para un DLM con matriz de transición \(\boldsymbol G_t\), la covarianza predictiva del estado es

\[ \boldsymbol R_t =\boldsymbol G_t\boldsymbol C_{t-1}\boldsymbol G_t^\top +\boldsymbol W_t. \]

Definamos \(\boldsymbol P_t=\boldsymbol G_t\boldsymbol C_{t-1}\boldsymbol G_t^\top\). Una regla de descuento escalar establece

\[ \boldsymbol R_t=\delta^{-1}\boldsymbol P_t, \qquad 0<\delta\leq1. \tag{13.14}\]

Al igualar ambas expresiones obtenemos

\[ \boxed{\boldsymbol W_t=\frac{1-\delta}{\delta} \boldsymbol G_t\boldsymbol C_{t-1}\boldsymbol G_t^\top.} \tag{13.15}\]

Esta igualdad es una regla de especificación: al reducir \(\delta\) se añade incertidumbre predictiva al estado. Para \(\delta=1\) no se añade ruido de evolución por esta regla; cuando \(\delta\) se aproxima a cero, la evolución es mucho más incierta.

No implica que la matriz \(\boldsymbol W_t\) sea constante, ni que pueda interpretarse como una estimación posterior de una varianza fija. Además, \(\boldsymbol C_{t-1}\) depende de los datos y, por tanto, la regla resulta adaptativa. En un modelo con escala común \(\sigma^2\), puede emplearse de manera equivalente \(\widetilde R_t=\widetilde C_{t-1}/\delta\). Bajo supuestos gaussianos conjugados, la actualización de escala continúa utilizando Ecuación 13.12, con \(\widetilde Q_t=\widetilde R_t+1\) (Prado et al. 2021, sec. 4.3.6; Petris et al. 2009, sec. 4.3.2).

13.5.2 Experimento: nivel local con descuento conjugado

Consideremos varios factores de descuento. Para facilitar la comparación fijaremos

\[ \sigma^2\sim \operatorname{IG}(3,2\times130^2), \quad x_0\mid\sigma^2\sim N\left(900,\frac{200^2}{130^2}\sigma^2\right). \tag{13.16}\]

La elección de estas distribuciones a priori permite controlar dos cantidades interpretables: la escala de variabilidad de las observaciones y la incertidumbre sobre el estado inicial.

Valor esperado de \(\sigma^2\). Recordemos que, bajo la parametrización de la distribución gamma inversa con parámetros de forma \(\alpha\) y escala \(\beta\), su función de densidad es

\[ p(s)=\frac{\beta^\alpha}{\Gamma(\alpha)} s^{-(\alpha+1)} \exp\left(-\frac{\beta}{s}\right), \qquad s>0. \]

El valor esperado existe para \(\alpha>1\) y está dado por

\[ \mathbb{E}(\sigma^2)=\frac{\beta}{\alpha-1}. \]

En nuestro caso, \(\alpha=3\) y \(\beta=2\times130^2\). Por tanto,

\[ \begin{aligned} \mathbb{E}(\sigma^2) &=\frac{2\times130^2}{3-1}\\ &=\frac{2\times130^2}{2}\\ &=130^2=16900. \end{aligned} \]

Así, los hiperparámetros se seleccionaron para que la varianza de observación tenga una esperanza a priori de \(16900\), correspondiente a una desviación estándar de referencia de \(130\). Debe señalarse que esto no significa que \(\mathbb{E}(\sigma)=130\), pues, en general,

\[ \mathbb{E}(\sigma)\neq\sqrt{\mathbb{E}(\sigma^2)}. \]

Varianza marginal del estado inicial. La distribución condicional del estado inicial implica que

\[ \mathbb{E}(x_0\mid\sigma^2)=900 \]

y

\[ \operatorname{Var}(x_0\mid\sigma^2) =\frac{200^2}{130^2}\sigma^2. \]

Sin embargo, la varianza anterior es condicional en \(\sigma^2\). Para obtener la varianza marginal de \(x_0\), debemos integrar la incertidumbre sobre este parámetro. Utilizamos la ley de la varianza total:

\[ \begin{aligned} \operatorname{Var}(x_0) ={}&\mathbb{E}\left[ \operatorname{Var}(x_0\mid\sigma^2) \right]\\ &+\operatorname{Var}\left[ \mathbb{E}(x_0\mid\sigma^2) \right]. \end{aligned} \]

Para el primer término, tenemos

\[ \begin{aligned} \mathbb{E}\left[ \operatorname{Var}(x_0\mid\sigma^2) \right] &=\mathbb{E}\left[ \frac{200^2}{130^2}\sigma^2 \right]\\ &=\frac{200^2}{130^2}\mathbb{E}(\sigma^2)\\ &=\frac{200^2}{130^2}\times130^2\\ &=200^2. \end{aligned} \]

Por otra parte, como la esperanza condicional de \(x_0\) es constante,

\[ \operatorname{Var}\left[ \mathbb{E}(x_0\mid\sigma^2) \right] =\operatorname{Var}(900)=0. \]

En consecuencia,

\[ \boxed{ \operatorname{Var}(x_0)=200^2=40000. } \]

Asimismo, por la ley de la esperanza iterada,

\[ \mathbb{E}(x_0) =\mathbb{E}\left[ \mathbb{E}(x_0\mid\sigma^2) \right] =900. \]

Por lo tanto, la distribución marginal a priori del estado inicial tiene media \(900\) y desviación estándar \(200\).

Interpretación de la parametrización. Estos valores no se obtienen de los datos, sino que representan elecciones previas a su observación. La especificación permite establecer una desviación estándar de referencia de \(130\) para las observaciones y una desviación estándar marginal de \(200\) para el estado inicial.

Además, la varianza condicional de \(x_0\) es proporcional a \(\sigma^2\). Por ello, valores mayores de la varianza de observación implican mayor incertidumbre condicional sobre el estado inicial:

\[ \operatorname{SD}(x_0\mid\sigma^2) =200\sqrt{\frac{\sigma^2}{130^2}}. \]

Finalmente, aunque la distribución de \(x_0\) condicionada en \(\sigma^2\) es normal, su distribución marginal no lo es. Al integrar \(\sigma^2\) bajo la priori gamma inversa, se obtiene una distribución Student-\(t\):

\[ x_0\sim t_6\left( 900,\;200\sqrt{\frac{2}{3}} \right), \]

donde el segundo argumento representa el parámetro de escala, no la desviación estándar. Esta distribución tiene seis grados de libertad, media \(900\) y varianza \(200^2\). Sus colas son más pesadas que las de una distribución normal, lo que permite asignar mayor probabilidad a valores iniciales alejados de \(900\).

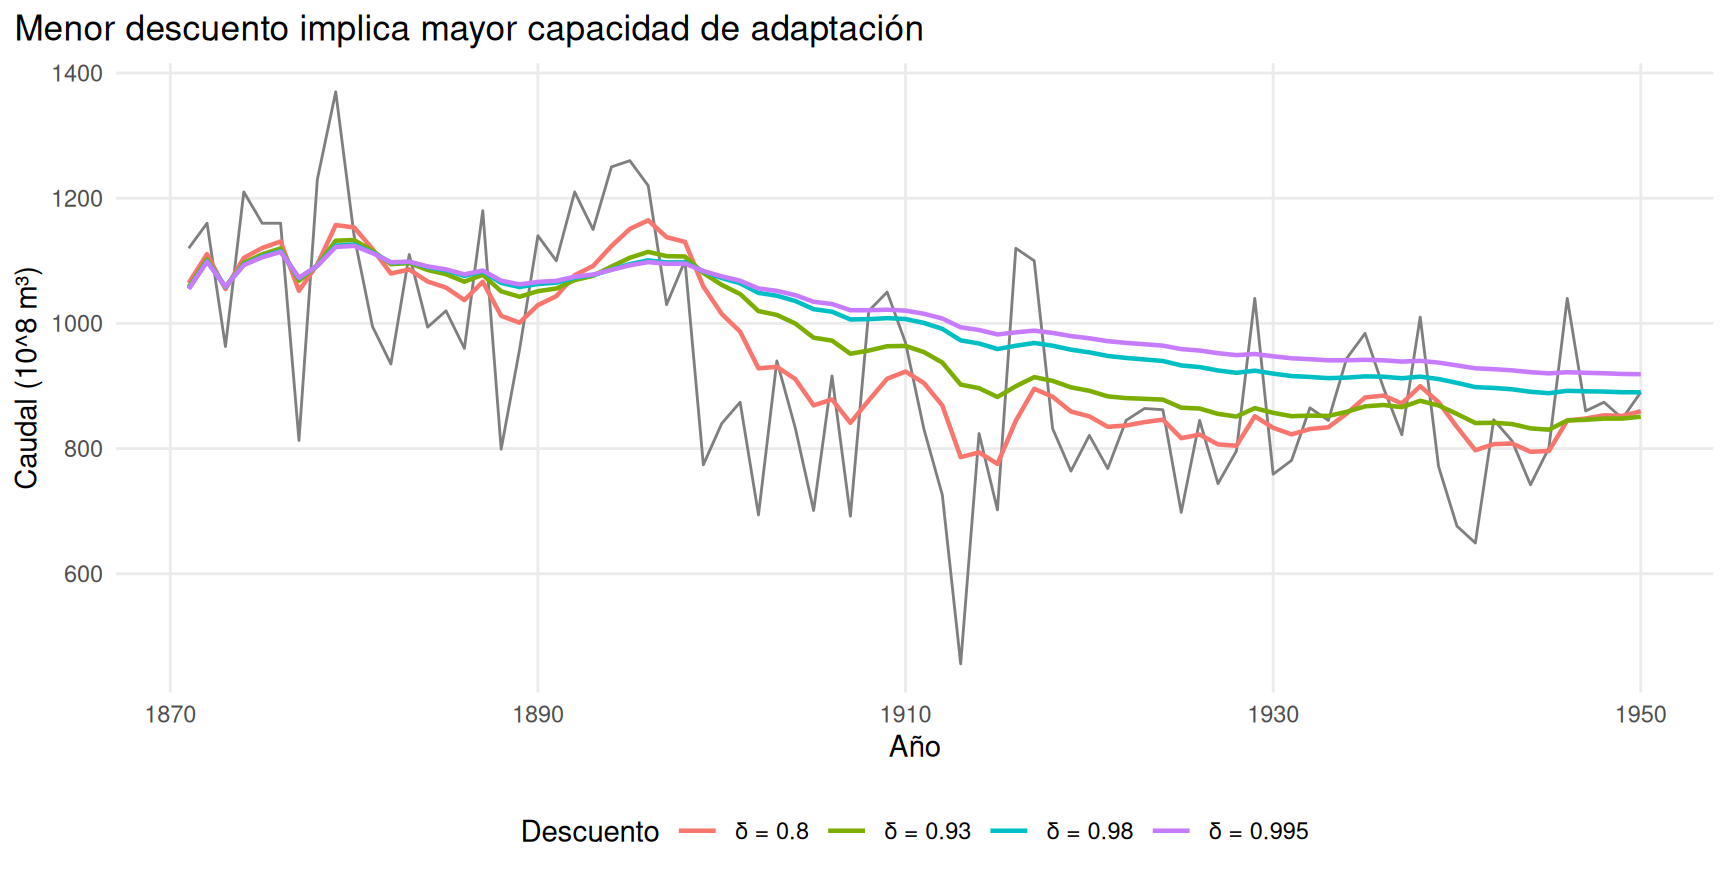
Una vez establecidas las distribuciones a priori, podemos estudiar cómo influye el factor de descuento \(\delta\) en la estimación del estado latente. Para ello, consideramos distintos valores de \(\delta\), manteniendo fija la especificación a priori anterior, y aplicamos el modelo a la serie del caudal del río Nilo. Recordemos que un menor valor de \(\delta\) implica una mayor varianza de evolución del estado y, por tanto, una mayor capacidad del modelo para adaptarse a cambios en las observaciones. En contraste, valores de \(\delta\) cercanos a uno producen estimaciones más suaves, que responden más lentamente a las fluctuaciones de la serie. La siguiente figura permite visualizar este compromiso entre adaptabilidad y suavidad.

nilo_bdlm <- tibble(
  anio = as.integer(stats::time(datasets::Nile)),
  caudal = as.numeric(datasets::Nile)
) |>
  mutate(t = row_number(),
         periodo = if_else(t <= 80L, "Entrenamiento", "Prueba"))

stopifnot(nrow(nilo_bdlm) == 100L,
          identical(range(nilo_bdlm$anio), c(1871L, 1970L)),
          all(diff(nilo_bdlm$anio) == 1L),
          !anyNA(nilo_bdlm), all(is.finite(nilo_bdlm$caudal)))
y_train_bdlm <- nilo_bdlm$caudal[1:80]
y_test_bdlm <- nilo_bdlm$caudal[81:100]
deltas_bdlm <- c(.80, .93, .98, .995)
ajustes_desc_bdlm <- purrr::map(deltas_bdlm,
                                ~filtrar_descuento_bdlm(y_train_bdlm, delta = .x))
curvas_desc_bdlm <- purrr::map2_dfr(
  ajustes_desc_bdlm, deltas_bdlm,
  ~mutate(.x$trayectoria,
          anio = nilo_bdlm$anio[t],
          descuento = paste0("δ = ", .y))
)

ggplot() +
  geom_line(data = nilo_bdlm |> filter(t <= 80L),
            aes(anio, caudal), colour = "grey50", linewidth = .5) +
  geom_line(data = curvas_desc_bdlm,
            aes(anio, m, colour = descuento), linewidth = .8) +
  labs(x = "Año", y = "Caudal (10^8 m³)", colour = "Descuento",
       title = "Menor descuento implica mayor capacidad de adaptación") +
  tema_bdlm
Datos observados y varias curvas de estado filtrado para distintos factores de descuento.
Figura 13.2: Estados filtrados del Nilo en entrenamiento (1871–1950) bajo factores de descuento distintos. El descuento regula la adaptación del nivel, no estima una W constante.

La adaptación rápida puede ser ventajosa si el nivel cambia bruscamente, pero puede provocar un seguimiento excesivo del ruido de observación. La elección de \(\delta\) debería contrastarse mediante log-verosimilitudes predictivas secuenciales, o preferentemente mediante evaluación temporal fuera de muestra; no basta con seleccionar la trayectoria visualmente más cercana a los datos.

13.6 Simulación conjunta de estados: FFBS

13.6.1 Por qué el suavizador RTS no basta

En Sección 12.7.1 aprendimos a calcular \(p(\boldsymbol x_t\mid y_{1:T},\boldsymbol\psi)\) mediante suavizamiento. Las distribuciones marginales no describen por sí solas la dependencia posterior entre tiempos. Si se simula cada \(\boldsymbol x_t\) independientemente desde su marginal RTS, el vector generado no tiene en general la distribución conjunta

\[ p(\boldsymbol x_{0:T}\mid y_{1:T},\boldsymbol\psi). \]

Esto importa especialmente al actualizar parámetros de evolución, cuya condicional depende de los incrementos \(x_t-x_{t-1}\).

Para comprender por qué esta distinción es importante, consideremos nuevamente el modelo de nivel local,

\[ x_t=x_{t-1}+w_t, \qquad w_t\sim N(0,W). \]

Como \(x_t-x_{t-1}=w_t\), los incrementos del estado latente, condicionalmente en \(W\), son independientes y siguen una distribución \(N(0,W)\). En consecuencia, la verosimilitud de \(W\) condicionada en la trayectoria completa de estados es

\[ p(x_{1:T}\mid x_0,W) \propto W^{-T/2} \exp\left\{ -\frac{1}{2W} \sum_{t=1}^{T}(x_t-x_{t-1})^2 \right\}. \]

Por ejemplo, si especificamos una priori \(W\sim\operatorname{IG}(a_W,b_W)\), independiente de la priori del estado inicial, obtenemos la distribución condicional completa

\[ W\mid x_{0:T},y_{1:T},V \sim \operatorname{IG}\left( a_W+\frac{T}{2}, b_W+\frac{1}{2} \sum_{t=1}^{T}(x_t-x_{t-1})^2 \right). \]

Por tanto, la actualización de \(W\) depende directamente de los incrementos cuadrados de los estados latentes.

El problema de simular cada \(x_t\) independientemente desde su distribución marginal suavizada es que se pierde la dependencia posterior entre estados consecutivos. En efecto,

\[ \begin{aligned} &\operatorname{Var}(x_t-x_{t-1}\mid y_{1:T},\boldsymbol\psi)\\ &\quad = C_{t\mid T}+C_{t-1\mid T}\\ &\qquad - 2\operatorname{Cov}(x_t,x_{t-1} \mid y_{1:T},\boldsymbol\psi). \end{aligned} \]

Si los estados se simulan independientemente, se elimina artificialmente el término de covarianza. Cuando esta covarianza es positiva, como suele ocurrir en un modelo de nivel local, la variabilidad de los incrementos simulados se sobreestima. Esto puede producir trayectorias excesivamente irregulares y distorsionar la actualización posterior de \(W\).

El algoritmo FFBS evita este problema porque genera trayectorias completas desde la distribución posterior conjunta \(p(x_{0:T}\mid y_{1:T},\boldsymbol\psi)\), preservando la dependencia temporal entre estados. Así, los incrementos calculados a partir de cada trayectoria simulada pueden utilizarse correctamente en la actualización de los parámetros de evolución dentro de un algoritmo MCMC.

Conviene señalar que las covarianzas entre estados consecutivos también pueden obtenerse mediante extensiones del suavizamiento RTS y utilizarse en métodos basados en momentos, como el algoritmo EM. La necesidad de FFBS surge específicamente cuando buscamos simular trayectorias conjuntas de estados, en lugar de calcular únicamente momentos marginales suavizados. (Petris et al. 2009, sec. 4.4.1).

13.6.2 Derivación gaussiana del paso retrospectivo

Condicionalmente en \(\boldsymbol\psi\), sean

\[ \begin{aligned} \boldsymbol x_t\mid y_{1:t}&\sim N_p(\boldsymbol m_t,\boldsymbol C_t),\\ \boldsymbol x_{t+1}\mid y_{1:t}&\sim N_p(\boldsymbol a_{t+1},\boldsymbol R_{t+1}). \end{aligned} \]

Por la ecuación de estado, la covarianza cruzada es

\[ \operatorname{Cov}(\boldsymbol x_t,\boldsymbol x_{t+1}\mid y_{1:t}) =\boldsymbol C_t\boldsymbol G_{t+1}^\top. \tag{13.17}\]

Por tanto, el vector \((\boldsymbol x_t^\top,\boldsymbol x_{t+1}^\top)^\top\), condicionado en \(y_{1:t}\), es normal con matriz de covarianza por bloques

\[ \begin{pmatrix} \boldsymbol C_t&\boldsymbol C_t\boldsymbol G_{t+1}^\top\\ \boldsymbol G_{t+1}\boldsymbol C_t&\boldsymbol R_{t+1} \end{pmatrix}. \]

Utilizando la fórmula de condicionamiento normal multivariado se obtiene

\[ \boxed{ \begin{aligned} \boldsymbol x_t\mid\boldsymbol x_{t+1},y_{1:T},\boldsymbol\psi &\sim N_p(\boldsymbol b_t,\boldsymbol B_t),\\ \boldsymbol b_t &=\boldsymbol m_t+ \boldsymbol J_t(\boldsymbol x_{t+1}-\boldsymbol a_{t+1}),\\ \boldsymbol B_t &=\boldsymbol C_t- \boldsymbol J_t\boldsymbol R_{t+1}\boldsymbol J_t^\top,\\ \boldsymbol J_t &=\boldsymbol C_t\boldsymbol G_{t+1}^\top \boldsymbol R_{t+1}^{-1}. \end{aligned}} \tag{13.18}\]

La igualdad al condicionar adicionalmente en \(y_{t+1:T}\) se justifica por la propiedad de Markov: conocida \(\boldsymbol x_{t+1}\), las observaciones futuras ya no suministran información adicional sobre \(\boldsymbol x_t\). El mismo coeficiente \(\boldsymbol J_t\) aparece en RTS, pero aquí se utiliza un estado futuro simulado, no su media suavizada.

El algoritmo completo es:

  1. Ejecutar el filtro de Kalman con parámetros fijados en \(\boldsymbol\psi\).
  2. Simular \(\boldsymbol x_T^{(s)}\sim N_p(\boldsymbol m_T,\boldsymbol C_T)\).
  3. Para \(t=T-1,\ldots,0\), simular \(\boldsymbol x_t^{(s)}\) con Ecuación 13.18 utilizando el estado futuro \(\boldsymbol x_{t+1}^{(s)}\) recién generado.

De esta manera la trayectoria tiene la factorización posterior

\[ p(\boldsymbol x_{0:T}\mid y_{1:T},\boldsymbol\psi) =p(\boldsymbol x_T\mid y_{1:T},\boldsymbol\psi) \prod_{t=0}^{T-1} p(\boldsymbol x_t\mid\boldsymbol x_{t+1},y_{1:t},\boldsymbol\psi). \tag{13.19}\]

13.6.3 Comprobación con una serie simulada

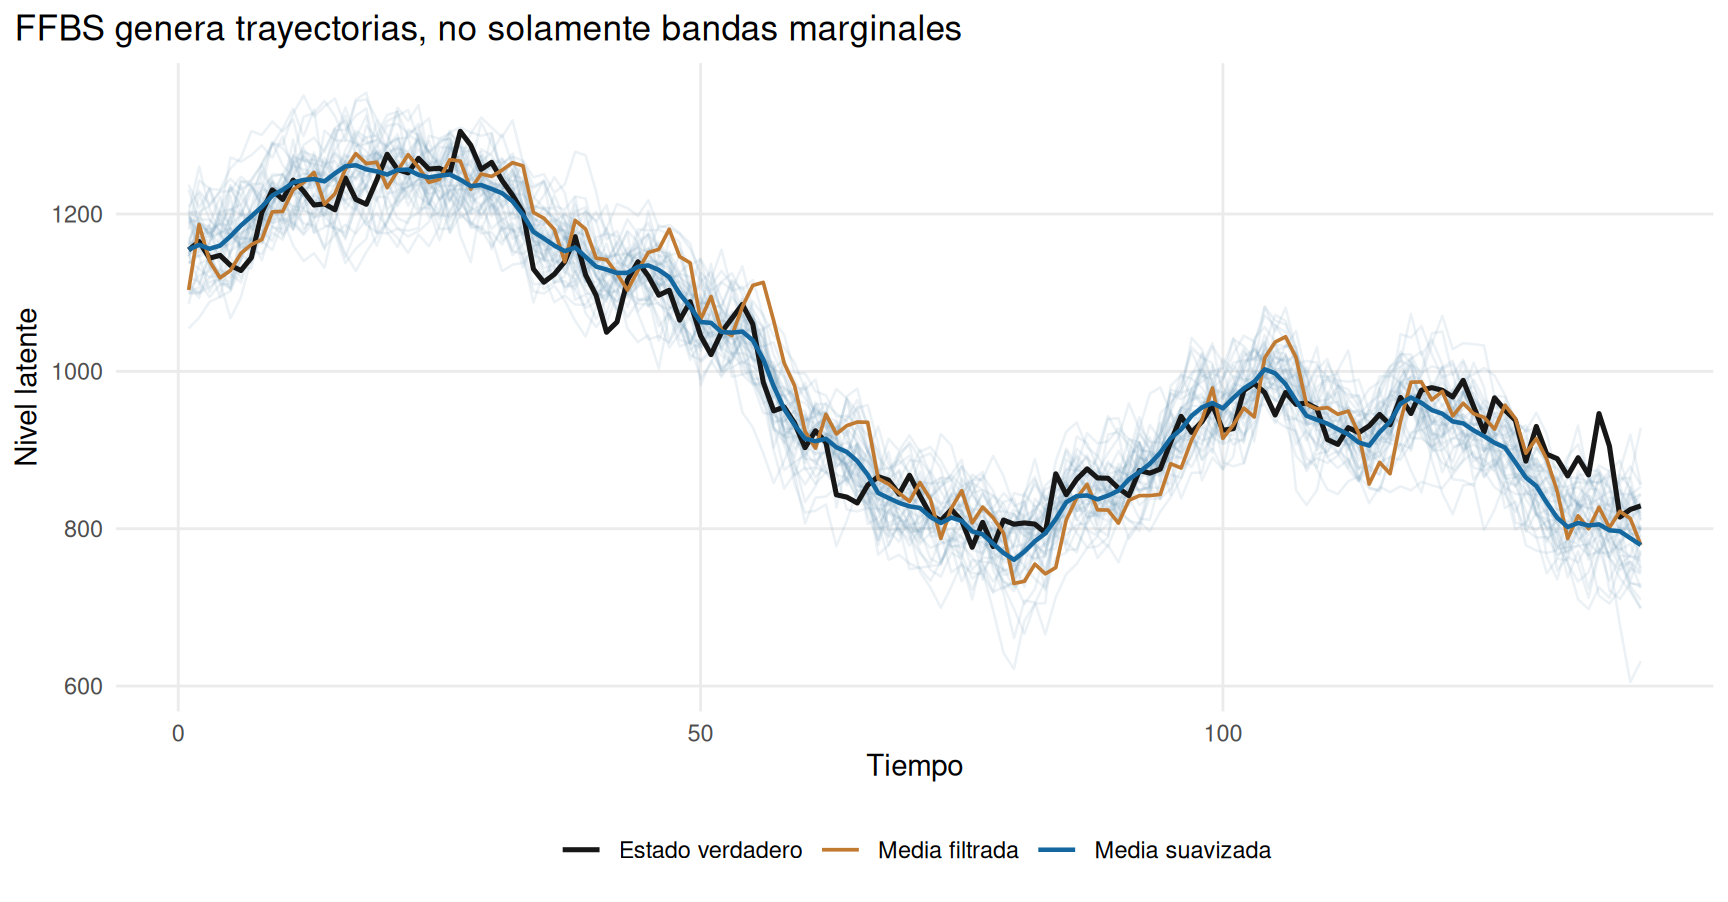
Simularemos \(T=140\) observaciones con \(V=100^2\) y \(W=30^2\). Con parámetros conocidos, las trayectorias FFBS son independientes entre sí si se emplean simulaciones independientes, pero los estados dentro de cada trayectoria mantienen su dependencia posterior.

set.seed(1313)
n_sim_bdlm <- 140L
V_sim_bdlm <- 100^2
W_sim_bdlm <- 30^2
x0_sim_bdlm <- rnorm(1, mean = 900, sd = 200)
estados_sim_bdlm <- x0_sim_bdlm + cumsum(rnorm(n_sim_bdlm, sd = sqrt(W_sim_bdlm)))
y_sim_bdlm <- estados_sim_bdlm + rnorm(n_sim_bdlm, sd = sqrt(V_sim_bdlm))
stopifnot(length(y_sim_bdlm) == n_sim_bdlm, all(is.finite(y_sim_bdlm)))

kf_sim_bdlm <- filtrar_nivel_bdlm(y_sim_bdlm, V_sim_bdlm, W_sim_bdlm)
rts_sim_bdlm <- suavizar_nivel_bdlm(kf_sim_bdlm)
set.seed(1314)
tray_sim_bdlm <- replicate(40L, muestrear_ffbs_bdlm(kf_sim_bdlm))
stopifnot(identical(dim(tray_sim_bdlm), c(n_sim_bdlm + 1L, 40L)))

tray_sim_tabla_bdlm <- tray_sim_bdlm[-1L, , drop = FALSE]
colnames(tray_sim_tabla_bdlm) <- paste0("rep_", seq_len(ncol(tray_sim_tabla_bdlm)))
trazas_sim_bdlm <- as_tibble(tray_sim_tabla_bdlm) |>
  mutate(t = seq_len(n_sim_bdlm)) |>
  pivot_longer(-t, names_to = "trayectoria", values_to = "estado")

resumen_sim_bdlm <- tibble(
  t = seq_len(n_sim_bdlm), observado = y_sim_bdlm,
  verdadero = estados_sim_bdlm,
  filtrado = kf_sim_bdlm$m[-1L],
  suavizado = rts_sim_bdlm$s[-1L]
)
ggplot() +
  geom_line(data = trazas_sim_bdlm,
            aes(t, estado, group = trayectoria),
            colour = "#6696B4", alpha = .13, linewidth = .45) +
  geom_line(data = resumen_sim_bdlm,
            aes(t, verdadero, colour = "Estado verdadero"), linewidth = .9) +
  geom_line(data = resumen_sim_bdlm,
            aes(t, filtrado, colour = "Media filtrada"), linewidth = .65) +
  geom_line(data = resumen_sim_bdlm,
            aes(t, suavizado, colour = "Media suavizada"), linewidth = .8) +
  scale_colour_manual(values = c("Estado verdadero" = "#171717",
                                 "Media filtrada" = "#C17A32",
                                 "Media suavizada" = "#14689F")) +
  labs(x = "Tiempo", y = "Nivel latente", colour = NULL,
       title = "FFBS genera trayectorias, no solamente bandas marginales") +
  tema_bdlm
Trayectorias latentes simuladas y curvas del estado real, filtrado y suavizado.
Figura 13.3: Simulación de un nivel local: cuarenta trayectorias posteriores FFBS (líneas tenues), estado verdadero, medias filtrada y suavizada. La simulación posterior conserva correlación temporal.

Una verificación numérica útil es comparar la media y varianza de muchas realizaciones FFBS en un tiempo fijo con los momentos RTS correspondientes. Las diferencias deben disminuir conforme aumenta el número de simulaciones. Este experimento ilustra el muestreo condicional en varianzas conocidas; en la siguiente sección incorporaremos incertidumbre de esas varianzas.

13.7 MCMC con parámetros desconocidos: Gibbs y muestreo marginal

13.7.1 Modelo y distribuciones a priori

Consideremos nuevamente Ecuación 13.1, pero ahora con varianzas independientes desconocidas:

\[ \begin{aligned} x_0&\sim N(m_0,C_0),\\ V&\sim\operatorname{IG}(a_V,b_V),\\ W&\sim\operatorname{IG}(a_W,b_W), \end{aligned} \tag{13.20}\]

con independencia previa entre \(V\), \(W\) y \(x_0\). En particular, \(x_0\) no tiene covarianza proporcional a \(V\) o \(W\). Esta elección permite utilizar las condicionales completas que derivaremos a continuación.

Es útil trabajar con la precisión de observación \(\tau_V=1/V\) y la precisión de evolución \(\tau_W=1/W\). Si \(V\sim\operatorname{IG}(a_V,b_V)\), entonces \(\tau_V\sim\operatorname{Gamma}(a_V,\text{tasa = }b_V)\).

13.7.2 Condicional completa de la varianza de observación

Condicionando en la trayectoria completa,

\[ p(y_{1:T}\mid x_{1:T},V) \propto V^{-T/2} \exp\left[-\frac{1}{2V}\sum_{t=1}^T(y_t-x_t)^2\right]. \]

Multiplicando por la priori de \(V\), su densidad posterior es la de una inversa-gamma::

\[ \boxed{ V\mid x_{0:T},W,y_{1:T} \sim\operatorname{IG}\left( a_V+\frac{T}{2},\ b_V+\frac12\sum_{t=1}^T(y_t-x_t)^2 \right).} \tag{13.21}\]

Obsérvese que la condicional no depende de \(W\) una vez conocida la trayectoria; sí depende de todos los estados observacionalmente relevantes \(x_1,\ldots,x_T\).

13.7.3 Condicional completa de la varianza de evolución

Por la ecuación de estado,

\[ p(x_{1:T}\mid x_0,W) \propto W^{-T/2} \exp\left[-\frac{1}{2W}\sum_{t=1}^T(x_t-x_{t-1})^2\right]. \]

Por tanto,

\[ \boxed{ W\mid x_{0:T},V,y_{1:T} \sim\operatorname{IG}\left( a_W+\frac{T}{2},\ b_W+\frac12\sum_{t=1}^T(x_t-x_{t-1})^2 \right).} \tag{13.22}\]

¿Por qué incluimos \(x_0\) en la simulación? Porque el término de evolución correspondiente a \(t=1\) es \((x_1-x_0)^2\). Si \(x_0\) fuera desconocido pero se fijara artificialmente en \(m_0\) durante el muestreo, ya no se estaría estimando el modelo con \(x_0\sim N(m_0,C_0)\).

13.7.4 Algoritmo de Gibbs por bloques

Las tres transiciones de cada iteración \(s\) son:

\[ \begin{aligned} x_{0:T}^{(s)}&\sim p(x_{0:T}\mid y_{1:T},V^{(s-1)},W^{(s-1)}),\\ V^{(s)}&\sim p(V\mid x_{0:T}^{(s)},y_{1:T}),\\ W^{(s)}&\sim p(W\mid x_{0:T}^{(s)},y_{1:T}). \end{aligned} \tag{13.23}\]

La primera transición se implementa mediante FFBS; las otras dos utilizan Ecuación 13.21 y Ecuación 13.22. Con una simulación posterior suficiente, se pueden construir inferencias para \(V\), \(W\), \(W/V\), \(x_t\) y las observaciones futuras.

No hay que confundir el muestreo de estados por FFBS dentro del Gibbs con el muestreo de trayectorias independientes bajo parámetros fijos. Entre iteraciones del Gibbs hay dependencia de Markov que exige diagnósticos MCMC (Petris et al. 2009, secs. 4.4.2–4.4.3; Prado et al. 2021, sec. 4.5).

13.7.5 Mejora computacional: Metropolis–Hastings marginal y FFBS

El Gibbs anterior facilita la derivación de las condicionales completas, pero puede mostrar alta autocorrelación en \(W\): una trayectoria latente muy suave favorece valores pequeños de \(W\), que a su vez inducen trayectorias igualmente suaves en la siguiente iteración. Aumentar las iteraciones reduce el error Monte Carlo, pero no elimina este mecanismo de dependencia.

Una alternativa consiste en integrar los estados antes de actualizar los parámetros. El filtro de Kalman permite calcular exactamente, para cada pareja \((V,W)\), la verosimilitud marginal

\[ p(y_{1:T}\mid V,W)=\prod_{t=1}^T p(y_t\mid y_{1:t-1},V,W). \tag{13.24}\]

Trabajamos en coordenadas no restringidas \(\boldsymbol\eta=(\log V,\log W)^\top\). Dado que \(V\) y \(W\) tienen prioris inversa-gamma independientes, incluidos los jacobianos del cambio de variable, el logaritmo de la posterior de \(\boldsymbol\eta\) es, salvo constantes,

\[ \begin{aligned} \log p(\boldsymbol\eta\mid y_{1:T}) ={}&\log p(y_{1:T}\mid e^{\eta_V},e^{\eta_W}) -a_V\eta_V-b_Ve^{-\eta_V}\\ &-a_W\eta_W-b_We^{-\eta_W}. \end{aligned} \tag{13.25}\]

13.7.5.1 Construcción de la propuesta independiente Student-\(t\)

El objetivo del procedimiento Metropolis–Hastings marginal es generar muestras de la distribución posterior de las varianzas \(V\) y \(W\) sin condicionar en una trayectoria particular de los estados latentes. Para ello, aprovechamos que el filtro de Kalman permite evaluar la verosimilitud marginal de los datos, integrando analíticamente los estados \(x_{0:T}\).

Recordemos que trabajamos con el vector transformado

\[ \boldsymbol\eta= \begin{pmatrix} \eta_V\\ \eta_W \end{pmatrix} = \begin{pmatrix} \log V\\ \log W \end{pmatrix}. \]

Esta transformación permite trabajar en \(\mathbb R^2\) sin imponer explícitamente las restricciones \(V>0\) y \(W>0\). Las varianzas originales se recuperan mediante \(V=e^{\eta_V}\) y \(W=e^{\eta_W}\).

Definamos

\[ \ell(\boldsymbol\eta) = \log p(\boldsymbol\eta\mid y_{1:T}), \]

omitiendo las constantes que no dependen de \(\boldsymbol\eta\). La expresión de \(\ell(\boldsymbol\eta)\) está dada por Ecuación 13.25, que incluye los jacobianos de la transformación logarítmica.

Paso 1. Aproximación local de la distribución posterior.

En primer lugar, calculamos numéricamente la moda de la distribución posterior en las coordenadas transformadas:

\[ \widehat{\boldsymbol\eta} = \underset{\boldsymbol\eta\in\mathbb R^2}{\arg\max} \;\ell(\boldsymbol\eta). \]

Alrededor de esta moda, una expansión de Taylor de segundo orden proporciona la aproximación

\[ \ell(\boldsymbol\eta) \approx \ell(\widehat{\boldsymbol\eta}) -\frac12 (\boldsymbol\eta-\widehat{\boldsymbol\eta})^\top \boldsymbol H (\boldsymbol\eta-\widehat{\boldsymbol\eta}), \]

donde

\[ \boxed{ \boldsymbol H = -\left. \frac{\partial^2\ell(\boldsymbol\eta)} {\partial\boldsymbol\eta\, \partial\boldsymbol\eta^\top} \right|_{\boldsymbol\eta=\widehat{\boldsymbol\eta}} } \tag{13.26}\]

es la matriz hessiana negativa de la log-posterior, evaluada en la moda.

En nuestro problema, \(\boldsymbol H\) es una matriz de dimensión \(2\times2\):

\[ \boldsymbol H= \begin{pmatrix} H_{VV} & H_{VW}\\ H_{WV} & H_{WW} \end{pmatrix}. \]

Los elementos diagonales describen la curvatura local de la log-posterior en las direcciones de \(\log V\) y \(\log W\). Los elementos fuera de la diagonal describen la interacción entre ambas direcciones.

Si \(\boldsymbol H\) es definida positiva, la aproximación cuadrática anterior corresponde al núcleo de una distribución normal bivariada:

\[ \boldsymbol\eta\mid y_{1:T} \;\dot{\sim}\; N_2\left( \widehat{\boldsymbol\eta}, \boldsymbol H^{-1} \right). \]

El símbolo \(\dot{\sim}\) indica que se trata de una aproximación local y no de una igualdad distribucional exacta.

La matriz \(\boldsymbol H^{-1}\) aproxima la dispersión posterior alrededor de la moda. En particular, sus elementos fuera de la diagonal permiten representar la asociación local entre \(\log V\) y \(\log W\).

Esta asociación es relevante porque distintas combinaciones de varianza de observación y varianza de evolución pueden explicar patrones similares de variabilidad en una serie temporal.

Paso 2. Construcción de una propuesta Student-\(t\) bivariada.

Aunque podríamos utilizar directamente la aproximación normal anterior como distribución de propuesta, preferimos una distribución Student-\(t\) multivariada, que tiene colas más pesadas y permite explorar con mayor frecuencia regiones alejadas de la moda.

Definimos

\[ \boxed{ q(\boldsymbol\eta) = t_\nu\left( \widehat{\boldsymbol\eta}, \boldsymbol S \right), } \tag{13.27}\]

donde \(\nu\) representa los grados de libertad y

\[ \boldsymbol S=\kappa^2\boldsymbol H^{-1}, \qquad \kappa>0, \]

es la matriz de escala de la propuesta.

El parámetro \(\kappa\) permite aumentar o disminuir la dispersión de la propuesta respecto de la aproximación local normal.

En la implementación computacional del capítulo utilizamos

\[ \nu=6,\qquad \kappa=1.3. \]

Por tanto, la matriz de escala se construye como

\[ \boldsymbol S=1.3^2\boldsymbol H^{-1}. \]

Es importante recordar que, para una distribución Student-\(t\) multivariada con \(\nu>2\), la matriz de covarianza es

\[ \operatorname{Var}_q(\boldsymbol\eta) = \frac{\nu}{\nu-2}\boldsymbol S. \]

En consecuencia, \(\boldsymbol S\) no coincide directamente con la matriz de covarianza de la propuesta.

La densidad Student-\(t\) bivariada es proporcional a

\[ q(\boldsymbol\eta) \propto \left[ 1+\frac{1}{\nu} (\boldsymbol\eta-\widehat{\boldsymbol\eta})^\top \boldsymbol S^{-1} (\boldsymbol\eta-\widehat{\boldsymbol\eta}) \right]^{-(\nu+2)/2}. \]

La forma cuadrática de esta expresión incorpora la asociación entre las dos componentes del vector de parámetros.

Además, las colas más pesadas de la distribución Student-\(t\) pueden mejorar la cobertura de regiones posteriores donde la aproximación normal local resulta poco precisa.

La matriz hessiana se utiliza solamente para construir una propuesta razonable. No estamos sustituyendo la posterior verdadera por una aproximación normal o Student-\(t\): el paso Metropolis–Hastings corrige la diferencia entre la propuesta y la distribución objetivo.

Paso 3. Generación de candidatos y probabilidad de aceptación.

Supongamos que el valor actual de la cadena es \(\boldsymbol\eta^{(s-1)}\).

Generamos un nuevo candidato desde

\[ \boldsymbol\eta^\star\sim q(\boldsymbol\eta). \]

Una característica fundamental es que esta propuesta es independiente: su distribución no depende del valor actual \(\boldsymbol\eta^{(s-1)}\).

Esto la distingue de una propuesta de caminata aleatoria, como

\[ \boldsymbol\eta^\star = \boldsymbol\eta^{(s-1)}+\boldsymbol\varepsilon, \]

en la que la distribución del candidato está centrada en el valor actual de la cadena.

En nuestro caso, todos los candidatos se generan desde la misma distribución Student-\(t\) centrada en \(\widehat{\boldsymbol\eta}\).

El candidato se acepta con probabilidad

\[ \boxed{ \alpha\left( \boldsymbol\eta^{(s-1)},\boldsymbol\eta^\star \right) = \min\left\{ 1,\, \frac{ p(\boldsymbol\eta^\star\mid y_{1:T}) q(\boldsymbol\eta^{(s-1)}) }{ p(\boldsymbol\eta^{(s-1)}\mid y_{1:T}) q(\boldsymbol\eta^\star) } \right\}. } \tag{13.28}\]

Esta expresión corresponde a la regla de Metropolis–Hastings para una propuesta independiente.

Obsérvese que aparece el cociente

\[ \frac{ q(\boldsymbol\eta^{(s-1)}) }{ q(\boldsymbol\eta^\star) }. \]

Este término es necesario porque, aunque la propuesta no depende del estado actual, no es simétrica en el sentido requerido para cancelar las densidades de propuesta.

En particular, la probabilidad de proponer \(\boldsymbol\eta^\star\) desde \(\boldsymbol\eta^{(s-1)}\) es \(q(\boldsymbol\eta^\star)\), mientras que la probabilidad de proponer el movimiento inverso es \(q(\boldsymbol\eta^{(s-1)})\).

Para mejorar la estabilidad numérica, trabajamos con logaritmos. Definimos

\[ \begin{aligned} r_s={}& \ell(\boldsymbol\eta^\star) -\ell(\boldsymbol\eta^{(s-1)})\\ &+\log q(\boldsymbol\eta^{(s-1)}) -\log q(\boldsymbol\eta^\star). \end{aligned} \]

Entonces,

\[ \alpha_s=\min\{1,\exp(r_s)\}. \]

Si generamos \(U_s\sim U(0,1)\), aceptamos el candidato cuando

\[ \log U_s<r_s. \]

En caso contrario, la cadena conserva el valor anterior:

\[ \boldsymbol\eta^{(s)} = \boldsymbol\eta^{(s-1)}. \]

La evaluación de \(\ell(\boldsymbol\eta^\star)\) requiere ejecutar el filtro de Kalman con \(V=e^{\eta_V^\star}\) y \(W=e^{\eta_W^\star}\) para calcular la verosimilitud marginal correspondiente.

13.7.5.2 Reconstrucción de las trayectorias latentes mediante FFBS

Una vez generada una muestra posterior de \(\boldsymbol\eta\), recuperamos las varianzas originales:

\[ V^{(s)}=\exp(\eta_V^{(s)}), \qquad W^{(s)}=\exp(\eta_W^{(s)}). \]

Sin embargo, hasta este momento solamente hemos generado muestras de la distribución marginal

\[ p(V,W\mid y_{1:T}). \]

Para realizar inferencia sobre los estados latentes, necesitamos reconstruir una trayectoria compatible con cada pareja de varianzas.

La factorización posterior relevante es

\[ \boxed{ \begin{aligned} &p(x_{0:T},V,W\mid y_{1:T})\\ &\qquad= p(x_{0:T}\mid V,W,y_{1:T}) p(V,W\mid y_{1:T}). \end{aligned} } \tag{13.29}\]

Esta identidad justifica el procedimiento de simulación en dos etapas:

  1. Generar \((V^{(s)},W^{(s)})\) de la posterior marginal mediante Metropolis–Hastings.
  2. Generar \(x_{0:T}^{(s)}\) de \(p(x_{0:T}\mid V^{(s)},W^{(s)},y_{1:T})\) mediante FFBS.

En la segunda etapa, volvemos a ejecutar el filtro de Kalman con las varianzas simuladas y utilizamos las distribuciones condicionales retrospectivas desarrolladas en Sección 13.6.

Específicamente, simulamos primero

\[ x_T^{(s)} \sim p(x_T\mid y_{1:T},V^{(s)},W^{(s)}). \]

Después, para \(t=T-1,\ldots,0\), generamos

\[ x_t^{(s)} \sim p(x_t\mid x_{t+1}^{(s)},y_{1:t}, V^{(s)},W^{(s)}). \]

De esta manera obtenemos una realización completa

\[ \left( V^{(s)},W^{(s)},x_{0:T}^{(s)} \right) \]

cuya distribución objetivo es la posterior conjunta de los parámetros y estados latentes.

Las muestras sucesivas pueden mantener dependencia de Markov, debido al paso Metropolis–Hastings; por eso siguen siendo necesarios los diagnósticos MCMC.

13.7.5.3 Algoritmo: Metropolis–Hastings marginal con FFBS

Entradas:

  • Observaciones \(y_{1:T}\).
  • Distribución inicial \(x_0\sim N(m_0,C_0)\).
  • Prioris independientes \(V\sim\operatorname{IG}(a_V,b_V)\) y \(W\sim\operatorname{IG}(a_W,b_W)\).
  • Número de iteraciones \(M\), calentamiento \(B\) y frecuencia de conservación de muestras.
  • Grados de libertad \(\nu\) y factor de dispersión \(\kappa\) de la propuesta.

Preparación:

  1. Definir \(\ell(\boldsymbol\eta)\) mediante Ecuación 13.25, utilizando la verosimilitud calculada por el filtro de Kalman.

  2. Encontrar numéricamente la moda \(\widehat{\boldsymbol\eta}\) y calcular la matriz hessiana negativa \(\boldsymbol H\) en ese punto.

  3. Construir la distribución de propuesta independiente

    \[ q(\boldsymbol\eta)= t_\nu\left( \widehat{\boldsymbol\eta}, \kappa^2\boldsymbol H^{-1} \right). \]

    Si la hessiana estimada presenta problemas numéricos, regularizar sus autovalores para obtener una matriz de escala definida positiva.

  4. Inicializar la cadena, por ejemplo, en

    \[ \boldsymbol\eta^{(0)} =\widehat{\boldsymbol\eta}. \]

Iteraciones MCMC:

Para \(s=1,\ldots,M\):

  1. Generar un candidato independiente

    \[ \boldsymbol\eta^\star\sim q(\boldsymbol\eta). \]

  2. Calcular \(\ell(\boldsymbol\eta^\star)\) mediante el filtro de Kalman.

  3. Evaluar la probabilidad de aceptación \(\alpha_s\) utilizando Ecuación 13.28.

  4. Generar \(U_s\sim U(0,1)\) y actualizar

    \[ \boldsymbol\eta^{(s)} = \begin{cases} \boldsymbol\eta^\star, &U_s<\alpha_s,\\ \boldsymbol\eta^{(s-1)}, &U_s\geq\alpha_s. \end{cases} \]

  5. Si la iteración corresponde a una muestra que debe conservarse, transformar

    \[ V^{(s)}=e^{\eta_V^{(s)}}, \qquad W^{(s)}=e^{\eta_W^{(s)}}. \]

  6. Condicionalmente en \((V^{(s)},W^{(s)})\), ejecutar FFBS para generar una trayectoria conjunta \(x_{0:T}^{(s)}\), si se requieren estados completos.

  7. Guardar las cantidades de interés, como \(V^{(s)}\), \(W^{(s)}\), \(W^{(s)}/V^{(s)}\), \(x_T^{(s)}\) y, cuando corresponda, la trayectoria completa de estados.

Resultados:

Descartar las iteraciones de calentamiento y utilizar las muestras conservadas para estimar distribuciones posteriores, intervalos creíbles y distribuciones predictivas.

Se recomienda ejecutar varias cadenas con semillas diferentes y evaluar convergencia y eficiencia mediante trazas, \(\widehat R\), ESS y tasas de aceptación.

Diferencia respecto del algoritmo de Gibbs.

En Gibbs, los parámetros se actualizan condicionalmente en la trayectoria latente generada durante la misma iteración. Por tanto, la actualización de \(W\) utiliza explícitamente los incrementos de esa trayectoria.

En el método marginal, la actualización de \((V,W)\) utiliza la verosimilitud después de integrar los estados. La trayectoria latente se genera solamente después de obtener una muestra de los parámetros, por lo que no condiciona la siguiente transición Metropolis–Hastings.

Este cambio puede reducir la autocorrelación de la cadena de parámetros, aunque requiere evaluar el filtro de Kalman para cada candidato.

La mejora en eficiencia no está garantizada: depende de qué tan bien la propuesta Student-\(t\) aproxime la posterior marginal. Por ello, además del ESS, conviene comparar el ESS por unidad de tiempo computacional.

La función mcmc_marginal_ffbs_bdlm() implementa este algoritmo. En particular, cuando solamente se necesita \(x_T\) para construir pronósticos, la implementación simula directamente de su distribución filtrada, evitando el costo de generar los estados intermedios.

Esta estrategia se basa en la verosimilitud marginal de Kalman y en los principios generales de Metropolis–Hastings y simulación retrospectiva (Petris et al. 2009, secs. 4.1 y 4.4; Prado et al. 2021, sec. 4.5).
13.7.6 Aplicación: posterior de las varianzas del Nilo

Para mantener continuidad con la semana 12 especificamos

\[ \begin{aligned} x_0&\sim N(900,200^2),\\ V&\sim \operatorname{IG}(2.5,1.5\times130^2),\\ W&\sim \operatorname{IG}(2.5,1.5\times40^2). \end{aligned} \tag{13.30}\]

Las medias previas de las varianzas son, respectivamente, \(130^2\) y \(40^2\). Son escalas plausibles para explorar el método, no inferencias anteriores basadas en los veinte años reservados como prueba. Las prioris inversa-gamma tienen colas largas; especificar solamente su media no describe por completo su concentración. Más adelante estudiaremos su sensibilidad.

priori_V_bdlm <- list(a = 2.5, b = 1.5 * 130^2)
priori_W_bdlm <- list(a = 2.5, b = 1.5 * 40^2)

# Algoritmo marginal MH + FFBS: 1000 muestras guardadas por cadena.
cadenas_bdlm <- purrr::map(seq_len(3L), function(k) {
  mcmc_marginal_ffbs_bdlm(
    y_train_bdlm,
    n_iter = 1500L, burn = 500L, thin = 1L,
    priori_V = priori_V_bdlm, priori_W = priori_W_bdlm,
    semilla = 1300L + k,
    guardar_trayectorias = TRUE
  )
})

mcmc_nilo_bdlm <- purrr::map2_dfr(
  cadenas_bdlm, seq_along(cadenas_bdlm),
  ~mutate(.x$muestras, cadena = .y)
)
stopifnot(nrow(mcmc_nilo_bdlm) == 3000L,
          n_distinct(mcmc_nilo_bdlm$cadena) == 3L,
          all(mcmc_nilo_bdlm$V > 0), all(mcmc_nilo_bdlm$W > 0))
ajuste_mv_train_bdlm <- ajustar_mv_nivel_bdlm(y_train_bdlm)
resumen_param_bdlm <- mcmc_nilo_bdlm |>
  summarise(across(c(V, W, razon),
                   list(media = mean,
                        mediana = median,
                        li95 = ~unname(quantile(.x, .025)),
                        ls95 = ~unname(quantile(.x, .975))))) |>
  pivot_longer(everything(), names_to = c("parametro", ".value"),
               names_pattern = "^(V|W|razon)_(media|mediana|li95|ls95)$") |>
  mutate(MV = case_when(
    parametro == "V" ~ ajuste_mv_train_bdlm$V,
    parametro == "W" ~ ajuste_mv_train_bdlm$W,
    TRUE ~ ajuste_mv_train_bdlm$W / ajuste_mv_train_bdlm$V
  ))
knitr::kable(resumen_param_bdlm, digits = 3)
Tabla 13.2: Resumen posterior de las varianzas y de la razón señal-ruido para el modelo de nivel local, usando únicamente los años 1871–1950.
parametro media mediana li95 ls95 MV
V 16175.677 15918.167 11078.008 23022.870 15906.198
W 1526.715 1269.130 469.923 4183.751 1584.741
razon 0.103 0.078 0.024 0.333 0.100

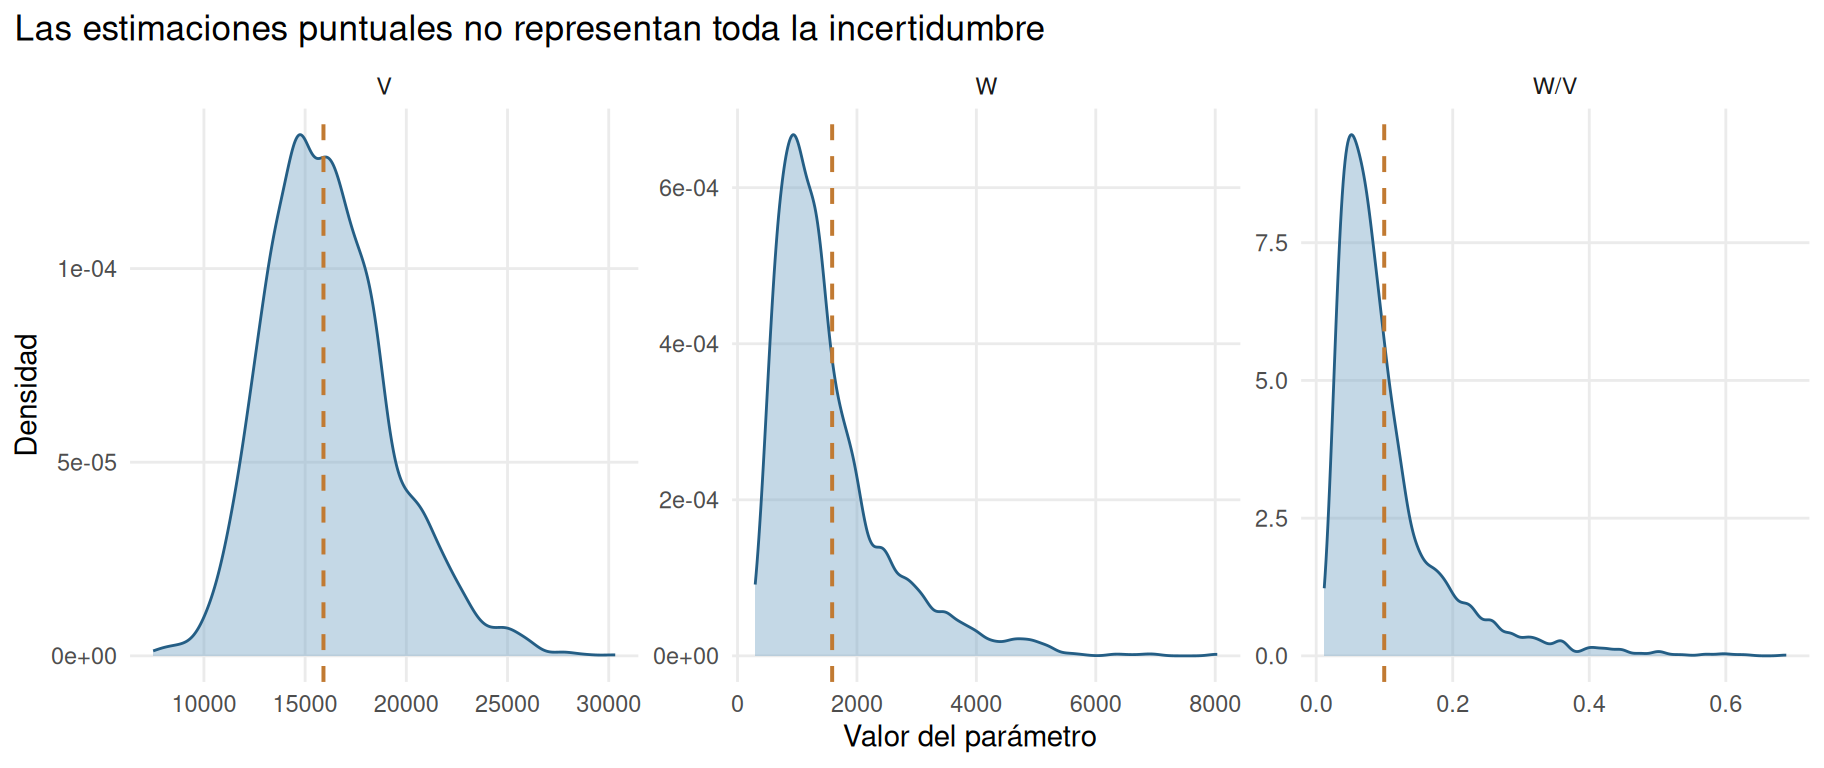
Una estimación MV y una media posterior son objetos inferenciales diferentes; no deben coincidir necesariamente. Además, \(V\) y \(W\) pueden estar correlacionadas en la posterior, aunque hayan recibido prioris independientes. El cociente \(W/V\) permite examinar cuánta variación se atribuye a la evolución latente frente al ruido de medida.

referencia_mv_bdlm <- tibble(
  parametro = c("V", "W", "W/V"),
  mv = c(ajuste_mv_train_bdlm$V, ajuste_mv_train_bdlm$W,
         ajuste_mv_train_bdlm$W / ajuste_mv_train_bdlm$V)
)

densidades_param_bdlm <- mcmc_nilo_bdlm |>
  transmute(V, W, `W/V` = razon) |>
  pivot_longer(everything(), names_to = "parametro", values_to = "valor")

ggplot(densidades_param_bdlm, aes(valor)) +
  geom_density(fill = "#7DA9C7", alpha = .45, colour = "#245E85") +
  geom_vline(data = referencia_mv_bdlm,
             aes(xintercept = mv), linewidth = .7,
             colour = "#C17A32", linetype = "dashed") +
  facet_wrap(~ parametro, scales = "free", nrow = 1L) +
  labs(x = "Valor del parámetro", y = "Densidad",
       title = "Las estimaciones puntuales no representan toda la incertidumbre") +
  tema_bdlm
Tres densidades posteriores con referencias verticales de máxima verosimilitud.
Figura 13.4: Distribuciones posteriores de V, W y W/V en el Nilo. Las líneas verticales representan las estimaciones de máxima verosimilitud como referencia, no como valores verdaderos.

13.7.7 Estados latentes integrando incertidumbre paramétrica

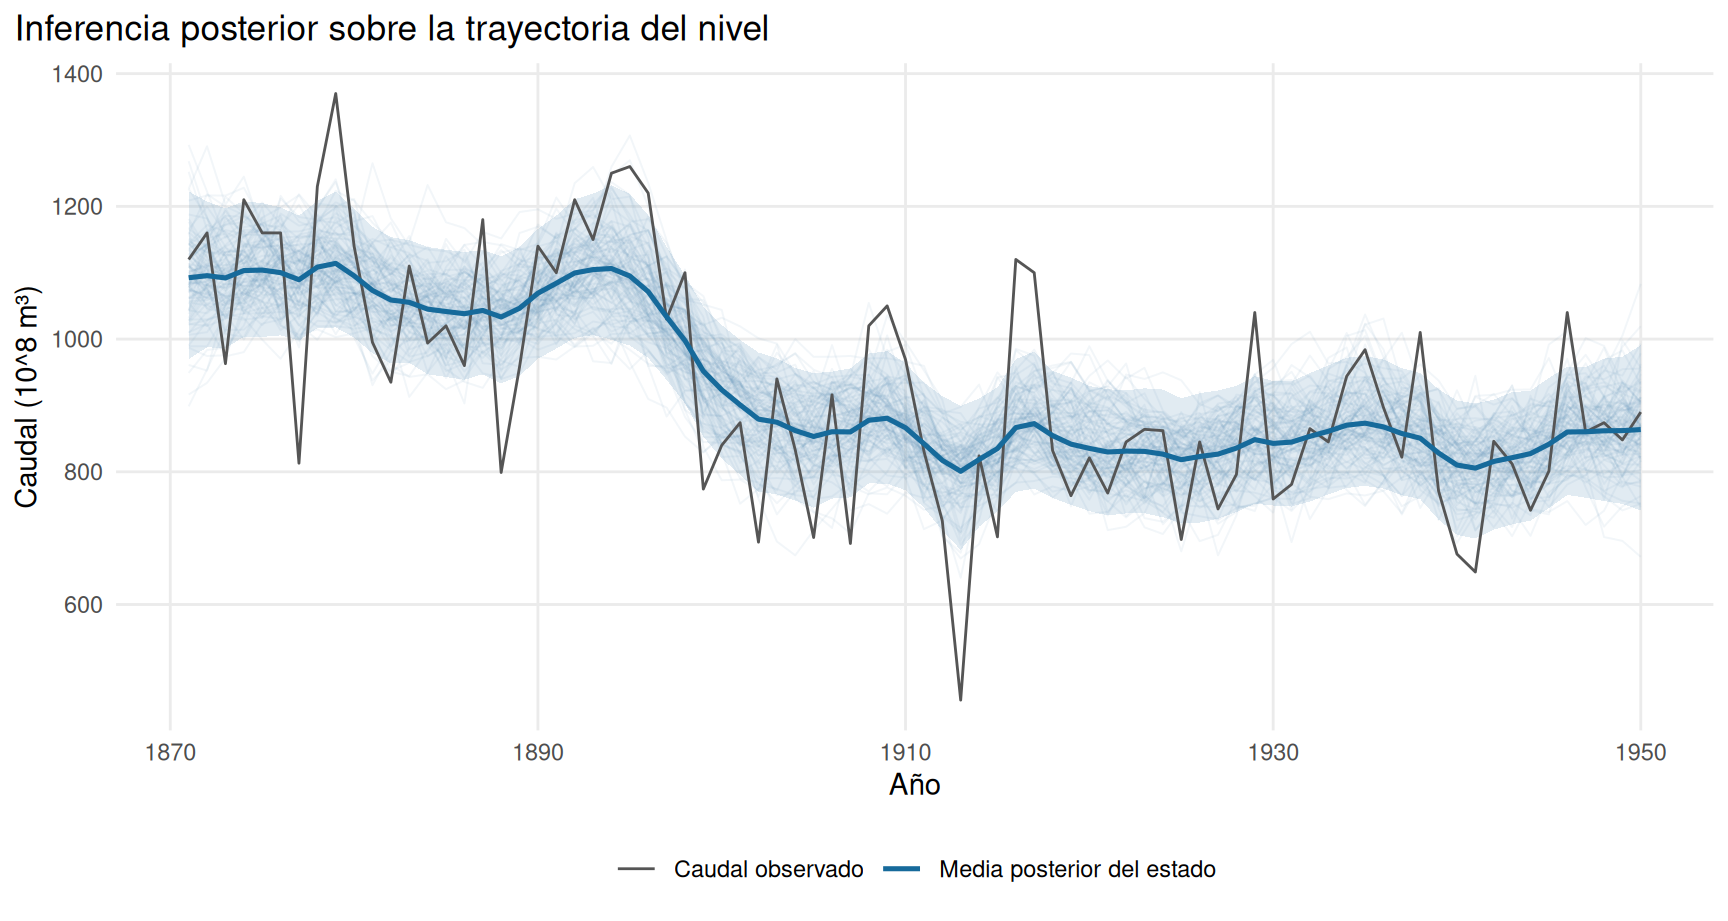
Las trayectorias guardadas tras el muestreo marginal de parámetros y FFBS constituyen muestras de la posterior marginal de los estados, una vez integrada aproximadamente la incertidumbre de \(V\) y \(W\). A diferencia de las trayectorias de Figura 13.3, estas incorporan ambas fuentes de incertidumbre, porque los parámetros cambian entre iteraciones y cada trayectoria se simula condicionalmente en los parámetros de su iteración. Para el resumen combinamos las tres cadenas y para el gráfico seleccionamos cien trayectorias representativas del conjunto simulado.

# Reunir los tres grupos de trayectorias para resumir la posterior.
estados_post_bdlm <- do.call(rbind, purrr::map(cadenas_bdlm, "trayectorias"))
stopifnot(nrow(estados_post_bdlm) == 3000L,
          ncol(estados_post_bdlm) == length(y_train_bdlm) + 1L)

resumen_estados_bdlm <- tibble(
  t = seq_along(y_train_bdlm),
  anio = nilo_bdlm$anio[1:80],
  observado = y_train_bdlm,
  media = colMeans(estados_post_bdlm[, -1L, drop = FALSE]),
  li95 = apply(estados_post_bdlm[, -1L, drop = FALSE], 2, quantile, probs = .025),
  ls95 = apply(estados_post_bdlm[, -1L, drop = FALSE], 2, quantile, probs = .975)
)

indices_tray_bdlm <- unique(round(seq(1, nrow(estados_post_bdlm), length.out = 100L)))
tray_nilo_matriz_bdlm <- t(estados_post_bdlm[indices_tray_bdlm, -1L, drop = FALSE])
colnames(tray_nilo_matriz_bdlm) <- paste0("rep_", seq_len(ncol(tray_nilo_matriz_bdlm)))
tray_nilo_bdlm <- as_tibble(tray_nilo_matriz_bdlm) |>
  mutate(anio = nilo_bdlm$anio[1:80]) |>
  pivot_longer(-anio, names_to = "trayectoria", values_to = "estado")
ggplot() +
  geom_ribbon(data = resumen_estados_bdlm,
              aes(anio, ymin = li95, ymax = ls95),
              fill = "#6D9DBF", alpha = .20) +
  geom_line(data = tray_nilo_bdlm,
            aes(anio, estado, group = trayectoria),
            colour = "#5792B4", alpha = .075, linewidth = .35) +
  geom_line(data = resumen_estados_bdlm,
            aes(anio, observado, colour = "Caudal observado"), linewidth = .50) +
  geom_line(data = resumen_estados_bdlm,
            aes(anio, media, colour = "Media posterior del estado"),
            linewidth = .9) +
  scale_colour_manual(values = c("Caudal observado" = "#555555",
                                 "Media posterior del estado" = "#166A9B")) +
  labs(x = "Año", y = "Caudal (10^8 m³)", colour = NULL,
       title = "Inferencia posterior sobre la trayectoria del nivel") +
  tema_bdlm
Caudal observado, trayectorias latentes, media y banda de incertidumbre de los estados del Nilo.
Figura 13.5: Estados latentes del Nilo: cien trayectorias posteriores del método marginal MH + FFBS, media y banda creíble marginal del 95 %. No se utilizan datos de 1951–1970.

13.8 Diagnóstico MCMC y sensibilidad a prioris

13.8.1 Diagnóstico de las cadenas

Antes de interpretar intervalos posteriores es necesario verificar si las simulaciones representan razonablemente la distribución objetivo. Utilizaremos tres cadenas, el estadístico \(\widehat R\), el tamaño efectivo de muestra (ESS), trazas y autocorrelación. Un \(\widehat R\) cercano a 1 es una condición diagnóstica útil, pero no garantiza por sí solo la exploración de regiones posteriores difíciles. Un ESS pequeño revela fuerte dependencia serial y reduce la precisión de las estimaciones Monte Carlo.

# Referencia pedagógica: mismo número de muestras guardadas que el
# MH marginal, pero con las condicionales completas originales de Gibbs.
cadenas_gibbs_ref_bdlm <- purrr::map(seq_len(3L), function(k) {
  gibbs_nivel_bdlm(
    y_train_bdlm,
    n_iter = 3200L, burn = 1200L, thin = 2L,
    priori_V = priori_V_bdlm, priori_W = priori_W_bdlm,
    semilla = 1300L + k,
    guardar_trayectorias = FALSE
  )
})
diagnosticar_cadenas_bdlm <- function(cadenas, metodo) {
  stopifnot(length(cadenas) == 3L)
  variables <- c("V", "W", "razon")
  n_post <- nrow(cadenas[[1L]]$muestras)
  stopifnot(all(purrr::map_int(cadenas, ~nrow(.x$muestras)) == n_post))
  arr <- array(
    NA_real_, dim = c(n_post, 3L, length(variables)),
    dimnames = list(NULL, NULL, c("V", "W", "W_sobre_V"))
  )
  for (k in seq_len(3L)) {
    arr[, k, ] <- as.matrix(cadenas[[k]]$muestras[, variables])
  }
  posterior::summarise_draws(
    posterior::as_draws_array(arr),
    mean, sd,
    rhat = posterior::rhat,
    ess_bulk = posterior::ess_bulk,
    ess_tail = posterior::ess_tail
  ) |>
    mutate(metodo = metodo,
           fraccion_ess = ess_bulk / (3 * n_post)) |>
    select(metodo, variable, mean, sd, rhat,
           ess_bulk, ess_tail, fraccion_ess)
}

diagnosticos_bdlm <- bind_rows(
  diagnosticar_cadenas_bdlm(cadenas_gibbs_ref_bdlm, "Gibbs + FFBS"),
  diagnosticar_cadenas_bdlm(cadenas_bdlm, "MH marginal + FFBS")
)
knitr::kable(diagnosticos_bdlm, digits = 3)
Tabla 13.3: Comparación de diagnósticos MCMC con tres cadenas y 1000 muestras guardadas por cadena: Gibbs y Metropolis–Hastings marginal con FFBS.
metodo variable mean sd rhat ess_bulk ess_tail fraccion_ess
Gibbs + FFBS V 16095.286 3241.470 1.001 902.142 1275.843 0.301
Gibbs + FFBS W 1588.961 1125.167 1.013 212.166 461.544 0.071
Gibbs + FFBS W_sobre_V 0.109 0.099 1.011 225.767 548.704 0.075
MH marginal + FFBS V 16175.677 3102.461 1.000 1591.694 1531.997 0.531
MH marginal + FFBS W 1526.715 967.267 1.002 1522.608 1582.834 0.508
MH marginal + FFBS W_sobre_V 0.103 0.082 1.002 1480.283 1577.780 0.493
trazas_param_bdlm <- mcmc_nilo_bdlm |>
  select(iteracion, cadena, V, W) |>
  pivot_longer(c(V, W), names_to = "parametro", values_to = "valor")

ggplot(trazas_param_bdlm,
       aes(iteracion, valor, colour = factor(cadena))) +
  geom_line(alpha = .7, linewidth = .35) +
  facet_wrap(~ parametro, scales = "free_y", ncol = 1L) +
  labs(x = "Iteración guardada", y = "Varianza",
       colour = "Cadena", title = "Diagnóstico de exploración de la posterior") +
  tema_bdlm
Paneles de trazas temporales para los parámetros V y W de tres cadenas.
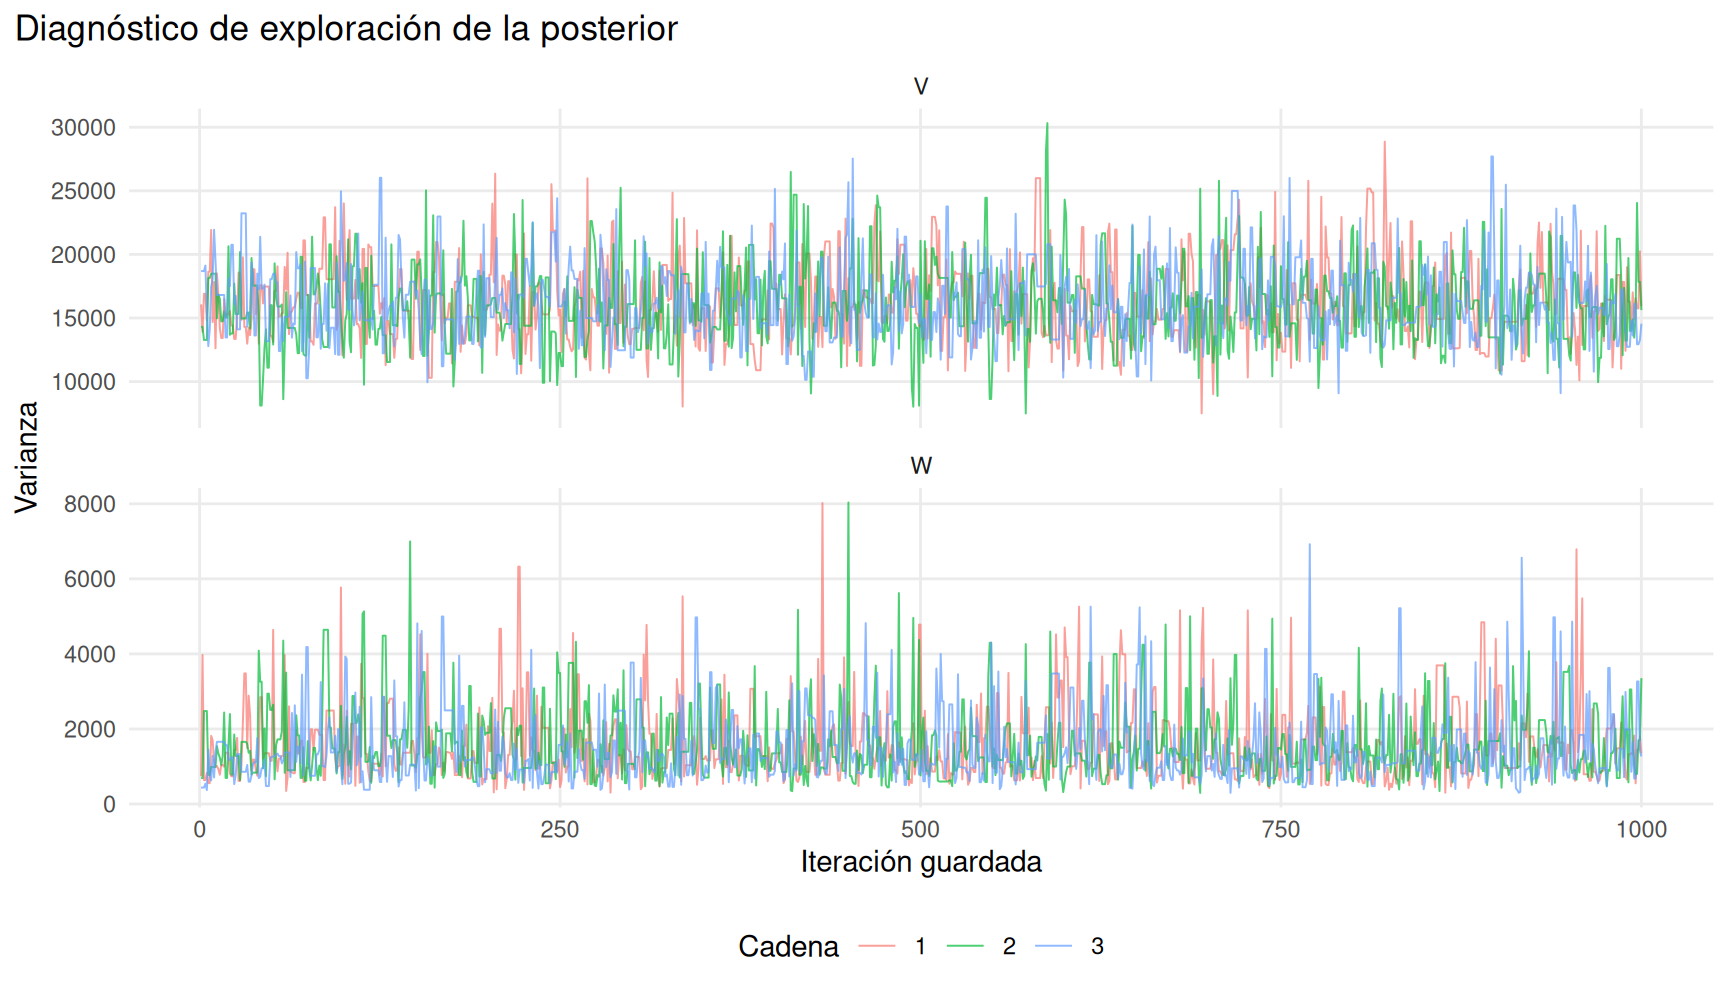
Figura 13.6: Trazas de las tres cadenas del método marginal MH + FFBS para las varianzas V y W. El diagnóstico debe combinar la exploración visual y las medidas numéricas.

En la tabla se compara la mezcla de dos procedimientos con igual número de muestras conservadas. La columna fraccion_ess facilita interpretar cuánto de ese tamaño nominal se traduce en información Monte Carlo. También conviene examinar las tasas de aceptación del algoritmo marginal (no aplicables al Gibbs puro):

knitr::kable(
  tibble(cadena = seq_along(cadenas_bdlm),
         aceptacion = purrr::map_dbl(cadenas_bdlm, "aceptacion")),
  digits = 3
)
Tabla 13.4: Tasa de aceptación de la propuesta Student-t independiente del método marginal MH + FFBS, por cadena.
cadena aceptacion
1 0.666
2 0.661
3 0.666

La posterior puede presentar una asociación importante entre \(V\) y \(W\): diferentes combinaciones de nivel suavizado y error de observación pueden explicar observaciones similares. En caso de mezcla deficiente habría que aumentar iteraciones, mejorar la parametrización, estudiar otra estrategia MCMC o revisar las prioris, antes de usar las inferencias como resultados definitivos. El adelgazamiento (thinning) no reemplaza un diagnóstico y no crea información adicional.

13.8.2 Sensibilidad a la priori de W

Estudiaremos tres prioris con la misma forma \(a_W=2.5\), pero distintas medias para \(W\):

\[ \mathbb E(W)\in\{10^2,40^2,120^2\}. \tag{13.31}\]

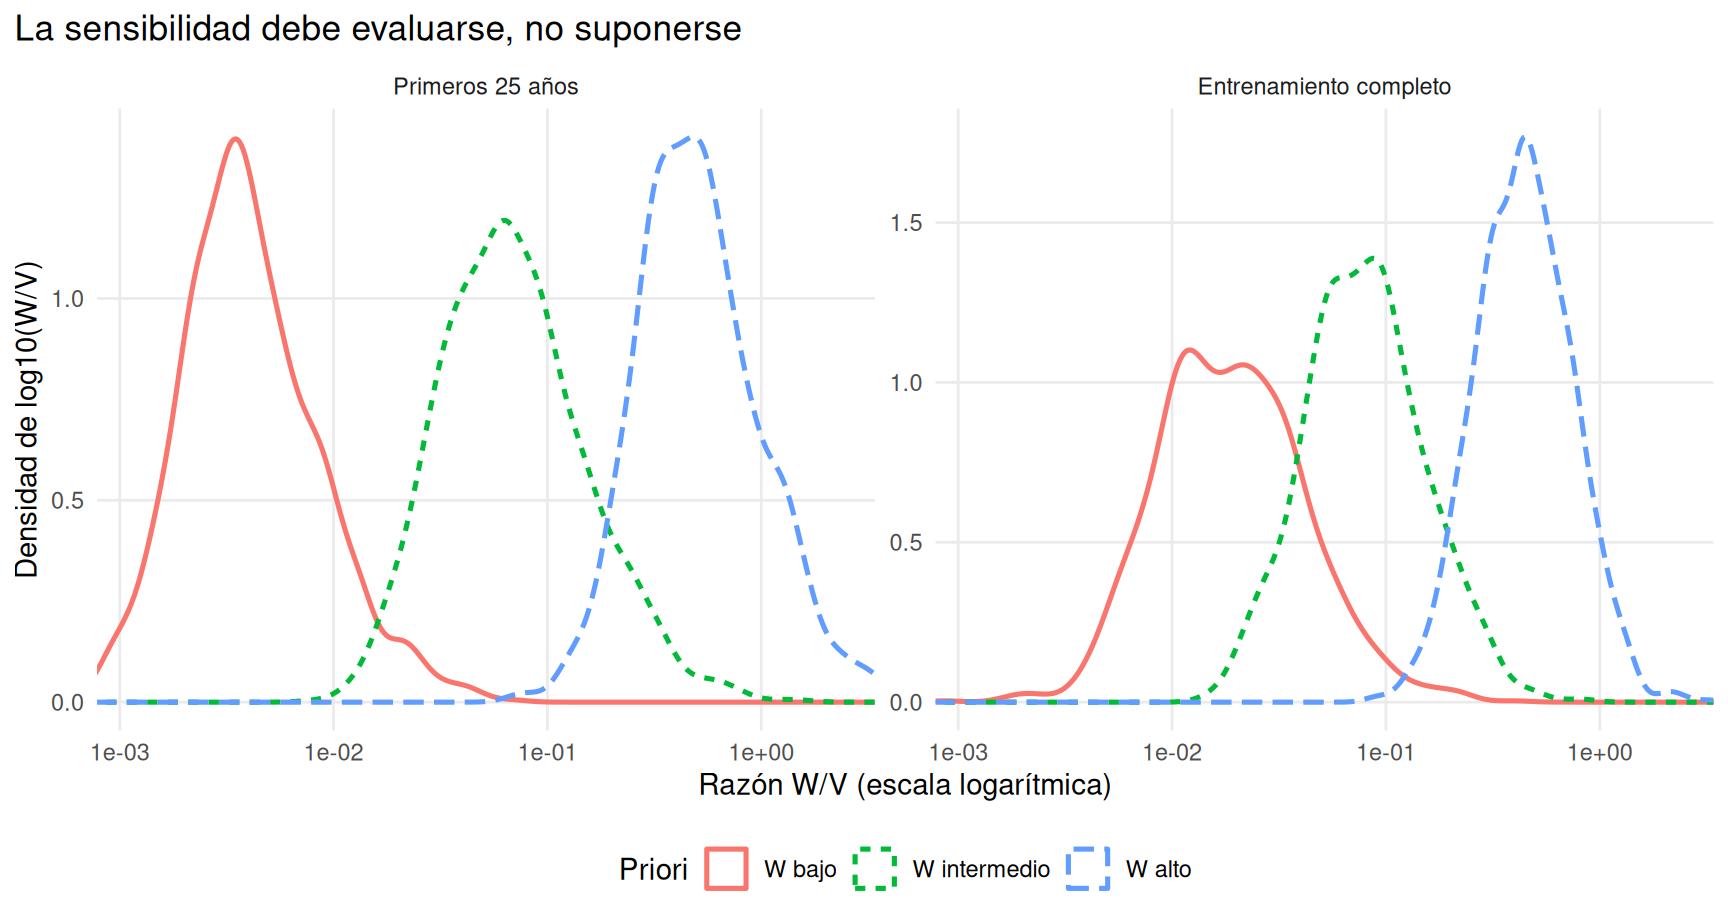
Mantendremos fija la priori para \(V\) y repetiremos el análisis usando (i) los primeros 25 años de la serie de entrenamiento, y (ii) los 80 años. Una muestra corta permite observar más claramente la contribución de la priori; una muestra larga puede reducirla, aunque no necesariamente en todos los parámetros de una estructura poco identificada.

escenarios_prior_bdlm <- tibble(
  escenario = c("W bajo", "W intermedio", "W alto"),
  media_previa_W = c(10^2, 40^2, 120^2)
)

a_sens_bdlm <- 2.5
sens_bdlm <- purrr::map_dfr(c(25L, 80L), function(n) {
  purrr::map2_dfr(seq_len(nrow(escenarios_prior_bdlm)),
                  escenarios_prior_bdlm$media_previa_W,
                  function(k, media_W) {
    mc <- mcmc_marginal_ffbs_bdlm(
      y_train_bdlm[seq_len(n)],
      n_iter = 1800L, burn = 500L, thin = 1L,
      priori_V = priori_V_bdlm,
      priori_W = list(a = a_sens_bdlm,
                      b = (a_sens_bdlm - 1) * media_W),
      semilla = 3000L + 10L * n + k
    )
    mc$muestras |>
      mutate(n = n, escenario = escenarios_prior_bdlm$escenario[k])
  })
})
# Transformamos para mostrar las diferencias próximas a cero sin
# distorsionar la comparación entre los escenarios de priori.
stopifnot(all(is.finite(sens_bdlm$razon)), all(sens_bdlm$razon > 0))
sens_graf_bdlm <- sens_bdlm |>
  mutate(
    log10_razon = log10(razon),
    escenario = factor(escenario,
                       levels = c("W bajo", "W intermedio", "W alto")),
    periodo = factor(n, levels = c(25L, 80L),
                     labels = c("Primeros 25 años", "Entrenamiento completo"))
  )

# El recorte es únicamente visual. Las densidades se estiman con todas
# las simulaciones; no se descartan muestras para el análisis estadístico.
limites_sens_bdlm <- unname(quantile(
  sens_graf_bdlm$log10_razon, probs = c(.005, .995)
))

ggplot(sens_graf_bdlm,
       aes(x = log10_razon, colour = escenario, linetype = escenario)) +
  geom_density(linewidth = .9, adjust = 1.05) +
  facet_wrap(~ periodo, scales = "free_y") +
  scale_x_continuous(
    labels = function(z) format(10^z, scientific = TRUE, digits = 1)
  ) +
  coord_cartesian(xlim = limites_sens_bdlm) +
  labs(x = "Razón W/V (escala logarítmica)",
       y = "Densidad de log10(W/V)",
       colour = "Priori", linetype = "Priori",
       title = "La sensibilidad debe evaluarse, no suponerse") +
  tema_bdlm
Densidades posteriores en escala logarítmica de W/V para tres prioris y dos tamaños de entrenamiento; las escalas verticales son independientes.
Figura 13.7: Sensibilidad de la posterior de W/V ante tres prioris de W, utilizando densidades de log10(W/V). Cada panel tiene su propia escala vertical; el eje horizontal muestra los valores originales de la razón.
tabla_sens_bdlm <- sens_bdlm |>
  group_by(n, escenario) |>
  summarise(mediana = median(razon),
            li95 = unname(quantile(razon, .025)),
            ls95 = unname(quantile(razon, .975)),
            .groups = "drop")
knitr::kable(tabla_sens_bdlm, digits = 4)
Tabla 13.5: Mediana e intervalo posterior del 95 % de W/V por escenario de priori y tamaño de muestra.
n escenario mediana li95 ls95
25 W alto 0.4926 0.1539 2.3478
25 W bajo 0.0038 0.0011 0.0222
25 W intermedio 0.0640 0.0176 0.3508
80 W alto 0.4418 0.1672 1.2163
80 W bajo 0.0184 0.0047 0.0958
80 W intermedio 0.0772 0.0234 0.2948

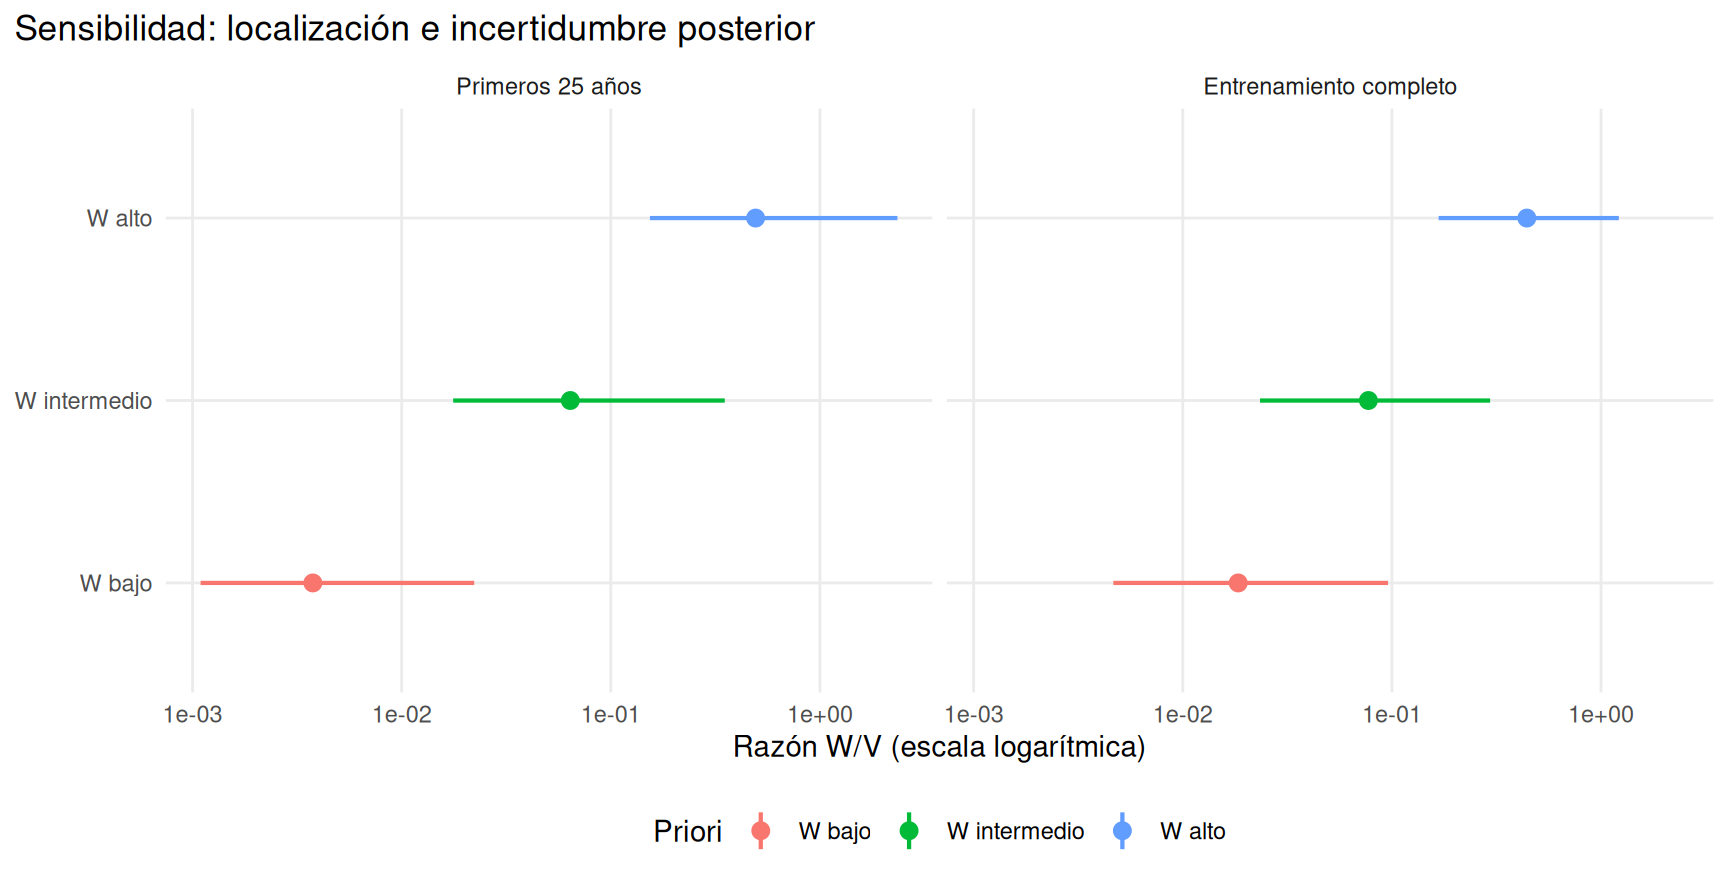
Las densidades de la figura anterior corresponden a \(\log_{10}(W/V)\), no a la razón en escala natural. El eje horizontal muestra únicamente el intervalo comprendido entre los percentiles 0.5 y 99.5 de las muestras (como límite visual); los cálculos y la tabla utilizan todas las muestras. Las escalas verticales difieren entre paneles, por lo que sus alturas no deben compararse directamente. Para contrastar las distribuciones de manera más cuantitativa, la siguiente figura muestra las medianas e intervalos creíbles posteriores del 95 % en la escala original de \(W/V\), con un eje logarítmico.

sens_intervalos_bdlm <- tabla_sens_bdlm |>
  mutate(
    escenario = factor(escenario,
                       levels = c("W bajo", "W intermedio", "W alto")),
    periodo = factor(n, levels = c(25L, 80L),
                     labels = c("Primeros 25 años", "Entrenamiento completo"))
  )
stopifnot(all(sens_intervalos_bdlm$li95 > 0))

ggplot(sens_intervalos_bdlm,
       aes(x = escenario, y = mediana, ymin = li95, ymax = ls95,
           colour = escenario)) +
  geom_pointrange(linewidth = .75) +
  facet_wrap(~ periodo) +
  scale_y_log10(labels = function(z) format(z, scientific = TRUE, digits = 2)) +
  coord_flip() +
  labs(x = NULL, y = "Razón W/V (escala logarítmica)",
       colour = "Priori",
       title = "Sensibilidad: localización e incertidumbre posterior") +
  tema_bdlm
Puntos y segmentos horizontales para las medianas e intervalos creíbles del 95 % de W sobre V, diferenciados por priori y número de observaciones.
Figura 13.8: Mediana e intervalos creíbles posteriores del 95 % de W/V según la priori para W y el tamaño de entrenamiento. El eje de la razón está en escala logarítmica.

Una diferencia visible entre prioris no implica que alguna sea incorrecta; indica que la evidencia disponible no elimina su influencia. Una diferencia pequeña tampoco certifica robustez universal: podría cambiar al modificar la parametrización, el estado inicial o la clase de modelo. La sensibilidad debe valorarse en parámetros y en cantidades predictivas.

13.9 Distribución predictiva posterior

13.9.1 Propagación de estados y observaciones

Para el nivel local con varianzas constantes y condicionando en una muestra posterior \((x_T^{(s)},V^{(s)},W^{(s)})\),

\[ \begin{aligned} x_{T+h}\mid x_T^{(s)},W^{(s)} &\sim N\bigl(x_T^{(s)},hW^{(s)}\bigr),\\ Y_{T+h}\mid x_T^{(s)},V^{(s)},W^{(s)} &\sim N\bigl(x_T^{(s)},hW^{(s)}+V^{(s)}\bigr). \end{aligned} \tag{13.32}\]

Podemos simular directamente la segunda distribución para cada muestra posterior. La distribución empírica de los \(Y_{T+h}^{(s)}\) aproxima

\[ p(y_{T+h}\mid y_{1:T}) =\iiint p(y_{T+h}\mid x_T,V,W) \,p(x_T,V,W\mid y_{1:T})\,dx_T\,dV\,dW. \tag{13.33}\]

En modelos generales habría que propagar las transiciones de estado sucesivas, incluida su dependencia entre horizontes, si se desean trayectorias futuras conjuntas. Para un marginal a un horizonte fijo basta la distribución de Ecuación 13.32.

13.9.2 Media y descomposición de varianza predictiva

Bajo momentos finitos, la ley de la varianza total establece:

\[ \begin{aligned} \mathbb E(Y_{T+h}\mid y_{1:T}) &=\mathbb E(x_T\mid y_{1:T}),\\ \operatorname{Var}(Y_{T+h}\mid y_{1:T}) &=\underbrace{\mathbb E(V+hW\mid y_{1:T})}_{\text{perturbaciones futuras}} +\underbrace{\operatorname{Var}(x_T\mid y_{1:T})}_{\text{incertidumbre del nivel actual}}. \end{aligned} \tag{13.34}\]

La incertidumbre paramétrica interviene en estas esperanzas posteriores y en la forma completa de la mezcla predictiva; en el nivel local sin deriva, la media condicional es \(x_T\) y no depende directamente de \(V\) o \(W\). En modelos más generales también puede aparecer una componente adicional de variación de la media condicional asociada a los parámetros. No debemos interpretar Ecuación 13.34 como una separación universal en tres sumandos independientes.

13.9.3 Pronóstico fijo del Nilo: 1951–1970

Construiremos pronósticos desde el último dato del entrenamiento, 1950, sin actualizar parámetros ni estados con valores de prueba. El método de MV sigue condicionando en \(\widehat V,\widehat W\); el método bayesiano integra sobre muestras de la posterior de parámetros obtenidas por MH marginal y de estados simuladas mediante FFBS.

set.seed(41320)
h_fijo_bdlm <- seq_len(20L)
pred_bayes_fijo_bdlm <- purrr::map_dfr(h_fijo_bdlm, function(h) {
  muestras <- simular_predictiva_mcmc_bdlm(mcmc_nilo_bdlm, h)
  cuant <- quantile(muestras, c(.025, .975), names = FALSE)
  tibble(h = h, media = mean(muestras),
         li95 = cuant[1], ls95 = cuant[2], metodo = "MH marginal–FFBS")
}) |>
  mutate(anio = 1950L + h)

kf_mv_bdlm <- ajuste_mv_train_bdlm$filtro
pred_mv_fijo_bdlm <- tibble(
  h = h_fijo_bdlm,
  anio = 1950L + h_fijo_bdlm,
  media = tail(kf_mv_bdlm$m, 1L),
  li95 = media - qnorm(.975) *
    sqrt(tail(kf_mv_bdlm$C, 1L) + h * ajuste_mv_train_bdlm$W +
           ajuste_mv_train_bdlm$V),
  ls95 = media + qnorm(.975) *
    sqrt(tail(kf_mv_bdlm$C, 1L) + h * ajuste_mv_train_bdlm$W +
           ajuste_mv_train_bdlm$V),
  metodo = "Nivel local MV"
)

stopifnot(nrow(pred_bayes_fijo_bdlm) == 20L,
          all(pred_bayes_fijo_bdlm$li95 < pred_bayes_fijo_bdlm$ls95))
ajuste_insample_bdlm <- tibble(
  anio = nilo_bdlm$anio[1:80],
  media = kf_mv_bdlm$f
)

ggplot() +
  annotate("rect", xmin = 1950.5, xmax = Inf,
           ymin = -Inf, ymax = Inf, fill = "grey70", alpha = .25) +
  geom_ribbon(data = pred_bayes_fijo_bdlm,
              aes(anio, ymin = li95, ymax = ls95),
              fill = "#4F93BF", alpha = .23) +
  geom_line(data = nilo_bdlm,
            aes(anio, caudal, colour = "Observado"), linewidth = .65) +
  geom_line(data = ajuste_insample_bdlm,
            aes(anio, media, colour = "Predicción 1 paso (entrenamiento)"),
            linewidth = .60) +
  geom_line(data = pred_mv_fijo_bdlm,
            aes(anio, media, colour = "Nivel local MV"),
            linewidth = .85, linetype = "dotdash") +
  geom_line(data = pred_bayes_fijo_bdlm,
            aes(anio, media, colour = "MH marginal–FFBS"),
            linewidth = .95, linetype = "dashed") +
  geom_vline(xintercept = 1950.5, linetype = "dashed") +
  coord_cartesian(xlim = c(1915, 1970)) +
  scale_colour_manual(values = c(
    "Observado" = "#202020",
    "Predicción 1 paso (entrenamiento)" = "#428066",
    "Nivel local MV" = "#B47B2B",
    "MH marginal–FFBS" = "#14689F")) +
  labs(x = "Año", y = "Caudal (10^8 m³)", colour = "Serie",
       title = "La incertidumbre predictiva debe evaluarse fuera del entrenamiento",
       subtitle = "Sombreado gris: prueba 1951–1970; la banda corresponde a MH marginal–FFBS") +
  tema_bdlm
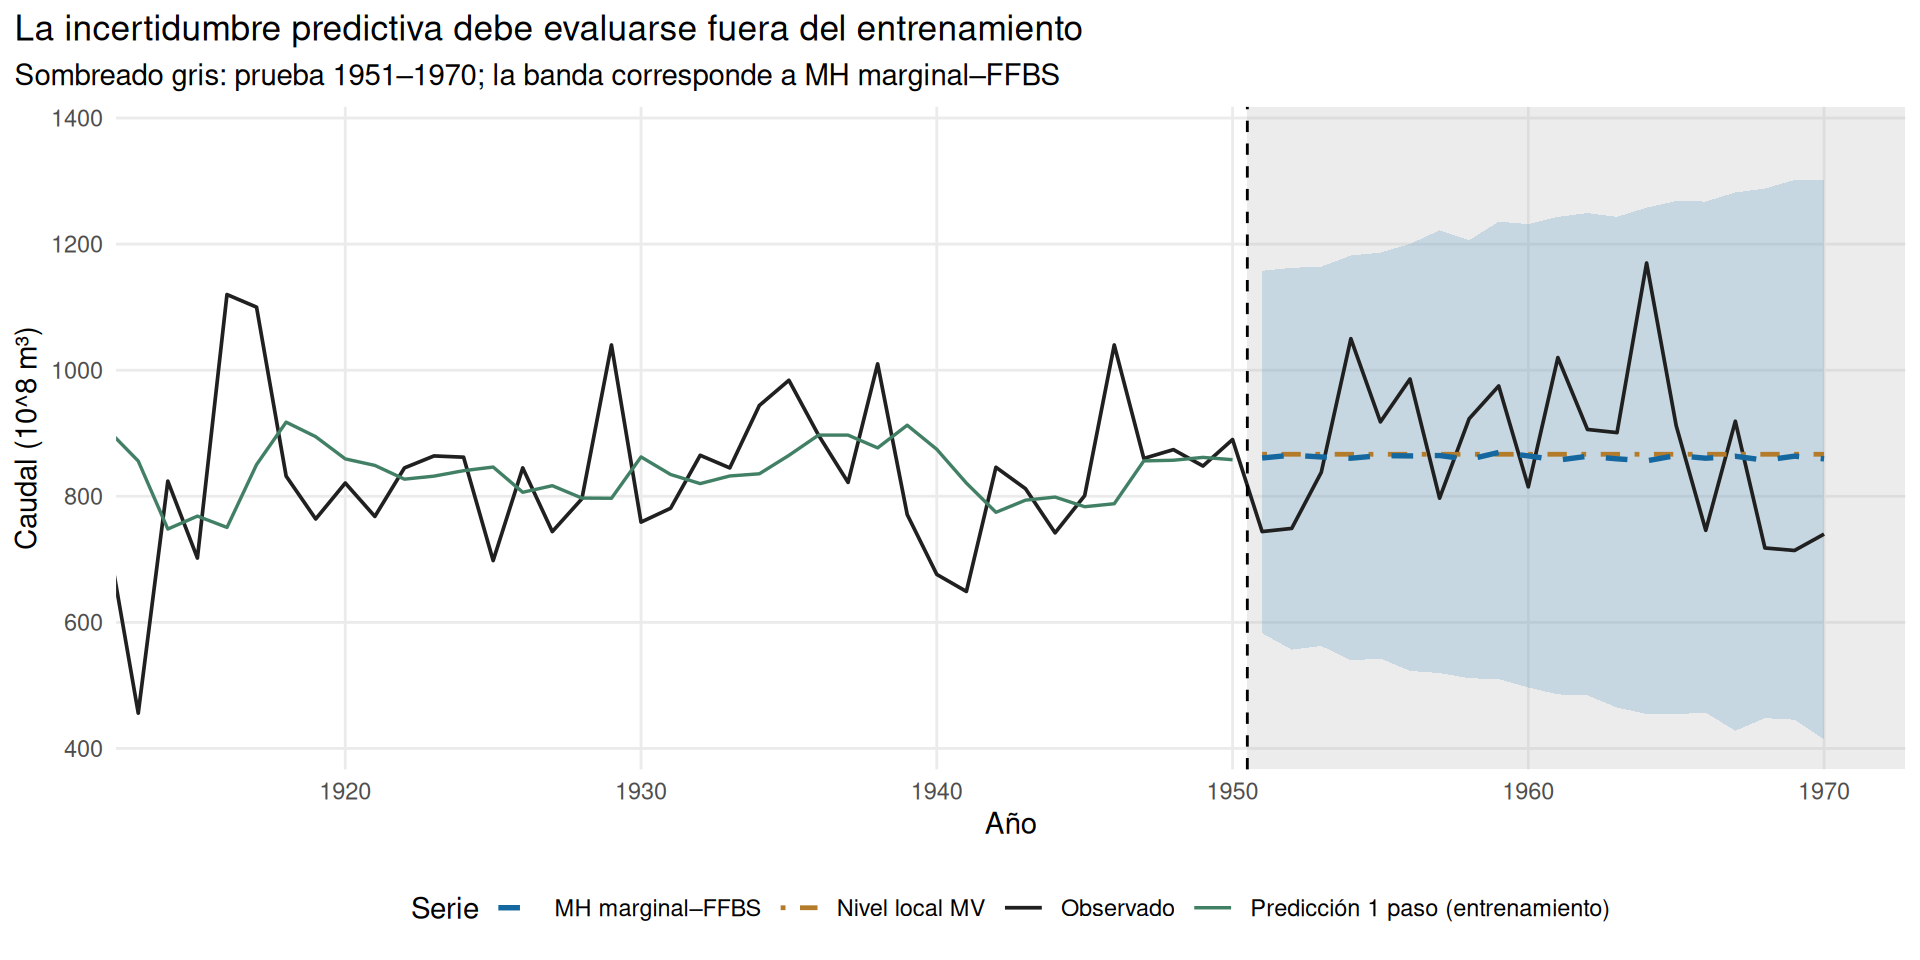
Serie del Nilo con predicción durante entrenamiento y dos pronósticos desde 1950; se distingue el período de prueba y la banda bayesiana.
Figura 13.9: Pronóstico desde 1950 sin actualizaciones posteriores: predicción de un paso en entrenamiento (verde), predicciones de origen fijo MV y MH marginal–FFBS, e intervalo predictivo posterior del 95 %. La prueba está sombreada.

Un buen ajuste dentro del entrenamiento no garantiza calidad predictiva. Además, el intervalo del 95 % dibujado para el enfoque bayesiano es un intervalo predictivo de observaciones, no una banda creíble para el estado latente. La comparación visual corresponde al origen fijo de 1950; para generalizar la conclusión es preferible emplear múltiples orígenes.

13.10 Aplicación y evaluación temporal fuera de muestra

13.10.1 Diseño común para los cuatro enfoques

Mantendremos el protocolo de Sección 12.12:

\[ \mathcal O=\{80,81,\ldots,95\},\qquad \mathcal H=\{1,3,5\}. \tag{13.35}\]

El origen \(o=80\) es 1950 y \(o=95\) es 1965. Cada candidato se ajustará usando solo \(y_{1:o}\). Se evaluará en el mismo año \(o+h\), para los mismos 16 orígenes por horizonte, comparando:

  • Naïve: \(\widehat y_{o+h\mid o}=y_o\); intervalo normal de referencia con varianza \(h\,\widehat\sigma^2_{\Delta,o}\), donde \(\widehat\sigma^2_{\Delta,o}=(o-1)^{-1}\sum_{t=2}^{o}(y_t-y_{t-1})^2\), estimada con los \(o-1\) incrementos disponibles en el origen.
  • Nivel local MV: \(V,W\) se reestiman por máxima verosimilitud para cada origen, y la normal predictiva las trata como fijas.
  • DLM conjugado con descuento: \(\delta=0.95\) se fija de antemano y se utiliza una distribución Student-t predictiva.
  • Nivel local MH marginal–FFBS: posterior de \((V,W,x_o)\) estimada en cada origen y predicciones de mezcla Monte Carlo.

La elección fija de \(\delta\) evita usar las fechas de prueba para seleccionar el descuento. La comparación no es un concurso universal de métodos: el modelo de descuento tiene covarianza de evolución adaptativa, mientras que el nivel local MV y el modelo bayesiano con MH marginal suponen \(W\) constante. Se comparan procedimientos de pronóstico completos, no únicamente formas distintas de estimar exactamente el mismo modelo.

Para MASE usamos, por origen,

\[ d_o=\frac{1}{o-1}\sum_{t=2}^{o}|y_t-y_{t-1}|, \qquad \mathrm{MASE}_h=\frac1{16} \sum_{o\in\mathcal O}\frac{|y_{o+h}-\widehat y_{o+h\mid o}|}{d_o}. \tag{13.36}\]

El denominador se calcula sin observaciones posteriores al origen y es común a todos los métodos evaluados en ese origen (Hyndman y Athanasopoulos 2021, sec. 5.8).

La evaluación bayesiana usa una sola cadena marginal MH por origen para mantener un costo razonable en clase; la inferencia sustantiva y el diagnóstico de convergencia se basan en el ajuste de tres cadenas de las secciones anteriores. Esta simplificación computacional de validación puede introducir error Monte Carlo y debe explicitarse cuando se interpreten diferencias pequeñas entre métodos.

origenes_bdlm <- 80:95
horizontes_bdlm <- c(1L, 3L, 5L)

evaluar_origen_bdlm <- function(o) {
  stopifnot(o >= 80L, o + max(horizontes_bdlm) <= nrow(nilo_bdlm))
  train <- nilo_bdlm$caudal[seq_len(o)]
  h <- horizontes_bdlm
  verdaderos <- nilo_bdlm$caudal[o + h]
  escala_mase <- mean(abs(diff(train)))
  stopifnot(escala_mase > 0)
  # Semilla independiente por origen, reproducible también en CRPS simulados.
  set.seed(41300L + o)

  # Referencia naïve gaussiana, con la misma convención de la semana 12.
  var_naive <- h * mean(diff(train)^2)
  pred_naive <- intervalo_normal_bdlm(
    rep(tail(train, 1L), length(h)), var_naive,
    h, "Naïve", verdaderos
  )

  # MV, con las mismas m0,C0 que en la semana 12.
  mv <- ajustar_mv_nivel_bdlm(train)
  media_mv <- rep(tail(mv$filtro$m, 1L), length(h))
  var_mv <- tail(mv$filtro$C, 1L) + h * mv$W + mv$V
  pred_mv <- intervalo_normal_bdlm(
    media_mv, var_mv, h, "Nivel local MV", verdaderos
  )

  # Conjugación normal-inversa-gamma con descuento fijado.
  desc <- filtrar_descuento_bdlm(train, delta = .95)
  pron_desc <- pronosticar_descuento_bdlm(desc, h)
  pred_desc <- purrr::map_dfr(seq_along(h), function(i) {
    muestras <- pron_desc$media[i] +
      pron_desc$escala[i] * rt(2000L, df = pron_desc$gl[i])
    tibble(
      h = h[i], modelo = "Descuento conjugado",
      media = pron_desc$media[i],
      li95 = pron_desc$li95[i], li80 = pron_desc$li80[i],
      ls80 = pron_desc$ls80[i], ls95 = pron_desc$ls95[i],
      crps = crps_muestras_bdlm(muestras, verdaderos[i])
    )
  })

  # Reajuste bayesiano marginal MH con una cadena por origen.
  mc <- mcmc_marginal_ffbs_bdlm(
    train, n_iter = 1400L, burn = 400L, thin = 1L,
    priori_V = priori_V_bdlm, priori_W = priori_W_bdlm,
    semilla = 42100L + o
  )
  pred_mc <- purrr::map_dfr(seq_along(h), function(i) {
    muestras <- simular_predictiva_mcmc_bdlm(mc$muestras, h[i])
    intervalo_empirico_bdlm(
      muestras, h[i], "Nivel local MH–FFBS", verdaderos[i]
    )
  })

  bind_rows(pred_naive, pred_mv, pred_desc, pred_mc) |>
    mutate(origen = o,
           anio_origen = nilo_bdlm$anio[o],
           anio_objetivo = nilo_bdlm$anio[o + h],
           observado = nilo_bdlm$caudal[o + h],
           escala_mase = escala_mase,
           error = observado - media,
           mase_individual = abs(error) / escala_mase,
           cubre80 = observado >= li80 & observado <= ls80,
           cubre95 = observado >= li95 & observado <= ls95,
           amplitud80 = ls80 - li80,
           amplitud95 = ls95 - li95,
           winkler95 = (ls95 - li95) +
             40 * (li95 - observado) * (observado < li95) +
             40 * (observado - ls95) * (observado > ls95))
}

cv_bdlm <- purrr::map_dfr(origenes_bdlm, evaluar_origen_bdlm)
stopifnot(nrow(cv_bdlm) == length(origenes_bdlm) *
            length(horizontes_bdlm) * 4L,
          all(cv_bdlm$li95 < cv_bdlm$ls95),
          all(is.finite(cv_bdlm$crps)),
          !anyNA(cv_bdlm),
          all(cv_bdlm$anio_objetivo > cv_bdlm$anio_origen))

Las puntuaciones basadas en la normal se calculan mediante una expresión cerrada. Para Student-t y las mezclas posteriores, se estima el CRPS por las simulaciones predictivas, aplicando

\[ \widehat{\mathrm{CRPS}}(F_B,y) =\frac1B\sum_{b=1}^B|z_b-y| -\frac{1}{2B^2}\sum_{b=1}^B\sum_{c=1}^B|z_b-z_c|, \tag{13.37}\]

con \(z_b\) realizaciones de la predictiva. El segundo término se evalúa en el código de forma eficiente ordenando las muestras; no se forma una matriz de \(B\times B\). El estimador corresponde exactamente al CRPS de la distribución empírica de las simulaciones y aproxima el CRPS de la predictiva a medida que \(B\) crece.

13.10.2 Evaluación puntual

tabla_cv_puntual_bdlm <- cv_bdlm |>
  group_by(h, modelo) |>
  summarise(
    n_origenes = n(),
    MAE = mean(abs(error)),
    RMSE = sqrt(mean(error^2)),
    MASE = mean(mase_individual),
    .groups = "drop"
  ) |>
  arrange(h, modelo)
knitr::kable(tabla_cv_puntual_bdlm, digits = 3)
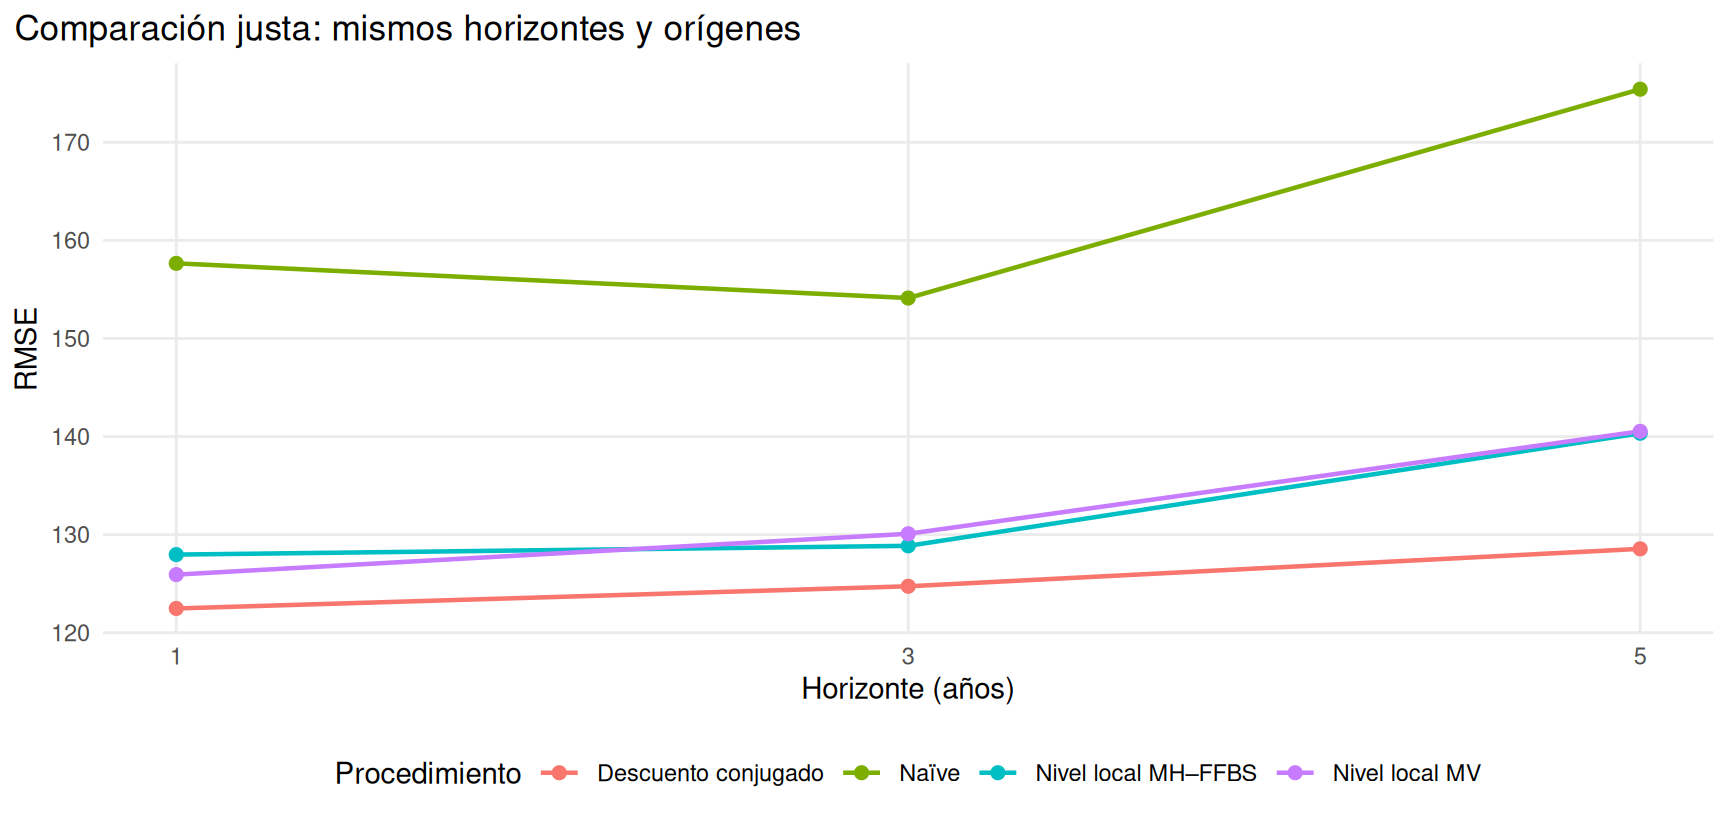
Tabla 13.6: Errores fuera de muestra por horizonte y modelo en los mismos 16 orígenes móviles (1950–1965).
h modelo n_origenes MAE RMSE MASE
1 Descuento conjugado 16 98.446 122.472 0.742
1 Naïve 16 137.250 157.655 1.035
1 Nivel local MH–FFBS 16 104.221 127.962 0.785
1 Nivel local MV 16 102.707 125.923 0.774
3 Descuento conjugado 16 99.559 124.733 0.749
3 Naïve 16 123.125 154.120 0.925
3 Nivel local MH–FFBS 16 102.434 128.855 0.770
3 Nivel local MV 16 101.868 130.085 0.766
5 Descuento conjugado 16 107.795 128.550 0.812
5 Naïve 16 133.500 175.414 1.004
5 Nivel local MH–FFBS 16 110.088 140.336 0.829
5 Nivel local MV 16 110.178 140.529 0.829
ggplot(tabla_cv_puntual_bdlm,
       aes(h, RMSE, colour = modelo, group = modelo)) +
  geom_line(linewidth = .8) +
  geom_point(size = 2) +
  scale_x_continuous(breaks = horizontes_bdlm) +
  labs(x = "Horizonte (años)", y = "RMSE", colour = "Procedimiento",
       title = "Comparación justa: mismos horizontes y orígenes") +
  tema_bdlm
Gráfico de RMSE por horizonte para naïve, nivel local MV, descuento conjugado y MH marginal con FFBS.
Figura 13.10: RMSE fuera de muestra por horizonte y procedimiento, calculado sobre los mismos 16 orígenes móviles.

13.10.3 Evaluación probabilística

tabla_cv_prob_bdlm <- cv_bdlm |>
  group_by(h, modelo) |>
  summarise(
    cobertura80 = mean(cubre80),
    amplitud80 = mean(amplitud80),
    cobertura95 = mean(cubre95),
    amplitud95 = mean(amplitud95),
    Winkler95 = mean(winkler95),
    CRPS = mean(crps),
    .groups = "drop"
  ) |>
  arrange(h, modelo)
knitr::kable(tabla_cv_prob_bdlm, digits = 3)
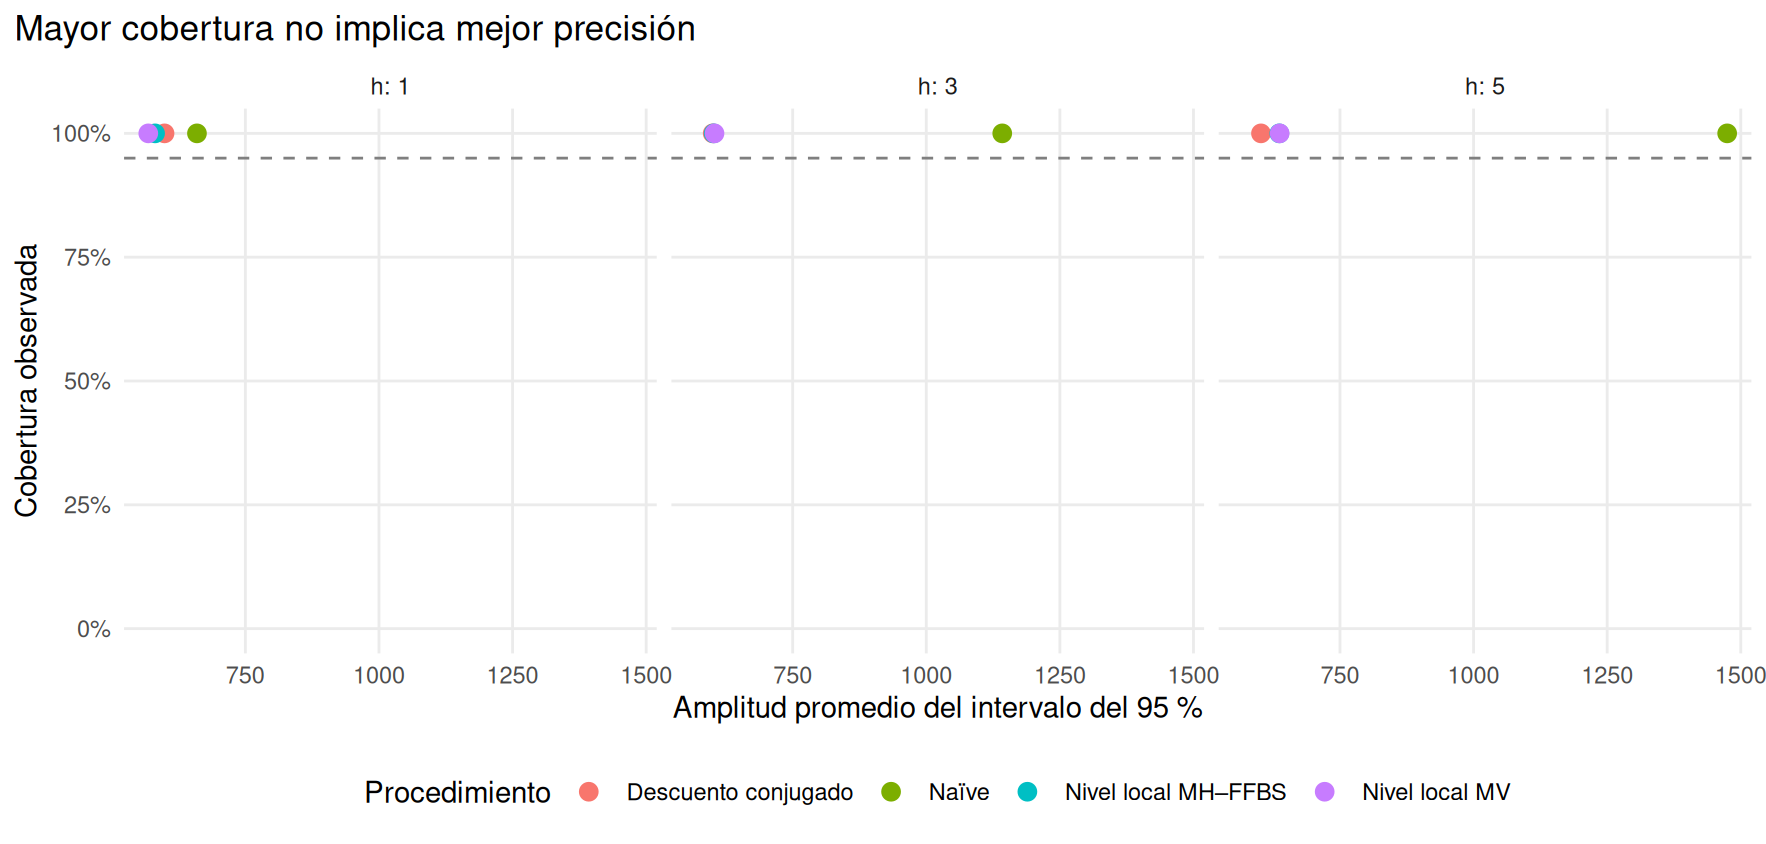
Tabla 13.7: Cobertura y amplitud de intervalos del 80 % y 95 %, puntuación de intervalo del 95 % y CRPS por horizonte.
h modelo cobertura80 amplitud80 cobertura95 amplitud95 Winkler95 CRPS
1 Descuento conjugado 0.875 389.171 1 598.739 598.739 70.170
1 Naïve 0.875 431.178 1 659.431 659.431 91.976
1 Nivel local MH–FFBS 0.812 376.840 1 581.051 581.051 73.240
1 Nivel local MV 0.812 371.612 1 568.332 568.332 71.998
3 Descuento conjugado 0.938 390.232 1 600.372 600.372 71.118
3 Naïve 1.000 746.823 1 1142.167 1142.167 98.928
3 Nivel local MH–FFBS 0.812 390.922 1 602.162 602.162 74.365
3 Nivel local MV 0.812 394.747 1 603.713 603.713 74.567
5 Descuento conjugado 0.938 391.404 1 602.176 602.176 73.895
5 Naïve 1.000 964.144 1 1474.532 1474.532 118.648
5 Nivel local MH–FFBS 0.812 416.920 1 636.504 636.504 79.861
5 Nivel local MV 0.812 416.594 1 637.125 637.125 80.810
ggplot(tabla_cv_prob_bdlm,
       aes(amplitud95, cobertura95, colour = modelo)) +
  geom_hline(yintercept = .95, colour = "grey50", linetype = "dashed") +
  geom_point(size = 2.8) +
  facet_wrap(~ h, labeller = label_both) +
  scale_y_continuous(limits = c(0, 1),
                     labels = function(z) paste0(round(100 * z), "%")) +
  labs(x = "Amplitud promedio del intervalo del 95 %",
       y = "Cobertura observada", colour = "Procedimiento",
       title = "Mayor cobertura no implica mejor precisión") +
  tema_bdlm
Gráfico de dispersión de cobertura y amplitud de los intervalos para cuatro procedimientos y tres horizontes.
Figura 13.11: Cobertura empírica frente a amplitud media de intervalos del 95 % en cada horizonte; la línea horizontal corresponde a la cobertura nominal.

La comparación debe leerse con cautela. Con 16 orígenes por horizonte, la cobertura cambia en saltos de \(1/16=6.25\) puntos porcentuales y los errores pueden estar correlacionados por el traslape de las ventanas. Además, el CRPS de los métodos simulados tiene error Monte Carlo adicional. No afirmaremos que una diferencia pequeña prueba superioridad estadística. Un estudio aplicado más amplio utilizaría más orígenes y análisis de sensibilidad a la cantidad de simulaciones.

13.11 Extensiones y conexiones

13.11.1 Descuento de varianzas e intervención

La varianza de observación puede evolucionar en el tiempo en lugar de permanecer como escala constante. Los esquemas beta-gamma de descuento permiten actualizar sucesivamente la incertidumbre sobre una precisión o escala; su construcción no equivale a la del modelo de volatilidad estocástica que estudiaremos en la semana 15. Asimismo, una intervención puede introducir un aumento puntual en la incertidumbre de evolución o alterar el estado, pero requiere una justificación sustantiva, no únicamente lograr un mejor ajuste (Prado et al. 2021, secs. 4.3.7–4.3.8; Petris et al. 2009, secs. 4.3.2–4.3.3).

13.11.2 Regresión dinámica y los capítulos siguientes

En la semana 14, \(\boldsymbol F_t\) dependerá de predictores observados o escenarios futuros, y \(\boldsymbol x_t\) podrá incluir coeficientes de regresión dinámicos. La misma arquitectura jerárquica permitirá formular prioris, simular estados y producir pronósticos condicionados en escenarios de covariables. Es esencial distinguir la incertidumbre sobre los coeficientes de la incertidumbre asociada a predictores futuros todavía desconocidos.

La semana 15 retomará el problema de varianzas cambiantes mediante un estado latente para la log-volatilidad; en ese caso, la ecuación de observación deja de ser lineal gaussiana condicionalmente en todos los estados y pueden requerirse otras aproximaciones computacionales (Prado et al. 2021, sec. 7.5; Shumway y Stoffer 2025, sec. 6.12).

13.12 Síntesis

  1. El filtro de Kalman ya es un procedimiento de actualización bayesiana condicional en parámetros conocidos. No es un competidor de la inferencia bayesiana.
  2. La inferencia completa debe considerar \(p(x_{0:T},\boldsymbol\psi\mid y_{1:T})\), no solamente \(p(x_{0:T}\mid y_{1:T},\widehat{\boldsymbol\psi})\).
  3. La conjugación normal–inversa-gamma exige una estructura específica de escala compartida. Dos varianzas desconocidas independientes no dan automáticamente la misma solución cerrada.
  4. RTS devuelve momentos suavizados marginales; FFBS genera trayectorias conjuntas. Por eso FFBS es adecuado para actualizar parámetros dependientes de incrementos latentes.
  5. El algoritmo de Gibbs combina FFBS con condicionales completas de parámetros. La alternativa marginal combina MH en escala logarítmica con FFBS y puede mejorar la mezcla. Ambos requieren diagnóstico de convergencia y sensibilidad.
  6. La distribución predictiva posterior integra incertidumbre sobre estados, parámetros y perturbaciones futuras. Su utilidad predictiva se juzga fuera de muestra usando los mismos orígenes y horizontes que los métodos de referencia.

13.13 Actividad computacional guiada

Realice las siguientes actividades a partir del código reproducible de este capítulo:

  1. Con datos simulados, aumente \(W/V\) manteniendo aproximadamente fija \(V\). Compare la anchura de las bandas RTS condicionadas en parámetros y la variabilidad entre trayectorias FFBS.
  2. Modifique las medias de las prioris de \(V\) y \(W\) y registre cómo cambian las posteriores de \(W/V\) y los intervalos predictivos a horizontes \(1,3,5\).
  3. Ejecute cuatro cadenas con inicializaciones suficientemente distintas; valore \(\widehat R\), ESS y las trazas. No concluya convergencia usando solamente una cadena.
  4. Cambie \(\delta\) entre \(0.90\), \(0.95\) y \(0.99\) sin observar el período de prueba al seleccionarlo. Compare la log-predictiva de entrenamiento secuencial y la evaluación fuera de muestra.
  5. Examine el compromiso entre cobertura, amplitud y CRPS. Identifique algún horizonte en el que los tres criterios no ordenen los procedimientos del mismo modo.

13.14 Ejercicios

Ejercicio 1 (posterior conjugada). Para Ecuación 13.7 con \(q\) conocido, derive explícitamente la densidad de \(\sigma^2\mid y_{1:T}\) a partir de Ecuación 13.10. Compruebe que la distribución predictiva posterior es Student-t y distinga su parámetro de escala de su desviación estándar.

Ejercicio 2 (descuento). Partiendo de \(\boldsymbol R_t=\boldsymbol G_t\boldsymbol C_{t-1}\boldsymbol G_t^\top+\boldsymbol W_t\), derive Ecuación 13.15. Discuta cuándo es inadecuado interpretar la matriz resultante como una varianza fija desconocida.

Ejercicio 3 (FFBS). Demuestre la identidad de covarianza Ecuación 13.17 y utilícela para obtener Ecuación 13.18. Explique por qué simular independientemente \(x_t\) desde sus distribuciones RTS no produce la distribución conjunta correcta.

Ejercicio 4 (condicionales de Gibbs). Usando prioris independientes como en Ecuación 13.20, derive las condicionales completas de \(V\) y \(W\). Explique por qué cambia la segunda condicional si se decide tratar \(x_0\) como fijo y conocido.

Ejercicio 5 (diagnóstico MCMC). Seleccione dos cadenas de simulación del nivel local y compare estimaciones de la razón \(W/V\). Examine autocorrelación, ESS y trazas. ¿Qué conclusiones estarían justificadas si las cadenas muestran ESS reducido y diferencias persistentes?

Ejercicio 6 (inferencia y predicción). Derive Ecuación 13.34. Proponga un ejemplo de modelo dinámico para el cual la incertidumbre sobre parámetros también modifique la media predictiva condicional y, por tanto, la descomposición de varianza.

Ejercicio 7 (evaluación temporal). Repita la comparación del Nilo con \(h\in\{1,2,4\}\), usando un conjunto común de orígenes compatible con esos horizontes. Presente MAE, RMSE, MASE, cobertura, amplitud y CRPS y discuta las limitaciones del tamaño efectivo de prueba.

Ejercicio 8 (lectura crítica). Justifique si es legítimo afirmar que un intervalo bayesiano debe ser más ancho que uno obtenido por máxima verosimilitud. Distinga el efecto de integrar la incertidumbre paramétrica del efecto de cambiar la estructura del modelo o la distribución a priori.

13.15 Lecturas recomendadas

Estas referencias corresponden a la bibliografía común references.bib ya utilizada en el libro. Las demostraciones y experimentos computacionales de esta nota adaptan los principios de los textos al modelo y a las convenciones de CA-0415.