14  Regresión dinámica y pronósticos bajo escenarios

CA-0415 Series de Tiempo — Semana 14

14.1 Objetivos de aprendizaje

Al finalizar el capítulo, el estudiantado podrá:

  1. distinguir una regresión ordinaria, una regresión con errores ARIMA y una regresión de coeficientes dinámicos;
  2. formular y estimar un modelo de regresión con errores autocorrelacionados, diferenciando error de regresión e innovación;
  3. representar regresores temporales y coeficientes evolutivos mediante un modelo lineal dinámico (DLM);
  4. utilizar tendencias, indicadoras de intervención y términos de Fourier como predictores;
  5. construir pronósticos condicionados en trayectorias futuras conocidas, estimadas o hipotéticas de los predictores;
  6. derivar la contribución de la incertidumbre de los predictores futuros a la varianza predictiva;
  7. comparar estimación por máxima verosimilitud e inferencia bayesiana para regresión dinámica;
  8. evaluar pronósticos fuera de muestra, respetando la información disponible en cada origen.

14.2 Motivación y conexión con el curso

En un modelo ARIMA univariado, la información para predecir \(Y_{T+h}\) proviene de la historia de la propia serie. Sin embargo, puede existir información relevante en otras variables: ingresos para anticipar el consumo, actividad económica para proyectar primas de seguros o temperatura para predecir demanda eléctrica. Incorporarla plantea preguntas que no aparecen en un ARIMA univariado:

  • ¿La relación entre la respuesta y el predictor se mantiene constante?
  • ¿Queda autocorrelación temporal una vez explicada la serie por la regresión?
  • ¿Se conocerá el predictor en el horizonte de pronóstico?
  • ¿Un escenario económico debe interpretarse como pronóstico, como supuesto condicional o como intervención causal?

En la semana 6 estudiamos ARIMA; en la semana 7, la evaluación con origen móvil; en las semanas 11 y 12, filtrado y predicción en espacio-estado; y en la semana 13, inferencia bayesiana para DLM. Aquí utilizaremos esos resultados, sin volver a derivar el filtro de Kalman ni el algoritmo FFBS. El capítulo 10 de Hyndman y Athanasopoulos (2021) desarrolla regresión con errores ARIMA; Prado et al. (2021) (capítulo 4) y Petris et al. (2009) (capítulos 3 y 4) permiten extenderla a regresiones con coeficientes evolutivos.

Dos significados de «dinámico». En regresión dinámica con errores ARIMA los coeficientes de regresión pueden ser constantes y es la estructura residual la que presenta dinámica temporal. En una regresión con coeficientes dinámicos, las pendientes y los interceptos pueden evolucionar como estados latentes. Ambos tipos de modelo son útiles y no deben confundirse.

Denotaremos por \(\mathcal D_T=\{y_{1:T},z_{1:T}\}\) la información histórica disponible al origen \(T\) (además de cualquier información determinista del calendario o del diseño conocida hasta ese momento). El predictor externo será \(Z_t\), y \(\boldsymbol x_t\) seguirá reservado para el estado latente del DLM.

14.3 Regresión con errores autocorrelacionados

14.3.1 De la regresión ordinaria a los errores ARMA

Consideremos inicialmente un solo predictor:

\[ Y_t=\beta_0+\beta_1Z_t+\eta_t, \qquad t=1,\ldots,T. \tag{14.1}\]

Si \(\eta_t\) es ruido blanco, la regresión clásica puede ser apropiada bajo las hipótesis habituales de exogeneidad y regularidad. Si \(\eta_t\) presenta dependencia temporal, el modelo debe describir esa dependencia. Por ejemplo,

\[ \eta_t=\phi\eta_{t-1}+\varepsilon_t, \qquad |\phi|<1, \qquad \varepsilon_t\overset{\mathrm{iid}}{\sim}N(0,\sigma^2). \tag{14.2}\]

Aquí existen dos errores distintos:

  • \(\eta_t=Y_t-\beta_0-\beta_1Z_t\) es el error de la ecuación de regresión, que puede estar autocorrelacionado.
  • \(\varepsilon_t=\eta_t-\phi\eta_{t-1}\) es la innovación del proceso residual, que bajo el modelo es ruido blanco gaussiano.

Es a las innovaciones, no necesariamente a los errores \(\eta_t\), a las que debemos exigir ausencia de correlación serial. Esta separación es central en el capítulo 10 de Hyndman y Athanasopoulos (2021) y en la sección 3.8 de Shumway y Stoffer (2025).

14.3.2 La verosimilitud para errores AR(1)

Supongamos para la derivación que \(\{Z_t\}\) se trata como una trayectoria fijada al condicionar, que \(\eta_t\) es estacionario desde el primer momento y que las innovaciones son gaussianas. Definamos \(r_t(\boldsymbol\beta)=y_t-\beta_0-\beta_1z_t\). Entonces

\[ \eta_1\sim N\!\left(0,\frac{\sigma^2}{1-\phi^2}\right), \qquad \eta_t\mid\eta_{t-1}\sim N(\phi\eta_{t-1},\sigma^2). \]

La factorización condicional de la densidad de \(\eta_{1:T}\) entrega

\[ \begin{aligned} \ell(\boldsymbol\beta,\phi,\sigma^2) ={}&-\frac{T}{2}\log(2\pi)-\frac{T}{2}\log(\sigma^2) +\frac12\log(1-\phi^2)\\ &-\frac{1}{2\sigma^2}\left[ (1-\phi^2)r_1^2+ \sum_{t=2}^T(r_t-\phi r_{t-1})^2 \right]. \end{aligned} \tag{14.3}\]

Esta es una verosimilitud gaussiana exacta para la especificación de inicio estacionario adoptada. Para \(\phi\) y \(\sigma^2\) fijos, maximizarla respecto de \(\boldsymbol\beta\) equivale a minimizar los residuos transformados y el término inicial apropiado. No equivale, en general, a minimizar \(\sum_t r_t^2\) mediante mínimos cuadrados ordinarios.

En forma matricial, si \(\boldsymbol y=X\boldsymbol\beta+\boldsymbol\eta\) y \(\operatorname{Var}(\boldsymbol\eta)=\Sigma_{\eta}\), el estimador GLS es

\[ \widehat{\boldsymbol\beta}_{\mathrm{GLS}}= (X^\top\Sigma_\eta^{-1}X)^{-1}X^\top\Sigma_\eta^{-1}\boldsymbol y. \tag{14.4}\]

Obtención del estimador GLS. Consideremos el modelo \(\boldsymbol y=X\boldsymbol\beta+\boldsymbol\eta\), donde \(E(\boldsymbol\eta\mid X)=\boldsymbol 0\) y \(\operatorname{Var}(\boldsymbol\eta\mid X)=\Sigma_\eta\). Suponemos que \(X\) tiene rango columna completo y que \(\Sigma_\eta\) es conocida, simétrica y definida positiva.

A diferencia de mínimos cuadrados ordinarios (OLS), que minimiza la suma de cuadrados de los residuos, el estimador GLS incorpora la estructura de covarianzas de los errores mediante el criterio

\[ S(\boldsymbol\beta) = (\boldsymbol y-X\boldsymbol\beta)^\top \Sigma_\eta^{-1} (\boldsymbol y-X\boldsymbol\beta). \]

Expandiendo la expresión cuadrática, obtenemos

\[ \begin{aligned} S(\boldsymbol\beta) ={}& \boldsymbol y^\top\Sigma_\eta^{-1}\boldsymbol y -2\boldsymbol\beta^\top X^\top\Sigma_\eta^{-1}\boldsymbol y\\ &+\boldsymbol\beta^\top X^\top\Sigma_\eta^{-1} X\boldsymbol\beta. \end{aligned} \]

Al derivar respecto de \(\boldsymbol\beta\) e igualar a cero,

\[ \frac{\partial S(\boldsymbol\beta)} {\partial\boldsymbol\beta} = -2X^\top\Sigma_\eta^{-1}\boldsymbol y +2X^\top\Sigma_\eta^{-1}X\boldsymbol\beta =\boldsymbol 0. \]

Reorganizando, se obtienen las ecuaciones normales generalizadas:

\[ X^\top\Sigma_\eta^{-1}X\widehat{\boldsymbol\beta} = X^\top\Sigma_\eta^{-1}\boldsymbol y. \]

Finalmente, despejando \(\widehat{\boldsymbol\beta}\),

\[ \widehat{\boldsymbol\beta}_{\mathrm{GLS}} = (X^\top\Sigma_\eta^{-1}X)^{-1} X^\top\Sigma_\eta^{-1}\boldsymbol y. \]

Dado que la matriz hessiana \(2X^\top\Sigma_\eta^{-1}X\) es definida positiva, esta solución corresponde al mínimo global único.

Interpretación. GLS puede entenderse como una aplicación de OLS a un modelo transformado cuyos errores tienen matriz de covarianzas identidad. En efecto, si \(\Sigma_\eta=LL^\top\) es una descomposición de Cholesky, la transformación

\[ L^{-1}\boldsymbol y = L^{-1}X\boldsymbol\beta + L^{-1}\boldsymbol\eta \]

produce errores con covarianza \(I_n\). Al aplicar OLS al modelo transformado se recupera exactamente el estimador GLS.

En particular, si \(\Sigma_\eta=\sigma^2I_n\), el estimador se reduce al estimador OLS convencional,

\[ \widehat{\boldsymbol\beta}_{\mathrm{OLS}} = (X^\top X)^{-1}X^\top\boldsymbol y. \]

Bajo errores gaussianos y una matriz \(\Sigma_\eta\) conocida, GLS coincide también con el estimador de máxima verosimilitud.

En una regresión con errores ARIMA, \(\Sigma_\eta\) depende habitualmente de parámetros desconocidos. Por ello, en la práctica se estima la estructura de dependencia y se utiliza GLS factible, o se estiman conjuntamente los coeficientes de regresión y los parámetros del proceso de errores mediante máxima verosimilitud.

14.3.3 Ejemplo analítico: pronóstico a varios pasos

Cuando \(z_{T+1:T+h}\) se conoce y \(\boldsymbol\beta,\phi,\sigma^2\) son conocidos, la información al origen permite recuperar \(\eta_T=y_T-\beta_0-\beta_1z_T\). La recursión de Ecuación 14.2 implica

\[ E(\eta_{T+h}\mid\mathcal D_T)=\phi^h\eta_T. \]

Por tanto,

\[ \widehat Y_{T+h\mid T}(\boldsymbol z) =\beta_0+\beta_1z_{T+h}+\phi^h\eta_T. \tag{14.5}\]

Puesto que

\[ \eta_{T+h}-\phi^h\eta_T =\sum_{j=0}^{h-1}\phi^j\varepsilon_{T+h-j}, \]

la varianza condicional de pronóstico es

\[ \operatorname{Var}(Y_{T+h}\mid\mathcal D_T,\boldsymbol z) =\sigma^2\sum_{j=0}^{h-1}\phi^{2j} =\sigma^2\frac{1-\phi^{2h}}{1-\phi^2}. \tag{14.6}\]

Interpretación. La parte AR aporta un ajuste transitorio \(\phi^h\eta_T\), que decrece con el horizonte cuando \(|\phi|<1\). La contribución de la covariable en cambio depende del valor asignado a \(z_{T+h}\). La varianza de Ecuación 14.6 no incorpora incertidumbre paramétrica ni incertidumbre sobre el predictor futuro.

14.3.4 Experimento controlado en R

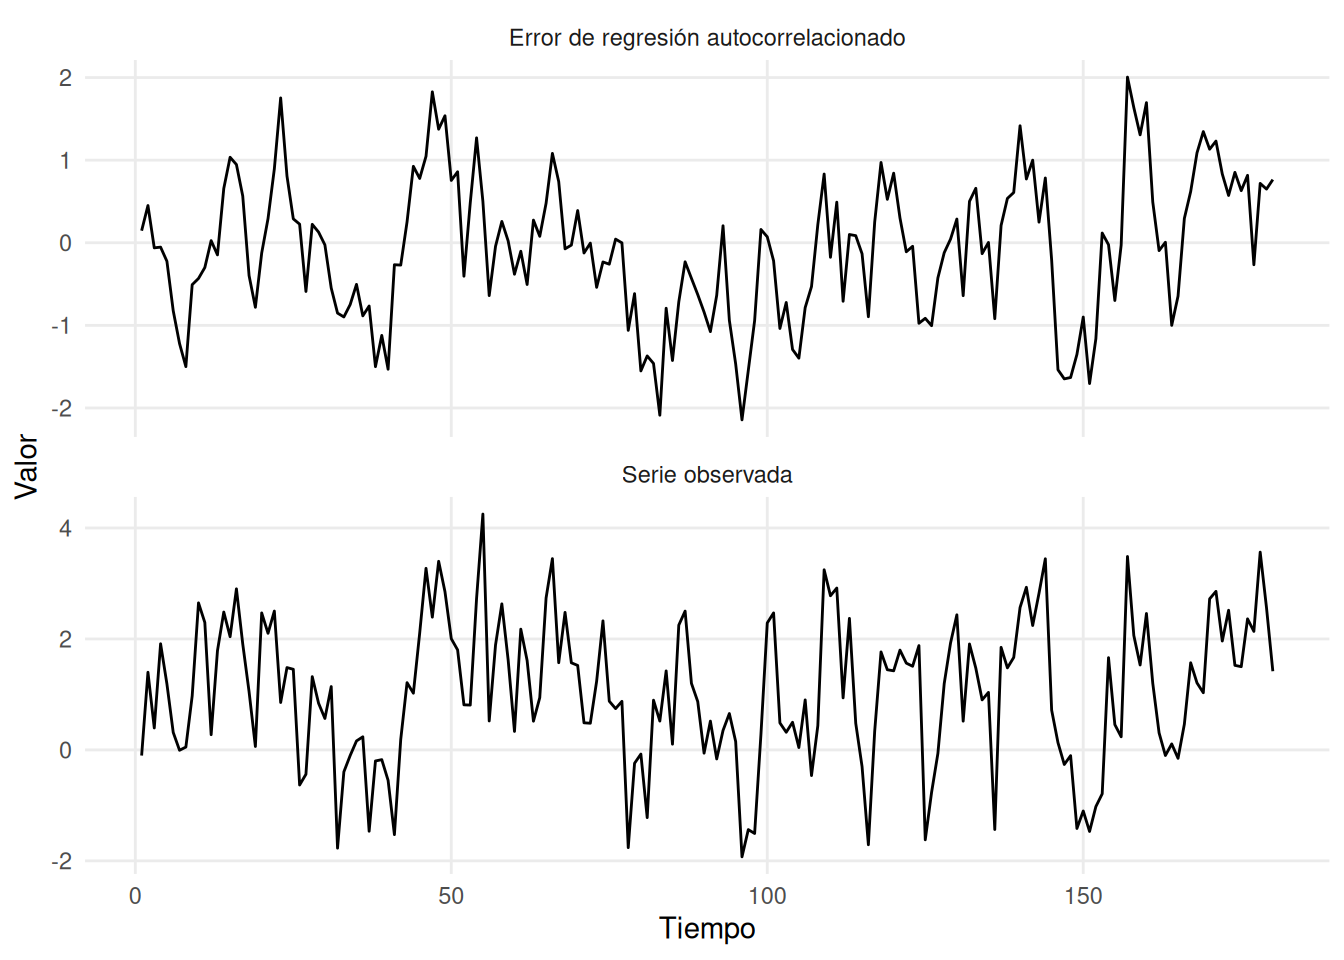
Simulamos una regresión con errores AR(1) para mostrar que la regresión ordinaria y la regresión con errores autocorrelacionados responden a supuestos diferentes.

set.seed(41401)
n_sim <- 180L
z_sim <- as.numeric(arima.sim(model = list(ar = 0.4), n = n_sim))
eta_sim <- as.numeric(arima.sim(model = list(ar = 0.75),
                                n = n_sim, sd = 0.6))
y_sim <- 1 + 0.8 * z_sim + eta_sim
sim_reg <- tibble(t = seq_len(n_sim), z = z_sim, y = y_sim, eta = eta_sim)

sim_reg |>
  select(t, y, eta) |>
  pivot_longer(-t, names_to = 'componente', values_to = 'valor') |>
  mutate(componente = recode(componente,
                              y = 'Serie observada',
                              eta = 'Error de regresión autocorrelacionado')) |>
  ggplot(aes(t, valor)) +
  geom_line(linewidth = 0.5) +
  facet_wrap(vars(componente), ncol = 1, scales = 'free_y') +
  labs(x = 'Tiempo', y = 'Valor') +
  tema_regdin
Figura 14.1: Regresión simulada con error AR(1): relación sistemática y dependencia en los errores.
ols_sim <- lm(y ~ z, data = sim_reg)
X_sim <- matrix(z_sim, ncol = 1L, dimnames = list(NULL, 'z'))
ar1_sim <- stats::arima(y_sim, order = c(1, 0, 0),
                         xreg = X_sim, include.mean = TRUE, method = 'ML')
tibble(
  metodo = c('Mínimos cuadrados', 'AR(1) en el error'),
  intercepto = c(unname(coef(ols_sim)['(Intercept)']),
                 unname(ar1_sim$coef['intercept'])),
  pendiente = c(unname(coef(ols_sim)['z']),
                unname(ar1_sim$coef['z'])),
  phi = c(NA_real_, unname(ar1_sim$coef['ar1']))
) |>
  mutate(across(where(is.numeric), ~ round(.x, 3))) |>
  kable()
Tabla 14.1: Coeficientes de la regresión simulada: mínimos cuadrados ordinarios y máxima verosimilitud con errores AR(1).
metodo intercepto pendiente phi
Mínimos cuadrados 0.916 0.836 NA
AR(1) en el error 0.940 0.778 0.733
acf_ols <- as.numeric(stats::acf(resid(ols_sim), lag.max = 20,
                                  plot = FALSE)$acf)[-1L]
acf_ar1 <- as.numeric(stats::acf(resid(ar1_sim), lag.max = 20,
                                  plot = FALSE)$acf)[-1L]
bind_rows(
  tibble(rezago = seq_along(acf_ols), acf = acf_ols,
         tipo = 'Errores de regresión (MCO)'),
  tibble(rezago = seq_along(acf_ar1), acf = acf_ar1,
         tipo = 'Innovaciones (AR(1) en el error)')
) |>
  ggplot(aes(rezago, acf)) +
  geom_hline(yintercept = 0, color = 'grey50') +
  geom_segment(aes(xend = rezago, yend = 0)) +
  facet_wrap(vars(tipo), ncol = 1) +
  labs(x = 'Rezago', y = 'Autocorrelación muestral') +
  tema_regdin
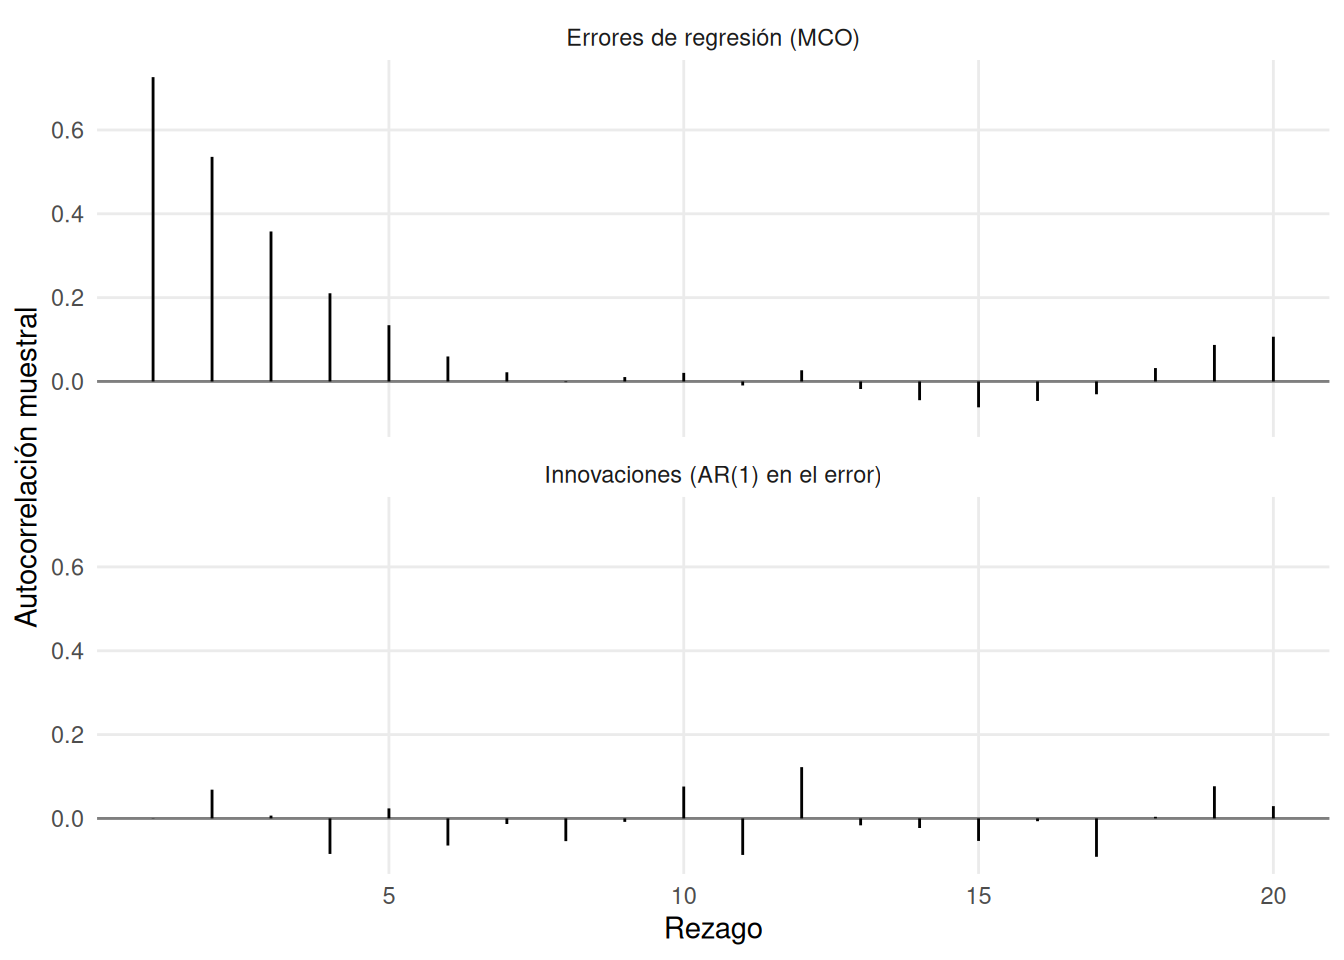
Figura 14.2: ACF del error estimado por regresión ordinaria y de las innovaciones del ajuste AR(1) en el error.

El contraste correcto es entre los supuestos de innovaciones de cada modelo y los patrones que muestran los residuos estimados. La desaparición de parte de la autocorrelación no prueba por sí misma que el modelo sea adecuado: también debemos inspeccionar estabilidad, varianza y posibles valores atípicos.

14.4 Regresión con errores ARIMA

14.4.1 Formulación general

Sea \(B\) el operador rezago y \(\boldsymbol Z_t\) un vector de predictores. Una regresión con errores ARIMA se escribe

\[ Y_t=\beta_0+\boldsymbol Z_t^\top\boldsymbol\beta+\eta_t, \qquad \phi(B)(1-B)^d\eta_t=\theta(B)\varepsilon_t. \tag{14.7}\]

La regresión describe la relación entre variables, mientras que \(\eta_t\) representa la dinámica no explicada por ellas. La especificación y el diagnóstico deben considerar ambas partes. Para un ARMA estacionario, \(d=0\); cuando \(d>0\), el error es integrado y el nivel de la regresión requiere una interpretación especial.

Si \(d=1\), diferenciando la primera ecuación obtenemos

\[ \Delta Y_t=\boldsymbol\beta^\top\Delta\boldsymbol Z_t +\Delta\eta_t, \tag{14.8}\]

pues la constante desaparece. Por tanto, una regresión con errores ARIMA\((p,1,q)\) puede verse como una regresión en diferencias con errores ARMA\((p,q)\), salvo las decisiones sobre constantes o derivas. No debe confundirse con incluir diferencias de los predictores en una regresión de niveles cuyos errores son estacionarios.

14.4.2 Regresión espuria, cointegración y corrección de errores

Una regresión con errores ARIMA permite describir la dependencia temporal de los errores, pero no garantiza, por sí sola, que una relación entre variables no estacionarias represente un equilibrio económico estable. Para precisar esta advertencia distinguiremos integración, regresión espuria y cointegración (Granger y Newbold 1974; Engle y Granger 1987).

14.4.2.1 Integración y tendencias estocásticas

Una serie \(Y_t\) es integrada de orden uno, \(Y_t\sim I(1)\), si no es estacionaria en niveles, pero \(\Delta Y_t=(1-B)Y_t\) es \(I(0)\). Por ejemplo, para una caminata aleatoria con \(Y_0\) fijo,

\[ Y_t=Y_{t-1}+\varepsilon_t =Y_0+\sum_{j=1}^{t}\varepsilon_j, \qquad \varepsilon_t\overset{\mathrm{iid}}{\sim}N(0,\sigma_\varepsilon^2), \]

se tiene \(\Delta Y_t=\varepsilon_t\) y

\[ \operatorname{Var}(Y_t\mid Y_0)=t\sigma_\varepsilon^2. \]

La acumulación de innovaciones genera una tendencia estocástica: los efectos de una perturbación sobre el nivel son persistentes y la varianza aumenta con el tiempo. La no estacionariedad en niveles no debe confundirse con una tendencia determinista, que podría eliminarse mediante la especificación adecuada de una función del tiempo.

14.4.2.2 Por qué puede aparecer una regresión espuria

Consideremos dos caminatas aleatorias independientes, con valores iniciales fijos:

\[ \begin{aligned} Y_t&=Y_{t-1}+\varepsilon_t,\\ Z_t&=Z_{t-1}+u_t, \end{aligned} \qquad \operatorname{Cov}(\varepsilon_t,u_s)=0 \quad\text{para todo }t,s, \tag{14.9}\]

donde \(\{\varepsilon_t\}\) y \(\{u_t\}\) son ruidos blancos mutuamente independientes, de varianzas positivas \(\sigma_\varepsilon^2\) y \(\sigma_u^2\). Supongamos que, pese a no existir un mecanismo que relacione las dos series, ajustamos por mínimos cuadrados ordinarios

\[ Y_t=\beta_0+\beta_1Z_t+\eta_t. \]

Las trayectorias acumuladas pueden mostrar movimientos prolongados en direcciones similares simplemente por azar. Esto suele producir ajustes visualmente convincentes, \(R^2\) elevados y valores \(p\) pequeños para la pendiente, aun cuando las series son independientes. El problema no se reduce a tener errores autocorrelacionados: bajo la ausencia de cointegración, no existe un coeficiente fijo que elimine la tendencia estocástica de la combinación lineal. Para ilustrarlo, para cualquier \(\beta_1\) fijo,

\[ \begin{aligned} \eta_t(\beta_1)&=Y_t-\beta_1 Z_t,\\ \Delta\eta_t(\beta_1)&=\varepsilon_t-\beta_1u_t,\\ \operatorname{Var}\{\eta_t(\beta_1)\mid Y_0,Z_0\} &=t(\sigma_\varepsilon^2+\beta_1^2\sigma_u^2). \end{aligned} \tag{14.10}\]

La varianza crece con \(t\) para cualquier \(\beta_1\) fijo y no degenerado. Como la pendiente estimada depende de toda la muestra, su comportamiento requiere teoría asintótica especial; en particular, los estadísticos \(t\) usuales no siguen sus distribuciones de referencia convencionales. No corresponde interpretar un valor \(p\) pequeño como evidencia de una relación económica estable (Granger y Newbold 1974).

14.4.2.3 Cointegración: una combinación estacionaria de series integradas

La situación cambia si \(Y_t\sim I(1)\) y \(Z_t\sim I(1)\), pero existen constantes \(\beta_0\) y \(\beta_1\) tales que

\[ \eta_t=Y_t-\beta_0-\beta_1Z_t\sim I(0). \tag{14.11}\]

En ese caso, \(Y_t\) y \(Z_t\) están cointegradas (en la formulación bivariada de orden \((1,1)\)), con vector de cointegración proporcional a \((1,-\beta_1)^\top\). La estacionariedad de \(\eta_t\) significa que las desviaciones respecto de \(\beta_0+\beta_1Z_t\) no acumulan una tendencia estocástica adicional. El coeficiente \(\beta_1\) puede interpretarse como una relación de equilibrio de largo plazo si existe, además, una justificación económica para esa interpretación. La cointegración no implica, por sí misma, causalidad ni exogeneidad del predictor (Engle y Granger 1987).

Como ejemplo, sea

\[ \begin{aligned} Z_t&=Z_{t-1}+u_t,\\ Y_t&=2+1.5Z_t+\eta_t,\\ \eta_t&=0.6\eta_{t-1}+\varepsilon_t, \end{aligned} \tag{14.12}\]

con innovaciones de varianza finita y \(\eta_t\) inicializado en su distribución estacionaria. Las series \(Y_t\) y \(Z_t\) son \(I(1)\), pero

\[ Y_t-2-1.5Z_t=\eta_t\sim I(0). \]

Por ello, una regresión en niveles no es necesariamente espuria: la propiedad que distingue este ejemplo es la estacionariedad del error de equilibrio.

14.4.2.4 De la cointegración al mecanismo de corrección de errores

La cointegración también tiene consecuencias para la dinámica. Partiendo del ejemplo anterior y tomando primeras diferencias,

\[ \Delta Y_t=1.5\,\Delta Z_t+\Delta\eta_t. \]

Como \(\eta_t=0.6\eta_{t-1}+\varepsilon_t\),

\[ \Delta\eta_t=(0.6-1)\eta_{t-1}+\varepsilon_t =-0.4\eta_{t-1}+\varepsilon_t. \]

Sustituyendo \(\eta_{t-1}=Y_{t-1}-2-1.5Z_{t-1}\) se obtiene

\[ \Delta Y_t =-0.4\bigl(Y_{t-1}-2-1.5Z_{t-1}\bigr) +1.5\,\Delta Z_t+\varepsilon_t. \tag{14.13}\]

Este es un modelo de corrección de errores (error correction model, ECM): el cambio de \(Y_t\) depende del cambio contemporáneo de \(Z_t\) y de la desviación frente al equilibrio en el período anterior. Si esa desviación es positiva, el término \(-0.4\eta_{t-1}\) contribuye a reducirla en el siguiente período, manteniendo constantes los otros efectos.

Una formulación más general es

\[ \Delta Y_t =\alpha\bigl(Y_{t-1}-\beta_0-\beta_1Z_{t-1}\bigr) +\gamma\Delta Z_t+\varepsilon_t, \tag{14.14}\]

con términos rezagados adicionales de \(\Delta Y_t\) y \(\Delta Z_t\) cuando sean necesarios. Aquí \(\beta_1\) caracteriza el equilibrio de largo plazo; \(\gamma\), la respuesta de corto plazo; y \(\alpha\), la velocidad y dirección del ajuste, sujetas a las condiciones de estabilidad de la especificación completa. El teorema de representación de Engle–Granger establece una conexión entre cointegración y representaciones de corrección de errores bajo condiciones de regularidad (Engle y Granger 1987).

Precaución sobre la diferenciación. Si se estima únicamente una regresión en diferencias,

\[ \Delta Y_t=\delta_0+\delta_1\Delta Z_t+w_t, \]

se describe una asociación de corto plazo, pero no se incorpora explícitamente el desequilibrio \(Y_{t-1}-\beta_0-\beta_1Z_{t-1}\). Por tanto, diferenciar puede ser adecuado cuando no existe cointegración, mientras que, si existe, un ECM permite conservar información sobre el equilibrio. No debe suponerse que \(\delta_1\) coincide necesariamente con el coeficiente de largo plazo \(\beta_1\).

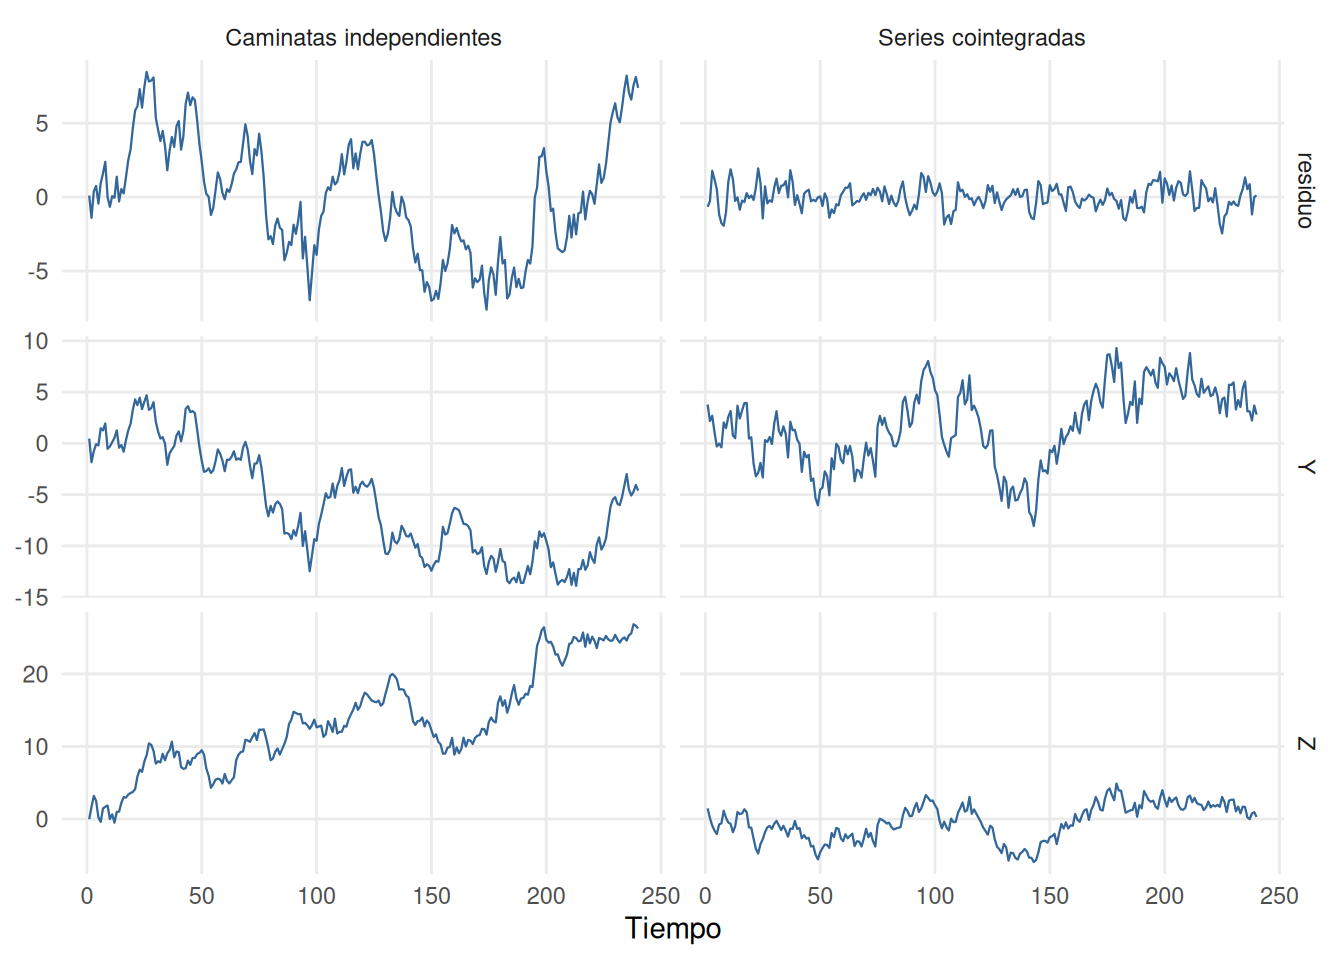
14.4.2.5 Experimento reproducible: dos regresiones con comportamientos diferentes

Simularemos primero dos caminatas aleatorias independientes y, después, dos series cointegradas. En ambos casos las variables observadas pueden presentar trayectorias persistentes; lo que cambia es el comportamiento del error de equilibrio.

set.seed(41414)
n_coint <- 240L

z_ind <- cumsum(rnorm(n_coint))
y_ind <- cumsum(rnorm(n_coint))
modelo_ind <- lm(y_ind ~ z_ind)

z_coint <- cumsum(rnorm(n_coint))
eta_coint <- as.numeric(stats::arima.sim(
  model = list(ar = 0.6), n = n_coint, sd = 0.7
))
y_coint <- 2 + 1.5 * z_coint + eta_coint
modelo_coint <- lm(y_coint ~ z_coint)

serie_coint <- dplyr::bind_rows(
  tibble::tibble(t = seq_len(n_coint),
                 caso = 'Caminatas independientes',
                 Y = y_ind, Z = z_ind,
                 residuo = as.numeric(residuals(modelo_ind))),
  tibble::tibble(t = seq_len(n_coint),
                 caso = 'Series cointegradas',
                 Y = y_coint, Z = z_coint,
                 residuo = as.numeric(residuals(modelo_coint)))
)

serie_coint |>
  tidyr::pivot_longer(cols = c(Y, Z, residuo),
                      names_to = 'variable', values_to = 'valor') |>
  ggplot2::ggplot(ggplot2::aes(x = t, y = valor)) +
  ggplot2::geom_line(linewidth = 0.4, colour = '#336699') +
  ggplot2::facet_grid(rows = ggplot2::vars(variable),
                      cols = ggplot2::vars(caso), scales = 'free_y') +
  ggplot2::labs(x = 'Tiempo', y = NULL) +
  tema_regdin
Figura 14.3: Series en niveles y residuos estimados: caminatas aleatorias independientes frente a series cointegradas (datos simulados).

El gráfico es ilustrativo: observar que los residuos parecen revertir hacia una media no constituye una prueba formal de cointegración. Para evidenciar por qué la inferencia convencional puede fallar, el siguiente experimento calcula la frecuencia con la que una prueba \(t\) ordinaria rechaza una pendiente nula al 5 %, cuando las dos series son en realidad independientes. Comparamos variables estacionarias independientes con caminatas aleatorias independientes.

set.seed(41415)
n_monte <- 200L
B_monte <- 300L

p_estacionaria <- replicate(B_monte, {
  z <- rnorm(n_monte)
  y <- rnorm(n_monte)
  unname(coef(summary(lm(y ~ z)))[2L, 4L])
})

p_caminatas <- replicate(B_monte, {
  z <- cumsum(rnorm(n_monte))
  y <- cumsum(rnorm(n_monte))
  unname(coef(summary(lm(y ~ z)))[2L, 4L])
})

tibble::tibble(
  escenario = c('Series I(0) independientes',
                'Caminatas aleatorias independientes'),
  simulaciones = B_monte,
  porcentaje_rechazo = round(100 * c(
    mean(p_estacionaria < 0.05), mean(p_caminatas < 0.05)
  ), 1)
) |>
  knitr::kable()
Tabla 14.2: Frecuencia de rechazo nominal al 5 % en regresiones entre variables independientes: comparación de un caso estacionario con caminatas aleatorias.
escenario simulaciones porcentaje_rechazo
Series I(0) independientes 300 6.0
Caminatas aleatorias independientes 300 84.3

La frecuencia en el segundo escenario no debe interpretarse como potencia: no existe ninguna relación entre las dos series. Es una tasa de falsos positivos de una prueba que se aplica fuera de las condiciones que justifican su distribución convencional. La simulación aproxima una característica de las regresiones espurias, no establece un porcentaje universal para cualquier tamaño muestral o proceso integrado.

14.4.2.6 Orientaciones para el análisis y el pronóstico

Antes de interpretar una regresión dinámica entre variables en niveles, conviene: (i) estudiar por separado la posible presencia de raíces unitarias, tendencias deterministas y rupturas; (ii) si hay series \(I(1)\) y una hipótesis sustantiva de equilibrio, examinar si alguna combinación lineal es \(I(0)\); (iii) contrastar, según el caso, una regresión en diferencias o un ECM; y (iv) evaluar residuos, estabilidad y pronósticos fuera de muestra. Las pruebas ADF y KPSS son auxiliares para evaluar el orden de integración, pero no sustituyen una evaluación de cointegración.

En un procedimiento de Engle–Granger, se estima primero la relación de largo plazo en niveles y luego se evalúa si sus residuos tienen raíz unitaria. Debido a que estos residuos fueron estimados, la distribución de la estadística no es la de una prueba ADF estándar aplicada a una serie observada: deben emplearse valores críticos o valores \(p\) específicos del procedimiento, y especificar correctamente intercepto, tendencia y rezagos. Las rupturas estructurales pueden complicar la interpretación del contraste. La evidencia de cointegración no establece causalidad ni garantiza capacidad de pronóstico fuera de muestra.

Finalmente, en el modelo de la aplicación del capítulo se utilizan variaciones trimestrales (us_change), no los niveles de consumo e ingreso. Esto evita aplicar sin justificación una regresión en niveles entre series potencialmente integradas; sin embargo, no demuestra por sí mismo estacionariedad, exogeneidad o estabilidad de la relación. Para pronosticar con un ECM o con una regresión en diferencias también se deben conocer, modelar o fijar escenarios para los valores futuros de los predictores.

14.4.3 Predicción y diagnóstico

Con coeficientes fijos, el pronóstico combina dos componentes:

\[ \widehat Y_{T+h\mid T} =\widehat\beta_0+\boldsymbol z_{T+h}^\top\widehat{\boldsymbol\beta} +\widehat\eta_{T+h\mid T}. \tag{14.15}\]

La última parte proviene de la recursión ARIMA del proceso residual. Deben estudiarse por separado los errores de regresión y las innovaciones. Los intervalos producidos a partir de una trayectoria \(\boldsymbol z_{T+1:T+h}\) fijada son condicionales a esa trayectoria; no convierten sus valores en observaciones futuras conocidas.

14.5 Variables de calendario, intervenciones y Fourier

14.5.1 Tendencias y variables indicadoras

Las covariables se pueden diseñar para representar mecanismos estructurados. Algunos ejemplos son:

  • \(t\) para una tendencia lineal determinista;
  • \(D_t=\mathbf 1(t\ge\tau)\) para un cambio persistente de nivel a partir de \(\tau\);
  • \(P_t=\mathbf 1(t=\tau)\) para un efecto transitorio de un único período;
  • \(R_t=(t-\tau)_+\) para un cambio en la pendiente desde \(\tau\);
  • indicadoras de trimestre, mes, festivos o días laborables.

Por ejemplo,

\[ Y_t=\beta_0+\beta_1t+\gamma D_t+\delta R_t+\eta_t \tag{14.16}\]

separa la pendiente inicial, el salto en \(\tau\) y la variación posterior de pendiente. Para pronosticar es imprescindible especificar los valores futuros de \(D_t\) y \(R_t\). No basta observar un cambio coincidente para atribuirle un efecto causal a una intervención: ello requeriría un diseño y supuestos adicionales.

14.5.2 Regresión armónica dinámica

Para una estacionalidad de período \(m\), pueden utilizarse regresores de Fourier:

\[ Y_t=\beta_0+\sum_{k=1}^K \left\{a_k\sin\left(\frac{2\pi kt}{m}\right) +b_k\cos\left(\frac{2\pi kt}{m}\right)\right\} +\eta_t. \tag{14.17}\]

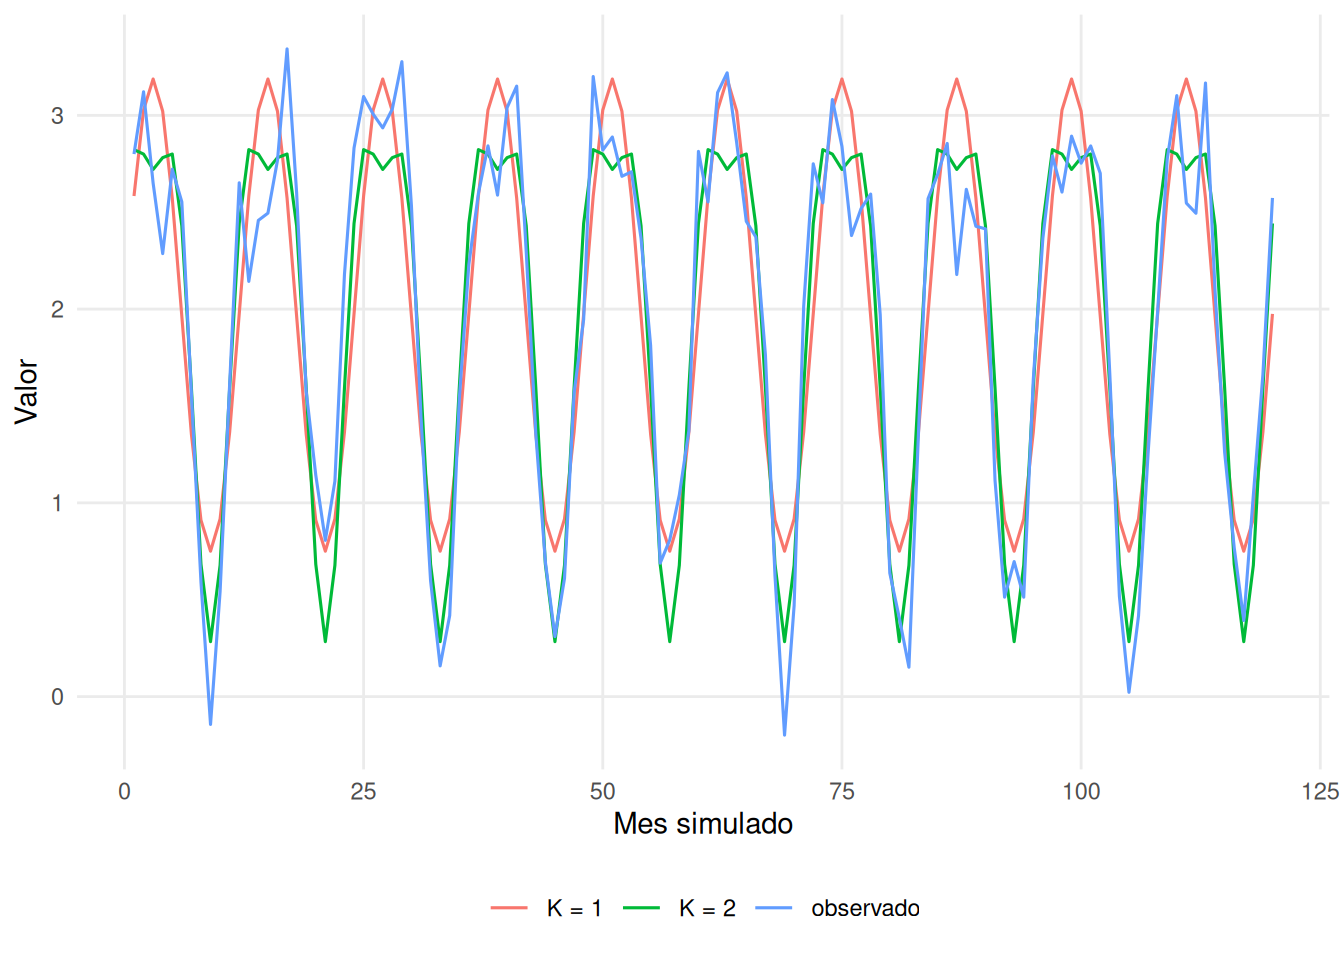
El número \(K\) controla la complejidad de la forma estacional. Estas funciones son conocidas para cualquier instante futuro; la incertidumbre en su trayectoria es nula, a diferencia de una covariable macroeconómica aún no observada. El término «dinámica» aquí se refiere a que \(\eta_t\) puede seguir un ARMA o ARIMA: los coeficientes \(a_k,b_k\) no tienen por qué cambiar con el tiempo. Véanse Hyndman y Athanasopoulos (2021), sección 10.5, y Petris et al. (2009), sección 3.2.3.

set.seed(41402)
t_fourier <- seq_len(120L)
serie_fourier <- 2 +
  1.2 * sin(2 * pi * t_fourier / 12) +
  0.45 * cos(4 * pi * t_fourier / 12) +
  as.numeric(arima.sim(list(ar = 0.35), n = 120L, sd = 0.3))
DF_fourier <- tibble(t = t_fourier, y = serie_fourier,
                    s1 = sin(2 * pi * t / 12), c1 = cos(2 * pi * t / 12),
                    s2 = sin(4 * pi * t / 12), c2 = cos(4 * pi * t / 12))
fit_k1 <- lm(y ~ s1 + c1, data = DF_fourier)
fit_k2 <- lm(y ~ s1 + c1 + s2 + c2, data = DF_fourier)
DF_fourier |>
  transmute(t, observado = y,
            `K = 1` = as.numeric(fitted(fit_k1)),
            `K = 2` = as.numeric(fitted(fit_k2))) |>
  pivot_longer(-t, names_to = 'componente', values_to = 'valor') |>
  ggplot(aes(t, valor, colour = componente)) +
  geom_line(linewidth = 0.55) +
  labs(x = 'Mes simulado', y = 'Valor', colour = NULL) +
  tema_regdin
Figura 14.4: Dos representaciones armónicas de una estacionalidad mensual simulada: uno frente a dos armónicos.

Esta figura ilustra únicamente la capacidad de la base de Fourier para representar formas estacionales. Los ajustes de la figura son MCO y no reemplazan el diagnóstico de un modelo de errores autocorrelacionados. En un análisis aplicado, compararíamos también los modelos resultantes con una referencia SARIMA bajo validación temporal.

14.6 Regresión con coeficientes variables en el tiempo

14.6.1 Un DLM de regresión

La regresión con errores ARIMA describe la dependencia residual sin obligar a que cambien los coeficientes. Una alternativa es permitir explícitamente que la relación entre \(Y_t\) y \(Z_t\) evolucione. Consideremos

\[ \begin{aligned} Y_t&=\beta_{0,t}+\beta_{1,t}Z_t+v_t, &v_t&\sim N(0,V),\\ \beta_{0,t}&=\beta_{0,t-1}+w_{0,t}, &w_{0,t}&\sim N(0,W_0),\\ \beta_{1,t}&=\beta_{1,t-1}+w_{1,t}, &w_{1,t}&\sim N(0,W_1). \end{aligned} \tag{14.18}\]

Suponemos inicialmente independencia mutua de los errores de observación y de evolución, en el tiempo y entre componentes, así como independencia respecto del estado inicial. En la notación de los capítulos 11–13:

\[ \underbrace{Y_t}_{1\times1} =\underbrace{\boldsymbol F_t^\top}_{1\times2} \underbrace{\boldsymbol x_t}_{2\times1}+v_t, \qquad \boldsymbol x_t=\boldsymbol G_t\boldsymbol x_{t-1}+\boldsymbol w_t, \tag{14.19}\]

con

\[ \boldsymbol x_t=\begin{pmatrix}\beta_{0,t}\\\beta_{1,t}\end{pmatrix}, \qquad \boldsymbol F_t=\begin{pmatrix}1\\Z_t\end{pmatrix}, \qquad \boldsymbol G_t=I_2, \qquad \boldsymbol W=\begin{pmatrix}W_0&0\\0&W_1\end{pmatrix}. \tag{14.20}\]

La observación depende del predictor contemporáneo, pero el estado es latente. Dada la trayectoria de \(Z_t\), el modelo es lineal y gaussiano. La media \(\beta_{1,t}\) tiene una interpretación directa: representa la asociación lineal condicional contemporánea, que puede cambiar gradualmente. No es automáticamente un efecto causal.

Casos especiales y restricciones. Si \(W_1=0\), la pendiente se mantiene constante a lo largo de la trayectoria latente, aun cuando persista incertidumbre sobre su valor. Si \(W_1>0\), puede variar entre períodos. Si también \(W_0=0\), el estado completo es constante y se recupera una regresión con coeficientes desconocidos y ruido de observación independiente, no una regresión con errores ARIMA. Para obtener simultáneamente coeficientes dinámicos y errores AR(1) habría que ampliar el estado, por ejemplo para contener \(\eta_t\), lo cual aumenta las dificultades de identificación.

14.6.2 La actualización depende de la covariable

Sean \(\boldsymbol m_{t-1}\) y \(\boldsymbol C_{t-1}\) los momentos filtrados del estado. Las recursiones conocidas de Kalman se convierten en

\[ \begin{aligned} \boldsymbol a_t &=\boldsymbol m_{t-1}, &\boldsymbol R_t&=\boldsymbol C_{t-1}+\boldsymbol W,\\ f_t&=\boldsymbol F_t^\top\boldsymbol a_t, &Q_t&=\boldsymbol F_t^\top\boldsymbol R_t\boldsymbol F_t+V,\\ \boldsymbol K_t&=\boldsymbol R_t\boldsymbol F_t/Q_t, &\boldsymbol m_t&=\boldsymbol a_t+\boldsymbol K_t(y_t-f_t),\\ \boldsymbol C_t&=\boldsymbol R_t- \boldsymbol R_t\boldsymbol F_tQ_t^{-1}\boldsymbol F_t^\top\boldsymbol R_t. \end{aligned} \tag{14.21}\]

Efecto del predictor sobre la ganancia de Kalman.

Para comprender cómo \(Z_t\) interviene en la actualización de los coeficientes, escribamos la matriz de covarianzas predictivas como

\[ \boldsymbol R_t= \begin{pmatrix} r_{00,t} & r_{01,t}\\ r_{01,t} & r_{11,t} \end{pmatrix}, \]

donde \(r_{00,t}\) y \(r_{11,t}\) son las varianzas predictivas del intercepto y la pendiente, respectivamente, y \(r_{01,t}\) es su covarianza.

Como \(\boldsymbol F_t=(1,Z_t)^\top\), la varianza predictiva de la observación es

\[ Q_t=r_{00,t}+2Z_t r_{01,t}+Z_t^2r_{11,t}+V. \]

Sustituyendo en la expresión de la ganancia de Kalman (Ecuación 14.21), obtenemos

\[ \boldsymbol K_t = \frac{1}{Q_t} \begin{pmatrix} r_{00,t}+Z_t r_{01,t}\\ r_{01,t}+Z_t r_{11,t} \end{pmatrix}. \tag{14.22}\]

Por consiguiente, la actualización de cada coeficiente es

\[ \begin{aligned} m_{0,t}&=a_{0,t}+K_{0,t}(y_t-f_t),\\ m_{1,t}&=a_{1,t}+K_{1,t}(y_t-f_t). \end{aligned} \]

Cuando \(Z_t=0\), la ecuación de observación se reduce a \(Y_t=\beta_{0,t}+v_t\). En este caso, la ganancia correspondiente a la pendiente es

\[ K_{1,t}=\frac{r_{01,t}}{r_{00,t}+V}. \]

Si \(r_{01,t}=0\), entonces \(K_{1,t}=0\) y la observación no modifica la estimación filtrada de la pendiente. Sin embargo, cuando \(r_{01,t}\neq 0\), la observación puede actualizar indirectamente la pendiente debido a su asociación predictiva con el intercepto.

Por tanto, un valor de \(Z_t\) próximo a cero reduce la información directa sobre la pendiente, pero no necesariamente elimina toda posibilidad de actualizarla.

Información sobre la pendiente e identificabilidad.

La cantidad de información aportada por una observación puede estudiarse mediante la reducción de la varianza posterior del coeficiente. A partir de la actualización de covarianzas de Kalman, la varianza filtrada de la pendiente es

\[ C_{11,t} = r_{11,t} - \frac{(r_{01,t}+Z_t r_{11,t})^2}{Q_t}. \]

Para simplificar la interpretación, supongamos que \(r_{01,t}=0\). Entonces,

\[ C_{11,t} = \frac{r_{11,t}(r_{00,t}+V)} {r_{00,t}+Z_t^2r_{11,t}+V}. \tag{14.23}\]

Equivalentemente, podemos expresar la actualización en términos de precisión:

\[ \frac{1}{C_{11,t}} = \frac{1}{r_{11,t}} + \frac{Z_t^2}{r_{00,t}+V}. \]

Esta última expresión permite observar que, manteniendo constantes las varianzas predictivas y \(V\), la información sobre la pendiente aumenta con \(Z_t^2\). Por tanto, valores grandes de \(|Z_t|\) pueden reducir considerablemente la incertidumbre sobre \(\beta_{1,t}\).

Es importante distinguir este resultado del comportamiento de la ganancia de Kalman. En efecto, cuando \(r_{01,t}=0\),

\[ K_{1,t} = \frac{Z_t r_{11,t}} {r_{00,t}+Z_t^2r_{11,t}+V}, \]

que no necesariamente aumenta de manera monótona con \(|Z_t|\), pues el predictor aparece tanto en el numerador como en el denominador.

Por otra parte, la variabilidad del predictor a lo largo del tiempo es fundamental para identificar los coeficientes. Si \(Z_t\approx c\) durante muchos períodos, entonces

\[ Y_t\approx\beta_{0,t}+c\beta_{1,t}+v_t. \]

En estas condiciones, las observaciones informan principalmente sobre la combinación \(\beta_{0,t}+c\beta_{1,t}\), dificultando distinguir las contribuciones individuales del intercepto y la pendiente. Si los coeficientes fueran constantes y \(Z_t=c\) exactamente, las columnas de la matriz de diseño serían linealmente dependientes. En un DLM, las distribuciones a priori y las restricciones de evolución pueden regularizar la estimación, aunque no sustituyen la información que proporciona la variabilidad del predictor.

Finalmente, la mayor información potencial asociada con valores extremos de \(Z_t\) depende de que el modelo esté correctamente especificado. Si existen observaciones atípicas, relaciones no lineales omitidas o una especificación inadecuada de \(V\), el filtro puede atribuir erróneamente discrepancias del modelo a cambios en los coeficientes dinámicos.

Por ello, una observación potencialmente muy informativa no es necesariamente una observación fiable. La interpretación de las actualizaciones debe acompañarse del diagnóstico de las innovaciones y de una evaluación de la sensibilidad a los supuestos del modelo.
14.6.3 Distribución predictiva con trayectoria futura conocida

Supongamos que \(V\) y \(\boldsymbol W\) están dados y que \(z_{T+1:T+H}\) se fija. Como \(\boldsymbol G=I_2\),

\[ \boldsymbol x_{T+h}\mid\mathcal D_T \sim N_2(\boldsymbol m_T,\boldsymbol C_T+h\boldsymbol W). \tag{14.24}\]

Por consiguiente, para cada \(h\ge1\),

\[ Y_{T+h}\mid\mathcal D_T,z_{T+1:T+H} \sim N\!\left( \boldsymbol F_{T+h}^\top\boldsymbol m_T, \boldsymbol F_{T+h}^\top(\boldsymbol C_T+h\boldsymbol W) \boldsymbol F_{T+h}+V \right). \tag{14.25}\]

La varianza tiene tres fuentes condicionales: incertidumbre sobre el estado al origen (\(\boldsymbol C_T\)), evolución futura de los coeficientes (\(h\boldsymbol W\)) y ruido de observación (\(V\)). Todavía no incluye incertidumbre sobre la trayectoria futura del predictor ni sobre los hiperparámetros \(V,W_0,W_1\). Obsérvese que cada horizonte utiliza un vector \(\boldsymbol F_{T+h}\) diferente.

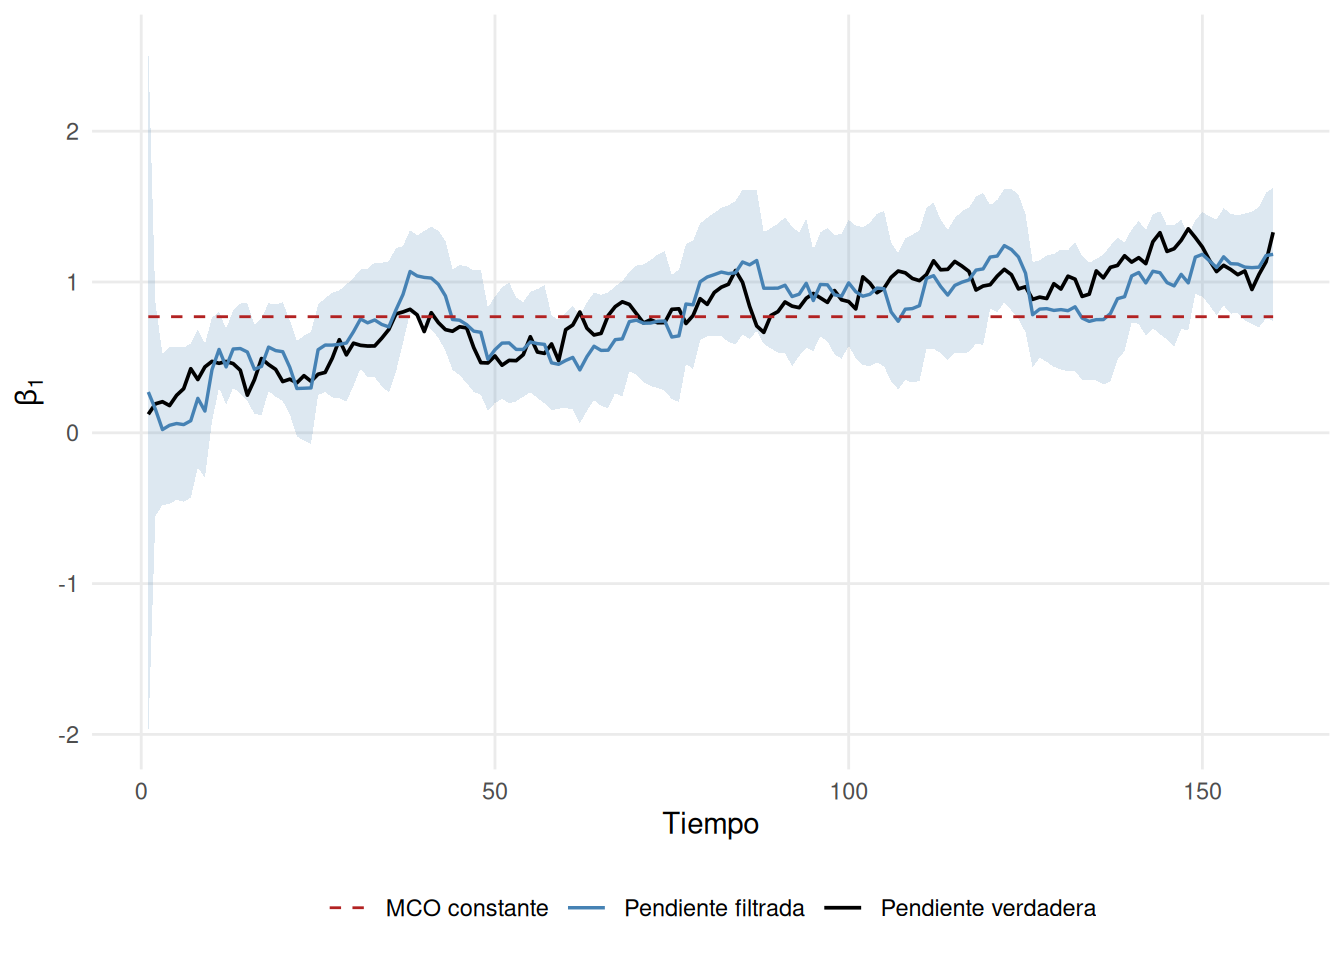
14.6.4 Experimento: una pendiente que realmente evoluciona

La siguiente simulación permite observar el efecto de aproximar una pendiente variable por una constante. Se utilizan varianzas conocidas en el filtro solamente para aislar el aprendizaje del estado; no estamos estimando hiperparámetros en esta etapa.

set.seed(41403)
n_dlm_sim <- 160L
z_dlm_sim <- as.numeric(arima.sim(model = list(ar = 0.6), n = n_dlm_sim))
W0_sim <- 0.0001
W1_sim <- 0.006
V_sim <- 0.30
beta0_sim <- 0.8 + cumsum(rnorm(n_dlm_sim, sd = sqrt(W0_sim)))
beta1_sim <- 0.15 + cumsum(rnorm(n_dlm_sim, sd = sqrt(W1_sim)))
y_dlm_sim <- beta0_sim + beta1_sim * z_dlm_sim +
  rnorm(n_dlm_sim, sd = sqrt(V_sim))
fil_sim <- filtrar_regdin(y_dlm_sim, z_dlm_sim, V_sim, W0_sim, W1_sim)
ols_dlm_sim <- lm(y_dlm_sim ~ z_dlm_sim)

sim_estados <- tibble(
  t = seq_len(n_dlm_sim),
  verdad = beta1_sim,
  filtrado = fil_sim$m[-1L, 2L],
  sd_filtrada = sqrt(fil_sim$C[2L, 2L, -1L]),
  constante = unname(coef(ols_dlm_sim)[2L])
) |>
  mutate(inferior = filtrado - 1.96 * sd_filtrada,
         superior = filtrado + 1.96 * sd_filtrada)

ggplot(sim_estados, aes(t)) +
  geom_ribbon(aes(ymin = inferior, ymax = superior),
              fill = 'steelblue', alpha = 0.18) +
  geom_line(aes(y = verdad, colour = 'Pendiente verdadera'), linewidth = 0.65) +
  geom_line(aes(y = filtrado, colour = 'Pendiente filtrada'), linewidth = 0.6) +
  geom_line(aes(y = constante, colour = 'MCO constante'),
            linetype = 'dashed') +
  scale_colour_manual(values = c('Pendiente verdadera' = 'black',
                                  'Pendiente filtrada' = 'steelblue',
                                  'MCO constante' = 'firebrick')) +
  labs(x = 'Tiempo', y = expression(beta[1,t]), colour = NULL) +
  tema_regdin
Figura 14.5: Pendiente latente simulada, estimación filtrada mediante Kalman e intervalo puntual del 95%; comparación con una pendiente constante estimada por MCO.

La línea filtrada usa datos hasta \(t\); no debe interpretarse como una estimación que aprovecha toda la serie. La banda se construye a partir de la incertidumbre condicional del filtro con parámetros conocidos y no corresponde a intervalos simultáneos para toda la trayectoria. Un suavizador RTS utilizaría información posterior a \(t\) para estimar retrospectivamente \(\beta_{1,t}\), como vimos en la semana 12.

14.7 Inferencia frecuentista y bayesiana para el DLM

14.7.1 Verosimilitud predictiva y estimación por máxima verosimilitud

Una vez fijados la distribución inicial \(\boldsymbol x_0\sim N(\boldsymbol m_0,\boldsymbol C_0)\) y los predictores históricos \(z_{1:T}\), la integración secuencial de los estados da

\[ \begin{aligned} \ell(V,W_0,W_1;\boldsymbol y,\boldsymbol z) &=\sum_{t=1}^T\log p(y_t\mid y_{1:t-1},z_{1:t},V,W_0,W_1)\\ &=-\frac12\sum_{t=1}^T \left\{\log(2\pi)+\log Q_t+\frac{e_t^2}{Q_t}\right\}, \end{aligned} \tag{14.26}\]

con \(e_t=y_t-f_t\). La verosimilitud es condicional a la trayectoria de covariables. En la implementación de la aplicación fijaremos \(W_0=10^{-4}\) y estimaremos \(V,W_1\) por máxima verosimilitud. Esto constituye una restricción explícita para evitar que tres varianzas poco identificables compitan por explicar la misma variabilidad; la constante fijada no debe confundirse con una estimación basada en datos.

Utilizaremos \(\log V\) y \(\log W_1\) como parámetros numéricos. La transformación garantiza positividad, pero la interpretación de un resultado muy próximo al límite inferior de \(W_1\) debe ser cuidadosa: puede indicar poca evidencia para una pendiente variable, o escasa información para identificar esa variación. Como en el capítulo 12, los errores estándar obtenidos de una curvatura local pueden ser poco fiables cerca de los límites.

14.7.2 Formulación bayesiana

Retomamos la estructura de la semana 13. Definimos \(\boldsymbol\psi=(V,W_1)\), fijamos \(W_0\) y especificamos distribuciones previas independientes

\[ V\sim\operatorname{IG}(a_V,b_V),\qquad W_1\sim\operatorname{IG}(a_W,b_W), \tag{14.27}\]

con la parametrización \(p(u)\propto u^{-a-1}\exp(-b/u)\), \(u>0\). Así, para \(a>1\), \(E(U)=b/(a-1)\). La distribución inicial normal del estado se considera fijada y conocida antes de observar la serie.

La posterior marginal de \(\boldsymbol\psi\), después de integrar los estados, satisface

\[ p(\boldsymbol\psi\mid\mathcal D_T) \propto p(y_{1:T}\mid z_{1:T},\boldsymbol\psi) \,p(V)\,p(W_1). \tag{14.28}\]

La primera componente se obtiene mediante Ecuación 14.26. Podemos simular de esta posterior con Metropolis–Hastings en las coordenadas \(\boldsymbol\xi=(\log V,\log W_1)\). El logaritmo de la densidad objetivo, salvo una constante, es

\[ \ell(e^{\xi_1},W_0,e^{\xi_2}) -a_V\xi_1-b_Ve^{-\xi_1} -a_W\xi_2-b_We^{-\xi_2}. \tag{14.29}\]

¿Por qué aparecen \(-a_V\xi_1\) y \(-a_W\xi_2\), en lugar de \(-(a+1)\xi\)? El cambio de variables introduce el jacobiano \(|d(e^\xi)/d\xi|=e^\xi\); ignorarlo produciría otra distribución posterior. Es un detalle importante cuando se muestrean parámetros estrictamente positivos en escala logarítmica.

Condicionalmente a una extracción de \(V,W_1\) y a \(\mathcal D_T\), el filtro proporciona

\[ \boldsymbol x_T\mid \mathcal D_T,\boldsymbol\psi \sim N_2(\boldsymbol m_T(\boldsymbol\psi), \boldsymbol C_T(\boldsymbol\psi)). \]

Se puede extraer \(\boldsymbol x_T\) y simular la evolución futura; para inferencia sobre toda la trayectoria \(\boldsymbol x_{0:T}\) se utiliza FFBS, tal como se estudió en el capítulo 13. El algoritmo aquí implementado no reconstruye la trayectoria histórica en cada iteración, porque el objetivo es la distribución predictiva y basta muestrear \(\boldsymbol x_T\).

14.7.3 La distribución predictiva posterior

La distribución predictiva bayesiana condicional en un escenario \(\boldsymbol z^*\) integra estados e hiperparámetros:

\[ \begin{aligned} p(y_{T+h}\mid\mathcal D_T,\boldsymbol z^*) ={}&\int p(y_{T+h}\mid\boldsymbol x_{T+h},V,\boldsymbol z^*)\\ &\quad\times p(\boldsymbol x_{T+h}\mid\mathcal D_T,\boldsymbol\psi) \,p(\boldsymbol\psi\mid\mathcal D_T) \,d\boldsymbol x_{T+h}\,d\boldsymbol\psi. \end{aligned} \tag{14.30}\]

Aquí se supone que el escenario externo no actualiza retroactivamente la posterior de los hiperparámetros ni aporta información adicional sobre los estados históricos. Esto es apropiado para escenarios considerados como condiciones de pronóstico bajo el modelo, pero no es una afirmación de que las futuras covariables sean exógenas en cualquier problema económico.

Si \(V,W_1\) se fijan en estimadores puntuales, se obtiene un pronóstico plug-in. Si se integran respecto de la posterior, aparece incertidumbre paramétrica adicional. La segunda construcción no garantiza por sí sola mejor desempeño: necesita diagnóstico MCMC y evaluación fuera de muestra.

14.8 Pronósticos bajo escenarios y propagación de incertidumbre

14.8.1 Tres situaciones informativas

Conviene distinguir los siguientes casos:

  1. Predictores futuros conocidos: el calendario, un feriado previamente establecido o una variable de intervención cuyo diseño futuro está especificado. Se puede pronosticar condicionalmente sin modelar esa trayectoria.
  2. Predictores futuros desconocidos: indicadores económicos o meteorológicos. Debemos pronosticarlos, tratarlos probabilísticamente o fijar valores hipotéticos.
  3. Escenarios: trayectorias supuestas (central, favorable, desfavorable) que expresan condiciones posibles, no necesariamente probabilidades sobre esas condiciones.

Las distinciones entre predicción ex ante, predicción ex post y pronóstico bajo escenarios se desarrollan en Hyndman y Athanasopoulos (2021), secciones 7.6 y 10.3. Evaluar el consumo de 2016 usando como covariable el ingreso efectivamente observado en 2016 sería un ejercicio ex post si ese ingreso no se conocía al emitir el pronóstico. No debemos reportarlo como evaluación ex ante.

14.8.2 Modelo probabilístico para el predictor futuro

En la aplicación consideraremos por simplicidad un AR(1) para el ingreso trimestral:

\[ Z_t=\mu_Z+\rho(Z_{t-1}-\mu_Z)+\nu_t, \quad |\rho|<1,\quad\nu_t\overset{\mathrm{iid}}{\sim}N(0,\sigma_Z^2). \tag{14.31}\]

Con parámetros conocidos,

\[ \begin{aligned} \mu_{Z,h}&=E(Z_{T+h}\mid\mathcal D_T) =\mu_Z+\rho^h(z_T-\mu_Z),\\ s^2_{Z,h}&=\operatorname{Var}(Z_{T+h}\mid\mathcal D_T) =\sigma_Z^2\sum_{j=0}^{h-1}\rho^{2j}. \end{aligned} \tag{14.32}\]

Para aplicar estas fórmulas supondremos que, condicional a la información disponible, la dinámica futura de \(Z_t\) puede modelarse separadamente del error futuro de consumo. Es una suposición de factorización predictiva, no una propiedad automática de dos series económicas. Una modelación conjunta multivariada podría captar realimentaciones y correlaciones contemporáneas que esta estrategia ignora.

14.8.3 Ley de varianza total

Para una trayectoria futura aleatoria \(\boldsymbol Z_{\mathrm{fut}}=(Z_{T+1},\ldots,Z_{T+H})^\top\), la distribución de interés sin fijar escenarios es

\[ p(y_{T+h}\mid\mathcal D_T) =\int p(y_{T+h}\mid\mathcal D_T,\boldsymbol z) \,p(\boldsymbol z\mid\mathcal D_T)\,d\boldsymbol z. \tag{14.33}\]

La ley de la varianza total implica

\[ \begin{aligned} \operatorname{Var}(Y_{T+h}\mid\mathcal D_T) ={}&E\!\left[\operatorname{Var}(Y_{T+h}\mid\mathcal D_T, \boldsymbol Z_{\mathrm{fut}})\mid\mathcal D_T\right]\\ &+\operatorname{Var}\!\left[E(Y_{T+h}\mid\mathcal D_T, \boldsymbol Z_{\mathrm{fut}})\mid\mathcal D_T\right]. \end{aligned} \tag{14.34}\]

El primer sumando promedia la variabilidad predictiva condicional; el segundo mide cuánto se mueven las medias de pronóstico al cambiar las covariables. Este segundo término es no negativo y desaparece únicamente cuando la media condicional no depende de la incertidumbre de los predictores.

14.8.4 Fórmula cerrada con pendiente constante

Si \(Y=\alpha+\beta Z+E\), con \(\beta\) conocido, \(E\) independiente de \(Z\) condicionalmente a \(\mathcal D_T\), y \(\operatorname{Var}(E\mid\mathcal D_T)=s_E^2\), entonces

\[ E(Y\mid\mathcal D_T)=\alpha+\beta\mu_Z, \qquad \operatorname{Var}(Y\mid\mathcal D_T)=s_E^2+\beta^2s_Z^2. \tag{14.35}\]

Si las distribuciones de \(Z\) y \(E\) son gaussianas independientes, la distribución resultante también es gaussiana. En la aplicación usaremos esta identidad como aproximación plug-in para la regresión con errores AR(1): reemplazaremos \(\beta,s_E^2,s_Z^2\) por valores estimados en cada origen. La aproximación no incluye incertidumbre sobre esos parámetros ni posibles covarianzas futuras entre los errores de las dos ecuaciones.

14.8.5 Fórmula cerrada con pendiente aleatoria

El resultado es más interesante para un DLM. Al origen \(T\) y con \(V,W_0,W_1\) fijos, sea

\[ \boldsymbol x_{T+h}\mid\mathcal D_T\sim N_2(\boldsymbol m_T,A_h),\qquad A_h=\boldsymbol C_T+h\boldsymbol W. \]

Supongamos que \(Z_{T+h}\) es independiente de \(\boldsymbol x_{T+h}\) condicionalmente a \(\mathcal D_T\), con media \(\mu_{Z,h}\) y varianza \(s^2_{Z,h}\). Entonces

\[ E(Y_{T+h}\mid\mathcal D_T) =m_{0,T}+m_{1,T}\mu_{Z,h}, \tag{14.36}\]

mientras que

\[ \boxed{\begin{aligned} \operatorname{Var}(Y_{T+h}\mid\mathcal D_T) ={}&V+(A_h)_{00}+2\mu_{Z,h}(A_h)_{01} +\mu_{Z,h}^2(A_h)_{11}\\ &+s_{Z,h}^2\left\{m_{1,T}^2+(A_h)_{11}\right\}. \end{aligned}} \tag{14.37}\]

Los índices \(00,01,11\) identifican entradas de la matriz de covarianza correspondientes a intercepto y pendiente. Para demostrarla, escribamos \(Y=\beta_0+\beta_1 Z+v\) y apliquemos \(\operatorname{Var}(Y)=E[\operatorname{Var}(Y\mid Z)]+\operatorname{Var}(E[Y\mid Z])\):

\[ \begin{aligned} E[\operatorname{Var}(Y\mid Z)] &=V+(A_h)_{00}+2\mu_{Z,h}(A_h)_{01} +(\mu_{Z,h}^2+s_{Z,h}^2)(A_h)_{11},\\ \operatorname{Var}(E[Y\mid Z]) &=m_{1,T}^2s_{Z,h}^2. \end{aligned} \]

La suma reproduce Ecuación 14.37. El término adicional no es simplemente \(m_{1,T}^2s_Z^2\): también aparece \(s_Z^2(A_h)_{11}\) porque la pendiente es incierta. Para predictores futuros no gaussianos o para coeficientes gaussianos multiplicados por predictores aleatorios, la distribución integrada puede dejar de ser normal aunque sus dos primeros momentos tengan esta forma.

14.8.6 Qué se está condicionando

Comparar dos escenarios \(\boldsymbol z^{(A)}\) y \(\boldsymbol z^{(B)}\) equivale a comparar

\[ p(Y_{T+h}\mid\mathcal D_T,\boldsymbol z^{(A)}) \quad\text{y}\quad p(Y_{T+h}\mid\mathcal D_T,\boldsymbol z^{(B)}). \]

Sin un modelo probabilístico que asigne pesos a los escenarios, estas distribuciones no deben promediarse automáticamente como si fuesen una mezcla predictiva. Asimismo, un cambio en el pronóstico condicionado al ingreso no equivale necesariamente al efecto causal de una política que modifique el ingreso: una intervención puede alterar simultáneamente otras relaciones del sistema.

14.9 Aplicación: consumo e ingreso trimestral en Estados Unidos

14.9.1 Datos y pregunta predictiva

Utilizaremos us_change, incluido en el paquete fpp3 (Hyndman y Athanasopoulos 2021). Son variaciones porcentuales trimestrales de indicadores estadounidenses, disponibles en el período 1970 T1–2019 T2. Para el ejercicio seleccionamos consumo personal (Consumption) e ingreso personal disponible (Income). El ejemplo se relaciona con el capítulo 10 de Hyndman y Athanasopoulos (2021), pero los procedimientos de estimación y evaluación que siguen son una elaboración pedagógica propia.

La pregunta predictiva es la siguiente: ¿se mejora el pronóstico de la variación trimestral del consumo utilizando el ingreso, y cómo cambian los intervalos cuando el ingreso futuro no se considera conocido?

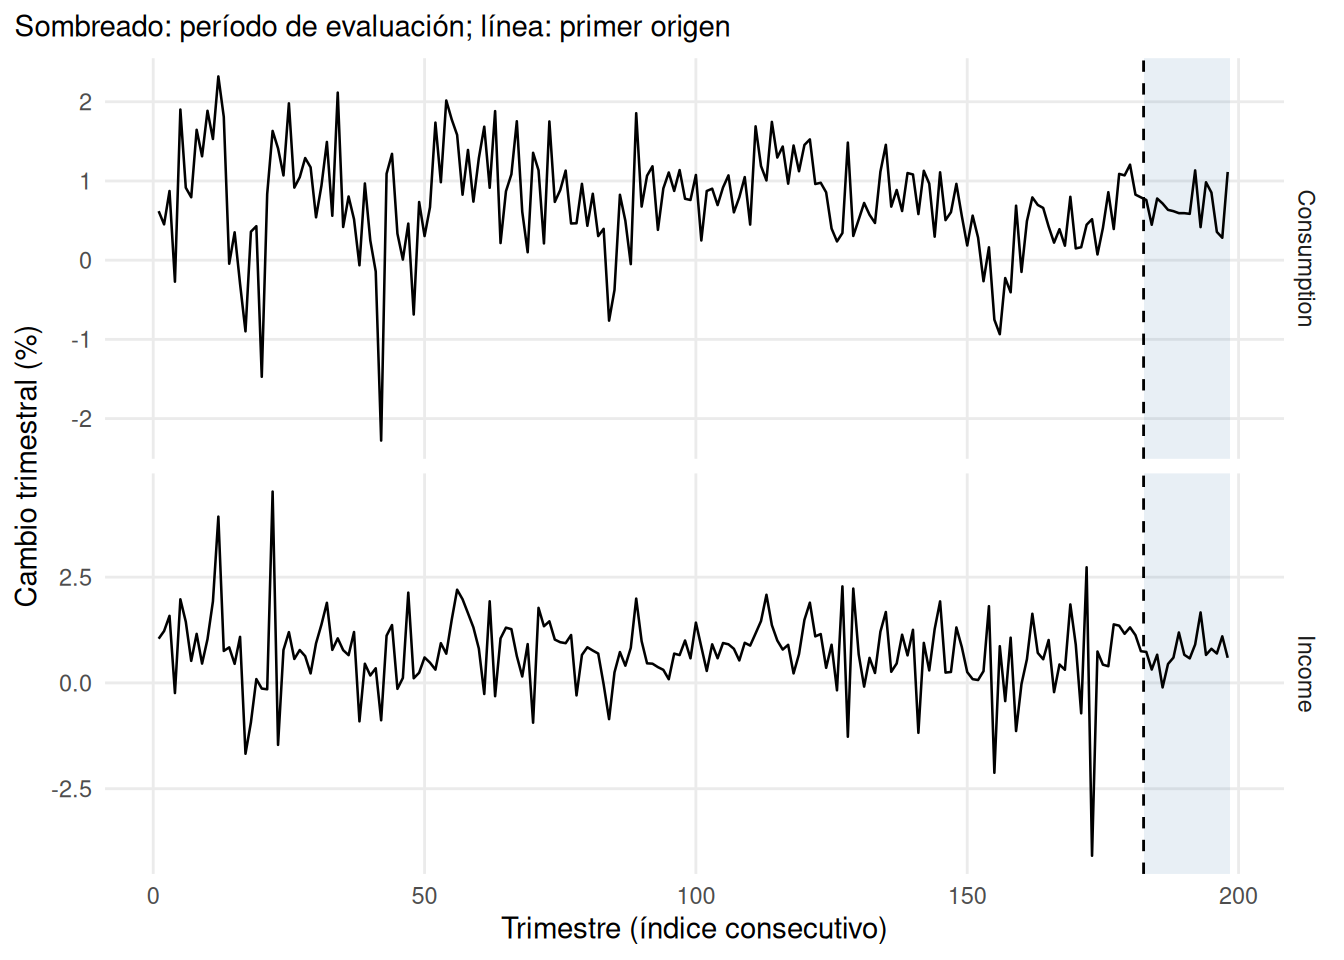
Separaremos los últimos 16 trimestres de la muestra. Dentro de este período compararemos un origen fijo a cuatro pasos y varios orígenes expansivos. Todos los parámetros se reestiman usando únicamente observaciones anteriores o iguales a cada origen.

us_regdin <- fpp3::us_change |>
  as_tibble() |>
  select(Quarter, Consumption, Income) |>
  arrange(Quarter) |>
  mutate(t = row_number())

stopifnot(
  nrow(us_regdin) >= 100L,
  !anyNA(us_regdin$Consumption), !anyNA(us_regdin$Income),
  all(is.finite(us_regdin$Consumption)),
  all(is.finite(us_regdin$Income)),
  !anyDuplicated(us_regdin$Quarter),
  nrow(us_regdin) == nrow(fpp3::us_change)
)

n_total_regdin <- nrow(us_regdin)
n_ent_regdin <- n_total_regdin - 16L
H_regdin <- 4L
ent_regdin <- us_regdin |> slice_head(n = n_ent_regdin)
prueba_regdin <- us_regdin |> slice_tail(n = 16L)

stopifnot(nrow(ent_regdin) + nrow(prueba_regdin) == n_total_regdin,
          max(ent_regdin$t) < min(prueba_regdin$t),
          nrow(prueba_regdin) >= H_regdin)

tibble(
  bloque = c('Entrenamiento inicial', 'Prueba reservada'),
  inicio = c(as.character(first(ent_regdin$Quarter)),
             as.character(first(prueba_regdin$Quarter))),
  fin = c(as.character(last(ent_regdin$Quarter)),
          as.character(last(prueba_regdin$Quarter))),
  observaciones = c(nrow(ent_regdin), nrow(prueba_regdin))
) |>
  kable()
Tabla 14.3: Extensión temporal de los datos y partición cronológica inicial.
bloque inicio fin observaciones
Entrenamiento inicial 1970 Q1 2015 Q2 182
Prueba reservada 2015 Q3 2019 Q2 16
us_regdin |>
  select(t, Consumption, Income) |>
  pivot_longer(-t, names_to = 'variable', values_to = 'valor') |>
  ggplot(aes(t, valor)) +
  annotate('rect', xmin = n_ent_regdin + 0.5,
           xmax = n_total_regdin + 0.5,
           ymin = -Inf, ymax = Inf, alpha = 0.12,
           fill = 'steelblue') +
  geom_line(linewidth = 0.45) +
  geom_vline(xintercept = n_ent_regdin + 0.5, linetype = 'dashed') +
  facet_grid(vars(variable), scales = 'free_y') +
  labs(x = 'Trimestre (índice consecutivo)', y = 'Cambio trimestral (%)',
       subtitle = 'Sombreado: período de evaluación; línea: primer origen') +
  tema_regdin
Figura 14.6: Variaciones porcentuales trimestrales del consumo y del ingreso en Estados Unidos. La zona sombreada corresponde a la prueba final.

Las variables se expresan como cambios porcentuales, no como niveles. Esto evita parte de la dificultad de regresiones espurias entre niveles tendenciales, aunque no garantiza estacionariedad, exogeneidad, estabilidad estructural ni ausencia de atípicos. La naturaleza contemporánea del predictor es importante: al final de un trimestre futuro, el ingreso correspondiente puede no conocerse al momento de emitir un pronóstico de consumo.

14.9.2 Modelos candidatos

Compararemos cuatro procedimientos, todos definidos antes de inspeccionar el conjunto de prueba:

Etiqueta Procedimiento Forma de tratar el ingreso futuro
M0 AR(1) univariado para consumo No lo utiliza
M1 Regresión con coeficiente constante y error AR(1) Pronóstico AR(1) del ingreso
M2 DLM de intercepto casi constante y pendiente evolutiva, estimado por MV Pronóstico AR(1) del ingreso
M3 Mismo DLM, con posterior para \(V,W_1\) por MH Simulación de trayectorias de ingreso AR(1)

Para M2 y M3 fijamos \(W_0=10^{-4}\), \(\boldsymbol m_0=(0,0)^\top\) y \(\boldsymbol C_0=\operatorname{diag}(9,2.25)\). El valor \(W_0\) es un supuesto de modelación, no una estimación; evita introducir una tercera varianza difícil de identificar. El intercepto no es estrictamente constante, pero su innovación de estado tiene desviación estándar \(0.01\) por trimestre.

La comparación se centra deliberadamente en errores AR(1) y en un modelo dinámico con pendiente de caminata aleatoria; no pretende ser una búsqueda exhaustiva de órdenes ARIMA o estructuras DLM. La limitación resulta útil para identificar cómo cada diferencia estructural afecta el pronóstico.

14.9.3 Estimación en el entrenamiento inicial

Y_ent <- ent_regdin$Consumption
Z_ent <- ent_regdin$Income

m0_regdin <- ajustar_ar1(Y_ent)
m1_regdin <- ajustar_reg_ar1(Y_ent, Z_ent)
m2_regdin <- ajustar_dlm_mv(Y_ent, Z_ent)
mz_regdin <- ajustar_ar1(Z_ent)

stopifnot(is.finite(m0_regdin$loglik),
          is.finite(m1_regdin$loglik),
          is.finite(m2_regdin$logver),
          all(is.finite(m2_regdin$filtro$mT)))

tibble(
  procedimiento = c('M0: AR(1) consumo',
                    'M1: regresión + AR(1)',
                    'M2: DLM-MV',
                    'AR(1) ingreso (auxiliar)'),
  parametro = c('phi', 'beta_ingreso', 'W1', 'rho'),
  estimacion = c(unname(m0_regdin$coef['ar1']),
                 unname(m1_regdin$coef['Income']),
                 m2_regdin$W1,
                 unname(mz_regdin$coef['ar1']))
) |>
  mutate(estimacion = signif(estimacion, 4)) |>
  kable()
Tabla 14.4: Ajustes iniciales: coeficientes del AR(1) del consumo, regresión con error AR(1) y varianzas del DLM por MV.
procedimiento parametro estimacion
M0: AR(1) consumo phi 0.3312000
M1: regresión + AR(1) beta_ingreso 0.1941000
M2: DLM-MV W1 0.0003716
AR(1) ingreso (auxiliar) rho -0.1266000

El ajuste del modelo M1 no debe confundirse con el del AR(1) de ingreso: este último se estima para generar una trayectoria futura ex ante de la covariable. En la regresión con errores AR(1), \(\beta_1\) mide la relación contemporánea a efectos del modelo. Como el ingreso no está aleatorizado y puede estar correlacionado con perturbaciones de consumo, no lo interpretaremos como efecto causal.

14.9.4 Implementación equivalente en fable

La función ARIMA() de fable permite incluir regresores en la fórmula. El siguiente ejemplo reproduce la clase de modelo M1 (un error AR(1) no estacional con covariable), pero sus estimaciones numéricas pueden diferir ligeramente de stats::arima() por opciones de inicialización, parametrización y optimización; no imponemos que ambas implementaciones den valores idénticos.

train_ts_regdin <- fpp3::us_change |>
  filter(Quarter <= last(ent_regdin$Quarter))

ajuste_fable_regdin <- train_ts_regdin |>
  model(reg_ar1 = ARIMA(
    Consumption ~ Income + pdq(1, 0, 0) + PDQ(0, 0, 0)
  ))

# No seleccionar campos internos sujetos a cambios (p. ej. sigma2);
# la tabla de coeficientes estandarizada es más estable.
ajuste_fable_regdin |>
  tidy() |>
  as_tibble() |>
  select(.model, term, estimate) |>
  mutate(estimate = round(estimate, 4)) |>
  kable()
Tabla 14.5: Verificación del flujo de regresión con errores AR(1) mediante fable.
.model term estimate
reg_ar1 ar1 0.2118
reg_ar1 Income 0.1941
reg_ar1 intercept 0.6064

A diferencia de una regresión estática, no basta introducir el futuro de la covariable a fable sin considerar de dónde procede. Más adelante construiremos new_data exclusivamente con predicciones del ingreso realizadas al origen.

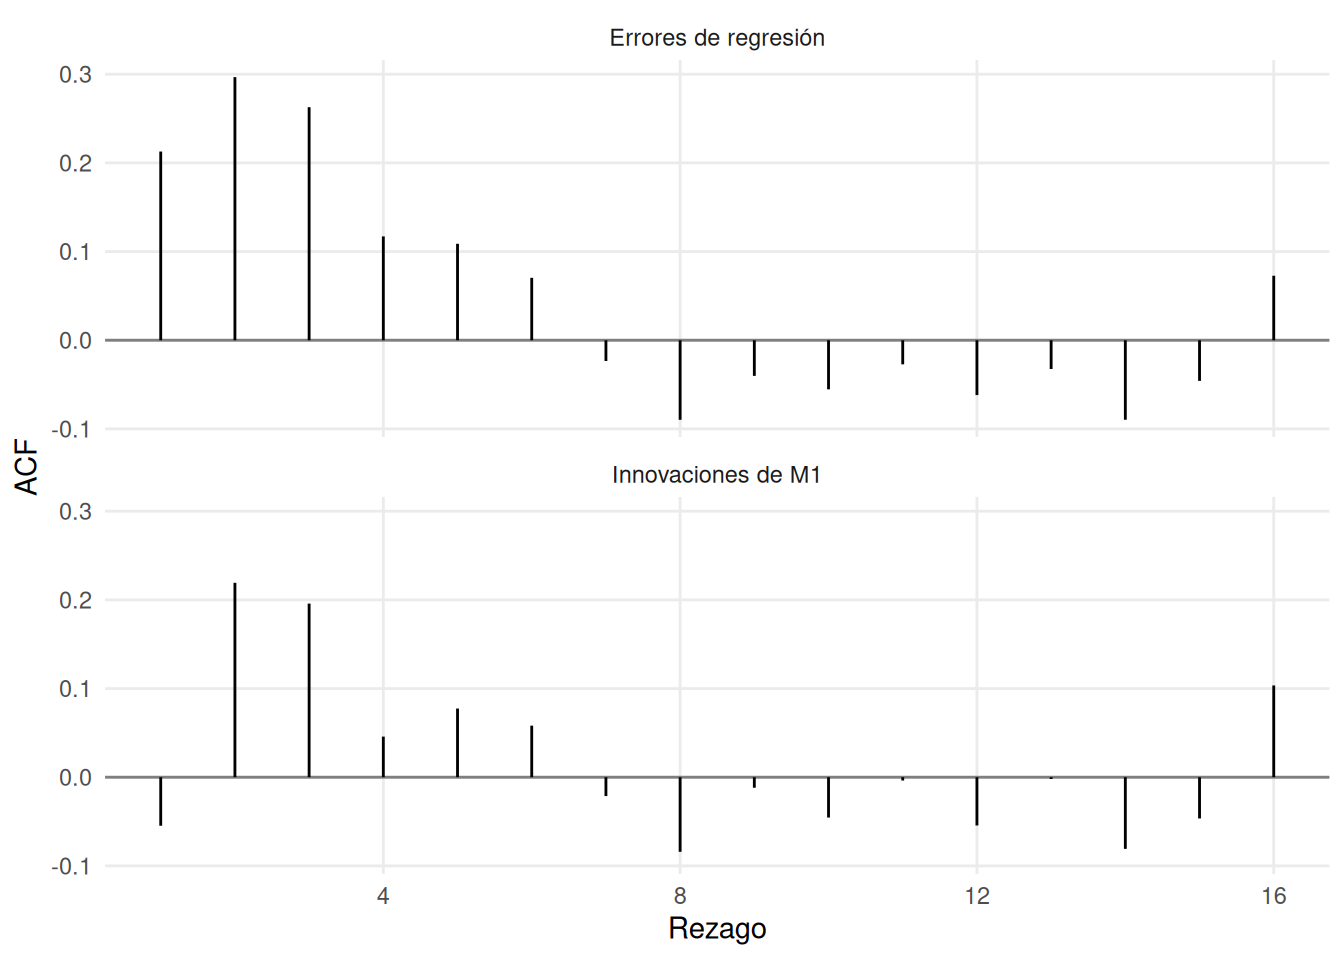
14.9.5 Diagnóstico de innovaciones y de la regresión

El residuo de la ecuación de regresión estimada por M1 puede reconstruirse con sus coeficientes:

\[ \widehat\eta_t=y_t-\widehat\beta_0-\widehat\beta_1z_t. \]

En cambio, residuals() para el objeto stats::arima representa innovaciones aproximadas de su modelo de error. Compararemos ambos para observar si queda dependencia serial.

beta0_m1 <- unname(m1_regdin$coef['intercept'])
beta1_m1 <- unname(m1_regdin$coef['Income'])
eta_m1 <- Y_ent - beta0_m1 - beta1_m1 * Z_ent
innov_m1 <- as.numeric(residuals(m1_regdin)) / sqrt(m1_regdin$sigma2)

acf_eta <- as.numeric(stats::acf(eta_m1, lag.max = 16, plot = FALSE)$acf)[-1L]
acf_innov <- as.numeric(stats::acf(innov_m1, lag.max = 16, plot = FALSE)$acf)[-1L]
bind_rows(
  tibble(rezago = seq_along(acf_eta), valor = acf_eta,
         tipo = 'Errores de regresión'),
  tibble(rezago = seq_along(acf_innov), valor = acf_innov,
         tipo = 'Innovaciones de M1')
) |>
  ggplot(aes(rezago, valor)) +
  geom_hline(yintercept = 0, colour = 'grey50') +
  geom_segment(aes(xend = rezago, yend = 0)) +
  facet_wrap(vars(tipo), ncol = 1) +
  labs(x = 'Rezago', y = 'ACF') +
  tema_regdin
Figura 14.7: ACF de errores de regresión estimados y de innovaciones estandarizadas del modelo M1, calculadas únicamente en entrenamiento.
innov_m2 <- m2_regdin$filtro$e / sqrt(m2_regdin$filtro$Q)

# En el AR(1) del error se estima 1 parámetro de correlación:
# fitdf=1 aproxima la corrección de grados de libertad usual.
# Para el DLM con hiperparámetros estimados no existe una corrección
# universal de grados de libertad: mostramos un diagnóstico descriptivo.
lb_m1 <- Box.test(innov_m1, lag = 12, type = 'Ljung-Box', fitdf = 1)
lb_m2 <- Box.test(innov_m2, lag = 12, type = 'Ljung-Box', fitdf = 0)
tibble(
  modelo = c('M1: AR(1) en error', 'M2: DLM-MV'),
  estadistico = c(unname(lb_m1$statistic), unname(lb_m2$statistic)),
  gl_referencia = c(unname(lb_m1$parameter), unname(lb_m2$parameter)),
  p_valor_referencia = c(lb_m1$p.value, lb_m2$p.value)
) |>
  mutate(across(where(is.numeric), ~ signif(.x, 4))) |>
  kable()
Tabla 14.6: Ljung–Box de las innovaciones de M1 y del DLM-MV; resultados exploratorios sujetos a la estimación de parámetros.
modelo estadistico gl_referencia p_valor_referencia
M1: AR(1) en error 21.31 11 0.03031
M2: DLM-MV 24.81 12 0.01573

Los valores \(p\) sirven como señales de diagnóstico, no como demostración de adecuación del DLM; los grados de libertad de Ljung–Box en modelos de espacio-estado con hiperparámetros estimados no se reducen necesariamente al número de varianzas. También deben examinarse heterocedasticidad, atípicos y cambios estructurales.

14.9.6 Coeficientes filtrados y bandas

filtro_m2 <- m2_regdin$filtro
estados_real <- tibble(
  t = ent_regdin$t,
  beta1 = filtro_m2$m[-1L, 2L],
  desviacion = sqrt(filtro_m2$C[2L, 2L, -1L])
) |>
  mutate(inferior = beta1 - 1.96 * desviacion,
         superior = beta1 + 1.96 * desviacion)

ggplot(estados_real, aes(t, beta1)) +
  geom_ribbon(aes(ymin = inferior, ymax = superior),
              fill = 'steelblue', alpha = 0.18) +
  geom_line(colour = 'steelblue', linewidth = 0.65) +
  geom_hline(yintercept = beta1_m1, linetype = 'dashed',
             colour = 'firebrick') +
  labs(x = 'Trimestre (índice consecutivo)',
       y = 'Coeficiente del ingreso',
       subtitle = 'Línea discontinua: coeficiente constante de M1') +
  tema_regdin
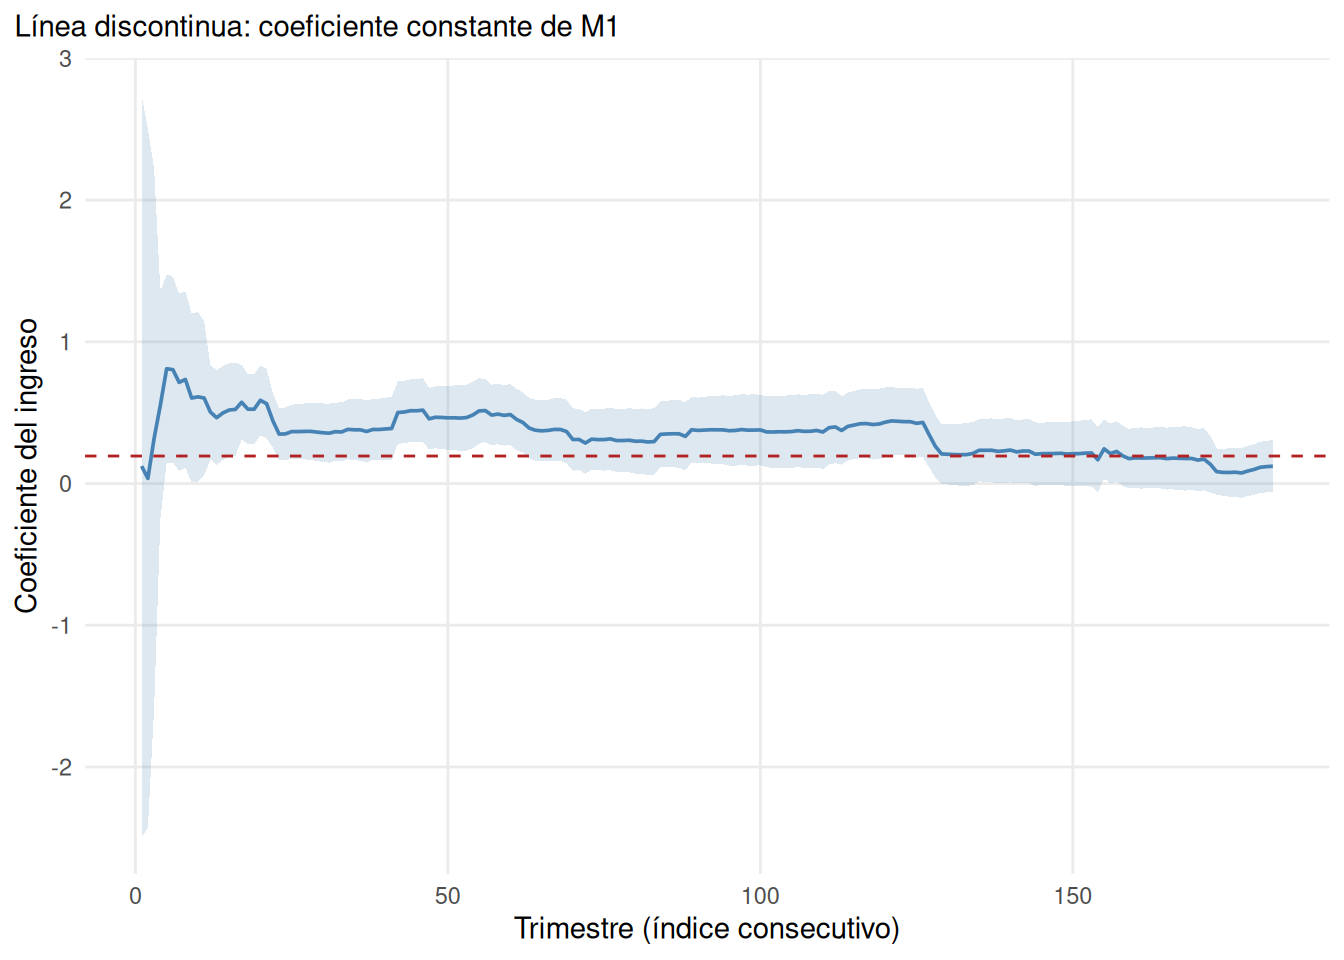
Figura 14.8: Pendiente de ingreso sobre consumo estimada secuencialmente por el DLM-MV, con intervalos puntuales del 95% condicionados en las varianzas estimadas.

La banda es condicional en los hiperparámetros ajustados por MV. La evolución visible de la pendiente debe interpretarse teniendo en cuenta la amplitud de la banda y la restricción sobre \(W_0\). No podemos concluir, solo a partir de la línea estimada, que existe un cambio real estadísticamente distinguible de una pendiente constante.

14.10 Escenarios y pronóstico de origen fijo

14.10.1 Ingreso pronosticado y tres escenarios

Para los próximos cuatro trimestres, el escenario central será la media condicional del AR(1) del ingreso, estimado exclusivamente en entrenamiento. Los escenarios favorable y desfavorable tendrán una diferencia aditiva de \(0.6\) desviaciones estándar históricas del ingreso respecto del central. Esto es una elección didáctica explícita, no una predicción del estado de la economía ni una probabilidad asignada a cada escenario.

pred_ingreso_fijo <- stats::predict(mz_regdin, n.ahead = H_regdin)
mu_z_fijo <- as.numeric(pred_ingreso_fijo$pred)
var_z_fijo <- as.numeric(pred_ingreso_fijo$se)^2
delta_escenario <- 0.6 * sd(Z_ent)

escenarios_fijos <- tibble(
  h = rep(seq_len(H_regdin), times = 3L),
  escenario = rep(c('Desfavorable', 'Central', 'Favorable'),
                  each = H_regdin),
  z = c(mu_z_fijo - delta_escenario,
        mu_z_fijo,
        mu_z_fijo + delta_escenario),
  t = n_ent_regdin + h
)

escenarios_fijos |>
  transmute(
    trimestre = as.character(us_regdin$Quarter[t]),
    escenario, ingreso_hipotetico = round(z, 3)
  ) |>
  pivot_wider(names_from = escenario, values_from = ingreso_hipotetico) |>
  kable()
Tabla 14.7: Trayectorias trimestrales de ingreso supuestas para tres escenarios, construidas únicamente con información del entrenamiento.
trimestre Desfavorable Central Favorable
2015 Q3 0.166 0.726 1.286
2015 Q4 0.169 0.729 1.289
2016 Q1 0.169 0.729 1.288
2016 Q2 0.169 0.729 1.288

14.10.2 Pronóstico condicional con fable

fable exige declarar el valor futuro de la covariable al pronosticar una regresión con errores ARIMA. Por ejemplo, podemos usar exactamente la trayectoria central calculada desde el origen, sin consultar los ingresos observados en la prueba:

nuevo_fable_regdin <- new_data(train_ts_regdin, H_regdin) |>
  mutate(Income = mu_z_fijo)

forecast(ajuste_fable_regdin, new_data = nuevo_fable_regdin) |>
  as_tibble() |>
  select(Quarter, .model, .mean) |>
  mutate(.mean = round(.mean, 3)) |>
  kable()
Tabla 14.8: Pronóstico condicionado de consumo con fable, utilizando valores del ingreso pronosticados al origen.
Quarter .model .mean
2015 Q3 reg_ar1 0.756
2015 Q4 reg_ar1 0.750
2016 Q1 reg_ar1 0.748
2016 Q2 reg_ar1 0.748

La columna .mean corresponde a la media predictiva condicional del modelo fable que se ajustó en entrenamiento. Sus intervalos habituales no incluyen la incertidumbre de la predicción de Income. Para ello se requiere una integración posterior como la que construimos a continuación con modelos clásicos y DLM.

14.10.3 Pronósticos de regresión y DLM condicionados

result_esc <- purrr::map_dfr(
  c('Desfavorable', 'Central', 'Favorable'),
  function(esc) {
    zf <- escenarios_fijos |>
      filter(escenario == esc) |>
      arrange(h) |>
      pull(z)
    tabla_m1 <- pronosticar_reg_ar1(m1_regdin, zf) |>
      resumir_normal_regdin() |>
      mutate(modelo = 'M1: coeficientes fijos')
    tabla_m2 <- pronosticar_dlm_cond(filtro_m2, zf) |>
      resumir_normal_regdin() |>
      mutate(modelo = 'M2: coeficientes dinámicos')
    bind_rows(tabla_m1, tabla_m2) |>
      mutate(escenario = esc, t = n_ent_regdin + h)
  }
)

# La figura usa bandas independientes por modelo y escenario. El tramo
# observado permanece visualmente separado del futuro pronosticado.
ggplot() +
  geom_line(data = us_regdin |> filter(t >= n_ent_regdin - 19L,
                                        t <= n_ent_regdin),
            aes(t, Consumption), colour = 'grey35', linewidth = 0.55) +
  geom_ribbon(data = result_esc,
              aes(t, ymin = inferior, ymax = superior, fill = escenario),
              alpha = 0.14) +
  geom_line(data = result_esc,
            aes(t, media, colour = escenario), linewidth = 0.8) +
  geom_point(data = us_regdin |>
               filter(t > n_ent_regdin, t <= n_ent_regdin + H_regdin),
             aes(t, Consumption), shape = 16, size = 1.8) +
  geom_vline(xintercept = n_ent_regdin + 0.5, linetype = 'dashed') +
  facet_wrap(vars(modelo), ncol = 1) +
  labs(x = 'Trimestre (índice consecutivo)',
       y = 'Variación del consumo (%)',
       colour = 'Escenario', fill = 'Escenario',
       subtitle = 'Línea gris: entrenamiento; puntos negros: prueba observada') +
  tema_regdin
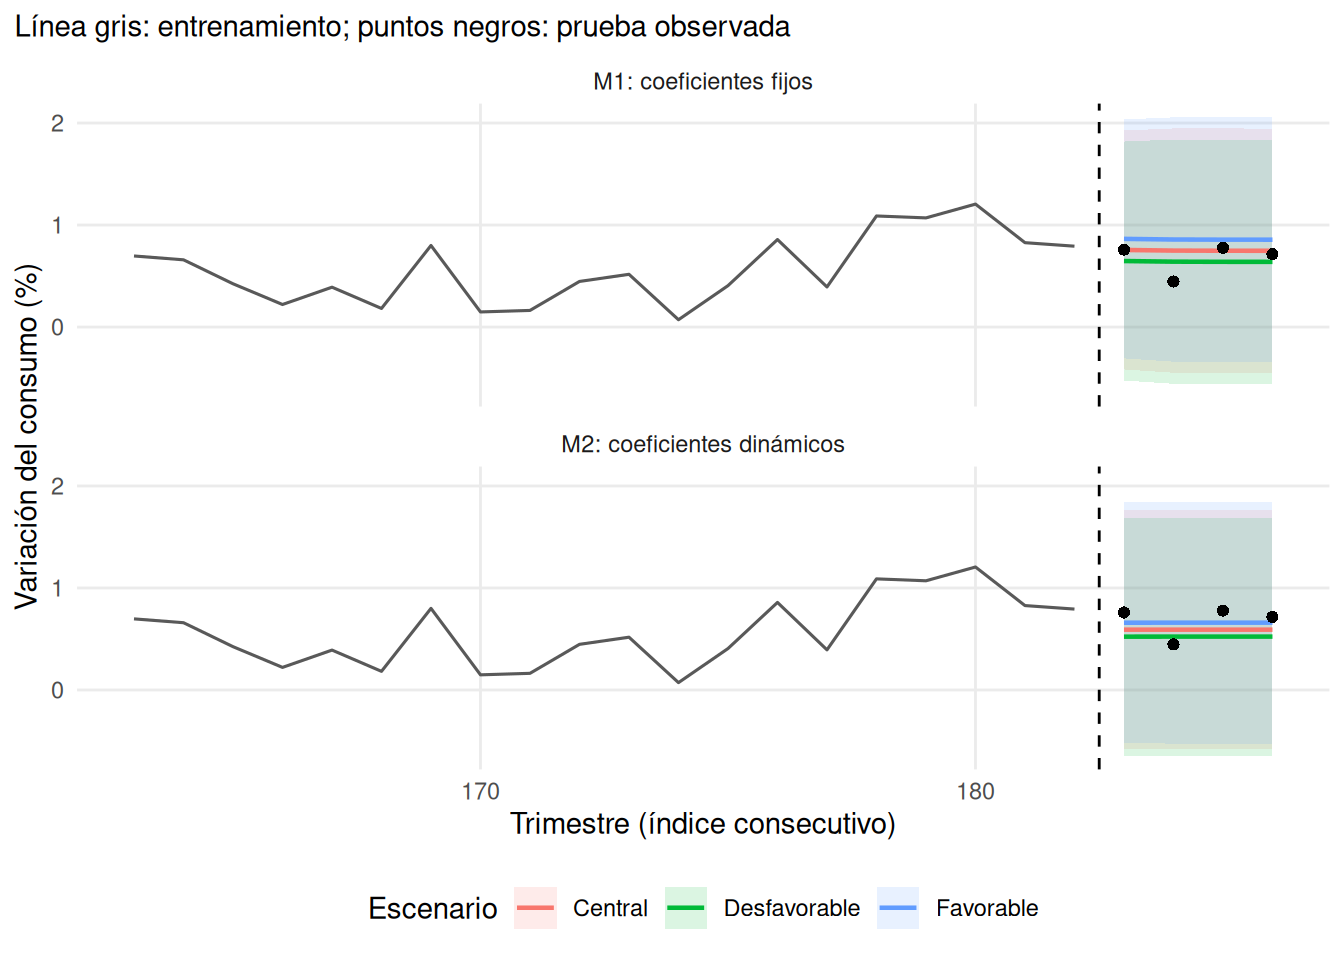
Figura 14.9: Pronósticos del consumo con intervalos condicionales del 95% bajo tres escenarios de ingreso; comparación M1 (regresión con errores AR(1)) y M2 (DLM-MV).

En cada panel las bandas cuantifican incertidumbre sobre el consumo dado el escenario de ingreso y parámetros sustituidos por estimaciones puntuales. En consecuencia, las bandas no deben confundirse con la incertidumbre de que el escenario favorable, central o desfavorable llegue a ocurrir.

14.10.4 El efecto de integrar la incertidumbre del ingreso

Para M1, con pendiente fija estimada \(\widehat\beta_1\), combinaremos la varianza condicional de predict() con \(\widehat\beta_1^2\widehat s_{Z,h}^2\), aplicando Ecuación 14.35. Para M2 utilizaremos exactamente Ecuación 14.37, bajo la hipótesis de independencia condicional entre el AR(1) futuro del ingreso y la evolución de los estados.

m1_cond_central <- pronosticar_reg_ar1(m1_regdin, mu_z_fijo) |>
  resumir_normal_regdin() |>
  mutate(modelo = 'M1', tratamiento = 'Ingreso fijado')
m1_integrado <- pronosticar_reg_ar1(m1_regdin, mu_z_fijo) |>
  mutate(varianza = varianza + beta1_m1^2 * var_z_fijo) |>
  resumir_normal_regdin() |>
  mutate(modelo = 'M1', tratamiento = 'Ingreso aleatorio')

m2_cond_central <- pronosticar_dlm_cond(filtro_m2, mu_z_fijo) |>
  resumir_normal_regdin() |>
  mutate(modelo = 'M2', tratamiento = 'Ingreso fijado')
m2_integrado <- pronosticar_dlm_integrado(filtro_m2,
                                          mu_z_fijo, var_z_fijo) |>
  resumir_normal_regdin() |>
  mutate(modelo = 'M2', tratamiento = 'Ingreso aleatorio')

tabla_propagacion <- bind_rows(
  m1_cond_central, m1_integrado,
  m2_cond_central, m2_integrado
)

tabla_propagacion |>
  select(modelo, tratamiento, h, media, amplitud) |>
  mutate(across(c(media, amplitud), ~ round(.x, 3))) |>
  kable()
Tabla 14.9: Comparación de amplitudes de intervalos del 95% al fijar el ingreso en su media futura frente a integrar la incertidumbre del AR(1) del ingreso.
modelo tratamiento h media amplitud
M1 Ingreso fijado 1 0.756 2.343
M1 Ingreso fijado 2 0.750 2.395
M1 Ingreso fijado 3 0.748 2.397
M1 Ingreso fijado 4 0.748 2.397
M1 Ingreso aleatorio 1 0.756 2.446
M1 Ingreso aleatorio 2 0.750 2.497
M1 Ingreso aleatorio 3 0.748 2.499
M1 Ingreso aleatorio 4 0.748 2.499
M2 Ingreso fijado 1 0.591 2.340
M2 Ingreso fijado 2 0.591 2.341
M2 Ingreso fijado 3 0.591 2.342
M2 Ingreso fijado 4 0.591 2.343
M2 Ingreso aleatorio 1 0.591 2.407
M2 Ingreso aleatorio 2 0.591 2.410
M2 Ingreso aleatorio 3 0.591 2.412
M2 Ingreso aleatorio 4 0.591 2.414

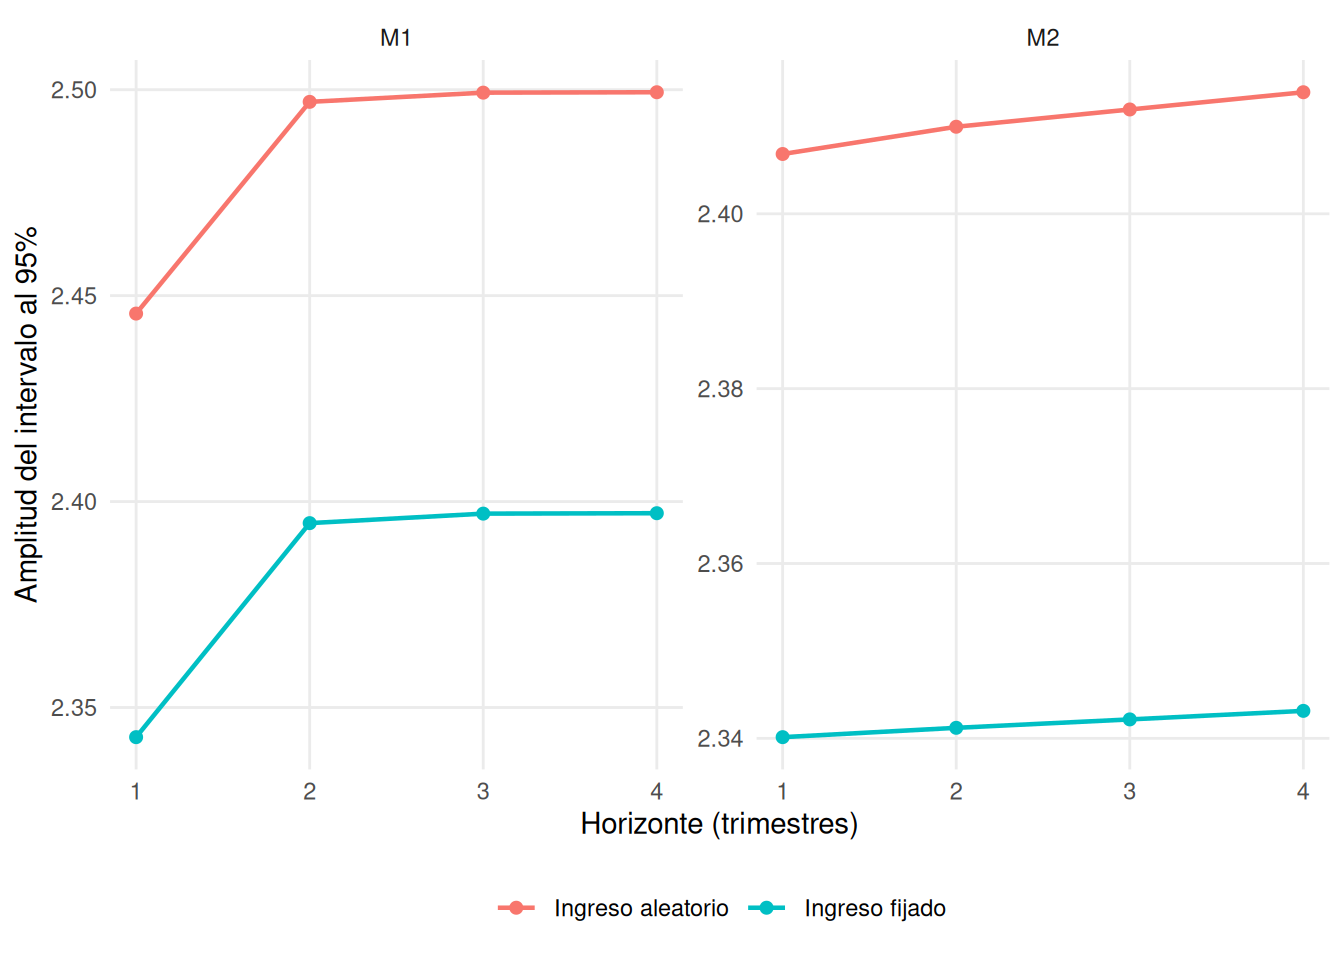
Precisión importante: la inflación de varianza que acabamos de calcular proviene únicamente de considerar aleatoria la trayectoria futura de ingreso dentro del modelo AR(1) ajustado. No incluye incertidumbre sobre los parámetros del AR(1) de ingreso, sobre la especificación de su dinámica ni sobre una posible covarianza con los shocks de consumo. El caso M2 tampoco incluye todavía incertidumbre sobre \(V\) y \(W_1\).

14.10.5 Visualización comparativa del intervalo

tabla_propagacion |>
  ggplot(aes(h, amplitud, colour = tratamiento)) +
  geom_line(linewidth = 0.8) +
  geom_point(size = 1.8) +
  facet_wrap(vars(modelo), scales = 'free_y') +
  scale_x_continuous(breaks = seq_len(H_regdin)) +
  labs(x = 'Horizonte (trimestres)',
       y = 'Amplitud del intervalo al 95%',
       colour = NULL) +
  tema_regdin
Figura 14.10: Aumento de la amplitud del intervalo predictivo al integrar incertidumbre de ingreso futuro. Se comparan M1 y M2 bajo el mismo AR(1) para ingreso.

Bajo las hipótesis utilizadas, la varianza integrada no puede ser menor que la correspondiente a fijar el ingreso en su media. El efecto sobre una amplitud de intervalo depende de la sensibilidad al ingreso y de su incertidumbre, y puede ser casi nulo si la pendiente es pequeña o el AR(1) pronostica el ingreso con gran precisión.

14.11 Inferencia bayesiana y distribución predictiva del DLM

14.11.1 Muestreo posterior con dos cadenas

Para M3 utilizaremos \(V\sim\operatorname{IG}(3,0.6)\) y \(W_1\sim\operatorname{IG}(3,0.02)\), independientes. Con la convención de Ecuación 14.27, sus medias previas son \(0.3\) y \(0.01\), respectivamente. Estos valores expresan supuestos de escala orientativos, no conocimiento empírico externo sobre la economía estadounidense. Es indispensable contrastarlos con el rango de los datos y realizar sensibilidad si las conclusiones dependieran de ellos.

Ajustamos dos cadenas de MH marginal: las trayectorias latentes históricas están integradas en la verosimilitud de Kalman. Muestreamos \(V\) y \(W_1\) por separado del estado terminal, que se recuperará después para el pronóstico. El bloque se almacena en caché para no ejecutar MCMC al modificar texto o figuras independientes.

mh_regdin_1 <- muestrear_mh_regdin(
  Y_ent, Z_ent, n_iter = 1200L, burn = 400L, thin = 2L,
  semilla = 41411L, init = c(0.25, 0.005)
)
mh_regdin_2 <- muestrear_mh_regdin(
  Y_ent, Z_ent, n_iter = 1200L, burn = 400L, thin = 2L,
  semilla = 41412L, init = c(0.55, 0.025)
)

posterior_regdin <- bind_rows(
  mh_regdin_1$draws |> mutate(cadena = 'Cadena 1'),
  mh_regdin_2$draws |> mutate(cadena = 'Cadena 2')
)

# Arreglo: iteración x cadena x parámetro (convención del paquete posterior).
n_kept_regdin <- nrow(mh_regdin_1$draws)
draws_array_regdin <- array(
  NA_real_, dim = c(n_kept_regdin, 2L, 2L),
  dimnames = list(NULL, c('cadena_1', 'cadena_2'), c('V', 'W1'))
)
draws_array_regdin[, 1L, 1L] <- mh_regdin_1$draws$V
draws_array_regdin[, 2L, 1L] <- mh_regdin_2$draws$V
draws_array_regdin[, 1L, 2L] <- mh_regdin_1$draws$W1
draws_array_regdin[, 2L, 2L] <- mh_regdin_2$draws$W1

diagnostico_regdin <- posterior::summarise_draws(
  posterior::as_draws_array(draws_array_regdin),
  mean = base::mean, sd = stats::sd,
  rhat = posterior::rhat,
  ess_bulk = posterior::ess_bulk,
  ess_tail = posterior::ess_tail
)
diagnostico_regdin |>
  as_tibble() |>
  select(variable, mean, sd, rhat, ess_bulk, ess_tail) |>
  mutate(across(where(is.numeric), ~ signif(.x, 4))) |>
  kable()
Tabla 14.10: Diagnóstico de dos cadenas MCMC para las varianzas de observación y de pendiente; los resultados deben evaluarse antes de interpretar la posterior.
variable mean sd rhat ess_bulk ess_tail
V 0.334400 0.039130 1.005 183.80 281.50
W1 0.004853 0.002068 1.018 71.67 94.31
tibble(
  cadena = c('Cadena 1', 'Cadena 2'),
  aceptacion = c(mh_regdin_1$aceptacion, mh_regdin_2$aceptacion)
) |>
  mutate(aceptacion = round(aceptacion, 3)) |>
  kable()
Tabla 14.11: Proporción de propuestas aceptadas en las cadenas de Metropolis–Hastings.
cadena aceptacion
Cadena 1 0.607
Cadena 2 0.601
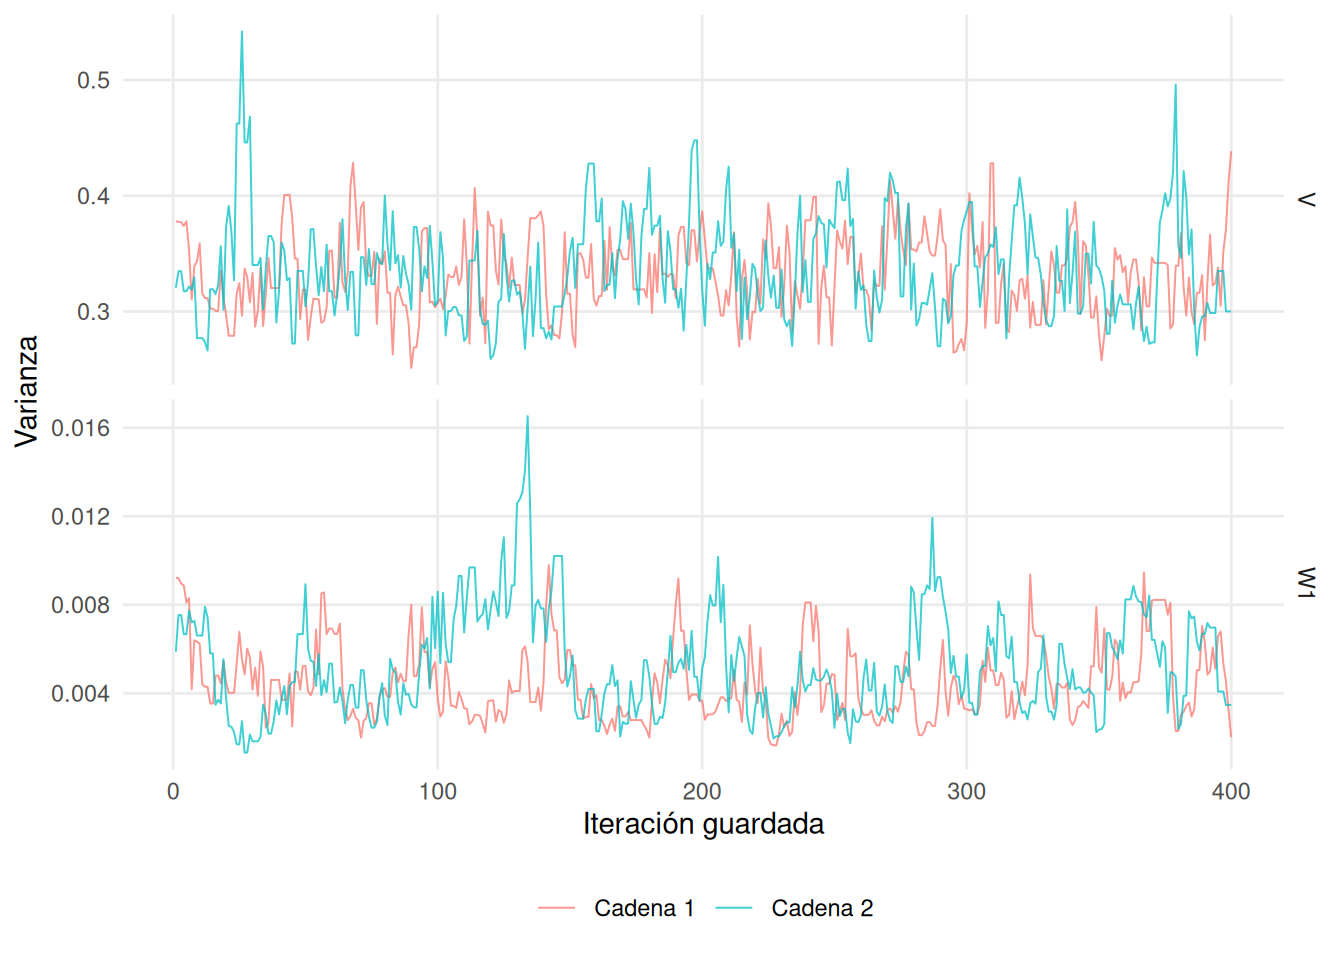
posterior_regdin |>
  group_by(cadena) |>
  mutate(iteracion = row_number()) |>
  ungroup() |>
  pivot_longer(c(V, W1), names_to = 'parametro', values_to = 'valor') |>
  ggplot(aes(iteracion, valor, colour = cadena)) +
  geom_line(linewidth = 0.35, alpha = 0.75) +
  facet_grid(vars(parametro), scales = 'free_y') +
  labs(x = 'Iteración guardada', y = 'Varianza', colour = NULL) +
  tema_regdin
Figura 14.11: Trazas posteriores de las dos cadenas en la escala original de las varianzas.

Un valor de \(\widehat R\) cercano a uno y tamaños efectivos de muestra suficientemente grandes favorecen la interpretación de las simulaciones, pero no prueban convergencia matemática. Si las cadenas muestran separación, tendencias prolongadas o tamaños efectivos muy bajos, debe ampliarse el muestreo, revisar la escala de las propuestas y reevaluar el modelo antes de interpretar los intervalos bayesianos. La tasa de aceptación, por sí sola, no determina calidad de la cadena.

14.11.2 Simulación de trayectorias futuras

Para cada extracción posterior \(\boldsymbol\psi^{(b)}=(V^{(b)},W_1^{(b)})\) simularemos

\[ \begin{aligned} \boldsymbol x_T^{(b)} &\sim p(\boldsymbol x_T\mid\mathcal D_T,\boldsymbol\psi^{(b)}),\\ \boldsymbol x_{T+h}^{(b)} &=\boldsymbol x_{T+h-1}^{(b)}+\boldsymbol w_{T+h}^{(b)},\\ Y_{T+h}^{(b)} &=\begin{pmatrix}1&Z_{T+h}^{(b)}\end{pmatrix} \boldsymbol x_{T+h}^{(b)}+v_{T+h}^{(b)}. \end{aligned} \tag{14.38}\]

Primero fijaremos \(Z_{T+h}^{(b)}=\widehat E(Z_{T+h}\mid\mathcal D_T)\) para todos los sorteos (pronóstico condicional central). Después repetiremos usando una trayectoria completa de ingreso generada recursivamente por Ecuación 14.31 (pronóstico que integra la incertidumbre de ingreso). En ambos casos integraremos la posterior de \(V,W_1\) y la incertidumbre del estado terminal.

set.seed(41421)
B_regdin <- 500L
indices_bayes <- sample(seq_len(nrow(posterior_regdin)),
                        size = B_regdin, replace = TRUE)
post_pred_regdin <- posterior_regdin |>
  slice(indices_bayes) |>
  select(V, W1)

# Columna h con B veces la media condicional pronosticada de ingreso.
z_central_bayes <- matrix(rep(mu_z_fijo, each = B_regdin),
                          nrow = B_regdin, ncol = H_regdin)

set.seed(41422)
sim_m3_cond <- simular_predictiva_regdin(
  post_pred_regdin, Y_ent, Z_ent, z_central_bayes
)

set.seed(41423)
z_aleatorio_bayes <- simular_ingreso_ar1(
  mz_regdin, ultimo_z = last(Z_ent), H = H_regdin, B = B_regdin
)

set.seed(41422)
sim_m3_integrado <- simular_predictiva_regdin(
  post_pred_regdin, Y_ent, Z_ent, z_aleatorio_bayes
)

res_m3_cond <- resumir_muestras_regdin(sim_m3_cond) |>
  mutate(modelo = 'M3', tratamiento = 'Ingreso fijado')
res_m3_integrado <- resumir_muestras_regdin(sim_m3_integrado) |>
  mutate(modelo = 'M3', tratamiento = 'Ingreso aleatorio')
bind_rows(res_m3_cond, res_m3_integrado) |>
  select(tratamiento, h, media, inferior, superior, amplitud) |>
  mutate(across(where(is.numeric), ~ round(.x, 3))) |>
  kable()
Tabla 14.12: Pronósticos bayesianos M3: intervalos centrales posteriores al 95% cuando el ingreso se fija o se simula con un AR(1).
tratamiento h media inferior superior amplitud
Ingreso fijado 1 0.642 -0.584 1.780 2.363
Ingreso fijado 2 0.617 -0.545 1.686 2.232
Ingreso fijado 3 0.625 -0.562 1.802 2.364
Ingreso fijado 4 0.619 -0.598 1.748 2.345
Ingreso aleatorio 1 0.645 -0.740 1.836 2.576
Ingreso aleatorio 2 0.611 -0.714 1.917 2.632
Ingreso aleatorio 3 0.637 -0.605 1.944 2.549
Ingreso aleatorio 4 0.625 -0.737 1.834 2.571
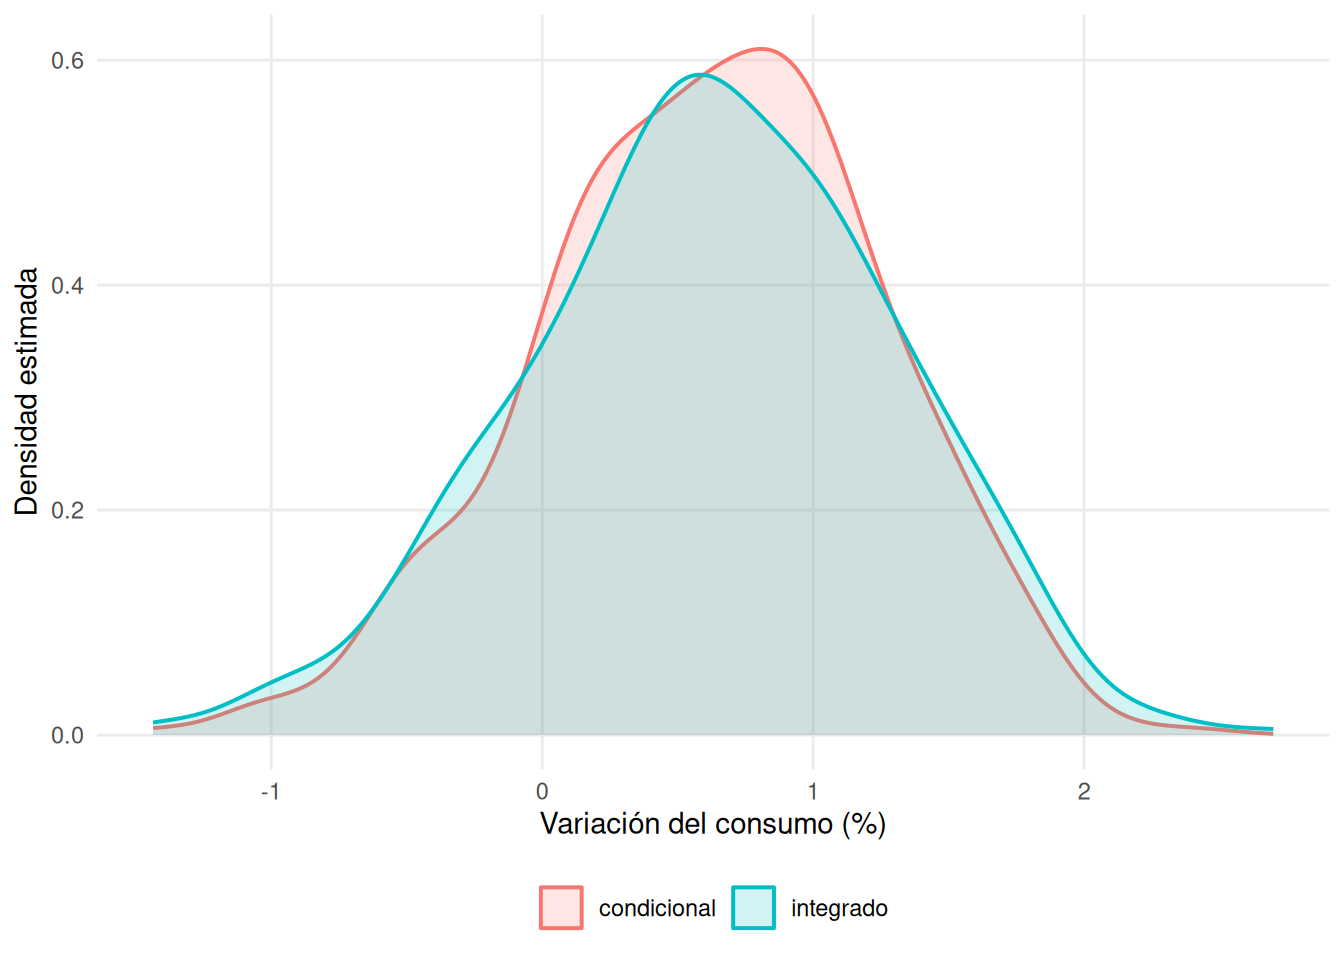
tibble(
  condicional = sim_m3_cond[, H_regdin],
  integrado = sim_m3_integrado[, H_regdin]
) |>
  pivot_longer(everything(), names_to = 'tratamiento', values_to = 'consumo') |>
  ggplot(aes(consumo, fill = tratamiento, colour = tratamiento)) +
  geom_density(alpha = 0.18, linewidth = 0.7) +
  labs(x = 'Variación del consumo (%)', y = 'Densidad estimada',
       fill = NULL, colour = NULL) +
  tema_regdin
Figura 14.12: Distribuciones predictivas simuladas del consumo a cuatro trimestres con ingreso fijo en el escenario central e ingreso futuro aleatorio.

La comparación no debe reducirse a dos desviaciones estándar: el producto de una pendiente aleatoria por un predictor aleatorio puede inducir asimetrías o colas que una aproximación normal no representa fielmente. Los cuantiles de las simulaciones dan intervalos basados directamente en la distribución predictiva empírica. Estas simulaciones aún tratan como fijos los parámetros ajustados del modelo AR(1) del ingreso.

14.11.3 Sensibilidad a las prioris

En una aplicación real, la distribución previa de \(W_1\) debe revisarse con particular atención: cuando las variaciones de la pendiente son difíciles de distinguir del ruido de observación, los datos pueden informar poco sobre esa varianza. Propongo que la comprobación de sensibilidad del laboratorio vuelva a estimar M3 con \(W_1\sim\operatorname{IG}(3,0.006)\) y \(W_1\sim\operatorname{IG}(3,0.06)\), cuyas medias son \(0.003\) y \(0.03\), respectivamente. La comparación debe estudiar tanto las posteriores de \(W_1\) como los cuantiles predictivos de consumo; no se debe afirmar sensibilidad o robustez antes de observar y diagnosticar las cadenas.

El núcleo reproducible del capítulo utiliza una sola priori declarada para mantener manejable el costo de computación. El ejercicio de sensibilidad es una extensión deliberada, no una evidencia empírica ya establecida.

14.12 Evaluación predictiva fuera de muestra

14.12.1 Protocolo de origen móvil

Siguiendo las reglas desarrolladas en el capítulo 7, utilizaremos:

  • orígenes de entrenamiento expansivo desde el final del entrenamiento inicial, cada dos trimestres;
  • horizonte común \(H=4\) trimestres;
  • reestimación de todos los modelos, incluido el AR(1) del ingreso, en cada origen;
  • predictores futuros no observados sustituidos por pronósticos ex ante o por trayectorias simuladas con información del origen;
  • exactamente las mismas parejas de origen y horizonte en la comparación M0–M3.

M0, M1 y M2 utilizarán aproximaciones normales basadas en parámetros estimados. Para M1 y M2 se incorporará la incertidumbre del AR(1) de ingreso en las varianzas como en Ecuación 14.35 y Ecuación 14.37. M3 tendrá una distribución predictiva simulada por MH. Estas diferencias de tratamiento de incertidumbre deben recordarse al interpretar los resultados probabilísticos.

Costo computacional. Para la evaluación móvil se emplea una cadena más corta de MH por origen, con el fin de mantener los tiempos razonables. Es una evaluación didáctica exploratoria: una aplicación formal debería aumentar iteraciones y cadenas en cada origen y comprobar el error Monte Carlo de las puntuaciones. El cálculo está almacenado en caché.

14.12.2 Medidas de evaluación

Sean \(e_{o,h}=y_{o+h}-\widehat y_{o+h\mid o}\) los errores producidos en origen \(o\) y horizonte \(h\). Para cada conjunto común de \(N\) pares \((o,h)\) definimos

\[ \operatorname{MAE}=\frac1N\sum|e_{o,h}|, \qquad \operatorname{RMSE}=\sqrt{\frac1N\sum e_{o,h}^2}. \]

Con un denominador naïve calculado en cada entrenamiento, \(q_o=(o-1)^{-1}\sum_{t=2}^o|y_t-y_{t-1}|\), utilizaremos

\[ \operatorname{MASE}=\frac1N\sum_{(o,h)}\frac{|e_{o,h}|}{q_o}. \tag{14.39}\]

Para intervalos centrales del 95%, cobertura y amplitud son \(\mathbf 1(y_{o+h}\in[L_{o,h},U_{o,h}])\) y \(U_{o,h}-L_{o,h}\). Además, calcularemos CRPS, que recompensa distribuciones concentradas pero penaliza asignar una masa predictiva lejos de la observación. Para una distribución normal con media \(\mu\) y desviación \(s\):

\[ \operatorname{CRPS}(N(\mu,s^2),y)= s\left[z\{2\Phi(z)-1\}+2\varphi(z)-\frac1{\sqrt\pi}\right], \quad z=\frac{y-\mu}{s}. \tag{14.40}\]

Para \(B\) simulaciones predictivas \(x^{(1)},\ldots,x^{(B)}\), utilizamos la estimación empírica

\[ \widehat{\operatorname{CRPS}}(y) =\frac1B\sum_{b=1}^B|x^{(b)}-y| -\frac{1}{2B^2}\sum_{b=1}^B\sum_{c=1}^B |x^{(b)}-x^{(c)}|. \tag{14.41}\]

Esta expresión trata la distribución empírica de las simulaciones como una distribución predictiva aproximada; su error Monte Carlo disminuye al aumentar \(B\). Para interpretar las puntuaciones y su propiedad de ser reglas de puntuación propias, véase Hyndman y Athanasopoulos (2021), secciones 5.8–5.10.

14.12.3 Función de evaluación para un solo origen

14.12.4 Evaluación con origen móvil: resultados

origenes_regdin <- seq.int(n_ent_regdin, n_total_regdin - H_regdin,
                           by = 2L)
stopifnot(length(origenes_regdin) >= 5L,
          all(origenes_regdin + H_regdin <= n_total_regdin))

resultados_cv_regdin <- purrr::map_dfr(
  origenes_regdin,
  ~ evaluar_origen_regdin(.x, us_regdin, H = H_regdin)
) |>
  mutate(error = observado - pronostico,
         cubierto = observado >= inferior & observado <= superior,
         amplitud = superior - inferior,
         mase_individual = abs(error) / escala)

stopifnot(
  nrow(resultados_cv_regdin) == length(origenes_regdin) *
    H_regdin * 4L,
  all(is.finite(resultados_cv_regdin$crps)),
  all(resultados_cv_regdin$amplitud > 0),
  !anyNA(resultados_cv_regdin)
)
resumen_cv_regdin <- resultados_cv_regdin |>
  group_by(modelo) |>
  summarise(
    n = n(),
    MAE = mean(abs(error)),
    RMSE = sqrt(mean(error^2)),
    MASE = mean(mase_individual),
    cobertura_95 = mean(cubierto),
    amplitud_95 = mean(amplitud),
    CRPS = mean(crps),
    .groups = 'drop'
  )

resumen_cv_regdin |>
  mutate(across(-c(modelo, n), ~ round(.x, 3))) |>
  kable()
Tabla 14.13: Evaluación ex ante con orígenes móviles compartidos: error puntual, cobertura, amplitud y CRPS. En M3 se utilizan cadenas cortas exploratorias.
modelo n MAE RMSE MASE cobertura_95 amplitud_95 CRPS
M0: AR(1) consumo 28 0.198 0.246 0.354 1 2.505 0.186
M1: regresión + AR(1) 28 0.200 0.243 0.358 1 2.449 0.183
M2: DLM-MV 28 0.183 0.245 0.326 1 2.384 0.180
M3: DLM-Bayes 28 0.187 0.241 0.334 1 2.522 0.190
resultados_cv_regdin |>
  group_by(modelo, h) |>
  summarise(
    MAE = mean(abs(error)),
    RMSE = sqrt(mean(error^2)),
    cobertura_95 = mean(cubierto),
    CRPS = mean(crps),
    .groups = 'drop'
  ) |>
  mutate(across(c(MAE, RMSE, cobertura_95, CRPS), ~ round(.x, 3))) |>
  kable()
Tabla 14.14: Errores medios, cobertura y CRPS según el horizonte bajo el mismo conjunto de orígenes.
modelo h MAE RMSE cobertura_95 CRPS
M0: AR(1) consumo 1 0.135 0.193 1 0.167
M0: AR(1) consumo 2 0.227 0.268 1 0.194
M0: AR(1) consumo 3 0.188 0.236 1 0.185
M0: AR(1) consumo 4 0.243 0.278 1 0.198
M1: regresión + AR(1) 1 0.135 0.180 1 0.164
M1: regresión + AR(1) 2 0.231 0.266 1 0.191
M1: regresión + AR(1) 3 0.192 0.237 1 0.182
M1: regresión + AR(1) 4 0.243 0.277 1 0.195
M2: DLM-MV 1 0.119 0.150 1 0.157
M2: DLM-MV 2 0.208 0.273 1 0.189
M2: DLM-MV 3 0.143 0.184 1 0.164
M2: DLM-MV 4 0.262 0.330 1 0.211
M3: DLM-Bayes 1 0.128 0.171 1 0.171
M3: DLM-Bayes 2 0.208 0.256 1 0.196
M3: DLM-Bayes 3 0.139 0.171 1 0.169
M3: DLM-Bayes 4 0.272 0.329 1 0.224
resultados_cv_regdin |>
  group_by(modelo, h) |>
  summarise(RMSE = sqrt(mean(error^2)), .groups = 'drop') |>
  ggplot(aes(h, RMSE, colour = modelo, group = modelo)) +
  geom_line(linewidth = 0.75) +
  geom_point(size = 1.8) +
  scale_x_continuous(breaks = seq_len(H_regdin)) +
  labs(x = 'Horizonte (trimestres)', y = 'RMSE', colour = NULL) +
  tema_regdin
Figura 14.13: RMSE por horizonte para los cuatro procedimientos, con las mismas fechas de origen y de evaluación.
resultados_cv_regdin |>
  group_by(modelo, h) |>
  summarise(CRPS = mean(crps), .groups = 'drop') |>
  ggplot(aes(h, CRPS, colour = modelo, group = modelo)) +
  geom_line(linewidth = 0.75) +
  geom_point(size = 1.8) +
  scale_x_continuous(breaks = seq_len(H_regdin)) +
  labs(x = 'Horizonte (trimestres)', y = 'CRPS', colour = NULL) +
  tema_regdin
Figura 14.14: CRPS promedio por horizonte en la evaluación con origen móvil. Valores menores indican mejor puntuación.

El mejor promedio de una métrica no tiene por qué coincidir con el mejor promedio de otra. Una ganancia aparente de CRPS puede depender de la calibración de intervalos, mientras que una disminución de RMSE refleja solo los pronósticos puntuales. El número de orígenes es deliberadamente pequeño y las ventanas se superponen; por tanto, no interpretaremos diferencias modestas como pruebas de superioridad universal.

14.12.5 Diferenciar visualmente ajuste y pronóstico

La siguiente figura evita confundir valores ajustados dentro de entrenamiento con pronósticos genuinos. El tramo inicial muestra el consumo observado y predicciones a un paso dentro de la muestra, hechas después de estimar cada modelo con todo el entrenamiento. La parte final muestra solamente pronósticos a \(1,\ldots,4\) pasos emitidos desde el mismo origen fijo, junto con los valores observados que quedaron fuera del ajuste. El entrenamiento y la evaluación tienen fondos y estilos distintos.

pr_m0_fijo <- predict(m0_regdin, n.ahead = H_regdin)
tabla_m0_fijo <- tibble(h = seq_len(H_regdin),
                        media = as.numeric(pr_m0_fijo$pred),
                        varianza = as.numeric(pr_m0_fijo$se)^2)

pronosticos_fijos <- bind_rows(
  resumir_normal_regdin(tabla_m0_fijo) |>
    mutate(modelo = 'M0: AR(1) consumo'),
  m1_integrado |> mutate(modelo = 'M1: regresión + AR(1)'),
  m2_integrado |> mutate(modelo = 'M2: DLM-MV'),
  res_m3_integrado |> mutate(modelo = 'M3: DLM-Bayes')
) |>
  mutate(t = n_ent_regdin + h)

ajustes_entrenamiento <- bind_rows(
  tibble(t = ent_regdin$t,
         ajuste = Y_ent - as.numeric(residuals(m0_regdin)),
         modelo = 'M0: AR(1) consumo'),
  tibble(t = ent_regdin$t,
         ajuste = Y_ent - as.numeric(residuals(m1_regdin)),
         modelo = 'M1: regresión + AR(1)'),
  tibble(t = ent_regdin$t,
         ajuste = filtro_m2$f,
         modelo = 'M2: DLM-MV')
) |>
  filter(t >= n_ent_regdin - 23L)

# M3 comparte la familia DLM de M2: la media filtrada bajo parámetros
# MV sirve aquí solo como referencia visual *del entrenamiento*, no como
# una supuesta media de ajuste posterior bayesiana.
ajustes_entrenamiento <- bind_rows(
  ajustes_entrenamiento,
  ajustes_entrenamiento |>
    filter(modelo == 'M2: DLM-MV') |>
    mutate(modelo = 'M3: DLM-Bayes', ajuste = NA_real_)
)

observaciones_grafico <- us_regdin |>
  filter(t >= n_ent_regdin - 23L,
         t <= n_ent_regdin + H_regdin) |>
  transmute(t, observado = Consumption,
            bloque = if_else(t <= n_ent_regdin, 'Entrenamiento', 'Prueba'))

marco_modelos <- tibble(modelo = unique(pronosticos_fijos$modelo))

# Las capas con datos sin variable 'modelo' se reproducen en cada faceta.
ggplot() +
  geom_rect(data = marco_modelos,
            aes(xmin = n_ent_regdin + 0.5,
                xmax = n_ent_regdin + H_regdin + 0.5,
                ymin = -Inf, ymax = Inf),
            fill = 'steelblue', alpha = 0.10) +
  geom_line(data = observaciones_grafico |>
              filter(bloque == 'Entrenamiento'),
            aes(t, observado), colour = 'grey45', linewidth = 0.55) +
  geom_line(data = observaciones_grafico |> filter(bloque == 'Prueba'),
            aes(t, observado), colour = 'black', linewidth = 1.0) +
  geom_point(data = observaciones_grafico |> filter(bloque == 'Prueba'),
             aes(t, observado), colour = 'black', size = 1.9) +
  geom_line(data = ajustes_entrenamiento,
            aes(t, ajuste), colour = 'steelblue', linewidth = 0.65,
            na.rm = TRUE) +
  geom_ribbon(data = pronosticos_fijos,
              aes(t, ymin = inferior, ymax = superior),
              fill = 'firebrick', alpha = 0.16) +
  geom_line(data = pronosticos_fijos,
            aes(t, media), colour = 'firebrick', linewidth = 0.8) +
  geom_vline(xintercept = n_ent_regdin + 0.5,
             linetype = 'dashed') +
  facet_wrap(vars(modelo), ncol = 2) +
  labs(x = 'Trimestre (índice consecutivo)',
       y = 'Variación del consumo (%)',
       subtitle = paste0(
         'Gris: observado en entrenamiento; azul: ajuste dentro de muestra; ',
         'negro: prueba; rojo: pronóstico e intervalo al 95%. ',
         'En M3 no se muestra ajuste posterior dentro de entrenamiento.'
       )) +
  tema_regdin
Figura 14.15: Ajuste dentro del entrenamiento y pronóstico fuera de muestra desde un origen fijo. La región sombreada separa rigurosamente la prueba; las líneas de prueba son predicciones ex ante.

Las predicciones a un paso dentro de entrenamiento no son pronósticos de validación temporal: usan parámetros estimados con toda esa muestra. Además, M1 usa el ingreso contemporáneo observado en entrenamiento, lo cual es legítimo para ajustar el modelo, pero no equivale a disponer del ingreso futuro en el conjunto de prueba. Por eso la comparación de desempeño se basa en los pronósticos ex ante de Sección 14.12.4, no en la cercanía visual de las curvas ajustadas.

14.12.6 Puntuaciones probabilísticas del origen fijo

Para completar la lectura de Figura 14.15, obtendremos una tabla específica para el origen fijo. Utiliza exactamente las mismas cuatro observaciones futuras y la misma definición del pronóstico ex ante.

real_fijo <- us_regdin$Consumption[n_ent_regdin + seq_len(H_regdin)]

tabla_fijo <- bind_rows(
  puntuar_normal_regdin('M0: AR(1) consumo', n_ent_regdin,
                         real_fijo, mean(abs(diff(Y_ent))),
                         tabla_m0_fijo),
  puntuar_normal_regdin('M1: regresión + AR(1)', n_ent_regdin,
                         real_fijo, mean(abs(diff(Y_ent))),
                         m1_integrado),
  puntuar_normal_regdin('M2: DLM-MV', n_ent_regdin,
                         real_fijo, mean(abs(diff(Y_ent))),
                         m2_integrado),
  puntuar_muestras_regdin('M3: DLM-Bayes', n_ent_regdin,
                           real_fijo, mean(abs(diff(Y_ent))),
                           sim_m3_integrado)
)

tabla_fijo |>
  select(modelo, h, observado, pronostico, inferior, superior, crps) |>
  mutate(across(where(is.numeric), ~ round(.x, 3))) |>
  kable()
Tabla 14.15: Pronóstico y CRPS al origen fijo inicial, con evaluación de los cuatro trimestres consecutivos reservados.
modelo h observado pronostico inferior superior crps
M0: AR(1) consumo 1 0.759 0.763 -0.456 1.981 0.145
M0: AR(1) consumo 2 0.447 0.753 -0.531 2.037 0.209
M0: AR(1) consumo 3 0.778 0.750 -0.541 2.040 0.154
M0: AR(1) consumo 4 0.716 0.748 -0.543 2.040 0.155
M1: regresión + AR(1) 1 0.759 0.756 -0.467 1.979 0.146
M1: regresión + AR(1) 2 0.447 0.750 -0.499 1.998 0.205
M1: regresión + AR(1) 3 0.778 0.748 -0.501 1.998 0.150
M1: regresión + AR(1) 4 0.716 0.748 -0.502 1.998 0.150
M2: DLM-MV 1 0.759 0.591 -0.612 1.794 0.162
M2: DLM-MV 2 0.447 0.591 -0.614 1.796 0.157
M2: DLM-MV 3 0.778 0.591 -0.615 1.797 0.166
M2: DLM-MV 4 0.716 0.591 -0.616 1.798 0.154
M3: DLM-Bayes 1 0.759 0.645 -0.740 1.836 0.162
M3: DLM-Bayes 2 0.447 0.611 -0.714 1.917 0.167
M3: DLM-Bayes 3 0.778 0.637 -0.605 1.944 0.165
M3: DLM-Bayes 4 0.716 0.625 -0.737 1.834 0.161

La evidencia del origen fijo es ilustrativa, pues cada horizonte tiene una sola realización. La evaluación móvil aumenta el número de observaciones de error y permite inspeccionar estabilidad temporal, aunque la dependencia por superposición de ventanas sigue presente.

14.13 Interpretación de los resultados y limitaciones

14.13.1 ¿Cuándo conviene introducir una covariable?

La inclusión de \(Z_t\) se justifica si aporta información predictiva adicional y si su trayectoria futura puede conocerse o pronosticarse con suficiente calidad. Una covariable que mejora mucho el ajuste in-sample puede empeorar la predicción ex ante cuando sus valores futuros son muy inciertos. Este punto es crucial para interpretar los resultados de M1 frente a M0: el valor de un predictor no depende solo de su coeficiente estimado, sino de la calidad de los datos que estarán disponibles al pronosticar.

14.13.2 El cambio de coeficientes no siempre está identificado

Una pendiente variable puede seguir fluctuaciones reales de la asociación o puede absorber ruido, atípicos y errores de especificación. La magnitud \(W_1\) debe compararse con la escala de \(V\), la variación de \(Z_t\) y la longitud temporal de la muestra. Si hay poca información para identificar \(W_1\), las conclusiones sobre la trayectoria de la pendiente requieren prudencia. Una alternativa parsimoniosa es fijar \(W_1=0\) y comparar su pronóstico fuera de muestra.

14.13.3 Condicionamiento, incertidumbre y dependencia conjunta

Los modelos utilizados aquí suponen que el proceso de ingreso futuro puede modelarse con un AR(1) separado y que su innovación futura no está correlacionada con la innovación futura del consumo o con la evolución de sus coeficientes. Si la economía presenta retroalimentación simultánea, el enfoque puede infravalorar o sobrevalorar la incertidumbre. Una extensión natural son modelos de regresión multivariada dinámica o modelos VAR y DLM conjuntos; véanse Prado et al. (2021) (capítulos 9–10) y Petris et al. (2009) (sección 3.3).

14.13.4 Diferentes niveles de aproximación

Conviene identificar exactamente qué integra cada modelo:

Modelo Parámetros de consumo Estados de consumo Incertidumbre futura de ingreso
M0 Sustituidos por estimadores Sin estado de regresión dinámico No aplica
M1 Sustituidos por estimadores Error AR(1) pronosticado Sí, por fórmula de varianza
M2 Varianzas sustituidas por estimadores Filtrados y propagados Sí, por momentos analíticos
M3 Posterior simulada de \(V,W_1\) Estado terminal y evolución simulados Sí, por trayectorias simuladas

M1–M3 mantienen fijos los parámetros ajustados del AR(1) de ingreso. En M1 y M2, usar intervalos normales basados en la varianza integrada es exacto bajo gaussianidad y coeficiente fijo para M1; para M2 es una aproximación basada en los dos primeros momentos, dado que una pendiente aleatoria multiplicada por ingreso aleatorio no suele generar una distribución normal.

14.13.5 Pronóstico condicionado no equivale a evaluación causal

Los escenarios económico-actuariales suelen formularse como condiciones: «si el ingreso crece a cierta tasa, ¿qué trayectoria de consumo espera el modelo?». Son preguntas válidas, pero distintas de «¿qué pasaría si una política provocara exactamente ese crecimiento?». Esta última requiere supuestos causales y posiblemente un modelo estructural de intervención.

14.14 Actividad computacional guiada

Se propone un laboratorio en el que el estudiantado modifique el archivo reproducible y entregue un informe breve con resultados numéricos, interpretación y limitaciones.

  1. Modelo de referencia. Reemplace M0 por un ARIMA automático, pero seleccione el orden usando exclusivamente el entrenamiento. Compare el diagnóstico y la predicción con el AR(1) que se utiliza en esta nota. Explique por qué una mejora en AICc no garantiza mejora en RMSE fuera de muestra.
  2. Covariable adelantada. Sustituya \(Z_t\) por \(Z_{t-1}\) dentro de M1. Estudie qué valores de covariables futuras son realmente conocidos a un horizonte de cuatro trimestres y cuáles deben pronosticarse. No use datos de la prueba durante la estimación.
  3. Coeficiente estático frente a dinámico. Ajuste M2 con \(W_1=0\) (o con un valor numéricamente próximo a cero) y contraste la secuencia filtrada y las predicciones con el modelo que permite \(W_1>0\).
  4. Escenarios. Cambie las magnitudes favorable y desfavorable; interprete los pronósticos como condicionales. No asigne probabilidades a escenarios sin proporcionar un modelo probabilístico de esos escenarios.
  5. Sensibilidad bayesiana. Utilice dos prioris alternativas para \(W_1\), diagnostique las cadenas y compare posterior e intervalos predictivos. Señale explícitamente si las diferencias son materiales o no.
  6. Evaluación. Amplíe el número de orígenes, aumente el tamaño de la simulación bayesiana y vuelva a calcular CRPS, cobertura y amplitud. Interprete el costo computacional y la estabilidad de los resultados.

14.14.1 Reproducibilidad y tiempo de cómputo

Los ejemplos fijan semillas en las simulaciones y ejecutan comprobaciones de dimensiones, valores faltantes y positividad. El cálculo MCMC y la evaluación móvil llevan #| cache: true para reducir ejecuciones repetidas durante la edición del capítulo. La caché de knitr no elimina la necesidad de volver a ejecutar esos bloques cuando cambia el modelo, las funciones que utilizan, los datos o sus dependencias; tras modificaciones sustantivas conviene invalidarla deliberadamente.

Para regenerar únicamente los bloques computacionales más largos, utilice la compilación normal de Quarto; para restablecer todos los resultados, elimine la caché correspondiente y renderice desde una sesión limpia. El núcleo del capítulo no requiere archivos externos de datos: us_change procede de fpp3 y el ejemplo armónico se simula internamente.

En la práctica, el análisis de una posterior de varianzas cercanas a cero puede necesitar propuestas MCMC adaptadas, mejores parametrizaciones o más iteraciones que las utilizadas aquí con fines docentes. El diagnóstico de la semana 13 sigue siendo obligatorio.

14.15 Síntesis

La regresión dinámica extiende los modelos univariados incorporando información explicativa sin perder de vista la dependencia temporal. Una regresión con errores ARIMA y una regresión DLM de coeficientes variables describen mecanismos distintos: autocorrelación de lo que no explica la regresión frente a evolución estocástica de la relación explicativa.

El pronóstico exige definir el conjunto de información al origen. Cuando la covariable futura no se conoce, un escenario produce una predicción condicional; para obtener una predicción integrada se necesita una distribución predictiva de la covariable. La ley de la varianza total muestra formalmente cómo esa incertidumbre puede ampliar los intervalos y, cuando las pendientes también son aleatorias, aparece una interacción adicional entre incertidumbre del predictor y del coeficiente.

La inferencia bayesiana añade un mecanismo explícito para integrar incertidumbre sobre estados y parámetros, pero no garantiza superioridad predictiva. La comparación responsable requiere diagnósticos, controles sobre la información futura, ventanas y horizontes comunes, y métricas tanto puntuales como probabilísticas. Estos principios conectan directamente con el tema de volatilidad estocástica y evaluación predictiva de la semana 15.

14.16 Ejercicios

14.16.1 Teoría y demostraciones

Ejercicio 14.1. Considere \(Y_t=\beta_0+\beta_1Z_t+\eta_t\), con \(\eta_t=\phi\eta_{t-1}+\varepsilon_t\) y \(|\phi|<1\). Deduzca (a) la densidad estacionaria de \(\eta_1\), (b) la verosimilitud exacta condicional en \(z_{1:T}\), (c) la media y la varianza del error de pronóstico a horizonte \(h\) cuando \(\boldsymbol\beta,\phi,\sigma^2\) y la trayectoria futura de \(Z_t\) son conocidos. Explique qué cambia si \(\eta_1\) es tratado como un parámetro fijo no aleatorio.

Ejercicio 14.2. Sea \(\phi(B)(1-B)\eta_t=\theta(B)\varepsilon_t\) y \(Y_t=\beta_0+\beta_1Z_t+\eta_t\). Obtenga la representación en diferencias y explique por qué no puede tratar \(\beta_0\) como un intercepto directamente identificable en la ecuación diferenciada sin introducir restricciones adicionales.

Ejercicio 14.3. Considere \(Y_t=\beta_{0,t}+\beta_{1,t}Z_t+v_t\), con un vector de estados de caminata aleatoria y matriz de evolución \(\boldsymbol W=\operatorname{diag}(W_0,W_1)\). (a) Identifique \(\boldsymbol F_t,\boldsymbol G_t,V,\boldsymbol W\). (b) Demuestre Ecuación 14.25 para \(h\ge1\). (c) Discuta qué ocurre si \(W_1=0\) pero \(C_{T,11}>0\). ¿La pendiente futura es conocida con certeza?

Ejercicio 14.4. Deduzca Ecuación 14.37 usando la ley de la varianza total. Compruebe que, al fijar \(\operatorname{Var}(Z_{T+h}\mid\mathcal D_T)=0\), se recupera la varianza predictiva condicionada del DLM. Explique el significado del término \(s_{Z,h}^2(A_h)_{11}\).

Ejercicio 14.5. Un analista dispone de tres escenarios de crecimiento del ingreso a cuatro trimestres, pero no ha especificado probabilidades sobre ellos. ¿Puede obtener una distribución predictiva integrada mezclando los tres intervalos con pesos iguales? Argumente su respuesta y proponga las condiciones adicionales que necesitaría.

14.16.2 Interpretación e inferencia

Ejercicio 14.6. Un DLM obtiene una estimación de \(W_1\) próxima a cero y una banda ancha para la pendiente filtrada. ¿Sería correcto concluir que la relación es constante? Analice la información aportada por la muestra, la identificación, las restricciones de estimación y una posible comparación predictiva con \(W_1=0\).

Ejercicio 14.7. Para dos prioris diferentes de \(W_1\) se obtienen cadenas con distintos valores de \(\widehat R\) y diferentes tamaños efectivos de muestra. Describa qué verificaciones haría antes de atribuir las diferencias entre posteriores al efecto de las prioris. Explique qué debería compararse en términos predictivos.

Ejercicio 14.8. Un informe afirma que «un aumento hipotético de 1% en ingreso causaría un crecimiento estimado de 0.2% en consumo» a partir de una regresión con errores ARIMA. Identifique el supuesto no justificado y reescriba la interpretación en términos de pronóstico condicional.

14.16.3 Computación y evaluación

Ejercicio 14.9. Ajuste a us_change (solo entrenamiento) una regresión con errores ARMA y compare con una regresión ordinaria. Examine la ACF de errores de regresión e innovaciones, y explique cómo se modifica el juicio sobre adecuación del modelo.

Ejercicio 14.10. Compare dos modelos de regresión armónica con períodos \(m=12\) y \(K=1,2\) para una serie simulada con dos armónicos. Modifique el ejemplo para que los errores sigan un AR(1), ajuste un modelo de errores autocorrelacionados e interprete el efecto de ignorarlos al estimar incertidumbre.

Ejercicio 14.11. Vuelva a ejecutar el protocolo de origen móvil de la aplicación, pero reduzca el conjunto de predictores a un rezago de ingreso. Compruebe para cada horizonte qué valores se observan al origen. Compare MAE, MASE y CRPS sin utilizar ingreso futuro efectivo para generar las predicciones.

Ejercicio 14.12. Con los resultados de la aplicación, determine qué modelo elegiría para pronosticar a un trimestre y cuál para pronosticar a cuatro trimestres. Justifique la elección mediante métricas, interpretación y costo computacional. No utilice solamente el orden de las puntuaciones agregadas y discuta la incertidumbre debida al reducido número de orígenes.

14.17 Lecturas recomendadas

  • Hyndman y Athanasopoulos (2021), capítulos 7 (regresión y pronósticos con covariables) y 10 (regresión con errores ARIMA, predictores futuros, intervenciones y Fourier); capítulo 5 para evaluación temporal.
  • Petris et al. (2009), capítulo 3, especialmente las secciones 3.2.7 y 3.3.5 (regresión y regresión dinámica); capítulo 4 para modelos con parámetros desconocidos.
  • Prado et al. (2021), capítulo 4, especialmente 4.1–4.3 y 4.5 (formulación de DLM, inferencia, pronóstico y simulación posterior).
  • Shumway y Stoffer (2025), secciones 3.8 y 6.1–6.3 (regresión con errores autocorrelacionados, espacio-estado e inferencia por MV).