11Introducción a los modelos de espacio-estado y al filtro de Kalman
CA-0415 Series de Tiempo — Semana 11
11.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
explicar por qué la representación mediante estados latentes ofrece una alternativa a la formulación puramente autorregresiva de una serie;
distinguir las ecuaciones de observación y transición, y reconocer los supuestos de independencia condicional que definen un modelo de espacio-estado;
formular un modelo lineal gaussiano, especificando dimensiones, distribuciones de sus perturbaciones y distribución del estado inicial;
derivar las distribuciones predictivas del estado y de la observación;
obtener las ecuaciones del filtro de Kalman utilizando las propiedades de la distribución normal conjunta y condicional;
interpretar la innovación y la ganancia de Kalman, particularmente en términos de incertidumbres relativas;
demostrar que la actualización no aumenta la covarianza del estado con respecto a su covarianza predictiva en el orden semidefinido positivo;
interpretar el filtro como actualización bayesiana secuencial de estados condicionalmente a parámetros conocidos;
formular un modelo de nivel local y un modelo AR(1) con error de medición;
relacionar el nivel local con ARIMA\((0,1,1)\) y el suavizamiento exponencial simple bajo los supuestos adecuados;
implementar el filtro escalar manualmente y verificarlo con dlm;
construir pronósticos e intervalos predictivos, y compararlos fuera de muestra con un método de referencia sin utilizar información futura;
reconocer las cuestiones que se abordarán posteriormente: verosimilitud, estimación de parámetros, suavizamiento y distribución predictiva que incorpora incertidumbre paramétrica.
Las semanas anteriores introdujeron tres perspectivas complementarias. En Sección 6.6 describimos modelos mediante diferencias y polinomios de rezagos. En Sección 8.10 vimos que ciertos métodos de suavizamiento pueden escribirse como modelos probabilísticos con estados. En Sección 7.3 distinguimos los pronósticos genuinos de los valores ajustados dentro de la muestra.
Esta semana la pregunta central es: si una característica del sistema no es directamente observable y cambia con el tiempo, ¿cómo podemos inferir su valor de manera recursiva conforme llegan observaciones nuevas?
El código requiere tidyverse, ggplot2, knitr y dlm. Si no están disponibles, se pueden instalar una sola vez en una sesión de R mediante install.packages(c("tidyverse", "ggplot2", "knitr", "dlm")). Los paquetes se cargan explícitamente al iniciar el capítulo; ningún chunk instala paquetes durante la compilación. Los cálculos son breves y no necesitan activar caché.
ImportanteAlcance de la semana 11
Trataremos las matrices y las varianzas del modelo como parámetros conocidos. Esta simplificación deliberada permite obtener una derivación transparente del filtro. En la semana 12 se estudiarán la verosimilitud predictiva, la estimación por máxima verosimilitud, los pronósticos generales, el suavizamiento retrospectivo y los datos faltantes; en la semana 13 se incorporará la incertidumbre sobre parámetros desconocidos mediante modelos dinámicos bayesianos.
Una distribución condicional gaussiana del estado no significa que se haya integrado la incertidumbre posterior de todas las varianzas y parámetros del modelo.
11.2 Motivación: una serie observada y un sistema no observado
Considérese una variable económica medida periódicamente, por ejemplo una magnitud de actividad agregada. Podemos imaginar que su valor registrado contiene dos componentes:
un nivel subyacente que evoluciona gradualmente a lo largo del tiempo;
una desviación originada por errores de medición, fluctuaciones de corta duración u otras fuentes transitorias.
La descripción informal
\[
\text{valor observado}
=\text{nivel subyacente}+\text{error de observación}
\]
no alcanza por sí sola para inferir el nivel: necesitamos también un modelo que describa cómo evoluciona ese nivel de un período a otro.
En modelos ARIMA la dependencia se introduce a través de rezagos de \(Y_t\) y de sus innovaciones. En un modelo de espacio-estado se introduce, en cambio, mediante una secuencia de variables latentes \(\boldsymbol x_t\). Una misma estructura observada puede admitir diversas representaciones de espacio-estado, por lo que el estado debe interpretarse dentro del modelo especificado, no como una magnitud única e inevitablemente identificable (Shumway y Stoffer 2025, sec. 6.1; Petris et al. 2009, sec. 2.3).
Los modelos de espacio-estado permiten organizar problemas de estimación y pronóstico cuando se consideran niveles, pendientes, factores y otras características que cambian con el tiempo. El enfoque no exige que la serie observada sea estacionaria: la evolución del estado puede contener tendencias estocásticas.
11.2.1 Un diagrama de dependencias temporales
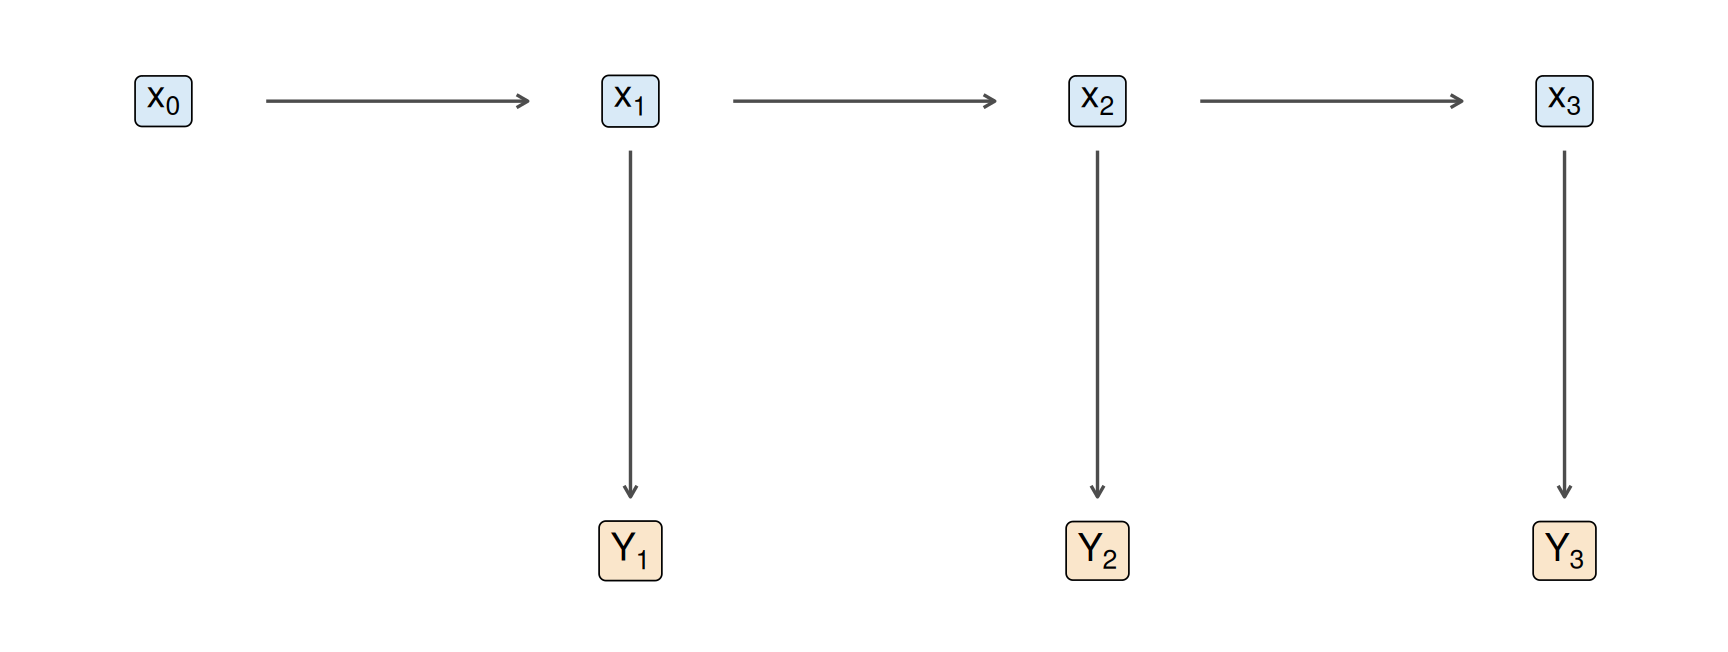
En el siguiente esquema, los estados evolucionan horizontalmente y cada observación depende de su estado contemporáneo. El estado inicial \(\boldsymbol x_0\) fija la distribución con que comienza el sistema.
nodos_ss <-bind_rows(tibble(x =0:3, y =2,etiqueta =paste0("x[", 0:3, "]"), grupo ="Estado"),tibble(x =1:3, y =0,etiqueta =paste0("Y[", 1:3, "]"), grupo ="Observación"))arcos_ss <-bind_rows(tibble(x = (0:2) +0.22, y =2,xend = (1:3) -0.22, yend =2),tibble(x =1:3, y =1.78,xend =1:3, yend =0.24))ggplot() +geom_segment(data = arcos_ss,aes(x = x, y = y, xend = xend, yend = yend),arrow = grid::arrow(length = grid::unit(0.17, "cm")),linewidth =0.6, colour ="grey30" ) +geom_label(data = nodos_ss,aes(x = x, y = y, label = etiqueta, fill = grupo),parse =TRUE, linewidth =0.3, size =5,show.legend =FALSE ) +scale_fill_manual(values =c("Estado"="#d9eaf7","Observación"="#fae6cb")) +coord_cartesian(xlim =c(-0.35, 3.35), ylim =c(-0.45, 2.45),expand =FALSE) +labs(x =NULL, y =NULL) +theme_void(base_size =12)
Figura 11.1: Estructura de dependencias de un modelo de espacio-estado de Markov de primer orden. Cada estado depende del estado anterior y cada observación de su estado contemporáneo.
Las flechas indican una factorización condicional, no una afirmación de causalidad por sí solas. Condicionalmente al estado \(\boldsymbol x_t\), la observación \(Y_t\) no necesita depender directamente del pasado observado. En cambio, el pasado influye indirectamente a través de la distribución del estado.
11.3 Formulación general de los modelos de espacio-estado
Sea \(\boldsymbol x_t\in\mathbb R^p\) el estado no observado y \(\boldsymbol Y_t\in\mathbb R^d\) el vector observado. Una formulación probabilística de primer orden consiste en especificar
En este caso se supone que, dados los estados, las observaciones son condicionalmente independientes en el tiempo y que los estados forman una cadena de Markov de primer orden. Más específicamente,
La ecuación Ecuación 11.3 es fundamental: describe la dependencia temporal utilizando distribuciones condicionales sencillas, aunque la distribución marginal de las observaciones pueda exhibir una estructura más compleja (Petris et al. 2009, secs. 2.3–2.4).
11.3.1 Modelo lineal gaussiano
Trabajaremos principalmente con una observación escalar \(Y_t\). Escribimos
Aquí \(\boldsymbol F_t\in\mathbb R^p\) es un vector columna, \(\boldsymbol G_t\in\mathbb R^{p\times p}\) y \(\boldsymbol W_t\) es una matriz de covarianzas semidefinida positiva. Supondremos \(V_t>0\), \(\boldsymbol C_0\) semidefinida positiva, y que \(\boldsymbol x_0\), las perturbaciones de estado \(\boldsymbol w_t\) y las perturbaciones de observación \(v_t\) son mutuamente independientes, tanto dentro de cada secuencia temporal como entre secuencias. En particular, \(\operatorname{Cov}(\boldsymbol w_t,v_t)=\boldsymbol 0\).
Si existen \(d>1\) series observadas, basta sustituir \(\boldsymbol F_t^\top\) por una matriz de observación \(\boldsymbol H_t\in\mathbb R^{d\times p}\), y \(V_t\) por una matriz de covarianzas de dimensión \(d\times d\). La estructura de las recursiones se mantiene, pero la innovación y su covarianza se vuelven vector y matriz, respectivamente (Shumway y Stoffer 2025, sec. 6.1).
11.3.2 Interpretación y dimensiones
Objetos de un modelo lineal gaussiano con una observación escalar y \(p\) componentes de estado.
Objeto
Dimensión
Interpretación
\(Y_t,\ v_t\)
Escalar
Observación y error de medición
\(\boldsymbol{x}_t\)
\(p\times 1\)
Componentes latentes del sistema
\(\boldsymbol{F}_t\)
\(p\times 1\)
Relación entre estado y observación
\(\boldsymbol{G}_t\)
\(p\times p\)
Transición del estado entre períodos
\(V_t\)
Escalar
Varianza del error de observación
\(\boldsymbol{W}_t\)
\(p\times p\)
Covarianza de la perturbación de estado
\(\boldsymbol{m}_0\)
\(p\times 1\)
Media inicial del estado
\(\boldsymbol{C}_0\)
\(p\times p\)
Covarianza inicial del estado
En esta formulación, el término lineal describe la dependencia de las ecuaciones respecto del estado, y gaussiano las distribuciones de las perturbaciones y del estado inicial. Que las matrices sean constantes en el tiempo no es necesario: \(\boldsymbol F_t\), \(\boldsymbol G_t\), \(V_t\) y \(\boldsymbol W_t\) pueden variar de manera conocida.
11.4 Tres distribuciones distintas: predicción, filtrado y suavizamiento
Es esencial distinguir el condicionamiento utilizado en cada problema. Dado un estado en el instante \(t\), tenemos:
Predicción antes de observar\(y_t\):
\[
p(\boldsymbol x_t\mid y_{1:t-1}).
\]
Filtrado después de observar\(y_t\):
\[
p(\boldsymbol x_t\mid y_{1:t}).
\]
Suavizamiento retrospectivo, después de observar datos posteriores:
\[
p(\boldsymbol x_t\mid y_{1:T}),\qquad T>t.
\]
La última distribución utiliza información futura respecto de \(t\). Su uso es legítimo al reconstruir retrospectivamente un estado, pero no puede confundirse con el conjunto de información disponible para emitir un pronóstico en el origen \(t\).
En esta semana derivaremos predicción y filtrado. Dejaremos las ecuaciones de suavizamiento para la semana 12 (Petris et al. 2009, secs. 2.7.1–2.7.4).
11.5 Predicción: propagación de media y covarianza
Para abreviar, denotaremos la distribución filtrada anterior por
La expresión Ecuación 11.9 muestra dos fuentes de incertidumbre: la covarianza que heredamos del estado anterior, propagada por \(\boldsymbol G_t\), y la perturbación nueva \(\boldsymbol W_t\). Es importante que predecir el estado no equivale simplemente a desplazar su media: también debemos propagar su incertidumbre.
Es decir, \(e_t\) es la diferencia entre la observación que acaba de llegar y el valor que el modelo predecía antes de recibirla. Condicionalmente al pasado, la variable aleatoria asociada \(E_t=Y_t-f_t\) satisface
es una herramienta natural de diagnóstico. Si el modelo gaussiano completo está correctamente especificado con parámetros conocidos, las innovaciones estandarizadas tienen distribución normal estándar y son independientes; ese resultado se retomará formalmente en la semana 12 (Petris et al. 2009, sec. 2.9).
11.6 El filtro de Kalman: derivación de la actualización
Ya conocemos \(p(\boldsymbol x_t\mid y_{1:t-1})\) y \(p(y_t\mid y_{1:t-1})\). Ahora necesitamos la distribución del estado después de observar \(y_t\):
\[
p(\boldsymbol x_t\mid y_{1:t}).
\]
11.6.1 Distribución conjunta del estado y de la observación
Condicionalmente a \(y_{1:t-1}\), el vector formado por estado y observación es gaussiano. Su vector de medias es
Para construir la matriz de covarianzas necesitamos, además de \(\boldsymbol R_t\) y \(Q_t\), la covarianza cruzada. Puesto que \(v_t\) es independiente de \(\boldsymbol x_t\),
Por tanto, \(\boldsymbol C_t\preceq\boldsymbol R_t\) en el orden de matrices semidefinidas positivas. La observación no aumenta la incertidumbre respecto del estado predictivo del mismo período. Esto no implica que \(\boldsymbol C_t\preceq\boldsymbol C_{t-1}\): al pasar del período anterior al actual, la perturbación de transición \(\boldsymbol W_t\) puede incrementar la incertidumbre antes de que llegue la observación.
Para cálculos matriciales, una expresión equivalente y con frecuencia más estable numéricamente es la forma de Joseph:
La identidad se obtiene expandiendo la expresión y sustituyendo \(Q_t=\boldsymbol F_t^\top\boldsymbol R_t\boldsymbol F_t+V_t\) y \(\boldsymbol K_t=\boldsymbol R_t\boldsymbol F_tQ_t^{-1}\). Es particularmente útil en implementaciones generales cuando los errores de redondeo dificultan mantener simetría y positividad de las covarianzas.
11.6.4 Recursiones reunidas
Secuencia de operaciones del filtro de Kalman para observaciones escalares.
Etapa
Cantidad
Símbolo
Predicción del estado
Media previa
\(\boldsymbol{a}_t\)
Predicción del estado
Covarianza previa
\(\boldsymbol{R}_t\)
Predicción observada
Media de \(Y_t\)
\(f_t\)
Predicción observada
Varianza de \(Y_t\)
\(Q_t\)
Innovación
Error de un paso
\(e_t\)
Ganancia
Peso de actualización
\(\boldsymbol{K}_t\)
Filtrado
Media posterior
\(\boldsymbol{m}_t\)
Filtrado
Covarianza posterior
\(\boldsymbol{C}_t\)
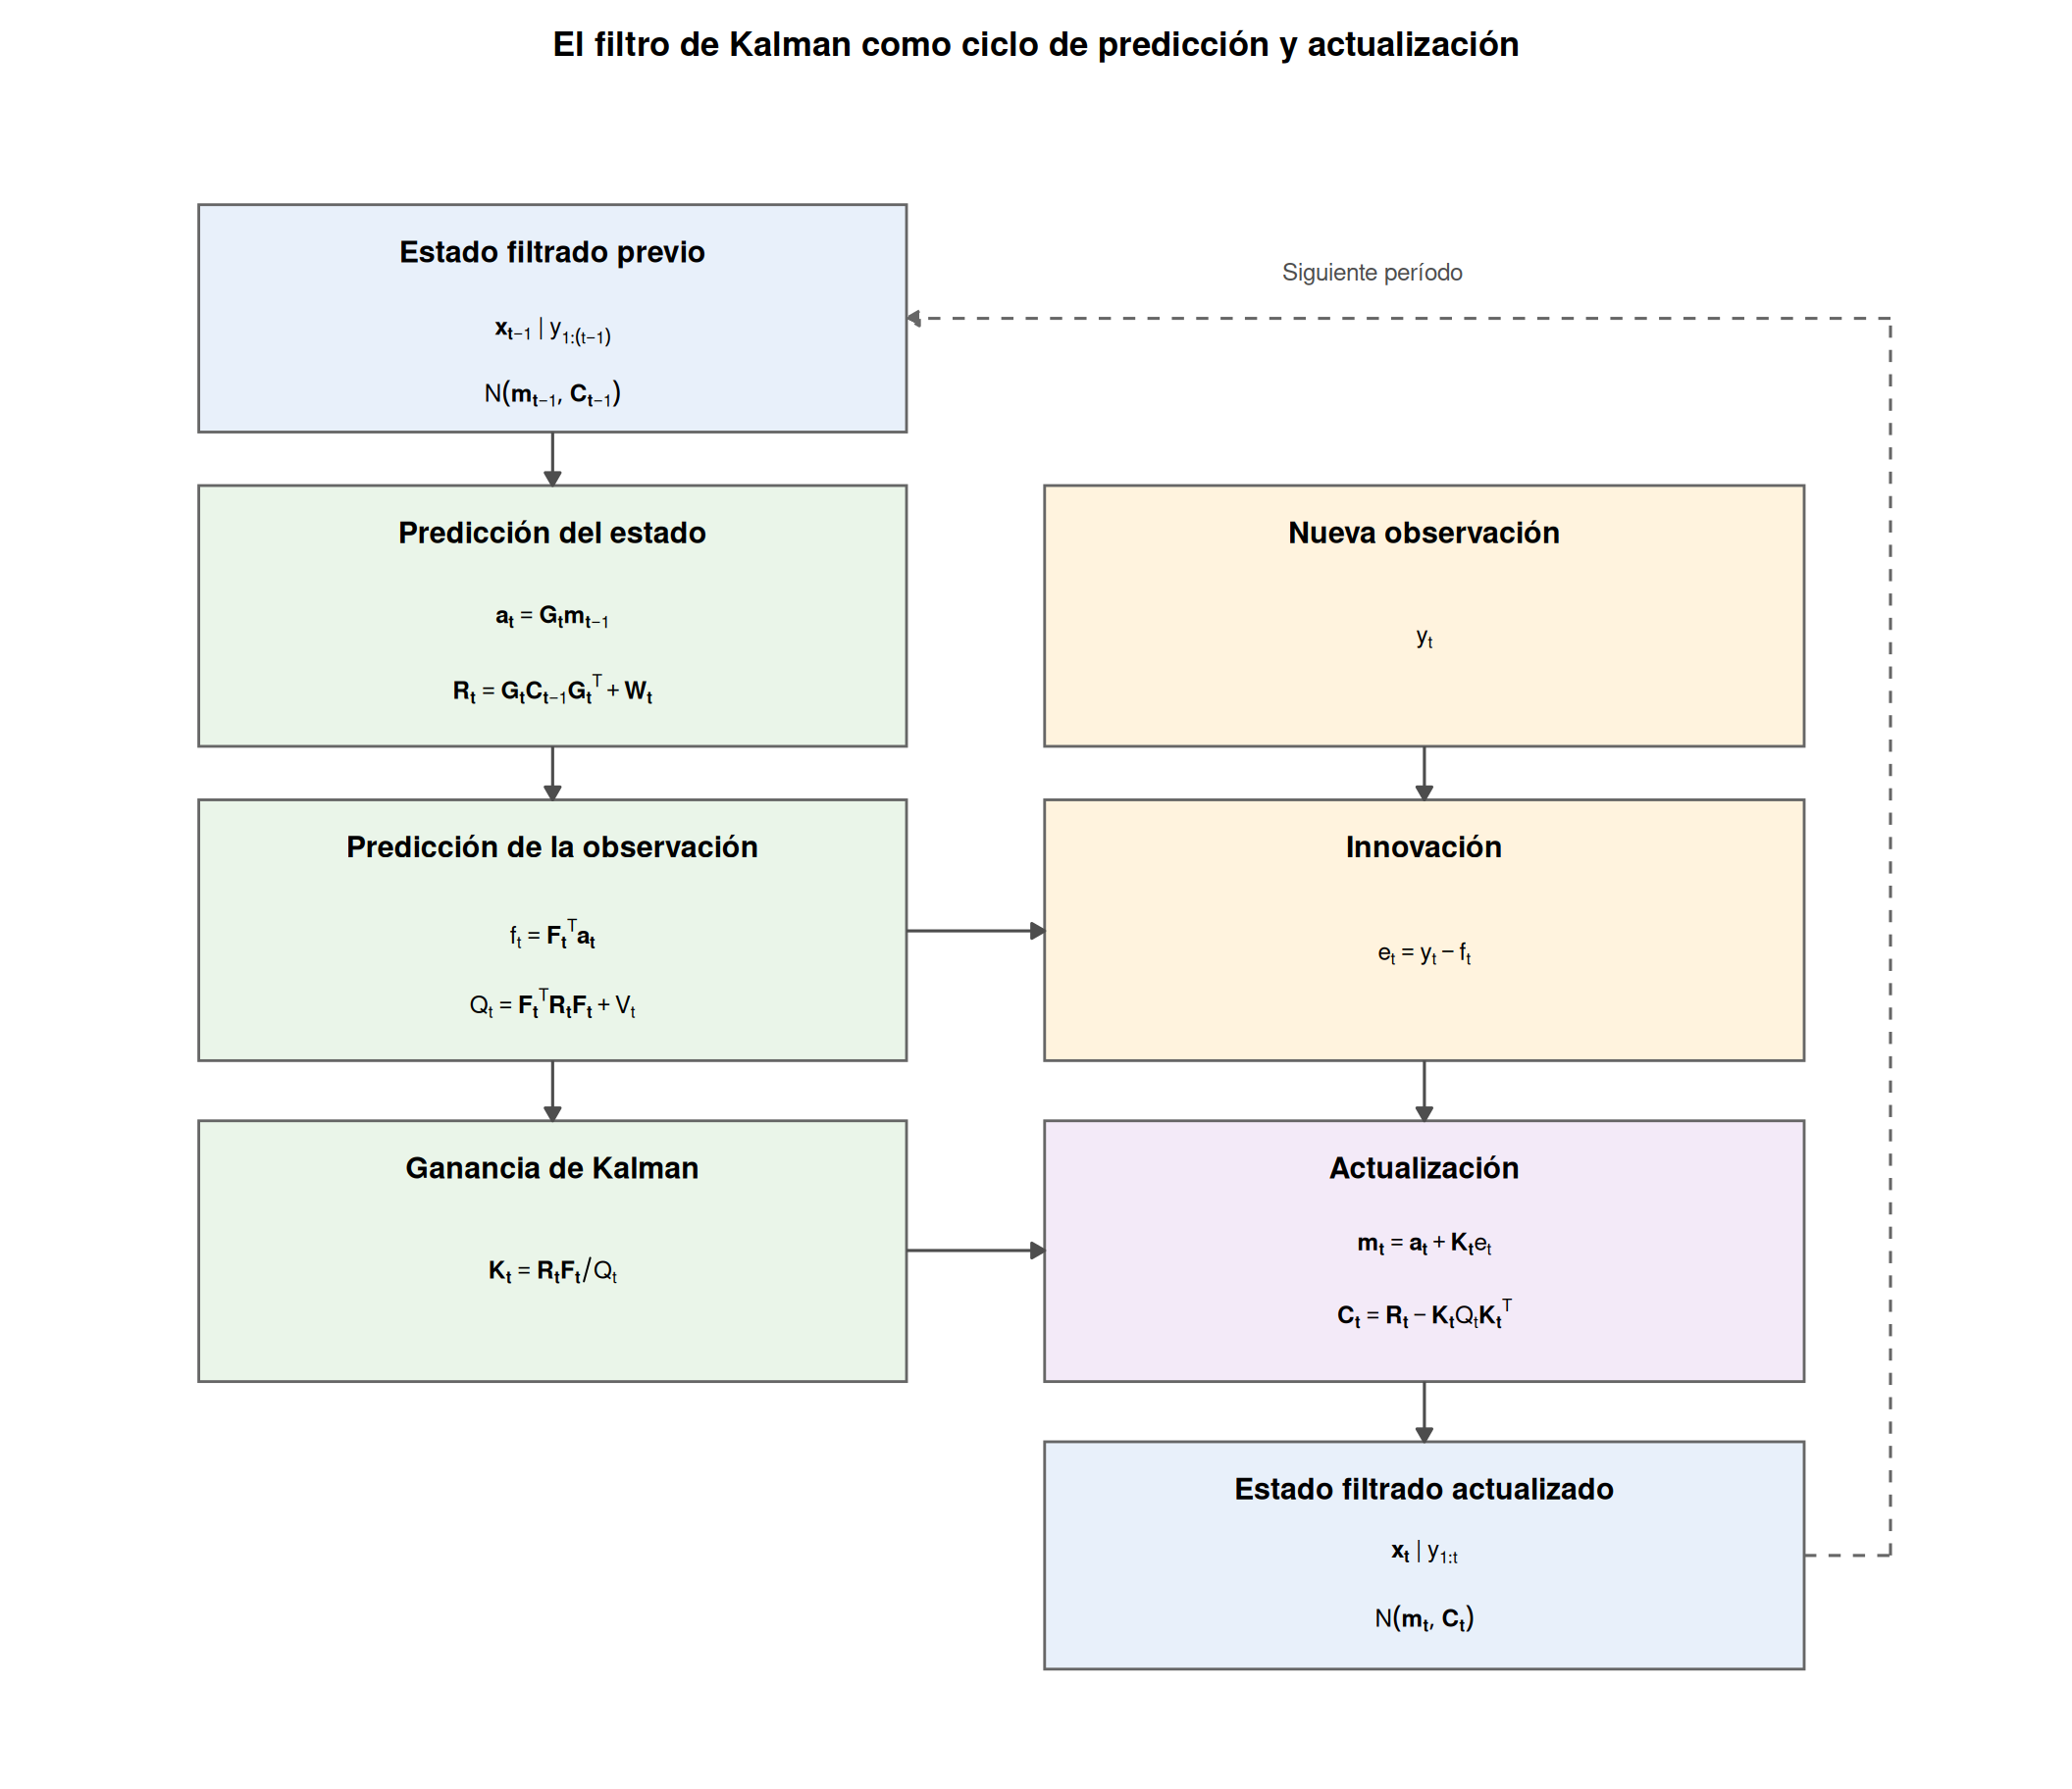
El procedimiento puede comenzar con \(\boldsymbol m_0,\boldsymbol C_0\) y repetirse a medida que llegan nuevas observaciones. No es necesario volver a procesar toda la historia: toda la información pasada necesaria para la actualización está condensada en la distribución filtrada anterior.
Figura 11.2: Secuencia de predicción y actualización en el filtro de Kalman. Las distribuciones filtradas proporcionan las condiciones iniciales para el siguiente período.
La Figura 11.2 resume la estructura recursiva del filtro de Kalman. A partir de la distribución filtrada en \(t-1\), se construyen las distribuciones predictivas del estado y de la observación en \(t\). La nueva observación \(y_t\) permite calcular la innovación \(e_t=y_t-f_t\), mientras que la ganancia de Kalman determina cómo utilizar dicha innovación para actualizar la distribución del estado.
La distribución filtrada resultante constituye el punto de partida para la predicción del siguiente período. De esta manera, el filtro alterna entre dos operaciones fundamentales: propagación de la incertidumbre mediante el modelo de transición y reducción de la incertidumbre mediante la información observada.
11.7 Ganancia de Kalman e interpretación bayesiana
11.7.1 El caso escalar como promedio ponderado
Consideremos por un momento la observación directa de un estado escalar:
Si \(R_t,V>0\), entonces \(0<K_t<1\). Por tanto, la media filtrada es un promedio ponderado de la predicción previa y de la observación actual. Las ponderaciones dependen de las incertidumbres:
Observación muy precisa: si \(V\to0\) y \(R_t>0\) permanece fijo, entonces \(K_t\to1\); el dato nuevo domina la actualización.
Observación muy ruidosa: si \(V\to\infty\) y \(R_t\) permanece fijo, entonces \(K_t\to0\); la predicción previa recibe casi todo el peso.
Estado predictivo casi conocido: si \(R_t\to0\) y \(V>0\) permanece fijo, la observación apenas cambia la media del estado.
Estas fórmulas son las mismas de una actualización normal–normal. En efecto, la identidad de Bayes establece
\[
\underbrace{p(x_t\mid y_{1:t})}_{\text{distribución filtrada}}
\propto
\underbrace{p(y_t\mid x_t)}_{\text{verosimilitud del dato}}\cdot
\underbrace{p(x_t\mid y_{1:t-1})}_{\text{distribución predictiva del estado}}.
\tag{11.31}\]
En este contexto, la predictiva del estado funciona como una priori secuencial y la distribución filtrada es la posterior secuencial. La inferencia es bayesiana respecto de los estados, aunque las varianzas del sistema se traten como constantes conocidas (Petris et al. 2009, secs. 2.2, 2.7; Prado et al. 2021, sec. 4.3.1).
NotaDos interpretaciones compatibles
Desde la perspectiva frecuentista, con parámetros conocidos, el filtro proporciona una media condicional óptima en error cuadrático medio bajo el modelo lineal gaussiano. Desde la perspectiva bayesiana, calcula exactamente la distribución posterior del estado dado el conjunto de observaciones disponible. En el caso gaussiano ambas perspectivas conducen a las mismas recursiones. La diferencia reaparecerá cuando consideremos las varianzas y los demás parámetros como desconocidos.
11.7.2 Ejemplo numérico: una sola actualización
Supongamos que la predicción anterior del estado es \(N(10,5)\) y que el error de observación tiene varianza \(V=9\). Si observamos \(y_t=14\), entonces
La media se mueve hacia la observación, pero no coincide con ella porque el dato está contaminado por un error de varianza considerable. La varianza posterior (\(45/14\)) es menor que la predictiva (\(5\)). Conviene comprobar esta actualización primero a mano y luego con R.
El estado \(x_t\) es una caminata aleatoria cuando \(W>0\). Por tanto, en general no es estacionario. Esto no impide aplicar el filtro: la estacionariedad de la serie observada no es un requisito del modelo lineal gaussiano.
El parámetro \(V\) representa ruido de observación, mientras que \(W\) determina cuánto puede cambiar el nivel latente de un período a otro. La razón \(W/V\) es importante: un valor grande facilita una adaptación rápida del filtro, mientras que un valor pequeño favorece trayectorias filtradas más suaves.
11.8.1 La ganancia depende de la razón entre varianzas
Al sustituir \(R_t=C_{t-1}+W\) en Ecuación 11.26, obtenemos
La ganancia también depende de la incertidumbre inicial y de su evolución recursiva. En sistemas homogéneos, con \(V>0\) y \(W>0\), suele estabilizarse: su límite \(K_\infty\) puede obtenerse resolviendo una ecuación de Riccati escalar.
Para derivarlo, supongamos que \(C_t\to C_\infty\) y escribamos \(R_\infty=C_\infty+W\). De Ecuación 11.28,
Este límite es útil para comprender el vínculo posterior con suavizamiento exponencial. No es necesario que el filtro alcance exactamente su régimen límite para aplicarse en muestras finitas.
11.9 Simulación: conocemos el estado verdadero
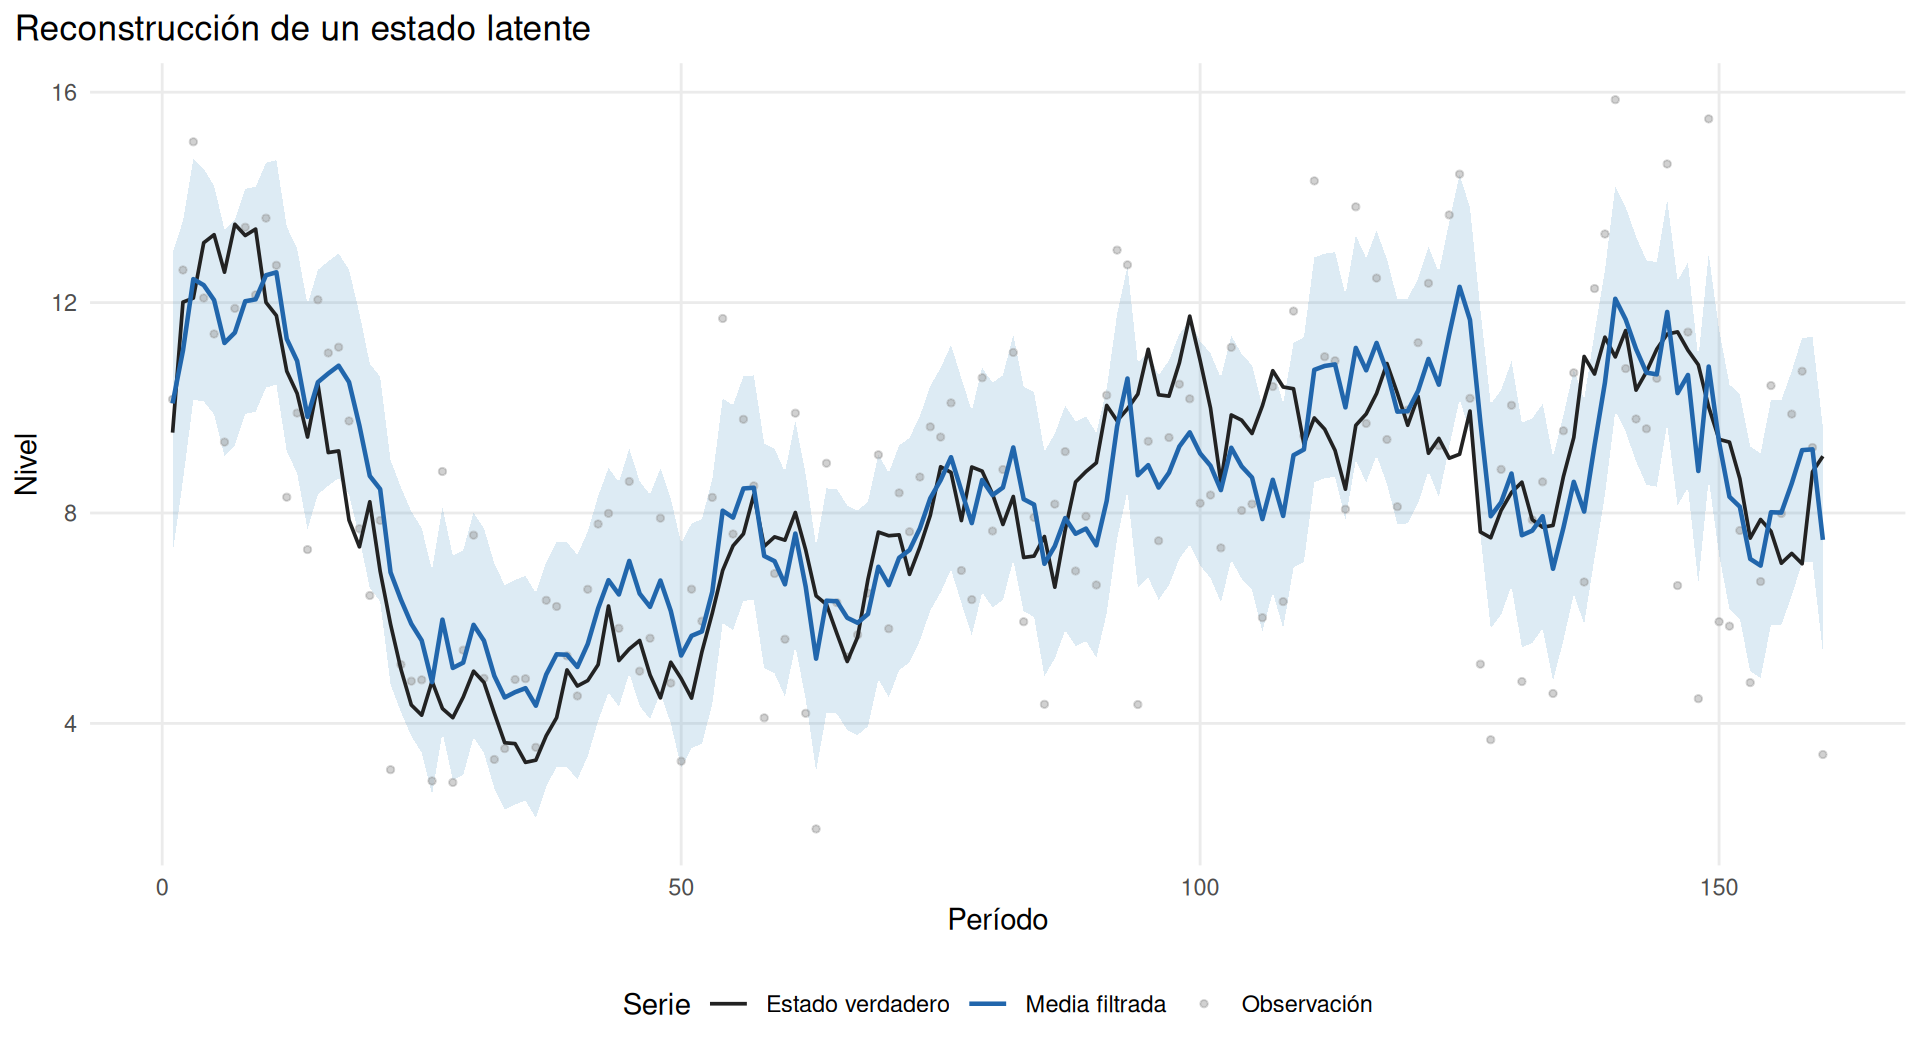
Los datos reales casi nunca nos permiten observar el estado latente. La simulación, en cambio, ofrece una oportunidad para comparar el nivel verdadero \(x_t\), la medición \(y_t\) y la inferencia filtrada \(m_t\).
Consideraremos \(160\) períodos con \(V=4\) y \(W=0.5\). El estado inicial será aleatorio con media \(10\) y varianza \(4\); emplearemos esa misma distribución inicial al ejecutar el filtro.
V_sim <-4W_sim <-0.5m0_sim <-10C0_sim <-4n_sim <-160Lsim_ss <-simular_nivel_local(n = n_sim,m0 = m0_sim, C0 = C0_sim,V = V_sim, W = W_sim,semilla =415)fil_sim <-filtrar_nivel_local(y = sim_ss$y,m0 = m0_sim, C0 = C0_sim,V = V_sim, W = W_sim)stopifnot(nrow(sim_ss) ==nrow(fil_sim),!anyNA(sim_ss), !anyNA(fil_sim))grafico_sim_ss <- sim_ss |>left_join(fil_sim |>select(t, m, C), by ="t") |>mutate(lim_inf = m -qnorm(0.975) *sqrt(C),lim_sup = m +qnorm(0.975) *sqrt(C) )
ggplot(grafico_sim_ss, aes(x = t)) +geom_ribbon(aes(ymin = lim_inf, ymax = lim_sup),fill ="#4393c3", alpha =0.18) +geom_point(aes(y = y, colour ="Observación"),size =0.95, alpha =0.45) +geom_line(aes(y = x, colour ="Estado verdadero"),linewidth =0.65) +geom_line(aes(y = m, colour ="Media filtrada"),linewidth =0.8) +scale_colour_manual(values =c("Observación"="#999999","Estado verdadero"="#222222","Media filtrada"="#2166ac") ) +labs(x ="Período", y ="Nivel",title ="Reconstrucción de un estado latente",colour ="Serie") + tema_ss
Figura 11.3: Modelo de nivel local simulado: estado verdadero, mediciones y media filtrada. La banda es un intervalo condicional del 95 % para el estado latente, no un intervalo para una nueva observación.
En Figura 11.3 el filtro no reproduce todas las oscilaciones de \(y_t\), porque atribuye parte de esas oscilaciones al ruido de medición. Sin embargo, tampoco coincide perfectamente con el estado verdadero: incluso cuando conocemos los parámetros, la información sobre \(x_t\) es incompleta.
11.9.1 La actualización de una distribución
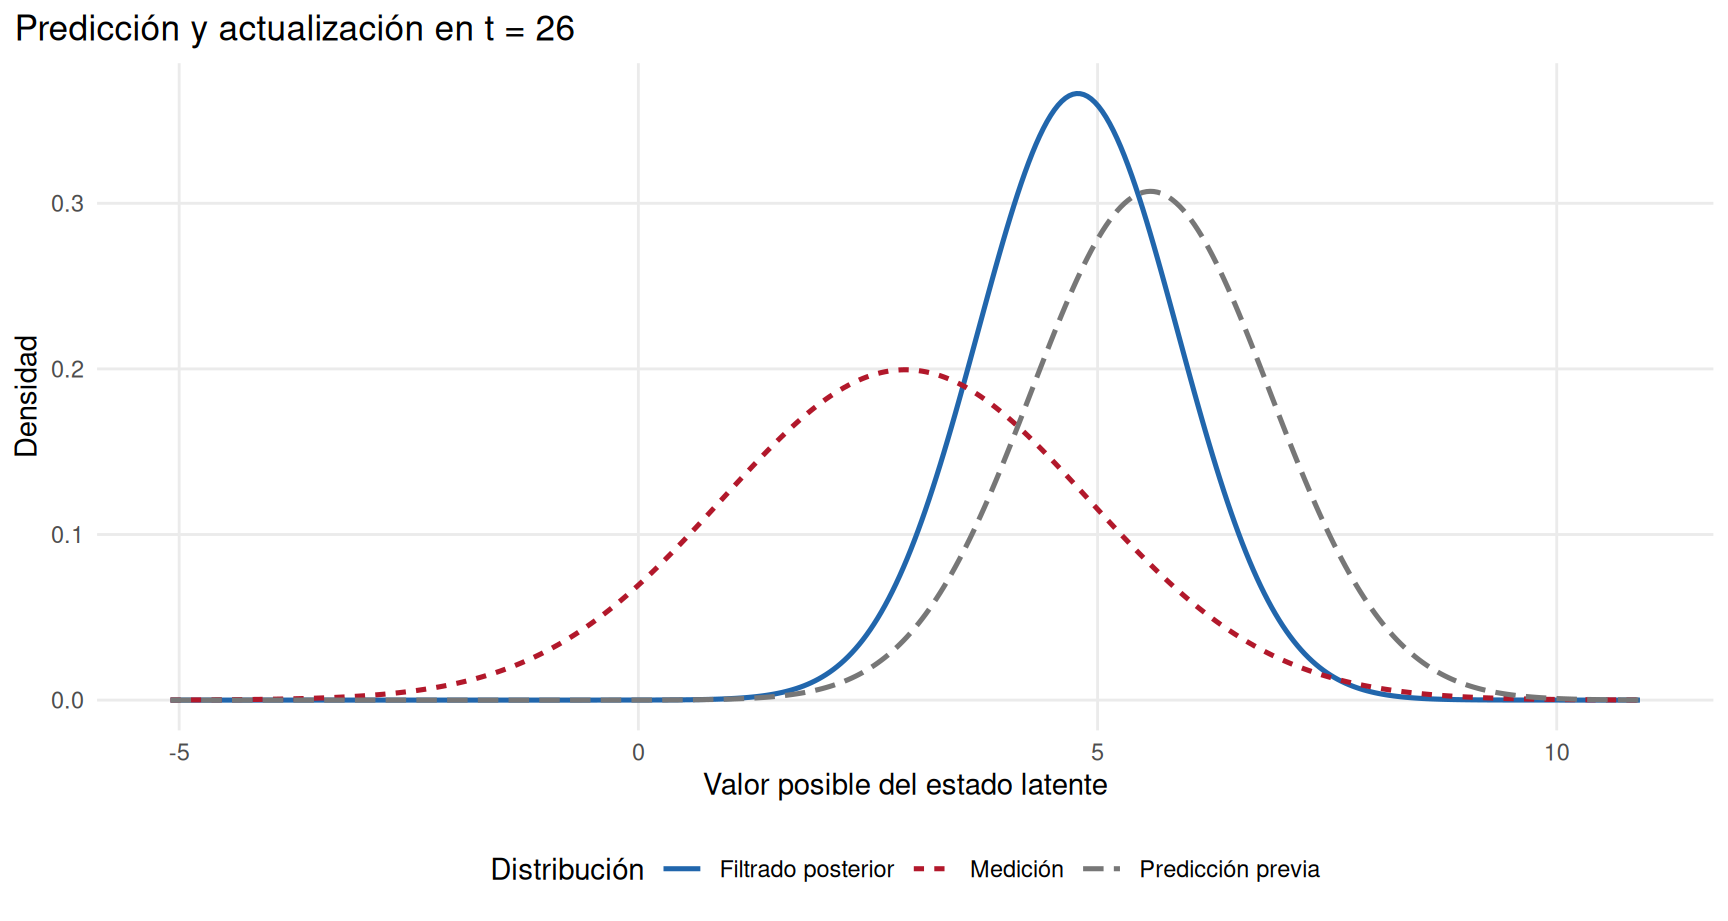
La siguiente figura selecciona un período de la simulación y superpone tres funciones: la distribución predictiva del estado, la verosimilitud (normalizada como función del estado en este ejemplo escalar) y la distribución filtrada.
Figura 11.4: Actualización gaussiana en un período seleccionado. La distribución posterior del estado combina la predicción previa con la información contenida en la nueva medición.
La posterior combina dos fuentes de información: el conocimiento anterior resumido en \(N(a_t,R_t)\) y el dato \(y_t\) condicionado en el estado. La actualización ocurre con una sola observación, pero es válida independientemente de cuántas observaciones pasadas haya procesado el filtro.
11.9.2 Sensibilidad de la ganancia a las varianzas
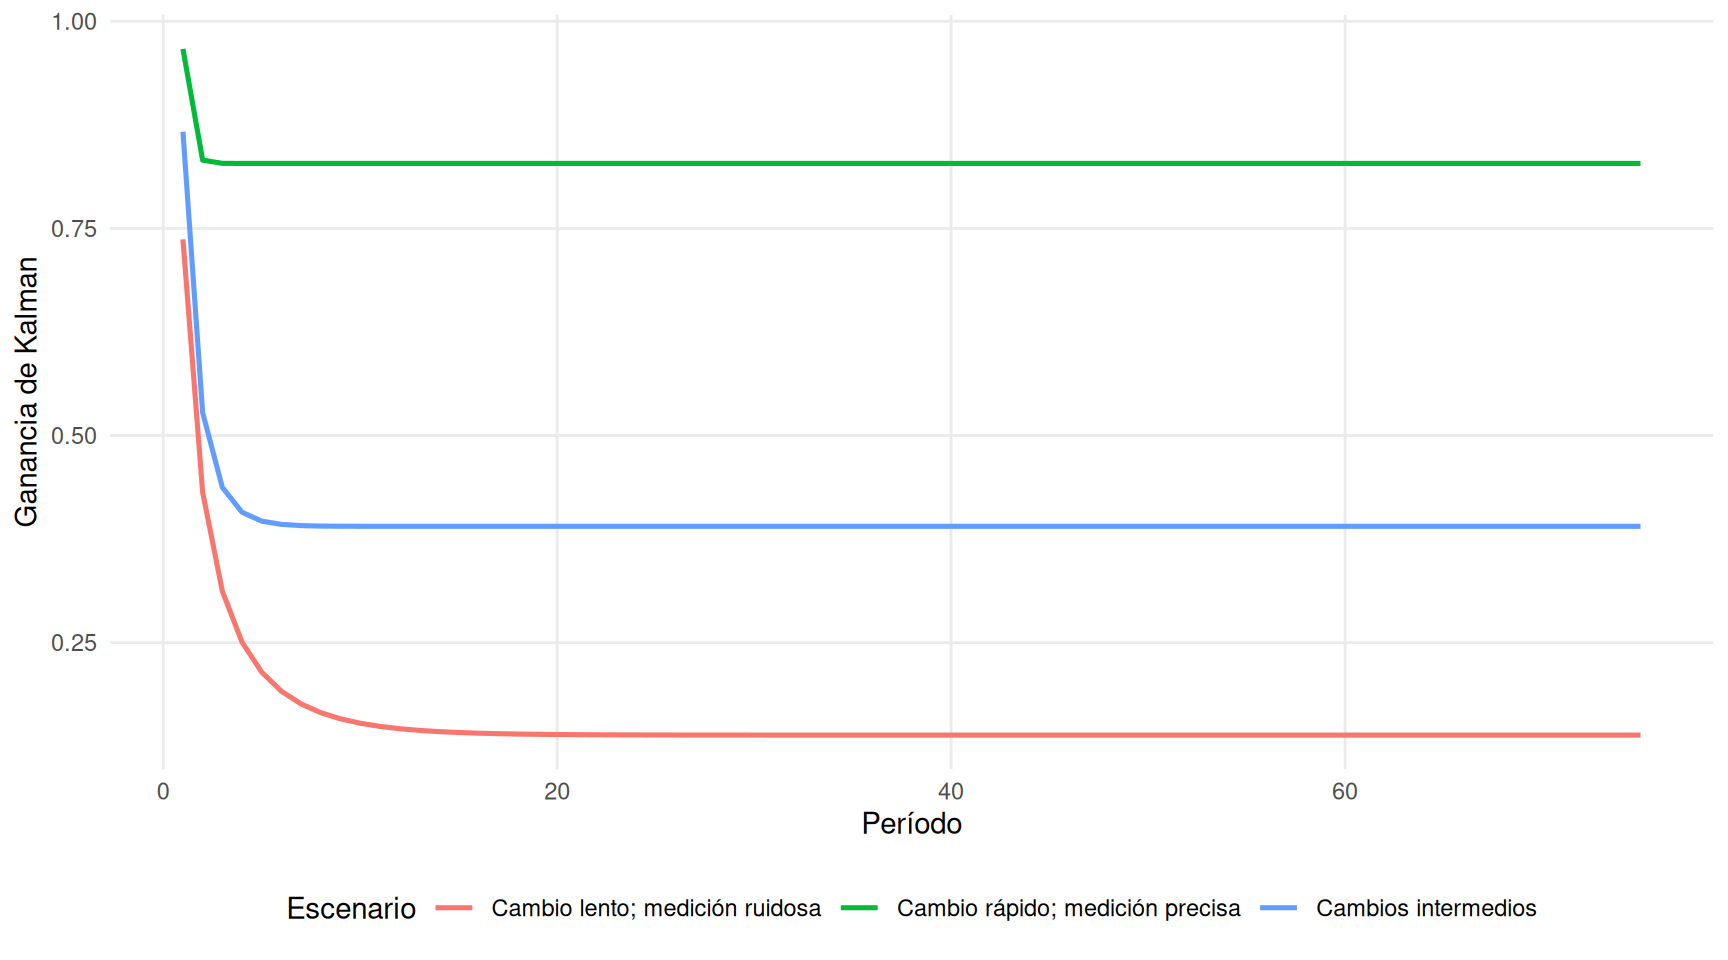
Como la ganancia en el modelo lineal gaussiano depende de las covarianzas y no del valor observado, podemos estudiar su evolución sin necesidad de generar una trayectoria aleatoria específica. Para cada escenario utilizamos observaciones artificiales iguales a cero; sus valores no afectan la sucesión de ganancias.
Figura 11.5: Ganancia de Kalman en tres escenarios de relación entre variación del estado y error de observación, con igual incertidumbre inicial. Cada curva converge hacia una ganancia límite distinta.
En un problema aplicado, una gran ganancia indica que el modelo da peso importante al dato nuevo. No significa necesariamente que dicho dato sea confiable en términos absolutos: la ganancia expresa una comparación de incertidumbres, no un índice universal de calidad de la medición.
11.10 Implementación manual y verificación con dlm
La función filtrar_nivel_local() reproduce línea por línea las operaciones de Ecuación 11.35:
tomar el estado filtrado del período anterior;
predecir el nivel y añadir la varianza de evolución \(W\);
predecir la observación y calcular la innovación;
calcular la ganancia;
actualizar media y varianza del estado.
La función almacena las cantidades antes y después de cada observación para evitar confundirlas. Para comprobar que el algoritmo no depende de una implementación particular, verificaremos la media filtrada con el paquete dlm, desarrollado para modelos lineales dinámicos y empleado en (Petris et al. 2009). La documentación oficial de dlmFilter() confirma que su componente m incluye el estado inicial antes del primer dato.
modelo_dlm_sim <- dlm::dlmModPoly(order =1,dV = V_sim,dW = W_sim,m0 = m0_sim,C0 = C0_sim)fil_dlm_sim <- dlm::dlmFilter(sim_ss$y, modelo_dlm_sim)# dlm$m incluye el estado inicial en su primera posición.medias_dlm <-as.numeric(fil_dlm_sim$m)[-1L]stopifnot(length(medias_dlm) == n_sim,max(abs(medias_dlm - fil_sim$m)) <1e-6)comparacion_dlm <-tibble(t =seq_len(n_sim),manual = fil_sim$m,paquete_dlm = medias_dlm,diferencia = manual - paquete_dlm)knitr::kable( comparacion_dlm |>filter(t %in%c(1, 2, 10, 60, 160)),digits =7)
Tabla 11.2: Comparación entre la media filtrada calculada manualmente y la obtenida con dlm en cinco períodos de la simulación.
t
manual
paquete_dlm
diferencia
1
10.084948
10.084948
0
2
11.087885
11.087885
0
10
12.520201
12.520201
0
60
6.644224
6.644224
0
160
7.489687
7.489687
0
La coincidencia numérica comprueba esta implementación escalar bajo la misma especificación e inicialización. No constituye una prueba general de corrección para todos los modelos o para otras opciones de inicialización.
11.11 Dos representaciones adicionales
11.11.1 AR(1) con error de medición
Un modelo autorregresivo latente puede escribirse como
\[
x_t=\phi x_{t-1}+w_t,
\qquad |\phi|<1,
\]
\[
Y_t=x_t+v_t,
\tag{11.39}\]
con perturbaciones independientes de varianzas \(W\) y \(V\), respectivamente. Aquí \(F=1\), \(G=\phi\). Cuando \(W>0\) y \(|\phi|<1\), una distribución inicial estacionaria del estado es
\[
x_0\sim N\left(0,\frac{W}{1-\phi^2}\right).
\]
Si \(V=0\), observamos el propio AR(1); si \(V>0\), el modelo observado incorpora ruido adicional y no debe confundirse con un AR(1) puro. Esta formulación separa conceptualmente una dinámica latente persistente de la variabilidad introducida por la medición.
11.11.2 Nivel y tendencia local: vista anticipatoria
Un ejemplo con estado bidimensional es el modelo de tendencia lineal local:
El estado incluye un nivel \(\ell_t\) y una pendiente \(b_t\) que puede cambiar con el tiempo. Esta representación retoma los componentes de Holt estudiados en Sección 8.6, pero ahora en una formulación gaussiana con perturbaciones de estado explícitas. La aplicación y estimación de modelos estructurales más elaborados corresponderá a la semana 12 (Petris et al. 2009, sec. 3.2.1).
11.12 Conexión con ARIMA y suavizamiento exponencial
11.12.1 El modelo de nivel local y ARIMA\((0,1,1)\)
Supongamos \(V>0\) y \(W>0\) constantes, con perturbaciones gaussianas independientes. A partir de Ecuación 11.33 y Ecuación 11.34,
Por tanto, las observaciones admiten una representación ARIMA\((0,1,1)\) sin deriva, con coeficiente MA negativo bajo la convención \(\Delta Y_t=\eta_t+\theta\eta_{t-1}\). La representación de los estados y la representación marginal ARIMA ofrecen perspectivas distintas de la misma distribución observada. Si \(W=0\), el coeficiente límite es \(\theta=-1\) y la representación MA resulta no invertible; si \(V=0\), las diferencias son ruido blanco y el coeficiente MA es cero.
NotaIdentificación y equivalencia observacional
Obtener una representación ARIMA de la serie observada no demuestra que el nivel latente propuesto sea la única descomposición físicamente válida. La interpretación de estado y error de medición requiere supuestos sustantivos además de equivalencia estadística.
11.12.2 ¿Por qué aparece suavizamiento exponencial?
En el nivel local,
\[
m_t=m_{t-1}+K_t(y_t-m_{t-1}).
\tag{11.46}\]
Comparemos esta relación con la recursión de suavizamiento exponencial simple de Sección 8.3.1:
\[
\ell_t=\ell_{t-1}+\alpha(y_t-\ell_{t-1}).
\]
Las expresiones tienen la misma estructura. La diferencia inicial es que el filtro determina\(K_t\) a partir de las covarianzas del modelo, mientras que en SES se introduce directamente un parámetro de suavizamiento \(\alpha\).
Cuando \(V,W>0\) permanecen constantes y la ganancia converge a \(K_\infty\), el filtro se comporta como SES con \(\alpha=K_\infty\). Si \(K_t\) todavía no es estable, la correspondencia es con un suavizamiento de ganancia variable. Además, el filtro proporciona una distribución condicional del estado y de las futuras observaciones, no solo una secuencia de pronósticos puntuales.
Esta conexión es especialmente relevante tras estudiar ETS\((A,N,N)\) en Sección 8.11. Las formulaciones pueden inducir los mismos pronósticos, sin que ello implique que sus perturbaciones latentes tengan exactamente la misma interpretación estructural (Petris et al. 2009, secs. 3.1–3.2; Hyndman y Athanasopoulos 2021, sec. 8.5).
11.13 Pronóstico con parámetros conocidos
Una vez terminado el filtrado en el origen \(T\), disponemos de la distribución condicional del estado
Nuestro objetivo es determinar la distribución predictiva del estado \(\boldsymbol x_{T+h}\) y de la observación \(Y_{T+h}\), para un horizonte \(h\geq 1\), utilizando únicamente la información disponible hasta el instante \(T\).
Durante esta etapa no se dispone de nuevas observaciones \(y_{T+1},\ldots,y_{T+h}\). Por tanto, las distribuciones futuras se obtienen propagando la distribución filtrada mediante las ecuaciones del modelo, sin aplicar nuevas actualizaciones de Kalman.
11.13.1 Propagación del estado hacia el futuro
Consideremos la ecuación de transición del modelo lineal gaussiano,
donde las matrices \(\boldsymbol G\) y \(\boldsymbol W\) son constantes.
Suponemos que las perturbaciones de estado son independientes entre períodos e independientes del estado inicial y de las perturbaciones de observación. En particular, las perturbaciones futuras \(\boldsymbol w_{T+1},\boldsymbol w_{T+2},\ldots\) son independientes del estado \(\boldsymbol x_T\) y de las observaciones \(y_{1:T}\).
Para un horizonte de un período, la ecuación de transición proporciona directamente
Estas expresiones revelan un patrón: el estado futuro se obtiene propagando el estado actual mediante una potencia de \(\boldsymbol G\) y acumulando las perturbaciones de estado generadas durante los períodos intermedios.
En general, mediante sustituciones sucesivas o por inducción matemática, obtenemos
En esta expresión, \(\boldsymbol G^0=\boldsymbol I_p\). Por ello, el término correspondiente a \(j=0\) es precisamente la perturbación más reciente, \(\boldsymbol w_{T+h}\), mientras que la perturbación \(\boldsymbol w_{T+1}\) aparece multiplicada por \(\boldsymbol G^{h-1}\).
Propagación del estado actual:\(\boldsymbol G^h\boldsymbol x_T\), que transmite hacia el horizonte \(h\) la incertidumbre que todavía existe sobre el estado en \(T\).
Acumulación de perturbaciones futuras: la suma de los términos \(\boldsymbol G^j\boldsymbol w_{T+h-j}\), que introduce incertidumbre adicional en cada período de pronóstico.
A partir de esta representación podemos derivar las dos primeras cantidades fundamentales del pronóstico: su media y su matriz de covarianzas.
11.13.2 Derivación de la media predictiva del estado
Definimos la media predictiva de horizonte \(h\) como
Esta expresión muestra que la media predictiva se calcula aplicando la matriz de transición \(\boldsymbol G\) un total de \(h\) veces sobre la media filtrada \(\boldsymbol m_T\).
Es importante destacar que las perturbaciones futuras no contribuyen a la media porque tienen esperanza cero. Sin embargo, esto no significa que puedan ignorarse al cuantificar la incertidumbre predictiva: sus varianzas sí deben incorporarse.
11.13.3 Derivación de la covarianza predictiva del estado
La matriz de covarianzas predictiva se define como
Segundo, la covarianza de una suma de vectores aleatorios incluye sus covarianzas individuales y los términos de covarianza cruzada. Si los vectores son condicionalmente independientes, estos últimos términos son nulos.
En nuestro modelo, las perturbaciones futuras son independientes entre sí y también del estado \(\boldsymbol x_T\) y de las observaciones \(y_{1:T}\). En consecuencia, todos los términos de covarianza cruzada desaparecen después de condicionar en la información disponible.
El primer término refleja que el estado actual no se conoce exactamente: incluso después del filtrado, la distribución de \(\boldsymbol x_T\) posee una matriz de covarianzas \(\boldsymbol C_T\).
El segundo término representa la incertidumbre introducida durante los \(h\) períodos futuros. Cada perturbación se transforma mediante una potencia de \(\boldsymbol G\), de acuerdo con el tiempo transcurrido desde su aparición hasta el horizonte del pronóstico.
con condición inicial \(\boldsymbol R_{T\mid T}=\boldsymbol C_T\).
Conviene señalar que conocer los parámetros\(\boldsymbol G\) y \(\boldsymbol W\) no equivale a conocer las realizaciones futuras de las perturbaciones. Por esta razón, el pronóstico conserva incertidumbre incluso cuando todas las matrices del modelo son conocidas.
Asimismo, la forma en que evoluciona la incertidumbre con \(h\) depende de la dinámica representada por \(\boldsymbol G\). No necesariamente aumenta sin límite: en modelos estables puede converger a una matriz de covarianzas finita, mientras que en modelos con raíces unitarias puede crecer con el horizonte.
11.13.4 Distribución predictiva de las observaciones
Una vez determinadas la media y la covarianza predictivas del estado, podemos obtener las correspondientes cantidades para una observación futura.
Obsérvese que \(Q_{T+h\mid T}\) incorpora tanto la incertidumbre del estado futuro como la variabilidad del error de observación. El segundo componente aparece porque nuestro objetivo es predecir una observación futura, no solamente el estado latente correspondiente.
Por consiguiente, la distribución predictiva del estado es
\[
x_{T+h}\mid y_{1:T}
\sim N(m_T,C_T+hW).
\]
Como \(F=1\), la media predictiva de la observación también es \(m_T\). Para calcular su varianza, debemos añadir la varianza del error de observación:
Este resultado permite distinguir claramente el comportamiento del pronóstico puntual y el de su incertidumbre.
Los pronósticos puntuales son planos porque el nivel futuro sigue una caminata aleatoria sin deriva: su esperanza condicional permanece igual a la última media filtrada, \(m_T\).
Sin embargo, la incertidumbre aumenta linealmente con el horizonte cuando \(W>0\), ya que en cada período se incorpora una nueva perturbación de estado independiente con varianza \(W\).
En consecuencia, aunque todos los pronósticos puntuales tengan el mismo valor, las distribuciones predictivas son cada vez más dispersas a medida que aumenta \(h\).
Un intervalo predictivo central de nivel nominal \(1-\alpha\) para una observación futura es
Por tanto, aunque la varianza predictiva aumenta linealmente con \(h\), la amplitud del intervalo crece de acuerdo con la raíz cuadrada de esa varianza.
Finalmente, es importante distinguir este intervalo, que predice una observación futura, de un intervalo para el estado futuro, cuya varianza es \(C_T+hW\) y no incluye el término adicional \(V\).
Esta distinción resulta especialmente importante cuando el error de medición es considerable: podemos tener una estimación relativamente precisa del nivel latente y, al mismo tiempo, mantener intervalos predictivos amplios para las observaciones futuras.
11.13.6 Dos protocolos diferentes
En una aplicación deben distinguirse al menos dos esquemas:
Origen fijo: se ajusta el estado con \(y_{1:T}\) y se predice \(Y_{T+1},\ldots,Y_{T+H}\) sin incorporar ninguna observación posterior a \(T\).
Origen móvil, un paso: una vez observado \(y_{T+1}\), se actualiza la distribución filtrada del estado y se pronostica \(Y_{T+2}\). Se repite el procedimiento en cada origen; ninguna predicción puede utilizar la observación que intenta predecir.
Las fórmulas del filtro pueden generar ambos tipos de pronóstico, pero las preguntas predictivas no son equivalentes. Esta distinción retoma Sección 7.3.1 y Sección 7.8.
11.14 Aplicación real: caudal anual del río Nilo
Utilizaremos datasets::Nile, una serie anual incluida en R. Contiene 100 observaciones de caudal del río Nilo, correspondientes a los años 1871–1970. Los valores históricos se expresan en las unidades del conjunto de datos (según la documentación oficial de R, \(10^8\,\mathrm{m}^3\)). Es un ejemplo conocido en el estudio de cambios en el nivel y modelos estructurales.
Nuestro objetivo no es afirmar que el nivel local sea necesariamente el modelo verdadero de la serie, sino ilustrar cómo funciona el filtrado al trabajar con una señal latente y datos reales (Petris et al. 2009, sec. 3.2.1).
11.14.1 Preparación y partición temporal
Reservaremos los últimos 20 años como período de prueba. La separación se hará antes de cualquier análisis de desempeño; el filtro tendrá parámetros fijados de antemano y no se seleccionarán ni ajustarán usando los resultados de la prueba.
Estas son elecciones didácticas y no estimaciones estadísticas. Su interpretación es que la desviación estándar del error de observación es \(130\) unidades del caudal, la del cambio anual latente es \(40\) y la incertidumbre inicial tiene desviación estándar \(200\). No utilizaremos los datos de prueba para fijarlas. Elegir parámetros y verificarlos frente a la evidencia observada es un problema distinto, que abordaremos por máxima verosimilitud en la semana 12.
m0_nilo <-900C0_nilo <-200^2V_nilo <-130^2W_nilo <-40^2fil_nilo <-filtrar_nivel_local(y = nilo$caudal,m0 = m0_nilo,C0 = C0_nilo,V = V_nilo,W = W_nilo)# Se conserva explícitamente el conjunto al que pertenece cada dato.nilo_filtrado <- nilo |>left_join(fil_nilo, by ="t") |>mutate(estado_inf = m -qnorm(0.975) *sqrt(C),estado_sup = m +qnorm(0.975) *sqrt(C),pred_inf = f -qnorm(0.975) *sqrt(Q),pred_sup = f +qnorm(0.975) *sqrt(Q),innovacion_estandar = e /sqrt(Q) )stopifnot(nrow(nilo_filtrado) == n_nilo,all(is.finite(nilo_filtrado$pred_inf)),all(nilo_filtrado$pred_inf < nilo_filtrado$pred_sup))
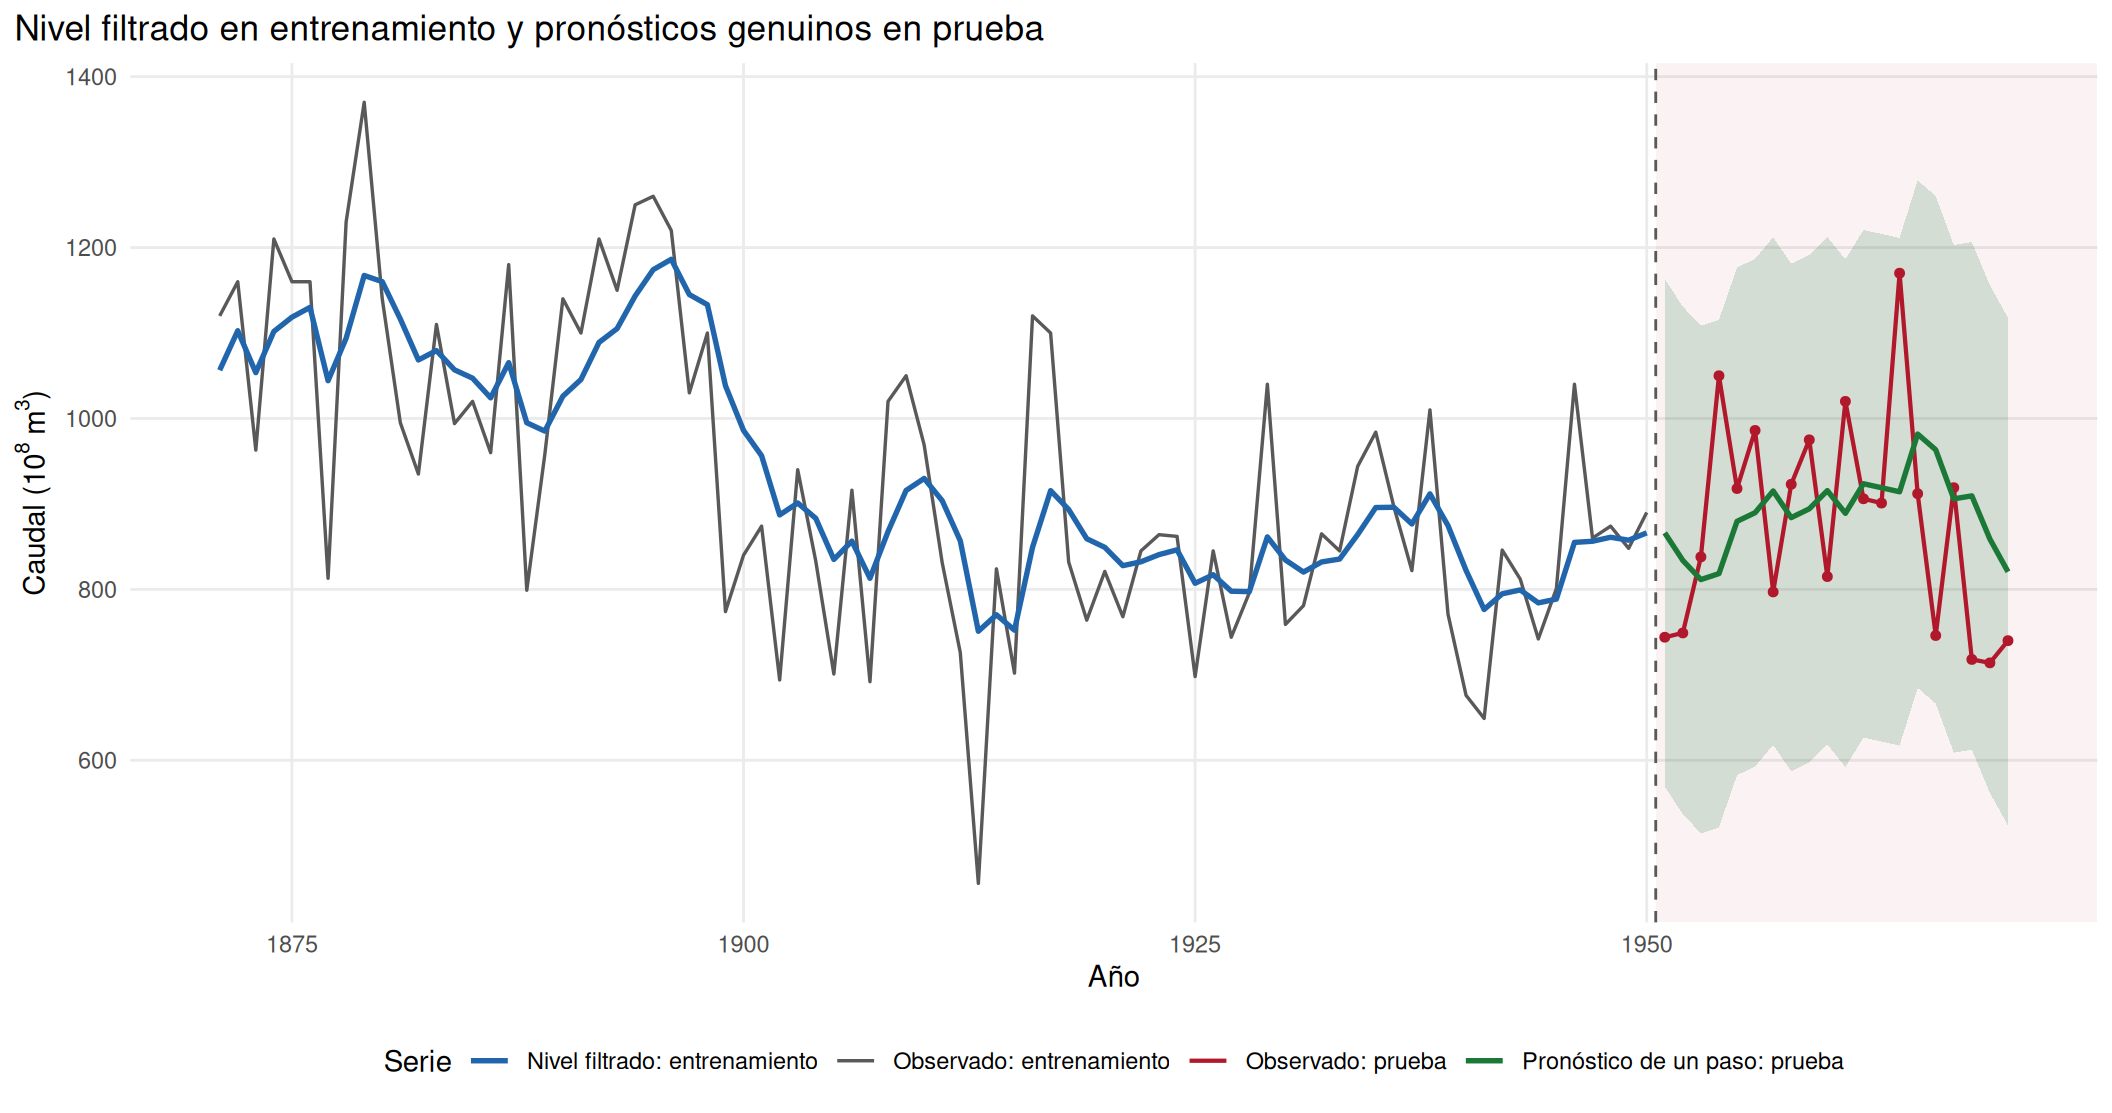
11.14.3 Filtrado y contraste entre entrenamiento y prueba
El gráfico distingue las observaciones de entrenamiento, las observaciones futuras reservadas para prueba y las medias filtradas de los estados. En el período de prueba, la curva de pronóstico de un paso \(f_t\) se calcula antes de incorporar \(y_t\), mientras que \(m_t\) se calcula después. Por eso mostraremos el filtrado solamente durante el entrenamiento y los pronósticos de un paso durante la prueba.
Figura 11.6: Caudal anual del Nilo. La línea vertical separa entrenamiento (1871–1950) y prueba (1951–1970). En entrenamiento se muestra la media del estado filtrado; en prueba se muestran exclusivamente los pronósticos de un paso emitidos antes de recibir cada observación, con sus intervalos predictivos del 95 %.
La distinción entre \(m_t\) y \(f_t\) evita una confusión frecuente: comparar el dato \(y_t\) con \(m_t\), que ya utilizó \(y_t\) para actualizarse, no equivale a evaluar un pronóstico genuino de un paso. En cambio, la comparación de \(y_t\) con \(f_t\) sí respeta el orden de la información, bajo el supuesto de que los parámetros del modelo se fijaron sin observar los datos de prueba.
11.14.4 Evaluación con origen móvil, horizonte uno
Para cada año del período de prueba, comparamos el pronóstico de Kalman de un paso con el método naïve. Este último utiliza el último caudal observado:
Tabla 11.3: Evaluación predictiva de horizonte uno en 1951–1970: comparación de un filtro de nivel local con parámetros supuestos y el método naïve. Las columnas de cobertura y amplitud se informan solo para el filtro, que tiene una distribución predictiva explícita en este ejercicio.
metodo
MAE
RMSE
MASE
cobertura_95
amplitud_95
Kalman: nivel local
103.878
126.271
0.775
1
593.985
Naïve
130.000
153.086
0.970
NA
NA
La cobertura es una frecuencia empírica de inclusión en intervalos predictivos del \(95\%\) sobre 20 años, no una garantía de que se alcance exactamente \(95\%\) en esa muestra. La amplitud promedio permite evaluar el compromiso entre precisión y dispersión de los intervalos. No asignaremos al método naïve un intervalo ad hoc para eludir una comparación probabilística mal especificada. La evaluación completa de distribuciones y puntuaciones probabilísticas se estudió en Sección 7.10 y Sección 7.11.
El filtro procesó secuencialmente todos los años, incluido el período de prueba. Esto no constituye fuga de información en la evaluación de un paso: cada predicción \(f_t\) se construye antes de actualizarse con \(y_t\). Una vez emitida y registrada esa predicción, \(y_t\) puede utilizarse para emitir el pronóstico del año siguiente. En cambio, no sería válido volver a estimar los parámetros usando datos futuros y atribuir los resultados a un procedimiento que únicamente conocía el entrenamiento.
11.14.5 Pronóstico de horizonte múltiple desde un origen fijo
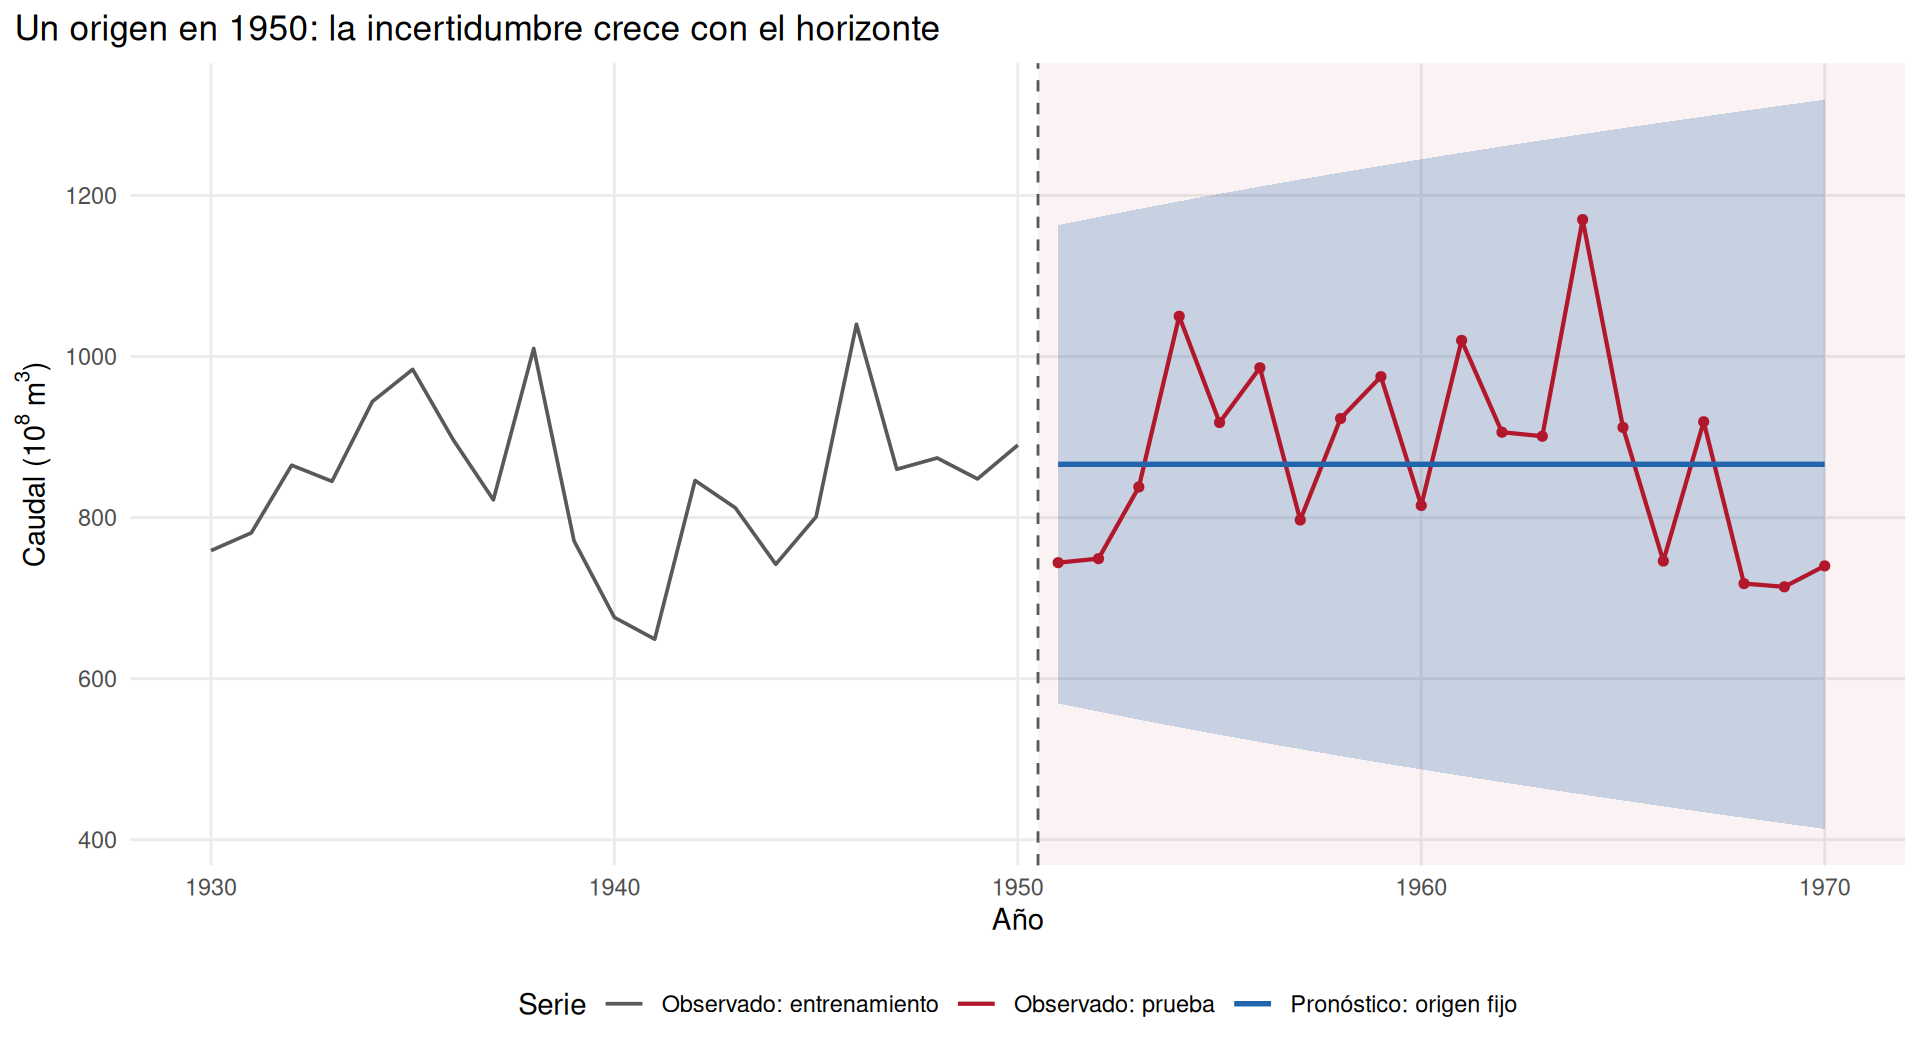
Ahora colocamos el origen del pronóstico en el último año de entrenamiento, 1950. Usaremos \(m_{80}\) y \(C_{80}\) y pronosticaremos, sin actualizaciones, los siguientes 20 años. En un nivel local los pronósticos puntuales de los 20 horizontes coinciden, pero su varianza aumenta según Ecuación 11.52.
observaciones_cercanas <- nilo |>filter(anio >=1930)ggplot() +annotate("rect", xmin = anio_corte_nilo, xmax =Inf,ymin =-Inf, ymax =Inf,fill ="#b2182b", alpha =0.055) +geom_ribbon(data = pronosticos_fijos,aes(x = anio, ymin = inferior_95, ymax = superior_95),fill ="#2166ac", alpha =0.23 ) +geom_line(data = observaciones_cercanas |>filter(periodo =="Entrenamiento"),aes(x = anio, y = caudal, colour ="Observado: entrenamiento"),linewidth =0.65 ) +geom_line(data = pronosticos_fijos,aes(x = anio, y = observado, colour ="Observado: prueba"),linewidth =0.75 ) +geom_point(data = pronosticos_fijos,aes(x = anio, y = observado),colour ="#b2182b", size =1.3 ) +geom_line(data = pronosticos_fijos,aes(x = anio, y = media, colour ="Pronóstico: origen fijo"),linewidth =0.95 ) +geom_vline(xintercept = anio_corte_nilo,linetype ="dashed", colour ="grey35") +scale_colour_manual(values =c("Observado: entrenamiento"="#595959","Observado: prueba"="#b2182b","Pronóstico: origen fijo"="#2166ac") ) +labs(x ="Año", y =expression("Caudal ("*10^8*" m"^3*")"),colour ="Serie",title ="Un origen en 1950: la incertidumbre crece con el horizonte") + tema_ss
Figura 11.7: Pronósticos de caudal emitidos desde 1950 para los 20 años posteriores, sin incorporar observaciones intermedias. La media pronosticada permanece constante, mientras que el intervalo predictivo del 95 % se amplía con el horizonte.
Tabla 11.4: Evaluación desde origen fijo en 1950. Los métodos de nivel local y naïve mantienen pronósticos puntuales constantes a todos los horizontes; las constantes iniciales pueden diferir.
metodo
MAE
RMSE
MASE
cobertura_95
amplitud_95
Kalman: origen fijo
104.338
122.866
0.778
1
759.962
Naïve: origen fijo
101.950
123.062
0.760
NA
NA
Es esperable que los resultados de esta tabla difieran de los obtenidos para origen móvil, pues responden a problemas distintos. En el esquema fijo no incorporamos observaciones nuevas después de 1950, mientras que en el móvil se actualiza el estado tras observar cada año. Una comparación metodológicamente correcta debe mantener el mismo origen y el mismo horizonte entre modelos, como discutimos en Sección 7.12.
11.14.6 Sensibilidad a la razón entre varianzas
Una limitación importante es que el pronóstico depende de \(W/V\). Para ilustrarlo sin seleccionar parámetros con el conjunto de prueba, repetiremos el filtrado solo con entrenamiento para tres valores de \(W\) y el mismo \(V\). La tabla informa el estado final estimado, la ganancia final y el pronóstico fijo para el siguiente año, sin usar el valor observado de 1951 en la comparación.
Tabla 11.5: Sensibilidad del estado filtrado en 1950 y del pronóstico de 1951 a la varianza supuesta de evolución, manteniendo fija la varianza de observación.
escenario
W
nivel_1950
ganancia_1950
desviacion_pred_1951
Evolución lenta
225
850.16
0.11
137.72
Escenario central
1600
866.12
0.26
151.53
Evolución rápida
6400
876.12
0.45
176.01
Este experimento muestra que el filtro no funciona con una noción abstracta de confianza en los datos: se apoya en supuestos cuantitativos sobre la incertidumbre del estado y de la medición. Determinar esas varianzas estadísticamente, evaluar identificabilidad y propagar la incertidumbre de su estimación serán temas posteriores.
11.15 Diagnóstico introductorio de las innovaciones
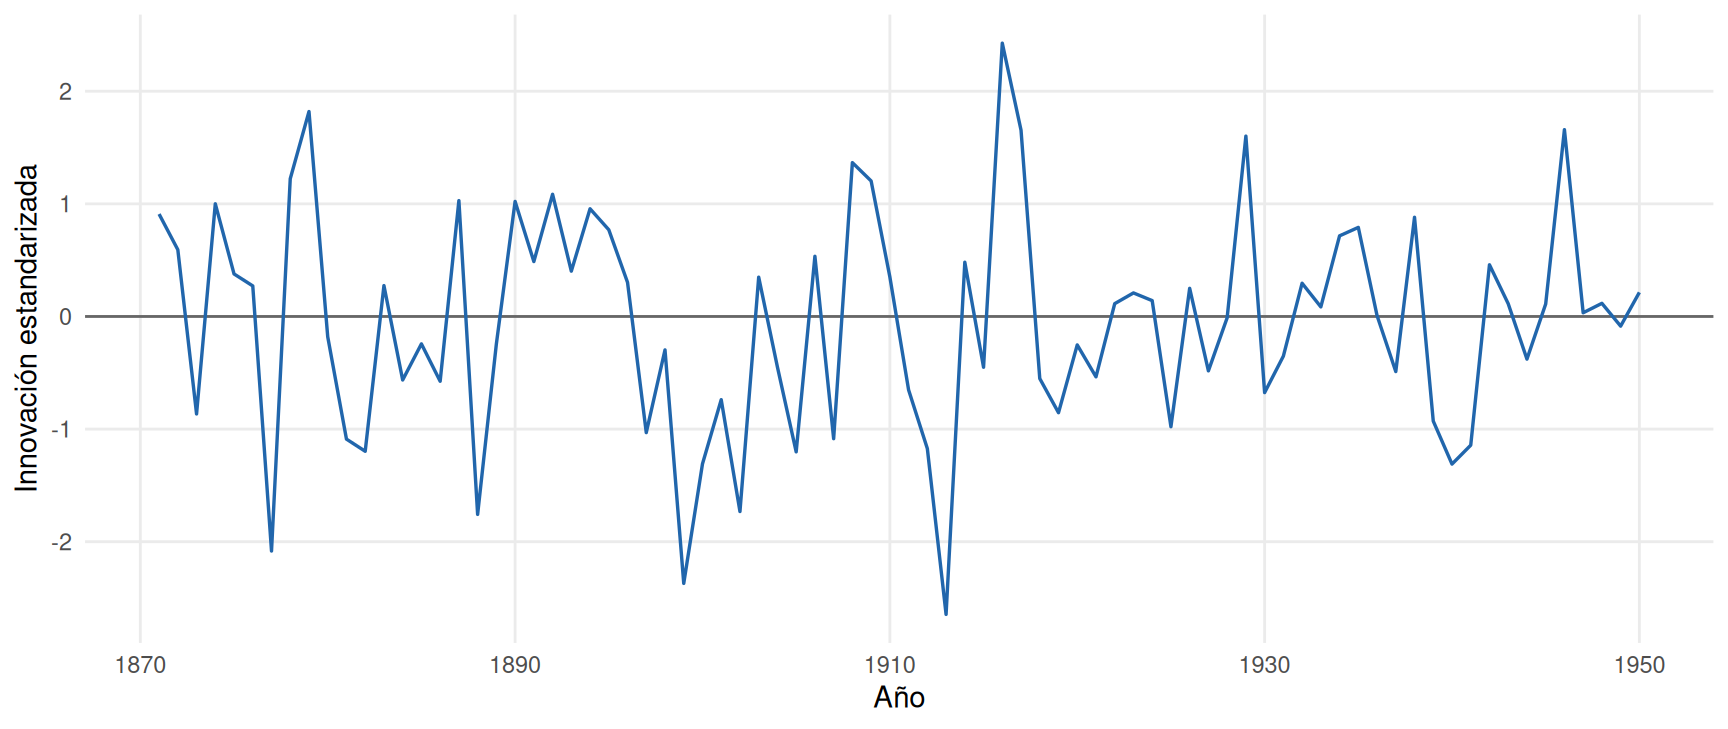
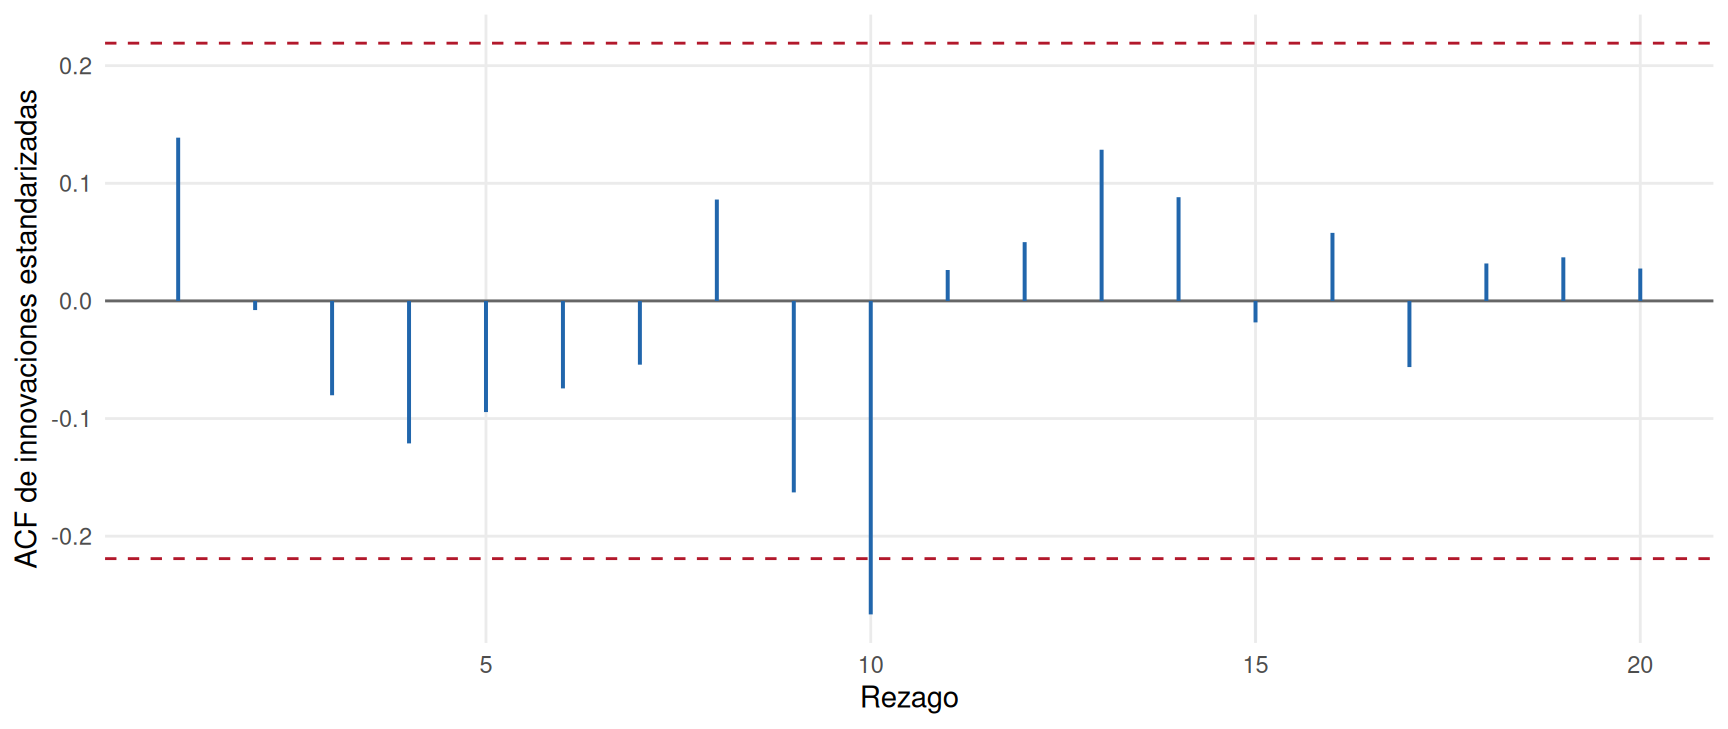
Bajo el modelo lineal gaussiano correctamente especificado, las innovaciones estandarizadas constituyen una secuencia de referencia para estudiar errores de pronóstico de un paso. Podemos explorar su distribución y dependencia, teniendo presente que los parámetros de esta ilustración son supuestos, no estimados.
En esta sección utilizaremos solo entrenamiento, pues diagnosticar y reespecificar un modelo utilizando observaciones reservadas para prueba alteraría el protocolo predictivo.
Figura 11.8: Innovaciones estandarizadas del modelo de nivel local en el período de entrenamiento.
print(p_acf)
Figura 11.9: Autocorrelación muestral de las innovaciones estandarizadas de entrenamiento. Las líneas discontinuas señalan umbrales exploratorios aproximados, no una decisión diagnóstica definitiva.
Tabla 11.6: Prueba de Ljung–Box para innovaciones estandarizadas del modelo de nivel local, calculada como herramienta diagnóstica exploratoria en el período de entrenamiento.
estadistico
rezagos
valor_p
14.7365
10
0.142
La falta de autocorrelación residual es una condición relevante, pero no suficiente, para validar un modelo de espacio-estado. La evaluación también requiere estudiar distribución, varianza condicional, estabilidad de parámetros y desempeño predictivo fuera de muestra. En la semana 12 abordaremos la descomposición predictiva de la verosimilitud y el diagnóstico específico de los modelos estimados (Petris et al. 2009, sec. 2.9).
11.16 Perspectiva frecuentista y bayesiana
El filtro de Kalman es especialmente valioso para mostrar que un mismo cálculo puede tener distintas interpretaciones inferenciales.
Condicionalmente a parámetros conocidos, la media filtrada \(\boldsymbol m_t\) es la esperanza condicional del estado, y minimiza el error cuadrático medio entre las funciones medibles de los datos en el modelo probabilístico especificado. En el modelo gaussiano, además, es una transformación lineal (o afín) de las observaciones.
En el lenguaje bayesiano, \(p(\boldsymbol x_t\mid y_{1:t-1})\) es la distribución predictiva previa, \(p(y_t\mid\boldsymbol x_t)\) es la verosimilitud asociada al nuevo dato y \(p(\boldsymbol x_t\mid y_{1:t})\) es la posterior filtrada. No es necesario ejecutar MCMC para esa actualización cuando todo el sistema es lineal y gaussiano con parámetros conocidos: se dispone de una solución analítica exacta.
El tratamiento cambia si \(\boldsymbol\vartheta\) denota parámetros desconocidos, por ejemplo \(V\) y \(W\). La predictiva posterior completa requiere integrar
Esto no se hace en los ejercicios de la presente semana. Distinguir la incertidumbre del estado condicional a\(\boldsymbol\vartheta\) de la incertidumbre sobre el propio \(\boldsymbol\vartheta\) prepara el estudio de conjugación, factores de descuento y MCMC de la semana 13 (Prado et al. 2021, secs. 4.3, 4.5; Petris et al. 2009, chap. 4).
11.17 Actividad computacional guiada
Se propone trabajar en parejas con el simulador y el filtro escalar del comienzo del capítulo. La actividad puede realizarse en una sesión de laboratorio de aproximadamente 40–50 minutos:
Simular 120 observaciones con \(m_0=0\), \(C_0=4\), \(V=1\) y tres valores de \(W\): \(0.05\), \(1\) y \(9\), utilizando la misma semilla.
Para cada simulación, ejecutar filtrar_nivel_local() con los parámetros que generaron los datos. Comparar el estado verdadero y la media filtrada.
Analizar numéricamente \(K_t\), \(C_t\), \(R_t\) y \(Q_t\). Verificar en cada período que \(C_t\leq R_t\).
Fijar un origen \(T=100\) y construir pronósticos desde ese origen para los siguientes 20 períodos; graficar la trayectoria verdadera y los intervalos predictivos.
Examinar cómo cambia la amplitud del intervalo al aumentar \(W\) manteniendo \(V\) constante.
Repetir el cálculo sustituyendo el valor supuesto \(W\) por otro y discutir el efecto de una especificación incorrecta sobre la estimación del estado y la cobertura predictiva.
La actividad debe concluir con una interpretación estadística escrita: ¿qué cambios de los gráficos se deben a la evolución real del estado y cuáles a la incertidumbre que el modelo atribuye a las observaciones?
11.18 Síntesis
Un modelo de espacio-estado separa la observación de la dinámica de un estado latente. Bajo linealidad, gaussianidad, independencia de perturbaciones y parámetros conocidos, las distribuciones predictivas y filtradas se actualizan exactamente mediante las recursiones de Kalman.
Las ideas principales que deben quedar claras son:
Predicción del estado: se propagan la media y la covarianza anteriores mediante la ecuación de transición.
Predicción de la observación: se incorpora el ruido de medición y se obtiene la innovación.
Actualización: la ganancia depende de la incertidumbre relativa del estado predictivo y de la observación.
Inferencia secuencial: el estado filtrado resume probabilísticamente la información disponible, sin reprocesar toda la historia.
Pronóstico: la incertidumbre de los estados futuros debe propagarse hasta el horizonte solicitado y, para pronosticar observaciones, debe sumarse la incertidumbre de medición.
Conexión con el curso: el nivel local relaciona espacio-estado con ARIMA\((0,1,1)\) y con suavizamiento exponencial simple.
Evaluación honesta: el valor filtrado después de observar \(y_t\) no sustituye al pronóstico emitido antes de observarlo.
En el capítulo siguiente retomaremos esta estructura para incorporar estimación de parámetros por máxima verosimilitud, suavizamiento retrospectivo y una variedad más amplia de modelos estructurales. En la semana 13 avanzaremos hacia la inferencia bayesiana con parámetros desconocidos.
11.19 Ejercicios
Ejercicio 11.1. Factorización de un modelo de espacio-estado. Considere un proceso de estados de Markov \(\{x_t\}\) y observaciones \(\{Y_t\}\) tales que cada \(Y_t\) es condicionalmente independiente de las demás variables dado \(x_t\). A partir de la regla de la cadena para densidades conjuntas y de los supuestos de independencia condicional, demuestre Ecuación 11.3. Explique qué términos cambiarían si \(Y_t\) dependiera también de \(Y_{t-1}\) una vez conocido \(x_t\).
Ejercicio 11.2. Distribución predictiva. Suponga un modelo escalar
\[
Y_t=2x_t+v_t,\qquad x_t=0.8x_{t-1}+w_t,
\]
con \(v_t\sim N(0,9)\) y \(w_t\sim N(0,4)\) independientes. Si \(x_{t-1}\mid y_{1:t-1}\sim N(5,16)\), obtenga analíticamente \(a_t,R_t,f_t,Q_t\) y calcule la ganancia de Kalman. Interprete las dimensiones y unidades de las cantidades obtenidas.
Ejercicio 11.3. Condicionamiento gaussiano. Derive Ecuación 11.20 y Ecuación 11.21 a partir de la distribución conjunta Ecuación 11.18. Luego pruebe la igualdad entre la expresión de la covarianza filtrada y la forma de Joseph en Ecuación 11.25.
Ejercicio 11.4. Incertidumbre y ganancia. En el modelo de nivel local, deduzca \(K_t\) en términos de \(C_{t-1},W,V\). Estudie analíticamente los límites cuando (a) \(V\to0\), (b) \(V\to\infty\), (c) \(W\to\infty\) manteniendo \(C_{t-1}\) y \(V\) constantes. Justifique las conclusiones en términos del peso asignado a la nueva observación.
Ejercicio 11.5. Riccati escalar. Obtenga la ecuación cuadrática de Ecuación 11.37 y determine el límite de la ganancia cuando \(W=V=1\). Explique por qué la raíz negativa de esa ecuación no puede representar una varianza predictiva. Compare el resultado teórico con una simulación numérica de 100 actualizaciones.
Ejercicio 11.6. AR(1) latente. Considere el modelo AR(1) con error de medición de Ecuación 11.39. Escriba las matrices del sistema, determine la distribución estacionaria del estado cuando \(|\phi|<1\) y \(W>0\), y obtenga las ecuaciones predictivas. Explique la diferencia entre observar exactamente \(x_t\) y observarlo con error.
Ejercicio 11.7. Conexión con ARIMA. Partiendo del modelo de nivel local, obtenga la función de autocovarianza de \(\Delta Y_t\). Resuelva la ecuación para el parámetro MA(1) invertible y estudie el límite cuando \(W\to0^+\). Explique por qué no debe identificarse automáticamente el estado latente con una única tendencia económica o física.
Ejercicio 11.8. Simulación y cobertura. Simule \(500\) trayectorias independientes de un nivel local con longitud \(T=80\) y parámetros conocidos, utilizando semillas diferentes y reproducibles para cada réplica (por ejemplo, semilla = 415 + i). Para cada trayectoria, filtre hasta \(T=60\) y construya un intervalo predictivo del \(95\%\) para \(Y_{61}\). Estime su cobertura por simulación y compare con \(95\%\). Distinga cuidadosamente un intervalo para \(x_{61}\) de uno para \(Y_{61}\).
Ejercicio 11.9. Parámetros mal especificados. Utilice las trayectorias del ejercicio anterior, pero ejecute el filtro con una varianza de observación distinta de la verdadera. Compare el error cuadrático medio de los estados filtrados y la cobertura de los intervalos predictivos. Explique por qué los errores de especificación no se corrigen simplemente acumulando más observaciones.
Ejercicio 11.10. Evaluación temporal. Con datasets::Nile, reproduzca el análisis de origen móvil y el de origen fijo. Describa qué información entra en cada pronóstico y compare MAE, RMSE, MASE, cobertura y amplitud. No seleccione valores de \(V\) y \(W\) a partir de la muestra de prueba.
Ejercicio opcional 11.11. Multivariado. Para \(\boldsymbol Y_t=\boldsymbol H_t\boldsymbol x_t+\boldsymbol v_t\), con \(\boldsymbol v_t\sim N_d(\boldsymbol 0,\boldsymbol V_t)\), derive la covarianza predictiva \(\boldsymbol Q_t\) y la ganancia matricial \(\boldsymbol K_t\). Indique condiciones suficientes para la invertibilidad de \(\boldsymbol Q_t\).
11.20 Lecturas recomendadas
Shumway y Stoffer(Shumway y Stoffer 2025, secs. 6.1–6.2): formulación lineal gaussiana, filtrado y predicción. Para la siguiente semana, continuar con las secciones 6.3–6.5.
Petris, Petrone y Campagnoli(Petris et al. 2009, secs. 2.3–2.9): modelos de espacio-estado, modelos lineales dinámicos, filtrado, predicción e innovaciones. En la semana 12 volveremos especialmente a las secciones 2.7.4 y 2.9.
Prado, Ferreira y West(Prado et al. 2021, secs. 4.1–4.3.1): estructuras de modelos dinámicos y actualización secuencial desde una perspectiva bayesiana.
Hyndman y Athanasopoulos(Hyndman y Athanasopoulos 2021, secs. 5.8–5.10, 8.5): evaluación fuera de muestra y conexión de los modelos de suavizamiento con formulaciones de espacio-estado.
En este capítulo se han utilizado las claves bibliográficas ya existentes en references.bib. Las derivaciones y simulaciones pedagógicas constituyen una exposición desarrollada para estas notas a partir de los resultados presentados en las fuentes indicadas.
Hyndman, Rob J., y George Athanasopoulos. 2021. Forecasting: Principles and Practice. 3.ª ed. OTexts. https://otexts.com/fpp3/.
Petris, Giovanni, Sonia Petrone, y Patrizia Campagnoli. 2009. Dynamic Linear Models with R. Springer. https://doi.org/10.1007/b135794.
Prado, Raquel, Marco A. R. Ferreira, y Mike West. 2021. Time Series: Modeling, Computation, and Inference. 2.ª ed. Chapman; Hall/CRC.
Shumway, Robert H., y David S. Stoffer. 2025. Time Series Analysis and Its Applications: With R Examples. 5.ª ed. Springer. https://doi.org/10.1007/978-3-031-70584-7.