n_sim_kf12 <- 160L
V_sim_kf12 <- 100
W_sim_kf12 <- 16
m0_sim_kf12 <- 0
C0_sim_kf12 <- 400

set.seed(412)
x0_sim_kf12 <- rnorm(1, m0_sim_kf12, sqrt(C0_sim_kf12))
estados_sim_kf12 <- x0_sim_kf12 +
  cumsum(rnorm(n_sim_kf12, 0, sqrt(W_sim_kf12)))
y_sim_kf12 <- estados_sim_kf12 +
  rnorm(n_sim_kf12, 0, sqrt(V_sim_kf12))

sim_kf12 <- tibble(
  t = seq_len(n_sim_kf12), estado = estados_sim_kf12,
  observado = y_sim_kf12
)

cfg_sim_kf12 <- list(
  F = matrix(1, 1, 1), G = matrix(1, 1, 1),
  V = V_sim_kf12, W = matrix(W_sim_kf12, 1, 1),
  m0 = m0_sim_kf12, C0 = matrix(C0_sim_kf12, 1, 1)
)
fil_sim_kf12 <- do.call(filtrar_kalman,
                        c(list(y = y_sim_kf12), cfg_sim_kf12))
sua_sim_kf12 <- suavizar_rts(fil_sim_kf12)

stopifnot(length(y_sim_kf12) == n_sim_kf12,
all(is.finite(y_sim_kf12)))12 Inferencia y pronóstico en modelos de espacio-estado
CA-0415 Series de Tiempo — Semana 12
12.1 Objetivos de aprendizaje
Al finalizar este capítulo, el estudiantado podrá:
- Diferenciar las distribuciones predictiva, filtrada y suavizada, especificando la información condicionante de cada una.
- Explicar y verificar las recursiones del filtro de Kalman para modelos gaussianos con parámetros conocidos.
- Derivar la verosimilitud de las observaciones a partir de la factorización de densidades predictivas e interpretar el papel de las innovaciones.
- Estimar parámetros estáticos por máxima verosimilitud y discutir la inicialización, la identificación y las restricciones sobre las varianzas.
- Derivar el suavizador retrospectivo de Rauch–Tung–Striebel (RTS) usando condicionamiento normal multivariado.
- Construir distribuciones predictivas a varios pasos sin incorporar información futura al origen.
- Tratar observaciones faltantes por propagación de la distribución predictiva, sin imputarlas artificialmente antes del filtro.
- Ajustar e interpretar modelos de nivel local y tendencia lineal local.
- Evaluar diagnósticos basados en innovaciones y comparar métodos bajo el mismo diseño temporal.
- Reconocer el alcance y las limitaciones de la inferencia condicional a parámetros estimados, como preparación para los DLM bayesianos.
En la semana 11 se formularon las ecuaciones de espacio-estado y se derivó el filtro de Kalman con parámetros conocidos; véanse Sección 11.3.1, Sección 11.6 y Sección 11.13. Antes, Sección 8.14 mostró cómo una formulación de innovaciones conduce a la verosimilitud de modelos ETS, y Sección 7.8 estableció cómo comparar pronósticos utilizando únicamente información disponible en cada origen. Esta semana unificaremos esos resultados: el filtro proporciona tanto estados como densidades predictivas, la secuencia de densidades permite estimar parámetros y, después de observar la muestra completa, podemos reconstruir retrospectivamente los estados latentes.
Son referencias centrales Shumway y Stoffer (Shumway y Stoffer 2025, secs. 6.1–6.5), Petris, Petrone y Campagnoli (Petris et al. 2009, secs. 2.7–2.9, 3.2, 4.1) y Prado, Ferreira y West (Prado et al. 2021, secs. 4.3.1, 4.3.3–4.3.5). La evaluación de pronósticos retoma (Hyndman y Athanasopoulos 2021, secs. 5.8–5.10). Las demostraciones y experimentos computacionales son desarrollos pedagógicos para este curso, no transcripciones de esas fuentes.
ImportanteDos niveles de incertidumbre
En buena parte del capítulo, \(\boldsymbol\psi\) se considera conocido o fijado en su estimación por máxima verosimilitud. El filtro y el suavizador son exactos bajo los supuestos gaussianos condicionalmente a esos parámetros. Sustituir \(\boldsymbol\psi\) por \(\widehat{\boldsymbol\psi}\) no incorpora la incertidumbre sobre los parámetros en los intervalos reportados. La integración sobre su distribución posterior corresponde a la semana 13.
12.2 Motivación: tres preguntas, tres conjuntos de información
Supongamos que la variable observada es el caudal anual de un río y que existe un nivel subyacente que cambia lentamente. Queremos responder tres preguntas distintas:
- Antes de observar el caudal en \(t\): ¿qué nivel y qué caudal esperamos, dado \(y_{1:t-1}\)?
- Después de recibir el dato de \(t\): ¿cómo cambia nuestra distribución sobre el nivel en ese momento?
- Al terminar el estudio en \(T>t\): ¿cómo debe revisarse la interpretación del nivel de \(t\) a la luz de los datos posteriores?
Estas preguntas corresponden, respectivamente, a predicción, filtrado y suavizamiento. La tercera tarea es retrospectiva: no debe utilizarse para simular un pronóstico que supuestamente se emitió en el pasado. Cuando las varianzas no son conocidas, surge una cuarta pregunta: ¿qué valores de esos parámetros hacen más plausibles las observaciones registradas?
12.3 Formulación y notación conservadas
Para una observación escalar y un estado \(p\)-dimensional, mantenemos las convenciones de Sección 11.3.1:
\[ Y_t=\boldsymbol F_t^\top\boldsymbol x_t+v_t, \qquad v_t\sim N(0,V_t), \tag{12.1}\]
\[ \boldsymbol x_t=\boldsymbol G_t\boldsymbol x_{t-1}+\boldsymbol w_t, \qquad \boldsymbol w_t\sim N_p(\boldsymbol0,\boldsymbol W_t), \tag{12.2}\]
\[ \boldsymbol x_0\sim N_p(\boldsymbol m_0,\boldsymbol C_0). \tag{12.3}\]
Las perturbaciones son independientes entre períodos, mutuamente independientes y también independientes del estado inicial. Suponemos \(V_t>0\), \(\boldsymbol W_t\succeq 0\) y \(\boldsymbol C_0\succeq 0\). El vector columna \(\boldsymbol F_t\in\mathbb R^p\) transforma estados en una observación; \(\boldsymbol G_t\in\mathbb R^{p\times p}\) describe su transición. Cuando estos objetos dependen de parámetros estáticos desconocidos, los reunimos en \(\boldsymbol\psi\).
Escribimos \(\mathcal D_t=\sigma(Y_1,\ldots,Y_t)\) para la información observada hasta \(t\). Para evitar ambigüedades, usaremos la siguiente tabla:
| Objeto | Definición | Datos usados |
|---|---|---|
| \(\boldsymbol a_t,\boldsymbol R_t\) | Media y covarianza de \(\boldsymbol x_t\mid\mathcal D_{t-1}\) | Hasta \(t-1\) |
| \(f_t,Q_t\) | Media y varianza de \(Y_t\mid\mathcal D_{t-1}\) | Hasta \(t-1\) |
| \(e_t=y_t-f_t\) | Innovación observada | Observación \(t\) versus pronóstico previo |
| \(\boldsymbol m_t,\boldsymbol C_t\) | Media y covarianza de \(\boldsymbol x_t\mid\mathcal D_t\) | Hasta \(t\) |
| \(\boldsymbol s_t,\boldsymbol S_t\) | Media y covarianza de \(\boldsymbol x_t\mid\mathcal D_T\) | Hasta \(T\), con \(T\ge t\) |
En particular, \(\boldsymbol m_t\) no es \(\boldsymbol s_t\) salvo en el último período \(t=T\), o en casos particulares sin información adicional relevante. Una matriz de covarianzas filtrada nunca debe interpretarse como si también incorporara la incertidumbre de parámetros desconocidos.
12.4 Repaso operativo del filtro de Kalman
Partimos de la distribución \(\boldsymbol x_{t-1}\mid\mathcal D_{t-1}\sim N_p(\boldsymbol m_{t-1},\boldsymbol C_{t-1})\). De Ecuación 12.2 obtenemos la predicción del estado:
\[ \begin{aligned} \boldsymbol a_t&=\boldsymbol G_t\boldsymbol m_{t-1},\\ \boldsymbol R_t&=\boldsymbol G_t\boldsymbol C_{t-1}\boldsymbol G_t^\top+\boldsymbol W_t. \end{aligned} \tag{12.4}\]
La distribución predictiva de la observación es
\[ Y_t\mid\mathcal D_{t-1}\sim N(f_t,Q_t),\qquad \begin{cases} f_t=\boldsymbol F_t^\top\boldsymbol a_t,\\ Q_t=\boldsymbol F_t^\top\boldsymbol R_t\boldsymbol F_t+V_t. \end{cases} \tag{12.5}\]
Con la innovación \(e_t=y_t-f_t\), la actualización queda
\[ \begin{aligned} \boldsymbol K_t&=\boldsymbol R_t\boldsymbol F_tQ_t^{-1},\\ \boldsymbol m_t&=\boldsymbol a_t+\boldsymbol K_te_t,\\ \boldsymbol C_t&=\boldsymbol R_t-\boldsymbol K_tQ_t\boldsymbol K_t^\top. \end{aligned} \tag{12.6}\]
La última expresión es exacta, pero en cálculos de punto flotante puede convenir la forma de Joseph:
\[ \boldsymbol C_t= (\boldsymbol I-\boldsymbol K_t\boldsymbol F_t^\top)\boldsymbol R_t (\boldsymbol I-\boldsymbol K_t\boldsymbol F_t^\top)^\top +\boldsymbol K_tV_t\boldsymbol K_t^\top. \tag{12.7}\]
La igualdad se verifica expandiendo los productos y utilizando \(\boldsymbol K_tQ_t=\boldsymbol R_t\boldsymbol F_t\). La forma de Joseph preserva mejor la simetría y la semidefinición positiva frente al redondeo. En el código que acompaña este capítulo, todas las cantidades se guardan tanto antes como después de cada actualización.
12.4.1 Una implementación propia para el laboratorio
En este documento se define filtrar_kalman(), suavizar_rts(), logver_kalman() y pronosticar_kalman(). El filtro acepta una observación escalar, un estado de dimensión arbitraria y matrices constantes en el tiempo. La extensión a \(\boldsymbol F_t,\boldsymbol G_t,V_t,\boldsymbol W_t\) variables se obtiene aplicando la matriz correspondiente en cada iteración..
El filtro manual también acepta valores faltantes, que trataremos formalmente más adelante. A diferencia de una función de suavizamiento no paramétrico, esta implementación no calcula medias locales sobre ventanas: estima estados de un modelo probabilístico. La prueba de la semana 11 se basó en un caso escalar con parámetros conocidos; ahora la misma mecánica servirá para definir la verosimilitud y el suavizador.
12.5 Verosimilitud mediante la descomposición predictiva
12.5.1 De la regla de la cadena a las innovaciones
Sea \(\boldsymbol\psi\) el conjunto de parámetros estáticos, que puede incluir, por ejemplo, \(V\) y \(W\) en un nivel local. La regla de multiplicación para densidades proporciona exactamente
\[ p(y_{1:T}\mid\boldsymbol\psi)= \prod_{t=1}^{T}p(y_t\mid y_{1:t-1},\boldsymbol\psi), \tag{12.8}\]
interpretando \(y_{1:0}\) como conjunto vacío. Esta factorización no requiere independencia marginal de las observaciones: cada factor condiciona en toda la historia disponible. Bajo Ecuación 12.1 y Ecuación 12.3, el filtro calcula
\[ p(y_t\mid y_{1:t-1},\boldsymbol\psi) =\frac{1}{\sqrt{2\pi Q_t(\boldsymbol\psi)}} \exp\left[-\frac{e_t(\boldsymbol\psi)^2}{2Q_t(\boldsymbol\psi)}\right]. \tag{12.9}\]
Las cantidades \(e_t\) y \(Q_t\) dependen de \(\boldsymbol\psi\), incluso si esa dependencia no se escribe explícitamente. Sustituyendo en Ecuación 12.8 y tomando logaritmos, obtenemos la log-verosimilitud de innovaciones:
\[ \boxed{ \ell(\boldsymbol\psi;y_{1:T}) =-\frac12\sum_{t=1}^{T} \left\{\log(2\pi)+\log Q_t(\boldsymbol\psi) +\frac{e_t(\boldsymbol\psi)^2}{Q_t(\boldsymbol\psi)}\right\}. } \tag{12.10}\]
El término \(\log Q_t\) penaliza la dispersión excesiva; el cociente \(e_t^2/Q_t\) penaliza discrepancias grandes respecto de la incertidumbre predictiva. No basta minimizar la suma de cuadrados de innovaciones: el modelo también escoge sus varianzas predictivas, y estas aparecen en la normalización de la densidad.
12.5.2 Relación con la covarianza conjunta
Si el vector observado completo \(\boldsymbol Y=(Y_1,\ldots,Y_T)^\top\) tiene distribución \(N_T(\boldsymbol\mu,\boldsymbol\Sigma_{\boldsymbol\psi})\), su log-verosimilitud es
\[ -\frac{T}{2}\log(2\pi) -\frac12\log|\boldsymbol\Sigma_{\boldsymbol\psi}| -\frac12(\boldsymbol y-\boldsymbol\mu)^\top \boldsymbol\Sigma_{\boldsymbol\psi}^{-1}(\boldsymbol y-\boldsymbol\mu). \tag{12.11}\]
La factorización predictiva produce exactamente esa misma densidad conjunta, pero evita formar e invertir explícitamente la matriz \(\boldsymbol\Sigma_{\boldsymbol\psi}\) de dimensión \(T\times T\). La clave es la llamada transformación triangular de innovaciones.
12.5.3 Transformación triangular de innovaciones
Para cada \(t\), el predictor lineal óptimo de \(Y_t\) con base en el pasado \(Y_{1:t-1}\) puede escribirse como
\[ \widehat Y_{t\mid t-1} = \mu_t+\sum_{j=1}^{t-1} a_{tj}(Y_j-\mu_j), \qquad t=1,\ldots,T, \]
donde, por convención, la suma es vacía cuando \(t=1\). La innovación correspondiente es
\[ E_t = Y_t-\widehat Y_{t\mid t-1}. \]
Por tanto,
\[ \begin{aligned} E_1 &= Y_1-\mu_1,\\ E_2 &= (Y_2-\mu_2)-a_{21}(Y_1-\mu_1),\\ E_3 &= (Y_3-\mu_3)-a_{31}(Y_1-\mu_1)-a_{32}(Y_2-\mu_2),\\ &\ \vdots\\ E_T &= (Y_T-\mu_T)-\sum_{j=1}^{T-1} a_{Tj}(Y_j-\mu_j). \end{aligned} \]
Si apilamos estas ecuaciones, obtenemos
\[ \boldsymbol E=\boldsymbol L(\boldsymbol Y-\boldsymbol\mu), \tag{12.12}\] donde \(\boldsymbol E=(E_1,\ldots,E_T)^\top\) y \(\boldsymbol L\) es una matriz triangular inferior con unos en la diagonal,
\[ \boldsymbol L= \begin{pmatrix} 1 & 0 & 0 & \cdots & 0\\ -a_{21} & 1 & 0 & \cdots & 0\\ -a_{31} & -a_{32} & 1 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ -a_{T1} & -a_{T2} & -a_{T3} & \cdots & 1 \end{pmatrix}. \]
Se habla de transformación triangular porque cada innovación \(E_t\) depende únicamente de \(Y_t\) y de observaciones anteriores \(Y_1,\ldots,Y_{t-1}\), nunca de observaciones futuras. Eso hace que la matriz de transformación sea triangular inferior. Además, como la diagonal de \(\boldsymbol L\) está formada por unos, se tiene
\[ |\boldsymbol L|=1. \]
En el caso gaussiano, las innovaciones son conjuntamente normales y ortogonales; por ortogonalidad gaussiana, son independientes. Si denotamos
\[ Q_t=\operatorname{Var}(E_t), \qquad t=1,\ldots,T, \]
entonces
\[ \operatorname{Var}(\boldsymbol E) = \boldsymbol D = \operatorname{diag}(Q_1,\ldots,Q_T). \tag{12.13}\]
Como \(\boldsymbol E=\boldsymbol L(\boldsymbol Y-\boldsymbol\mu)\), resulta
\[ \boldsymbol D = \operatorname{Var}(\boldsymbol E) = \boldsymbol L\, \boldsymbol\Sigma_{\boldsymbol\psi}\, \boldsymbol L^\top. \]
Equivalentemente,
\[ \boldsymbol\Sigma_{\boldsymbol\psi} = \boldsymbol L^{-1}\boldsymbol D\,\boldsymbol L^{-\top}. \tag{12.14}\]
Esta descomposición es una versión de tipo LDL\(^\top\) asociada a la sucesión de predicciones un paso adelante.
12.5.4 Justificación de las identidades de innovaciones
A partir de Ecuación 12.14 se obtiene inmediatamente
\[ |\boldsymbol\Sigma_{\boldsymbol\psi}| = |\boldsymbol L^{-1}|\, |\boldsymbol D|\, |\boldsymbol L^{-\top}| = |\boldsymbol D| = \prod_{t=1}^T Q_t, \]
porque \(|\boldsymbol L|=1\) y, por tanto, también \(|\boldsymbol L^{-1}|=|\boldsymbol L^{-\top}|=1\).
De igual manera, invirtiendo Ecuación 12.14 obtenemos
\[ \boldsymbol\Sigma_{\boldsymbol\psi}^{-1} = \boldsymbol L^\top \boldsymbol D^{-1}\boldsymbol L. \]
Así, para la forma cuadrática de Mahalanobis,
\[ \begin{aligned} (\boldsymbol y-\boldsymbol\mu)^\top \boldsymbol\Sigma_{\boldsymbol\psi}^{-1} (\boldsymbol y-\boldsymbol\mu) &= (\boldsymbol y-\boldsymbol\mu)^\top \boldsymbol L^\top \boldsymbol D^{-1}\boldsymbol L (\boldsymbol y-\boldsymbol\mu)\\ &= \big[\boldsymbol L(\boldsymbol y-\boldsymbol\mu)\big]^\top \boldsymbol D^{-1} \big[\boldsymbol L(\boldsymbol y-\boldsymbol\mu)\big]\\ &= \boldsymbol e^\top \boldsymbol D^{-1}\boldsymbol e\\ &= \sum_{t=1}^T \frac{e_t^2}{Q_t}, \end{aligned} \]
donde \(\boldsymbol e=(e_1,\ldots,e_T)^\top\) es la realización observada del vector de innovaciones.
En consecuencia,
\[ |\boldsymbol\Sigma_{\boldsymbol\psi}|=\prod_{t=1}^TQ_t, \qquad (\boldsymbol y-\boldsymbol\mu)^\top \boldsymbol\Sigma_{\boldsymbol\psi}^{-1}(\boldsymbol y-\boldsymbol\mu) =\sum_{t=1}^T\frac{e_t^2}{Q_t}. \tag{12.15}\]
Estas dos identidades muestran que la verosimilitud multivariada usual y la verosimilitud basada en innovaciones son exactamente la misma. La ventaja computacional del filtro de Kalman es que genera recursivamente \(e_t\) y \(Q_t\), de modo que no es necesario construir ni invertir la matriz completa \(\boldsymbol\Sigma_{\boldsymbol\psi}\) (Shumway y Stoffer 2025, sec. 6.3; Petris et al. 2009, sec. 4.1).
12.5.5 La distribución inicial es parte del modelo
La fórmula Ecuación 12.10 depende de \(\boldsymbol m_0\) y \(\boldsymbol C_0\). Fijar \(\boldsymbol x_0\) con certeza, darle una distribución normal propia o utilizar técnicas de inicialización difusa puede producir funciones de verosimilitud diferentes, especialmente en series cortas. No debe sustituirse arbitrariamente una inicialización propia por otra y comparar los resultados como si el modelo estadístico fuera idéntico.
En este capítulo fijaremos \(\boldsymbol m_0\) y \(\boldsymbol C_0\) antes de estimar las varianzas, y esa convención se mantendrá igual en todas las ventanas de entrenamiento. Esta elección hace transparentes los experimentos, aunque no agota las técnicas de inicialización disponibles en paquetes especializados.
Nota¿Qué ocurre cuando falta un dato?
Si el dato de \(t\) no se observa y la ausencia se considera ignorable para la inferencia sobre el proceso, no aparece el factor predictivo de \(Y_t\) en la verosimilitud observada. Sí se propaga el estado a través de ese instante. Por tanto, Ecuación 12.10 suma únicamente sobre tiempos efectivamente observados. El tratamiento de ausencias informativas requiere un modelo adicional para el mecanismo de observación.
12.6 Estimación de parámetros por máxima verosimilitud
Definimos
\[ \widehat{\boldsymbol\psi}_{\mathrm{MV}} \in\underset{\boldsymbol\psi\in\Psi}{\operatorname{argmax}} \;\ell(\boldsymbol\psi;y_{1:T}), \tag{12.16}\]
con \(\Psi\) el espacio paramétrico admisible. En la práctica se evalúa Ecuación 12.10 ejecutando un filtro completo para cada conjunto de parámetros candidato, y un algoritmo numérico busca el máximo. La función es generalmente no lineal en las varianzas y no suele admitir una solución cerrada.
12.6.1 Modelo de nivel local: varianzas desconocidas
Retomamos el modelo de Sección 11.8:
\[ Y_t=x_t+v_t,\qquad x_t=x_{t-1}+w_t, \qquad v_t\sim N(0,V),\quad w_t\sim N(0,W). \tag{12.17}\]
Aquí \(\boldsymbol\psi=(V,W)^\top\). Para este modelo,
\[ \begin{aligned} a_t&=m_{t-1}, & R_t&=C_{t-1}+W,\\ f_t&=a_t, & Q_t&=R_t+V,\\ K_t&=R_t/Q_t, & m_t&=a_t+K_t(y_t-a_t),\\ &&C_t&=(1-K_t)R_t. \end{aligned} \tag{12.18}\]
El cociente \(r=W/V\) determina gran parte del comportamiento de la ganancia: \(r\) elevado favorece el dato nuevo porque el nivel puede evolucionar rápidamente; \(r\) pequeño favorece la estabilidad del estado anterior. Sin embargo, \(r\) no determina por sí solo toda la distribución observada: la escala de las varianzas también fija el tamaño de \(Q_t\) y la amplitud de los intervalos.
Para garantizar positividad durante la optimización definimos
\[ \eta_V=\log V,\qquad \eta_W=\log W, \qquad V=e^{\eta_V},\quad W=e^{\eta_W}. \tag{12.19}\]
En los ejemplos computacionales imponemos además límites numéricos positivos a las varianzas. Esos límites son decisiones de implementación, no propiedades teóricas del modelo. Si el máximo se localiza cerca de \(W=0\), habrá que estudiar explícitamente el caso frontera y no interpretar automáticamente la solución restringida como evidencia de variación estrictamente positiva del nivel.
12.6.2 Curvatura y errores estándar
Bajo condiciones regulares y con un máximo interior, la información observada es
\[ \boldsymbol{\mathcal I}_{\mathrm{obs}}(\widehat{\boldsymbol\eta}) =-\left.\frac{\partial^2\ell(\boldsymbol\eta)} {\partial\boldsymbol\eta\,\partial\boldsymbol\eta^\top} \right|_{\boldsymbol\eta=\widehat{\boldsymbol\eta}}. \tag{12.20}\]
Su inversa puede aproximar la covarianza del estimador en la escala \(\boldsymbol\eta\). Si interesa volver a las varianzas originales, puede emplearse el método delta con \(\boldsymbol D=\operatorname{diag}(e^{\widehat{\eta}_1},\ldots)\):
\[ \widehat{\operatorname{Var}}(\widehat{\boldsymbol\psi}) \approx \boldsymbol D\,\boldsymbol{\mathcal I}_{\mathrm{obs}}^{-1} \boldsymbol D^\top. \tag{12.21}\]
Esta aproximación puede ser inadecuada cuando la verosimilitud es plana, el tamaño muestral es pequeño o un parámetro está cerca de cero. Para tales casos son más informativos los perfiles de verosimilitud, los procedimientos de remuestreo adecuados o el tratamiento bayesiano de la semana 13. No mostraremos errores estándar numéricos sin verificar primero las condiciones de su cálculo.
12.6.3 Simulación: perfil de verosimilitud
El primer experimento permitirá conocer los estados verdaderos, una posibilidad que no tendremos con los datos del Nilo. Simularemos un nivel local con \(T=160\), \(V=100\), \(W=16\) y \(x_0\sim N(0,400)\). Los parámetros de generación no se estiman con ayuda de las trayectorias latentes: la función de verosimilitud solo utiliza las observaciones.
sim_comp_kf12 <- sim_kf12 |>
  mutate(
    filtrada = fil_sim_kf12$m[, 1],
    suavizada = sua_sim_kf12$s[, 1]
  ) |>
  pivot_longer(c(estado, filtrada, suavizada),
               names_to = "tipo", values_to = "valor")

ggplot(sim_comp_kf12, aes(t, valor, colour = tipo)) +
  geom_point(data = sim_kf12, aes(t, observado),
             inherit.aes = FALSE, alpha = .22, size = .8) +
  geom_line(linewidth = .75) +
  scale_colour_manual(values = c(estado = "#222222",
                                 filtrada = "#2376aa",
                                 suavizada = "#ce6418")) +
  labs(x = "Período", y = "Valor",
       colour = "Trayectoria",
       title = "Filtrar no es lo mismo que suavizar") +
  tema_kf12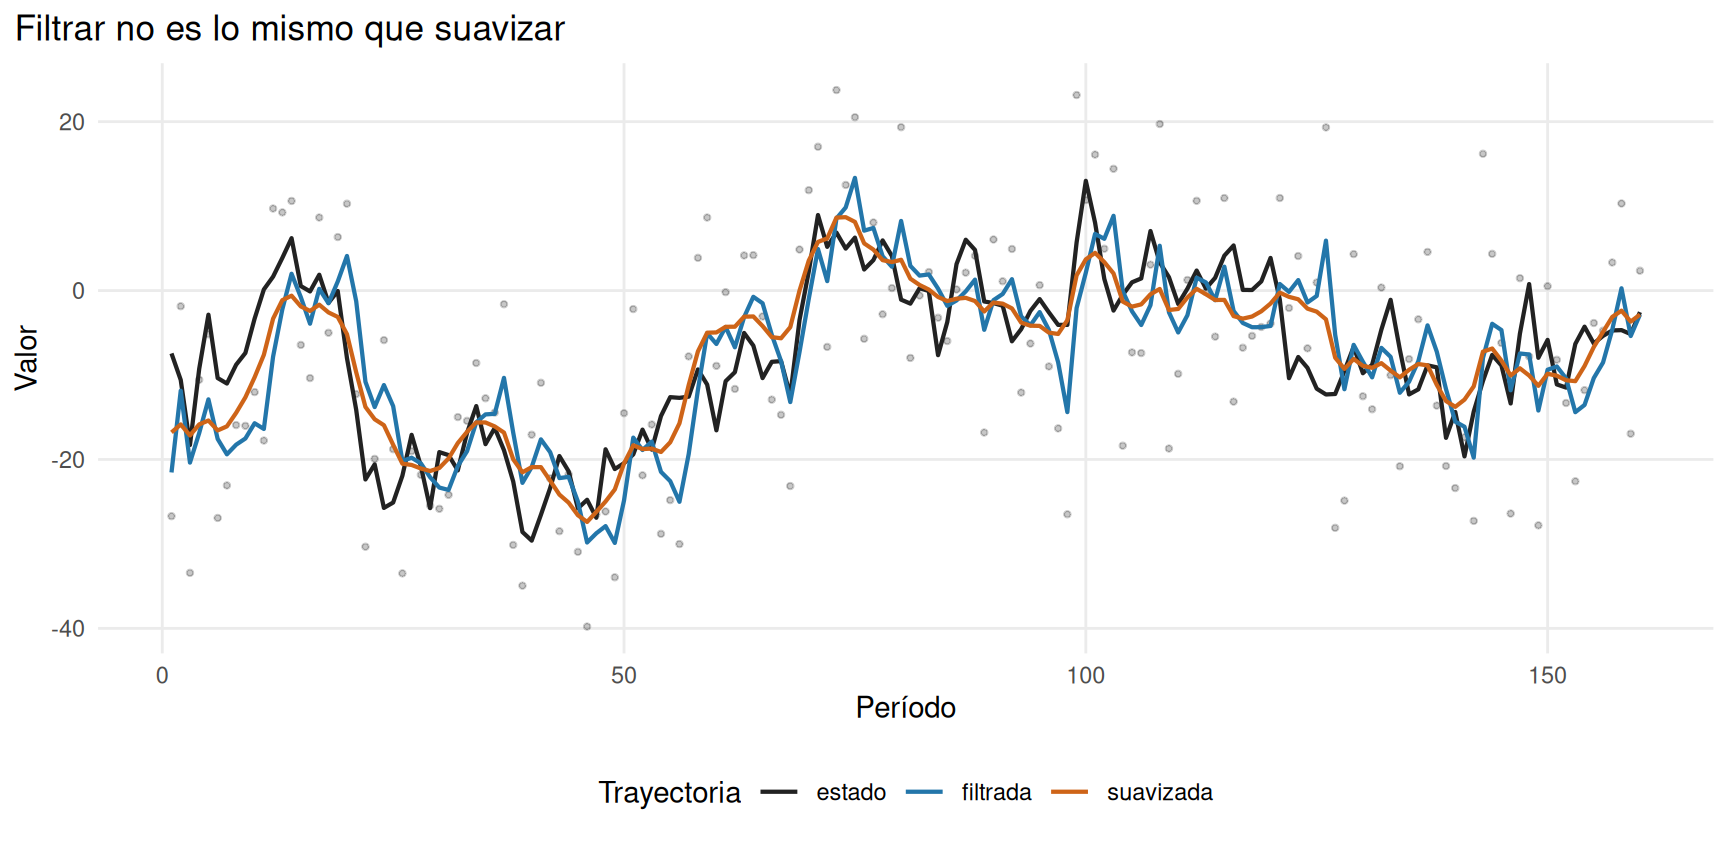
El estado suavizado aprovecha más observaciones que el filtrado en fechas anteriores a \(T\). No existe garantía de que la media suavizada quede más cerca de la realización latente en cada instante particular: su propiedad es optimizar el error cuadrático medio condicional al conjunto de información empleado, no mejorar necesariamente todas las realizaciones individuales.
Para visualizar la log-verosimilitud sin ambigüedad, evaluaremos una cuadrícula de varianzas alrededor del mecanismo generador. Este gráfico no es una distribución posterior ni un intervalo de confianza; describe valores de la función objetivo.
rejilla_kf12 <- tidyr::expand_grid(
  sd_observacion = seq(6, 16, length.out = 23),
  sd_estado = seq(1.5, 8, length.out = 23)
)
rejilla_kf12$log_ver <- purrr::map2_dbl(
  rejilla_kf12$sd_observacion,
  rejilla_kf12$sd_estado,
  function(sd_o, sd_e) {
    cfg <- cfg_sim_kf12
    cfg$V <- sd_o^2
    cfg$W <- matrix(sd_e^2, 1, 1)
    f <- do.call(filtrar_kalman, c(list(y = y_sim_kf12), cfg))
    logver_kalman(f)
  }
)

ggplot(rejilla_kf12,
       aes(sd_observacion, sd_estado, z = log_ver)) +
  geom_contour_filled(bins = 12) +
  annotate("point", x = sqrt(V_sim_kf12), y = sqrt(W_sim_kf12),
           colour = "black", shape = 4, stroke = 1.4, size = 3.4) +
  labs(x = "Desviación estándar de observación",
       y = "Desviación estándar de estado",
       fill = "Log-verosimilitud",
       title = "La escala de ambas varianzas afecta la verosimilitud") +
  tema_kf12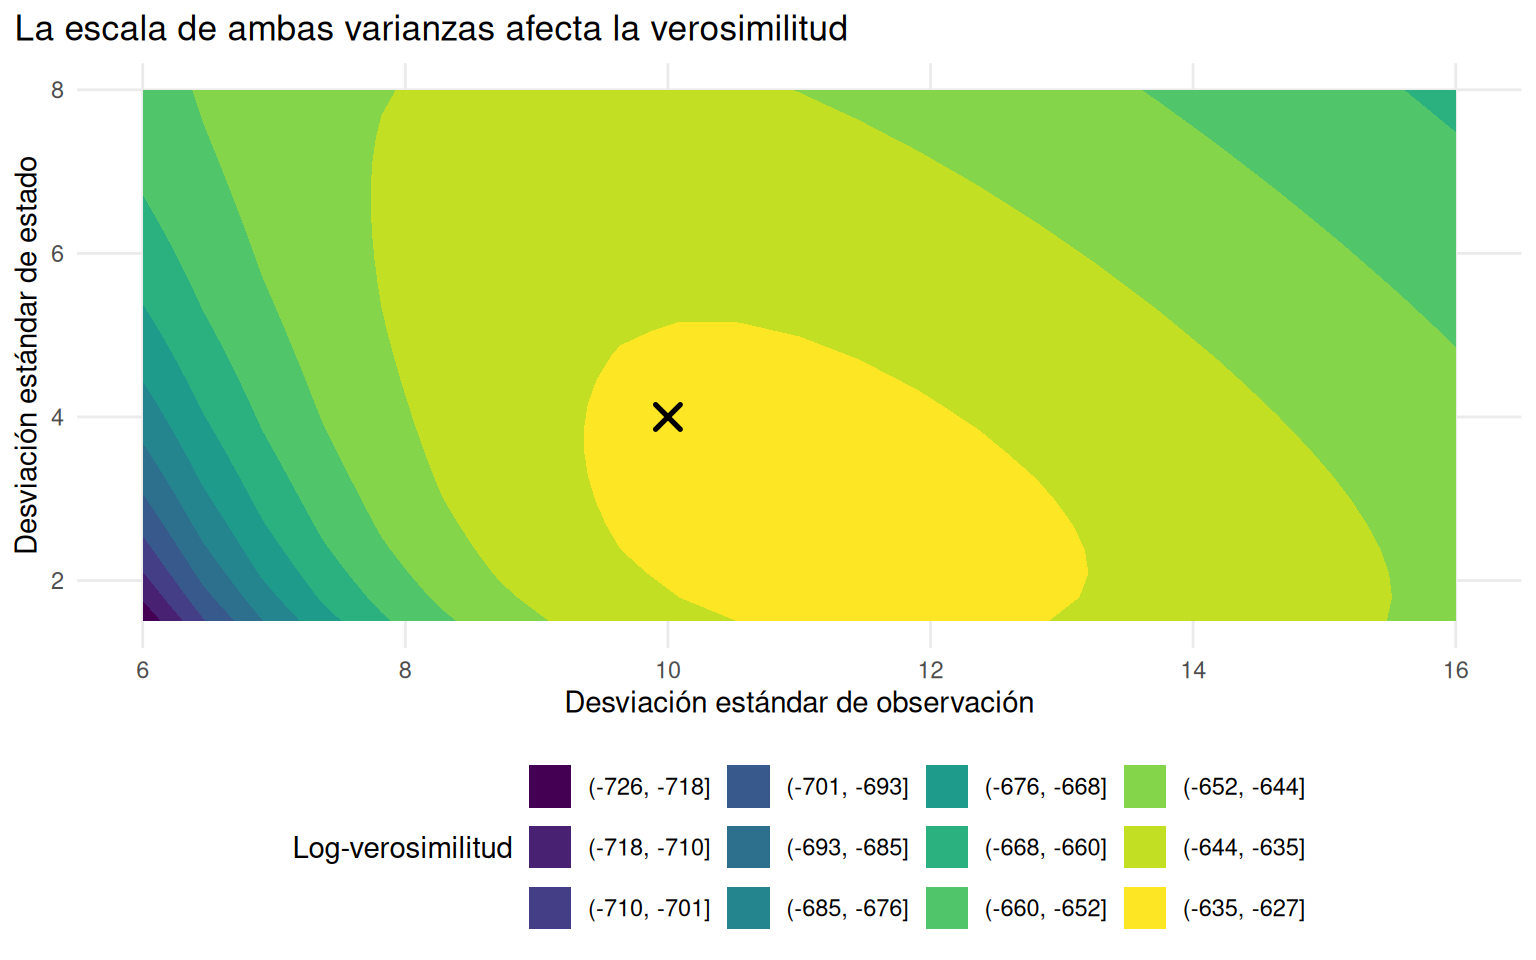
12.7 Suavizamiento retrospectivo: algoritmo RTS
12.7.1 Condicionamiento gaussiano de dos estados consecutivos
La pregunta ahora es cómo calcular \(p(\boldsymbol x_t\mid y_{1:T},\boldsymbol\psi)\) para \(t<T\). Partimos de la distribución filtrada en \(t\), y la predictiva de \(t+1\):
\[ \boldsymbol x_t\mid\mathcal D_t\sim N_p(\boldsymbol m_t,\boldsymbol C_t),\qquad \boldsymbol x_{t+1}\mid\mathcal D_t\sim N_p(\boldsymbol a_{t+1},\boldsymbol R_{t+1}). \]
De la transición, \(\boldsymbol x_{t+1}=\boldsymbol G_{t+1}\boldsymbol x_t+\boldsymbol w_{t+1}\). Condicionalmente a \(\mathcal D_t\), tenemos
\[ \operatorname{Cov}(\boldsymbol x_t,\boldsymbol x_{t+1}\mid\mathcal D_t) =\boldsymbol C_t\boldsymbol G_{t+1}^\top. \tag{12.22}\]
En consecuencia, los dos estados tienen una distribución normal conjunta con media y covarianza por bloques:
\[ \begin{pmatrix}\boldsymbol x_t\\\boldsymbol x_{t+1}\end{pmatrix} \mid\mathcal D_t\sim N_{2p}\left[ \begin{pmatrix}\boldsymbol m_t\\\boldsymbol a_{t+1}\end{pmatrix}, \begin{pmatrix} \boldsymbol C_t & \boldsymbol C_t\boldsymbol G_{t+1}^\top\\ \boldsymbol G_{t+1}\boldsymbol C_t & \boldsymbol R_{t+1} \end{pmatrix} \right]. \tag{12.23}\]
Al condicionar una normal multivariada en \(\boldsymbol x_{t+1}\) se obtiene
\[ E(\boldsymbol x_t\mid\boldsymbol x_{t+1},\mathcal D_t) =\boldsymbol m_t+\boldsymbol J_t (\boldsymbol x_{t+1}-\boldsymbol a_{t+1}), \tag{12.24}\]
\[ \operatorname{Var}(\boldsymbol x_t\mid\boldsymbol x_{t+1},\mathcal D_t) =\boldsymbol C_t-\boldsymbol J_t\boldsymbol R_{t+1}\boldsymbol J_t^\top, \tag{12.25}\]
con la ganancia de suavizamiento
\[ \boxed{ \boldsymbol J_t=\boldsymbol C_t\boldsymbol G_{t+1}^\top \boldsymbol R_{t+1}^{-1}. } \tag{12.26}\]
Suponemos que \(\boldsymbol R_{t+1}\) es invertible; las situaciones singulares requieren tratamientos numéricos apropiados. Nótese la diferencia entre \(\boldsymbol J_t\) y \(\boldsymbol K_t\): la primera vincula estados consecutivos; la segunda vincula un estado con la innovación observada contemporánea.
12.7.2 ¿Cómo aparecen las observaciones futuras?
Una propiedad fundamental de los modelos de espacio-estado es que los estados latentes forman un proceso de Markov de primer orden. Es decir,
\[ p(\boldsymbol x_{t+1}\mid \boldsymbol x_{1:t}) = p(\boldsymbol x_{t+1}\mid \boldsymbol x_t). \]
Además, las observaciones son condicionalmente independientes dado el proceso de estados, de modo que
\[ p(y_t\mid \boldsymbol x_{1:T},y_{1:t-1}) = p(y_t\mid\boldsymbol x_t). \]
Estas dos propiedades determinan cómo se transmite la información a través del tiempo.
La propiedad de separación condicional.
Consideremos tres cantidades: el estado actual \(\boldsymbol x_t\), el estado siguiente \(\boldsymbol x_{t+1}\) y las observaciones futuras \(y_{t+1:T}\).
En un modelo de espacio-estado, la información sobre \(\boldsymbol x_t\) se transmite hacia el futuro a través de \(\boldsymbol x_{t+1}\). Una vez que conocemos este último estado, las observaciones posteriores no proporcionan información adicional sobre \(\boldsymbol x_t\), suponiendo que también conocemos las observaciones hasta \(t\).
Formalmente, tenemos la independencia condicional
\[ \boldsymbol X_t\ \perp\!\!\!\perp\ Y_{t+1:T} \mid (\boldsymbol X_{t+1},Y_{1:t}). \]
Esto equivale a afirmar que
\[ p(y_{t+1:T}\mid \boldsymbol x_t,\boldsymbol x_{t+1},y_{1:t}) = p(y_{t+1:T}\mid\boldsymbol x_{t+1},y_{1:t}). \]
De hecho, bajo los supuestos habituales del modelo, el segundo término puede expresarse como \(p(y_{t+1:T}\mid\boldsymbol x_{t+1})\).
Para demostrar la consecuencia de esta propiedad, aplicamos la regla de Bayes:
\[ \begin{aligned} &p(\boldsymbol x_t\mid \boldsymbol x_{t+1},y_{1:T})\\[4pt] &= \frac{ p(y_{t+1:T}\mid \boldsymbol x_t,\boldsymbol x_{t+1},y_{1:t}) p(\boldsymbol x_t\mid \boldsymbol x_{t+1},y_{1:t}) }{ p(y_{t+1:T}\mid \boldsymbol x_{t+1},y_{1:t}) }. \end{aligned} \]
Por la independencia condicional anterior, las densidades de las observaciones futuras que aparecen en el numerador y el denominador son iguales. Por tanto, se cancelan y obtenemos
\[ \boxed{ p(\boldsymbol x_t\mid\boldsymbol x_{t+1},y_{1:T}) = p(\boldsymbol x_t\mid\boldsymbol x_{t+1},y_{1:t}). } \tag{12.27}\]
Esta identidad es válida para el modelo de espacio-estado especificado, condicionando en sus parámetros estáticos.
Supondremos que ya conocemos \(\boldsymbol x_{t+1}\mid\mathcal D_T\sim N_p(\boldsymbol s_{t+1},\boldsymbol S_{t+1})\). La ley de la esperanza iterada, aplicada a Ecuación 12.24, produce
\[ \begin{aligned} \boldsymbol s_t &=E\{E(\boldsymbol x_t\mid\boldsymbol x_{t+1},\mathcal D_T)\mid\mathcal D_T\}\\ &=\boldsymbol m_t+\boldsymbol J_t(\boldsymbol s_{t+1}-\boldsymbol a_{t+1}). \end{aligned} \tag{12.28}\]
La ley de la varianza total proporciona
\[ \begin{aligned} \boldsymbol S_t &= E\{\operatorname{Var}(\boldsymbol x_t\mid\boldsymbol x_{t+1},\mathcal D_T)\mid\mathcal D_T\}\\ &\quad+\operatorname{Var}\{E(\boldsymbol x_t\mid\boldsymbol x_{t+1},\mathcal D_T)\mid\mathcal D_T\}\\ &=\boldsymbol C_t-\boldsymbol J_t\boldsymbol R_{t+1}\boldsymbol J_t^\top +\boldsymbol J_t\boldsymbol S_{t+1}\boldsymbol J_t^\top. \end{aligned} \]
Así obtenemos
\[ \boxed{ \begin{aligned} \boldsymbol s_t&=\boldsymbol m_t+ \boldsymbol J_t(\boldsymbol s_{t+1}-\boldsymbol a_{t+1}),\\ \boldsymbol S_t&=\boldsymbol C_t+ \boldsymbol J_t(\boldsymbol S_{t+1}-\boldsymbol R_{t+1}) \boldsymbol J_t^\top. \end{aligned}} \tag{12.29}\]
Se inicia en \(T\) con \(\boldsymbol s_T=\boldsymbol m_T\) y \(\boldsymbol S_T=\boldsymbol C_T\), y se itera hacia atrás para \(t=T-1,\ldots,1\) (Petris et al. 2009, sec. 2.7.4; Shumway y Stoffer 2025, sec. 6.2).
12.7.3 Interpretación de la corrección retrospectiva
La corrección \(\boldsymbol s_{t+1}-\boldsymbol a_{t+1}\) compara lo que se sabe después de terminar la muestra sobre el estado \(t+1\) con lo que se esperaba desde \(t\). Multiplicada por \(\boldsymbol J_t\), dicha diferencia revisa la estimación de \(\boldsymbol x_t\). Una consecuencia teórica de agregar información es
\[ \boldsymbol S_t\preceq\boldsymbol C_t, \tag{12.30}\]
pues, en el modelo gaussiano con parámetros conocidos, la covarianza condicional disminuye (en el orden semidefinido positivo) al condicionar en un conjunto de información más amplio. No significa que la trayectoria suavizada tenga siempre menor variación temporal, ni que esté más cerca de la trayectoria verdadera en cada punto de una realización.
En un análisis histórico es legítimo utilizar \(\boldsymbol s_t\) para describir el pasado. Para pronósticos emitidos realmente en \(t\) debe usarse \(\boldsymbol m_t\) y la información disponible en ese instante.
12.7.4 Comprobación numérica y bandas para los estados
tabla_rts_kf12 <- tibble(
  t = seq_len(n_sim_kf12),
  estado_verdadero = estados_sim_kf12,
  media_filtrada = fil_sim_kf12$m[, 1],
  media_suavizada = sua_sim_kf12$s[, 1],
  de_filtrada = sqrt(fil_sim_kf12$C[1, 1, ]),
  de_suavizada = sqrt(pmax(0, sua_sim_kf12$S[1, 1, ]))
)
stopifnot(
  max(tabla_rts_kf12$de_suavizada - tabla_rts_kf12$de_filtrada) < 1e-6,
  abs(tabla_rts_kf12$media_filtrada[n_sim_kf12] -
        tabla_rts_kf12$media_suavizada[n_sim_kf12]) < 1e-8
)
knitr::kable(
  tabla_rts_kf12 |>
    filter(t %in% c(5L, 25L, 60L, 120L, 160L)),
  digits = 3
)| t | estado_verdadero | media_filtrada | media_suavizada | de_filtrada | de_suavizada |
|---|---|---|---|---|---|
| 5 | -2.861 | -12.887 | -15.388 | 5.837 | 4.479 |
| 25 | -25.098 | -13.684 | -18.263 | 5.726 | 4.429 |
| 60 | -16.546 | -6.322 | -4.957 | 5.726 | 4.429 |
| 120 | 3.862 | -4.190 | -1.539 | 5.726 | 4.429 |
| 160 | -2.554 | -2.842 | -2.842 | 5.726 | 5.726 |
12.7.4.1 Convergencia de las varianzas filtradas y suavizadas
Una característica interesante de Tabla 12.1 es que las desviaciones estándar filtradas y suavizadas toman valores prácticamente constantes después de cierto número de observaciones. Este comportamiento no es un error numérico, sino una consecuencia de las propiedades del filtro de Kalman cuando las matrices del modelo son constantes.
Consideremos nuevamente el modelo de nivel local utilizado en la simulación:
\[ \begin{aligned} Y_t &= X_t+\varepsilon_t, &\varepsilon_t&\sim N(0,V),\\ X_t &= X_{t-1}+\eta_t, &\eta_t&\sim N(0,W), \end{aligned} \]
donde \(V>0\) y \(W>0\) son constantes conocidas.
Convergencia de la varianza filtrada.
En este modelo, las recursiones de predicción y filtrado para las varianzas son
\[ R_t=C_{t-1}+W, \qquad C_t=R_t-\frac{R_t^2}{R_t+V}. \]
Sustituyendo la primera expresión en la segunda y simplificando, obtenemos
\[ C_t= \frac{V(C_{t-1}+W)} {C_{t-1}+W+V}. \]
Esta es una ecuación de Riccati escalar. Nótese que su evolución depende únicamente de \(C_{t-1}\) y de las varianzas \(V\) y \(W\), pero no de los valores observados \(y_t\).
Cuando \(V\) y \(W\) son estrictamente positivos, la sucesión de varianzas filtradas converge a un valor estacionario \(C_\infty\), independientemente de la varianza inicial finita \(C_0\geq 0\).
Para determinar ese valor, imponemos la condición de equilibrio \(C_t=C_{t-1}=C_\infty\):
\[ C_\infty= \frac{V(C_\infty+W)} {C_\infty+W+V}. \]
Multiplicando ambos lados por el denominador y reorganizando,
\[ C_\infty^2+WC_\infty-VW=0. \]
Esta ecuación cuadrática tiene una única solución positiva:
\[ \boxed{ C_\infty= \frac{-W+\sqrt{W^2+4VW}}{2}. } \tag{12.31}\]
Para los valores utilizados en nuestra simulación, \(V=100\) y \(W=16\), obtenemos
\[ C_\infty= \frac{-16+\sqrt{16^2+4(100)(16)}}{2} \approx 32.7922. \]
En consecuencia, la desviación estándar filtrada converge a
\[ \sqrt{C_\infty}\approx 5.72644. \]
Esto explica por qué en Tabla 12.1 aparece repetidamente el valor \(5.726\) a partir de \(t=25\), después del redondeo a tres cifras decimales.
Convergencia de la varianza suavizada.
También podemos estudiar el comportamiento de la varianza suavizada. En el modelo de nivel local, la ganancia del suavizador RTS es
\[ J_t=\frac{C_t}{C_t+W}, \]
y la recursión de su varianza viene dada por
\[ S_t=C_t+J_t^2(S_{t+1}-C_t-W). \]
Cuando las varianzas filtradas han alcanzado su equilibrio, la ganancia de suavizamiento se aproxima a
\[ J_\infty=\frac{C_\infty}{C_\infty+W}. \]
Lejos de ambos extremos de una muestra suficientemente larga, las varianzas suavizadas también se aproximan a un valor estacionario \(S_\infty\), que satisface
\[ S_\infty= C_\infty+ J_\infty^2(S_\infty-C_\infty-W). \]
Despejando \(S_\infty\) y sustituyendo la expresión de \(J_\infty\), se obtiene
\[ \boxed{ S_\infty= \frac{C_\infty(C_\infty+W)} {2C_\infty+W}. } \tag{12.32}\]
Con los parámetros de la simulación,
\[ S_\infty\approx19.6116, \qquad \sqrt{S_\infty}\approx4.42850. \]
Por tanto, la desviación estándar suavizada se aproxima a \(4.429\), tal como se observa en Tabla 12.1 para los instantes \(t=25\), \(t=60\) y \(t=120\).
Además, dado que \(W>0\), se cumple
\[ S_\infty<C_\infty. \]
Este resultado refleja la reducción de incertidumbre que se obtiene al utilizar observaciones futuras para estimar retrospectivamente los estados.
Comportamiento en el último instante.
Finalmente, en \(t=T=160\), las desviaciones estándar filtrada y suavizada coinciden exactamente. Esto se debe a que el algoritmo RTS comienza con las condiciones
\[ s_T=m_T,\qquad S_T=C_T. \]
Como no existen observaciones posteriores a \(T\), la distribución suavizada del último estado coincide con su distribución filtrada.
Esta condición también explica por qué, cerca del extremo derecho de la muestra, la varianza suavizada puede alejarse de su valor estacionario y aproximarse a la varianza filtrada.
En síntesis, el comportamiento observado en la tabla refleja tres propiedades fundamentales:
- Las varianzas del filtro de Kalman siguen recursiones deterministas cuando los parámetros son conocidos.
- En el modelo de nivel local con varianzas constantes y positivas, la incertidumbre filtrada converge a un equilibrio, mientras que la incertidumbre suavizada se aproxima a otro equilibrio menor en el interior de una muestra larga.
- En el último instante, ambas incertidumbres coinciden porque no se dispone de información futura para realizar el suavizamiento.
Estos resultados ayudan a comprender que la ganancia informativa del suavizamiento depende de la posición temporal del estado dentro de la muestra y de la cantidad de información posterior disponible.
bandas_sim_kf12 <- bind_rows(
  tibble(t = seq_len(n_sim_kf12), tipo = "Filtrado",
         media = fil_sim_kf12$m[, 1],
         de = sqrt(fil_sim_kf12$C[1, 1, ])),
  tibble(t = seq_len(n_sim_kf12), tipo = "Suavizado",
         media = sua_sim_kf12$s[, 1],
         de = sqrt(pmax(0, sua_sim_kf12$S[1, 1, ])))
) |>
  mutate(li = media - qnorm(.975) * de,
         ls = media + qnorm(.975) * de)

ggplot(bandas_sim_kf12, aes(t, media)) +
  geom_ribbon(aes(ymin = li, ymax = ls), fill = "#5f86af", alpha = .25) +
  geom_line(colour = "#14608b") +
  geom_line(data = sim_kf12, aes(t, estado),
            inherit.aes = FALSE, linewidth = .6, colour = "black") +
  facet_wrap(~ tipo, ncol = 1) +
  labs(x = "Período", y = "Estado latente",
       title = "La información retrospectiva reduce la incertidumbre condicional") +
  tema_kf12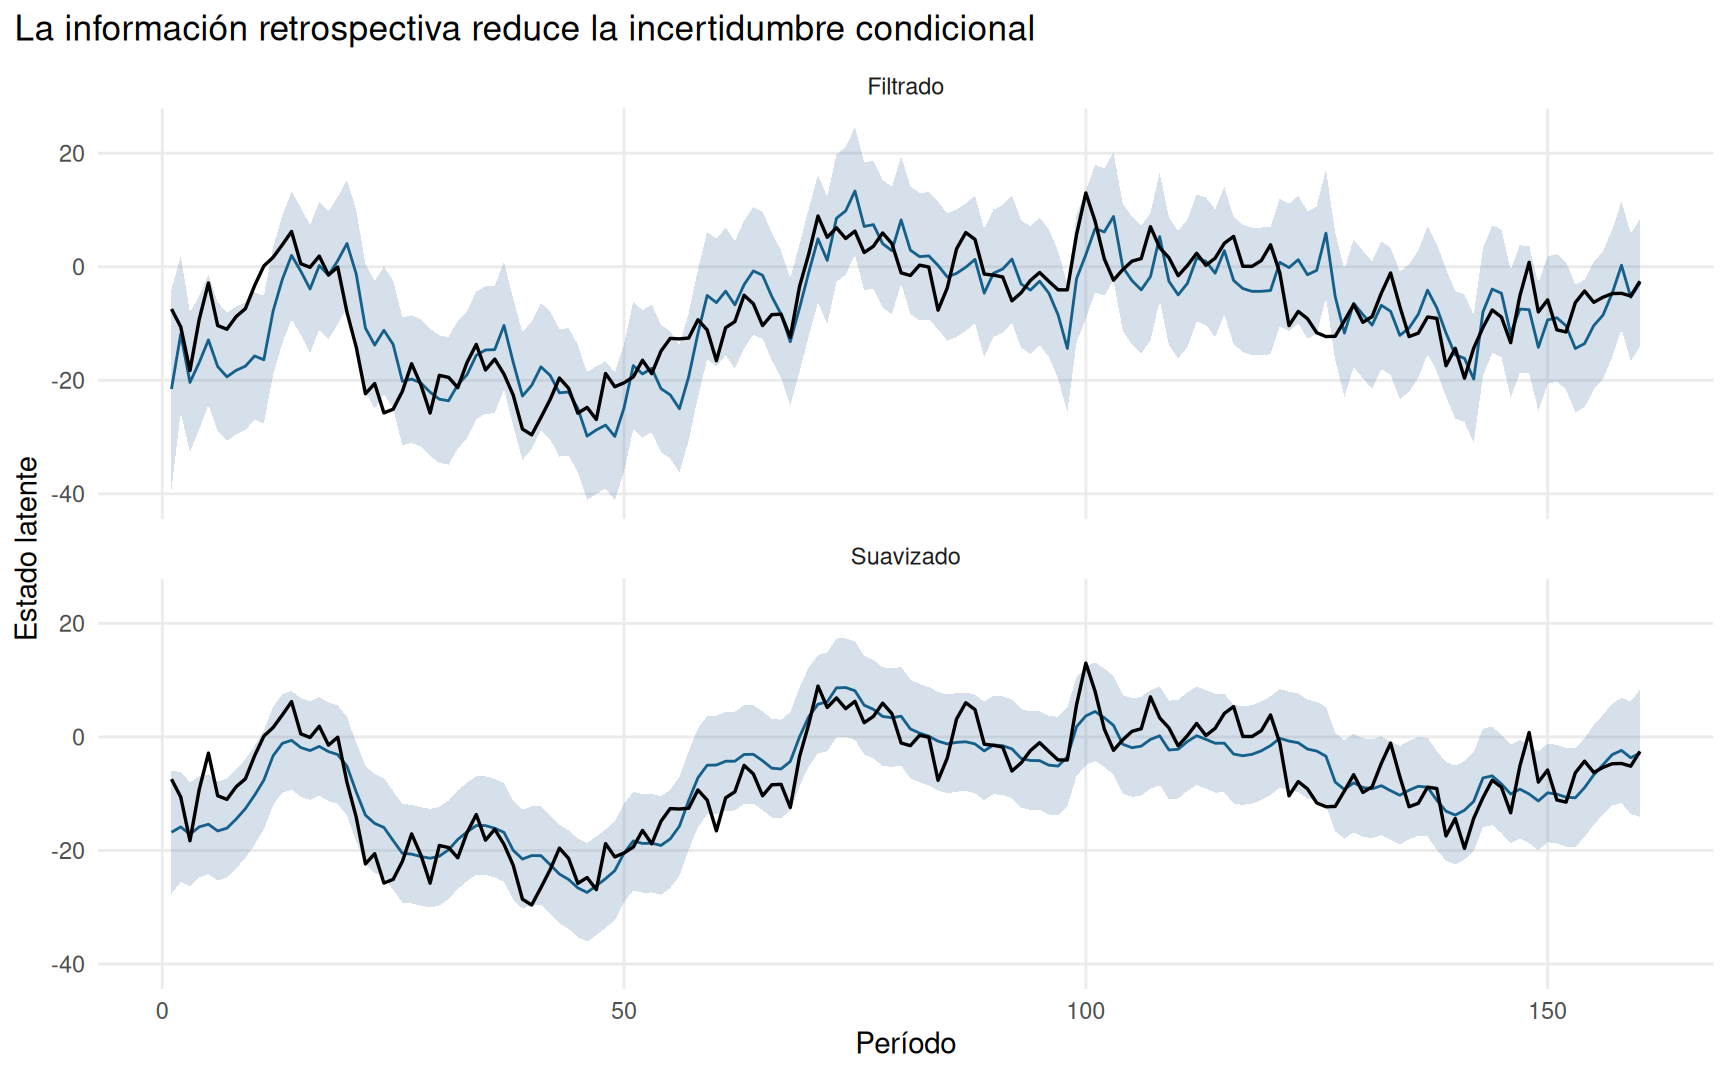
12.7.5 Verificación con dlm
El paquete dlm implementa filtrado y suavizamiento gaussianos lineales (Petris et al. 2009, cap. 2). Contrastamos el filtro manual con dlmFilter() usando la misma distribución inicial y varianzas. En dlm, la primera entrada del componente m corresponde al estado inicial; por eso se descarta antes de comparar \(t=1,\ldots,T\).
modelo_dlm_sim_kf12 <- dlm::dlmModPoly(
  order = 1, dV = V_sim_kf12, dW = W_sim_kf12,
  m0 = m0_sim_kf12, C0 = C0_sim_kf12
)
fil_dlm_sim_kf12 <- dlm::dlmFilter(y_sim_kf12, modelo_dlm_sim_kf12)
medias_dlm_kf12 <- as.numeric(fil_dlm_sim_kf12$m)[-1L]
stopifnot(
  length(medias_dlm_kf12) == n_sim_kf12,
  max(abs(medias_dlm_kf12 - fil_sim_kf12$m[, 1])) < 1e-6
)
knitr::kable(
  tibble(t = seq_len(n_sim_kf12),
         manual = fil_sim_kf12$m[, 1], dlm = medias_dlm_kf12,
         diferencia = manual - dlm) |>
    filter(t %in% c(1L, 15L, 50L, 100L, 160L)),
  digits = 7
)dlm).
| t | manual | dlm | diferencia |
|---|---|---|---|
| 1 | -21.5379513 | -21.5379513 | 0 |
| 15 | -0.7750629 | -0.7750629 | 0 |
| 50 | -24.8446161 | -24.8446161 | 0 |
| 100 | 2.1197991 | 2.1197991 | 0 |
| 160 | -2.8421770 | -2.8421770 | 0 |
Esta comprobación numérica es útil porque detecta errores de indexación del estado inicial, una fuente habitual de discrepancias. La derivación de Ecuación 12.29 justifica el suavizador manual de manera independiente del paquete.
12.8 Pronóstico de estados y observaciones a varios pasos
El pronóstico desde \(T\) es una distribución condicionada en \(\mathcal D_T\). No incorpora las observaciones que serán recogidas después de ese origen. Una vez concluido el filtro, el estado cumple \(\boldsymbol x_T\mid\mathcal D_T\sim N_p(\boldsymbol m_T,\boldsymbol C_T)\).
12.8.1 Propagación de momentos
Para un sistema con matrices que pueden variar en el tiempo, inicializamos \(\boldsymbol a_{T\mid T}=\boldsymbol m_T\) y \(\boldsymbol R_{T\mid T}=\boldsymbol C_T\). Para \(h=1,2,\ldots\) aplicamos
\[ \begin{aligned} \boldsymbol a_{T+h\mid T} &=\boldsymbol G_{T+h}\boldsymbol a_{T+h-1\mid T},\\ \boldsymbol R_{T+h\mid T} &=\boldsymbol G_{T+h}\boldsymbol R_{T+h-1\mid T} \boldsymbol G_{T+h}^\top+\boldsymbol W_{T+h}. \end{aligned} \tag{12.33}\]
La segunda recursión se deduce tomando la varianza condicional de \(\boldsymbol G_{T+h}\boldsymbol x_{T+h-1}+\boldsymbol w_{T+h}\) y usando la independencia de la perturbación futura. Para la observación futura,
\[ \begin{aligned} \widehat y_{T+h\mid T} &=\boldsymbol F_{T+h}^\top\boldsymbol a_{T+h\mid T},\\ Q_{T+h\mid T} &=\boldsymbol F_{T+h}^\top\boldsymbol R_{T+h\mid T} \boldsymbol F_{T+h}+V_{T+h}. \end{aligned} \tag{12.34}\]
Así,
\[ Y_{T+h}\mid\mathcal D_T,\boldsymbol\psi \sim N(\widehat y_{T+h\mid T},Q_{T+h\mid T}). \tag{12.35}\]
Un intervalo central de nivel \(1-\alpha\) es
\[ \widehat y_{T+h\mid T} \pm z_{1-\alpha/2}\sqrt{Q_{T+h\mid T}}. \tag{12.36}\]
La covarianza predictiva del estado es \(\boldsymbol R_{T+h\mid T}\); la varianza predictiva de la observación incorpora adicionalmente \(V_{T+h}\). Confundirlas produciría intervalos incorrectos para la magnitud observada.
12.8.2 Solución cerrada con matrices constantes
Si \(\boldsymbol G\) y \(\boldsymbol W\) no dependen del tiempo, iterar la ecuación de transición da
\[ \boldsymbol x_{T+h} =\boldsymbol G^h\boldsymbol x_T +\sum_{j=0}^{h-1}\boldsymbol G^j\boldsymbol w_{T+h-j}. \tag{12.37}\]
De aquí se deduce
\[ \boxed{ \begin{aligned} \boldsymbol a_{T+h\mid T}&=\boldsymbol G^h\boldsymbol m_T,\\ \boldsymbol R_{T+h\mid T} &=\boldsymbol G^h\boldsymbol C_T(\boldsymbol G^h)^\top +\sum_{j=0}^{h-1}\boldsymbol G^j\boldsymbol W(\boldsymbol G^j)^\top. \end{aligned}} \tag{12.38}\]
Las dos partes de la covarianza tienen interpretaciones diferentes: la primera propaga la incertidumbre que ya existía en \(T\); la segunda acumula perturbaciones futuras no observables. Condicionar en \(\widehat{\boldsymbol\psi}_{\rm MV}\) deja fuera una tercera fuente de variabilidad: la incertidumbre de estimación paramétrica.
12.8.3 Caso particular: nivel local
Con \(F=G=1\), la media predictiva permanece constante aunque la incertidumbre aumente:
\[ \boxed{ \widehat y_{T+h\mid T}=m_T, \qquad Q_{T+h\mid T}=C_T+hW+V. } \tag{12.39}\]
La desviación estándar crece en proporción a la raíz cuadrada de \(C_T+hW+V\), no linealmente en \(h\). Recordemos que esta fórmula describe las distribuciones del nivel local bajo parámetros fijos y no exige diferenciación explícita de las observaciones.
12.8.4 Caso particular: tendencia lineal local
Para capturar cambios en nivel y pendiente, consideremos
\[ \begin{aligned} Y_t &=\mu_t+v_t,\\ \mu_t&=\mu_{t-1}+\beta_{t-1}+w_{\mu,t},\\ \beta_t&=\beta_{t-1}+w_{\beta,t}, \end{aligned} \tag{12.40}\]
con innovaciones gaussianas independientes y covarianza de estado diagonal. Su representación matricial es
\[ \boldsymbol x_t=\begin{pmatrix}\mu_t\\\beta_t\end{pmatrix},\quad \boldsymbol F=\begin{pmatrix}1\\0\end{pmatrix},\quad \boldsymbol G=\begin{pmatrix}1&1\\0&1\end{pmatrix},\quad \boldsymbol W=\begin{pmatrix}W_\mu&0\\0&W_\beta\end{pmatrix}. \tag{12.41}\]
Puesto que
\[ \boldsymbol G^h=\begin{pmatrix}1&h\\0&1\end{pmatrix}, \tag{12.42}\]
si \(\boldsymbol m_T=(m_{\mu,T},m_{\beta,T})^\top\), obtenemos
\[ \boxed{ \widehat y_{T+h\mid T}=m_{\mu,T}+h\,m_{\beta,T}. } \tag{12.43}\]
Escribiendo \(\boldsymbol C_T=(c_{ij,T})_{i,j=1}^2\) y suponiendo \(\operatorname{Cov}(w_{\mu,t},w_{\beta,t})=0\), la varianza de la observación futura se simplifica a
\[ \boxed{ \begin{aligned} Q_{T+h\mid T} ={}&c_{11,T}+2h\,c_{12,T}+h^2c_{22,T}\\ &+hW_\mu +\frac{h(h-1)(2h-1)}{6}W_\beta+V. \end{aligned}} \tag{12.44}\]
Derivación del término de pendiente. La contribución de \(\boldsymbol W\) en Ecuación 12.38 tiene, para su primera coordenada, la forma
\[ \sum_{j=0}^{h-1}(W_\mu+j^2W_\beta) =hW_\mu+W_\beta\sum_{j=0}^{h-1}j^2. \]
La identidad \(\sum_{j=0}^{h-1}j^2=h(h-1)(2h-1)/6\) conduce a Ecuación 12.44. La pendiente estocástica puede hacer que la incertidumbre de la observación aumente mucho más rápido que en un modelo de nivel local. En particular, la perturbación \(w_{\beta,T+1}\) no entra en el nivel \(\mu_{T+1}\) bajo nuestra convención: empieza a afectar el nivel del período siguiente. Por eso el término de \(W_\beta\) vale cero cuando \(h=1\).
Interpretación. Una pendiente estimada positiva produce una trayectoria de pronóstico creciente, pero eso no demuestra que exista una tendencia ininterrumpida: es una extrapolación condicional a la especificación. La estimación de \(W_\beta\) puede ser delicada en muestras cortas y el modelo puede generar intervalos muy amplios a largo plazo (Petris et al. 2009, sec. 3.2.1; Shumway y Stoffer 2025, sec. 6.5).
12.9 Observaciones faltantes
El filtrado permite tratar registros ausentes sin interpolarlos con valores construidos usando datos posteriores. Si \(y_t\) no se observa, se mantiene la predicción del estado:
\[ \boxed{ \boldsymbol m_t=\boldsymbol a_t, \qquad \boldsymbol C_t=\boldsymbol R_t \quad\text{si }y_t\text{ no está disponible}. } \tag{12.45}\]
La transición al tiempo siguiente utiliza ese estado predictivo como entrada. En el nivel local, después de \(k\) períodos consecutivos sin datos y con \(W>0\), la varianza crece al menos con la acumulación de \(k\) perturbaciones de estado, y la estimación del nivel mantiene la misma media durante el bloque ausente. Al observar un dato nuevo, vuelve a aplicarse Ecuación 12.6.
Importante: esta regla supone que el patrón de observación faltante es ignorable para los parámetros y estados de interés. Si el dato tiende a faltar precisamente cuando el nivel es extremo, habría que incorporar un mecanismo de selección o un modelo de observación más completo.
12.9.1 Ejemplo controlado con un bloque ausente
y_faltante_kf12 <- y_sim_kf12
y_faltante_kf12[55:68] <- NA_real_
y_faltante_kf12[115:119] <- NA_real_
fil_faltante_kf12 <- do.call(
  filtrar_kalman,
  c(list(y = y_faltante_kf12), cfg_sim_kf12)
)
sua_faltante_kf12 <- suavizar_rts(fil_faltante_kf12)
stopifnot(
  all(is.na(fil_faltante_kf12$e[55:68])),
  all(is.na(fil_faltante_kf12$z[115:119])),
  all(diff(fil_faltante_kf12$C[1, 1, 55:68]) >= -1e-8)
)
tray_faltante_kf12 <- tibble(
t = seq_len(n_sim_kf12), y = y_faltante_kf12,
filtro = fil_faltante_kf12$m[, 1],
suavizador = sua_faltante_kf12$s[, 1],
li = fil_faltante_kf12$m[, 1] -
qnorm(.975) * sqrt(fil_faltante_kf12$C[1, 1, ]),
ls = fil_faltante_kf12$m[, 1] +
qnorm(.975) * sqrt(fil_faltante_kf12$C[1, 1, ])
)
ggplot(tray_faltante_kf12, aes(t)) +
annotate("rect", xmin = 54.5, xmax = 68.5,
ymin = -Inf, ymax = Inf, fill = "grey65", alpha = .16) +
annotate("rect", xmin = 114.5, xmax = 119.5,
ymin = -Inf, ymax = Inf, fill = "grey65", alpha = .16) +
geom_ribbon(aes(ymin = li, ymax = ls), fill = "#2376aa", alpha = .17) +
geom_point(aes(y = y), alpha = .28, size = .7) +
geom_line(aes(y = filtro, colour = "Filtrada"), linewidth = .7) +
geom_line(aes(y = suavizador, colour = "Suavizada"), linewidth = .7) +
scale_colour_manual(values = c(Filtrada = "#2376aa", Suavizada = "#c55c19")) +
labs(x = "Período", y = "Valor", colour = "Estimación",
title = "Un dato ausente no debe tratarse como un cero") +
tema_kf12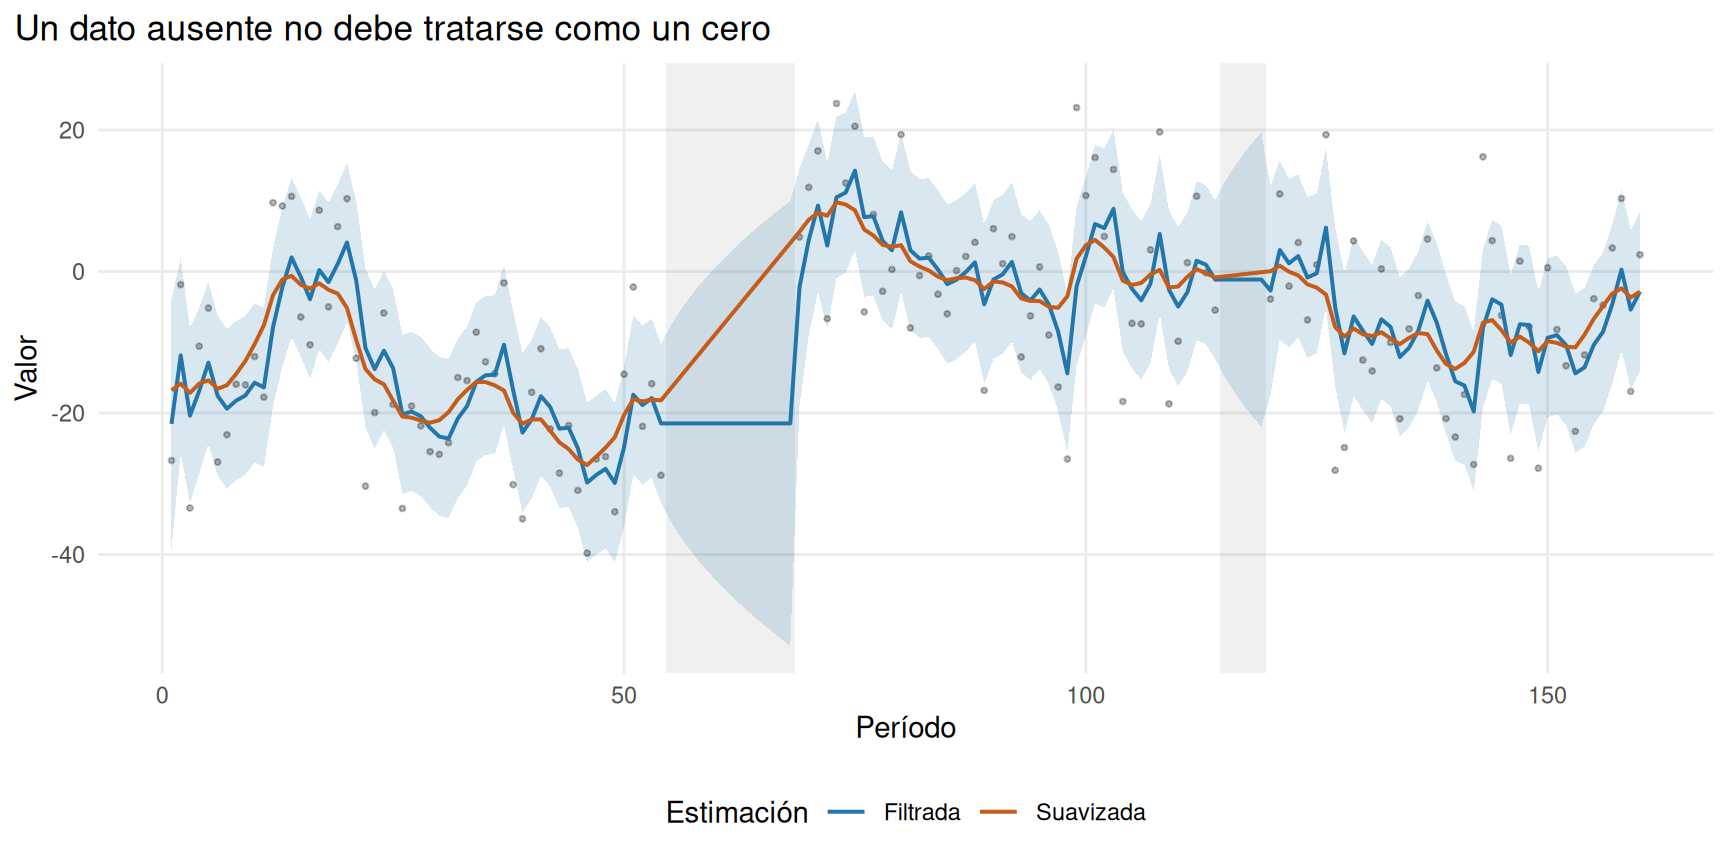
La banda azul describe la incertidumbre filtrada del estado, no la incertidumbre predictiva de una nueva observación. El sombreado gris señala los bloques sin medición. En esas fechas la verosimilitud observada no contiene términos correspondientes a los registros faltantes, aunque las covarianzas sigan evolucionando.
12.10 Aplicación real: caudal anual del río Nilo
Utilizaremos datasets::Nile, que contiene 100 observaciones anuales entre 1871 y 1970, en unidades de \(10^8\,\mathrm{m}^3\). Ya se usó en Sección 11.14 para practicar el filtrado con \(V\) y \(W\) fijados como ejemplo didáctico. Esta vez estimaremos esas varianzas únicamente con los datos del período de entrenamiento.
El análisis no pretende demostrar que exista una única descomposición física del caudal en nivel y ruido. Es una representación probabilística útil para reconstrucción y pronóstico; los resultados dependen de la familia de modelos, del estado inicial y de la calidad del ajuste (Petris et al. 2009, secs. 2.7–2.9, 3.2.1).
12.10.1 Datos, verificación y partición
Mantendremos exactamente la separación del capítulo 11: 80 años para entrenamiento (1871–1950) y 20 años para prueba (1951–1970). Ninguna estimación inicial utilizará observaciones de 1951 en adelante.
serie_nilo_kf12 <- as.numeric(datasets::Nile)
anios_nilo_kf12 <- as.integer(stats::time(datasets::Nile))
n_nilo_kf12 <- length(serie_nilo_kf12)
n_train_kf12 <- 80L

stopifnot(
  n_nilo_kf12 == 100L,
  length(anios_nilo_kf12) == n_nilo_kf12,
  identical(range(anios_nilo_kf12), c(1871L, 1970L)),
  all(diff(anios_nilo_kf12) == 1L),
  !anyNA(serie_nilo_kf12), all(is.finite(serie_nilo_kf12))
)

nilo_kf12 <- tibble(
  t = seq_len(n_nilo_kf12),
  anio = anios_nilo_kf12,
  caudal = serie_nilo_kf12,
  periodo = if_else(t <= n_train_kf12, "Entrenamiento", "Prueba")
)
y_train_kf12 <- serie_nilo_kf12[seq_len(n_train_kf12)]
stopifnot(length(y_train_kf12) == 80L,
all(nilo_kf12$periodo[81:100] == "Prueba"))ggplot(nilo_kf12, aes(anio, caudal)) +
annotate("rect", xmin = 1950.5, xmax = Inf,
ymin = -Inf, ymax = Inf,
fill = "grey70", alpha = .27) +
geom_line(colour = "#295f86", linewidth = .65) +
geom_vline(xintercept = 1950.5, linetype = "dashed") +
annotate("text", x = 1960, y = max(serie_nilo_kf12),
label = "Prueba", colour = "grey30", vjust = 1.1) +
labs(x = "Año", y = "Caudal (10^8 m³)",
title = "El orden cronológico define entrenamiento y prueba") +
tema_kf12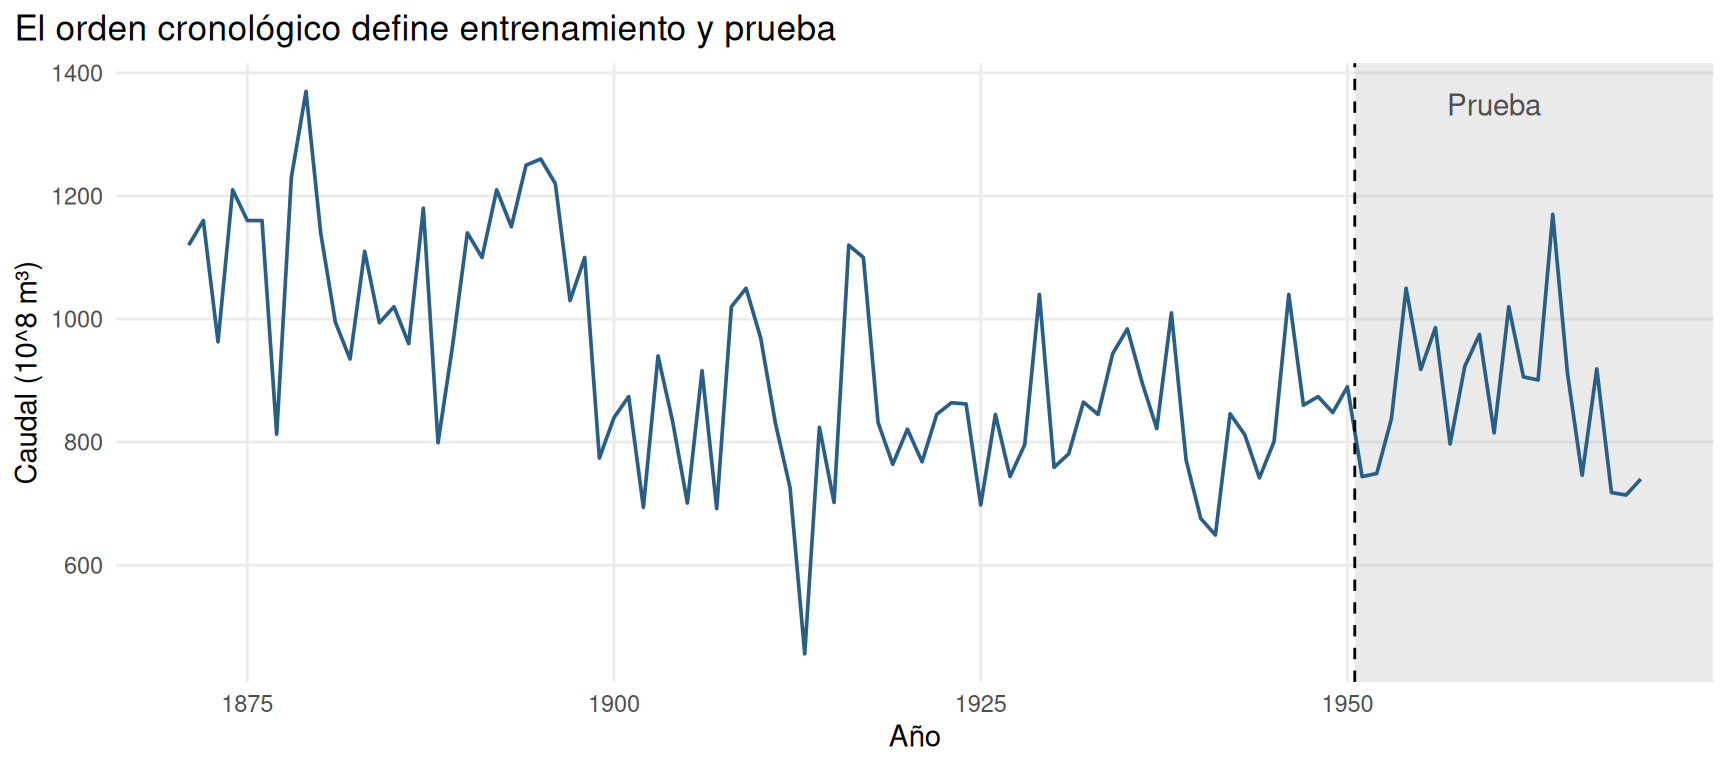
12.10.2 Estimación de nivel local y tendencia local
Compararemos dos especificaciones. En el nivel local se estiman \(V\) y \(W\). En el modelo de tendencia lineal local se estiman \(V\), \(W_\mu\) y \(W_\beta\). Se emplearán las mismas 80 observaciones, distribuciones iniciales propias, explícitas y fijadas antes de utilizar el período de prueba:
\[ \begin{aligned} \text{Nivel local: }&x_0\sim N(900,200^2),\\ \text{Tendencia local: }& \begin{pmatrix}\mu_0\\\beta_0\end{pmatrix} \sim N_2\left[ \begin{pmatrix}900\\0\end{pmatrix}, \begin{pmatrix}200^2&0\\0&25^2\end{pmatrix} \right]. \end{aligned} \tag{12.46}\]
Estas inicializaciones corresponden a modelos distintos y afectan las primeras densidades predictivas. No se presentan como prioris estimadas de los datos ni como parámetros elegidos para maximizar el desempeño fuera de muestra. Usaremos optim() con L-BFGS-B sobre log-varianzas; los límites son \(0.25^2\) y \(1000^2\) en las unidades cuadradas correspondientes. Para la varianza de innovación de la pendiente la escala corresponde a una perturbación anual de pendiente.
ajuste_nivel_kf12 <- ajustar_mv(y_train_kf12, "nivel")
ajuste_tendencia_kf12 <- ajustar_mv(y_train_kf12, "tendencia")

ajustes_kf12 <- list(
  "Nivel local" = ajuste_nivel_kf12,
  "Tendencia local" = ajuste_tendencia_kf12
)

# Mostramos diagnósticos explícitos del optimizador.
estado_opt_kf12 <- tibble(
  modelo = names(ajustes_kf12),
  codigo_opt = vapply(ajustes_kf12,
                      function(obj) obj$convergencia, integer(1)),
  log_ver = vapply(ajustes_kf12,
                   function(obj) obj$logLik, numeric(1))
)
stopifnot(all(is.finite(estado_opt_kf12$log_ver)))
tabla_param_kf12 <- bind_rows(
tibble(modelo = "Nivel local", parametro = c("V", "W"),
estimacion = ajuste_nivel_kf12$parametros),
tibble(modelo = "Tendencia local",
parametro = c("V", "W_nivel", "W_pendiente"),
estimacion = ajuste_tendencia_kf12$parametros)
)
knitr::kable(tabla_param_kf12, digits = 3)| modelo | parametro | estimacion |
|---|---|---|
| Nivel local | V | 15906.198 |
| Nivel local | W | 1584.741 |
| Tendencia local | V | 15292.701 |
| Tendencia local | W_nivel | 2038.695 |
| Tendencia local | W_pendiente | 0.062 |
La magnitud de \(V\) debe interpretarse en unidades cuadradas de caudal, y \(W\) como varianza del cambio anual del estado. En el modelo de tendencia, \(W_\beta\) mide la variabilidad de las modificaciones de la pendiente. Un estimador próximo al límite inferior de la optimización requiere cautela: puede indicar que el procedimiento está aproximando un modelo con evolución determinista de esa componente. El código de convergencia del optimizador se revisará junto con los resultados.
knitr::kable(estado_opt_kf12, digits = 3)| modelo | codigo_opt | log_ver |
|---|---|---|
| Nivel local | 0 | -513.808 |
| Tendencia local | 0 | -515.299 |
12.10.3 Verosimilitud, penalización y tamaño de muestra
Para describir el compromiso entre ajuste y complejidad, calculamos AIC y AICc,
\[ \mathrm{AIC}=-2\ell(\widehat{\boldsymbol\psi})+2k, \quad \mathrm{AICc}=\mathrm{AIC}+\frac{2k(k+1)}{n-k-1}, \tag{12.47}\]
con \(k\) el número de varianzas estimadas y \(n\) el número de observaciones de entrenamiento. Estos indicadores se calculan sobre la misma respuesta observada y las mismas fechas, aunque las dos especificaciones tengan estados iniciales y espacios de estados distintos. El AICc es una corrección habitual y debe leerse como indicador aproximado: cuando una estimación cae en una frontera, las justificaciones regulares usuales de estas penalizaciones pueden fallar.
tabla_aic_kf12 <- purrr::imap_dfr(ajustes_kf12, function(a, nombre) {
  n <- length(y_train_kf12)
  aic <- -2 * a$logLik + 2 * a$k
  tibble(modelo = nombre, parametros = a$k,
         log_ver = a$logLik, AIC = aic,
         AICc = aic + 2 * a$k * (a$k + 1) / (n - a$k - 1))
})
knitr::kable(tabla_aic_kf12, digits = 2)| modelo | parametros | log_ver | AIC | AICc |
|---|---|---|---|---|
| Nivel local | 2 | -513.81 | 1031.62 | 1031.77 |
| Tendencia local | 3 | -515.30 | 1036.60 | 1036.91 |
AICc no sustituye la evaluación externa. Los criterios de información se basan en verosimilitud ajustada, no en resultados observados bajo un horizonte de pronóstico determinado. Un candidato con menor AICc puede tener peor desempeño a \(h=5\) que otro que describe de forma más conservadora la tendencia. La comparación temporal se hará en Sección 12.12.
12.10.4 Estados filtrados y suavizados: análisis del entrenamiento
El suavizamiento se realizará primero solo sobre 1871–1950 para poder contrastar distribuciones filtradas y suavizadas calculadas sobre la misma muestra. No utilizaremos un suavizador ajustado hasta 1970 para emitir pronósticos desde 1950.
fil_nivel_train_kf12 <- ajuste_nivel_kf12$filtro
sua_nivel_train_kf12 <- suavizar_rts(fil_nivel_train_kf12)

nilo_estados_kf12 <- tibble(
  anio = anios_nilo_kf12[1:n_train_kf12],
  observado = y_train_kf12,
  filtrado = fil_nivel_train_kf12$m[, 1],
  suavizado = sua_nivel_train_kf12$s[, 1],
  des_filtrado = sqrt(fil_nivel_train_kf12$C[1, 1, ]),
  des_suavizado = sqrt(pmax(0, sua_nivel_train_kf12$S[1, 1, ]))
)
nilo_bandas_kf12 <- bind_rows(
nilo_estados_kf12 |>
transmute(anio, estado = "Filtrado", media = filtrado,
de = des_filtrado),
nilo_estados_kf12 |>
transmute(anio, estado = "Suavizado", media = suavizado,
de = des_suavizado)
) |>
mutate(li = media - qnorm(.975) * de,
ls = media + qnorm(.975) * de)
ggplot(nilo_bandas_kf12, aes(anio, media)) +
geom_ribbon(aes(ymin = li, ymax = ls), fill = "#5794be", alpha = .22) +
geom_line(colour = "#276a95", linewidth = .75) +
geom_point(data = nilo_kf12 |> filter(t <= n_train_kf12),
aes(anio, caudal), inherit.aes = FALSE,
alpha = .25, size = .8) +
facet_wrap(~ estado, ncol = 1) +
labs(x = "Año", y = "Caudal (10^8 m³)",
title = "El estado suavizado es retrospectivo, no un pronóstico") +
tema_kf12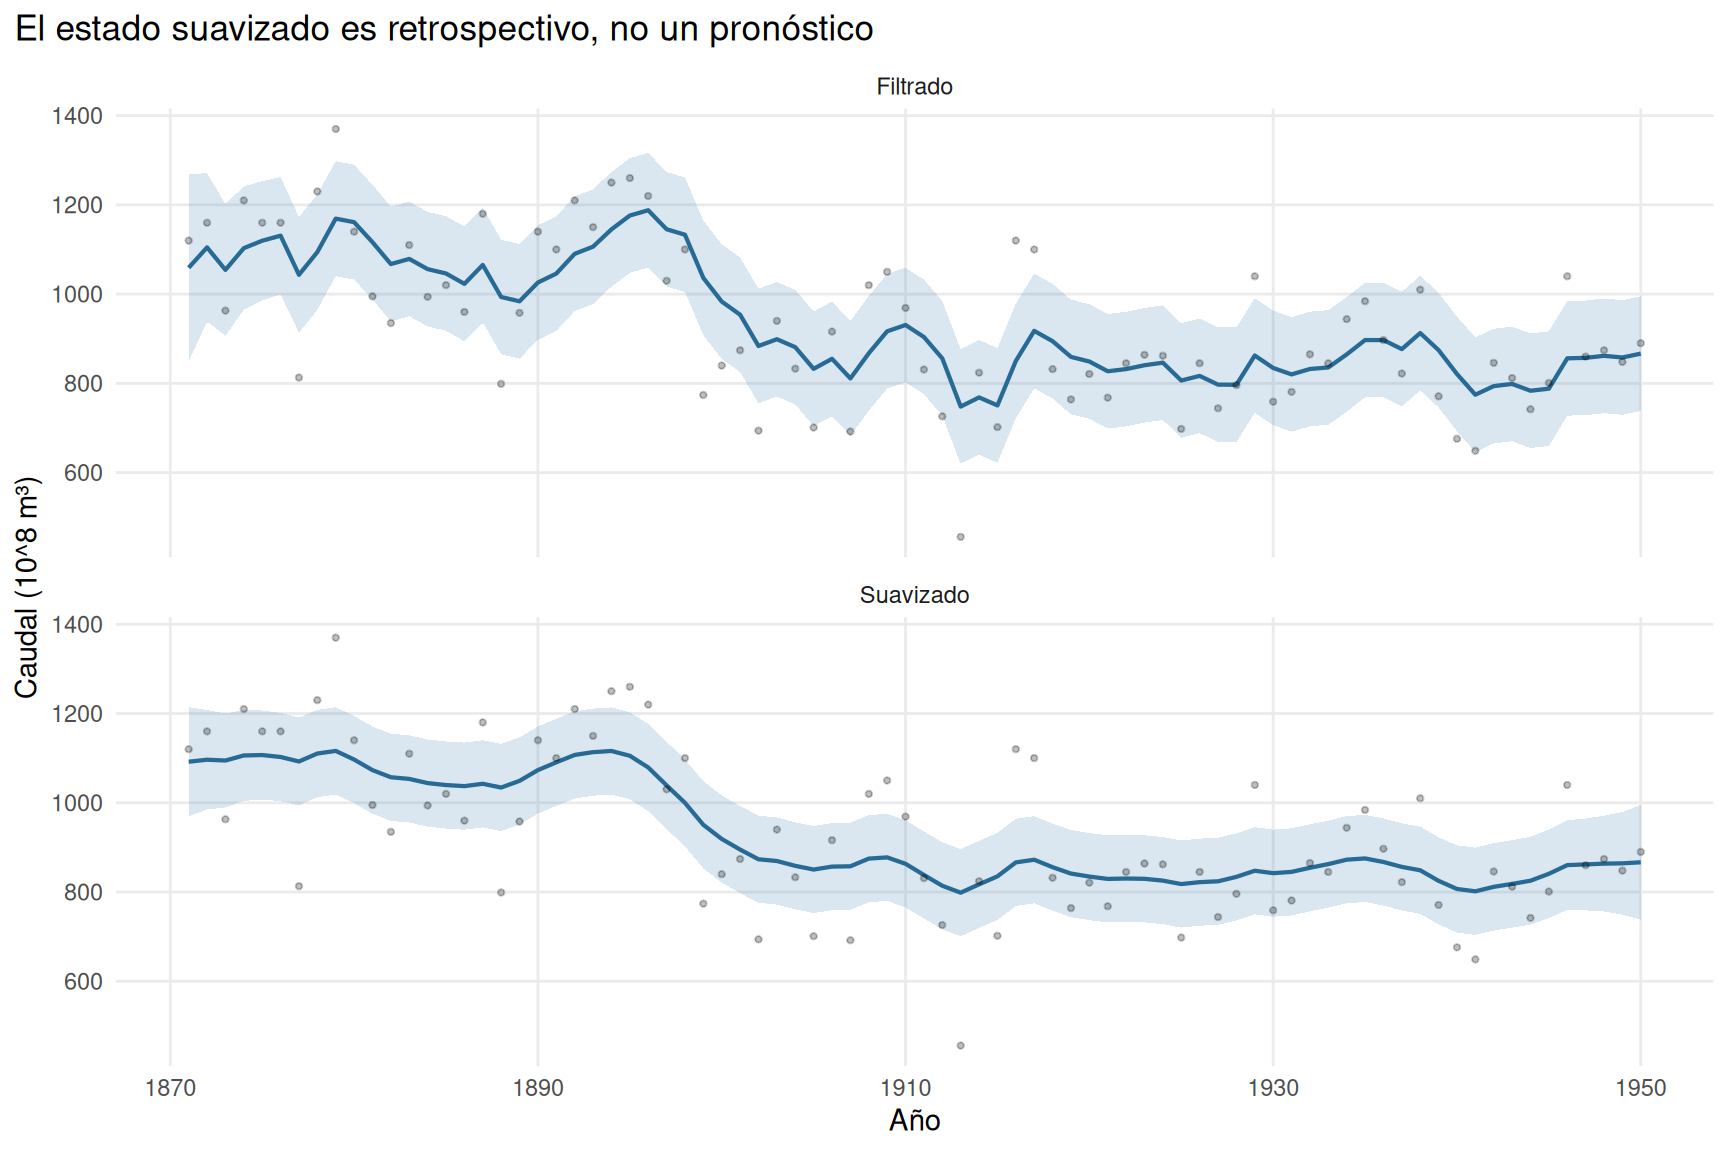
Una comparación sustantiva debe atender tanto a los cambios en las medias de estado como a los intervalos. El estado suavizado aprovecha toda la evidencia de 1871–1950 para revisar, por ejemplo, el nivel latente atribuido a 1900. El nivel filtrado en 1900 utiliza únicamente observaciones de 1871–1900. Esa diferencia temporal en la información condicionante es más importante que una aparente mayor suavidad visual.
knitr::kable(
  nilo_estados_kf12 |>
    filter(anio %in% c(1880L, 1900L, 1920L, 1940L, 1950L)),
  digits = 2
)| anio | observado | filtrado | suavizado | des_filtrado | des_suavizado |
|---|---|---|---|---|---|
| 1880 | 1140 | 1161.23 | 1096.83 | 65.61 | 49.85 |
| 1900 | 840 | 983.31 | 918.87 | 65.50 | 49.80 |
| 1920 | 821 | 848.97 | 834.68 | 65.50 | 49.80 |
| 1940 | 676 | 820.95 | 806.83 | 65.50 | 49.83 |
| 1950 | 890 | 866.63 | 866.63 | 65.50 | 65.50 |
12.10.5 Diagnóstico de innovaciones estandarizadas
El vector de innovaciones estandarizadas calculado antes de actualizar con \(y_t\) es
\[ z_t=\frac{y_t-f_t}{\sqrt{Q_t}}. \tag{12.48}\]
Bajo el modelo lineal gaussiano correcto y parámetros conocidos, las innovaciones estandarizadas son independientes y tienen distribución \(N(0,1)\). La independencia se justifica porque cada error de predicción es ortogonal al pasado y el vector total de innovaciones es gaussiano; en un vector gaussiano, la ausencia de correlación implica independencia. Cuando sustituimos los parámetros por estimaciones, estas propiedades son aproximadas y las pruebas residuales deben interpretarse con precaución.
Son útiles cuatro verificaciones: media residual próxima a cero, dispersión compatible con unidad, ausencia de autocorrelación relevante y ausencia de patrones pronunciados que contradigan la normalidad o la estabilidad de la varianza. Una prueba global como Ljung–Box no reemplaza la inspección de la serie ni detecta por sí sola todos los errores de especificación (Petris et al. 2009, sec. 2.9).
innov_kf12 <- tibble(
  anio = anios_nilo_kf12[1:n_train_kf12],
  z = fil_nivel_train_kf12$z,
  z2 = fil_nivel_train_kf12$z^2
)
stopifnot(!anyNA(innov_kf12), all(is.finite(innov_kf12$z)))

resumen_innov_kf12 <- tibble(
  media = mean(innov_kf12$z),
  desviacion_estandar = sd(innov_kf12$z),
  proporcion_abs_sup_2 = mean(abs(innov_kf12$z) > 2),
  lb_pvalor = stats::Box.test(
    innov_kf12$z, lag = 10, type = "Ljung-Box")$p.value
)knitr::kable(resumen_innov_kf12, digits = 4)| media | desviacion_estandar | proporcion_abs_sup_2 | lb_pvalor |
|---|---|---|---|
| -0.0541 | 1.0047 | 0.05 | 0.1449 |
El valor \(p\) mostrado corresponde al contraste Ljung–Box aplicado como diagnóstico exploratorio, sin una corrección universal por los parámetros estimados. No debe interpretarse mecánicamente como prueba exacta de que el modelo es verdadero. Una secuencia no correlacionada puede presentar dependencia no lineal o cambios de distribución.
ggplot(innov_kf12, aes(anio, z)) +
  geom_hline(yintercept = c(-2, 2), colour = "grey55",
             linetype = "dotted") +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_line(colour = "#236b95") +
  geom_point(size = .8, alpha = .6) +
  labs(x = "Año", y = "Innovación estandarizada",
       title = "¿Queda estructura sistemática en los errores predictivos?") +
  tema_kf12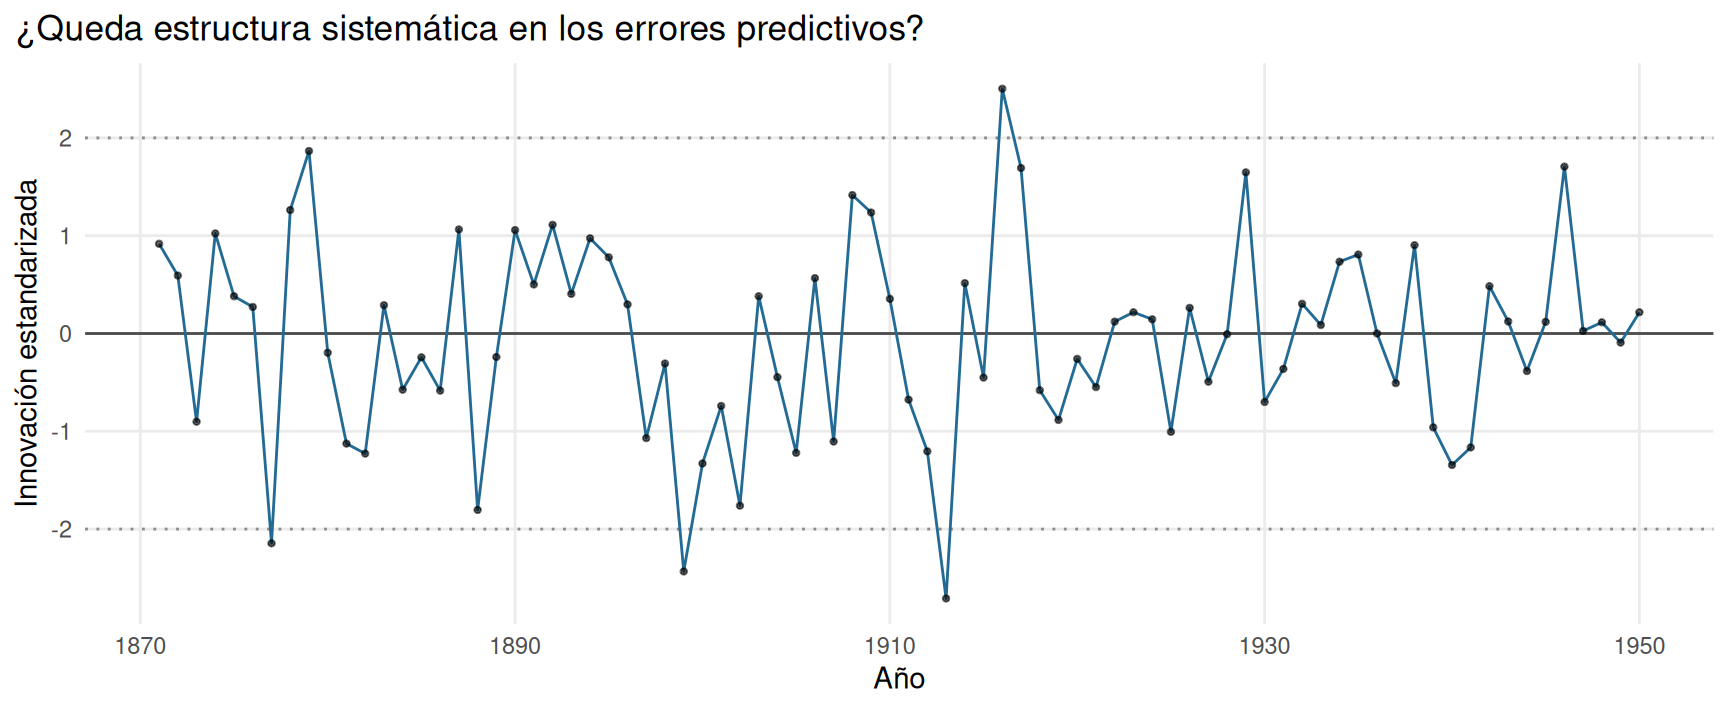
calcular_acf_kf12 <- function(x, nombre, max_lag = 16L) {
  acf_obj <- stats::acf(x, lag.max = max_lag, plot = FALSE)
  tibble(rezago = seq_len(max_lag),
         correlacion = as.numeric(acf_obj$acf)[-1L],
         tipo = nombre)
}
acf_innov_kf12 <- bind_rows(
  calcular_acf_kf12(innov_kf12$z, "Innovaciones"),
  calcular_acf_kf12(innov_kf12$z2, "Innovaciones al cuadrado")
)

ggplot(acf_innov_kf12, aes(rezago, correlacion)) +
  geom_hline(yintercept = c(-1, 1) *
               qnorm(.975) / sqrt(n_train_kf12),
             linetype = "dashed", colour = "grey50") +
  geom_segment(aes(xend = rezago, yend = 0), colour = "#2b6d98") +
  geom_point(size = 1, colour = "#2b6d98") +
  facet_wrap(~ tipo, ncol = 1) +
  scale_x_continuous(breaks = seq(0, 16, 2)) +
  labs(x = "Rezago", y = "ACF",
       title = "Dependencia lineal y dependencia en los cuadrados") +
  tema_kf12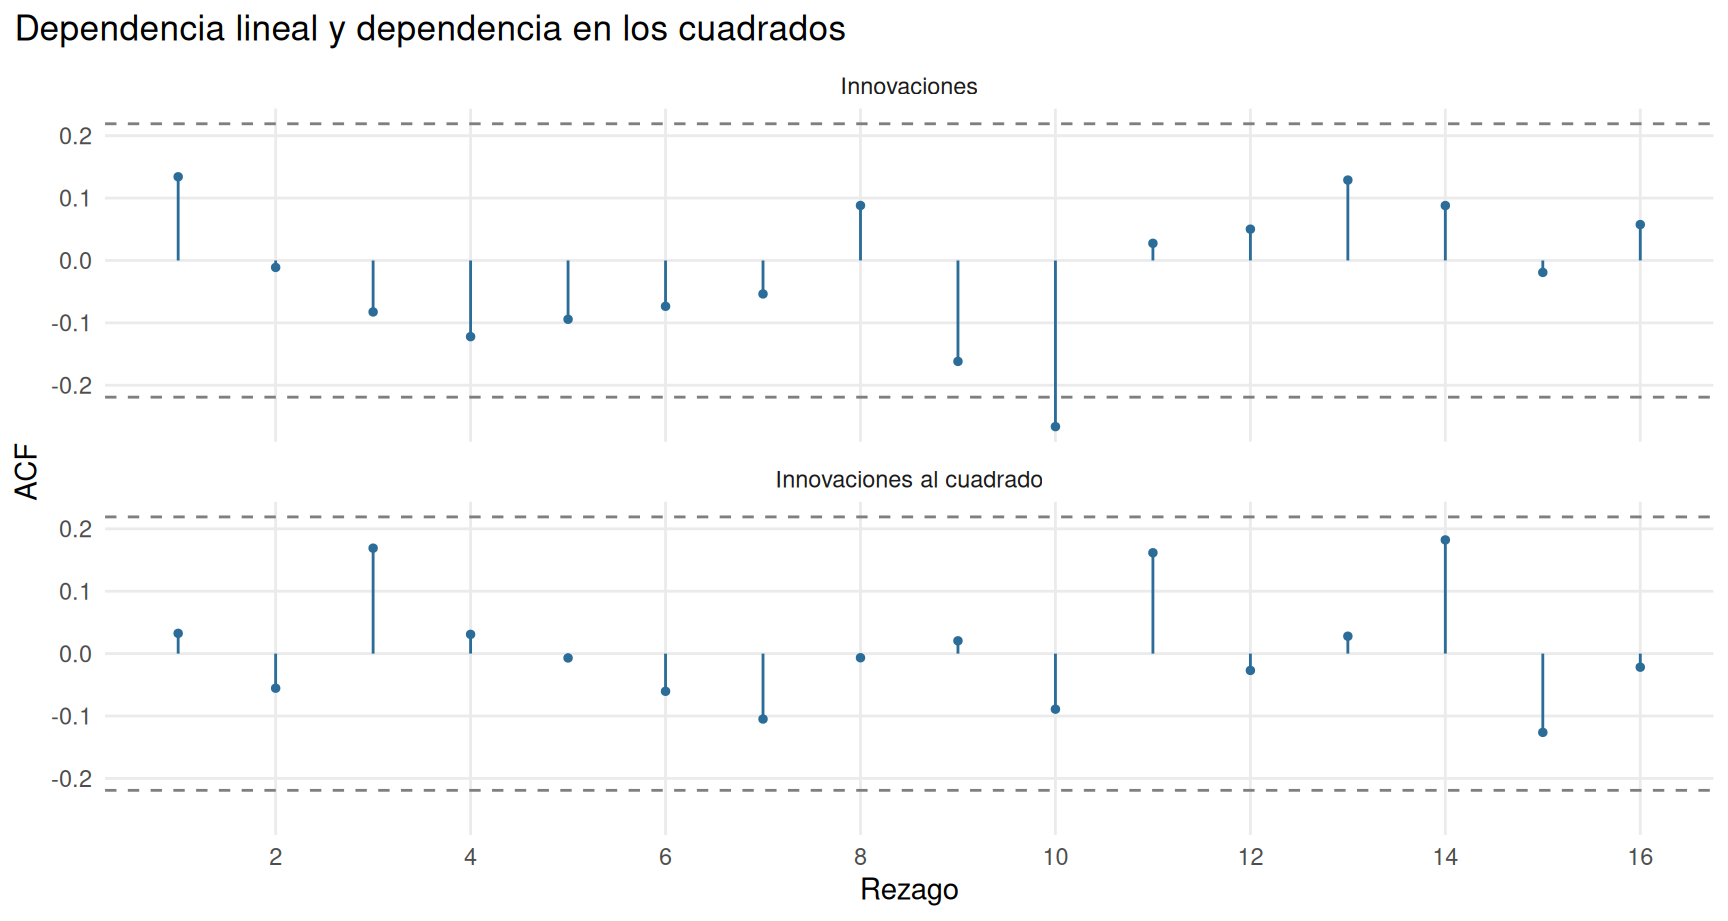
Las bandas \(\pm1.96/\sqrt n\) son referencias asintóticas simples; no son límites exactos simultáneos para todos los rezagos ni reemplazan un análisis de incertidumbre ajustado a la estimación del modelo.
12.11 Pronóstico con origen fijo: contraste visual explícito
Ajustaremos el filtro sobre 1871–1950 con las varianzas estimadas solo en entrenamiento. Después construiremos los pronósticos para los 20 años futuros sin actualizar con ningún dato posterior a 1950. El modelo naïve servirá como referencia: todos sus pronósticos puntuales desde un mismo origen son iguales a la última observación registrada.
pred_nivel_fijo_kf12 <- pronosticar_kalman(
  ajuste_nivel_kf12$filtro, h = 20L) |>
  mutate(anio = anios_nilo_kf12[n_train_kf12] + h,
         modelo = "Nivel local")

pred_tend_fijo_kf12 <- pronosticar_kalman(
  ajuste_tendencia_kf12$filtro, h = 20L) |>
  mutate(anio = anios_nilo_kf12[n_train_kf12] + h,
         modelo = "Tendencia local")

pred_naive_fijo_kf12 <- tibble(
  anio = anios_nilo_kf12[(n_train_kf12 + 1L):n_nilo_kf12],
  media = rep(y_train_kf12[n_train_kf12], n_nilo_kf12 - n_train_kf12),
  modelo = "Naïve"
)

pred_fijo_kf12 <- bind_rows(
  pred_nivel_fijo_kf12, pred_tend_fijo_kf12
)
stopifnot(
  nrow(pred_fijo_kf12) == 40L,
  all(pred_fijo_kf12$li95 < pred_fijo_kf12$ls95),
  !anyNA(pred_fijo_kf12)
)
ajuste_insample_kf12 <- tibble(
anio = anios_nilo_kf12[1:n_train_kf12],
media = fil_nivel_train_kf12$f
)
ggplot() +
annotate("rect", xmin = 1950.5, xmax = Inf,
ymin = -Inf, ymax = Inf,
fill = "grey70", alpha = .25) +
geom_ribbon(data = pred_nivel_fijo_kf12,
aes(anio, ymin = li95, ymax = ls95),
fill = "#347fac", alpha = .2) +
geom_line(data = nilo_kf12,
aes(anio, caudal, colour = "Observado"),
linewidth = .67) +
geom_line(data = ajuste_insample_kf12,
aes(anio, media, colour = "Predicción un paso (entrenamiento)"),
linewidth = .55, alpha = .88) +
geom_line(data = pred_nivel_fijo_kf12,
aes(anio, media, colour = "Pronóstico desde 1950"),
linewidth = 1, linetype = "dashed") +
geom_vline(xintercept = 1950.5, linetype = "dashed") +
scale_colour_manual(values = c(
"Observado" = "#222222",
"Predicción un paso (entrenamiento)" = "#5b9b80",
"Pronóstico desde 1950" = "#14689f")) +
coord_cartesian(xlim = c(1915, 1970)) +
labs(x = "Año", y = "Caudal (10^8 m³)",
colour = "Serie",
title = "Ajuste dentro de entrenamiento y prueba no son equivalentes",
subtitle = "Sombreado: 1951--1970; línea discontinua: pronóstico sin nuevos datos") +
tema_kf12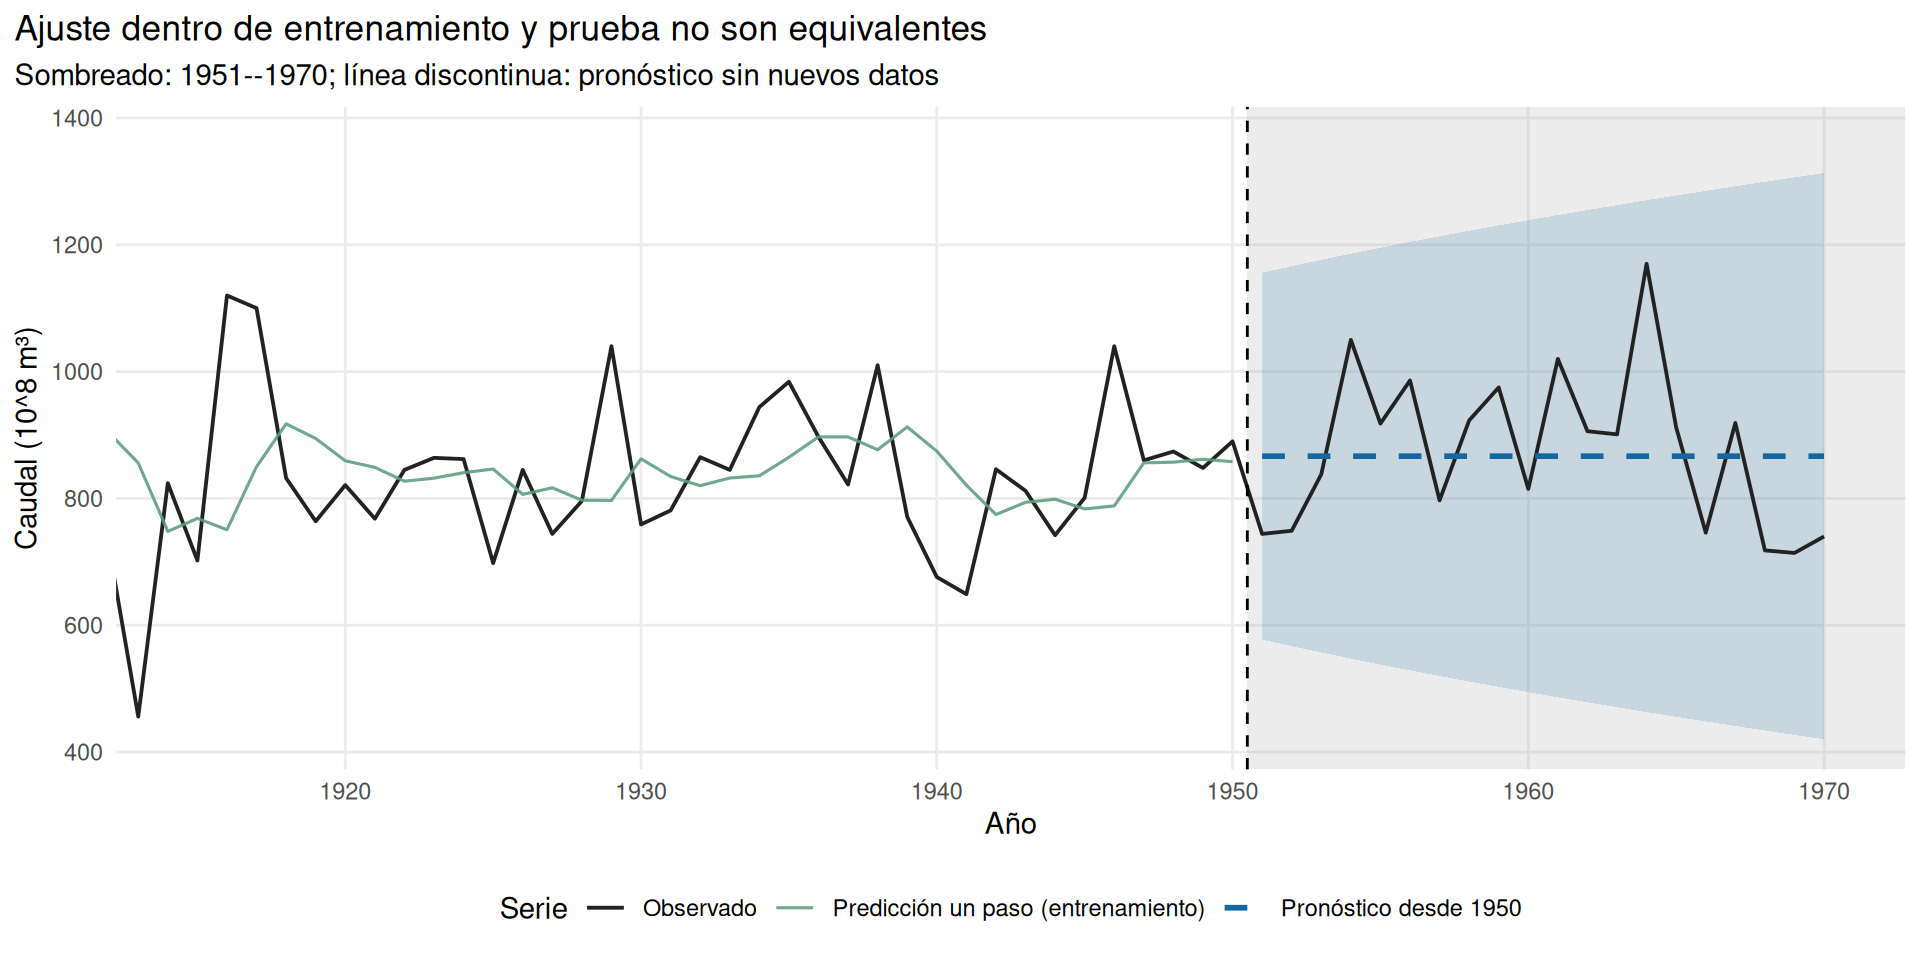
El tramo verde es la predicción de un paso \(f_t\), obtenida antes de actualizar con la observación de entrenamiento correspondiente. Es deliberadamente diferente del estado filtrado \(m_t\). La línea azul discontinua, en cambio, se calcula una sola vez desde 1950. En el modelo de nivel local es plana por Ecuación 12.39. Aunque se dibuje junto a los datos de prueba para valorar la precisión, no se ha recalculado después de observar cada año.
ggplot(pred_fijo_kf12, aes(anio, media)) +
  geom_ribbon(aes(ymin = li95, ymax = ls95),
              fill = "#4c85ae", alpha = .2) +
  geom_line(colour = "#17649b", linewidth = .8) +
  geom_point(data = nilo_kf12 |> filter(periodo == "Prueba"),
             aes(anio, caudal), inherit.aes = FALSE,
             size = 1.1, colour = "#222222") +
  facet_wrap(~ modelo, ncol = 1, scales = "fixed") +
  labs(x = "Año", y = "Caudal (10^8 m³)",
       title = "La incertidumbre de tendencia puede crecer con rapidez") +
  tema_kf12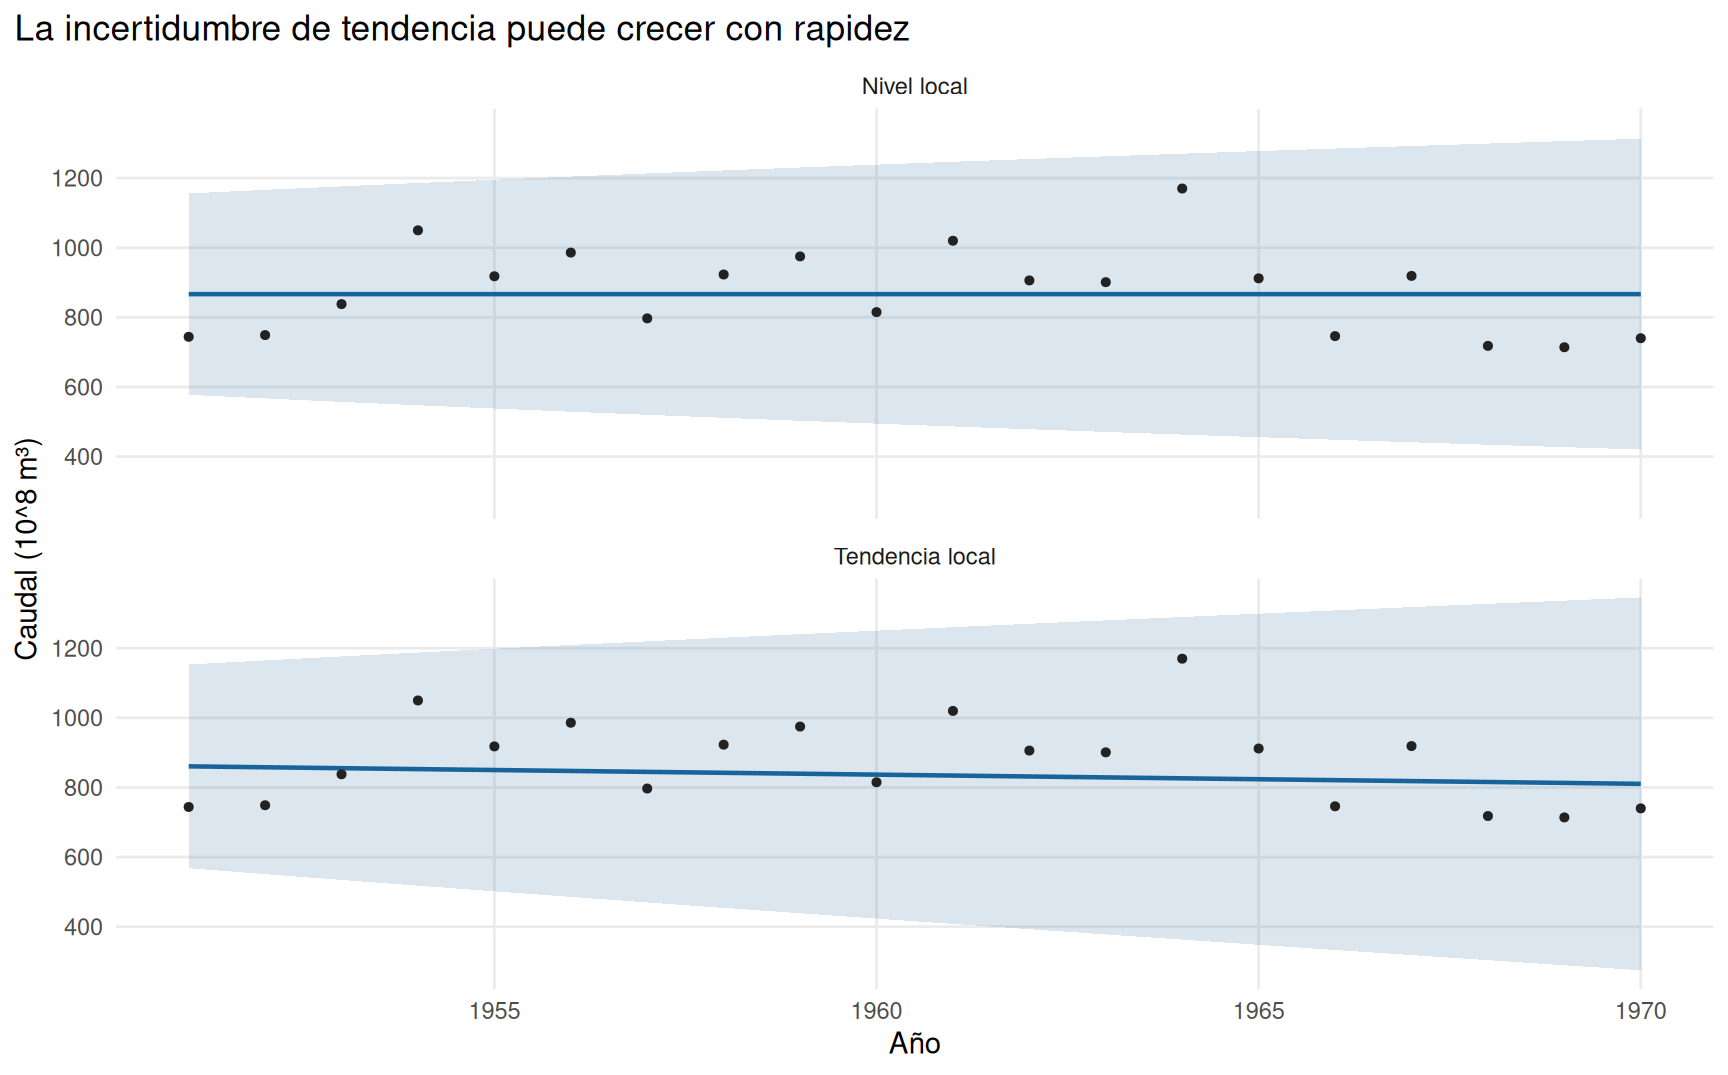
12.12 Validación con origen móvil y reestimación
Un solo origen no informa sobre el desempeño del procedimiento en distintos momentos. Para construir una comparación que respete el capítulo 7, evaluaremos los tres modelos en los mismos orígenes y horizontes, incluyendo el ajuste de varianzas dentro de cada entrenamiento expansivo. Usaremos
\[ \mathcal O=\{80,81,\ldots,95\}, \qquad \mathcal H=\{1,3,5\}. \tag{12.49}\]
Aquí el origen \(o=80\) corresponde a 1950 y \(o=95\) a 1965. Como \(o+h\le 100\) para todos los pares evaluados, existe una observación realizada para cada comparación. El conjunto contiene 16 orígenes para cada horizonte y candidato. Los tamaños por horizonte son iguales, pero los años objetivo difieren entre horizontes. Por tanto, las métricas deben presentarse por \(h\).
El protocolo es:
- Tomar \(y_{1:o}\) como entrenamiento de ese origen.
- Estimar por MV las varianzas de nivel y tendencia con esa muestra, sin utilizar \(y_{o+1},\ldots,y_{100}\).
- Filtrar hasta \(o\) y propagar la distribución sin actualizaciones hasta \(o+h\).
- Predecir con naïve desde \(y_o\); para su intervalo de referencia aproximar un modelo de caminata aleatoria gaussiana sin deriva con varianza \(s_o^2=(o-1)^{-1}\sum_{t=2}^{o}(y_t-y_{t-1})^2\), a partir de las \(o-1\) diferencias observadas.
- Guardar el error y las puntuaciones usando \(y_{o+h}\) solo al evaluar, no para ajustar.
La referencia probabilística naïve es una aproximación bajo caminata aleatoria gaussiana, no un intervalo libre de supuestos. Para MASE, la escala \(d_o=(o-1)^{-1}\sum_{t=2}^o|y_t-y_{t-1}|\) se calcula con datos del origen, y es común a todos los modelos comparados en ese origen. El uso de un mismo conjunto de orígenes evita comparar un candidato en fechas más fáciles que otro.
12.12.1 Construcción reproducible de las predicciones
El siguiente bloque reestima ambos modelos para cada origen.
origenes_kf12 <- 80:95
horizontes_kf12 <- c(1L, 3L, 5L)

pronosticar_naive_kf12 <- function(y, h) {
  n <- length(y)
  # Varianza ML de incrementos iid N(0,sigma^2) sin deriva.
  v_incr <- mean(diff(y)^2)
  varianzas <- h * v_incr
  medias <- rep(tail(y, 1), length(h))
  tibble(
    h = h, media = medias, varianza = varianzas,
    li80 = medias - qnorm(.90) * sqrt(varianzas),
    ls80 = medias + qnorm(.90) * sqrt(varianzas),
    li95 = medias - qnorm(.975) * sqrt(varianzas),
    ls95 = medias + qnorm(.975) * sqrt(varianzas)
  )
}

evaluar_origen_kf12 <- function(o) {
  train <- serie_nilo_kf12[seq_len(o)]
  escala_mase <- mean(abs(diff(train)))
  stopifnot(is.finite(escala_mase), escala_mase > 0)
  hmax <- max(horizontes_kf12)

  ajuste_nivel <- ajustar_mv(train, "nivel")
  ajuste_tendencia <- ajustar_mv(train, "tendencia")

  pred_nivel <- pronosticar_kalman(ajuste_nivel$filtro, hmax) |>
    mutate(modelo = "Nivel local")
  pred_tendencia <- pronosticar_kalman(ajuste_tendencia$filtro, hmax) |>
    mutate(modelo = "Tendencia local")
  pred_naive <- pronosticar_naive_kf12(train, seq_len(hmax)) |>
    mutate(modelo = "Naïve")

  bind_rows(pred_naive, pred_nivel, pred_tendencia) |>
    filter(h %in% horizontes_kf12) |>
    mutate(
      origen = o,
      anio_origen = anios_nilo_kf12[o],
      anio_objetivo = anios_nilo_kf12[o + h],
      observado = serie_nilo_kf12[o + h],
      escala_mase = escala_mase,
      error = observado - media,
      error_abs_escalado = abs(error) / escala_mase,
      cubre80 = observado >= li80 & observado <= ls80,
      cubre95 = observado >= li95 & observado <= ls95,
      amplitud80 = ls80 - li80,
      amplitud95 = ls95 - li95,
      winkler95 = puntuacion_intervalo(observado, li95, ls95),
      crps = crps_normal(observado, media, sqrt(varianza))
    )
}

cv_nilo_kf12 <- purrr::map_dfr(origenes_kf12, evaluar_origen_kf12)
stopifnot(
  nrow(cv_nilo_kf12) == length(origenes_kf12) *
    length(horizontes_kf12) * 3L,
  all(is.finite(cv_nilo_kf12$error)),
  all(is.finite(cv_nilo_kf12$crps)),
  !anyNA(cv_nilo_kf12),
  all(cv_nilo_kf12$varianza > 0)
)
12.12.2 Evaluación puntual
Definimos, para un horizonte fijo y \(M\) orígenes, el error \(u_{o,h}=y_{o+h}-\widehat y_{o+h\mid o}\) y
\[ \mathrm{MAE}_h=\frac1M\sum_o|u_{o,h}|, \qquad \mathrm{RMSE}_h=\sqrt{\frac1M\sum_o u_{o,h}^2}, \tag{12.50}\]
\[ \mathrm{MASE}_h=\frac1M\sum_o\frac{|u_{o,h}|}{d_o}, \quad d_o=\frac{1}{o-1}\sum_{t=2}^{o}|y_t-y_{t-1}|. \tag{12.51}\]
En este diseño, MASE promedia errores escalados con un denominador específico de cada origen, siempre estimado sin datos futuros. Ello difiere de usar un denominador global calculado con toda la serie y evita esa fuga de información.
tabla_cv_puntual_kf12 <- cv_nilo_kf12 |>
  group_by(h, modelo) |>
  summarise(
    n_origenes = n(),
    MAE = mean(abs(error)),
    RMSE = sqrt(mean(error^2)),
    MASE = mean(error_abs_escalado),
    .groups = "drop"
  ) |>
  arrange(h, modelo)
knitr::kable(tabla_cv_puntual_kf12, digits = 3)| h | modelo | n_origenes | MAE | RMSE | MASE |
|---|---|---|---|---|---|
| 1 | Naïve | 16 | 137.250 | 157.655 | 1.035 |
| 1 | Nivel local | 16 | 102.707 | 125.923 | 0.774 |
| 1 | Tendencia local | 16 | 105.360 | 128.874 | 0.794 |
| 3 | Naïve | 16 | 123.125 | 154.120 | 0.925 |
| 3 | Nivel local | 16 | 101.868 | 130.085 | 0.766 |
| 3 | Tendencia local | 16 | 105.001 | 134.921 | 0.789 |
| 5 | Naïve | 16 | 133.500 | 175.414 | 1.004 |
| 5 | Nivel local | 16 | 110.178 | 140.529 | 0.829 |
| 5 | Tendencia local | 16 | 117.506 | 144.567 | 0.884 |
ggplot(tabla_cv_puntual_kf12,
       aes(h, RMSE, colour = modelo, group = modelo)) +
  geom_line(linewidth = .8) +
  geom_point(size = 2) +
  scale_x_continuous(breaks = horizontes_kf12) +
  labs(x = "Horizonte (años)", y = "RMSE",
       colour = "Modelo", title = "El desempeño depende del horizonte") +
  tema_kf12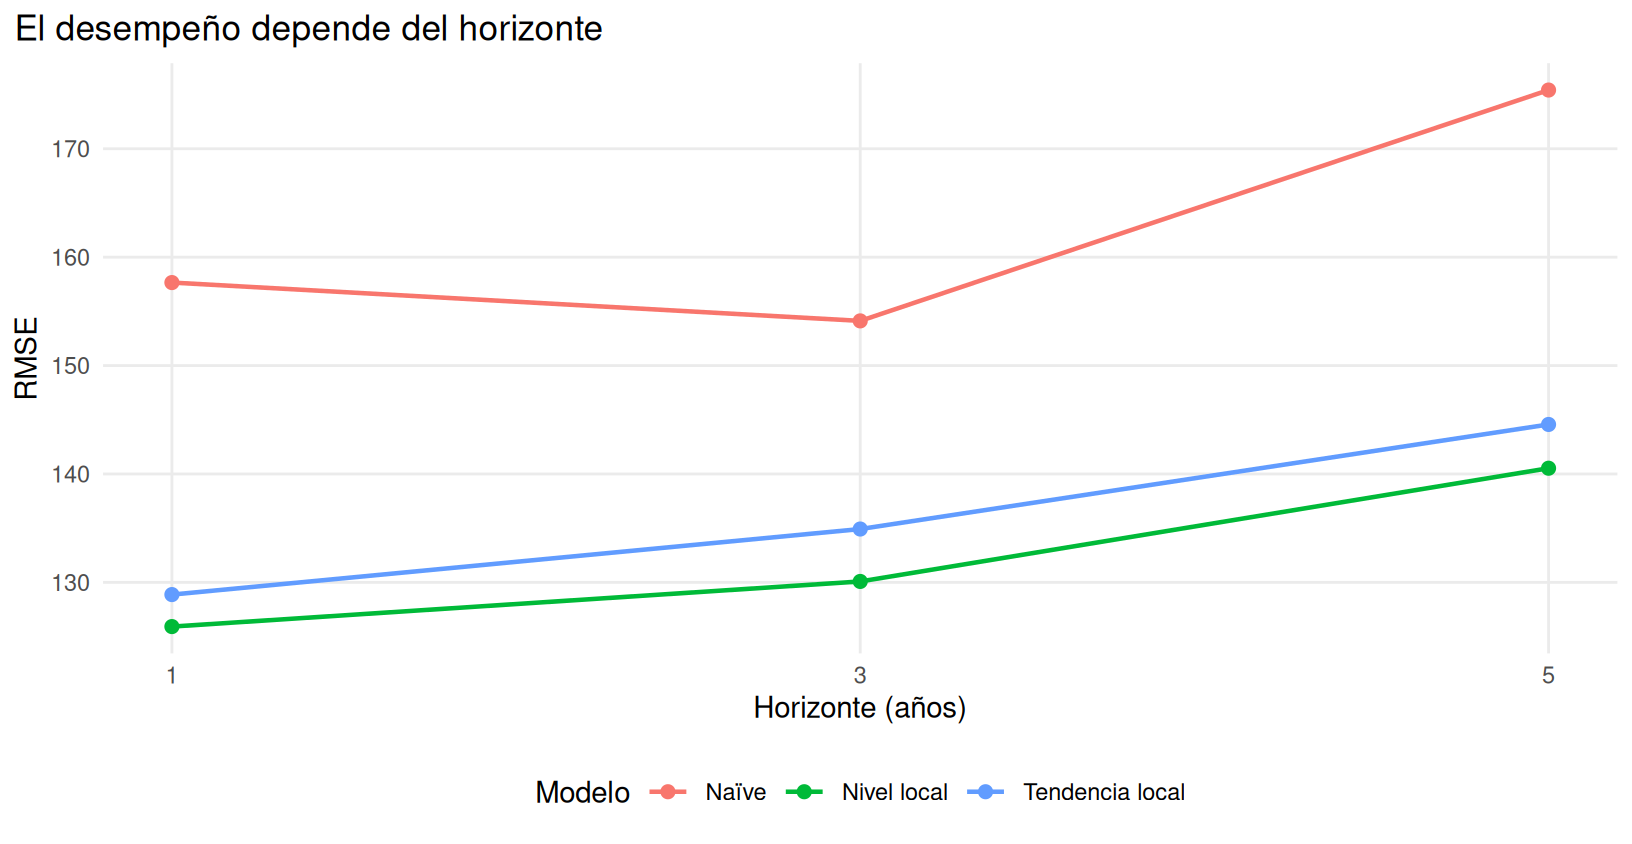
Estas métricas responden a una pregunta predictiva y una pérdida determinadas. No necesariamente tendrán el mismo ordenamiento: RMSE penaliza con más fuerza errores grandes, MAE refleja la magnitud absoluta típica y MASE ofrece una escala relativa basada en la variabilidad histórica de diferencias en cada origen.
12.12.3 Cobertura, amplitud y puntuaciones probabilísticas
Para un intervalo predictivo \([L_{o,h},U_{o,h}]\) de nivel nominal \(1-\alpha\), calculamos cobertura y amplitud mediante
\[ \widehat{\mathrm{Cobertura}}_{h} =\frac1M\sum_o\mathbf1\{L_{o,h}\le y_{o+h}\le U_{o,h}\}, \qquad \overline A_h=\frac1M\sum_o(U_{o,h}-L_{o,h}). \tag{12.52}\]
La cobertura sola no premia adecuadamente la precisión: intervalos excesivamente anchos pueden cubrir casi todo. Por eso incluimos la puntuación de intervalo (Winkler),
\[ \mathrm{IS}_{\alpha}(L,U;y) =(U-L)+\frac{2}{\alpha}(L-y)\mathbf1(y<L) +\frac{2}{\alpha}(y-U)\mathbf1(y>U). \tag{12.53}\]
Para la evaluación completa de la distribución normal predictiva utilizamos el CRPS, que en términos de \(z=(y-\mu)/\sigma\) admite la fórmula
\[ \mathrm{CRPS}\{N(\mu,\sigma^2),y\} =\sigma\left[z\{2\Phi(z)-1\}+2\varphi(z)-\frac1{\sqrt\pi}\right], \tag{12.54}\]
siendo \(\Phi\) y \(\varphi\) la función de distribución y la densidad de una normal estándar. En las dos puntuaciones, menores valores son mejores. Estas herramientas fueron introducidas en Sección 7.11 y empleadas también en Sección 8.20.
tabla_cv_prob_kf12 <- cv_nilo_kf12 |>
  group_by(h, modelo) |>
  summarise(
    cobertura80 = mean(cubre80),
    amplitud80 = mean(amplitud80),
    cobertura95 = mean(cubre95),
    amplitud95 = mean(amplitud95),
    Winkler95 = mean(winkler95),
    CRPS = mean(crps),
    .groups = "drop"
  ) |>
  arrange(h, modelo)
knitr::kable(tabla_cv_prob_kf12, digits = 3)| h | modelo | cobertura80 | amplitud80 | cobertura95 | amplitud95 | Winkler95 | CRPS |
|---|---|---|---|---|---|---|---|
| 1 | Naïve | 0.875 | 431.178 | 1 | 659.431 | 659.431 | 91.976 |
| 1 | Nivel local | 0.812 | 371.612 | 1 | 568.332 | 568.332 | 71.998 |
| 1 | Tendencia local | 0.812 | 375.703 | 1 | 574.588 | 574.588 | 73.587 |
| 3 | Naïve | 1.000 | 746.823 | 1 | 1142.167 | 1142.167 | 98.928 |
| 3 | Nivel local | 0.812 | 394.747 | 1 | 603.713 | 603.713 | 74.567 |
| 3 | Tendencia local | 0.812 | 408.381 | 1 | 624.565 | 624.565 | 77.402 |
| 5 | Naïve | 1.000 | 964.144 | 1 | 1474.532 | 1474.532 | 118.648 |
| 5 | Nivel local | 0.812 | 416.594 | 1 | 637.125 | 637.125 | 80.810 |
| 5 | Tendencia local | 0.812 | 439.987 | 1 | 672.902 | 672.902 | 83.484 |
ggplot(tabla_cv_prob_kf12,
       aes(amplitud95, cobertura95, colour = modelo)) +
  geom_hline(yintercept = .95, linetype = "dashed", colour = "grey50") +
  geom_point(size = 2.6) +
  facet_wrap(~ h, labeller = label_both) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%"),
                     limits = c(0, 1)) +
  labs(x = "Amplitud media del intervalo del 95 %",
       y = "Cobertura observada", colour = "Modelo",
       title = "La calibración se evalúa junto con la precisión") +
  tema_kf12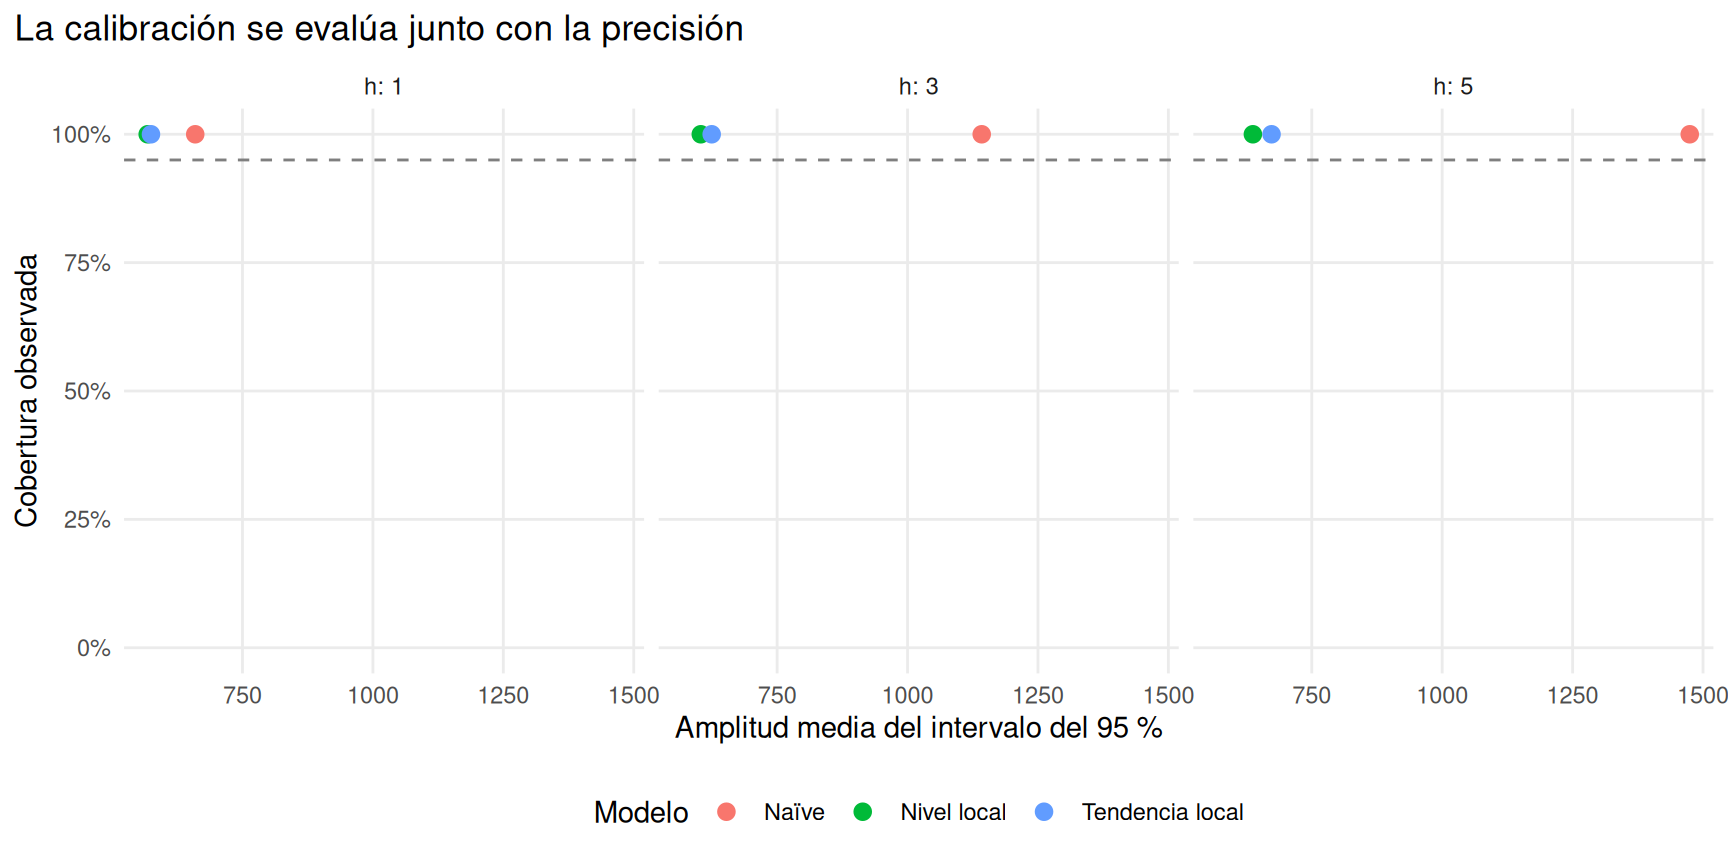
Con solo 16 observaciones evaluadas por horizonte, las coberturas empíricas son muy discretas (saltos de 6.25 puntos porcentuales) y contienen considerable incertidumbre muestral. Además, los errores de orígenes móviles pueden estar correlacionados por el traslape de períodos. No interpretaríamos una diferencia pequeña como evidencia definitiva de superioridad de un modelo sin una evaluación más amplia. La elección final de modelos debería considerar estabilidad de resultados, fines sustantivos y posibles cambios estructurales, no únicamente el mínimo de una tabla.
12.12.4 Qué significa una comparación frecuentista con parámetros estimados
La estimación por máxima verosimilitud utiliza una distribución predictiva condicional al estimador \(\widehat{\boldsymbol\psi}_o\) en cada origen. Por su parte, la inferencia bayesiana completa produciría
\[ p(y_{o+h}\mid y_{1:o}) =\int p(y_{o+h}\mid y_{1:o},\boldsymbol\psi) \,p(\boldsymbol\psi\mid y_{1:o})\,d\boldsymbol\psi. \tag{12.55}\]
Cuando los estados son gaussianos condicionalmente a \(\boldsymbol\psi\), la primera densidad de la integral se obtiene con el mismo filtro y las mismas recursiones predictivas. La diferencia es que el segundo enfoque integra sobre incertidumbre paramétrica. En la semana 13 estudiaremos prioris para varianzas y estados, distribuciones posteriores y procedimientos de simulación de trayectorias latentes.
12.13 Relación con ARIMA y ETS
El modelo de nivel local induce una estructura integrada para la serie observada. Restando \(Y_{t-1}\) de \(Y_t\) en Ecuación 12.17,
\[ \Delta Y_t=w_t+v_t-v_{t-1}. \tag{12.56}\]
Su función de autocovarianza tiene
\[ \gamma_{\Delta Y}(0)=W+2V,\quad \gamma_{\Delta Y}(1)=-V,\quad \gamma_{\Delta Y}(h)=0\ \ (|h|\ge2). \tag{12.57}\]
La correspondencia con ARIMA\((0,1,1)\) ya se dedujo en Sección 11.12.1. Si \(V,W>0\) y se utiliza la convención de MA(1) con signo \(+\), el coeficiente invertible es negativo; la equivalencia es entre distribuciones observacionales, no entre interpretaciones físicas de un único estado latente.
Asimismo, para el nivel local \(m_t=m_{t-1}+K_te_t\) se parece a la forma de corrección por innovaciones del suavizamiento exponencial simple. Con varianzas constantes, la ganancia tiende en condiciones habituales a un valor \(K_\infty\), dando lugar a una regla de actualización de peso aproximadamente constante. Esta conexión se trabajó en Sección 11.12.2 y Sección 8.11. No conviene concluir que el suavizador RTS, SES y el estado filtrado sean una misma operación: RTS revisa el pasado con datos futuros, mientras SES y Kalman en línea actualizan estados a medida que llegan los datos.
12.14 Interpretación estadística y limitaciones
12.14.1 Parámetros estructurales e identificabilidad
La identificación de \(V\) y \(W\) se apoya en características diferentes de la serie: ruido de observación de alta frecuencia y variaciones persistentes del nivel. En muestras cortas, esas fuentes pueden ser difíciles de separar. La curvatura de la verosimilitud, la sensibilidad a la inicialización y los posibles máximos próximos a cero son tan importantes como el valor de los estimadores. No debe identificarse automáticamente una variación del estado con un cambio causal del sistema físico o económico.
12.14.2 Ajuste, suavizamiento y pronóstico tienen objetivos distintos
Un estado suavizado puede ser útil para reconstruir retrospectivamente un fenómeno, pero su proximidad a los datos observados no valida por sí sola la distribución predictiva futura. Un modelo flexible puede seguir bien los cambios históricos y pronosticar mal si extrapola pendientes poco estables. A la inversa, un modelo sencillo puede perder detalle estructural pero ofrecer pronósticos competitivos.
12.14.3 Observaciones atípicas y rupturas
El caudal del Nilo se utiliza tradicionalmente para estudiar cambios de nivel. Un modelo gaussiano de parámetros constantes puede responder lentamente ante una ruptura, confundir temporalmente observaciones extremas con modificaciones del estado o producir innovaciones sistemáticas. La inspección gráfica y residual es indispensable para decidir si una extensión, una intervención o un modelo con cambios estructurales estaría justificado.
12.14.4 Estado latente no es parámetro estático
La incertidumbre de \(\boldsymbol x_t\) está incluida en las covarianzas filtradas y suavizadas condicionales a \(\boldsymbol\psi\). La incertidumbre de \(\boldsymbol\psi\), en cambio, no desaparece por el hecho de emplear un filtro. Tampoco los intervalos condicionados a \(\widehat{\boldsymbol\psi}\) deben describirse como intervalos posteriores bayesianos completos.
12.15 Actividad computacional guiada
Se propone un laboratorio de aproximadamente 90 minutos, seguido de discusión. Las partes A–C consolidan la teoría, y D–E conectan con la aplicación real.
- Filtrado y verosimilitud. Emplee la serie simulada en Sección 12.6.3. Ejecute el filtro para dos pares \((V,W)\) distintos. Calcule a mano los tres primeros factores de Ecuación 12.8 y verifique que su suma logarítmica coincide con el resultado de
logver_kalman()restringido a esos instantes. Explique el papel de \(Q_t\). - Suavizamiento. Revise
suavizar_rts()y compruebe \(\boldsymbol s_T=\boldsymbol m_T\). Seleccione un instante intermedio, calcule \(J_t\) a partir de las covarianzas guardadas y reproduzca manualmente una actualización retrospectiva. - Ausencias. Elimine artificialmente diez observaciones consecutivas sin alterar sus valores verdaderos guardados aparte. Compare incertidumbre filtrada, incertidumbre suavizada y predicciones durante y después del bloque. Explique por qué sustituir los faltantes por cero no representa el mismo procedimiento.
- Estimación. Cambie las condiciones iniciales del nivel local dentro de opciones justificables y compare estimaciones y log-verosimilitudes. Discuta qué cambios responden a modificaciones del modelo y cuáles reflejan dificultades numéricas.
- Predicción y evaluación. Reproduzca las tablas puntuales y probabilísticas del Nilo. Proponga una modificación del conjunto de horizontes sin utilizar observaciones futuras para estimar parámetros, y explique qué afirmaciones siguen siendo comparables.
Como actividad complementaria, el estudiantado puede adaptar filtrar_kalman() para admitir \(\boldsymbol F_t\) y \(\boldsymbol G_t\) variables y comprobar que los resultados concuerdan con el caso constante cuando todas las matrices temporales se fijan iguales.
12.16 Síntesis
En un modelo lineal gaussiano, las innovaciones proporcionan una representación predictiva completa de la densidad observada. La factorización temporal conduce directamente a una log-verosimilitud que se puede optimizar sin formar matrices de covarianzas de dimensión \(T\times T\). Después de filtrar, el algoritmo RTS permite revisar retrospectivamente los estados utilizando toda la muestra. Para pronosticar, se propagan la media y la covarianza desde el origen sin incorporar observaciones futuras.
Cuatro distinciones resumen la unidad:
- Predicción versus filtrado: la primera se calcula antes de \(y_t\); el segundo, después de observarlo.
- Filtrado versus suavizamiento: el segundo utiliza información posterior a \(t\) para reconstruir el estado de \(t\).
- Estimar versus integrar parámetros: sustituir por MV las varianzas es distinto de promediar sobre su posterior.
- Ajuste versus evaluación externa: los estados y los pronósticos dentro de la muestra no sustituyen un experimento temporal honesto.
En la semana 13 retomaremos estas recursiones como parte de la inferencia bayesiana de modelos lineales dinámicos, incluyendo distribuciones a priori, incertidumbre en varianzas y simulación de estados por forward filtering–backward sampling (FFBS).
12.17 Ejercicios
Ejercicio 12.1 (factorización). Partiendo de la regla de la cadena, derive Ecuación 12.8. Obtenga Ecuación 12.10 en el caso escalar. Explique por qué minimizar solamente \(\sum_te_t^2\) no equivale, en general, a maximizar la verosimilitud si \(Q_t\) depende de parámetros desconocidos.
Ejercicio 12.2 (primeras innovaciones). Para un nivel local con \(m_0=10\), \(C_0=4\), \(V=9\), \(W=1\) y observaciones \((y_1,y_2,y_3)=(12,8,11)\), calcule \(a_t,R_t,f_t,Q_t,e_t,K_t,m_t,C_t\) para \(t=1,2,3\). Use sus resultados para evaluar la log-verosimilitud de la muestra. Verifique numéricamente el resultado con el filtro proporcionado.
Ejercicio 12.3 (curvatura). Explique la transformación logarítmica Ecuación 12.19 y derive la matriz jacobiana requerida para utilizar el método delta. Discuta cómo cambia la interpretación de un error estándar al pasar de \(\eta_W=\log W\) a \(W\).
Ejercicio 12.4 (RTS). A partir de la matriz de covarianzas por bloques de Ecuación 12.23, derive la ganancia Ecuación 12.26. Utilice las leyes de esperanza y varianza total para demostrar Ecuación 12.29. Explique por qué no es posible reemplazar \(\boldsymbol J_t\) por la ganancia de Kalman \(\boldsymbol K_t\).
Ejercicio 12.5 (información futura). Considere un nivel local con tres observaciones y parámetros conocidos. Compare formalmente \(p(x_1\mid y_1)\) y \(p(x_1\mid y_1,y_2,y_3)\). ¿Cuál de las distribuciones puede utilizarse para reproducir una decisión emitida después de observar solamente \(y_1\)? Justifique.
Ejercicio 12.6 (tendencia). Demuestre Ecuación 12.42 por inducción. Partiendo de Ecuación 12.38, derive Ecuación 12.44. Analice los términos dominantes de la varianza predictiva cuando \(h\) crece y \(W_\beta>0\).
Ejercicio 12.7 (datos ausentes). Demuestre Ecuación 12.45. Para un modelo de nivel local con un bloque de \(k\) valores faltantes, encuentre la distribución predictiva del estado al finalizar dicho bloque. Discuta cómo cambiaría la inferencia si la ausencia de datos dependiera del valor no observado.
Ejercicio 12.8 (simulación). Simule 300 réplicas independientes de un nivel local de longitud \(T=100\), con semillas 412 + i para la réplica \(i\). Calcule, en \(t=30\), el error cuadrático medio de las estimaciones filtradas y suavizadas del estado, usando los parámetros verdaderos. Contraste el promedio de esos errores con las covarianzas condicionales correspondientes; explique por qué la comparación debe hacerse en promedio, no realización por realización.
Ejercicio 12.9 (identificación). Ajuste un nivel local a una simulación con \(W/V\) muy pequeño. Compare las estimaciones obtenidas con al menos dos configuraciones de estado inicial propio y examine el perfil de verosimilitud. Explique cuándo se hace difícil separar ruido de observación y evolución del nivel.
Ejercicio 12.10 (Nilo: inferencia). Ajuste los dos modelos estructurales con la muestra 1871–1950. Compare el parámetro de pendiente y su influencia sobre las varianzas predictivas a \(h=1,5,10\). Discuta los límites de utilizar una tendencia estocástica para pronósticos lejanos.
Ejercicio 12.11 (comparación temporal). Modifique el experimento de Sección 12.12 para emplear horizontes \(h=1,2,4\). Conserve los mismos orígenes para todos los métodos y horizontes. Obtenga MAE, RMSE, MASE, cobertura, amplitud y CRPS. Justifique los denominadores elegidos para la evaluación escalada y explique las limitaciones de una comparación con pocos orígenes.
Ejercicio 12.12 (Bayes y frecuentismo). Escriba una priori propia para \((V,W)\) que respete positividad, especifique la posterior conjunta de parámetros y estados y describa, sin implementar aún MCMC, cómo se calcularía la distribución predictiva que integra incertidumbre paramétrica. Identifique qué componentes del filtro de Kalman se reutilizarían.
12.18 Lecturas recomendadas
- Shumway y Stoffer (Shumway y Stoffer 2025, secs. 6.1–6.5): formulación gaussiana, filtrado, suavizamiento, pronóstico, máxima verosimilitud y datos faltantes. La sección 6.3 también presenta el algoritmo EM, que aquí dejamos como ampliación opcional.
- Petris, Petrone y Campagnoli (Petris et al. 2009, secs. 2.7–2.9, 3.2.1, 4.1): recursiones de estado, suavizamiento, pronóstico, innovaciones, modelos de nivel/tendencia y estimación de parámetros mediante MV. Es la referencia computacional principal para
dlm. - Prado, Ferreira y West (Prado et al. 2021, secs. 4.3.1, 4.3.3–4.3.5): actualización secuencial, observaciones faltantes, pronóstico y suavizamiento desde una formulación de DLM. En la próxima semana se retomarán los apartados 4.3.2, 4.3.6–4.3.8 y 4.5.
- Hyndman y Athanasopoulos (Hyndman y Athanasopoulos 2021, secs. 5.8–5.10): medidas puntuales y probabilísticas y validación temporal. La aplicación al Nilo conserva el diseño introducido en el capítulo 7 de estas notas.
Las referencias bibliográficas utilizan las claves disponibles en el archivo común references.bib. Los ejemplos simulados, las funciones R y los ejercicios se elaboraron específicamente para este capítulo.