precios <- as.numeric(datasets::EuStockMarkets[, "DAX"])
stopifnot(length(precios) > 1000L, all(is.finite(precios)), all(precios > 0))

precios_dax <- tibble(observacion = seq_along(precios), precio = precios)
retornos_dax <- tibble(
  observacion = seq.int(2L, length(precios)),
  retorno = 100 * diff(log(precios))
)

stopifnot(
  nrow(retornos_dax) == length(precios) - 1L,
  !anyNA(retornos_dax),
  all(is.finite(retornos_dax$retorno))
)

n_dax <- nrow(retornos_dax)
n_entrenamiento <- floor(0.80 * n_dax)
retornos_dax <- retornos_dax |>
  mutate(periodo = if_else(row_number() <= n_entrenamiento,
                          "Entrenamiento", "Prueba"))

resumen_dax <- retornos_dax |>
  summarise(
    observaciones = n(),
    media = mean(retorno),
    desviacion = sd(retorno),
    minimo = min(retorno),
    maximo = max(retorno)
)10 Modelos ARCH, GARCH y pronóstico de volatilidad
CA-0415 Series de Tiempo — Semana 10
10.1 Objetivos de aprendizaje
Al finalizar este capítulo, se espera que el estudiantado pueda:
- identificar agrupamiento de volatilidad, colas pesadas y dependencia temporal de los retornos al cuadrado;
- distinguir una innovación independiente de una innovación meramente incorrelacionada, y una varianza condicional de una incondicional;
- formular los modelos ARCH\((q)\) y GARCH\((p,q)\), con especial énfasis en ARCH\((1)\) y GARCH\((1,1)\);
- justificar restricciones de positividad y separar las condiciones de estacionariedad estricta, segundo momento y cuarto momento;
- derivar la varianza incondicional y la curtosis del ARCH\((1)\) gaussiano;
- demostrar la representación ARMA del proceso de innovaciones al cuadrado para GARCH\((1,1)\);
- construir la verosimilitud gaussiana condicional e interpretar estimaciones y restricciones;
- aplicar una prueba ARCH-LM y diagnosticar innovaciones estandarizadas y sus cuadrados;
- derivar pronósticos de varianza a uno y varios pasos y relacionarlos con persistencia y reversión a largo plazo;
- analizar datos financieros reales mediante código reproducible en R;
- comparar pronósticos de varianza fuera de muestra con una referencia homocedástica, usando errores cuadráticos y QLIKE;
- distinguir GARCH de un modelo con volatilidad latente y anticipar el análisis bayesiano posterior.
En Sección 4.11 aprendimos que una ACF residual pequeña no agota las comprobaciones sobre un modelo temporal. En Sección 7.2.1 y Sección 7.4 distinguimos el diagnóstico dentro de muestra de la comparación predictiva genuina. En Sección 9.20 aprendimos otra manera de describir la estructura de dependencia. En este capítulo estudiaremos un tipo distinto de dependencia: la predicción del segundo momento condicional.
Para ejecutar el capítulo se requieren los paquetes tidyverse, ggplot2, knitr y rugarch. Deben instalarse una sola vez, antes de compilar el libro, mediante install.packages(c("tidyverse", "ggplot2", "knitr", "rugarch")). No se realizan instalaciones desde los chunks durante el renderizado. Los dos bloques de estimación con rugarch y la validación temporal usan la opción cache: true para evitar recálculos innecesarios al modificar exclusivamente la exposición escrita.
La referencia principal es Shumway y Stoffer (Shumway y Stoffer 2025, sec. 5.3). Para el contraste conceptual con volatilidad estocástica utilizaremos (Prado et al. 2021, sec. 7.5) y (Shumway y Stoffer 2025, sec. 6.12). La lógica de evaluación temporal retoma (Hyndman y Athanasopoulos 2021, chap. 5) y el capítulo 7 de estas notas.
NotaConvención de símbolos
Usaremos \(R_t\) para el retorno aleatorio, \(r_t\) para el retorno observado, \(\varepsilon_t\) para su innovación y \(Z_t\) para la innovación estandarizada. La varianza condicional será \(h_t=\sigma_t^2\). En la ecuación de varianza, \(\omega>0\) denotará el intercepto; esta \(\omega\) no es la frecuencia angular del capítulo 9. Los parámetros \(\alpha\) y \(\beta\) describirán el efecto del cuadrado rezagado y de la varianza rezagada, respectivamente.
10.2 ¿Por qué modelar la volatilidad?
En numerosas series de precios, las observaciones \(P_t\) presentan tendencias y cambios de escala. Por ese motivo, suele estudiarse el retorno logarítmico
\[ R_t=100\bigl(\log P_t-\log P_{t-1}\bigr) =100\log\left(\frac{P_t}{P_{t-1}}\right). \tag{10.1}\]
El factor \(100\) expresa el retorno en puntos porcentuales aproximados; no modifica su estructura de dependencia. Un cambio logarítmico no es exactamente el rendimiento porcentual simple \(100(P_t/P_{t-1}-1)\), aunque ambos son cercanos para movimientos pequeños.
Una pregunta se refiere a la media condicional \(E(R_t\mid\mathcal F_{t-1})\): ¿se espera un aumento o una disminución? Otra se refiere a la varianza condicional \(\operatorname{Var}(R_t\mid\mathcal F_{t-1})\): ¿qué tan grande podría ser la fluctuación? Ambas cantidades intervienen en un intervalo predictivo, pero responden a preguntas diferentes.
10.2.1 Patrones empíricos de los retornos financieros
Al examinar retornos financieros es frecuente observar:
- Agrupamiento de volatilidad: períodos de movimientos grandes seguidos de otros movimientos grandes (positivos o negativos), y períodos de pequeñas fluctuaciones seguidos de pequeñas fluctuaciones.
- Autocorrelación lineal limitada: la ACF de retornos puede ser pequeña, aunque la ACF de \(R_t^2\) o \(|R_t|\) sea positiva.
- Colas marginales pesadas: ocurrencias extremas más frecuentes que las predichas por una distribución normal con la misma varianza.
- Posibles asimetrías: respuestas diferentes a retornos negativos y positivos de la misma magnitud.
No son leyes universales. Deben comprobarse en cada aplicación. Los modelos ARCH y GARCH simétricos que desarrollaremos representan los tres primeros fenómenos en grados diferentes, pero no incorporan asimetría ante el signo de una innovación de modo explícito.
10.2.2 Datos: índice DAX de EuStockMarkets
La aplicación usará el índice DAX del conjunto de datos EuStockMarkets, distribuido con R. El conjunto registra observaciones bursátiles históricas; su índice temporal original no proporciona un calendario diario exacto de fechas de negociación. Para evitar inventar fechas, graficaremos el número consecutivo de observación y mantendremos intacto su orden. No lo convertiremos artificialmente en un tsibble diario sin verificar los días hábiles y festivos.
serie_grafico <- bind_rows(
  precios_dax |>
    transmute(observacion, valor = precio, serie = "Índice DAX",
              periodo = if_else(observacion <= n_entrenamiento + 1L,
                                "Entrenamiento", "Prueba")),
  retornos_dax |>
    transmute(observacion, valor = retorno, serie = "Retorno logarítmico (%)",
              periodo)
)

ggplot(serie_grafico, aes(observacion, valor, color = periodo)) +
  geom_line(linewidth = 0.35) +
  geom_vline(xintercept = n_entrenamiento + 1.5,
             linetype = "dashed", color = "grey30") +
  facet_wrap(~ serie, ncol = 1, scales = "free_y") +
  scale_color_manual(values = c("Entrenamiento" = "#2166ac",
                                "Prueba" = "#b2182b")) +
  labs(x = "Número de observación", y = NULL,
       color = "Período", title = "De niveles de precios a retornos") +
  tema_garch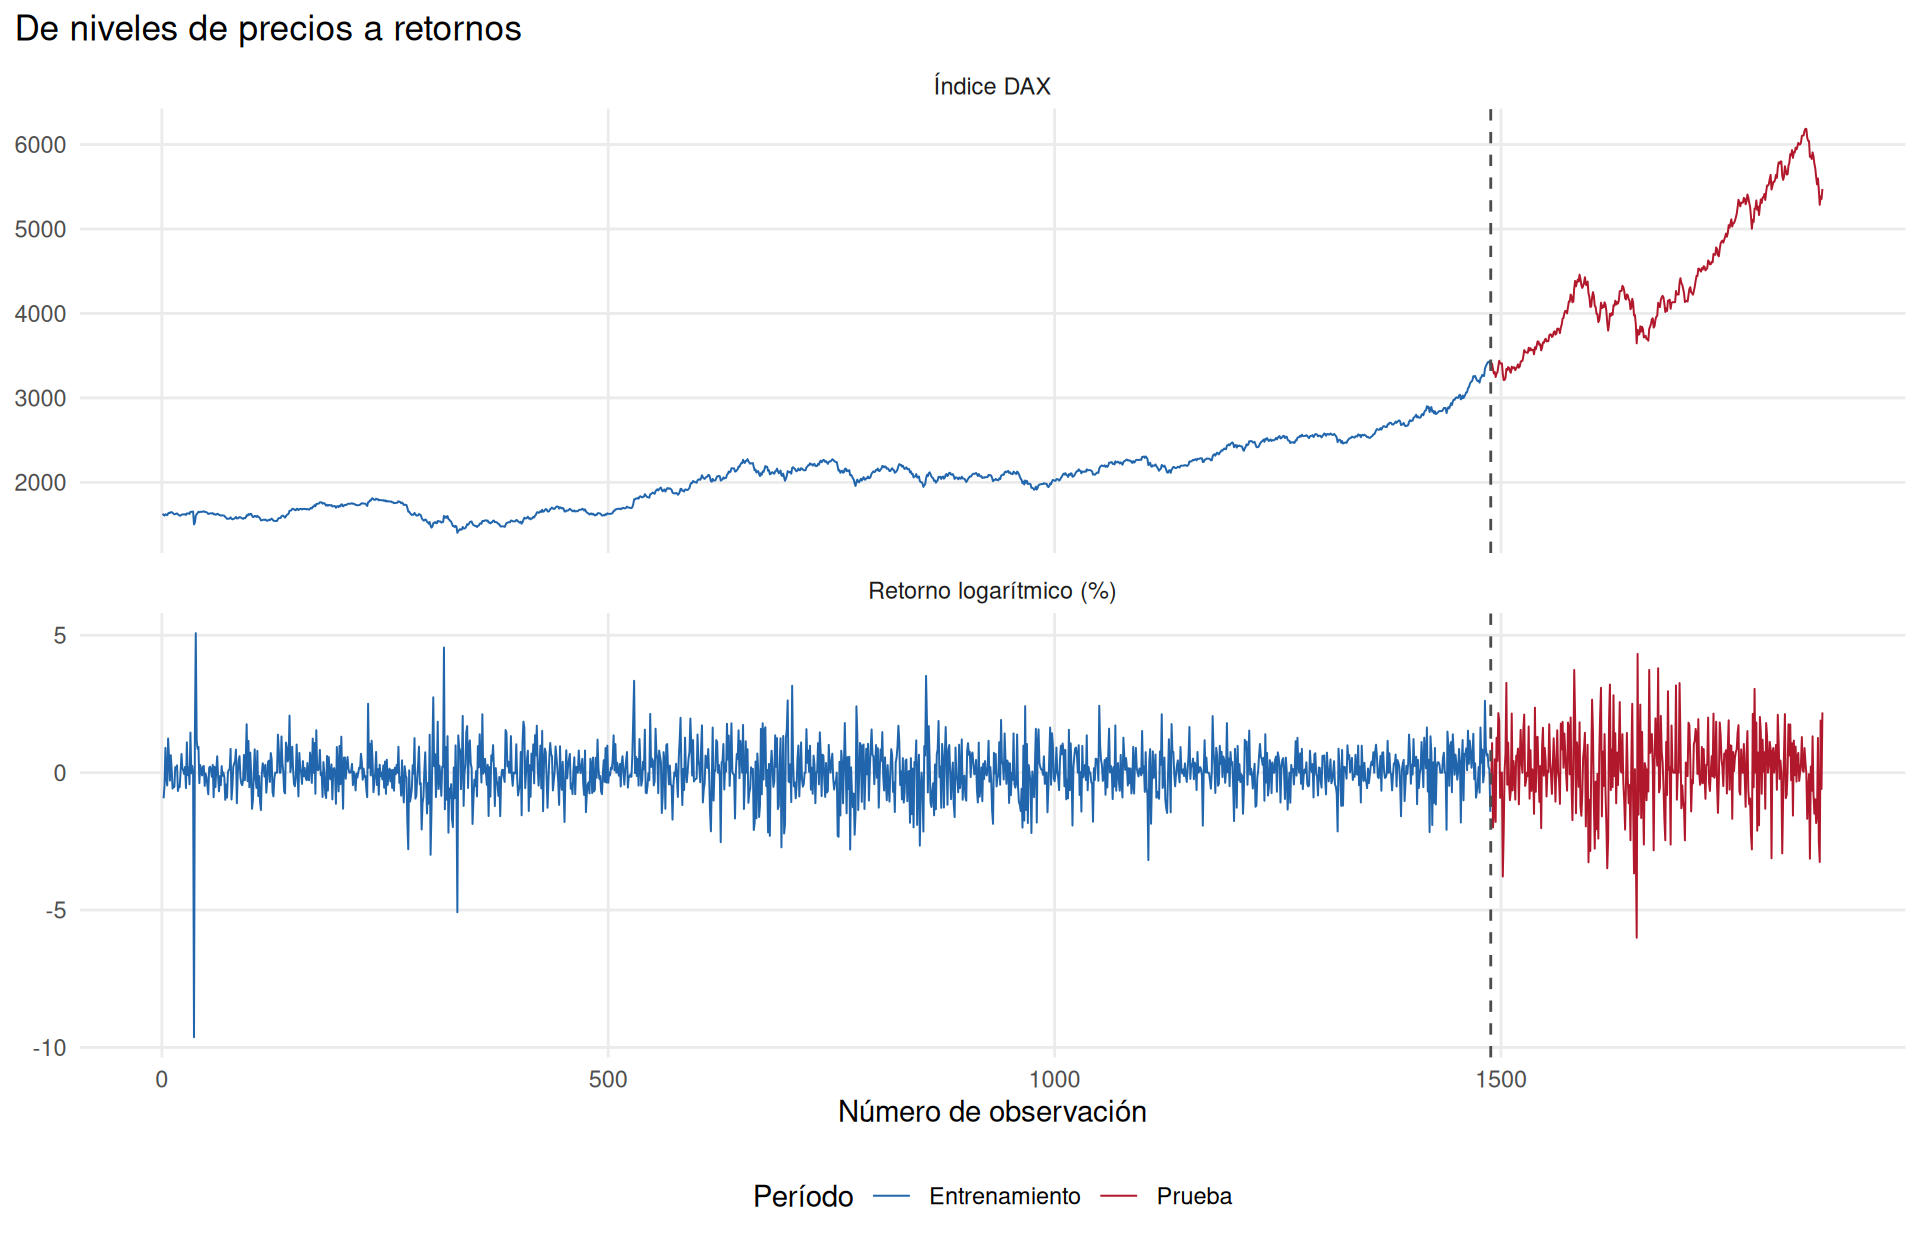
En Figura 10.1 la línea vertical separa claramente el ajuste de entrenamiento de las observaciones reservadas para prueba. La diferencia entre niveles y retornos es importante: ajustar GARCH directamente al precio no tiene la misma interpretación que ajustarlo a sus retornos. En la aplicación usaremos un modelo sencillo de media constante, sin sostener que esta sea siempre la mejor descripción de los retornos. Si la media mostrara autocorrelación sustancial, correspondería incluir, por ejemplo, una estructura ARMA antes de diagnosticar la varianza.
knitr::kable(resumen_dax, digits = 3)| observaciones | media | desviacion | minimo | maximo |
|---|---|---|---|---|
| 1859 | 0.065 | 1.03 | -9.628 | 5.076 |
10.3 Varianza condicional e independencia
Sea \(\mathcal F_{t-1}\) la información observada hasta el instante \(t-1\). Escribimos
\[ R_t=\mu_t+\varepsilon_t, \qquad \mu_t=E(R_t\mid\mathcal F_{t-1}), \tag{10.2}\]
con
\[ \varepsilon_t=\sqrt{h_t}\,Z_t, \qquad E(Z_t)=0, \qquad E(Z_t^2)=1, \tag{10.3}\]
suponiendo que \(Z_t\) es independiente de \(\mathcal F_{t-1}\) y que \(h_t\) es medible respecto de \(\mathcal F_{t-1}\). Entonces
\[ E(\varepsilon_t\mid\mathcal F_{t-1})=0, \qquad \operatorname{Var}(\varepsilon_t\mid\mathcal F_{t-1})=h_t. \tag{10.4}\]
En cambio, por esperanza total,
\[ \operatorname{Var}(\varepsilon_t)=E(h_t) \tag{10.5}\]
si el segundo momento es finito. El proceso puede tener varianza incondicional constante y a la vez presentar varianza condicional variable.
10.3.1 Ausencia de correlación no significa independencia
Para \(k\ge1\), la variable \(\varepsilon_{t-k}\) es medible respecto de \(\mathcal F_{t-1}\). Si existe el segundo momento,
\[ \begin{aligned} E(\varepsilon_t\varepsilon_{t-k}) &=E\left\{\varepsilon_{t-k}E(\varepsilon_t\mid\mathcal F_{t-1})\right\}\\ &=0. \end{aligned} \tag{10.6}\]
Por tanto, \(\{\varepsilon_t\}\) es una secuencia de diferencias de martingala y, bajo momentos finitos, está no-correlacionada. Pero \(\varepsilon_t\) y \(\varepsilon_{t-1}\) no son en general independientes, pues el tamaño esperado de \(\varepsilon_t^2\) puede depender de \(\varepsilon_{t-1}^2\).
Esta distinción también explica por qué un contraste de Ljung–Box aplicado solo a las innovaciones podría no detectar la dependencia relevante: la señal aparece más claramente en sus cuadrados, no necesariamente en los valores con signo.
10.4 Modelos ARCH
En un ARCH\((q)\) (autoregressive conditional heteroskedasticity) la varianza condicional depende de cuadrados de innovaciones pasadas:
\[ h_t=\omega+\sum_{j=1}^{q}\alpha_j\varepsilon_{t-j}^2, \qquad \omega>0,\quad \alpha_j\ge0. \tag{10.7}\]
Las restricciones anteriores aseguran \(h_t\ge\omega>0\) para todos los valores del pasado. Son condiciones suficientes sencillas de positividad, distintas de las condiciones necesarias para que la distribución incondicional tenga segundo o cuarto momento finito.
Para ARCH\((1)\),
\[ \boxed{\varepsilon_t=\sqrt{h_t}Z_t, \qquad h_t=\omega+\alpha\varepsilon_{t-1}^2.} \tag{10.8}\]
El efecto del retorno anterior no depende de su signo: un choque positivo y uno negativo de igual magnitud producen la misma varianza condicional del siguiente período.
10.4.1 Media y varianza incondicional de ARCH(1)
Suponiendo que existe una solución estacionaria con \(E(\varepsilon_t^2)<\infty\) y que \(E(Z_t^2)=1\), escribamos \(m_2=E(\varepsilon_t^2)\). Por la ley de expectativas iteradas,
\[ \begin{aligned} m_2 &=E\{E(\varepsilon_t^2\mid\mathcal F_{t-1})\}\\ &=E(h_t)\\ &=\omega+\alpha E(\varepsilon_{t-1}^2)\\ &=\omega+\alpha m_2. \end{aligned} \]
De aquí se obtiene
\[ \boxed{m_2=\frac{\omega}{1-\alpha},\qquad 0\le\alpha<1.} \tag{10.9}\]
La desigualdad \(\alpha<1\) no es un artificio algebraico: con \(\omega>0\) y \(m_2\) positivo y finito, la identidad \(m_2(1-\alpha)=\omega\) la exige. A la inversa, con \(\alpha<1\) se puede construir una solución causal estacionaria de segundo orden mediante la representación no negativa que discutiremos enseguida.
10.4.2 Estacionariedad estricta y estacionariedad de segundo orden
Sustituir \(\varepsilon_{t-1}^2=h_{t-1}Z_{t-1}^2\) en Ecuación 10.8 conduce a la ecuación aleatoria
\[ h_t=\omega+\alpha Z_{t-1}^2h_{t-1}. \tag{10.10}\]
Iterando formalmente,
\[ \begin{aligned} h_t &=\omega\biggl[1+\alpha Z_{t-1}^2 +\alpha^2 Z_{t-1}^2Z_{t-2}^2+\cdots\biggr]\\ &=\omega\left[1+\sum_{j=1}^{\infty} \alpha^j\prod_{i=1}^{j}Z_{t-i}^2\right]. \end{aligned} \tag{10.11}\]
Para \(\alpha>0\), una condición habitual para la convergencia casi segura de esta serie y la existencia de una solución causal estrictamente estacionaria es
\[ E\{\log(\alpha Z_t^2)\}<0. \tag{10.12}\]
Si \(\alpha=0\), \(h_t=\omega\) y la estacionariedad es inmediata. Cuando \(0<\alpha<1\), la desigualdad de Jensen da
\[ E\{\log(\alpha Z_t^2)\} \le\log\{\alpha E(Z_t^2)\} =\log\alpha<0. \]
Por tanto, \(\alpha<1\) es suficiente para la existencia de una solución causal estrictamente estacionaria con segundo momento finito. Sin embargo, la condición logarítmica puede cumplirse aun para algunos \(\alpha\ge1\), dando una solución estrictamente estacionaria cuya varianza incondicional es infinita. No debe identificarse estacionariedad estricta con existencia de varianza.
10.4.3 Cuarto momento y curtosis de ARCH(1)
Bajo \(Z_t\sim N(0,1)\), tenemos \(E(Z_t^4)=3\). Denotemos \(m_4=E(\varepsilon_t^4)\). Por independencia entre \(Z_t\) y \(h_t\),
\[ \begin{aligned} m_4 &=E(h_t^2Z_t^4)=3E(h_t^2)\\ &=3E\{(\omega+\alpha\varepsilon_{t-1}^2)^2\}\\ &=3\omega^2+6\omega\alpha m_2+3\alpha^2m_4. \end{aligned} \]
Por lo tanto, si \(3\alpha^2<1\),
\[ \begin{aligned} m_4 &=\frac{3\omega^2+6\omega\alpha m_2}{1-3\alpha^2}\\ &=\frac{3\omega^2(1+\alpha)}{(1-\alpha)(1-3\alpha^2)}. \end{aligned} \tag{10.13}\]
Dividiendo entre \(m_2^2\), obtenemos la curtosis (no el exceso de curtosis):
\[ \boxed{\operatorname{Kurt}(\varepsilon_t) =\frac{3(1-\alpha^2)}{1-3\alpha^2}, \qquad 0\le\alpha<1/\sqrt 3.} \tag{10.14}\]
Para \(\alpha>0\) la curtosis es mayor que \(3\). Así, normalidad condicional no implica normalidad marginal. Es posible tener \(\alpha<1\) y \(3\alpha^2\ge1\): existe la varianza incondicional, pero no existe el cuarto momento finito para la solución causal no degenerada.
curtosis_teorica <- tibble(
  alpha = seq(0, 1 / sqrt(3) - 0.018, length.out = 250)
) |>
  mutate(curtosis = 3 * (1 - alpha^2) / (1 - 3 * alpha^2))

ggplot(curtosis_teorica, aes(alpha, curtosis)) +
  geom_line(color = "#2166ac", linewidth = 0.85) +
  geom_hline(yintercept = 3, linetype = "dotted", color = "grey35") +
  geom_vline(xintercept = 1 / sqrt(3), linetype = "dashed") +
  coord_cartesian(ylim = c(2, 70)) +
  labs(x = expression(alpha), y = "Curtosis marginal",
       title = "ARCH(1): las colas pesadas dependen de los momentos") +
  tema_garch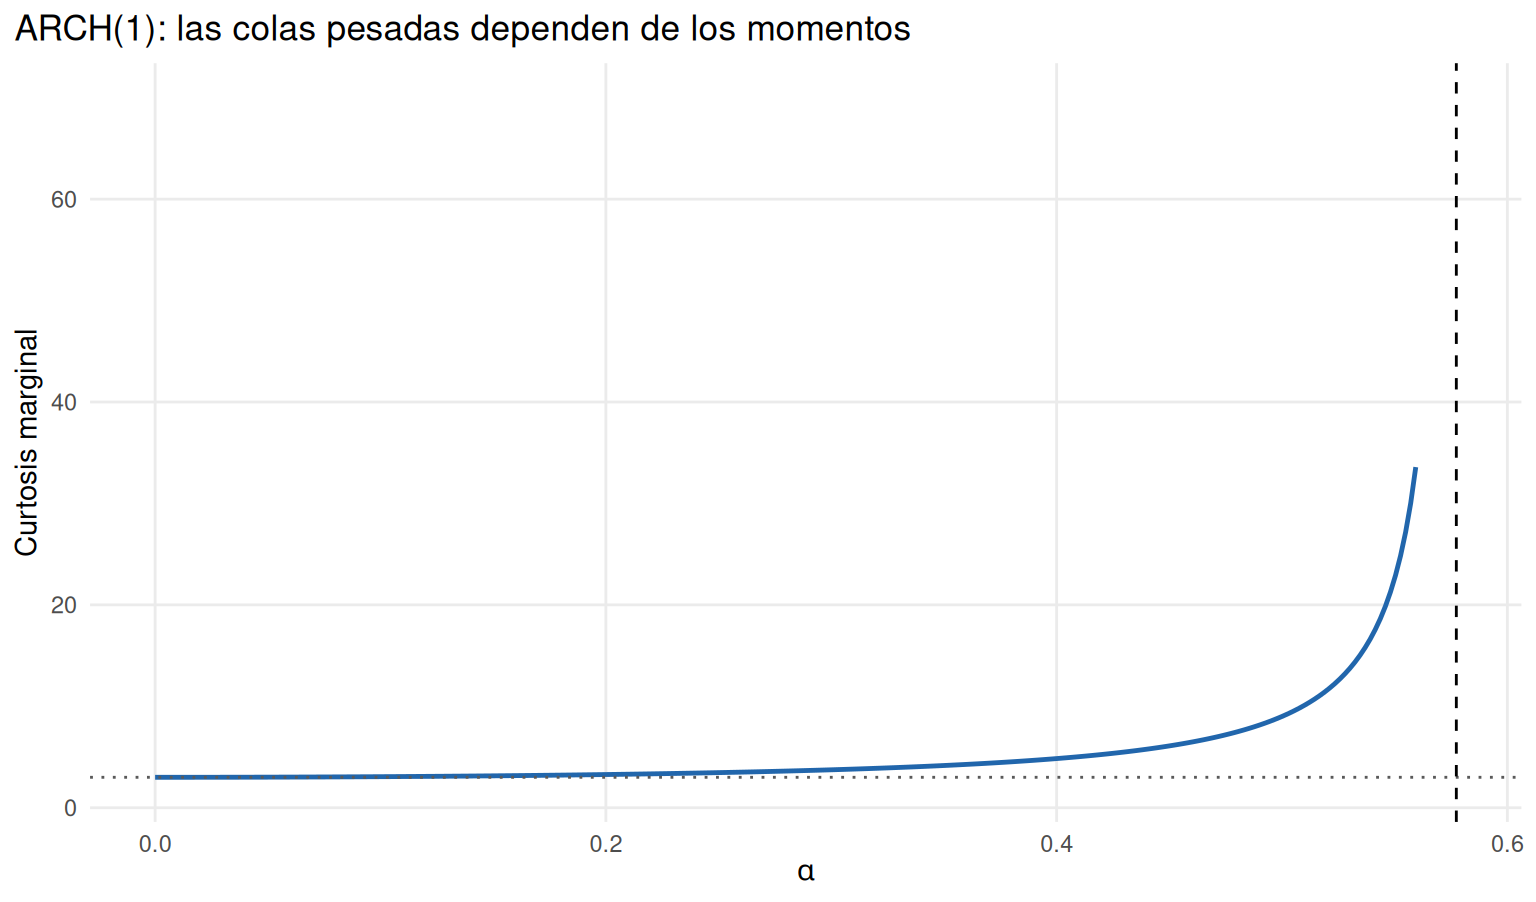
10.4.4 La dinámica de los cuadrados
Definamos
\[ u_t=\varepsilon_t^2-h_t=h_t(Z_t^2-1). \tag{10.15}\]
Como \(E(u_t\mid\mathcal F_{t-1})=0\), \(u_t\) es una diferencia de martingala. Para ARCH\((1)\),
\[ \varepsilon_t^2=\omega+\alpha\varepsilon_{t-1}^2+u_t. \tag{10.16}\]
La ecuación tiene forma AR\((1)\) para los cuadrados, pero \(u_t\) no es en general ruido blanco independiente y homocedástico. La formulación no autoriza aplicar automáticamente toda la teoría gaussiana de AR\((1)\) a \(\varepsilon_t^2\).
10.5 Experimento de simulación: media y varianza
Compararemos ruido blanco homocedástico con un ARCH\((1)\) con \(\alpha=0.45\). Para que el contraste sea informativo, ambos procesos tienen varianza incondicional teórica igual a uno.
n_sim <- 1200L
ruido <- simular_garch(n_sim, omega = 1, alpha = 0,
                       semilla = 415) |>
  mutate(modelo = "Ruido blanco homocedástico")
arch <- simular_garch(n_sim, omega = 1 - 0.45, alpha = 0.45,
                      semilla = 416) |>
  mutate(modelo = "ARCH(1), alfa = 0.45")

sim_arch <- bind_rows(ruido, arch)
stopifnot(nrow(sim_arch) == 2 * n_sim)ggplot(sim_arch, aes(t, epsilon)) +
geom_line(color = "#2166ac", linewidth = 0.3) +
facet_wrap(~ modelo, ncol = 1) +
labs(x = "Tiempo", y = "Innovación",
title = "La misma varianza marginal no implica la misma dinámica") +
tema_garch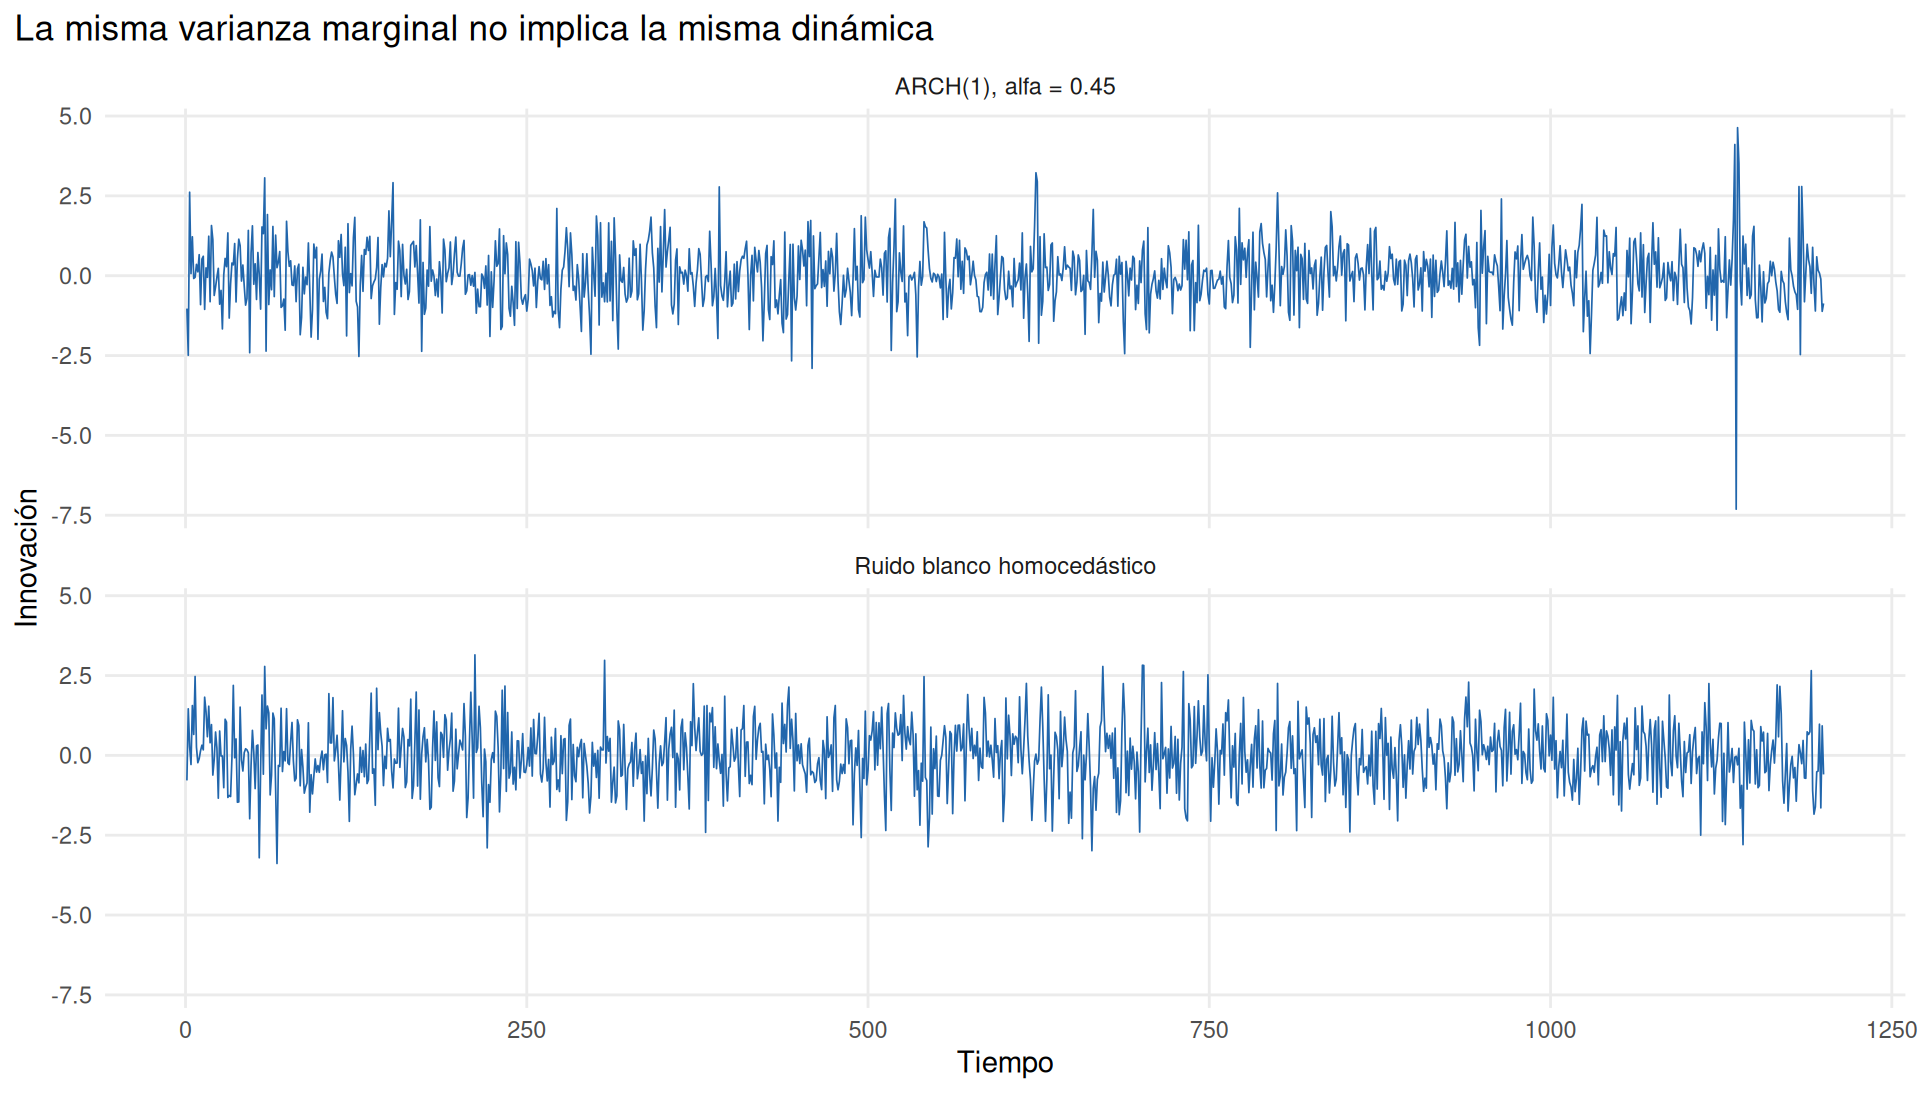
acf_simuladas <- sim_arch |>
  group_by(modelo) |>
  group_modify(~ {
    tibble(
      rezago = rep(seq_len(25L), 2L),
      acf = c(
        as.numeric(stats::acf(.x$epsilon, lag.max = 25,
                              plot = FALSE)$acf)[-1],
        as.numeric(stats::acf(.x$epsilon^2, lag.max = 25,
                              plot = FALSE)$acf)[-1]
      ),
      variable = rep(c("Innovaciones", "Innovaciones al cuadrado"),
                     each = 25L)
    )
  }) |>
  ungroup()

ggplot(acf_simuladas, aes(rezago, acf)) +
  geom_hline(yintercept = 0, color = "grey40") +
  geom_segment(aes(xend = rezago, yend = 0), color = "#2166ac") +
  facet_grid(modelo ~ variable) +
  labs(x = "Rezago", y = "ACF muestral") +
  tema_garch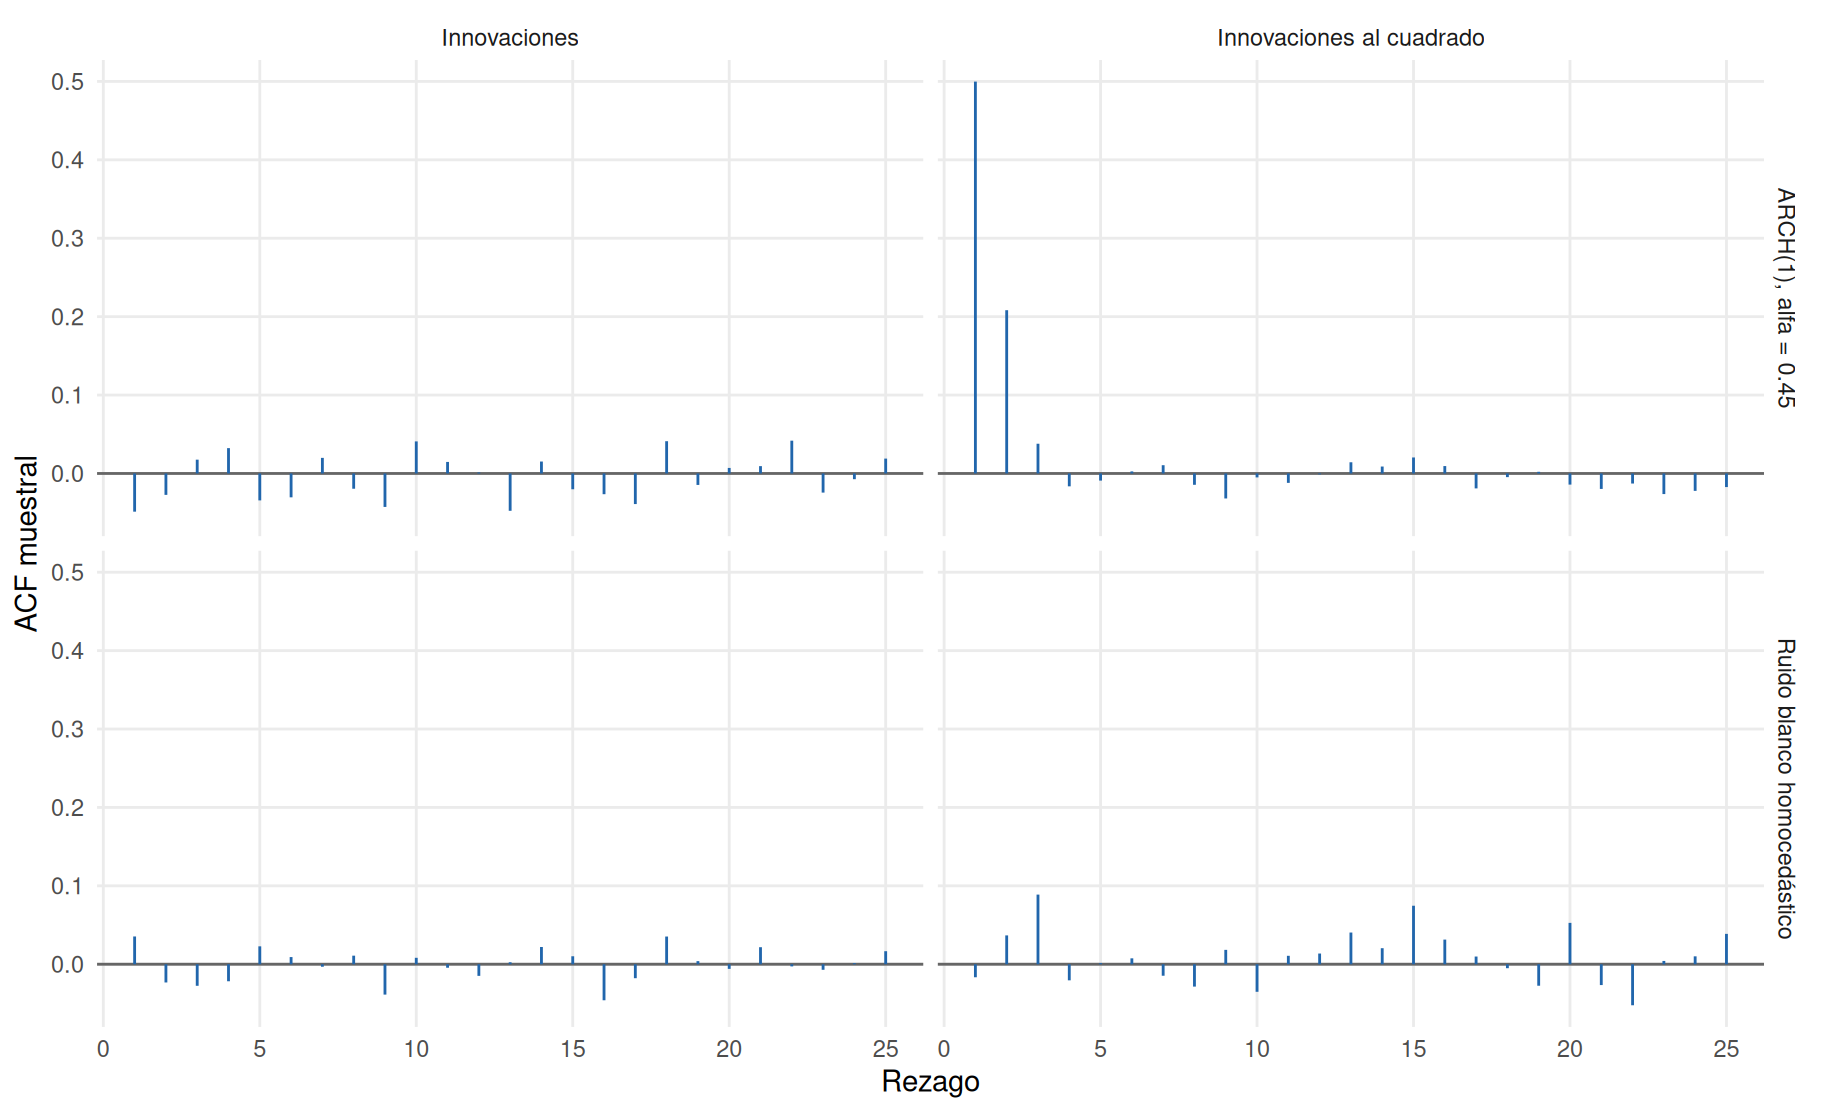
En Figura 10.3 y Figura 10.4 observamos cómo la dependencia aparece en la dispersión aun cuando no domine la ACF en niveles.
10.6 Modelos GARCH
Un GARCH\((p,q)\) generaliza ARCH al incluir varianzas condicionales rezagadas:
\[ h_t=\omega +\sum_{i=1}^{q}\alpha_i\varepsilon_{t-i}^2 +\sum_{j=1}^{p}\beta_jh_{t-j}, \quad \omega>0,\quad \alpha_i,\beta_j\ge0. \tag{10.17}\]
Seguiremos la convención GARCH\((p,q)\) con \(p\) rezagos de varianza y \(q\) rezagos de innovaciones al cuadrado, como en implementaciones habituales de R. En la literatura hay convenciones de índices alternativas; lo importante es identificar explícitamente ambas sumas. Para GARCH\((1,1)\) no surge ambigüedad:
\[ \boxed{h_t=\omega+\alpha\varepsilon_{t-1}^2+\beta h_{t-1}.} \tag{10.18}\]
El coeficiente \(\alpha\) cuantifica la reacción de la varianza ante el último choque al cuadrado, mientras \(\beta\) controla cuánto del nivel de varianza previo persiste directamente. Esta interpretación supone mantener fijo el resto de la información disponible; no son coeficientes de una ecuación de media.
10.6.1 Varianza incondicional
Bajo una solución estacionaria con varianza finita, denotemos \(m_2=E(\varepsilon_t^2)=E(h_t)\). Por la ecuación de varianza,
\[ m_2=\omega+\alpha m_2+\beta m_2. \]
Se sigue que
\[ \boxed{m_2=\frac{\omega}{1-\alpha-\beta}, \quad \alpha+\beta<1.} \tag{10.19}\]
Esta es una condición de segundo momento finito bajo la parametrización considerada. No es la condición más general para estacionariedad estricta.
En efecto, sustituyendo \(\varepsilon_{t-1}^2=h_{t-1}Z_{t-1}^2\) obtenemos
\[ h_t=\omega+(\alpha Z_{t-1}^2+\beta)h_{t-1}. \tag{10.20}\]
Para innovaciones iid con condiciones de integrabilidad apropiadas, la existencia de una solución causal estrictamente estacionaria se caracteriza mediante
\[ E\{\log(\alpha Z_t^2+\beta)\}<0. \tag{10.21}\]
Como antes, \(\alpha+\beta<1\) implica esta desigualdad por Jensen, pero la condición logarítmica puede cumplirse en casos con \(\alpha+\beta\ge1\). Conviene no afirmar que \(\alpha+\beta<1\) es necesaria para toda forma de estacionariedad.
10.6.2 Persistencia y memoria de choques
La suma \(\lambda=\alpha+\beta\) determina la velocidad de reversión del pronóstico de segundo momento cuando existe \(\bar h=\omega/(1-\lambda)\). Cuanto más cercana esté \(\lambda\) a uno, más lentamente converge el pronóstico hacia \(\bar h\). Esta suma por sí sola no revela todo el comportamiento de una trayectoria: importa también cómo se distribuye entre \(\alpha\) y \(\beta\).
10.6.3 Representación ARMA de los cuadrados
Usamos nuevamente \(u_t=\varepsilon_t^2-h_t\). De \(h_{t-1}=\varepsilon_{t-1}^2-u_{t-1}\) resulta
\[ \begin{aligned} \varepsilon_t^2 &=h_t+u_t\\ &=\omega+\alpha\varepsilon_{t-1}^2 +\beta\bigl(\varepsilon_{t-1}^2-u_{t-1}\bigr)+u_t\\ &=\omega+(\alpha+\beta)\varepsilon_{t-1}^2 +u_t-\beta u_{t-1}. \end{aligned} \]
Así,
\[ \boxed{\varepsilon_t^2 =\omega+\lambda\varepsilon_{t-1}^2+u_t-\beta u_{t-1}.} \tag{10.22}\]
La semejanza con ARMA\((1,1)\) es útil para describir autocorrelaciones de cuadrados, siempre que existan los momentos adecuados. Pero no debemos suponer que \(u_t\) es gaussiano ni iid. En particular, para utilizar la ACF usual de cuadrados necesitamos que \(E(\varepsilon_t^4)\) sea finito.
10.6.4 Cuarto momento de GARCH(1,1)
Bajo innovaciones gaussianas, una condición para la existencia del cuarto momento finito en la solución causal no degenerada es
\[ E\{(\alpha Z_t^2+\beta)^2\} =3\alpha^2+2\alpha\beta+\beta^2<1. \tag{10.23}\]
La desigualdad es más exigente que \(\alpha+\beta<1\) cuando \(\alpha>0\). Por tanto, un GARCH puede tener varianza finita y presentar curtosis marginal no finita.
condiciones <- tibble::tibble(
  Modelo = c("ARCH(1)", "GARCH(1,1)"),

  Positividad = c(
    "$\\omega>0,\\ \\alpha\\geq 0$",
    "$\\omega>0,\\ \\alpha,\\beta\\geq 0$"
  ),

  `Varianza finita` = c(
    "$\\alpha<1$",
    "$\\alpha+\\beta<1$"
  ),

  `Cuarto momento finito` = c(
    "$3\\alpha^2<1$",
    "$3\\alpha^2+2\\alpha\\beta+\\beta^2<1$"
  )
)

knitr::kable(
  condiciones,
  format = "pipe",
  escape = FALSE,
  align = c("l", "c", "c", "c")
)| Modelo | Positividad | Varianza finita | Cuarto momento finito |
|---|---|---|---|
| ARCH(1) | \(\omega>0,\ \alpha\geq 0\) | \(\alpha<1\) | \(3\alpha^2<1\) |
| GARCH(1,1) | \(\omega>0,\ \alpha,\beta\geq 0\) | \(\alpha+\beta<1\) | \(3\alpha^2+2\alpha\beta+\beta^2<1\) |
10.7 Simulación y persistencia de GARCH(1,1)
Para comparar grados de persistencia sin confundirlos con cambios de escala, fijaremos \(E(h_t)=1\), es decir, elegiremos \(\omega=1-\alpha-\beta\). Este control del experimento es importante: si se deja \(\omega\) fijo, cambiar \(\alpha+\beta\) también modifica la varianza marginal.
parametros_sim <- tibble(
  escenario = c("Persistencia baja", "Persistencia media", "Persistencia alta"),
  alpha = c(0.12, 0.12, 0.12),
  beta = c(0.25, 0.65, 0.85)
) |>
  mutate(omega = 1 - alpha - beta,
         persistencia = alpha + beta)

sim_persistencia <- purrr::pmap_dfr(
  parametros_sim,
  function(escenario, alpha, beta, omega, persistencia) {
    simular_garch(n = 900, omega = omega, alpha = alpha,
                  beta = beta, semilla = 415) |>
      mutate(escenario = escenario, persistencia = persistencia)
  }
)ggplot(sim_persistencia, aes(t, h)) +
geom_line(color = "#2166ac", linewidth = 0.45) +
geom_hline(yintercept = 1, color = "#b2182b", linetype = "dashed") +
facet_wrap(~ escenario, ncol = 1, scales = "free_y") +
labs(x = "Tiempo", y = "Varianza condicional",
title = "Dinámica de volatilidad con distintas persistencias") +
tema_garch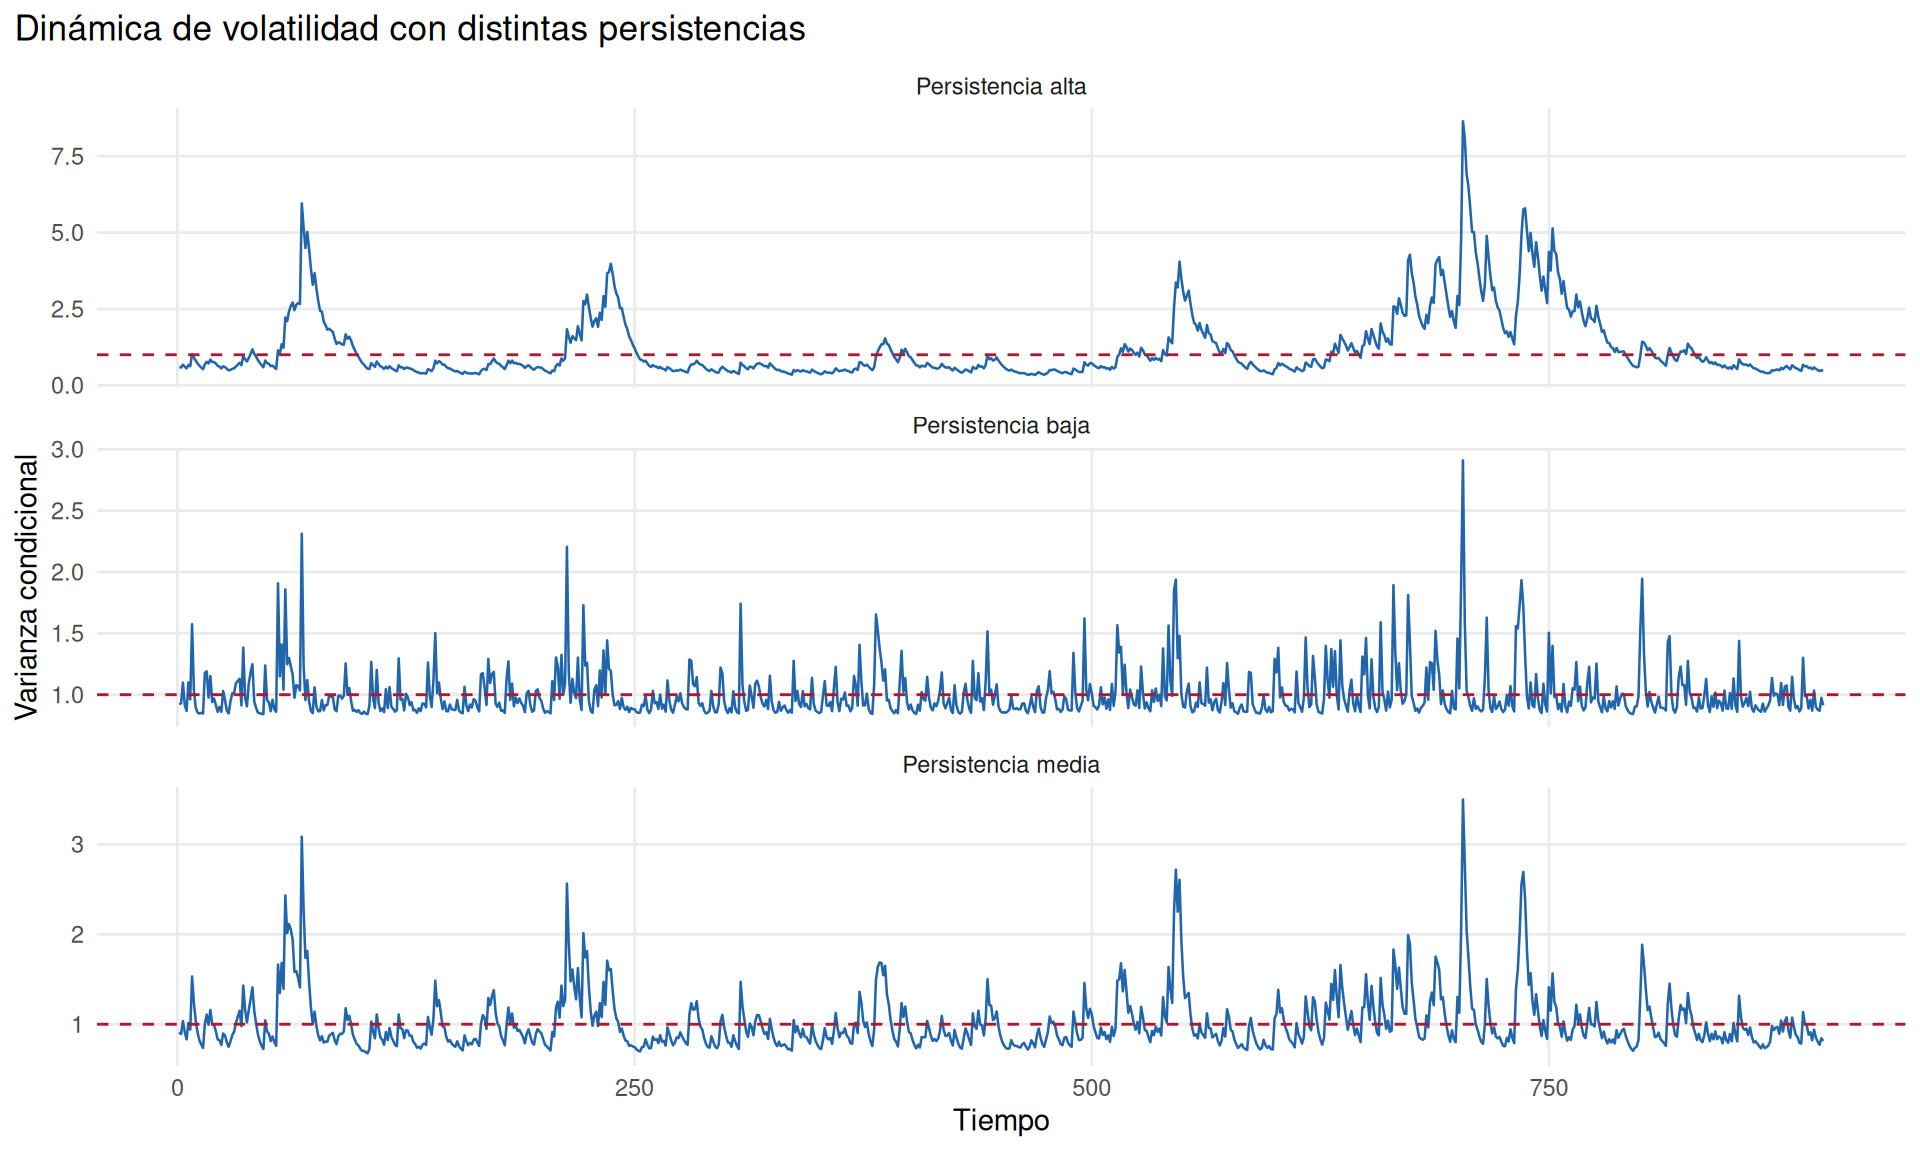
En Figura 10.5 se representa el estado condicional real de la simulación, no una estimación. Si las gráficas muestran episodios distintos a pesar de utilizar parámetros relacionados, parte de la diferencia se debe a que cada trayectoria responde de manera recursiva a sus propias innovaciones. En este experimento usamos la misma semilla para facilitar la comparación, pero no debemos equiparar una sola trayectoria con una propiedad poblacional.
10.8 Estimación de ARCH y GARCH
10.8.1 Verosimilitud gaussiana condicional
Consideremos, inicialmente, una media constante \(\mu\), de modo que \(\varepsilon_t=R_t-\mu\). Si \(Z_t\overset{\mathrm{iid}}{\sim}N(0,1)\), entonces
\[ R_t\mid\mathcal F_{t-1},\boldsymbol\theta \sim N(\mu,h_t), \tag{10.24}\]
con \(\boldsymbol\theta=(\mu,\omega,\alpha,\beta)\) en el caso GARCH\((1,1)\). Por factorización de densidades condicionales, condicionando en la información usada para inicializar \(h_t\),
\[ L(\boldsymbol\theta) =\prod_{t=1}^{T} \frac{1}{\sqrt{2\pi h_t(\boldsymbol\theta)}} \exp\left[-\frac{(r_t-\mu)^2}{2h_t(\boldsymbol\theta)}\right]. \]
Por tanto,
\[ \boxed{\ell(\boldsymbol\theta) =-\frac12\sum_{t=1}^{T} \left\{\log(2\pi)+\log h_t(\boldsymbol\theta) +\frac{(r_t-\mu)^2}{h_t(\boldsymbol\theta)}\right\}.} \tag{10.25}\]
Esta es la log-verosimilitud condicional gaussiana. Se evalúa recursivamente porque cada \(h_t\) depende de los parámetros y de innovaciones anteriores.
La elección de \(h_1\) no es irrelevante en muestras pequeñas. Entre las alternativas se encuentran fijar una varianza inicial basada solo en entrenamiento, utilizar el momento estacionario cuando existe o emplear procedimientos de retroproyección (backcasting). Las implementaciones especializadas pueden diferir en su inicialización, de modo que dos estimadores numéricos no tienen por qué coincidir exactamente en muestras finitas.
10.8.2 Restricciones y transformaciones paramétricas
Para maximizar en una región admisible se puede trabajar con parámetros transformados. En ARCH\((1)\), por ejemplo,
\[ \omega=\exp(\eta_\omega),\qquad \alpha=\frac{\exp(\eta_\alpha)}{1+\exp(\eta_\alpha)}, \tag{10.26}\]
lo que asegura \(\omega>0\) y \(0<\alpha<1\) sin restricciones explícitas en \(\eta_\omega,\eta_\alpha\). Esta parametrización excluye el punto frontera \(\alpha=0\), que sí puede ser relevante como hipótesis de homocedasticidad.
En GARCH\((1,1)\) podemos usar una parametrización de tipo simplex para garantizar \(\alpha\ge0\), \(\beta\ge0\), \(\alpha+\beta<1\), o podemos recurrir a restricciones implementadas por el optimizador.
10.8.3 Ejemplo: ARCH(1) estimado con optim()
Primero usaremos un conjunto simulado de ARCH\((1)\) para que los parámetros verdaderos sean conocidos. Estimaremos conjuntamente una media constante y los parámetros de varianza. El objetivo didáctico es reconocer qué maximiza el algoritmo, no reemplazar las rutinas robustas de un paquete especializado.
set.seed(415)
datos_arch_ml <- simular_garch(
  n = 1400, omega = 0.40, alpha = 0.50,
  semilla = 415
)$epsilon + 0.20

neg_loglik_arch1 <- function(eta, y) {
  mu <- eta[1]
  omega <- exp(eta[2])
  alpha <- plogis(eta[3])
  eps <- as.numeric(y) - mu
  n <- length(eps)
  h <- numeric(n)
  h[1] <- omega / (1 - alpha)
  for (t in 2:n) {
    h[t] <- omega + alpha * eps[t - 1]^2
  }
  if (any(!is.finite(h)) || any(h <= 0)) return(1e100)
  -sum(dnorm(eps, mean = 0, sd = sqrt(h), log = TRUE))
}

inicio <- c(
  mean(datos_arch_ml),
  log(var(datos_arch_ml) * 0.7),
  qlogis(0.30)
)

estimacion_arch <- optim(
  par = inicio,
  fn = neg_loglik_arch1,
  y = datos_arch_ml,
  method = "BFGS",
  control = list(maxit = 1000),
  hessian = TRUE
)
stopifnot(estimacion_arch$convergence == 0L)

parametros_arch <- tibble(
  parametro = c("mu", "omega", "alpha"),
  verdadero = c(0.20, 0.40, 0.50),
  estimado = c(
    estimacion_arch$par[1],
    exp(estimacion_arch$par[2]),
    plogis(estimacion_arch$par[3])
  )
)knitr::kable(parametros_arch, digits = 4)| parametro | verdadero | estimado |
|---|---|---|
| mu | 0.2 | 0.2051 |
| omega | 0.4 | 0.3727 |
| alpha | 0.5 | 0.5070 |
Los valores estimados no coincidirán exactamente con los verdaderos por la variación muestral. Debe diferenciarse esta discrepancia del error de optimización. Los errores estándar basados en la Hessiana requieren transformar correctamente la matriz de covarianzas desde los parámetros no restringidos y dependen de supuestos de regularidad; no los confundiremos con una incertidumbre bayesiana posterior.
10.8.4 Normalidad, cuasiverosimilitud y colas
La distribución normal de \(Z_t\) facilita la estimación, pero puede ser demasiado restrictiva para extremos. Si el modelo de varianza condicional es correcto y se cumplen las condiciones adecuadas, la maximización de la expresión gaussiana puede justificarse como cuasimáxima verosimilitud, aun cuando \(Z_t\) no sea normal. Esto no hace válidos automáticamente los errores estándar gaussianos usuales: pueden requerirse estimadores robustos (sandwich) y condiciones adicionales de momentos.
Una distribución Student-\(t\) para \(Z_t\), estandarizada para tener varianza uno, será una extensión útil, pero no es necesaria para comprender el mecanismo GARCH básico. Tampoco debemos interpretar un ajuste gaussiano como una garantía de cobertura correcta de intervalos de cola.
10.9 Identificación y diagnóstico
10.9.1 ¿Cómo detectar heterocedasticidad condicional?
La prueba ARCH-LM de Engle puede aplicarse a innovaciones de un modelo de media previamente ajustado. Su regresión auxiliar, para \(q\) rezagos, es
\[ \widehat\varepsilon_t^2 =c+\delta_1\widehat\varepsilon_{t-1}^2+\cdots +\delta_q\widehat\varepsilon_{t-q}^2+u_t. \tag{10.27}\]
La hipótesis nula es \(H_0:\delta_1=\cdots=\delta_q=0\). Bajo regularidad y bajo la hipótesis nula de ausencia de efectos ARCH de los órdenes considerados, el estadístico
\[ LM=n_* R^2\ \overset{d}{\longrightarrow}\ \chi_q^2, \tag{10.28}\]
con \(n_*\) observaciones útiles y \(R^2\) de la regresión auxiliar, tiene distribución asintótica chi-cuadrado con \(q\) grados de libertad. Se requiere cautela con muestras pequeñas, datos extremos y especificaciones incorrectas de la media. Rechazar \(H_0\) no demuestra que el verdadero modelo sea específicamente ARCH\((q)\).
r_ent <- retornos_dax$retorno[seq_len(n_entrenamiento)]
mu_ent <- mean(r_ent)
y_ent <- r_ent - mu_ent
stopifnot(all(is.finite(y_ent)), length(y_ent) == n_entrenamiento)

resultado_arch_lm <- prueba_arch_lm(y_ent, q = 10)
knitr::kable(resultado_arch_lm, digits = 4)| rezagos | estadistico | gl | valor_p |
|---|---|---|---|
| 10 | 51.6897 | 10 | 0 |
10.9.2 Ajuste de modelos a datos reales
Para hacer comparables las varianzas condicionales utilizaremos una media común \(\widehat\mu\) calculada exclusivamente en entrenamiento, y luego ajustaremos los modelos de varianza a los residuos centrados. Esta es una simplificación pedagógica de la estimación conjunta media–varianza; una aplicación avanzada debe reconsiderarla si la media condicional no es estable.
Estimaremos un ARCH\((1)\) y un GARCH\((1,1)\) gaussianos. rugarch nombra la familia estándar como sGARCH; con orden (1,0) obtenemos ARCH\((1)\) y con (1,1) obtenemos GARCH\((1,1)\).
ajuste_dax_arch <- ajustar_vol(y_ent, orden = c(1, 0))
ajuste_dax_garch <- ajustar_vol(y_ent, orden = c(1, 1))

stopifnot(
  length(as.numeric(rugarch::sigma(ajuste_dax_arch))) == length(y_ent),
  length(as.numeric(rugarch::sigma(ajuste_dax_garch))) == length(y_ent)
)

extraer_coeficientes <- function(ajuste, modelo) {
  cfs <- rugarch::coef(ajuste)
  tibble(modelo = modelo, parametro = names(cfs), estimado = as.numeric(cfs))
}

coeficientes_dax <- bind_rows(
  extraer_coeficientes(ajuste_dax_arch, "ARCH(1)"),
  extraer_coeficientes(ajuste_dax_garch, "GARCH(1,1)")
)

criterios_dax <- bind_rows(
  tibble(modelo = "ARCH(1)",
         AIC_por_obs = unname(as.numeric(rugarch::infocriteria(ajuste_dax_arch)[1])),
         BIC_por_obs = unname(as.numeric(rugarch::infocriteria(ajuste_dax_arch)[2]))),
  tibble(modelo = "GARCH(1,1)",
         AIC_por_obs = unname(as.numeric(rugarch::infocriteria(ajuste_dax_garch)[1])),
         BIC_por_obs = unname(as.numeric(rugarch::infocriteria(ajuste_dax_garch)[2])))
)knitr::kable(coeficientes_dax, digits = 5)| modelo | parametro | estimado |
|---|---|---|
| ARCH(1) | omega | 0.05731 |
| ARCH(1) | alpha1 | 0.87884 |
| GARCH(1,1) | omega | 0.07556 |
| GARCH(1,1) | alpha1 | 0.05102 |
| GARCH(1,1) | beta1 | 0.85696 |
knitr::kable(criterios_dax, digits = 5)| modelo | AIC_por_obs | BIC_por_obs |
|---|---|---|
| ARCH(1) | 4.81973 | 4.82687 |
| GARCH(1,1) | 2.59826 | 2.60896 |
Las estimaciones en Tabla 10.5 y los criterios en Tabla 10.6 se obtienen de un único período de entrenamiento. Interpretación: AIC o BIC más pequeños pueden favorecer un modelo en la muestra de entrenamiento, pero no sustituyen el diagnóstico ni la evaluación fuera de muestra. Los criterios se calculan para modelos estimados sobre la misma muestra, variable y definición de verosimilitud.
volatilidades_dax <- bind_rows(
  tibble(
    observacion = seq_len(n_entrenamiento),
    innovacion = y_ent,
    sigma = as.numeric(rugarch::sigma(ajuste_dax_arch)),
    modelo = "ARCH(1)"
  ),
  tibble(
    observacion = seq_len(n_entrenamiento),
    innovacion = y_ent,
    sigma = as.numeric(rugarch::sigma(ajuste_dax_garch)),
    modelo = "GARCH(1,1)"
  )
)

ggplot(volatilidades_dax, aes(observacion, innovacion)) +
  geom_ribbon(aes(ymin = -2 * sigma, ymax = 2 * sigma),
              inherit.aes = TRUE, fill = "#92c5de", alpha = 0.55) +
  geom_line(color = "#2166ac", linewidth = 0.23) +
  facet_wrap(~ modelo, ncol = 1) +
  labs(x = "Observación en entrenamiento", y = "Retorno centrado (%)",
       title = "Cambios en la escala condicional de las innovaciones") +
  tema_garch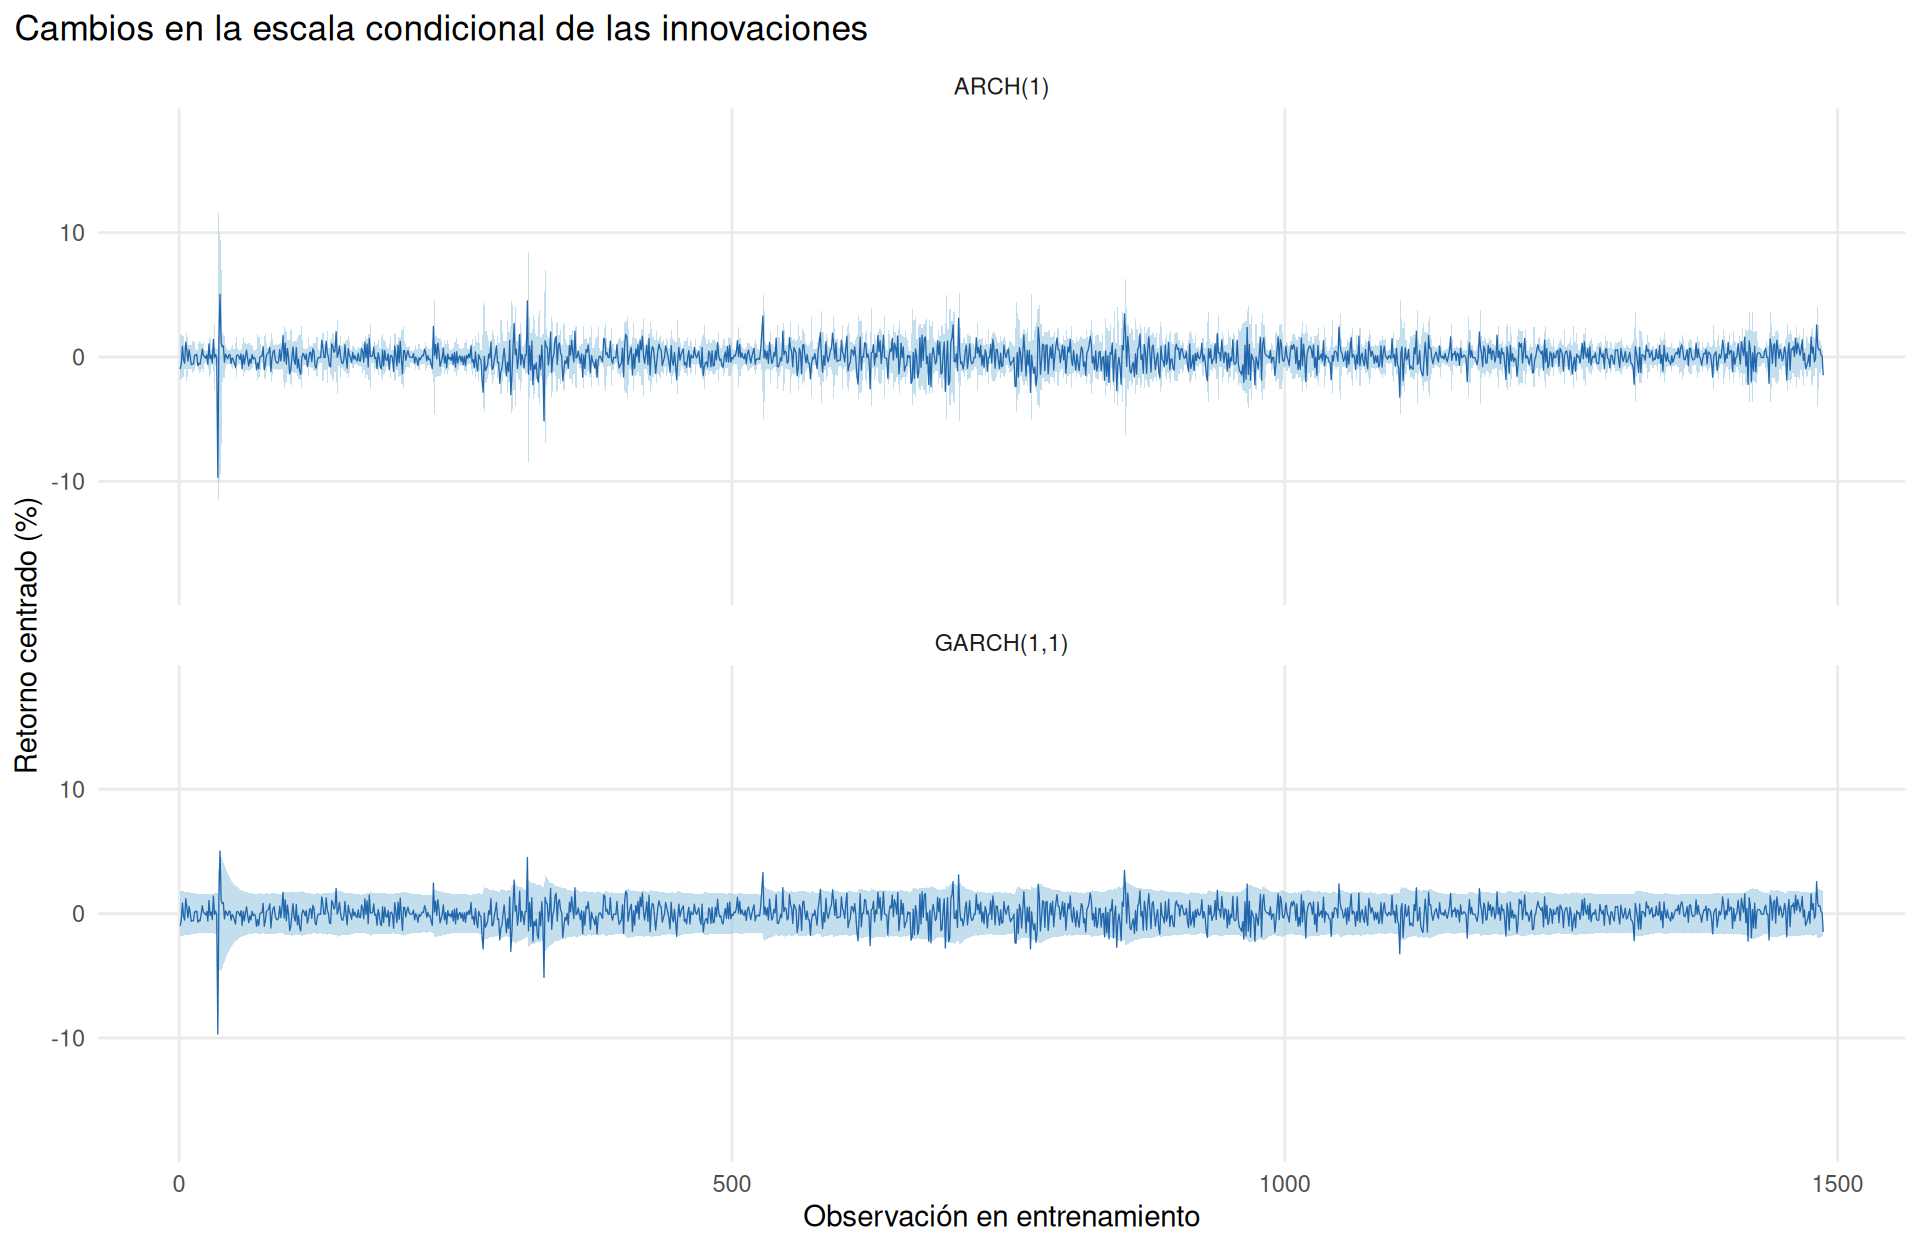
En Figura 10.6 las bandas resaltan el contraste entre modelos. Las bandas \(\pm2\widehat\sigma_t\) son una visualización descriptiva condicionada en parámetros estimados. No equivalen a intervalos predictivos de cobertura garantizada ni a intervalos de confianza para la trayectoria de volatilidad.
10.9.3 Innovaciones estandarizadas
En un modelo de varianza bien especificado, las innovaciones estandarizadas estimadas
\[ \widehat z_t=\frac{\widehat\varepsilon_t}{\widehat\sigma_t} \tag{10.29}\]
no deberían presentar patrones de dependencia sistemática ni en niveles ni en cuadrados, más allá de la variabilidad muestral. Examinaremos tres diagnósticos complementarios:
- ACF de \(\widehat z_t\) para dependencia residual en la media.
- ACF de \(\widehat z_t^2\) y prueba ARCH-LM para dependencia residual de segundo orden.
- Gráfico cuantil–cuantil para comprobar si la distribución normal describe adecuadamente las colas.
z_arch <- y_ent / as.numeric(rugarch::sigma(ajuste_dax_arch))
z_garch <- y_ent / as.numeric(rugarch::sigma(ajuste_dax_garch))
stopifnot(all(is.finite(z_arch)), all(is.finite(z_garch)))

diagnosticos_z <- bind_rows(
  tibble(modelo = "ARCH(1)", z = z_arch),
  tibble(modelo = "GARCH(1,1)", z = z_garch)
)

acf_estandarizados <- diagnosticos_z |>
  group_by(modelo) |>
  group_modify(~ tibble(
    rezago = rep(seq_len(25L), 2L),
    acf = c(
      as.numeric(stats::acf(.x$z, lag.max = 25, plot = FALSE)$acf)[-1],
      as.numeric(stats::acf(.x$z^2, lag.max = 25, plot = FALSE)$acf)[-1]
    ),
    variable = rep(c("Estandarizados", "Estandarizados al cuadrado"),
                   each = 25L)
  )) |>
ungroup()ggplot(acf_estandarizados, aes(rezago, acf)) +
geom_hline(yintercept = 0, color = "grey40") +
geom_segment(aes(xend = rezago, yend = 0), color = "#2166ac") +
facet_grid(modelo ~ variable) +
labs(x = "Rezago", y = "ACF muestral") +
tema_garch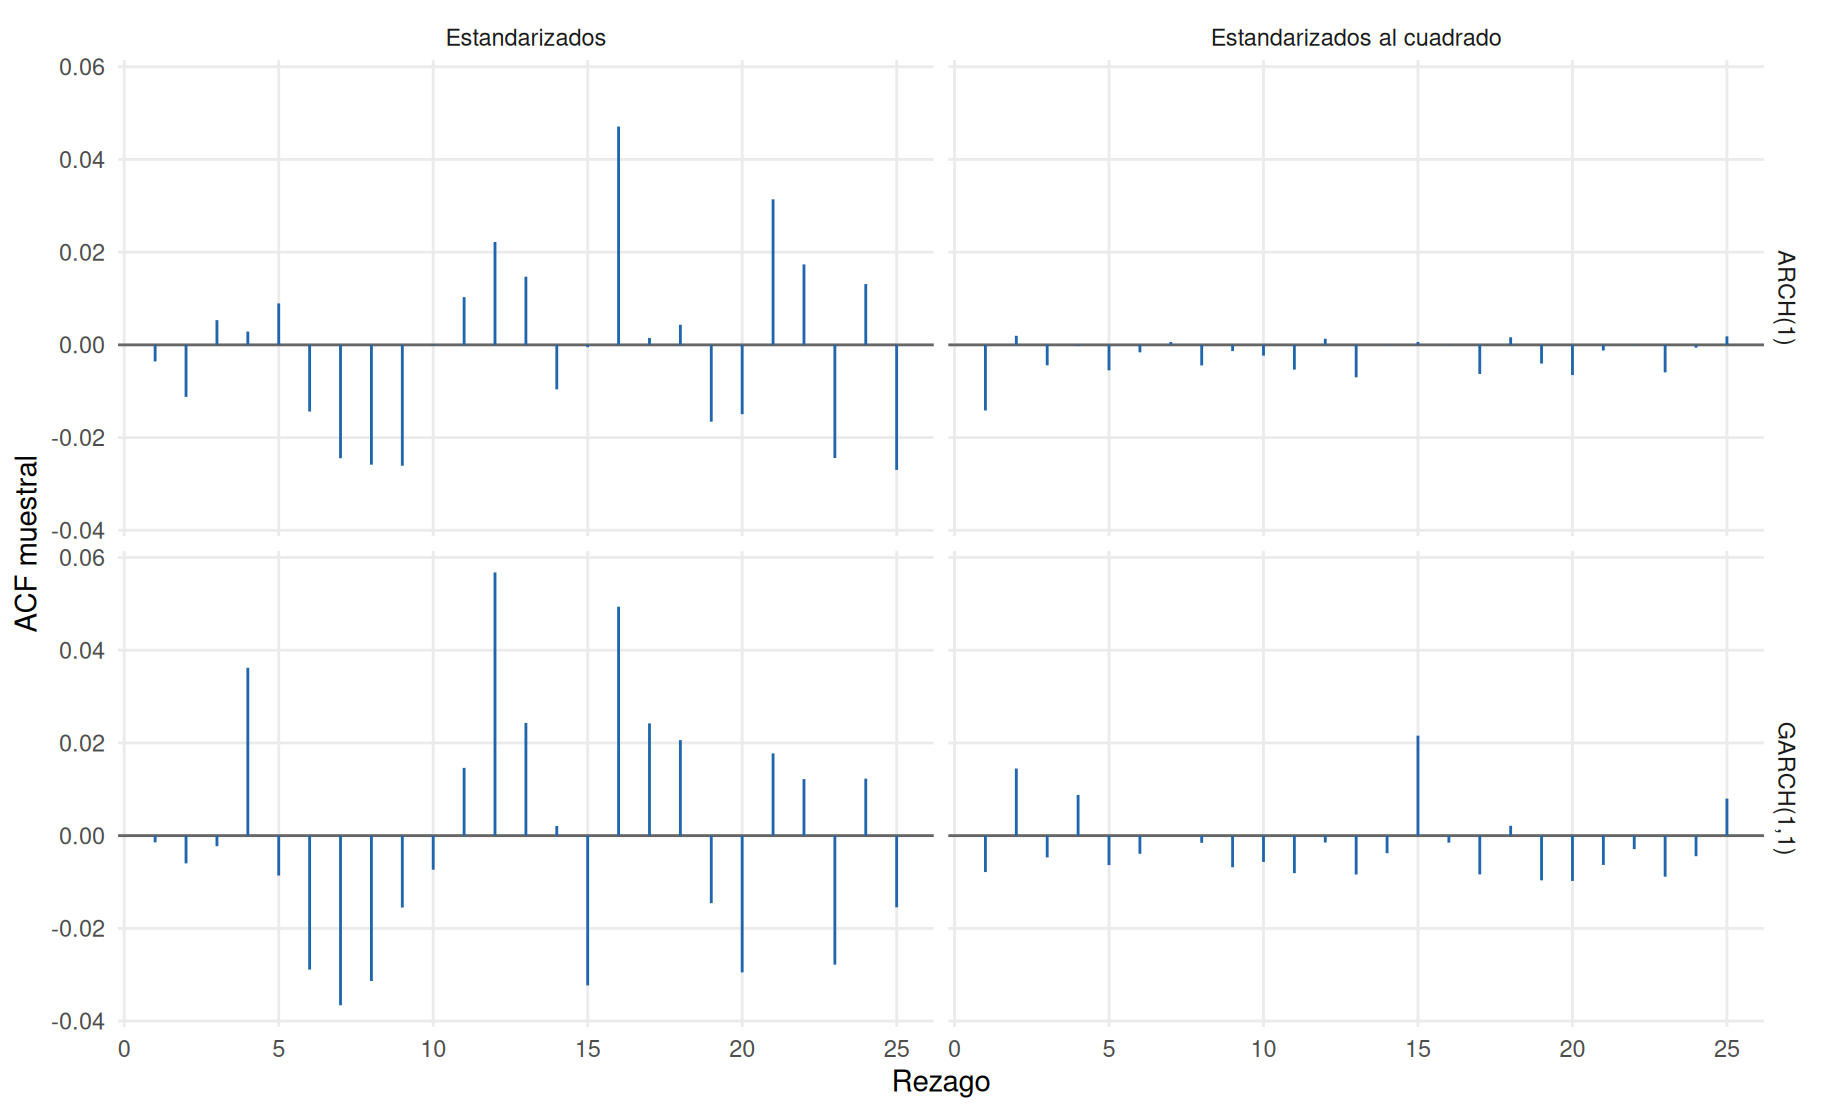
ggplot(diagnosticos_z, aes(sample = z)) +
  stat_qq(color = "#2166ac", alpha = 0.50) +
  stat_qq_line(color = "#b2182b") +
  facet_wrap(~ modelo) +
  labs(x = "Cuantil normal teórico", y = "Cuantil empírico",
       title = "La estandarización no garantiza normalidad") +
  tema_garch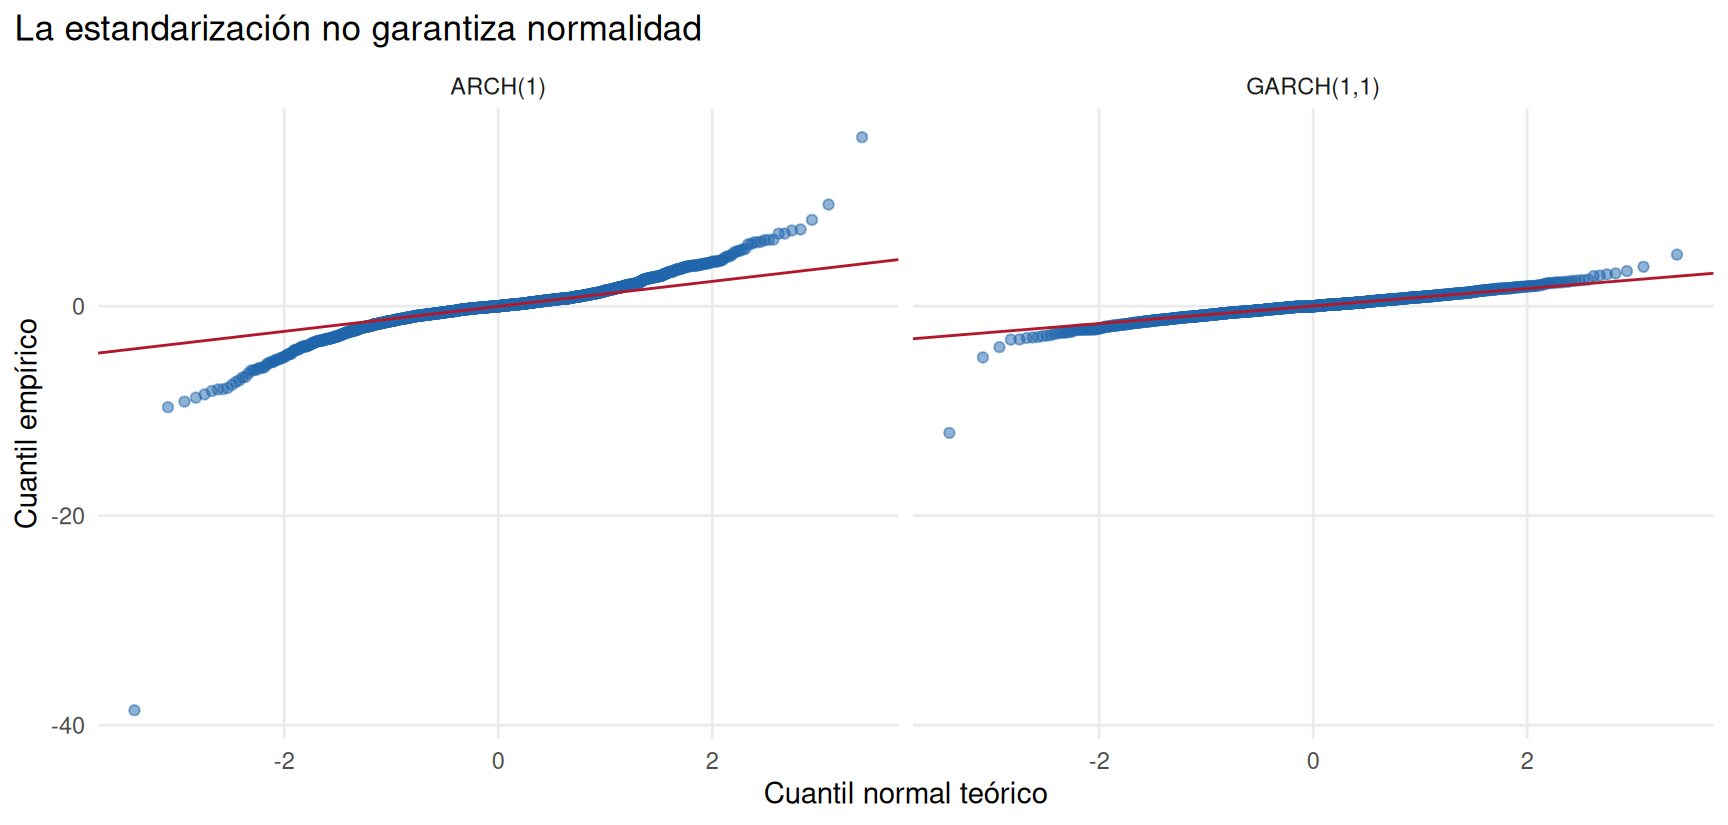
resultados_diagnostico <- diagnosticos_z |>
  group_by(modelo) |>
  group_modify(~ {
    z <- .x$z
    tibble(
      ARCH_LM_p = prueba_arch_lm(z, q = 10)$valor_p,
      Ljung_Box_z_p = Box.test(z, lag = 20, type = "Ljung-Box")$p.value,
      Ljung_Box_z2_p = Box.test(z^2, lag = 20, type = "Ljung-Box")$p.value
    )
  }) |>
  ungroup()

knitr::kable(resultados_diagnostico, digits = 4)| modelo | ARCH_LM_p | Ljung_Box_z_p | Ljung_Box_z2_p |
|---|---|---|---|
| ARCH(1) | 1 | 0.9819 | 1 |
| GARCH(1,1) | 1 | 0.3545 | 1 |
Los resultados de Figura 10.7, Figura 10.8 y Tabla 10.7 son complementarios. Estas pruebas son diagnósticos orientativos: sus valores \(p\) no incorporan automáticamente todas las consecuencias de estimar parámetros, seleccionar modelos o probar múltiples especificaciones. Conviene interpretarlas conjuntamente con los gráficos, no como un semáforo automático.
10.10 Pronósticos de varianza condicional
10.10.1 Un paso adelante
Con \(\mathcal F_T\) disponible y parámetros conocidos, el pronóstico a un paso de GARCH\((1,1)\) es directamente
\[ \widehat h_{T+1\mid T} =E(h_{T+1}\mid\mathcal F_T) =\omega+\alpha\varepsilon_T^2+\beta h_T. \tag{10.30}\]
A diferencia de \(\varepsilon_{T+1}^2\), \(h_{T+1}\) es conocido condicionalmente si se conocen los parámetros y el pasado. El valor observado de \(\varepsilon_{T+1}^2\), en cambio, sigue siendo aleatorio.
10.10.2 Varios pasos: esperanza condicional iterada
Para \(h\ge2\),
\[ \begin{aligned} \widehat h_{T+h\mid T} &=E(h_{T+h}\mid\mathcal F_T)\\ &=\omega+\alpha E(\varepsilon_{T+h-1}^2\mid\mathcal F_T) +\beta E(h_{T+h-1}\mid\mathcal F_T)\\ &=\omega+(\alpha+\beta)\widehat h_{T+h-1\mid T}, \end{aligned} \]
pues \(E(\varepsilon_s^2\mid\mathcal F_{s-1})=h_s\). Sea \(\lambda=\alpha+\beta<1\) y \(\bar h=\omega/(1-\lambda)\). Restando \(\bar h\) a ambos lados,
\[ \widehat h_{T+h\mid T}-\bar h =\lambda(\widehat h_{T+h-1\mid T}-\bar h). \]
Por inducción,
\[ \boxed{ \widehat h_{T+h\mid T} =\bar h+\lambda^{h-1} \left(\widehat h_{T+1\mid T}-\bar h\right), \quad h\ge1. } \tag{10.31}\]
La predicción de volatilidad a largo plazo revierte hacia el nivel \(\bar h\), en lugar de crecer indefinidamente cuando \(0\le\lambda<1\). La rapidez depende de \(\lambda\), no solo de \(\beta\).
Para \(0<\lambda<1\) puede definirse una semivida aproximada de la desviación del pronóstico:
\[ H_{1/2}=\frac{\log(1/2)}{\log\lambda}. \tag{10.32}\]
Esta cantidad mide pasos futuros hasta que la distancia pronosticada a \(\bar h\) se reduzca aproximadamente a la mitad. No es una semivida de la media del retorno.
10.10.3 Pronóstico de volatilidad frente a pronóstico de varianza
Conviene distinguir dos objetos:
\[ \widehat h_{T+h\mid T} =E(h_{T+h}\mid\mathcal F_T), \qquad \sqrt{\widehat h_{T+h\mid T}}. \]
La raíz de la varianza esperada no es, en general, la esperanza de la desviación estándar futura:
\[ E(\sqrt{h_{T+h}}\mid\mathcal F_T) \neq\sqrt{E(h_{T+h}\mid\mathcal F_T)}. \]
Por la concavidad de la raíz cuadrada, el lado izquierdo es menor o igual al derecho. Muchas interfaces de pronóstico reportan \(\sqrt{\widehat h}\) como medida de escala futura. Interpretaremos cuidadosamente qué objeto devuelven.
10.10.4 Ejemplo analítico: persistencia
Considere \(\omega=0.08\), \(\alpha=0.10\), \(\beta=0.85\), por lo que \(\lambda=0.95\) y \(\bar h=1.6\). Si el pronóstico inicial es \(\widehat h_{T+1\mid T}=3\), entonces
\[ \widehat h_{T+h\mid T} =1.6+0.95^{h-1}(3-1.6). \]
trayectorias_pronostico <- tidyr::crossing(
  horizonte = 1:50,
  persistencia = c(0.60, 0.85, 0.95)
) |>
  mutate(
    varianza_largo_plazo = 1.6,
    varianza_inicial = 3,
    varianza_pronosticada = varianza_largo_plazo +
      persistencia^(horizonte - 1) *
      (varianza_inicial - varianza_largo_plazo),
    escenario = paste0("alfa + beta = ", persistencia)
  )

ggplot(trayectorias_pronostico,
       aes(horizonte, varianza_pronosticada, color = escenario)) +
  geom_line(linewidth = 0.9) +
  geom_hline(yintercept = 1.6, linetype = "dashed") +
  labs(x = "Horizonte", y = "Varianza condicional pronosticada",
       color = "Persistencia") +
  tema_garch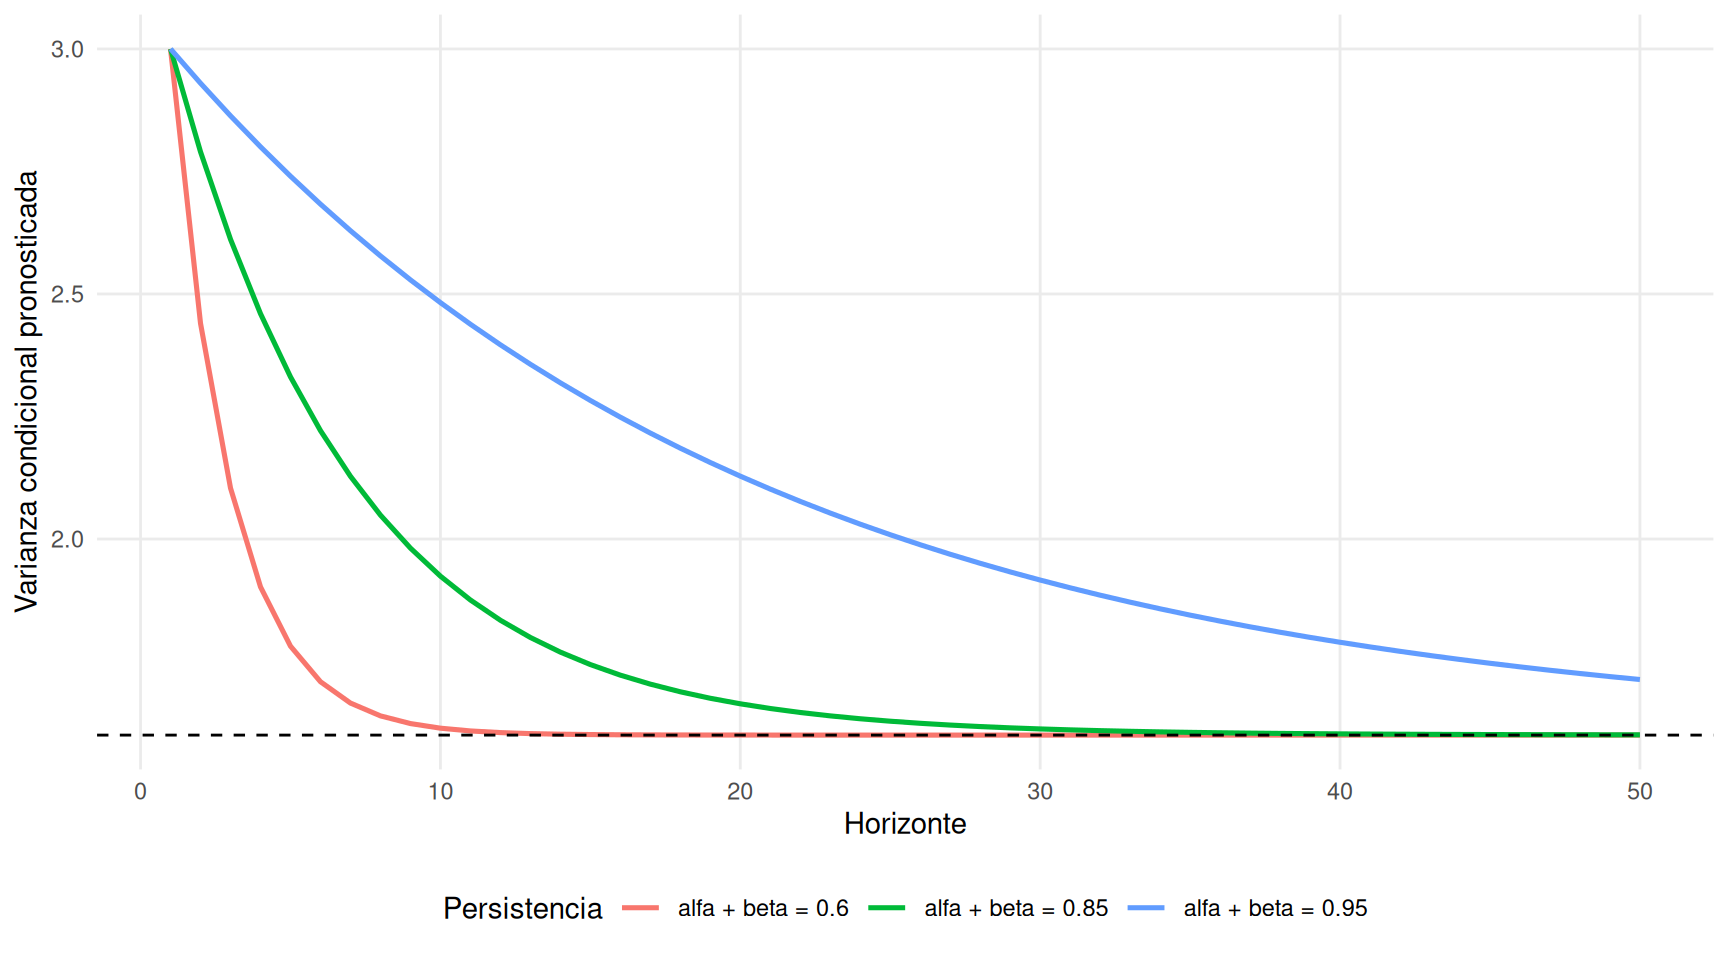
La fórmula supone parámetros conocidos. Si los parámetros se estiman, sustituirlos por sus estimadores es una predicción por sustitución (plug-in). La incertidumbre de estimación puede importar, especialmente para horizontes largos o muestras pequeñas; los intervalos que ignoran esa incertidumbre pueden ser demasiado estrechos.
10.11 Evaluación fuera de muestra
10.11.1 ¿Qué significa evaluar una varianza no observada?
La varianza condicional verdadera \(h_t\) no se registra directamente en la serie de retornos. En una aplicación diaria sencilla utilizaremos la variable
\[ v_{t\mid o}=(r_t-\widehat\mu_o)^2, \tag{10.33}\]
como aproximación observable para evaluar el pronóstico de varianza emitido en el origen \(o<t\). En un modelo con media condicional correctamente especificada, el cuadrado de la innovación tiene esperanza condicional igual a la varianza, pero su realización individual puede diferir considerablemente de ella. En nuestro experimento \(\widehat\mu_o\) será la media estimada con las observaciones disponibles hasta \(o\) y se mantendrá fija en la comparación de los modelos de varianza para ese origen.
La comparación de pérdidas debe reconocer este ruido de medición. Para series de alta frecuencia se podrían considerar medidas realizadas construidas a partir de retornos intradiarios, pero tales datos no están disponibles en EuStockMarkets.
10.11.2 Funciones de pérdida
Utilizaremos dos pérdidas para pronósticos de varianza \(\widehat v_t>0\):
\[ L_{\mathrm{EC}}(v_t,\widehat v_t) =(v_t-\widehat v_t)^2, \tag{10.34}\]
\[ L_{\mathrm{QLIKE}}(v_t,\widehat v_t) =\log\widehat v_t+\frac{v_t}{\widehat v_t}. \tag{10.35}\]
Existen distintas expresiones equivalentes de la función de pérdida QLIKE. Una versión normalizada, definida para \(v_t>0\) y \(\widehat v_t>0\), es
\[ L_{\mathrm{norm}}(v_t,\widehat v_t) = \frac{v_t}{\widehat v_t} - \log\left(\frac{v_t}{\widehat v_t}\right)-1. \]
Esta expresión se relaciona con la versión utilizada anteriormente mediante
\[ L_{\mathrm{norm}}(v_t,\widehat v_t) = L_{\mathrm{QLIKE}}(v_t,\widehat v_t)-\log(v_t)-1, \]
Por tanto, ambas funciones difieren únicamente en un término que depende del valor objetivo \(v_t\), pero no del pronóstico \(\widehat v_t\).
En consecuencia, cuando varios modelos se evalúan sobre exactamente las mismas observaciones objetivo, ambas versiones producen la misma clasificación de los modelos según su pérdida promedio, aunque los valores numéricos de las pérdidas sean distintos. Esto ocurre porque el término \(-\log(v_t)-1\) es idéntico para todos los modelos y se cancela al calcular las diferencias de pérdidas.
La versión normalizada tiene además la propiedad
\[ L_{\mathrm{norm}}(v_t,\widehat v_t)\geq 0, \]
con igualdad si y solo si \(\widehat v_t=v_t\).
Por otra parte, la versión no normalizada tiene la ventaja de permanecer definida cuando \(v_t=0\), siempre que \(\widehat v_t>0\). Esta característica resulta útil cuando se utilizan los retornos al cuadrado como aproximación observable de la varianza condicional.
QLIKE penaliza de forma marcada los pronósticos de varianza demasiado pequeños frente a una realización grande. Sus valores no deben compararse como si fueran un RMSE ni interpretarse directamente como una probabilidad.
En particular, no aplicaremos MAE, RMSE o MASE a \(\widehat v_t\) con la misma interpretación que tienen al pronosticar directamente \(r_t\). Si se desean medidas de varianza cuadrática, se debe declarar la variable objetivo y las unidades: \(v_t\) y \(\widehat v_t\) están en puntos porcentuales al cuadrado.
10.11.3 Diseño temporal y referencia
La comparación seguirá Sección 7.2.1 y Sección 7.4:
- Reservaremos la parte final de la serie para evaluación.
- Para cada origen se recalculará la media con los datos disponibles hasta ese instante.
- Se ajustarán nuevamente ARCH\((1)\) y GARCH\((1,1)\) utilizando solo esos datos.
- Se emitirán pronósticos para horizontes \(h=1\) y \(h=5\).
- Los tres métodos usarán exactamente las mismas observaciones objetivo.
El método de referencia será una varianza constante estimada mediante la media de los cuadrados de retornos centrados de la ventana de entrenamiento. No pretende modelar agrupamiento de volatilidad, pero ofrece un contraste interpretable.
Para controlar el tiempo de cálculo en el libro, utilizaremos un conjunto moderado de orígenes expansivos espaciados. La selección de orígenes está fijada antes de conocer los errores, no depende del desempeño. Este es un ejemplo pedagógico; un estudio aplicado más exhaustivo debería ampliar el período de prueba y la densidad de orígenes, y estudiar sensibilidad temporal.
r_total <- retornos_dax$retorno
n_total <- length(r_total)
horizontes <- c(1L, 5L)

# Hasta nueve orígenes distintos dentro del último 20% de la serie.
# La primera estimación utiliza aproximadamente el 80% inicial.
origen_inicial <- n_entrenamiento
origen_final <- n_total - max(horizontes)
origenes <- unique(as.integer(round(seq(
  from = origen_inicial,
  to = origen_final,
  length.out = 9L
))))
stopifnot(all(origenes >= 100L), all(origenes + max(horizontes) <= n_total))

pronosticar_en_origen <- function(origen) {
  r_train <- r_total[seq_len(origen)]
  media_train <- mean(r_train)
  y_train <- r_train - media_train
  var_referencia <- mean(y_train^2)

  # El ajuste y la selección de modelos no incorporan observaciones
  # posteriores al origen.
  fit_arch <- ajustar_vol(y_train, orden = c(1, 0))
  fit_garch <- ajustar_vol(y_train, orden = c(1, 1))

  fc_arch <- rugarch::ugarchforecast(fit_arch, n.ahead = max(horizontes))
  fc_garch <- rugarch::ugarchforecast(fit_garch, n.ahead = max(horizontes))
  var_arch <- as.numeric(rugarch::sigma(fc_arch))^2
  var_garch <- as.numeric(rugarch::sigma(fc_garch))^2
  stopifnot(
    length(var_arch) == max(horizontes),
    length(var_garch) == max(horizontes),
    all(is.finite(c(var_arch, var_garch))),
    all(c(var_arch, var_garch) > 0)
  )

  purrr::map_dfr(horizontes, function(h) {
    observado <- r_total[origen + h]
    objetivo <- (observado - media_train)^2
    tibble(
      origen = origen,
      horizonte = h,
      destino = origen + h,
      retorno_observado = observado,
      media_pronosticada = media_train,
      proxy_varianza = objetivo,
      modelo = c("Varianza constante", "ARCH(1)", "GARCH(1,1)"),
      varianza_pronosticada = c(var_referencia, var_arch[h], var_garch[h])
    )
  })
}

pronosticos_validacion <- purrr::map_dfr(origenes, pronosticar_en_origen) |>
  mutate(
    error_cuadratico = (proxy_varianza - varianza_pronosticada)^2,
    qlike = log(varianza_pronosticada) +
      proxy_varianza / varianza_pronosticada
  )

stopifnot(
  !anyNA(pronosticos_validacion),
  nrow(pronosticos_validacion) ==
    length(origenes) * length(horizontes) * 3L
)

# Comparación justa: los modelos deben compartir cada par origen-horizonte-destino.
comparabilidad <- pronosticos_validacion |>
  count(origen, horizonte, destino)
stopifnot(all(comparabilidad$n == 3L))

resumen_validacion <- pronosticos_validacion |>
  group_by(modelo, horizonte) |>
  summarise(
    origenes = n(),
    ECM_varianza = mean(error_cuadratico),
    QLIKE = mean(qlike),
    .groups = "drop"
)knitr::kable(resumen_validacion, digits = 4)| modelo | horizonte | origenes | ECM_varianza | QLIKE |
|---|---|---|---|---|
| ARCH(1) | 1 | 9 | 10.7519 | 1.8749 |
| ARCH(1) | 5 | 9 | 22.2480 | 2.5554 |
| GARCH(1,1) | 1 | 9 | 5.4601 | 1.4609 |
| GARCH(1,1) | 5 | 9 | 17.6293 | 1.6211 |
| Varianza constante | 1 | 9 | 5.0175 | 1.4625 |
| Varianza constante | 5 | 9 | 20.6438 | 2.3554 |
ggplot(resumen_validacion,
       aes(x = modelo, y = QLIKE, fill = modelo)) +
  geom_col(width = 0.68) +
  facet_wrap(~ horizonte, labeller = label_both, scales = "free_y") +
  scale_fill_manual(values = c(
    "Varianza constante" = "#999999",
    "ARCH(1)" = "#2166ac",
    "GARCH(1,1)" = "#b2182b"
  )) +
  labs(x = NULL, y = "QLIKE promedio", title = "Comparación predictiva por horizonte") +
  tema_garch +
  theme(axis.text.x = element_text(angle = 20, hjust = 1),
        legend.position = "none")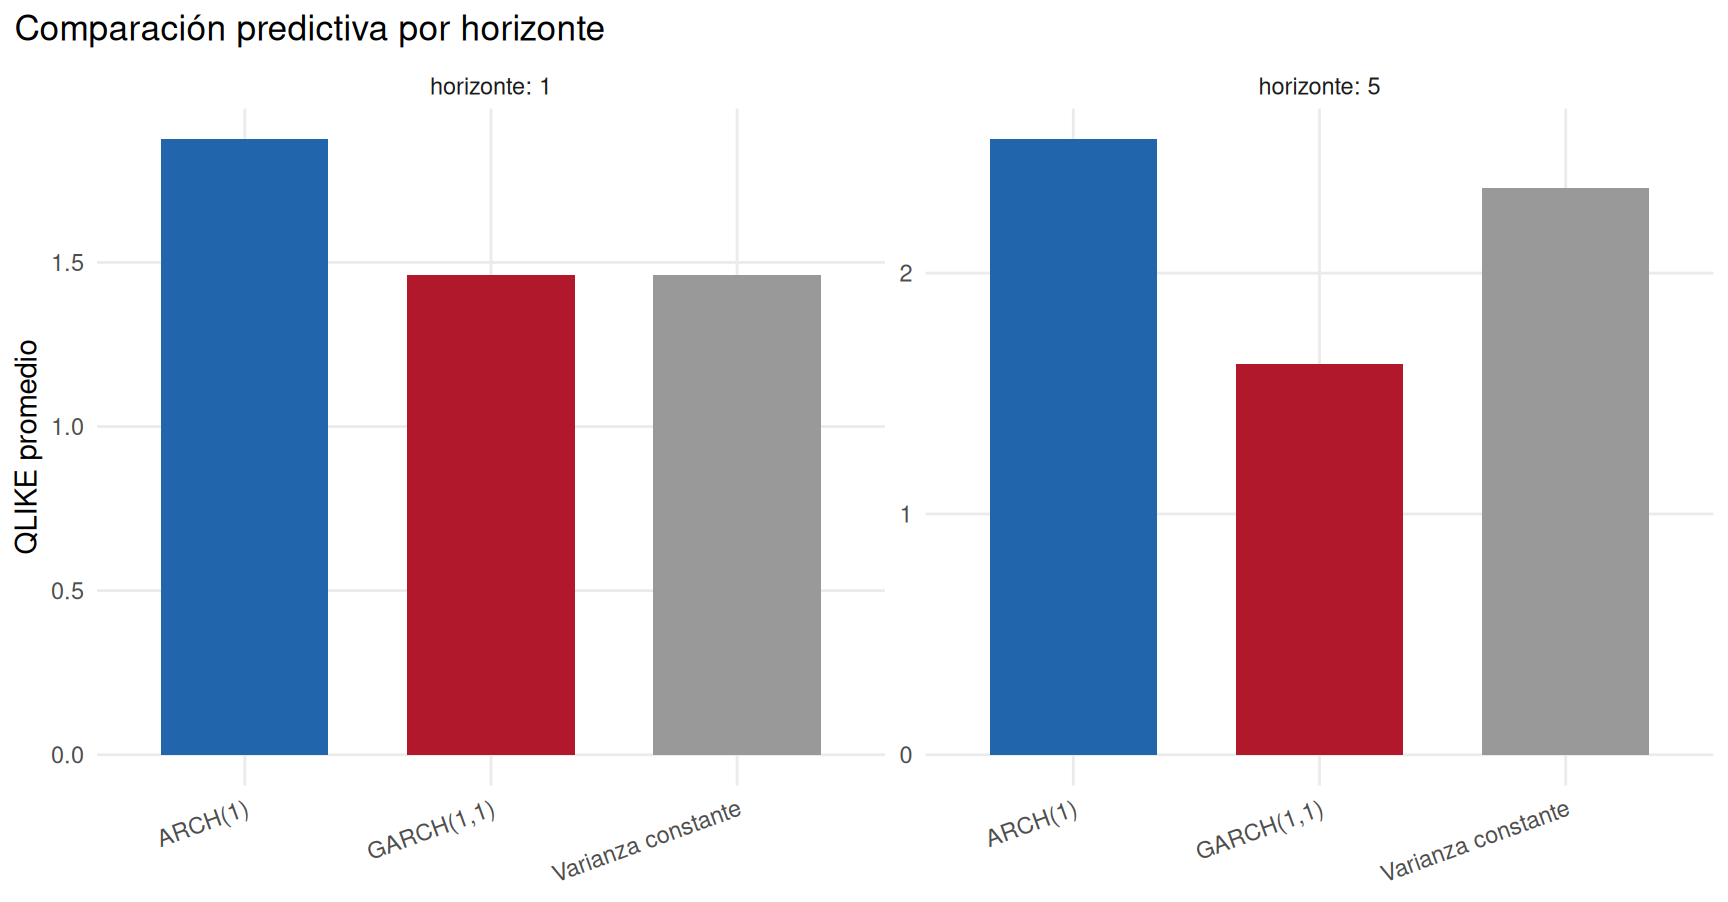
El resumen numérico aparece en Tabla 10.8 y su visualización en Figura 10.10. Es posible que un modelo gane en un horizonte y pierda en otro. También es posible que ARCH o GARCH no mejoren la referencia: ese resultado no es un error de la metodología, sino información sobre el desempeño en los orígenes y la serie estudiados. La comparación está condicionada por el tamaño del conjunto de prueba, el tipo de aproximación de varianza realizada y la familia de modelos candidata.
10.11.4 ¿Qué sucede con los intervalos predictivos?
Si se supone normalidad condicional y una media prevista \(\widehat\mu_{T+1\mid T}\), un intervalo predictivo por sustitución a un paso, de nivel aproximado \(1-\gamma\), es
\[ \widehat\mu_{T+1\mid T} \ \pm\ z_{1-\gamma/2}\sqrt{\widehat h_{T+1\mid T}}. \tag{10.36}\]
Para \(h>1\) la distribución predictiva puede ser una mezcla sobre trayectorias futuras de varianza condicional, incluso con parámetros conocidos; por tanto, no debemos presentar sin justificación una distribución normal con varianza igual a \(E(h_{T+h}\mid\mathcal F_T)\) como la distribución predictiva exacta a varios pasos. Una alternativa es simular conjuntamente los choques futuros y las varianzas futuras, y calcular cuantiles de los retornos simulados.
10.12 Perspectivas frecuentista y bayesiana
El procedimiento utilizado fue frecuentista: condicionamos en parámetros desconocidos, los estimamos por máxima verosimilitud y calculamos \(\widehat h_{T+h\mid T}\) al sustituir los parámetros estimados. En una formulación bayesiana se especificarían prioris para parámetros positivos y para los que gobiernan la persistencia; luego se integraría sobre su distribución posterior. Conceptualmente,
\[ p(r_{T+h}\mid r_{1:T}) =\int p(r_{T+h}\mid r_{1:T},\boldsymbol\theta) \,p(\boldsymbol\theta\mid r_{1:T})\,d\boldsymbol\theta. \tag{10.37}\]
Para varios pasos, la distribución dentro de la integral también incorpora las posibles trayectorias intermedias de retornos y varianzas. Una simulación posterior predictiva debe respetar esas dependencias. Las restricciones de positividad y estacionariedad también deben considerarse al definir las prioris; asignar distribuciones independientes arbitrarias a parámetros sin transformación puede generar regiones inadmisibles.
No desarrollaremos un muestreador MCMC para GARCH en esta semana. La inferencia bayesiana computacional para estados latentes se estudiará con mayor profundidad después de introducir los modelos de espacio-estado.
10.13 Puente hacia volatilidad estocástica
Un modelo de volatilidad estocástica (SV) usual representa directamente la log-varianza mediante un proceso latente, por ejemplo (Prado et al. 2021, sec. 7.5; Shumway y Stoffer 2025, sec. 6.12):
\[ \begin{aligned} R_t&=\exp(H_t/2)Z_t,\\ H_t&=\mu_H+\phi(H_{t-1}-\mu_H)+\eta_t, \end{aligned} \tag{10.38}\]
con \(|\phi|<1\) en el caso estacionario y con \(Z_t\) y \(\eta_t\) sujetos a hipótesis probabilísticas adicionales, habitualmente innovaciones gaussianas independientes. Aquí \(H_t\) es un estado latente, no simplemente una función recursiva de los retornos observados.
comparacion_sv <- tibble(
  Aspecto = c("Dinámica de volatilidad", "Incertidumbre de estado",
              "Inferencia usual", "Pronóstico"),
  `GARCH(1,1)` = c(
    "Recursión de cuadrados y varianzas pasadas",
    "Varianza determinada por datos pasados y parámetros conocidos",
    "Máxima verosimilitud o métodos bayesianos",
    "Recursión de esperanza condicional"
  ),
  `Volatilidad estocástica` = c(
    "Proceso estocástico para la log-varianza latente",
    "Estado no observado con innovación propia",
    "Filtrado, suavizamiento y MCMC, entre otros",
    "Integración sobre estados y parámetros"
  )
)
knitr::kable(comparacion_sv)| Aspecto | GARCH(1,1) | Volatilidad estocástica |
|---|---|---|
| Dinámica de volatilidad | Recursión de cuadrados y varianzas pasadas | Proceso estocástico para la log-varianza latente |
| Incertidumbre de estado | Varianza determinada por datos pasados y parámetros conocidos | Estado no observado con innovación propia |
| Inferencia usual | Máxima verosimilitud o métodos bayesianos | Filtrado, suavizamiento y MCMC, entre otros |
| Pronóstico | Recursión de esperanza condicional | Integración sobre estados y parámetros |
Esta distinción anticipa el filtro de Kalman y los modelos de espacio-estado de las semanas 11–13, pero el modelo SV no es lineal gaussiano en la ecuación de observación usual. Su inferencia requiere métodos adicionales, que retomaremos en la semana 15.
10.14 Síntesis
Los modelos estudiados permiten comprender cuatro ideas que conviene mantener separadas:
- No correlación no implica independencia: un retorno puede ser impredecible en media y predecible en varianza.
- La estación de segundo orden no describe toda la dinámica: un ARCH o GARCH puede tener varianza marginal constante y varianza condicional cambiante.
- Las condiciones sobre momentos son diferentes: positividad, estacionariedad estricta, varianza finita y cuarto momento finito no son sinónimos.
- El pronóstico requiere evaluación genuina: un modelo más flexible puede ofrecer mejor descripción de heterocedasticidad dentro de muestra y aun así no mejorar a un método simple fuera de muestra.
El itinerario de este capítulo fue
\[ \boxed{ \text{retornos} \longrightarrow \text{dependencia de cuadrados} \longrightarrow \text{ARCH/GARCH} \longrightarrow \text{estimación} \longrightarrow \text{diagnóstico} \longrightarrow \text{pronóstico de varianza} \longrightarrow \text{evaluación temporal} }. \]
10.15 Actividad computacional guiada
Utilizando la función simular_garch(), compare dos modelos GARCH\((1,1)\) que tengan la misma suma \(\alpha+\beta\) pero distinta composición entre \(\alpha\) y \(\beta\). Mantenga también la misma varianza marginal. Para cada modelo:
- simule varias trayectorias con semillas distintas y compare su concentración de episodios extremos;
- represente la ACF de los cuadrados y examine si difiere aunque la suma \(\alpha+\beta\) sea igual;
- calcule la curtosis empírica de las innovaciones y verifique si existe teóricamente el cuarto momento;
- ajuste un GARCH\((1,1)\) a una de las series y evalúe la sensibilidad de las estimaciones al tamaño de muestra;
- estime pronósticos a horizontes \(1\) y \(5\) utilizando el modelo correcto y una referencia de varianza constante.
Discuta si una única trayectoria basta para obtener conclusiones generales sobre la superioridad predictiva del modelo.
10.16 Ejercicios
Ejercicio 1. Dependencia condicional. Sea \(\varepsilon_t=\sqrt{h_t}Z_t\) con \(E(Z_t\mid\mathcal F_{t-1})=0\), \(E(Z_t^2\mid\mathcal F_{t-1})=1\) y \(h_t\) medible respecto de \(\mathcal F_{t-1}\). Demuestre que \(E(\varepsilon_t\mid\mathcal F_{t-1})=0\). Indique qué hipótesis adicionales se requieren para justificar que \(\operatorname{Cov}(\varepsilon_t,\varepsilon_{t-k})=0\) y explique por qué esto no implica independencia.
Ejercicio 2. Momentos de ARCH\((1)\). Para el modelo de Ecuación 10.8 con innovaciones gaussianas, derive el segundo y cuarto momento de \(\varepsilon_t\). Determine los valores de \(\alpha\) que hacen finito cada momento. Explique el comportamiento de la curtosis cuando \(\alpha\) se aproxima a \(1/\sqrt{3}\) desde abajo.
Ejercicio 3. Estacionariedad estricta. Considere la ecuación aleatoria Ecuación 10.10. Explique qué controla la condición \(E\{\log(\alpha Z_t^2)\}<0\) y por qué es distinta de \(\alpha<1\). Discuta qué puede afirmarse de la varianza cuando \(\alpha\ge1\).
Ejercicio 4. Representación ARMA. Partiendo de GARCH\((1,1)\), demuestre Ecuación 10.22. ¿Qué propiedades posee \(u_t\)? ¿Sería correcto considerar que \(u_t\) es iid gaussiano? Justifique.
Ejercicio 5. Persistencia de GARCH. Considere dos modelos con \(\bar h=1\) y parámetros \((\alpha,\beta)=(0.05,0.90)\) y \((0.20,0.75)\). Compare la reversión de sus pronósticos a largo plazo. ¿Tendrán idéntica distribución de trayectorias de \(h_t\)? Explique por qué la suma \(\alpha+\beta\) no determina todos los aspectos de la dinámica.
Ejercicio 6. Prueba ARCH-LM. Simule un proceso iid normal y un ARCH\((1)\) con la misma varianza incondicional. Compare las tasas de rechazo de la prueba ARCH-LM sobre numerosas repeticiones, al nivel nominal de \(5\%\). Distinga tasa de rechazo bajo la nula de potencia bajo la alternativa; examine la sensibilidad al tamaño muestral.
Ejercicio 7. Inferencia numérica. Modifique la función neg_loglik_arch1() para registrar los valores de la función objetivo en una cuadrícula de \(\alpha\) y \(\omega\). Identifique regiones donde la superficie sea relativamente plana y discuta las consecuencias para el error de estimación y la predicción.
Ejercicio 8. Diagnóstico financiero. Para los retornos DAX, contraste ARCH\((1)\), GARCH\((1,1)\) y una varianza constante usando exactamente el mismo entrenamiento. Compare ACF de innovaciones estandarizadas, ACF de cuadrados, ARCH-LM y un gráfico cuantil–cuantil. ¿Qué aspectos de los datos quedan insuficientemente explicados?
Ejercicio 9. Evaluación fuera de muestra. Repita la validación cambiando la cantidad de orígenes y el horizonte. Compare ECM y QLIKE. ¿Se mantiene el mismo orden entre modelos? Discuta por qué no se debe afirmar una superioridad general a partir de un solo período de evaluación.
Ejercicio 10. Transición hacia SV. Explique por qué en el modelo Ecuación 10.38 no es posible reconstruir exactamente \(H_t\) a partir de los retornos observados, incluso suponiendo conocidos los parámetros. ¿Qué cantidad probabilística reemplazaría a un único valor de varianza filtrada?
10.17 Lecturas recomendadas
- (Shumway y Stoffer 2025, sec. 5.3): motivación financiera, modelos ARCH/GARCH, estimación, aplicaciones y pronóstico. Es la referencia principal de esta semana.
- (Shumway y Stoffer 2025, sec. 6.12): contraste con volatilidad estocástica y estimación clásica y bayesiana de modelos de espacio-estado.
- (Prado et al. 2021, sec. 7.5): modelo de volatilidad estocástica con log-volatilidad latente, inferencia y métodos computacionales; lectura de preparación para la semana 15.
- (Hyndman y Athanasopoulos 2021, secs. 5.8–5.10): evaluación de pronósticos, predicción distribucional y validación temporal. Las pérdidas específicas para pronosticar varianza que se exponen aquí constituyen una ampliación orientada a volatilidad.
En la próxima semana formularemos los modelos de espacio-estado y el filtro de Kalman. El vínculo conceptual es que la variación temporal de una distribución condicional puede modelarse mediante distintas arquitecturas: una recursión observable como GARCH o un proceso de estados no observados como los modelos dinámicos que estudiaremos a continuación.