logistica_s8 <- tibble(
  eta = seq(-6, 6, length.out = 500),
  p = plogis(eta)
)8 Semana 8. Modelos multinivel para respuestas binarias
SP-1653 Modelos Mixtos
8.1 Panorama de la semana
Durante las primeras siete semanas trabajamos con una idea que se repetirá a lo largo del curso: cuando las observaciones están agrupadas, una parte de la variación puede representarse mediante coeficientes que cambian entre grupos y una distribución poblacional que los conecta. Hasta ahora la respuesta ha sido principalmente continua. Esta semana cambia la capa observacional, pero no desaparece la estructura multinivel.
La pregunta orientadora es:
¿Cómo modelamos una probabilidad cuando las respuestas son binarias y, al mismo tiempo, existe heterogeneidad entre grupos?
Una respuesta binaria solo puede tomar dos valores. Podemos codificar, por ejemplo, éxito/fracaso como \(1/0\), presencia/ausencia como \(1/0\) o elección A/B como \(1/0\). En estos problemas una regresión gaussiana no es una descripción probabilística natural: puede producir valores esperados menores que 0 o mayores que 1 y supone una estructura de varianza que no corresponde a una variable Bernoulli. La regresión logística resuelve este problema al modelar una probabilidad \(p_i\) mediante un predictor lineal transformado con el enlace logit (Gelman y Hill 2007, chap. 5; McElreath 2020, secs. 10.2, 11.1).
El paso multinivel consiste en permitir que uno o más coeficientes de ese predictor lineal cambien entre grupos. Por ejemplo,
\[ y_{ij}\mid p_{ij}\sim\operatorname{Bernoulli}(p_{ij}), \]
\[ \operatorname{logit}(p_{ij}) = \alpha_j+\beta x_{ij}, \]
\[ \alpha_j\mid\mu_\alpha,\tau_\alpha \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \tag{8.1}\]
Gelman y Hill presentan la extensión multinivel de la regresión logística con la misma lógica utilizada para los modelos lineales multinivel: los coeficientes se organizan en conjuntos y se asigna una distribución poblacional a cada conjunto (Gelman y Hill 2007, chap. 14). Hox, Moerbeek y van de Schoot expresan la misma idea desde el marco de los GLMM: la distribución de la respuesta y la función de enlace cambian, mientras la estructura multinivel aparece dentro del predictor lineal (Hox et al. 2018, chap. 6).
Hay, sin embargo, una diferencia interpretativa fundamental respecto de la regresión lineal. El predictor lineal vive en la escala de log-odds, mientras que la cantidad sustantiva de mayor interés suele ser una probabilidad. Debido a que la transformación logística es no lineal, un cambio de una unidad en un predictor no genera una diferencia constante en probabilidad. McElreath enfatiza precisamente que la misma diferencia en el predictor lineal se comprime cerca de probabilidades 0 y 1 y produce cambios mayores alrededor de 0.5 (McElreath 2020, 316-20).
Por eso, aunque aprenderemos a interpretar log-odds y odds ratios, la interpretación principal de esta unidad se hará mediante:
- probabilidades posteriores;
- diferencias de probabilidades;
- curvas predictivas;
- distribuciones predictivas de resultados binarios;
- predicciones para grupos existentes y nuevos.
La secuencia conceptual de la semana será:
\[ \boxed{ \text{Bernoulli/binomial} \longrightarrow \text{logit} \longrightarrow \text{estructura multinivel} \longrightarrow \text{posterior} \longrightarrow \text{probabilidades y predicción} } \]
La comprobación predictiva seguirá siendo transversal. Una buena mezcla de las cadenas no garantiza que el modelo reproduzca la heterogeneidad entre personas, ítems u otros grupos. A la vez, una comprobación predictiva favorable no sustituye los diagnósticos computacionales de la semana 7. Estas dos preguntas deben mantenerse separadas.
NotaConvención de fuentes y elaboración
Las formulaciones y discusiones conceptuales de esta unidad se apoyan principalmente en Gelman y Hill, McElreath, Hox et al., Bayesian Workflow y Bürkner. Las simulaciones, figuras y decisiones de implementación en R que se presentan como laboratorio son elaboraciones pedagógicas originales para el curso, construidas para ilustrar esas ideas sin reproducir extensamente los ejemplos de los textos.
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
- distinguir respuestas Bernoulli de conteos binomiales agregados e identificar correctamente la unidad binomial;
- explicar por qué una regresión lineal gaussiana no constituye, en general, una formulación probabilística adecuada para una respuesta 0/1;
- definir odds, log-odds, función logit e inversa-logit y describir la relación entre estas escalas;
- formular un modelo logístico multinivel con interceptos variables;
- interpretar el papel de la distribución poblacional de los interceptos en el pooling parcial de probabilidades grupales;
- explicar por qué una diferencia constante en log-odds no implica una diferencia constante en probabilidad;
- interpretar un coeficiente logístico mediante log-odds, odds ratios y, preferentemente, probabilidades predichas;
- distinguir un intercepto variable de una pendiente variable en un modelo logístico;
- describir cómo una interacción entre niveles puede explicar heterogeneidad de asociaciones en la escala logit;
- distinguir predicciones para observaciones de un grupo existente, predicciones con coeficientes grupales fijados en cero y predicciones para grupos nuevos;
- explicar por qué fijar un coeficiente grupal en cero no es, en general, equivalente a marginalizar sobre la distribución de grupos;
- derivar e interpretar con cautela el ICC aproximado en la representación latente de un modelo logístico de interceptos variables;
- especificar previas débilmente informativas para interceptos, pendientes y desviaciones estándar grupales en la escala logit;
- utilizar simulación predictiva previa para evaluar las implicaciones de esas previas en la escala de probabilidad;
- explicar qué es separación completa o cuasi-separación y por qué una previa propia regularizadora es especialmente importante en ese contexto;
- ajustar un modelo Bernoulli multinivel en
brmsusandocmdstanrcomo backend; - revisar \(\widehat R\), bulk-ESS, tail-ESS, divergencias y profundidad del árbol antes de interpretar el ajuste;
- diseñar comprobaciones predictivas posteriores apropiadas para datos binarios, incluyendo cantidades agregadas por grupo;
- interpretar resultados principalmente en la escala de respuesta y comunicar la incertidumbre posterior;
- verificar, para el proyecto del curso, que la familia de respuesta y la unidad binomial sean coherentes con el mecanismo de observación.
8.2 Problema motivador: éxito o fracaso dentro de grupos
Supongamos que observamos una respuesta binaria \(y_{ij}\) para la unidad \(i\) del grupo \(j\). Algunos ejemplos posibles son:
- un paciente presenta o no un evento dentro de cierto periodo;
- una persona responde sí/no a un ítem;
- un estudiante aprueba o no una evaluación;
- un animal elige una de dos alternativas;
- un componente falla o no durante una prueba.
Si todos los grupos tuvieran exactamente la misma probabilidad de éxito, un modelo muy simple sería
\[ y_{ij}\mid p \sim \operatorname{Bernoulli}(p). \]
Este modelo realiza pooling completo: todos los grupos comparten una única probabilidad \(p\).
En el extremo contrario podríamos asignar una probabilidad independiente a cada grupo,
\[ y_{ij}\mid p_j \sim \operatorname{Bernoulli}(p_j), \]
sin ninguna relación probabilística entre \(p_1,\ldots,p_J\). Esta estrategia se acerca a la ausencia de pooling: la información de un grupo no contribuye a estabilizar la estimación de otro.
Una formulación multinivel conecta los grupos mediante una población de coeficientes. Como las probabilidades están restringidas al intervalo \((0,1)\), es conveniente modelar una transformación no restringida de \(p_j\):
\[ \operatorname{logit}(p_j)=\alpha_j, \]
\[ \alpha_j\sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \tag{8.2}\]
Esta formulación permite pooling parcial en la escala logit. Un grupo pequeño con una proporción observada extrema, por ejemplo \(1/1\) o \(0/2\), no obliga al modelo a concluir que su probabilidad verdadera es exactamente 1 o 0. La información de los demás grupos, expresada mediante \(\mu_\alpha\) y \(\tau_\alpha\), contribuye a regularizar su coeficiente. El ejemplo de supervivencia de renacuajos de McElreath ilustra este comportamiento con un modelo binomial jerárquico: las estimaciones de grupos pequeños se contraen con mayor intensidad que las de grupos con más observaciones (McElreath 2020, secs. 13.1-13.2).
La lógica de pooling es entonces la misma que en la semana 2, pero la transformación no lineal añade una nueva dificultad:
\[ \boxed{ \text{pooling parcial ocurre sobre coeficientes en la escala logit,} \quad \text{pero queremos interpretar probabilidades.} } \]
Esta diferencia de escalas será el hilo conductor del capítulo.
8.3 Bernoulli y binomial: identificar la unidad de observación
8.3.1 Respuesta Bernoulli
Una variable Bernoulli \(Y\) toma valores 0 y 1:
\[ Y\sim\operatorname{Bernoulli}(p), \]
con
\[ \Pr(Y=1)=p, \qquad \Pr(Y=0)=1-p. \]
Su esperanza y varianza son
\[ \operatorname E(Y)=p, \qquad \operatorname{Var}(Y)=p(1-p). \tag{8.3}\]
La varianza depende de la media. No existe una desviación estándar residual libre análoga a \(\sigma\) en un modelo gaussiano. Esta es una de las razones por las que no debemos trasladar mecánicamente todos los conceptos de la regresión lineal al caso binario (Hox et al. 2018, sec. 6.2; Gelman y Hill 2007, chap. 14).
8.3.2 Conteo binomial agregado
Si observamos \(n_i\) ensayos con una misma probabilidad \(p_i\) y contamos cuántos éxitos se producen,
\[ Y_i\sim\operatorname{Binomial}(n_i,p_i), \]
entonces
\[ \Pr(Y_i=y_i) = {n_i\choose y_i} p_i^{y_i}(1-p_i)^{n_i-y_i}, \]
para \(y_i=0,1,\ldots,n_i\).
La distribución Bernoulli es el caso particular
\[ \operatorname{Bernoulli}(p) = \operatorname{Binomial}(1,p). \]
McElreath enfatiza que la regresión logística con registros individuales 0/1 y la regresión binomial agregada son dos formas de organizar el mismo tipo básico de información cuando los ensayos agregados comparten covariables y una misma probabilidad (McElreath 2020, 324-25). Hox et al. hacen la misma conexión al señalar que, cuando \(n_{ij}=1\), la respuesta binomial se reduce a una Bernoulli (Hox et al. 2018, sec. 6.2).
ImportanteLa unidad binomial es una decisión de modelación
No basta con que una columna contenga números entre 0 y 1 para concluir que debe usarse una familia Bernoulli o binomial.
Antes de ajustar el modelo pregunte:
- ¿qué constituye un ensayo?
- ¿qué se define como éxito?
- ¿cuántos ensayos están representados por cada fila?
- ¿es razonable considerar que esos ensayos comparten la misma probabilidad condicional?
- ¿se perdió información al agregar los datos?
Estas preguntas serán especialmente importantes en la semana 10, cuando trabajemos con proporciones y familias adicionales.
8.3.3 ¿Por qué no usar una regresión lineal para 0/1?
Considere
\[ Y_i=\alpha+\beta x_i+\varepsilon_i. \]
Si tratamos \(Y_i\in\{0,1\}\) como una respuesta gaussiana, aparecen al menos tres problemas conceptuales:
- el valor esperado lineal \(\alpha+\beta x_i\) no está restringido a \([0,1]\);
- la varianza Bernoulli \(p_i(1-p_i)\) cambia con la probabilidad;
- una distribución normal asigna masa a valores de respuesta imposibles.
En algunos intervalos pequeños de los predictores una regresión lineal puede aproximar una curva de probabilidad, pero eso no convierte la formulación gaussiana en un modelo probabilístico apropiado para todo el mecanismo de observación. En este curso preferiremos especificar directamente una distribución compatible con la naturaleza de la respuesta.
8.4 El enlace logit
8.4.1 Odds y log-odds
Para una probabilidad \(p\in(0,1)\), los odds se definen como
\[ \operatorname{odds}(p) = \frac{p}{1-p}. \]
Si \(p=0.5\), los odds son 1. Si \(p=0.8\),
\[ \frac{0.8}{0.2}=4, \]
es decir, el evento es cuatro veces tan probable como el no evento en la escala de odds.
El logit es el logaritmo de los odds:
\[ \operatorname{logit}(p) = \log\left(\frac{p}{1-p}\right). \tag{8.4}\]
La transformación tiene una propiedad clave:
\[ p\in(0,1) \quad\longleftrightarrow\quad \operatorname{logit}(p)\in\mathbb R. \]
Por eso podemos escribir un predictor lineal no restringido,
\[ \eta_i=\alpha+\beta x_i, \]
y conectarlo con una probabilidad mediante
\[ \operatorname{logit}(p_i)=\eta_i. \]
8.4.2 Inversa-logit
Despejando \(p_i\) obtenemos
\[ p_i = \operatorname{logit}^{-1}(\eta_i) = \frac{\exp(\eta_i)}{1+\exp(\eta_i)} = \frac{1}{1+\exp(-\eta_i)}. \tag{8.5}\]
La función inversa-logit (logística) transforma cualquier número real en una probabilidad estrictamente entre 0 y 1. McElreath utiliza esta transformación para mostrar que intervalos iguales en el predictor lineal se comprimen cerca de los extremos de la escala de probabilidad (McElreath 2020, 316-18). Gelman y Hill hacen la misma observación al discutir por qué un cambio fijo en log-odds puede representar cambios absolutos muy diferentes en probabilidad (Gelman y Hill 2007, sec. 5.2).
8.4.3 Una derivada útil
Sea
\[ p(x)=\operatorname{logit}^{-1}(\alpha+\beta x). \]
Entonces
\[ \frac{dp(x)}{dx} = \beta p(x)\{1-p(x)\}. \tag{8.6}\]
La ecuación muestra directamente que el cambio en probabilidad depende de la probabilidad inicial. Para un mismo \(\beta\), el valor absoluto de la pendiente es mayor cerca de \(p=0.5\) y menor cerca de 0 o 1.
Por tanto,
\[ \boxed{ \beta\neq\text{cambio constante en probabilidad} } \]
incluso si el predictor aparece de forma lineal en \(\eta\).
8.5 Cuatro escalas de interpretación
Considere
\[ \operatorname{logit}(p_i)=\alpha+\beta x_i. \]
Es útil distinguir cuatro escalas.
8.5.1 1. Predictor lineal
\[ \eta_i=\alpha+\beta x_i. \]
Un aumento de una unidad en \(x\) cambia \(\eta\) en \(\beta\) unidades.
8.5.2 2. Log-odds
Como \(\eta_i=\log\{p_i/(1-p_i)\}\), el coeficiente \(\beta\) es la diferencia en log-odds asociada con una unidad de diferencia en \(x\), manteniendo constantes los demás términos del predictor lineal.
8.5.3 3. Odds ratio
Aplicando exponenciales,
\[ \frac{\operatorname{odds}(x+1)}{\operatorname{odds}(x)} = \exp(\beta). \tag{8.7}\]
Por tanto, \(\exp(\beta)\) es un odds ratio condicional para una unidad de diferencia en \(x\).
Esta interpretación es matemáticamente conveniente, pero no siempre responde directamente la pregunta sustantiva. Un odds ratio de la misma magnitud puede corresponder a diferencias absolutas de probabilidad muy distintas dependiendo del nivel de referencia.
8.5.4 4. Probabilidad
La comparación sustantiva puede expresarse como
\[ \Delta p(x) = \operatorname{logit}^{-1}\{\alpha+\beta(x+1)\} - \operatorname{logit}^{-1}(\alpha+\beta x). \tag{8.8}\]
Esta diferencia depende de \(x\), de \(\alpha\) y, en un modelo con más predictores, de los valores de todos los términos que forman \(\eta\).
TipRegla de comunicación
En un informe puede ser útil presentar el coeficiente o el odds ratio para conectar con la literatura, pero conviene acompañarlo con probabilidades predichas o diferencias de probabilidades en escenarios sustantivamente relevantes.
8.6 Modelo logístico multinivel de interceptos variables
Supongamos que la unidad \(i\) pertenece al grupo \(j=1,\ldots,J\). Una formulación básica es
\[ y_{ij}\mid p_{ij} \sim \operatorname{Bernoulli}(p_{ij}), \]
\[ \operatorname{logit}(p_{ij}) = \alpha_j+\beta x_{ij}, \]
\[ \alpha_j\mid\mu_\alpha,\tau_\alpha \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \tag{8.9}\]
Podemos escribir de manera equivalente
\[ \alpha_j=\mu_\alpha+u_j, \qquad u_j\sim\mathcal N(0,\tau_\alpha^2), \]
por lo que
\[ \operatorname{logit}(p_{ij}) = \mu_\alpha+u_j+\beta x_{ij}. \tag{8.10}\]
En esta formulación:
- \(\mu_\alpha\) es el intercepto poblacional en la escala logit;
- \(u_j\) es la desviación del grupo \(j\) respecto del intercepto poblacional;
- \(\tau_\alpha\) describe la heterogeneidad entre grupos en log-odds;
- \(\beta\) es una pendiente común en la escala logit;
- \(p_{ij}\) es la probabilidad condicional para la unidad \(i\) del grupo \(j\).
Gelman y Hill presentan este tipo de extensión como una regresión logística cuyos interceptos de grupo se modelan conjuntamente mediante una distribución poblacional (Gelman y Hill 2007, chap. 14). En la notación de Hox et al., la estructura multinivel se introduce dentro de \(\eta_{ij}\) y luego se conecta con la media binomial mediante el logit (Hox et al. 2018, sec. 6.2).
8.6.1 Independencia condicional y dependencia marginal
Condicionalmente en los parámetros y coeficientes grupales, podemos asumir
\[ y_{ij}\perp y_{i'j} \mid u_j,\beta,\ldots \]
para \(i\neq i'\). Sin embargo, después de integrar la incertidumbre y variación de \(u_j\), dos observaciones del mismo grupo comparten una fuente común de heterogeneidad. Por tanto, no son marginalmente equivalentes a observaciones de grupos independientes.
Este es el mismo principio visto en las semanas 1 y 2: la dependencia surge porque varias observaciones comparten cantidades latentes o coeficientes grupales. Lo que cambia ahora es que esa dependencia se propaga a través de una función logística.
8.7 Pooling parcial en la escala logit
En un modelo gaussiano simple, el shrinkage podía visualizarse directamente comparando medias grupales. En el caso binario, la idea es análoga, pero el coeficiente jerárquico se encuentra en log-odds.
Para un modelo sin predictores,
\[ y_{ij}\sim\operatorname{Bernoulli}(p_j), \qquad \operatorname{logit}(p_j)=\alpha_j, \]
\[ \alpha_j\sim\mathcal N(\mu_\alpha,\tau_\alpha^2). \]
La información del grupo \(j\) empuja a \(\alpha_j\) hacia valores compatibles con su proporción observada, mientras la distribución poblacional regulariza estimaciones poco informadas. Después, la transformación inversa-logit lleva esa regularización a la escala de probabilidad.
Tres consecuencias son particularmente importantes:
- los grupos pequeños tienden a mostrar más pooling que los grupos grandes;
- proporciones empíricas 0 o 1 no obligan a probabilidades posteriores exactamente 0 o 1;
- la magnitud del shrinkage en probabilidad no es una transformación lineal de la magnitud del shrinkage en log-odds.
El ejemplo de renacuajos de McElreath muestra explícitamente que las estimaciones multinivel de supervivencia se acercan a la distribución poblacional, especialmente para tanques con menor número de individuos (McElreath 2020, 401-15).
NotaEl pooling no corrige automáticamente el modelo
El pooling parcial puede estabilizar probabilidades grupales, pero no compensa una familia de respuesta equivocada, una variable de agrupamiento mal definida, predictores omitidos importantes o una estructura jerárquica sustantivamente incorrecta.
8.8 Predictores individuales y grupales
Podemos extender Ecuación 8.9 con predictores del nivel individual y grupal:
\[ \operatorname{logit}(p_{ij}) = \alpha_j + \beta_W(x_{ij}-\bar x_j) + \beta_B\bar x_j + \gamma z_j. \tag{8.11}\]
La separación dentro/entre grupos conserva la interpretación de la semana 3. La diferencia es que \(\beta_W\) y \(\beta_B\) operan en log-odds. Si el objetivo sustantivo es describir diferencias de probabilidad, debemos transformar escenarios completos y no interpretar los coeficientes como diferencias absolutas directas.
Por ejemplo, para dos valores \(x_a\) y \(x_b\) dentro del mismo grupo,
\[ p_a = \operatorname{logit}^{-1}(\eta_a), \qquad p_b = \operatorname{logit}^{-1}(\eta_b), \]
y la comparación relevante puede ser
\[ p_b-p_a, \]
no solamente
\[ \eta_b-\eta_a=\beta_W(x_b-x_a). \]
8.9 Pendientes variables e interacciones entre niveles
Si la asociación entre \(x_{ij}\) y la respuesta cambia entre grupos,
\[ \operatorname{logit}(p_{ij}) = \alpha_j+\beta_j x_{ij}, \]
con
\[ \begin{pmatrix} \alpha_j\\ \beta_j \end{pmatrix} \sim \mathcal N_2\!\left( \begin{pmatrix} \mu_\alpha\\ \mu_\beta \end{pmatrix}, \Sigma \right). \tag{8.12}\]
La matriz
\[ \Sigma = \begin{pmatrix} \tau_\alpha^2 & \rho\tau_\alpha\tau_\beta\\ \rho\tau_\alpha\tau_\beta & \tau_\beta^2 \end{pmatrix} \]
describe la heterogeneidad conjunta de interceptos y pendientes en la escala logit.
Las ideas de la semana 4 siguen siendo válidas, pero la escala de respuesta añade una capa de interpretación. Dos grupos con el mismo \(\beta_j\) pueden mostrar diferencias de probabilidad de distinta magnitud si sus interceptos son distintos. Incluso con una pendiente logit común, la curva de probabilidad tiene pendiente local distinta en diferentes regiones.
Si un predictor grupal \(z_j\) explica parte de la variación de las pendientes,
\[ \beta_j = \gamma_0+\gamma_1z_j+b_{1j}, \]
entonces
\[ \operatorname{logit}(p_{ij}) = \alpha_j + (\gamma_0+\gamma_1z_j+b_{1j})x_{ij}. \]
El término \(\gamma_1x_{ij}z_j\) es una interacción entre niveles. Su interpretación directa es en la escala del predictor lineal; su consecuencia sobre la probabilidad debe evaluarse mediante predicciones para valores concretos de \(x\) y \(z\).
8.10 Condicional, coeficientes grupales en cero y marginal: tres cantidades distintas
Esta distinción es una de las más importantes del capítulo.
Considere
\[ \operatorname{logit}(p_{ij}) = \eta_{ij}+u_j, \qquad u_j\sim\mathcal N(0,\tau^2). \]
8.10.1 Predicción para un grupo existente
Para un grupo observado \(j\), una probabilidad condicional utiliza la distribución posterior de su coeficiente \(u_j\):
\[ p_{ij}^{\text{existente}} = \operatorname{logit}^{-1}(\eta_{ij}+u_j). \]
La información observada para ese grupo contribuye a la posterior de \(u_j\).
8.10.2 Predicción con el coeficiente grupal fijado en cero
Podemos calcular
\[ p_{ij}^{u=0} = \operatorname{logit}^{-1}(\eta_{ij}). \]
Esta cantidad corresponde a un grupo cuyo coeficiente se fija exactamente en el centro de la distribución grupal. Es útil como referencia, pero no es en general una probabilidad marginal sobre la población de grupos.
8.10.3 Predicción para un grupo nuevo
Para un grupo nuevo debemos representar que su coeficiente todavía no ha sido observado:
\[ u_{\text{nuevo}}\mid\tau \sim \mathcal N(0,\tau^2), \]
\[ p_i^{\text{nuevo}} = \operatorname{logit}^{-1} (\eta_i+u_{\text{nuevo}}). \]
La distribución predictiva integra tanto la incertidumbre posterior sobre los parámetros como la variación entre grupos.
8.10.4 Promedio marginal sobre grupos
La media sobre la población de grupos es
\[ \bar p(\eta,\tau) = \operatorname E_u \left[ \operatorname{logit}^{-1}(\eta+u) \right], \qquad u\equiv u\sim\mathcal N(0,\tau^2). \tag{8.13}\]
En general,
\[ \operatorname E_u \left[ \operatorname{logit}^{-1}(\eta+u) \right] \neq \operatorname{logit}^{-1}(\eta). \tag{8.14}\]
La desigualdad aparece por la no linealidad de la inversa-logit. Fijar \(u=0\) y promediar sobre la distribución de \(u\) son operaciones diferentes.
ImportanteLa palabra ‘poblacional’ puede ser ambigua
En software y en artículos, expresiones como population-level prediction, marginal effect o conditional effect pueden utilizarse con convenciones distintas. En estas notas siempre indicaremos explícitamente qué se hizo con los coeficientes grupales:
- incluidos para grupos observados;
- fijados en cero;
- simulados para grupos nuevos;
- integrados/promediados sobre una distribución.
8.11 ICC aproximado en un modelo logístico
En el modelo lineal de interceptos variables,
\[ Y_{ij}=\mu_\alpha+u_j+\varepsilon_{ij}, \]
con
\[ u_j\sim\mathcal N(0,\tau_\alpha^2), \qquad \varepsilon_{ij}\sim\mathcal N(0,\sigma^2), \]
el ICC tiene una descomposición directa:
\[ \operatorname{ICC} = \frac{\tau_\alpha^2} {\tau_\alpha^2+\sigma^2}. \]
En un modelo Bernoulli-logit no existe un parámetro residual \(\sigma^2\) observado que pueda sustituirse directamente en esa expresión. Una convención frecuente introduce una representación latente logística, cuya varianza residual se fija en
\[ \frac{\pi^2}{3}\approx3.29. \]
Para un modelo de interceptos variables se obtiene entonces
\[ \operatorname{ICC}_{\text{latente}} \approx \frac{\tau_\alpha^2} {\tau_\alpha^2+\pi^2/3}. \tag{8.15}\]
Hox et al. utilizan esta representación para calcular un ICC aproximado en modelos logísticos multinivel (Hox et al. 2018, secs. 6.3, 6.5).
8.11.1 ¿Qué interpreta este ICC?
La cantidad de Ecuación 8.15 describe la proporción de variación en una escala latente estandarizada atribuible al nivel grupal bajo esa representación. No es literalmente la correlación observada entre dos variables Bernoulli, y no debe interpretarse como si existiera una varianza residual observada constante igual a \(\pi^2/3\).
Además, Hox et al. advierten que la escala latente de los modelos logit y probit está estandarizada. Al modificar los predictores, los coeficientes y componentes de varianza pueden cambiar también por reescalamiento implícito, no únicamente porque se haya explicado cierta fracción de una varianza fija (Hox et al. 2018, sec. 6.5).
AdvertenciaNo convierta el ICC latente en una medida universal de dependencia binaria
Para preguntas predictivas suele ser más informativo examinar:
- distribución posterior de \(\tau_\alpha\);
- probabilidades predichas por grupo;
- variación posterior entre grupos en la escala de probabilidad;
- correlaciones o contrastes predictivos definidos específicamente para el problema.
El ICC latente es útil para conectar con la literatura, pero no sustituye esas cantidades.
8.12 Previas en la escala logit
La semana 6 estableció una regla que aquí resulta especialmente importante: una previa debe evaluarse por sus consecuencias en la escala del problema.
8.12.1 Intercepto
Si
\[ \alpha\sim\mathcal N(0,1.5^2), \]
entonces la mediana previa de
\[ p=\operatorname{logit}^{-1}(\alpha) \]
es 0.5, pero la distribución permite probabilidades sustancialmente alejadas de 0.5. La conveniencia de esta previa depende de qué representa \(x=0\) y de si el predictor lineal está centrado de manera sustantivamente interpretable.
Si, por conocimiento previo, una probabilidad basal cercana a 0.05 es más razonable que 0.5, una previa centrada en cero sería poco coherente. Podemos transformar la probabilidad esperada a log-odds:
\[ \operatorname{logit}(0.05) \approx -2.94. \]
La previa del intercepto debería entonces reflejar esa escala, con una dispersión justificada por la incertidumbre real.
8.12.2 Pendientes
Una previa como
\[ \beta\sim\mathcal N(0,0.7^2) \]
para un predictor estandarizado asigna la mayor parte de la masa a cambios moderados en log-odds por una desviación estándar del predictor. Su implicación sobre probabilidades depende del intercepto y de los demás coeficientes.
No debe interpretarse normal(0, 0.7) como una recomendación universal. Si el predictor está medido en miligramos, años, miles de dólares o una escala 0–100, una unidad tiene significados completamente distintos. Centrar o estandarizar puede facilitar la especificación y la comunicación, pero debe conservarse el vínculo con la escala sustantiva.
8.12.3 Desviaciones estándar grupales
Para una desviación estándar \(\tau>0\) podemos usar, por ejemplo,
\[ \tau\sim\operatorname{Exponential}(1), \]
o una half-normal con una escala acorde con el problema. En la escala logit, valores grandes de \(\tau\) pueden producir grupos con probabilidades muy cercanas a 0 o 1 aun si el intercepto poblacional es moderado. Esa consecuencia debe inspeccionarse mediante simulación predictiva previa.
8.12.4 Correlaciones de coeficientes variables
Si se incluyen interceptos y pendientes variables, podemos conservar la separación
\[ \Sigma=DRD \]
de la semana 6 y asignar una previa LKJ a \(R\). El principio no cambia por utilizar una respuesta binaria: la previa debe regularizar configuraciones extremas sin imponer una estructura de correlación que no pueda justificarse.
8.13 Comprobación predictiva previa
En un modelo binario, una comprobación predictiva previa debe responder preguntas como:
- ¿qué probabilidades basales considera plausibles el modelo?
- ¿con qué frecuencia genera grupos casi deterministas, con \(p\) muy cerca de 0 o 1?
- ¿qué diferencias entre grupos induce la previa de \(\tau\)?
- ¿qué cambios de probabilidad produce una pendiente para valores realistas del predictor?
- ¿las interacciones permiten contrastes absurdamente grandes antes de observar los datos?
La distribución predictiva previa puede escribirse esquemáticamente como
\[ p(\tilde y) = \int p(\tilde y\mid\theta) p(\theta) \,d\theta. \]
En un modelo multinivel, \(\theta\) incluye coeficientes poblacionales, escalas grupales y coeficientes de grupos simulados cuando corresponde. Bayesian Workflow recomienda inspeccionar estas implicaciones antes del ajuste, no únicamente densidades marginales de parámetros (Gelman et al. 2026, secs. 5.6-5.10).
8.14 Separación: cuando los datos no determinan la magnitud de un coeficiente
Hasta ahora hemos supuesto que los datos proporcionan información suficiente para ubicar los coeficientes de una regresión logística en una región finita de valores. Con respuestas binarias esto no siempre ocurre.
Consideremos un ejemplo muy sencillo. Supongamos que observamos:
| \(x_i\) | \(y_i\) |
|---|---|
| -2 | 0 |
| -1 | 0 |
| 1 | 1 |
| 2 | 1 |
En estos datos, el signo de \(x\) predice perfectamente la respuesta:
- cuando \(x<0\), siempre observamos \(y=0\);
- cuando \(x>0\), siempre observamos \(y=1\).
No hay ningún caso que contradiga esta regla.
Supongamos ahora el modelo
\[ y_i\sim\operatorname{Bernoulli}(p_i), \]
\[ \operatorname{logit}(p_i)=\beta x_i. \]
Para comprender el problema, examinemos qué ocurre al aumentar \(\beta\).
Si \(\beta=1\), obtenemos, por ejemplo,
\[ p(y=1\mid x=1) = \operatorname{logit}^{-1}(1) \approx 0.73, \]
mientras que
\[ p(y=1\mid x=-1) = \operatorname{logit}^{-1}(-1) \approx 0.27. \]
El modelo asigna mayor probabilidad de éxito a los valores positivos de \(x\), pero todavía conserva una incertidumbre considerable.
Si aumentamos el coeficiente a \(\beta=5\),
\[ p(y=1\mid x=1) = \operatorname{logit}^{-1}(5) \approx 0.993, \]
y
\[ p(y=1\mid x=-1) = \operatorname{logit}^{-1}(-5) \approx 0.007. \]
Estas probabilidades concuerdan todavía mejor con los datos observados: los casos con \(x>0\) reciben probabilidades muy cercanas a 1 y los casos con \(x<0\), probabilidades muy cercanas a 0.
Pero podemos continuar. Si \(\beta=10\), las probabilidades quedan aún más cerca de 0 y 1. Si \(\beta=20\), todavía más.
Este es el punto fundamental:
los datos indican claramente la dirección del efecto, pero no establecen qué tan grande debe ser el coeficiente.
Para estos datos, pasar de un coeficiente grande a uno todavía mayor continúa haciendo que las probabilidades predichas se acerquen a los resultados observados. No aparece un valor finito de \(\beta\) que sea preferido por la verosimilitud frente a todos los valores mayores.
Este fenómeno se denomina separación completa (Gelman y Hill 2007, sec. 5.8).
8.14.1 Qué significa separación completa
En términos generales, existe separación completa cuando algún predictor, o alguna combinación de predictores, permite dividir perfectamente las observaciones con \(y=0\) de las observaciones con \(y=1\).
Por ejemplo, si existe un valor \(T\) tal que
\[ y_i=0 \quad\text{para todos los casos con }x_i<T \]
y
\[ y_i=1 \quad\text{para todos los casos con }x_i>T, \]
entonces aumentar suficientemente el coeficiente asociado con \(x\) hace que las probabilidades predichas sean cada vez más cercanas a los ceros y unos observados.
La separación no requiere necesariamente un solo predictor. También puede ocurrir cuando una combinación lineal de varios predictores clasifica perfectamente la respuesta (Gelman y Hill 2007, sec. 5.8).
NotaSeparación no significa simplemente una asociación fuerte
Una asociación fuerte y la separación no son lo mismo.
Con una asociación fuerte todavía pueden existir, por ejemplo, algunos éxitos para valores bajos de \(x\) y algunos fracasos para valores altos de \(x\). Esas observaciones ayudan a determinar la magnitud del coeficiente.
Con separación completa no existen esas observaciones contradictorias. Los datos permiten establecer hacia qué dirección debe moverse el coeficiente, pero contienen muy poca información para determinar hasta dónde debe hacerlo.
8.14.2 ¿Qué ocurre con máxima verosimilitud?
En una regresión logística ordinaria, el estimador de máxima verosimilitud busca el valor de \(\beta\) que maximiza
\[ p(y\mid\beta). \]
Cuando hay separación completa, valores cada vez mayores de \(|\beta|\) pueden producir probabilidades cada vez más compatibles con los datos.
Por ejemplo, en el caso anterior con \(\beta>0\),
\[ \beta \longrightarrow +\infty \]
implica que
\[ p_i\longrightarrow 1 \qquad\text{para }x_i>0, \]
y
\[ p_i\longrightarrow 0 \qquad\text{para }x_i<0. \]
Por tanto, la verosimilitud no identifica un máximo en un valor finito de \(\beta\). Decir que el estimador de máxima verosimilitud es \(+\infty\) no significa que hayamos medido un efecto de tamaño infinito. Significa que los datos y el modelo no proporcionan información suficiente para establecer un límite superior finito para ese coeficiente.
Este punto es importante porque un resultado numérico extremadamente grande o una advertencia del software no deben interpretarse simplemente como un problema que se arregla ejecutando más iteraciones.
8.14.3 ¿Qué cambia en un análisis bayesiano?
En el enfoque bayesiano no utilizamos únicamente la verosimilitud. La posterior satisface
\[ p(\beta\mid y) \propto p(y\mid\beta)\,p(\beta). \]
Supongamos, por ejemplo, una previa
\[ \beta\sim\mathcal N(0,1.5^2). \]
La verosimilitud favorece valores positivos grandes porque separan correctamente los ceros y unos. Sin embargo, la previa asigna cada vez menos densidad a valores extremadamente grandes de \(\beta\).
La posterior resulta entonces de un balance entre ambas fuentes de información:
- los datos indican con claridad que \(\beta\) debe ser positivo;
- los datos por sí solos no determinan bien cuán grande debe ser;
- la previa expresa qué magnitudes considerábamos plausibles antes de observar estos datos y evita que valores arbitrariamente extremos sean equivalentes.
Gelman y Hill mencionan precisamente los enfoques bayesianos o de verosimilitud penalizada como alternativas cuando los coeficientes no están identificados por los datos debido a separación (Gelman y Hill 2007, sec. 5.8).
Esto no significa que la previa haya creado información observacional. Más bien, hace explícita la información adicional necesaria para estimar una magnitud que la muestra no determina por sí sola.
ImportanteLa posterior puede depender mucho de la previa
Cuando existe separación, una posterior finita no implica que los datos hayan determinado con precisión la magnitud del efecto.
Si distintas previas razonables producen posteriores apreciablemente diferentes para \(\beta\), esa sensibilidad es precisamente una señal de que los datos contienen poca información sobre su magnitud.
Por ello conviene:
- examinar la posterior del coeficiente;
- realizar un análisis de sensibilidad a previas defendibles;
- estudiar las probabilidades predictivas que realmente interesan;
- comunicar que la magnitud del efecto está débilmente determinada por los datos.
8.14.4 Separación e identificación
La separación permite distinguir dos ideas que hemos venido desarrollando durante el curso.
Problema de identificación.
Los datos no contienen suficiente información para determinar la magnitud de ciertos parámetros bajo el modelo especificado.
Problema computacional.
El algoritmo tiene dificultades para explorar una posterior que sí está razonablemente identificada.
No son lo mismo.
Ante separación, aumentar adapt_delta, incrementar el número de iteraciones o cambiar la parametrización no crea la información que falta en los datos. Primero debemos reconocer el problema estadístico y especificar un modelo con previas defendibles. Después debemos comprobar que HMC/NUTS pueda explorar adecuadamente la posterior resultante.
La Sección 8.20 mostrará este fenómeno gráficamente: veremos cómo la log-verosimilitud continúa favoreciendo valores crecientes del coeficiente, mientras que una previa propia produce una posterior con una región finita de alta densidad.
8.15 Flujo de trabajo para un GLMM binario
Para esta semana usaremos la siguiente secuencia:
- identificar la unidad de observación y la unidad binomial;
- identificar fuentes de agrupamiento y dependencia;
- especificar Bernoulli o binomial y el enlace;
- escribir el predictor lineal multinivel;
- centrar o escalar predictores cuando la interpretación lo justifique;
- especificar previas en la escala logit y en parámetros de variación grupal;
- realizar comprobación predictiva previa;
- ajustar con HMC/NUTS;
- revisar diagnósticos computacionales;
- realizar comprobaciones predictivas posteriores globales y por grupo;
- interpretar probabilidades y contrastes en escenarios relevantes;
- distinguir explícitamente la población predictiva: grupos existentes o grupos nuevos.
La secuencia evita tratar la elección de family = bernoulli() como una receta de software. La familia, el enlace y la estructura de agrupamiento son afirmaciones probabilísticas sobre el problema.
8.16 Laboratorio reproducible en R
El laboratorio tiene cuatro propósitos complementarios:
- visualizar la no linealidad de la función logística;
- comparar pooling completo, ausencia de pooling y pooling parcial con probabilidades grupales conocidas por simulación;
- ilustrar la diferencia entre fijar el coeficiente grupal en cero y promediar sobre grupos;
- ajustar una aplicación Bernoulli con dos factores de agrupamiento cruzados usando
brmsycmdstanr.
8.17 Experimento 1: del predictor lineal a la probabilidad
Primero construiremos la transformación logística sin ajustar ningún modelo.
logistica_s8 |>
  ggplot(aes(x = eta, y = p)) +
  geom_line(linewidth = 1) +
  geom_hline(yintercept = 0.5, linetype = 2) +
  geom_vline(xintercept = 0, linetype = 2) +
  labs(
    x = expression(eta),
    y = "Probabilidad"
  ) +
  theme_minimal(base_size = 12)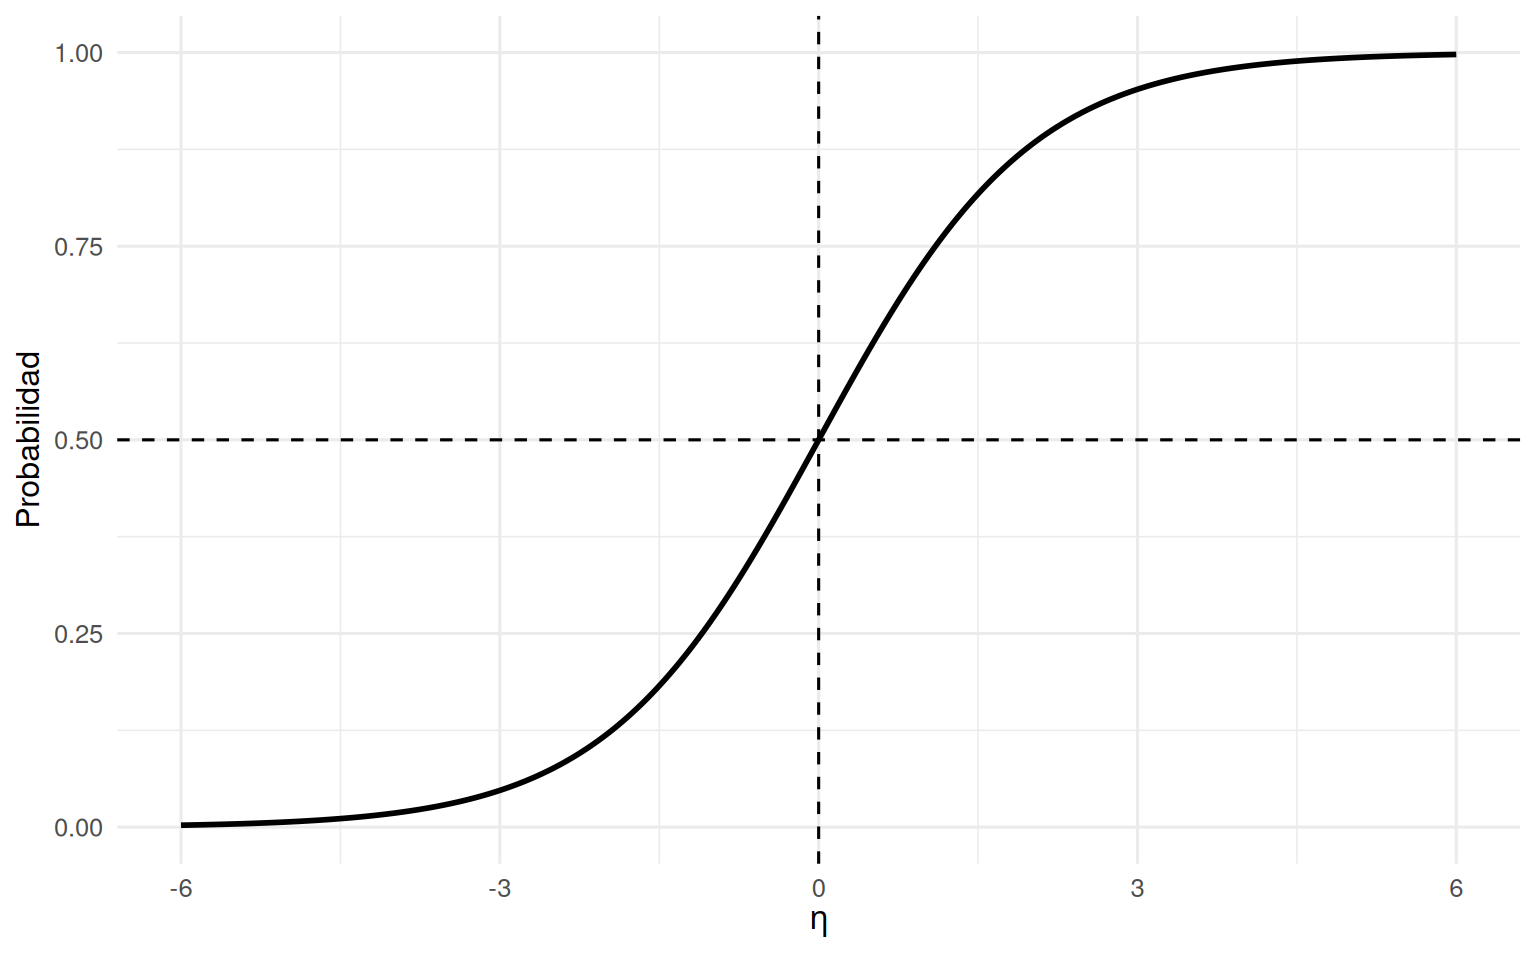
La curva es más pronunciada alrededor de \(\eta=0\), donde \(p=0.5\), y se aplana en los extremos.
8.17.1 El mismo cambio en log-odds, distintos cambios en probabilidad
Tomemos un incremento fijo
\[ \Delta\eta=0.8. \]
Calcularemos qué diferencia de probabilidad produce cuando el punto inicial cambia.
cambios_s8 <- tibble(
  eta_inicial = c(-4, -2, 0, 2, 4),
  eta_final = eta_inicial + 0.8
) |>
  mutate(
    p_inicial = plogis(eta_inicial),
    p_final = plogis(eta_final),
    diferencia = p_final - p_inicial,
    odds_ratio = exp(0.8)
  )

cambios_s8
# A tibble: 5 × 6
eta_inicial eta_final p_inicial p_final diferencia odds_ratio
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 -4 -3.2 0.0180 0.0392 0.0212 2.23
2 -2 -1.2 0.119 0.231 0.112 2.23
3 0 0.8 0.5 0.690 0.190 2.23
4 2 2.8 0.881 0.943 0.0619 2.23
5 4 4.8 0.982 0.992 0.00982 2.23El odds ratio es idéntico en todas las filas,
\[ \exp(0.8), \]
pero la diferencia absoluta de probabilidades no lo es.
cambios_s8 |>
  transmute(
    eta_inicial,
    segmento = map2(p_inicial, p_final, ~ tibble(
      extremo = c("Inicial", "Final"),
      probabilidad = c(.x, .y)
    ))
  ) |>
  unnest(segmento) |>
  ggplot(
    aes(
      x = factor(eta_inicial),
      y = probabilidad,
      group = eta_inicial
    )
  ) +
  geom_line(linewidth = 0.7) +
  geom_point(size = 2.4) +
  labs(
    x = expression(eta["inicial"]),
    y = "Probabilidad"
  ) +
  theme_minimal(base_size = 12)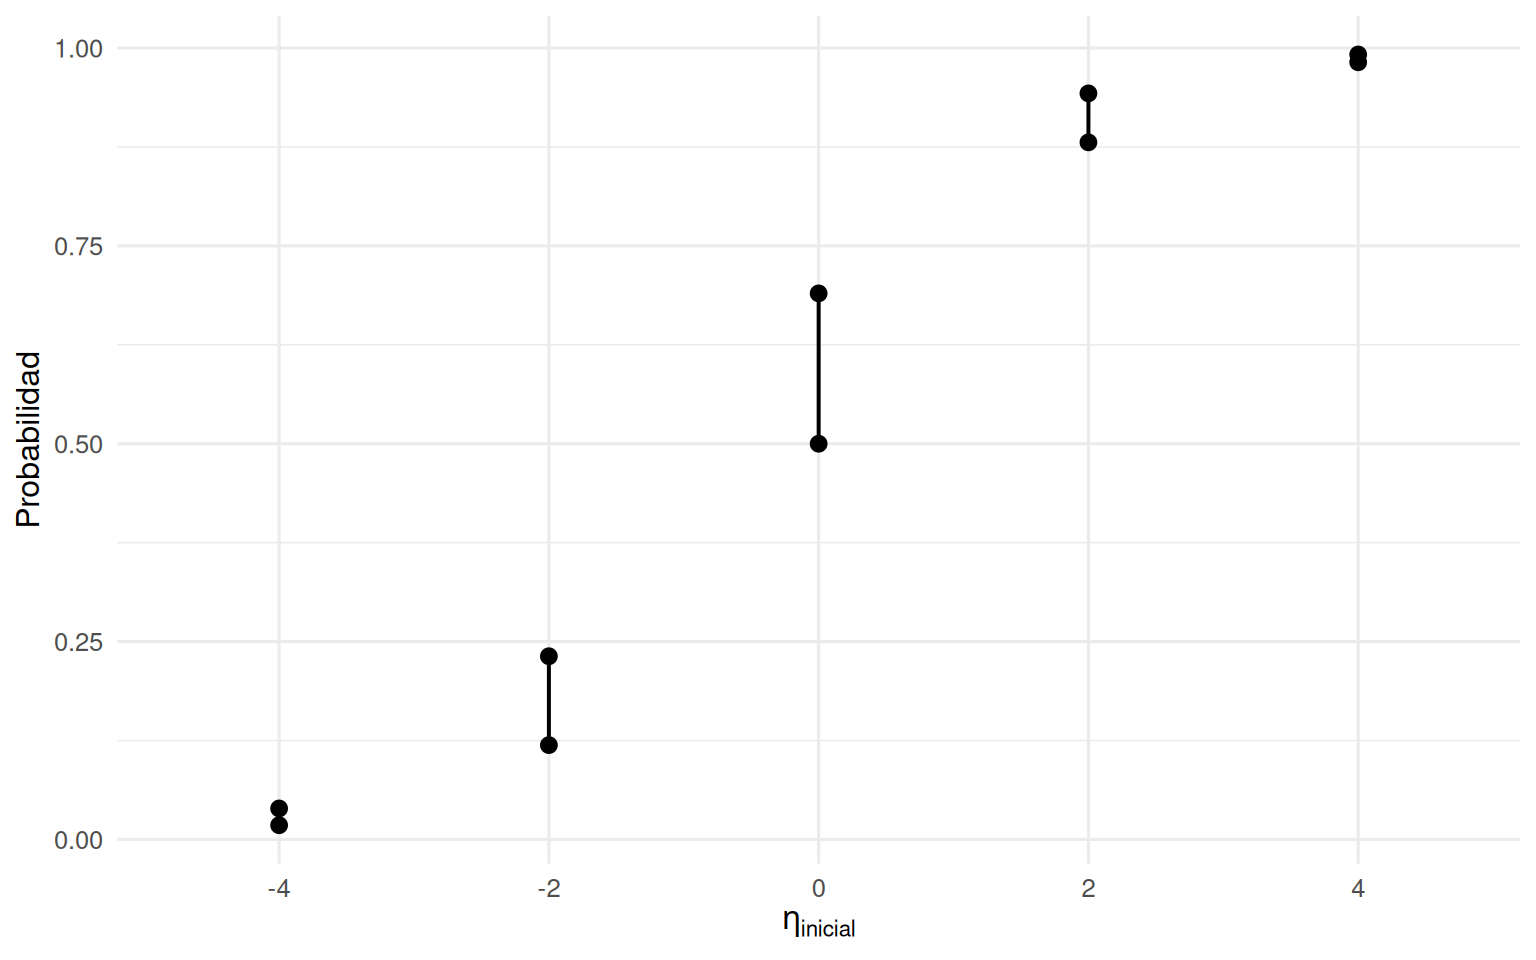
La figura ofrece una advertencia práctica: reportar únicamente \(\beta\) o \(\exp(\beta)\) puede ocultar el tamaño de la diferencia en la escala que realmente interesa.
8.18 Experimento 2: pooling parcial con probabilidades grupales
Simularemos grupos de tamaños diferentes. Conocemos las probabilidades verdaderas, por lo que podremos comparar las estrategias de estimación con un objetivo conocido.
8.18.1 Simular una población de grupos
Usaremos
\[ \mu_\alpha=-0.7, \qquad \tau_\alpha=1.0, \]
\[ \alpha_j\sim\mathcal N(-0.7,1), \qquad p_j=\operatorname{logit}^{-1}(\alpha_j). \]
Los tamaños grupales serán deliberadamente desiguales.
set.seed(1653081)

J_s8 <- 24L

tamanos_s8 <- sample(
  c(2:8, 12, 16, 20, 30, 45),
  size = J_s8,
  replace = TRUE
)

parametros_grupo_s8 <- tibble(
  grupo = factor(seq_len(J_s8)),
  n = tamanos_s8,
  alpha_verdadero = rnorm(J_s8, -0.7, 1.0),
  p_verdadero = plogis(alpha_verdadero)
)

datos_pooling_s8 <- parametros_grupo_s8 |>
  select(grupo, n, p_verdadero) |>
  uncount(n, .id = "unidad") |>
  mutate(
    y = rbinom(n(), size = 1, prob = p_verdadero)
  )

resumen_grupos_s8 <- datos_pooling_s8 |>
  group_by(grupo) |>
  summarise(
    n = n(),
    exitos = sum(y),
    proporcion_observada = mean(y),
    .groups = "drop"
  ) |>
  left_join(
    parametros_grupo_s8 |>
      select(grupo, p_verdadero),
    by = "grupo"
  )

resumen_grupos_s8
# A tibble: 24 × 5
grupo n exitos proporcion_observada p_verdadero
<fct> <int> <int> <dbl> <dbl>
1 1 45 13 0.289 0.328
2 2 45 33 0.733 0.540
3 3 7 3 0.429 0.432
4 4 30 14 0.467 0.443
5 5 8 2 0.25 0.194
6 6 2 0 0 0.0595
7 7 20 6 0.3 0.290
8 8 4 2 0.5 0.562
9 9 12 2 0.167 0.265
10 10 6 0 0 0.407
# ℹ 14 more rowsAlgunos grupos pequeños pueden mostrar proporciones empíricas 0 o 1 aunque sus probabilidades verdaderas estén lejos de esos extremos.
8.18.2 Pooling completo
La estimación empírica con pooling completo es
p_pooling_completo_s8 <- mean(datos_pooling_s8$y)
p_pooling_completo_s8
[1] 0.3146341Todos los grupos recibirían esa misma probabilidad estimada.
8.18.3 Ausencia de pooling
La proporción observada de cada grupo es la estimación empírica más directa sin compartir información:
\[ \widehat p_j^{\text{NP}} = \frac{y_j}{n_j}. \]
Con tamaños pequeños puede ser muy variable. Además, cuando \(y_j=0\) o \(y_j=n_j\), el logit empírico es infinito, lo que ilustra por qué la parametrización logística sin regularización puede volverse inestable.
8.18.4 Pooling parcial bayesiano
Ajustaremos
\[ y_{ij}\sim\operatorname{Bernoulli}(p_j), \]
\[ \operatorname{logit}(p_j) = \mu_\alpha+u_j, \]
\[ u_j\sim\mathcal N(0,\tau_\alpha^2). \]
Utilizaremos previas moderadamente regularizadoras en la escala logit.
formula_pooling_s8 <- bf(
  y ~ 1 + (1 | grupo)
)

priors_pooling_s8 <- c(
  prior(normal(0, 1.5), class = "Intercept"),
  prior(exponential(1), class = "sd")
)

priors_pooling_s8
prior class coef group resp dpar nlpar lb ub tag source
normal(0, 1.5) Intercept <NA> <NA> user
exponential(1) sd <NA> <NA> userAntes del ajuste, simulemos únicamente desde la previa para verificar las probabilidades que induce para un grupo nuevo.
set.seed(1653082)

prior_pooling_s8 <- tibble(
  draw = 1:6000,
  mu_alpha = rnorm(6000, 0, 1.5),
  tau_alpha = rexp(6000, 1),
  u_nuevo = rnorm(6000, 0, tau_alpha),
  p_centro = plogis(mu_alpha),
  p_nuevo = plogis(mu_alpha + u_nuevo)
)
prior_pooling_s8 |>
select(p_centro, p_nuevo) |>
pivot_longer(
everything(),
names_to = "tipo",
values_to = "probabilidad"
) |>
mutate(
tipo = recode(
tipo,
p_centro = "Coeficiente grupal = 0",
p_nuevo = "Grupo nuevo"
)
) |>
ggplot(aes(x = probabilidad)) +
geom_histogram(bins = 45) +
facet_wrap(~ tipo, ncol = 1) +
labs(
x = "Probabilidad previa",
y = "Frecuencia"
) +
theme_minimal(base_size = 12)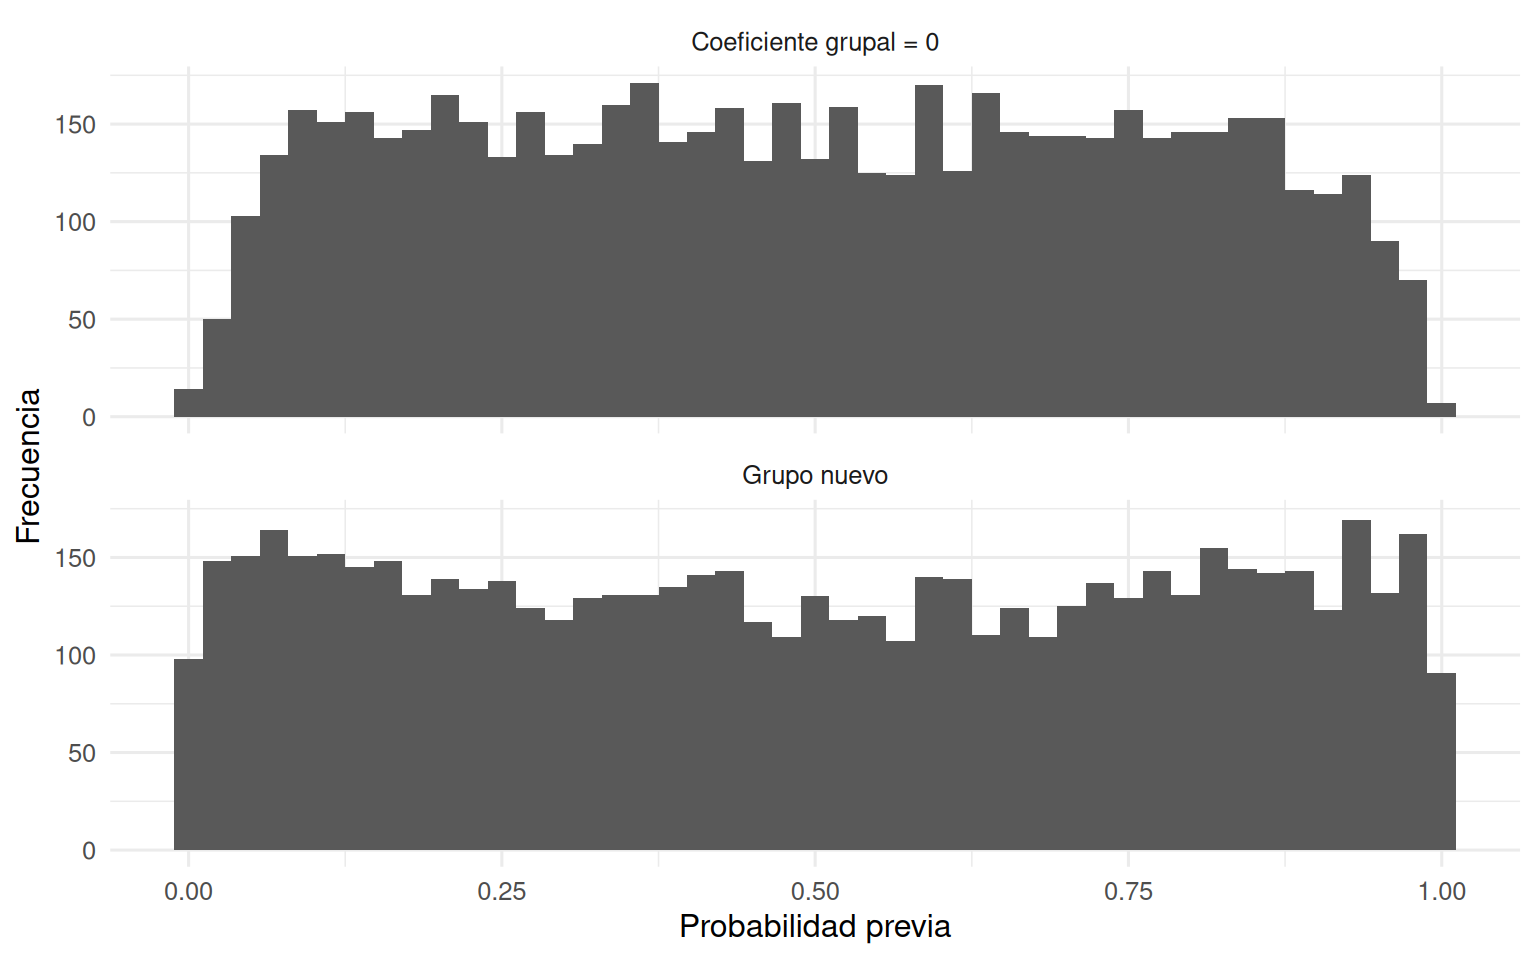
La distribución para grupos nuevos es más dispersa porque incorpora la heterogeneidad representada por \(\tau_\alpha\). Este gráfico permite evaluar si la combinación de previas considera plausibles demasiados grupos casi deterministas.
8.18.5 Ajustar el modelo
fit_pooling_s8 <- brm(
  formula = formula_pooling_s8,
  data = datos_pooling_s8,
  family = bernoulli(link = "logit"),
  prior = priors_pooling_s8,
  backend = "cmdstanr",
  seed = 1653083,
  chains = 4,
  cores = 4,
  iter = 2200,
  warmup = 1000,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s8_pooling_binario_cmdstanr"
  ),
  file_refit = "on_change"
)
Antes de interpretar las probabilidades, revisamos el muestreo.
posterior::summarise_draws(
  as_draws_df(fit_pooling_s8),
  "mean", "sd", "rhat", "ess_bulk", "ess_tail"
) |>
  filter(
    str_detect(variable, "^(b_|sd_)")
  )
# A tibble: 2 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept -1.14 0.284 1.00 1348. 2190.
2 sd_grupo__Intercept 1.07 0.266 1.000 1478. 2151.nuts_pooling_s8 <- brms::nuts_params(fit_pooling_s8)
nuts_pooling_s8 |>
summarise(
divergencias = sum(
Parameter == "divergent__" & Value == 1
),
profundidad_maxima = max(
Value[Parameter == "treedepth__"]
)
) divergencias profundidad_maxima
1 0 68.18.6 Extraer probabilidades posteriores por grupo
Construimos una fila por grupo. Como el modelo contiene solo un intercepto variable, basta especificar el nivel del grupo.
nuevos_grupos_s8 <- tibble(
  grupo = levels(datos_pooling_s8$grupo)
) |>
  mutate(
    grupo = factor(
      grupo,
      levels = levels(datos_pooling_s8$grupo)
    )
  )

epred_grupos_s8 <- posterior_epred(
  fit_pooling_s8,
  newdata = nuevos_grupos_s8,
  re_formula = NULL
)

resumen_partial_s8 <- tibble(
  grupo = factor(
    levels(datos_pooling_s8$grupo),
    levels = levels(datos_pooling_s8$grupo)
  ),
  p_partial = apply(epred_grupos_s8, 2, median),
  q10_partial = apply(
    epred_grupos_s8,
    2,
    quantile,
    probs = 0.10
  ),
  q90_partial = apply(
    epred_grupos_s8,
    2,
    quantile,
    probs = 0.90
  )
)

comparacion_pooling_s8 <- resumen_grupos_s8 |>
  left_join(resumen_partial_s8, by = "grupo") |>
  mutate(
    p_complete = p_pooling_completo_s8
  )
Ordenaremos los grupos por la probabilidad verdadera para facilitar la lectura.
orden_grupos_s8 <- comparacion_pooling_s8 |>
  arrange(p_verdadero) |>
  pull(grupo) |>
  as.character()

comparacion_pooling_s8 |>
  mutate(
    grupo = factor(
      grupo,
      levels = orden_grupos_s8
    )
  ) |>
  select(
    grupo,
    p_verdadero,
    proporcion_observada,
    p_partial,
    p_complete
  ) |>
  pivot_longer(
    -grupo,
    names_to = "estimador",
    values_to = "probabilidad"
  ) |>
  mutate(
    estimador = recode(
      estimador,
      p_verdadero = "Verdadera",
      proporcion_observada = "Sin pooling",
      p_partial = "Pooling parcial",
      p_complete = "Pooling completo"
    )
  ) |>
  ggplot(
    aes(
      x = grupo,
      y = probabilidad,
      shape = estimador
    )
  ) +
  geom_point(size = 2.3) +
  coord_cartesian(ylim = c(0, 1)) +
  labs(
    x = "Grupo, ordenado por probabilidad verdadera",
    y = "Probabilidad",
    shape = NULL
  ) +
  theme_minimal(base_size = 12) +
  theme(
    axis.text.x = element_text(
      angle = 60,
      hjust = 1
    )
  )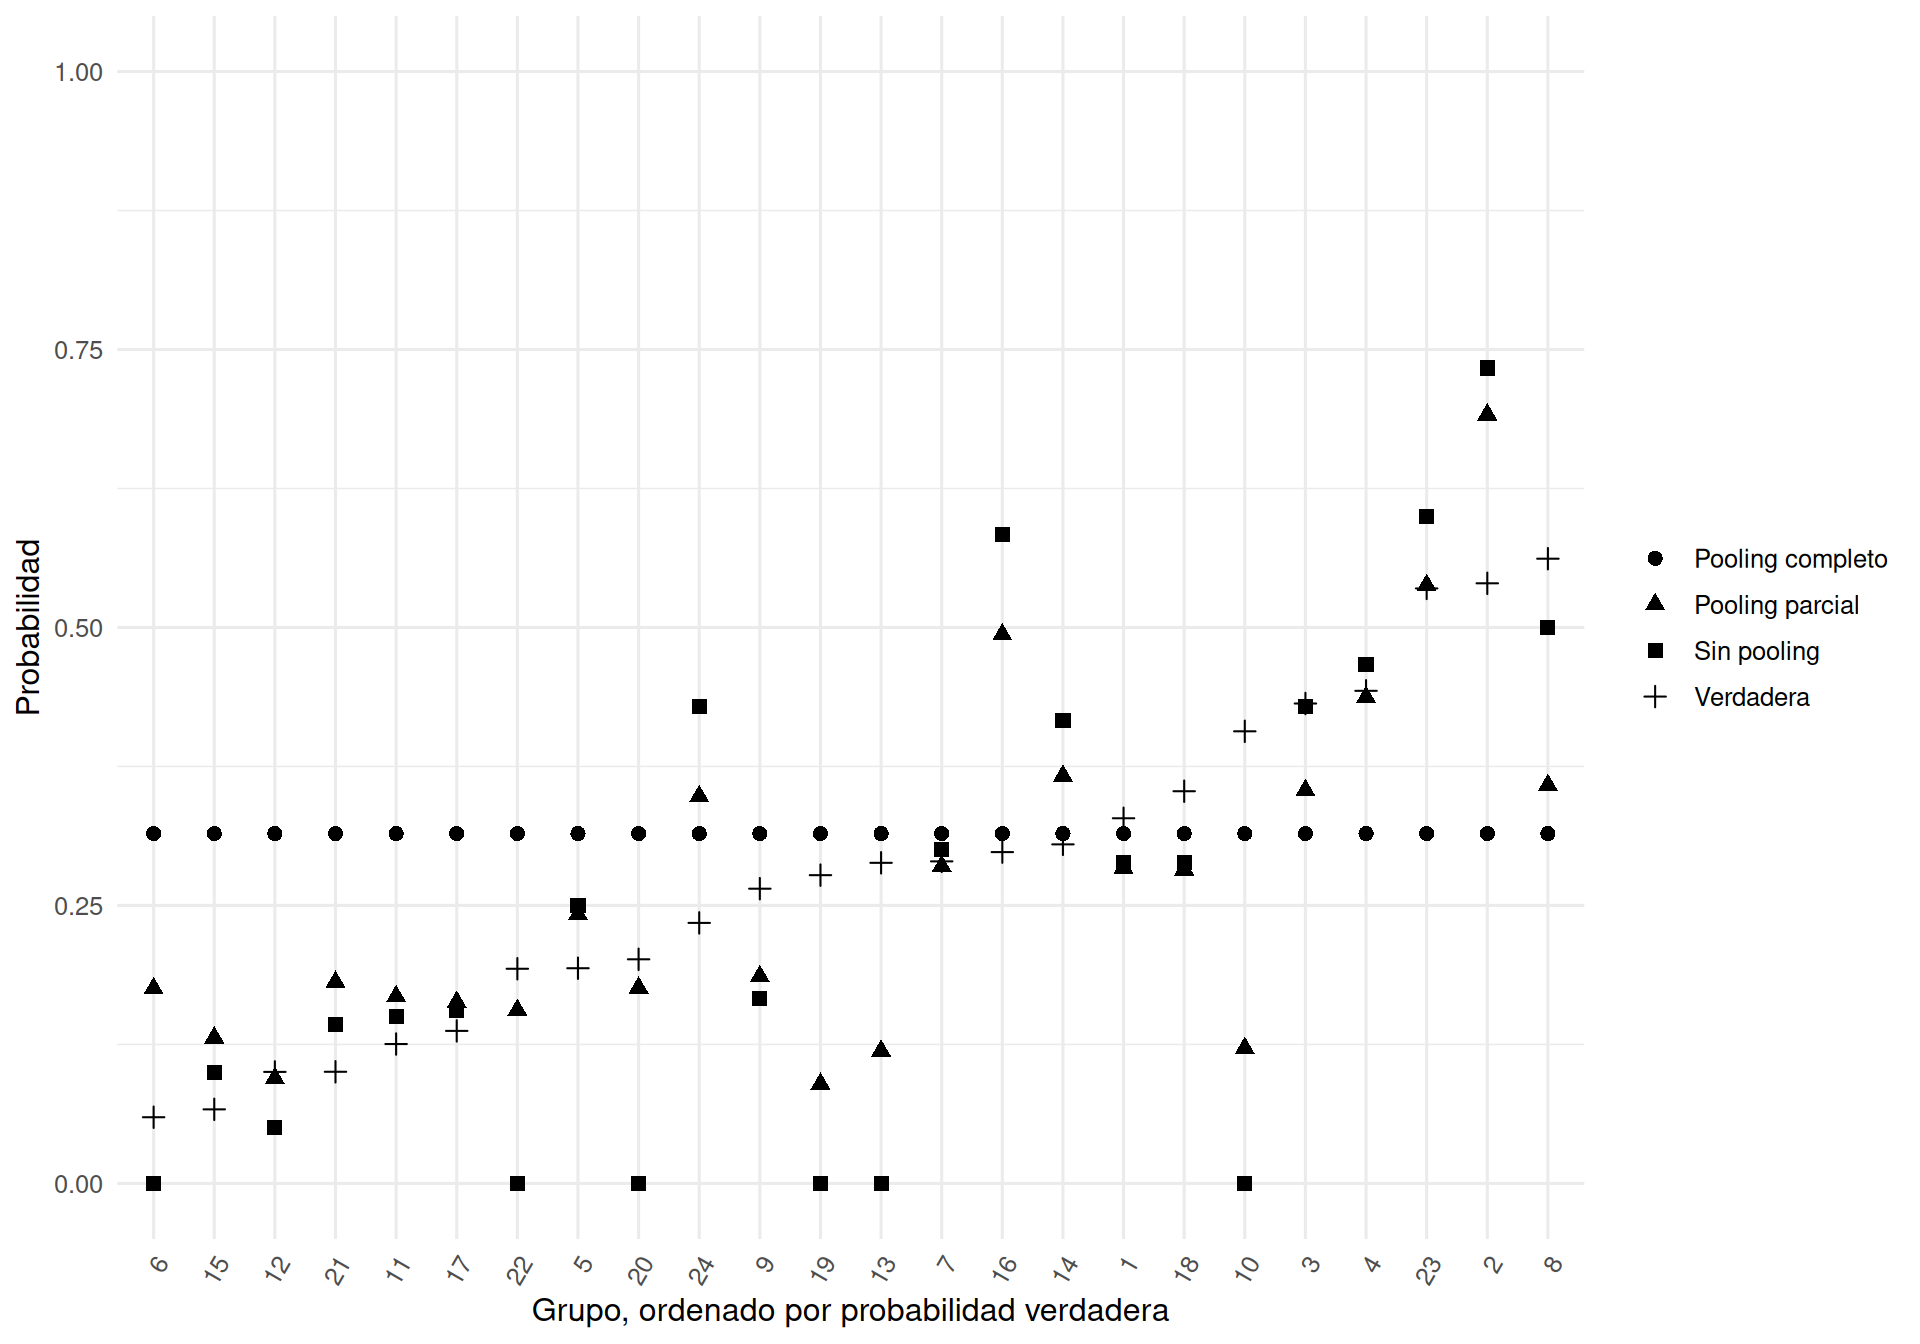
La figura permite comparar las tres estrategias con la verdad conocida. No esperamos que el pooling parcial sea mejor en cada grupo particular; el principio es que la regularización reduce, en promedio, la variabilidad excesiva de las estimaciones poco informadas.
8.18.7 El tamaño del grupo y la magnitud del shrinkage
Definamos una medida simple en la escala de probabilidad:
\[ S_j = \left| \widehat p_j^{\text{PP}} - \widehat p_j^{\text{NP}} \right|. \]
No es un coeficiente de pooling formal; es un resumen descriptivo para visualizar cuánto se separa la mediana posterior de la proporción empírica.
shrinkage_s8 <- comparacion_pooling_s8 |>
  mutate(
    desplazamiento = abs(
      p_partial - proporcion_observada
    )
  )

shrinkage_s8 |>
  ggplot(
    aes(
      x = n,
      y = desplazamiento
    )
  ) +
  geom_point(size = 2.2) +
  geom_smooth(
    method = "loess",
    se = FALSE
  ) +
  labs(
    x = "Tamaño del grupo",
    y = "|Pooling parcial - proporción observada|"
  ) +
  theme_minimal(base_size = 12)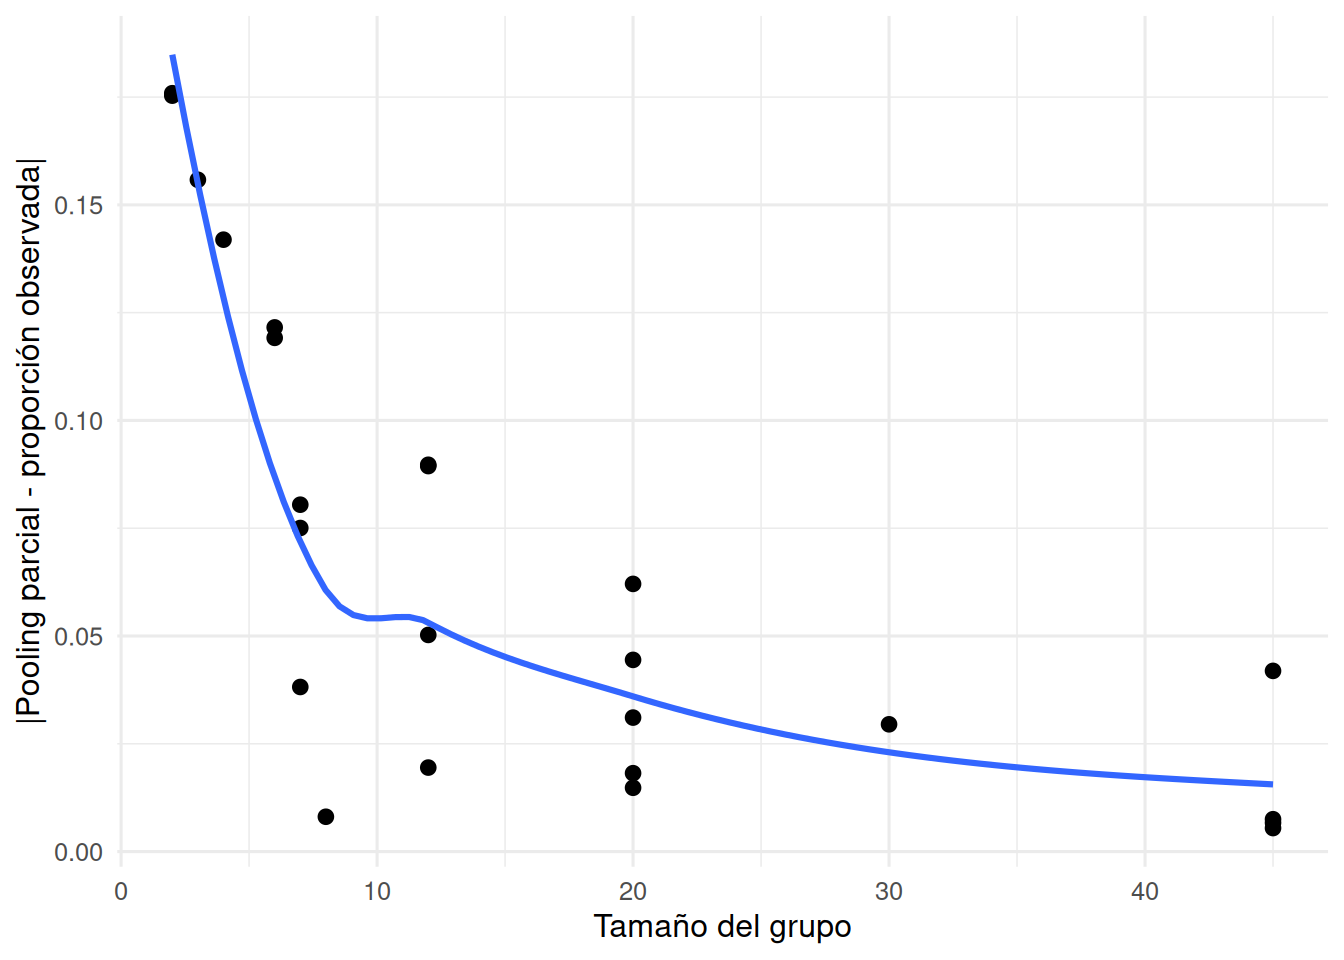
En una simulación particular puede haber excepciones, pero los grupos pequeños suelen admitir desplazamientos mayores porque sus proporciones contienen menos información.
8.19 Experimento 3: fijar el efecto grupal en cero no es marginalizar
Usaremos Ecuación 8.13 para comparar
\[ p_0(\eta)=\operatorname{logit}^{-1}(\eta) \]
con
\[ p_M(\eta,\tau) = E_u\left[ \operatorname{logit}^{-1}(\eta+u) \right]. \]
Aproximaremos la segunda cantidad por Monte Carlo.
set.seed(1653084)

eta_grid_s8 <- seq(-4, 4, length.out = 121)
tau_grid_s8 <- c(0.5, 1.0, 1.8)

marginal_logistico_s8 <- crossing(
  eta = eta_grid_s8,
  tau = tau_grid_s8
) |>
  mutate(
    p_u0 = plogis(eta),
    p_marginal = map2_dbl(
      eta,
      tau,
      ~ mean(
        plogis(
          .x + rnorm(12000, 0, .y)
        )
      )
    )
  )
marginal_logistico_s8 |>
select(
eta,
tau,
`u = 0` = p_u0,
Marginal = p_marginal
) |>
pivot_longer(
cols = c(`u = 0`, Marginal),
names_to = "cantidad",
values_to = "probabilidad"
) |>
ggplot(
aes(
x = eta,
y = probabilidad,
linetype = cantidad
)
) +
geom_line(linewidth = 0.9) +
facet_wrap(
~ tau,
labeller = label_both
) +
labs(
x = expression(eta),
y = "Probabilidad",
linetype = NULL
) +
theme_minimal(base_size = 12)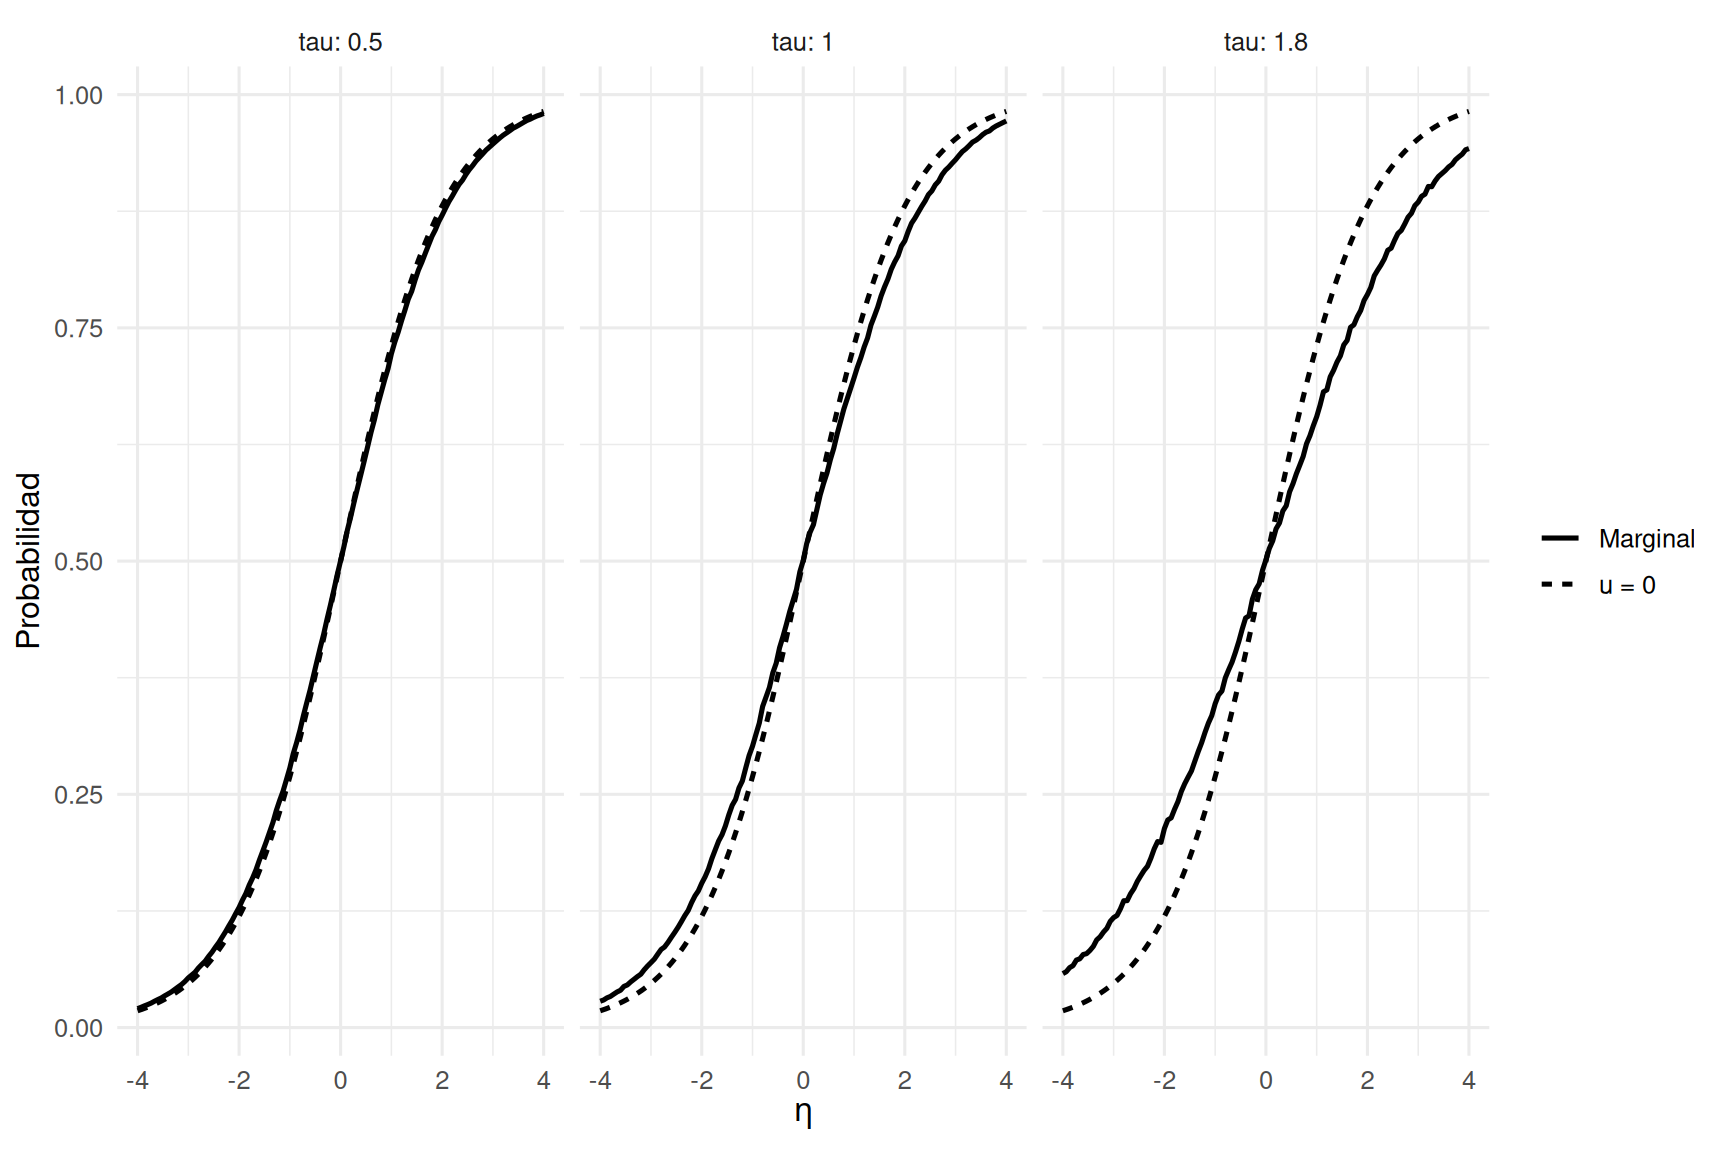
La diferencia aumenta con la heterogeneidad \(\tau\). Este resultado será útil más adelante para comprender por qué dos procedimientos de software etiquetados como “marginales” pueden producir resultados distintos si uno fija coeficientes grupales en cero y otro realmente promedia sobre su distribución.
8.20 Experimento 4: visualizar la separación
Construiremos un ejemplo deliberadamente simple con intercepto fijado en cero:
\[ x_i=-1\Rightarrow y_i=0, \qquad x_i=1\Rightarrow y_i=1. \]
Para un coeficiente \(\beta\), la log-verosimilitud es
\[ \ell(\beta) = \sum_i \left[ y_i\log p_i +(1-y_i)\log(1-p_i) \right], \]
con
\[ p_i=\operatorname{logit}^{-1}(\beta x_i). \]
x_sep_s8 <- rep(c(-1, 1), each = 20)
y_sep_s8 <- rep(c(0, 1), each = 20)

beta_grid_s8 <- seq(-2, 12, length.out = 600)

loglik_sep_s8 <- map_dbl(
  beta_grid_s8,
  function(beta) {
    p <- plogis(beta * x_sep_s8)
    sum(dbinom(
      y_sep_s8,
      size = 1,
      prob = p,
      log = TRUE
    ))
  }
)

logprior_sep_s8 <- dnorm(
  beta_grid_s8,
  mean = 0,
  sd = 1.5,
  log = TRUE
)

separacion_s8 <- tibble(
  beta = beta_grid_s8,
  `Log-verosimilitud` = loglik_sep_s8 - max(loglik_sep_s8),
  `Log-posterior con prior N(0, 1.5)` =
    loglik_sep_s8 + logprior_sep_s8 -
    max(loglik_sep_s8 + logprior_sep_s8)
) |>
  pivot_longer(
    -beta,
    names_to = "funcion",
    values_to = "valor"
  )
separacion_s8 |>
ggplot(
aes(
x = beta,
y = valor,
linetype = funcion
)
) +
geom_line(linewidth = 0.9) +
coord_cartesian(ylim = c(-15, 0)) +
labs(
x = expression(beta),
y = "Log densidad relativa",
linetype = NULL
) +
theme_minimal(base_size = 12)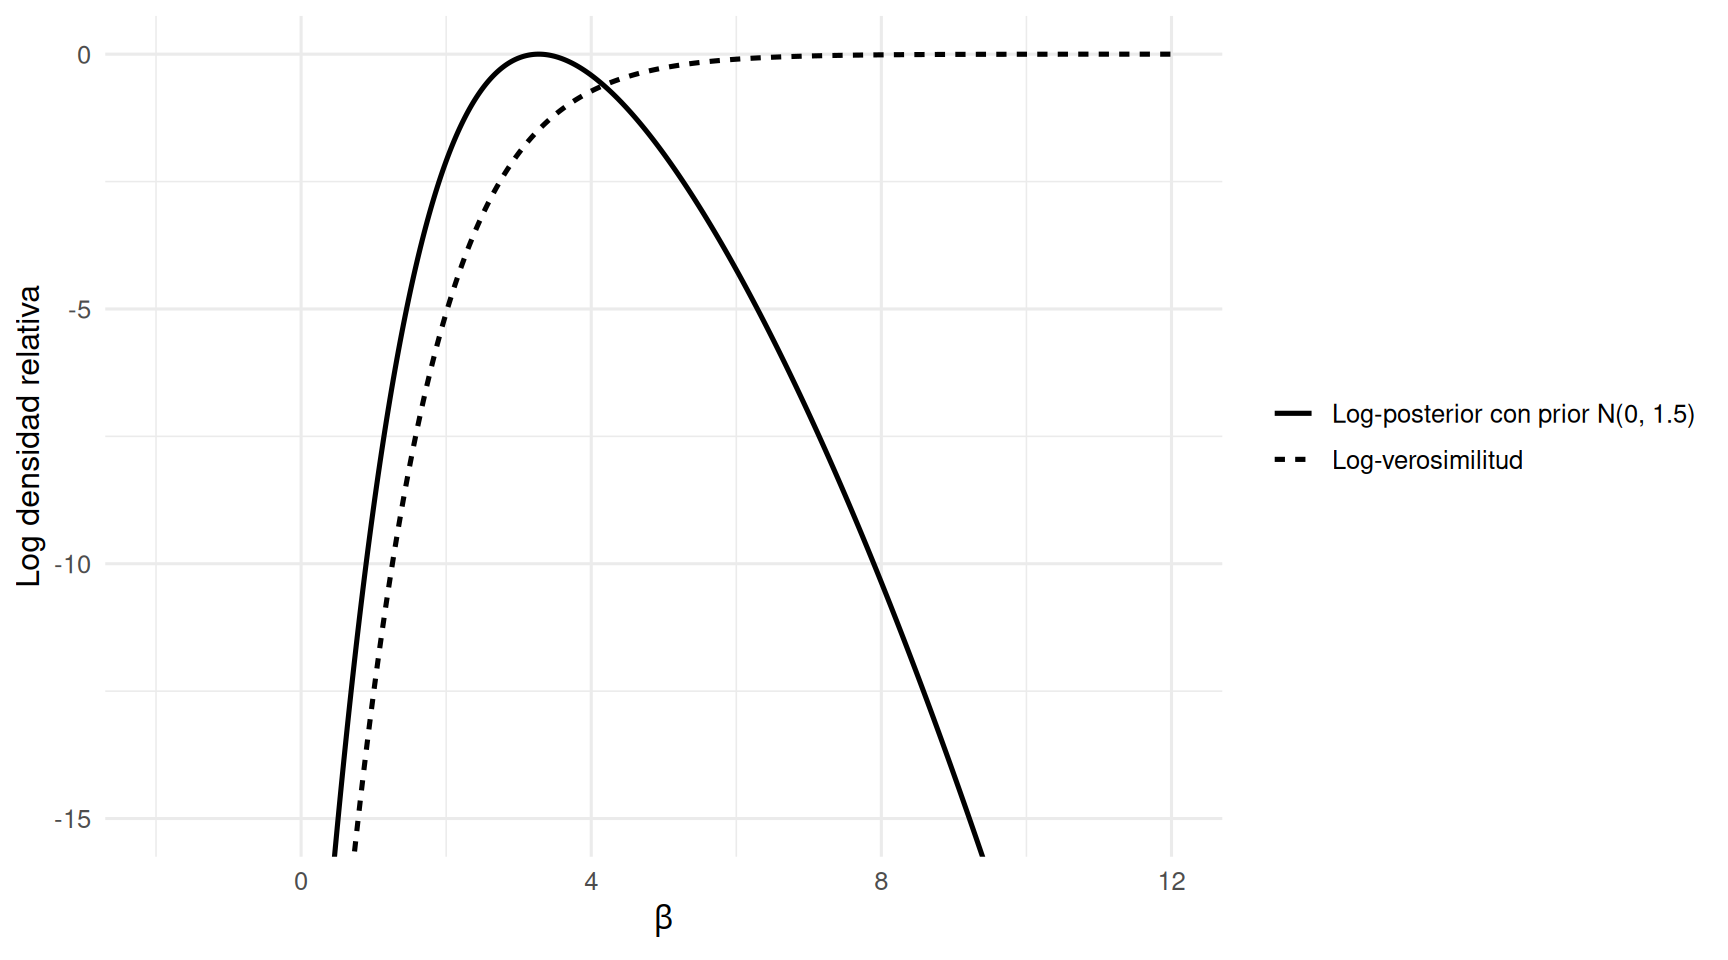
La figura no implica que Normal(0, 1.5) sea la previa correcta para todos los problemas. Muestra el papel conceptual de una previa propia: evita que la inferencia dependa de valores arbitrariamente grandes cuando los datos solo indican que la asociación es suficientemente fuerte para separar las observaciones.
8.21 Aplicación: agresión verbal con factores cruzados
Para la aplicación utilizaremos VerbAgg, un conjunto de datos distribuido con lme4. Bürkner lo utiliza para ilustrar que la misma sintaxis general de modelos multinivel puede extenderse a una respuesta Bernoulli con dos factores de agrupamiento, persona e ítem (Bürkner 2017).
El objetivo aquí no es reproducir el modelo completo del artículo. Utilizaremos una especificación deliberadamente más sencilla para concentrarnos en cuatro ideas:
- respuesta Bernoulli;
- predictor lineal en escala logit;
- interceptos variables para dos factores cruzados;
- interpretación y comprobación en la escala de probabilidad.
8.21.1 Preparar los datos
data("VerbAgg", package = "lme4")

convertir_binaria_s8 <- function(x) {
  if (is.logical(x)) {
    return(as.integer(x))
  }

  if (is.numeric(x) || is.integer(x)) {
    valores <- sort(unique(x[!is.na(x)]))

    if (!all(valores %in% c(0, 1))) {
      stop("La variable numérica no está codificada como 0/1.")
    }

    return(as.integer(x))
  }

  x_chr <- as.character(x)
  valores <- sort(unique(x_chr[!is.na(x_chr)]))

  if (all(valores %in% c("0", "1"))) {
    return(as.integer(x_chr))
  }

  if (length(valores) == 2) {
    return(
      as.integer(
        factor(x_chr, levels = valores)
      ) - 1L
    )
  }

  stop("No fue posible convertir la respuesta a una variable binaria 0/1.")
}

datos_verbagg_s8 <- as_tibble(VerbAgg) |>
  mutate(
    y = convertir_binaria_s8(r2),
    id = factor(id),
    item = factor(item),
    Gender = factor(Gender),
    btype = factor(btype),
    situ = factor(situ),
    Anger_z = as.numeric(scale(Anger))
  ) |>
  select(
    y,
    Anger,
    Anger_z,
    Gender,
    btype,
    situ,
    id,
    item
  )
Antes de modelar comprobamos faltantes, codificación y estructura de agrupamiento.
tibble(
  n_observaciones = nrow(datos_verbagg_s8),
  faltantes = sum(is.na(datos_verbagg_s8)),
  n_personas = n_distinct(datos_verbagg_s8$id),
  n_items = n_distinct(datos_verbagg_s8$item),
  proporcion_unos = mean(datos_verbagg_s8$y)
)
# A tibble: 1 × 5
n_observaciones faltantes n_personas n_items proporcion_unos
<int> <int> <int> <int> <dbl>
1 7584 0 316 24 0.476list(
respuesta = table(datos_verbagg_s8$y),
genero = table(datos_verbagg_s8$Gender),
tipo = table(datos_verbagg_s8$btype),
situacion = table(datos_verbagg_s8$situ)
)$respuesta
0 1
3973 3611
$genero
F M
5832 1752
$tipo
curse scold shout
2528 2528 2528
$situacion
other self
3792 3792 La estructura no es una jerarquía simple persona \(\rightarrow\) ítem. Las respuestas están clasificadas simultáneamente por persona e ítem, por lo que retomamos la lógica de estructuras cruzadas de la semana 5.
8.21.2 Exploración inicial
Una respuesta binaria individual se visualiza mejor mediante resúmenes que mediante una nube de puntos 0/1. Calcularemos tasas observadas por persona y por ítem.
por_persona_s8 <- datos_verbagg_s8 |>
  group_by(id) |>
  summarise(
    n = n(),
    proporcion = mean(y),
    anger_promedio = mean(Anger_z),
    .groups = "drop"
  )

por_item_s8 <- datos_verbagg_s8 |>
  group_by(item) |>
  summarise(
    n = n(),
    proporcion = mean(y),
    .groups = "drop"
  )
por_persona_s8 |>
ggplot(aes(x = reorder(id, proporcion), y = proporcion)) +
geom_point(size = 1.3) +
coord_cartesian(ylim = c(0, 1)) +
labs(
x = "Persona, ordenada por proporción observada",
y = "Proporción observada"
) +
theme_minimal(base_size = 12) +
theme(
axis.text.x = element_blank(),
axis.ticks.x = element_blank()
)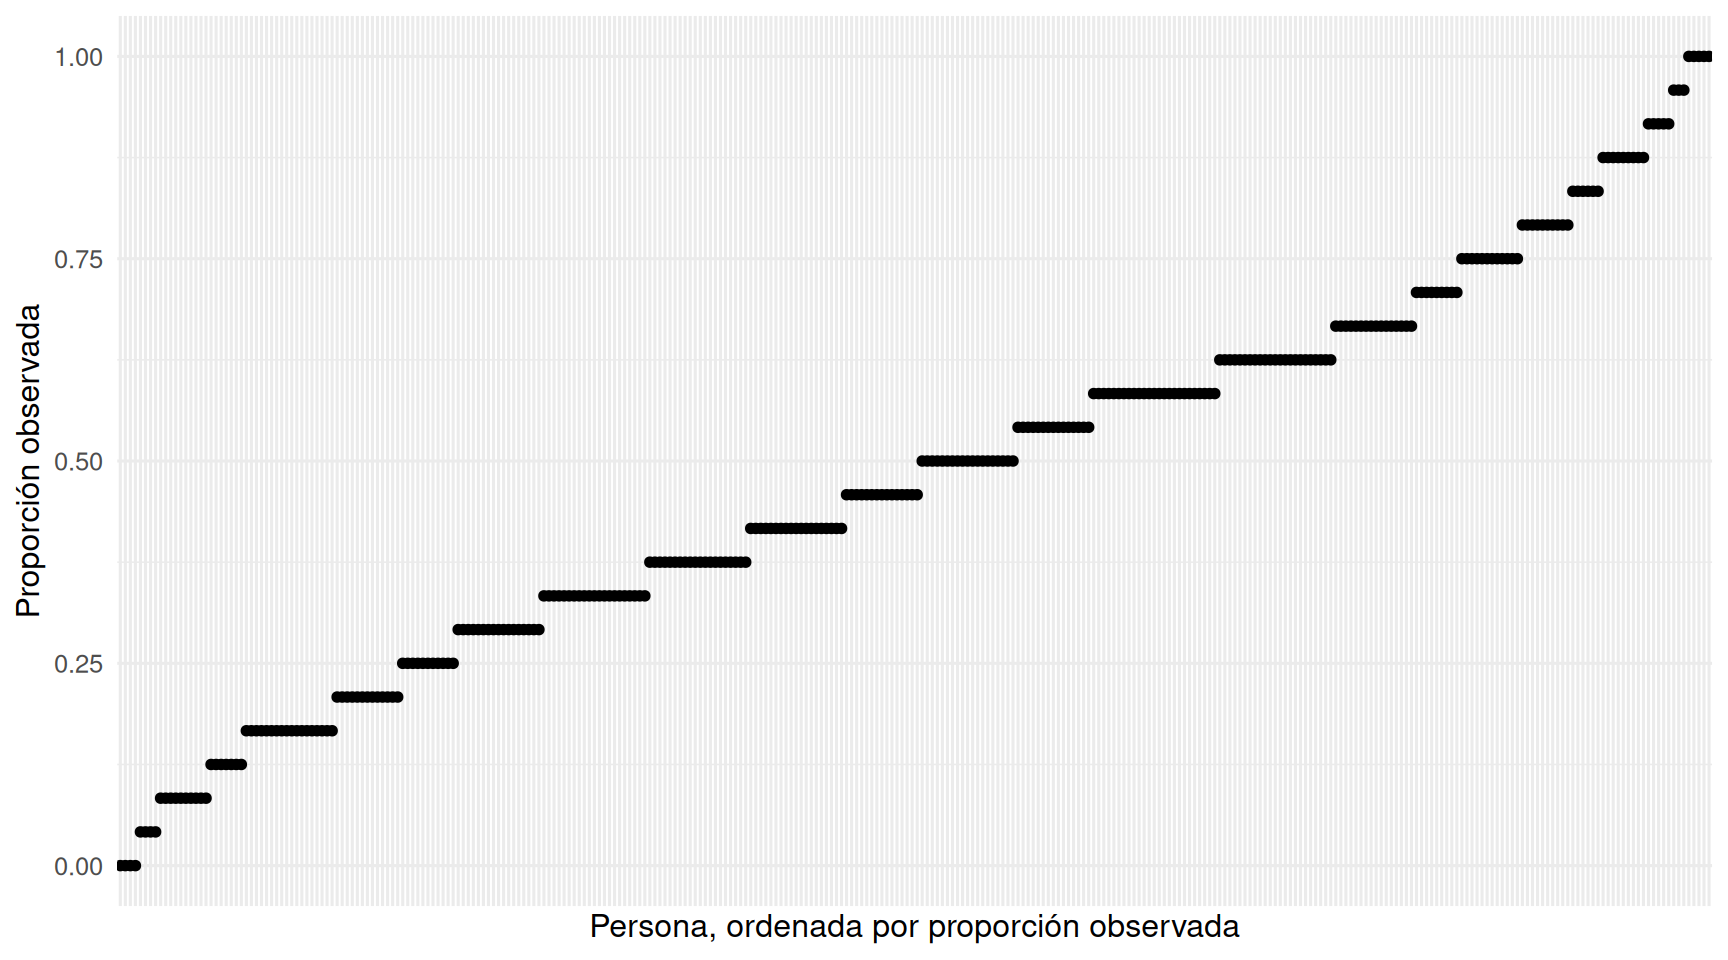
No debemos interpretar cada diferencia entre proporciones como una diferencia verdadera entre personas. Precisamente por eso utilizaremos pooling parcial.
8.21.3 Pregunta y modelo
Nuestro modelo de trabajo será
\[ y_i\mid p_i \sim \operatorname{Bernoulli}(p_i), \]
\[ \begin{aligned} \operatorname{logit}(p_i) ={}& \alpha +\beta_A\operatorname{Anger}_{z,i} +\boldsymbol\beta_G^\top G_i +\boldsymbol\beta_B^\top B_i\\ &+\boldsymbol\beta_S^\top S_i +u_{\operatorname{id}[i]} +v_{\operatorname{item}[i]}, \end{aligned} \tag{8.16}\]
con
\[ u_j\sim\mathcal N(0,\tau_{\text{id}}^2), \]
\[ v_k\sim\mathcal N(0,\tau_{\text{item}}^2). \]
Los términos \(G_i\), \(B_i\) y \(S_i\) representan las variables indicadoras creadas a partir de Gender, btype y situ según los contrastes de R. El coeficiente \(\beta_A\) corresponde a una diferencia de una desviación estándar en Anger, porque utilizamos Anger_z.
La formulación contiene dos poblaciones de interceptos variables:
- una para personas;
- otra para ítems.
Esto permite separar parcialmente la heterogeneidad asociada con quién responde de la heterogeneidad asociada con el ítem respondido.
NotaPor qué no incluimos todas las interacciones del ejemplo de Bürkner
Bürkner muestra una fórmula más rica con interacciones entre los predictores. Aquí reducimos deliberadamente la parte poblacional para que la clase se concentre en la extensión Bernoulli y en la estructura cruzada. Una expansión con interacciones debe responder a una pregunta sustantiva y puede utilizarse como ejercicio posterior.
8.21.4 Fórmula en brms
formula_verbagg_s8 <- bf(
  y ~
    1 +
    Anger_z +
    Gender +
    btype +
    situ +
    (1 | id) +
    (1 | item)
)

formula_verbagg_s8
y ~ 1 + Anger_z + Gender + btype + situ + (1 | id) + (1 | item) Esta estructura sigue la sintaxis general documentada por Bürkner para modelos Bernoulli multinivel, donde los términos grupales se incorporan en el predictor lineal y Stan se utiliza para la inferencia bayesiana (Bürkner 2017).
8.21.5 Inspeccionar las clases de parámetros
get_prior(
  formula = formula_verbagg_s8,
  data = datos_verbagg_s8,
  family = bernoulli(link = "logit")
)
prior class coef group resp dpar nlpar lb ub tag
(flat) b
(flat) b Anger_z
(flat) b btypescold
(flat) b btypeshout
(flat) b GenderM
(flat) b situself
student_t(3, 0, 2.5) Intercept
student_t(3, 0, 2.5) sd 0
student_t(3, 0, 2.5) sd id 0
student_t(3, 0, 2.5) sd Intercept id 0
student_t(3, 0, 2.5) sd item 0
student_t(3, 0, 2.5) sd Intercept item 0
source
default
(vectorized)
(vectorized)
(vectorized)
(vectorized)
(vectorized)
default
default
(vectorized)
(vectorized)
(vectorized)
(vectorized)La inspección es importante porque evita especificar previas usando nombres de parámetros supuestos. En brms, los coeficientes poblacionales pertenecen a la clase b, el intercepto a Intercept y las desviaciones estándar grupales a sd.
8.21.6 Previas
Utilizaremos
\[ \alpha\sim\mathcal N(0,1.5^2), \]
\[ \beta_k\sim\mathcal N(0,0.7^2), \]
\[ \tau_{\text{id}},\tau_{\text{item}} \sim \operatorname{Exponential}(1). \]
priors_verbagg_s8 <- c(
  prior(normal(0, 1.5), class = "Intercept"),
  prior(normal(0, 0.7), class = "b"),
  prior(exponential(1), class = "sd")
)

priors_verbagg_s8
prior class coef group resp dpar nlpar lb ub tag source
normal(0, 1.5) Intercept <NA> <NA> user
normal(0, 0.7) b <NA> <NA> user
exponential(1) sd <NA> <NA> userEstas previas son una decisión pedagógica para este ejemplo, no valores por defecto recomendados para cualquier análisis binario. La estandarización de Anger hace que la escala de normal(0, 0.7) sea interpretable en términos de una desviación estándar del predictor.
8.21.7 Comprobación predictiva previa con brms
Ajustaremos primero únicamente la previa. El archivo de caché evita repetir este paso cuando el modelo y sus dependencias no cambian.
fit_prior_verbagg_s8 <- brm(
  formula = formula_verbagg_s8,
  data = datos_verbagg_s8,
  family = bernoulli(link = "logit"),
  prior = priors_verbagg_s8,
  sample_prior = "only",
  backend = "cmdstanr",
  seed = 1653085,
  chains = 4,
  cores = 4,
  iter = 1400,
  warmup = 700,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s8_verbagg_prior_cmdstanr"
  ),
  file_refit = "on_change"
)
Una comprobación muy básica es la distribución previa del porcentaje total de respuestas 1.
set.seed(1653086)

yrep_prior_verbagg_s8 <- posterior_predict(
  fit_prior_verbagg_s8,
  ndraws = 500
)

prior_media_verbagg_s8 <- tibble(
  proporcion = rowMeans(yrep_prior_verbagg_s8)
)
prior_media_verbagg_s8 |>
ggplot(aes(x = proporcion)) +
geom_histogram(bins = 40) +
geom_vline(
xintercept = mean(datos_verbagg_s8$y),
linetype = 2
) +
coord_cartesian(xlim = c(0, 1)) +
labs(
x = "Proporción predictiva previa de respuestas 1",
y = "Frecuencia"
) +
theme_minimal(base_size = 12)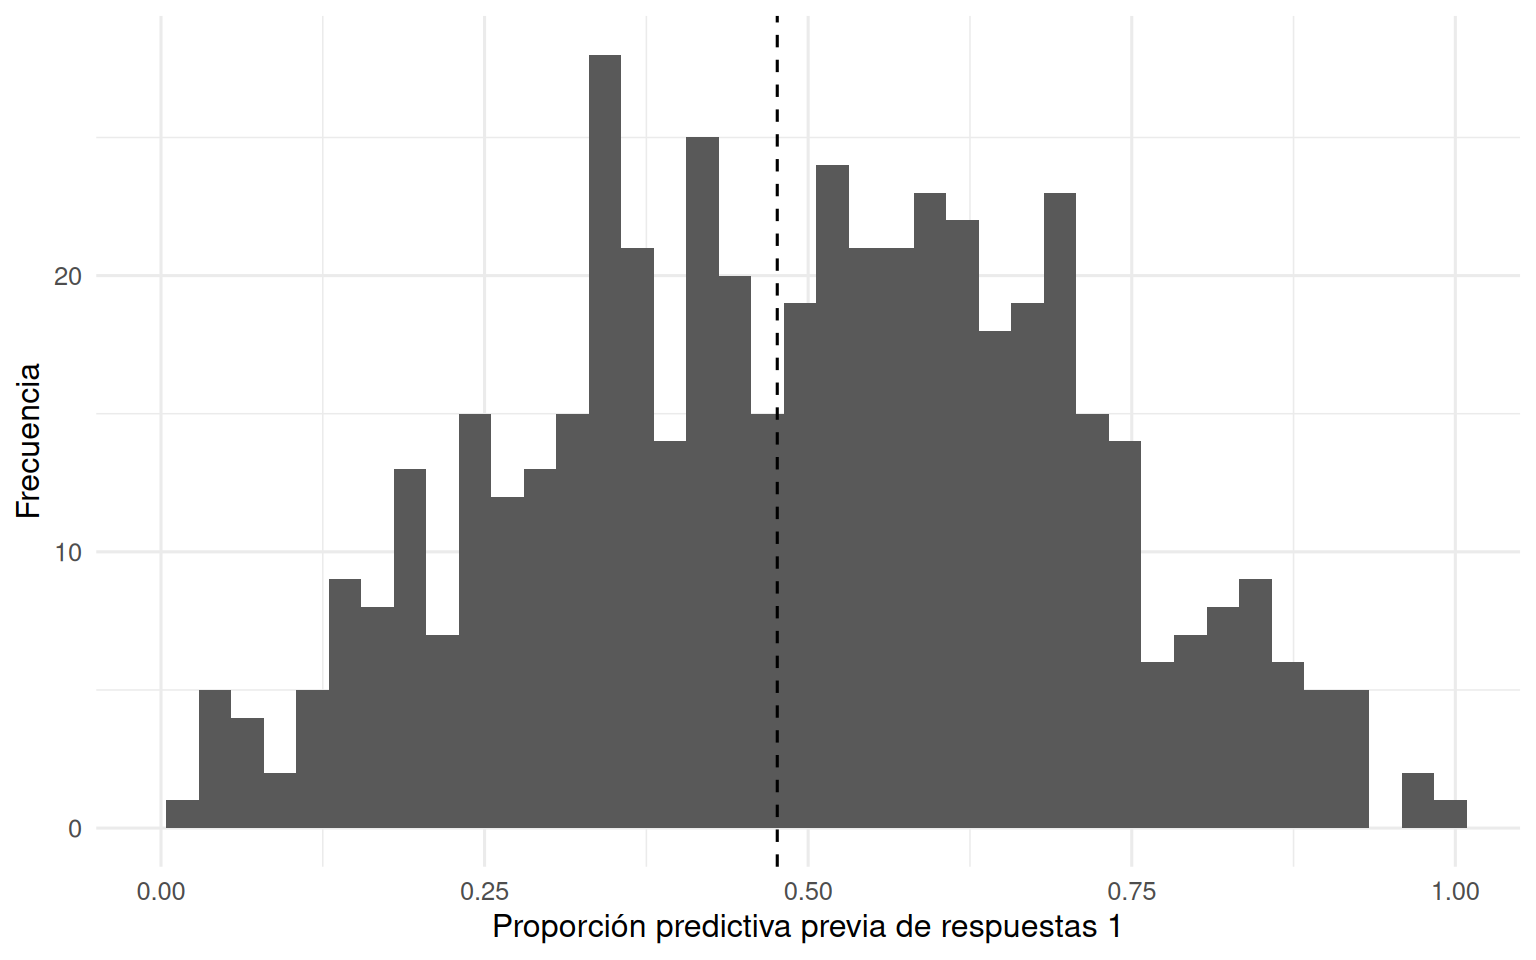
La línea observada no se utiliza aquí para “afinar” las previas hasta que el gráfico coincida con los datos. Su función en las notas es permitir discutir si las previas son tan restrictivas que excluyen resultados razonables o tan amplias que generan casi siempre configuraciones extremas.
8.21.8 Ajuste posterior
fit_verbagg_s8 <- brm(
  formula = formula_verbagg_s8,
  data = datos_verbagg_s8,
  family = bernoulli(link = "logit"),
  prior = priors_verbagg_s8,
  backend = "cmdstanr",
  seed = 1653087,
  chains = 4,
  cores = 4,
  iter = 2500,
  warmup = 1000,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s8_verbagg_bernoulli_cmdstanr"
  ),
  file_refit = "on_change"
)
No interpretaremos el ajuste antes de revisar los diagnósticos de la semana 7.
8.22 Diagnóstico computacional de la aplicación
8.22.1 \(\widehat R\) y tamaños efectivos
resumen_mcmc_verbagg_s8 <- posterior::summarise_draws(
  as_draws_df(fit_verbagg_s8),
  "mean",
  "sd",
  "rhat",
  "ess_bulk",
  "ess_tail"
) |>
  filter(
    str_detect(variable, "^(b_|sd_)")
  )

resumen_mcmc_verbagg_s8
# A tibble: 8 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept 1.05 0.271 1.00 842. 1616.
2 b_Anger_z 0.280 0.0823 1.01 810. 1617.
3 b_GenderM 0.306 0.187 1.00 784. 1475.
4 b_btypescold -0.750 0.296 1.00 964. 1694.
5 b_btypeshout -1.71 0.312 1.00 840. 1521.
6 b_situself -0.925 0.238 1.01 952. 1888.
7 sd_id__Intercept 1.36 0.0692 1.00 1280. 2881.
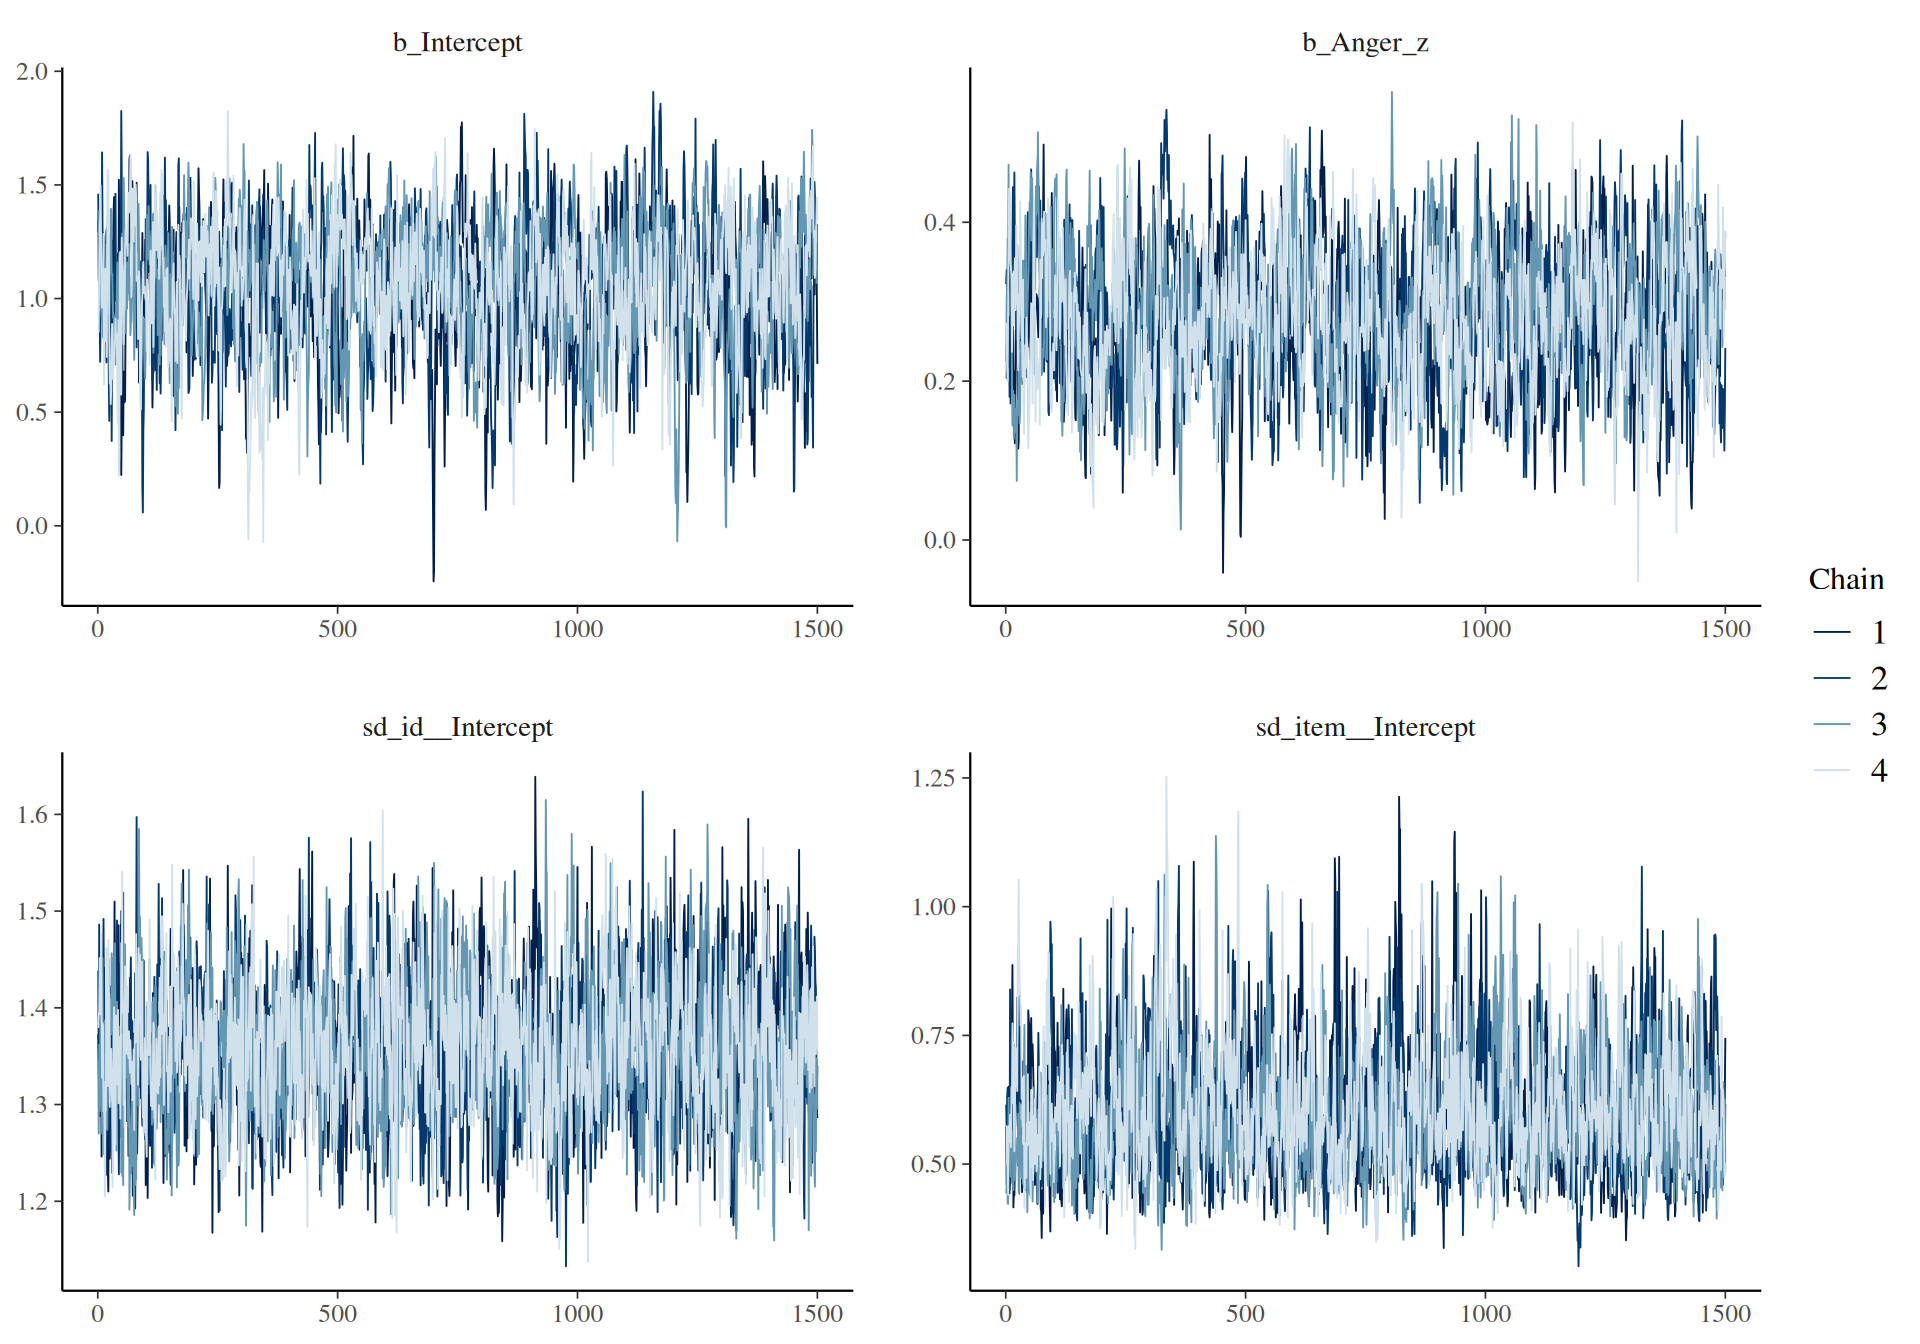
8 sd_item__Intercept 0.603 0.120 1.00 967. 1985.Buscamos cadenas mezcladas, \(\widehat R\) cercanos a 1 y tamaños efectivos suficientes para las cantidades que queremos resumir. No aplicaremos un umbral aislado como sustituto de la revisión conjunta.
8.22.2 Divergencias y profundidad del árbol
nuts_verbagg_s8 <- brms::nuts_params(fit_verbagg_s8)

resumen_nuts_verbagg_s8 <- nuts_verbagg_s8 |>
  summarise(
    divergencias = sum(
      Parameter == "divergent__" & Value == 1
    ),
    profundidad_maxima = max(
      Value[Parameter == "treedepth__"]
    ),
    saturaciones_treedepth_12 = sum(
      Parameter == "treedepth__" & Value >= 12
    )
  )

resumen_nuts_verbagg_s8
divergencias profundidad_maxima saturaciones_treedepth_12
1 0 6 0Si aparecen divergencias, no modificaremos automáticamente adapt_delta. Primero revisaremos si la dificultad se relaciona con escalas, priors, identificación, estructura del modelo o parametrización, siguiendo el flujo de la semana 7.
8.22.3 Trazas de parámetros seleccionados
Seleccionaremos automáticamente algunos coeficientes poblacionales y desviaciones estándar para no depender de los nombres concretos de todos los niveles factoriales.
variables_disponibles_s8 <- posterior::variables(
  as_draws_array(fit_verbagg_s8)
)

variables_traza_s8 <- variables_disponibles_s8[
  str_detect(
    variables_disponibles_s8,
    "^(b_Intercept|b_Anger_z|sd_)"
  )
]

variables_traza_s8 <- head(
  variables_traza_s8,
  6
)

variables_traza_s8
[1] "b_Intercept" "b_Anger_z" "sd_id__Intercept"
[4] "sd_item__Intercept"bayesplot::mcmc_trace(
as_draws_array(fit_verbagg_s8),
pars = variables_traza_s8
)
8.23 Interpretación posterior
8.23.1 Coeficiente de Anger_z
El coeficiente puede resumirse en log-odds y odds ratio.
draws_verbagg_s8 <- as_draws_df(fit_verbagg_s8)

resumen_anger_s8 <- draws_verbagg_s8 |>
  transmute(
    beta_anger = b_Anger_z,
    odds_ratio = exp(beta_anger)
  ) |>
  summarise(
    beta_mediana = median(beta_anger),
    beta_q05 = quantile(beta_anger, 0.05),
    beta_q95 = quantile(beta_anger, 0.95),
    or_mediana = median(odds_ratio),
    or_q05 = quantile(odds_ratio, 0.05),
    or_q95 = quantile(odds_ratio, 0.95)
  )

resumen_anger_s8
# A tibble: 1 × 6
beta_mediana beta_q05 beta_q95 or_mediana or_q05 or_q95
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 0.277 0.146 0.415 1.32 1.16 1.51Como Anger_z está estandarizado, el odds ratio compara observaciones que difieren en una desviación estándar de Anger, manteniendo iguales los demás predictores y el mismo valor de los coeficientes grupales.
Pero la probabilidad es más informativa para la comunicación. Construiremos escenarios para Anger_z entre -2 y 2, fijando los factores categóricos en sus niveles de referencia y excluyendo los interceptos variables mediante re_formula = NA.
nivel_gender_ref_s8 <- levels(datos_verbagg_s8$Gender)[1]
nivel_btype_ref_s8 <- levels(datos_verbagg_s8$btype)[1]
nivel_situ_ref_s8 <- levels(datos_verbagg_s8$situ)[1]
id_ref_s8 <- levels(datos_verbagg_s8$id)[1]
item_ref_s8 <- levels(datos_verbagg_s8$item)[1]

escenarios_anger_s8 <- tibble(
  Anger_z = seq(-2, 2, length.out = 81),
  Gender = factor(
    nivel_gender_ref_s8,
    levels = levels(datos_verbagg_s8$Gender)
  ),
  btype = factor(
    nivel_btype_ref_s8,
    levels = levels(datos_verbagg_s8$btype)
  ),
  situ = factor(
    nivel_situ_ref_s8,
    levels = levels(datos_verbagg_s8$situ)
  ),
  id = id_ref_s8,
  item = item_ref_s8
)

epred_anger_s8 <- posterior_epred(
  fit_verbagg_s8,
  newdata = escenarios_anger_s8,
  re_formula = NA,
  ndraws = 1200
)

resumen_epred_anger_s8 <- escenarios_anger_s8 |>
  mutate(
    mediana = apply(epred_anger_s8, 2, median),
    q10 = apply(
      epred_anger_s8,
      2,
      quantile,
      probs = 0.10
    ),
    q90 = apply(
      epred_anger_s8,
      2,
      quantile,
      probs = 0.90
    )
  )
resumen_epred_anger_s8 |>
ggplot(aes(x = Anger_z, y = mediana)) +
geom_ribbon(
aes(ymin = q10, ymax = q90),
alpha = 0.25
) +
geom_line(linewidth = 0.9) +
coord_cartesian(ylim = c(0, 1)) +
labs(
x = "Anger estandarizado",
y = "Probabilidad posterior esperada"
) +
theme_minimal(base_size = 12)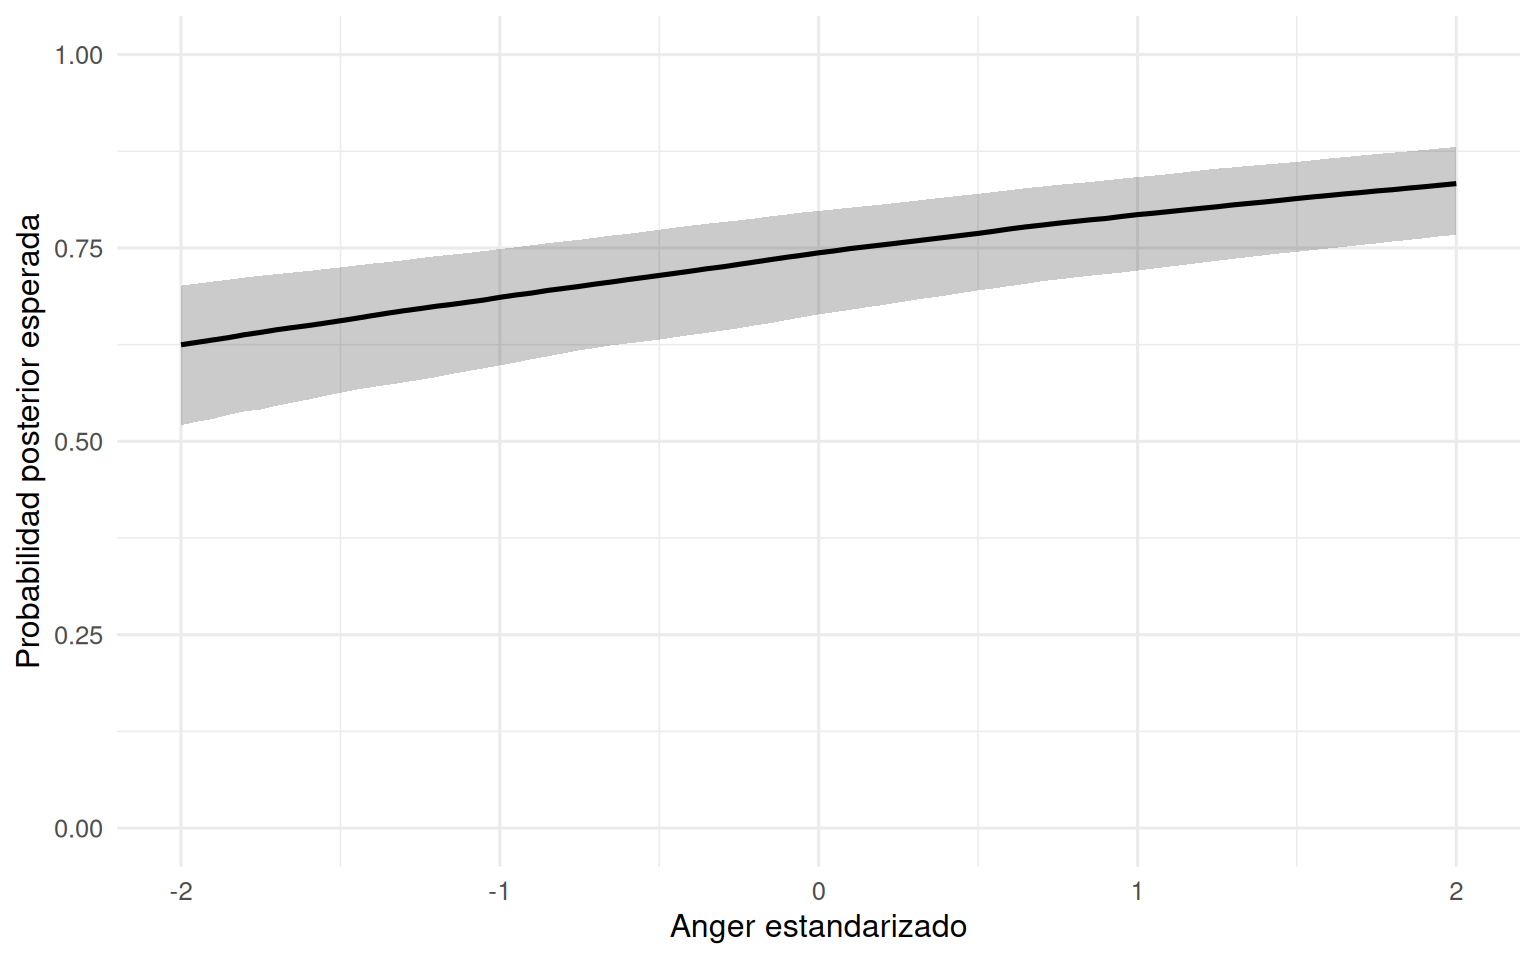
Esta curva no es una probabilidad marginal promediada sobre personas e ítems. Es una curva de referencia con los términos grupales fijados en cero. La distinción evita llamar “promedio poblacional” a una cantidad que no ha sido integrada sobre la distribución de grupos.
8.23.2 Variación entre personas e ítems
resumen_mcmc_verbagg_s8 |>
  filter(str_detect(variable, "^sd_"))
# A tibble: 2 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 sd_id__Intercept 1.36 0.0692 1.00 1280. 2881.
2 sd_item__Intercept 0.603 0.120 1.00 967. 1985.Las desviaciones estándar se encuentran en la escala logit. Para comunicar su magnitud conviene complementar esta tabla con predicciones de probabilidad para grupos existentes y nuevos, en vez de intentar convertir una desviación estándar logit en una única diferencia de probabilidad.
8.24 Comprobación predictiva posterior
Para una respuesta 0/1, comparar únicamente histogramas de observaciones individuales es poco informativo: todas las réplicas también contienen ceros y unos. Necesitamos estadísticas que reflejen características relevantes del problema.
Usaremos tres cantidades:
- proporción global de respuestas 1;
- desviación estándar de las proporciones por persona;
- desviación estándar de las proporciones por ítem.
Las dos últimas evalúan si el modelo reproduce aproximadamente la heterogeneidad observada entre los dos factores de agrupamiento.
set.seed(1653088)

yrep_verbagg_s8 <- posterior_predict(
  fit_verbagg_s8,
  ndraws = 350
)

indices_id_s8 <- split(
  seq_len(nrow(datos_verbagg_s8)),
  datos_verbagg_s8$id
)

indices_item_s8 <- split(
  seq_len(nrow(datos_verbagg_s8)),
  datos_verbagg_s8$item
)

sd_tasas_grupo_s8 <- function(y, indices) {
  tasas <- vapply(
    indices,
    function(ind) mean(y[ind]),
    numeric(1)
  )

  sd(tasas)
}

ppc_estadisticas_s8 <- tibble(
  draw = seq_len(nrow(yrep_verbagg_s8)),
  proporcion_global = rowMeans(yrep_verbagg_s8),
  sd_personas = apply(
    yrep_verbagg_s8,
    1,
    sd_tasas_grupo_s8,
    indices = indices_id_s8
  ),
  sd_items = apply(
    yrep_verbagg_s8,
    1,
    sd_tasas_grupo_s8,
    indices = indices_item_s8
  )
)

observadas_ppc_s8 <- tibble(
  estadistica = c(
    "Proporción global",
    "DE de proporciones por persona",
    "DE de proporciones por ítem"
  ),
  observado = c(
    mean(datos_verbagg_s8$y),
    sd_tasas_grupo_s8(
      datos_verbagg_s8$y,
      indices_id_s8
    ),
    sd_tasas_grupo_s8(
      datos_verbagg_s8$y,
      indices_item_s8
    )
  )
)

ppc_largo_s8 <- ppc_estadisticas_s8 |>
  select(-draw) |>
  rename(
    `Proporción global` = proporcion_global,
    `DE de proporciones por persona` = sd_personas,
    `DE de proporciones por ítem` = sd_items
  ) |>
  pivot_longer(
    everything(),
    names_to = "estadistica",
    values_to = "replicado"
  )
ppc_largo_s8 |>
left_join(
observadas_ppc_s8,
by = "estadistica"
) |>
ggplot(aes(x = replicado)) +
geom_histogram(bins = 35) +
geom_vline(
aes(xintercept = observado),
linetype = 2
) +
facet_wrap(
~ estadistica,
scales = "free",
ncol = 1
) +
labs(
x = "Estadística en datos replicados",
y = "Frecuencia"
) +
theme_minimal(base_size = 12)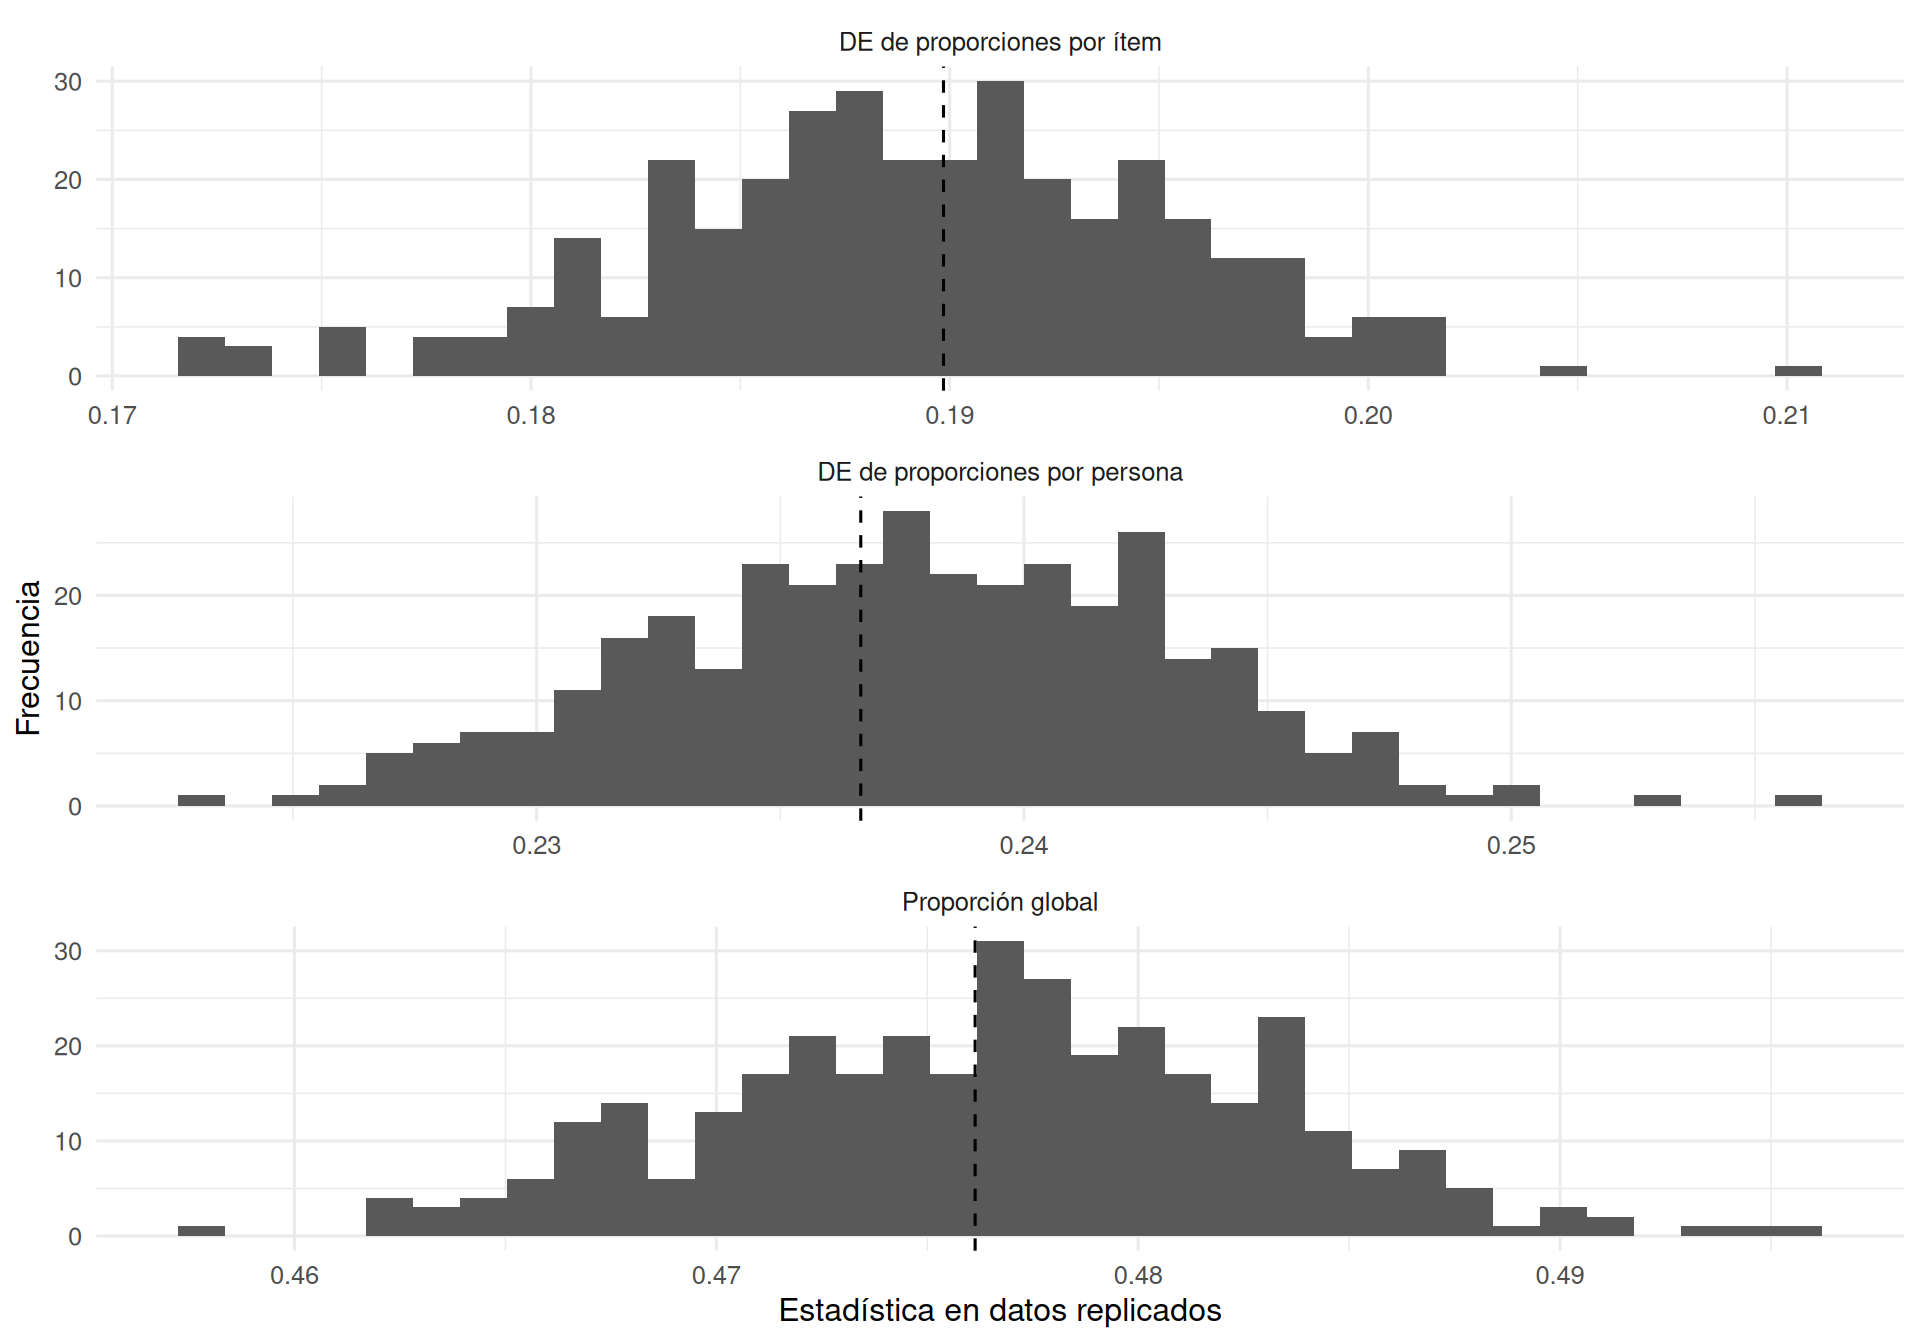
Si la línea observada cae sistemáticamente en una cola extrema de la distribución replicada, el modelo tiene dificultad para reproducir esa característica. Esto no indica automáticamente cuál término debe añadirse: la discrepancia debe conectarse con una hipótesis de modelación.
8.24.1 Comprobación por ítem
También podemos comparar las tasas observadas de cada ítem con su distribución predictiva posterior.
yrep_item_s8 <- vapply(
  indices_item_s8,
  function(ind) {
    rowMeans(
      yrep_verbagg_s8[, ind, drop = FALSE]
    )
  },
  numeric(nrow(yrep_verbagg_s8))
)

resumen_ppc_item_s8 <- tibble(
  item = names(indices_item_s8),
  observado = vapply(
    indices_item_s8,
    function(ind) mean(datos_verbagg_s8$y[ind]),
    numeric(1)
  ),
  mediana_rep = apply(yrep_item_s8, 2, median),
  q10_rep = apply(
    yrep_item_s8,
    2,
    quantile,
    probs = 0.10
  ),
  q90_rep = apply(
    yrep_item_s8,
    2,
    quantile,
    probs = 0.90
  )
)
resumen_ppc_item_s8 |>
mutate(
item = reorder(item, observado)
) |>
ggplot(aes(x = item)) +
geom_linerange(
aes(ymin = q10_rep, ymax = q90_rep),
linewidth = 0.6
) +
geom_point(
aes(y = mediana_rep),
size = 2
) +
geom_point(
aes(y = observado),
shape = 1,
size = 2.4,
stroke = 0.8
) +
coord_cartesian(ylim = c(0, 1)) +
labs(
x = "Ítem",
y = "Proporción de respuestas 1"
) +
theme_minimal(base_size = 12) +
theme(
axis.text.x = element_text(
angle = 60,
hjust = 1
)
)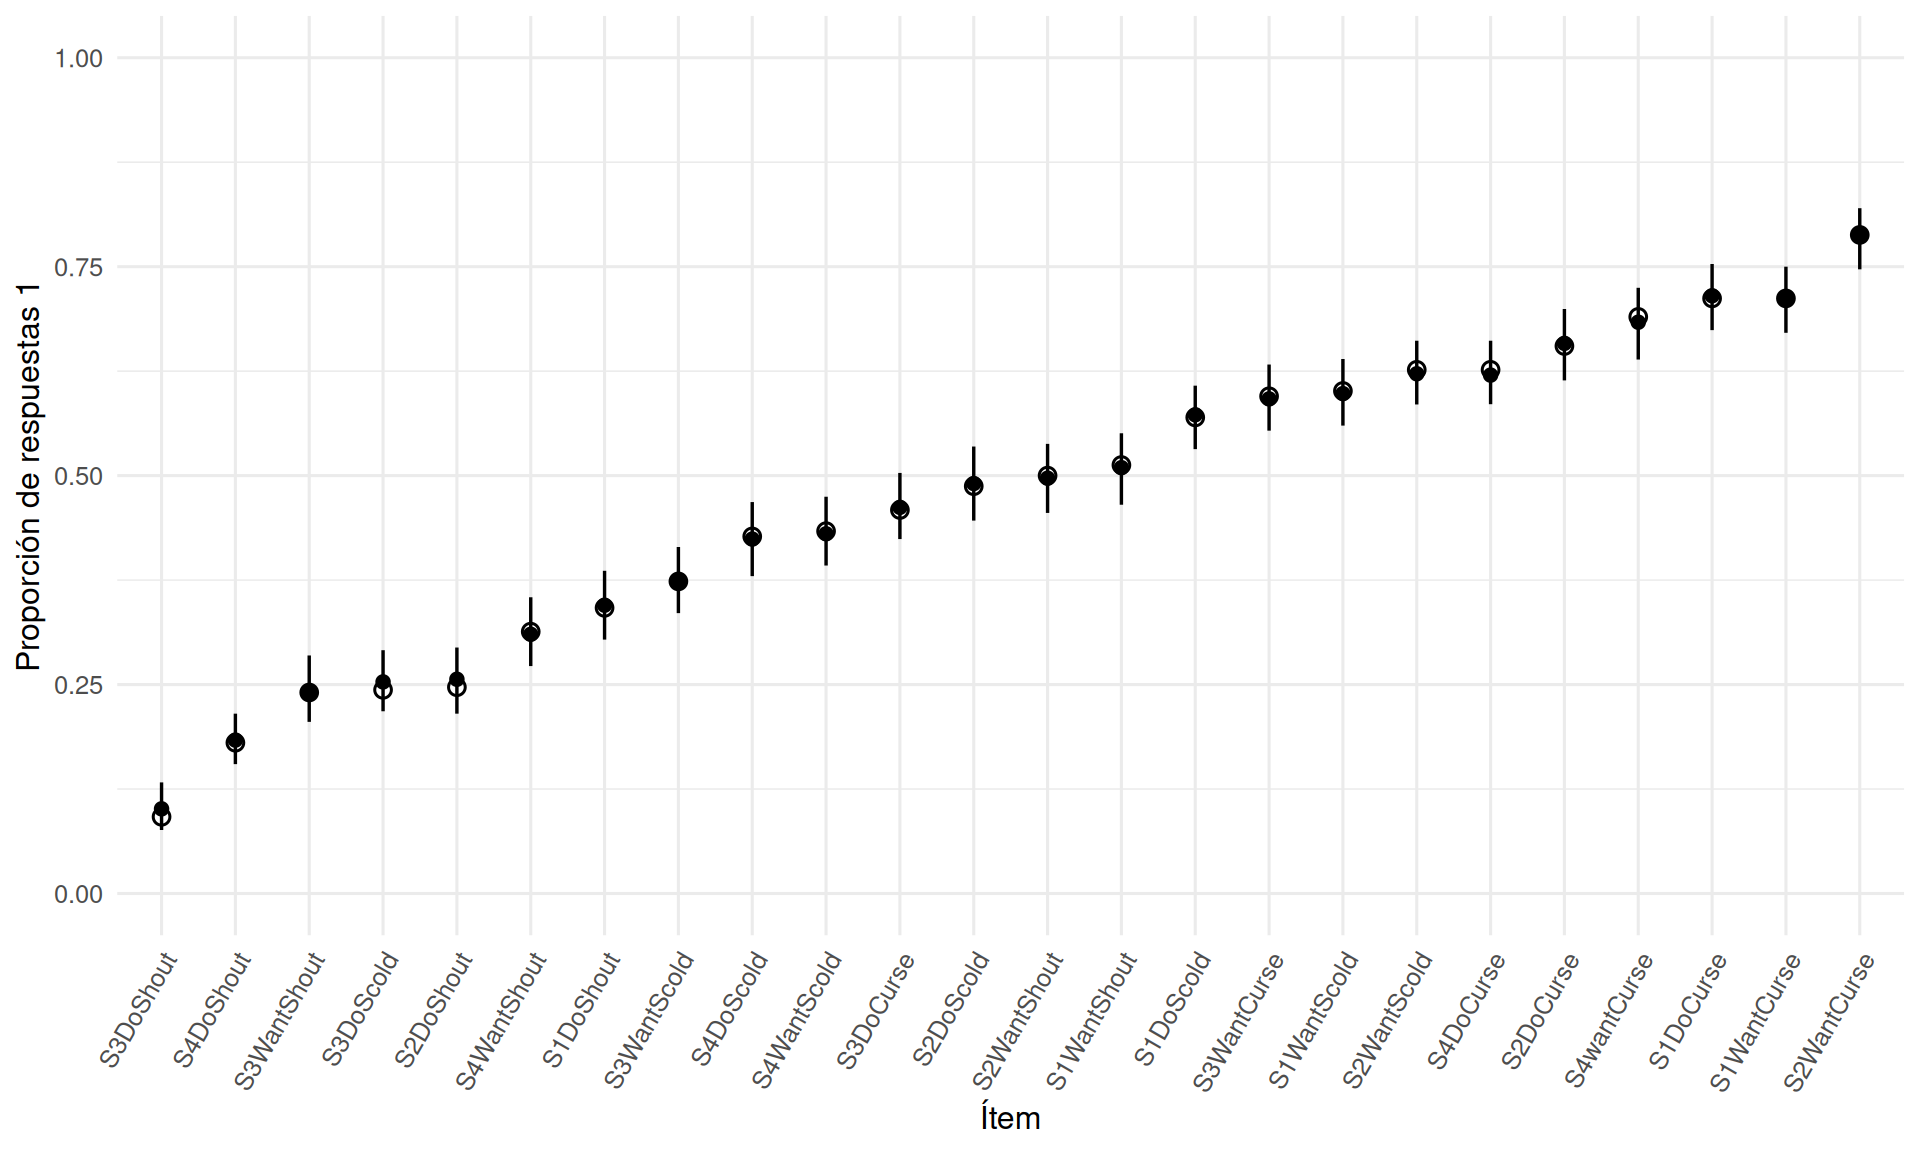
El círculo abierto representa la tasa observada; el punto sólido y el intervalo corresponden a la distribución predictiva posterior. La pregunta no es si todos los puntos observados quedan dentro de un intervalo particular, sino si existe un patrón sistemático de discrepancia que el modelo no logra reproducir.
8.25 Predicción para grupos existentes y nuevos
La aplicación cruzada permite distinguir tres preguntas predictivas usando exactamente los mismos valores de los predictores poblacionales.
Definiremos un escenario con Anger_z = 0 y niveles de referencia para los factores categóricos.
id_existente_s8 <- levels(datos_verbagg_s8$id)[1]
item_existente_s8 <- levels(datos_verbagg_s8$item)[1]

escenario_base_s8 <- tibble(
  Anger_z = 0,
  Gender = factor(
    nivel_gender_ref_s8,
    levels = levels(datos_verbagg_s8$Gender)
  ),
  btype = factor(
    nivel_btype_ref_s8,
    levels = levels(datos_verbagg_s8$btype)
  ),
  situ = factor(
    nivel_situ_ref_s8,
    levels = levels(datos_verbagg_s8$situ)
  ),
  id = id_existente_s8,
  item = item_existente_s8
)
8.25.1 Caso 1: persona e ítem existentes
p_existente_s8 <- posterior_epred(
  fit_verbagg_s8,
  newdata = escenario_base_s8,
  re_formula = NULL,
  ndraws = 1200
)
Aquí la predicción utiliza las distribuciones posteriores de los interceptos correspondientes a esa persona y ese ítem.
8.25.2 Caso 2: términos grupales fijados en cero
p_cero_s8 <- posterior_epred(
  fit_verbagg_s8,
  newdata = escenario_base_s8,
  re_formula = NA,
  ndraws = 1200
)
Esta cantidad representa un escenario de referencia en el centro de las distribuciones grupales, no una integración sobre personas e ítems.
8.25.3 Caso 3: persona e ítem nuevos
escenario_nuevo_s8 <- escenario_base_s8 |>
  mutate(
    id = "persona_nueva_s8",
    item = "item_nuevo_s8"
  )

p_nuevo_s8 <- posterior_epred(
  fit_verbagg_s8,
  newdata = escenario_nuevo_s8,
  re_formula = NULL,
  allow_new_levels = TRUE,
  sample_new_levels = "gaussian",
  ndraws = 1200
)
Con sample_new_levels = "gaussian", las nuevas contribuciones grupales se simulan a partir de las distribuciones normales definidas por los parámetros de variación grupal de cada simulación posterior. Así, la predicción representa la heterogeneidad esperada para unidades grupales todavía no observadas.
Resumimos las tres distribuciones de probabilidad.
resumir_prob_s8 <- function(x, tipo) {
  tibble(
    tipo = tipo,
    mediana = median(as.numeric(x)),
    q10 = quantile(as.numeric(x), 0.10),
    q90 = quantile(as.numeric(x), 0.90)
  )
}

resumen_pred_grupos_s8 <- bind_rows(
  resumir_prob_s8(
    p_existente_s8,
    "Persona e ítem existentes"
  ),
  resumir_prob_s8(
    p_cero_s8,
    "Términos grupales = 0"
  ),
  resumir_prob_s8(
    p_nuevo_s8,
    "Persona e ítem nuevos"
  )
)

resumen_pred_grupos_s8
# A tibble: 3 × 4
tipo mediana q10 q90
<chr> <dbl> <dbl> <dbl>
1 Persona e ítem existentes 0.615 0.457 0.752
2 Términos grupales = 0 0.744 0.662 0.797
3 Persona e ítem nuevos 0.728 0.274 0.949resumen_pred_grupos_s8 |>
ggplot(
aes(
x = reorder(tipo, mediana),
y = mediana
)
) +
geom_linerange(
aes(ymin = q10, ymax = q90),
linewidth = 0.8
) +
geom_point(size = 2.6) +
scale_y_continuous(limits = c(0, 1)) +
coord_flip() +
labs(
x = NULL,
y = "Probabilidad posterior esperada"
) +
theme_minimal(base_size = 12)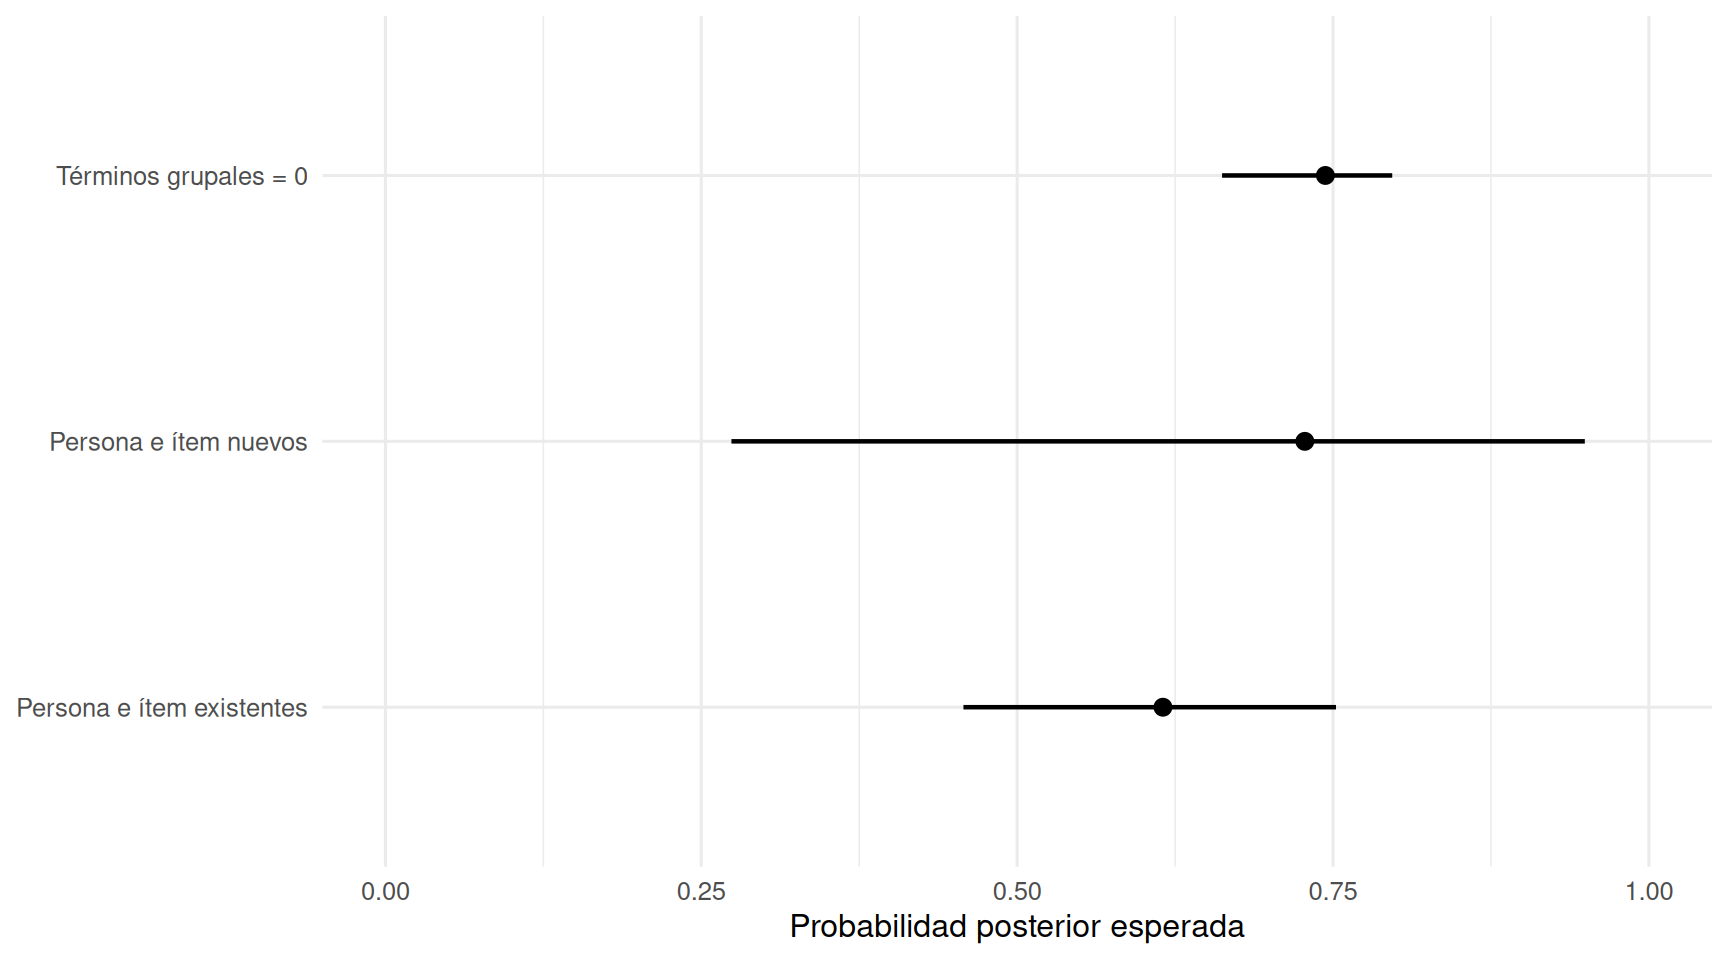
Las diferencias entre estas cantidades no son un detalle de software. Responden preguntas científicas diferentes. Una predicción para una persona que ya fue observada puede utilizar información específica de esa persona; una predicción para una persona nueva debe propagar la heterogeneidad entre personas.
8.26 Una nota sobre comparación frecuentista
En la literatura, un modelo análogo puede ajustarse con lme4::glmer() mediante una fórmula del tipo
lme4::glmer(
  y ~ Anger_z + Gender + btype + situ +
    (1 | id) + (1 | item),
  family = binomial(link = "logit"),
  data = datos_verbagg_s8
)
Bürkner muestra explícitamente la correspondencia entre fórmulas glmer() y brm() para modelos binomiales y Bernoulli multinivel (Bürkner 2017). En este curso la formulación bayesiana seguirá siendo la principal porque queremos:
- especificar previas explícitas;
- propagar incertidumbre de todos los parámetros;
- obtener distribuciones predictivas para grupos existentes y nuevos;
- integrar diagnóstico computacional y comprobación predictiva dentro de un mismo flujo.
La comparación con glmer() es útil para leer literatura y reconocer una estructura equivalente, no para reorganizar la inferencia alrededor de pruebas de hipótesis.
8.27 Errores frecuentes
8.27.1 Interpretar \(\beta\) como una diferencia de probabilidades
En
\[ \operatorname{logit}(p)=\alpha+\beta x, \]
\(\beta\) es una diferencia de log-odds. La diferencia de probabilidad depende del punto de evaluación y de todos los demás términos del predictor lineal.
8.27.2 Interpretar un odds ratio como riesgo relativo
Un odds ratio
\[ \exp(\beta) \]
no es, en general, el cociente directo de probabilidades. La diferencia entre odds ratio y razón de probabilidades puede ser considerable cuando el evento no es raro.
8.27.3 Reportar solo odds ratios
Los odds ratios pueden ser útiles, pero no sustituyen probabilidades predichas, diferencias de probabilidad o distribuciones predictivas cuando esas cantidades responden mejor la pregunta sustantiva.
8.27.4 Tratar \(\pi^2/3\) como varianza residual observada
La cantidad \(\pi^2/3\) pertenece a una representación latente del enlace logit. No es un parámetro residual estimado a partir de la respuesta Bernoulli.
8.27.5 Llamar marginal a re_formula = NA
En brms, excluir los términos grupales produce una predicción con esas contribuciones fijadas en cero. La marginalización sobre una población de grupos exige integrar o simular sobre la distribución grupal.
8.27.6 Ignorar la unidad binomial
Una proporción agregada requiere conocer el número de ensayos. Dos proporciones de 0.5 basadas en \(1/2\) y \(500/1000\) no contienen la misma información.
8.27.7 Ignorar separación
Coeficientes enormes, incertidumbre inusual o fuerte sensibilidad a la previa pueden revelar separación o información insuficiente. Aumentar el número de iteraciones no resuelve la falta de información de la verosimilitud.
8.27.8 Utilizar previas excesivamente difusas por “neutralidad”
En la escala logit, coeficientes muy grandes implican probabilidades casi deterministas. Una previa amplia puede declarar plausibles configuraciones extremadamente fuertes sin que exista conocimiento sustantivo que las respalde.
8.27.9 Comprobar solo la tasa global
Un modelo puede reproducir la proporción total de unos y, al mismo tiempo, fallar en la heterogeneidad entre grupos, patrones por predictor o combinaciones específicas de covariables. Las comprobaciones deben dirigirse a las características que motivaron la estructura multinivel.
8.27.10 Interpretar antes de diagnosticar
Un resumen posterior no debe utilizarse sustantivamente antes de revisar \(\widehat R\), ESS, divergencias, profundidad del árbol y otras señales relevantes del ajuste.
8.28 Síntesis
Los modelos multinivel para respuestas binarias combinan tres componentes:
\[ \boxed{ \text{distribución Bernoulli/binomial} + \text{enlace logit} + \text{predictor lineal multinivel} } \]
El enlace transforma una probabilidad restringida en un predictor lineal no restringido. Los interceptos y pendientes variables se incorporan en ese predictor exactamente donde antes aparecían en modelos gaussianos, pero su interpretación directa es ahora en log-odds.
El pooling parcial sigue siendo fundamental. Los grupos con información limitada reciben mayor regularización, lo que evita tratar proporciones extremas de muestras pequeñas como probabilidades conocidas. Sin embargo, debido a la no linealidad, el pooling y las diferencias entre grupos deben visualizarse también en la escala de probabilidad.
La semana deja cuatro advertencias que conviene conservar para todos los GLMM posteriores:
- familia y enlace son supuestos, no opciones de menú;
- los coeficientes no viven necesariamente en la escala de la respuesta;
- condicional y marginal no son sinónimos;
- diagnóstico computacional y comprobación predictiva responden preguntas distintas.
En la semana 9 conservaremos esta estructura de trabajo, pero cambiaremos el mecanismo observacional hacia conteos y tasas, utilizando principalmente distribuciones Poisson y binomial negativa y el enlace log.
8.29 Ejercicios
8.29.1 Ejercicio 1. Identificar la unidad binomial
Para cada situación, indique si una fila de datos debería representarse naturalmente como Bernoulli o binomial agregada. Defina éxito y número de ensayos.
- Una fila por paciente indica si hubo una readmisión durante 30 días.
- Una fila por hospital contiene 17 readmisiones de 240 pacientes.
- Una fila por estudiante indica si respondió correctamente un ítem.
- Una fila por escuela contiene 82 respuestas correctas de 120 estudiantes para el mismo ítem.
Discuta qué información podría perderse al pasar de los datos individuales a los agregados.
8.29.2 Ejercicio 2. Escalas de interpretación
Considere
\[ \operatorname{logit}(p) =-1.5+0.8x. \]
- Interprete \(0.8\) en log-odds.
- Calcule e interprete \(\exp(0.8)\).
- Calcule \(p\) para \(x=0,1,2\).
- Compare \(p(1)-p(0)\) con \(p(2)-p(1)\).
- Explique por qué las diferencias no coinciden aunque la pendiente logit sea constante.
8.29.3 Ejercicio 3. Pooling parcial con un grupo extremo
Dos grupos presentan:
\[ \frac{1}{1} \qquad\text{y}\qquad \frac{80}{80}. \]
Ambos tienen una proporción empírica igual a 1.
- Explique por qué un modelo multinivel no debería asignar necesariamente la misma distribución posterior de \(p_j\) a ambos.
- ¿Cuál esperaría que exhiba mayor shrinkage?
- ¿Qué papel desempeña \(\tau_\alpha\)?
- ¿Cómo cambiaría la respuesta si \(\tau_\alpha\) fuera conocida y extremadamente grande?
8.29.4 Ejercicio 4. ICC logístico
Suponga que la posterior de \(\tau_\alpha\) está concentrada cerca de 0.9.
- Calcule el ICC latente aproximado usando Ecuación 8.15.
- Explique qué representa la cantidad \(\pi^2/3\).
- Explique por qué no debe describirse como una varianza residual observada estimada.
- Proponga una cantidad predictiva en la escala de probabilidad que complementaría el ICC.
8.29.5 Ejercicio 5. Condicional frente a marginal
Considere
\[ \operatorname{logit}(p_j)=1+u_j, \qquad u_j\sim\mathcal N(0,1.5^2). \]
Calcule \(\operatorname{logit}^{-1}(1)\).
Mediante simulación, aproxime
\[ E_u[\operatorname{logit}^{-1}(1+u)]. \]
Compare ambas cantidades.
Explique qué pregunta responde cada una.
Repita con \(\tau=0.2\) y explique por qué la diferencia cambia.
8.29.6 Ejercicio 6. Previas en la escala de probabilidad
Compare
\[ \alpha\sim\mathcal N(0,1.5^2) \]
con
\[ \alpha\sim\mathcal N(0,5^2). \]
- Simule 10000 valores de cada previa.
- Transforme mediante \(p=\operatorname{logit}^{-1}(\alpha)\).
- Grafique ambas distribuciones de \(p\).
- Compare la probabilidad previa de \(p<0.01\) o \(p>0.99\).
- Discuta en qué problemas una de las dos especificaciones podría resultar implausible.
8.29.7 Ejercicio 7. Separación
Simule 40 observaciones con
\[ y=0\quad\text{para}\quad x<0, \]
\[ y=1\quad\text{para}\quad x>0. \]
- Grafique los datos.
- Explique por qué la máxima verosimilitud favorece una pendiente cada vez mayor.
- Ajuste un modelo bayesiano con \(\beta\sim\mathcal N(0,1)\).
- Repita con \(\beta\sim\mathcal N(0,3)\).
- Compare la posterior de \(\beta\) y las probabilidades predichas dentro del rango observado.
- Explique qué parte de la diferencia entre ajustes proviene de información previa.
8.29.8 Ejercicio 8. Simulación de pooling
Modifique el experimento de pooling parcial de las notas.
- Simule 50 grupos con tamaños entre 2 y 100.
- Compare proporciones observadas y estimaciones con pooling parcial.
- Calcule el error absoluto respecto de las probabilidades verdaderas.
- Compare el error promedio para grupos pequeños y grandes.
- Repita toda la simulación al menos 50 veces.
- Discuta por qué una sola simulación no demuestra que pooling parcial sea mejor en cada grupo.
8.29.9 Ejercicio 9. Pendiente variable en un GLMM
Extienda la aplicación VerbAgg a
y ~ Anger_z + Gender + btype + situ +
  (1 + Anger_z | id) +
(1 | item)- Escriba el modelo probabilístico completo.
- Especifique previas para la desviación estándar de la pendiente y para la correlación intercepto-pendiente.
- Realice comprobación predictiva previa.
- Revise divergencias y ESS.
- Interprete la heterogeneidad de pendientes mediante curvas de probabilidad para una selección de personas.
- Explique por qué la correlación intercepto-pendiente no debe interpretarse sin considerar el centrado de
Anger_z.
8.29.10 Ejercicio 10. Comprobación predictiva por grupo
Para la aplicación VerbAgg, proponga tres estadísticas predictivas adicionales que detecten aspectos que no se observan en la tasa global.
Para cada estadística:
- defina \(T(y)\);
- explique qué defecto del modelo podría revelar;
- simule su distribución posterior predictiva;
- compare con el valor observado.
8.29.11 Ejercicio 11. Grupos existentes y nuevos
Utilice posterior_epred() para calcular la probabilidad bajo cuatro escenarios:
- persona existente e ítem existente;
- persona nueva e ítem existente;
- persona existente e ítem nuevo;
- persona nueva e ítem nuevo.
Mantenga los predictores poblacionales iguales. Compare las distribuciones posteriores y explique qué fuente de incertidumbre se añade en cada caso.
8.29.12 Ejercicio 12. Criticar una interpretación
Se proporciona el siguiente texto:
“El modelo logístico estimó \(\beta=1.2\). Por tanto, aumentar \(x\) en una unidad aumenta en 120 puntos porcentuales la probabilidad del evento. El odds ratio es 3.32, lo que significa que la probabilidad se triplica. Como el ICC es 0.25, dos observaciones del mismo grupo tienen una correlación observada exacta de 0.25.”
Redacte una crítica técnica que:
- identifique cada afirmación incorrecta o incompleta;
- dé la interpretación correcta de \(\beta\) y \(\exp(\beta)\);
- proponga una interpretación en la escala de probabilidad;
- explique la naturaleza aproximada y latente del ICC logístico.
8.29.13 Ejercicio 13. Crítica de una recomendación de IA
Una herramienta de IA produce la recomendación:
“Como la respuesta solo toma 0 y 1, use siempre
family = bernoulli(). No hace falta revisar el agrupamiento porque el enlace logit ya corrige la dependencia. Para interpretar el efecto, reporteexp(beta)y omita las probabilidades porque contienen la misma información.”
Escriba una respuesta de no más de 250 palabras que:
- identifique al menos cuatro errores conceptuales;
- distinga familia, enlace y estructura de dependencia;
- explique cuándo Bernoulli y binomial agregada representan organizaciones diferentes de los datos;
- justifique por qué las probabilidades predichas son necesarias para la interpretación.
8.30 Referencias de la semana
Las lecturas centrales para esta unidad son:
- Gelman y Hill, Data Analysis Using Regression and Multilevel/Hierarchical Models, capítulo 5 para regresión logística, interpretación y separación; capítulo 14 para regresión logística multinivel, coeficientes variables, predicción y pooling (Gelman y Hill 2007, chaps. 5, 14).
- McElreath, Statistical Rethinking, sección 10.2 para enlaces y la no linealidad de la escala de respuesta; sección 11.1 para regresión binomial/Bernoulli; secciones 13.1–13.2 para pooling parcial en un modelo binomial jerárquico (McElreath 2020, secs. 10.2, 11.1, 13.1-13.2).
- Hox, Moerbeek y van de Schoot, Multilevel Analysis, capítulo 6 para GLMM dicotómicos, formulación binomial-logit, interpretación en probabilidades y la representación latente utilizada para el ICC (Hox et al. 2018, chap. 6).
- Gelman et al., Bayesian Workflow, capítulos 5 y 8 para especificación, comprobación predictiva previa y posterior; capítulos 11–12 para mantener el diagnóstico computacional dentro del flujo general (Gelman et al. 2026, chaps. 5, 8, 11-12).
- Bürkner para la formulación de modelos Bernoulli/binomiales multinivel en
brmsy la conexión con Stan (Bürkner 2017).