12Semana 12. Dependencia residual y tiempo no lineal
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
26 de octubre de 2026
12.1 Panorama de la semana
En la semana 11 modelamos las trayectorias longitudinales permitiendo que cada individuo tuviera su propio intercepto y su propia pendiente. Bajo ese modelo, las mediciones de una persona son dependientes marginalmente, aun cuando se supone que los errores de las observaciones son independientes condicionalmente en los coeficientes individuales. La distinción es esencial: permitir trayectorias distintas no garantiza que se hayan representado todas las fuentes de dependencia temporal.
Pregunta orientadora. ¿Los interceptos y pendientes variables explican adecuadamente las asociaciones entre mediciones de una persona, o es necesario modificar la estructura de los residuos y la forma de las trayectorias?
Continuaremos con los tiempos de reacción registrados durante días de restricción del sueño. Una persona puede mostrar una tasa de deterioro distinta de la de otra, pero también experimentar un día especialmente malo cuyo efecto persista parcialmente al día siguiente. Esas dos formas de dependencia no significan lo mismo. Además, puede ocurrir que los tiempos de reacción aumenten cada vez más rápido, que el deterioro se estabilice o que la dispersión residual cambie con el seguimiento. Ninguna de esas posibilidades se resuelve automáticamente añadiendo una pendiente variable.
En este capítulo estudiaremos tres extensiones, que responden a preguntas diferentes: (1) autocorrelación de los errores condicionados en las trayectorias individuales; (2) cambios sistemáticos de su varianza; (3) trayectorias medias que no necesariamente son rectas. La estructura de covarianza y la forma de la media deben considerarse conjuntamente, pero conviene comprender primero cada componente por separado (Hox et al. 2018, sec. 5.6; West et al. 2022, sec. 2.2; Verbeke y Molenberghs 2000, chaps. 3-4).
Objetivos de aprendizaje
Al finalizar esta semana, la persona estudiante podrá:
distinguir la dependencia inducida por interceptos y pendientes variables de la dependencia residual condicional;
derivar la matriz de covarianza marginal de un modelo mixto como suma de componentes correspondientes a coeficientes individuales y residuos;
formular e interpretar una estructura residual AR(1), incluidas sus hipótesis sobre espaciado temporal, estacionariedad y escala residual;
distinguir un índice de ocasión de una distancia temporal y proponer una correlación apropiada para mediciones irregulares;
formular modelos con desviación estándar residual dependiente del tiempo;
representar trayectorias no lineales mediante polinomios, funciones por tramos y splines, e interpretar sus restricciones;
justificar previas coherentes con la escala temporal y la escala de la respuesta;
ajustar modelos longitudinales bayesianos con brms y cmdstanr, examinar los diagnósticos HMC/NUTS y realizar comprobaciones predictivas temporales;
evaluar críticamente si una extensión mejora la representación de una característica sustantiva, sin interpretar una mejora en un criterio aislado como prueba de que el modelo sea correcto.
NotaFuentes, notación y alcance
La discusión de covarianzas longitudinales y AR(1) se basa principalmente en Hox, Moerbeek y van de Schoot (Hox et al. 2018, secs. 5.4-5.7) y West, Welch y Galecki (West et al. 2022, secs. 2.2, 7.8-7.10). La formulación de modelos marginales y mixtos se apoya en Verbeke y Molenberghs (Verbeke y Molenberghs 2000, chaps. 3-4). La conexión con procesos de estados proviene de Matsuura (matsuura-2022?, chap. 11); la construcción iterativa y comprobación predictiva de Gelman y colaboradores (Gelman et al. 2026, chaps. 5, 8, 11-12, 27). Las derivaciones detalladas, simulaciones y ejercicios fueron elaborados para estas notas. Conservamos \(i\) para individuo, \(j\) para ocasión, \(t_{ij}\) para tiempo real, \(\boldsymbol\Sigma\) para covarianza de coeficientes individuales y \(\mathbf R_i\) para covarianza residual. La letra \(\rho\) designará autocorrelación residual; la correlación entre interceptos y pendientes se denotará \(r_{01}\).
12.2 ¿De dónde proviene la dependencia temporal?
12.2.1 Dependencia marginal y condicional
Imaginemos dos observaciones próximas de la misma persona. Son similares por al menos dos razones posibles:
Rasgos persistentes de la trayectoria: su nivel y tasa de cambio difieren de los de otras personas. Los coeficientes \(u_{0i}\) y \(u_{1i}\) representan esas diferencias individuales.
Persistencia de fluctuaciones alrededor de la trayectoria: un desvío respecto a la respuesta esperada en una ocasión puede guardar relación con el desvío de la ocasión siguiente. Esta asociación requiere una estructura de dependencia residual.
En Ecuación 12.1, conocer los coeficientes \(u_{0i}\) y \(u_{1i}\) elimina, por hipótesis, la dependencia entre los errores de mediciones distintas. Formalmente, para \(j\ne k\),
siendo \(\boldsymbol\theta\) los parámetros poblacionales. Sin embargo, antes de condicionar en los coeficientes individuales, las respuestas están correlacionadas. Por tanto, es incorrecto decir que un modelo de interceptos y pendientes variables “supone observaciones independientes” sin precisar respecto de qué se condiciona.
Si introducimos residuos correlacionados, tendremos en general
Esto no invalida la jerarquía de coeficientes variables: añade una dependencia diferente dentro de cada individuo (Hox et al. 2018, sec. 5.6).
12.2.2 Una comparación intuitiva
Consideremos dos mecanismos hipotéticos. En el primero, cada persona sigue una recta diferente y, una vez conocida su recta, los errores de días consecutivos son independientes. En el segundo, las personas también siguen rectas diferentes, pero una desviación positiva en un día tiende a persistir parcialmente al siguiente. Aunque ambos procesos pueden generar trayectorias observadas visualmente suaves, sus estructuras probabilísticas difieren.
No es suficiente mirar el gráfico de las respuestas para decidir cuál mecanismo opera: también hay que estudiar qué patrón temporal permanece después de descontar las trayectorias individuales. Más adelante construiremos comprobaciones predictivas expresamente diseñadas para este propósito.
ImportanteInterpretación de los componentes
Un intercepto variable explica semejanza entre observaciones de una persona por compartir un nivel individual. Una pendiente variable explica semejanza adicional por compartir una tasa individual de cambio. Una estructura AR(1) explica dependencia entre fluctuaciones residuales cercanas en el tiempo. Estas componentes pueden coexistir; tampoco siempre pueden distinguirse con precisión cuando los seguimientos son cortos.
12.3 La estructura de covarianza del modelo longitudinal
12.3.1 Del modelo por observación al modelo vectorial
Para cada individuo \(i\), reunimos sus \(n_i\) observaciones en un vector \(\mathbf Y_i=(Y_{i1},\ldots,Y_{in_i})^\top\). Una formulación lineal mixta general es
con \(\operatorname{Cov}(\mathbf u_i,\boldsymbol\varepsilon_i)=\mathbf0\) condicionalmente en los hiperparámetros. Aquí \(\mathbf X_i\) y \(\mathbf Z_i\) son matrices de diseño; en un modelo de interceptos y pendientes variables, ambas contienen una columna de unos y otra con tiempos, si no hay otros predictores. Las matrices \(\boldsymbol\Sigma\) y \(\mathbf R_i\) operan en niveles diferentes: la primera describe heterogeneidad de coeficientes entre personas y la segunda la covarianza residual entre ocasiones de una misma persona.
12.3.2 Derivación de la covarianza marginal
Aplicando la ley de varianza total, condicionalmente en los hiperparámetros poblacionales,
La matriz marginal\(\mathbf V_i\) no es igual a la matriz residual\(\mathbf R_i\). Confundirlas conduce a atribuir erróneamente a autocorrelación residual una asociación que ya está explicada por los coeficientes individuales. En el enfoque frecuentista es frecuente escribir \(\mathbf V_i=\mathbf Z_i\mathbf D\mathbf Z_i^\top+\mathbf R_i\); aquí \(\mathbf D\) corresponde a nuestra \(\boldsymbol\Sigma\)(West et al. 2022, sec. 2.2; Verbeke y Molenberghs 2000, chap. 3).
12.3.3 Casos particulares: interceptos y pendientes
Solo intercepto variable. Si \(Y_{ij}=\mu_0+\mu_1t_{ij}+u_{0i}+\varepsilon_{ij}\), con \(\operatorname{Var}(u_{0i})=\tau_0^2\) y residuos independientes de varianza \(\sigma^2\), entonces
Todas las parejas de tiempos diferentes tienen la misma correlación marginal, igual a \(\tau_0^2/(\tau_0^2+\sigma^2)\). Esta estructura se llama simetría compuesta, inducida en este caso por un intercepto variable más error independiente.
La covarianza marginal depende de ambos tiempos, no necesariamente solo de su separación. Además, la varianza marginal puede cambiar a lo largo del seguimiento aun cuando \(\sigma\) sea constante. Una mayor dispersión de respuestas en el último día, por tanto, no demuestra heterocedasticidad residual.
Intercepto y pendiente variables más dependencia residual. Si \(j\ne k\),
La contribución adicional \(R_{i,jk}\) debe justificarse a partir de la dinámica observada y evaluarse con comprobaciones predictivas. Una dificultad de identificación puede surgir cuando distintos conjuntos de parámetros producen matrices \(\mathbf V_i\) muy similares en los tiempos efectivamente observados.
12.3.4 Matrices con patrones diferentes
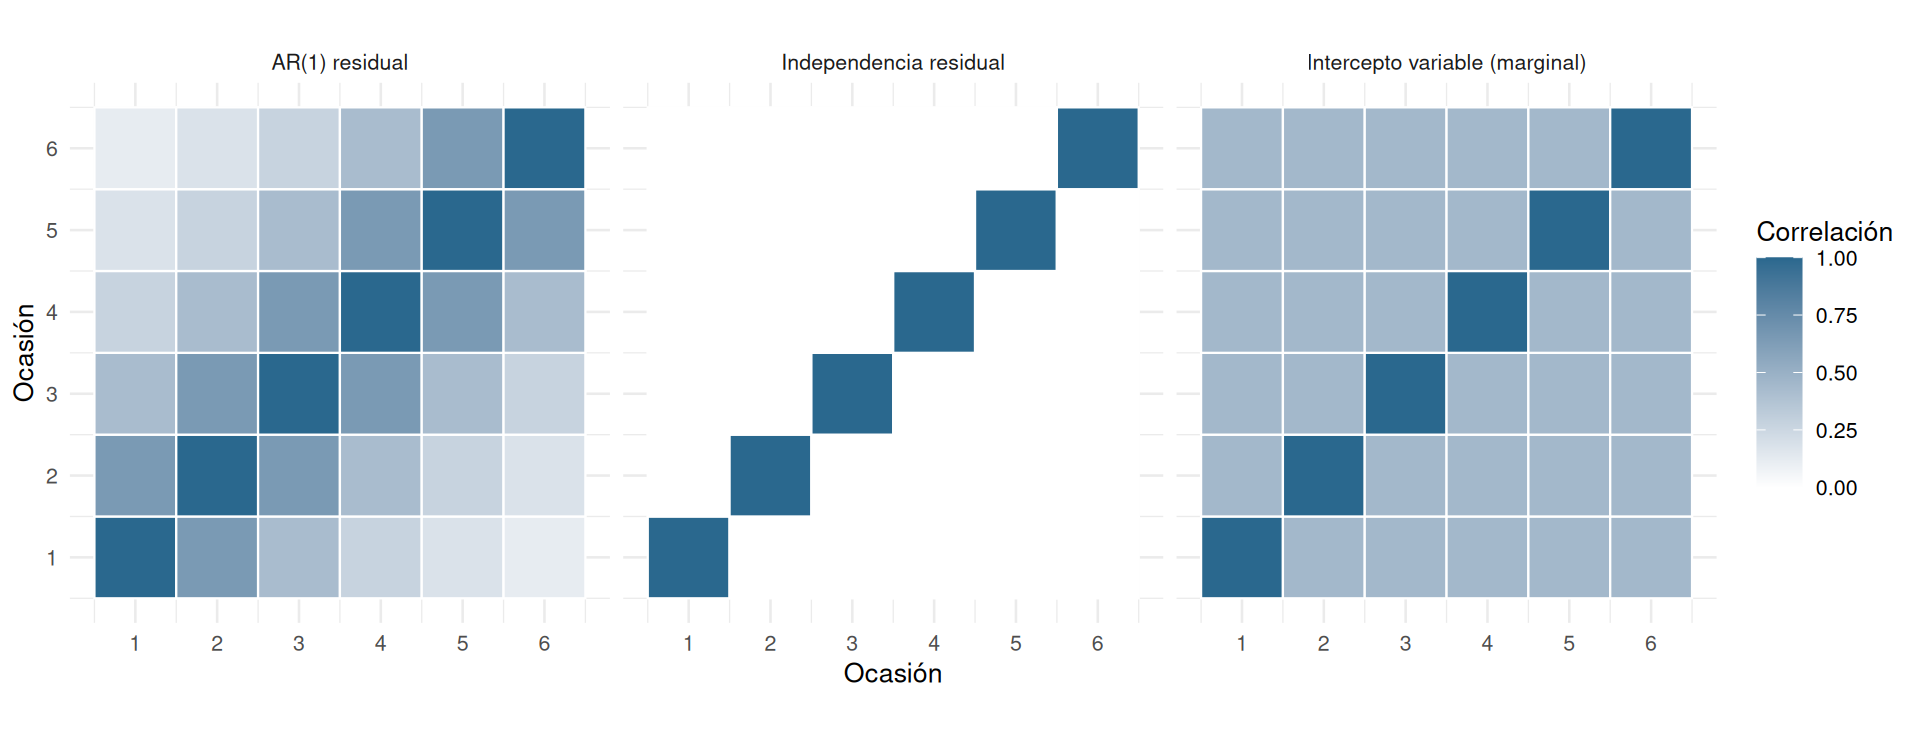
Para ilustrar las estructuras, consideremos cuatro ocasiones igualmente espaciadas y una desviación residual constante. La independencia residual corresponde a \(\mathbf R_i=\sigma^2\mathbf I_4\). La simetría compuesta en la covarianza marginal de un modelo con interceptos variables produce una matriz con diagonal común y covarianzas no diagonales iguales. Una estructura residual AR(1), en cambio, tiene covarianzas que dependen de la separación entre ocasiones. No debemos confundir una hipótesis sobre \(\mathbf V_i\) con una sobre \(\mathbf R_i\).
La figura de Figura 12.3, generada en R, permite observar las diferencias entre las estructuras residuales independientes y AR(1), junto con la correlación marginal inducida por un intercepto variable.
12.4 Autocorrelación residual AR(1)
12.4.1 Formulación estacionaria para ocasiones equiespaciadas
Consideramos inicialmente que las ocasiones están separadas por una unidad de tiempo constante y que, condicionalmente en los coeficientes individuales, los residuos siguen el proceso
Conviene distinguir \(\sigma_\eta\), escala de las innovaciones, de \(\sigma\), desviación estándar estacionaria de los residuos. No son intercambiables cuando \(\rho\ne0\). El modelo anterior presupone que los procesos de distintas personas son independientes condicionalmente en los hiperparámetros y los coeficientes individuales. AR(1) no obliga a que la respuesta tenga una media constante: se aplica aquí a errores alrededor de trayectorias que pueden cambiar con el tiempo (Hox et al. 2018, sec. 5.6; West et al. 2022, sec. 2.2.2).
Si \(\rho=0\), los residuos de ocasiones diferentes son independientes bajo la normalidad conjunta. Si \(0<\rho<1\), desvíos del mismo signo tienden a persistir y la correlación disminuye al aumentar el rezago. Por ejemplo, con \(\rho=0.6\), la correlación entre ocasiones contiguas es \(0.6\), entre ocasiones separadas por dos pasos es \(0.36\) y entre ocasiones separadas por tres pasos es \(0.216\). Con \(-1<\rho<0\), las correlaciones cambian de signo entre rezagos impares y pares; la afirmación “las correlaciones decrecen positivamente con la distancia” no describe este caso.
El valor \(\rho\)no representa la correlación total entre \(Y_{ij}\) y \(Y_{i,j+1}\). Esa correlación incorpora además \(\mathbf Z_i\boldsymbol\Sigma\mathbf Z_i^\top\), como muestra Ecuación 12.3. Asimismo, un posterior concentrado cerca de cero para \(\rho\) no prueba que todas las hipótesis residuales sean correctas: pueden permanecer heterocedasticidad, colas pesadas o una media mal especificada.
TipPregunta para discusión
Si las mediciones sucesivas de una persona son similares, ¿cuánto de esa similitud se debe a que comparten sus coeficientes individuales y cuánto a fluctuaciones residuales persistentes? ¿Qué información del diseño permitiría distinguir ambas componentes?
12.4.3 Límites de la hipótesis AR(1)
AR(1) es una hipótesis parsimoniosa, no una descripción universal de toda serie longitudinal. Impone un mismo \(\rho\) y una misma varianza residual estacionaria, salvo que se construya una extensión; presupone una escala temporal discreta con pasos comparables y un patrón geométrico de correlación. Cuando hay pocos tiempos por individuo, la información para separar \(\rho\) de la heterogeneidad de pendientes puede ser limitada. De manera análoga, una forma incorrecta de la trayectoria media puede generar patrones residuales que parezcan autocorrelación.
Una matriz residual no estructurada permitiría muchas más covarianzas, pero requiere \(n_i(n_i+1)/2\) parámetros para \(n_i\) ocasiones comunes, antes de considerar diferencias individuales. Su gran flexibilidad puede traducirse en problemas de identificación y predicción. La elección de una estructura más compleja exige un propósito sustantivo y evidencia suficiente (Hox et al. 2018, sec. 5.6).
12.5 Tiempos de observación irregulares
12.5.1 Índice de visita frente a distancia temporal
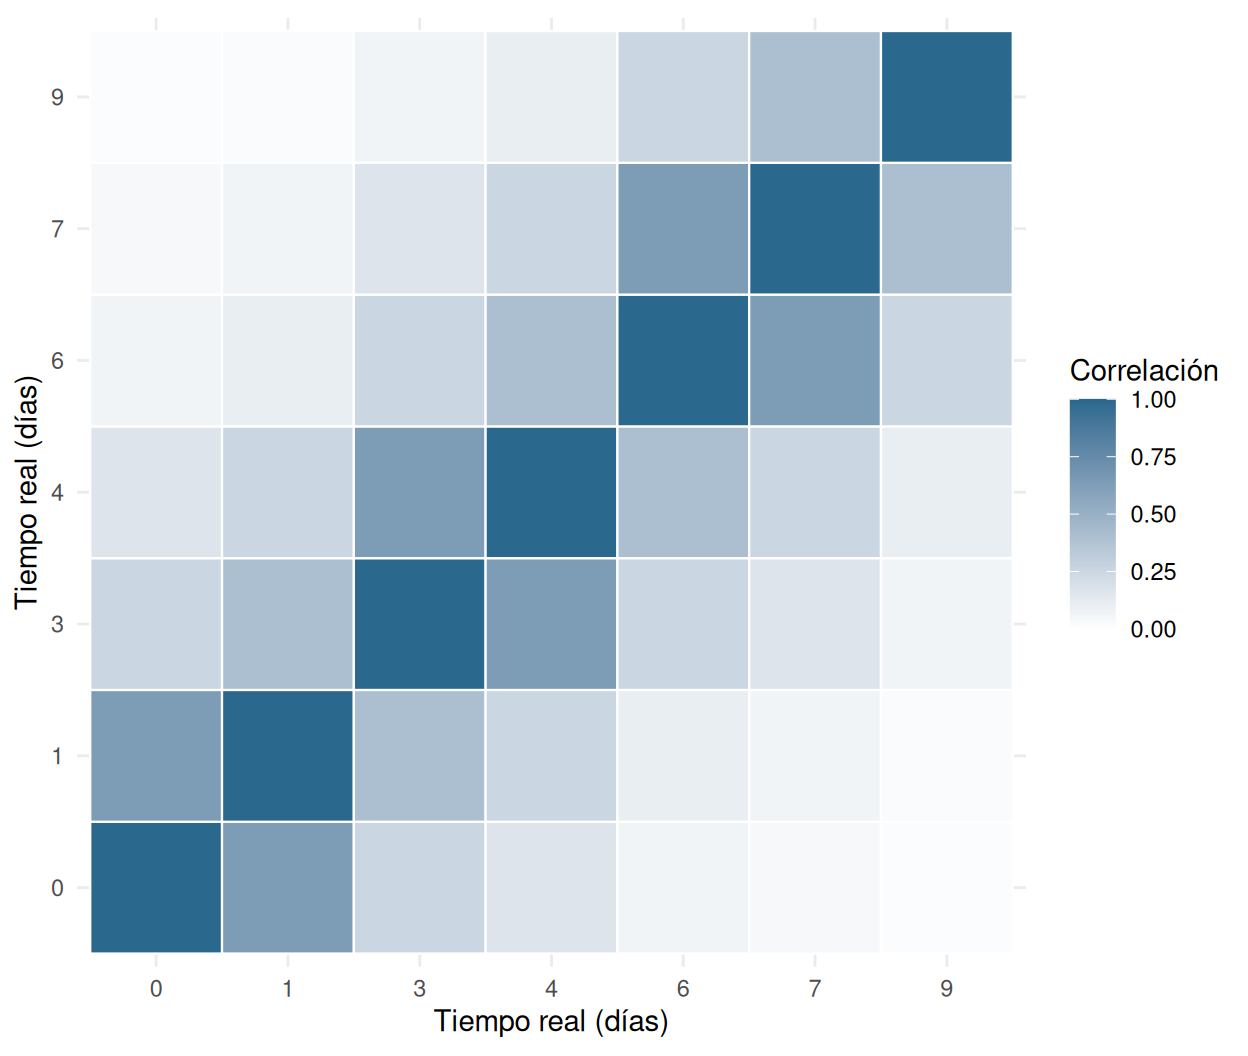
El índice \(j\) de Ecuación 12.7 representa un paso del proceso, no necesariamente un día, semana o mes. Si una persona fue medida en los días \(0,1,5\), hay un paso entre sus dos primeras observaciones y otro entre las dos últimas, pero las separaciones cronológicas son de uno y cuatro días. Utilizar simplemente \(\rho^{|j-k|}\) atribuye la misma correlación a ambos intervalos. Esto solo tiene sentido si el mecanismo opera por visita y no por tiempo transcurrido.
Cuando las observaciones pertenecen a una rejilla regular de tiempos, pero algunas faltan, la relación \(\rho^{|t_{ij}-t_{ik}|/\Delta}\) puede ser apropiada para una AR(1) de paso \(\Delta\) si los tiempos se expresan en unidades enteras de esa rejilla. Los saltos sin mediciones siguen contando como pasos del proceso. Es incorrecto reemplazarlos automáticamente por visitas consecutivas.
Es la correlación estacionaria de un proceso de Ornstein–Uhlenbeck. Si definimos \(\rho_\Delta=\exp(-\phi\Delta)\), al observarlo en una rejilla regular de paso \(\Delta\) obtenemos correlación \(\rho_\Delta^{|j-k|}\). El parámetro \(\phi\) tiene unidades de tiempo inverso; la correlación se reduce a \(e^{-1}\) para una separación \(1/\phi\). Esta familia representa correlación positiva, por lo que no extiende automáticamente un AR(1) de \(\rho\) negativo.
El capítulo mostrará gráficamente el efecto de distancias irregulares. No ajustaremos una supuesta AR(1) de visitas para presentarla como correlación en tiempo continuo. Una especificación de covarianza exponencial puede implementarse mediante Stan si la aplicación la exige; no se confundirá esa opción con la sintaxis discreta ar() de brms.
12.6 Varianza residual dependiente del tiempo
Hasta ahora hemos supuesto una desviación estándar residual constante. En un seguimiento, sin embargo, las fluctuaciones alrededor de las trayectorias pueden variar con el tiempo. El modelo
Por tanto, \(\gamma_1\) es un cambio en el logaritmo de la desviación estándar, no en el logaritmo de la varianza. La razón de varianzas por unidad temporal es \(\exp(2\gamma_1)\). Un \(\gamma_1\) positivo indica aumento de la dispersión condicional y uno negativo indica disminución.
Conviene contrastar este modelo con la varianza marginal del modelo de pendientes variables:
La dispersión total puede crecer aun si \(\gamma_1=0\), solo por la heterogeneidad de pendientes. Estimar una función para \(\sigma_{ij}\) no equivale a explicar la variación entre trayectorias. Ambas pueden estar débilmente identificadas cuando hay pocas mediciones (West et al. 2022, secs. 2.2, 7.10; Verbeke y Molenberghs 2000, chap. 4).
Una generalización combina heterocedasticidad y correlación residual mediante
con \(\mathbf C_i\) una matriz de correlación válida. En lugar de ajustar simultáneamente todas las extensiones desde el principio, analizaremos qué datos respaldan cada una.
12.7 Trayectorias no lineales
12.7.1 ¿Por qué una recta puede resultar insuficiente?
Una recta supone una tasa constante de cambio a lo largo de la ventana observada. En cambio, algunos procesos se aceleran, se estabilizan, presentan umbrales o cambian cuando comienza una intervención. Una curvatura sistemática que el modelo no representa puede manifestarse como residuos con patrones temporales, sin que ello indique necesariamente un proceso residual autorregresivo.
Por esa razón, al estudiar autocorrelación debemos examinar también la adecuación de la media \(\mu_i(t)\). Las opciones siguientes representan hipótesis diferentes sobre el cambio, no simples variantes estéticas de una curva.
Por consiguiente, \(\mu_1+u_{1i}\) es la tasa instantánea de cambio en \(t=0\), no una tasa constante durante todo el período. El parámetro \(\gamma_2\) expresa la variación de esa tasa por unidad temporal adicional, con unidades de respuesta/tiempo\(^2\). Un término cuadrático puede aproximar curvatura suave dentro de la ventana, pero la extrapolación fuera de ella suele ser muy sensible a su forma funcional.
12.7.3 Funciones por tramos y cambios de pendiente
Si hay un momento sustantivo \(c\), por ejemplo el inicio de un tratamiento, una alternativa es
La pendiente es \(\beta_i\) antes de \(c\) y \(\beta_i+\delta\) después. La trayectoria es continua en \(c\), pero su tasa de cambio puede cambiar. En contraste, añadir \(\kappa\mathbb 1(t\ge c)\) permitiría un salto en el nivel; un salto no es lo mismo que un cambio de pendiente. La ubicación de \(c\) debe responder al diseño o a una hipótesis sustantiva, y una búsqueda post hoc de puntos de cambio requeriría modelar la incertidumbre adicional.
con funciones base \(B_k(t)\). La flexibilidad no consiste únicamente en aumentar \(K\): debe controlarse también la complejidad efectiva de la función mediante regularización de sus coeficientes. En brms, los términos s(t) proporcionan una representación de suavizado compatible con un modelo bayesiano; la escala de la componente penalizada se regula mediante una previa sobre su desviación estándar. La interpretación principal pasa de un coeficiente de pendiente constante a una trayectoria estimada, sus contrastes entre tiempos y, cuando resulte útil, sus derivadas (Gelman et al. 2026, chap. 27; Bürkner 2017).
La formulación anterior es conceptual. En el laboratorio utilizaremos un suavizado poblacional s(Days, k = 5)sin duplicar un término lineal fijo y conservaremos desviaciones individuales lineales mediante (1 + dia_c | Subject). Así, la curva poblacional se separa de las diferencias individuales de nivel y tasa de cambio. Hay que recordar que los componentes lineales de las bases y la jerarquía pueden compartir información: pocas ocasiones y demasiada flexibilidad dificultan separar esas fuentes.
12.7.5 Qué no resuelve una función flexible
Una curva que reproduce bien las medias por día no garantiza que el modelo represente la variación residual por día ni la persistencia de errores cercanos. Un spline tampoco sustituye una justificación científica de la forma de las trayectorias y puede comportarse inadecuadamente fuera del intervalo observado. Inversamente, una estructura AR(1) no corrige un cambio sistemático de media mal modelado. Revisaremos por separado los patrones de media, dispersión y dependencia.
12.8 Especificación bayesiana y distribuciones previas
12.8.1 Verosimilitud jerárquica y posterior
Para un modelo normal con coeficientes individuales y dependencia residual, escribimos
con \(\boldsymbol\psi=(\sigma,\rho)\) para AR(1) estacionaria de varianza constante, o con otros parámetros cuando se modela heterocedasticidad. Si \(\boldsymbol\theta\) reúne todos los parámetros poblacionales, la posterior conjunta es proporcional a
No debemos reemplazar en esta última expresión \(p(\mathbf Y_i\mid\mathbf u_i,\boldsymbol\theta)\) por un producto de densidades normales univariadas cuando la especificación incluye una matriz \(\mathbf R_i\) no diagonal. La hipótesis de independencia condicional entre las personas se mantiene, pero dentro de cada persona la densidad puede ser normal multivariada.
12.8.2 Previas y escala temporal
Mantendremos en el análisis de sleepstudy las escalas pedagógicas de la semana 11, con la respuesta expresada en milisegundos y el tiempo centrado en el día 4.5:
La última expresión significa una normal truncada y renormalizada en \((-1,1)\); el indicador se emplea aquí para indicar su soporte y no sustituye la constante de normalización. Estas elecciones son un punto de partida didáctico. Una previa centrada cerca de \(\rho=0\) expresa preferencia inicial por autocorrelaciones moderadas, sin impedir valores de mayor magnitud cuando los datos los respaldan. Una LKJ(2) favorece correlaciones entre intercepto y pendiente más próximas a cero que una LKJ(1).
Cuidado con la escala: si el tiempo se transforma de días a semanas, la pendiente media y su desviación estándar cambian de unidad. Asimismo, la autocorrelación a un rezago de una semana no debe recibir automáticamente la misma previa numérica que la autocorrelación a un rezago de un día. Las previas deben corresponder al mecanismo y a la unidad del rezago (Gelman et al. 2026, secs. 5.6-5.10).
Para la extensión heterocedástica propondremos, usando \(d_{ij}=t_{ij}-4.5\),
En esta parametrización las cantidades positivas \(\sigma_{ij}\) se obtienen con enlace logarítmico; \(\gamma_0\) se interpreta a partir de la desviación estándar residual en el día 4.5. La escala \(0.08\) corresponde a cambios relativos moderados por día en el centro de la previa y debe examinarse sobre los nueve días de seguimiento, no solo punto a punto.
12.8.3 Comprobación predictiva previa y posterior
Antes del ajuste preguntaremos si las previas generan respuestas y trayectorias razonables en el calendario del estudio, si admiten correlaciones residuales demasiado persistentes y si la dispersión cambia de manera plausible. Después del ajuste, evaluaremos no solo la distribución de respuestas, sino estadísticas calculadas para cada trayectoria: variación entre personas, desviación residual por día, autocorrelación de residuos a rezago uno y discrepancias de la media por ocasión.
Las predicciones para días futuros de participantes existentes tienen un significado distinto de las predicciones para un participante nuevo. Además, cuando hay autocorrelación residual, predecir el siguiente registro usando el historial observado requiere especificar también qué información sobre el estado residual actual se condiciona. Una simulación de nuevas respuestas sin ese condicionamiento no equivale a una predicción dinámica de un paso adelante.
12.9 Laboratorio reproducible: tiempo de reacción durante la restricción del sueño
Trabajaremos con sleepstudy, utilizado también en la semana 11. El objetivo no será declarar a priori que sus residuos sean autocorrelacionados o heterocedásticos: los modelos ampliados son hipótesis a contrastar mediante su capacidad para reproducir patrones relevantes. El laboratorio distingue ejemplos con datos observados de experimentos simulados cuyo mecanismo conocemos.
12.9.1 Preparación del entorno y control de los datos
El capítulo requiere brms, cmdstanr y una instalación funcional de CmdStan. Todos los modelos posteriores se ajustarán explícitamente con backend = "cmdstanr".
Precisiones de diseño. En los datos originales hay diez mediciones igualmente espaciadas para cada una de 18 personas. Esta estructura permite construir una matriz AR(1) con paso de un día, pero no implica por sí misma que AR(1) sea un mecanismo adecuado. Las diferencias individuales y la forma de la media deben incluirse en el diagnóstico.
12.9.2 Visualización inicial de trayectorias y dispersión
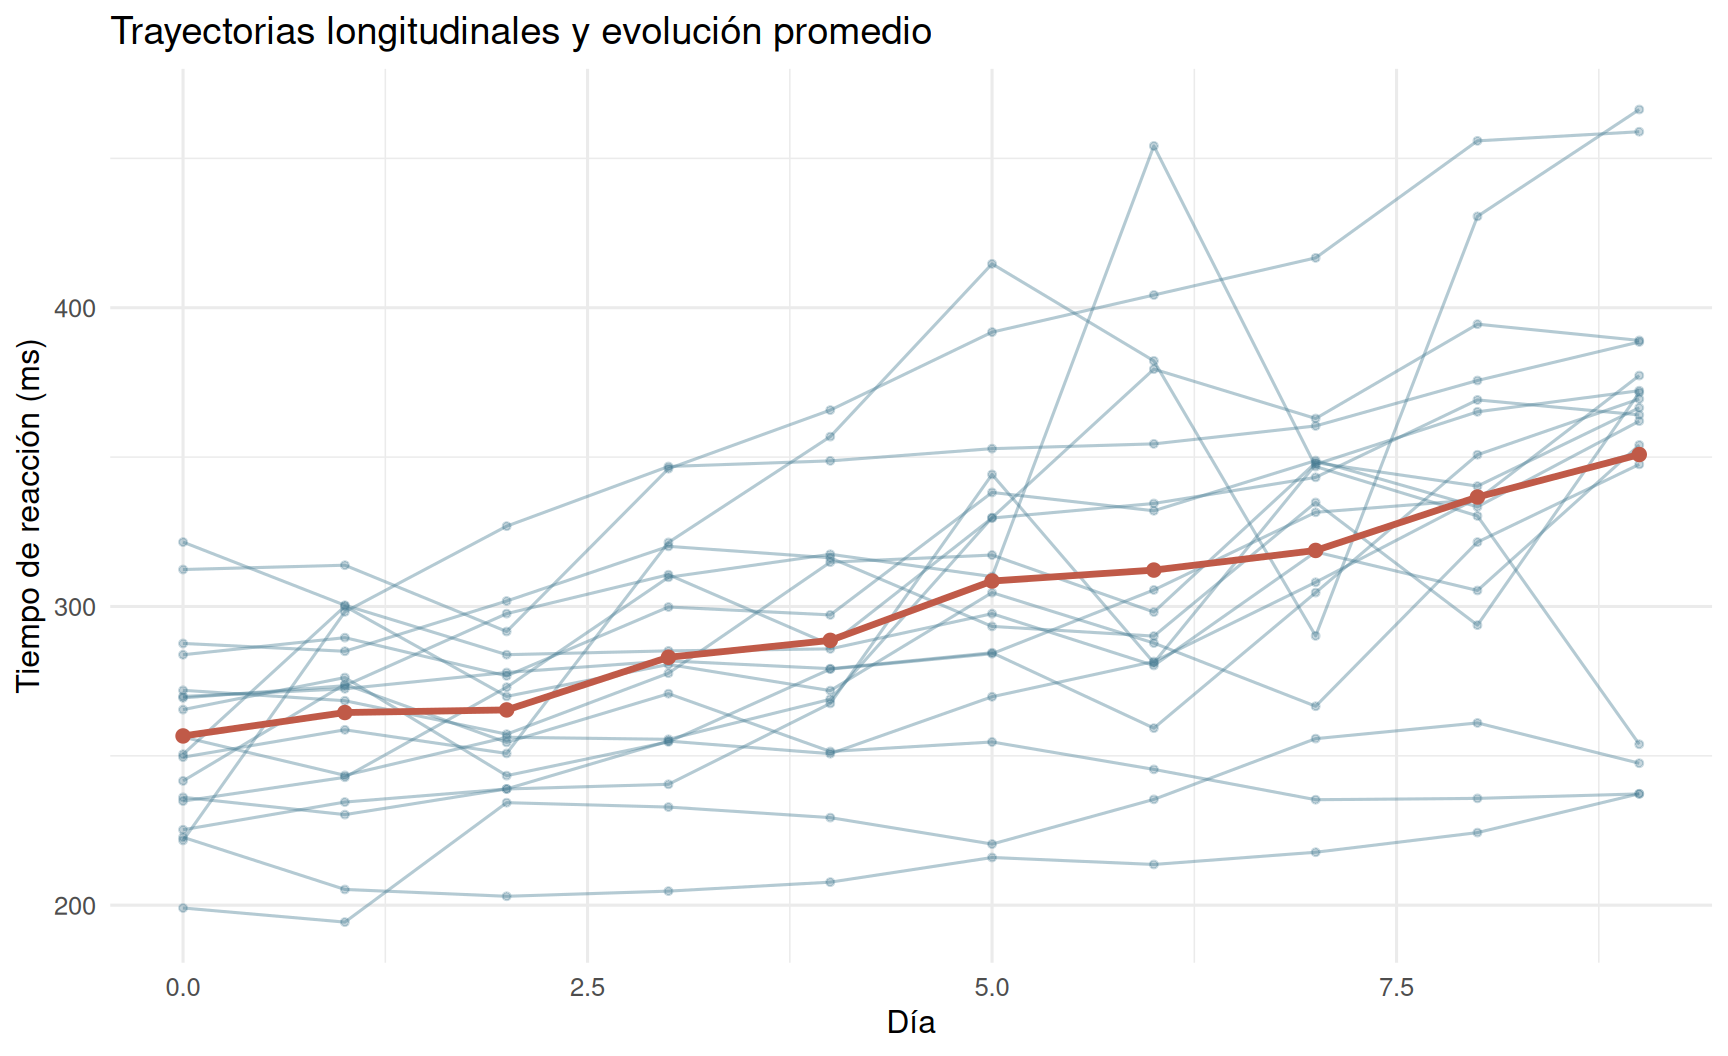
Figura 12.1: Trayectorias individuales observadas y promedio por día. La dispersión marginal combina heterogeneidad individual y fluctuaciones residuales.
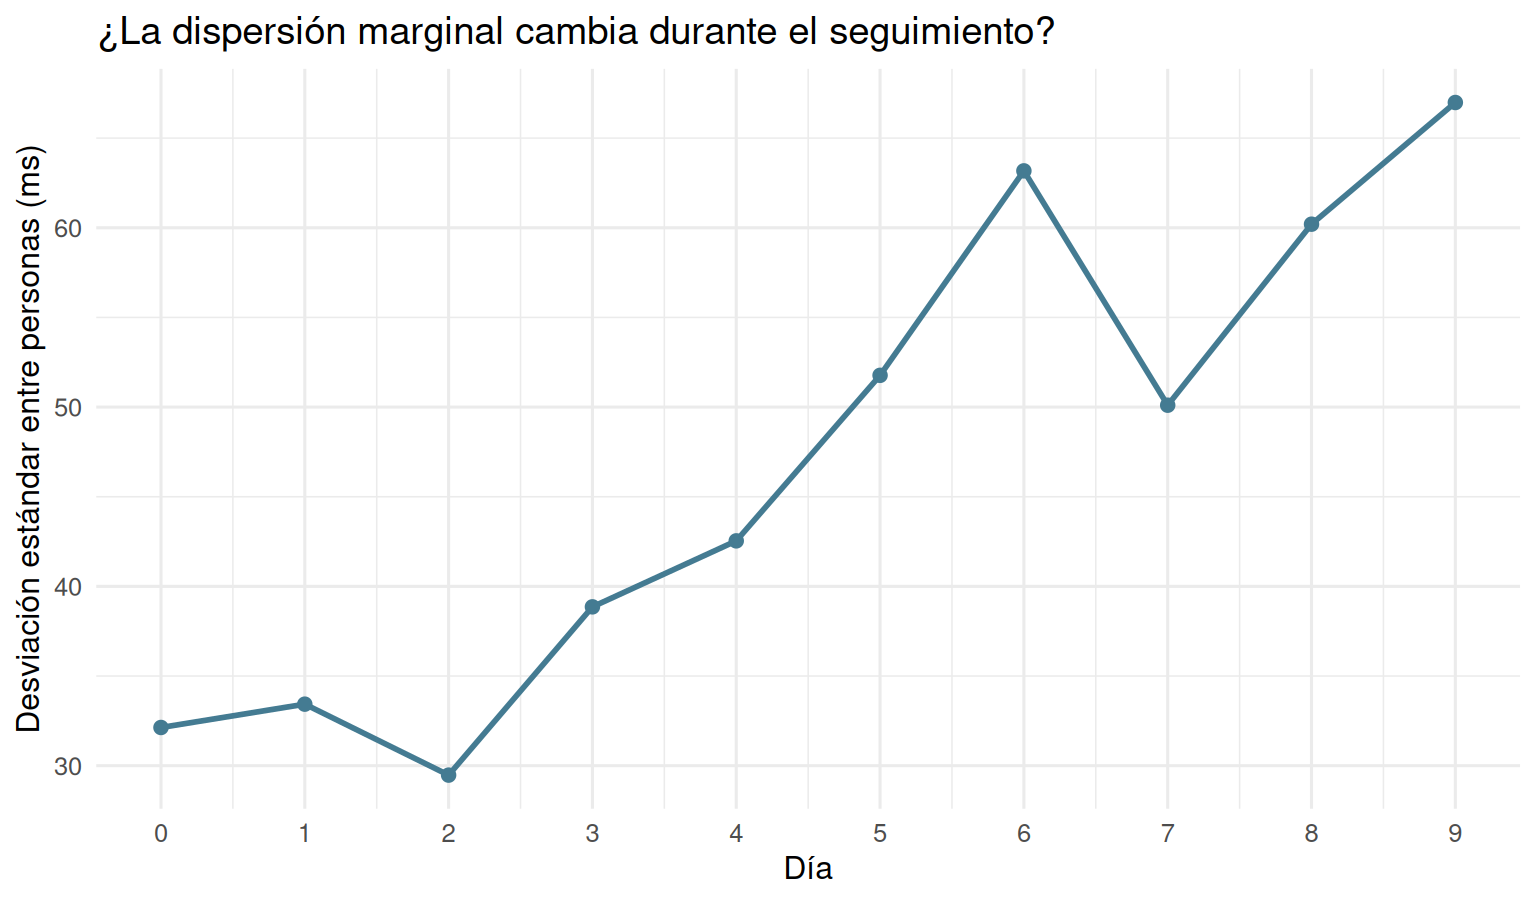
dispersion_dia_s12 <- datos_s12 |>group_by(Days) |>summarise(sd_marginal =sd(Reaction), .groups ="drop")ggplot(dispersion_dia_s12, aes(Days, sd_marginal)) +geom_line(colour ="#447B92", linewidth =1) +geom_point(colour ="#447B92", size =2) +scale_x_continuous(breaks =0:9) +labs(x ="Día", y ="Desviación estándar entre personas (ms)",title ="¿La dispersión marginal cambia durante el seguimiento?") +theme_minimal(base_size =12)
Figura 12.2: Desviación estándar de las respuestas entre participantes por día. Este resumen NO es una estimación directa de la desviación estándar residual condicional.
En esta última figura podemos encontrar diferencias apreciables entre días, pero no atribuirlas a \(\sigma_{ij}\) sin descontar antes el término \(\mathbf Z_i\boldsymbol\Sigma\mathbf Z_i^\top\).
12.9.3 Visualización de matrices de correlación
La siguiente figura es teórica: sus valores son seleccionados para mostrar patrones, no estimados a partir de los datos. Se contrasta una matriz de independencia residual, la correlación marginal de un modelo con intercepto variable y un AR(1) residual.
n_tiempos_s12 <-6LC_ind_s12 <-diag(n_tiempos_s12)C_intercepto_s12 <-matrix(0.45, n_tiempos_s12, n_tiempos_s12)diag(C_intercepto_s12) <-1C_ar_s12 <-outer(1:n_tiempos_s12, 1:n_tiempos_s12,function(j, k) 0.65^abs(j - k))# Al construir la tabla a partir de índices explícitos evitamos depender de# los nombres de dimensiones que asigna as.table() a matrices sin dimnames.matriz_correlaciones_s12 <-function(M, etiqueta) {stopifnot(is.matrix(M), nrow(M) >0L, ncol(M) >0L)tibble(ocasion_1 =rep(seq_len(nrow(M)), times =ncol(M)),ocasion_2 =rep(seq_len(ncol(M)), each =nrow(M)),correlacion =as.vector(M),estructura = etiqueta )}correlaciones_s12 <-bind_rows(matriz_correlaciones_s12(C_ind_s12, "Independencia residual"),matriz_correlaciones_s12(C_intercepto_s12, "Intercepto variable (marginal)"),matriz_correlaciones_s12(C_ar_s12, "AR(1) residual"))ggplot(correlaciones_s12,aes(ocasion_1, ocasion_2, fill = correlacion)) +geom_tile(colour ="white", linewidth =0.4) +coord_equal() +facet_wrap(~estructura, nrow =1) +scale_fill_gradient(low ="white", high ="#2A688E", limits =c(0, 1)) +scale_x_continuous(breaks =1:6) +scale_y_continuous(breaks =1:6) +labs(x ="Ocasión", y ="Ocasión", fill ="Correlación") +theme_minimal(base_size =10)
Figura 12.3: Patrones teóricos de correlación con seis ocasiones: independencia residual; correlación marginal por intercepto variable; y correlación residual AR(1) con rho = 0.65.
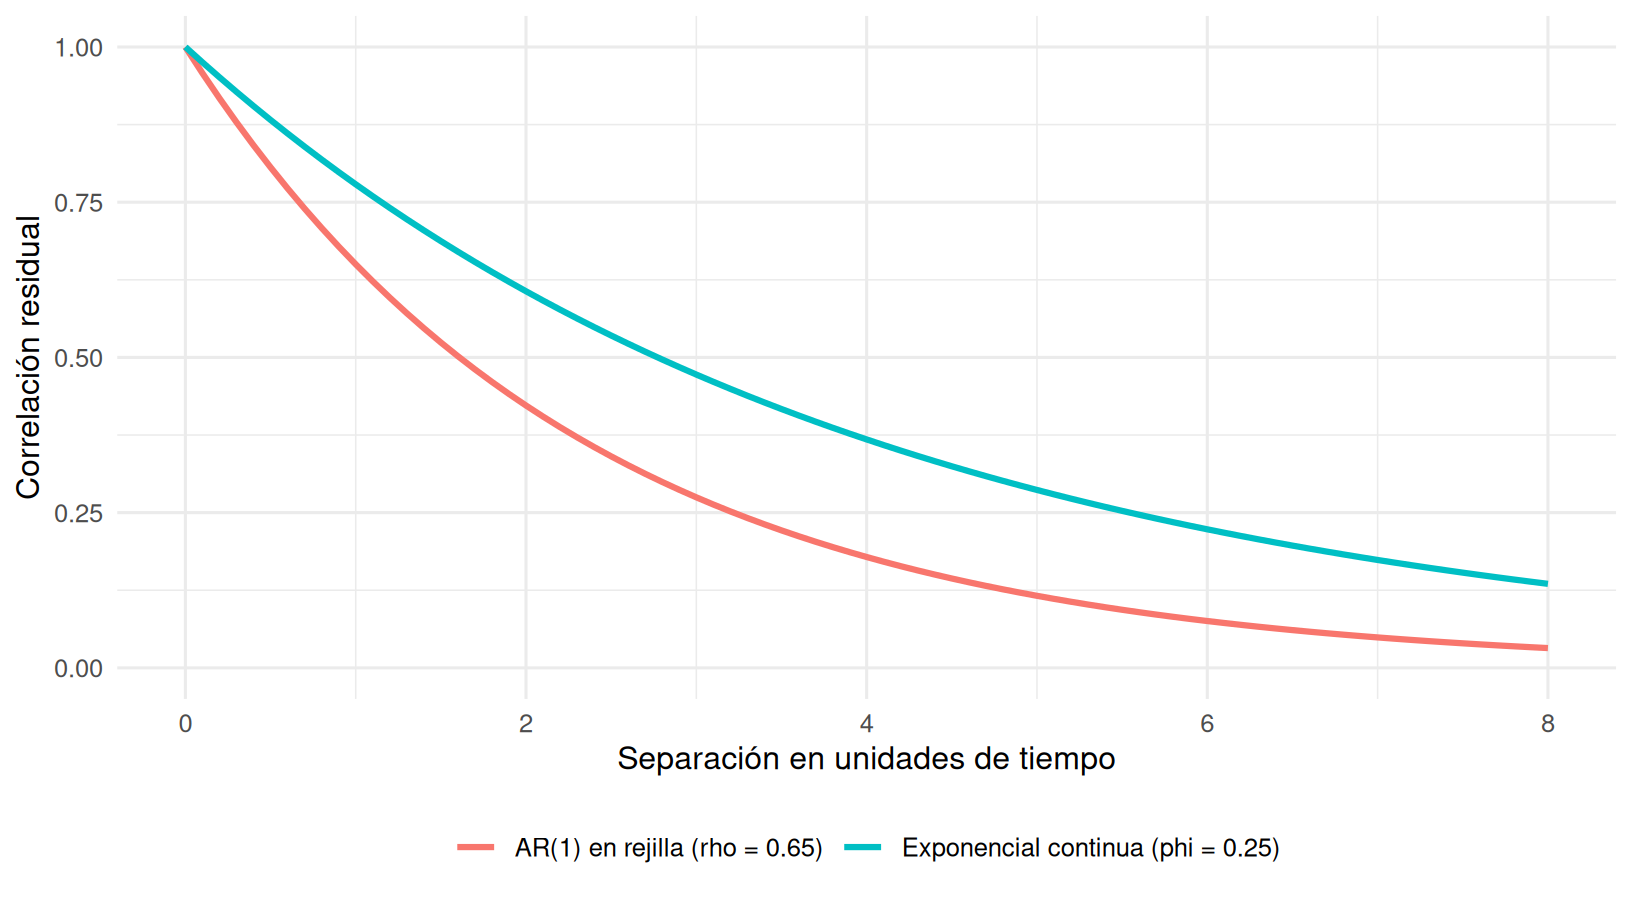
lags_s12 <-seq(0, 8, by =0.1)curvas_corr_s12 <-tibble(distancia =rep(lags_s12, 2L),correlacion =c(0.65^lags_s12, exp(-0.25* lags_s12)),tipo =rep(c("AR(1) en rejilla (rho = 0.65)","Exponencial continua (phi = 0.25)"),each =length(lags_s12)))ggplot(curvas_corr_s12, aes(distancia, correlacion, colour = tipo)) +geom_line(linewidth =1.1) +coord_cartesian(ylim =c(0, 1)) +labs(x ="Separación en unidades de tiempo", y ="Correlación residual",colour =NULL) +theme_minimal(base_size =12) +theme(legend.position ="bottom")
Figura 12.4: Correlación residual según la separación temporal: AR(1) positiva y correlación exponencial en tiempo continuo. Para rho negativo, AR(1) alternaría de signo.
Aquí \(0.65^d\) se dibuja como continuación matemática sobre distancias reales, pero el modelo AR(1) original se define en rezagos enteros. La curva continua resulta útil para comparar formas, no para justificar el uso indiscriminado de ar() con tiempos irregulares.
12.9.4 Comprobación predictiva previa mediante simulación directa
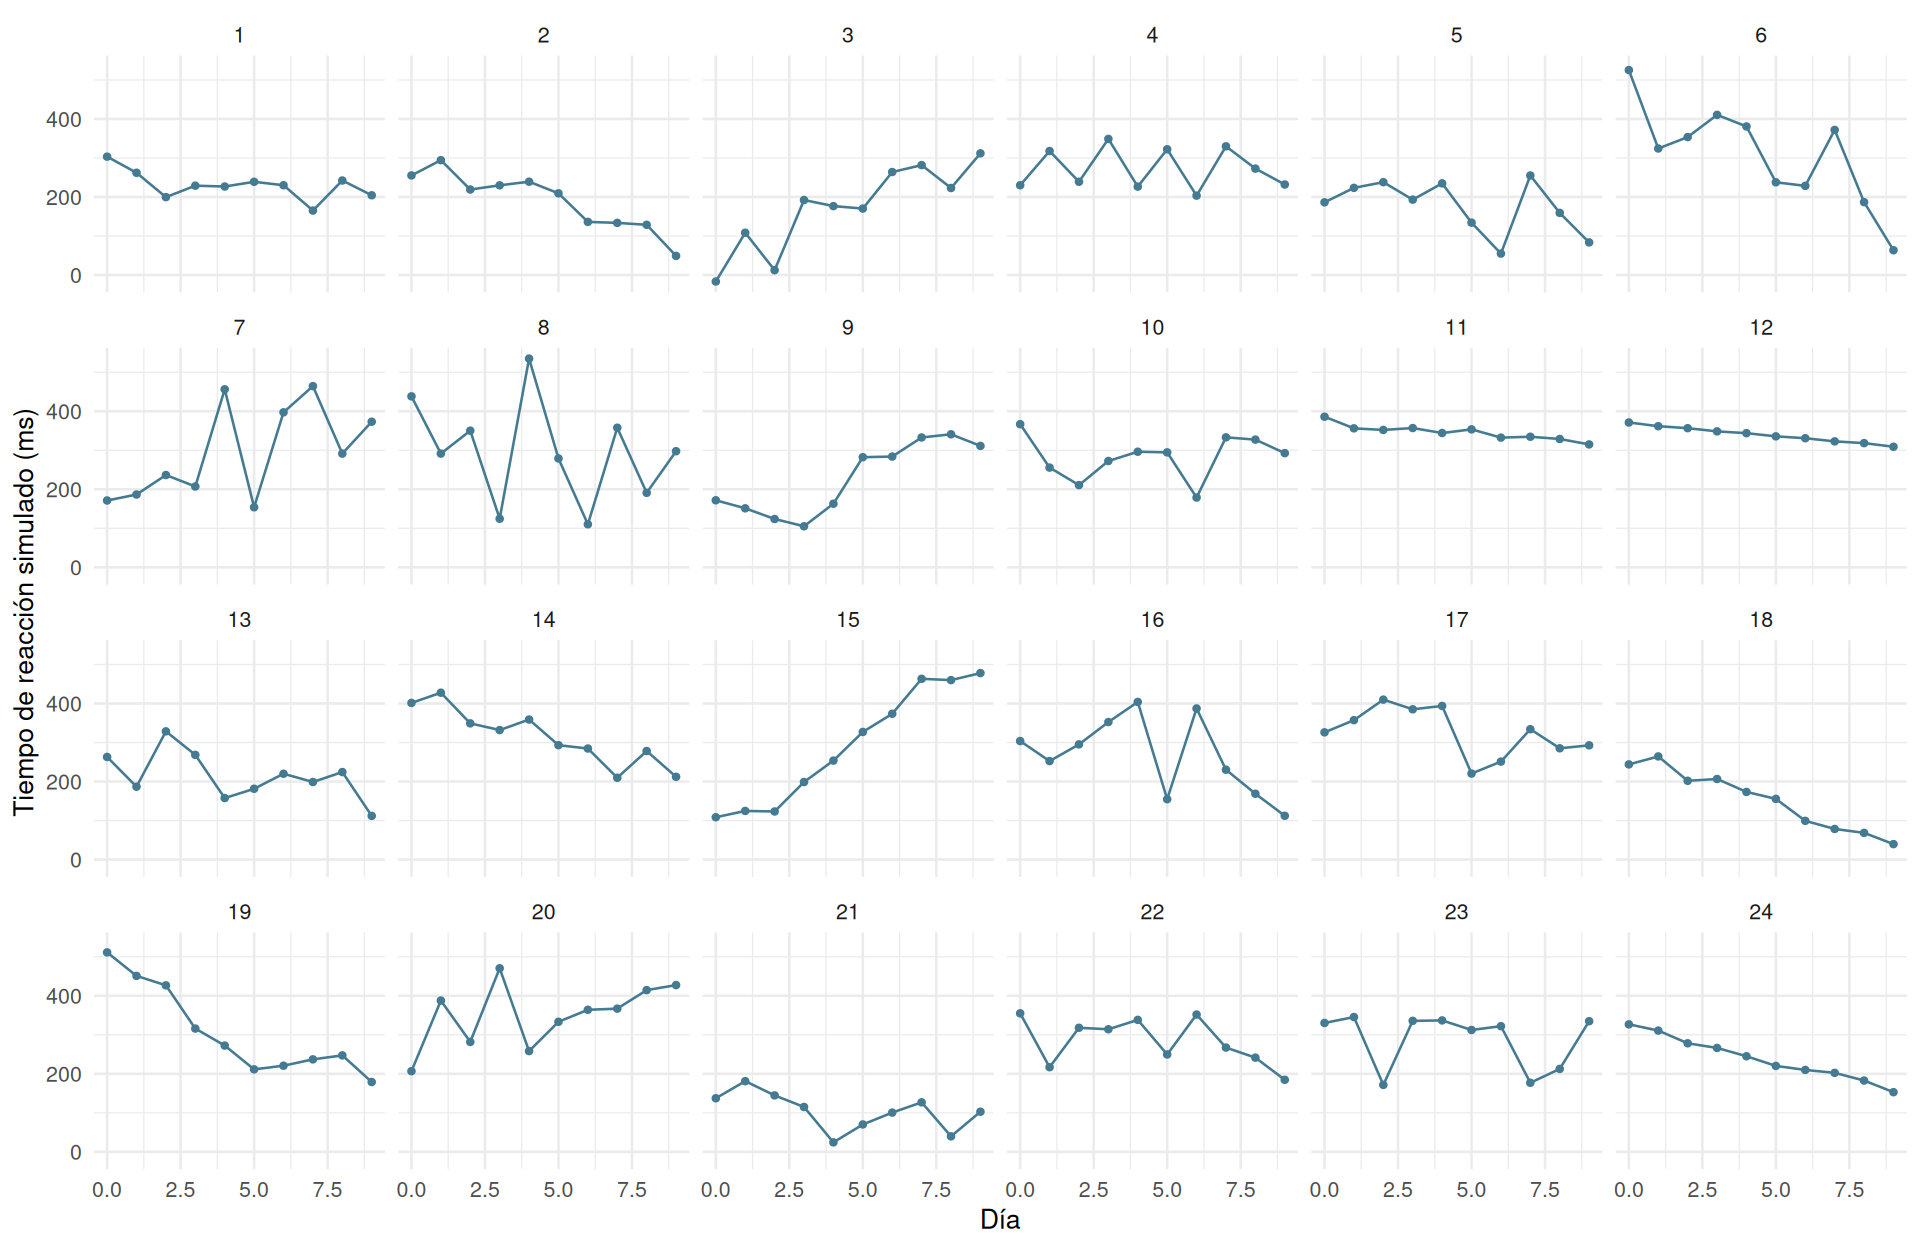
Antes de ajustar modelos, simularemos exactamente las distribuciones previas de Ecuación 12.18 para un participante nuevo y diez ocasiones, usando una normal bivariada para los coeficientes individuales y una secuencia AR(1) estacionaria para los residuos. En dimensión dos, la distribución LKJ(2) de la correlación \(r_{01}\) es equivalente a \(2B-1\), con \(B\sim\mathrm{Beta}(2,2)\).
previa_s12 |>filter(simulacion <=24) |>ggplot(aes(Days, Reaction, group = simulacion)) +geom_line(colour ="#447B92") +geom_point(size =0.9, colour ="#447B92") +facet_wrap(~simulacion, ncol =6) +labs(x ="Día", y ="Tiempo de reacción simulado (ms)") +theme_minimal(base_size =10)
Figura 12.5: Veinticuatro trayectorias simuladas de las previas, antes de utilizar las respuestas observadas. Algunas realizaciones pueden ser sustantivamente implausibles; esa es precisamente una señal para revisar las previas.
La simulación usa las mismas familias de previas que propondremos al ajustar el modelo, pero sin realizar una actualización posterior. Esta comprobación es importante si alguna combinación produce valores negativos, cambios extraordinarios o persistencias temporales poco razonables. El propósito no es eliminar cualquier realización rara: es verificar si la distribución previa conjunta expresa incertidumbre compatible con el contexto del estudio.
12.9.5 De un modelo sencillo a una estructura residual AR(1)
Primero ajustaremos M0, con interceptos variables, y M1, con interceptos y pendientes variables. El segundo es la continuación directa de la semana 11. Después ajustaremos M2, que añade correlación residual AR(1) a M1. Mantendremos la misma media condicional y las mismas previas de los componentes compartidos; de ese modo, la principal extensión de M1 a M2 será la covarianza residual.
En la sintaxis actual de brms, la estructura autorregresiva se introduce con ar(time = Days, gr = Subject, p = 1, cov = TRUE). Indicamos cov = TRUE para utilizar la representación estacionaria mediante matrices de covarianza residual, que corresponde directamente a Ecuación 12.8. Esta formulación está disponible para AR(1); no es una autorización para usar cov = TRUE con cualquier orden ARMA. Evitaremos cor_ar(), la interfaz antigua deprecada; véase la documentación de ar() de brms.
formula_m0_s12 <- brms::bf( Reaction ~1+ dia_c + (1| Subject))formula_m1_s12 <- brms::bf( Reaction ~1+ dia_c + (1+ dia_c | Subject))formula_m2_s12 <- brms::bf( Reaction ~1+ dia_c + (1+ dia_c | Subject) +ar(time = Days, gr = Subject, p =1, cov =TRUE))prioris_m0_s12 <-c( brms::prior(normal(300, 70), class ="Intercept"), brms::prior(normal(0, 12), class ="b", coef ="dia_c"), brms::prior(normal(0, 60), class ="sd", group ="Subject",coef ="Intercept"), brms::prior(normal(0, 60), class ="sigma"))prioris_m1_s12 <-c( brms::prior(normal(300, 70), class ="Intercept"), brms::prior(normal(0, 12), class ="b", coef ="dia_c"), brms::prior(normal(0, 60), class ="sd", group ="Subject",coef ="Intercept"), brms::prior(normal(0, 12), class ="sd", group ="Subject",coef ="dia_c"), brms::prior(normal(0, 60), class ="sigma"), brms::prior(lkj(2), class ="cor"))prioris_m2_s12 <-c( prioris_m1_s12, brms::prior(normal(0, 0.35), class ="ar"))# Comprobar las clases y coeficientes antes de ajustar.previas_disponibles_m2_s12 <- brms::get_prior( formula_m2_s12, data = datos_s12, family =gaussian())previas_disponibles_m2_s12 |>select(prior, class, coef, group, dpar, lb, ub)
La clase ar se encuentra limitada al intervalo admisible, mientras que las previas normales para las desviaciones estándar de clase sd o sigma se restringen a valores no negativos. En casos donde get_prior() revele diferencias entre versiones de brms, deben reconciliarse los nombres de clases antes del ajuste, en lugar de suponer que el software aplicó una previa concreta.
 Family: gaussian
  Links: mu = identity
Formula: Reaction ~ 1 + dia_c + (1 + dia_c | Subject)
   Data: datos_s12 (Number of observations: 180)
  Draws: 4 chains, each with iter = 2200; warmup = 1000; thin = 1;
         total post-warmup draws = 4800

Multilevel Hyperparameters:
~Subject (Number of levels: 18)
                     Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS
sd(Intercept)           39.44      7.18    27.97    55.78 1.00     1171
sd(dia_c)                6.25      1.36     3.99     9.32 1.00     1689
cor(Intercept,dia_c)     0.61      0.18     0.18     0.88 1.00     1930
                     Tail_ESS
sd(Intercept)            2062
sd(dia_c)                2562
cor(Intercept,dia_c)     2806

Regression Coefficients:
          Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
Intercept   297.30      9.66   278.66   316.74 1.01      757     1260
dia_c        10.15      1.60     6.92    13.29 1.00     1356     1828

Further Distributional Parameters:
      Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
sigma    25.80      1.52    23.07    29.03 1.00     4422     3671

Draws were sampled using sample(hmc). For each parameter, Bulk_ESS
and Tail_ESS are effective sample size measures, and Rhat is the potential
scale reduction factor on split chains (at convergence, Rhat = 1).
print(fit_m2_s12)
 Family: gaussian
  Links: mu = identity
Formula: Reaction ~ 1 + dia_c + (1 + dia_c | Subject) + ar(time = Days, gr = Subject, p = 1, cov = TRUE)
   Data: datos_s12 (Number of observations: 180)
  Draws: 4 chains, each with iter = 2500; warmup = 1000; thin = 1;
         total post-warmup draws = 6000

Correlation Structures:
      Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
ar[1]     0.44      0.11     0.22     0.66 1.00     1333     1414

Multilevel Hyperparameters:
~Subject (Number of levels: 18)
                     Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS
sd(Intercept)           36.30      7.47    23.56    53.05 1.00     1730
sd(dia_c)                5.03      1.57     2.12     8.51 1.00     1919
cor(Intercept,dia_c)     0.65      0.22     0.14     0.94 1.00     3284
                     Tail_ESS
sd(Intercept)            2095
sd(dia_c)                2156
cor(Intercept,dia_c)     3425

Regression Coefficients:
          Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
Intercept   298.91      9.47   280.12   317.95 1.00     1670     2417
dia_c        10.29      1.56     7.21    13.37 1.00     2770     3935

Further Distributional Parameters:
      Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
sigma    26.69      1.68    23.66    30.18 1.00     2725     3099

Draws were sampled using sample(hmc). For each parameter, Bulk_ESS
and Tail_ESS are effective sample size measures, and Rhat is the potential
scale reduction factor on split chains (at convergence, Rhat = 1).
Es importante no asumir que el modelo con autocorrelación ajusta mejor simplemente porque contiene más parámetros. En particular, un valor de \(\rho\) poco determinado, una disminución de \(\tau_1\) o fuertes relaciones posteriores entre \(\rho\) y la variación de pendientes pueden indicar que las distintas componentes compiten por explicar el mismo patrón temporal. Debemos examinar el significado y la estabilidad de cada componente, además de sus predicciones.
12.9.6 Heterocedasticidad y trayectoria no lineal: dos extensiones separadas
Ajustaremos M3, con desviación estándar residual dependiente de dia_c, y M4, con tendencia poblacional suavizada. Mantener estas ampliaciones separadas facilita reconocer qué aspecto de las observaciones puede mejorar cada una. M3 conserva la independencia residual condicional de M1; M4 también conserva esa independencia, pero permite una media poblacional más flexible. Ninguno contiene AR(1) en este laboratorio.
formula_m3_s12 <- brms::bf( Reaction ~1+ dia_c + (1+ dia_c | Subject), sigma ~1+ dia_c)prioris_m3_s12 <-c( brms::prior(normal(300, 70), class ="Intercept"), brms::prior(normal(0, 12), class ="b", coef ="dia_c"), brms::prior(normal(0, 60), class ="sd", group ="Subject",coef ="Intercept"), brms::prior(normal(0, 12), class ="sd", group ="Subject",coef ="dia_c"), brms::prior(lkj(2), class ="cor"), brms::prior(normal(log(35), 0.6), class ="Intercept", dpar ="sigma"), brms::prior(normal(0, 0.08), class ="b", coef ="dia_c", dpar ="sigma"))# Suavizado de media poblacional; diferencias individuales lineales.formula_m4_s12 <- brms::bf( Reaction ~1+s(Days, k =5) + (1+ dia_c | Subject))prioris_m4_s12 <-c( brms::prior(normal(300, 70), class ="Intercept"), brms::prior(normal(0, 60), class ="sd", group ="Subject",coef ="Intercept"), brms::prior(normal(0, 12), class ="sd", group ="Subject",coef ="dia_c"), brms::prior(normal(0, 60), class ="sigma"), brms::prior(lkj(2), class ="cor"), brms::prior(normal(0, 20), class ="sds"))brms::get_prior(formula_m3_s12, datos_s12, family =gaussian()) |>select(class, coef, dpar, group)
     class      coef  dpar   group    source
         b                         (unknown)
         b     dia_c               (unknown)
       cor                         (unknown)
       cor                 Subject (unknown)
 Intercept                         (unknown)
        sd                         (unknown)
        sd                 Subject (unknown)
        sd     dia_c       Subject (unknown)
        sd Intercept       Subject (unknown)
         b           sigma         (unknown)
         b     dia_c sigma         (unknown)
 Intercept           sigma         (unknown)
brms::get_prior(formula_m4_s12, datos_s12, family =gaussian()) |>select(class, coef, dpar, group)
     class           coef dpar   group    source
         b                             (unknown)
         b        sDays_1              (unknown)
       cor                             (unknown)
       cor                     Subject (unknown)
 Intercept                             (unknown)
        sd                             (unknown)
        sd                     Subject (unknown)
        sd          dia_c      Subject (unknown)
        sd      Intercept      Subject (unknown)
       sds                             (unknown)
       sds s(Days, k = 5)              (unknown)
     sigma                             (unknown)
En M4 no introdujimos un coeficiente fijo dia_c adicional porque la función s(Days, k = 5) ya puede representar la componente lineal de la evolución media. El coeficiente individual de dia_c es una desviación respecto de la trayectoria poblacional, no una pendiente poblacional constante. Los parámetros de suavizado merecen diagnóstico y las extrapolaciones fuera de días 0–9 deben interpretarse con cautela.
12.10 Diagnóstico computacional
12.10.1 ¿Qué constituye un ajuste computacional confiable?
Para cada modelo examinaremos \(\widehat R\), tamaños efectivos de muestra para la región central y las colas, divergencias de NUTS y saturaciones de la profundidad máxima del árbol. Los diagnósticos deben evaluarse antes de extraer conclusiones sobre \(\rho\), cambios de varianza o curvatura (Gelman et al. 2026, chaps. 11-12).
El objetivo es disponer de \(\widehat R\) cercano a uno (como referencia, menor de 1.01), tamaños efectivos suficientes para las cantidades de interés y ausencia de divergencias. Una saturación de max_treedepth advierte sobre posible ineficiencia, pero no equivale a una divergencia. Si falla algún diagnóstico, no debemos confiar en los intervalos producidos ni asumir que aumentar adapt_delta resolverá un problema de identificación. Se revisarán la escala del tiempo, las previas, la complejidad de \(\boldsymbol\Sigma\) y la posible redundancia entre componentes antes de modificar controles de HMC.
draws_m2_s12 <- posterior::as_draws_df(fit_m2_s12)param_ar_s12 <-grep("^ar(\\[|$|_)", names(draws_m2_s12), value =TRUE)param_ar_s12
[1] "ar[1]"
if (length(param_ar_s12) !=1L) {stop("No se pudo identificar un único parámetro AR(1). ","Revise variables(fit_m2_s12) y la versión de brms." )}posterior::summarise_draws( posterior::subset_draws( posterior::as_draws_array(fit_m2_s12),variable = param_ar_s12 ),"mean", "sd", "median", "rhat", "ess_bulk", "ess_tail")
# A tibble: 1 × 7
  variable  mean    sd median  rhat ess_bulk ess_tail
  <chr>    <dbl> <dbl>  <dbl> <dbl>    <dbl>    <dbl>
1 ar[1]    0.440 0.110  0.440  1.00    1333.    1414.
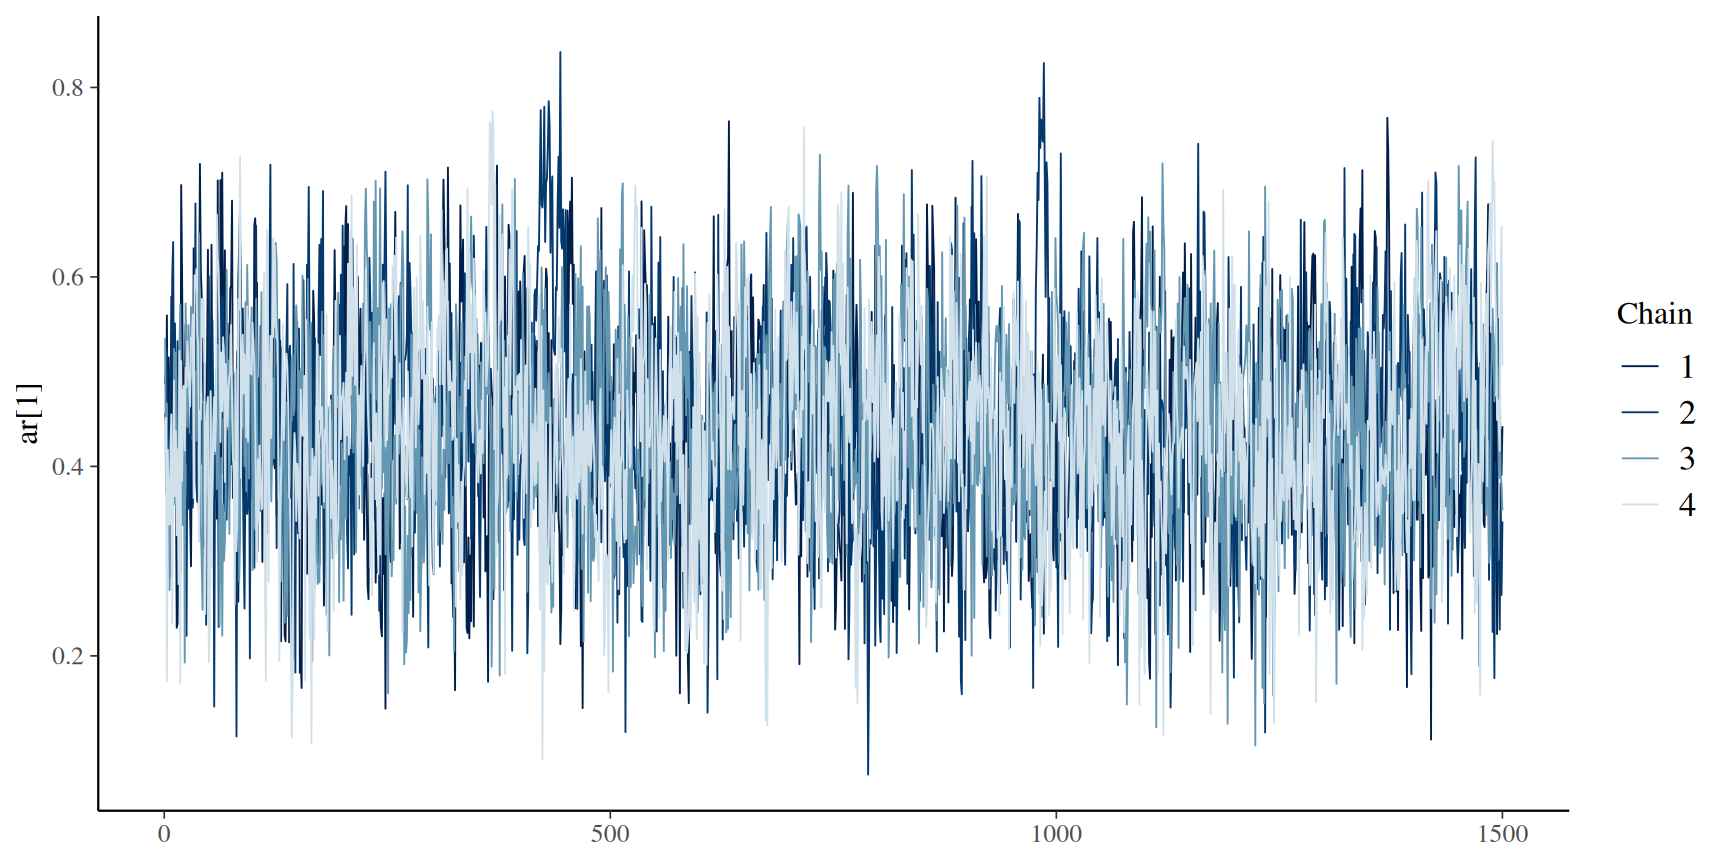
bayesplot::mcmc_trace( posterior::as_draws_array(fit_m2_s12), pars = param_ar_s12)
Figura 12.6: Trazas de la autocorrelación residual de M2: comprobar que las cuatro cadenas exploren regiones semejantes de la posterior.
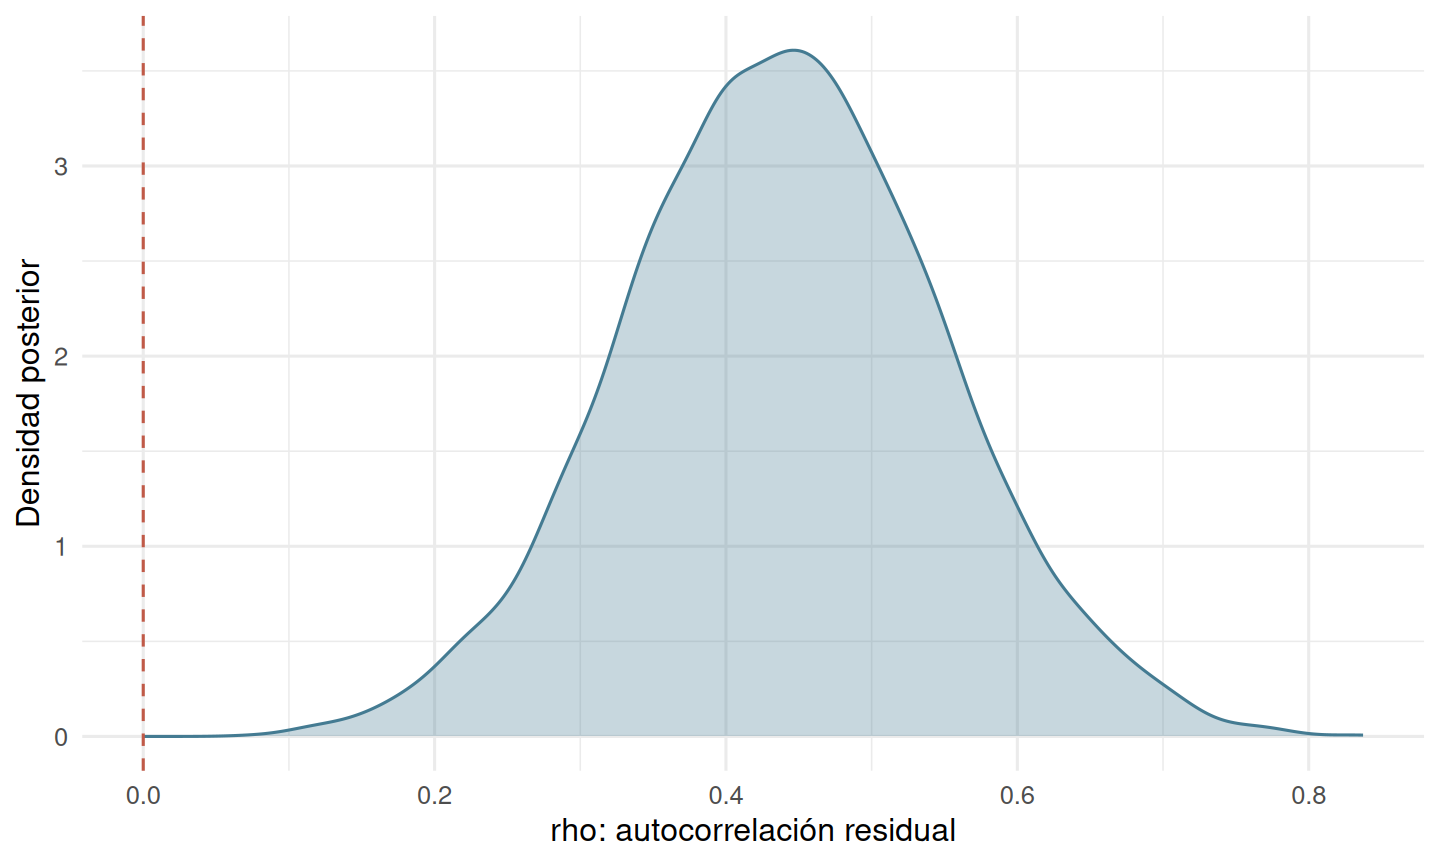
Figura 12.7: Distribución posterior de la autocorrelación residual AR(1). El cero representa ausencia de autocorrelación residual en esta estructura, no ausencia de correlación marginal entre las respuestas.
El resumen de \(\rho\) debe leerse junto con las posteriors de \(\tau_0\), \(\tau_1\), \(r_{01}\) y \(\sigma\). Los cambios de esas distribuciones entre M1 y M2 pueden ser informativos, pero no justifican por sí solos una interpretación causal de los componentes de covarianza.
Los diagnósticos HMC/NUTS evalúan la simulación de la posterior, no la adecuación estadística del modelo. Para comprobar un modelo longitudinal necesitamos resúmenes que preserven quién fue observado y cuándo. Una comprobación que mezcla todas las respuestas puede ocultar errores en la trayectoria media, la variación condicional y la persistencia temporal (Gelman et al. 2026, sec. 8.2).
12.11.1 Simulación coherente de trayectorias posteriores
Generaremos réplicas del conjunto de datos manteniendo las mismas personas y el mismo calendario. Para M1, M3 y M4 utilizaremos posterior_predict(). Para M2 mostraremos explícitamente cómo simular una secuencia estacionaria AR(1) por individuo, utilizando, en cada extracción posterior, sus valores de \(\rho\) y \(\sigma\) y las medias condicionales correspondientes. Esto hace transparente qué dependencia debe aparecer en una réplica conjunta de toda una trayectoria.
ids_s12 <-seq_len(180L)set.seed(16531221)# Todas estas matrices tienen dimensiones: extracciones x filas del estudio.yrep_m1_s12 <- brms::posterior_predict( fit_m1_s12, draw_ids = ids_s12)yrep_m3_s12 <- brms::posterior_predict( fit_m3_s12, draw_ids = ids_s12)yrep_m4_s12 <- brms::posterior_predict( fit_m4_s12, draw_ids = ids_s12)mu_m1_s12 <- brms::posterior_epred(fit_m1_s12, draw_ids = ids_s12)mu_m2_s12 <- brms::posterior_epred(fit_m2_s12, draw_ids = ids_s12)mu_m3_s12 <- brms::posterior_epred(fit_m3_s12, draw_ids = ids_s12)mu_m4_s12 <- brms::posterior_epred(fit_m4_s12, draw_ids = ids_s12)idx_sujetos_s12 <-split(seq_len(nrow(datos_s12)), datos_s12$Subject)stopifnot(all(vapply(idx_sujetos_s12, length, integer(1)) ==10L))simular_ar_condicional_s12 <-function(mu, sigma, rho, indices) {# Solo para este diseño: paso temporal uno, observaciones 0:9 completas. eps <-numeric(length(mu))for (ii in indices) { eps[ii[1]] <-rnorm(1, 0, sigma)for (k in2:length(ii)) { eps[ii[k]] <- rho * eps[ii[k -1L]] +rnorm(1, 0, sigma *sqrt(1- rho^2)) } } mu + eps}# Se preserva la correspondencia entre draw_ids de epred y parámetros.stopifnot("sigma"%in%names(draws_m2_s12))yrep_m2_s12 <-matrix(NA_real_, nrow =length(ids_s12), ncol =nrow(datos_s12))for (h inseq_along(ids_s12)) { k <- ids_s12[h] yrep_m2_s12[h, ] <-simular_ar_condicional_s12(mu = mu_m2_s12[h, ],sigma = draws_m2_s12$sigma[k],rho = draws_m2_s12[[param_ar_s12]][k],indices = idx_sujetos_s12 )}stopifnot(identical(dim(yrep_m1_s12), dim(mu_m1_s12)),identical(dim(yrep_m2_s12), dim(mu_m2_s12)),identical(dim(yrep_m3_s12), dim(mu_m3_s12)),identical(dim(yrep_m4_s12), dim(mu_m4_s12)),all(is.finite(yrep_m2_s12)))
Alcance de esta simulación: las réplicas M2 son trayectorias completas con residuos inicializados en su distribución estacionaria y con intervalos consecutivos de un día. No representan una predicción de la siguiente medición condicionada en el último error observado, ni deben aplicarse sin cambios a datos con visitas irregulares. Para formular esa predicción dinámica hace falta incorporar el historial residual en la distribución predictiva pertinente.
12.11.2 Comprobación global de la respuesta
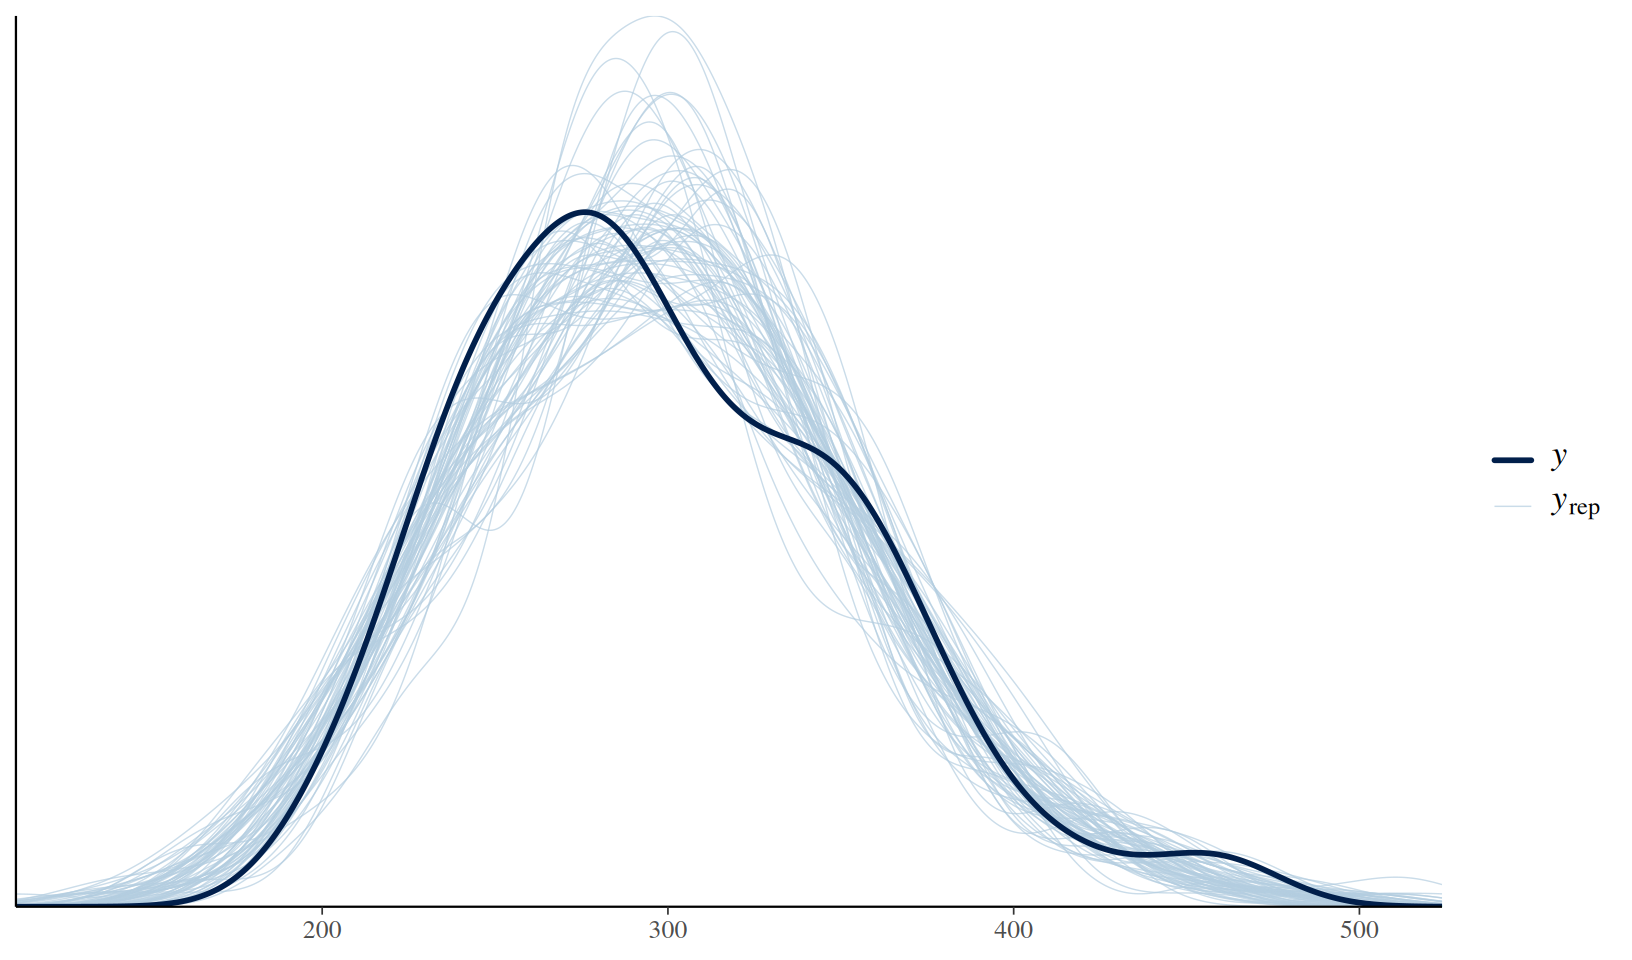
bayesplot::ppc_dens_overlay(y = datos_s12$Reaction,yrep = yrep_m1_s12[1:70, , drop =FALSE])
Figura 12.8: Distribuciones globales: respuestas observadas frente a réplicas de M1. Este diagnóstico es útil, pero puede no detectar una dependencia temporal mal especificada.
Una reproducción global razonable no garantiza la reproducción de promedios por día ni de la asociación entre desviaciones consecutivas.
12.11.3 Comprobación de la media por día
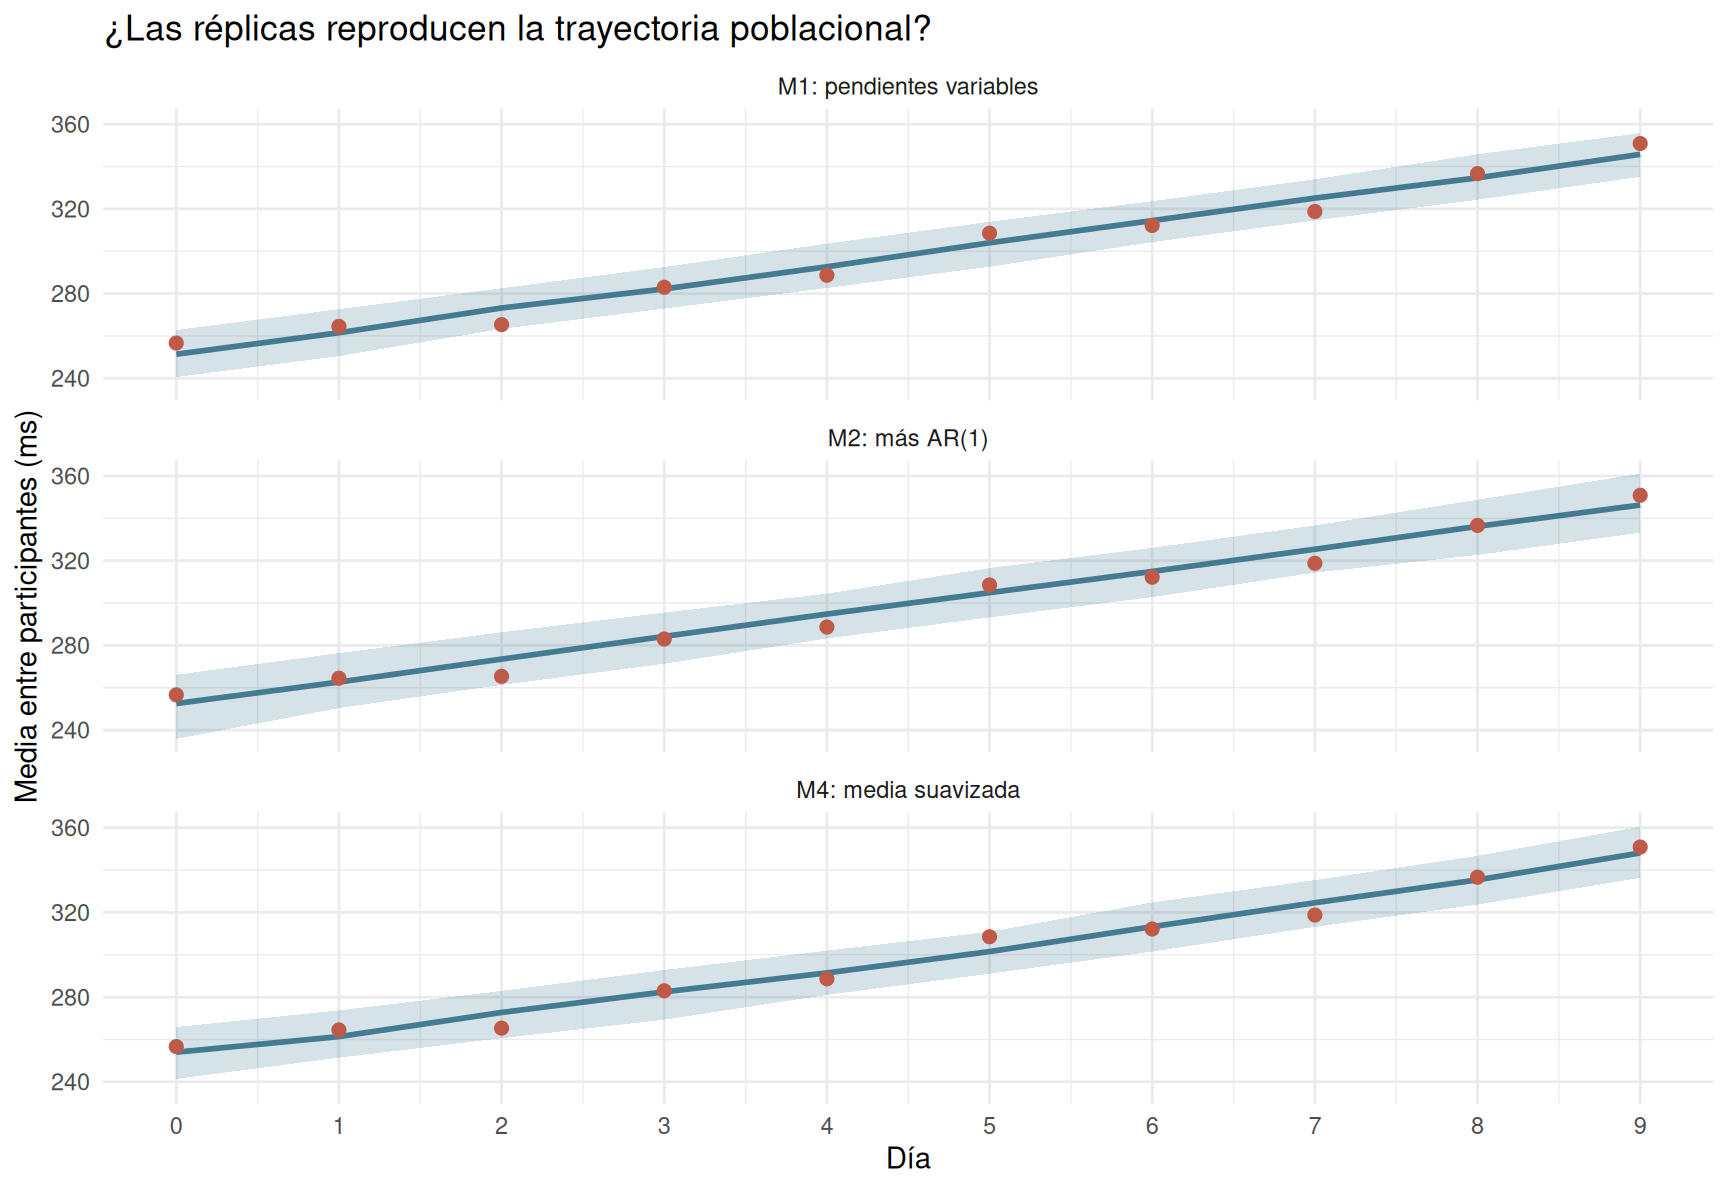
Para cada réplica obtendremos la media entre participantes en los días 0–9 y contrastaremos esas distribuciones con las medias observadas. Esto permite estudiar la necesidad de una trayectoria poblacional flexible sin recurrir únicamente a una gráfica de la curva ajustada.
Figura 12.9: Medias observadas por día y bandas predictivas posteriores del 90 % para M1, M2 y M4. Las bandas corresponden a réplicas de datos, no solamente a incertidumbre de la media condicional.
Es esperable que introducir AR(1) cambie principalmente el patrón de dependencia residual, no que proporcione por sí mismo una función de media más flexible. Si las medias por día muestran curvatura sistemática fuera de las bandas de M1 y M2, la estructura de la media merece revisión. M4 permite una curva más flexible, pero es igualmente necesario evaluar si su amplitud y regularización resultan compatibles con la evidencia.
12.11.4 Comprobación de dispersión condicional por día
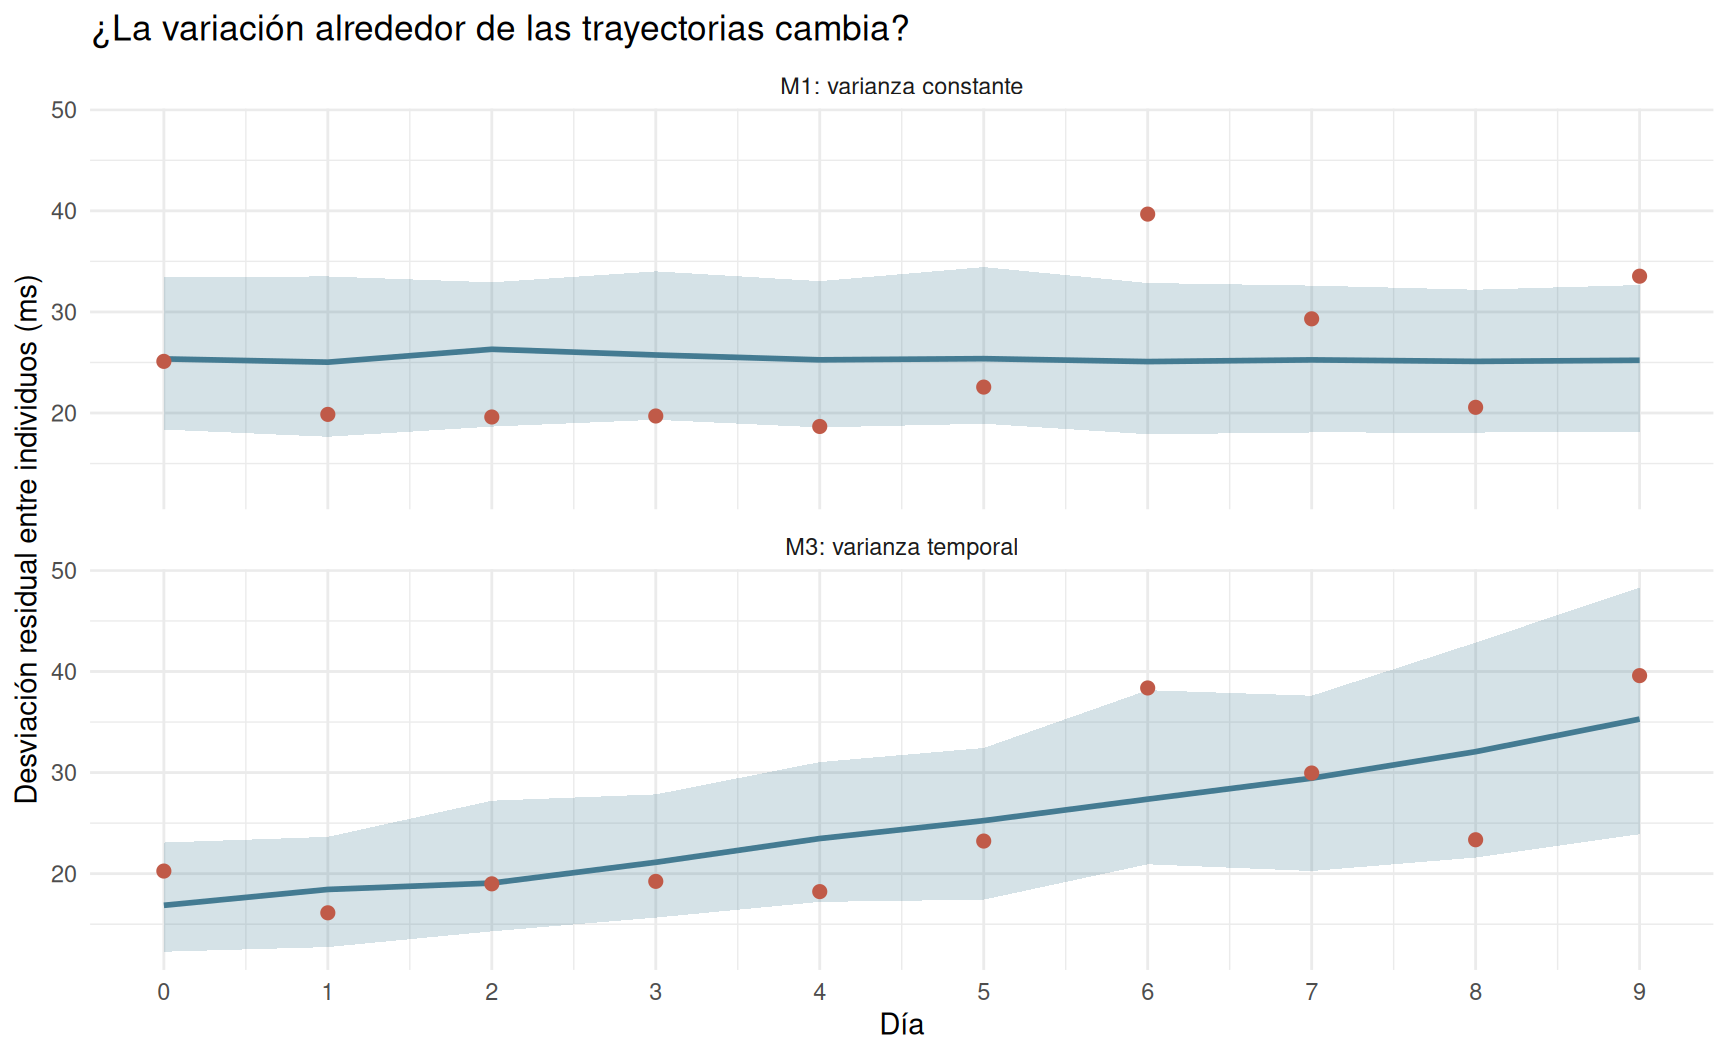
La desviación estándar entre participantes de Figura 12.2 no aísla la escala residual. Para ello, en cada extracción posterior \(s\) calcularemos residuos condicionales
con la media del mismo individuo y la misma extracción. Calcularemos su desviación estándar entre personas por día. En el caso observado, el resumen depende de \(s\) porque la trayectoria condicional no es conocida sin incertidumbre; para las réplicas incorpora también la variabilidad residual generada.
Figura 12.10: Dispersión residual condicional por día: resúmenes observados (puntos) frente a intervalos predictivos posteriores de M1 y M3.
Esta discrepancia es una herramienta de exploración posterior, no una estimación independiente de los parámetros de variación. Un patrón persistente en la dispersión condicional observada puede sugerir revisar la función de \(\sigma(t)\), la forma de la media o la distribución de los errores.
12.11.5 Comprobación de autocorrelación residual a rezago uno
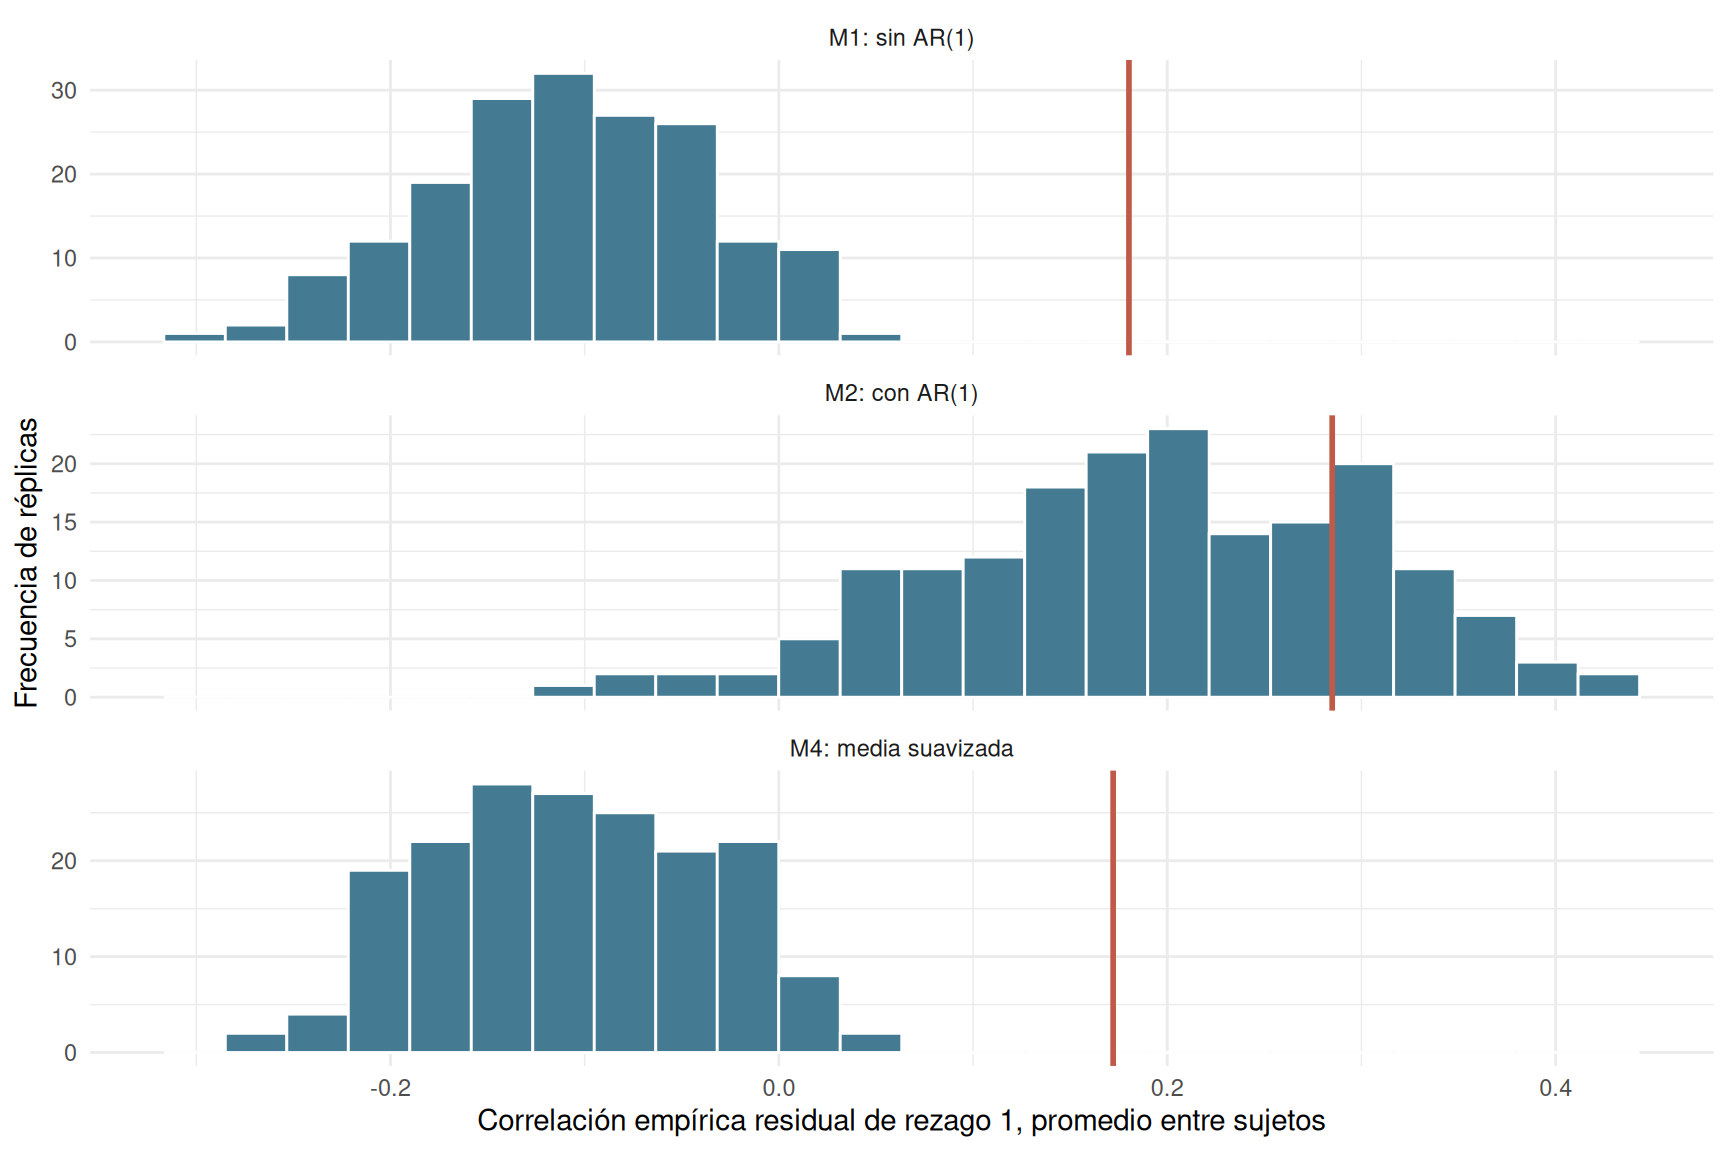
Construiremos una discrepancia centrada en la dependencia que queremos evaluar: para cada participante calculamos la correlación empírica entre sus residuos de días consecutivos, siempre después de descontar la trayectoria de esa persona, y luego promediamos entre participantes. Diez ocasiones por persona producen estimaciones individuales ruidosas; por eso comparamos una estadística agregada, cuya distribución se obtiene simulando trayectorias completas.
Figura 12.11: Distribución predictiva posterior de la autocorrelación residual empírica promedio (histogramas). Las líneas marcan las medianas de la misma discrepancia calculada sobre los datos observados para cada modelo.
Una precaución importante: la correlación muestral de dos vectores de longitud nueve no es un estimador sin sesgo de \(\rho\); incluso cuando \(\rho=0\), el promedio de correlaciones empíricas centradas dentro de cada sujeto puede mostrar un sesgo apreciable. Por eso no comparamos mecánicamente la discrepancia con cero ni con la mediana posterior de \(\rho\), sino con la distribución de la misma discrepancia calculada en réplicas generadas bajo el modelo y el mismo calendario.
Además, hay incertidumbre en las medias individuales \(\mu_{ij}\) utilizadas para construir residuos; por ese motivo calculamos la discrepancia observada para cada extracción posterior. La comparación es descriptiva y no reemplaza una validación fuera de muestra. Si se desea un análisis de autocorrelación para varios rezagos, puede repetirse el procedimiento teniendo presente la reducción de pares disponibles a rezagos grandes.
12.11.6 Interpretación de las cinco especificaciones
La secuencia M0–M4 debe interpretarse como una investigación de mecanismos, no como un concurso que obligatoriamente escogerá al último modelo. Podemos encontrar, por ejemplo, que M1 ya reproduce la variabilidad entre trayectorias, que M2 solo modifica ligeramente la correlación condicional, o que M4 aporta una trayectoria media más adecuada. También podemos encontrar resultados inconcluyentes debido al tamaño y la duración del estudio.
Modelo
Qué modifica respecto de una regresión común
Qué debemos comprobar prioritariamente
M0
Interceptos individuales
Diferencias en nivel y dispersión entre personas
M1
Pendientes individuales
Heterogeneidad de cambio y dependencia marginal
M2
AR(1) residual, además de M1
Autocorrelación de desvíos alrededor de cada trayectoria
M3
\(\sigma\) dependiente del tiempo, además de M1
Dispersión residual condicional durante el seguimiento
M4
Suavizado de la media, además de pendientes variables
Curvatura y medias por ocasión
En este capítulo no decidiremos entre ellos solo mediante un escalar de ajuste. En la semana 14 analizaremos comparación predictiva y validación cruzada, con especial atención a la unidad de validación adecuada: futuras ocasiones de individuos conocidos frente a individuos completamente nuevos.
12.12 Un experimento simulado: curvatura y tiempos irregulares
El conjunto sleepstudy facilita comparar modelos, pero no conocemos el proceso real que produjo las observaciones. Para distinguir entre curvatura media y dependencia residual en tiempo real, construiremos un segundo conjunto donde ambos mecanismos están especificados por nosotros. Este experimento es elaboración didáctica original; no es una aplicación empírica adicional.
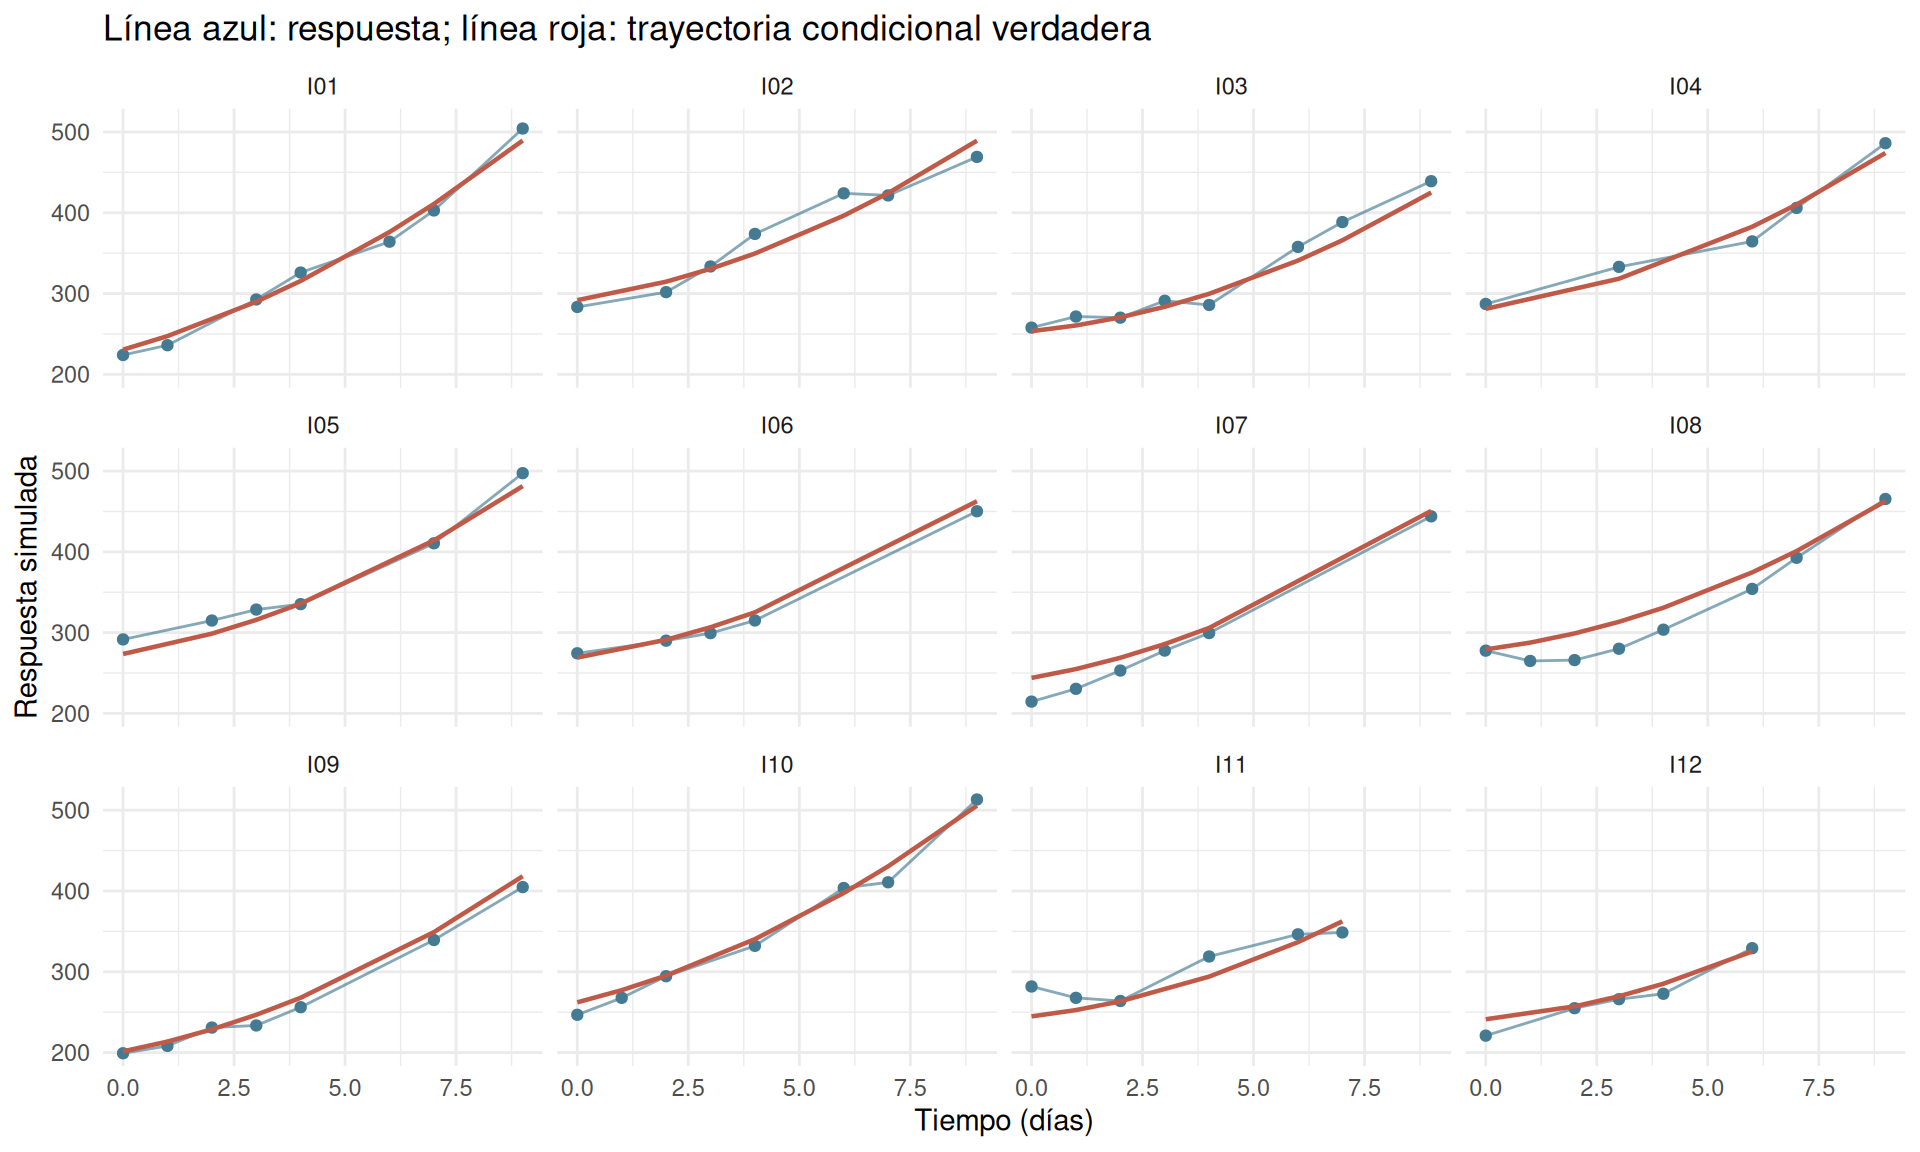
Generaremos individuos con tiempos observados distintos dentro de la ventana de nueve días:
Los valores de esta ecuación fueron elegidos para que la no linealidad y la persistencia residual sean visibles; no representan estimaciones para sleepstudy.
Figura 12.12: Trayectorias simuladas con una curvatura común, diferencias individuales y fluctuaciones residuales correlacionadas en tiempo continuo. Las observaciones de cada persona ocurren en tiempos desiguales.
tiempos_1_s12 <- datos_irreg_s12 |>filter(individuo ==levels(individuo)[1]) |>pull(tiempo)C_1_s12 <-exp(-0.45*abs(outer(tiempos_1_s12, tiempos_1_s12, `-`)))# Los índices se construyen explícitamente para que coincidan con el# orden por columnas de as.vector(C_1_s12), sin depender de dimnames.mapa_1_s12 <-tibble(j =rep(seq_len(nrow(C_1_s12)), times =ncol(C_1_s12)),k =rep(seq_len(ncol(C_1_s12)), each =nrow(C_1_s12)),correlacion =as.vector(C_1_s12)) |>mutate(t1 = tiempos_1_s12[j],t2 = tiempos_1_s12[k])ggplot(mapa_1_s12, aes(factor(t1), factor(t2), fill = correlacion)) +geom_tile(colour ="white", linewidth =0.4) +coord_equal() +scale_fill_gradient(low ="white", high ="#2A688E", limits =c(0, 1)) +labs(x ="Tiempo real (días)", y ="Tiempo real (días)",fill ="Correlación") +theme_minimal(base_size =11)
Figura 12.13: Correlación residual verdadera entre los tiempos observados para una persona simulada. La distancia cronológica, no solamente el orden de visita, determina cada elemento.
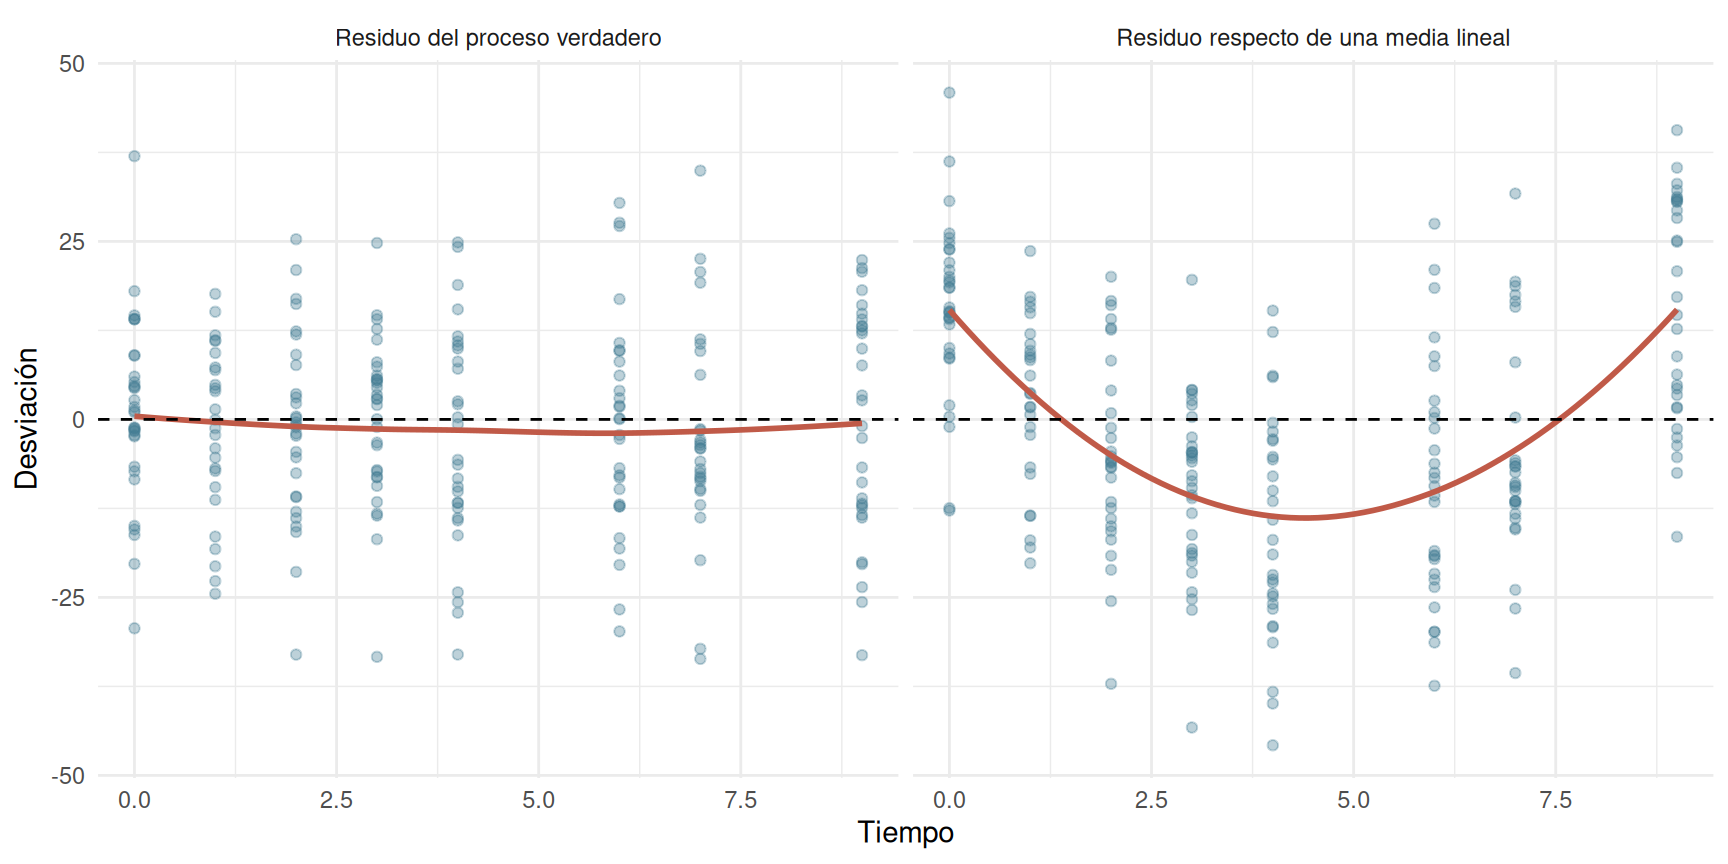
Si ignoramos el término cuadrático y usamos únicamente rectas, aparecerá estructura sistemática incluso con una representación correcta de la dependencia residual. Para ilustrar este punto, podemos comparar los residuos verdaderos, conocidos en la simulación, con lo que quedaría después de quitar una recta aproximada a la trayectoria verdadera de cada persona. No es un procedimiento de inferencia, sino una demostración de lo que puede ocurrir cuando se especifica mal la media.
residuos_demostracion_s12 <- datos_irreg_s12 |>group_by(individuo) |>group_modify(~ { recta <-lm(media_verdadera ~ tiempo, data = .x)mutate(.x, residuo_recta = respuesta -predict(recta, newdata = .x)) }) |>ungroup() |>select(individuo, tiempo, residuo_verdadero, residuo_recta) |>pivot_longer(cols =c(residuo_verdadero, residuo_recta),names_to ="tipo", values_to ="residuo" ) |>mutate(tipo =recode( tipo,residuo_verdadero ="Residuo del proceso verdadero",residuo_recta ="Residuo respecto de una media lineal" ))ggplot(residuos_demostracion_s12, aes(tiempo, residuo)) +geom_point(alpha =0.35, colour ="#447B92") +geom_smooth(se =FALSE, method ="loess", span =0.8,colour ="#C05A48") +geom_hline(yintercept =0, linetype ="dashed") +facet_wrap(~tipo) +labs(x ="Tiempo", y ="Desviación") +theme_minimal(base_size =11)
Figura 12.14: Residuos verdaderos y residuos respecto de una recta ajustada a la media verdadera de cada individuo. El patrón curvo del segundo panel proviene de la forma incorrecta de la media, no necesariamente de mayor autocorrelación residual.
Los tiempos irregulares y las medias curvilíneas pueden manejarse conjuntamente dentro de una formulación probabilística, pero aquí las presentamos por separado para distinguir los mecanismos. No ajustaremos al conjunto simulado una AR(1) en función del índice de visita y la presentaremos como una estimación de la dependencia en tiempo real. Para ese objetivo se necesita implementar la covarianza de Ecuación 12.9 u otra estructura continua adecuada.
12.13 Errores frecuentes y decisiones de modelación
12.13.1 Confundir correlación marginal con residual
Una correlación grande entre respuestas consecutivas no implica un valor grande de \(\rho\). Parte de la dependencia puede provenir de \(\boldsymbol\Sigma\), incluso si \(\mathbf R_i\) es diagonal. La descomposición de Ecuación 12.3 debe orientar la interpretación de toda estructura longitudinal.
12.13.2 Pensar que una pendiente variable es un AR(1)
Una pendiente variable induce covarianzas relacionadas con los valores absolutos de los tiempos y sus productos; AR(1) residual depende del rezago entre ocasiones. Pueden generar patrones semejantes en un seguimiento corto, pero no son equivalentes matemáticamente ni tienen la misma interpretación científica.
12.13.3 Utilizar la visita como si fuera tiempo cronológico
Si las visitas ocurren en días irregulares, modelar la asociación por índice de visita equivale a imponer una escala de dependencia diferente. El modelo puede ser coherente cuando el mecanismo está ligado a cada exposición o visita, pero es inadecuado si se interpreta como persistencia por día sin justificarlo.
12.13.4 Concluir heterocedasticidad a partir de la dispersión bruta
La desviación estándar entre individuos puede cambiar con el tiempo debido a las pendientes variables, aunque los residuos condicionales tengan una varianza constante. Debe estudiarse la dispersión después de considerar las trayectorias y su incertidumbre.
12.13.5 Interpretar un spline como una explicación causal
Una función flexible representa asociaciones temporales. No determina qué proceso físico, biológico o social las produjo. Además, una curva estimada con diez días de seguimiento no garantiza predicciones confiables para meses posteriores.
12.13.6 Corregir todas las fallas agregando términos automáticamente
Introducir simultáneamente pendientes variables, AR(1), heterocedasticidad y un suavizado flexible puede crear dificultades de identificación. Conviene ampliar un modelo de manera dirigida por comprobaciones, preservar la interpretación de las componentes y revisar la sensibilidad a las previas. Un algoritmo que converge no resuelve un modelo débilmente identificado.
12.13.7 Tomar una discrepancia residual observada como un dato sin incertidumbre
En un modelo bayesiano la trayectoria individual no es conocida exactamente. Construir un único vector de residuos utilizando estimaciones puntuales puede ocultar incertidumbre sobre \(\mu_{ij}\). Las comprobaciones del laboratorio emplean las mismas extracciones posteriores para construir residuos observados y simulados, y preservan su calendario temporal.
12.14 Síntesis de la semana
El modelo longitudinal separa variabilidad entre individuos y variabilidad dentro de individuos. La dependencia marginal de las respuestas puede originarse en interceptos y pendientes variables, en residuos temporalmente correlacionados o en ambos. Su representación general es \(\mathbf V_i=\mathbf Z_i\boldsymbol\Sigma\mathbf Z_i^\top+\mathbf R_i\).
La estructura AR(1) expresa dependencia residual estacionaria a rezagos discretos y equiespaciados. Los tiempos irregulares requieren prestar atención a la escala de la distancia temporal; una correlación exponencial continua proporciona una alternativa cuando resulta apropiada. La heterocedasticidad residual y la curvatura de la media responden a preguntas diferentes, aunque las tres características pueden producir patrones parecidos si el seguimiento es breve.
El flujo de trabajo bayesiano integra justificación de previas, comprobación predictiva previa, ajuste con NUTS, diagnóstico computacional y comprobaciones predictivas temporales. No basta con reproducir la distribución global de las respuestas: debemos examinar si el modelo reproduce la evolución de las medias, la dispersión condicional y la dependencia entre desvíos consecutivos. La elección final de una extensión exige considerar qué aspecto del proceso representa, con qué incertidumbre y para qué tarea predictiva resulta necesaria.
con \(\operatorname{Var}(u_{0i})=\tau_0^2\), \(\operatorname{Var}(u_{1i})=\tau_1^2\), \(\operatorname{Cov}(u_{0i},u_{1i})=c_{01}\) y residuos AR(1) estacionarios de varianza \(\sigma^2\) y correlación \(\rho\).
Derive \(\operatorname{Cov}(Y_{ij},Y_{ik}\mid\boldsymbol\theta)\) para dos ocasiones de una misma persona. (b) Derive \(\operatorname{Var}(Y_{ij}\mid\boldsymbol\theta)\). (c) Explique por qué una correlación marginal grande no implica necesariamente \(\rho\) grande. (d) Discuta qué problemas de identificación podrían aparecer si cada individuo aporta solo dos mediciones.
12.15.2 Ejercicio 2. Interpretación de AR(1)
Suponga que \(\rho=0.7\) y que \(\sigma=15\) corresponde a la desviación estándar estacionaria de los residuos.
Obtenga las covarianzas entre residuos separados por uno, dos y tres pasos, así como la varianza de las innovaciones \(\sigma_\eta^2\). (b) Interprete estas cantidades en sus unidades. (c) Repita el razonamiento cualitativamente para \(\rho=-0.7\). (d) Explique por qué no corresponde reemplazar una distancia de cuatro días por un solo rezago cuando el mecanismo opera por día.
12.15.3 Ejercicio 3. Heterocedasticidad y dispersión marginal
Considere \(\log\sigma(t)=\gamma_0+\gamma_1t\) con \(\gamma_1=0.08\) por mes. (a) Obtenga la razón entre las desviaciones estándar de los meses 3 y 0, y la correspondiente razón de varianzas. (b) Explique por qué una mayor dispersión de respuestas al mes 3 puede observarse incluso cuando \(\gamma_1=0\). (c) Proponga una comprobación predictiva que permita investigar cuál de los mecanismos es relevante.
12.15.4 Ejercicio 4. Curvatura y cambios de pendiente
Calcule e interprete la derivada temporal de cada uno para tiempos donde exista. (b) Compare las formas de cambio que permiten. (c) Indique en qué circunstancia el modelo B tendría una interpretación sustantiva más transparente. (d) Analice los riesgos de extrapolar cualquiera de los dos fuera de la ventana observada.
12.15.5 Ejercicio 5. Comprobación computacional y crítica de un ajuste
Usando sleepstudy y los modelos M1–M4, elabore un informe breve con: (a) un resumen de HMC/NUTS, incluyendo \(\widehat R\), ESS y divergencias; (b) un gráfico de la posterior de \(\rho\) si M2 tiene un ajuste computacional confiable; (c) una comprobación de medias por día; (d) una comprobación de autocorrelación residual que preserve el orden temporal; (e) una explicación de qué extensión, si alguna, considera necesaria para el objetivo sustantivo. Su conclusión no debe basarse únicamente en la magnitud de \(\rho\) ni en un número escalar de ajuste.
12.15.6 Ejercicio 6. Diseño irregular y extensión a espacio de estados
Considere un estudio con observaciones de una persona en los días \(0,1,5,9\). (a) Construya la matriz de correlación AR(1) de paso diario con \(\rho=0.6\) para los tiempos observados. (b) Construya la matriz basada en \(\exp(-0.4|t-s|)\). (c) Explique qué hipótesis temporal impone cada una y por qué una matriz AR(1) por visitas consecutivas sería diferente. (d) Proponga un mecanismo científico en el que un estado latente dinámico fuera más justificable que una pendiente individual fija con residuos AR(1).
Extensión opcional de programación. Modifique el experimento simulado para que las trayectorias tengan un salto de nivel en el día 5 en lugar de una curvatura cuadrática. Distinga en los gráficos la introducción de una discontinuidad de la introducción de un cambio de pendiente. Discuta cuáles comprobaciones predictivas serían informativas para distinguir estos modelos.
12.16 Lecturas recomendadas y referencias
Lecturas principales
Hox, Moerbeek y van de Schoot, capítulo 5, especialmente § 5.6 (pp. 89–94) y § 5.7 (pp. 94–102): estructuras complejas de covarianza, dependencia temporal y cuestiones estadísticas del análisis longitudinal (Hox et al. 2018).
West, Welch y Galecki, § 2.2.2 (pp. 19–21), §§ 7.8–7.10 (pp. 375–384): covarianza marginal, estructuras residuales y dificultades prácticas de especificación (West et al. 2022).
Verbeke y Molenberghs, capítulos 3–4: representación de modelos mixtos longitudinales y descripción de características temporales de la media, la varianza y la correlación (Verbeke y Molenberghs 2000).
Lecturas complementarias
Matsuura, capítulo 11, especialmente §§ 11.1–11.4 (pp. 237–264): formulación e interpretación de modelos bayesianos de espacio de estados (matsuura-2022?).
Gelman y colaboradores, Bayesian Workflow, capítulos 5, 8, 11–12 y 27: formulación y revisión progresiva de modelos, simulación predictiva y descomposición de componentes temporales (Gelman et al. 2026).
Bürkner, §§ 2–3: formulación de modelos bayesianos multinivel mediante Stan y brms(Bürkner 2017).
NotaReproducibilidad y revisión antes de usar los resultados
Estas notas no inventan resultados empíricos: las tablas posteriores y las comprobaciones predictivas se generan al ejecutar sus bloques. El texto explica qué se debe investigar, sin declarar que los datos favorecen de antemano alguno de los cinco modelos. Para renderizar se requiere R, los paquetes y CmdStan configurados; los ajustes usan backend = "cmdstanr" y file_refit = "on_change". Las simulaciones manuales de AR(1) se aplican solo al diseño completo y equiespaciado de sleepstudy. El capítulo usa references.bib y debe añadirse al índice de capítulos de _quarto.yml inmediatamente después de la semana 11.
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.
Verbeke, Geert, y Geert Molenberghs. 2000. Linear Mixed Models for Longitudinal Data. Springer.
West, Brady T., Kathleen B. Welch, y Andrzej T. Galecki. 2022. Linear Mixed Models: A Practical Guide Using Statistical Software. 3.ª ed. CRC Press. https://doi.org/10.1201/9781003181064.