resumen_conteos_s9 <- function(y) {
  c(
    media = mean(y),
    sd = sd(y),
    prop_ceros = mean(y == 0),
    q90 = unname(quantile(y, 0.90)),
    q95 = unname(quantile(y, 0.95)),
    maximo = max(y)
  )
}

resumen_ppc_s9 <- function(y_obs, yrep) {
  obs <- as_tibble_row(resumen_conteos_s9(y_obs)) |>
    pivot_longer(
      everything(),
      names_to = "estadistica",
      values_to = "observado"
    )

  rep <- as_tibble(
    t(apply(yrep, 1, resumen_conteos_s9))
  ) |>
    mutate(draw = row_number()) |>
    pivot_longer(
      -draw,
      names_to = "estadistica",
      values_to = "replicado"
    )

  list(observado = obs, replicado = rep)
}

plot_ppc_resumen_s9 <- function(objeto_ppc) {
  objeto_ppc$replicado |>
    ggplot(aes(x = replicado)) +
    geom_histogram(bins = 35) +
    geom_vline(
      data = objeto_ppc$observado,
      aes(xintercept = observado),
      linewidth = 0.8,
      linetype = 2,
      inherit.aes = FALSE
    ) +
    facet_wrap(
      ~ estadistica,
      scales = "free",
      ncol = 2
    ) +
    labs(
      x = "Estadística en réplicas posteriores",
      y = "Frecuencia"
    ) +
    theme_minimal(base_size = 11)
}9 Semana 9. Modelos de conteo, tasas y sobredispersión
SP-1653 Modelos Mixtos
9.1 Panorama de la semana
En la semana 8 cambiamos la distribución de la respuesta, pero conservamos la lógica multinivel: una respuesta Bernoulli o binomial se conectó con un predictor lineal mediante el enlace logit, y uno o más coeficientes pudieron variar entre grupos. Esta semana hacemos un cambio análogo para respuestas de conteo.
La pregunta orientadora es:
¿Cómo modelamos conteos cuando la exposición y la heterogeneidad difieren entre grupos?
Los conteos aparecen en muchas aplicaciones: número de crisis epilépticas de una persona durante un período, accidentes en un tramo de carretera, infecciones en un hospital, llamadas recibidas por una oficina, especies observadas en una parcela o eventos de falla en una unidad productiva. En todos estos casos la respuesta toma valores
\[ 0,1,2,\ldots \]
y no tiene, en principio, un límite superior conocido.
Una formulación básica utiliza la distribución Poisson:
\[ y_{ij}\mid \mu_{ij} \sim \operatorname{Poisson}(\mu_{ij}), \]
con
\[ \log(\mu_{ij}) = \log(E_{ij})+\alpha_j+\beta x_{ij}, \]
\[ \alpha_j\mid\mu_\alpha,\tau_\alpha \sim \mathcal N(\mu_\alpha,\tau_\alpha^2). \tag{9.1}\]
Aquí \(E_{ij}>0\) representa una exposición conocida: tiempo observado, población en riesgo, área muestreada u otra cantidad que determina cuántas oportunidades hubo para que ocurrieran eventos. El término \(\log(E_{ij})\) entra como un offset, es decir, con coeficiente fijado en 1. De esta manera el resto del predictor modela una tasa y no solamente un conteo bruto (Gelman y Hill 2007, sec. 6.2; McElreath 2020, sec. 11.2.3).
La distribución Poisson impone una relación fuerte entre media y varianza. Condicionalmente a los predictores y a los coeficientes grupales,
\[ E(Y_{ij}\mid\cdot)=\mu_{ij}, \qquad \operatorname{Var}(Y_{ij}\mid\cdot)=\mu_{ij}. \]
Por ello, la comprobación predictiva adquiere un papel central. Si los datos muestran más variación condicional de la que el modelo puede reproducir, debemos preguntarnos qué fuente de heterogeneidad falta en la formulación. Puede tratarse de predictores omitidos, agrupamiento no representado, variación adicional entre observaciones, colas más pesadas o un mecanismo especial para producir ceros. No todas estas posibilidades se corrigen con el mismo modelo (Hox et al. 2018, sec. 7.2; McElreath 2020, sec. 12.1).
La binomial negativa será la principal expansión de esta semana. En la parametrización que utilizaremos,
\[ y_{ij}\mid \mu_{ij},\phi \sim \operatorname{NegBin}(\mu_{ij},\phi), \]
con
\[ E(Y_{ij}\mid\cdot)=\mu_{ij}, \]
\[ \operatorname{Var}(Y_{ij}\mid\cdot) = \mu_{ij}+\frac{\mu_{ij}^2}{\phi}. \tag{9.2}\]
Valores grandes de \(\phi\) hacen que la distribución se aproxime a Poisson; valores pequeños permiten mayor dispersión. McElreath presenta esta familia como una mezcla gamma–Poisson y BDA utiliza la misma interpretación para mostrar cómo una distribución de tasas latentes produce varianza adicional (McElreath 2020, sec. 12.1.2; Gelman et al. 2013, sec. 17.2).
La secuencia conceptual de la semana será:
\[ \boxed{ \text{conteo} \longrightarrow \text{tasa y exposición} \longrightarrow \text{Poisson multinivel} \longrightarrow \text{comprobación predictiva} \longrightarrow \text{sobredispersión} \longrightarrow \text{binomial negativa} } \]
No trataremos esta secuencia como un algoritmo automático de selección de familias. Un Poisson puede producir una distribución marginal de conteos muy dispersa cuando existen interceptos variables. Por ello, observar que la varianza muestral bruta excede la media muestral no basta para concluir que la familia Poisson es inadecuada. La afirmación media–varianza del Poisson es condicional al modelo completo.
NotaConvención de fuentes y elaboración
La estructura conceptual se apoya principalmente en Gelman y Hill, McElreath, Hox et al., Bayesian Data Analysis, Bayesian Workflow y Bürkner. Las simulaciones y figuras del laboratorio son elaboraciones pedagógicas originales para el curso. La aplicación con crisis epilépticas retoma una estructura de datos discutida por Hox et al.; el análisis presentado aquí se reformula como un flujo bayesiano con brms y cmdstanr.
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
- distinguir un conteo no acotado de un conteo binomial con número conocido de ensayos;
- identificar la unidad de conteo, la unidad de exposición y las fuentes de agrupamiento relevantes;
- explicar la distribución Poisson y la restricción condicional \(E(Y)=\operatorname{Var}(Y)\);
- explicar por qué el enlace logarítmico es natural para modelar medias y tasas positivas;
- formular un modelo Poisson con predictores y un offset de exposición;
- interpretar \(\exp(\beta)\) como una razón de tasas bajo una especificación log-lineal;
- distinguir conteo esperado, tasa esperada y exposición;
- formular un modelo Poisson multinivel con interceptos variables;
- interpretar el pooling parcial de log-tasas y tasas grupales;
- explicar por qué la heterogeneidad entre grupos induce sobredispersión marginal aun cuando la distribución condicional sea Poisson;
- distinguir sobredispersión condicional de heterogeneidad grupal;
- explicar la binomial negativa como una expansión del Poisson que permite variación adicional entre observaciones;
- interpretar el parámetro de dispersión de la binomial negativa en la parametrización usada por
brms; - distinguir conceptualmente Poisson con interceptos variables, binomial negativa y binomial negativa multinivel;
- especificar previas débilmente informativas en la escala log y evaluar sus consecuencias en la escala de conteos y tasas;
- detectar mediante comprobaciones predictivas problemas en la varianza, la frecuencia de ceros y las colas;
- explicar por qué muchos ceros no implican automáticamente un modelo cero-inflado;
- ajustar modelos Poisson y binomial negativa multinivel en
brmsusandocmdstanrcomo backend; - revisar \(\widehat R\), ESS, divergencias y profundidad del árbol antes de interpretar un ajuste;
- realizar predicciones para grupos existentes y nuevos;
- interpretar resultados principalmente mediante tasas, razones de tasas y distribuciones predictivas;
- justificar, para el proyecto del curso, la exposición utilizada y la elección entre una formulación de conteos y una formulación de tasas.
9.2 Problema motivador: contar eventos dentro de grupos
Supongamos que registramos el número de eventos \(Y_{ij}\) para la observación \(i\) perteneciente al grupo \(j\). Algunos ejemplos son:
- crisis epilépticas de la persona \(j\) durante la visita \(i\);
- accidentes durante cierto período en la carretera \(j\);
- infecciones observadas durante cierto número de días-paciente en el hospital \(j\);
- defectos observados en una cantidad determinada de producto de la planta \(j\);
- especies detectadas en una superficie muestreada dentro de la región \(j\).
Tres preguntas deben formularse antes de elegir la distribución:
- ¿Qué estamos contando?
- ¿Durante cuánto tiempo, área, población u otra exposición se contó?
- ¿Qué observaciones comparten una fuente de heterogeneidad?
Estas preguntas separan tres componentes que pueden confundirse fácilmente:
\[ \boxed{ \text{conteo observado} = \text{exposición} \times \text{tasa} + \text{variación probabilística} } \]
La igualdad es conceptual, no algebraica para cada observación individual. El modelo probabilístico expresará que el conteo esperado depende de la exposición y de la tasa.
Si dos hospitales presentan 20 infecciones cada uno, pero el primero acumuló 500 días-paciente y el segundo 5000, los conteos brutos son iguales mientras las tasas son muy distintas. Un modelo que ignore esa diferencia de exposición respondería una pregunta diferente de la que probablemente interesa.
Gelman y Hill introducen el offset precisamente para separar esta idea: si \(u_i\) es la exposición y \(\theta_i\) la tasa por unidad de exposición,
\[ Y_i\sim\operatorname{Poisson}(u_i\theta_i), \]
por lo que
\[ \log E(Y_i) = \log u_i+\log\theta_i. \]
Así, \(\log u_i\) entra con coeficiente conocido igual a uno (Gelman y Hill 2007, 111-12).
9.3 ¿Conteo Poisson o conteo binomial?
En la semana 8 utilizamos una binomial cuando \(Y_i\) representaba éxitos de un total conocido \(n_i\):
\[ Y_i\sim\operatorname{Binomial}(n_i,p_i). \]
El límite superior \(n_i\) forma parte del mecanismo de observación. Si se aplicaron 20 pruebas y contamos 7 positivas, existe un máximo conocido de 20 éxitos.
En un modelo Poisson,
\[ Y_i\sim\operatorname{Poisson}(\mu_i), \]
el conteo no tiene un máximo finito especificado por el diseño. Podemos contar 0, 1, 2, 3, … eventos. McElreath conecta ambas familias recordando que una Poisson surge como aproximación de una binomial con muchos ensayos y probabilidad pequeña, pero en la práctica la distinción importante es si existe un número de oportunidades claramente definido que deba formar parte del modelo (McElreath 2020, 345-46).
ImportanteLa presencia de números enteros no determina la familia
Un conteo puede ser binomial, Poisson, binomial negativo, multinomial o surgir de otro mecanismo. La elección depende de cómo se produjeron los datos, no solamente de que la columna contenga enteros no negativos.
9.4 La distribución Poisson
Para \(Y\sim\operatorname{Poisson}(\mu)\),
\[ \Pr(Y=y\mid\mu) = \frac{\mu^y e^{-\mu}}{y!}, \qquad y=0,1,2,\ldots, \]
con
\[ E(Y\mid\mu)=\mu, \]
\[ \operatorname{Var}(Y\mid\mu)=\mu. \tag{9.3}\]
La misma cantidad \(\mu\) controla la posición y la dispersión de la distribución. Hox et al. subrayan además que una formulación Poisson clásica se asocia con eventos que ocurren a una tasa aproximadamente constante dentro de la unidad de exposición y con independencia en intervalos disjuntos; los modelos multinivel permiten representar ciertas fuentes de dependencia, pero no vuelven irrelevante la descripción del proceso observado (Hox et al. 2018, 139-41).
9.4.1 La igualdad media–varianza es condicional
La expresión
\[ \operatorname{Var}(Y_i\mid\mu_i)=\mu_i \]
no afirma que
\[ \operatorname{Var}(Y_1,\ldots,Y_n) = \overline Y \]
en una muestra heterogénea.
Si distintas observaciones tienen medias distintas, la variación total combina:
- variación Poisson alrededor de cada media condicional;
- variación entre las medias condicionales.
Por la ley de varianza total,
\[ \operatorname{Var}(Y) = E\{\operatorname{Var}(Y\mid\mu)\} + \operatorname{Var}\{E(Y\mid\mu)\}. \]
Para Poisson,
\[ \operatorname{Var}(Y) = E(\mu)+\operatorname{Var}(\mu). \tag{9.4}\]
Por tanto, una colección de observaciones con tasas muy distintas puede presentar una varianza marginal mucho mayor que su media, aunque cada observación satisfaga una distribución Poisson condicionalmente.
Esta distinción será esencial cuando incorporemos interceptos variables.
9.5 Enlace logarítmico e interpretación
La media Poisson debe ser positiva. El enlace estándar es
\[ \log(\mu_i)=\eta_i, \]
por lo que
\[ \mu_i=\exp(\eta_i). \]
Si
\[ \eta_i=\alpha+\beta x_i, \]
entonces
\[ \mu_i = \exp(\alpha)\exp(\beta x_i). \]
La estructura es lineal en la escala logarítmica y multiplicativa en la escala del conteo.
9.5.1 Una unidad de cambio en un predictor
Para dos observaciones que difieren en una unidad de \(x\) y mantienen iguales los demás predictores,
\[ \frac{\mu(x+1)}{\mu(x)} = \frac{\exp\{\alpha+\beta(x+1)\}} {\exp(\alpha+\beta x)} = \exp(\beta). \tag{9.5}\]
Por tanto, \(\exp(\beta)\) es una razón multiplicativa de medias. Cuando el modelo contiene un offset que separa exposición y tasa, la interpretación natural es una razón de tasas.
Por ejemplo, si
\[ \beta=\log(0.75), \]
entonces
\[ \exp(\beta)=0.75, \]
y la tasa esperada es 25% menor para una unidad adicional de \(x\), manteniendo constantes los demás componentes del predictor.
La interpretación de Gelman y Hill para regresión Poisson se realiza justamente de esta forma: los coeficientes exponentiados representan cambios multiplicativos en la tasa (Gelman y Hill 2007, 111-13).
AdvertenciaRazón de tasas no es diferencia de conteos
Si \(\exp(\beta)=1.5\), no significa que aparezcan 0.5 eventos adicionales. Significa que la media o tasa se multiplica por 1.5. La diferencia absoluta de conteos depende de la tasa de referencia y de la exposición.
9.6 Tasas, exposición y offsets
Supongamos que \(r_i\) es una tasa esperada por unidad de exposición y \(E_i\) la exposición observada. Entonces
\[ \mu_i=E_i r_i. \]
Si modelamos
\[ \log(r_i)=\alpha+\beta x_i, \]
obtenemos
\[ \log(\mu_i) = \log(E_i)+\alpha+\beta x_i. \tag{9.6}\]
El término \(\log(E_i)\) es un predictor cuyo coeficiente está fijado en 1.
9.6.1 Ejemplos de exposición
Dependiendo de la aplicación, \(E_i\) puede representar:
- días de seguimiento;
- persona-años en riesgo;
- kilómetros recorridos;
- área de muestreo;
- número de máquinas-día;
- población susceptible;
- esfuerzo de captura o de observación.
La exposición debe ser estrictamente positiva si se utiliza \(\log(E_i)\).
9.6.2 ¿Por qué no incluir la exposición como un predictor ordinario?
Si ajustamos
\[ \log(\mu_i) = \alpha+\gamma\log(E_i)+\beta x_i, \]
estamos estimando \(\gamma\) en lugar de fijarlo en uno. Esta especificación afirma que
\[ \mu_i\propto E_i^\gamma. \]
Puede ser razonable si existe una hipótesis sustantiva de no proporcionalidad o si la variable que llamamos exposición es un proxy imperfecto. Gelman y Hill muestran explícitamente que tratar \(\log(E)\) como offset equivale a fijar su coeficiente en 1, mientras estimarlo permite una relación distinta (Gelman y Hill 2007, 112, 330).
La decisión debe responder al mecanismo, no a cuál opción produce mejor ajuste numérico.
ImportanteEl offset es una afirmación científica
Especificar offset(log(E)) afirma que, manteniendo fija la tasa, duplicar la exposición duplica el conteo esperado. Antes de usar un offset conviene poder defender esa proporcionalidad.
9.7 Modelo Poisson multinivel de interceptos variables
Considere observaciones \(i=1,\ldots,n_j\) dentro de grupos \(j=1,\ldots,J\):
\[ Y_{ij}\mid\mu_{ij} \sim \operatorname{Poisson}(\mu_{ij}), \]
\[ \log(\mu_{ij}) = \log(E_{ij})+\alpha_j+\beta x_{ij}, \]
\[ \alpha_j = \mu_\alpha+u_j, \]
\[ u_j\mid\tau_\alpha \sim \mathcal N(0,\tau_\alpha^2). \tag{9.7}\]
El parámetro \(\alpha_j\) es el logaritmo de la tasa basal del grupo \(j\) cuando \(x_{ij}=0\). Por tanto,
\[ \exp(\alpha_j) \]
es la tasa basal esperada por unidad de exposición para ese grupo.
El parámetro \(\tau_\alpha\) mide heterogeneidad entre grupos en la escala log. La razón de tasas entre un grupo con efecto \(u_j\) y un grupo situado en el centro de la distribución es
\[ \exp(u_j). \]
La formulación sigue la misma lógica que los interceptos variables gaussianos y logísticos: los grupos con poca información se regularizan mediante una distribución poblacional compartida (Gelman y Hill 2007, sec. 15.1; Gelman et al. 2013, sec. 16.4).
9.7.1 Pooling parcial de tasas
El pooling ocurre sobre \(\alpha_j\), es decir, en la escala log. Sin embargo, las cantidades de interpretación son tasas:
\[ r_j=\exp(\alpha_j). \]
Como la exponencial es no lineal, la transformación de un resumen posterior y el resumen de la cantidad transformada no coinciden necesariamente. Por ejemplo,
\[ \exp\{E(\alpha_j\mid y)\} \neq E\{\exp(\alpha_j)\mid y\} \]
en general.
Por ello utilizaremos simulaciones posteriores para resumir tasas y conteos directamente en la escala de respuesta.
9.8 Heterogeneidad grupal y sobredispersión marginal
El modelo de Ecuación 9.7 es condicionalmente Poisson. Aun así, si integramos sobre la distribución de \(u_j\), la distribución marginal de \(Y_{ij}\) deja de tener varianza igual a la media.
Para simplificar, defina
\[ \eta_{ij} = \log(E_{ij})+\mu_\alpha+\beta x_{ij}. \]
Entonces
\[ \mu_{ij}(u_j) = \exp(\eta_{ij}+u_j), \]
con
\[ u_j\sim\mathcal N(0,\tau_\alpha^2). \]
Como una variable lognormal satisface
\[ E\{\exp(u_j)\} = \exp(\tau_\alpha^2/2), \]
la media marginal es
\[ m_{ij} = E(Y_{ij}\mid x_{ij},E_{ij}) = \exp\left(\eta_{ij}+\frac{\tau_\alpha^2}{2}\right). \tag{9.8}\]
Aplicando la ley de varianza total,
\[ \operatorname{Var}(Y_{ij}\mid x_{ij},E_{ij}) = m_{ij} + m_{ij}^2 \left\{ \exp(\tau_\alpha^2)-1 \right\}. \tag{9.9}\]
Esta varianza es mayor que \(m_{ij}\) cuando \(\tau_\alpha>0\).
ImportanteUna fuente de sobredispersión puede ser el agrupamiento
Si ignoramos grupos que tienen tasas distintas, un modelo Poisson de un solo nivel puede parecer fuertemente sobredisperso. Incorporar la estructura multinivel puede explicar parte de esa variación. Hox et al. señalan explícitamente que omitir un nivel completo es una posible fuente de sobredispersión (Hox et al. 2018, 141).
Por eso no debemos decidir entre Poisson y binomial negativa mirando solamente la media y la varianza marginales de la respuesta.
9.9 ¿Qué entendemos por sobredispersión?
En estas notas llamaremos sobredispersión condicional respecto de Poisson a una situación en la que, después de incorporar la estructura de predictores y agrupamiento que consideramos relevante, los datos siguen mostrando más variación de la que las réplicas predictivas del modelo Poisson pueden reproducir.
Esta definición enfatiza la comprobación del modelo completo.
Entre las causas posibles se encuentran:
- predictores importantes omitidos;
- heterogeneidad entre grupos no representada;
- variación no observada específica de cada observación;
- dependencia temporal o espacial no modelada;
- colas más pesadas que Poisson;
- mezcla de procesos distintos;
- errores en la definición de la exposición;
- exceso de ceros generado por un mecanismo adicional.
McElreath interpreta la sobredispersión como una señal de heterogeneidad no observada en probabilidades o tasas. Hox et al. también enfatizan que puede aparecer por valores extremos o niveles omitidos (McElreath 2020, 369-75; Hox et al. 2018, 141-44).
9.9.1 ¿Cómo la detectaremos?
No utilizaremos una única estadística diagnóstica. Compararemos los datos observados con réplicas de la distribución predictiva posterior mediante características como:
- media;
- desviación estándar y varianza;
- proporción de ceros;
- cuantiles altos;
- máximo;
- distribución completa de frecuencias;
- resúmenes por grupo;
- relación entre exposición y conteo.
La pregunta no es solamente “¿la varianza es demasiado grande?”, sino “¿qué aspecto importante de los conteos no reproduce el modelo?”.
9.10 Binomial negativa como mezcla gamma–Poisson
Una forma de introducir variación adicional es suponer que cada observación posee una tasa latente que fluctúa alrededor de una tasa promedio.
Conceptualmente,
\[ Y_i\mid\lambda_i \sim \operatorname{Poisson}(\lambda_i), \]
mientras
\[ \lambda_i \]
varía de una observación a otra según una distribución gamma. Al integrar esas tasas latentes obtenemos una distribución binomial negativa. Esta construcción explica el nombre gamma–Poisson usado por McElreath (McElreath 2020, sec. 12.1.2).
En la parametrización media–forma que utilizaremos,
\[ Y_i\sim\operatorname{NegBin}(\mu_i,\phi), \]
con
\[ E(Y_i)=\mu_i, \]
\[ \operatorname{Var}(Y_i) = \mu_i+\frac{\mu_i^2}{\phi}. \]
La cantidad \(\phi>0\) controla la dispersión:
- \(\phi\) pequeña \(\Rightarrow\) mayor variación adicional;
- \(\phi\) grande \(\Rightarrow\) menor variación adicional;
- \(\phi\to\infty\) \(\Rightarrow\) aproximación a Poisson.
BDA presenta una parametrización gamma diferente para la mezcla; por eso es importante no trasladar símbolos entre textos o programas sin verificar qué media y varianza implican (Gelman et al. 2013, sec. 17.2).
9.10.1 Modelo binomial negativo multinivel
Podemos combinar las dos fuentes de heterogeneidad:
\[ Y_{ij}\mid \mu_{ij},\phi \sim \operatorname{NegBin}(\mu_{ij},\phi), \]
\[ \log(\mu_{ij}) = \log(E_{ij})+\mu_\alpha+u_j+\beta x_{ij}, \]
\[ u_j\sim\mathcal N(0,\tau_\alpha^2). \tag{9.10}\]
Aquí \(\tau_\alpha\) y \(\phi\) no representan la misma cosa:
- \(\tau_\alpha\) describe heterogeneidad compartida dentro del grupo;
- \(\phi\) permite variación adicional entre observaciones, condicional a grupo y predictores.
El modelo puede necesitar ambos componentes.
9.10.2 Cuatro modelos que no deben confundirse
| Modelo | Heterogeneidad entre grupos | Sobredispersión adicional a nivel de observación |
|---|---|---|
| Poisson de un nivel | No | No |
| Poisson con interceptos variables | Sí | No, condicional al efecto grupal |
| Binomial negativa de un nivel | No explícitamente | Sí |
| Binomial negativa con interceptos variables | Sí | Sí |
Esta tabla resume una idea central: cambiar la familia de Poisson a binomial negativa no sustituye automáticamente una estructura multinivel. Del mismo modo, añadir interceptos variables no garantiza que toda la variación condicional quede explicada.
9.11 Predicción para grupos existentes y nuevos
Considere
\[ \log(r_{ij}) = \mu_\alpha+u_j+\beta x_{ij}. \]
Para un grupo existente, la predicción utiliza la posterior de su \(u_j\).
Para un grupo nuevo,
\[ u_{\text{nuevo}}\mid\tau_\alpha \sim \mathcal N(0,\tau_\alpha^2), \]
y la predicción debe incorporar la variación entre grupos. La incertidumbre predictiva será mayor que cuando se predice una nueva observación dentro de un grupo ya observado.
También podemos calcular una tasa con \(u=0\),
\[ r^{u=0}(x)=\exp(\mu_\alpha+\beta x), \]
pero esta cantidad representa un grupo situado exactamente en el centro de la distribución de efectos en la escala log. No es la media marginal de tasas sobre todos los grupos, ya que
\[ E_u\{\exp(\mu_\alpha+u+\beta x)\} = \exp\left(\mu_\alpha+\beta x+\frac{\tau_\alpha^2}{2}\right). \]
La diferencia es una consecuencia directa de la transformación exponencial.
9.12 Previas en modelos de conteo
La semana 6 estableció que las previas deben evaluarse en la escala de cantidades observables. El enlace log hace esta recomendación especialmente importante.
9.12.1 Previa para el intercepto
Si
\[ \alpha\sim\mathcal N(0,5^2), \]
entonces
\[ \exp(\alpha) \]
tiene una distribución lognormal extremadamente extendida. Valores que parecen moderados en la escala lineal pueden implicar tasas enormes en la escala de respuesta.
McElreath muestra este problema en regresión Poisson: una previa normal muy amplia sobre el intercepto genera tasas previas implausibles y recomienda inspeccionar las consecuencias mediante simulación (McElreath 2020, 347-50).
Una estrategia más defendible consiste en pensar primero en una tasa basal plausible \(r_0\) y centrar la previa alrededor de
\[ \log(r_0). \]
9.12.2 Previa para coeficientes
Si
\[ \beta\sim\mathcal N(0,0.5^2), \]
entonces la razón de tasas por unidad de \(x\) es
\[ \exp(\beta). \]
Por ello, conviene evaluar la previa sobre \(\exp(\beta)\) y considerar la escala del predictor. Una desviación estándar de 0.5 puede ser moderada para un predictor estandarizado y excesivamente restrictiva o amplia para otra unidad de medición.
9.12.3 Previa para heterogeneidad grupal
Para
\[ \tau_\alpha>0, \]
una previa como
\[ \tau_\alpha\sim\operatorname{Exponential}(2) \]
coloca mayor masa en heterogeneidad pequeña o moderada, pero permite valores sustanciales. Su interpretación debe hacerse mediante razones de tasas entre grupos, por ejemplo
\[ \exp(\pm\tau_\alpha). \]
No existe una previa universal para \(\tau_\alpha\). Su escala debe relacionarse con cuánta heterogeneidad entre tasas es plausible antes de observar los datos.
9.12.4 Previa para la dispersión binomial negativa
En la parametrización de Ecuación 9.2, \(\phi\) es positiva y una \(\phi\) muy pequeña puede producir colas extremadamente amplias. En el laboratorio utilizaremos una previa explícita sobre shape y examinaremos su consecuencia mediante simulación previa.
La elección no debe hacerse a partir de una lista de defaults. El objetivo es generar conteos plausibles antes de condicionar en los datos.
9.13 Comprobación predictiva previa para conteos
Una comprobación previa útil debe mirar más que el promedio. Para cada réplica \(y^{\mathrm{rep}}\) podemos examinar:
\[ T_1(y)=\overline y, \]
\[ T_2(y)=\operatorname{sd}(y), \]
\[ T_3(y)=\frac{1}{n}\sum_i I(y_i=0), \]
\[ T_4(y)=Q_{0.95}(y), \]
\[ T_5(y)=\max_i y_i. \]
Estas cantidades permiten detectar previas que generan conteos casi siempre cero, cantidades astronómicas o colas incompatibles con el contexto.
En un modelo multinivel también es útil inspeccionar la distribución previa de tasas grupales. Una previa sobre \(\tau_\alpha\) puede parecer inocua en la escala log y, sin embargo, implicar diferencias de órdenes de magnitud entre grupos.
9.14 Flujo de trabajo para un GLMM de conteo
Para esta semana utilizaremos la secuencia:
- identificar el evento contado;
- identificar la unidad de observación y el agrupamiento;
- definir la exposición y justificar si su relación con el conteo debe ser proporcional;
- elegir una distribución inicial coherente con el mecanismo;
- escribir el predictor lineal y el offset;
- centrar o escalar predictores cuando facilite interpretación y especificación de previas;
- especificar previas en la escala log y para componentes de heterogeneidad;
- realizar comprobación predictiva previa;
- ajustar con HMC/NUTS;
- revisar diagnósticos computacionales;
- realizar comprobaciones predictivas posteriores globales y por grupo;
- si el Poisson falla, identificar qué característica falla antes de expandir el modelo;
- considerar binomial negativa u otras expansiones cuando tengan interpretación defendible;
- interpretar tasas, razones de tasas y distribuciones predictivas;
- distinguir predicción para grupos existentes y nuevos.
El flujo es deliberadamente distinto de “Poisson → prueba de sobredispersión → binomial negativa”. La expansión debe estar motivada por el mecanismo y por las discrepancias predictivas.
9.15 Laboratorio reproducible en R
El laboratorio tiene cuatro propósitos:
- visualizar las consecuencias de las previas bajo un enlace log;
- mostrar por simulación por qué la exposición debe incorporarse cuando los períodos de observación difieren;
- comparar Poisson y binomial negativa cuando existe sobredispersión condicional;
- analizar una aplicación con conteos repetidos por persona.
Todos los ajustes bayesianos se realizarán con brms y backend = "cmdstanr".
9.15.1 Funciones auxiliares para comprobación predictiva
Utilizaremos los mismos resúmenes observados y replicados en varios ajustes.
La línea vertical en cada panel representará el valor observado. El objetivo no es que el valor observado coincida exactamente con el centro de cada distribución, sino detectar discrepancias sistemáticas o sustantivamente importantes.
9.16 Experimento 1: previas bajo un enlace log
Primero comparemos dos previas para un intercepto Poisson:
\[ \alpha\sim\mathcal N(0,5^2) \]
frente a
\[ \alpha\sim\mathcal N(\log 2,0.7^2). \]
La cantidad interpretable es
\[ r=\exp(\alpha), \]
la tasa basal por unidad de exposición.
set.seed(1653091)

prior_intercepto_s9 <- bind_rows(
  tibble(
    especificacion = "Normal(0, 5)",
    alpha = rnorm(10000, 0, 5)
  ),
  tibble(
    especificacion = "Normal(log(2), 0.7)",
    alpha = rnorm(10000, log(2), 0.7)
  )
) |>
  mutate(
    tasa = exp(alpha)
  )

prior_intercepto_s9 |>
  group_by(especificacion) |>
  summarise(
    mediana_tasa = median(tasa),
    q025 = quantile(tasa, 0.025),
    q975 = quantile(tasa, 0.975),
    .groups = "drop"
  )
# A tibble: 2 × 4
especificacion mediana_tasa q025 q975
<chr> <dbl> <dbl> <dbl>
1 Normal(0, 5) 0.968 0.0000592 13985.
2 Normal(log(2), 0.7) 2.01 0.507 8.03prior_intercepto_s9 |>
filter(tasa <= 30) |>
ggplot(aes(x = tasa)) +
geom_histogram(bins = 50) +
facet_wrap(~ especificacion, ncol = 1) +
labs(
x = "Tasa basal previa",
y = "Frecuencia dentro de la región mostrada"
) +
theme_minimal(base_size = 12)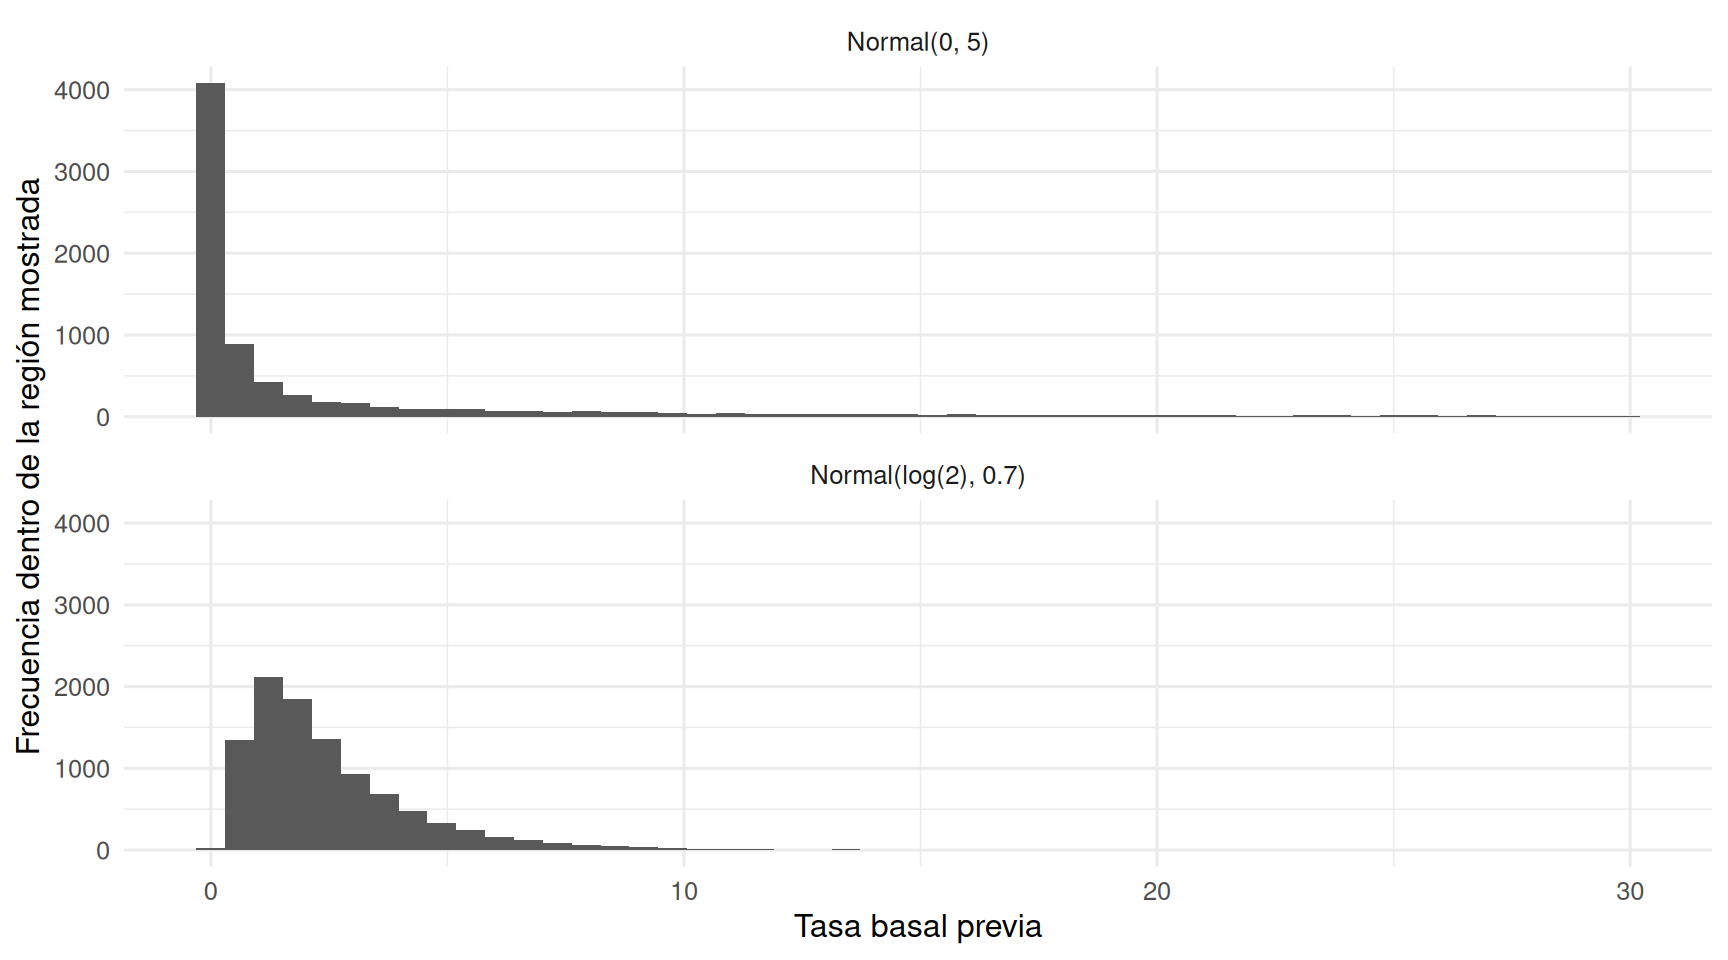
La primera especificación coloca parte considerable de su masa fuera del rango mostrado. El problema no es que una normal con desviación 5 sea “matemáticamente incorrecta”; el problema es que, después de aplicar la exponencial, expresa expectativas extraordinariamente amplias sobre la tasa.
9.16.1 Previa para una razón de tasas
Si \(x\) está estandarizado y usamos
\[ \beta\sim\mathcal N(0,0.5^2), \]
la cantidad \(\exp(\beta)\) tiene la siguiente distribución:
set.seed(1653092)

prior_rr_s9 <- tibble(
  beta = rnorm(10000, 0, 0.5),
  razon_tasas = exp(beta)
)

quantile(
  prior_rr_s9$razon_tasas,
  probs = c(0.025, 0.5, 0.975)
)
2.5% 50% 97.5%
0.3707255 1.0003137 2.6705781 Esta inspección es más útil que describir la previa solamente como “Normal(0, 0.5)”: nos dice qué cambios multiplicativos consideramos plausibles antes de observar los datos.
9.17 Experimento 2: tasas y exposición por simulación
Simularemos 25 grupos. Cada observación tendrá una exposición entre 0.5 y 3 unidades. El proceso verdadero será
\[ Y_{ij}\sim\operatorname{Poisson}(\mu_{ij}), \]
\[ \log(\mu_{ij}) = \log(E_{ij}) + \log(1.8) + 0.45x_{ij} + u_j, \]
\[ u_j\sim\mathcal N(0,0.5^2). \tag{9.11}\]
Así, 1.8 es la tasa basal por unidad de exposición para un grupo con \(u_j=0\) y \(x=0\).
set.seed(1653093)

J_s9 <- 25L

n_por_grupo_s9 <- sample(
  9:18,
  size = J_s9,
  replace = TRUE
)

u_grupo_s9 <- tibble(
  grupo = factor(seq_len(J_s9)),
  u = rnorm(J_s9, 0, 0.5)
)

base_sim_s9 <- tibble(
  grupo = factor(
    rep(seq_len(J_s9), times = n_por_grupo_s9),
    levels = seq_len(J_s9)
  ),
  x = rnorm(sum(n_por_grupo_s9)),
  exposicion = runif(sum(n_por_grupo_s9), 0.5, 3)
) |>
  left_join(u_grupo_s9, by = "grupo") |>
  mutate(
    log_tasa = log(1.8) + 0.45 * x + u,
    tasa = exp(log_tasa),
    mu = exposicion * tasa,
    y_poisson = rpois(n(), lambda = mu),
    y_nb = rnbinom(n(), mu = mu, size = 2)
  )

base_sim_s9 |>
  summarise(
    n = n(),
    grupos = n_distinct(grupo),
    exposicion_min = min(exposicion),
    exposicion_max = max(exposicion),
    media_poisson = mean(y_poisson),
    var_poisson = var(y_poisson),
    media_nb = mean(y_nb),
    var_nb = var(y_nb)
  )
# A tibble: 1 × 8
n grupos exposicion_min exposicion_max media_poisson var_poisson media_nb
<int> <int> <dbl> <dbl> <dbl> <dbl> <dbl>
1 332 25 0.507 2.99 4.03 16.3 4.28
# ℹ 1 more variable: var_nb <dbl>La varianza marginal del conteo Poisson puede exceder la media porque mezclamos exposiciones, valores de \(x\) y grupos con diferentes tasas. Esto no constituye evidencia de mala especificación: conocemos el mecanismo y sabemos que el modelo condicional es Poisson.
9.17.1 Visualizar conteos y tasas
base_sim_s9 |>
  ggplot(
    aes(
      x = exposicion,
      y = y_poisson
    )
  ) +
  geom_point(alpha = 0.55) +
  labs(
    x = "Exposición",
    y = "Conteo observado"
  ) +
  theme_minimal(base_size = 12)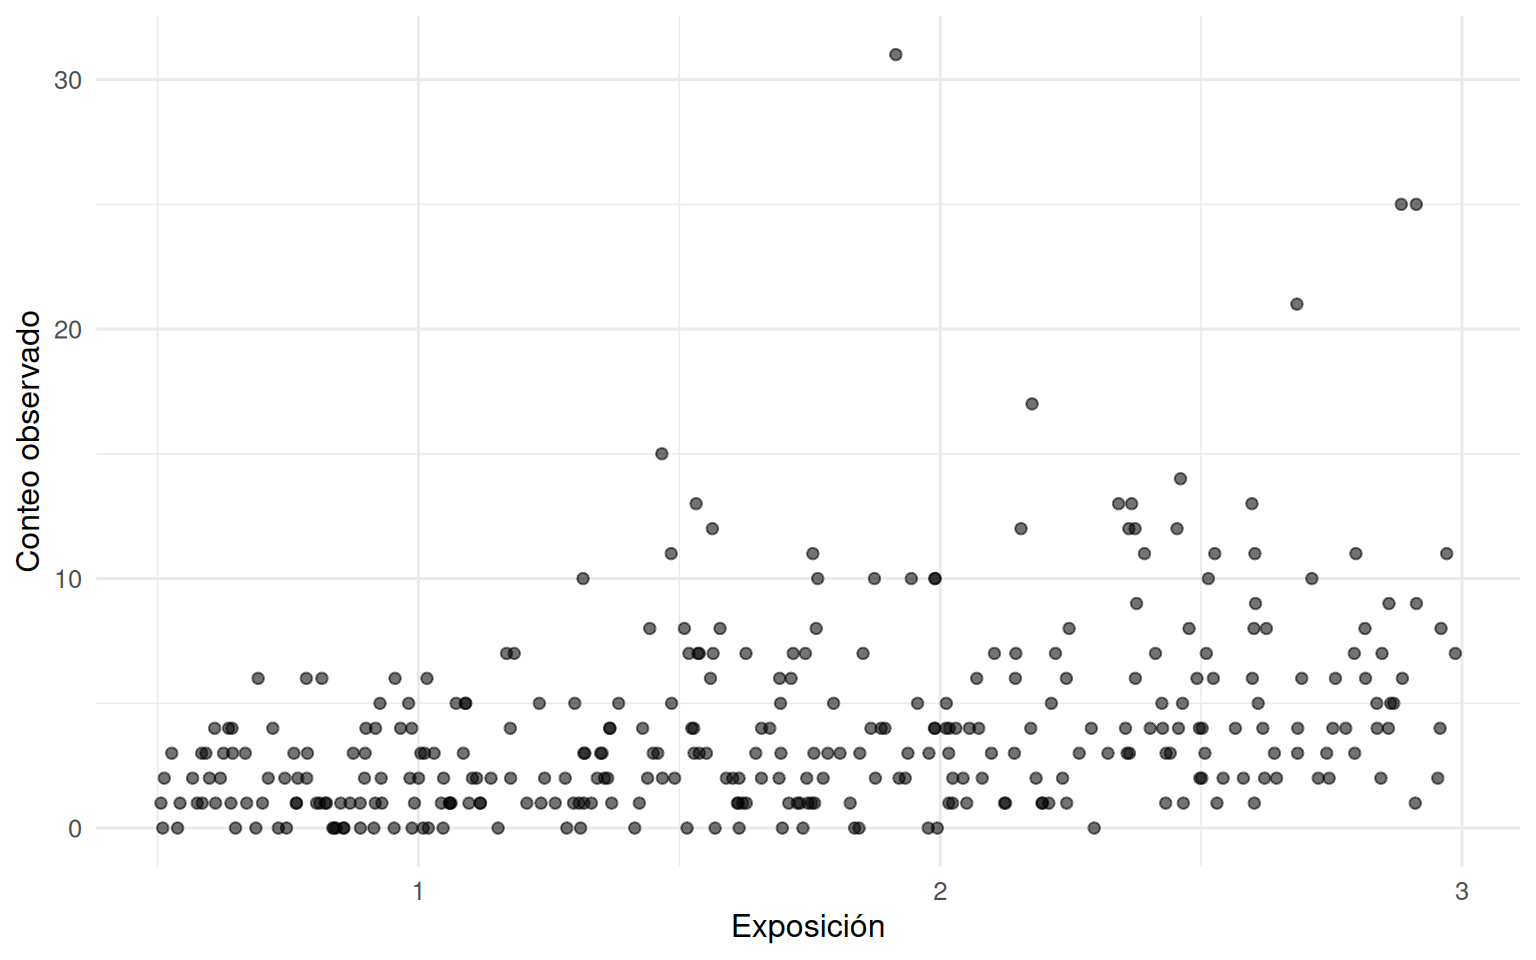
Dos observaciones con la misma tasa no tienen el mismo conteo esperado si sus exposiciones difieren. Esta es la razón para incorporar el offset.
9.17.2 Modelo correctamente especificado
Prepararemos una versión con la respuesta Poisson.
datos_pois_s9 <- base_sim_s9 |>
  transmute(
    grupo,
    x,
    exposicion,
    y = y_poisson
  )

formula_pois_offset_s9 <- bf(
  y ~ 1 + x + offset(log(exposicion)) + (1 | grupo)
)

priors_pois_s9 <- c(
  prior(normal(log(2), 0.7), class = "Intercept"),
  prior(normal(0, 0.5), class = "b"),
  prior(exponential(2), class = "sd")
)
fit_pois_correcto_s9 <- brm(
formula = formula_pois_offset_s9,
data = datos_pois_s9,
family = poisson(link = "log"),
prior = priors_pois_s9,
backend = "cmdstanr",
seed = 1653094,
chains = 4,
cores = getOption("mc.cores", 4),
iter = 1600,
warmup = 800,
control = list(
adapt_delta = 0.95,
max_treedepth = 12
),
refresh = 0,
file = file.path(
"_fits",
"s9_poisson_offset_correcto_cmdstanr"
),
file_refit = "on_change"
)Antes de mirar coeficientes, revisamos diagnósticos básicos.
posterior::summarise_draws(
  as_draws_df(fit_pois_correcto_s9),
  "mean", "sd", "rhat", "ess_bulk", "ess_tail"
) |>
  filter(
    str_detect(variable, "^(b_|sd_)")
  )
# A tibble: 3 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept 0.665 0.0946 1.00 458. 664.
2 b_x 0.454 0.0298 1.00 3072. 2466.
3 sd_grupo__Intercept 0.446 0.0759 1.01 528. 1015.nuts_pois_correcto_s9 <- brms::nuts_params(
fit_pois_correcto_s9
)
nuts_pois_correcto_s9 |>
summarise(
divergencias = sum(
Parameter == "divergent__" & Value == 1
),
profundidad_maxima = max(
Value[Parameter == "treedepth__"]
)
) divergencias profundidad_maxima
1 0 6La ausencia de problemas computacionales no prueba que la familia sea correcta. Ahora verificamos características de los datos.
set.seed(1653095)

yrep_pois_correcto_s9 <- posterior_predict(
  fit_pois_correcto_s9,
  ndraws = 500
)

ppc_pois_correcto_s9 <- resumen_ppc_s9(
  y_obs = datos_pois_s9$y,
  yrep = yrep_pois_correcto_s9
)

plot_ppc_resumen_s9(ppc_pois_correcto_s9)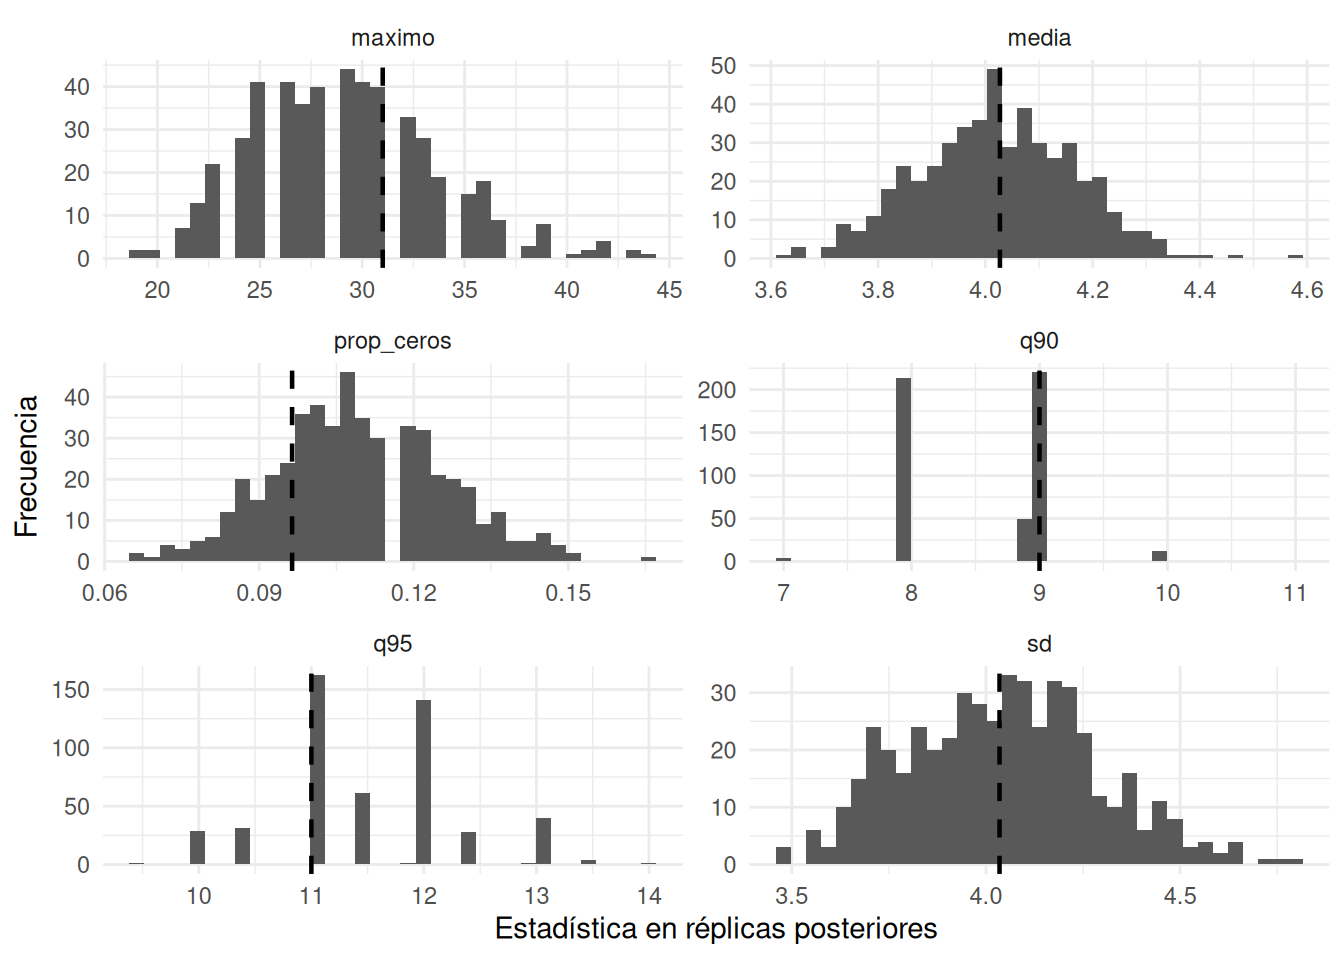
Como los datos se simularon desde el modelo que estamos ajustando, no esperamos discrepancias sistemáticas importantes. Una simulación particular puede producir estadísticas observadas relativamente extremas; por eso la comprobación predictiva no se interpreta como una prueba binaria de aceptación/rechazo.
9.17.3 ¿Qué ocurre si omitimos el offset?
Ajustemos deliberadamente un modelo incorrecto:
\[ \log(\mu_{ij}) = \alpha+u_j+\beta x_{ij}, \]
que no incorpora la exposición.
fit_pois_sin_offset_s9 <- brm(
  formula = bf(
    y ~ 1 + x + (1 | grupo)
  ),
  data = datos_pois_s9,
  family = poisson(link = "log"),
  prior = priors_pois_s9,
  backend = "cmdstanr",
  seed = 1653096,
  chains = 4,
  cores = getOption("mc.cores", 4),
  iter = 1600,
  warmup = 800,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s9_poisson_sin_offset_cmdstanr"
  ),
  file_refit = "on_change"
)
Para ver la implicación, comparemos el conteo esperado cuando \(x=0\) y variamos la exposición. En ambos casos fijaremos los efectos grupales en cero para aislar la estructura media.
new_exposicion_s9 <- tibble(
  x = 0,
  exposicion = seq(0.5, 3, length.out = 60),
  grupo = levels(datos_pois_s9$grupo)[1]
)

mu_con_offset_s9 <- posterior_epred(
  fit_pois_correcto_s9,
  newdata = new_exposicion_s9,
  re_formula = NA
)

mu_sin_offset_s9 <- posterior_epred(
  fit_pois_sin_offset_s9,
  newdata = new_exposicion_s9,
  re_formula = NA
)

pred_offset_s9 <- bind_rows(
  tibble(
    exposicion = new_exposicion_s9$exposicion,
    modelo = "Con offset",
    mediana = apply(mu_con_offset_s9, 2, median),
    q10 = apply(mu_con_offset_s9, 2, quantile, probs = 0.10),
    q90 = apply(mu_con_offset_s9, 2, quantile, probs = 0.90)
  ),
  tibble(
    exposicion = new_exposicion_s9$exposicion,
    modelo = "Sin offset",
    mediana = apply(mu_sin_offset_s9, 2, median),
    q10 = apply(mu_sin_offset_s9, 2, quantile, probs = 0.10),
    q90 = apply(mu_sin_offset_s9, 2, quantile, probs = 0.90)
  )
)
pred_offset_s9 |>
ggplot(
aes(
x = exposicion,
y = mediana,
linetype = modelo
)
) +
geom_ribbon(
aes(
ymin = q10,
ymax = q90,
group = modelo
),
alpha = 0.15,
inherit.aes = TRUE
) +
geom_line(linewidth = 0.9) +
labs(
x = "Exposición",
y = "Conteo esperado",
linetype = NULL
) +
theme_minimal(base_size = 12)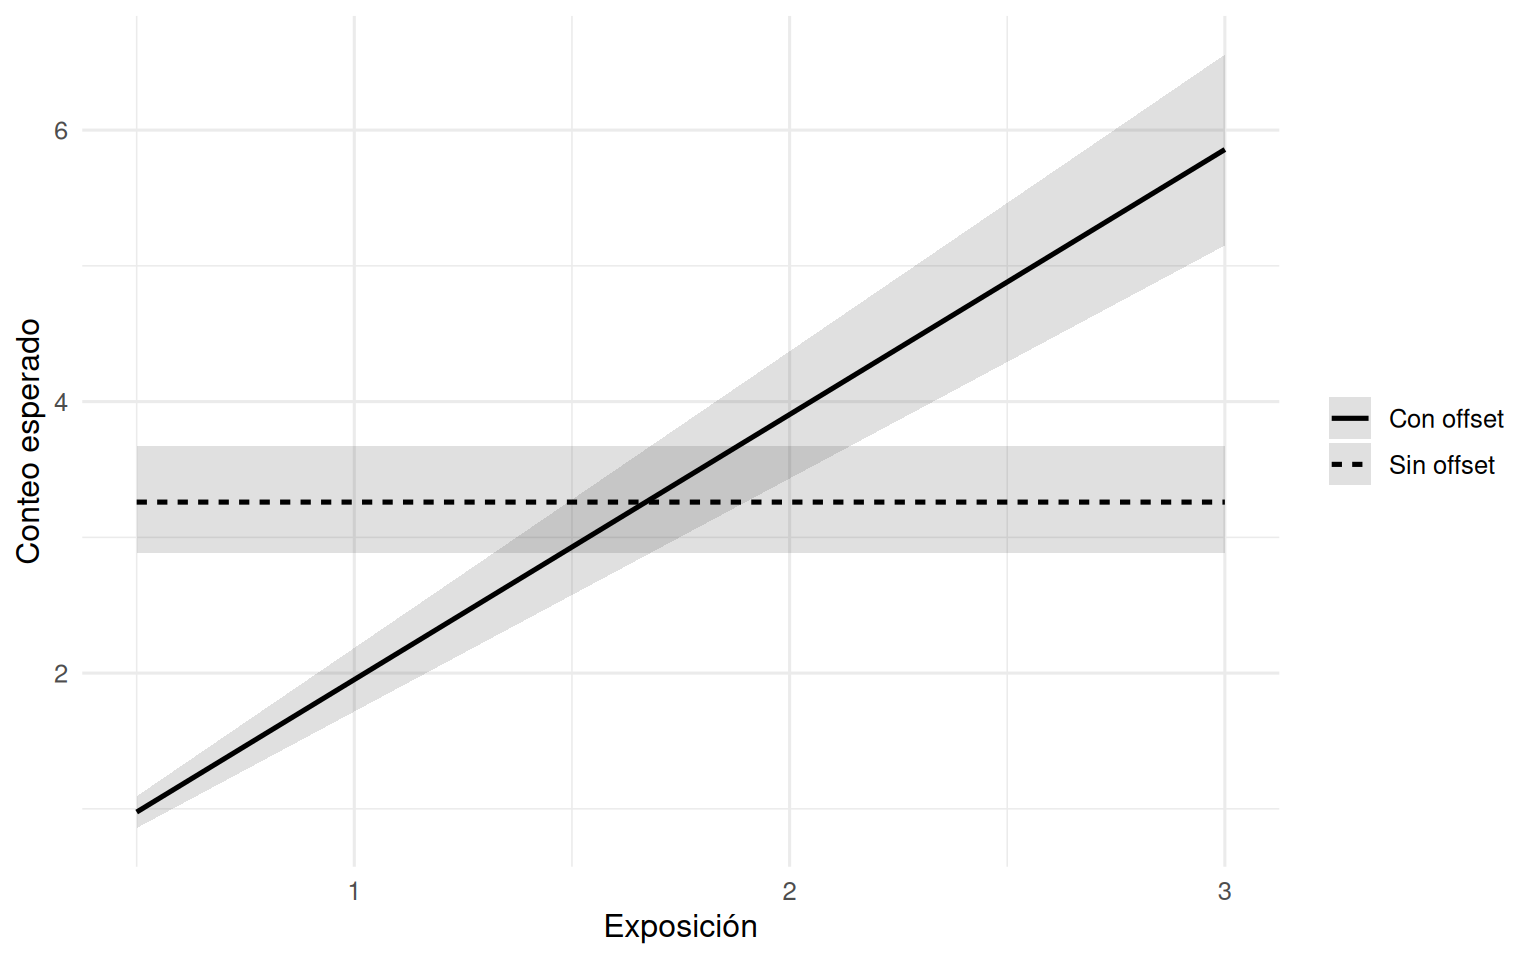
La figura ilustra un error frecuente: sin el offset, el modelo puede atribuir a los grupos o a otros predictores diferencias que en realidad se deben simplemente a que algunas unidades estuvieron observadas durante más tiempo.
9.18 Experimento 3: sobredispersión condicional y binomial negativa
Utilizaremos exactamente los mismos predictores, grupos y exposiciones de Sección 9.17, pero ahora la respuesta se generó como
\[ Y_{ij} \sim \operatorname{NegBin}(\mu_{ij},\phi=2). \]
El valor esperado es el mismo que en la simulación Poisson, pero la varianza condicional es
\[ \mu_{ij}+\frac{\mu_{ij}^2}{2}. \]
datos_nb_s9 <- base_sim_s9 |>
  transmute(
    grupo,
    x,
    exposicion,
    y = y_nb
  )
9.18.1 Ajustar un Poisson multinivel
fit_pois_sobre_nb_s9 <- brm(
  formula = formula_pois_offset_s9,
  data = datos_nb_s9,
  family = poisson(link = "log"),
  prior = priors_pois_s9,
  backend = "cmdstanr",
  seed = 1653097,
  chains = 4,
  cores = getOption("mc.cores", 4),
  iter = 1600,
  warmup = 800,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s9_poisson_sobre_datos_nb_cmdstanr"
  ),
  file_refit = "on_change"
)
El modelo contiene ya interceptos variables. Si aun así las réplicas son demasiado concentradas, la discrepancia no puede atribuirse simplemente a que ignoramos el agrupamiento simulado.
set.seed(1653098)

yrep_pois_sobre_nb_s9 <- posterior_predict(
  fit_pois_sobre_nb_s9,
  ndraws = 500
)

ppc_pois_sobre_nb_s9 <- resumen_ppc_s9(
  y_obs = datos_nb_s9$y,
  yrep = yrep_pois_sobre_nb_s9
)

plot_ppc_resumen_s9(ppc_pois_sobre_nb_s9)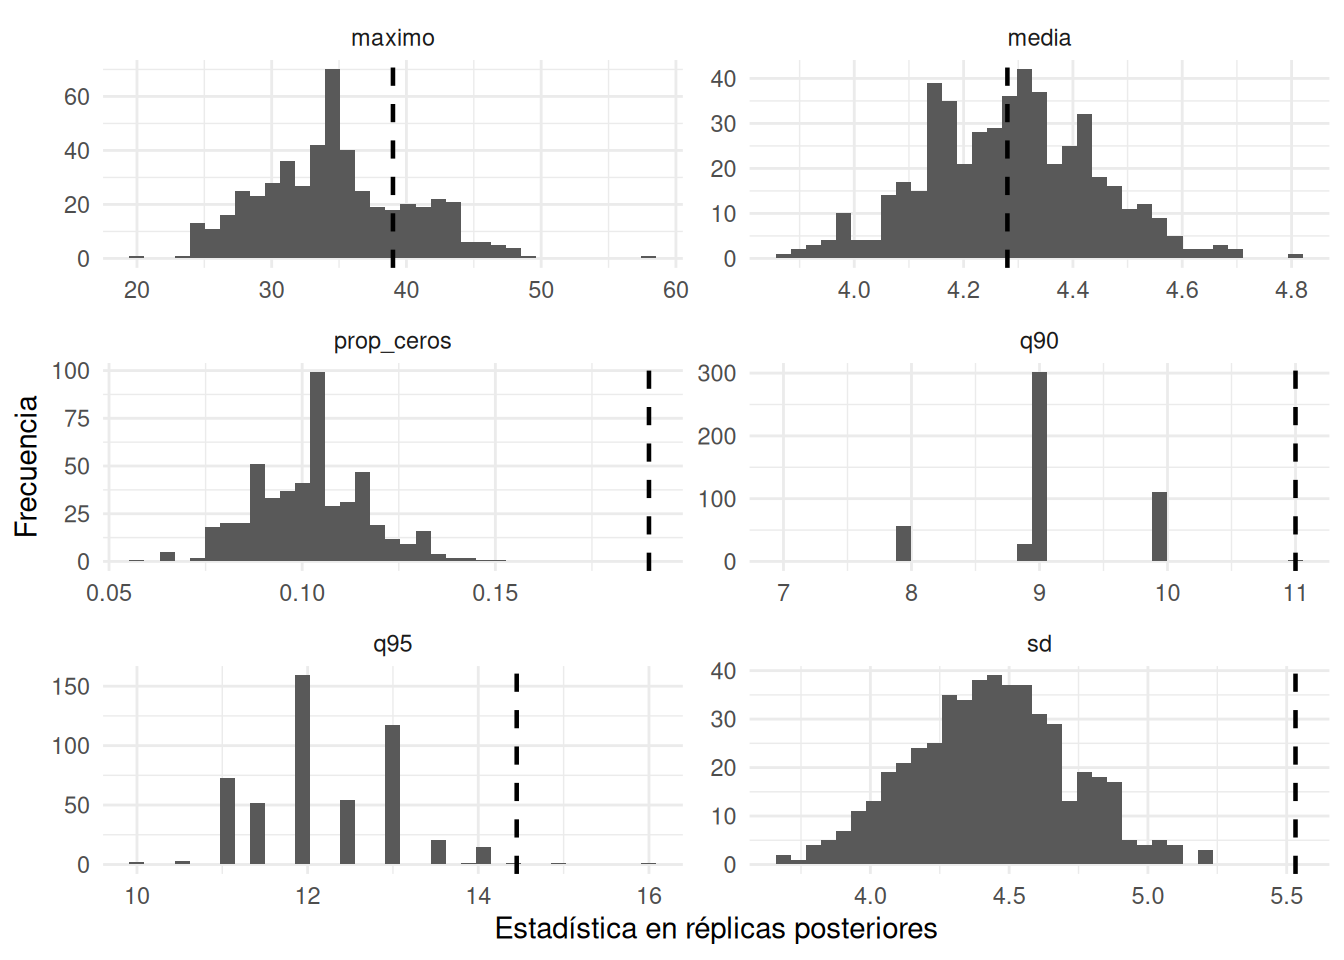
Preste atención, en particular, a la desviación estándar, la proporción de ceros, los cuantiles altos y el máximo. Un Poisson puede aproximar razonablemente la media y aun fallar de manera clara en la forma de la distribución.
9.18.2 Ajustar una binomial negativa multinivel
priors_nb_s9 <- c(
  prior(normal(log(2), 0.7), class = "Intercept"),
  prior(normal(0, 0.5), class = "b"),
  prior(exponential(2), class = "sd"),
  prior(gamma(2, 0.5), class = "shape")
)

priors_nb_s9
prior class coef group resp dpar nlpar lb ub tag source
normal(log(2), 0.7) Intercept <NA> <NA> user
normal(0, 0.5) b <NA> <NA> user
exponential(2) sd <NA> <NA> user
gamma(2, 0.5) shape <NA> <NA> userfit_nb_s9 <- brm(
formula = formula_pois_offset_s9,
data = datos_nb_s9,
family = negbinomial(link = "log"),
prior = priors_nb_s9,
backend = "cmdstanr",
seed = 1653099,
chains = 4,
cores = getOption("mc.cores", 4),
iter = 1800,
warmup = 900,
control = list(
adapt_delta = 0.95,
max_treedepth = 12
),
refresh = 0,
file = file.path(
"_fits",
"s9_nb_offset_simulacion_cmdstanr"
),
file_refit = "on_change"
)posterior::summarise_draws(
as_draws_df(fit_nb_s9),
"mean", "sd", "rhat", "ess_bulk", "ess_tail"
) |>
filter(
str_detect(variable, "^(b_|sd_|shape)")
)# A tibble: 4 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept 0.742 0.0994 1.00 1023. 1948.
2 b_x 0.448 0.0540 1.00 5868. 2778.
3 sd_grupo__Intercept 0.414 0.0893 1.00 1376. 1803.
4 shape 1.80 0.238 1.00 4659. 2822.nuts_nb_s9 <- brms::nuts_params(fit_nb_s9)
nuts_nb_s9 |>
summarise(
divergencias = sum(
Parameter == "divergent__" & Value == 1
),
profundidad_maxima = max(
Value[Parameter == "treedepth__"]
)
) divergencias profundidad_maxima
1 0 5La comprobación predictiva posterior es:
set.seed(16530910)

yrep_nb_s9 <- posterior_predict(
  fit_nb_s9,
  ndraws = 500
)

ppc_nb_s9 <- resumen_ppc_s9(
  y_obs = datos_nb_s9$y,
  yrep = yrep_nb_s9
)

plot_ppc_resumen_s9(ppc_nb_s9)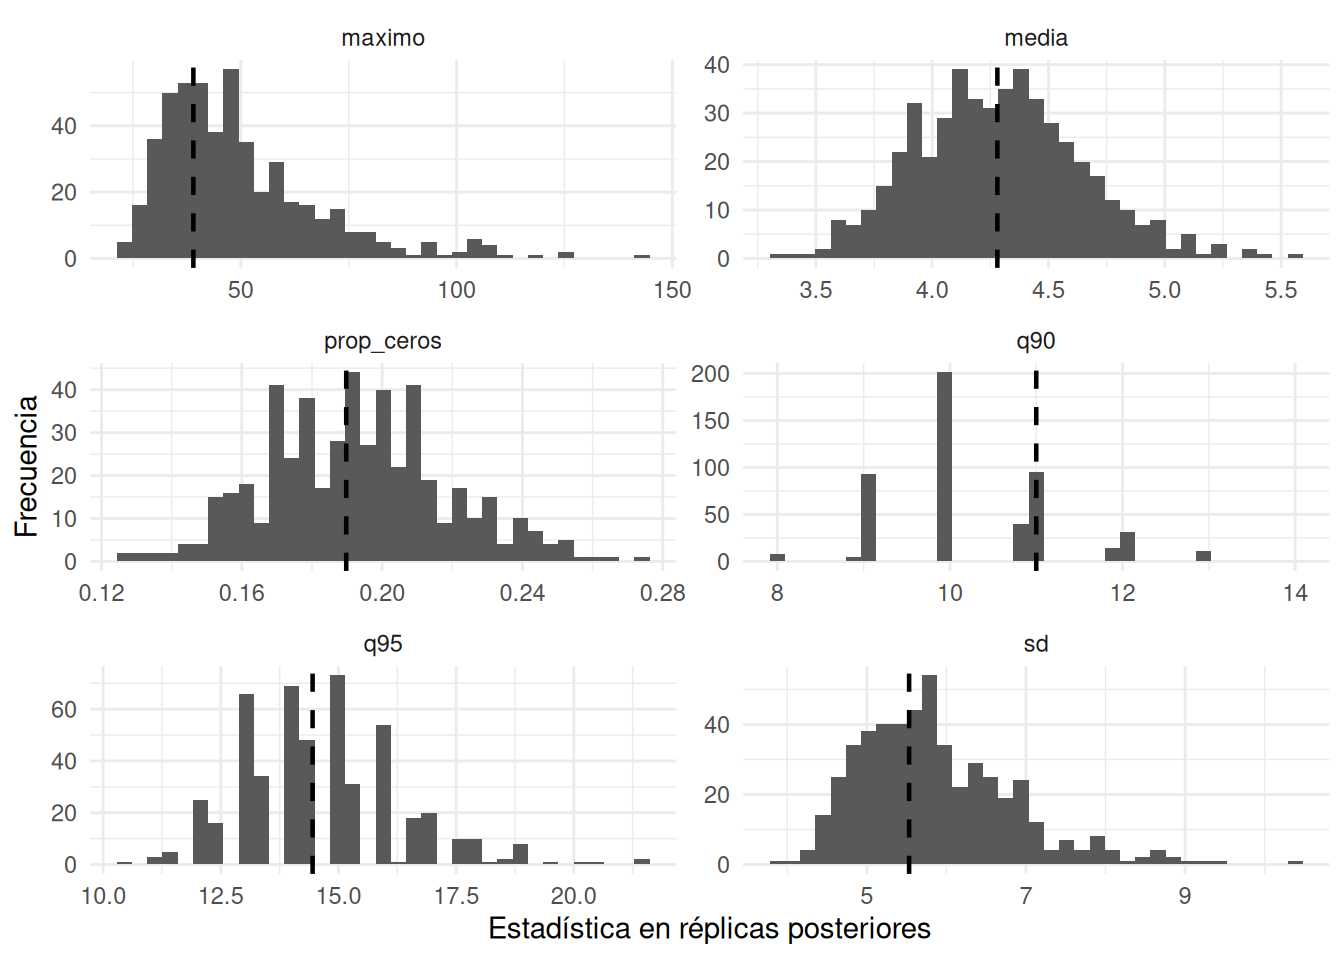
La comparación que interesa en este punto no es cuál modelo obtiene un número escalar ligeramente mejor, sino qué discrepancias predictivas desaparecen al permitir variación adicional. En los datos simulados conocemos la respuesta: la binomial negativa es la familia correcta. En una aplicación real esa certeza no existe.
9.18.3 Comparación gráfica directa
Podemos colocar lado a lado las distribuciones predictivas de algunas estadísticas.
comparar_ppc_s9 <- bind_rows(
  ppc_pois_sobre_nb_s9$replicado |>
    mutate(modelo = "Poisson"),
  ppc_nb_s9$replicado |>
    mutate(modelo = "Binomial negativa")
)

obs_comparar_s9 <- ppc_nb_s9$observado
comparar_ppc_s9 |>
filter(
estadistica %in% c(
"sd",
"prop_ceros",
"q95",
"maximo"
)
) |>
ggplot(aes(x = replicado)) +
geom_histogram(bins = 30) +
geom_vline(
data = obs_comparar_s9 |>
filter(
estadistica %in% c(
"sd",
"prop_ceros",
"q95",
"maximo"
)
),
aes(xintercept = observado),
linewidth = 0.8,
linetype = 2,
inherit.aes = FALSE
) +
facet_grid(
modelo ~ estadistica,
scales = "free"
) +
labs(
x = "Valor en réplicas posteriores",
y = "Frecuencia"
) +
theme_minimal(base_size = 11)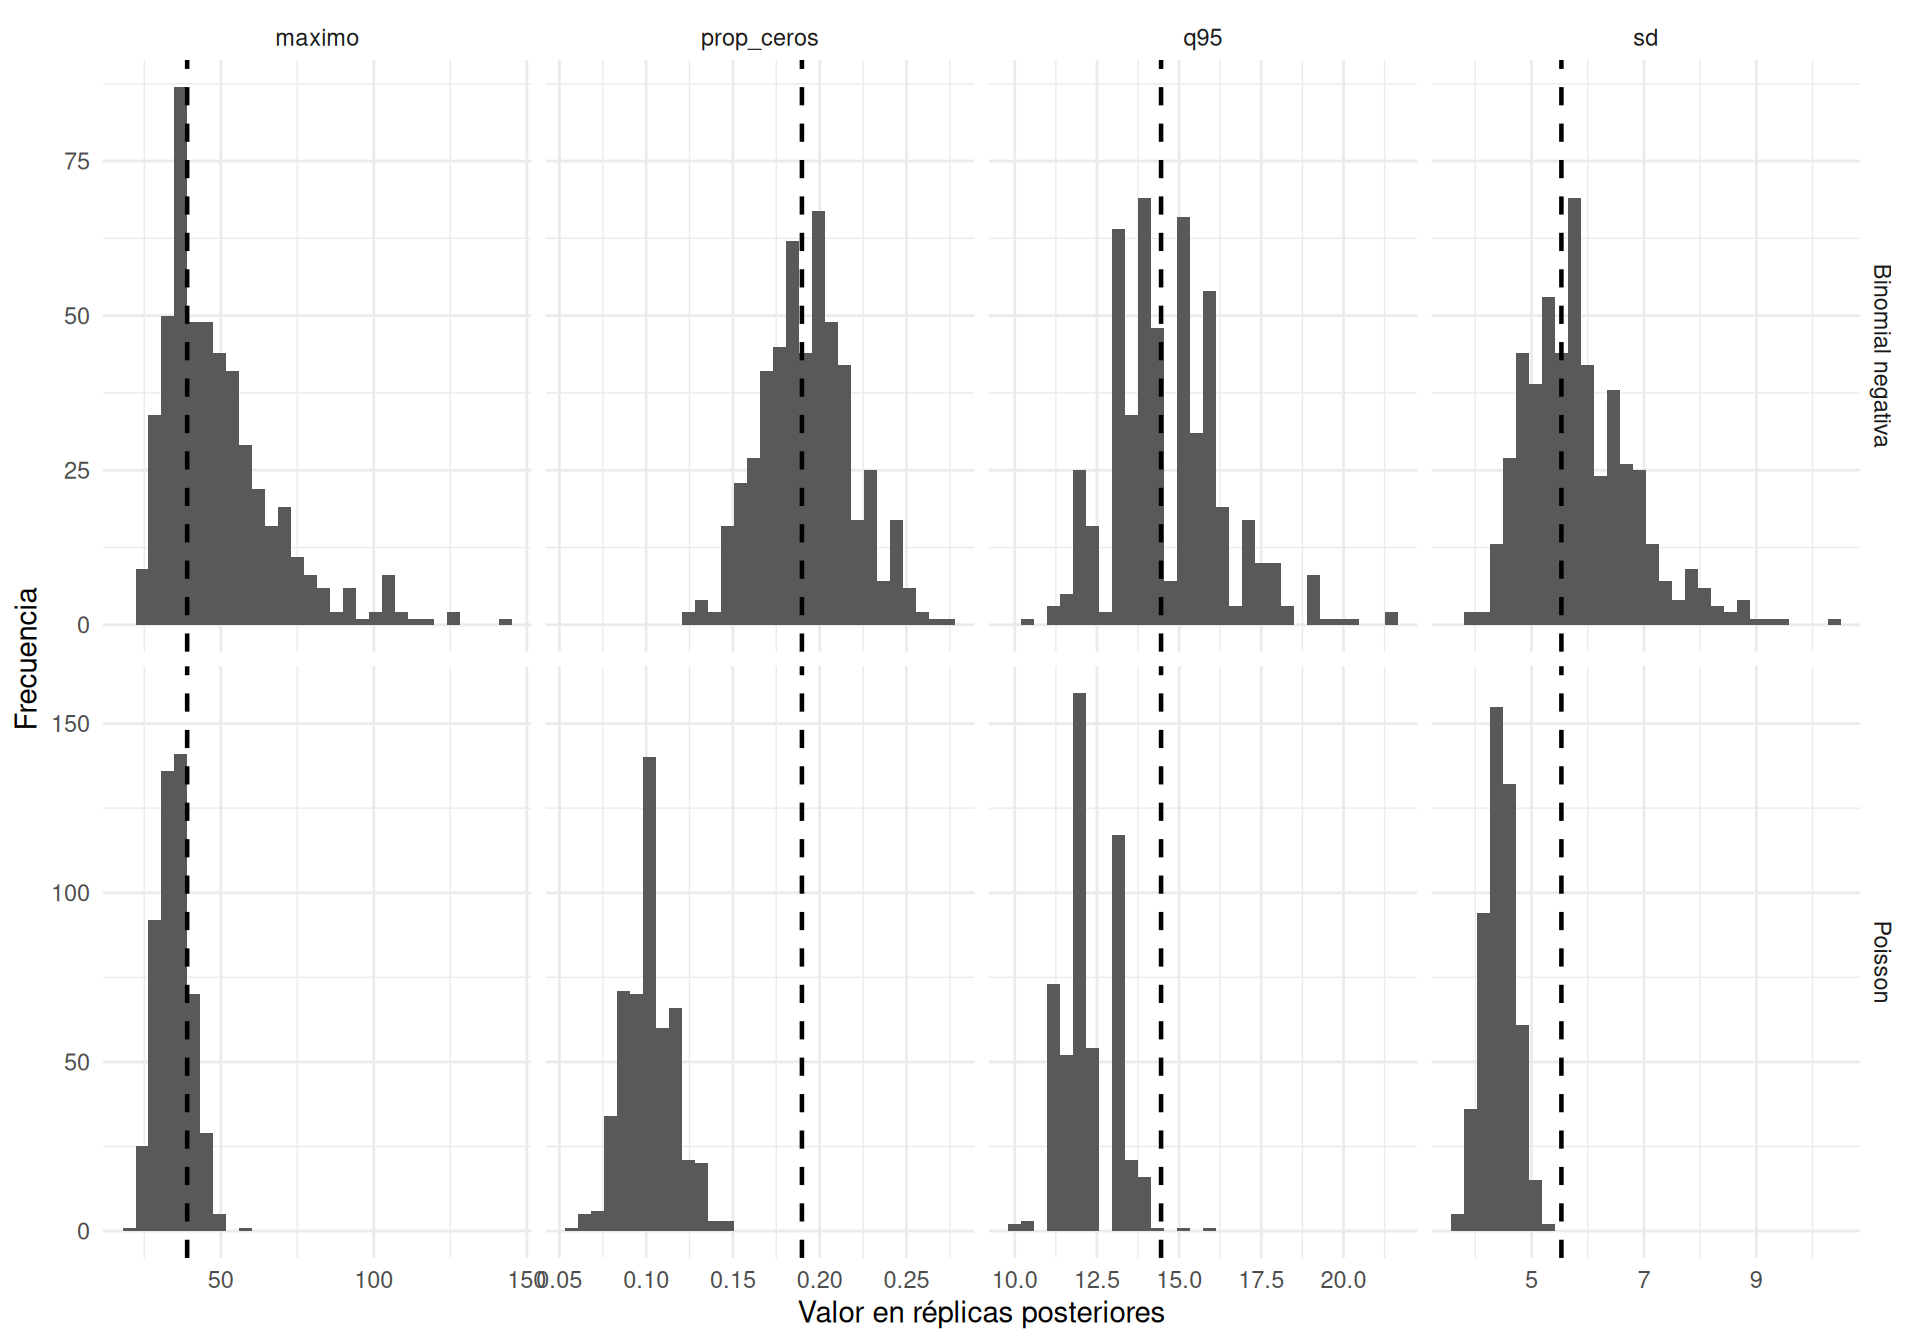
NotaQué aprendemos de la simulación
La simulación separa tres fuentes que en datos reales suelen aparecer mezcladas:
- la exposición cambia el conteo esperado aun con tasa constante;
- los interceptos variables producen heterogeneidad compartida por observaciones del mismo grupo;
- la binomial negativa añade variación condicional que no se explica únicamente por el intercepto grupal.
El objetivo no es concluir que la binomial negativa debe usarse siempre, sino reconocer qué afirmación agrega al modelo.
9.19 Aplicación: crisis epilépticas observadas repetidamente
Hox et al. utilizan un estudio de personas con epilepsia para ilustrar modelos multinivel de conteo. El conjunto contiene pacientes observados repetidamente después de asignarlos a tratamiento o control, junto con un conteo basal de crisis y la edad. El ejemplo es útil porque combina las dos cuestiones de esta semana: conteos y heterogeneidad entre personas (Hox et al. 2018, 141-45).
Para mantener el ejemplo reproducible utilizaremos el conjunto epil distribuido con el paquete MASS. La estructura concreta del archivo se comprobará antes de ajustar el modelo.
epil_raw_s9 <- MASS::epil |>
  as_tibble()

variables_requeridas_s9 <- c(
  "y",
  "trt",
  "base",
  "age",
  "subject",
  "period"
)

faltan_variables_s9 <- setdiff(
  variables_requeridas_s9,
  names(epil_raw_s9)
)

if (length(faltan_variables_s9) > 0) {
  stop(
    "El conjunto MASS::epil no contiene las variables esperadas: ",
    paste(faltan_variables_s9, collapse = ", ")
  )
}

if (anyNA(epil_raw_s9[variables_requeridas_s9])) {
  stop(
    "Hay valores faltantes en variables utilizadas por la aplicación. ",
    "Revise el conjunto antes de continuar."
  )
}

if (any(epil_raw_s9$y < 0) || any(epil_raw_s9$y %% 1 != 0)) {
  stop("La respuesta y debe contener conteos enteros no negativos.")
}

if (any(epil_raw_s9$base <= 0)) {
  stop("La variable base debe ser positiva para aplicar log(base).")
}

niveles_trt_s9 <- unique(as.character(epil_raw_s9$trt))

if (length(niveles_trt_s9) != 2) {
  stop("Se esperaban exactamente dos niveles de tratamiento en MASS::epil.")
}

ref_trt_s9 <- niveles_trt_s9[
  which.min(
    !str_detect(
      str_to_lower(niveles_trt_s9),
      "placebo|control"
    )
  )
]

if (!any(
  str_detect(
    str_to_lower(niveles_trt_s9),
    "placebo|control"
  )
)) {
  ref_trt_s9 <- niveles_trt_s9[1]
}

activo_trt_s9 <- setdiff(niveles_trt_s9, ref_trt_s9)[1]

ref_trt_s9
[1] "placebo"activo_trt_s9[1] "progabide"La codificación será 0 para el nivel de referencia y 1 para el otro nivel.
epil_s9 <- epil_raw_s9 |>
  mutate(
    subject = factor(subject),
    tratamiento = as.integer(
      as.character(trt) == activo_trt_s9
    ),
    periodo_num = as.numeric(as.character(period)),
    periodo_c = periodo_num - min(periodo_num),
    log_base = log(base),
    log_base_c = log_base - mean(log_base),
    edad_z = as.numeric(scale(age))
  ) |>
  select(
    y,
    subject,
    tratamiento,
    periodo_num,
    periodo_c,
    base,
    log_base_c,
    age,
    edad_z
  )

if (anyNA(epil_s9$periodo_num)) {
  stop(
    "No fue posible convertir period a una variable numérica. ",
    "Revise los niveles de MASS::epil."
  )
}

epil_s9 |>
  summarise(
    observaciones = n(),
    sujetos = n_distinct(subject),
    minimo = min(y),
    mediana = median(y),
    media = mean(y),
    varianza = var(y),
    proporcion_ceros = mean(y == 0),
    maximo = max(y)
  )
# A tibble: 1 × 8
observaciones sujetos minimo mediana media varianza proporcion_ceros maximo
<int> <int> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 236 59 0 4 8.26 153. 0.0975 102La comparación entre media y varianza anterior es solamente descriptiva. Como las personas tienen distintos valores basales y observaciones repetidas, no puede utilizarse por sí sola para decidir que un Poisson está mal especificado.
9.19.1 Estructura de los datos
Cada fila representa un conteo de crisis para una persona en un período. Las observaciones de una misma persona no son intercambiables con observaciones de personas distintas: comparten una propensión individual a presentar crisis.
Un modelo inicial será
\[ Y_{it}\mid \mu_{it} \sim \operatorname{Poisson}(\mu_{it}), \]
\[ \log(\mu_{it}) = \alpha_i + \beta_T T_i + \beta_B B_i + \beta_P t + \beta_A A_i, \]
\[ \alpha_i = \mu_\alpha+u_i, \]
\[ u_i\sim\mathcal N(0,\tau_\alpha^2). \tag{9.12}\]
Aquí:
- \(T_i\) indica tratamiento;
- \(B_i\) es el logaritmo centrado del conteo basal;
- \(t\) es el período, codificado de modo que \(t=0\) corresponde al primer período observado;
- \(A_i\) es la edad estandarizada;
- \(u_i\) representa heterogeneidad persistente entre personas.
Incluimos la edad como predictor basal en lugar de eliminarla mediante una prueba de significancia. Hox et al. describen edad, tratamiento y conteo basal en el ejemplo original; nuestro objetivo aquí es construir un modelo probabilístico razonable y luego comprobarlo, no seleccionar predictores mediante una secuencia de pruebas (Hox et al. 2018, 141-43).
NotaEste no es todavía un modelo longitudinal completo
El intercepto variable representa heterogeneidad persistente entre personas, pero no una autocorrelación residual dentro de persona ni una trayectoria temporal no lineal. Esas extensiones corresponden a las semanas 11 y 12. Aquí utilizamos la estructura repetida porque permite estudiar un GLMM de conteos sin adelantar toda la modelación longitudinal.
9.19.2 Exploración gráfica
epil_s9 |>
  ggplot(aes(x = y)) +
  geom_histogram(binwidth = 2, boundary = 0) +
  labs(
    x = "Número de crisis",
    y = "Frecuencia"
  ) +
  theme_minimal(base_size = 12)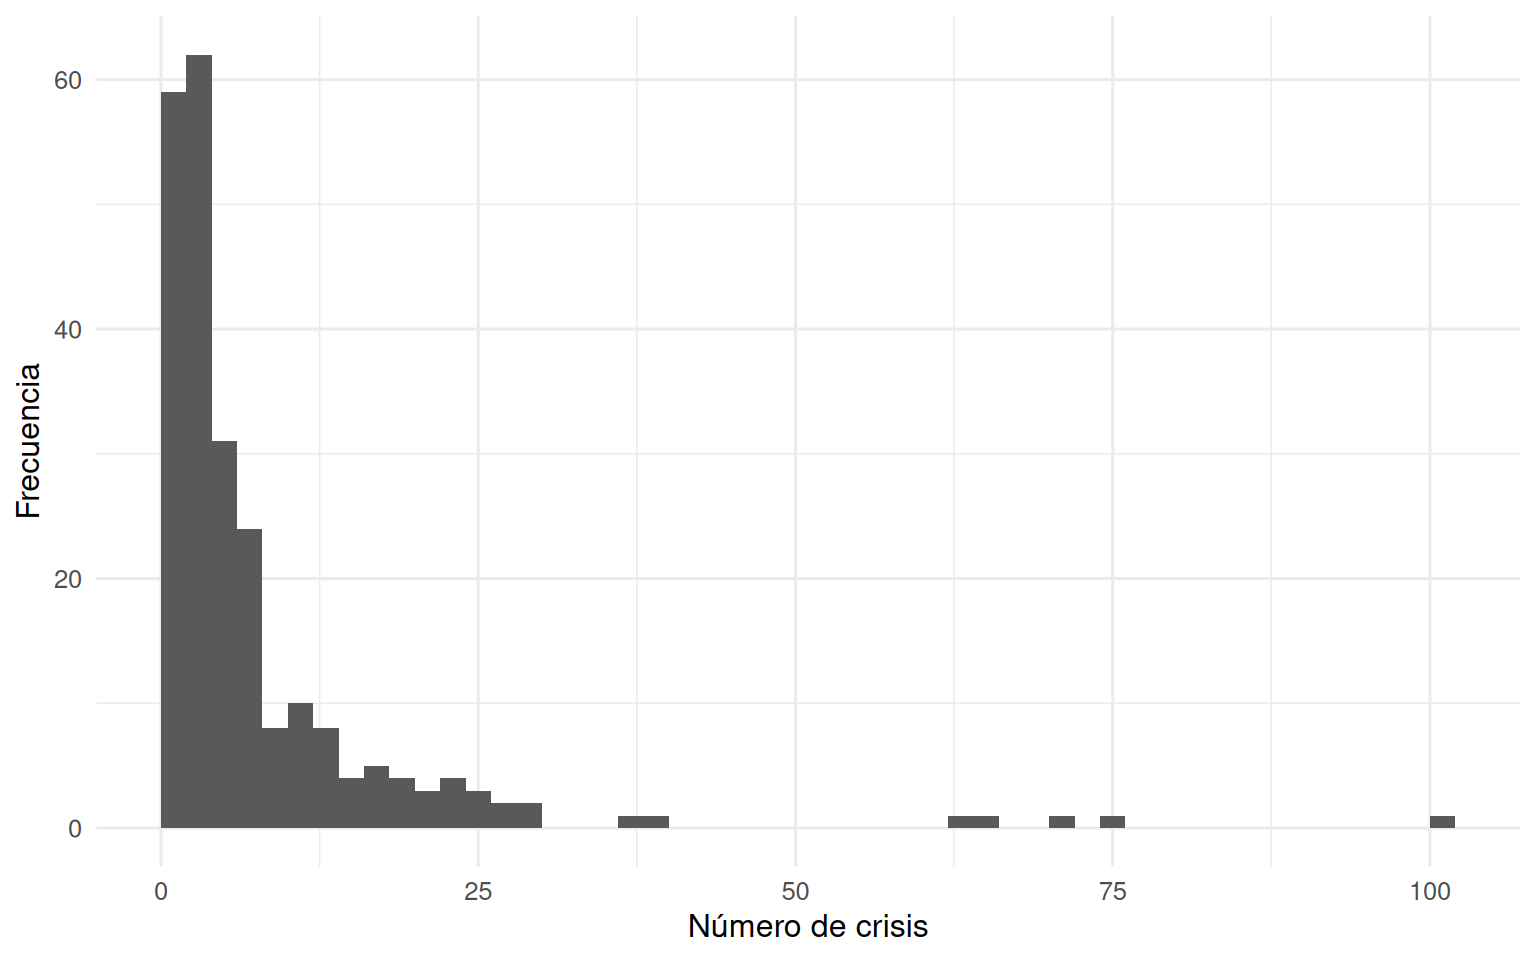
Para visualizar la estructura repetida, seleccionamos algunas personas y conectamos sus conteos a través de los períodos.
sujetos_mostrar_s9 <- levels(epil_s9$subject)[1:12]epil_s9 |>
filter(subject %in% sujetos_mostrar_s9) |>
ggplot(
aes(
x = periodo_num,
y = y,
group = subject
)
) +
geom_line(alpha = 0.65) +
geom_point(size = 1.8) +
facet_wrap(~ subject, scales = "free_y") +
labs(
x = "Período",
y = "Conteo de crisis"
) +
theme_minimal(base_size = 11)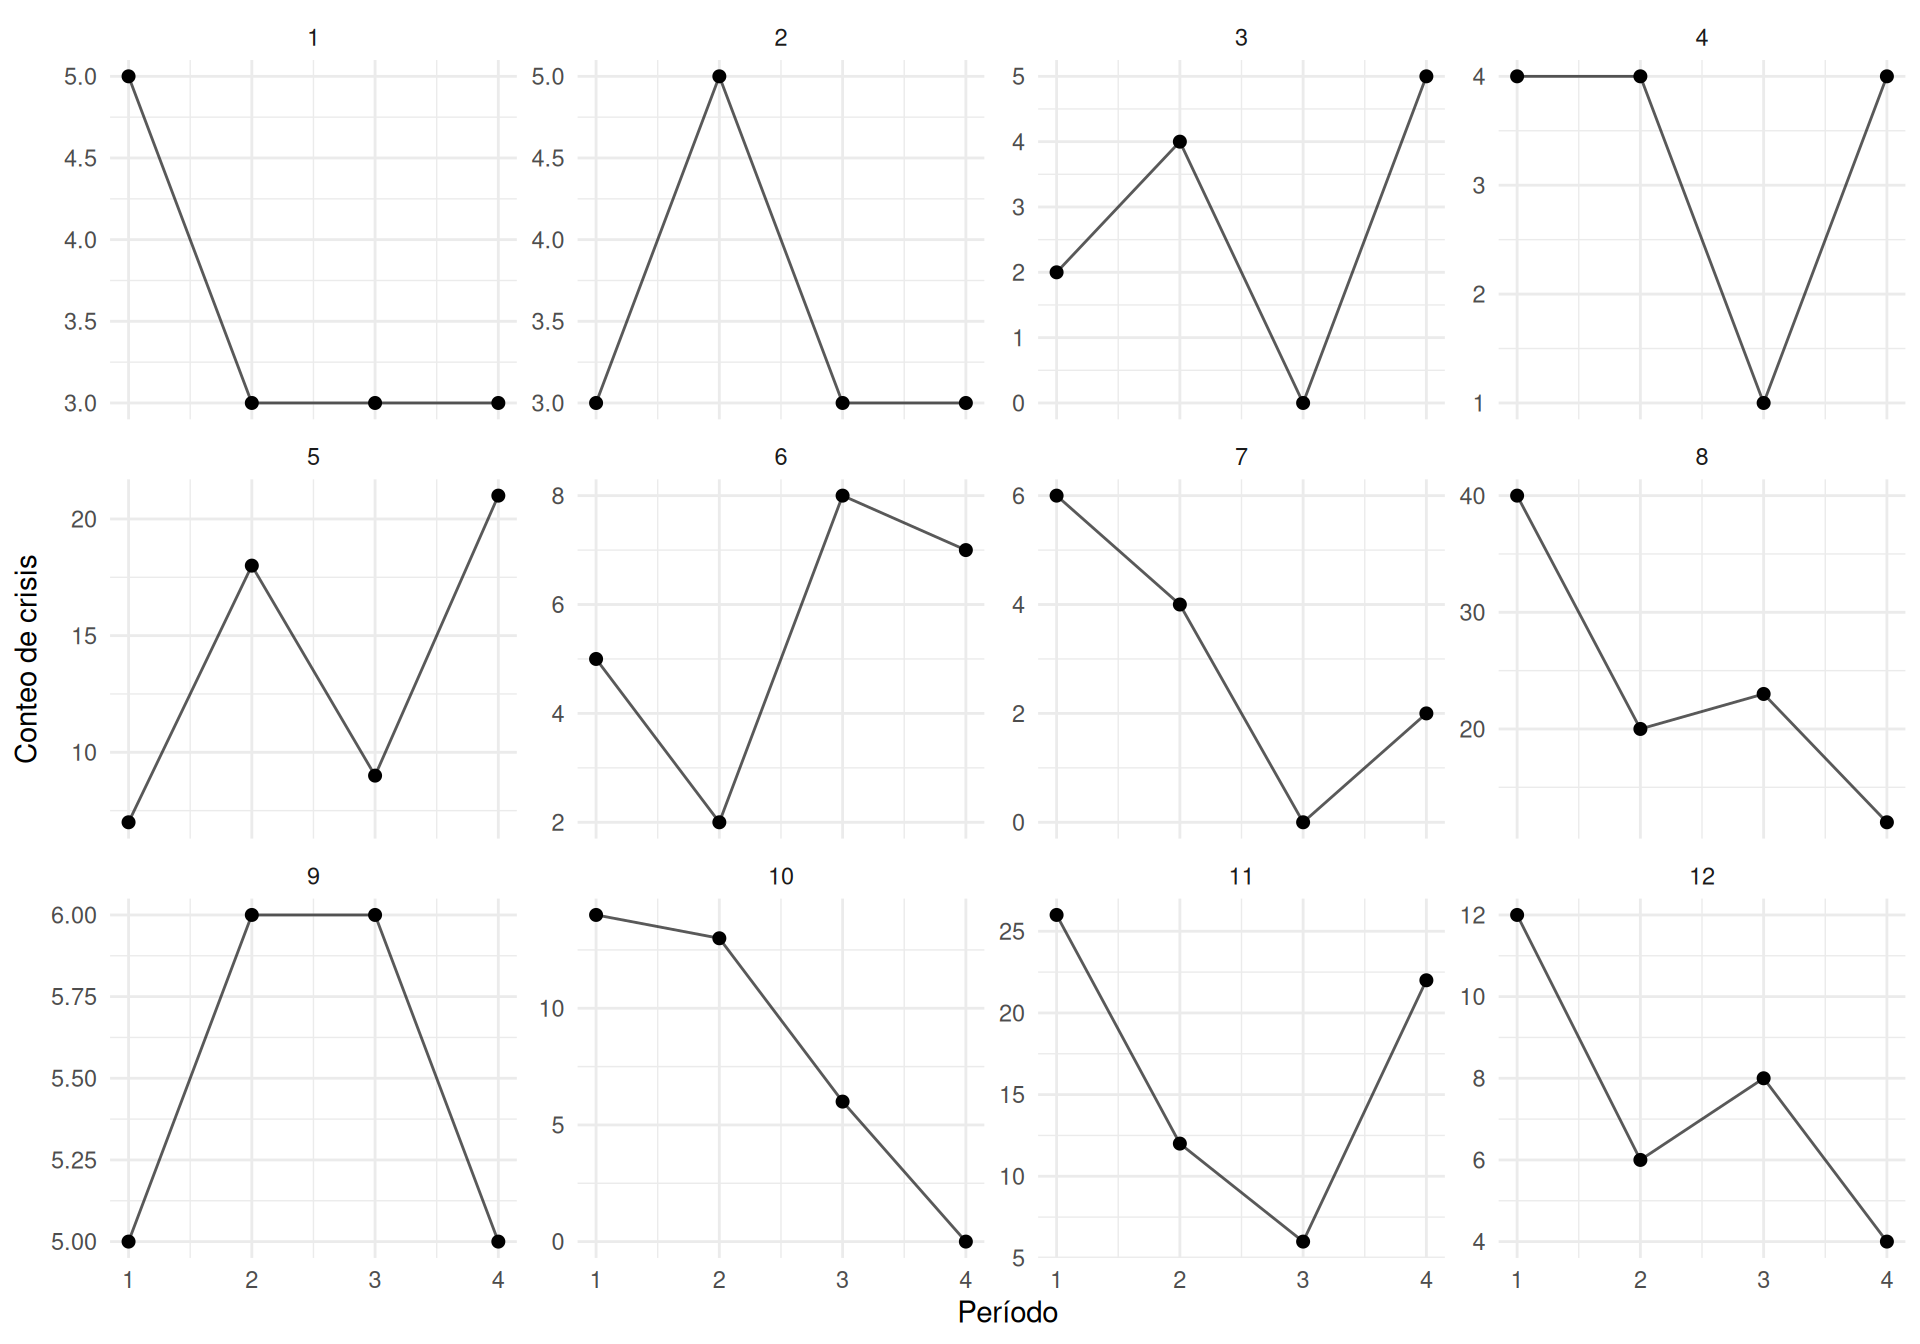
9.20 Previas para la aplicación
Usaremos las siguientes previas comunes a Poisson y binomial negativa:
\[ \mu_\alpha \sim \mathcal N\{\log(5),0.7^2\}, \]
\[ \beta_k \sim \mathcal N(0,0.5^2), \]
\[ \tau_\alpha \sim \operatorname{Exponential}(2). \]
Como log_base_c = 0, edad_z = 0 y periodo_c = 0 representan valores de referencia cercanos al centro de los predictores continuos, la previa del intercepto puede interpretarse como una tasa esperada alrededor de 5 crisis por período para una persona situada en el centro de la distribución grupal y en el nivel de referencia del tratamiento. La desviación 0.7 permite una gama amplia de tasas sin colocar demasiada masa en valores astronómicos.
Para la binomial negativa añadiremos
\[ \phi\sim\operatorname{Gamma}(2,0.5), \]
donde el segundo parámetro se interpreta como tasa en la notación de Stan.
formula_epil_s9 <- bf(
  y ~ 1 + tratamiento + log_base_c + periodo_c + edad_z +
    (1 | subject)
)

priors_epil_pois_s9 <- c(
  prior(normal(log(5), 0.7), class = "Intercept"),
  prior(normal(0, 0.5), class = "b"),
  prior(exponential(2), class = "sd")
)

priors_epil_nb_s9 <- c(
  priors_epil_pois_s9,
  prior(gamma(2, 0.5), class = "shape")
)
9.20.1 Comprobación predictiva previa manual
Antes del ajuste simularemos el conteo de una persona nueva con covariables continuas centradas. Esta simulación no reemplaza una comprobación más extensa de todos los perfiles de covariables, pero permite detectar problemas graves de escala.
set.seed(16530911)

S_prior_s9 <- 12000L

prior_epil_s9 <- tibble(
  alpha = rnorm(S_prior_s9, log(5), 0.7),
  beta_tratamiento = rnorm(S_prior_s9, 0, 0.5),
  tau = rexp(S_prior_s9, rate = 2),
  u_nuevo = rnorm(S_prior_s9, 0, tau),
  shape = rgamma(S_prior_s9, shape = 2, rate = 0.5),
  tratamiento = rep(c(0, 1), length.out = S_prior_s9),
  mu = exp(
    alpha +
      beta_tratamiento * tratamiento +
      u_nuevo
  ),
  y_prior = rnbinom(
    S_prior_s9,
    mu = mu,
    size = shape
  )
)

prior_epil_s9 |>
  summarise(
    mediana = median(y_prior),
    q90 = quantile(y_prior, 0.90),
    q95 = quantile(y_prior, 0.95),
    q99 = quantile(y_prior, 0.99),
    prop_mayor_100 = mean(y_prior > 100),
    prop_ceros = mean(y_prior == 0)
  )
# A tibble: 1 × 6
mediana q90 q95 q99 prop_mayor_100 prop_ceros
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 4 19 30 80.0 0.00717 0.129prior_epil_s9 |>
filter(y_prior <= 100) |>
ggplot(aes(x = y_prior)) +
geom_histogram(binwidth = 2, boundary = 0) +
labs(
x = "Conteo predictivo previo",
y = "Frecuencia"
) +
theme_minimal(base_size = 12)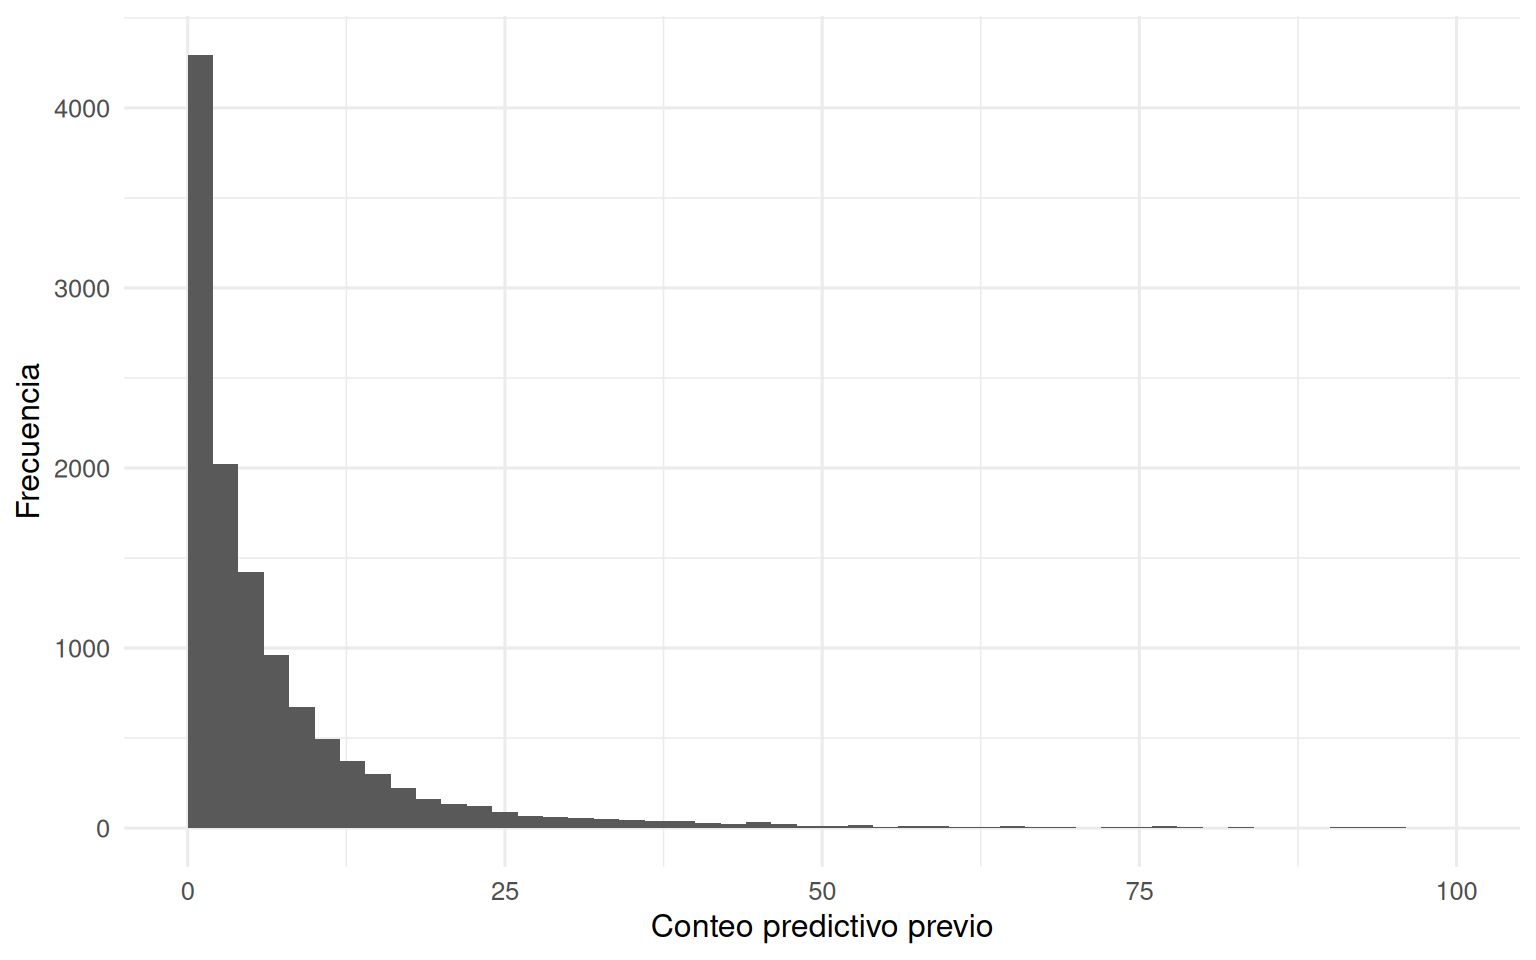
Si la comprobación generara con frecuencia miles o millones de crisis por período, deberíamos revisar las previas antes de ajustar. La finalidad no es hacer que la previa reproduzca exactamente el histograma observado, sino evitar implicaciones claramente incompatibles con el dominio.
9.21 Ajuste Poisson de la aplicación
fit_epil_pois_s9 <- brm(
  formula = formula_epil_s9,
  data = epil_s9,
  family = poisson(link = "log"),
  prior = priors_epil_pois_s9,
  backend = "cmdstanr",
  seed = 16530912,
  chains = 4,
  cores = getOption("mc.cores", 4),
  iter = 2000,
  warmup = 1000,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s9_epil_poisson_cmdstanr"
  ),
  file_refit = "on_change"
)
9.22 Diagnóstico computacional del Poisson
Primero resumimos parámetros sustantivos y componentes de variación.
posterior::summarise_draws(
  as_draws_df(fit_epil_pois_s9),
  "mean", "sd", "rhat", "ess_bulk", "ess_tail"
) |>
  filter(
    str_detect(variable, "^(b_|sd_)")
  )
# A tibble: 6 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept 1.86 0.114 1.01 844. 1429.
2 b_tratamiento -0.288 0.151 1.00 850. 1248.
3 b_log_base_c 0.975 0.103 1.01 847. 1504.
4 b_periodo_c -0.0587 0.0203 1.00 6225. 2732.
5 b_edad_z 0.0604 0.0820 1.01 689. 1558.
6 sd_subject__Intercept 0.544 0.0652 1.01 1012. 1921.nuts_epil_pois_s9 <- brms::nuts_params(
fit_epil_pois_s9
)
nuts_epil_pois_s9 |>
summarise(
divergencias = sum(
Parameter == "divergent__" & Value == 1
),
profundidad_maxima = max(
Value[Parameter == "treedepth__"]
)
) divergencias profundidad_maxima
1 0 7También podemos inspeccionar trazas de un subconjunto de parámetros.
mcmc_trace(
  as.array(fit_epil_pois_s9),
  pars = c(
    "b_Intercept",
    "b_tratamiento",
    "b_log_base_c",
    "sd_subject__Intercept"
  )
)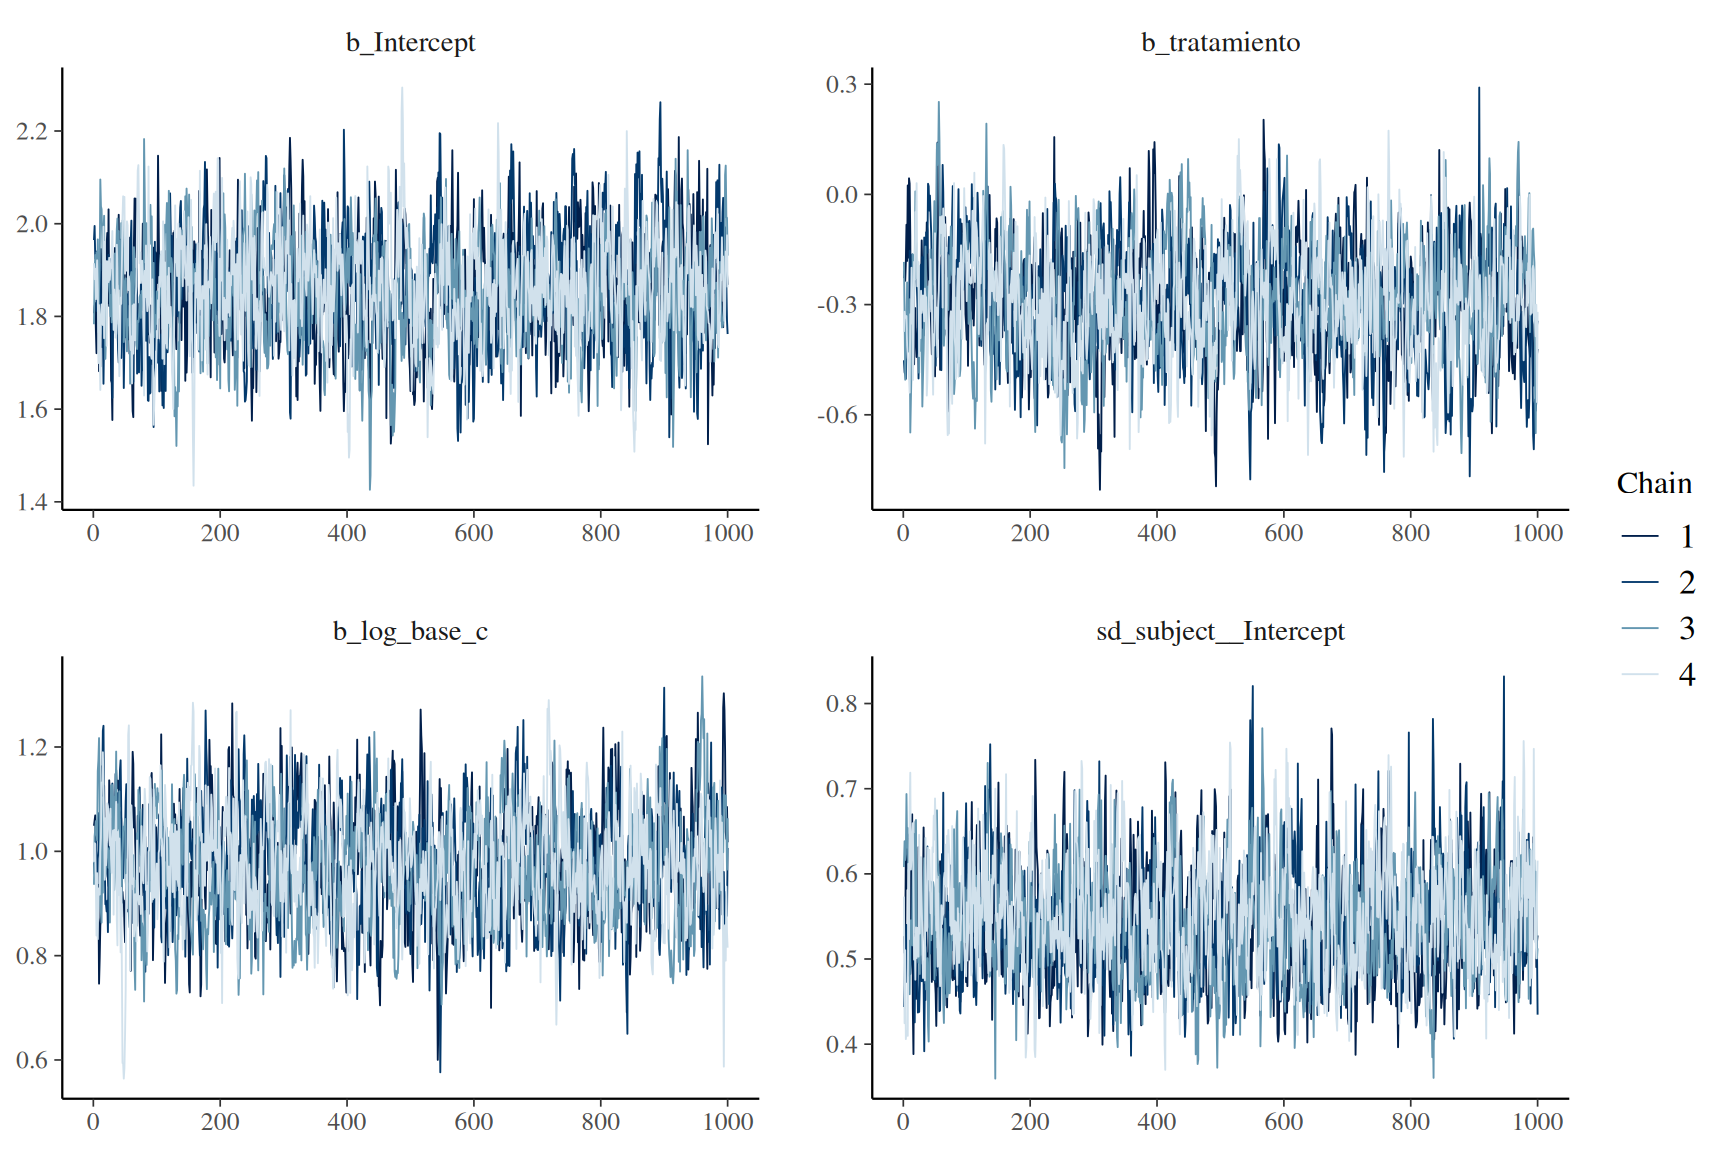
Si aparecen divergencias, \(\widehat R\) elevados o ESS problemáticos, no debemos interpretar todavía el modelo. Si el muestreo es adecuado, pasamos a una pregunta diferente: ¿el modelo Poisson reproduce los datos?
9.23 Comprobación predictiva del Poisson
set.seed(16530913)

yrep_epil_pois_s9 <- posterior_predict(
  fit_epil_pois_s9,
  ndraws = 600
)

ppc_epil_pois_s9 <- resumen_ppc_s9(
  y_obs = epil_s9$y,
  yrep = yrep_epil_pois_s9
)

plot_ppc_resumen_s9(ppc_epil_pois_s9)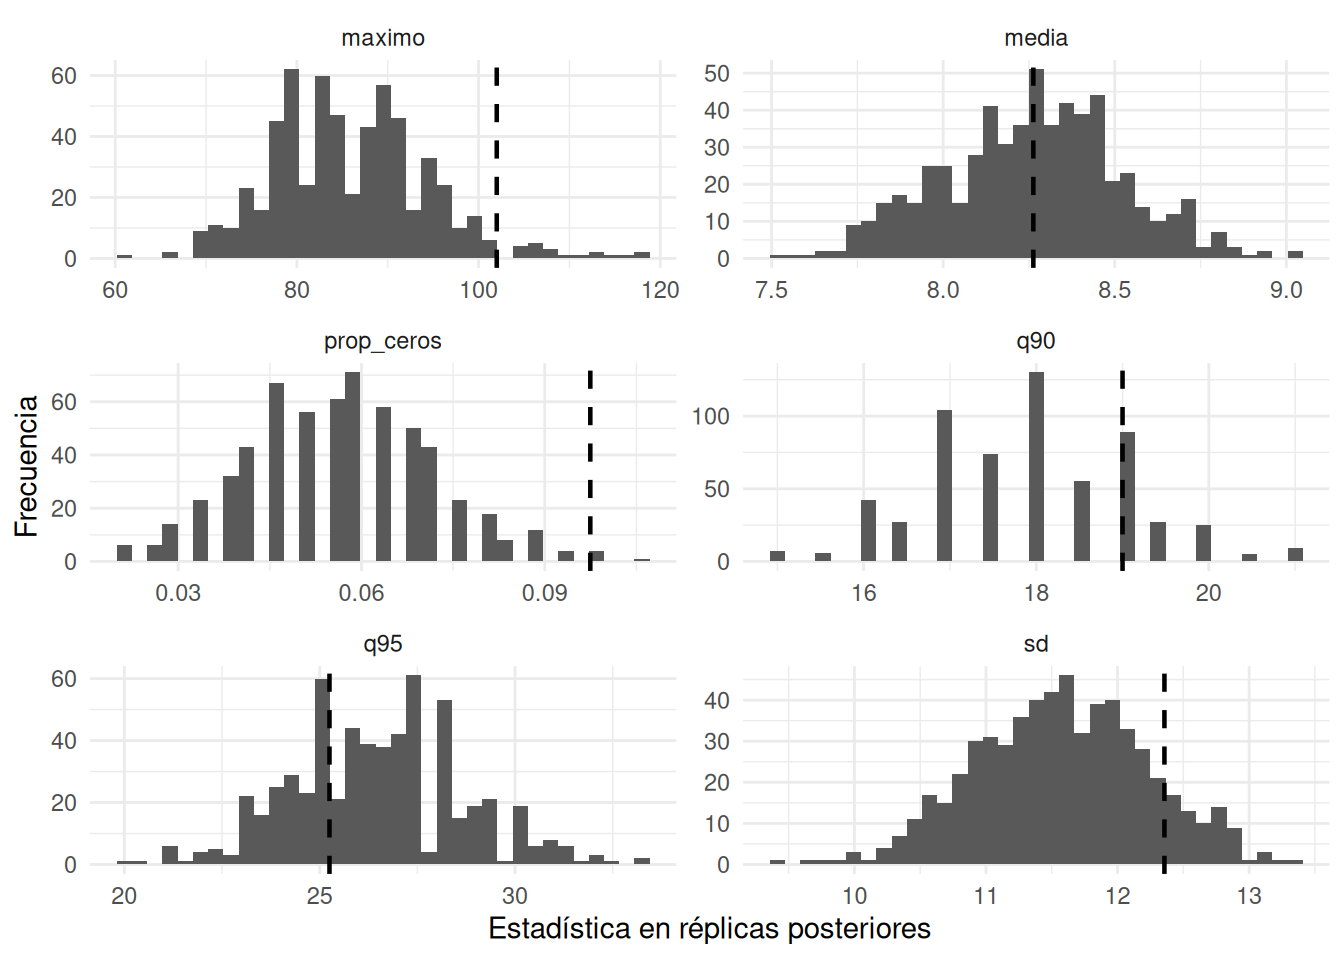
En el ejemplo de Hox et al. la variación observada de las crisis es mucho mayor que la que sugeriría una Poisson simple, y la binomial negativa aparece como una expansión natural (Hox et al. 2018, 141-44). Sin embargo, nuestra formulación Poisson ya contiene un intercepto variable por persona, por lo que la decisión debe basarse en lo que todavía quede sin reproducir después de incorporar esa heterogeneidad.
9.23.1 Frecuencias observadas y replicadas
Una comprobación visual adicional compara frecuencias discretas. Para evitar una figura dominada por unos pocos conteos muy grandes, agruparemos todos los valores mayores o iguales a 30.
agrupar_conteo_s9 <- function(y, corte = 30L) {
  pmin(y, corte)
}

seleccion_draws_pois_s9 <- seq_len(
  min(40L, nrow(yrep_epil_pois_s9))
)

freq_obs_epil_s9 <- tibble(
  y = agrupar_conteo_s9(epil_s9$y)
) |>
  count(y, name = "frecuencia") |>
  mutate(tipo = "Observado")

freq_rep_epil_pois_s9 <- map_dfr(
  seleccion_draws_pois_s9,
  function(s) {
    tibble(
      y = agrupar_conteo_s9(
        yrep_epil_pois_s9[s, ]
      )
    ) |>
      count(y, name = "frecuencia") |>
      mutate(draw = s)
  }
)ggplot() +
geom_line(
data = freq_rep_epil_pois_s9,
aes(
x = y,
y = frecuencia,
group = draw
),
alpha = 0.15
) +
geom_point(
data = freq_obs_epil_s9,
aes(
x = y,
y = frecuencia
),
size = 2
) +
labs(
x = "Conteo de crisis; 30 representa 30 o más",
y = "Frecuencia"
) +
theme_minimal(base_size = 12)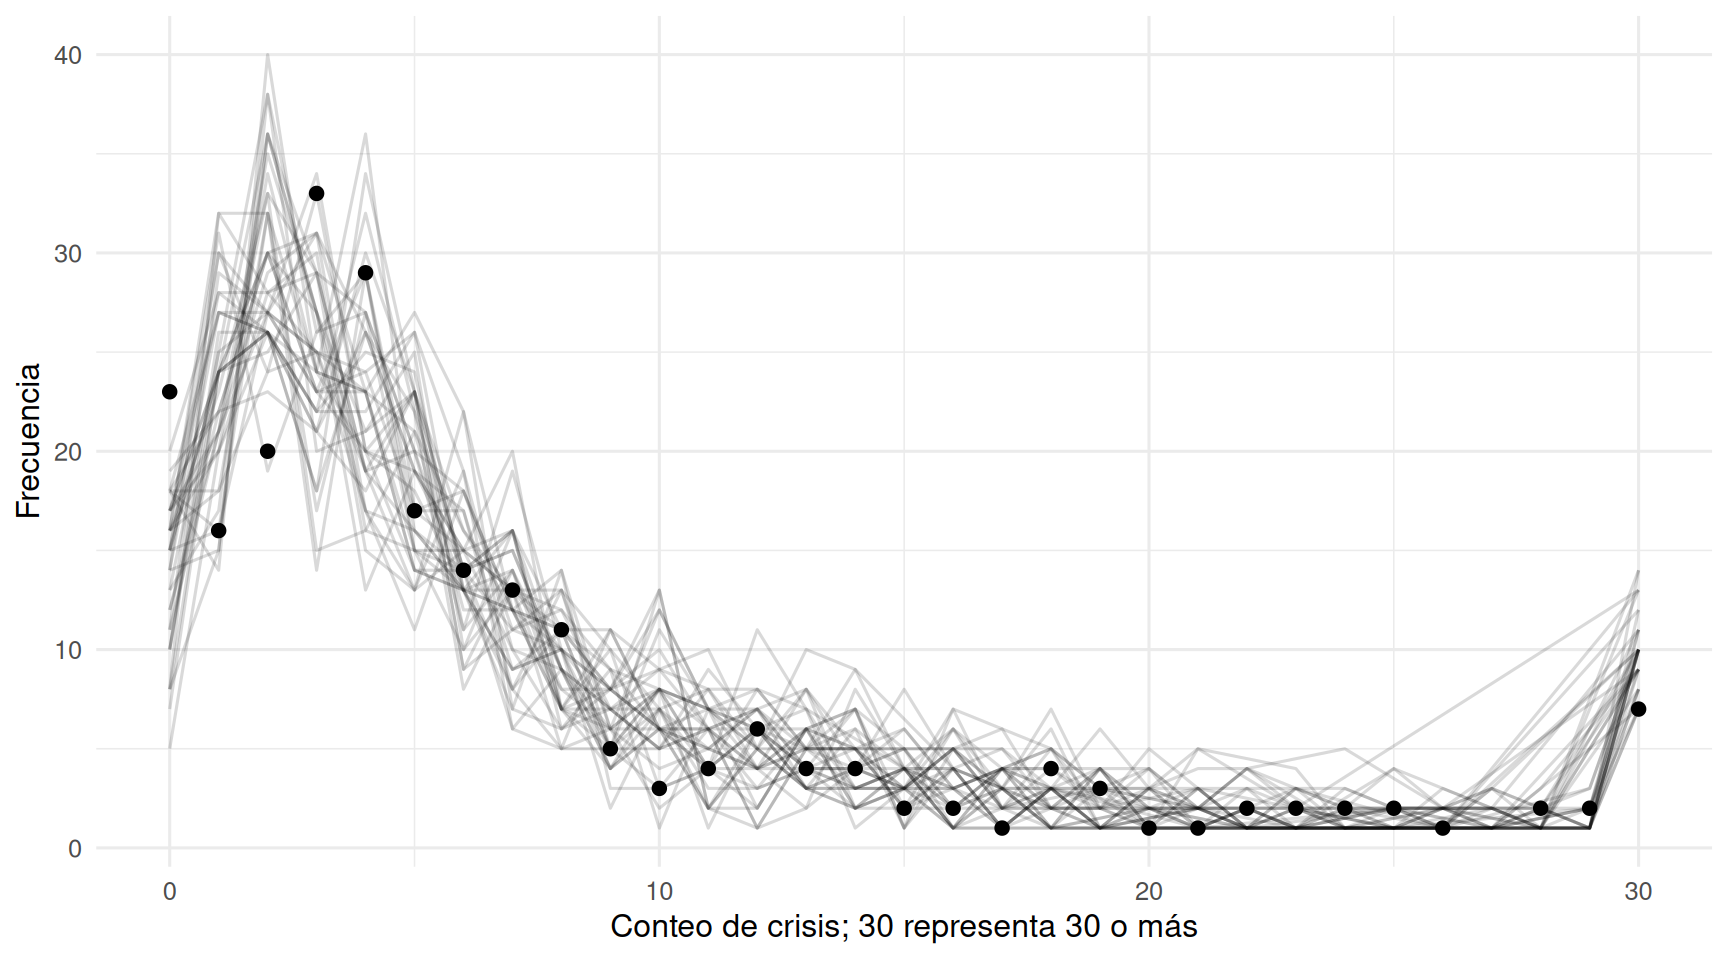
Si el Poisson produce muy pocas réplicas con colas comparables a las observadas, o no reproduce simultáneamente ceros y valores altos, existe evidencia predictiva para expandir la distribución observacional.
9.24 Ajuste binomial negativo de la aplicación
Conservaremos exactamente el mismo predictor lineal y cambiaremos únicamente la familia de respuesta:
\[ Y_{it}\mid\mu_{it},\phi \sim \operatorname{NegBin}(\mu_{it},\phi). \]
Esta estrategia permite atribuir las diferencias entre ajustes principalmente a la capa observacional, no a una modificación simultánea de muchos componentes del modelo.
fit_epil_nb_s9 <- brm(
  formula = formula_epil_s9,
  data = epil_s9,
  family = negbinomial(link = "log"),
  prior = priors_epil_nb_s9,
  backend = "cmdstanr",
  seed = 16530914,
  chains = 4,
  cores = getOption("mc.cores", 4),
  iter = 2200,
  warmup = 1100,
  control = list(
    adapt_delta = 0.95,
    max_treedepth = 12
  ),
  refresh = 0,
  file = file.path(
    "_fits",
    "s9_epil_negbinomial_cmdstanr"
  ),
  file_refit = "on_change"
)
9.25 Diagnóstico computacional de la binomial negativa
posterior::summarise_draws(
  as_draws_df(fit_epil_nb_s9),
  "mean", "sd", "rhat", "ess_bulk", "ess_tail"
) |>
  filter(
    str_detect(variable, "^(b_|sd_|shape)")
  )
# A tibble: 7 × 6
variable mean sd rhat ess_bulk ess_tail
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 b_Intercept 1.88 0.122 1.00 1545. 2644.
2 b_tratamiento -0.293 0.147 1.00 1445. 2142.
3 b_log_base_c 0.980 0.104 1.00 1318. 2236.
4 b_periodo_c -0.0537 0.0344 1.00 5175. 2832.
5 b_edad_z 0.0598 0.0803 1.00 1249. 2138.
6 sd_subject__Intercept 0.509 0.0677 1.00 1385. 2539.
7 shape 6.99 1.53 1.000 4403. 3434.nuts_epil_nb_s9 <- brms::nuts_params(
fit_epil_nb_s9
)
nuts_epil_nb_s9 |>
summarise(
divergencias = sum(
Parameter == "divergent__" & Value == 1
),
profundidad_maxima = max(
Value[Parameter == "treedepth__"]
)
) divergencias profundidad_maxima
1 0 6mcmc_trace(
as.array(fit_epil_nb_s9),
pars = c(
"b_Intercept",
"b_tratamiento",
"b_log_base_c",
"sd_subject__Intercept",
"shape"
)
)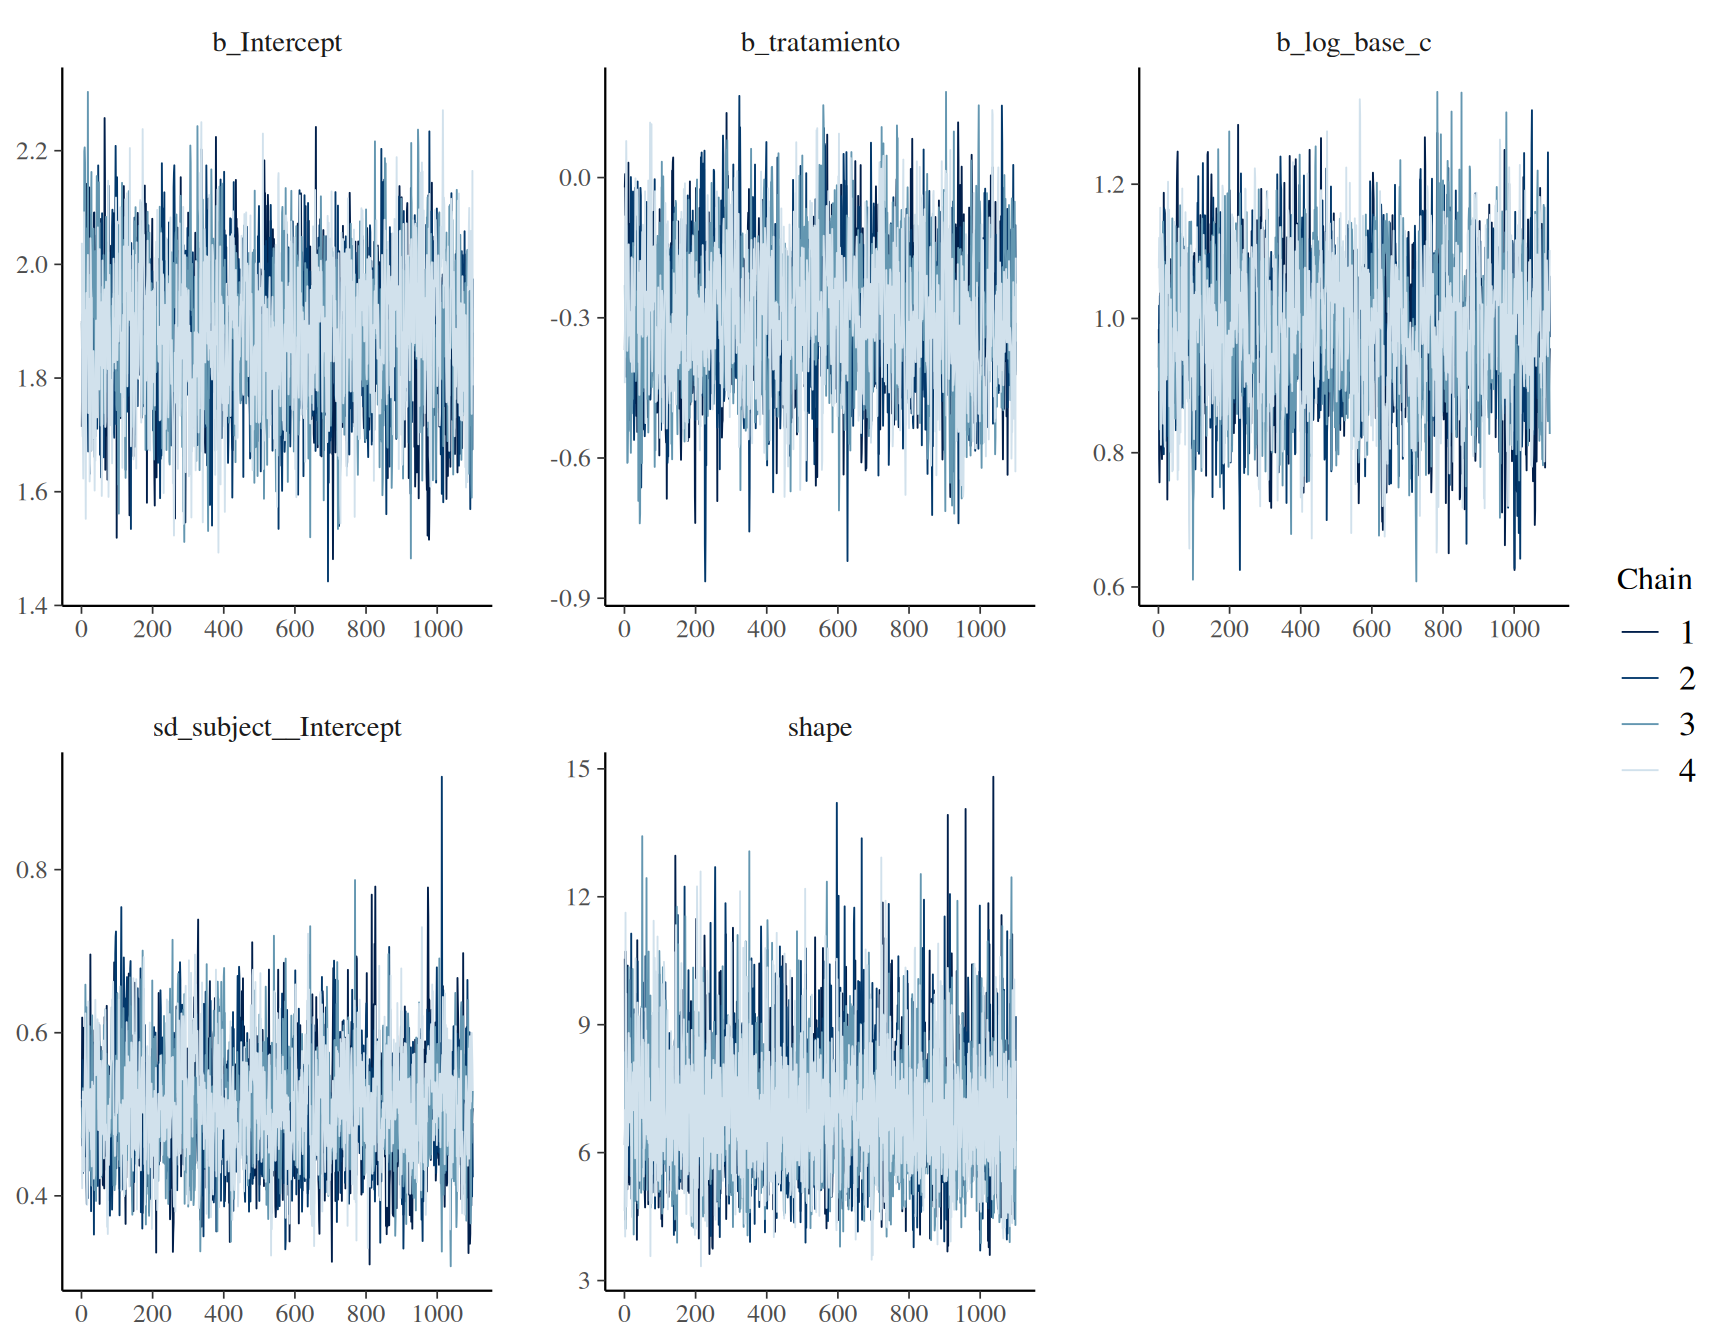
La incorporación de shape aumenta la flexibilidad estadística, pero también añade una dimensión que debe ser explorada correctamente por HMC. Una mejora predictiva no compensa un ajuste computacional deficiente.
9.26 Comprobación predictiva: Poisson frente a binomial negativa
set.seed(16530915)

yrep_epil_nb_s9 <- posterior_predict(
  fit_epil_nb_s9,
  ndraws = 600
)

ppc_epil_nb_s9 <- resumen_ppc_s9(
  y_obs = epil_s9$y,
  yrep = yrep_epil_nb_s9
)plot_ppc_resumen_s9(ppc_epil_nb_s9)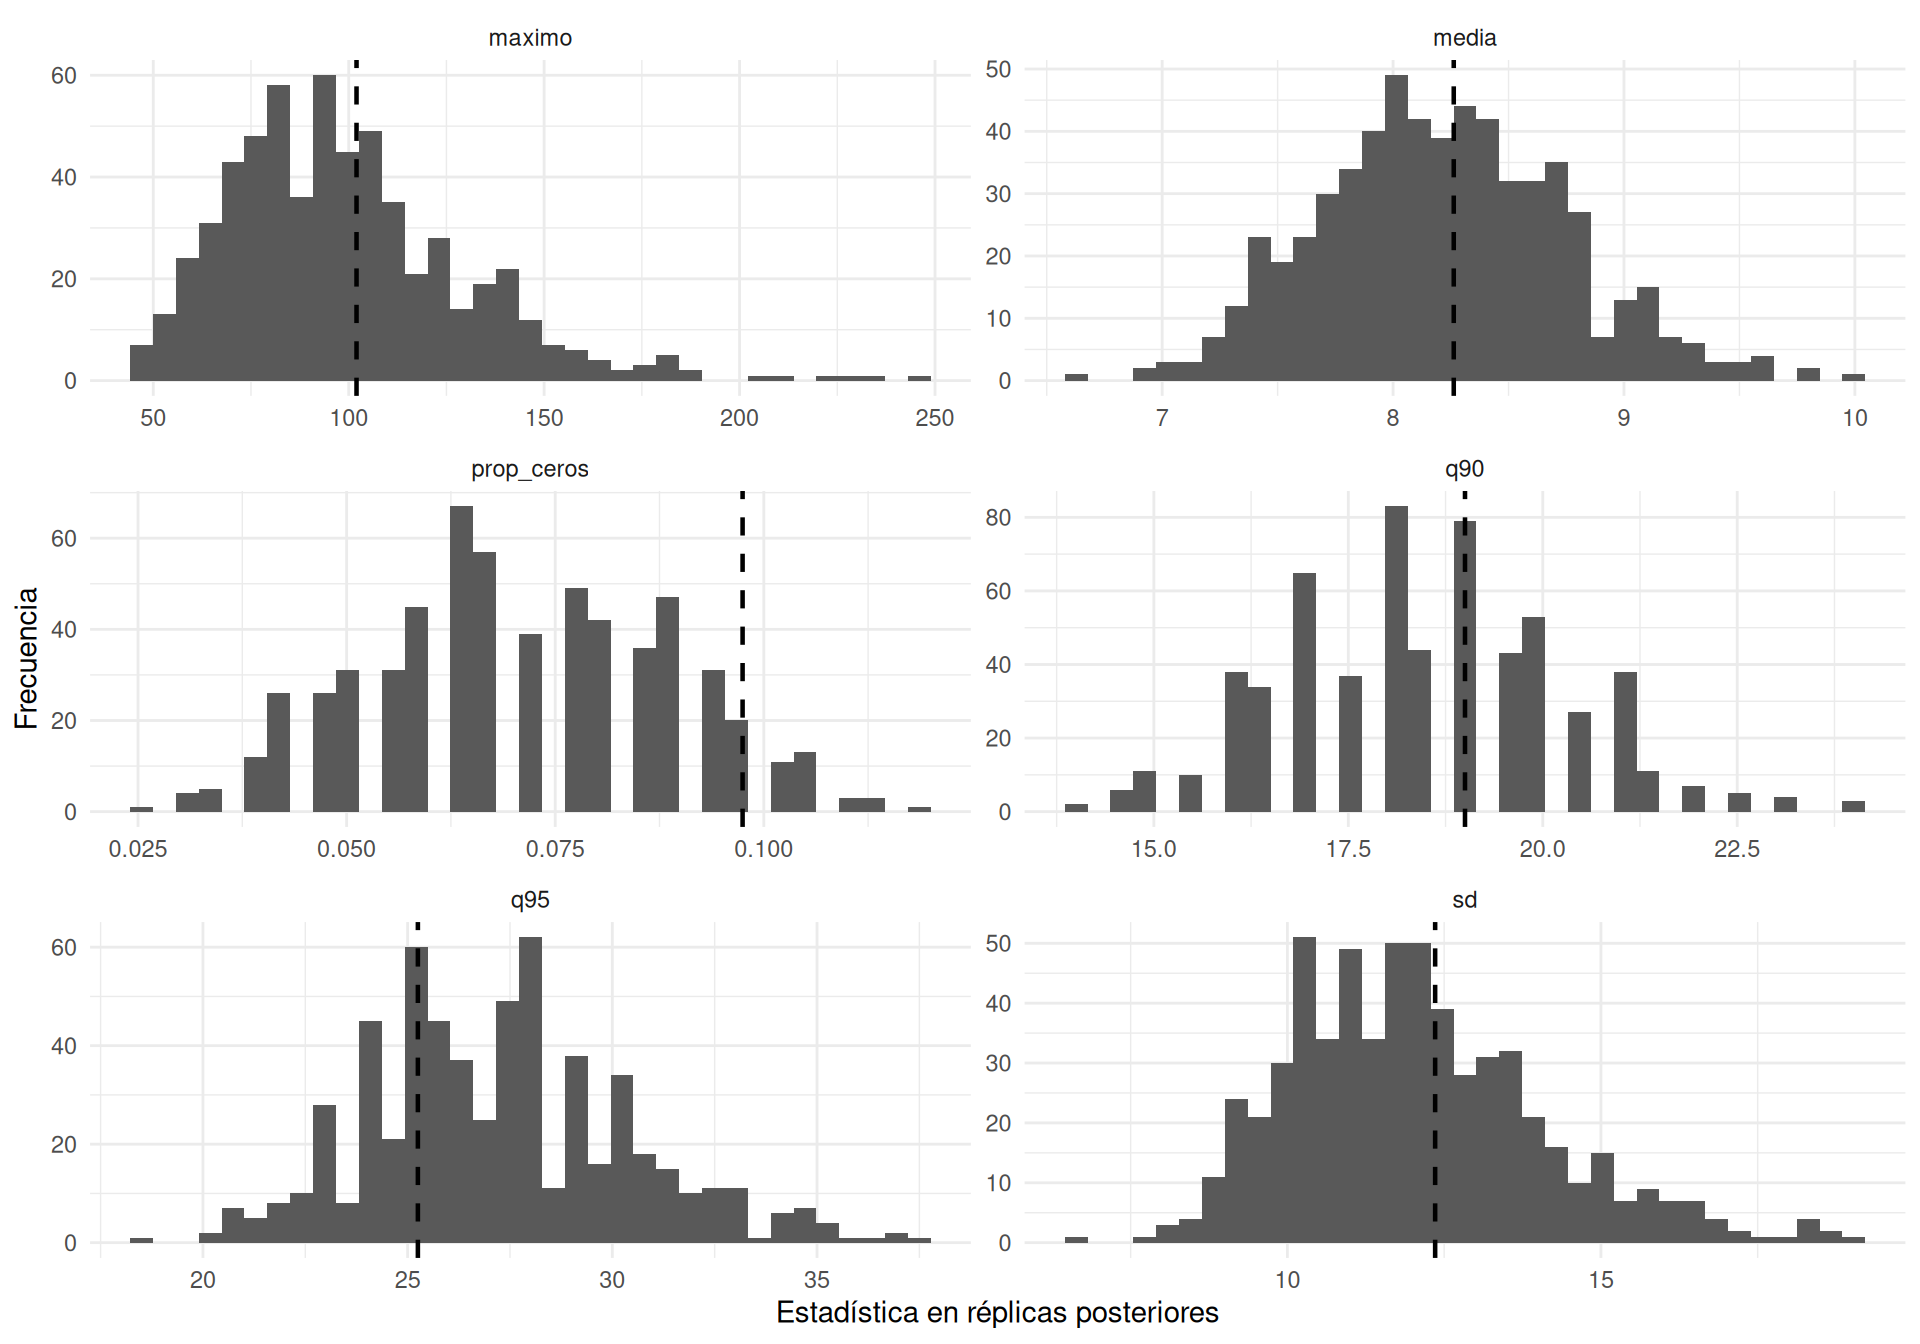
Comparemos directamente cuatro características especialmente importantes en conteos.
ppc_comparar_epil_s9 <- bind_rows(
  ppc_epil_pois_s9$replicado |>
    mutate(modelo = "Poisson"),
  ppc_epil_nb_s9$replicado |>
    mutate(modelo = "Binomial negativa")
) |>
  filter(
    estadistica %in% c(
      "sd",
      "prop_ceros",
      "q95",
      "maximo"
    )
  )

obs_ppc_epil_s9 <- ppc_epil_nb_s9$observado |>
  filter(
    estadistica %in% c(
      "sd",
      "prop_ceros",
      "q95",
      "maximo"
    )
  )
ppc_comparar_epil_s9 |>
ggplot(aes(x = replicado)) +
geom_histogram(bins = 30) +
geom_vline(
data = obs_ppc_epil_s9,
aes(xintercept = observado),
linewidth = 0.8,
linetype = 2,
inherit.aes = FALSE
) +
facet_grid(
modelo ~ estadistica,
scales = "free"
) +
labs(
x = "Valor en réplicas posteriores",
y = "Frecuencia"
) +
theme_minimal(base_size = 11)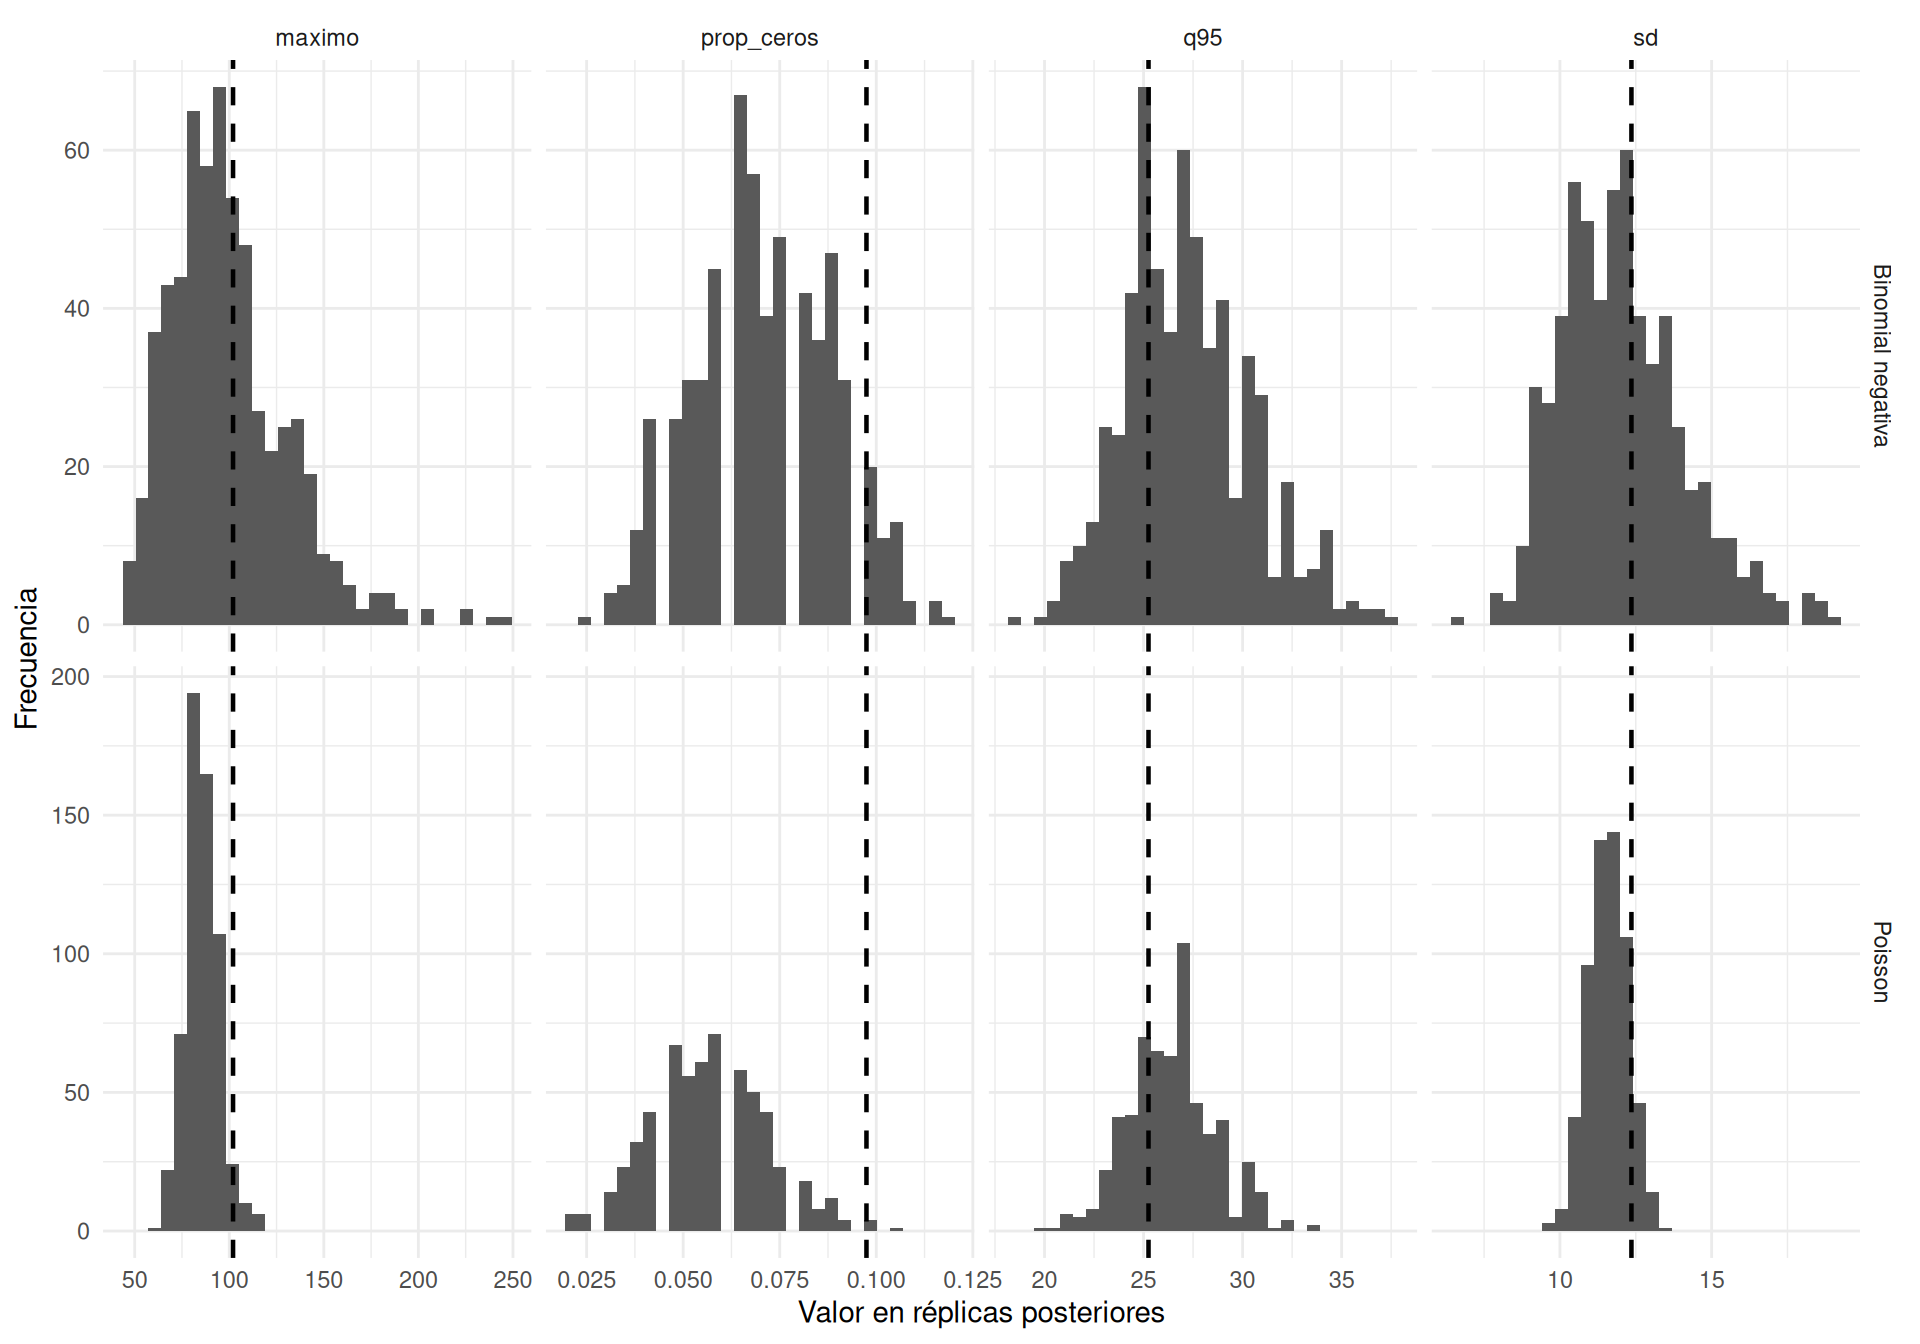
Este procedimiento sigue el principio que Bayesian Workflow ilustra con los datos de cucarachas: antes de confiar en coeficientes aparentemente precisos, debemos comprobar si el modelo reproduce la dispersión observada. En ese estudio, el Poisson produce réplicas claramente demasiado concentradas y la binomial negativa mejora sustancialmente la adecuación predictiva (Gelman et al. 2026, chap. 24).
No calculamos todavía PSIS-LOO para seleccionar un ganador. La comparación predictiva formal se desarrollará en la semana 14. En esta semana la prioridad es decidir si una expansión de la familia está justificada por discrepancias concretas del modelo.
9.27 Comprobación predictiva por persona
Una comprobación global puede ocultar fallas dentro de grupos. Para cada persona calcularemos el total observado de crisis a través de los períodos y lo compararemos con la distribución predictiva del total bajo la binomial negativa.
indices_sujeto_s9 <- split(
  seq_len(nrow(epil_s9)),
  epil_s9$subject
)

ppc_sujeto_s9 <- map_dfr(
  names(indices_sujeto_s9),
  function(s) {
    idx <- indices_sujeto_s9[[s]]
    total_rep <- rowSums(
      yrep_epil_nb_s9[, idx, drop = FALSE]
    )

    tibble(
      subject = s,
      observado = sum(epil_s9$y[idx]),
      mediana = median(total_rep),
      q10 = quantile(total_rep, 0.10),
      q90 = quantile(total_rep, 0.90)
    )
  }
) |>
  arrange(observado) |>
  mutate(
    subject = factor(subject, levels = subject)
  )
ppc_sujeto_s9 |>
ggplot(aes(x = subject)) +
geom_linerange(
aes(
ymin = q10,
ymax = q90
)
) +
geom_point(
aes(y = mediana),
shape = 1,
size = 2
) +
geom_point(
aes(y = observado),
size = 1.8
) +
coord_flip() +
labs(
x = "Persona",
y = "Total de crisis en los períodos observados"
) +
theme_minimal(base_size = 11)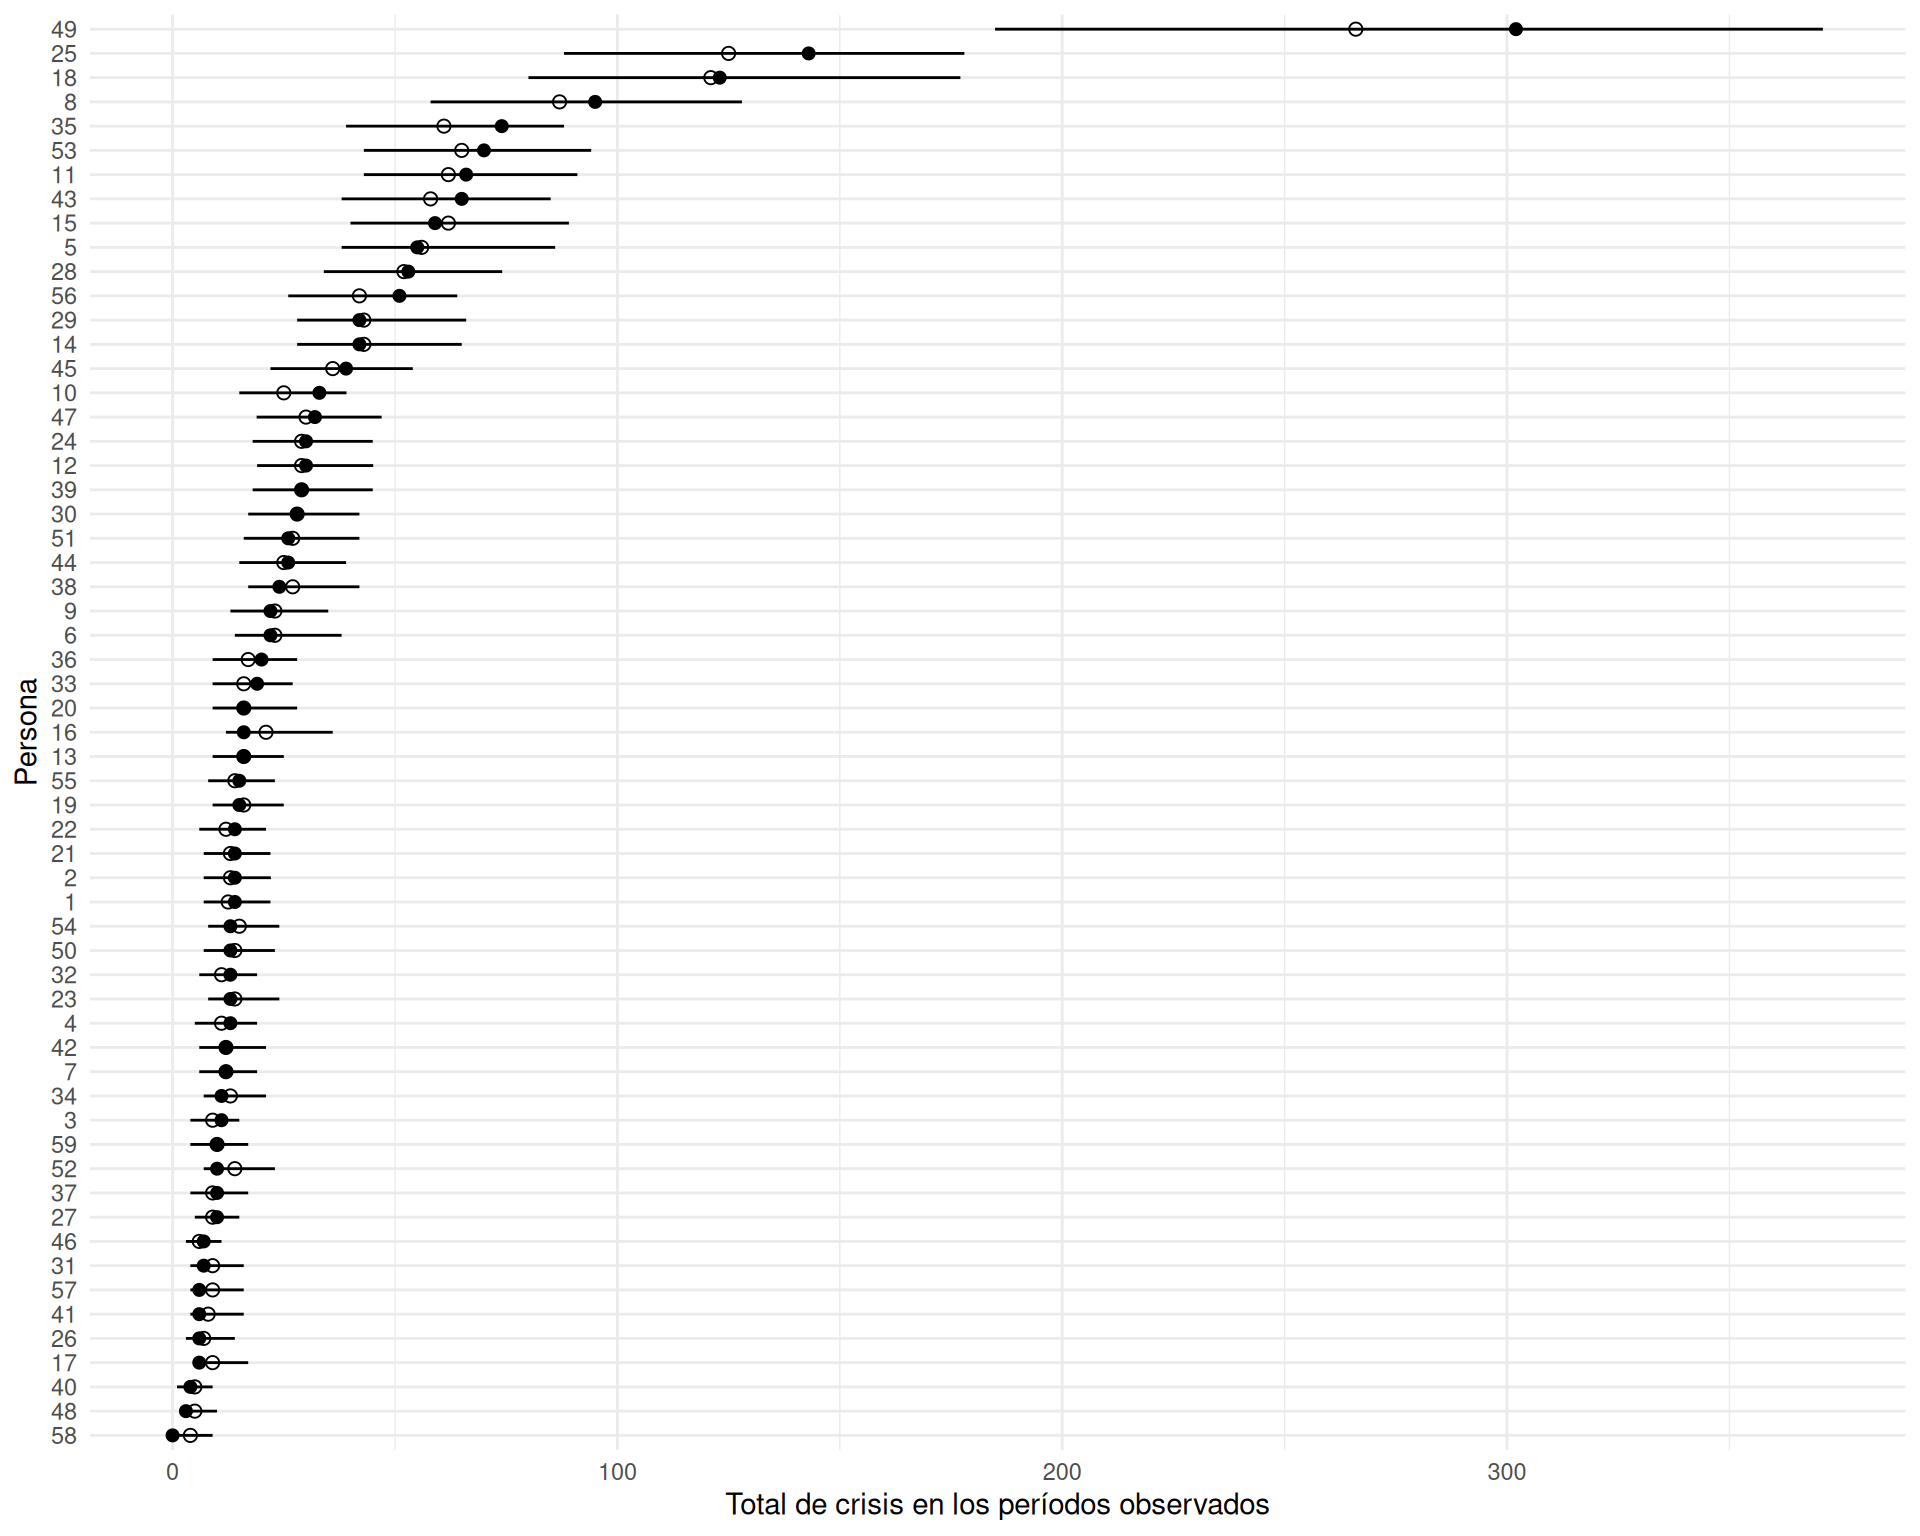
Una persona fuera de su intervalo predictivo no debe eliminarse automáticamente. El gráfico ayuda a localizar dónde falla el modelo y a preguntarnos si existe estructura adicional: heterogeneidad de pendientes temporales, dependencia residual, covariables omitidas o una familia todavía insuficiente.
9.28 Interpretación posterior de la aplicación
Extraeremos cantidades que tienen una interpretación directa como razones de tasas.
draws_epil_nb_s9 <- as_draws_df(
  fit_epil_nb_s9
)

cantidades_epil_s9 <- draws_epil_nb_s9 |>
  transmute(
    rr_tratamiento = exp(b_tratamiento),
    rr_doblar_baseline = exp(
      b_log_base_c * log(2)
    ),
    rr_periodo = exp(b_periodo_c),
    rr_edad_1sd = exp(b_edad_z),
    sd_log_tasa_sujeto = sd_subject__Intercept,
    shape = shape
  )

resumen_cantidades_epil_s9 <- cantidades_epil_s9 |>
  pivot_longer(
    everything(),
    names_to = "cantidad",
    values_to = "valor"
  ) |>
  group_by(cantidad) |>
  summarise(
    mediana = median(valor),
    q10 = quantile(valor, 0.10),
    q90 = quantile(valor, 0.90),
    .groups = "drop"
  )

resumen_cantidades_epil_s9
# A tibble: 6 × 4
cantidad mediana q10 q90
<chr> <dbl> <dbl> <dbl>
1 rr_doblar_baseline 1.98 1.80 2.16
2 rr_edad_1sd 1.06 0.956 1.18
3 rr_periodo 0.948 0.907 0.990
4 rr_tratamiento 0.746 0.618 0.900
5 sd_log_tasa_sujeto 0.504 0.427 0.597
6 shape 6.81 5.19 8.98 Las interpretaciones son:
rr_tratamiento: multiplicador de la tasa esperada al pasar del nivel de referencia al tratamiento activo, manteniendo constantes los demás predictores y el intercepto individual;rr_doblar_baseline: multiplicador asociado con duplicar el conteo basal, porque un duplicamiento cambia \(\log(\text{base})\) en \(\log 2\);rr_periodo: multiplicador de la tasa por una unidad adicional del período bajo la tendencia lineal especificada;rr_edad_1sd: multiplicador asociado con una desviación estándar adicional de edad;sd_log_tasa_sujeto: heterogeneidad residual entre personas en la escala log de la tasa;shape: parámetro de dispersión de la binomial negativa.
ImportanteNo interprete
shape como una desviación estándar
En la parametrización utilizada,
\[ \operatorname{Var}(Y\mid\mu,\phi) = \mu+\mu^2/\phi. \]
El efecto de \(\phi\) depende de \(\mu\). Por eso es más informativo examinar distribuciones predictivas que intentar convertir shape en una única “cantidad de ruido” independiente de la media.
9.28.1 Curvas esperadas para perfiles sustantivos
Construiremos predicciones con los efectos grupales fijados en cero para visualizar el componente poblacional del predictor. Recordemos que esto no incorpora la variación entre personas.
rango_base_s9 <- range(epil_s9$base)

newdata_curvas_s9 <- crossing(
  base = exp(
    seq(
      log(rango_base_s9[1]),
      log(rango_base_s9[2]),
      length.out = 80
    )
  ),
  tratamiento = c(0L, 1L)
) |>
  mutate(
    log_base_c = log(base) - mean(log(epil_s9$base)),
    periodo_c = 0,
    edad_z = 0,
    subject = levels(epil_s9$subject)[1]
  )

mu_curvas_epil_s9 <- posterior_epred(
  fit_epil_nb_s9,
  newdata = newdata_curvas_s9,
  re_formula = NA
)

resumen_curvas_epil_s9 <- newdata_curvas_s9 |>
  mutate(
    mediana = apply(mu_curvas_epil_s9, 2, median),
    q10 = apply(mu_curvas_epil_s9, 2, quantile, probs = 0.10),
    q90 = apply(mu_curvas_epil_s9, 2, quantile, probs = 0.90),
    tratamiento = factor(
      tratamiento,
      levels = c(0, 1),
      labels = c(ref_trt_s9, activo_trt_s9)
    )
  )
resumen_curvas_epil_s9 |>
ggplot(
aes(
x = base,
y = mediana,
linetype = tratamiento
)
) +
geom_ribbon(
aes(
ymin = q10,
ymax = q90,
group = tratamiento
),
alpha = 0.15
) +
geom_line(linewidth = 0.9) +
scale_x_log10() +
labs(
x = "Conteo basal, escala logarítmica",
y = "Conteo esperado",
linetype = "Tratamiento"
) +
theme_minimal(base_size = 12)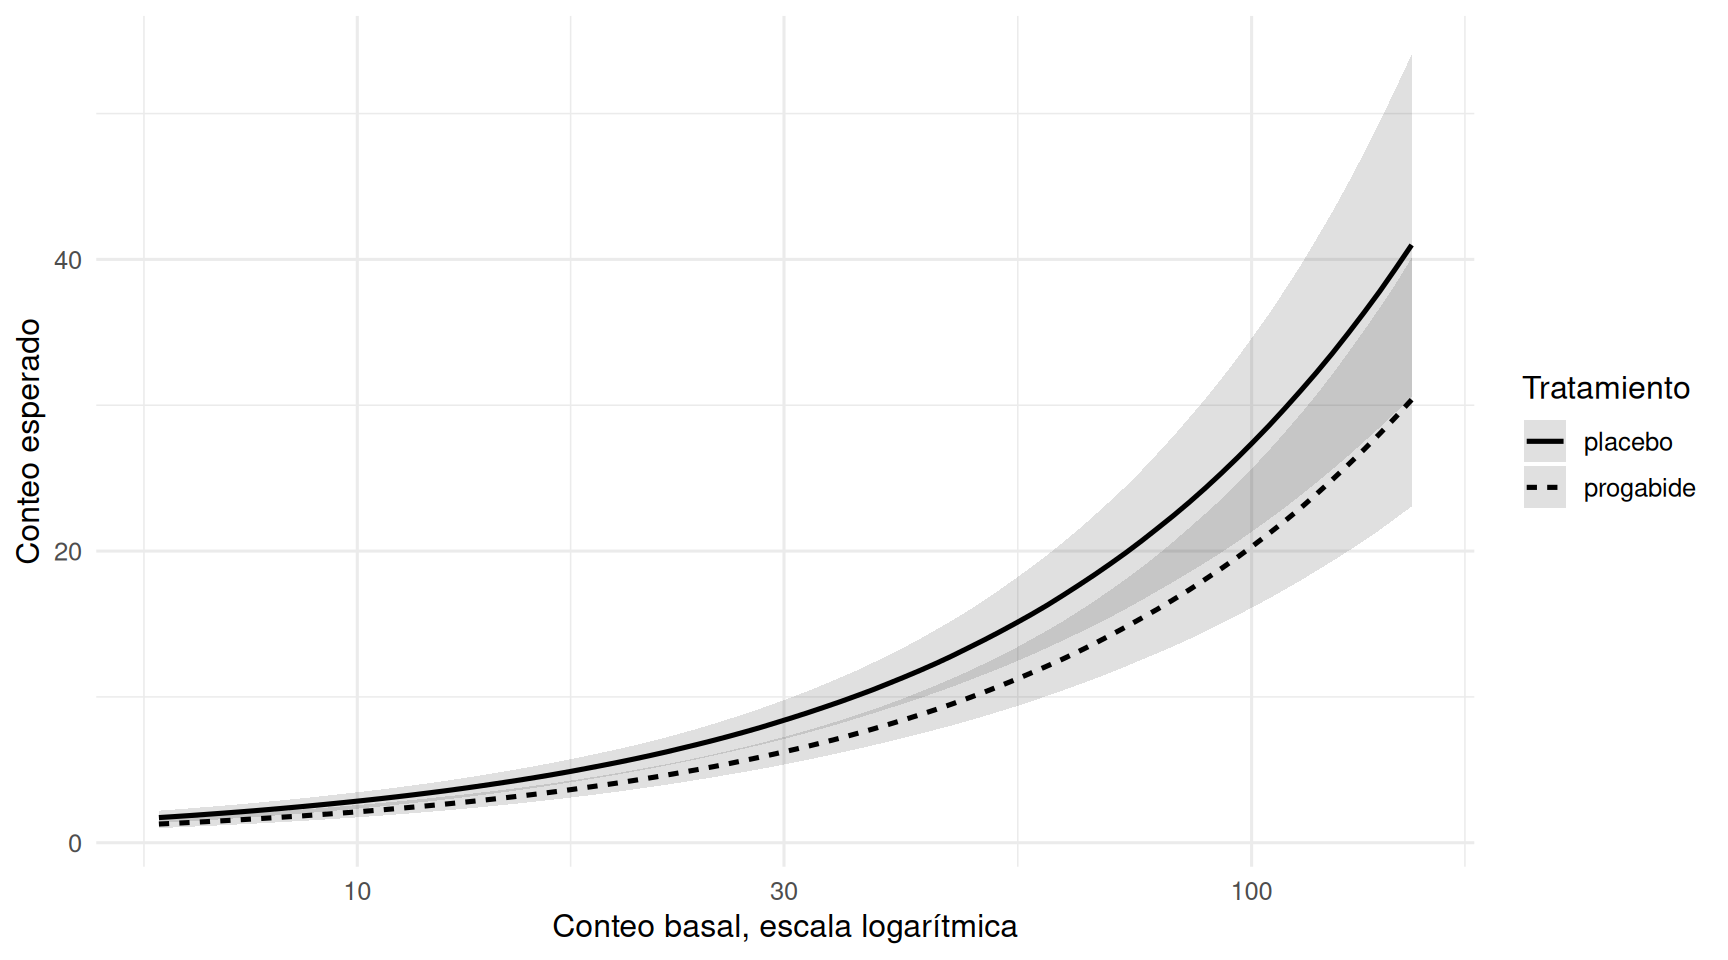
La figura comunica la magnitud del efecto en la escala de conteos, no solamente como un coeficiente en log-tasa.
9.29 Predicción para una persona existente y una persona nueva
Tomaremos un perfil con predictores centrados y nivel de referencia del tratamiento.
sujeto_existente_s9 <- levels(epil_s9$subject)[1]

perfil_existente_s9 <- tibble(
  tratamiento = 0L,
  log_base_c = 0,
  periodo_c = 0,
  edad_z = 0,
  subject = sujeto_existente_s9
)

perfil_nuevo_s9 <- tibble(
  tratamiento = 0L,
  log_base_c = 0,
  periodo_c = 0,
  edad_z = 0,
  subject = "nuevo_sujeto"
)
La distribución predictiva para una nueva observación de una persona existente utiliza la posterior de su intercepto:
set.seed(16530916)

pred_existente_s9 <- posterior_predict(
  fit_epil_nb_s9,
  newdata = perfil_existente_s9,
  re_formula = NULL,
  ndraws = 3000
)[, 1]
Para una persona nueva debemos simular un intercepto desde la distribución grupal:
set.seed(16530917)

pred_nuevo_s9 <- posterior_predict(
  fit_epil_nb_s9,
  newdata = perfil_nuevo_s9,
  re_formula = NULL,
  allow_new_levels = TRUE,
  sample_new_levels = "gaussian",
  ndraws = 3000
)[, 1]
Como referencia adicional calculamos una predicción con el intercepto grupal fijado en cero.
set.seed(16530918)

pred_u0_s9 <- posterior_predict(
  fit_epil_nb_s9,
  newdata = perfil_existente_s9,
  re_formula = NA,
  ndraws = 3000
)[, 1]

pred_tipos_epil_s9 <- bind_rows(
  tibble(
    tipo = "Persona existente",
    y_pred = pred_existente_s9
  ),
  tibble(
    tipo = "Efecto grupal fijado en 0",
    y_pred = pred_u0_s9
  ),
  tibble(
    tipo = "Persona nueva",
    y_pred = pred_nuevo_s9
  )
)
pred_tipos_epil_s9 |>
group_by(tipo) |>
summarise(
media = mean(y_pred),
mediana = median(y_pred),
q10 = quantile(y_pred, 0.10),
q90 = quantile(y_pred, 0.90),
prop_cero = mean(y_pred == 0),
.groups = "drop"
)# A tibble: 3 × 6
tipo media mediana q10 q90 prop_cero
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Efecto grupal fijado en 0 6.60 6 2 12 0.015
2 Persona existente 7.65 7 2 14 0.0113
3 Persona nueva 7.47 6 2 15 0.023 La predicción para una persona nueva incluye incertidumbre por la heterogeneidad entre personas. Este es el análogo de la distinción entre grupos existentes y nuevos desarrollada en semanas anteriores.
9.30 Introducción a modelos con exceso de ceros
Una distribución de conteos puede presentar muchos ceros por varias razones:
- la tasa ordinaria del proceso es pequeña;
- existe heterogeneidad de tasas y algunas unidades tienen tasas muy pequeñas;
- la binomial negativa produce más variación, incluyendo más ceros y colas más amplias;
- existe un proceso adicional que produce ceros estructurales.
Solo la cuarta explicación motiva directamente un modelo cero-inflado.
9.30.1 Estructura de un Poisson cero-inflado
Supongamos que con probabilidad \(\pi_i\) una unidad entra en un estado que produce necesariamente un cero. Con probabilidad \(1-\pi_i\) participa en el proceso de conteo Poisson con media \(\mu_i\).
Entonces
\[ \Pr(Y_i=0) = \pi_i+(1-\pi_i)e^{-\mu_i}, \]
mientras para \(y>0\),
\[ \Pr(Y_i=y) = (1-\pi_i) \frac{\mu_i^y e^{-\mu_i}}{y!}. \tag{9.13}\]
Podemos tener dos predictores:
\[ \operatorname{logit}(\pi_i) = \eta_i^{(0)}, \]
\[ \log(\mu_i) = \eta_i^{(c)}. \]
Los predictores no tienen que ser los mismos. McElreath utiliza esta formulación para mostrar que un cero puede surgir de dos procesos distintos, mientras Hox et al. presentan la misma idea como una mezcla entre una clase que produce ceros estructurales y un proceso de conteo (McElreath 2020, sec. 12.2; Hox et al. 2018, 144-45).
AdvertenciaMuchos ceros no equivalen a cero-inflación
Antes de usar zero_inflated_poisson() o zero_inflated_negbinomial() debemos poder explicar qué mecanismo adicional produce los ceros estructurales. Si una binomial negativa o una estructura multinivel reproduce adecuadamente la frecuencia de ceros, añadir una mezcla cero-inflada puede ser innecesario y débilmente identificado.
Los modelos hurdle y otras familias con ceros especiales se retomarán como extensiones en la semana 10.
9.31 Una nota sobre la formulación Poisson-lognormal
Gelman y Hill y BDA presentan otra forma de representar sobredispersión: añadir un término normal específico de cada observación en la escala log,
\[ Y_i\sim\operatorname{Poisson}(\mu_i), \]
\[ \log(\mu_i) = \eta_i+\epsilon_i, \]
\[ \epsilon_i\sim\mathcal N(0,\sigma_\epsilon^2). \tag{9.14}\]
Esta formulación produce una mezcla Poisson-lognormal, mientras la binomial negativa es una mezcla gamma–Poisson. Ambas permiten varianza adicional, pero sus distribuciones de mezcla y comportamiento de colas no son idénticos (Gelman y Hill 2007, sec. 15.1; Gelman et al. 2013, secs. 16.4, 17.2).
La comparación es útil conceptualmente: “sobredispersión” describe un problema de adecuación, no una única distribución correctiva.
9.32 Conexión con el enfoque frecuentista
La literatura clásica utiliza varias estrategias para sobredispersión Poisson:
- errores estándar robustos;
- quasi-Poisson;
- factores de dispersión;
- Poisson con efectos aleatorios;
- binomial negativa;
- modelos cero-inflados.
Gelman y Hill muestran un factor de sobredispersión basado en residuos estandarizados y luego discuten modelos Poisson sobredispersos y binomial negativos (Gelman y Hill 2007, 114-16). Hox et al. presentan comparaciones mediante deviance, AIC y BIC (Hox et al. 2018, 142-45).
En este curso la conexión se utiliza para leer esa literatura, pero el flujo principal será diferente. Una corrección quasi-Poisson ajusta la relación entre media y varianza para la inferencia frecuentista, pero no especifica una distribución de probabilidad completa para generar nuevos conteos. Para comprobación predictiva bayesiana necesitamos una distribución observacional explícita.
Por ello preferiremos formular y simular modelos probabilísticos completos, como Poisson multinivel, binomial negativa o mezclas justificadas por el mecanismo.
9.33 Errores frecuentes
9.33.1 Error 1: usar la varianza muestral bruta para descartar Poisson
La igualdad media–varianza es condicional. Predictores, exposiciones y efectos grupales distintos producen una mezcla marginal sobredispersa aun cuando el modelo condicional sea Poisson.
9.33.2 Error 2: modelar conteos sin revisar la exposición
Si los períodos o cantidades observadas son diferentes, el conteo bruto mezcla tasa y exposición. Omitir el offset puede producir asociaciones espurias o trasladar variación al componente grupal.
9.33.3 Error 3: interpretar \(\beta\) como un cambio aditivo en conteos
Con enlace log,
\[ \exp(\beta) \]
es un multiplicador de la media o tasa, no una diferencia absoluta.
9.33.4 Error 4: suponer que binomial negativa sustituye la estructura multinivel
La binomial negativa modela heterogeneidad adicional entre observaciones. Un intercepto variable representa similitud entre observaciones del mismo grupo. Son componentes conceptualmente diferentes.
9.33.5 Error 5: llamar “sobredispersión” a cualquier valor extremo
Un conteo grande puede ser compatible con el modelo una vez considerados exposición, predictores y grupo. La comprobación debe evaluar la distribución predictiva completa.
9.33.6 Error 6: elegir binomial negativa solamente porque tiene mejor ajuste in-sample
Una familia más flexible puede adaptarse mejor a los datos observados. La expansión debe justificarse mediante discrepancias predictivas, interpretación sustantiva y estabilidad de la inferencia.
9.33.7 Error 7: usar un modelo cero-inflado solamente porque hay muchos ceros
Los ceros pueden ser producidos por el mismo proceso de conteo. Un componente cero-inflado requiere una hipótesis sobre un proceso adicional.
9.33.8 Error 8: utilizar previas muy amplias en la escala log sin simular
Una previa que parece poco informativa para \(\alpha\) o \(\beta\) puede generar tasas de varios órdenes de magnitud después de exponentiar.
9.33.9 Error 9: interpretar antes de revisar HMC
Una comprobación predictiva razonable no corrige divergencias, ESS muy pequeños o falta de mezcla entre cadenas. Diagnóstico computacional y diagnóstico estadístico responden preguntas diferentes.
9.33.10 Error 10: confundir conteo esperado con una observación futura
posterior_epred() resume incertidumbre sobre la media condicional. posterior_predict() añade además variación observacional. Para comunicar una observación futura necesitamos la distribución predictiva completa.
9.34 Síntesis
La semana puede resumirse en diez ideas.
- Un conteo no acotado se modela naturalmente con distribuciones de conteo, no transformando automáticamente la respuesta a una escala continua.
- En Poisson, la media y la varianza condicional son iguales.
- El enlace log mantiene positiva la media y convierte efectos aditivos en log-tasa en efectos multiplicativos sobre la tasa.
- Un offset separa exposición y tasa mediante \(\log(E_i)\) con coeficiente fijado en 1.
- Los interceptos variables representan heterogeneidad compartida por observaciones de un mismo grupo.
- La heterogeneidad grupal genera sobredispersión marginal incluso bajo una Poisson condicional.
- La sobredispersión relevante se evalúa después de incorporar la estructura que consideramos sustantivamente necesaria.
- La binomial negativa añade variación condicional mediante una mezcla de tasas y no sustituye automáticamente los efectos grupales.
- Ceros, varianza y colas deben examinarse mediante comprobaciones predictivas, no mediante un único número.
- Un modelo cero-inflado requiere una hipótesis de mezcla: algunos ceros deben poder surgir de un proceso distinto del proceso ordinario de conteo.
El hilo general permanece igual que en las semanas anteriores:
\[ \boxed{ \text{estructura del problema} \to \text{modelo probabilístico} \to \text{previas} \to \text{HMC} \to \text{comprobación predictiva} \to \text{reformulación} } \]
9.35 Ejercicios
9.35.1 Ejercicio 1. Conteo, tasa o binomial
Para cada situación indique qué cantidad constituye la respuesta, si existe una exposición relevante y cuál familia utilizaría como punto de partida. Justifique cada decisión.
- número de accidentes en cada intersección durante un año, con distinto volumen vehicular;
- número de estudiantes que aprueban de un total conocido de estudiantes matriculados en cada sección;
- número de llamadas recibidas por una central durante turnos de distinta duración;
- número de especies detectadas en parcelas con distinta superficie;
- número de respuestas correctas de 40 ítems en una prueba.
En al menos dos casos proponga una situación en la que la familia inicial dejaría de ser adecuada.
9.35.2 Ejercicio 2. Interpretación del enlace log
Considere
\[ Y_i\sim\operatorname{Poisson}(\mu_i), \]
\[ \log(\mu_i) = \log(E_i)-1.2+0.35x_i. \]
- Interprete \(\exp(-1.2)\).
- Interprete \(\exp(0.35)\).
- Compare el conteo esperado para dos unidades con el mismo \(x\) pero exposiciones 2 y 5.
- Compare la tasa esperada de esas dos unidades.
- Explique por qué sería incorrecto afirmar que \(0.35\) representa 0.35 eventos adicionales.
9.35.3 Ejercicio 3. Derivación del offset
Suponga que \(r_i\) es una tasa por unidad de exposición y
\[ \log(r_i)=\alpha+\beta x_i. \]
Si
\[ \mu_i=E_i r_i, \]
demuestre que
\[ \log(\mu_i) = \log(E_i)+\alpha+\beta x_i. \]
Después explique qué supuesto adicional introduciríamos si en lugar de un offset ajustáramos
\[ \log(\mu_i) = \alpha+\gamma\log(E_i)+\beta x_i. \]
¿Qué significa \(\gamma=0.7\) en términos de cómo escala el conteo esperado al duplicar la exposición?
9.35.4 Ejercicio 4. Sobredispersión marginal en un Poisson multinivel
Considere
\[ Y_{ij}\mid u_j \sim \operatorname{Poisson}\{\exp(\eta_{ij}+u_j)\}, \]
\[ u_j\sim\mathcal N(0,\tau^2). \]
Utilice las propiedades de la lognormal para derivar
\[ E(Y_{ij}) = \exp(\eta_{ij}+\tau^2/2). \]
Utilice la ley de varianza total para demostrar Ecuación 9.9.
Explique por qué una varianza marginal mayor que la media no demuestra que la familia condicional Poisson sea incorrecta.
Interprete qué ocurre con la dispersión marginal cuando \(\tau\to0\).
9.35.5 Ejercicio 5. Diferenciar fuentes de variación
Para cada patrón indique qué modificación del modelo investigaría primero y justifique su respuesta.
- grupos distintos presentan medias muy distintas, pero dentro de cada grupo la dispersión parece compatible con Poisson;
- después de incluir interceptos variables todavía aparecen demasiados valores extremos dentro de cada grupo;
- la frecuencia de ceros es alta, pero una binomial negativa reproduce adecuadamente tanto ceros como colas;
- existe un subgrupo de unidades que, por diseño, nunca puede experimentar el evento;
- observaciones cercanas en el tiempo muestran rachas de valores altos y bajos dentro de la misma persona.
No es necesario que exista una única respuesta correcta; se evaluará la coherencia entre diagnóstico y expansión propuesta.
9.35.6 Ejercicio 6. Simulación de la exposición
Modifique Ecuación 9.11 para que la exposición varíe entre 0.1 y 10.
- Simule 50 conjuntos de datos.
- En cada conjunto ajuste un Poisson multinivel con offset y otro sin offset.
- Compare el sesgo posterior del coeficiente de \(x\) y de la desviación estándar grupal.
- Compare las comprobaciones predictivas según quintiles de exposición.
- Explique por qué el modelo sin offset puede trasladar parte de la variación por exposición hacia otros componentes.
9.35.7 Ejercicio 7. La parametrización binomial negativa
Suponga
\[ Y\sim\operatorname{NegBin}(\mu,\phi), \]
con
\[ \operatorname{Var}(Y) = \mu+\frac{\mu^2}{\phi}. \]
- Para \(\mu=5\), calcule la varianza cuando \(\phi=0.5,2,10,100\).
- Repita para \(\mu=20\).
- Explique por qué el efecto de \(\phi\) sobre la varianza depende de \(\mu\).
- Explique el límite \(\phi\to\infty\).
- Investigue la parametrización utilizada por otro software de su elección y escriba cómo se relaciona con esta. No asuma que símbolos iguales significan parámetros iguales.
9.35.8 Ejercicio 8. Comprobaciones predictivas dirigidas
Utilice el modelo fit_epil_nb_s9.
- Proponga una estadística de discrepancia distinta de las usadas en el capítulo.
- Justifique qué característica sustantiva de los conteos evalúa.
- Calcule esa estadística para los datos observados y para al menos 500 réplicas posteriores.
- Construya una figura.
- Explique qué modificación del modelo consideraría si la discrepancia fuese clara.
9.35.9 Ejercicio 9. Predicción para una persona nueva
Con la aplicación de epilepsia:
- compare
posterior_epred()para una persona existente, parare_formula = NAy para una persona nueva; - compare luego
posterior_predict()para las mismas tres situaciones; - explique por qué la segunda comparación muestra más variabilidad;
- identifique qué fuentes de incertidumbre están presentes en cada caso;
- explique por qué fijar el intercepto grupal en cero no equivale a predecir una persona nueva.
9.35.10 Ejercicio 10. Sensibilidad a la previa de shape
Reajuste la binomial negativa de la aplicación bajo al menos tres previas defendibles para \(\phi\).
- Compare las distribuciones previas de \(\phi\).
- Compare sus implicaciones para \(\operatorname{Var}(Y\mid\mu)\) cuando \(\mu=2,5,15\).
- Compare las posteriores de \(\phi\).
- Compare la razón de tasas del tratamiento.
- Compare al menos dos comprobaciones predictivas.
- Determine si la conclusión sustantiva depende de la previa de dispersión.
9.35.11 Ejercicio 11. ¿Cero-inflado o no?
Considere dos procesos.
Proceso A. Todos los individuos pueden experimentar el evento, pero sus tasas son muy heterogéneas.
Proceso B. Una fracción de individuos no puede experimentar el evento por razones estructurales; el resto sigue un proceso de conteo.
- Explique por qué ambos procesos pueden producir muchos ceros.
- ¿Cuál motiva directamente un modelo cero-inflado?
- Escriba una formulación probabilística para cada proceso.
- Proponga datos auxiliares o conocimiento sustantivo que permitirían distinguirlos.
- Explique por qué observar un histograma con muchos ceros no identifica por sí solo el mecanismo.
9.35.12 Ejercicio 12. Crítica de una interpretación
Un informe afirma:
“El coeficiente del tratamiento en una regresión Poisson fue \(-0.30\), por lo que el tratamiento reduce 0.30 eventos en promedio. Como la varianza observada es mayor que la media, el Poisson queda descartado. Al cambiar a binomial negativa, ya no es necesario incluir interceptos por hospital porque la sobredispersión corrige la dependencia.”
Redacte una crítica técnica que:
- corrija la interpretación de \(-0.30\);
- explique por qué la comparación media–varianza marginal no basta para descartar Poisson;
- distinga sobredispersión de dependencia intragrupal;
- proponga al menos dos comprobaciones predictivas relevantes;
- indique qué información adicional necesitaría antes de recomendar una familia.
9.35.13 Ejercicio 13. Crítica de una recomendación de IA
Una herramienta de IA produce la recomendación:
“Para conteos use siempre Poisson. Si la varianza es mayor que la media, cambie automáticamente a binomial negativa. Si hay más de 20% de ceros, use un modelo cero-inflado. Los offsets son opcionales porque el modelo puede absorber la duración de observación mediante el intercepto.”
Escriba una respuesta de no más de 300 palabras que:
- identifique al menos cinco errores conceptuales;
- explique el papel de la exposición;
- distinga dispersión marginal y condicional;
- explique por qué una regla basada en el porcentaje de ceros no identifica cero-inflación;
- proponga un flujo bayesiano más defendible.
9.35.14 Ejercicio 14. Diseño de una comprobación por exposición
Suponga que se modelan accidentes con exposición igual al número de vehículos que pasan por una intersección.
- Divida conceptualmente las observaciones en grupos de exposición baja, media y alta.
- Proponga una comprobación predictiva posterior para cada estrato.
- Explique qué patrón sugeriría que la proporcionalidad implícita en el offset es inadecuada.
- Escriba una expansión del modelo en la que el coeficiente de \(\log(E)\) sea estimado.
- Explique por qué esa expansión cambia la pregunta científica.
9.36 Referencias de la semana
Las lecturas centrales para esta unidad son:
- Gelman y Hill, Data Analysis Using Regression and Multilevel/Hierarchical Models, sección 6.2 para Poisson, interpretación, exposición y sobredispersión; sección 15.1 para modelos Poisson multinivel y sobredispersión como componente adicional (Gelman y Hill 2007, secs. 6.2, 15.1).
- McElreath, Statistical Rethinking, sección 11.2 para Poisson, enlace log, previas y offsets; secciones 12.1–12.2 para binomial negativa/gamma–Poisson, sobredispersión y modelos cero-inflados (McElreath 2020, secs. 11.2, 12.1-12.2).
- Hox, Moerbeek y van de Schoot, Multilevel Analysis, sección 7.2 para Poisson multinivel, exposición, sobredispersión, binomial negativa y exceso de ceros (Hox et al. 2018, sec. 7.2).
- Gelman et al., Bayesian Data Analysis, sección 16.4 para regresión Poisson jerárquica y sección 17.2 para distribuciones sobredispersas y la interpretación de la binomial negativa como mezcla (Gelman et al. 2013, secs. 16.4, 17.2).
- Gelman et al., Bayesian Workflow, capítulo 24 para el flujo Poisson → comprobación predictiva → binomial negativa → extensiones en datos de conteo con exposición (Gelman et al. 2026, chap. 24).
- Bürkner para la implementación de familias Poisson, binomial negativa y familias con exceso de ceros en modelos multinivel con
brms(Bürkner 2017).