14Semana 14. Comparación de modelos, validación y sensibilidad
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
9 de noviembre de 2026
14.1 Panorama de la semana
En la semana 13 distinguimos el diagnóstico computacional de la comprobación de las implicaciones estadísticas de un modelo. Mostramos, mediante datos binarios agrupados por centro, que un modelo con una pendiente común puede ajustar razonablemente algunas frecuencias globales y, al mismo tiempo, representar de manera insuficiente la heterogeneidad de las asociaciones entre centros. También aprendimos a comunicar contrastes en la escala de probabilidad, diferenciando centros existentes y centros nuevos.
Esta semana damos un paso adicional: examinar qué ocurre cuando una especificación debe predecir datos que no participaron en su ajuste. A partir de ello podremos comparar modelos y estudiar cuánto dependen nuestras conclusiones de las decisiones de modelación.
Pregunta orientadora. ¿Qué significa que un modelo sea preferible a otro y en qué condiciones son estables sus conclusiones?
Un modelo puede ser preferible para explicar una asociación, otro puede ofrecer predicciones más estables en centros conocidos y un tercero puede representar mejor la heterogeneidad de centros nuevos. No existe una regla de selección universal independiente del objetivo del análisis. Para ordenar esta discusión distinguiremos cuatro tareas (Gelman et al. 2013, chap. 7; Gelman et al. 2026, chaps. 8–9):
Comprobar: confrontar las implicaciones observables del modelo con características de los datos.
Validar: evaluar predicciones de respuestas no utilizadas para ajustar el modelo correspondiente.
Comparar: contrastar la capacidad predictiva, las implicaciones sustantivas y las limitaciones de varias especificaciones.
Examinar sensibilidad: investigar cómo cambian las conclusiones ante alternativas razonables de previas, estructura jerárquica o distribución de respuesta.
En un modelo multinivel, la unidad que dejamos fuera durante la validación determina qué tipo de generalización estamos evaluando. Predecir otra persona de un centro que ya conocemos no es la misma tarea que predecir personas de un centro completamente nuevo. No basta con escribir «se realizó validación cruzada» sin precisar qué se omitió en cada ajuste.
NotaFuentes, notación y alcance
La fundamentación de la precisión predictiva, los criterios de información y la comparación corresponde a Bayesian Data Analysis(Gelman et al. 2013, secs. 7.1–7.6). El enfoque iterativo, el sobreajuste, la comparación y la expansión provienen de Bayesian Workflow(Gelman et al. 2026, chap. 9); su caso de validación y PSIS-LOO de conteos aparece en el capítulo 24, y la validación con datos nuevos y la reformulación en el capítulo 25. La exposición intuitiva complementaria sigue a McElreath (McElreath 2020, secs. 7.4–7.5). Los desarrollos sobre unidad de validación, los datos simulados, el laboratorio y los ejercicios son elaboración pedagógica original para SP-1653. Para la implementación se consultan las funciones actuales de brms y loo; su documentación se enlaza al final.
Usamos \(i\) para una observación dentro del grupo \(j\), \(\boldsymbol\phi\) para parámetros poblacionales, \(\boldsymbol u_j\) para coeficientes grupales y \(\boldsymbol\theta\) para el conjunto de parámetros del modelo. En las fórmulas de LOO sin índices de grupo, \(i\) recorre todas las filas de la base. Esta convención continúa la de las semanas anteriores.
Objetivos de aprendizaje
Al finalizar esta semana, se espera que la persona estudiante pueda:
explicar la diferencia entre comprobación posterior, validación predictiva y comparación de modelos;
describir por qué la evaluación con los datos de ajuste puede sobrestimar la capacidad de generalización;
formular la densidad predictiva de validación leave-one-out (LOO) y la correspondiente suma de puntuaciones logarítmicas;
interpretar qué aproxima PSIS-LOO y cuál es el papel del diagnóstico de Pareto \(\widehat k\);
identificar observaciones influyentes e indicar estrategias justificadas cuando la aproximación PSIS no es confiable;
interpretar diferencias de \(\widehat{\mathrm{elpd}}\), sus errores estándar y sus contribuciones por unidad;
distinguir las predicciones para observaciones de grupos conocidos y para grupos completamente nuevos;
diseñar un esquema de validación que respete el objetivo predictivo y las dependencias entre observaciones;
reconocer el alcance de WAIC y relacionar, de manera crítica, LOO con AIC, BIC y LRT;
efectuar y comunicar un análisis de sensibilidad a las previas de heterogeneidad entre grupos;
decidir cuándo corresponde conservar varias especificaciones o expandir un modelo en lugar de elegir mecánicamente un ganador;
reproducir el análisis con brms, cmdstanr, loo, posterior y ggplot2.
14.2 ¿Qué significa comparar modelos?
14.2.1 Una comparación depende de la pregunta
Supongamos que analizamos una respuesta binaria \(Y_{ij}\) de la persona \(i\) en el centro \(j\), con un predictor individual \(x_{ij}\). Consideremos dos modelos de la semana 13:
M2 permite más heterogeneidad entre centros. Sin embargo, que M2 sea más flexible no implica automáticamente que sus predicciones fuera de la muestra sean mejores. Con pocos datos por centro, su estructura adicional puede estar débilmente informada; con muchos datos por centro, la variación de pendientes puede resultar esencial. La cuestión debe estudiarse en relación con el diseño, la cantidad de información y la pregunta sustantiva (Gelman y Hill 2007, chap. 13; Gelman et al. 2026, sec. 9.5).
Existen, además, comparaciones con finalidades distintas:
Finalidad
Pregunta
Cantidad que podría interesar
Interpretación
¿Hay heterogeneidad sustantivamente relevante en la asociación con \(x\)?
Posterior de \(\tau_1\) y contrastes de probabilidades por centro.
Comprobación
¿Se reproducen las diferencias observadas entre centros?
Distribución predictiva posterior de un resumen de heterogeneidad.
Predicción condicional
¿Podemos predecir una persona adicional de un centro conocido?
\(p(y_{ij}^{\mathrm{nuevo}}\mid\boldsymbol y)\) utilizando las demás observaciones de ese centro.
Predicción de grupos nuevos
¿Qué ocurriría en un centro que no aportó datos?
Distribución predictiva integrando sobre el coeficiente de ese centro.
Robustez
¿Una conclusión sobre heterogeneidad cambia al modificar una previa plausible?
Posterior de \(\tau_1\) y contrastes bajo varias especificaciones.
La comparación predictiva complementa, pero no sustituye, la evaluación del mecanismo científico, la calidad de los datos, las comprobaciones predictivas y la interpretabilidad del modelo (Gelman et al. 2013, secs. 7.3–7.6; Gelman et al. 2026, sec. 9.4).
14.2.2 Por qué un único criterio numérico es insuficiente
La ventaja predictiva puede ser pequeña frente a su incertidumbre. Dos modelos pueden asignar probabilidades similares a la mayoría de los datos y discrepar considerablemente en centros raros o en un subgrupo que resulta importante para la investigación. Un modelo también puede obtener una puntuación global relativamente alta y, sin embargo, representar incorrectamente una característica sustantiva: por ejemplo, la dispersión de contrastes entre centros.
En consecuencia, no utilizaremos una regla como «seleccionar siempre el modelo con menor LOOIC». En cambio, examinaremos qué se está prediciendo, qué diferencias existen, cuán estables son y qué implican para la pregunta científica.
14.3 Precisión predictiva y sobreajuste
14.3.1 De la distribución posterior a la predicción
Si \(\boldsymbol\theta\) reúne los parámetros desconocidos, la predicción de una nueva respuesta \(\widetilde y\), dados sus predictores \(\widetilde{\boldsymbol x}\), se obtiene al promediar sobre la posterior:
En un modelo jerárquico, debemos precisar si \(\boldsymbol\theta\) contiene el coeficiente de un grupo ya observado o si ese coeficiente corresponde a un grupo todavía desconocido. Retomaremos esta distinción en la sección Sección 14.5.
Para evaluar una predicción probabilística completa, una medida usual es la puntuación logarítmica:
\[
\log p(y_{\mathrm{observado}}\mid\text{información de entrenamiento}).
\]
Una predicción recibe una puntuación mayor cuando asigna mayor densidad —o probabilidad, si la respuesta es discreta— al valor que efectivamente se observó. La puntuación utiliza toda la distribución predictiva, no solamente la mediana o una clasificación binaria (Gelman et al. 2013, sec. 7.1; McElreath 2020, secs. 7.2–7.4).
La densidad predictiva logarítmica esperada (expected log predictive density, elpd) expresa el desempeño promedio que tendría un modelo ante nuevos datos provenientes de un proceso de interés. En general, la distribución que genera esos datos futuros es desconocida. Por ello recurrimos a validación cruzada para estimar esa capacidad, bajo el supuesto de que las observaciones retenidas son un sustituto pertinente del objetivo futuro.
14.3.2 Evaluación dentro de la muestra y optimismo
La densidad predictiva logarítmica calculada con la posterior ajustada a todos los datos es
Esta cantidad reutiliza \(y_i\) para ajustar y para evaluar la predicción. Un modelo muy flexible puede adaptarse a particularidades de los datos que difícilmente reaparecerán en una muestra nueva. La comparación basada solamente en \(\mathrm{lppd}\) suele favorecer injustificadamente esa adaptación. La validación cruzada intenta corregir el problema mediante una separación explícita entre entrenamiento y evaluación (Gelman et al. 2013, sec. 7.2; McElreath 2020, sec. 7.4).
ImportanteUna separación importante
Que M2 reproduzca mejor que M1 la dispersión observada de los contrastes entre centros, en una comprobación posterior, no implica que la diferencia entre sus puntuaciones predictivas fuera de la muestra tenga que ser grande. Las dos evaluaciones responden preguntas relacionadas, pero diferentes.
14.4 Validación cruzada y PSIS-LOO
14.4.1 Leave-one-out: la cantidad que queremos aproximar
Escribamos \(\boldsymbol y_{-i}\) para los datos excluyendo \(y_i\). La densidad predictiva LOO de esa observación es
Para simplificar la notación, se omite la dependencia explícita respecto de las variables explicativas. En la validación cruzada dejando una observación fuera (LOO), se excluye su respuesta del ajuste del modelo, pero se consideran conocidos los valores de sus predictores al calcular la distribución predictiva. En modelos multinivel, las demás observaciones del mismo grupo permanecen disponibles, por lo que la predicción puede incorporar información sobre los coeficientes específicos de ese grupo. Esto es distinto de la validación dejando grupos completos fuera, en la que dichos coeficientes no pueden estimarse utilizando respuestas del grupo excluido. Cuando existen grupos, \(\boldsymbol\theta\) puede incluir coeficientes grupales y su tratamiento depende de la tarea de predicción.
Calcular exactamente la ecuación Ecuación 14.7 por su definición exigiría ajustar el modelo \(n\) veces. Cada ajuste usa \(n-1\) observaciones y evalúa la que dejó fuera. Para un modelo bayesiano multinivel ajustado mediante HMC, esto podría ser costoso.
14.4.2 La aproximación mediante muestreo por importancia
PSIS-LOO utiliza la posterior ajustada al conjunto completo de datos para aproximar las distribuciones posteriores que se habrían obtenido al excluir cada observación (Gelman et al. 2026, sec. 9.4 y chap. 24; Vehtari et al. 2017, 2024).
Bajo la factorización condicional de la verosimilitud,
Si una observación tiene mucha influencia sobre el ajuste, algunas extracciones posteriores pueden recibir pesos excesivos al intentar representar la posterior sin ella. El método PSIS ajusta una distribución de Pareto generalizada a la cola de los pesos y los estabiliza. La finalidad es mejorar la estimación numérica, no alterar arbitrariamente los datos ni ocultar observaciones influyentes.
No derivaremos el algoritmo de suavizado; nos interesa comprender qué aproxima, cuándo puede fallar y cómo responder al diagnóstico. Para datos jerárquicos, también es relevante la posibilidad de integrar determinados parámetros individuales antes de evaluar la verosimilitud punto por punto; el capítulo 24 de Bayesian Workflow presenta un ejemplo de esta idea (Gelman et al. 2026, sec. 24.4). Integrar parámetros individuales no equivale a dejar fuera grupos completos, como veremos después.
14.4.3 El diagnóstico de Pareto \(\widehat k\)
Para cada observación, PSIS devuelve una estimación \(\widehat k_i\) que describe el comportamiento de la cola de sus pesos de importancia. Valores elevados señalan que el ajuste con todos los datos puede diferir demasiado del ajuste sin esa observación para que la aproximación sea confiable.
La documentación reciente del paquete loo establece como umbral orientativo
siendo \(S\) el número de extracciones posteriores utilizado por PSIS. El umbral depende del tamaño de simulación y la implementación considera el número nominal de extracciones; si el tamaño efectivo de MCMC es pequeño, puede resultar demasiado optimista. Por eso primero debemos revisar \(\widehat R\), ESS y advertencias de HMC. La regla fija \(0.7\) es habitual para un número suficiente de simulaciones, pero no es una regla sin condiciones. Véase la documentación oficial de loo.
Situación
Interpretación práctica
\(\widehat k_i<k_{\mathrm{lim}}\)
La estimación PSIS para esa observación suele ser suficientemente estable.
\(\widehat k_i\ge k_{\mathrm{lim}}\)
Conviene investigar la confiabilidad de PSIS y la influencia de esa observación.
\(0.7\le\widehat k_i<1\)
La aproximación puede presentar sesgo considerable; no debe aceptarse sin investigación.
\(\widehat k_i\ge1\)
Los pesos de importancia tienen un comportamiento especialmente problemático para la aproximación.
Un \(\widehat k\) elevado puede deberse a una respuesta extrema, una especificación poco robusta, escasa información para un coeficiente grupal o una observación que cambia sustancialmente la posterior. Es una señal para investigar, no una orden de eliminar la observación.
Si encontramos advertencias importantes, las alternativas incluyen (Gelman et al. 2026, chap. 24):
revisar datos, codificación, estructura grupal y diagnósticos del ajuste;
aplicar moment matching cuando sea apropiado y estén disponibles los parámetros necesarios;
reajustar exactamente los modelos sin ciertas observaciones influyentes (reloo) o utilizar validación \(K\)-fold;
revisar la formulación de la verosimilitud o del modelo jerárquico cuando las comprobaciones indiquen una discrepancia real.
Ninguna de estas soluciones convierte automáticamente una comparación entre modelos mal especificados en una conclusión científicamente válida.
14.4.3.1 elpd, número efectivo de parámetros y LOOIC
La salida de loo suele incluir las siguientes cantidades:
La cantidad \(\widehat p_{\mathrm{LOO}}\) se conoce como número efectivo de parámetros, aunque su interpretación no corresponde necesariamente al número de coeficientes incluidos en el modelo. Más precisamente, es una medida de complejidad predictiva efectiva.
Para comprender su significado, recordemos que \(\widehat{\operatorname{lppd}}\) evalúa la capacidad predictiva del modelo utilizando las mismas observaciones empleadas en su ajuste, mientras que \(\widehat{\operatorname{elpd}}_{\mathrm{LOO}}\) estima el desempeño predictivo cuando cada observación se excluye del ajuste. Por tanto, \(\widehat p_{\mathrm{LOO}}\) cuantifica la diferencia entre ambas evaluaciones y puede interpretarse como una medida del optimismo predictivo asociado al ajuste del modelo sobre los datos observados.
En términos generales, su interpretación es la siguiente:
Valores pequeños: indican una diferencia reducida entre el desempeño predictivo dentro y fuera de muestra. Esto puede ocurrir cuando el modelo tiene poca flexibilidad o cuando las distribuciones previas restringen considerablemente sus parámetros. Sin embargo, un valor pequeño no garantiza que el modelo represente adecuadamente los datos.
Valores mayores: indican una diferencia más pronunciada entre ambas evaluaciones y, por tanto, una mayor penalización por optimismo predictivo. En modelos regulares con distribuciones previas poco informativas, \(\widehat p_{\mathrm{LOO}}\) puede aproximarse al número de parámetros libres, pero esta correspondencia no es general.
En modelos multinivel: el pooling parcial y la regularización pueden reducir la complejidad predictiva efectiva. Por ejemplo, un modelo con diez interceptos grupales no necesariamente tiene una complejidad efectiva equivalente a diez parámetros independientes. Cuando los interceptos están fuertemente regularizados hacia una media poblacional, su contribución a la complejidad efectiva puede ser considerablemente menor.
Valores inusualmente elevados: especialmente cuando resultan grandes en relación con el número de observaciones o con la complejidad esperada del modelo, pueden indicar problemas de especificación, observaciones muy influyentes o dificultades en la aproximación mediante PSIS-LOO. En estos casos conviene examinar los valores de Pareto \(\widehat k\) y realizar comprobaciones predictivas adicionales.
Es importante destacar que no se busca necesariamente minimizar \(\widehat p_{\mathrm{LOO}}\). Un modelo excesivamente restringido puede tener una complejidad efectiva pequeña y, al mismo tiempo, una capacidad predictiva deficiente. Asimismo, una diferencia entre modelos en términos de \(\widehat p_{\mathrm{LOO}}\) no constituye, por sí misma, un argumento para descartar alguno de ellos.
La interpretación de esta cantidad también depende de cómo se haya definido la unidad de validación y de si las predicciones se condicionan en coeficientes grupales o se integran sobre su distribución. Por ello, en modelos multinivel, su valor debe analizarse en relación con la pregunta predictiva y la estrategia de validación utilizada.
Por su parte, LOOIC expresa la estimación de desempeño predictivo en una escala multiplicada por \(-2\). En consecuencia, un mayor valor de \(\widehat{\operatorname{elpd}}_{\mathrm{LOO}}\) indica mejor puntuación predictiva, mientras que un menor LOOIC indica lo mismo en la escala transformada. Para interpretar las diferencias entre modelos, conservaremos principalmente la escala de elpd.
En síntesis, \(\widehat p_{\mathrm{LOO}}\) proporciona información complementaria sobre la flexibilidad efectiva del modelo, pero la comparación debe considerar conjuntamente el desempeño predictivo, su incertidumbre, los diagnósticos de PSIS-LOO y la adecuación sustantiva de las especificaciones consideradas.
14.5 Validación en modelos jerárquicos: ¿qué dejamos fuera?
14.5.1 Dos preguntas predictivas que no deben confundirse
Sea \(\boldsymbol\phi\) el conjunto de parámetros poblacionales y \(\boldsymbol u_j\) el coeficiente del grupo \(j\). Para simplificar, supongamos independencia condicional de las respuestas dado \(\boldsymbol\phi\) y \(\boldsymbol u_j\):
Pregunta A: nueva observación de un grupo conocido. Si dejamos fuera \(Y_{ij}\), pero conservamos las otras respuestas del mismo grupo, la posterior \(p(\boldsymbol u_j,\boldsymbol\phi\mid\boldsymbol y_{-ij})\) puede utilizar esas otras respuestas. La densidad predictiva es
La predicción se beneficia de la información disponible del centro. Esta es la tarea que representa el LOO por fila de un modelo multinivel habitual, si se implementa correctamente.
Pregunta B: grupo completamente nuevo. Si dejamos fuera todas las respuestas del grupo \(j\), no tenemos información específica sobre su coeficiente grupal. Su densidad predictiva conjunta es
Aquí \(\boldsymbol y_{-j}\) contiene solamente las respuestas de los otros grupos. El producto dentro de la integral es importante: todas las respuestas del centro nuevo comparten el mismo\(\boldsymbol u_j\). No corresponde generar un coeficiente grupal independiente para cada fila de ese centro.
Importante¿Qué se está validando?
LOO por observación evalúa la predicción de una respuesta dejando disponibles las otras observaciones del grupo. Validación dejando grupos completos fuera evalúa generalización a grupos no vistos. Una puntuación alta en la primera tarea no garantiza una puntuación alta en la segunda. Comparar ambas puntuaciones numéricamente como si estimaran exactamente la misma cantidad sería un error.
14.5.2 Otras estructuras y unidades de validación
Estructura
Pregunta futura
Unidad razonable de exclusión
Estudiantes agrupados en escuelas
Otro estudiante de una escuela observada
Estudiante, conservando el resto de su escuela.
Estudiantes agrupados en escuelas
Estudiantes de una escuela no observada
Escuela completa.
Mediciones repetidas
Otra ocasión de un individuo conocido
Ocasión, respetando orden y disponibilidad temporal.
Mediciones longitudinales
Trayectoria de un individuo nuevo
Individuo completo.
Serie temporal
Predicción de períodos futuros
Bloques de tiempo posteriores, sin utilizar información futura para entrenar.
Datos con factores cruzados
Nuevo evaluador, nuevo objeto o ambos
Bloques que respeten cuáles factores serán desconocidos.
En series temporales, dejar una observación intermedia mientras se conservan las posteriores puede incorporar información que no estaría disponible al realizar una predicción prospectiva. La validación debe reproducir el contexto de información de la aplicación; no es simplemente una partición arbitraria de filas.
14.5.3 Validación \(K\)-fold por grupos
Cuando el número de grupos es moderado, podemos repartir los grupos en \(K\) conjuntos. En cada iteración ajustamos el modelo utilizando \(K-1\) conjuntos y evaluamos los grupos reservados. Todos los registros de un mismo grupo se asignan al mismo conjunto de validación.
Hay dos formas de resumir el resultado:
Puntuación por observación: sumar puntuaciones predictivas individuales de las respuestas retenidas, aunque el grupo haya quedado fuera del ajuste. Evalúa el promedio de predicciones individuales de grupos nuevos.
Puntuación conjunta por grupo: calcular el logaritmo de la probabilidad predictiva conjunta de las respuestas del grupo según Ecuación 14.12. Evalúa la predicción del vector completo de un grupo nuevo.
No son exactamente el mismo criterio: el segundo preserva explícitamente la dependencia del conjunto de respuestas bajo un único coeficiente grupal compartido. La función brms::kfold() admite folds = "grouped", group = "grupo" y joint = "group". Por requerir reajustes con HMC, la demostración computacional de esta opción será ejecutable bajo solicitud en la sección de laboratorio.
14.5.4 La integración de coeficientes individuales no reemplaza este diseño
El capítulo 24 de Bayesian Workflow estudia una formulación de conteos con interceptos individuales, e integra esos interceptos para estabilizar la aproximación LOO al evaluar una observación (Gelman et al. 2026, secs. 24.3–24.4). La integración resuelve una dificultad numérica asociada a la presencia de parámetros específicos de observaciones; no cambia por sí sola la tarea de validación a la de predecir centros enteramente nuevos. Debemos identificar siempre qué observaciones se excluyen y cómo se obtiene la distribución predictiva correspondiente.
14.6 Cómo interpretar las comparaciones predictivas
14.6.1 Diferencia de elpd y error estándar
Si \(M_1\) y \(M_2\) se evalúan con la misma unidad de validación, las mismas observaciones y la misma puntuación, definamos la contribución de la unidad \(i\) a la diferencia:
La fórmula del error estándar es una aproximación a partir de contribuciones por unidades evaluadas y presupone que estas pueden tratarse como réplicas adecuadas del objetivo predictivo. Con fuerte dependencia entre filas, no debemos tratar automáticamente todas las filas como unidades independientes para cuantificar esta incertidumbre. Para puntuaciones conjuntas por grupo, una aproximación análoga se construiría a partir de contribuciones por grupo, con sus propias limitaciones cuando el número de grupos es pequeño.
El error estándar de la diferencia no se obtiene restando los errores estándar de los dos modelos. La comparación es emparejada: ambos se evalúan en los mismos datos (Gelman et al. 2013, sec. 7.3; 2026, sec. 9.4).
Supongamos, solo como ejemplo ilustrativo, que \(\widehat\Delta_{12}=3\) y \(\widehat{\operatorname{SE}}=11\). La diferencia estimada es pequeña en relación con su incertidumbre. No sería sensato declarar una superioridad predictiva concluyente de M1. Si las predicciones son similares y ambos modelos satisfacen las comprobaciones relevantes, puede ser razonable mantener ambos o preferir uno por su interpretación y estabilidad.
14.6.2 Examinar quiénes explican la diferencia
Una suma global puede ocultar que algunas unidades favorecen M1 y otras M2. Por ello examinaremos las contribuciones \(d_i\) y sus sumas descriptivas por centro. Sumar contribuciones PSIS por centro no constituye validación dejando ese centro completo fuera: cada contribución todavía procede de LOO por observación.
Los resultados pueden sugerir nuevas comprobaciones: ¿existen grupos pequeños con errores especialmente grandes?, ¿hay un patrón con el predictor \(x\)?, ¿los grupos en los que un modelo falla son importantes para el objetivo sustantivo? Estos interrogantes orientan la crítica del modelo; no deben convertirse en una búsqueda indiscriminada de mejoras numéricas.
14.6.3 ¿Debemos elegir siempre un modelo?
No necesariamente. Si varias especificaciones representan mecanismos sustantivos plausibles y sus predicciones son parecidas, podemos mostrar sus resultados conjuntamente y explicar las diferencias. Una alternativa predictiva es stacking, que combina distribuciones predictivas utilizando ponderaciones elegidas para mejorar la puntuación predictiva validada (Gelman et al. 2026, sec. 9.6). Las ponderaciones no son probabilidades posteriores de que los modelos sean verdaderos.
El stacking se tratará como extensión: primero debemos contar con comparaciones confiables y con modelos que no presenten deficiencias sustantivas graves.
14.7 WAIC y métodos de comparación tradicionales
14.7.1 WAIC como aproximación alternativa
El criterio WAIC aproxima capacidad predictiva mediante una corrección basada en la variabilidad posterior de la log-verosimilitud punto por punto. En su forma habitual,
BDA desarrolla WAIC y su relación con validación cruzada (Gelman et al. 2013, sec. 7.2). PSIS-LOO suele ser preferible en la práctica porque dispone de diagnósticos explícitos de la aproximación de importancia, mientras que WAIC puede ser menos estable ante observaciones influyentes. WAIC tampoco resuelve la selección de la unidad predictiva en datos agrupados: su forma punto por punto evalúa la factorización que se le proporcionó.
14.7.2 Relación con AIC, BIC y LRT
Los métodos habituales en la literatura frecuentista ofrecen puntos de comparación, pero responden a supuestos y objetivos distintos:
AIC utiliza la log-verosimilitud maximizada y una penalización por número de parámetros en un marco de aproximación a la precisión predictiva.
BIC incorpora una penalización que depende del tamaño muestral y se relaciona, bajo condiciones específicas, con aproximaciones a evidencia marginal y selección de modelos.
LRT contrasta modelos anidados mediante diferencias de log-verosimilitud; sus calibraciones asintóticas usuales pueden requerir cuidados especiales con parámetros de variancia en la frontera.
Los criterios basados en verosimilitud y su interpretación en modelos mixtos aparecen en Gelman y Hill (Gelman y Hill 2007, sec. 24.3) y en las referencias clásicas del curso (West et al. 2022, sec. 2.6). Ninguno reemplaza la pregunta por la unidad de generalización, las comprobaciones predictivas, ni la evaluación de sensibilidad. Los factores de Bayes, discutidos en BDA §7.4, corresponden a otra lógica comparativa basada en verosimilitudes marginales y pueden ser sensibles a las previas; no serán el eje del laboratorio de esta semana.
14.8 Sensibilidad y expansión del modelo
14.8.1 ¿A qué decisión podría ser sensible una conclusión?
La inferencia bayesiana resulta de combinar una verosimilitud con distribuciones previas. Si algunos parámetros están débilmente identificados, su posterior puede variar de manera importante entre previas sustantivamente plausibles. En modelos multinivel, las desviaciones estándar de coeficientes grupales suelen merecer especial atención, sobre todo con pocos grupos o poca información dentro de ellos (Gelman et al. 2013, sec. 5.7; Gelman et al. 2026, chaps. 17–19).
El análisis de sensibilidad puede involucrar:
Decisión
Alternativa a investigar
Cantidad para comparar
Previa de heterogeneidad
Dos escalas razonables de una previa para \(\tau_1\)
Posterior de \(\tau_1\) y diferencias predictivas por centro nuevo.
Coeficientes comparables y cantidades de respuesta.
La última fila requiere una precaución: una reparametrización algebraicamente equivalente, acompañada de una transformación coherente de las previas, no debería alterar las predicciones por sí misma. Si las previas se mantienen numéricamente iguales después de cambiar la escala del predictor, se puede estar cambiando el modelo en vez de efectuar solamente una transformación de coordenadas.
14.8.2 Un ejemplo de sensibilidad a la previa de una pendiente variable
En M2, la desviación estándar \(\tau_1\) expresa la variación poblacional de pendientes en escala logit. Consideremos como previa base
\[
\tau_1\sim\operatorname{Exponencial}(1.5),
\]
con parámetro de tasa\(1.5\) y media \(1/1.5\). Para estudiar sensibilidad, podríamos utilizar
\[
\tau_1\sim\operatorname{Exponencial}(3),
\qquad\text{alternativa más concentrada cerca de cero},
\]
manteniendo las demás previas y la verosimilitud sin cambios. Las escalas deben justificarse en la aplicación: aquí son elecciones pedagógicas para datos simulados en los que \(x\) es binario. No son previas recomendadas universalmente.
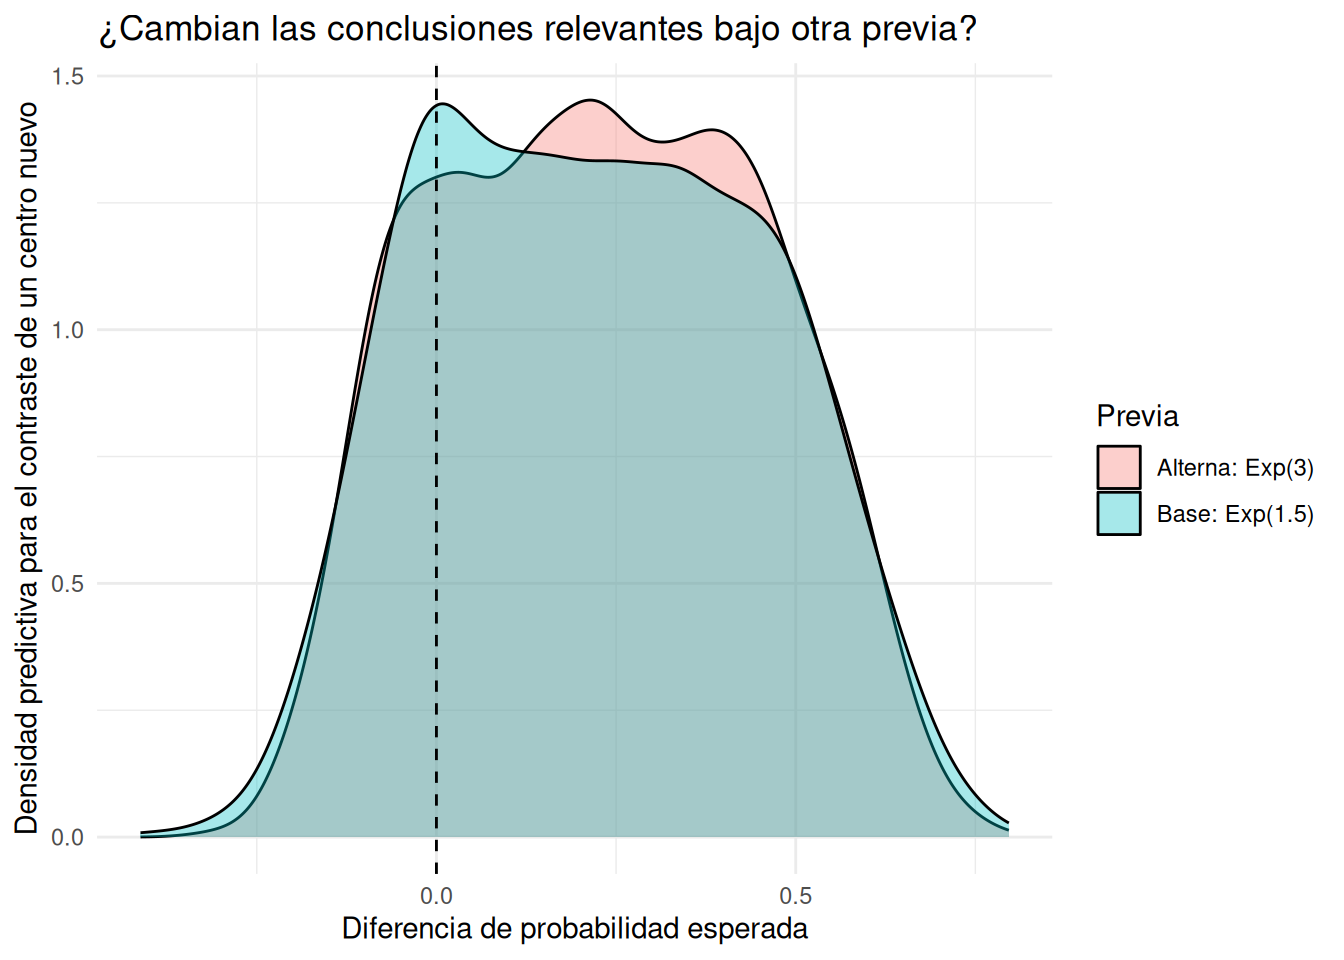
La pregunta relevante no es únicamente si cambia la media posterior de \(\tau_1\), sino si cambian en forma importante las cantidades que sustentan nuestras conclusiones: por ejemplo, la diferencia de probabilidades para una nueva persona de un nuevo centro y la probabilidad posterior de que esa diferencia sea positiva.
14.8.3 De sensibilidad a expansión
Si ambas especificaciones predicen de manera inadecuada una característica importante, el siguiente paso no consiste necesariamente en seleccionar «la menos mala». Podemos considerar un predictor grupal, una interacción entre niveles, otra distribución de respuesta o una estructura de dependencia más pertinente. BDA y Bayesian Workflow entienden la modelación como un proceso de crítica y expansión, no como una competencia definitiva entre un conjunto fijo de candidatos (Gelman et al. 2013, secs. 7.5–7.6; Gelman et al. 2026, secs. 9.4–9.7 y chap. 25).
14.9 Laboratorio reproducible en R
14.9.1 Objetivos, decisiones y reproducibilidad
Continuaremos exactamente el mecanismo de simulación y las formulaciones de M1 y M2 de la semana 13. Esto permite comparar resultados sin confundir cambios de datos con cambios de método de evaluación. Para que este capítulo pueda compilarse de manera independiente, generaremos otra vez los datos con las mismas semillas y volveremos a declarar los modelos. Los ajustes de esta semana se almacenan en archivos propios de la semana 14 para no modificar los ajustes de la semana anterior.
El laboratorio tendrá cuatro etapas que se ejecutan normalmente: (a) preparar datos y modelos; (b) diagnosticar HMC y PSIS-LOO; (c) estudiar diferencias por observación y por centro; y (d) efectuar sensibilidad a una previa. Incluiremos, además, dos módulos ejecutables, pero opcionales por su costo computacional: validación \(K\)-fold dejando centros completos fuera y comparación de dos modelos con datos reales.
Para ejecutar los módulos opcionales, se configuran variables de entorno antes de renderizar:
# Activar antes de usar quarto render (no son necesarias por defecto):Sys.setenv(EJECUTAR_CV_GRUPOS_S14 ="1")Sys.setenv(EJECUTAR_EPIL_S14 ="1")# Opcional para intentar reparar PSIS con moment matching:Sys.setenv(EJECUTAR_MOMENT_MATCH_S14 ="1")
Por ejemplo, en una sesión interactiva de R se puede llamar quarto::quarto_render("14-comparacion-validacion-sensibilidad.qmd", execute = TRUE) después de activar alguna de estas opciones. Si el archivo ya se congeló con freeze: auto, para forzar una nueva ejecución durante el desarrollo puede usarse quarto render 14-comparacion-validacion-sensibilidad.qmd --execute desde una terminal. Cuando no se activan, el capítulo igualmente compila las secciones principales y documenta la ejecución de las extensiones.
14.9.2 Configuración de R y CmdStan
Como en las semanas anteriores, no intentaremos instalar CmdStan dentro del documento. Las instalaciones y la configuración del compilador corresponden a la preparación del entorno. La carpeta _fits/ conserva los ajustes y file_refit = "on_change" permite reutilizarlos cuando el modelo no cambie.
14.9.3 Volver a generar los datos de la semana 13
El mecanismo utilizado para simular los datos es Ecuación 14.2, con 24 centros de tamaños diferentes y \(x\in\{0,1\}\). Los valores verdaderos empleados para generar los datos son \(\alpha=-1.15\), \(\beta=0.90\), \(\tau_0=0.70\), \(\tau_1=1.30\) y \(\rho=-0.25\). Se mantienen las mismas semillas y el mismo orden de generación usados en la semana 13.
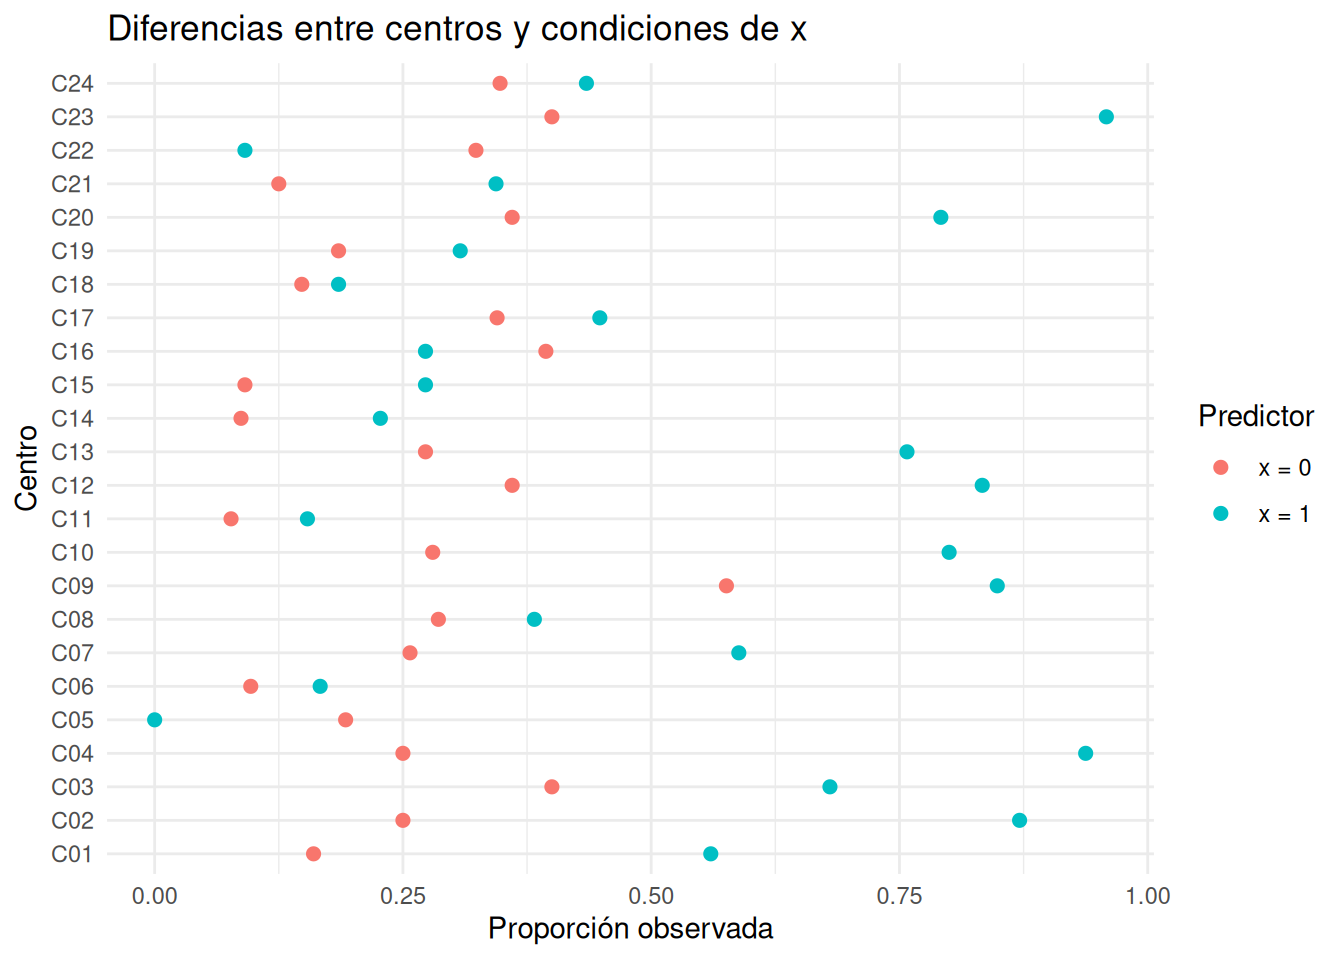
El siguiente gráfico reproduce una característica que motivó el capítulo 13. Las diferencias observadas no son las pendientes verdaderas de los centros: contienen variación muestral binomial.
resumen_datos_s14 <- datos_s14 |> dplyr::group_by(grupo, x) |> dplyr::summarise(prop =mean(y), n = dplyr::n(), .groups ="drop")ggplot2::ggplot( resumen_datos_s14, ggplot2::aes(x = grupo, y = prop, colour =factor(x))) + ggplot2::geom_point(size =2) + ggplot2::coord_flip() + ggplot2::scale_colour_discrete(name ="Predictor", labels =c("x = 0", "x = 1") ) + ggplot2::labs(x ="Centro", y ="Proporción observada",title ="Diferencias entre centros y condiciones de x" ) + ggplot2::theme_minimal(base_size =11)
Proporciones de respuestas positivas según el predictor y el centro. Datos simulados como en la semana 13.
14.9.4 Ajuste de M1 y M2
Conservaremos las mismas fórmulas y distribuciones previas de la semana 13:
La exponencial se parametriza por tasa, no por escala. La fórmula 0 + Intercept mantiene explícito el coeficiente poblacional correspondiente a \(x=0\) y evita confundirlo con el intercepto internamente centrado de brms. Para permitir una eventual reparación de PSIS mediante moment matching guardaremos los parámetros necesarios mediante save_pars = brms::save_pars(all = TRUE).
formula_m1_s14 <- brms::bf(y ~0+ Intercept + x + (1| grupo))formula_m2_s14 <- brms::bf(y ~0+ Intercept + x + (1+ x | grupo))prior_m1_s14 <-c( brms::prior(normal(-1, 1), class ="b", coef ="Intercept"), brms::prior(normal(0, 1.5), class ="b", coef ="x"), brms::prior(exponential(1.5), class ="sd"))prior_m2_s14 <-c( brms::prior(normal(-1, 1), class ="b", coef ="Intercept"), brms::prior(normal(0, 1.5), class ="b", coef ="x"), brms::prior(exponential(1.5), class ="sd"), brms::prior(lkj(2), class ="cor"))
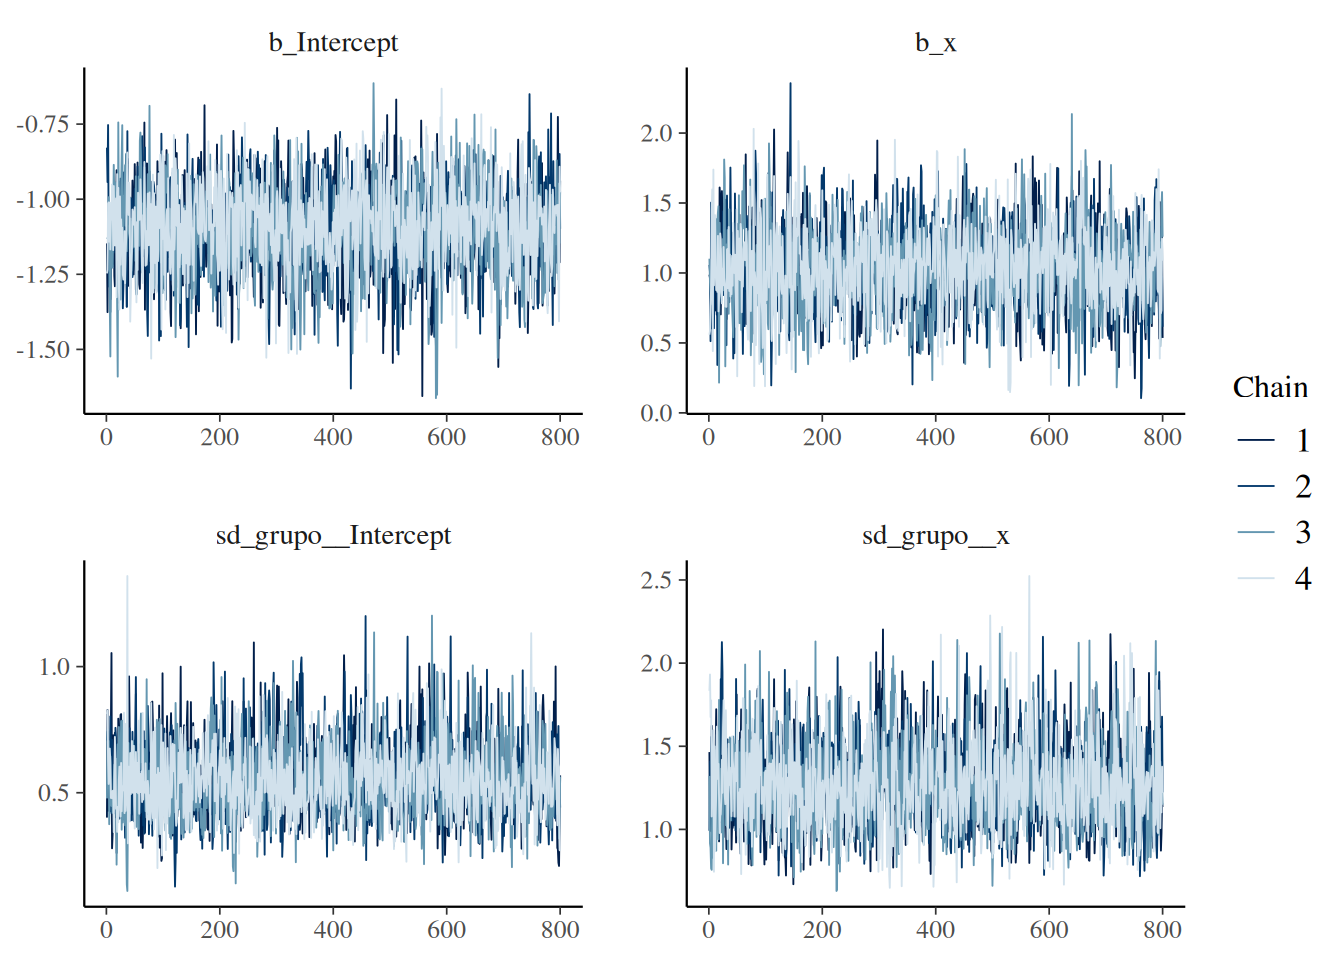
No debemos interpretar resultados de PSIS-LOO si la aproximación a las distribuciones posteriores es computacionalmente inadecuada. Volvemos a inspeccionar \(\widehat R\), ESS y divergencias, separando problemas del ajuste de problemas de la aproximación LOO.
Trazas de parámetros seleccionados de M2. Antes de utilizar las predicciones, deben revisarse las advertencias computacionales.
Si hay divergencias, mezclado inadecuado o estimaciones de ESS insuficientes, investigaremos primero la parametrización, las escalas y las previas, según el flujo de la semana 7. Si los diagnósticos resultan adecuados, continuaremos con PSIS-LOO. La ausencia de advertencias no demuestra que el modelo esté correctamente especificado.
14.9.6 PSIS-LOO por observación
Los dos modelos deben evaluarse sobre las mismas filas, en el mismo orden y con la misma definición de respuesta. brms::loo() calcula las contribuciones de log-verosimilitud necesarias para la aproximación.
loo_m1_s14 <- brms::loo(fit_m1_s14)loo_m2_s14 <- brms::loo(fit_m2_s14)cat("M1: interceptos variables y pendiente común\n")
M1: interceptos variables y pendiente común
print(loo_m1_s14)
Computed from 3200 by 1356 log-likelihood matrix.

         Estimate   SE
elpd_loo   -773.0 17.3
p_loo        22.3  0.7
looic      1546.1 34.6
------
MCSE of elpd_loo is 0.1.
MCSE and ESS estimates assume MCMC draws (r_eff in [1.1, 1.7]).

All Pareto k estimates are good (k < 0.7).
See help('pareto-k-diagnostic') for details.
cat("\nM2: interceptos y pendientes variables\n")
M2: interceptos y pendientes variables
print(loo_m2_s14)
Computed from 3200 by 1356 log-likelihood matrix.

         Estimate   SE
elpd_loo   -743.6 17.8
p_loo        32.9  1.3
looic      1487.1 35.7
------
MCSE of elpd_loo is 0.1.
MCSE and ESS estimates assume MCMC draws (r_eff in [0.9, 1.4]).

All Pareto k estimates are good (k < 0.7).
See help('pareto-k-diagnostic') for details.
                  model elpd_diff se_diff p_worse diag_diff diag_elpd
 M2: pendiente variable       0.0     0.0      NA
    M1: pendiente común     -29.5     7.7    1.00
La primera fila que devuelve loo_compare corresponde al modelo con mayor elpd estimada y su diferencia es cero. Las demás filas se expresan respecto de ese modelo. La interpretación correcta exige examinar simultáneamente la magnitud de elpd_diff, se_diff, los diagnósticos de Pareto y los patrones por centro; la posición de una fila en la tabla no basta para justificar la elección.
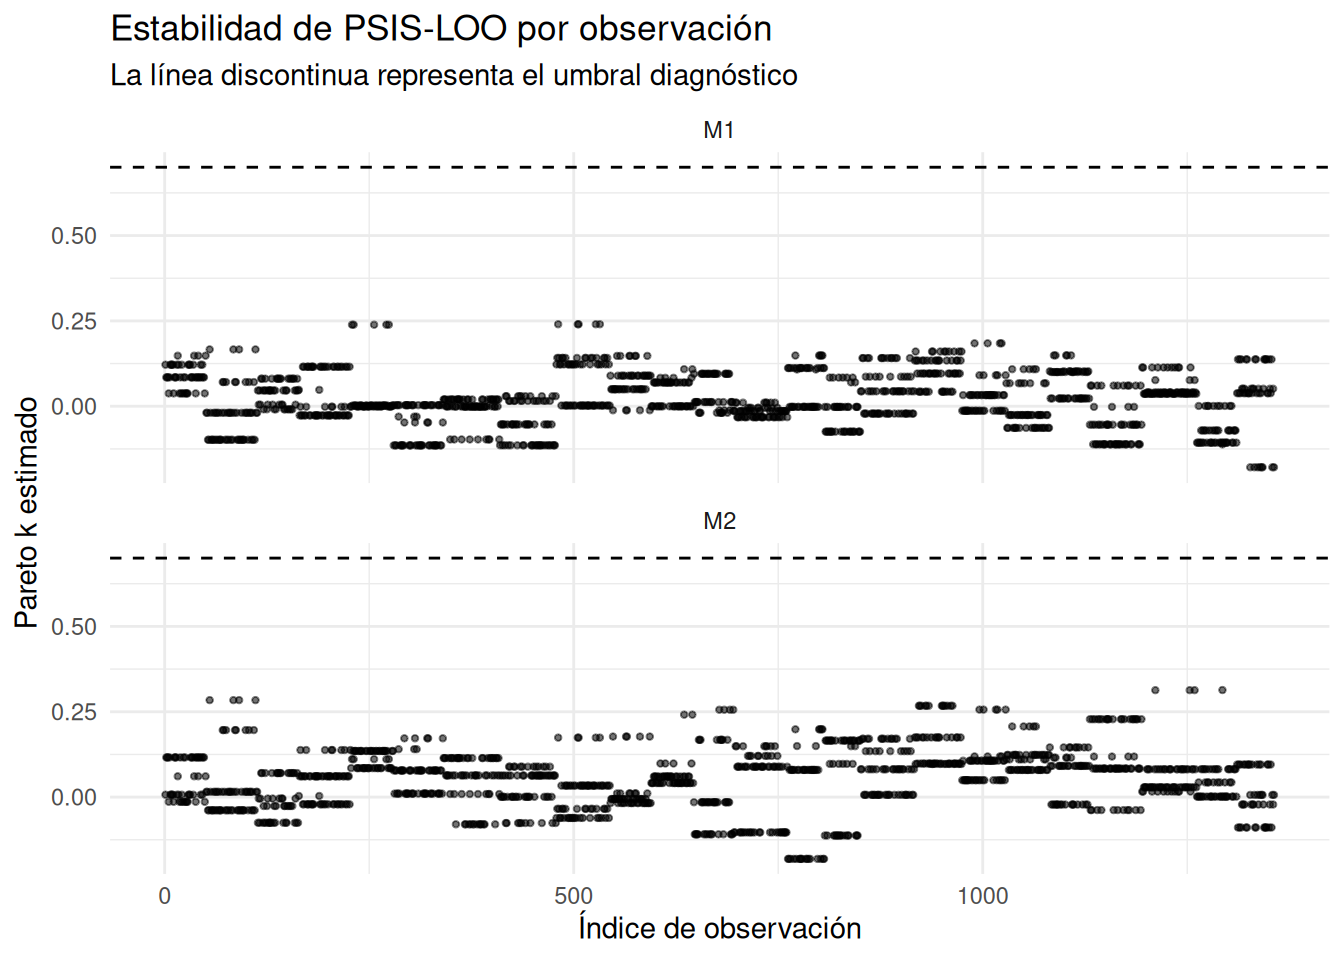
k_grafico_s14 <- dplyr::bind_rows( tibble::tibble(observacion =seq_len(nrow(datos_s14)),grupo = datos_s14$grupo,modelo ="M1",k = k_m1_s14,umbral = limite_k_m1_s14 ), tibble::tibble(observacion =seq_len(nrow(datos_s14)),grupo = datos_s14$grupo,modelo ="M2",k = k_m2_s14,umbral = limite_k_m2_s14 ))ggplot2::ggplot( k_grafico_s14, ggplot2::aes(x = observacion, y = k)) + ggplot2::geom_point(size =0.8, alpha =0.55) + ggplot2::geom_hline( ggplot2::aes(yintercept = umbral), linetype =2,data = dplyr::distinct(k_grafico_s14, modelo, umbral) ) + ggplot2::facet_wrap(~modelo, ncol =1) + ggplot2::labs(x ="Índice de observación", y ="Pareto k estimado",title ="Estabilidad de PSIS-LOO por observación",subtitle ="La línea discontinua representa el umbral diagnóstico" ) + ggplot2::theme_minimal(base_size =11)
Valores de Pareto k por observación y modelo, con el umbral dependiente del número de extracciones.
Los datos simulados no garantizan que aparezcan observaciones con \(\widehat k\) elevado. No inventaremos una advertencia si los resultados no la producen. Cuando aparezca alguna, investigaremos qué observación y qué centro la originan. Si no aparece ninguna, ello solo favorece la confiabilidad numérica de esta aproximación específica, no la validez absoluta del modelo.
observaciones_influyentes_s14 <- k_grafico_s14 |> dplyr::filter(!is.finite(k) | k >= umbral) |> dplyr::left_join( datos_s14 |> dplyr::mutate(observacion = dplyr::row_number()) |> dplyr::select(observacion, y, x),by ="observacion" ) |> dplyr::arrange(dplyr::desc(k))if (nrow(observaciones_influyentes_s14) ==0L) {cat("No se detectaron observaciones por encima del umbral diagnóstico.\n")} else {print(observaciones_influyentes_s14)}
No se detectaron observaciones por encima del umbral diagnóstico.
Reparación opcional mediante moment matching
La siguiente sección no se ejecuta de manera predeterminada, porque transformar las simulaciones y recalcular los pesos puede implicar cómputo adicional. Para activarla use EJECUTAR_MOMENT_MATCH_S14=1. Su ejecución es pertinente solo si la aproximación inicial presenta problemas. Haber guardado los parámetros con save_pars(all = TRUE) permite intentar este procedimiento.
if (identical(Sys.getenv("EJECUTAR_MOMENT_MATCH_S14", "0"), "1")) {if (any(!is.finite(k_m1_s14) | k_m1_s14 >= limite_k_m1_s14)) { loo_m1_reparado_s14 <- brms::loo( fit_m1_s14, moment_match =TRUE )print(loo_m1_reparado_s14) }if (any(!is.finite(k_m2_s14) | k_m2_s14 >= limite_k_m2_s14)) { loo_m2_reparado_s14 <- brms::loo( fit_m2_s14, moment_match =TRUE )print(loo_m2_reparado_s14) }if (!any(!is.finite(k_m1_s14) | k_m1_s14 >= limite_k_m1_s14) &&!any(!is.finite(k_m2_s14) | k_m2_s14 >= limite_k_m2_s14)) {cat("No había advertencias de k que motivaran moment matching.\n") }} else {cat("Módulo de moment matching omitido. Active EJECUTAR_MOMENT_MATCH_S14=1.\n")}
Módulo de moment matching omitido. Active EJECUTAR_MOMENT_MATCH_S14=1.
Si la reparación se ejecuta, deben revisarse los nuevos diagnósticos y volver a construir la comparación con los objetos reparados. No utilizaremos una tabla derivada de valores con advertencias graves como evidencia concluyente.
14.9.8 ¿Dónde se originan las diferencias predictivas?
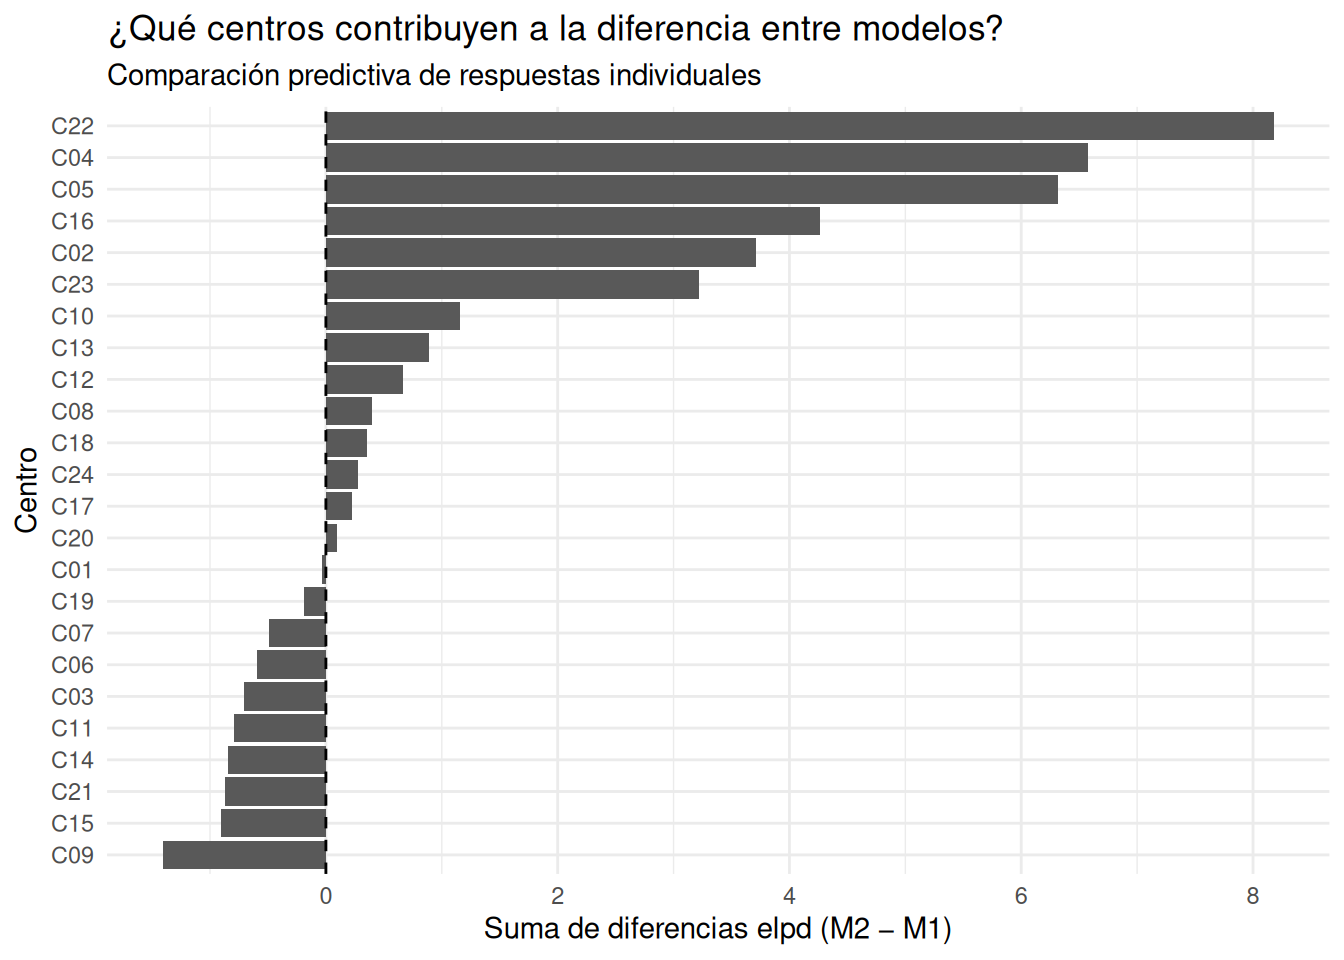
Extraemos las contribuciones individuales a elpd y calculamos diferencias emparejadas M2 menos M1. Esta operación sigue siendo LOO por observación incluso cuando posteriormente agregamos sus contribuciones según el centro.
Esta tabla identifica los centros con mayores contribuciones descriptivas a la diferencia global, pero no asigna un error estándar independiente a cada centro. Es útil contrastarla con el gráfico de proporciones observadas y con las comprobaciones predictivas de la semana 13. En particular, una ventaja predictiva puede concentrarse en pocos centros y no ser uniforme entre ellos.
14.9.9 Diseño de validación para centros nuevos
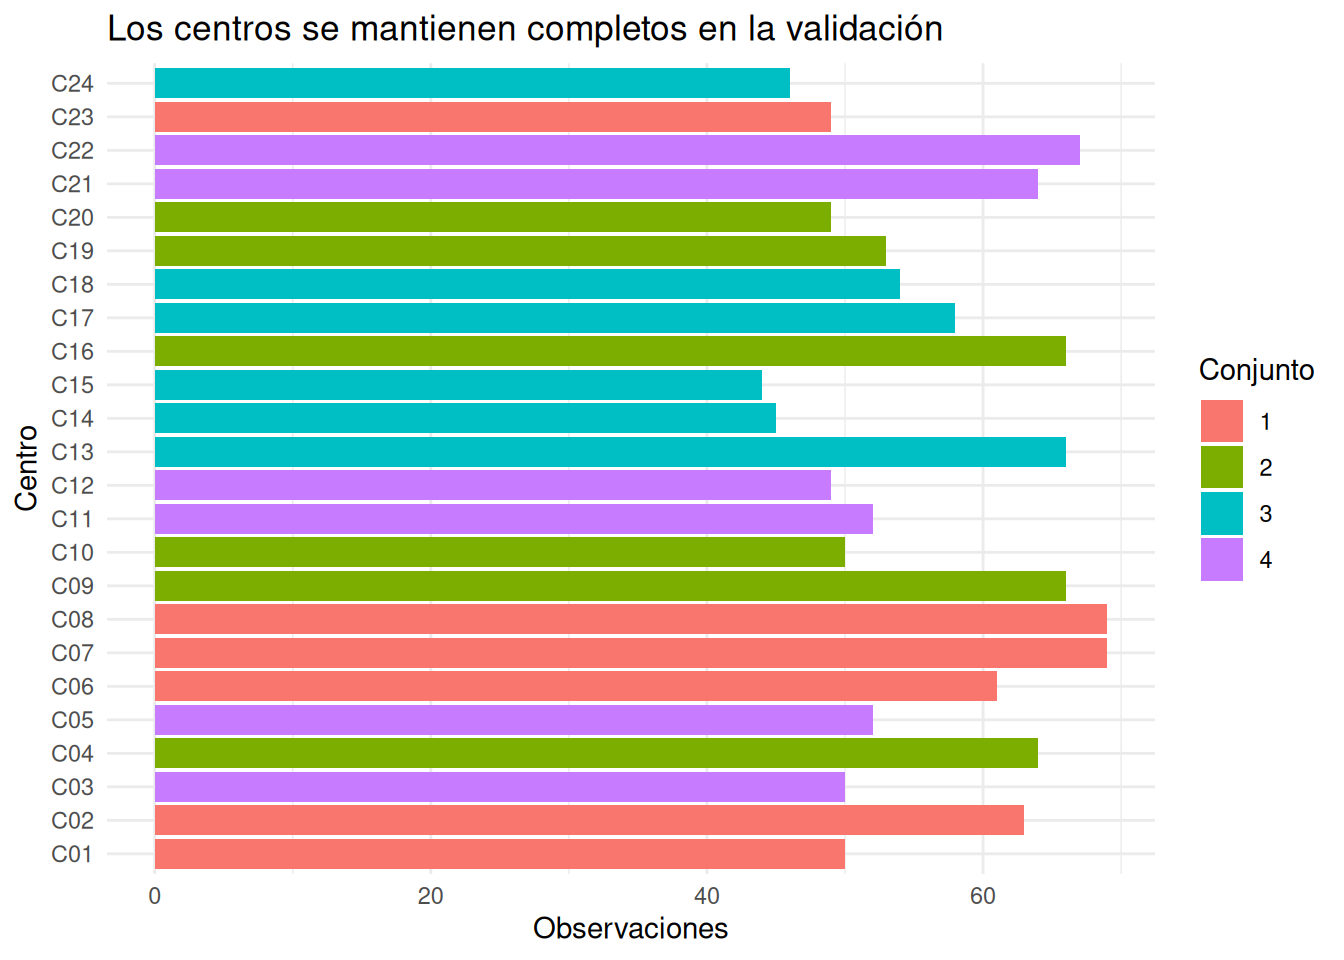
Primero construiremos una partición explícita de los centros completos en cuatro conjuntos. La partición será idéntica para M1 y M2. La figura ilustra el procedimiento sin efectuar todavía los reajustes costosos.
datos_s14 |> dplyr::mutate(fold =factor(fold_por_fila_s14)) |> dplyr::count(grupo, fold) |> ggplot2::ggplot(ggplot2::aes(x = grupo, y = n, fill = fold)) + ggplot2::geom_col() + ggplot2::coord_flip() + ggplot2::labs(x ="Centro", y ="Observaciones",fill ="Conjunto",title ="Los centros se mantienen completos en la validación" ) + ggplot2::theme_minimal(base_size =11)
Partición de centros completos en cuatro conjuntos de validación: ninguna observación del centro aparece en un conjunto distinto al resto de ese centro.
Para la evaluación conjunta por grupos, joint = "group" corresponde a Ecuación 14.12 y sample_new_levels = "gaussian", utilizado por defecto en brms::kfold() para estos coeficientes normales, genera efectos de los centros excluidos a partir de la distribución de grupo. La validación requiere reajustar cada modelo cuatro veces. Este bloque se activa con EJECUTAR_CV_GRUPOS_S14=1; dejarlo desactivado en una compilación ordinaria no significa que sus resultados se hayan obtenido.
if (identical(Sys.getenv("EJECUTAR_CV_GRUPOS_S14", "0"), "1")) {set.seed(16531411) cv_grupos_m1_s14 <- brms::kfold( fit_m1_s14,K =4,folds = fold_por_fila_s14,group ="grupo",joint ="group",save_fits =FALSE,refresh =0 )set.seed(16531412) cv_grupos_m2_s14 <- brms::kfold( fit_m2_s14,K =4,folds = fold_por_fila_s14,group ="grupo",joint ="group",save_fits =FALSE,refresh =0 )print(cv_grupos_m1_s14)print(cv_grupos_m2_s14)print(loo::loo_compare(list("M1: grupos nuevos"= cv_grupos_m1_s14,"M2: grupos nuevos"= cv_grupos_m2_s14 ) ))} else {cat("Validación K-fold conjunta por grupos omitida. ","Active EJECUTAR_CV_GRUPOS_S14=1 para reajustar los modelos.\n",sep ="" )}
Validación K-fold conjunta por grupos omitida. Active EJECUTAR_CV_GRUPOS_S14=1 para reajustar los modelos.
Interpretación requerida una vez activada. Primero verifique los diagnósticos de los reajustes. Después compare las puntuaciones conjuntas por grupo de M1 y M2, sin compararlas en magnitud directa con las puntuaciones LOO por fila de la sección Sección 14.9.6. Aunque las dos comparaciones se refieran a los mismos datos originales, sus unidades y sus preguntas predictivas son diferentes. Si se desea evaluar predicciones individuales en centros nuevos, puede repetirse el experimento con joint = "obs", manteniendo la misma partición por centros.
14.9.10 Análisis de sensibilidad a la previa de las pendientes
Volvamos a M2. La previa base de las desviaciones estándar de coeficientes grupales es exponencial de tasa \(1.5\). En la alternativa dejaremos igual la previa del intercepto grupal, pero concentraremos más cerca de cero la desviación estándar de pendientes, \(\tau_1\sim\operatorname{Exponencial}(3)\).
prior_m2_alterno_s14 <-c( brms::prior(normal(-1, 1), class ="b", coef ="Intercept"), brms::prior(normal(0, 1.5), class ="b", coef ="x"), brms::prior(exponential(1.5),class ="sd", group ="grupo", coef ="Intercept"), brms::prior(exponential(3),class ="sd", group ="grupo", coef ="x"), brms::prior(lkj(2), class ="cor"))
# A tibble: 1 × 5
  modelo                         rhat_max ess_bulk_min ess_tail_min divergencias
  <chr>                             <dbl>        <dbl>        <dbl>        <int>
1 M2: previa de pendiente más c…     1.00         984.        1495.            0
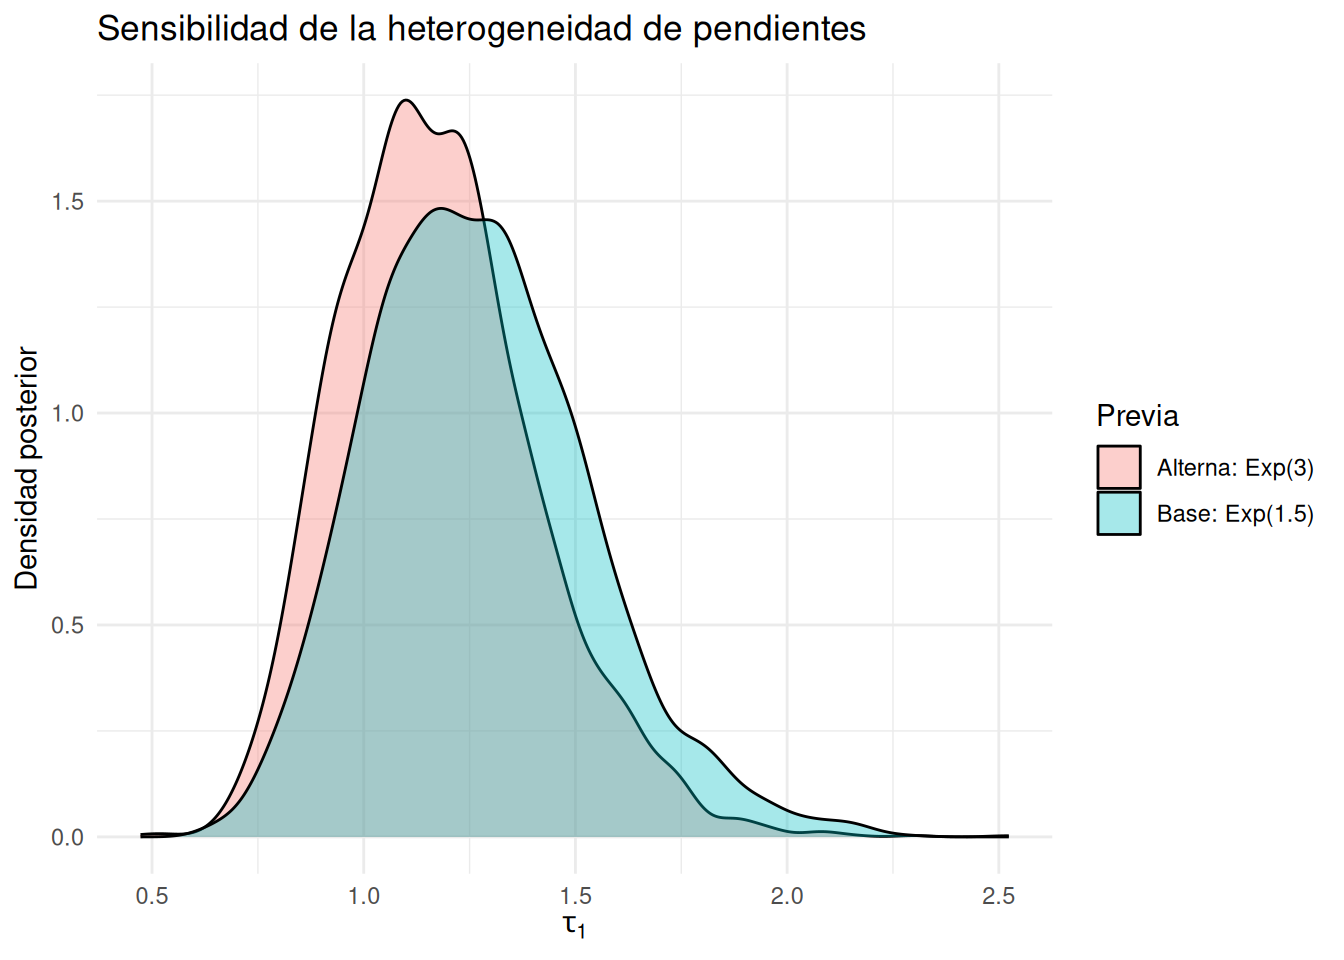
La comparación de las previas es más informativa si se combina con su implicación para \(\tau_1\), las probabilidades predichas y los contrastes en centros nuevos. Comenzaremos con la posterior de \(\tau_1\), sin asignar un valor numérico antes de calcular las simulaciones.
datos_tau_s14 <- dplyr::bind_rows( tibble::tibble(tau = tau_base_s14, previa ="Base: Exp(1.5)"), tibble::tibble(tau = tau_alt_s14, previa ="Alterna: Exp(3)"))ggplot2::ggplot( datos_tau_s14, ggplot2::aes(x = tau, fill = previa)) + ggplot2::geom_density(alpha =0.35) + ggplot2::labs(x =expression(tau[1]), y ="Densidad posterior",fill ="Previa",title ="Sensibilidad de la heterogeneidad de pendientes" ) + ggplot2::theme_minimal(base_size =11)
Distribuciones posteriores de la desviación estándar de pendientes grupales bajo dos previas.
Ahora construiremos una cantidad en la escala original de la respuesta: la diferencia de probabilidades esperadas entre \(x=1\) y \(x=0\) para un mismo centro nuevo. Cada extracción incluye un par de efectos grupales generado conjuntamente, por lo que ambas probabilidades comparten la heterogeneidad de ese centro.
datos_contraste_s14 <- dplyr::bind_rows( tibble::tibble(delta = delta_nuevo_base_s14,previa ="Base: Exp(1.5)" ), tibble::tibble(delta = delta_nuevo_alt_s14,previa ="Alterna: Exp(3)" ))ggplot2::ggplot( datos_contraste_s14, ggplot2::aes(x = delta, fill = previa)) + ggplot2::geom_density(alpha =0.35) + ggplot2::geom_vline(xintercept =0, linetype =2) + ggplot2::labs(x ="Diferencia de probabilidad esperada",y ="Densidad predictiva para el contraste de un centro nuevo",fill ="Previa",title ="¿Cambian las conclusiones relevantes bajo otra previa?" ) + ggplot2::theme_minimal(base_size =11)
Diferencia de probabilidades esperadas entre x = 1 y x = 0 para un mismo centro nuevo, bajo dos previas.
El gráfico incorpora incertidumbre de parámetros poblacionales y heterogeneidad de posibles centros nuevos. No incorpora variabilidad binomial de respuestas individuales porque se comparan probabilidades esperadas, no resultados binarios generados. Tampoco representa la posterior de un promedio poblacional sobre todos los centros: para calcular ese promedio habría que integrar adicionalmente sobre la distribución de centros en cada extracción. Esta distinción es la misma que trabajamos al comunicar predicciones en la semana 13.
El análisis de sensibilidad debe concluir con una afirmación condicionada a los resultados efectivamente obtenidos. Por ejemplo, si la posterior de \(\tau_1\) cambia, pero la probabilidad de un contraste positivo para un centro nuevo es parecida, podríamos afirmar que esa conclusión particular resulta relativamente estable bajo las dos previas examinadas; no que el modelo es insensible a cualquier distribución previa.
14.9.11 Extensión breve: WAIC y stacking
La siguiente comparación tiene un propósito secundario. No se utilizará para reemplazar los diagnósticos de LOO.
waic_m1_s14 <- brms::waic(fit_m1_s14)waic_m2_s14 <- brms::waic(fit_m2_s14)cat("WAIC de M1:\n")
WAIC de M1:
print(waic_m1_s14)
Computed from 3200 by 1356 log-likelihood matrix.

          Estimate   SE
elpd_waic   -773.0 17.3
p_waic        22.2  0.7
waic        1546.0 34.6
cat("\nWAIC de M2:\n")
WAIC de M2:
print(waic_m2_s14)
Computed from 3200 by 1356 log-likelihood matrix.

          Estimate   SE
elpd_waic   -743.4 17.8
p_waic        32.8  1.3
waic        1486.8 35.7

1 (0.1%) p_waic estimates greater than 0.4. We recommend trying loo instead.
# Las ponderaciones de stacking son una extensión predictiva.# Su interpretación requiere que los objetos LOO sean confiables.if (all(is.finite(k_m1_s14) & k_m1_s14 < limite_k_m1_s14) &&all(is.finite(k_m2_s14) & k_m2_s14 < limite_k_m2_s14)) { pesos_stacking_s14 <- loo::loo_model_weights(list(M1 = loo_m1_s14, M2 = loo_m2_s14),method ="stacking" )print(pesos_stacking_s14)} else {cat("No se calculan pesos de stacking: primero debe investigarse ","la confiabilidad de los resultados PSIS-LOO.\n",sep ="" )}
Method: stacking
------
   weight
M1 0.028
M2 0.972
Si WAIC y LOO presentan diferencias o advertencias, debemos estudiar las contribuciones observacionales y la confiabilidad de las aproximaciones. Las ponderaciones de stacking, cuando se calculan, describen una combinación predictiva y no una probabilidad posterior sobre la verdad de cada modelo.
14.10 Aplicación con datos reales: conteos repetidos de crisis epilépticas
Retomamos MASS::epil, utilizado en la semana 9 y en la sección aplicada de la semana 13. La respuesta es un conteo observado repetidamente en personas, por lo que un análisis que ignore la estructura longitudinal puede atribuir demasiada información independiente a mediciones de una misma persona. Nuestra pregunta aquí no es decidir si un coeficiente es «significativo», sino elegir qué aspecto del proceso queremos predecir.
El siguiente bloque prepara el conjunto real y presenta su estructura; no implica todavía ajustar modelos.
La media y la variancia de los conteos, por sí solas, no demuestran sobredispersión condicional. El modelo Poisson puede tener una variancia marginal mayor que su media cuando existe heterogeneidad entre personas. La pregunta es si la estructura Poisson condicional y el intercepto variable reproducen adecuadamente las características que interesan; la binomial negativa permite una forma adicional de dispersión condicional.
Proponemos dos especificaciones con predictores idénticos:
con \(\operatorname{Var}(Y_{it}\mid\mu_{it},\varphi)=\mu_{it}+\mu_{it}^2/\varphi\) para la binomial negativa. La fórmula de la media también corresponde al modelo P sustituyendo \(\mu\) por \(\lambda\). La variable log_base_c es una transformación centrada del conteo basal; el tratamiento se maneja como factor y el período como tendencia lineal exploratoria. Es una especificación didáctica, no un análisis definitivo del estudio.
La comparación con loo por fila evaluaría otra ocasión de una persona con otras observaciones suyas disponibles. Para predecir trayectorias de personas enteramente nuevas, la unidad de exclusión debería ser la persona completa. Para predecir una ocasión futura de una persona conocida, además, se debe respetar la información temporal que efectivamente estará disponible.
El ajuste es opcional, porque introduce otros dos modelos con HMC. Para activarlo use EJECUTAR_EPIL_S14=1.
if (identical(Sys.getenv("EJECUTAR_EPIL_S14", "0"), "1")) { prior_epil_poisson_s14 <-c( brms::prior(normal(1.5, 1.5), class ="Intercept"), brms::prior(normal(0, 1), class ="b"), brms::prior(exponential(1), class ="sd") ) prior_epil_nb_s14 <-c( prior_epil_poisson_s14, brms::prior(gamma(2, 0.2), class ="shape") ) formula_epil_s14 <- brms::bf( y ~ trt + periodo + log_base_c + (1| subject) ) fit_epil_p_s14 <- brms::brm(formula = formula_epil_s14,data = epil_s14,family = brms::poisson(link ="log"),prior = prior_epil_poisson_s14,backend ="cmdstanr",chains =4, cores = n_cores_s14,iter =1600, warmup =800,seed =16531431,control =list(adapt_delta =0.95),file ="_fits/epil_poisson_s14",file_refit ="on_change",refresh =0 ) fit_epil_nb_s14 <- brms::brm(formula = formula_epil_s14,data = epil_s14,family = brms::negbinomial(link ="log"),prior = prior_epil_nb_s14,backend ="cmdstanr",chains =4, cores = n_cores_s14,iter =1600, warmup =800,seed =16531432,control =list(adapt_delta =0.95),file ="_fits/epil_binomial_negativa_s14",file_refit ="on_change",refresh =0 )cat("Diagnóstico de P y NB:\n")print(dplyr::bind_rows(resumir_mcmc_s14(fit_epil_p_s14, "Poisson"),resumir_mcmc_s14(fit_epil_nb_s14, "Binomial negativa") ))print(brms::pp_check(fit_epil_p_s14, ndraws =40, type ="bars"))print(brms::pp_check(fit_epil_nb_s14, ndraws =40, type ="bars")) loo_epil_p_s14 <- brms::loo(fit_epil_p_s14) loo_epil_nb_s14 <- brms::loo(fit_epil_nb_s14)print(loo::loo_compare(list(Poisson = loo_epil_p_s14,`Binomial negativa`= loo_epil_nb_s14 )))cat("Pareto k de Poisson:\n")print(loo::pareto_k_table(loo_epil_p_s14))cat("Pareto k de binomial negativa:\n")print(loo::pareto_k_table(loo_epil_nb_s14))} else {cat("Ajuste con datos reales omitido. ","Active EJECUTAR_EPIL_S14=1 si desea ejecutarlo.\n",sep ="" )}
Ajuste con datos reales omitido. Active EJECUTAR_EPIL_S14=1 si desea ejecutarlo.
Como actividad posterior al ajuste, se debe construir una comprobación de la proporción de ceros y la heterogeneidad entre personas, e identificar si el desempeño por observación de Poisson y NB cambia al considerar personas nuevas. Esta última comparación puede realizarse con brms::kfold(), particionando por subject, no mediante la exclusión aleatoria de filas. Si la binomial negativa obtiene una puntuación superior, todavía se necesita interpretar las diferencias predictivas y comprobar que la forma de dispersión adicional es adecuada para los datos.
14.11 Síntesis y decisiones de modelación
La comparación predictiva no es el último paso del análisis. Forma parte del ciclo que conecta pregunta sustantiva, formulación probabilística, inferencia, comprobación, predicción y revisión. Para organizar un informe recomendamos el siguiente orden:
Definir el objetivo. ¿Se quiere explicar una asociación, predecir una observación de un grupo conocido o generalizar a grupos nuevos?
Describir las especificaciones. Identificar qué estructura de coeficientes grupales y qué supuestos cambian, manteniendo claro el estimando de interés.
Confirmar el diagnóstico de MCMC. Inspeccionar \(\widehat R\), ESS, divergencias y dificultades de parametrización.
Comprobar las implicaciones del modelo. Considerar resúmenes globales y por grupo que resulten relevantes para el problema.
Elegir la unidad de validación. Justificar si se excluyen filas, individuos, centros, períodos o bloques completos.
Cuantificar el desempeño. Interpretar elpd, diferencias y su incertidumbre; investigar \(\widehat k\) de Pareto y contribuciones concentradas.
Estudiar sensibilidad. Comparar conclusiones ante previas u otras especificaciones razonables, sin reescribir la pregunta después de mirar únicamente la tabla de resultados.
Comunicar una decisión proporcional a la evidencia. Puede corresponder conservar un modelo, presentar varios, ampliar su estructura o reconocer que los datos no permiten distinguirlos de manera confiable.
14.11.1 Errores frecuentes
Error
Por qué es problemático
Corrección conceptual
Declarar «mejor modelo» por el menor LOOIC.
Ignora magnitud, incertidumbre, diagnósticos y relevancia sustantiva.
Examinar diferencias de elpd y las predicciones que las producen.
Interpretar LOO por fila como predicción de centros nuevos.
Las otras respuestas del mismo centro siguen informando su coeficiente.
Excluir centros completos para ese objetivo.
Suponer que \(\widehat k\) elevado demuestra que una observación es errónea.
Es un diagnóstico de estabilidad de pesos e influencia, no de calidad de medición.
Investigar el caso, la verosimilitud y alternativas de cómputo.
Restar errores estándar individuales para obtener el error de la comparación.
Las dos puntuaciones están emparejadas por unidad.
Utilizar las diferencias por unidad.
Ignorar la dependencia al construir incertidumbre de elpd.
Puede producir incertidumbre demasiado pequeña.
Usar unidades de evaluación acordes con el objetivo y la dependencia.
Aplicar stacking antes de comprobar modelos.
Una combinación puede ocultar deficiencias de ambos componentes.
Comprobar, diagnosticar y luego considerar la combinación.
Cambiar todas las previas a la vez en un análisis de sensibilidad.
Impide identificar qué decisión causa la variación.
Modificar decisiones de manera transparente y justificada.
Interpretar robustez de un contraste como robustez de todo el modelo.
Cada conclusión puede tener sensibilidad distinta.
Seleccionar una alternativa solo porque mejora la puntuación en los mismos datos examinados repetidamente.
La exploración adaptativa puede volver optimista la evaluación.
Reconocer el proceso exploratorio y, cuando sea posible, usar evaluación externa o validación anidada.
14.11.2 Criterios de comunicación
Un reporte informativo no termina con una tabla de comparación. Debería incluir una declaración del objetivo predictivo, la unidad de exclusión, un resumen de la evidencia sobre adecuación del modelo, la comparación con su incertidumbre, el diagnóstico de Pareto, una cantidad sustantiva en la escala de respuesta y un análisis de sensibilidad relevante. Si las diferencias son pequeñas o inestables, conviene explicarlo en vez de presentarlas como una clasificación precisa (Gelman et al. 2026, chaps. 8–9).
En particular, una comparación entre M1 y M2 podría concluir que M2 representa mejor la heterogeneidad de contrastes de la muestra, que su ventaja LOO por observación es incierta, y que aún falta evaluar la generalización a centros nuevos. Estas tres afirmaciones son compatibles, porque corresponden a evaluaciones diferentes.
14.12 Ejercicios y avance del proyecto
Ejercicio 1. Comprobación frente a validación
Se ajusta un modelo binomial multinivel de la respuesta de pacientes agrupados en centros. Los gráficos predictivos posteriores reproducen satisfactoriamente la proporción global del evento y la variación de proporciones por centro. Sin embargo, una evaluación fuera de muestra revela que el modelo asigna probabilidades demasiado bajas a ciertos eventos observados.
a) Explique por qué no hay contradicción entre ambas evaluaciones. b) Proponga dos comprobaciones adicionales que ayuden a investigar el problema, indicando qué característica concreta del conjunto observado revisaría cada una. c) Distinga una posible deficiencia de la formulación del modelo de un problema de exploración MCMC. d) Explique por qué un nuevo predictor podría mejorar la predicción sin resolver necesariamente una discrepancia de dependencia entre observaciones.
Ejercicio 2. ¿Cuál es la unidad de validación?
Para cada caso, identifique la unidad de observación, la principal dependencia y el diseño de validación adecuado. Justifique qué información queda disponible al predecir:
a) El rendimiento de un estudiante de una escuela para la que ya existe información de otros estudiantes. b) El rendimiento en una escuela completamente nueva. c) La trayectoria completa de un paciente que no participó en el estudio. d) La próxima visita de un paciente conocido, sin utilizar las visitas posteriores a la que se predice. e) El conteo del próximo mes en un estudio de regiones con series temporales.
En los incisos d) y e), explique por qué una partición aleatoria de filas puede no reproducir el escenario de predicción prospectiva.
Ejercicio 3. Derivación para grupos nuevos
Considere el modelo normal de interceptos variables
con independencia condicional dentro de cada grupo.
a) Para parámetros poblacionales conocidos, obtenga la distribución marginal de una observación de un grupo nuevo. b) Para dos respuestas del mismo grupo nuevo, calcule su covarianza marginal condicionada a \(\mu,\sigma,\tau\). c) Explique por qué el producto de las dos densidades marginales univariadas no coincide con la densidad conjunta del par cuando \(\tau>0\). d) Relacione ese resultado con la integral de Ecuación 14.12. e) Explique qué cambia cuando \(\mu\), \(\sigma\) y \(\tau\) son desconocidos y deben promediarse sobre su posterior.
Ejercicio 4. Interpretar diferencias de elpd
Se comparan tres modelos mediante validación por observación, utilizando las mismas filas. Se obtiene la siguiente salida hipotética, creada para este ejercicio:
Modelo
Diferencia de elpd respecto al mejor
Error estándar de la diferencia
Observaciones con \(\widehat k\) elevado
A
0.0
0.0
0
B
-2.8
8.9
1
C
-17.5
6.4
14
a) ¿Qué permite concluir la comparación entre A y B? b) ¿Qué precaución impone el resultado de C? c) ¿Sería correcto calcular el error estándar de A frente a B restando los errores estándar individuales de sus elpd? Justifique. d) Indique qué resultados adicionales solicitaría antes de recomendar un modelo para centros nuevos. e) Explique cómo comunicaría la comparación sin utilizar una prueba automática de hipótesis.
Ejercicio 5. Auditoría computacional de PSIS-LOO
Utilice los objetos loo_m1_s14, loo_m2_s14, contribuciones_s14 y contribuciones_centro_s14.
a) Reproduzca a mano, mediante la suma de contribuciones por fila, la diferencia global de elpd entre M2 y M1. b) Identifique los tres centros con mayores diferencias absolutas de puntuación y describa el patrón. c) Investigue las filas que excedan el umbral de Pareto, si las hay. Si ninguna lo excede, explique qué significa ese resultado y qué no significa. d) Distinga explícitamente la suma de diferencias por centro de una evaluación que haya dejado el centro entero fuera. e) Proponga un gráfico adicional que permita estudiar si la ventaja predictiva de M2 cambia con \(x\).
Ejercicio 6. Sensibilidad de las conclusiones
Compare fit_m2_s14 con fit_m2_alterno_s14.
a) ¿Cuál parámetro recibe una distribución previa diferente? b) Examine la posterior de la desviación estándar de pendientes grupales y la distribución de los contrastes para un centro nuevo. c) Formule una conclusión cuya estabilidad pueda discutirse mediante estas cantidades. d) Explique por qué una diferencia considerable en la posterior de \(\tau_1\) no obliga a encontrar la misma diferencia en una probabilidad promedio. e) Describa una tercera previa plausible para \(\tau_1\) en esta escala y cómo comprobaría sus implicaciones antes de ajustar el modelo.
Ejercicio 7. Aplicación con datos reales
A partir de MASS::epil, examine dos modelos de conteos repetidos con interceptos individuales: Poisson y binomial negativa. Active el módulo opcional si dispone del entorno computacional apropiado.
a) Justifique por qué la varianza marginal de los conteos no basta para diagnosticar sobredispersión condicional. b) Compare predicciones de ceros y observaciones extremas mediante simulación posterior. c) Evalúe PSIS-LOO por fila y sus diagnósticos. d) Proponga una validación por individuos completos y señale por qué responde otra pregunta. e) Escriba un informe breve que reúna adecuación, comparación, incertidumbre y sensibilidad a una decisión de modelación.
Avance del proyecto de investigación
Para esta semana, cada equipo deberá incorporar a su informe reproducible un apartado de validación y sensibilidad que incluya: la pregunta predictiva; la unidad que corresponde excluir para evaluar esa pregunta; al menos dos especificaciones comparables; evidencia de que los ajustes son computacionalmente adecuados; una evaluación predictiva con su incertidumbre y diagnósticos; un análisis de sensibilidad a una decisión concreta de modelación; y una conclusión que distinga comparación numérica, adecuación sustantiva y limitaciones. En modelos longitudinales deberá indicarse si la validación utiliza o no información temporal futura. No es necesario que la comparación produzca un modelo ganador.
14.13 Referencias y lecturas recomendadas
Lecturas principales: Gelman et al. (Gelman et al. 2013, chap. 7, especialmente secs. 7.1–7.3, pp. 165–181) para precisión predictiva, criterios de información y comparación; Bayesian Workflow(Gelman et al. 2026, sec. 9.4, pp. 162–167) para el vínculo entre comprobación y desempeño, y (Gelman et al. 2026, chap. 24, pp. 369–388) para el estudio de PSIS-LOO, diagnóstico y comparación en modelos de conteos.
Lecturas complementarias: McElreath (McElreath 2020, secs. 7.4–7.5, pp. 217–235) para sobreajuste y PSIS; Bayesian Workflow(Gelman et al. 2026, secs. 9.5–9.7 y chap. 25) para stacking, expansión y predicción con datos nuevos; BDA (Gelman et al. 2013, secs. 7.4–7.6) para factores de Bayes y expansión; y Gelman y Hill (Gelman y Hill 2007, sec. 24.3) para la conexión con criterios tradicionales. La base computacional se encuentra en Bürkner (Bürkner 2017) y en los trabajos de evaluación predictiva de Vehtari y colaboradores (Vehtari et al. 2017, 2024).
La semana 15 ampliará esta discusión hacia datos faltantes y error de medición. Allí analizaremos cómo las decisiones sobre información no observada y mediciones imperfectas afectan tanto las inferencias como las predicciones que buscamos validar.
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, John B. Carlin, Hal S. Stern, David B. Dunson, Aki Vehtari, y Donald B. Rubin. 2013. Bayesian Data Analysis. 3.ª ed. Chapman & Hall/CRC.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. 2.ª ed. Chapman & Hall/CRC.
Vehtari, Aki, Andrew Gelman, y Jonah Gabry. 2017. «Practical Bayesian Model Evaluation Using Leave-One-Out Cross-Validation and WAIC». Statistics and Computing 27 (5): 1413-32. https://doi.org/10.1007/s11222-016-9696-4.
Vehtari, Aki, Daniel Simpson, Andrew Gelman, Yuling Yao, y Jonah Gabry. 2024. «Pareto Smoothed Importance Sampling». Journal of Machine Learning Research 25 (72): 1-58.
West, Brady T., Kathleen B. Welch, y Andrzej T. Galecki. 2022. Linear Mixed Models: A Practical Guide Using Statistical Software. 3.ª ed. CRC Press. https://doi.org/10.1201/9781003181064.