11Semana 11. Modelos longitudinales de trayectorias
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
19 de octubre de 2026
11.1 Panorama de la semana
En las semanas anteriores hemos utilizado modelos multinivel para representar la variación entre grupos, permitiendo que sus interceptos y pendientes cambien de acuerdo con distribuciones poblacionales. En esta semana los grupos serán individuos observados varias veces, y el predictor principal será el tiempo. La cuestión estadística ya no consiste solamente en describir diferencias entre personas, sino en estudiar cómo cambia una respuesta dentro de cada persona y en qué medida las trayectorias difieren de un individuo a otro.
Pregunta orientadora. ¿Cómo representamos el cambio individual a través del tiempo, sus diferencias entre individuos y la incertidumbre de las trayectorias estimadas y futuras?
Pensemos en un estudio donde se registra diariamente el tiempo de reacción de diferentes participantes durante varios días de restricción del sueño. Algunos pueden comenzar con respuestas más rápidas; algunos pueden experimentar un aumento marcado del tiempo de reacción, y otros pueden mostrar cambios menores. Una sola regresión de la respuesta sobre el día de medición describiría una tendencia común, pero no representaría directamente estas diferencias entre trayectorias. Por otra parte, ajustar una recta completamente independiente para cada participante desaprovecharía la información sobre la población de individuos.
Un modelo longitudinal de interceptos y pendientes variables combina ambas fuentes de información. Para el individuo \(i\), observado en la ocasión \(j\), consideramos inicialmente
Aquí \(t_{ij}\) es el tiempo real de observación, no necesariamente el número entero de la visita. El intercepto \(\alpha_i\) describe el valor esperado de la respuesta del individuo \(i\) cuando \(t=0\); la pendiente \(\beta_i\) describe su cambio esperado por unidad de tiempo. Los parámetros \(\mu_\alpha\) y \(\mu_\beta\) caracterizan la población de individuos, mientras que \(\boldsymbol\Sigma\) describe la variación y asociación de sus coeficientes (Gelman y Hill 2007, sec. 13.1; Hox et al. 2018, chap. 5).
El concepto principal es que la trayectoria poblacional y las trayectorias individuales son objetos distintos. Un modelo puede sugerir un cambio medio positivo y, simultáneamente, permitir individuos con cambios cercanos a cero o negativos. Una evaluación adecuada debe considerar ambas escalas.
Objetivos de aprendizaje
Al finalizar la semana, se espera que la persona estudiante pueda:
reconocer la unidad de observación, la unidad longitudinal y el papel del tiempo en un conjunto de mediciones repetidas;
distinguir datos longitudinales de diseños de medidas repetidas con ocasiones fijas, y examinar tiempos irregulares y números desiguales de observaciones;
escribir la formulación jerárquica y matricial de un modelo de interceptos y pendientes temporales variables;
interpretar las trayectorias poblacionales e individuales, sus componentes de variabilidad y las interacciones con el tiempo;
deducir la varianza en un instante y la covarianza entre dos mediciones de un mismo individuo;
explicar cómo el cambio del origen temporal modifica el intercepto y la correlación intercepto–pendiente, sin alterar las trayectorias descritas por la verosimilitud;
justificar previas para parámetros de localización, tasas de cambio, desviaciones estándar y correlaciones, y comprobar sus implicaciones predictivas;
ajustar el modelo con brms y el backendcmdstanr, revisando los diagnósticos básicos de HMC/NUTS;
realizar comprobaciones predictivas globales, temporales y por individuo, e interpretar predicciones para individuos conocidos y nuevos;
identificar las limitaciones de extrapolar una trayectoria lineal y distinguir la heterogeneidad de trayectorias de la dependencia residual adicional.
NotaFuentes, terminología y elaboración
La estructura conceptual del capítulo procede principalmente del capítulo 5 de Hox, Moerbeek y van de Schoot, de los capítulos 11–13 de Gelman y Hill, y de la discusión de modelos longitudinales de coeficientes variables de West, Welch y Galecki (Hox et al. 2018, chap. 5; Gelman y Hill 2007, secs. 11.3, 13.1-13.4; West et al. 2022, chap. 6). Verbeke y Molenberghs proporcionan el marco clásico de análisis exploratorio y modelos lineales mixtos longitudinales (Verbeke y Molenberghs 2000, chaps. 3-4). La formulación bayesiana se complementa con Bayesian Workflow(Gelman et al. 2026, chaps. 5, 8, 11-12). Las simulaciones, derivaciones didácticas, figuras y decisiones del laboratorio son elaboraciones originales para esta unidad. Utilizaremos preferentemente interceptos y pendientes variables, señalando que la literatura clásica también los denomina efectos aleatorios.
11.2 ¿Qué distingue a una estructura longitudinal?
11.2.1 Unidad de observación, individuo y ocasión
En un conjunto longitudinal cada individuo \(i=1,\ldots,N\) aporta \(n_i\) observaciones. El índice \(j=1,\ldots,n_i\) identifica la observación dentro del individuo; \(t_{ij}\) indica el tiempo correspondiente. Esta notación diferencia orden de visita (\(j\)) y tiempo transcurrido (\(t_{ij}\)). Por ejemplo, dos personas pueden tener su segunda visita en momentos distintos.
Variable
Nivel y función
Ejemplo
\(Y_{ij}\)
Respuesta en la ocasión \(j\) del individuo \(i\)
Tiempo de reacción
\(i\)
Identificador del individuo
Participante
\(j\)
Índice de la observación dentro del individuo
Primera, segunda, tercera medición
\(t_{ij}\)
Tiempo de la medición, en una escala definida
Días desde el comienzo del seguimiento
\(z_i\)
Covariable constante durante el período observado
Grupo asignado al inicio
\(x_{ij}\)
Covariable que puede cambiar de ocasión a ocasión
Consumo de cafeína ese día
En la representación larga (long), cada fila contiene una medición y el identificador del individuo. En la representación ancha (wide), una fila corresponde al individuo y existen columnas distintas para cada ocasión. La primera facilita los modelos multinivel con tiempos desiguales o mediciones faltantes (Hox et al. 2018, secs. 5.1-5.3).
Un esquema ilustrativo en formato largo es:
individuo
ocasión
día
respuesta
A
1
0
265
A
2
2
279
A
3
5
305
B
1
0
301
B
2
3
298
B
3
5
320
Los números anteriores son ficticios y solo muestran la estructura: \(j\) no debe reemplazar automáticamente a \(t_{ij}\). Si una persona fue observada en los días 0, 2 y 5, codificar el tiempo como 1, 2 y 3 cambiaría la relación entre la pendiente y los días realmente transcurridos.
11.2.2 Longitudinal, medidas repetidas y datos desbalanceados
Datos longitudinales son registros de una misma unidad a lo largo del tiempo, generalmente para estudiar cómo cambia una característica. El término medidas repetidas también cubre situaciones experimentales en las que las observaciones repetidas corresponden, por ejemplo, a condiciones de laboratorio aplicadas en un orden preestablecido. Ambos tipos de datos tienen dependencia entre observaciones de una misma unidad, pero no siempre tienen una noción equivalente de trayectoria temporal.
Es conveniente distinguir:
Ocasiones fijas: todos los individuos siguen un calendario común, aunque algunos tengan mediciones faltantes. El tiempo puede representarse como variable cuantitativa o, si interesa comparar ocasiones sin imponer linealidad, como factor.
Ocasiones variables: la edad, fecha o tiempo desde la entrada puede diferir entre individuos; una variable cuantitativa de tiempo permite utilizar esos intervalos reales.
Panel balanceado: todos los individuos aportan observaciones en los mismos tiempos.
Panel desbalanceado: difieren los números de observaciones o los tiempos de medición.
Una ventaja de los modelos de coeficientes variables es que permiten trabajar directamente con \(n_i\) y \(t_{ij}\) distintos, sin obligar a completar artificialmente un rectángulo de datos. Esto no significa que cualquier mecanismo de ausencia sea ignorable: su interpretación dependerá de por qué faltan mediciones (Hox et al. 2018, secs. 5.4-5.7; West et al. 2022, chap. 6). La modelación explícita de datos faltantes se retomará en la semana 15.
ImportanteTres preguntas que no deben confundirse
¿Cuántos individuos hay? Determina la cantidad de unidades que informan directamente sobre la heterogeneidad poblacional de trayectorias.
¿Cuántas mediciones aporta cada individuo y en qué tiempos? Determina cuánta información está disponible para distinguir sus interceptos y pendientes.
¿Por qué algunas mediciones no fueron observadas? Determina si el análisis de los datos disponibles tiene una interpretación suficiente para el objetivo de estudio.
11.3 Del gráfico de trayectorias al modelo
Antes del ajuste conviene dibujar la respuesta frente al tiempo y unir, dentro de cada individuo, observaciones sucesivas. Este gráfico suele llamarse gráfico de trayectorias individuales o spaghetti plot. Permite examinar niveles iniciales, tasas de cambio, cambios bruscos, dispersión temporal y diferencias en la cobertura del seguimiento (Verbeke y Molenberghs 2000, chap. 4; West et al. 2022, sec. 6.2).
La lectura de estas figuras requiere prudencia. Las líneas que unen puntos observados no son estimaciones precisas de una curva subyacente y las pendientes calculadas a partir de dos observaciones pueden ser muy inestables. Además, si la varianza observada aumenta con el tiempo, ello puede resultar de heterogeneidad en pendientes sin que necesariamente aumente la varianza residual condicional.
Para motivar los modelos, imaginemos tres individuos que presentan los siguientes cambios por día:
No basta con una única recta para expresar estas tres trayectorias. Un modelo de interceptos variables permite distintas alturas, pero impone la misma pendiente; un modelo de pendientes variables permite diferencias en las tasas de cambio.
11.4 Modelo longitudinal de interceptos variables
El primer modelo supone que todas las personas tienen una pendiente temporal común, aunque difieran en su nivel esperado al tiempo de referencia:
La interpretación es concreta: los individuos tienen rectas paralelas. El contraste esperado entre dos tiempos cualesquiera dentro del mismo individuo es
Por lo tanto, todos comparten la misma tasa de cambio. El modelo no implica independencia marginal entre mediciones de una persona. Si \(j\ne k\) y los errores condicionales son independientes,
La correlación entre dos mediciones distintas es constante: \(\tau_0^2/(\tau_0^2+\sigma^2)\). Es una estructura de simetría compuesta, demasiado restrictiva cuando quienes comienzan con respuestas similares cambian después a velocidades distintas. La distinción entre la dependencia generada por coeficientes variables y la dependencia residual será importante en la próxima semana (Hox et al. 2018, sec. 5.6).
11.5 Modelo de interceptos y pendientes variables
11.5.1 Jerarquía, parámetros y verosimilitud
La extensión principal consiste en admitir una pendiente distinta por individuo. Para no confundir los coeficientes individuales con los parámetros poblacionales, escribimos
Así, \(\alpha_i=\mu_\alpha+u_{0i}\) y \(\beta_i=\mu_\beta+u_{1i}\) son el intercepto y la pendiente individual. Su distribución conjunta es equivalente a la presentada en Ecuación 11.1.
Los parámetros se interpretan como sigue:
Parámetro
Interpretación, condicionada a los demás parámetros
\(\mu_\alpha\)
Intercepto poblacional en \(t=0\)
\(\mu_\beta\)
Cambio esperado por unidad de tiempo, promediado sobre la distribución poblacional de individuos
\(\tau_0\)
Desviación estándar entre interceptos individuales
\(\tau_1\)
Desviación estándar entre pendientes individuales
\(\rho\)
Correlación poblacional entre interceptos y pendientes en la parametrización temporal elegida
\(\sigma\)
Desviación estándar de la dispersión observacional alrededor de la recta de cada individuo
Interpretación de una pendiente. Si la respuesta se mide en milisegundos y \(t\) en días, una pendiente de \(12\) significa un incremento esperado de 12 milisegundos por día para ese individuo, siempre bajo la aproximación lineal y condicionado a sus coeficientes. La diferencia esperada entre los días 2 y 6 sería \(4\times12=48\) milisegundos.
La distribución de los coeficientes grupales permite pooling parcial: individuos con pocas mediciones o tiempos poco informativos reciben una regularización mayor hacia la distribución poblacional. La magnitud y forma de esa regularización dependen de la variación residual, de la variabilidad entre individuos, del número y separación temporal de sus observaciones y de la covarianza entre los coeficientes (Gelman y Hill 2007, chaps. 12-13).
La verosimilitud condicional en los coeficientes individuales es
El modelo declara independientes los errores condicionalmente en\((u_{0i},u_{1i})\) y los demás parámetros. Al integrar los coeficientes individuales se obtiene una distribución conjunta correlacionada para las observaciones de un mismo individuo. No debe confundirse independencia condicional con independencia marginal.
11.5.2 Representación matricial
Para cada individuo, definimos el vector \(\mathbf y_i\) de longitud \(n_i\) y las matrices de diseño
Aquí los términos \(\mathbf u_i\) y \(\boldsymbol\varepsilon_i\) son independientes según el modelo. La forma matricial es especialmente útil para representar la estructura de covarianza marginal, incorporar otros predictores y reconocer la correspondencia con los modelos lineales mixtos de la literatura clásica (West et al. 2022, chap. 2; Verbeke y Molenberghs 2000, chap. 3).
11.5.3 ¿Cuánto cambia la respuesta entre dos tiempos?
La diferencia esperada condicional, no la diferencia observada, entre los tiempos \(t_a\) y \(t_b\) es
Estos dos contrastes tienen distribuciones posteriores diferentes: uno depende del coeficiente de una persona concreta y el otro del coeficiente poblacional. Además, la distribución de los cambios observados contiene errores de medición en ambas ocasiones.
11.6 Dependencia temporal inducida por los coeficientes variables
11.6.1 Varianza que depende del tiempo
Condicionalmente en los parámetros poblacionales \(\boldsymbol\theta=(\mu_\alpha,\mu_\beta,\tau_0,\tau_1,\rho,\sigma)\), y después de integrar los coeficientes individuales,
El término \(t^2\tau_1^2\) muestra que la heterogeneidad de pendientes puede hacer que aumente la dispersión entre observaciones a medida que el tiempo se aleja de su origen. La variación no tiene por qué crecer monótonamente: el término de covarianza \(2t\rho\tau_0\tau_1\) puede cambiar esa forma.
11.6.2 Covarianza entre dos observaciones
Sean \(t\) y \(s\) dos tiempos distintos de una misma persona. Aplicando la bilinealidad de la covarianza,
La última igualdad presupone errores condicionalmente independientes y sin correlación con los coeficientes individuales. Para dos tiempos coincidentes, la varianza de una observación incluye además \(\sigma^2\), como en Ecuación 11.7.
Por tanto, la matriz de covarianza marginal del individuo \(i\) es
Una característica importante es que esta covarianza depende de los tiempos concretos\(t\) y \(s\), y no únicamente de la distancia \(|t-s|\). Así, en general no representa un proceso estacionario. En términos sustantivos, la dependencia surge porque dos respuestas comparten el nivel y la tasa de cambio propios del individuo.
En la semana 12 distinguiremos esta dependencia de una eventual autocorrelación residual adicional: aun después de conocer la recta individual, observaciones próximas podrían exhibir errores correlacionados.
TipResultado para discutir en clase
Un aumento de la variabilidad observada hacia el final del seguimiento no constituye, por sí solo, evidencia de heterocedasticidad residual. Podría explicarse por una distribución heterogénea de pendientes. Conviene preguntar primero qué parte de la dispersión reproduce la jerarquía de coeficientes antes de proponer otra estructura para los errores.
11.7 Origen temporal, centrado e interpretación
11.7.1 ¿Qué significa tiempo cero?
El intercepto individual \(\alpha_i\) es el valor esperado en \(t=0\). Por eso el origen del tiempo debe elegirse con significado sustantivo y dentro, o razonablemente cerca, del rango observado. Algunas posibilidades son: fecha de ingreso al estudio, primera medición, inicio de un tratamiento, edad específica o punto medio del seguimiento.
No son decisiones equivalentes. Tiempo desde el ingreso permite comparar trayectorias desde la entrada; edad cronológica permite comparar individuos a edades iguales, pero mezcla la edad de entrada con la duración del seguimiento si no se incorpora información adicional. Tampoco deben confundirse períodos de calendario, edad y tiempo desde un evento cuando pueden operar procesos diferentes (Hox et al. 2018, sec. 5.4).
El centrado en el punto medio del seguimiento suele facilitar la interpretación del intercepto cuando \(t=0\) originalmente queda lejos de los datos. También puede disminuir ciertas dependencias posteriores entre interceptos y pendientes y favorecer una parametrización numéricamente estable, aunque no garantiza por sí mismo un ajuste computacional satisfactorio.
11.7.2 Derivación del cambio de origen
Supongamos que definimos un tiempo centrado \(t^*=t-c\). Entonces \(t=t^*+c\) y, para un individuo,
\[
\alpha_i+\beta_i t
=(\alpha_i+c\beta_i)+\beta_i t^*
=\alpha_i^*+\beta_i^*t^*.
\]
La recta representada es exactamente la misma, pero su intercepto ahora expresa el valor esperado en el tiempo original \(t=c\). Los parámetros poblacionales también se transforman:
En consecuencia, la correlación entre interceptos y pendientes no es una propiedad independiente del origen del tiempo. Un mismo conjunto de trayectorias puede dar correlaciones distintas al describirse desde el comienzo, el punto medio o el final del seguimiento. Hox y colaboradores destacan esta equivalencia de las representaciones temporales y la necesidad de interpretar la correlación en un origen significativo (Hox et al. 2018, 82-84).
Por ejemplo, si \(\tau_1^2>0\), la covarianza transformada es cero cuando \(c=-\rho\tau_0\tau_1/\tau_1^2\). Tal elección puede quedar fuera del rango observado y no es una regla obligatoria de centrado. La prioridad debe ser interpretar el tiempo y representar los datos adecuadamente.
ImportantePrecisión bayesiana sobre la equivalencia
El cambio \(t\mapsto t-c\) es una reparametrización exacta de la verosimilitud, y preserva las trayectorias si transformamos conjuntamente sus coeficientes. Para que la distribución posterior de las cantidades sustantivas permanezca idéntica, también hay que transformar coherentemente la distribución previa conjunta. Si se reajusta el modelo imponiendo las mismas previas numéricas, pero independientes, a coeficientes definidos respecto de otro origen, pueden cambiar las distribuciones posteriores porque se ha cambiado la información previa, no solo la etiqueta del tiempo. Esta distinción es relevante en modelos bayesianos.
11.8 Covariables e interacciones con el tiempo
11.8.1 Covariables constantes en el tiempo
Si \(z_i\) es una característica del individuo que no cambia durante el seguimiento, podemos formular
\(\gamma\): diferencia esperada entre individuos con \(z=1\) y \(z=0\)en el tiempo de referencia, cuando \(z\) es binaria;
\(\delta\): diferencia en tasas temporales de cambio entre esas dos categorías;
\(\gamma+\delta t\): diferencia esperada entre categorías en el tiempo \(t\);
\(\mu_\beta+\delta z_i+u_{1i}\): pendiente temporal esperada del individuo \(i\).
Una interacción tiempo \(\times\) grupo puede describir trayectorias de medias diferentes aunque exista heterogeneidad residual entre pendientes individuales. No debe presentarse automáticamente como efecto causal del grupo; esa interpretación exigiría hipótesis sustantivas y de diseño adicionales (Hox et al. 2018, secs. 5.3-5.4; Gelman y Hill 2007, chap. 13).
11.8.2 Covariables que cambian durante el seguimiento
Podríamos disponer de una variable \(x_{ij}\) medida en cada ocasión. Entonces
La descomposición separa cambios dentro de una persona de diferencias entre personas. Por ejemplo, \(\eta_W\) compara ocasiones en las que una persona presenta valores distintos de su propio promedio de \(x\), mientras \(\eta_B\) caracteriza las diferencias entre promedios individuales, ajustadas por las demás variables. Los dos coeficientes no responden a la misma pregunta.
Esta extensión conecta con el centrado por grupo de la semana 3. Exige cuidado cuando los promedios individuales se calculan con cobertura temporal desigual, cuando \(x\) se determina en parte por respuestas anteriores o cuando existe confusión temporal. Aquí no se desarrollará un modelo causal del proceso conjunto de \(x\) e \(Y\).
11.9 Distribución posterior y formulación bayesiana
Escribamos \(\mathbf u=(\mathbf u_1,\ldots,\mathbf u_N)\) y \(\boldsymbol\phi=(\mu_\alpha,\mu_\beta,\tau_0,\tau_1,\rho,\sigma)\). En el modelo básico,
Los coeficientes individuales son parámetros latentes, no datos faltantes ni errores residuales. La inferencia bayesiana resume su distribución posterior conjuntamente con la incertidumbre en los parámetros poblacionales. Esto permite obtener, por ejemplo, \(p(\beta_i\mid\mathbf y)\), \(p(\mu_\beta\mid\mathbf y)\) y la distribución posterior del cambio \(\Delta_i(0,5)=5\beta_i\).
11.9.1 Distribuciones previas coherentes con las escalas
Para los coeficientes de población se pueden considerar normales con localizaciones y escalas ligadas a las unidades de la respuesta. Para las desviaciones estándar positivas son útiles distribuciones normales truncadas a \((0,\infty)\) y para la correlación, una distribución LKJ sobre la matriz de correlación (Bürkner 2017, sec. 2.1; Gelman et al. 2026, secs. 5.6-5.9).
con \(\eta>0\). Para \(\eta>1\), la LKJ concentra relativamente más masa cerca de correlaciones nulas que la LKJ con \(\eta=1\). Los valores numéricos deben justificarse a partir de la amplitud plausible de respuestas y cambios a lo largo de la ventana temporal: una previa que parezca moderada por día podría permitir cambios inverosímiles al multiplicarse por veinte o treinta días.
En el laboratorio centraremos el tiempo en el punto medio observado. Las previas del intercepto se expresarán entonces para una respuesta esperada en ese punto, no necesariamente para la primera visita. Antes de condicionar en las respuestas examinaremos muestras de la distribución predictiva previa, incluyendo la frecuencia de respuestas negativas, que no tendría interpretación física como tiempo de reacción.
11.9.2 Comprobación predictiva antes y después del ajuste
Las dos operaciones responden a preguntas diferentes:
La primera examina las consecuencias previas de la jerarquía; la segunda examina qué patrones pueden reproducirse después de observar las respuestas. Para datos longitudinales revisaremos no solo la distribución global, sino la dispersión por tiempo y la variación de pendientes observadas entre individuos. Un resumen adecuado de la distribución global puede ocultar errores importantes en las trayectorias (Gelman et al. 2026, secs. 5.9, 8.2).
11.10 Laboratorio: trayectorias de tiempo de reacción
Utilizaremos sleepstudy, un conjunto de datos incluido en el paquete lme4. La respuesta Reaction es el tiempo de reacción en milisegundos, Days representa el día de medición y Subject identifica al participante. La estructura permite estudiar cómo cambia la respuesta durante días sucesivos de restricción del sueño. El propósito de este análisis es ilustrar la modelación longitudinal, sin atribuir a las asociaciones observadas un efecto causal demostrado de la privación de sueño.
11.10.1 Preparación computacional y revisión de datos
En este conjunto el punto medio de los días observados se encuentra en \(4.5\). La variable dia_c expresa el día respecto a ese punto medio. Así, en el modelo que sigue, el intercepto corresponde al tiempo de reacción esperado en el día 4.5, aunque no exista una medición en ese instante. El coeficiente de dia_c sigue expresándose en milisegundos por día.
datos_s11 |>count(Subject, name ="n_mediciones") |>summarise(participantes =n(),minimo =min(n_mediciones),mediana =median(n_mediciones),maximo =max(n_mediciones) )
El ejemplo original es balanceado. Esto nos permitirá estudiar primero la interpretación del modelo y después construir un ejemplo separado de tiempos desiguales sin confundirlo con las observaciones originales.
11.10.2 Exploración gráfica de trayectorias
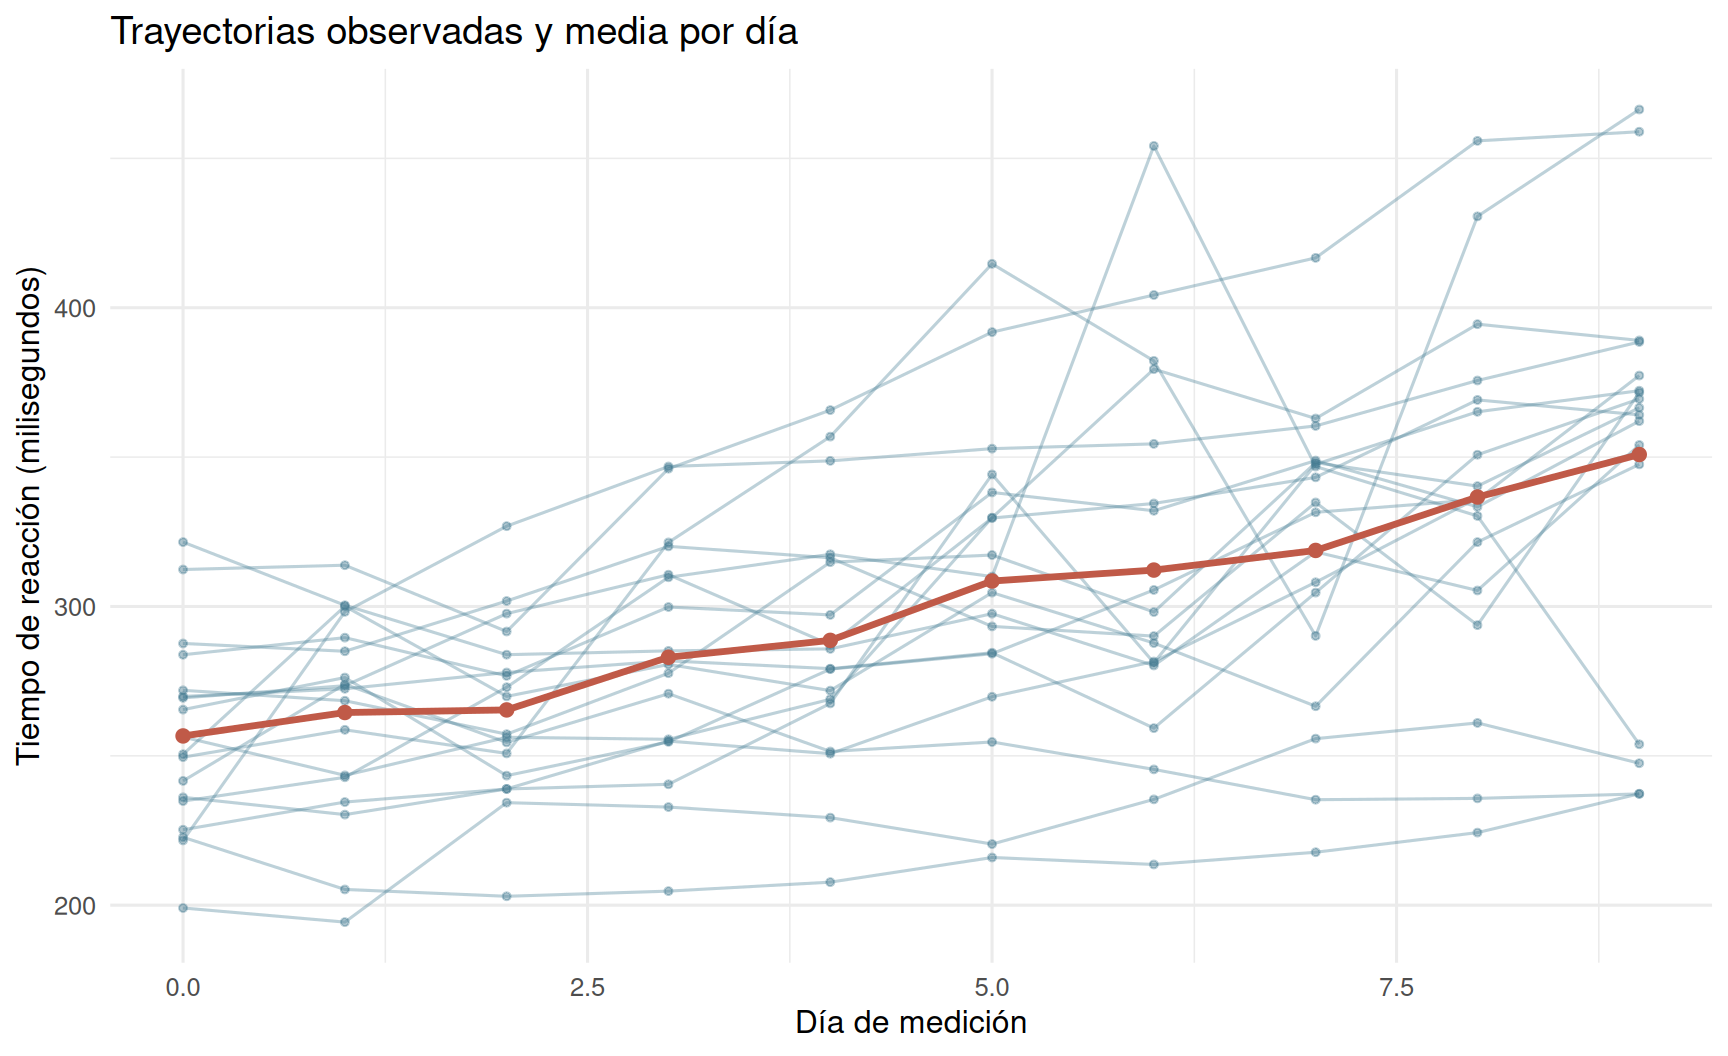
media_dia_s11 <- datos_s11 |>group_by(Days) |>summarise(media =mean(Reaction), .groups ="drop")ggplot(datos_s11, aes(x = Days, y = Reaction, group = Subject)) +geom_line(alpha =0.35, colour ="#447B92") +geom_point(alpha =0.40, colour ="#447B92", size =1) +geom_line(data = media_dia_s11,aes(x = Days, y = media, group =1),inherit.aes =FALSE,colour ="#C05A48", linewidth =1.2 ) +geom_point(data = media_dia_s11,aes(x = Days, y = media),inherit.aes =FALSE,colour ="#C05A48", size =2 ) +labs(x ="Día de medición",y ="Tiempo de reacción (milisegundos)",title ="Trayectorias observadas y media por día" ) +theme_minimal(base_size =12)
Figura 11.1: Mediciones longitudinales de tiempo de reacción. Cada línea une observaciones de un mismo participante; la línea roja resume las medias de los participantes en cada día.
El gráfico debe examinarse antes de imponer el modelo: ¿hay diferencias al comienzo?, ¿las líneas parecen paralelas?, ¿se abren con el transcurso de los días?, ¿hay participantes que siguen tendencias particulares? La media por día no sustituye el análisis individual; es un resumen de un conjunto de observaciones correlacionadas.
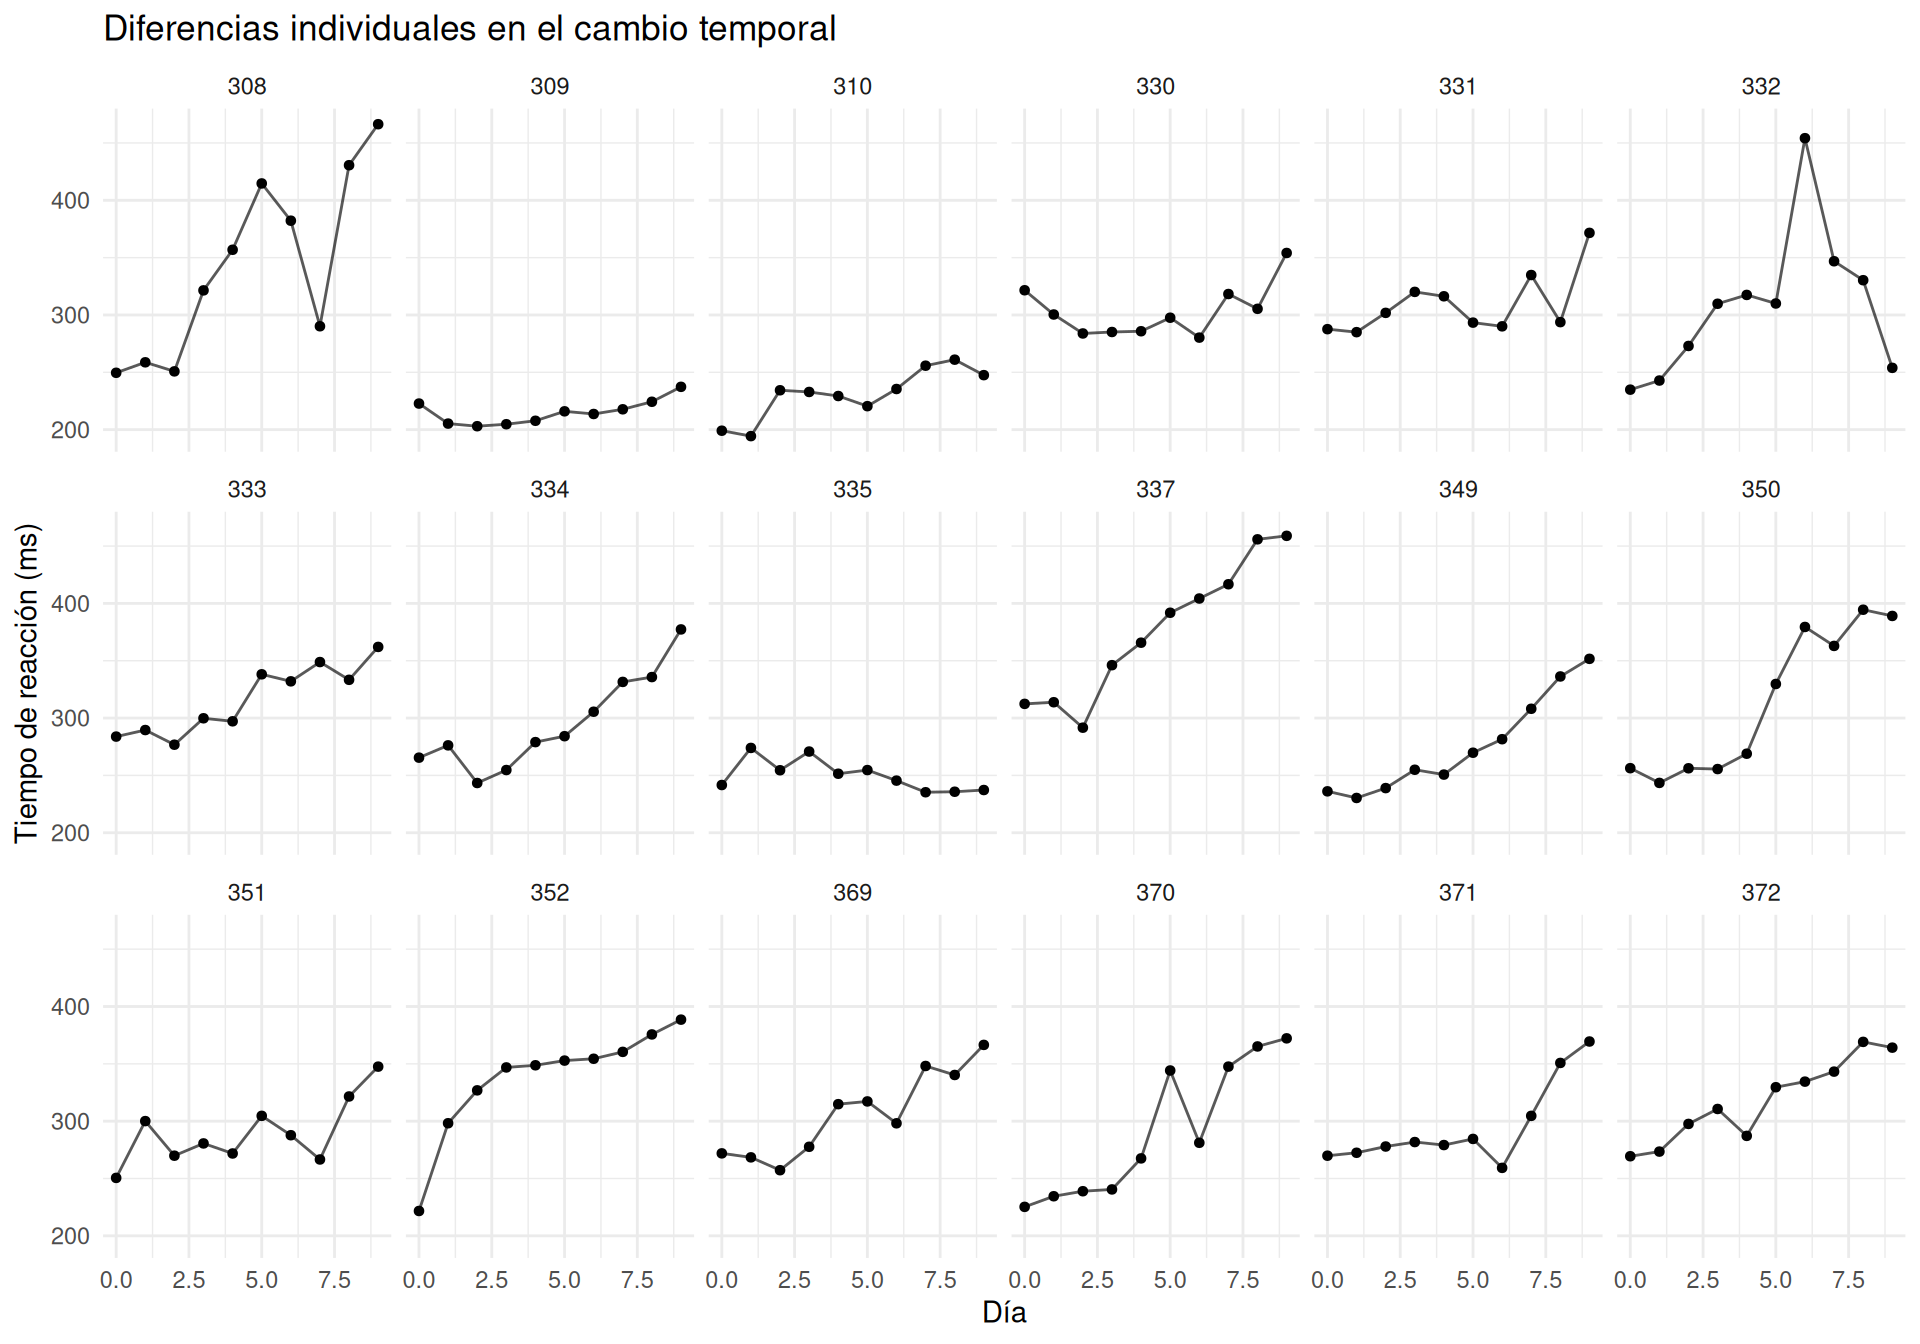
ggplot(datos_s11, aes(Days, Reaction)) +geom_point(size =1.2) +geom_line(alpha =0.65) +facet_wrap(~Subject, ncol =6) +labs(x ="Día",y ="Tiempo de reacción (ms)",title ="Diferencias individuales en el cambio temporal" ) +theme_minimal(base_size =11)
Figura 11.2: Trayectorias observadas por participante, representadas en paneles separados. Se conserva una escala común para facilitar las comparaciones de niveles y cambios.
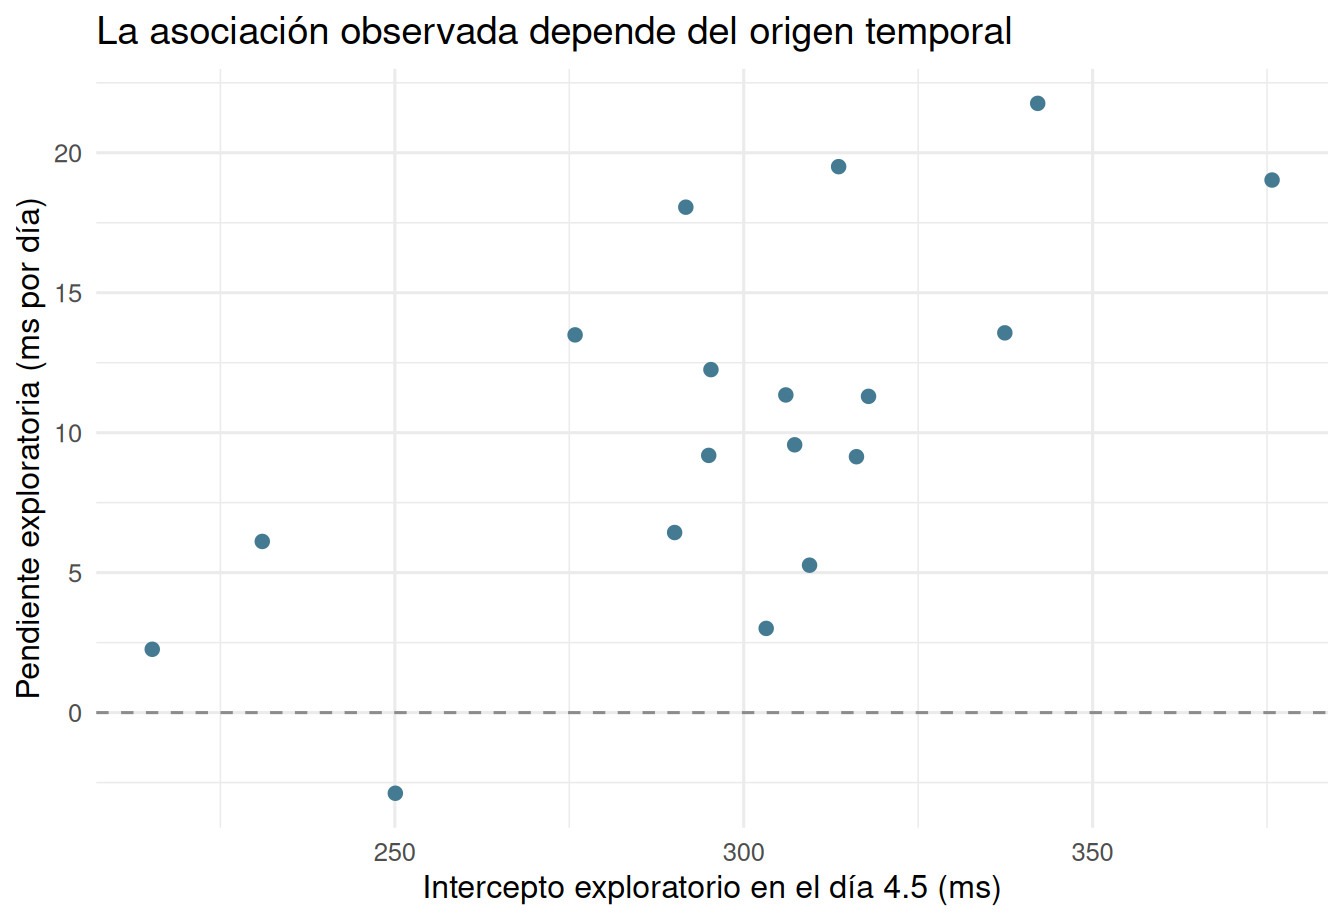
Una manera preliminar de describir el cambio es ajustar rectas separadas, solamente con propósito exploratorio. No sustituiremos con ellas al modelo jerárquico porque sus estimaciones ignoran la distribución poblacional que conecta a los participantes.
ggplot(rectas_ind_s11, aes(intercepto, pendiente)) +geom_point(size =2, colour ="#447B92") +geom_hline(yintercept =0, linetype ="dashed", colour ="grey55") +labs(x ="Intercepto exploratorio en el día 4.5 (ms)",y ="Pendiente exploratoria (ms por día)",title ="La asociación observada depende del origen temporal" ) +theme_minimal(base_size =12)
Figura 11.3: Relación descriptiva entre interceptos y pendientes obtenidos por regresiones separadas. No son estimaciones de la correlación poblacional corregidas por incertidumbre de estimación.
Advertencia de interpretación: la correlación entre los pares de coeficientes obtenidos por lm() no equivale al parámetro \(\rho\) de la distribución poblacional. Los coeficientes separados contienen error de estimación, y ese error puede estar correlacionado. La jerarquía de coeficientes variables representa explícitamente esa incertidumbre.
11.10.3 Datos desbalanceados e intervalos irregulares: un ejemplo didáctico
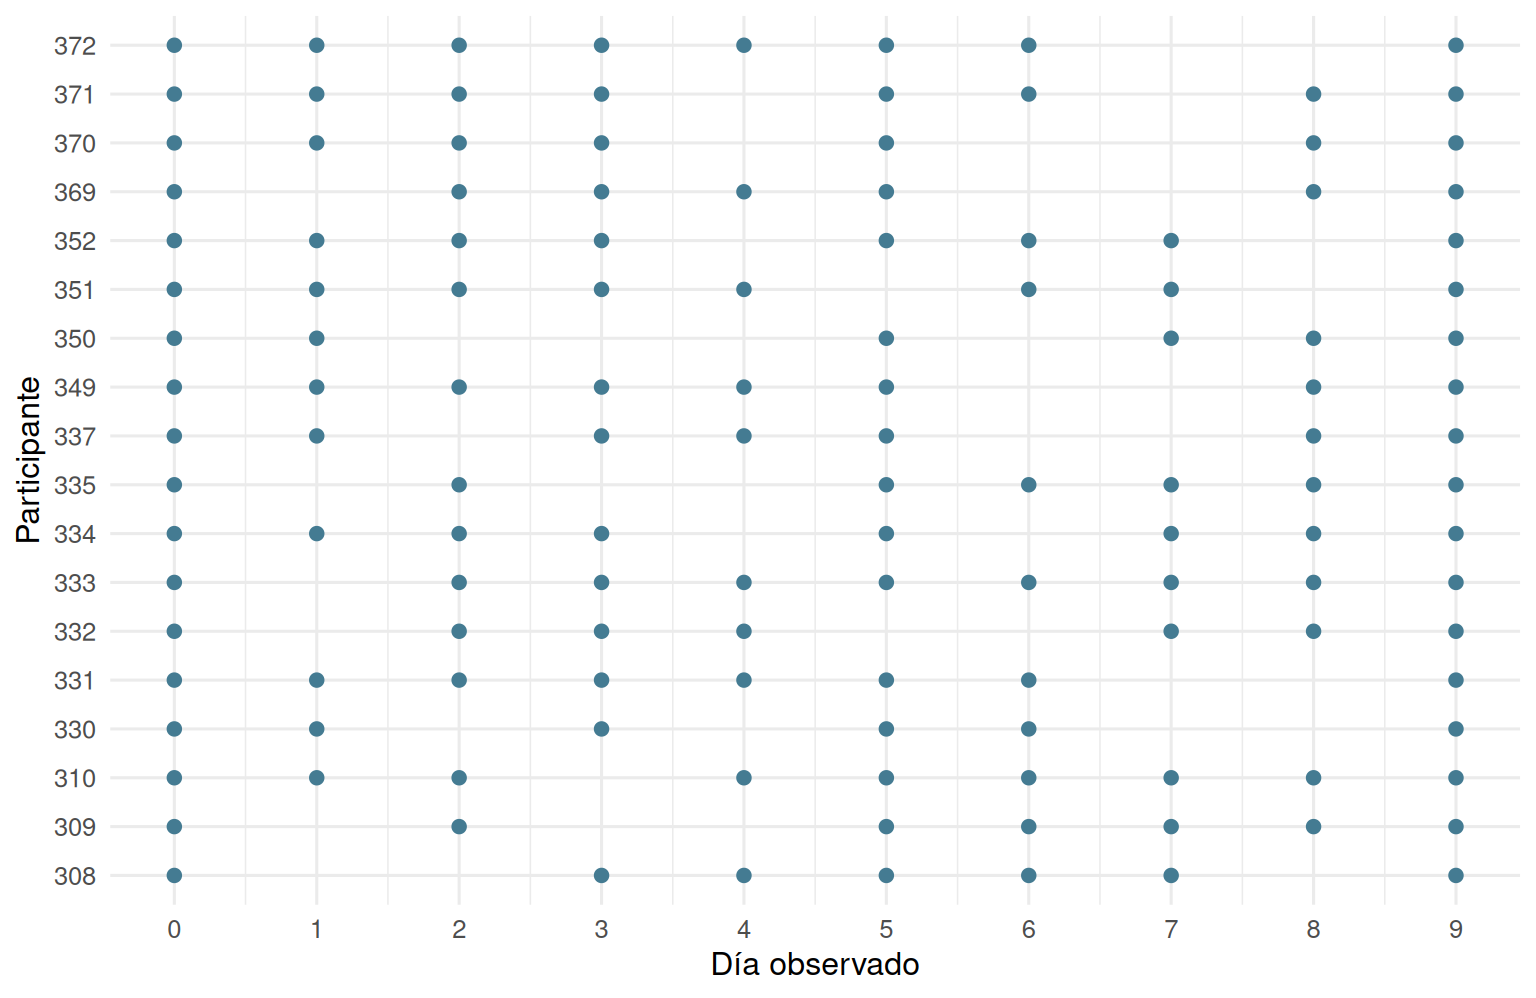
Para ilustrar la estructura, retiraremos artificialmente algunas filas al azar, conservando la primera y la última ocasión. Este procedimiento no representa el mecanismo de ausencia del estudio original, y no se utilizará para extraer conclusiones sobre los datos reales.
Figura 11.4: Momentos observados en un subconjunto artificialmente desbalanceado. Los puntos en una misma fila corresponden al mismo individuo.
El diseño desbalanceado cambia \(\mathbf X_i\) y \(\mathbf Z_i\) de una persona a otra, pero no requiere cambiar la forma del modelo. Sí puede reducir la información individual sobre la pendiente, especialmente cuando quedan pocas observaciones o sus tiempos están muy próximos.
Por tanto, \(\mu_0\) es el tiempo de reacción poblacional esperado en el punto medio del seguimiento; \(\mu_1\) está en milisegundos por día. Como punto de partida pedagógico proponemos:
Estas cantidades están expresadas en milisegundos y milisegundos/día y son elecciones didácticas para comprobar, no reglas generales ni resultados de una calibración previa independiente del ejemplo. La comprobación predictiva debe determinar si permiten trayectorias plausibles sobre toda la ventana de diez días. En particular, \(\mu_1\sim\mathcal N(0,12^2)\) corresponde a una variación previa apreciable en cambios acumulados de nueve días.
En brms, la clase Intercept puede referirse a un intercepto internamente centrado en las medias de los predictores poblacionales. Como dia_c tiene media exactamente cero en el conjunto balanceado, el intercepto anterior coincide con el del tiempo centrado. Si el diseño cambia, verificaremos de nuevo este punto con get_prior() y con la parametrización efectiva.
formula_s11 <- brms::bf( Reaction ~1+ dia_c + (1+ dia_c | Subject))prioris_s11 <-c( brms::prior(normal(300, 70), class ="Intercept"), brms::prior(normal(0, 12), class ="b", coef ="dia_c"), brms::prior(normal(0, 60), class ="sd",group ="Subject", coef ="Intercept"), brms::prior(normal(0, 12), class ="sd",group ="Subject", coef ="dia_c"), brms::prior(normal(0, 60), class ="sigma"), brms::prior(lkj(2), class ="cor"))brms::get_prior(formula = formula_s11,data = datos_s11,family =gaussian())
Las desviaciones estándar modeladas mediante class = "sd" tienen soporte positivo: las normales indicadas se restringen internamente a su soporte permitido. La previa LKJ se define para la matriz de correlación de los dos coeficientes individuales.
11.10.5 Comprobación predictiva previa
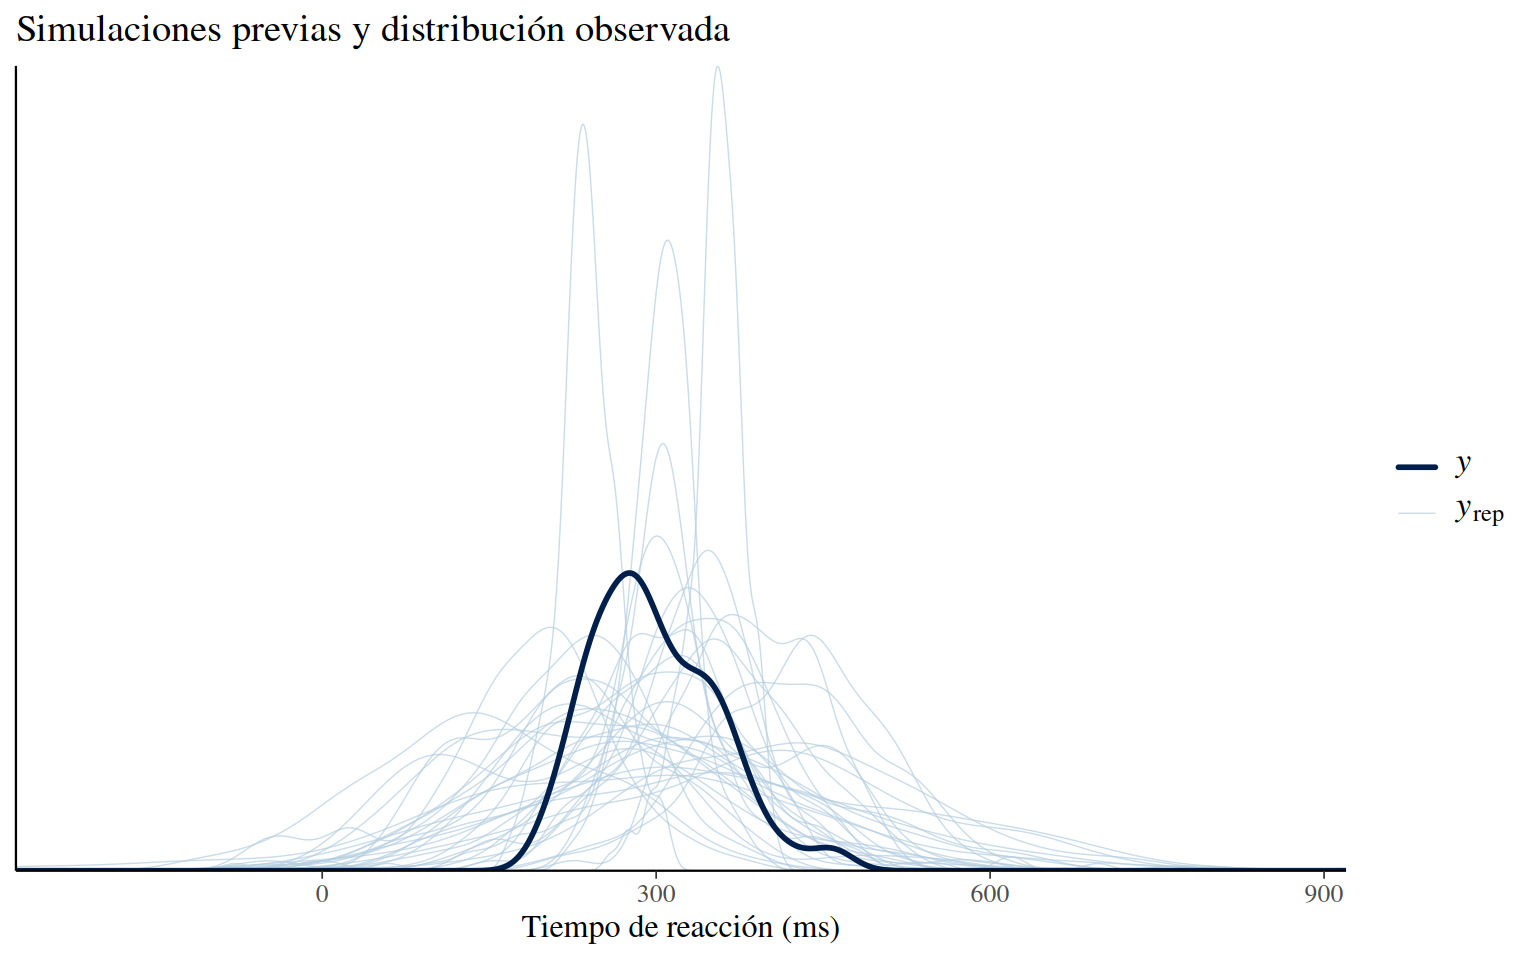
sample_prior = "only" permite simular parámetros y respuestas sin actualizar las previas con las respuestas observadas. Se conserva el diseño de mediciones —identificadores y tiempos— para preguntar qué formas de trayectorias consideramos plausibles antes de utilizar la información de Reaction.
y_prior_s11 <- brms::posterior_predict( fit_prior_s11, ndraws =250)bayesplot::ppc_dens_overlay(y = datos_s11$Reaction,yrep = y_prior_s11[1:35, , drop =FALSE]) +labs(x ="Tiempo de reacción (ms)",title ="Simulaciones previas y distribución observada" )
Figura 11.5: Distribuciones predictivas previas del tiempo de reacción: bandas de modelos posibles antes del ajuste, condicionadas únicamente en el calendario e identificadores.
La simulación se juzga mediante su plausibilidad sustantiva, no por su semejanza exacta con los datos del estudio. Si las previas asignan masa excesiva a tiempos negativos, trayectorias absurdamente pronunciadas o valores incompatibles con el instrumento de medición, debe revisarse la especificación antes de ajustar el modelo posterior. Una distribución normal observacional no asegura positividad; por ello la presencia de algún valor negativo en simulaciones es motivo para evaluar su magnitud y frecuencia, no una prohibición automática de esta aproximación.
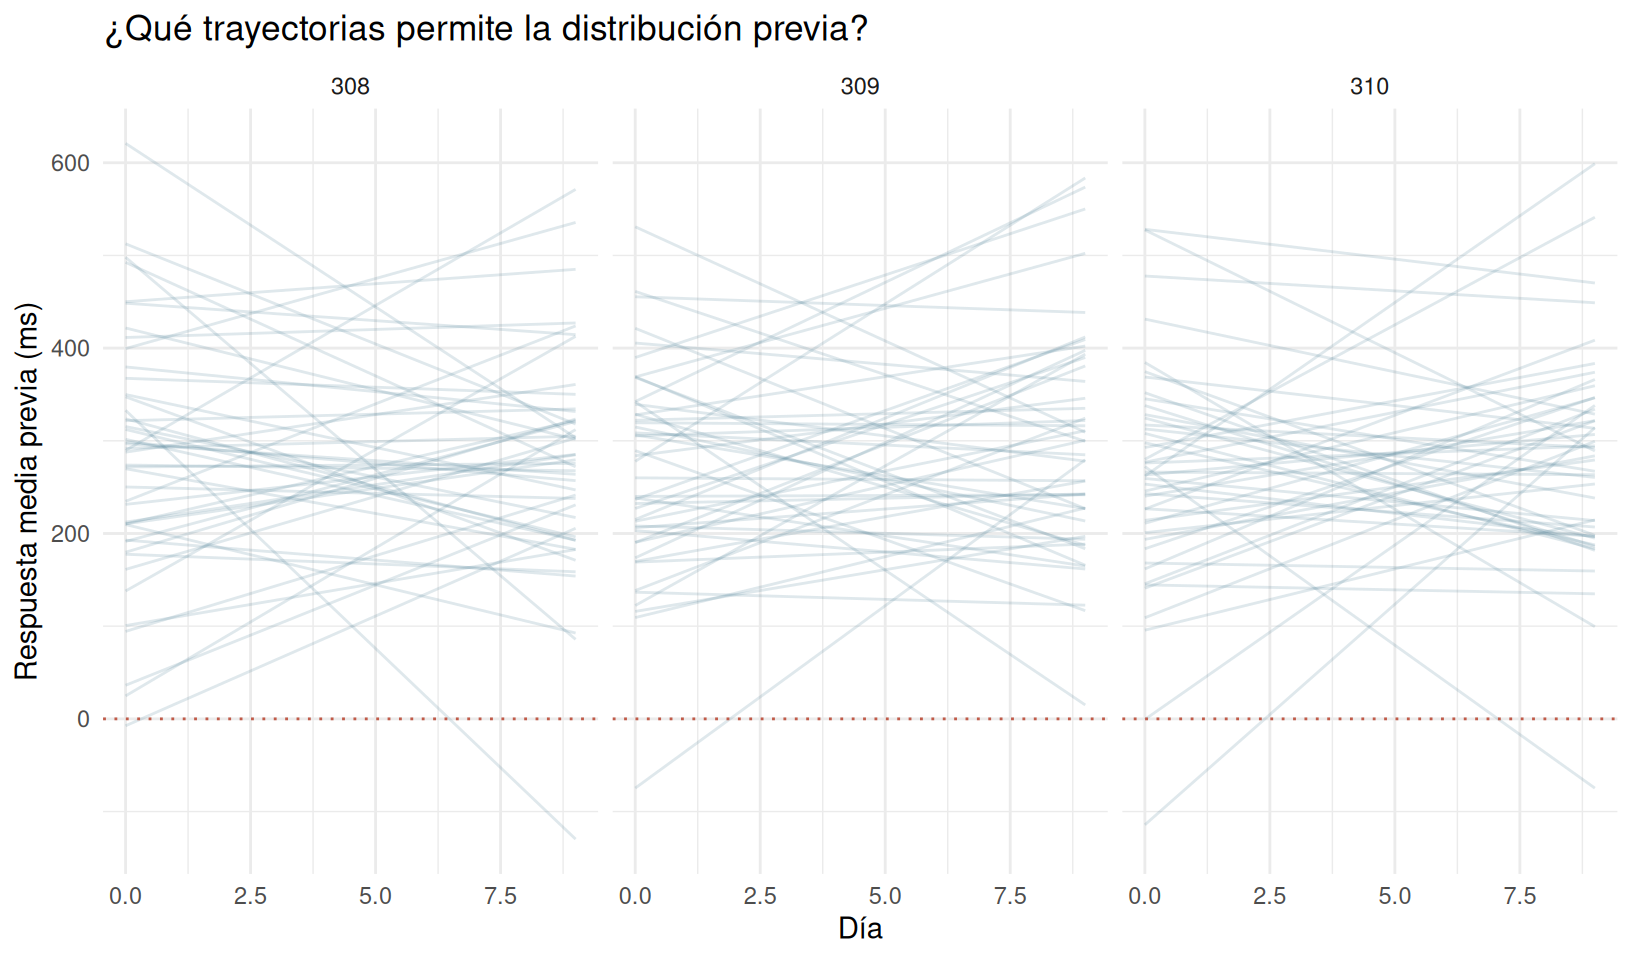
Una comprobación complementaria debe conservar la forma longitudinal de las simulaciones. La siguiente figura muestra medias condicionales simuladas desde la previa para tres participantes hipotéticamente etiquetados con identificadores de sleepstudy. Se conserva la misma pertenencia individual a lo largo de cada trayectoria simulada.
# seleccionar explícitamente tres sujetossujetos_3_s11 <-levels(droplevels(datos_s11$Subject))[1:3]# grilla solo para esos tres sujetosgrid_prior_tray_s11 <- tidyr::crossing(Subject =factor(sujetos_3_s11, levels = sujetos_3_s11),Days =0:9) |>mutate(dia_c = Days - centro_tiempo_s11)# medias previas simuladasmu_prior_tray_s11 <- brms::posterior_epred( fit_prior_s11,newdata = grid_prior_tray_s11,re_formula =NULL,ndraws =45)# pasar a formato largoprior_tray_largo_s11 <- dplyr::bind_cols( grid_prior_tray_s11[rep(seq_len(nrow(grid_prior_tray_s11)),times =nrow(mu_prior_tray_s11)), ], tibble::tibble(simulacion =rep(seq_len(nrow(mu_prior_tray_s11)),each =nrow(grid_prior_tray_s11)),media_simulada =as.vector(t(mu_prior_tray_s11)) )) |> dplyr::mutate(Subject =droplevels(Subject) )# gráficoggplot2::ggplot( prior_tray_largo_s11, ggplot2::aes(Days, media_simulada, group = simulacion)) + ggplot2::geom_line(colour ="#447B92", alpha =0.17) + ggplot2::geom_hline(yintercept =0, linetype ="dotted", colour ="#C05A48") + ggplot2::facet_wrap(~ Subject, ncol =3, drop =TRUE) + ggplot2::labs(x ="Día",y ="Respuesta media previa (ms)",title ="¿Qué trayectorias permite la distribución previa?" ) + ggplot2::theme_minimal(base_size =11)
Figura 11.6: Trayectorias medias generadas desde las previas para tres participantes, sin condicionar en sus respuestas observadas. Cada línea representa una simulación distinta del modelo jerárquico.
Conviene discutir no solo si una simulación produce valores negativos, sino si la previa permite pendientes demasiado grandes, cambios de signo o dispersión entre personas poco realista para el problema. Esta inspección informa posibles revisiones de las escalas \(s_0\) y \(s_1\) y de la previa sobre la correlación.
 Family: gaussian
  Links: mu = identity
Formula: Reaction ~ 1 + dia_c + (1 + dia_c | Subject)
   Data: datos_s11 (Number of observations: 180)
  Draws: 4 chains, each with iter = 2500; warmup = 1000; thin = 1;
         total post-warmup draws = 6000

Multilevel Hyperparameters:
~Subject (Number of levels: 18)
                     Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS
sd(Intercept)           39.25      7.08    27.88    56.09 1.00     1535
sd(dia_c)                6.19      1.31     4.05     9.10 1.00     2417
cor(Intercept,dia_c)     0.61      0.17     0.20     0.87 1.00     2624
                     Tail_ESS
sd(Intercept)            2522
sd(dia_c)                3364
cor(Intercept,dia_c)     3676

Regression Coefficients:
          Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
Intercept   298.22      9.38   279.94   317.48 1.00     1083     1487
dia_c        10.28      1.56     7.19    13.36 1.00     1739     2489

Further Distributional Parameters:
      Estimate Est.Error l-95% CI u-95% CI Rhat Bulk_ESS Tail_ESS
sigma    25.83      1.51    23.09    28.97 1.00     5302     4184

Draws were sampled using sample(hmc). For each parameter, Bulk_ESS
and Tail_ESS are effective sample size measures, and Rhat is the potential
scale reduction factor on split chains (at convergence, Rhat = 1).
El resumen permite examinar coeficientes poblacionales, desviaciones estándar entre individuos, correlación de coeficientes y variación residual. No tomaremos una decisión sustantiva exclusivamente a partir de si un intervalo creíble contiene o no el valor cero. Nos interesan las magnitudes de cambio y su incertidumbre en la escala original de la respuesta.
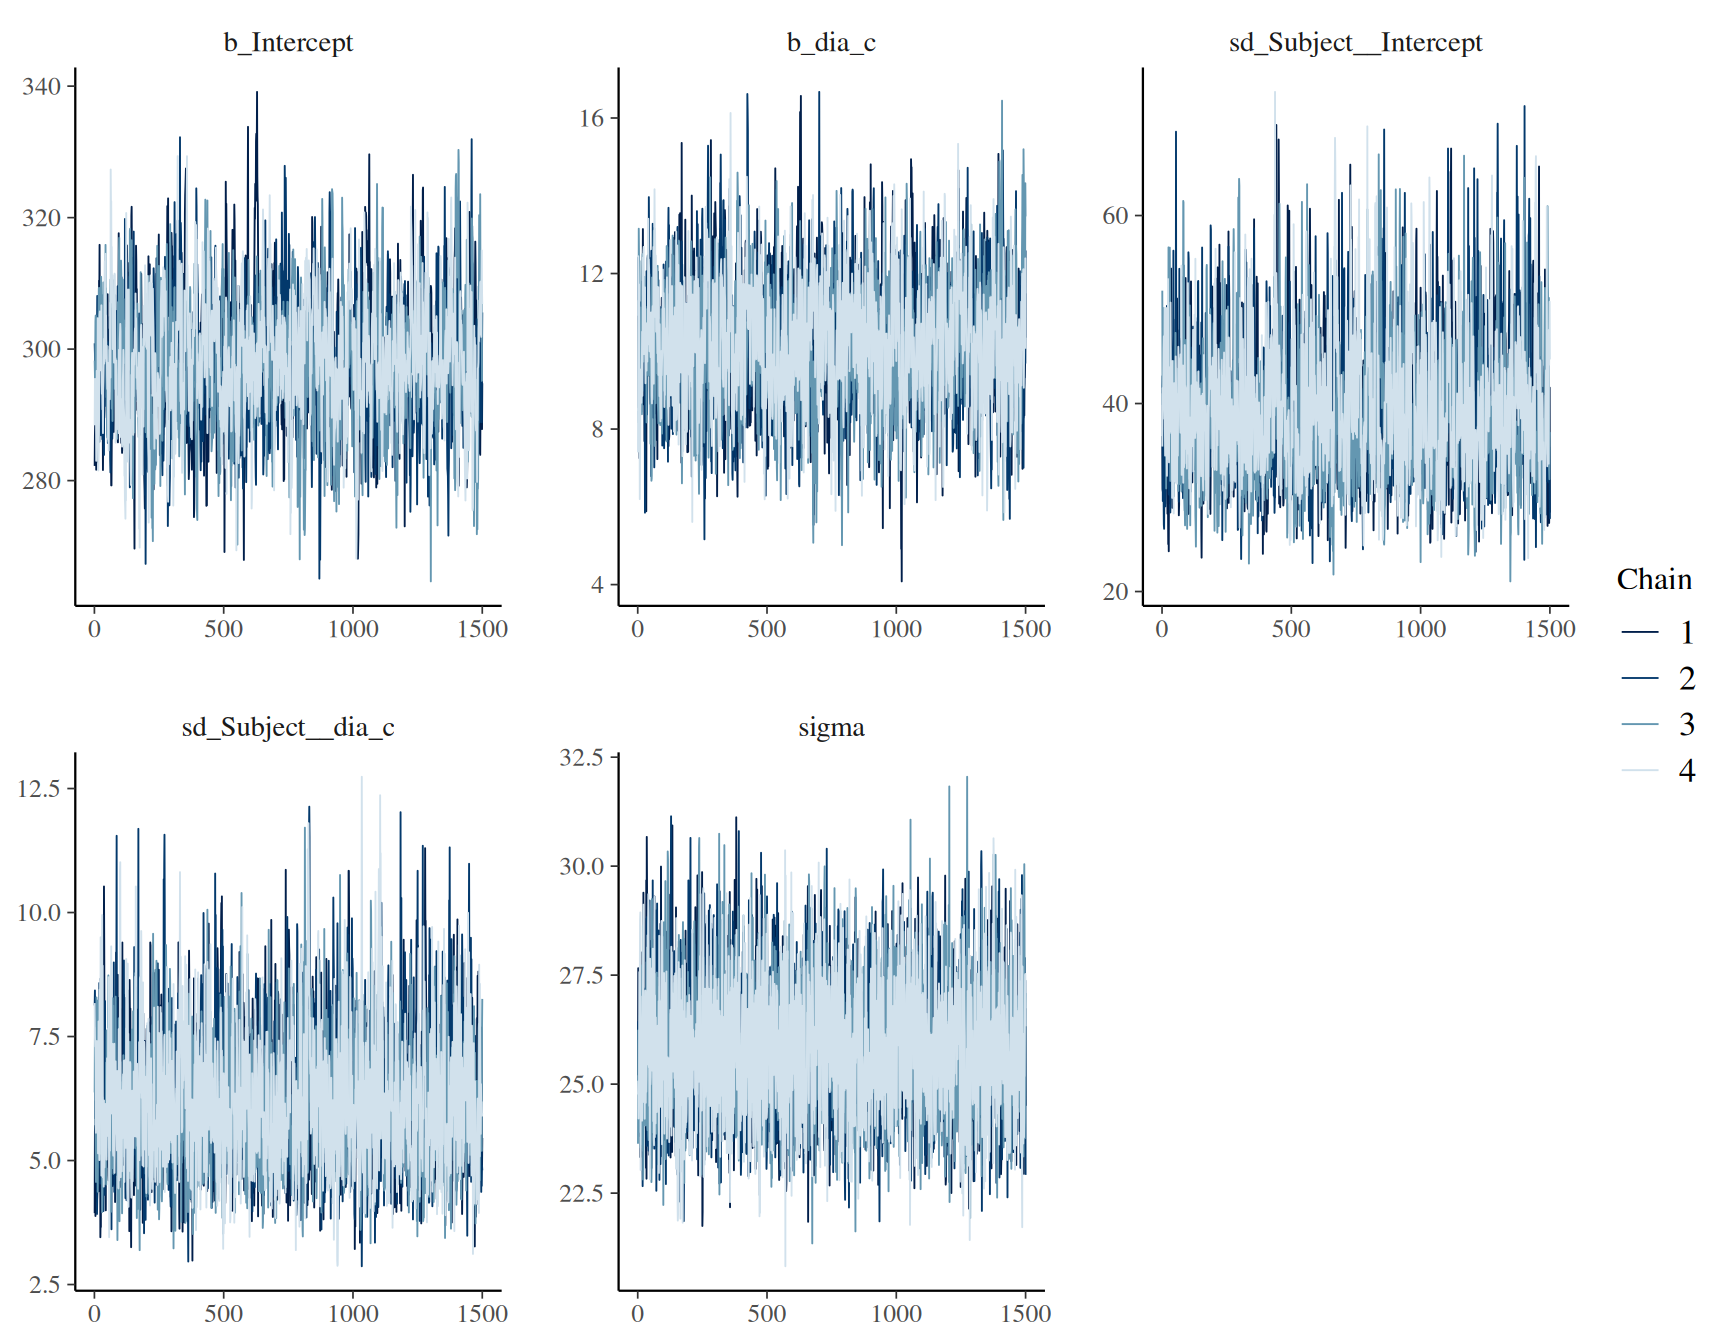
11.10.7 Diagnóstico computacional de HMC/NUTS
Una interpretación posterior requiere que las simulaciones describan suficientemente bien la distribución objetivo. Revisaremos \(\widehat R\), tamaños efectivos de muestra, trazas, divergencias y saturaciones de profundidad del árbol. Los problemas de geometría posterior pueden aparecer particularmente cuando una desviación estándar de coeficientes individuales es pequeña o cuando algunos coeficientes están débilmente determinados (Gelman et al. 2026, chaps. 11-12).
Figura 11.7: Trazas de parámetros poblacionales y de heterogeneidad. Las cadenas deben explorar regiones similares de sus distribuciones marginales.
Una regla operativa útil es buscar \(\widehat R\) cercano a 1, idealmente inferior a 1.01, ESS suficientemente grandes para las cantidades de interés y ausencia de divergencias. Estas condiciones se analizan conjuntamente, no como una certificación mecánica de la validez del modelo. Una saturación de max_treedepth sugiere ineficiencia computacional, pero no equivale a una divergencia. Si aparecen problemas, se investigarán las escalas de los parámetros, la estructura de la posterior, las previas y la parametrización antes de aumentar iteraciones o modificar controles arbitrariamente.
11.10.8 Interpretación posterior de trayectorias y heterogeneidad
La distribución posterior permite expresar incertidumbre directamente en milisegundos y milisegundos por día. Las siguientes cantidades se refieren al punto medio temporal que utilizamos para el intercepto.
Estas probabilidades son resúmenes de la distribución posterior bajo el modelo y las previas elegidas; no demuestran la existencia de un mecanismo causal. La posterior de la desviación estándar de pendientes describe cuánta heterogeneidad de tasas temporales es compatible con los datos y las hipótesis del modelo.
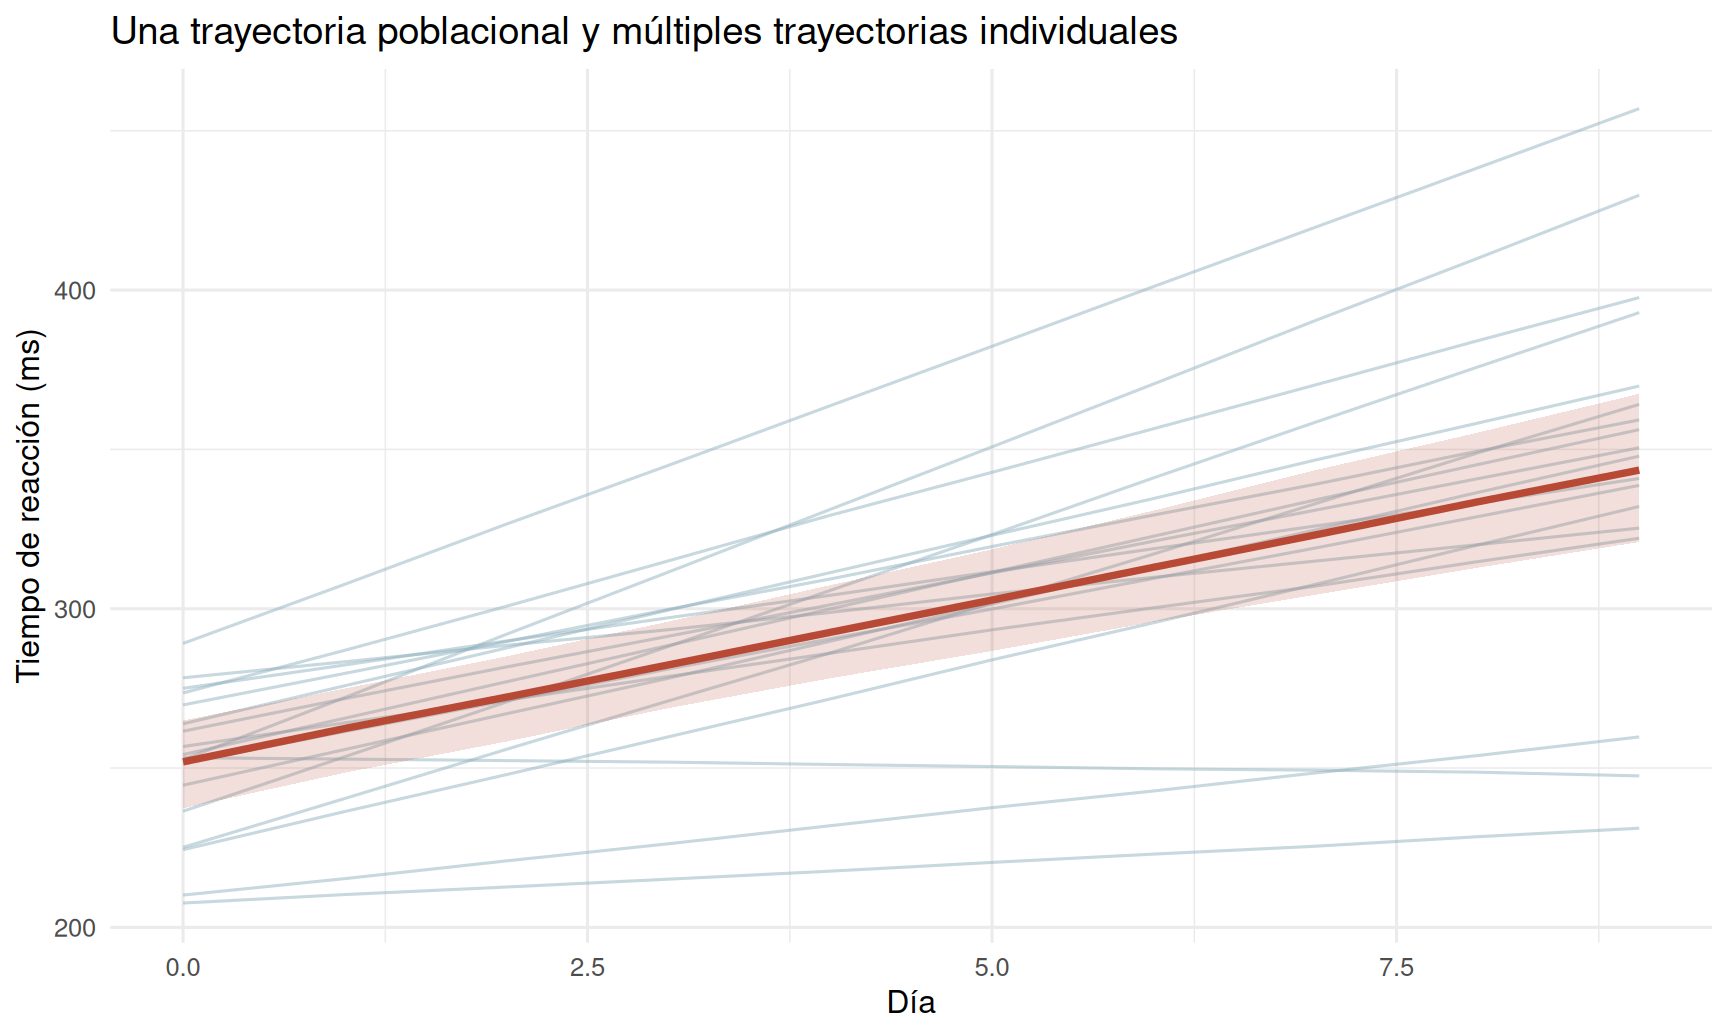
11.10.9 Trayectoria poblacional y trayectorias individuales
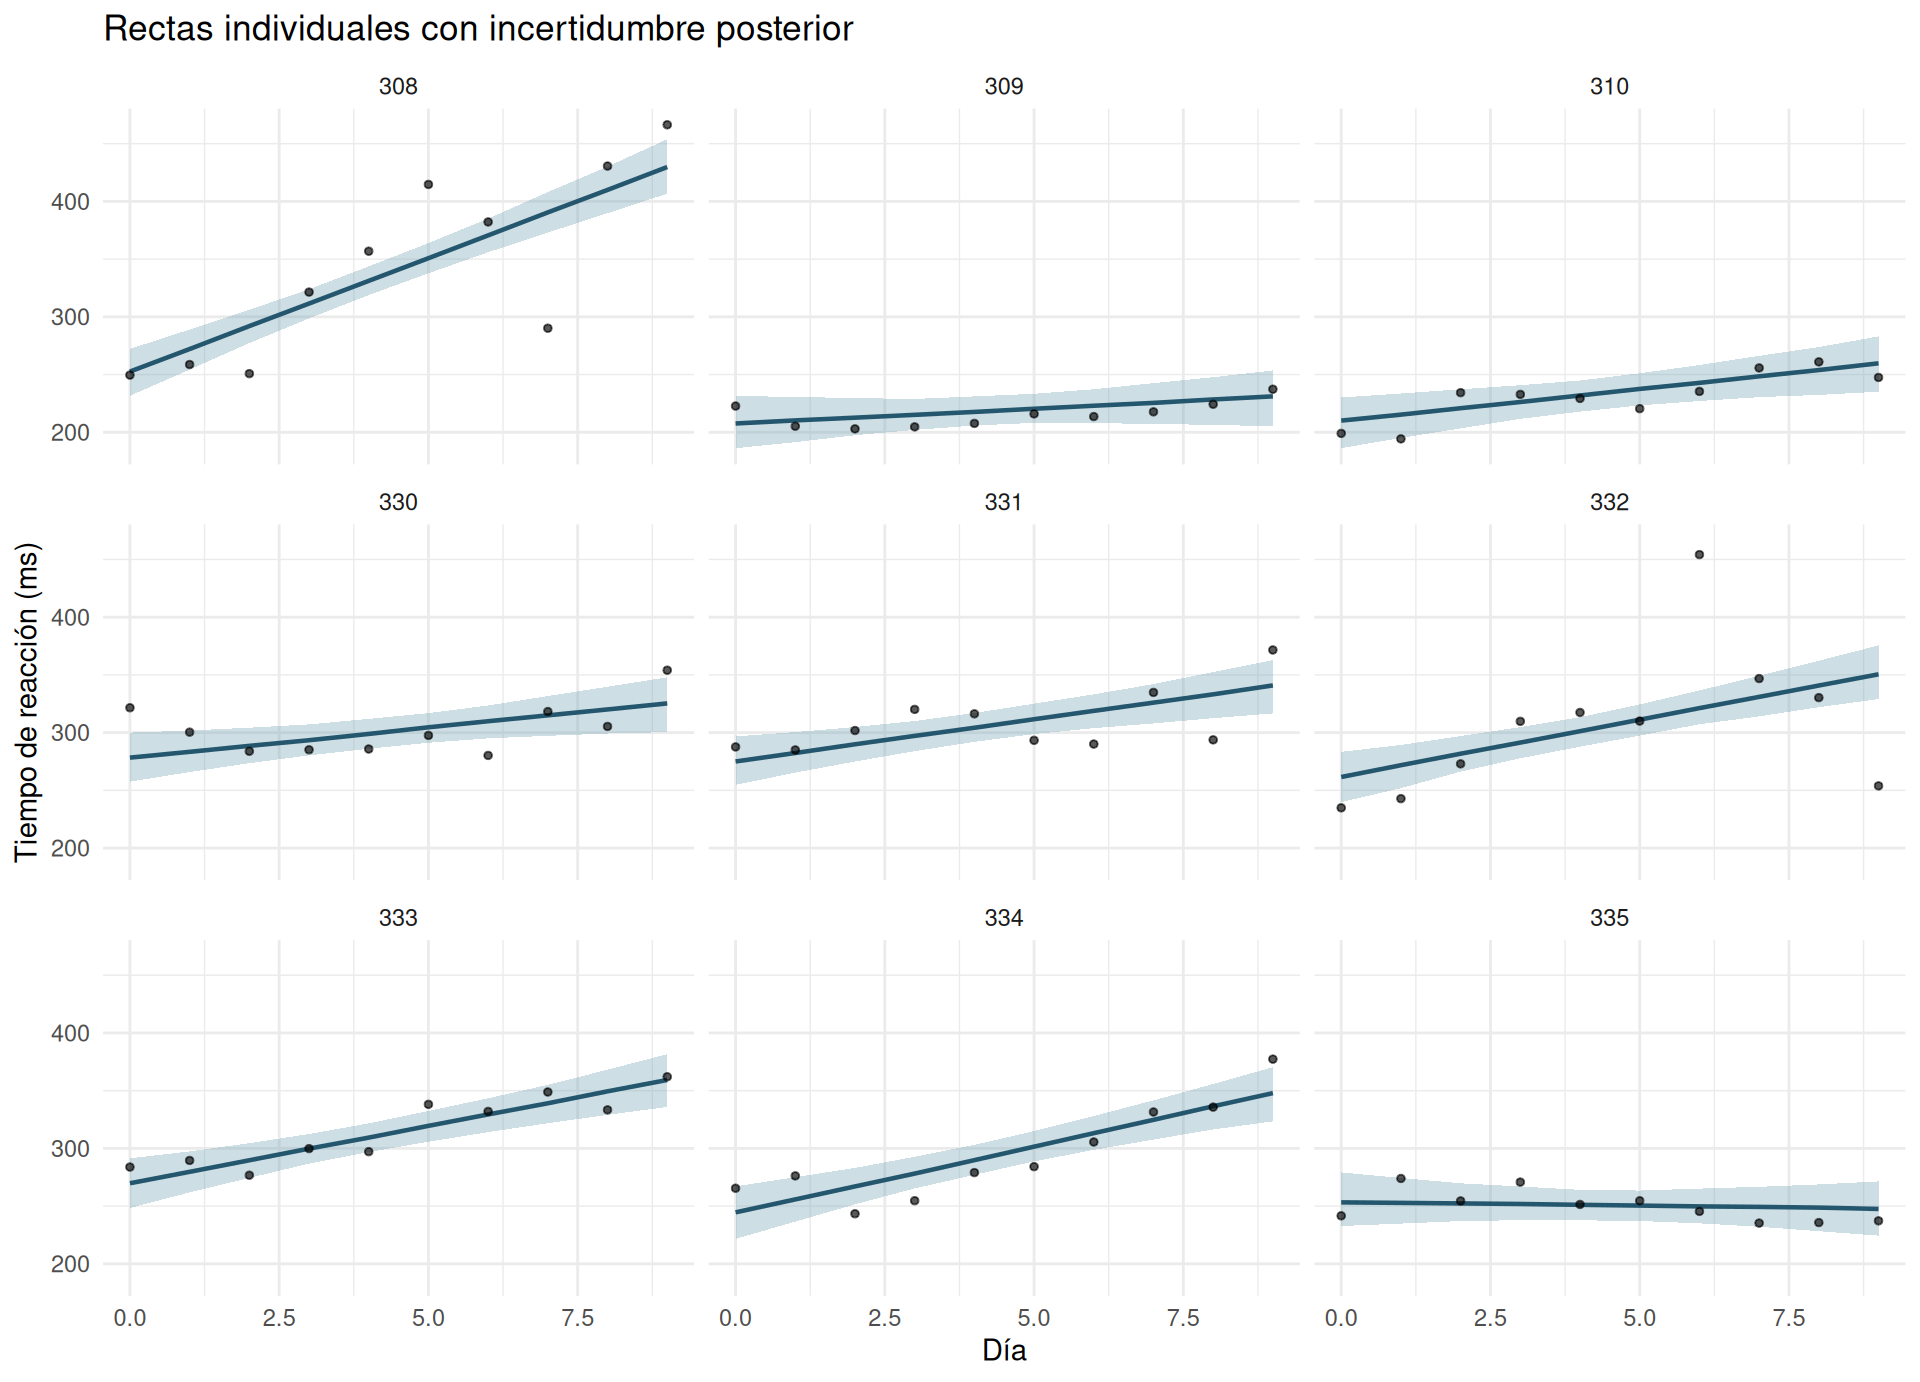
Definiremos una cuadrícula con los mismos días para cada individuo. Utilizaremos posterior_epred() para obtener distribuciones posteriores de las respuestas esperadas condicionales; esta función no agrega el error observacional que sí incorpora posterior_predict().
Figura 11.8: Trayectorias posteriores individuales: mediana y banda creíble puntual del 90 % para la respuesta media de cada participante, condicionadas en su información observada.
La banda se refiere a la incertidumbre sobre la media condicional de cada participante, no al intervalo que contendría una nueva respuesta observada. Las respuestas individuales pueden situarse fuera de esta banda porque incluyen dispersión residual.
Para obtener una trayectoria de referencia de la población, utilizaremos re_formula = NA, que fija los coeficientes grupales en cero. En este modelo gaussiano lineal, dicha curva coincide con la esperanza marginal sobre la distribución poblacional de individuos; no obstante, su banda creíble no incluye la variabilidad entre individuos nuevos.
Figura 11.9: Media poblacional posterior (línea central y banda creíble puntual del 90 %) comparada con las trayectorias individuales posteriores. La banda poblacional no es un intervalo predictivo para un participante nuevo.
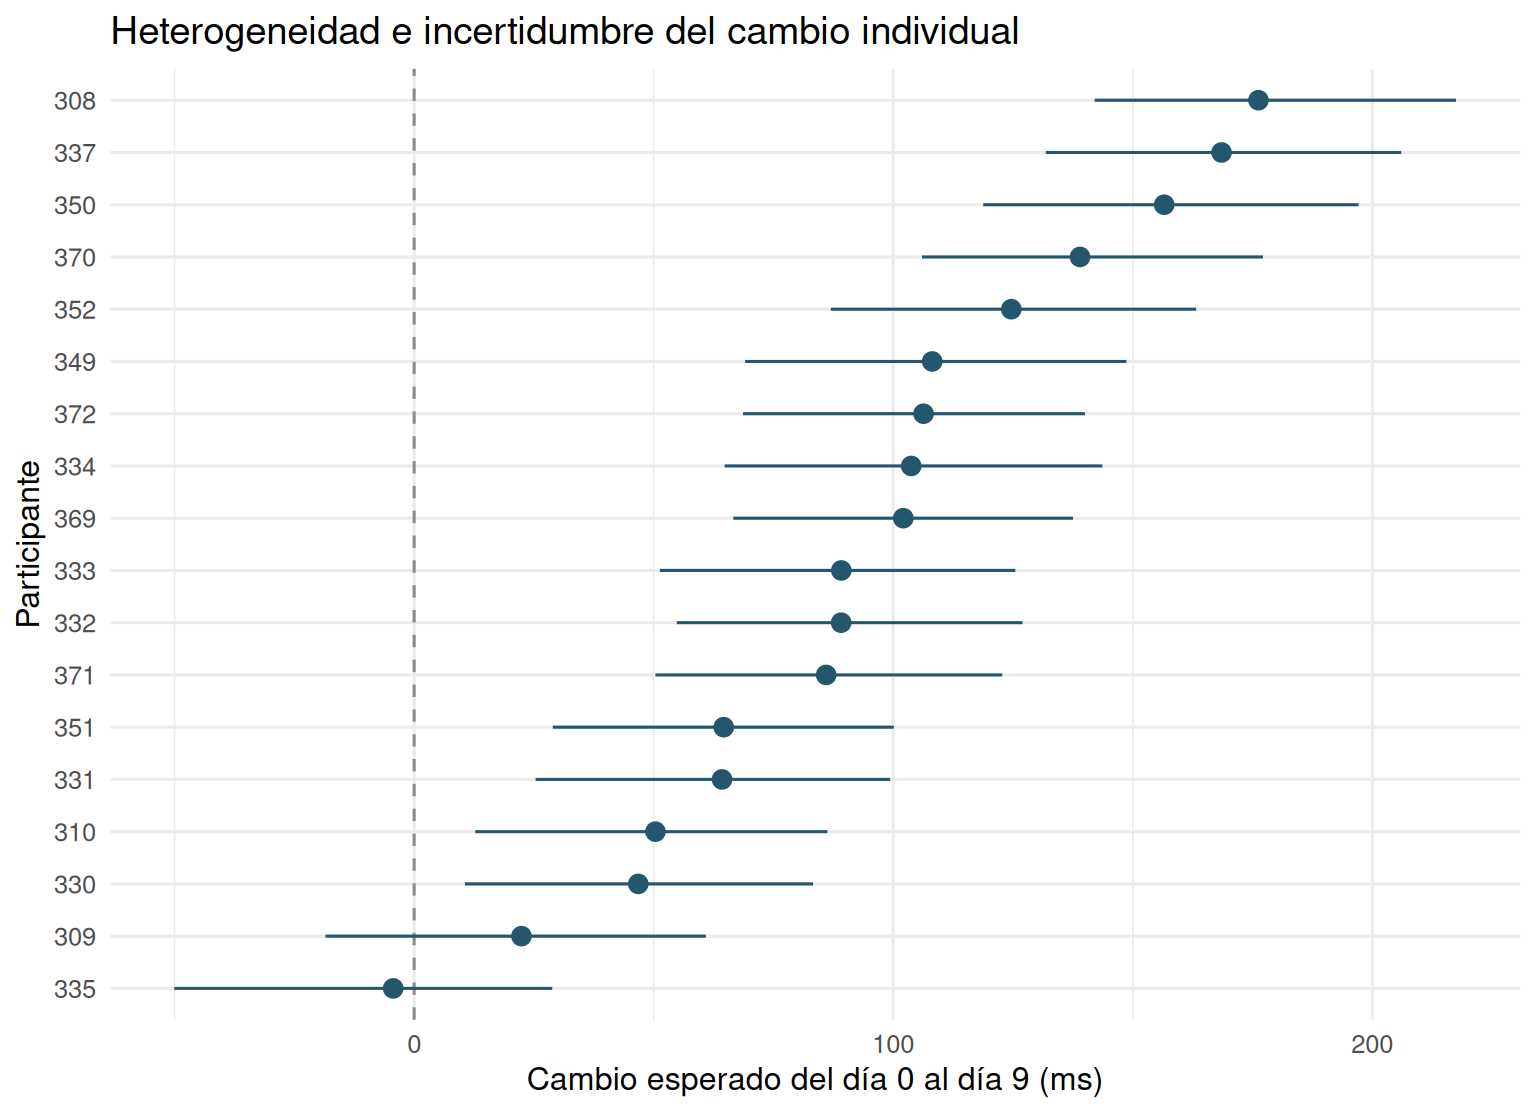
11.10.10 Contrastes posteriores de cambio individual
La distribución posterior del contraste entre los días 0 y 9 puede extraerse directamente de las simulaciones de las trayectorias esperadas. No hace falta ajustar modelos separados para cada contraste.
ggplot(contrastes_s11, aes(x =reorder(Subject, cambio_mediana), y = cambio_mediana)) +geom_hline(yintercept =0, linetype ="dashed", colour ="grey55") +geom_pointrange(aes(ymin = q05, ymax = q95), colour ="#24566E") +coord_flip() +labs(x ="Participante",y ="Cambio esperado del día 0 al día 9 (ms)",title ="Heterogeneidad e incertidumbre del cambio individual" ) +theme_minimal(base_size =12)
Figura 11.10: Cambio esperado entre el día 0 y el día 9: medianas e intervalos creíbles del 90 % por individuo.
Es especialmente importante separar las respuestas a dos preguntas: ¿cuál es el cambio poblacional esperado? y ¿cuál es el cambio esperado de un participante concreto? Para la primera, la distribución posterior de \(9\mu_1\) es suficiente; la segunda depende de \(9(\mu_1+u_{1i})\).
cambio_poblacional_s11 <-9* post_s11$b_dia_ctibble(cantidad ="Cambio poblacional esperado entre los días 0 y 9 (ms)",mediana =median(cambio_poblacional_s11),q05 =unname(quantile(cambio_poblacional_s11, 0.05)),q95 =unname(quantile(cambio_poblacional_s11, 0.95)),prob_aumento =mean(cambio_poblacional_s11 >0))
# A tibble: 1 × 5
  cantidad                                      mediana   q05   q95 prob_aumento
  <chr>                                           <dbl> <dbl> <dbl>        <dbl>
1 Cambio poblacional esperado entre los días 0…    92.6  69.3  115.            1
11.11 Comprobación predictiva posterior
Un modelo que reproduce bien la distribución conjunta debería generar observaciones con características semejantes a las registradas. En datos longitudinales necesitamos estadísticas que examinen varias dimensiones del problema:
distribución global de respuestas y valores extremos;
tendencia y dispersión entre individuos en cada día;
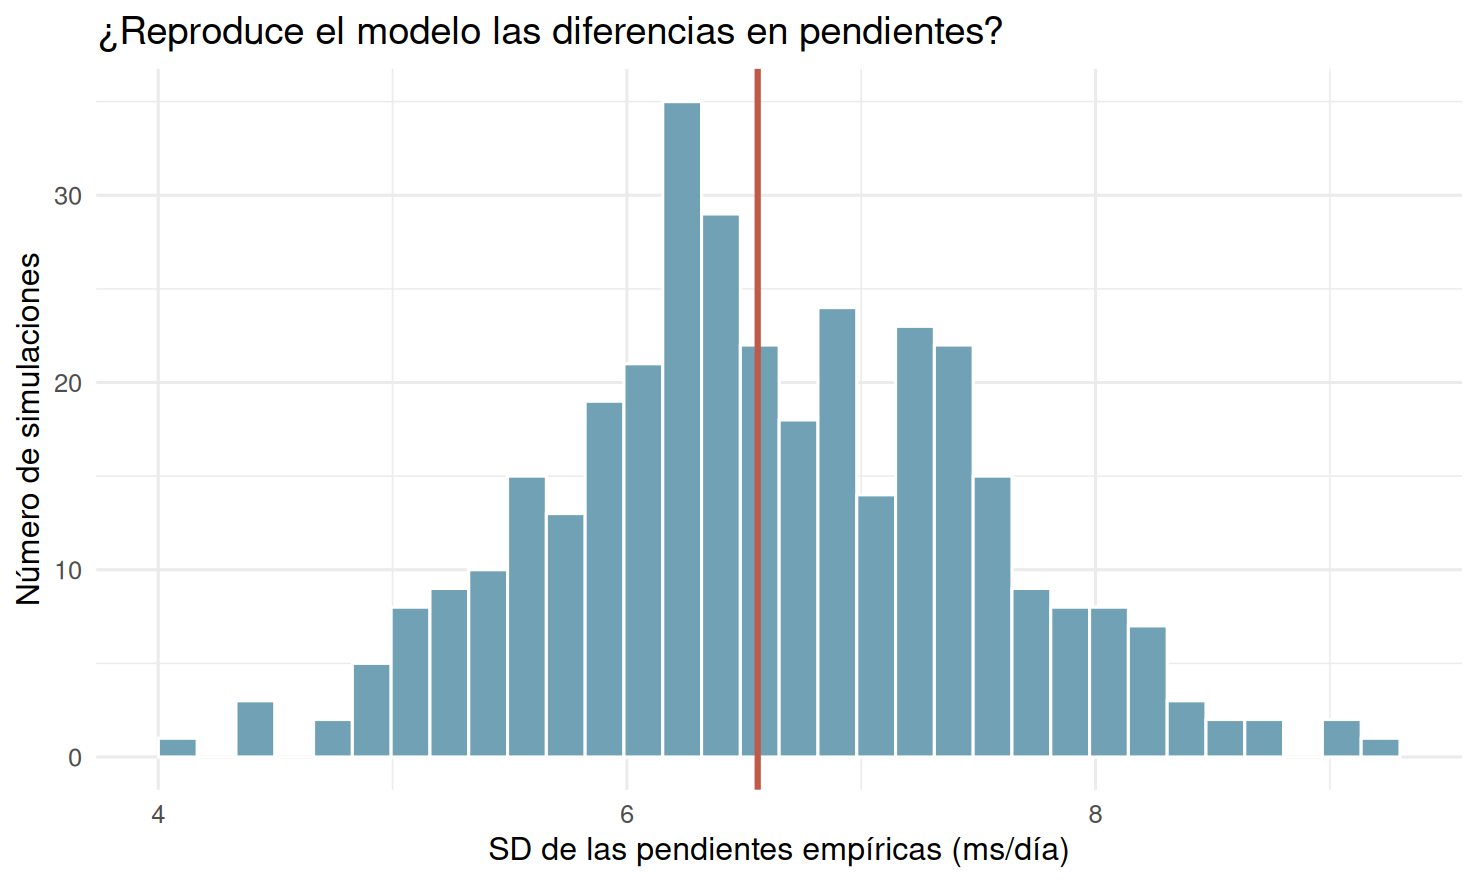
variabilidad entre las pendientes empíricas de los participantes.
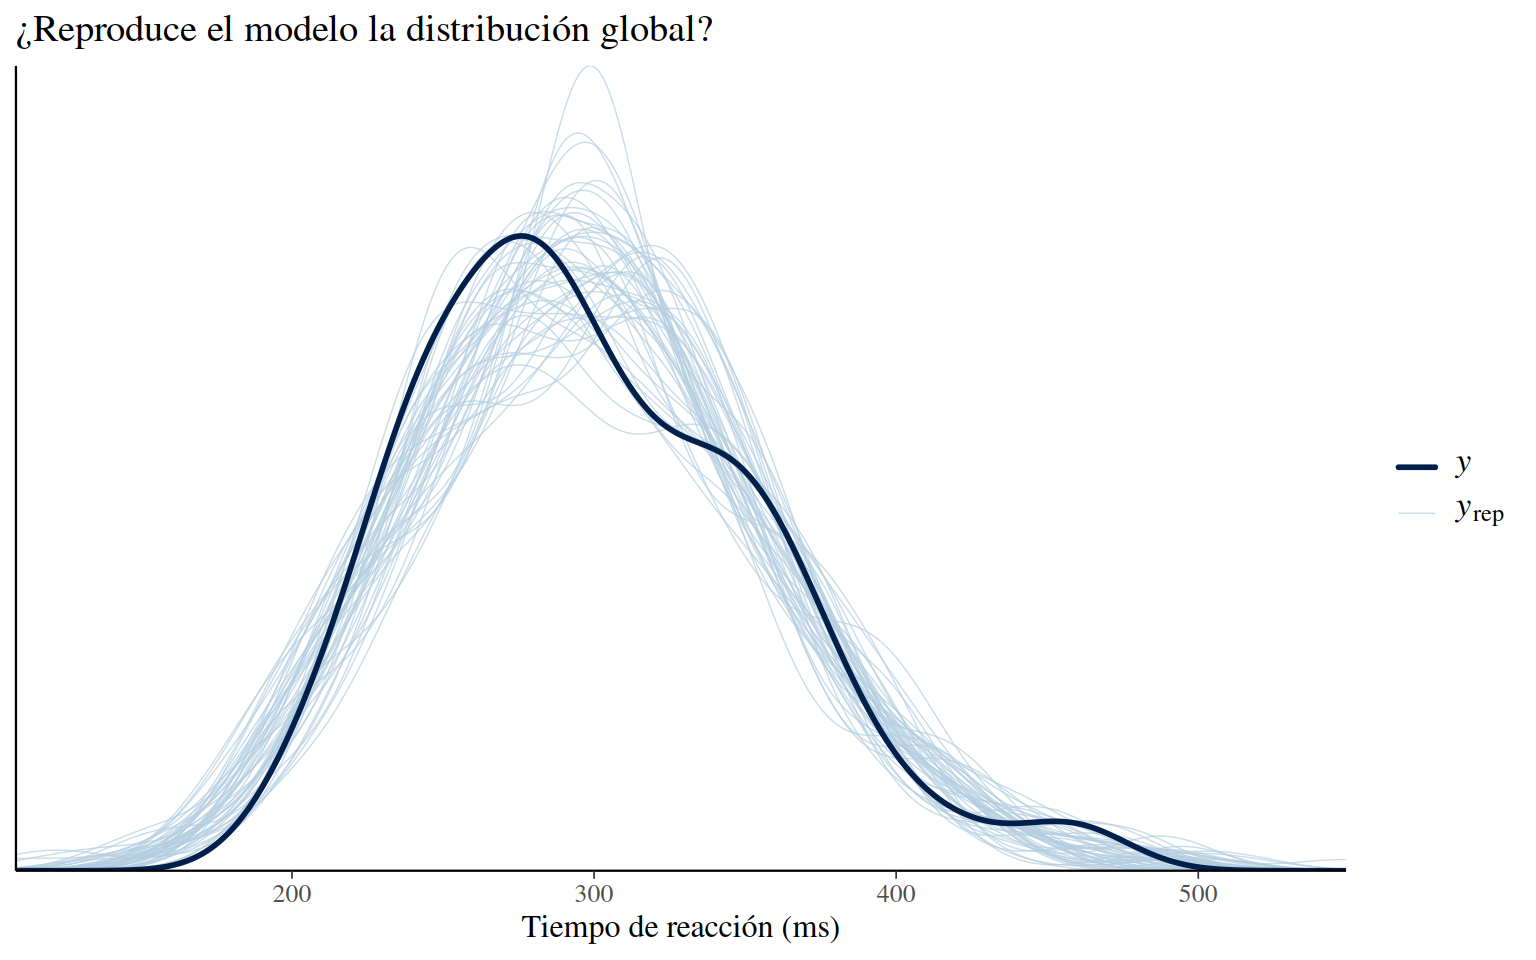
Los siguientes gráficos no equivalen a una validación externa. Utilizan las mismas observaciones empleadas para ajustar la posterior, por lo que son comprobaciones internas de adecuación(Gelman et al. 2026, sec. 8.2).
bayesplot::ppc_dens_overlay(y = datos_s11$Reaction,yrep = yrep_s11[1:50, , drop =FALSE]) +labs(x ="Tiempo de reacción (ms)",title ="¿Reproduce el modelo la distribución global?" )
Figura 11.11: Comprobación predictiva posterior global. La línea resaltada representa la distribución observada y las demás líneas son realizaciones simuladas del modelo ajustado.
11.11.2 Dispersión a lo largo del seguimiento
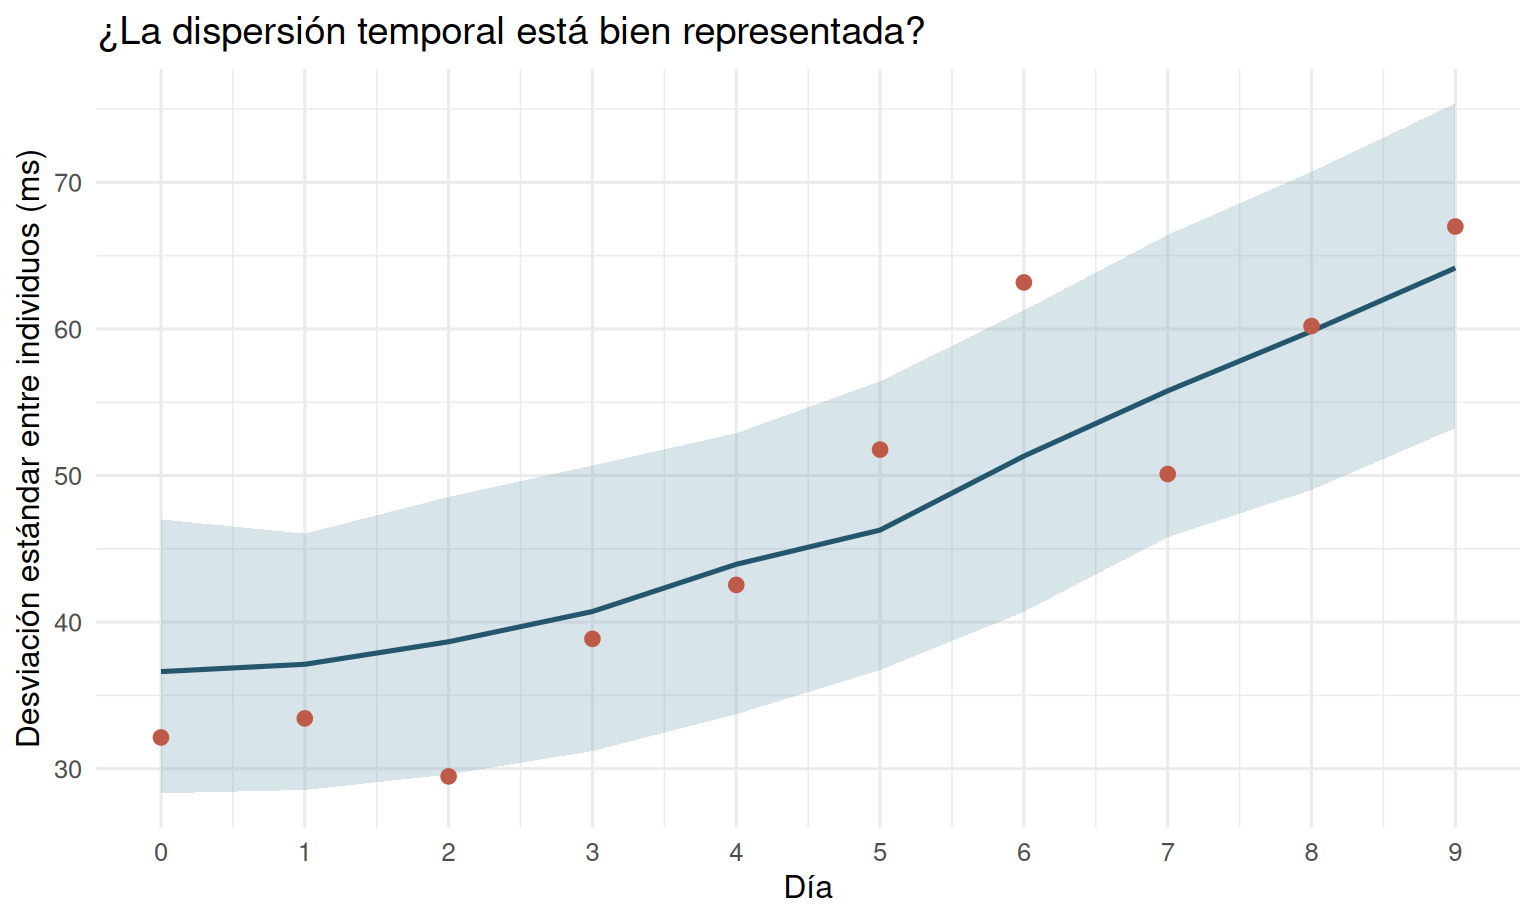
Para cada día calcularemos la desviación estándar observada entre participantes y la compararemos con su distribución posterior predictiva. Este resumen permite examinar si la heterogeneidad de pendientes representa razonablemente la dispersión a lo largo del tiempo.
Figura 11.12: Desviación estándar de las respuestas entre individuos para cada día: estadística observada frente a la distribución predictiva posterior (mediana y banda del 90 %).
Un gráfico razonable no demuestra que \(\sigma\) sea homocedástica condicionalmente; la dispersión que estamos mostrando incluye la heterogeneidad de interceptos y pendientes. Para investigar heterocedasticidad o autocorrelación residual necesitamos comprobaciones adicionales, asunto de la semana 12.
11.11.3 Variación de las pendientes empíricas
Una comprobación particularmente informativa consiste en comparar la desviación estándar de las pendientes estimadas separadamente entre participantes con la misma cantidad calculada en cada conjunto replicado. En ambos casos aplicamos el mismo procedimiento descriptivo, de modo que los errores de estimación de las pendientes afectan tanto a la estadística observada como a las simuladas.
ggplot(tibble(sd_pendientes = sd_pendientes_rep_s11),aes(sd_pendientes)) +geom_histogram(bins =32, fill ="#70A1B5", colour ="white") +geom_vline(xintercept = sd_pendientes_obs_s11,colour ="#C05A48", linewidth =1.1) +labs(x ="SD de las pendientes empíricas (ms/día)",y ="Número de simulaciones",title ="¿Reproduce el modelo las diferencias en pendientes?" ) +theme_minimal(base_size =12)
Figura 11.13: Comprobación de la heterogeneidad longitudinal: distribución posterior predictiva de la desviación estándar de las pendientes descriptivas y valor observado.
Si el valor observado cae sistemáticamente en una cola de esta distribución, debemos examinar si el modelo reproduce la heterogeneidad de trayectorias: podrían existir respuestas inusuales, covariables omitidas, formas temporales no lineales o problemas con la distribución de errores. La estadística elegida orienta el diagnóstico, no identifica por sí sola la causa de la discrepancia.
11.12 Predicción longitudinal: individuos existentes y nuevos
En modelos multinivel la predicción depende de a quién deseamos predecir. Esto es particularmente importante cuando pretendemos representar una trayectoria a lo largo del tiempo (Gelman y Hill 2007, sec. 12.8; McElreath 2020, sec. 13.5).
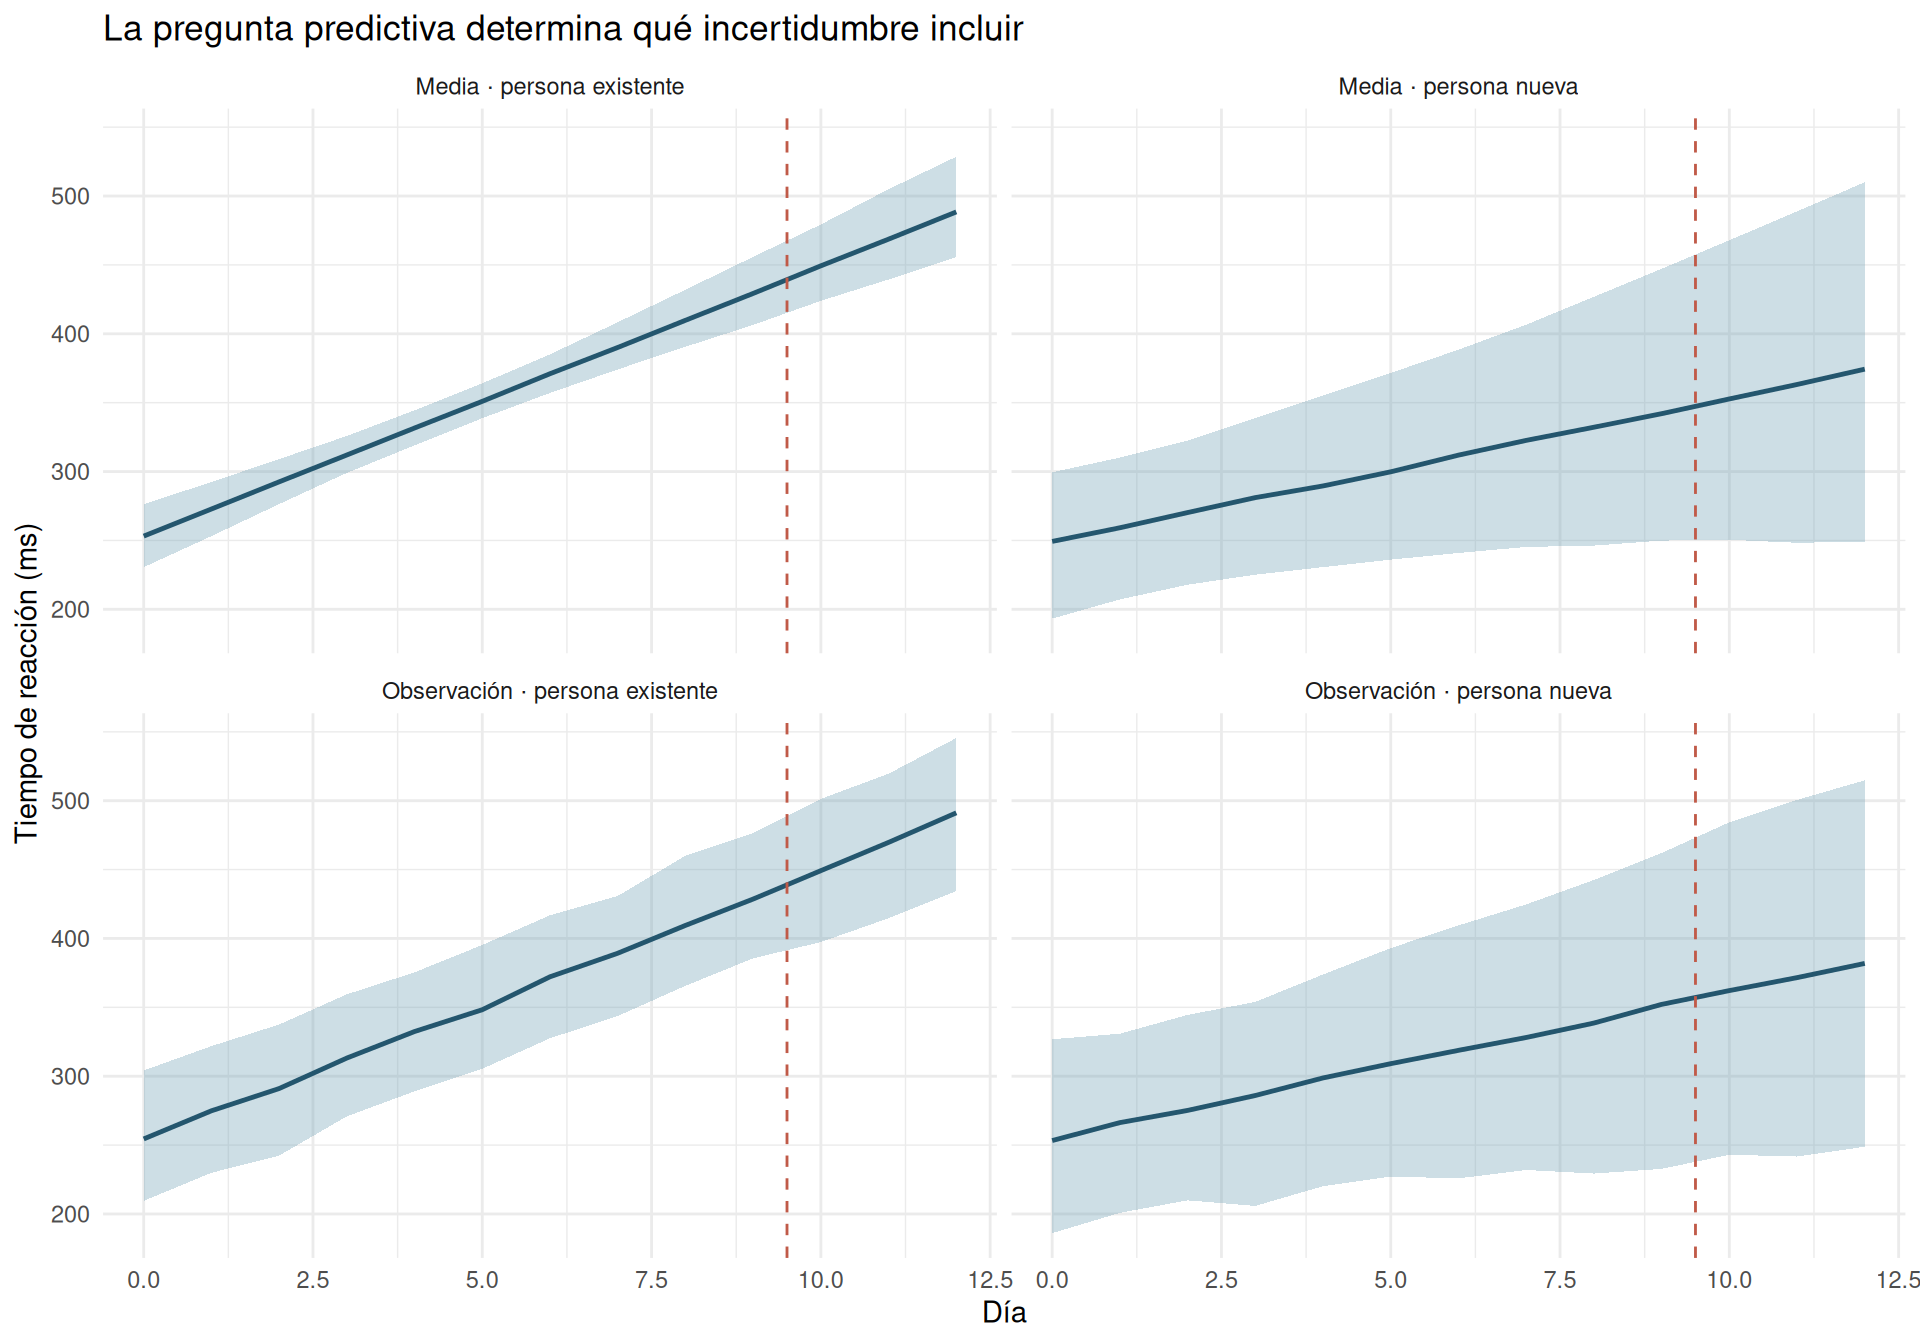
Para un individuo ya observado, las mediciones anteriores informan sobre sus coeficientes \(\mathbf u_i\). Para un individuo nuevo, sus coeficientes no están estimados individualmente: debemos simularlos de la distribución poblacional de coeficientes, incorporando la incertidumbre en sus parámetros. Cuando interesa una nueva observación se añade también el error residual.
Objeto de predicción
Fuente de incertidumbre
Media esperada de una persona existente
Parámetros poblacionales y coeficientes de esa persona, condicionados en sus datos
Nueva observación de una persona existente
Lo anterior, más variación residual
Media esperada de una persona nueva
Parámetros poblacionales y coeficientes simulados de una persona nueva
Nueva observación de una persona nueva
Lo anterior, más variación residual
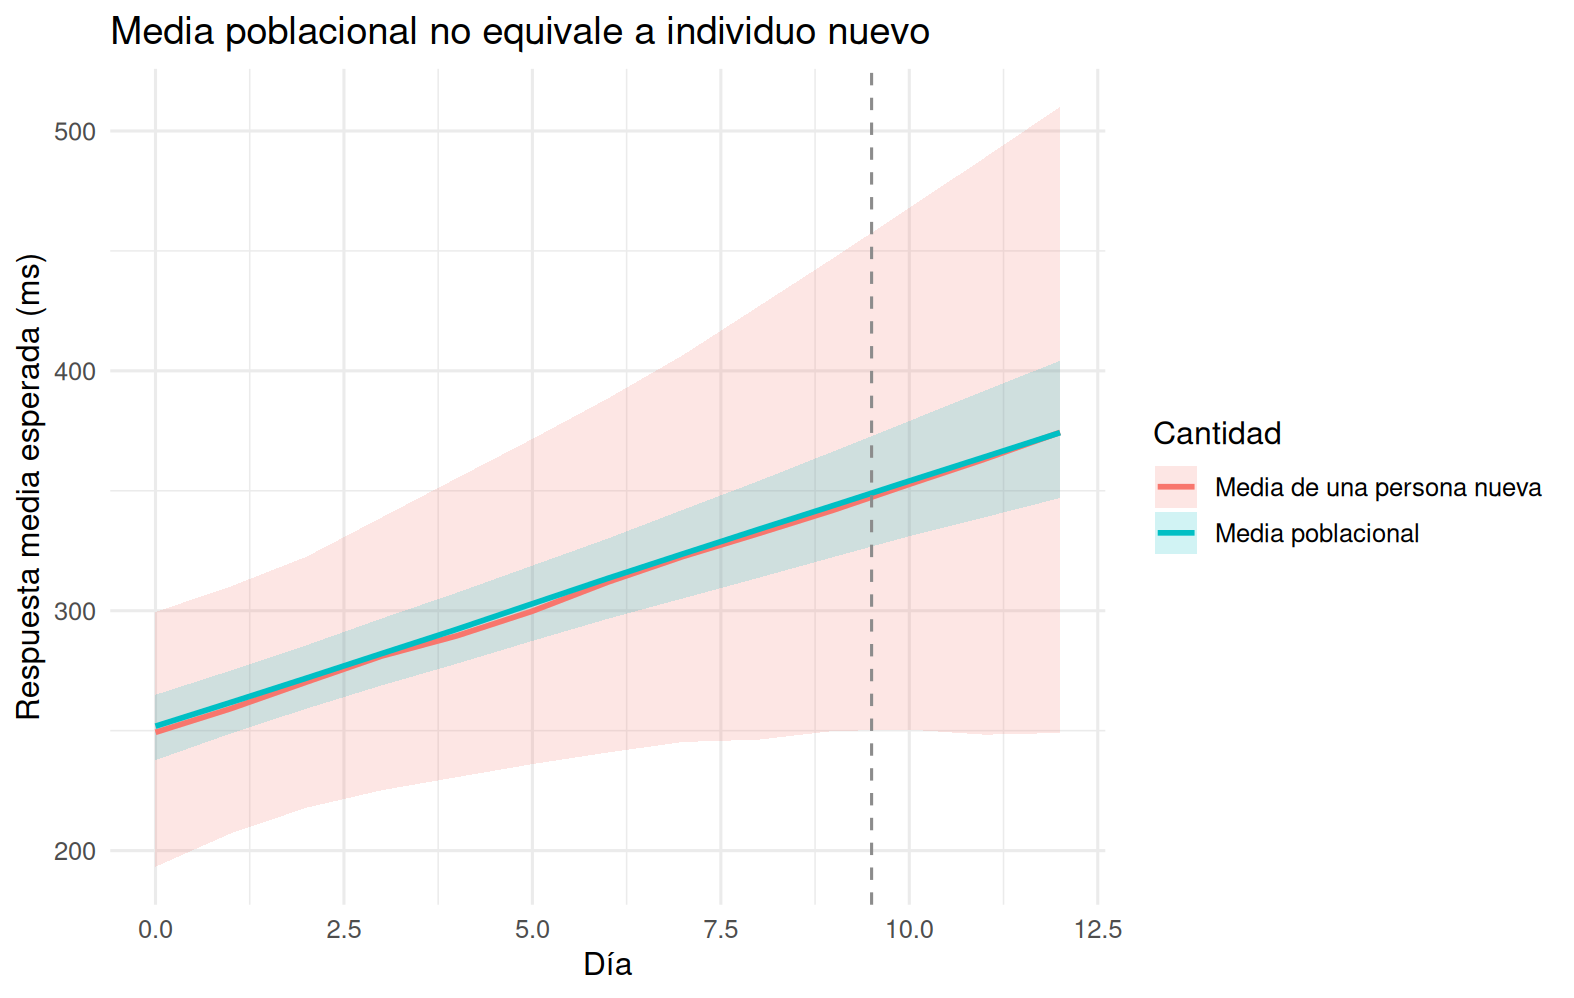
La predicción de una media marginal poblacional se obtiene de manera distinta. En el modelo lineal gaussiano, su valor esperado es \(\mu_\alpha+\mu_\beta t\). Fijar re_formula = NA produce esta curva media, pero no simula la heterogeneidad de personas nuevas. En consecuencia, re_formula = NA no reemplaza allow_new_levels = TRUE cuando la pregunta se refiere a resultados de un participante futuro.
11.12.1 Construcción de los escenarios predictivos
Elegiremos un participante existente y un identificador no observado. Pediremos predicciones entre los días 0 y 12; los días 10–12 serán una extrapolación respecto del rango 0–9 de los datos. Utilizaremos el mismo identificador nuevo en toda la secuencia para representar una única trayectoria individual futura.
Figura 11.14: Incertidumbre de trayectorias y observaciones para una persona existente y otra nueva. Bandas puntuales del 90 %. Los días 10–12 son extrapolaciones lineales no comprobadas con datos observados.
resumen_media_nuevo_s11 <-bind_rows(resumir_columnas_s11( mu_centro_s11, dias_pred_s11, "Media poblacional" ),resumir_columnas_s11( mu_nuevo_s11, dias_pred_s11, "Media de una persona nueva" ))ggplot( resumen_media_nuevo_s11,aes(x, mediana, colour = tipo, fill = tipo)) +geom_ribbon(aes(ymin = q05, ymax = q95), alpha =0.18,colour =NA) +geom_line(linewidth =1) +geom_vline(xintercept =9.5, linetype ="dashed", colour ="grey55") +labs(x ="Día", y ="Respuesta media esperada (ms)",colour ="Cantidad", fill ="Cantidad",title ="Media poblacional no equivale a individuo nuevo" ) +theme_minimal(base_size =12)
Figura 11.15: Comparación entre incertidumbre de la media poblacional y variación de la media de un participante nuevo. Ambas curvas pueden compartir el mismo centro, pero difieren en dispersión.
11.12.2 ¿Qué cambia si el objetivo es predecir otra persona?
Si queremos pronosticar la próxima medición de alguien ya observado, una validación posible consiste en reservar las últimas ocasiones de cada participante y ajustar con las anteriores. Si el objetivo es generalizar a participantes nunca observados, la validación debería separar personas completas entre entrenamiento y prueba. Dividir filas al azar entre ambos conjuntos puede colocar mediciones de la misma persona en entrenamiento y prueba, produciendo una evaluación demasiado favorable para la tarea de predecir individuos nuevos.
En los capítulos sobre comparación y validación retomaremos estas decisiones mediante validación cruzada y PSIS-LOO cuando la unidad de predicción sea apropiada. Aquí lo esencial es especificar primero el escenario de generalización; la métrica se elige después (Gelman et al. 2026, secs. 7.1, 8.3, chap. 9).
AdvertenciaExtrapolar no equivale a validar
Las predicciones de los días 10–12 prolongan una recta más allá del último día observado. Su aparente precisión cuantifica incertidumbre dentro del modelo lineal adoptado; no incluye automáticamente incertidumbre por una trayectoria que pueda curvarse, estabilizarse o cambiar de régimen. En consecuencia, una banda estrecha para una extrapolación no demuestra que ese pronóstico sea confiable.
11.13 Limitaciones, alternativas y enlace con la semana 12
En el modelo desarrollado se supone que, condicionadas en los coeficientes individuales, las observaciones siguen distribuciones normales con una misma desviación estándar residual y sin autocorrelación residual adicional. También se supone que la media condicional es lineal durante la ventana temporal considerada y que la distribución de interceptos y pendientes es normal bivariada.
Estas son decisiones de modelación, no propiedades necesarias de los datos. Pueden surgir limitaciones como las siguientes:
Curvatura temporal: los cambios pueden acelerarse, frenarse o presentar fases. Un término cuadrático, una función por tramos o una función flexible del tiempo podrían representar esa situación, pero requieren justificar qué patrones interesa permitir.
Dependencia residual: mediciones cercanas pueden parecerse incluso después de condicionar en la trayectoria individual.
Heterocedasticidad residual: la dispersión alrededor de cada trayectoria puede depender del tiempo o de características individuales.
Ausencias informativas: individuos con ciertas respuestas podrían abandonar el seguimiento o ser medidos con distinta frecuencia; el modelo de respuesta condicional no resuelve automáticamente ese mecanismo.
Poca información sobre pendientes: pocos tiempos por persona, o tiempos con una ventana demasiado corta, pueden dejar gran incertidumbre en \(\tau_1\) y \(\rho\).
Extrapolación sustantivamente débil: una tendencia aproximadamente lineal en el intervalo observado puede dejar de ser razonable fuera de él.
La semana 12 estará dedicada específicamente a dependencia residual y tiempo no lineal. La distinción principal será que la heterogeneidad de pendientes crea correlación marginal aun cuando los errores condicionales sean independientes; una estructura residual adicional describe una fuente distinta de dependencia (Hox et al. 2018, secs. 5.6-5.7; Verbeke y Molenberghs 2000, chaps. 3-4).
11.14 Errores de interpretación frecuentes
11.14.1 Interpretar la ocasión de visita como tiempo transcurrido
Si las visitas ocurren en tiempos irregulares, utilizar 1, 2, 3, … como predictor hace que una unidad represente una visita, no necesariamente un día, mes o año. Esto altera el significado de la pendiente y las predicciones. El índice de ocasión sirve para ordenar; el tiempo numérico debe representar la escala sustantiva relevante.
11.14.2 Interpretar la correlación intercepto–pendiente sin indicar el origen
La correlación cambia con el origen temporal porque el intercepto cambia. No es correcto concluir que una correlación positiva obtenida en un origen y una negativa obtenida en otro implican poblaciones contradictorias. Hay que indicar en qué tiempo está definido el intercepto y, cuando se cambia de origen, transformar coherentemente los parámetros y las previas.
11.14.3 Confundir una pendiente poblacional con todas las pendientes individuales
Una pendiente poblacional positiva no exige que todas las personas aumenten su respuesta. El parámetro \(\tau_1\) cuantifica la heterogeneidad de pendientes y los intervalos posteriores de individuos concretos pueden ser muy distintos.
11.14.4 Interpretar una banda de media como intervalo de nuevas observaciones
Las bandas de posterior_epred() representan incertidumbre en medias condicionales. Las de posterior_predict() incorporan también variación observacional. Las predicciones de individuos nuevos deben incluir además su heterogeneidad no conocida. Mezclar estos objetos puede llevar a comunicar una incertidumbre engañosamente pequeña.
11.14.5 Considerar que el balance de datos resuelve el mecanismo de ausencia
El modelo admite números y tiempos de observación distintos, pero la inferencia sustantiva puede verse afectada por un proceso de abandono dependiente de respuestas no observadas o de factores no incluidos. Admitir datos desbalanceados no es sinónimo de corregir automáticamente el sesgo por ausencias.
11.14.6 Usar comprobaciones predictivas globales como única evaluación
Dos modelos pueden reproducir distribuciones marginales semejantes y, sin embargo, diferir considerablemente en su capacidad de representar la variabilidad de pendientes, los niveles al final del seguimiento o las trayectorias de grupos particulares. Debemos seleccionar estadísticas predictivas que correspondan a la estructura científica de interés.
11.15 Síntesis
El análisis longitudinal formula explícitamente la dependencia de mediciones de un mismo individuo y permite representar, simultáneamente, un cambio poblacional y la heterogeneidad de trayectorias individuales. El modelo de interceptos variables describe rectas paralelas; el de interceptos y pendientes variables admite diferencias tanto en niveles como en tasas de cambio. Esta jerarquía proporciona pooling parcial e induce una matriz de covarianza que depende de los tiempos observados.
El origen temporal define qué significa el intercepto y condiciona la interpretación de su correlación con la pendiente. La formulación bayesiana permite expresar la incertidumbre de los parámetros poblacionales, los coeficientes individuales y las predicciones, distinguiendo individuos existentes, individuos nuevos, medias esperadas y observaciones futuras.
En el flujo de trabajo, ajustar no equivale a validar: debemos revisar la simulación HMC y comprobar que el modelo reproduce características longitudinales importantes. Finalmente, debemos reconocer que la linealidad y la independencia residual condicional son hipótesis que podrán ampliarse, pero no supuestos universales.
11.16 Ejercicios propuestos
11.16.1 Ejercicio 1. Unidad longitudinal y calendario
Un estudio mide presión arterial de tres personas en las siguientes semanas desde su ingreso:
Persona
Semanas observadas
A
0, 2, 4, 8
B
0, 1, 3, 6, 8
C
0, 4, 8
Identifique la unidad de observación, el individuo y la variable temporal. (b) Explique por qué el índice de visita no es intercambiable con el tiempo transcurrido. (c) Escriba la fórmula del modelo de interceptos y pendientes variables y explique qué parte de la información se comparte entre personas. (d) Discuta en qué condiciones la desigualdad en números y tiempos de medición podría afectar la interpretación de las predicciones.
11.16.2 Ejercicio 2. Interpretación de parámetros y cambio individual
Considere un modelo donde la respuesta se mide en puntos y el tiempo en meses, con \(\mu_\alpha=50\), \(\mu_\beta=2\), \(\tau_0=6\), \(\tau_1=1.5\) y \(\rho=-0.4\). El origen temporal es el inicio del estudio.
Interprete cada parámetro en sus unidades correspondientes. (b) Si un individuo tiene \(u_{0i}=3\) y \(u_{1i}=-1\), escriba su trayectoria esperada y contraste su cambio de los meses 1 a 5 con el cambio poblacional. (c) Explique por qué \(\rho=-0.4\) no implica que todas las personas con respuesta inicial alta tengan pendientes negativas.
11.16.3 Ejercicio 3. Derivación de covarianza y correlación
Partiendo de Ecuación 11.3, derive Ecuación 11.8 y Ecuación 11.7. Obtenga la correlación entre dos tiempos diferentes y compárela con la del modelo de interceptos variables. Analice qué ocurre con la varianza marginal cuando \(\rho=0\) y el tiempo se aleja de cero. Discuta por qué la dependencia generada por pendientes variables no corresponde necesariamente a una función exclusiva de \(|t-s|\).
11.16.4 Ejercicio 4. Cambiar el origen temporal
Sea \(t^*=t-c\). (a) Obtenga \(\alpha_i^*\) y \(\beta_i^*\) en función de los coeficientes originales. (b) Derive la nueva matriz de covarianza de los coeficientes. (c) Determine el valor de \(c\) que anula la covarianza intercepto–pendiente cuando \(\tau_1^2>0\). (d) Discuta por qué dos modelos bayesianos reajustados con las mismas previas numéricas independientes en dos orígenes diferentes no tienen necesariamente la misma posterior, aunque sus verosimilitudes representen las mismas rectas.
11.16.5 Ejercicio 5. Predicción e incertidumbre
Para el modelo longitudinal ajustado, proponga cómo simular: (a) la respuesta media en el día 7 de una persona ya observada; (b) su próxima respuesta en ese mismo día; (c) la respuesta media de una persona completamente nueva; (d) una observación de esa persona nueva. Indique qué componentes de incertidumbre incluye cada distribución y explique por qué re_formula = NA no es una solución general para (c) y (d).
11.16.6 Ejercicio 6. Laboratorio crítico
Utilice los resultados del laboratorio para responder: (a) ¿qué evidencia posterior muestra el signo y la magnitud del cambio poblacional? (b) ¿cómo varía el cambio individual a lo largo del seguimiento? (c) ¿la dispersión entre personas por día y la dispersión de pendientes descriptivas se encuentran dentro de patrones generados con frecuencia por el modelo? (d) ¿qué diferencias observa entre la incertidumbre para una persona existente y otra nueva? (e) ¿qué condiciones deberían cumplirse antes de comunicar predicciones para días posteriores al día 9?
Extensión opcional. Modifique la pregunta predictiva: reserve el último día de cada persona, ajuste con los días anteriores y describa una comprobación fuera de muestra para personas conocidas. Compare conceptualmente ese diseño con reservar personas completas para evaluar predicciones de nuevos individuos. No es necesario reducir ambos objetivos a un único indicador numérico.
11.17 Lecturas recomendadas y referencias
Lecturas principales
Hox, Moerbeek y van de Schoot, capítulo 5, especialmente §§ 5.1–5.5 (pp. 71–88): organización de datos longitudinales, ocasiones fijas y variables, crecimiento individual y origen temporal (Hox et al. 2018).
Gelman y Hill, § 11.3 (pp. 241–244) y §§ 13.1–13.4 (pp. 279–289): medidas repetidas y distribución conjunta de interceptos y pendientes variables (Gelman y Hill 2007).
Lecturas complementarias
West, Welch y Galecki, capítulo 6 (pp. 263–322): modelos de coeficientes variables para datos longitudinales, con aplicación al seguimiento de niños con autismo (West et al. 2022).
Verbeke y Molenberghs, capítulos 3–4: estructura de los modelos lineales mixtos y exploración de trayectorias longitudinales (Verbeke y Molenberghs 2000).
Gelman y colaboradores, Bayesian Workflow, §§ 5.6–5.9, 8.2 y capítulos 11–12: previas, comprobación predictiva y diagnóstico computacional (Gelman et al. 2026).
Bürkner, §§ 2–3: formulación jerárquica e inferencia bayesiana con brms y Stan (Bürkner 2017).
NotaNota sobre reproducibilidad y lectura de resultados
Este capítulo no presenta números de ajuste ni conclusiones empíricas predeterminadas: las tablas, probabilidades, bandas y comprobaciones se calculan al ejecutar el código en el entorno del curso. La elección de previas y las figuras didácticas deben revisarse a la luz del resultado de su ejecución. Para reproducir los ajustes se requiere CmdStan instalado y configurado; freeze: auto permite evitar repetir cálculos al construir el libro cuando los resultados congelados no cambian.
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. 2.ª ed. Chapman & Hall/CRC.
Verbeke, Geert, y Geert Molenberghs. 2000. Linear Mixed Models for Longitudinal Data. Springer.
West, Brady T., Kathleen B. Welch, y Andrzej T. Galecki. 2022. Linear Mixed Models: A Practical Guide Using Statistical Software. 3.ª ed. CRC Press. https://doi.org/10.1201/9781003181064.