10Semana 10. Proporciones, respuestas ordinales y familias adicionales
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
12 de octubre de 2026
10.1 Panorama de la semana
En las semanas 8 y 9 estudiamos GLMM para respuestas binarias y conteos. Una estructura multinivel no obliga a utilizar una distribución normal: conservamos la idea de coeficientes que varían entre grupos y cambiamos la distribución de las observaciones para que refleje qué se midió y cómo se obtuvo la respuesta. En esta semana estudiaremos dos situaciones que requieren especial atención: proporciones provenientes de ensayos conocidos y categorías que tienen un orden, pero no necesariamente distancias numéricas interpretables.
Pregunta orientadora. ¿Cómo elegir una distribución de respuesta coherente con la unidad de observación y construir un modelo multinivel que permita interpretar y comprobar sus predicciones?
La progresión será
\[
\underbrace{\text{éxitos de }n\text{ ensayos}}_{\text{binomial}}
\;\longrightarrow\;
\underbrace{\text{variación extra de probabilidades}}_{\text{beta-binomial}}
\;\longrightarrow\;
\underbrace{\text{categorías ordenadas}}_{\text{modelo acumulativo}}
\;\longrightarrow\;
\underbrace{\text{otros mecanismos de respuesta}}_{\text{familias adicionales}}.
\]
El modelo logístico ordinal acumulativo con interceptos variables será el tema central. La beta-binomial profundiza la discusión de sobredispersión de la semana anterior; las familias adicionales se presentan como extensiones motivadas por el mecanismo de observación, no como una lista de alternativas intercambiables (Gelman y Hill 2007, secs. 6.3 y 15.2; McElreath 2020, chap. 12; Hox et al. 2018, secs. 6.4 y 7.1).
NotaFuentes y materiales originales
La formulación binomial y ordinal se apoya en Gelman y Hill, McElreath y Hox et al.; la implementación ordinal en Bürkner (Bürkner 2017, sec. 4.8). El diagnóstico y las comprobaciones siguen los principios de Bayesian Workflow(Gelman et al. 2026, chaps. 5 y 8). Las simulaciones, funciones auxiliares y figuras construidas en R para esta clase son elaboraciones pedagógicas originales. La aplicación utiliza datos incluidos en brms, pero sus análisis, previas y visualizaciones se formulan para este curso.
Objetivos de aprendizaje
Al finalizar la unidad, la persona estudiante podrá:
identificar la unidad de observación, el denominador binomial y las fuentes de dependencia;
distinguir conteos binomiales, proporciones calculadas a partir de esos conteos y proporciones continuas;
formular un modelo binomial multinivel con distintos números de ensayos por observación;
derivar la media y la varianza beta-binomial e interpretar su parámetro de precisión;
explicar por qué la dispersión marginal puede provenir tanto de heterogeneidad grupal como de variación adicional entre unidades;
distinguir una respuesta ordinal de una nominal y de una medida numérica con distancias definidas;
formular un modelo logístico ordinal acumulativo y derivar probabilidades de cada categoría a partir de probabilidades acumuladas;
explicar el orden de los umbrales, su interpretación y la restricción de identificación de la localización;
interpretar el supuesto de odds proporcionales y el signo de los coeficientes en la convención adoptada;
incorporar interceptos variables y explicar el pooling parcial en un modelo ordinal;
especificar previas en la escala pertinente y examinar sus implicaciones en la escala de probabilidades;
ajustar modelos binomial, beta-binomial y ordinal con brms y backend = "cmdstanr";
distinguir diagnóstico computacional de HMC y adecuación predictiva;
comprobar frecuencias de categorías, proporciones extremas y heterogeneidad por grupos;
comparar predicciones condicionales para un grupo, predicciones con el coeficiente grupal fijado en cero y predicciones para un grupo nuevo;
reconocer cuándo son conceptualmente pertinentes modelos beta, cero-inflados, hurdle o semicontinuos.
10.2 Del tipo de respuesta a la verosimilitud
Antes de escribir una ecuación de regresión, conviene responder tres preguntas: ¿qué representa un registro?, ¿cuáles son los valores posibles de la respuesta?, ¿qué información adicional se conoce sobre su obtención? Una respuesta como «0.40» no determina por sí sola la familia estadística: puede significar 4 éxitos de 10 intentos, 400 de 1000, o una fracción continua observada por medición directa.
Dato observado
Información esencial
Modelo inicial posible
4 éxitos de 10 ensayos
Número de éxitos y de ensayos
Binomial
40 éxitos de 100 ensayos
Número de éxitos y de ensayos
Binomial
Proporción continua en \((0,1)\)
Medición acotada, sin denominador de ensayos
Beta, bajo supuestos apropiados
Evaluación «mala, regular, buena, excelente»
Orden conocido, distancias desconocidas
Ordinal acumulativo
Categoría «A, B, C» sin orden
Categorías nominales
Categórico/multinomial
Conteo no acotado con muchos ceros
Mecanismo de conteo y de generación de ceros
Poisson/binomial negativa y, si procede, mezcla o hurdle
El denominador importa. Las proporciones \(4/10\) y \(400/1000\) son iguales, pero contienen cantidades muy diferentes de información bajo el supuesto de ensayos binomiales condicionalmente independientes. Sustituir la respuesta binomial por el cociente observado y omitir \(n\) pierde esa distinción. También importa identificar qué ensayos son independientes condicionalmente a las variables incluidas; contar muchos ensayos no garantiza independencia ni representatividad (Gelman y Hill 2007, sec. 6.3; Hox et al. 2018, sec. 6.4).
10.3 Proporciones originadas en ensayos: modelo binomial multinivel
Supongamos que la unidad \(i\) del grupo \(j\) incluye \(n_{ij}\) ensayos y \(Y_{ij}\) éxitos. Escribimos
El componente \(u_j\) permite que la probabilidad basal varíe entre grupos. La distribución normal conecta esos componentes y genera pooling parcial sobre la escala logit. El intercepto poblacional \(\mu_\alpha\) describe el valor del predictor para \(x_{ij}=0\) y \(u_j=0\). No es, en general, el logit de la probabilidad promedio después de integrar la distribución de grupos, debido a la no linealidad de la inversa-logit.
La segunda expresión muestra directamente que una proporción basada en pocos ensayos tiene mayor variabilidad binomial. Si un grupo tiene un único ensayo, su proporción observada será 0 o 1 sin que eso obligue a asignar probabilidad de éxito 0 o 1 al grupo. Su estimación posterior se regulariza a través de la jerarquía.
ImportanteVariabilidad marginal y condicional
La relación varianza–media de Ecuación 10.2 es condicional a la probabilidad \(p_{ij}\). Si esta cambia entre grupos por medio de \(u_j\), la distribución marginal de \(Y_{ij}\) puede presentar más variación que una binomial con una sola probabilidad común. Observar dispersión en todas las unidades combinadas no basta para justificar otra familia: primero debemos considerar los predictores y la estructura jerárquica.
En ocasiones, incluso después de condicionar en las covariables y los grupos, observaciones con el mismo \(n_{ij}\) y valores predictivos similares presentan proporciones más variables que las previstas por una binomial. Una explicación posible es que dentro de una observación agregada los ensayos compartan una probabilidad latente específica, no capturada por el predictor. La beta-binomial representa explícitamente esa variación (McElreath 2020, sec. 12.1.1).
Introducimos \(q_{ij}\) como probabilidad latente de la observación agregada:
con \(B(a,b)=\Gamma(a)\Gamma(b)/\Gamma(a+b)\). No es necesario introducir un \(q_{ij}\) diferente como parámetro explícito en Stan si utilizamos esta verosimilitud marginal.
El factor de inflación respecto de la binomial es \((n+\phi)/(\phi+1)\); resulta mayor que 1 para \(n>1\) y \(\phi\) finito. Cuando \(\phi\to\infty\), la variabilidad de \(q_{ij}\) tiende a cero y recuperamos la binomial como límite. Cuando \(n=1\), ambas verosimilitudes coinciden: una respuesta Bernoulli aislada no identifica el parámetro\(\phi\) mediante esa observación.
Para los \(n\) ensayos de una misma unidad, que comparten \(q_{ij}\) y son condicionalmente independientes dado \(q_{ij}\), su correlación marginal condicional en \(\mu_{ij},\phi\) es
Se trata de correlación entre ensayos dentro de la observación agregada, no del ICC entre grupos asociado con \(\tau_\alpha\). En Ecuación 10.3, los dos componentes representan fuentes de variación distintas. Si no hay replicación suficiente dentro de los grupos, puede ser difícil distinguirlas.
10.4.3 ¿Cuándo expandir el modelo?
No recomendamos reemplazar automáticamente la binomial por beta-binomial si la varianza observada es grande. Procederemos examinando, en orden: (i) la definición de ensayos y denominadores; (ii) los predictores relevantes; (iii) la variación entre grupos; (iv) comprobaciones predictivas condicionales al modelo ajustado, por ejemplo de proporciones extremas y frecuencias de éxitos; y (v) la plausibilidad de una probabilidad latente adicional por unidad. La elección también depende de si cada fila resume verdaderos ensayos intercambiables: la beta-binomial no soluciona por sí sola un mecanismo de selección sesgado.
Pensemos en una escala con las opciones «nunca», «rara vez», «a veces», «frecuentemente». Existe un orden, pero no se sigue de él que las distancias entre categorías sean iguales. Codificar esas respuestas como 1, 2, 3 y 4 permite almacenarlas, pero esos números no son cuatro medidas sobre una escala de intervalo. El modelo ordinario de regresión normal, por ejemplo,
permite respuestas continuas y valores fuera de las categorías posibles. Puede servir como aproximación pragmática en ciertas escalas con muchas categorías y distribuciones aproximadamente simétricas, pero presupone distancias iguales y debe justificarse; no lo utilizaremos como formulación principal (Hox et al. 2018, sec. 7.1; McElreath 2020, sec. 12.3).
Un modelo categórico nominal asignaría probabilidades a todas las categorías sin imponer su orden. Es más flexible, pero renunciaría a una propiedad conocida de la respuesta. Una regresión ordinal utiliza esa propiedad para describir cambios a lo largo de una secuencia de categorías.
10.6 Modelo logístico ordinal acumulativo
10.6.1 Probabilidades acumuladas y umbrales
Sea \(Y_{ij}\in\{1,\ldots,K\}\), con \(K\ge2\) categorías ordenadas de menor a mayor. Definimos
Como \(c_1<\cdots<c_{K-1}\) y \(L\) es creciente, obtenemos automáticamente \(F_{ij}(1)<\cdots<F_{ij}(K-1)\), de manera que las probabilidades resultantes son válidas. Los umbrales representan puntos que separan categorías consecutivas sobre una escala latente. Se estiman conjuntamente con los demás parámetros; no son números de corte establecidos a priori por la codificación 1, 2, …, \(K\).
TipRepresentación latente: una interpretación, no una observación adicional
Podemos imaginar \(Z_{ij}=\eta_{ij}+\varepsilon_{ij}\) con \(\varepsilon_{ij}\) logística estándar y observar \(Y_{ij}=k\) cuando \(c_{k-1}<Z_{ij}\le c_k\), usando \(c_0=-\infty\) y \(c_K=+\infty\). Esta construcción reproduce exactamente Ecuación 10.7. \(Z_{ij}\) no necesita existir como medición física ni incorporarse como variable latente explícita durante el ajuste.
10.6.2 Derivar las probabilidades de cada categoría
Un cambio de \(\eta\) mueve simultáneamente las cuatro probabilidades, pero no todas en el mismo sentido: las probabilidades de las categorías intermedias pueden aumentar en cierta región y disminuir en otra. Por ello, la interpretación central de los coeficientes se realizará mediante probabilidades posteriores por categoría y eventos acumulados.
10.6.3 Escala, orientación e identificación
Con la convención \(F(k)=L(c_k-\eta)\), valores mayores de \(\eta\) desplazan masa hacia las categorías más altas. El signo de un coeficiente debe interpretarse con esta convención y con el orden efectivo de los niveles del factor en R.
Una primera tentación sería introducir al mismo tiempo un intercepto global \(\alpha\) en \(\eta_{ij}=\alpha+\beta x_{ij}\) y todos los umbrales libres. Sin una restricción adicional, esto no identifica la localización: para cualquier constante \(a\),
En el modelo acumulativo estándar, los \(K-1\) umbrales cumplen el papel de interceptos específicos de corte y no se agrega otro intercepto poblacional libre al predictor. Esto no impide incorporar coeficientes grupales de media cero, definidos mediante una distribución jerárquica. Su localización está conectada a la media poblacional cero de esos coeficientes.
Si \(x\) aumenta una unidad, manteniendo constantes los demás predictores, las odds de pertenecer a una categoría superior a\(k\) frente a una categoría menor o igual a\(k\) se multiplican por \(\exp(\beta)\), para todos los cortes \(k\). Es el supuesto de odds proporcionales. No afirma que todas las probabilidades cambien la misma cantidad ni que los odds ratios sean comparaciones de categorías adyacentes (Hox et al. 2018, sec. 7.1.1).
Un modelo con \(\beta>0\) aumenta la probabilidad de categorías superiores, pero \(P(Y=k\mid x)\) para una categoría intermedia puede no ser monótona en \(x\). Veremos ambas propiedades por simulación.
Se habla de interceptos variables porque \(u_j\) desplaza la posición latente del grupo. No significa que el modelo tenga un intercepto global adicional a los umbrales; todos los grupos utilizan los umbrales comunes \(c_k\) y difieren en su desplazamiento \(u_j\). Dos unidades del mismo grupo pueden compartir \(u_j\), generando dependencia marginal incluso si sus respuestas son independientes condicionalmente a los parámetros y al coeficiente grupal.
Si \(u_j>0\), y se mantienen constantes las covariables, las probabilidades acumuladas \(P(Y\le k)\) disminuyen: ese grupo presenta mayor tendencia a categorías altas. El coeficiente se regulariza mediante la distribución poblacional, de manera análoga a los modelos de interceptos variables estudiados previamente. La precisión de una estimación grupal depende de cuántas observaciones haya, de la distribución de categorías, de los predictores y de la heterogeneidad estimada.
Un coeficiente grupal no observado para un grupo nuevo debe simularse de la distribución \(\mathcal N(0,\tau_\alpha^2)\) para cada simulación posterior, no fijarse permanentemente en cero. La predicción con \(u_j=0\) representa un perfil situado en la localización poblacional de la escala latente, y generalmente no coincide con la probabilidad marginalizada sobre los grupos (Gelman y Hill 2007, sec. 12.8; McElreath 2020, sec. 13.5).
10.7.1 Posibles ampliaciones y límites
Podemos permitir que una pendiente varíe por grupo, por ejemplo \(\eta_{ij}=u_{0j}+(\beta+u_{1j})x_{ij}\), con una distribución normal conjunta para \(u_{0j}\) y \(u_{1j}\). Esto conserva el supuesto de odds proporcionales dentro de cada grupo, aunque permite que el valor de la pendiente cambie entre grupos. Una modificación diferente sería permitir que la asociación con \(x\) dependa del umbral: eso relaja las odds proporcionales. No debe hacerse simplemente asignando pendientes independientes a los cortes sin garantizar que las probabilidades acumuladas continúen ordenadas. Los modelos parciales o alternativos requieren restricciones apropiadas y comprobación predictiva (Hox et al. 2018, sec. 7.1; Bürkner 2017, sec. 4.8).
Gelman y Hill examinan también un modelo donde puntos de corte individuales cambian entre sujetos (Gelman y Hill 2007, sec. 15.2). No es exactamente lo mismo que desplazar conjuntamente umbrales comunes con \(u_j\): variar separadamente puntos de corte requiere preservar su orden y puede representar heterogeneidad en el uso de categorías además de heterogeneidad de localización.
10.8 Distribuciones previas e implicaciones en la escala de respuesta
10.8.1 Coeficientes logit y desplazamientos grupales
Para predictores centrados o codificados de manera interpretable, una previa como \(\beta\sim\mathcal N(0,0.8^2)\) admite cambios relevantes en odds sin concentrar mucha probabilidad en efectos extremadamente grandes. Antes de adoptarla, debemos indicar qué significa una unidad de \(x\); una escala de 1 punto y una de 100 puntos no justifican el mismo desvío previo. Para la heterogeneidad podemos utilizar \(\tau_\alpha\sim\operatorname{Exponential}(2)\) y verificar qué diferencias entre grupos induce en la escala de probabilidades.
Los números anteriores son elecciones didácticas para los ejercicios que siguen, no previas universales recomendadas por los autores. Si la información sustantiva exige otro rango de probabilidades, hay que modificar la elección, justificarla y examinar su sensibilidad.
10.8.2 Previas de umbrales ordinales
Con cuatro categorías, una posibilidad es aplicar una previa normal moderada a los tres umbrales, sujeta a la restricción de orden:
Aquí \(\varphi\) es una densidad normal. El orden significa que los umbrales no son independientes bajo la distribución conjunta condicionada a la restricción. En brms pueden establecerse previas para la clase Intercept, que en esta familia se refiere a los umbrales; comprobar la simulación predictiva previa es indispensable, porque sus posiciones determinan las frecuencias esperadas en cada categoría.
10.8.3 Precisión beta-binomial
En el laboratorio utilizaremos \(\phi\sim\operatorname{Gamma}(2,0.2)\), con el segundo parámetro expresado como tasa (media previa 10). Esta distribución induce diferentes grados de dispersión, y su pertinencia se estudiará a través de la transformación \(1/(\phi+1)\) y de datos simulados. Ningún valor individual de \(\phi\) basta para diagnosticar un modelo: también debemos revisar la capacidad predictiva de las proporciones observadas.
10.8.4 Qué comprobar antes de usar los datos
Para el ordinal, examinaremos la distribución previa de probabilidades de categoría, la proporción de respuestas extremas y la dispersión entre grupos. Para la beta-binomial, examinaremos proporciones 0, 1 y valores intermedios según \(n\), y cuánta heterogeneidad se permite entre grupos. La comprobación previa no consiste en adaptar las previas hasta reproducir exactamente el histograma observado: es una evaluación de si los escenarios que el modelo considera plausibles antes de los datos son defendibles (Gelman et al. 2026, sec. 5.9).
10.9 Laboratorio 1: binomial y beta-binomial con grupos
El primer laboratorio utiliza datos simulados. Conocer los parámetros de simulación permite examinar qué tipos de heterogeneidad tienen realmente los datos y qué captura cada modelo. En particular, crearemos una probabilidad latente \(q_{ij}\)por fila, además de un intercepto variable por grupo. No atribuiremos al modelo un resultado numérico antes de realizar el ajuste.
10.9.1 Simulación desde una estructura multinivel beta-binomial
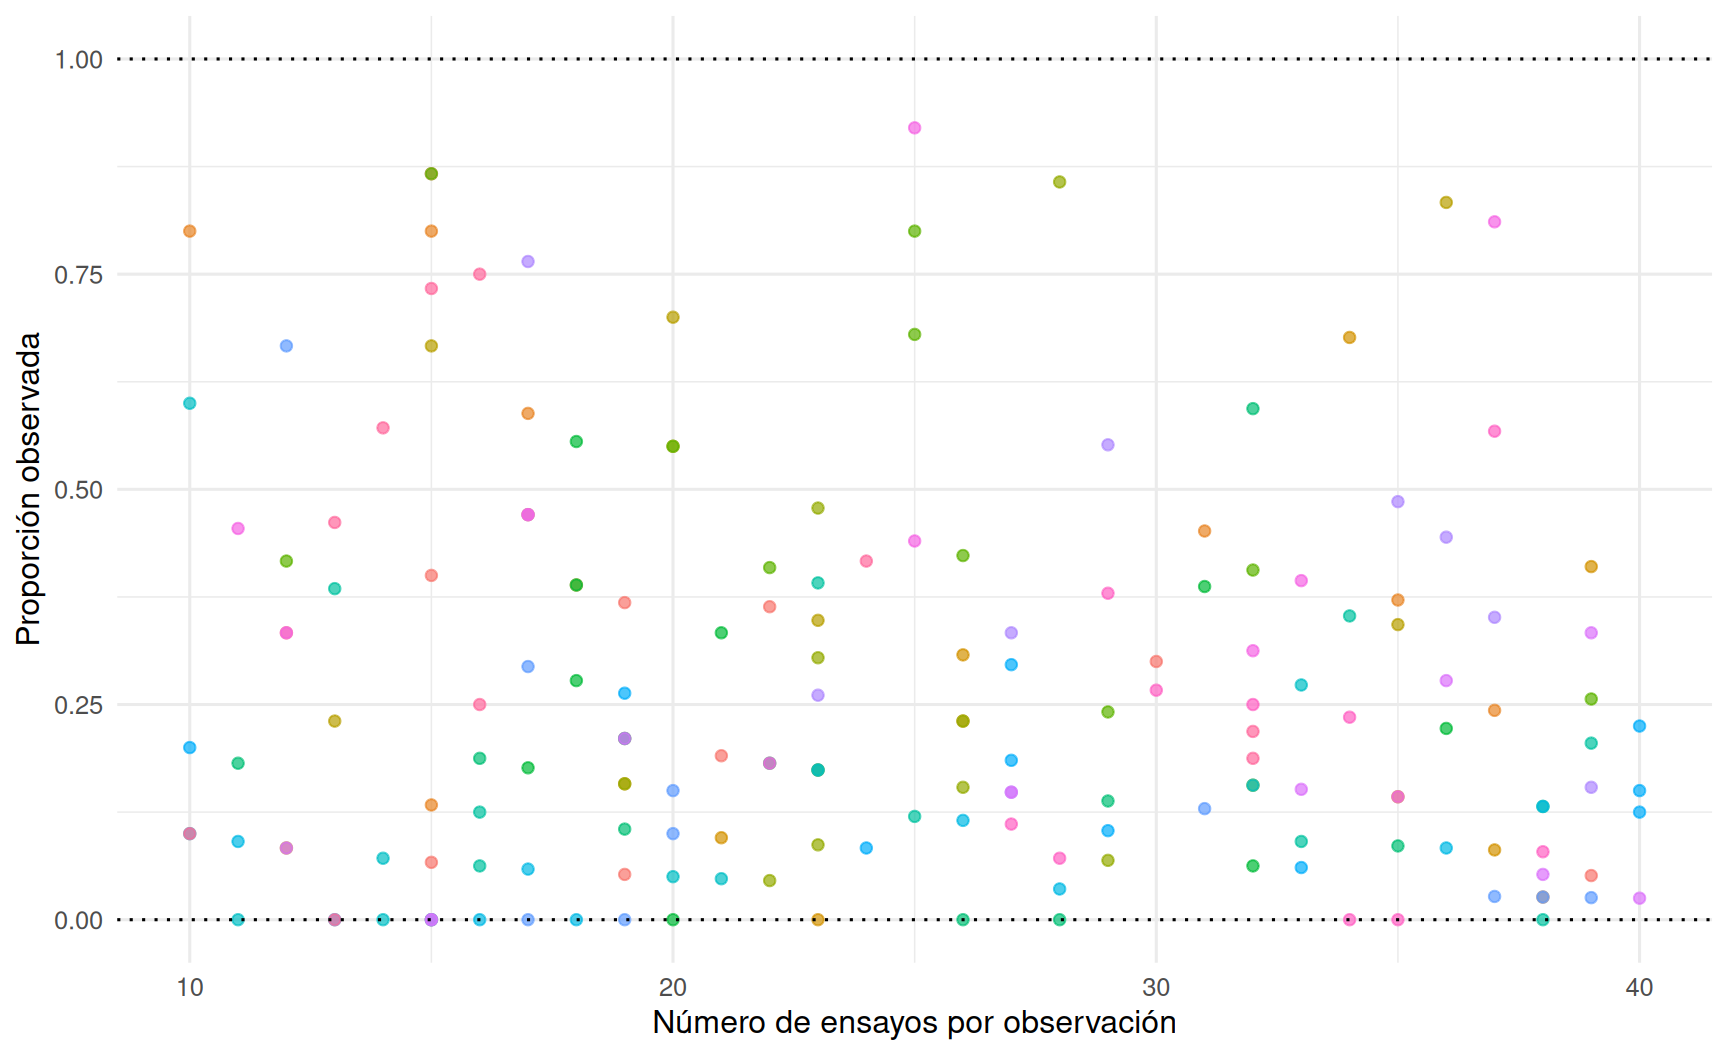
Simularemos 18 grupos con 10 filas cada uno. Los denominadores cambiarán entre filas. Los valores elegidos son didácticos: intercepto basal en logit \(\operatorname{logit}(0.28)\), pendiente \(0.55\), desviación entre grupos \(0.65\) y precisión beta-binomial \(\phi=9\).
ggplot(datos_bb_s10, aes(x = n, y = prop, color = grupo)) +geom_point(alpha =0.70) +geom_hline(yintercept =c(0, 1), linetype ="dotted") +scale_y_continuous(limits =c(0, 1)) +labs(x ="Número de ensayos por observación", y ="Proporción observada") +theme_minimal(base_size =12) +theme(legend.position ="none")
Figura 10.1: Proporciones observadas y números de ensayos en datos simulados; puntos grandes no necesariamente son estimaciones más precisas si los ensayos comparten probabilidades latentes.
El gráfico permite observar que la amplitud de las proporciones depende de \(n\) y de otras fuentes de variación. No debemos interpretar la diferencia entre puntos como evidencia directa de un determinado valor de \(\phi\) sin ajustar y comprobar el modelo.
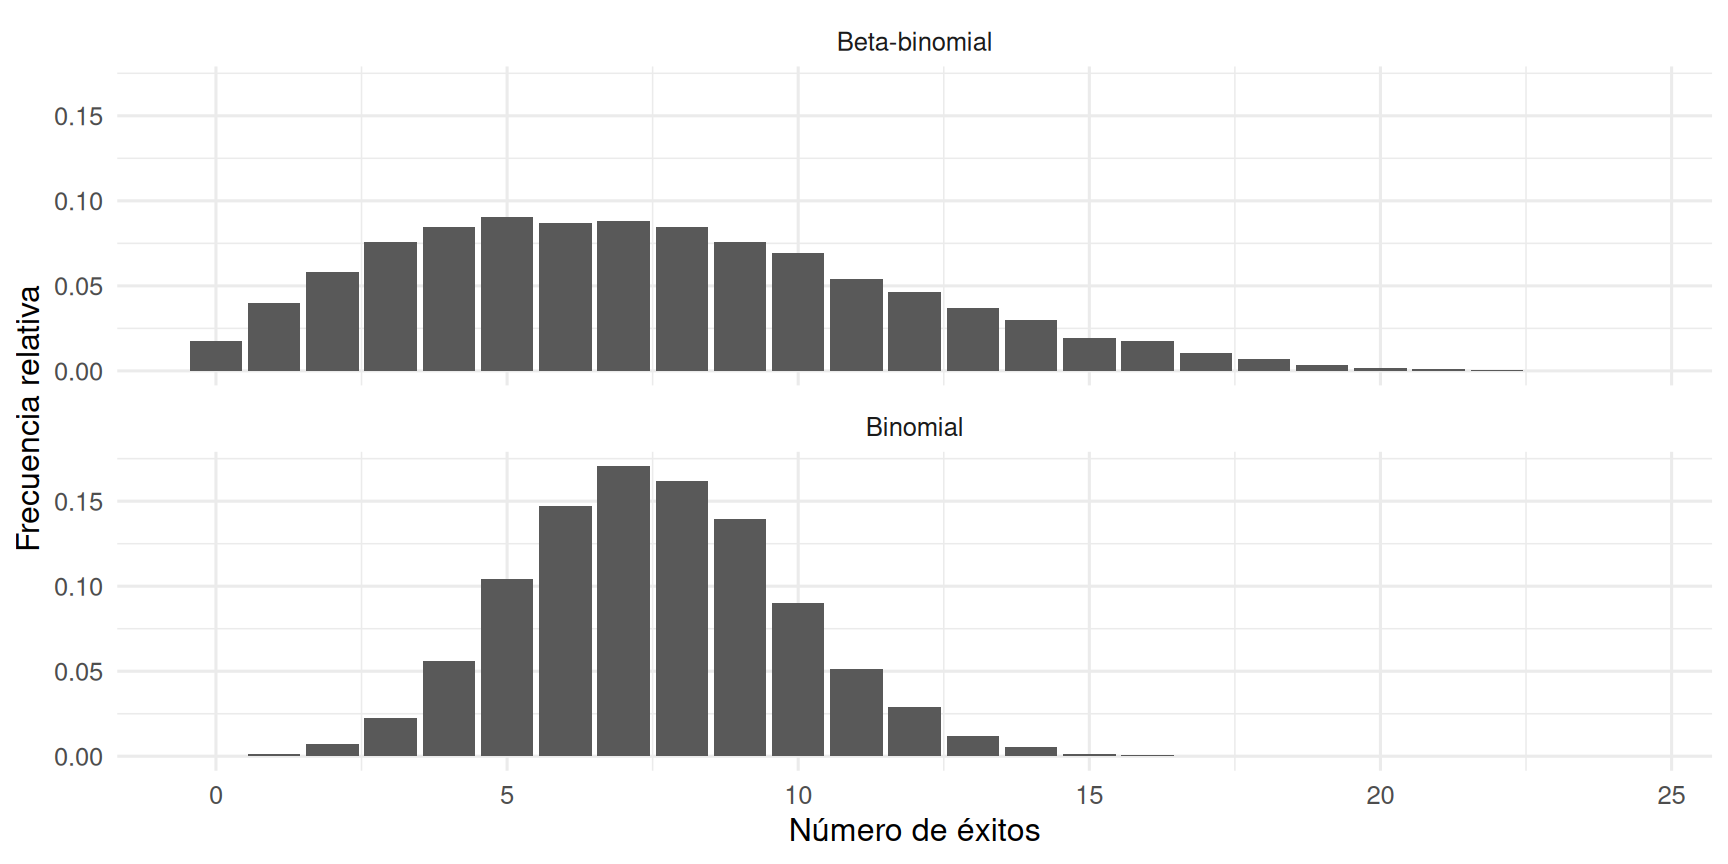
10.9.2 Comparación previa de dispersión binomial y beta-binomial
Primero visualizaremos la consecuencia del parámetro \(\phi\)manteniendo fija la media. Esta actividad separa el mecanismo probabilístico de cualquier algoritmo MCMC.
# A tibble: 2 × 5
  familia       media varianza prop_cero prop_total
  <chr>         <dbl>    <dbl>     <dbl>      <dbl>
1 Beta-binomial  7.43    17.5  0.0177             0
2 Binomial       7.53     5.29 0.0000833          0
comparacion_bb_s10 |>count(familia, y) |>group_by(familia) |>mutate(frecuencia_rel = n /sum(n)) |>ggplot(aes(x = y, y = frecuencia_rel)) +geom_col() +facet_wrap(~familia, ncol =1) +labs(x ="Número de éxitos", y ="Frecuencia relativa") +theme_minimal(base_size =12)
Figura 10.2: Distribución de conteos de éxitos con igual media y denominador, bajo una binomial y una beta-binomial.
A partir de Ecuación 10.5 el factor de inflación teórico, con \(n=25\) y \(\phi=9\), es \((25+9)/(9+1)\). Lo relevante es que la media se conserva: el cambio de familia altera la distribución de éxitos alrededor de esa media, no la interpretación de \(\mu\).
10.9.3 Especificar y ajustar ambos modelos
Usaremos la misma estructura de regresión multinivel y las mismas previas para los parámetros compartidos. Solo la beta-binomial incorpora un parámetro adicional \(\phi\).
formula_binom_s10 <- brms::bf(y |trials(n) ~1+ x + (1| grupo))prior_base_binom_s10 <-c( brms::prior(normal(-0.85, 0.8), class ="Intercept"), brms::prior(normal(0, 0.8), class ="b"), brms::prior(exponential(2), class ="sd"))prior_bb_s10 <-c( prior_base_binom_s10, brms::prior(gamma(2, 0.2), class ="phi"))brms::get_prior( formula_binom_s10, data = datos_bb_s10,family = brms::beta_binomial(link ="logit"))
                prior     class      coef group resp dpar nlpar lb ub tag
               (flat)         b
               (flat)         b         x
 student_t(3, 0, 2.5) Intercept
    gamma(0.01, 0.01)       phi                                  0
 student_t(3, 0, 2.5)        sd                                  0
 student_t(3, 0, 2.5)        sd           grupo                  0
 student_t(3, 0, 2.5)        sd Intercept grupo                  0
       source
      default
 (vectorized)
      default
      default
      default
 (vectorized)
 (vectorized)
Antes del ajuste comprobaremos la gama de proporciones generadas por las distribuciones previas. La siguiente es una simulación independiente de la especificación probabilística, no una extracción de parámetros de brms (que centra internamente los predictores para parametrizar su intercepto). Dado que x se simuló cerca de cero, resulta una comprobación pedagógica útil de las escalas elegidas.
Estas estadísticas permiten identificar previas que produzcan con demasiada frecuencia únicamente proporciones extremas o que prácticamente excluyan respuestas próximas a 0 o 1. Como se examinan antes de condicionar en los datos, la pregunta es si la diversidad de patrones es sustantivamente razonable, no si coincide exactamente con el conjunto simulado que vamos a analizar.
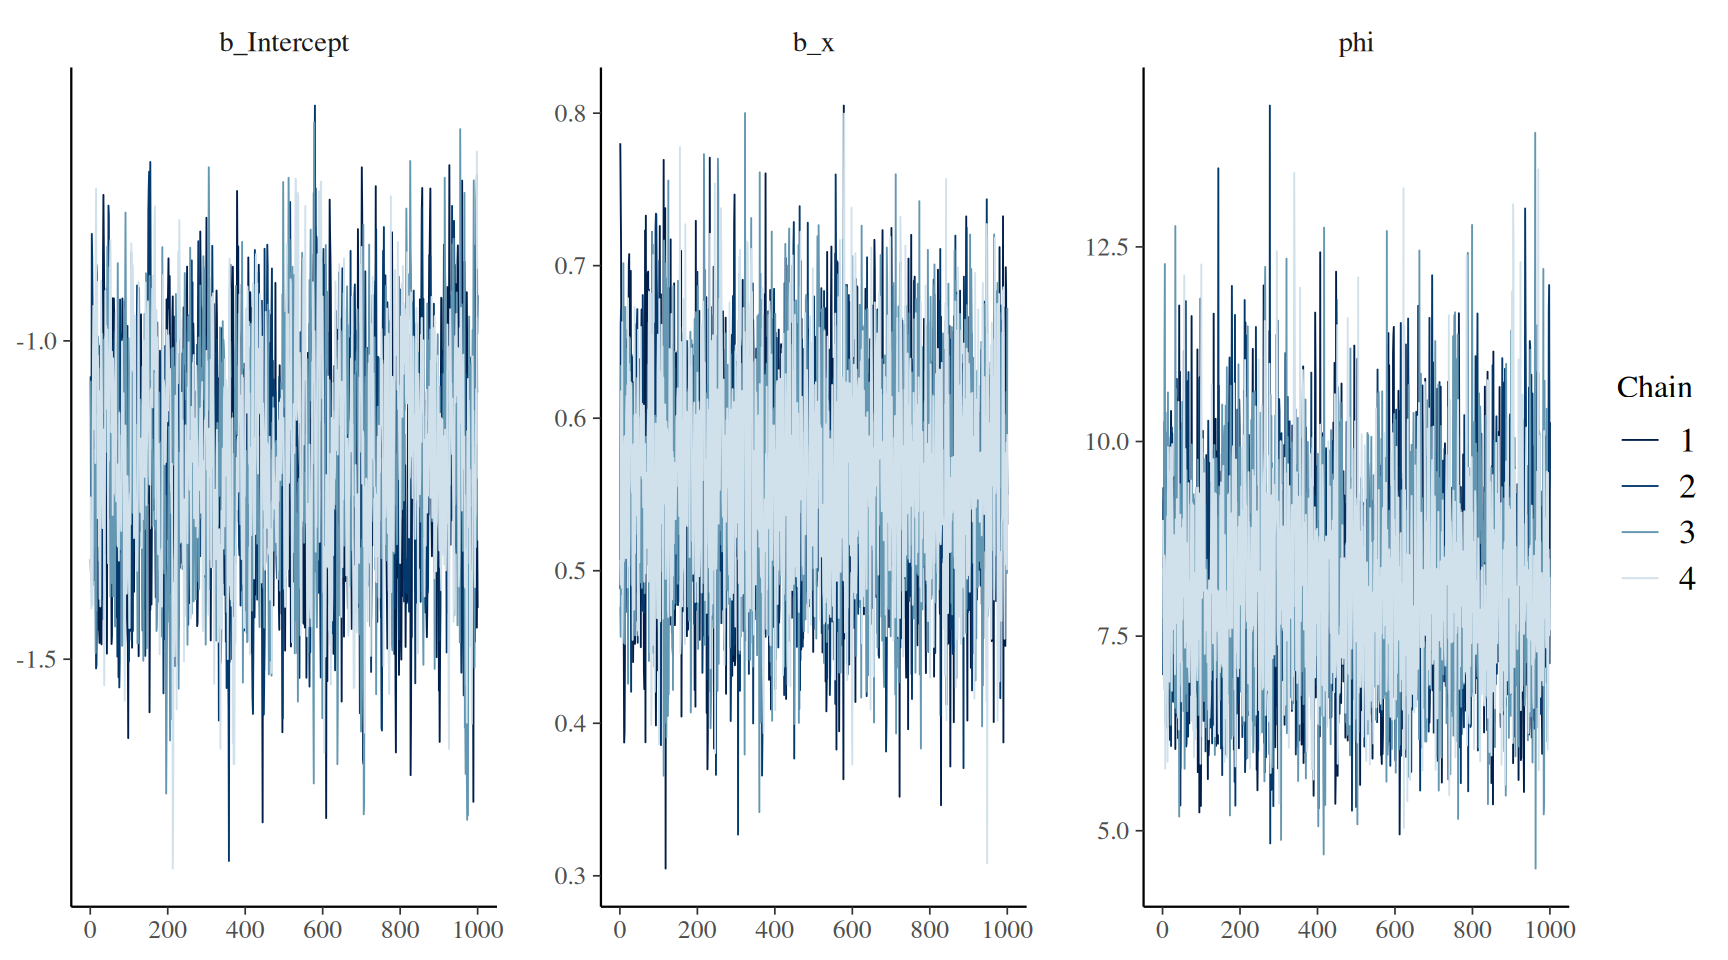
Figura 10.3: Trazas de parámetros seleccionados del modelo beta-binomial.
Criterio de lectura. Se deben investigar valores de \(\widehat R\) alejados de 1, tamaños efectivos de muestra bajos, divergencias y saturación frecuente de la profundidad máxima. Si aparecen advertencias, no debemos presentar estimaciones como confiables solo porque brm() terminó; hay que localizar la dificultad y reconsiderar escalas, previas, identificación o parametrización (Gelman et al. 2026, chaps. 11-12).
La cantidad \(1/(\phi+1)\) resume la dependencia inducida entre ensayos dentro de cada observación. Su posterior puede derivarse de las simulaciones sin refitar otro modelo:
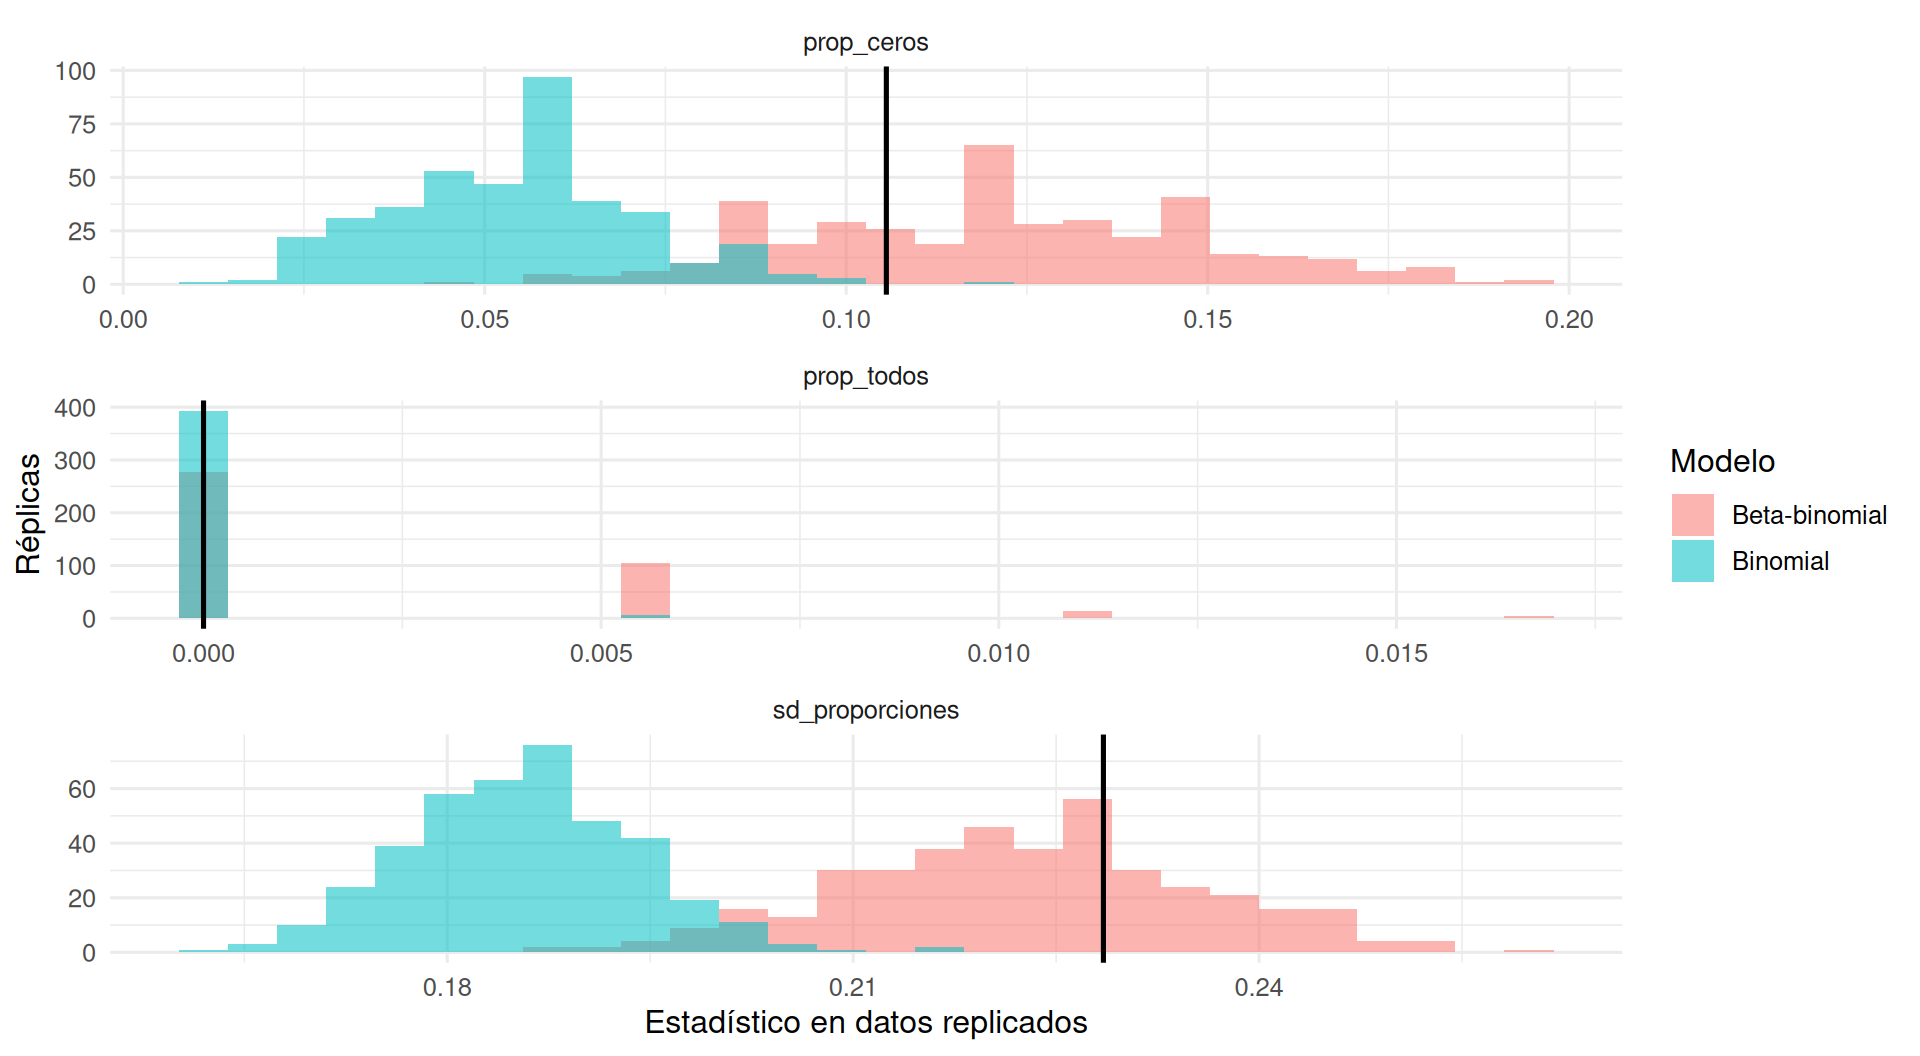
Un histograma global de éxitos mezcla observaciones con denominadores muy diferentes; por ello examinaremos proporciones, extremos y agrupaciones. También analizaremos la variabilidad condicional reproduciendo exactamente los valores de \(n\), \(x\) y grupo utilizados en el ajuste.
ppc_both_s10 |>left_join(obs_bb_s10, by ="estadistico") |>ggplot(aes(x = valor, fill = modelo)) +geom_histogram(bins =28, alpha =0.55, position ="identity") +geom_vline(aes(xintercept = valor_obs),color ="black", linewidth =0.9) +facet_wrap(~estadistico, scales ="free", ncol =1) +labs(x ="Estadístico en datos replicados", y ="Réplicas", fill ="Modelo") +theme_minimal(base_size =12)
Figura 10.4: Comprobaciones predictivas del grado de variación de las proporciones y de los extremos. La línea vertical representa el estadístico observado.
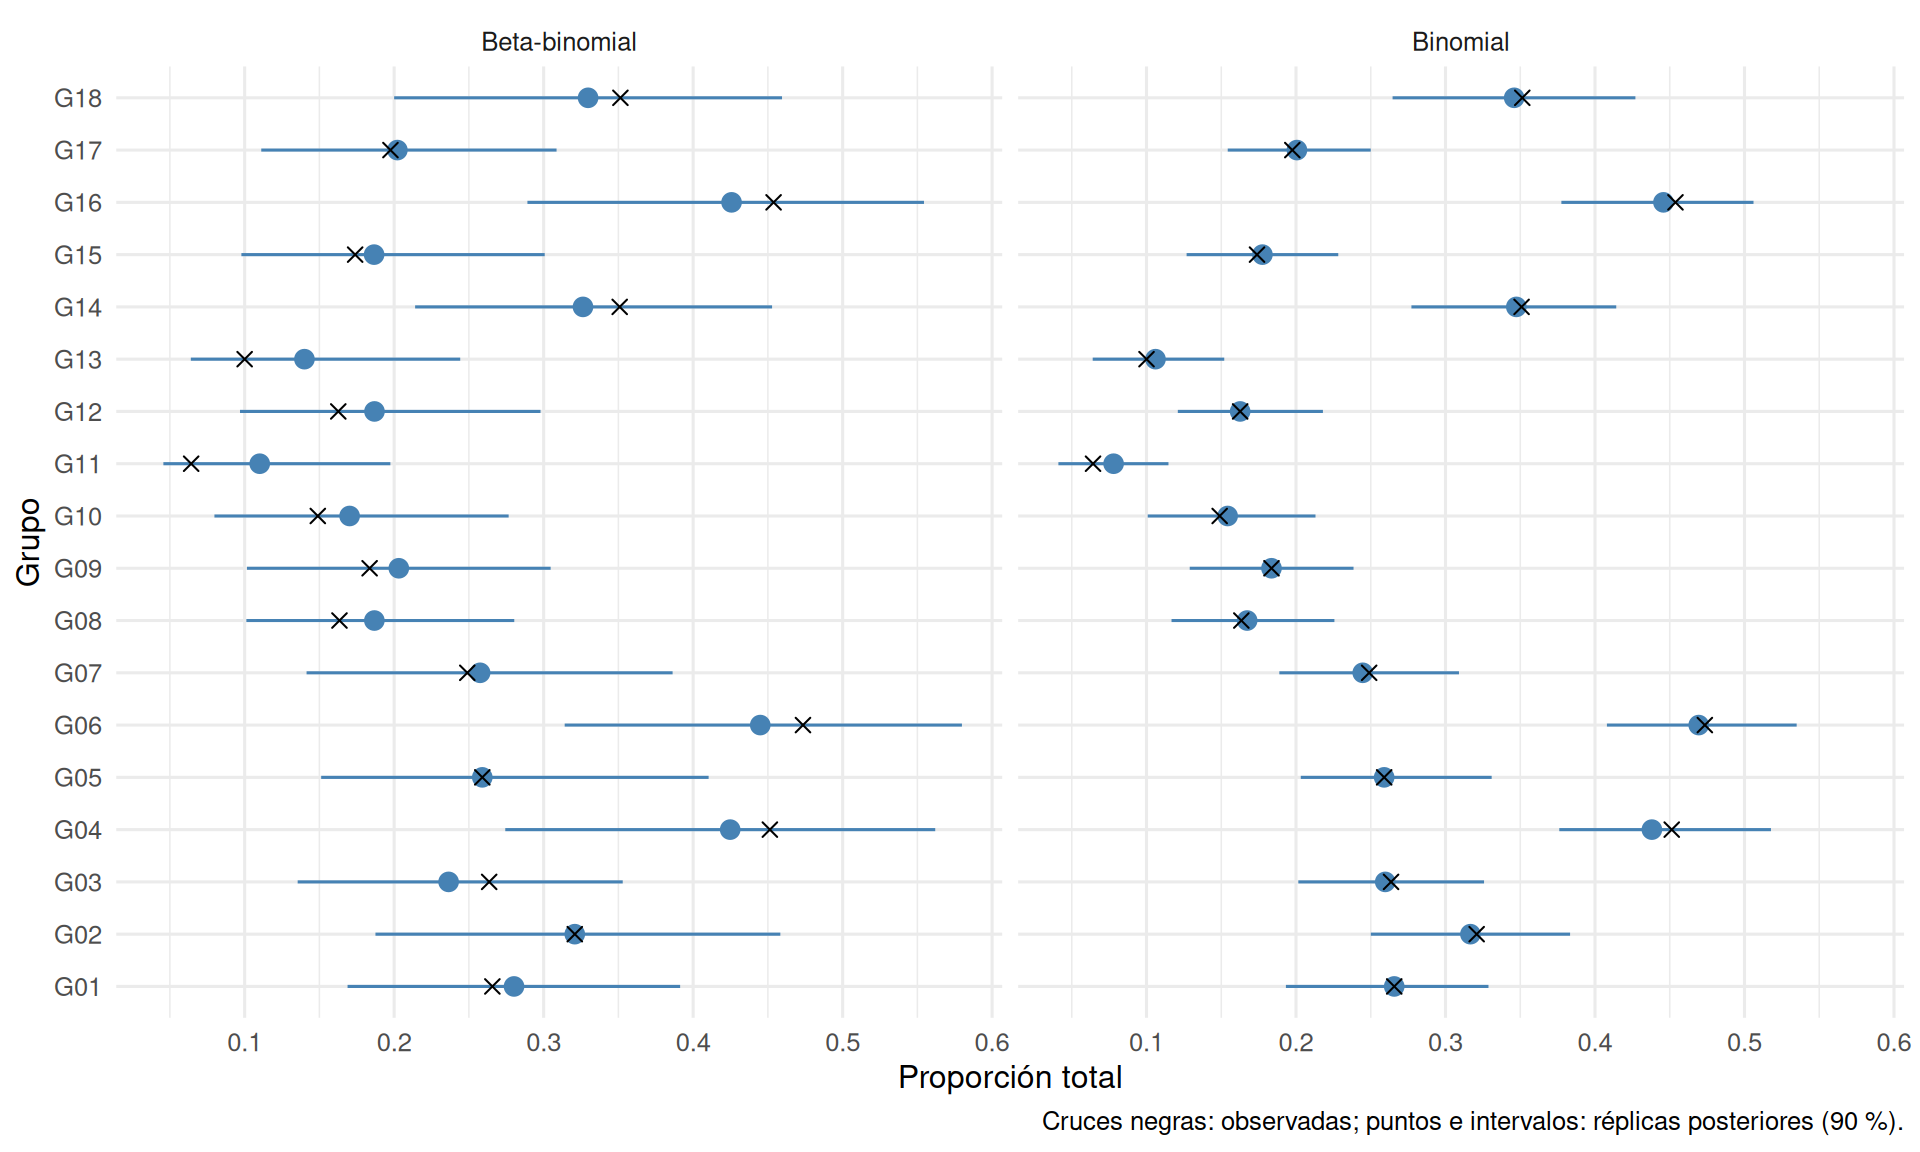
Para comprobar la capacidad de reproducir diferencias entre grupos, resumimos éxitos/ensayos para cada grupo en cada réplica. El objetivo es ver en qué grupos fallan las predicciones, no solamente cuál familia tiene un estadístico agregado más cercano.
grupos_s10 <-levels(datos_bb_s10$grupo)indices_grupo_s10 <-split(seq_len(nrow(datos_bb_s10)), datos_bb_s10$grupo)agrupar_replicas_s10 <-function(yrep, datos) {t(vapply(indices_grupo_s10, function(ii) {rowSums(yrep[, ii, drop =FALSE]) /sum(datos$n[ii]) }, numeric(nrow(yrep))))}# La matriz resultante tiene una fila por grupo y una columna por réplica.ppc_grupos_binom_s10 <-agrupar_replicas_s10(yrep_binom_s10, datos_bb_s10)ppc_grupos_bb_s10 <-agrupar_replicas_s10(yrep_bb_s10, datos_bb_s10)resumen_grupos_s10 <-function(mat, nombre) {tibble(grupo =factor(rownames(mat), levels = grupos_s10),modelo = nombre,mediana =apply(mat, 1, median),l90 =apply(mat, 1, quantile, probs =0.05),u90 =apply(mat, 1, quantile, probs =0.95) )}p_grupos_s10 <-bind_rows(resumen_grupos_s10(ppc_grupos_binom_s10, "Binomial"),resumen_grupos_s10(ppc_grupos_bb_s10, "Beta-binomial"))obs_grupos_s10 <- datos_bb_s10 |>group_by(grupo) |>summarise(observada =sum(y) /sum(n), .groups ="drop")
p_grupos_s10 |>left_join(obs_grupos_s10, by ="grupo") |>ggplot(aes(x = grupo, y = mediana)) +geom_pointrange(aes(ymin = l90, ymax = u90), color ="steelblue") +geom_point(aes(y = observada), color ="black", shape =4, size =2.2) +coord_flip() +facet_wrap(~modelo, ncol =2) +labs(x ="Grupo", y ="Proporción total",caption ="Cruces negras: observadas; puntos e intervalos: réplicas posteriores (90 %).") +theme_minimal(base_size =12)
Figura 10.5: Proporciones agregadas observadas por grupo y sus distribuciones predictivas posteriores bajo ambas familias.
10.9.6 Predicción binomial: observaciones futuras
Para un grupo existente podemos condicionar en su \(u_j\) posterior; para un grupo nuevo debemos integrar su variación. La diferencia entre las dos familias se apreciará especialmente en posterior_predict() (observaciones futuras), mientras que posterior_epred() representa el número esperado de éxitos \(n\mu\) y por ello no incorpora toda la variabilidad beta-binomial de nuevos conteos.
# A tibble: 2 × 5
  perfil          media_esperada mediana_y_nueva limite_05 limite_95
  <chr>                    <dbl>           <dbl>     <dbl>     <dbl>
1 Grupo observado           5.26               5         0        12
2 Grupo nuevo               5.06               4         0        13
10.10 Laboratorio 2: modelo ordinal con medidas repetidas
10.10.1 Aplicación: claridad de instrucciones de inhaladores
El artículo de Bürkner (Bürkner 2017, sec. 4.8, pp. 15-16) presenta el conjunto inhaler: un estudio cruzado con dos tratamientos y dos períodos en 286 pacientes con asma. Se registró, para cada dispositivo, una valoración ordinal de cuatro niveles sobre la claridad de las instrucciones del folleto; el conjunto de datos del artículo incluye 572 registros. Los predictores treat, period y carry recogen tratamiento, período y posible efecto de arrastre, respectivamente. Trabajaremos con la estructura original y un intercepto variable por paciente. La existencia de dos respuestas por paciente es precisamente la fuente de dependencia que interesa modelar.
El objetivo no es estimar un efecto clínico de la medicación: la variable de respuesta evalúa instrucciones, no síntomas ni eficacia terapéutica. Tampoco afirmaremos que un contraste de tratamiento constituye un efecto causal sin revisar los supuestos del diseño cruzado, especialmente el arrastre entre períodos.
10.10.2 Preparación y validación de los datos
data("inhaler", package ="brms")columnas_s10 <-c("subject", "rating", "treat", "period", "carry")if (!all(columnas_s10 %in%names(inhaler))) {stop("Cambió la estructura de brms::inhaler; revisar nombres de columnas.")}niveles_ordinales_s10 <-sort(unique(as.character(inhaler$rating)))if (length(niveles_ordinales_s10) !=4L) {stop("Se esperaban cuatro categorías ordinales en inhaler.")}inhaler_s10 <-as_tibble(inhaler) |>transmute(subject =factor(as.character(subject)),rating_ord =ordered(as.character(rating),levels = niveles_ordinales_s10),treat =as.numeric(treat),period =as.numeric(period),carry =as.numeric(carry) ) |>mutate(rating_num =as.integer(rating_ord))if (anyNA(inhaler_s10)) {stop("Hay datos faltantes o fallas de conversión en inhaler.")}if (any(!is.finite(as.matrix(select(inhaler_s10, treat, period, carry))))) {stop("Los predictores deben ser finitos.")}if (n_distinct(inhaler_s10$treat) !=2L) {stop("Se esperaban dos valores de tratamiento.")}inhaler_s10 |>summarise(observaciones =n(),pacientes =n_distinct(subject),categorias =n_distinct(rating_ord),min_por_paciente =min(as.integer(table(subject))),max_por_paciente =max(as.integer(table(subject))) )
La conversión a ordered es deliberada. No utilizaremos el número asignado a cada nivel como una distancia continua dentro del modelo ordinal. Los valores originales de treat, period y carry se mantienen sin recodificar, de modo que los coeficientes correspondan a la codificación del conjunto de datos y puedan verificarse al interpretarlos.
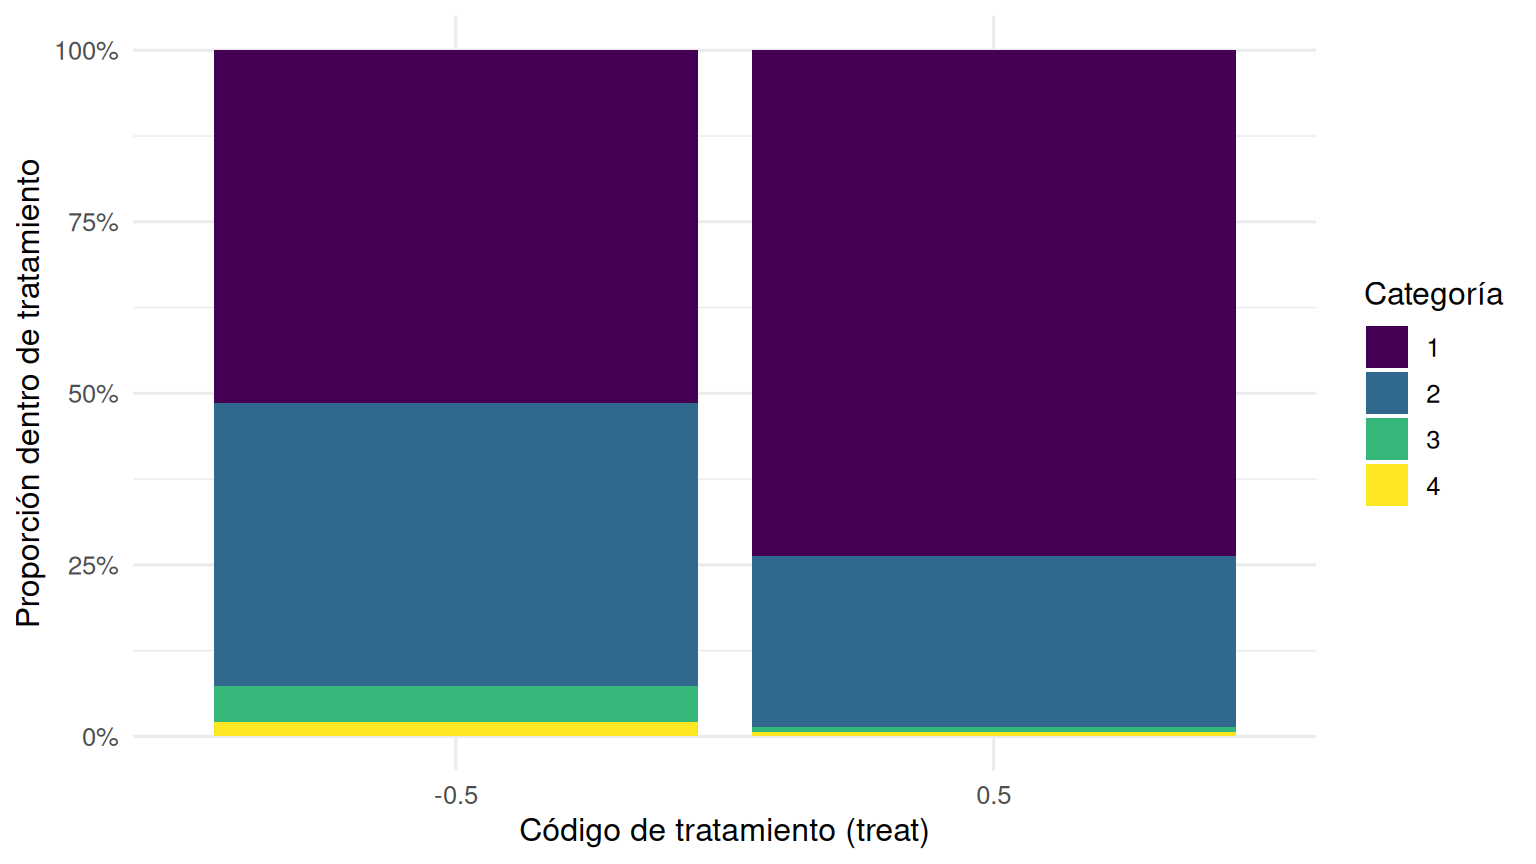
inhaler_s10 |>count(rating_ord, treat) |>group_by(treat) |>mutate(proporcion = n /sum(n)) |>ungroup()
inhaler_s10 |>count(treat, rating_ord) |>group_by(treat) |>mutate(prop = n /sum(n)) |>ungroup() |>ggplot(aes(x =factor(treat), y = prop, fill = rating_ord)) +geom_col(position ="fill") +scale_y_continuous(labels = scales::label_percent()) +labs(x ="Código de tratamiento (treat)",y ="Proporción dentro de tratamiento", fill ="Categoría") +theme_minimal(base_size =12)
Figura 10.6: Distribución observada de las cuatro categorías de claridad de instrucciones, por nivel de la variable de tratamiento.
Las barras describen los datos marginales, pero no representan el ajuste para período y arrastre ni la dependencia dentro de paciente. La interpretación posterior deberá utilizar el modelo completo.
10.10.3 Una visualización previa de umbrales y probabilidades
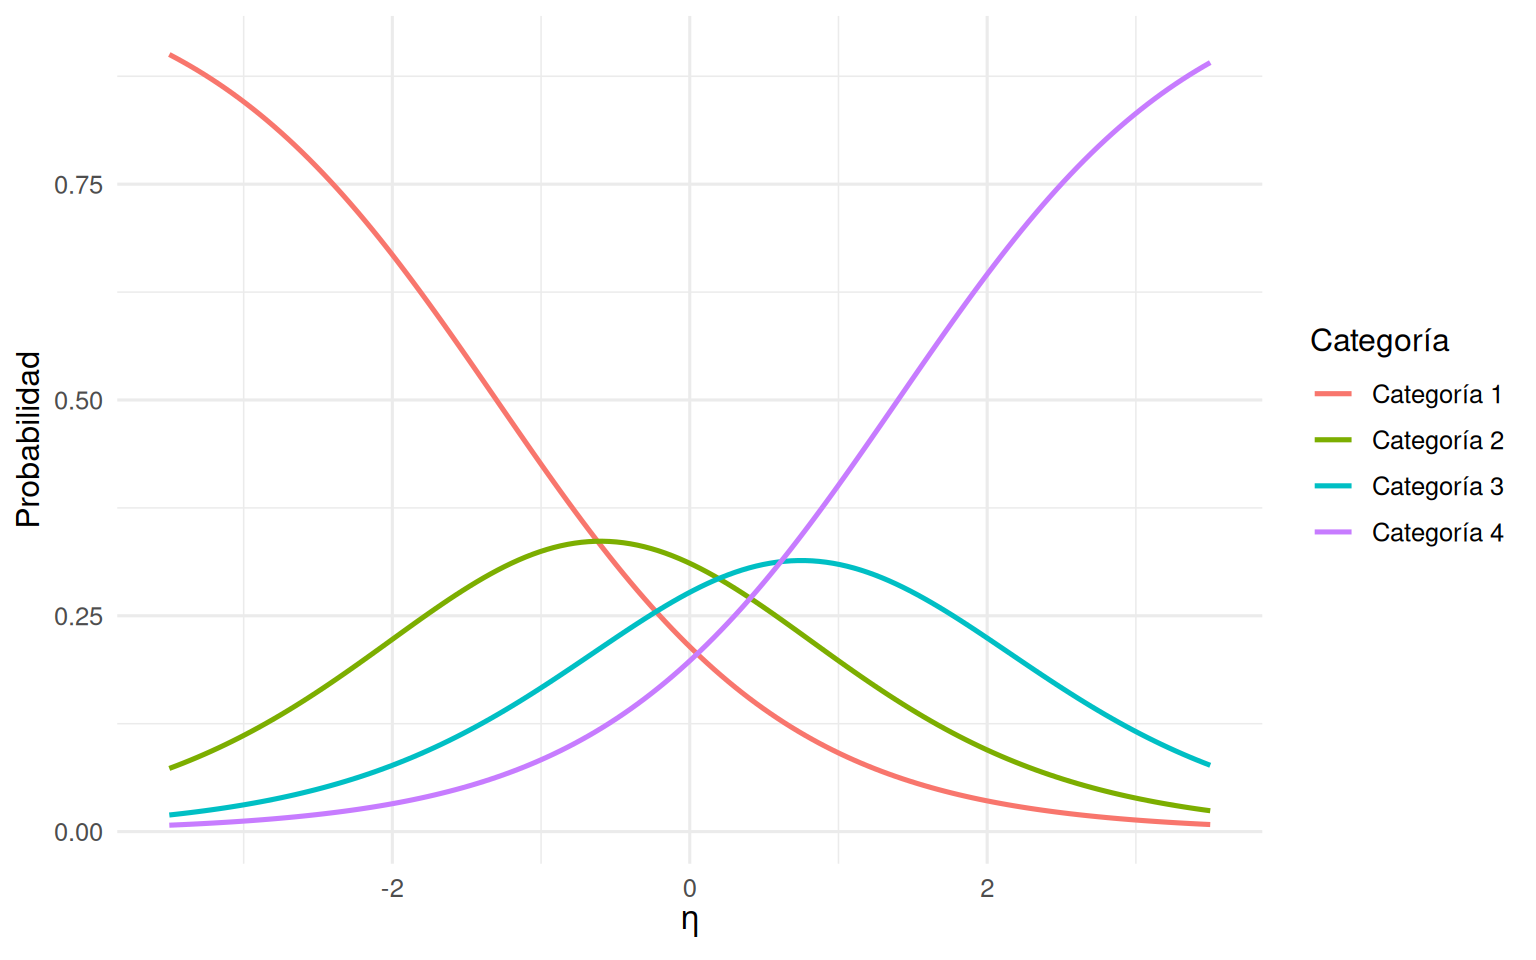
Para ver cómo funciona un modelo ordinal antes de ajustarlo, fijaremos provisionalmente los umbrales \((-1.3,0.1,1.4)\) y calcularemos las cuatro probabilidades para diferentes valores de \(\eta\). Estos valores son ilustrativos, no estimaciones del estudio.
prob_ordinal_s10 <-function(eta, cortes) {stopifnot(all(diff(cortes) >0)) cum <-plogis(outer(eta, cortes, function(a, b) b - a)) K <-length(cortes) +1L res <-matrix(0, nrow =length(eta), ncol = K) res[, 1] <- cum[, 1]if (K >2L) {for (k in2:(K -1L)) res[, k] <- cum[, k] - cum[, k -1L] } res[, K] <-1- cum[, K -1L]colnames(res) <-paste0("Categoría ", seq_len(K)) res}eta_ejemplo_s10 <-seq(-3.5, 3.5, length.out =150)curvas_ordinales_s10 <-prob_ordinal_s10( eta_ejemplo_s10, c(-1.3, 0.1, 1.4))stopifnot(max(abs(rowSums(curvas_ordinales_s10) -1)) <1e-12)
as_tibble(curvas_ordinales_s10) |>mutate(eta = eta_ejemplo_s10) |>pivot_longer(-eta, names_to ="categoria", values_to ="probabilidad") |>ggplot(aes(x = eta, y = probabilidad, color = categoria)) +geom_line(linewidth =0.9) +labs(x =expression(eta), y ="Probabilidad", color ="Categoría") +theme_minimal(base_size =12)
Figura 10.7: Probabilidades por categoría de un modelo acumulativo de cuatro niveles con umbrales fijos ilustrativos.
Nótese que las probabilidades de las categorías extremas cambian monótonamente al aumentar \(\eta\), mientras que las categorías intermedias pueden primero aumentar y luego disminuir. No es correcto traducir una pendiente del predictor en «el mismo aumento de probabilidad en todas las categorías».
Los tres umbrales \(c_1<c_2<c_3\) son compartidos por los pacientes. Las tres pendientes son poblacionales; el desplazamiento \(u_j\) representa heterogeneidad entre pacientes. Por ahora no incluiremos pendientes variables: cada paciente proporciona dos observaciones y esa estructura limita la información para identificar muchas características específicas por paciente.
Las previas para los tres coeficientes se centrarán en cero y las de los umbrales permitirán diferentes composiciones de categorías. Para la variación entre personas adoptaremos una previa exponencial que favorece escalas moderadas sin excluir heterogeneidad.
formula_ord_s10 <- brms::bf( rating_ord ~1+ treat + period + carry + (1| subject))priors_ord_s10 <-c( brms::prior(normal(0, 1.5), class ="Intercept"), brms::prior(normal(0, 0.8), class ="b"), brms::prior(exponential(2), class ="sd"))brms::get_prior(formula = formula_ord_s10,data = inhaler_s10,family = brms::cumulative(link ="logit"))
                prior     class      coef   group resp dpar nlpar lb ub tag
               (flat)         b
               (flat)         b     carry
               (flat)         b    period
               (flat)         b     treat
 student_t(3, 0, 2.5) Intercept
 student_t(3, 0, 2.5) Intercept         1
 student_t(3, 0, 2.5) Intercept         2
 student_t(3, 0, 2.5) Intercept         3
 student_t(3, 0, 2.5)        sd                                    0
 student_t(3, 0, 2.5)        sd           subject                  0
 student_t(3, 0, 2.5)        sd Intercept subject                  0
       source
      default
 (vectorized)
 (vectorized)
 (vectorized)
      default
 (vectorized)
 (vectorized)
 (vectorized)
      default
 (vectorized)
 (vectorized)
NotaIntercept en cumulative no es el intercepto de una regresión normal
En una familia cumulative, las entradas Intercept[1], Intercept[2], … corresponden a los umbrales ordenados. En esta formulación no añadimos a ellos otro parámetro global \(\alpha\). El término (1 | subject) sí introduce los desplazamientos individuales de media poblacional cero. Verificaremos la parametrización real con get_prior() antes de ajustar.
10.10.5 Comprobación predictiva previa con brms
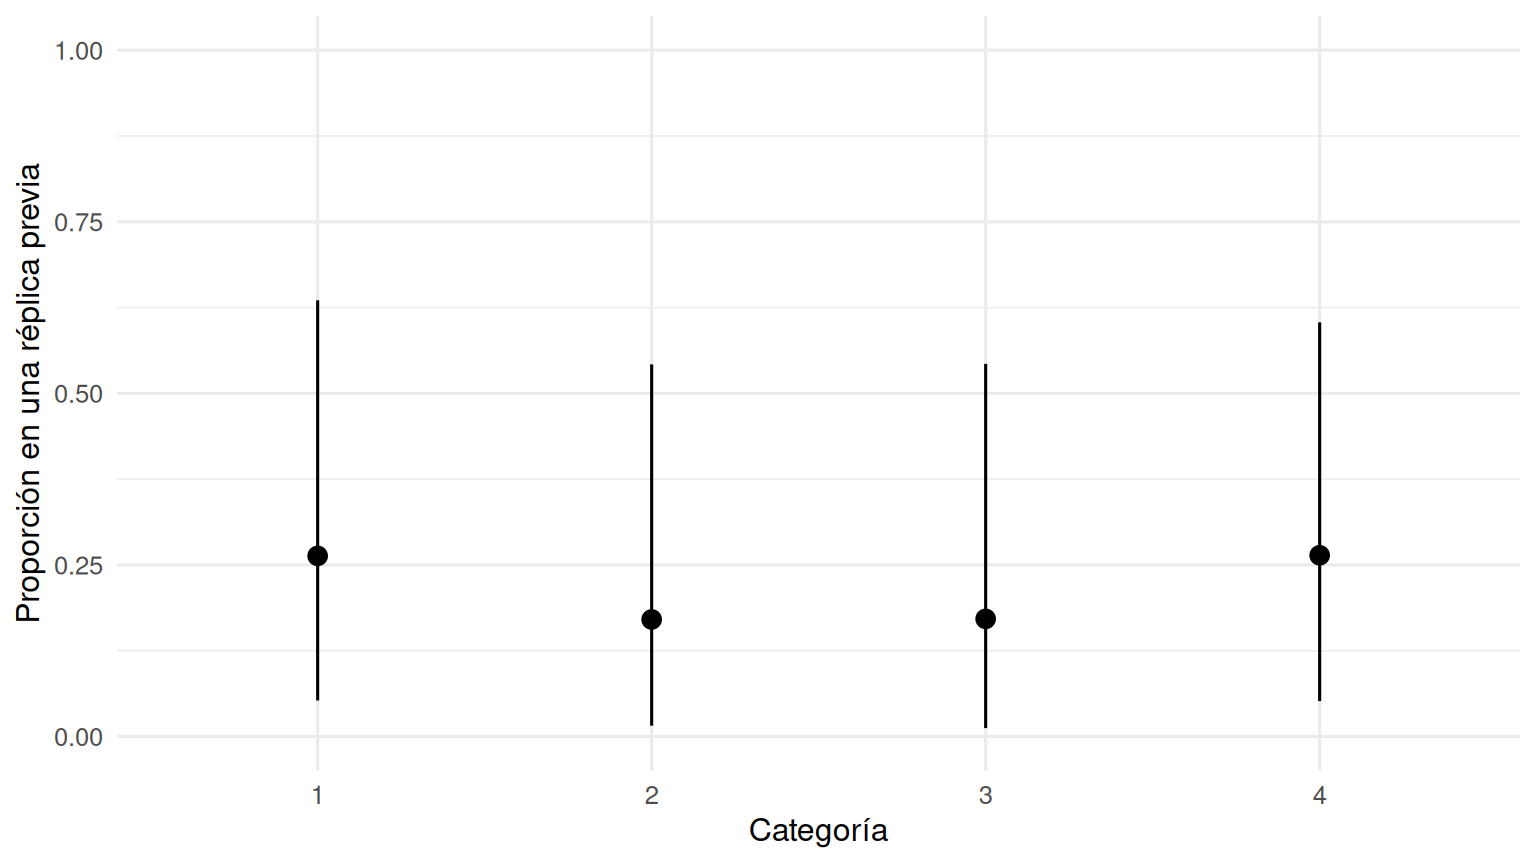
Para observar las consecuencias de las previas antes de usar la verosimilitud de los datos, ajustaremos un objeto de simulación con sample_prior = "only". Esto utiliza Stan para generar parámetros desde la previa y respuestas replicadas desde el modelo especificado.
resumen_prior_cat_s10 |>ggplot(aes(x = categoria, y = mediana)) +geom_pointrange(aes(ymin = l90, ymax = u90)) +coord_cartesian(ylim =c(0, 1)) +labs(x ="Categoría", y ="Proporción en una réplica previa") +theme_minimal(base_size =12)
Figura 10.8: Distribución predictiva previa de proporciones de categoría en los registros del diseño de inhaladores. Intervalos centrales del 90 %.
La previa predictiva reproduce el esquema de observaciones y de agrupamiento del estudio, pero no utiliza las valoraciones observadas para ajustar parámetros. Si sugiere que casi siempre se producirá una sola categoría o composiciones imposibles para el problema, debemos reconsiderar la escala de los umbrales, coeficientes y componentes grupales.
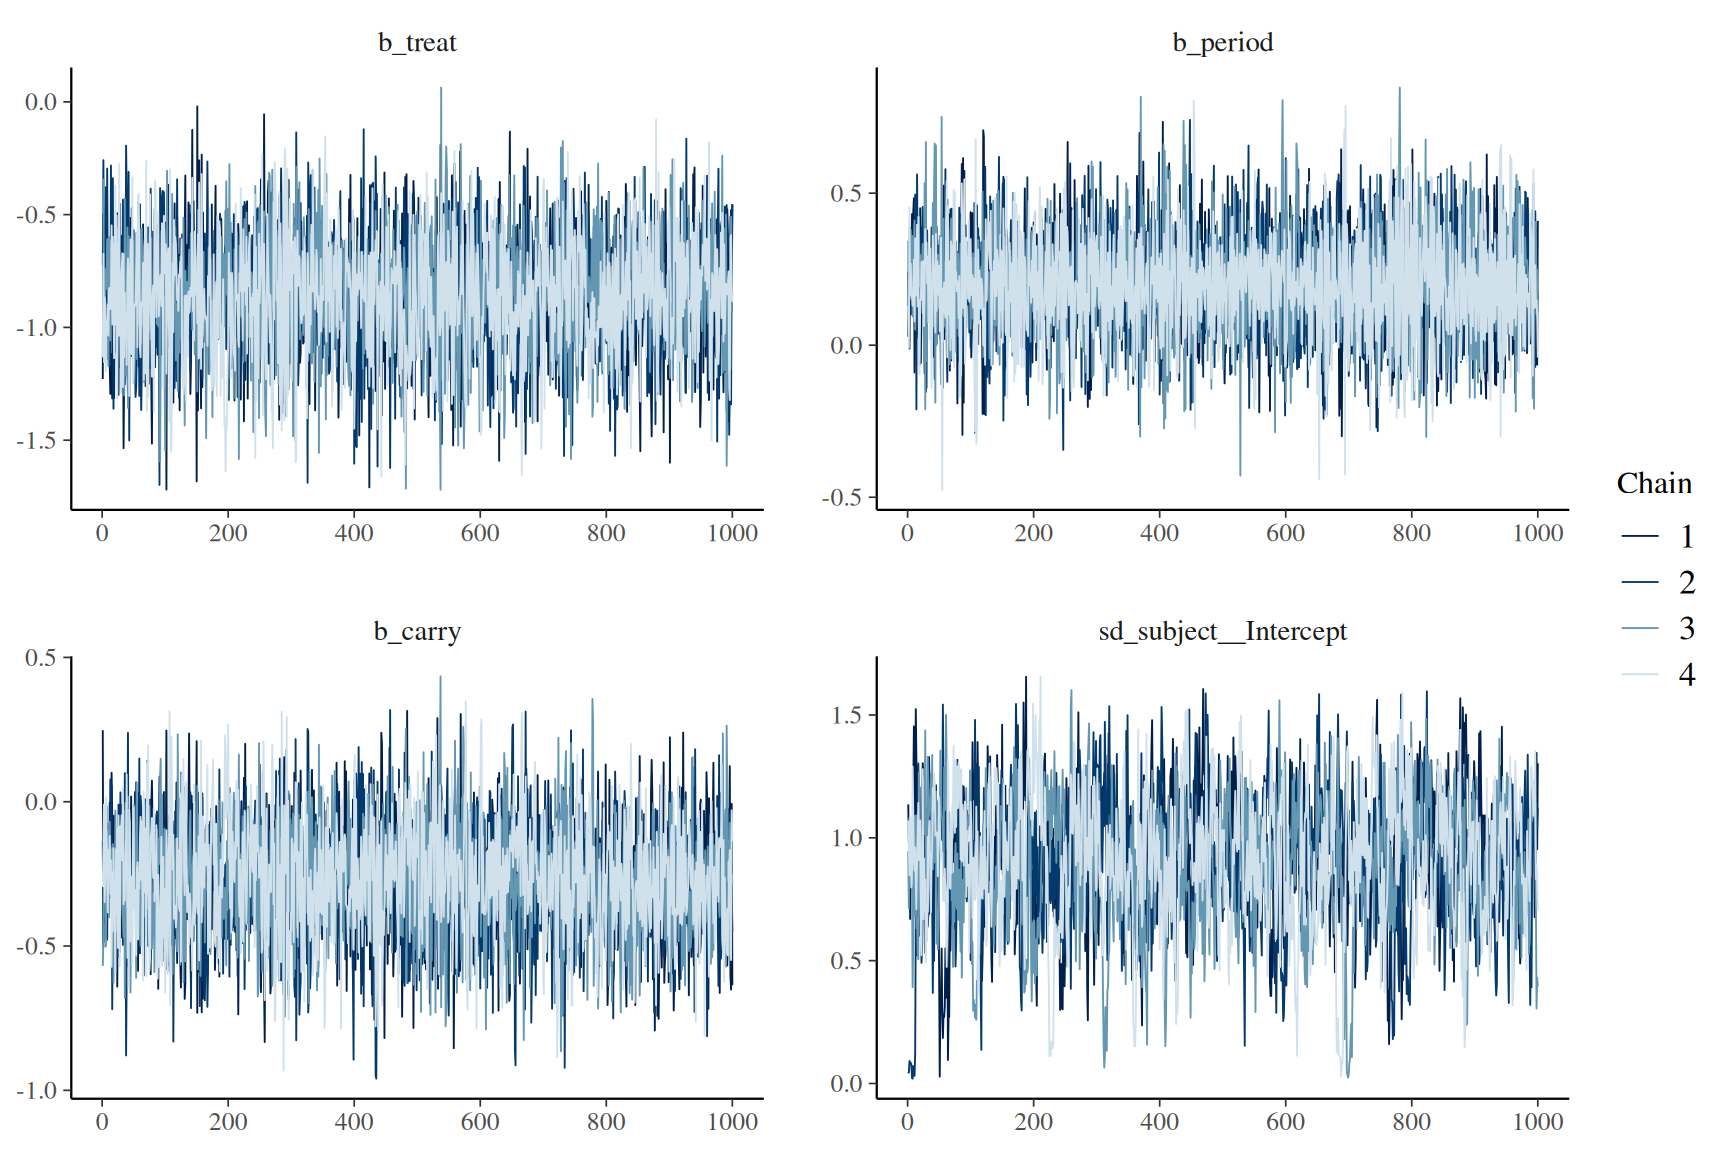
Figura 10.9: Trazas de las pendientes y la heterogeneidad grupal del modelo ordinal.
Si estas comprobaciones no son satisfactorias, no seguiremos con interpretaciones sustantivas sin investigar la causa. También debemos considerar posibles dificultades de identificación de umbrales cuando alguna categoría es poco frecuente y de desviaciones grupales cuando existen pocas observaciones por sujeto. La ausencia de divergencias no demuestra que el supuesto ordinal sea correcto.
10.10.8 Interpretar coeficientes y umbrales
El coeficiente de treat describe una diferencia de log-odds de estar por encima de cada umbral, por una unidad de la codificación original de treat, manteniendo constantes período, arrastre y el coeficiente específico del paciente. Si la codificación pasa de \(-0.5\) a \(+0.5\), esa diferencia es una unidad y el odds ratio condicional es \(\exp(\beta_T)\). De todos modos, reportaremos también diferencias de probabilidades de categorías concretas.
Los resultados del modelo ordinal multinivel muestran que el tratamiento presenta la asociación más claramente identificada con la respuesta ordinal. Manteniendo constantes el período, el arrastre y el intercepto individual, un incremento unitario en la codificación del tratamiento se asocia con una reducción aproximada del 57.3 % en las odds de ubicarse por encima de cualquier umbral de la respuesta (OR = 0.427; intervalo de credibilidad del 90 %: [0.270, 0.646]). Esto indica una mayor concentración de probabilidad en las categorías inferiores para el valor más alto de la codificación del tratamiento. Por su parte, el período presenta una asociación positiva con las categorías superiores (OR = 1.22; intervalo del 90 %: [0.907, 1.64]), mientras que el arrastre presenta una asociación negativa (OR = 0.763; intervalo del 90 %: [0.541, 1.06]). Sin embargo, en ambos casos los intervalos incluyen el valor 1, por lo que la evidencia sobre la dirección de estas asociaciones es menos concluyente. Es importante recordar que estos odds ratios son condicionales a los efectos individuales y, bajo el supuesto de odds proporcionales, se mantienen constantes a través de los umbrales. No representan cambios porcentuales directos en las probabilidades de cada categoría ni, por sí solos, establecen relaciones causales.
10.10.9 Probabilidades posteriores para dos niveles de tratamiento
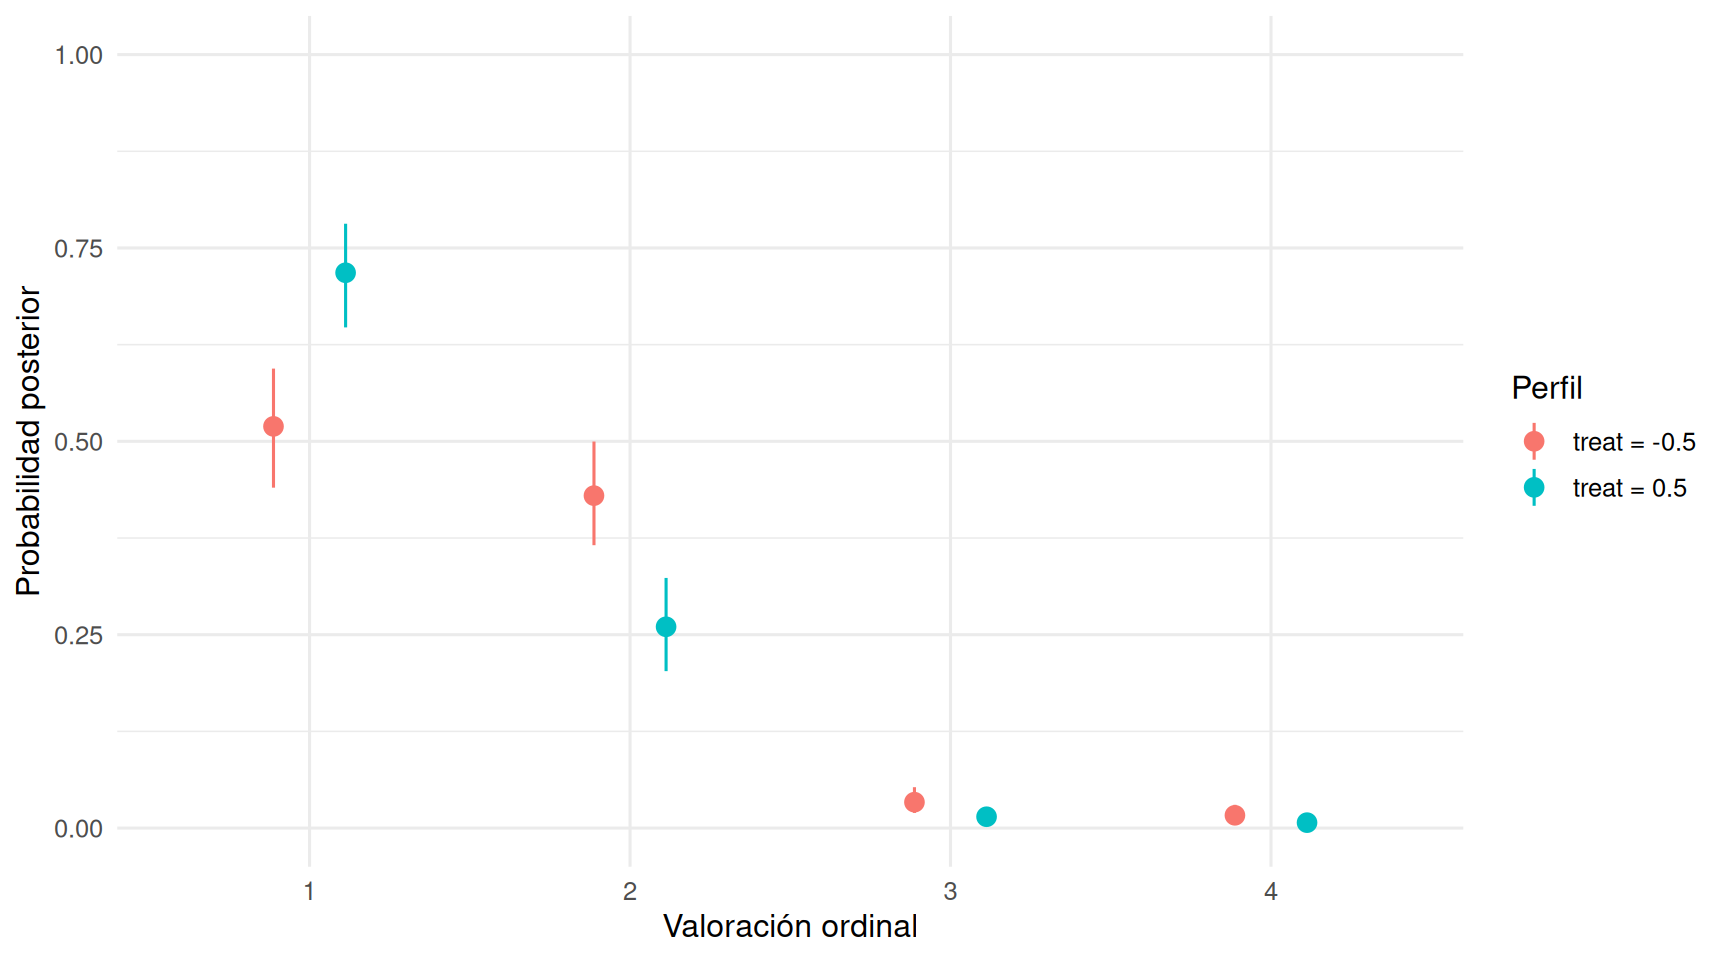
Construiremos predicciones para dos perfiles con período y arrastre fijados en una combinación observada bajo ambos códigos de tratamiento, para respetar el diseño cruzado. Usaremos re_formula = NA para fijar \(u_j=0\), lo cual describe la localización poblacional en la escala latente, no la media marginal sobre todos los pacientes. Más adelante realizaremos la marginalización relevante para un paciente nuevo.
valores_tratamiento_s10 <-sort(unique(inhaler_s10$treat))# Seleccionar una combinación período-arrastre observada con ambos códigos# de tratamiento, evitando extrapolar a celdas estructuralmente imposibles.pares_diseno_s10 <- inhaler_s10 |>distinct(treat, period, carry) |>group_by(period, carry) |>summarise(n_tratamientos =n_distinct(treat), .groups ="drop") |>filter(n_tratamientos ==length(valores_tratamiento_s10)) |>arrange(period, carry)if (nrow(pares_diseno_s10) ==0L) {stop("No hay un perfil común de período y arrastre para ambos tratamientos.")}periodo_ref_s10 <- pares_diseno_s10$period[1]carry_ref_s10 <- pares_diseno_s10$carry[1]paciente_ref_s10 <-levels(inhaler_s10$subject)[1]perfiles_ord_s10 <-tibble(treat = valores_tratamiento_s10,period = periodo_ref_s10,carry = carry_ref_s10,subject =factor(rep(paciente_ref_s10, length(valores_tratamiento_s10)),levels =levels(inhaler_s10$subject)))set.seed(16531023)prob_centro_s10 <-posterior_epred( fit_ord_s10, newdata = perfiles_ord_s10,re_formula =NA, ndraws =1000)stopifnot(length(dim(prob_centro_s10)) ==3L,dim(prob_centro_s10)[2] ==nrow(perfiles_ord_s10),dim(prob_centro_s10)[3] == K_ord_s10)resumir_prob_ord_s10 <-function(prob, perfiles, etiqueta) {bind_rows(lapply(seq_len(dim(prob)[2]), function(i) {bind_rows(lapply(seq_len(dim(prob)[3]), function(k) { valores <- prob[, i, k]tibble(perfil =paste0("treat = ", perfiles$treat[i]),tipo_prediccion = etiqueta,categoria =factor(levels(inhaler_s10$rating_ord)[k],levels =levels(inhaler_s10$rating_ord)),mediana =median(valores),l90 =unname(quantile(valores, 0.05)),u90 =unname(quantile(valores, 0.95)) ) })) }))}resumen_centro_s10 <-resumir_prob_ord_s10( prob_centro_s10, perfiles_ord_s10, "u = 0")resumen_centro_s10
resumen_centro_s10 |>ggplot(aes(x = categoria, y = mediana, color = perfil)) +geom_pointrange(aes(ymin = l90, ymax = u90),position =position_dodge(width =0.45)) +labs(x ="Valoración ordinal", y ="Probabilidad posterior",color ="Perfil") +coord_cartesian(ylim =c(0, 1)) +theme_minimal(base_size =12)
Figura 10.10: Probabilidades posteriores de cada categoría para dos valores de tratamiento, con período y arrastre fijos y coeficiente individual igual a cero.
Cómo leer la figura. Cada intervalo expresa incertidumbre posterior acerca de la probabilidad de una categoría para un perfil bien definido. No representa variación entre todas las observaciones futuras: para generar una valoración concreta es necesario, además, simular la categoría de respuesta.
Una cantidad más directa puede ser la probabilidad de que una respuesta esté en las dos categorías más altas. Con cuatro categorías, definimos
# A tibble: 3 × 4
  cantidad                          mediana     l90     u90
  <chr>                               <dbl>   <dbl>   <dbl>
1 P(categoría >= 3), primer código   0.0506  0.0308  0.0770
2 P(categoría >= 3), segundo código  0.0223  0.0126  0.0363
3 Diferencia segundo - primero      -0.0279 -0.0494 -0.0126
La diferencia de probabilidades es interpretable sin suponer que las categorías tienen distancias equivalentes. Para comunicarla correctamente, se deben declarar el orden de las categorías, el valor de período, el supuesto sobre arrastre y el tratamiento de la heterogeneidad grupal.
10.10.10 Comprobación predictiva posterior por categoría
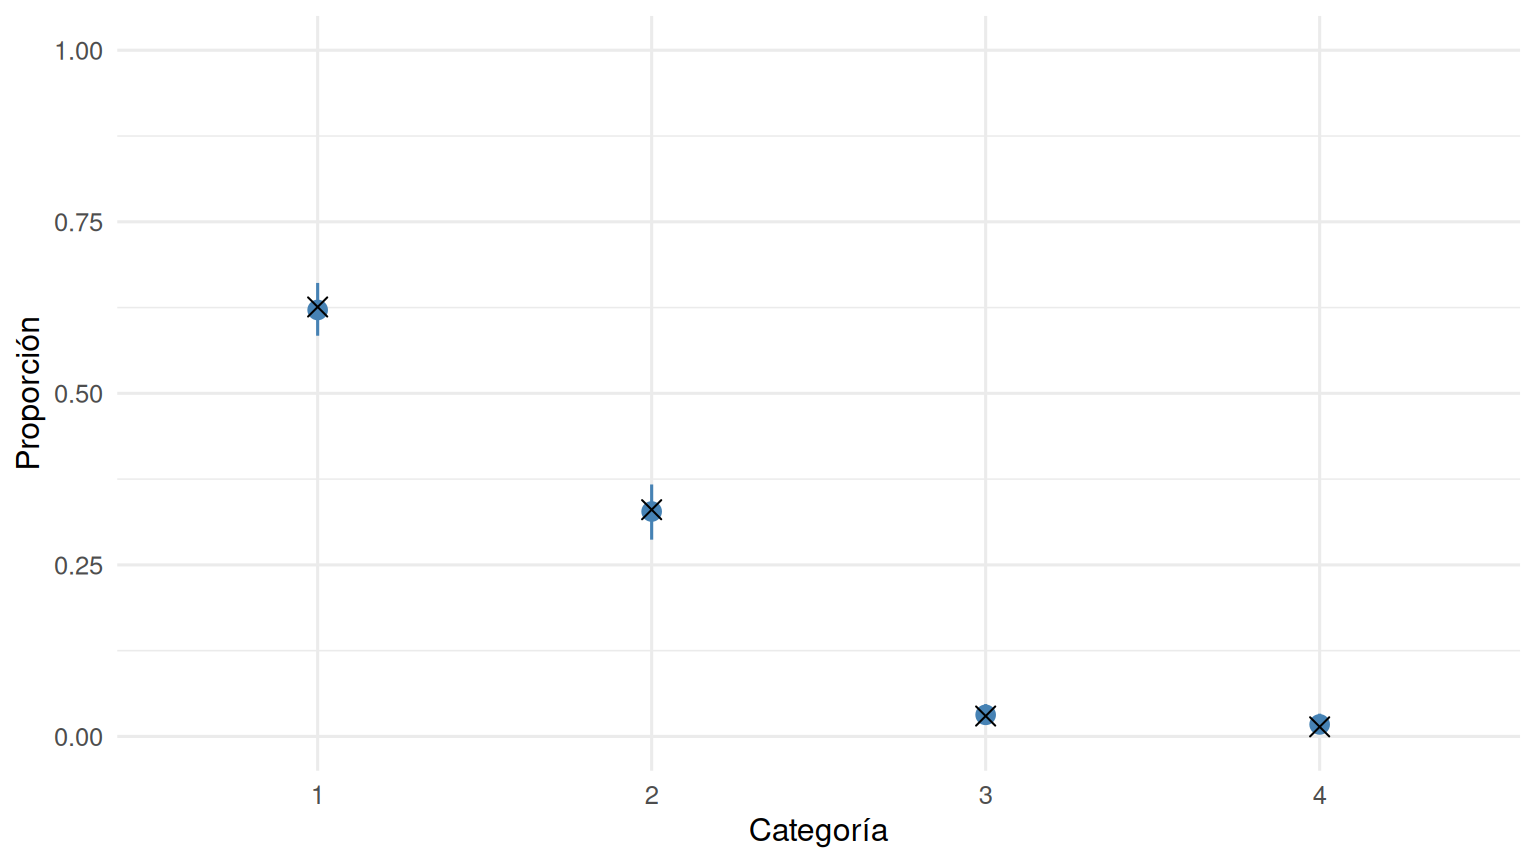
En una respuesta de cuatro categorías, un gráfico de densidades continuas no es la comprobación más informativa. Para cada simulación posterior \(Y^{\mathrm{rep}}\) examinaremos la proporción en cada categoría y la compararemos con la observada (Gelman et al. 2013, chap. 6; Gelman et al. 2026, sec. 8.2).
ppc_cat_s10 |>ggplot(aes(x = categoria, y = mediana)) +geom_pointrange(aes(ymin = l90, ymax = u90), color ="steelblue") +geom_point(aes(y = observada), color ="black", shape =4, size =3) +labs(x ="Categoría", y ="Proporción") +coord_cartesian(ylim =c(0, 1)) +theme_minimal(base_size =12)
Figura 10.11: Frecuencias observadas por categoría (cruces) y proporciones replicadas desde la posterior (intervalos centrales del 90 %).
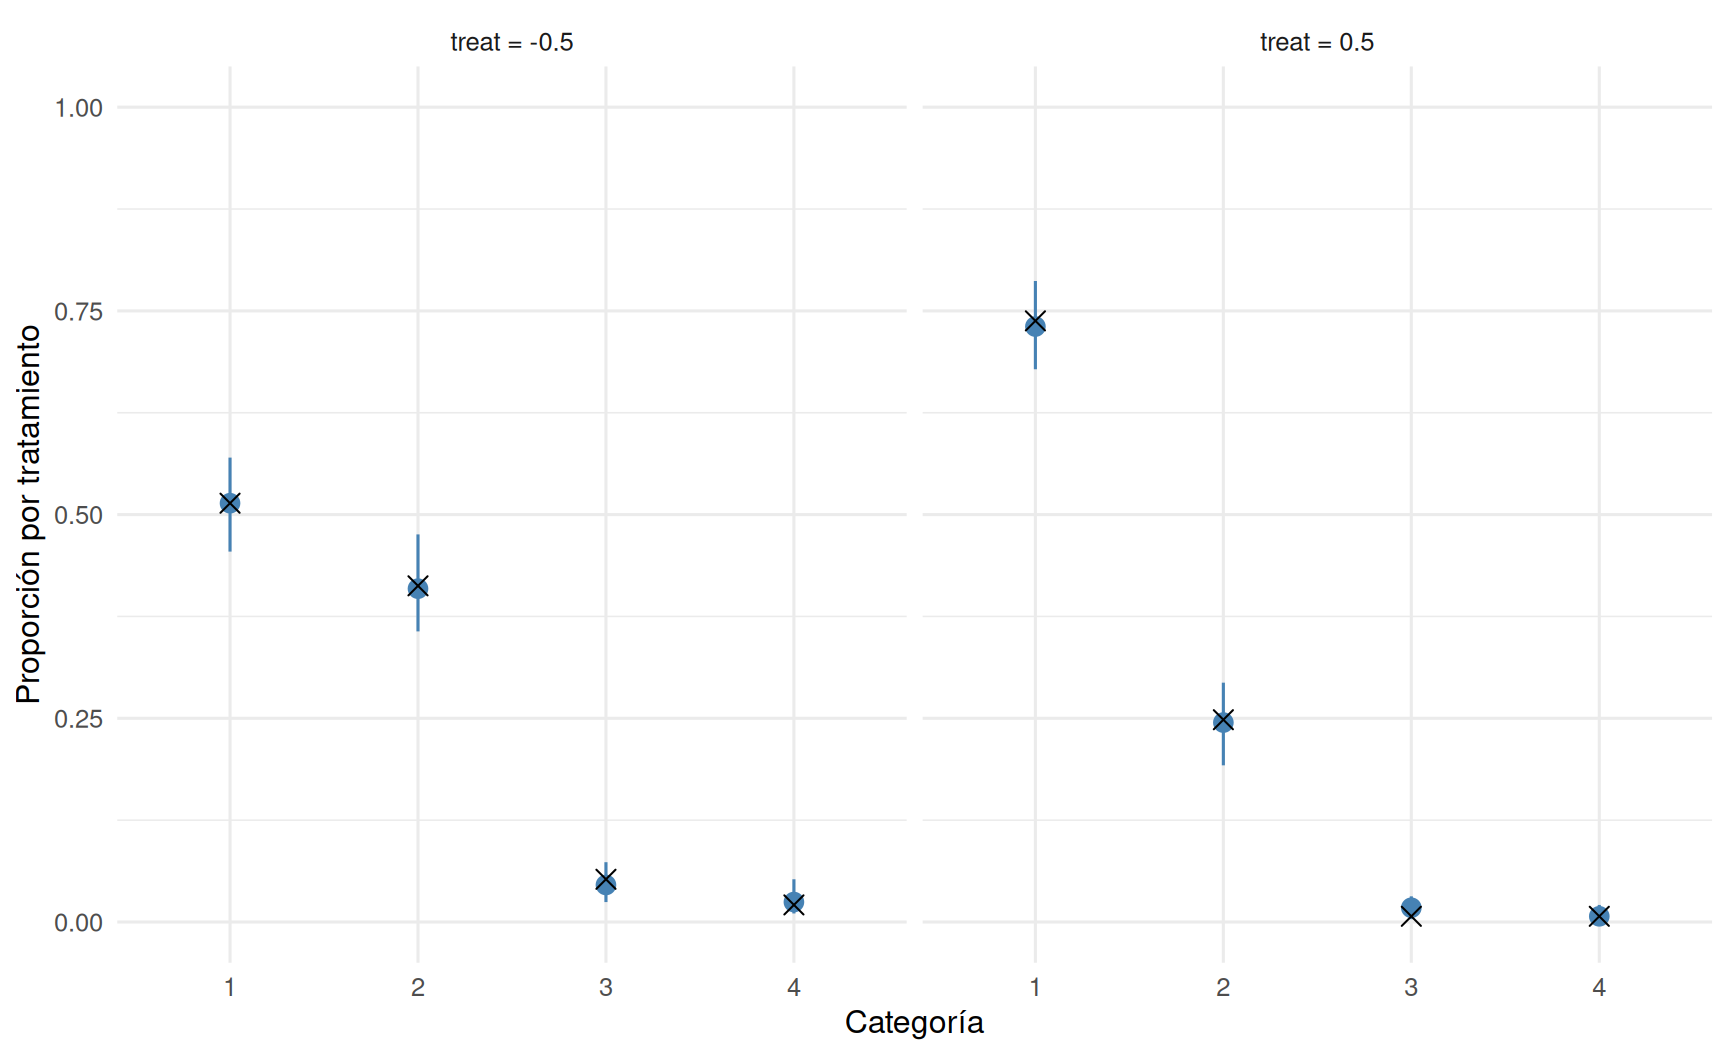
Estas frecuencias constituyen una primera comprobación, pero pueden ocultar diferencias entre tratamientos o una dependencia intrapaciente mal representada. Por eso desagregaremos los estadísticos.
ppc_tratamiento_s10 |>ggplot(aes(x = categoria, y = mediana)) +geom_pointrange(aes(ymin = l90, ymax = u90), color ="steelblue") +geom_point(aes(y = observada), shape =4, size =3) +facet_wrap(~tratamiento) +labs(x ="Categoría", y ="Proporción por tratamiento") +coord_cartesian(ylim =c(0, 1)) +theme_minimal(base_size =12)
Figura 10.12: Comprobación predictiva de las categorías ordinales por tratamiento, manteniendo la estructura del diseño observado.
También es razonable repetir la comprobación por período o por secuencia de tratamientos cuando estas cantidades respondan a una duda sustantiva. Una discrepancia por tratamiento no se corrige necesariamente agregando más interceptos individuales: puede indicar que el efecto del tratamiento no es correctamente representado o que alguna dimensión relevante del diseño no se modeló.
10.10.12 Comprobación de asociación dentro de paciente
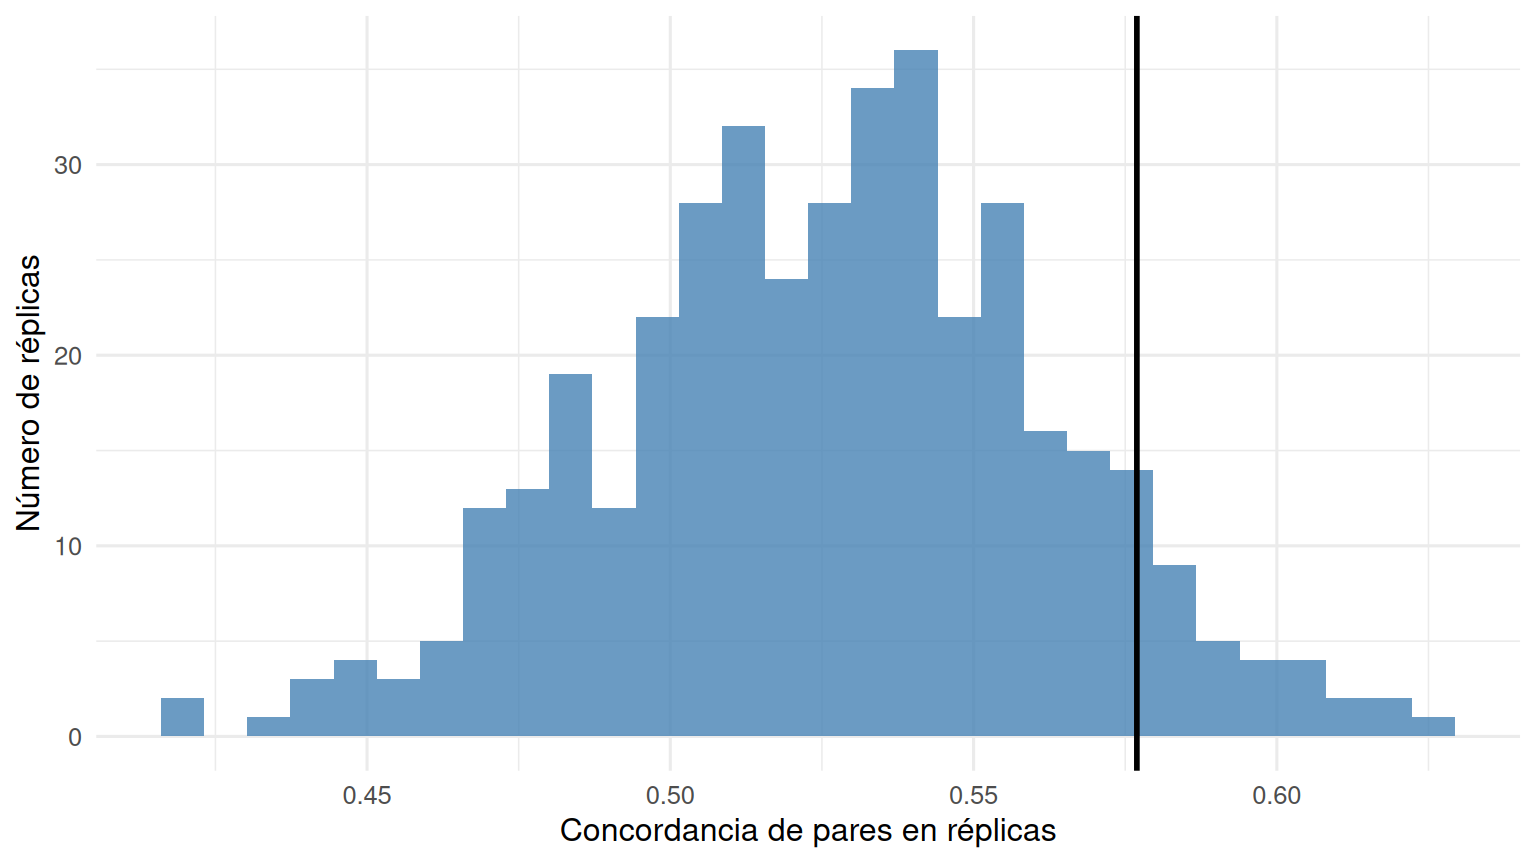
Las dos observaciones por paciente nos permiten examinar una característica que un simple histograma de categorías no revela: la proporción de pacientes que respondieron con la misma categoría en ambas ocasiones. Esa concordancia depende de las probabilidades de categoría, del efecto de los covariables y de la heterogeneidad compartida por paciente. La usaremos como estadístico predictivo descriptivo, no como prueba única de independencia.
pares_s10 <-split(seq_len(nrow(inhaler_s10)), inhaler_s10$subject)pares_s10 <-Filter(function(ii) length(ii) ==2L, pares_s10)if (length(pares_s10) ==0L) {stop("No hay pares de observaciones para la comprobación por sujeto.")}conc_observada_s10 <-mean(vapply(pares_s10, function(ii) { inhaler_s10$rating_num[ii[1]] == inhaler_s10$rating_num[ii[2]]}, logical(1)))conc_replicada_s10 <-vapply(seq_len(nrow(yrep_ord_s10)), function(s) {mean(vapply(pares_s10, function(ii) { yrep_ord_s10[s, ii[1]] == yrep_ord_s10[s, ii[2]] }, logical(1)))}, numeric(1))tibble(concordancia_observada = conc_observada_s10,mediana_predictiva =median(conc_replicada_s10),l90 =quantile(conc_replicada_s10, 0.05),u90 =quantile(conc_replicada_s10, 0.95),pacientes_con_dos_registros =length(pares_s10))
tibble(concordancia = conc_replicada_s10) |>ggplot(aes(x = concordancia)) +geom_histogram(bins =30, fill ="steelblue", alpha =0.8) +geom_vline(xintercept = conc_observada_s10, linewidth =1) +labs(x ="Concordancia de pares en réplicas", y ="Número de réplicas") +theme_minimal(base_size =12)
Figura 10.13: Comprobación de la proporción de pacientes cuyas dos valoraciones coinciden. La línea negra representa los datos observados.
Si la concordancia observada cae sistemáticamente lejos de la distribución predictiva, el modelo no reproduce adecuadamente un aspecto importante de la asociación dentro de paciente. Antes de agregar nuevas componentes se debe investigar si la discrepancia proviene de heterogeneidad, orden temporal, arrastre, diferencias entre categorías o de la escala de los parámetros.
10.10.13 Tres preguntas predictivas distintas
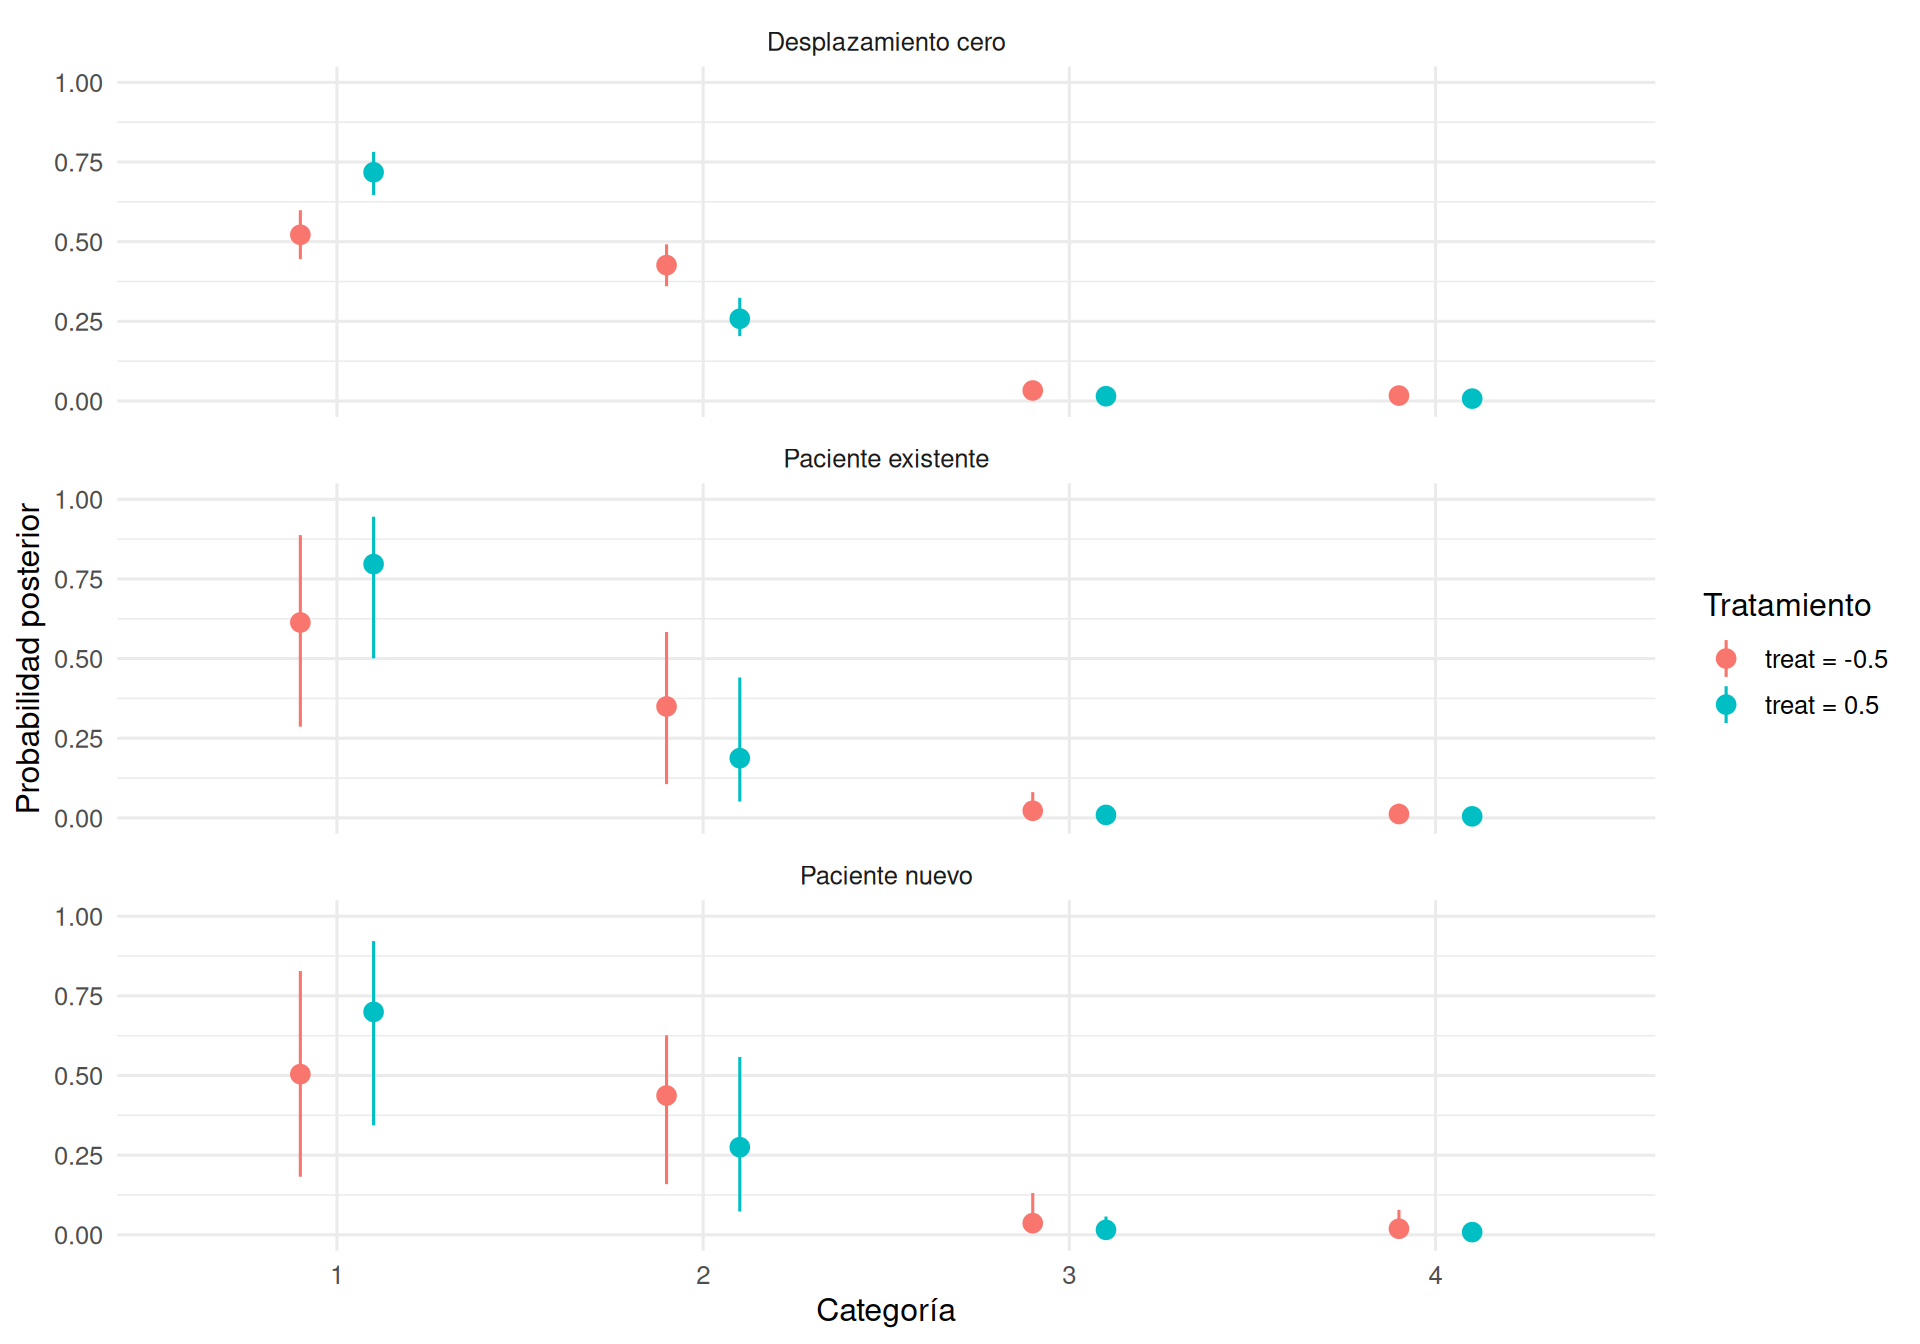
Para mostrar la importancia de definir la población objetivo, compararemos tres escenarios manteniendo constantes las covariables: (i) paciente existente, (ii) desplazamiento individual fijado en cero, y (iii) paciente nuevo. En el tercer caso la distribución de \(u_{\mathrm{nuevo}}\) es parte de la predicción. No debemos etiquetar (ii) como el promedio marginal sobre pacientes (Gelman y Hill 2007, sec. 12.8; Gelman et al. 2026, chap. 7).
resumen_tres_s10 |>ggplot(aes(x = categoria, y = mediana, color = perfil)) +geom_pointrange(aes(ymin = l90, ymax = u90),position =position_dodge(width =0.4)) +facet_wrap(~tipo_prediccion, ncol =1) +labs(x ="Categoría", y ="Probabilidad posterior", color ="Tratamiento") +coord_cartesian(ylim =c(0, 1)) +theme_minimal(base_size =12)
Figura 10.14: Predicciones de categoría bajo tres tratamientos diferentes de la variación individual.
En un paciente nuevo, además de la incertidumbre posterior de los parámetros poblacionales, hay incertidumbre acerca de su propio desplazamiento. Esa diferencia puede ser relevante para el pronóstico de una persona no observada, incluso cuando las predicciones para pacientes ya estudiados parecen precisas.
10.10.14 ¿Qué cambia si tratamos las categorías como números continuos?
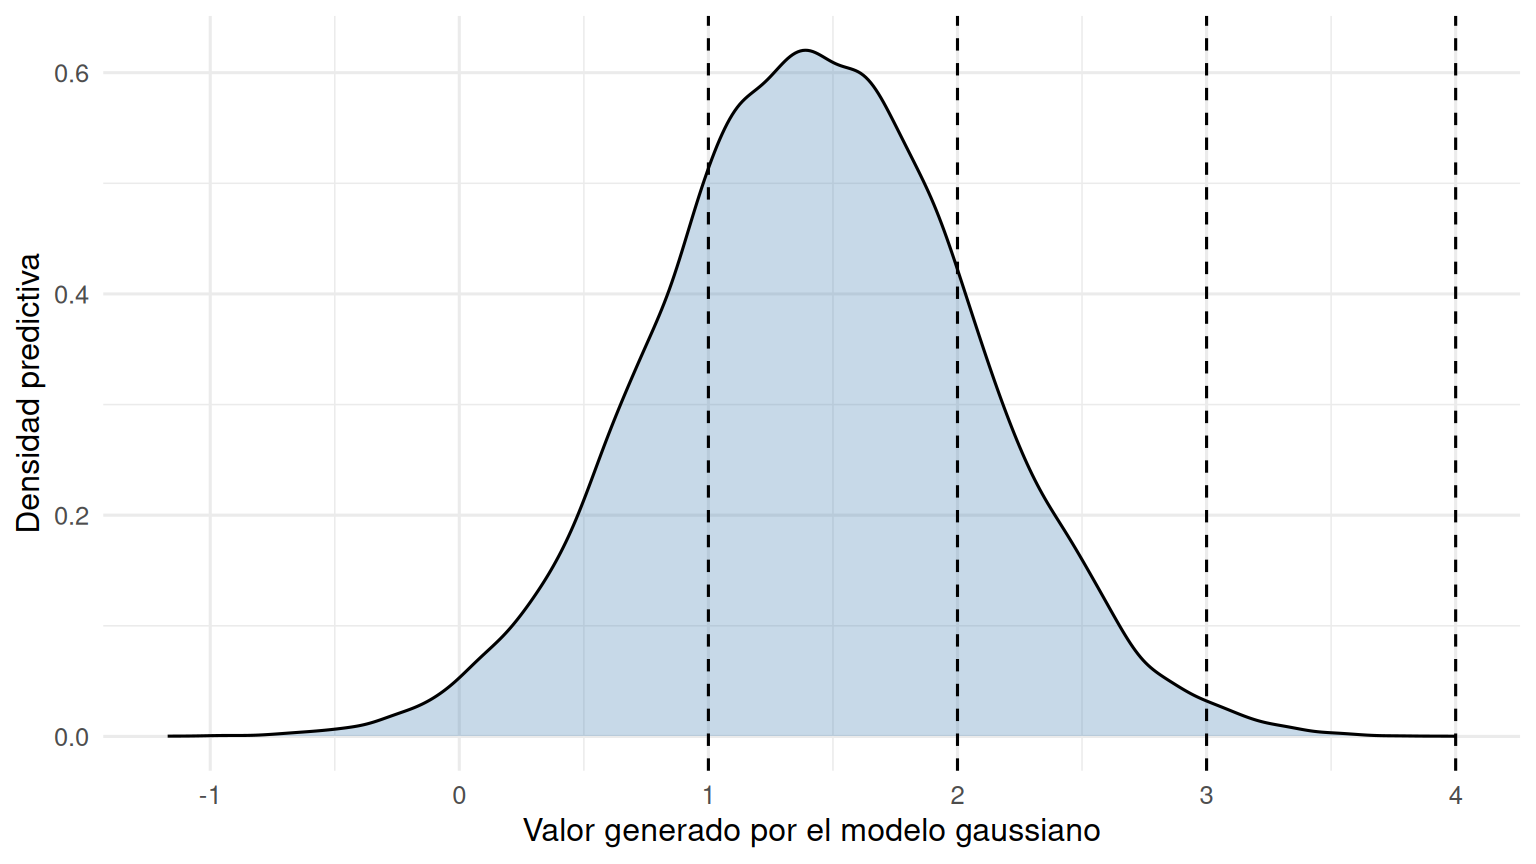
Para una comparación pedagógica ajustaremos también un modelo gaussiano de interceptos variables a la codificación rating_num. En este modelo, una unidad numérica entre categorías se interpreta como una distancia constante, y se permite una distribución continua de resultados. No emplearemos automáticamente criterios de ajuste dentro de muestra para declarar un ganador: el problema es qué verosimilitud responde a la pregunta y qué aspectos predictivos reproduce(Hox et al. 2018, sec. 7.1).
fit_gauss_ord_s10 <- brms::brm( rating_num ~1+ treat + period + carry + (1| subject),data = inhaler_s10,family = stats::gaussian(),prior =c( brms::prior(normal(2.5, 1), class ="Intercept"), brms::prior(normal(0, 0.8), class ="b"), brms::prior(exponential(2), class ="sd"), brms::prior(exponential(1), class ="sigma") ),backend ="cmdstanr",chains =4, cores =getOption("mc.cores", 4),iter =2000, warmup =1000, seed =16531026,control =list(adapt_delta =0.95, max_treedepth =12),refresh =0,file ="_fits/s10_inhaler_gaussiano_pedagogico",file_refit ="on_change")
Antes de usar las predicciones de este ajuste auxiliar, revisamos que el muestreo de su posterior tampoco haya producido advertencias graves. Este paso es tan necesario en un modelo normal como en uno ordinal.
Figura 10.15: Distribución predictiva continua del modelo gaussiano aplicado a códigos numéricos ordinales. Las líneas muestran los únicos cuatro valores observables.
La distribución normal genera, casi seguramente, valores no enteros. Esa propiedad no impide usar algunas aproximaciones gaussianas cuando hay muchas categorías, pero sí muestra que su verosimilitud no representa directamente la observación ordinal. Si para obtener categorías aplicáramos puntos de corte a sus predicciones, estaríamos definiendo un mecanismo de medición adicional y deberíamos justificarlo. En esta aplicación de cuatro categorías, el modelo acumulativo utiliza de manera explícita la información de orden sin suponer distancias iguales.
10.11 Panorama de familias adicionales
10.11.1 Respuesta beta continua
Si \(Y_{ij}\in(0,1)\) es una magnitud proporcional medida en escala continua, y no un cociente derivado de un número de ensayos Bernoulli conocido, podemos considerar
La familia beta tiene soporte abierto \((0,1)\): no asigna masa a ceros o unos exactos. Si los datos incluyen valores exactamente 0 o 1, debemos explicar si provienen de redondeo, censura, límites estructurales u otro mecanismo; no basta transformar automáticamente esos valores para satisfacer el soporte de la beta. Los modelos cero-uno inflados o una formulación que respete el proceso de medición pueden ser apropiados según el caso.
10.11.2 Cero-inflación: ceros con dos posibles orígenes
En un conteo, un modelo Poisson cero-inflado introduce una mezcla: con probabilidad \(\pi\) se produce un cero estructural y con probabilidad \(1-\pi\) se genera un conteo Poisson con media \(\lambda\). Por tanto,
La presencia de muchos ceros no basta para justificarlo. Interceptos variables y familias sobredispersas también pueden predecir numerosos ceros. La diferencia sustantiva es la existencia defendible de un proceso adicional capaz de forzar un cero (McElreath 2020, sec. 12.2).
10.11.3 Modelo hurdle: ocurrencia y magnitud positiva
Un modelo hurdle separa explícitamente la probabilidad de cero de la distribución de los valores positivos. Si \(\pi=P(Y=0)\) y \(f_+\) es una distribución truncada en cero definida únicamente para \(y>0\),
A diferencia de una mezcla cero-inflada, los valores positivos se producen mediante una distribución que no admite ceros. Un modelo de dos etapas puede ser coherente cuando primero debe ocurrir una decisión o superar una barrera y, solo después, se determina el número o la magnitud.
10.11.4 Respuestas semicontinuas
Algunas mediciones tienen una masa en cero y valores positivos continuos, por ejemplo gastos en un servicio (cero si no se utiliza; gasto positivo entre quienes sí lo utilizan). Una posibilidad es
con predictores, y eventualmente interceptos variables, en el proceso de ocurrencia y en la magnitud positiva. El proceso lognormal se interpreta sobre los valores positivos, no como una distribución de conteos. Familia, enlace y jerarquía dependen de la pregunta científica y de la definición exacta de la variable.
10.11.5 Cuadro comparativo
Mecanismo
Rango de respuesta
Pregunta central
Ejemplo de familia en brms
Éxitos de ensayos conocidos
\(0,\ldots,n\)
¿Cuántos éxitos de \(n\)?
binomial()
Probabilidades heterogéneas por fila
\(0,\ldots,n\)
¿Existe dispersión adicional tras considerar grupos y covariables?
beta_binomial()
Categorías ordenadas
\(1,\ldots,K\)
¿Cómo se desplaza la probabilidad entre categorías?
cumulative()
Fracción continua sin extremos
\((0,1)\)
¿Cómo cambia una media acotada continua?
Beta()
Exceso de ceros en conteos
\(0,1,\ldots\)
¿Hay un proceso adicional que produce ceros?
zero_inflated_poisson()
Paso por cero y luego valores positivos
\(0\) y valores positivos
¿Hay mecanismos diferentes de ocurrencia y magnitud?
hurdle_negbinomial() o hurdle_lognormal()
La tabla presenta modelos posibles, no recetas de selección. También existen categorías nominales, familias de categorías adyacentes y modelos secuenciales ordinales (Bürkner 2017, sec. 4.8). Esas extensiones requieren formular supuestos y comprobaciones propios; no las ajustaremos en este laboratorio.
10.12 Diagnóstico, comprobación y comunicación
El procedimiento de trabajo que buscamos consolidar es:
Medición: definir unidad observacional, soporte de la respuesta, denominadores, categorías y orden.
Estructura: identificar grupos, covariables, repetición, dependencias condicionales e interacciones plausibles.
Modelo: especificar distribución, función de enlace, jerarquía, umbrales o parámetros de dispersión.
Previas: justificar escalas mediante probabilidades, odds, proporciones o frecuencias de categoría.
Ajuste: utilizar HMC/NUTS con diagnósticos antes de interpretar la posterior.
Comprobación: comparar aspectos observados y replicados, globalmente y por grupos o tratamientos.
Predicción: definir si la unidad futura pertenece a un grupo existente o nuevo, y si buscamos una media o una observación.
Comunicación: resumir incertidumbre en la escala original de respuesta, reconocer limitaciones e investigar discrepancias.
No seleccionaremos automáticamente un modelo por una única medida escalar. En la semana 14 estudiaremos validación predictiva y PSIS-LOO, prestando especial atención a la unidad de observación dejada fuera; en estos datos, dejar fuera una respuesta del mismo paciente no equivale a dejar fuera un paciente completo (Gelman et al. 2026, chaps. 8-9).
10.13 Errores frecuentes
10.13.1 Ignorar el denominador binomial
Tratar \(1/2\) y \(100/200\) como dos proporciones con igual precisión bajo un modelo binomial pierde la información del número de ensayos. El denominador es parte de la verosimilitud, no un detalle que pueda omitirse sin consecuencias.
10.13.2 Confundir variación entre grupos y sobredispersión residual
Un intercepto variable crea dependencia entre observaciones del mismo grupo; una beta-binomial introduce variación de la probabilidad latente de cada observación agregada. Pueden coexistir, pero su identificación requiere datos apropiados. No son sinónimos ni dos parametrizaciones equivalentes de cualquier modelo.
10.13.3 Interpretar \(\phi\) al revés
En la parametrización beta-binomial empleada, \(\phi\) grande implica menor variabilidad adicional, no mayor. El parámetro equivalente de correlación entre ensayos \(1/(\phi+1)\) ayuda a evitar esta confusión.
10.13.4 Usar números ordinales como si las distancias estuvieran definidas
El orden de «1, 2, 3, 4» no afirma que el paso de 1 a 2 sea comparable al de 3 a 4. Una aproximación normal debe justificarse explícitamente y comprobarse, en lugar de utilizarse por comodidad.
10.13.5 Agregar un intercepto global libre a todos los umbrales
La combinación \(c_k-\alpha\) no distingue un desplazamiento común de los cortes y del intercepto. Por tanto, debemos respetar una convención de identificación antes de atribuir significado separado a esos parámetros.
10.13.6 Leer \(\exp(\beta)\) como razón de probabilidades
En la convención adoptada, \(\exp(\beta)\) es un odds ratio condicional de estar por encima de cualquier umbral, no una razón constante entre probabilidades de categorías ni una diferencia de probabilidades. Para comunicación sustantiva, las probabilidades por categoría son preferibles.
10.13.7 Suponer que el supuesto de odds proporcionales es automáticamente cierto
El supuesto de pendiente común entre umbrales restringe las relaciones posibles. Es una simplificación útil, pero puede fallar para algunas covariables. Las discrepancias en probabilidades de categoría por predictor, y cuando sea pertinente modelos ordinales alternativos, ayudan a examinarlo.
10.13.8 Interpretar re_formula = NA como la predicción marginal de un nuevo grupo
Esa opción fija los términos grupales en cero. Una predicción genuina para grupos nuevos debe representar su variación mediante la distribución grupal posterior. Ambas predicciones responden preguntas distintas.
10.13.9 Seleccionar una mezcla solo por exceso visible de ceros
Un exceso de ceros respecto de una Poisson simple puede provenir de predictores omitidos, heterogeneidad entre grupos, dispersión adicional o un mecanismo especial de ceros. La modelación debe distinguir esas posibilidades.
10.13.10 Interpretar un ajuste sin revisar sus diagnósticos
El hecho de que el software haya producido coeficientes no garantiza una posterior explorada adecuadamente. Las conclusiones están condicionadas a la validez computacional y a la suficiencia predictiva del modelo.
10.14 Síntesis
La elección de una familia probabilística tiene consecuencias interpretativas y predictivas. En una binomial con denominador conocido, el número de ensayos determina parte de la precisión; la beta-binomial introduce variabilidad adicional a través de probabilidades latentes de las observaciones agregadas. En una respuesta ordinal, los umbrales ordenados conectan una escala latente con las categorías y permiten derivar probabilidades de respuesta sin asumir distancias iguales entre códigos.
En un modelo ordinal multinivel, los interceptos variables desplazan las probabilidades acumuladas y representan diferencias entre grupos. La interpretación preferente es la distribución posterior de probabilidades de cada categoría y de eventos como \(Y\ge k\), atendiendo a si se predice para un grupo observado o nuevo. Las comprobaciones predictivas deben dirigirse al soporte y a la estructura: extremos para proporciones, categorías por tratamiento y concordancia intrapaciente para respuestas ordinales repetidas.
La idea central es que modelo, mecanismo de medición y pregunta predictiva deben corresponderse. Ni la flexibilidad computacional de brms ni la disponibilidad de una familia más compleja sustituyen esa justificación.
10.15 Ejercicios
Los ejercicios combinan razonamiento probabilístico, interpretación y comprobación computacional. Las preguntas no requieren pruebas de significancia ni selección automática por un criterio escalar.
10.15.1 Ejercicio 1. ¿Qué se observó realmente?
Se presentan cuatro situaciones:
En cada escuela se cuenta el número de estudiantes que aprueban un examen entre quienes lo rindieron, con denominadores que varían entre escuelas.
En cada hospital se mide la proporción del día durante la cual una sala permanece ocupada, mediante un sensor continuo.
Cada estudiante responde una encuesta de satisfacción en las categorías «muy baja», «baja», «media», «alta» y «muy alta».
En cada región se cuenta el número de días con un accidente de tránsito durante una ventana fija de observación.
Para cada caso identifique unidad de observación, soporte de la respuesta, posible agrupamiento, familia inicial y un supuesto que debería comprobarse antes de ajustar el modelo. En (a), explique por qué no sería suficiente modelar la proporción sin el denominador.
10.15.2 Ejercicio 2. Derivación de la varianza beta-binomial
Use la ley de la esperanza iterada para obtener \(E(Y)\).
Mediante la ley de la varianza total derive Ecuación 10.5, mostrando los dos componentes de variación.
Investigue el límite de la varianza cuando \(\phi\to\infty\) y el caso \(n=1\).
Explique por qué un parámetro adicional de precisión es difícil de identificar cuando todos los registros tienen un solo ensayo.
10.15.3 Ejercicio 3. Sobredispersión residual y estructura multinivel
Un conjunto de datos contiene 40 grupos con 12 observaciones por grupo y 20 ensayos por observación. El investigador observa variación considerable de proporciones y propone inmediatamente una beta-binomial sin efectos grupales.
Escriba dos formulaciones alternativas: binomial con interceptos variables y beta-binomial con interceptos variables.
Distinga sus supuestos sobre los ensayos de una misma fila y sobre las filas de un mismo grupo.
Proponga dos estadísticas predictivas que permitan investigar ambas fuentes de variación.
Explique qué podría dificultar la identificación conjunta de \(\tau_\alpha\) y \(\phi\).
10.15.4 Ejercicio 4. Probabilidades de cuatro categorías
Para un modelo ordinal acumulativo de cuatro categorías se consideran
Escriba las cuatro probabilidades usando la función logística \(L\).
Calcule numéricamente las probabilidades y compruebe que suman 1.
Repita con \(\eta=1.6\) e identifique cuáles aumentan o disminuyen.
Explique por qué las categorías intermedias no tienen por qué cambiar monótonamente cuando aumenta \(\eta\).
Interprete el evento \(Y\ge3\) sin asignar una distancia numérica entre categorías.
10.15.5 Ejercicio 5. Identificación de umbrales
Considere
\[
P(Y\le k)=L(c_k-\alpha-\beta x).
\]
Muestre por sustitución que no se identifican por separado \(\alpha\) y \(c_k\) si ambos pueden desplazarse por la misma constante.
Describa una convención de identificación compatible con la formulación acumulativa usada en clase.
Explique por qué un coeficiente grupal \(u_j\sim\mathcal N(0,\tau^2)\) no cumple exactamente el mismo papel que añadir otro intercepto poblacional libre sin restricción.
10.15.6 Ejercicio 6. Interpretación de odds proporcionales
En un modelo ordinal de cinco categorías, el coeficiente posterior de un predictor \(x\) se concentra cerca de \(0.7\).
¿Qué odds ratio condicional se deriva al aumentar \(x\) una unidad? Precise qué dos eventos se comparan.
¿Este odds ratio se aplica a todos los cortes \(k\)? Explique el supuesto requerido.
¿Por qué no se puede afirmar que \(P(Y=5)\) se multiplica siempre por ese mismo número?
¿Qué gráficos predictivos propondría para investigar una posible asociación que varía con el umbral?
10.15.7 Ejercicio 7. Extensión del laboratorio beta-binomial
Utilice los datos simulados datos_bb_s10.
Cambie la precisión generadora de \(\phi=9\) a \(\phi=40\) manteniendo los demás parámetros.
Compare visualmente la dispersión de las proporciones replicadas y la proporción de respuestas exactamente 0 o \(n\).
Ajuste nuevamente las dos familias con las mismas previas y compruebe si las conclusiones predictivas se modifican.
Repita con solo dos observaciones por grupo, y discuta la estabilidad de las estimaciones de dispersión y heterogeneidad.
No presente una sola realización de simulación como prueba general; contraste varios conjuntos simulados para evaluar estabilidad.
10.15.8 Ejercicio 8. Comprobación ordinal por grupo
En la aplicación inhaler, las comprobaciones por tratamiento y por concordancia de dos mediciones tienen objetivos diferentes.
Explique qué aspecto verifica cada una.
Proponga una comprobación adicional por período.
Describa qué patrón de discrepancias sería compatible con un efecto de arrastre mal representado.
Formule una extensión razonable del modelo que responda a esa evidencia y discuta qué información de los datos podría limitar su identificación.
10.15.9 Ejercicio 9. Personas existentes y nuevas
A partir de Ecuación 10.12, considere un perfil fijo de covariables.
Escriba la distribución predictiva de \(Y_{ij}^{\mathrm{nuevo}}\) para una observación adicional de un paciente \(j\) ya estudiado.
Escriba la distribución predictiva correspondiente para un paciente no observado, integrando \(u_{\mathrm{nuevo}}\).
Explique por qué fijar \(u=0\) no es igual a integrar sobre \(u\).
Utilice posterior_epred() y posterior_predict() para comparar probabilidades estimadas y categorías futuras en ambos escenarios.
10.15.10 Ejercicio 10. Crítica de una respuesta de IA
Un asistente automático propone:
«Como las valoraciones del inhalador van de 1 a 4, basta con una regresión lineal. Si hay muchos ceros en cualquier GLMM, se usa un modelo cero-inflado. Además, en regresión ordinal, el coeficiente del tratamiento indica cuánto aumenta la probabilidad de todas las categorías. Finalmente, se debe usar re_formula = NA para predecir un paciente nuevo, porque elimina los efectos aleatorios».
Identifique al menos cinco afirmaciones problemáticas o incompletas. Justifique cada corrección mediante el soporte de la respuesta, la formulación probabilística o la diferencia entre predicción condicional y marginal. Proponga una interpretación alternativa apropiada en la escala de la respuesta.
10.15.11 Ejercicio 11. Análisis de sensibilidad de previas
Considere el modelo ordinal del laboratorio.
Compare la previa \(\mathcal N(0,1.5^2)\) para umbrales con otra más concentrada y otra más dispersa.
Examine por simulación previa las composiciones de categorías que producen.
Repita el ajuste posterior con dos elecciones defendibles y compare probabilidades de categoría, heterogeneidad y diagnósticos de HMC.
Explique qué aspectos de la inferencia son robustos y cuáles dependen de las decisiones previas. No se limite a comparar medianas de coeficientes.
10.15.12 Ejercicio 12. Selección sustantiva de una familia
Para cada problema, proponga una distribución de respuesta y una comprobación posterior especialmente informativa:
fracción continua de cobertura vegetal, con ceros exactos y valores positivos en \((0,1)\);
número de visitas médicas, con posibilidad de que un grupo de individuos nunca utilice el servicio;
número de intentos exitosos de un procedimiento entre \(n\) intentos observados por institución;
evaluación de un servicio de 1 a 7 por personas anidadas en centros;
gasto familiar en un servicio con masa en cero y valores positivos continuos.
Explique por qué la decisión no puede basarse solamente en un histograma marginal de la respuesta.
10.16 Referencias de la semana
Las fuentes principales para el capítulo son:
Gelman y Hill. Regresión binomial y ejemplos ordinales multinivel, especialmente § 6.3, pp. 116–118; § 15.2, pp. 331–332; y § 17.6, pp. 383–384 (Gelman y Hill 2007).
McElreath. Beta-binomial y dispersión, § 12.1.1, pp. 370–373; modelos cero-inflados, § 12.2, pp. 376–380; respuestas ordinales, § 12.3, pp. 380–391 (McElreath 2020).
Hox, Moerbeek y van de Schoot. Proporciones agrupadas, § 6.4, pp. 113–121; y modelos ordinales acumulativos, § 7.1, pp. 130–139 (Hox et al. 2018).
Bürkner. Uso de brms con respuestas ordinales y un intercepto variable por sujeto, § 4.8, pp. 15–16 (Bürkner 2017).
Gelman et al. Fundamentos generales de comprobación del modelo, capítulo 6 de Bayesian Data Analysis(Gelman et al. 2013).
Gelman, Vehtari y McElreath et al. Simulación predictiva previa, § 5.9; comprobación posterior, § 8.2; y diagnóstico de ajuste, capítulos 11–12 de Bayesian Workflow(Gelman et al. 2026).
Para los detalles actuales de interfaz y dimensiones de posterior_epred(), se consultó adicionalmente la documentación de brms. Para la parametrización media–precisión de beta_binomial(), se cotejó la documentación de familias de brms y la explicación de la familia beta-binomial en la viñeta técnica del paquete. Esas fuentes de software complementan, pero no reemplazan, los textos de referencia.
Bürkner, Paul-Christian. 2017. «brms: An R Package for Bayesian Multilevel Models Using Stan». Journal of Statistical Software 80 (1): 1-28. https://doi.org/10.18637/jss.v080.i01.
Gelman, Andrew, John B. Carlin, Hal S. Stern, David B. Dunson, Aki Vehtari, y Donald B. Rubin. 2013. Bayesian Data Analysis. 3.ª ed. Chapman & Hall/CRC.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. 2.ª ed. Chapman & Hall/CRC.