13Semana 13. Comprobación, interpretación y comunicación de modelos multinivel bayesianos
SP-1653 Modelos Mixtos
Autor/a
Programa de Posgrado en Estadística, Universidad de Costa Rica
Fecha de publicación
2 de noviembre de 2026
13.1 Panorama de la semana
Durante las semanas anteriores formulamos modelos para respuestas continuas, binarias, conteos y otras familias; incorporamos interceptos y pendientes variables, estructuras cruzadas, trayectorias longitudinales y dependencia residual. También examinamos distribuciones previas y diagnósticos de HMC/NUTS. Todas estas herramientas se integran ahora en una tarea que es indispensable para un análisis estadístico: confrontar las implicaciones de un modelo ajustado con las características de los datos que pretendemos representar.
La pregunta orientadora de esta semana es:
¿Cómo evaluar si un modelo multinivel bayesiano reproduce las características relevantes de los datos y proporciona resultados adecuados para responder una pregunta sustantiva?
En las semanas 8–12 ya realizamos comprobaciones predictivas particulares. Aquí organizaremos esas prácticas alrededor de criterios explícitos: qué se está comprobando, qué distribución predictiva se utiliza, qué discrepancia tendría importancia sustantiva, qué revela el resultado y qué modificación del modelo sería razonable investigar (Gelman et al. 2013, chap. 6; Gelman et al. 2026, chap. 8).
Conviene distinguir tres preguntas:
¿Es confiable la aproximación computacional a la posterior? Revisamos \(\widehat R\), ESS, trazas, divergencias y otros diagnósticos del algoritmo.
¿Qué implican las distribuciones de probabilidad del modelo para los datos observables? Simulamos conjuntos de datos bajo la distribución predictiva posterior y los contrastamos con el conjunto observado.
¿Qué inferencias y predicciones debemos comunicar? Seleccionamos cantidades que respondan a la pregunta de investigación, las expresamos en una escala comprensible y describimos su incertidumbre y sus limitaciones.
Estas tres preguntas son complementarias, pero no equivalentes. Un algoritmo puede explorar correctamente la distribución posterior de un modelo mal especificado. Asimismo, un conjunto de comprobaciones sin discrepancias llamativas no demuestra que el modelo sea verdadero ni garantiza una capacidad predictiva adecuada para una población diferente (Gelman et al. 2013, secs. 6.1–6.3; Gelman et al. 2026, sec. 8.2).
Nuestro recorrido será:
\[
\boxed{\text{modelo}\ \longrightarrow\ \text{ajuste}\ \longrightarrow\
\text{diagnóstico computacional}\ \longrightarrow\
\text{réplicas predictivas}\ \longrightarrow\
\text{crítica y, si procede, reformulación}}
\]
NotaFuentes, notación y elaboración propia
La base conceptual y matemática de la comprobación predictiva corresponde principalmente a Gelman et al. (Gelman et al. 2013, chap. 6), Gelman y Hill (Gelman y Hill 2007, secs. 21.1, 21.3–21.4 y 24.1–24.2) y Bayesian Workflow(Gelman et al. 2026, chaps. 8 y 21). El capítulo 13 de Hox et al. sirve como contraste con los diagnósticos de residuos de la tradición de modelos mixtos (Hox et al. 2018, sec. 13.3). Las derivaciones adicionales, la simulación, los indicadores y el laboratorio de R son elaboración pedagógica original para SP-1653. En el laboratorio utilizaremos \(j\) para centro y \(i\) para observación dentro del centro; en las secciones longitudinales indicaremos explícitamente la convención alternativa individuo–ocasión de las semanas 11–12.
Objetivos de aprendizaje
Al finalizar la semana, la persona estudiante podrá:
Distinguir un diagnóstico de MCMC de una comprobación estadística de las implicaciones del modelo.
Derivar e interpretar una distribución predictiva posterior en un modelo jerárquico.
Identificar cuándo la simulación corresponde a grupos existentes o a grupos nuevos.
Proponer estadísticas de discrepancia relacionadas con una pregunta sustantiva, en lugar de elegirlas mecánicamente.
Interpretar comprobaciones globales, por grupos y condicionadas en covariables, incluyendo las discrepancias que pueden ocultar los resúmenes agregados.
Explicar la interpretación y las limitaciones de las probabilidades predictivas posteriores de cola.
Describir comprobaciones orientadas a la heterogeneidad multinivel y a la dependencia temporal.
Distinguir variabilidad entre unidades, incertidumbre posterior y variabilidad predictiva.
Comunicar contrastes y probabilidades con intervalos de incertidumbre en la escala de la respuesta.
Diagnosticar, justificar y volver a comprobar una extensión concreta de un modelo ajustado con brms y cmdstanr.
13.2 ¿Qué significa comprobar un modelo?
13.2.1 Un modelo que converge no necesariamente reproduce los datos
Imaginemos un estudio de personas agrupadas en centros de atención. La respuesta \(Y_{ij}\) indica la presencia (\(1\)) o ausencia (\(0\)) de un evento y \(x_{ij}\) es un predictor individual. Un primer modelo logístico es
El intercepto varía por centro, pero la asociación con \(x\) en la escala logit es común a todos. Supongamos que el modelo se ajusta sin divergencias y con valores de \(\widehat R\) próximos a uno. Esos resultados apoyan la calidad de la aproximación computacional, no la hipótesis de que las diferencias observadas entre centros se explican suficientemente mediante interceptos variables.
Por ejemplo, el modelo podría reproducir la frecuencia global del evento, pero no las diferencias de esa frecuencia entre personas con \(x=1\) y \(x=0\) dentro de ciertos centros. Esa es una discrepancia sobre la estructura de asociación, no necesariamente un problema de HMC. En términos de la semana 7, hay que separar los problemas de exploración de la posterior de las limitaciones de la formulación probabilística.
13.2.2 Comprobación, predicción y validación no son sinónimos
Una comprobación predictiva posterior utiliza datos simulados desde el modelo ajustado a los mismos datos que se examinan. Es un procedimiento de crítica: pregunta si aspectos elegidos del conjunto observado parecen compatibles con el comportamiento que el modelo puede producir.
La validación predictiva utiliza observaciones no empleadas para el ajuste —o predicciones de validación cruzada que las dejan fuera— con el propósito de estudiar generalización. Cuando existen grupos, debemos decidir si se desea predecir nuevas observaciones de grupos conocidos o grupos enteramente nuevos. Esta distinción determinará la unidad de validación en la semana 14 (Gelman et al. 2026, secs. 8.2–8.3).
Una comprobación favorable de un resumen agregado no excluye una discrepancia en otro resumen. Tampoco permite deducir causalidad, ausencia de sesgo de medición o extrapolación confiable a escenarios no observados.
13.2.3 Por qué no basta una lista de residuos
En modelos lineales mixtos, inspeccionar residuos condicionales y sus patrones sigue siendo útil (Hox et al. 2018, sec. 13.3). Sin embargo, una discrepancia de interés puede involucrar conjuntos enteros de observaciones: número de ceros por centro, dispersión de tasas, persistencia temporal, proporción de grupos extremos o heterogeneidad de pendientes. No hay motivo para restringir la evaluación a una única variable residual individual.
La propuesta predictiva permite definir una característica \(T\) del conjunto observado y calcular la misma característica en conjuntos replicados. El mecanismo del modelo —incluidas las dependencias entre observaciones— forma parte de la simulación. Las comparaciones tienen sentido si se mantienen, o se simulan apropiadamente, el diseño, los grupos y las covariables (Gelman y Hill 2007, sec. 24.1).
13.3 La distribución predictiva posterior
13.3.1 De la posterior a datos replicados
Denotemos por \(\boldsymbol\theta\) todos los parámetros desconocidos que intervienen en el modelo, incluidos los coeficientes grupales cuando corresponda; por \(\mathbf x\) la matriz o conjunto de predictores observados; y por \(\mathbf y\) las respuestas observadas. Si reproducimos el mismo diseño, la distribución predictiva posterior es
La fórmula expresa dos fuentes de incertidumbre: no conocemos los parámetros y, aun fijados esos parámetros, la respuesta futura es aleatoria. En simulaciones, la integral se aproxima de manera natural. Para \(s=1,\ldots,S\):
En cada réplica se conserva un mismo vector de parámetros para generar el conjunto completo; no se sustituyen libremente los coeficientes por estimaciones puntuales distintas entre observaciones. Esta construcción preserva la dependencia implicada por la jerarquía. La notación \(\mathbf y^{\mathrm{rep}}\) sigue la utilizada por Gelman et al. (Gelman et al. 2013, sec. 6.3).
Es importante distinguir tres objetos:
\(E(Y_{ij}\mid\boldsymbol\theta)\): media condicional de la respuesta para parámetros dados.
\(p(\boldsymbol\theta\mid\mathbf y)\): incertidumbre posterior acerca de los parámetros.
\(p(\mathbf y^{\mathrm{rep}}\mid\mathbf y)\): distribución de resultados replicados, que incorpora incertidumbre posterior y variación observacional.
Por lo tanto, posterior_epred() (simulaciones de la media esperada) y posterior_predict() (simulaciones de nuevas respuestas) responden preguntas distintas. Para comprobar frecuencias, máximos, ceros y dispersión observada debemos usar, en general, réplicas de la respuesta, no solo medias estimadas.
Si queremos generar observaciones replicadas para los mismos grupos, utilizamos las distribuciones posteriores de los coeficientes grupales y de los demás parámetros del modelo. Para cada extracción posterior \(s\), disponemos de un conjunto de valores
obtenidos conjuntamente de la distribución posterior. Manteniendo los valores observados de los predictores \(x_{ij}\), generamos una nueva respuesta para cada observación \(i\) del grupo \(j\) mediante
Al repetir este procedimiento para las distintas extracciones posteriores, obtenemos conjuntos de datos replicados que conservan la estructura de agrupamiento original e incorporan tanto la incertidumbre sobre los parámetros como la variabilidad residual de las respuestas.
En cambio, si queremos predecir observaciones de un grupo nuevo\(J+1\), debemos generar primero un coeficiente grupal a partir de la distribución poblacional correspondiente, utilizando los hiperparámetros de la extracción posterior \(s\):
La diferencia fundamental es que, para los grupos observados, utilizamos directamente las extracciones posteriores de sus coeficientes \(\alpha_j\), que ya incorporan la información de las observaciones de cada grupo. Para un grupo nuevo, en cambio, no disponemos de esa información y debemos simular su coeficiente a partir de la distribución poblacional de los interceptos, incorporando así la heterogeneidad esperada entre grupos.
Por tanto, en el primer caso, no debemos volver a simular los interceptos grupales a partir de su distribución poblacional, porque eso representaría grupos nuevos y no réplicas condicionadas en los grupos existentes.
Con pendientes variables se simula conjuntamente un nuevo vector de intercepto y pendiente, preservando la correlación de su distribución poblacional. Una comprobación condicional a grupos observados puede detectar problemas internos; una comprobación que vuelve a generar grupos evalúa aspectos de la distribución poblacional propuesta (Gelman y Hill 2007, secs. 12.8 y 24.1; McElreath 2020, sec. 13.5).
Hay otra diferencia relevante en regresión logística. La predicción fijando los efectos grupales en cero es
En general, no son iguales. Fijar los efectos grupales en cero con re_formula = NAno equivale a integrar sobre la distribución de grupos nuevos. Esta distinción ya apareció en la semana 8 y será importante al comunicar contrastes posteriores.
13.4 Estadísticas de discrepancia
13.4.1 Construir una cantidad relacionada con el problema
Sea \(T(\mathbf y)\) una estadística que resume un aspecto relevante de los datos: una media, la fracción de ceros, un máximo, la desviación estándar de proporciones grupales o una medida de asociación. Para cada réplica se calcula \(T(\mathbf y^{\mathrm{rep},(s)})\). Si el valor observado se encuentra en una región inusual de la distribución replicada, tenemos evidencia de una discrepancia respecto de esa característica.
La teoría más general permite que la cantidad dependa también de los parámetros, \(T(\mathbf y,\boldsymbol\theta)\); entonces las comparaciones se hacen emparejando la misma extracción\(\boldsymbol\theta^{(s)}\) con los datos observados y replicados (Gelman et al. 2013, sec. 6.3; Gelman y Hill 2007, sec. 24.1). Para la mayoría de los ejercicios de esta semana bastará \(T(\mathbf y)\), que es más sencilla de comunicar.
Las siguientes comprobaciones ilustran el vínculo entre una pregunta y su estadística:
Pregunta
Estadística de discrepancia posible
Posible evidencia de limitación
¿Es adecuada la frecuencia global de un evento?
\(T(\mathbf y)=n^{-1}\sum_i y_i\) para datos binarios.
La proporción observada es atípica en las réplicas.
Variación entre promedios grupales demasiado pequeña o grande.
¿Se reproduce la diversidad de asociaciones?
\(T(\mathbf y)=\operatorname{sd}_j(\widehat\Delta_j)\), con \(\widehat\Delta_j\) una diferencia observada dentro del grupo.
Las asociaciones varían más que lo esperado bajo una pendiente común.
¿Se reproduce la persistencia temporal?
Correlación de rezago 1 de una transformación residual o un resumen de secuencias.
Dependencia temporal adicional no explicada.
Para comprender la estadística \(\widehat{\Delta}_j\), consideremos un estudio en el que interesa evaluar la asociación entre una exposición binaria (\(x=0\) o \(x=1\)) y la probabilidad de presentar determinado evento en diferentes centros de salud. Para cada centro \(j\), calculamos la diferencia observada \(\widehat{\Delta}_j\) entre la proporción de eventos en las personas expuestas y la proporción en las no expuestas. Por ejemplo, supongamos que en el centro A estas proporciones son 30 % y 20 %, respectivamente, por lo que \(\widehat{\Delta}_A=0.10\); en el centro B son 55 % y 15 %, de modo que \(\widehat{\Delta}_B=0.40\); y en el centro C son 52 % y 50 %, por lo que \(\widehat{\Delta}_C=0.02\). Estas diferencias sugieren que la asociación observada entre la exposición y la respuesta no tiene la misma magnitud en todos los centros. La estadística \(T(\mathbf y)=\operatorname{sd}_j(\widehat{\Delta}_j)\) resume precisamente esa heterogeneidad mediante la desviación estándar de las diferencias observadas entre centros. Para evaluar si el modelo reproduce esta característica, calculamos la misma estadística en cada conjunto de datos replicados de la distribución predictiva posterior. Si el valor observado de \(T(\mathbf y)\) resulta considerablemente mayor que los valores obtenidos en las réplicas, esto indica que el modelo no reproduce adecuadamente la heterogeneidad de las asociaciones observadas, lo que podría motivar la incorporación de pendientes variables. Sin embargo, debe recordarse que las diferencias de probabilidades también dependen de las probabilidades de referencia y de la variabilidad muestral, incluso cuando la pendiente es común en la escala logit.
Cada estadística exige definir denominadores, grupos y covariables de manera idéntica en observaciones y réplicas. En particular, la dispersión de promedios grupales refleja tanto heterogeneidad entre grupos como ruido de muestreo dependiente de sus tamaños. Por ello no debe identificarse mecánicamente con una desviación estándar de efectos grupales.
13.4.2 Probabilidades predictivas posteriores de cola
Para una estadística cuya discrepancia interesa en la cola superior, definimos
Estas probabilidades deben leerse como resúmenes de posición del dato observado respecto de una distribución de referencia predictiva posterior. Una probabilidad muy pequeña indica que las réplicas rara vez alcanzan un valor tan grande como el observado; una muy grande indica que la estadística observada queda por debajo de gran parte de las réplicas. La elección entre una cola, ambas colas o una visualización directa depende de cómo se define la discrepancia.
No interpretamos \(p_{\mathrm{PPC}}\) como la probabilidad de que el modelo sea verdadero ni aplicamos mecánicamente un umbral de 0.05. Tampoco posee en general la calibración uniforme de un valor \(p\) frecuentista bajo muestreo repetido: los datos se utilizan tanto para ajustar el modelo como para calcular la discrepancia (Gelman et al. 2013, sec. 6.3). Si \(T\) es discreta, las igualdades y empates también afectan la distribución del resumen. Los gráficos suelen comunicar más que un único número.
13.4.3 Una distinción matemática útil: condicionamiento y promediado
Para una respuesta binaria con predictor \(x\), definamos dentro del grupo \(j\)
Aunque el coeficiente \(\beta\) sea común en la escala logit, las diferencias en la escala de probabilidad no son exactamente iguales entre grupos, debido a la no linealidad del enlace. Además, los valores muestrales \(\widehat\Delta_j\) fluctúan por azar. Por tanto, observar una dispersión no nula de \(\widehat\Delta_j\)no demuestra la existencia de pendientes variables. Una prueba relevante es comparar la dispersión observada con la dispersión generada por el modelo de pendiente común bajo el mismo diseño.
Este ejemplo ilustra el valor añadido de la simulación predictiva: el modelo determina una distribución de referencia que ya incorpora la no linealidad logística y las diferencias en tamaños grupales.
13.5 Comprobaciones globales y condicionadas
13.5.1 El nivel global
Una comprobación global compara características del conjunto completo de respuestas: histograma, distribución empírica, media, varianza, número de ceros, máximo o cuantiles. Es un primer contacto útil con las consecuencias observables del modelo. En una respuesta binaria, un histograma con dos barras informa relativamente poco: su contenido es esencialmente la frecuencia global de éxitos.
La interpretación debe atender al diseño. Que la media observada se encuentre cerca del centro de su distribución predictiva no dice si el modelo reproduce diferencias entre centros, tiempos o niveles del predictor. Un modelo con suficientes parámetros de intercepto podría ajustar la media global y, sin embargo, imponer una estructura de asociación demasiado rígida.
13.5.2 Condicionar en covariables, grupos y períodos
Una comprobación más informativa divide el conjunto en unidades científicamente relevantes y examina los resúmenes correspondientes. Algunos ejemplos son:
Por grupo: proporciones, medias, varianzas, conteos extremos y discrepancias que dependan del tamaño del grupo.
Por predictor: respuesta observada y predictiva a distintos valores de una covariable; diferencias entre niveles y variaciones de pendiente.
Por período: tasas, dispersión y patrones de cambio para cada tiempo o etapa del estudio.
Por combinación de factores: grupos pequeños/grandes, tratamiento/control, o niveles de exposición dentro de cada centro.
Cuando se examinan muchos grupos, no es sorprendente que algunos resúmenes queden fuera de intervalos predictivos individuales del 90%. La evaluación debe identificar patrones sistemáticos —por ejemplo, muchos grupos con contrastes extremos en una dirección o mayor dispersión global— y no confundir una sola observación inusual con evidencia concluyente.
Una forma especialmente útil de acompañar los gráficos grupo a grupo es comprobar una estadística global de heterogeneidad, como la desviación estándar de los contrastes grupales. Así conservamos la pregunta sobre la estructura multinivel sin depender únicamente de una colección de decisiones individuales.
13.5.3 Ceros, colas y observaciones extremas
Las familias de respuesta sugieren estadísticas distintas. En un modelo Poisson de conteos, los ceros, la varianza condicional y los máximos pueden informar sobre heterogeneidad no representada; en un modelo binomial negativo, conviene verificar si la flexibilidad adicional reproduce esos mismos rasgos. En respuestas continuas, se pueden examinar cuantiles altos, asimetría y variabilidad residual; en ordinales, las frecuencias de categorías pueden comprobarse por grupo y predictor.
No debe atribuirse automáticamente una discrepancia de ceros a un mecanismo de inflación de ceros: quizá falta un predictor, exposición, heterogeneidad grupal o una distribución de conteo apropiada. De igual manera, un máximo inesperado podría señalar colas pesadas, error de registro, mezcla de subpoblaciones o variación no modelada. La discrepancia abre una investigación; no identifica de manera única su explicación.
13.6 Comprobaciones específicas de modelos multinivel
13.6.1 ¿Qué heterogeneidad estamos comprobando?
En un modelo con interceptos variables podemos querer comprobar si las diferencias entre medias grupales son plausibles. En un modelo con pendientes variables, el objetivo cambia: interesa la heterogeneidad de relaciones condicionales. Para estructuras cruzadas, se pueden comparar resúmenes por persona y por evaluador de manera separada. Para datos longitudinales, importan tanto las trayectorias individuales como las dependencias residuales.
Una regla de diseño útil es identificar primero la fuente de variación a representar:
\[
\text{diferencias entre grupos}
\quad\text{vs.}\quad
\text{fluctuación dentro de grupos}
\quad\text{vs.}\quad
\text{incertidumbre posterior}.
\]
Un gráfico de intervalos posteriores de \(u_{0j}\) comunica incertidumbre acerca de coeficientes grupales; no es, por sí solo, una comprobación de que el modelo reproduzca una estadística de la respuesta observada. Para realizar esa comprobación es necesario pasar por una distribución predictiva de datos y definir qué característica comparar (Gelman y Hill 2007, chap. 21; Gelman et al. 2026, sec. 8.1).
13.6.2 Dependencia de la comprobación respecto del objetivo predictivo
Para un conjunto de centros observados, la simulación condicional sobre sus coeficientes posteriores evalúa qué respuestas cabe esperar en esos mismos centros. Este procedimiento puede acomodar algunos patrones observados mediante los coeficientes que fueron estimados con sus propios datos. Si la cuestión es cuánto varían centros completamente nuevos, debemos generar coeficientes desde la distribución poblacional para cada réplica.
Estas dos comprobaciones pueden proporcionar impresiones distintas sin ser contradictorias. Se refieren a preguntas diferentes. En la semana 14 el mismo principio determinará si la validación deja fuera observaciones individuales o centros completos.
13.6.3 Cuando hay pocos grupos
Con pocos grupos, la distribución poblacional de coeficientes puede estar débilmente identificada. Una discrepancia en la variabilidad predictiva para nuevos grupos puede reflejar tanto una especificación inapropiada como gran incertidumbre sobre \(\tau\) o sobre una correlación entre pendientes e interceptos. Conviene mostrar esa incertidumbre, revisar las distribuciones previas y evitar interpretar una réplica extrema aislada como una conclusión estable.
13.7 Comprobaciones en datos longitudinales
En las semanas 11 y 12 consideramos observaciones \(y_{it}\) medidas en el individuo \(i\) en tiempos \(t\). Un modelo de trayectorias puede incluir intercepto y pendiente propios de cada individuo. Eso induce dependencia marginal entre sus mediciones. Además, puede existir autocorrelación residual condicional que ese modelo no represente. Por ello, comparar únicamente medias a cada tiempo sería insuficiente (Hox et al. 2018, secs. 5.5–5.7).
Se pueden definir, por ejemplo, tres comprobaciones complementarias:
Media por tiempo:\(T_t(\mathbf y)=n_t^{-1}\sum_{i\in\mathcal I_t}y_{it}\), para investigar si se reproduce la evolución promedio.
Dispersión por tiempo:\(V_t(\mathbf y)=\operatorname{sd}_{i\in\mathcal I_t}(y_{it})\), para evaluar heterocedasticidad y variación entre individuos.
Persistencia condicional: un resumen de productos o correlaciones entre residuos de tiempos adyacentes, construido de igual forma para los datos observados y replicados y utilizando la misma definición de media ajustada en cada comparación.
La tercera comprobación requiere cuidado. En datos irregulares, “rezago 1” puede representar intervalos temporales de distinta longitud. En modelos no gaussianos, los residuos ordinarios tampoco poseen una interpretación uniforme. Una estadística basada en secuencias o en residuales adecuadamente definidos puede ser más informativa. El punto central no es imponer una fórmula universal, sino mantener la correspondencia entre la estructura temporal que interesa y la simulación bajo el modelo.
Una comprobación conjunta de trayectorias enteras puede mostrar comportamientos que la comparación de medias oculta. Por ejemplo, el promedio observado podría concordar con las simulaciones mientras estas producen secuencias demasiado irregulares o cambios individuales demasiado pequeños.
13.8 De la discrepancia a la reformulación
La comprobación no termina al detectar un valor inusual. La tarea siguiente es traducirlo a una pregunta sobre la construcción del modelo:
Discrepancia observada
Hipótesis de modelación que conviene investigar
Exceso de variación entre centros
Estructura de agrupamiento incompleta, predictores grupales o heterogeneidad adicional.
Contrastes entre niveles de \(x\) más heterogéneos que lo replicado
Pendientes variables, interacciones entre niveles o predictores omitidos.
Conteos máximos persistentemente superiores a las réplicas
Dispersión condicional, colas de la familia y observaciones con exposición excepcional.
Autocorrelación residual positiva en secuencias
Proceso residual temporal, tendencia no representada o covariables dependientes del tiempo.
Medias predichas adecuadas, pero variación creciente con el tiempo
Heterocedasticidad, diferencias de trayectoria o estructura temporal más flexible.
Estas son posibles explicaciones, no equivalencias lógicas. Distintas modificaciones pueden actuar sobre una misma discrepancia. La reformulación requiere criterios sustantivos, plausibilidad de los mecanismos, examen de las previas y nuevos diagnósticos computacionales (Gelman et al. 2026, secs. 8.2 y 21.3–21.6).
El capítulo 21 de Bayesian Workflow vuelve a analizar un experimento histórico de aprendizaje en perros. Allí, el modo de ordenar las secuencias observadas y replicadas permite identificar patrones que no resultaban evidentes en otra presentación. El ejemplo muestra que la elección de la visualización y de las estadísticas no es un detalle meramente estético: puede determinar qué deficiencias del modelo llegan a reconocerse (Gelman et al. 2026, chap. 21).
En el laboratorio reproduciremos esa lógica con un ejemplo diferente, referido a asociaciones entre una covariable binaria y la respuesta en distintos centros.
13.9 Interpretación y comunicación de la posterior
13.9.1 De coeficientes a cantidades sustantivas
Los coeficientes del modelo son importantes para describir su formulación, pero no siempre constituyen el mejor resultado para la comunicación. En una regresión logística, un coeficiente puede expresarse en log-odds o como odds ratio; sin embargo, en una aplicación puede interesar más una diferencia de probabilidades.
Para un centro de referencia con efecto grupal fijado en cero, definamos
Cada extracción posterior \(\boldsymbol\theta^{(s)}\) induce una extracción \(\Delta_0^{(s)}\). Resumiremos la distribución de \(\Delta_0\), no solamente la distribución de \(\beta\). Si queremos la diferencia para un grupo nuevo promedio en la población de grupos, la cantidad cambia:
No debemos intercambiar \(\Delta_0\) y \(\Delta_{\mathrm{nuevo}}\). El segundo requiere integrar respecto de la distribución conjunta de los coeficientes grupales; puede calcularse por simulación interna. Si se predice el resultado de un único grupo nuevo, también existirá variabilidad entre los posibles coeficientes de ese nuevo grupo.
13.9.2 Tres incertidumbres que no deben confundirse
Conviene diferenciar:
Incertidumbre sobre una cantidad poblacional: por ejemplo, la posterior de \(\Delta_{\mathrm{nuevo}}\), cuyo ancho refleja incertidumbre sobre los parámetros de la población y sobre el promedio definido.
Heterogeneidad entre grupos: por ejemplo, la dispersión posterior de pendientes \(u_{1j}\) o de diferencias de probabilidad entre grupos.
Variación de resultados futuros: por ejemplo, la predictiva de una respuesta Bernoulli de un individuo nuevo, que incorpora también variabilidad observacional.
Una tabla única con “estimación e intervalo” para todo tiende a ocultar estas distinciones. Gelman y Hill proponen separar incertidumbre y variabilidad, examinar contrastes de coeficientes grupales y utilizar comparaciones predictivas promedio según el objetivo (Gelman y Hill 2007, secs. 21.1, 21.3–21.4).
13.10 Laboratorio reproducible en R
Objetivo del laboratorio. Ajustaremos un modelo logístico multinivel que puede mostrar diagnósticos computacionales razonables y reproducir resúmenes globales, pero que deja sin representar una parte importante de la heterogeneidad entre centros. Compararemos sus réplicas predictivas con las de un modelo ampliado. Los resultados son simulados y no se presentarán como evidencia empírica sobre centros de atención reales.
13.10.1 Simular centros con asociaciones diferentes
Los tamaños de los centros serán distintos, pero garantizaremos observaciones de \(x=0\) y \(x=1\) en todos ellos para poder calcular diferencias empíricas. La variación de pendientes se incluye deliberadamente en la simulación: es una característica conocida del ejercicio, no un hallazgo obtenido mediante análisis real. La correlación entre interceptos y pendientes también se tendrá en cuenta en la construcción.
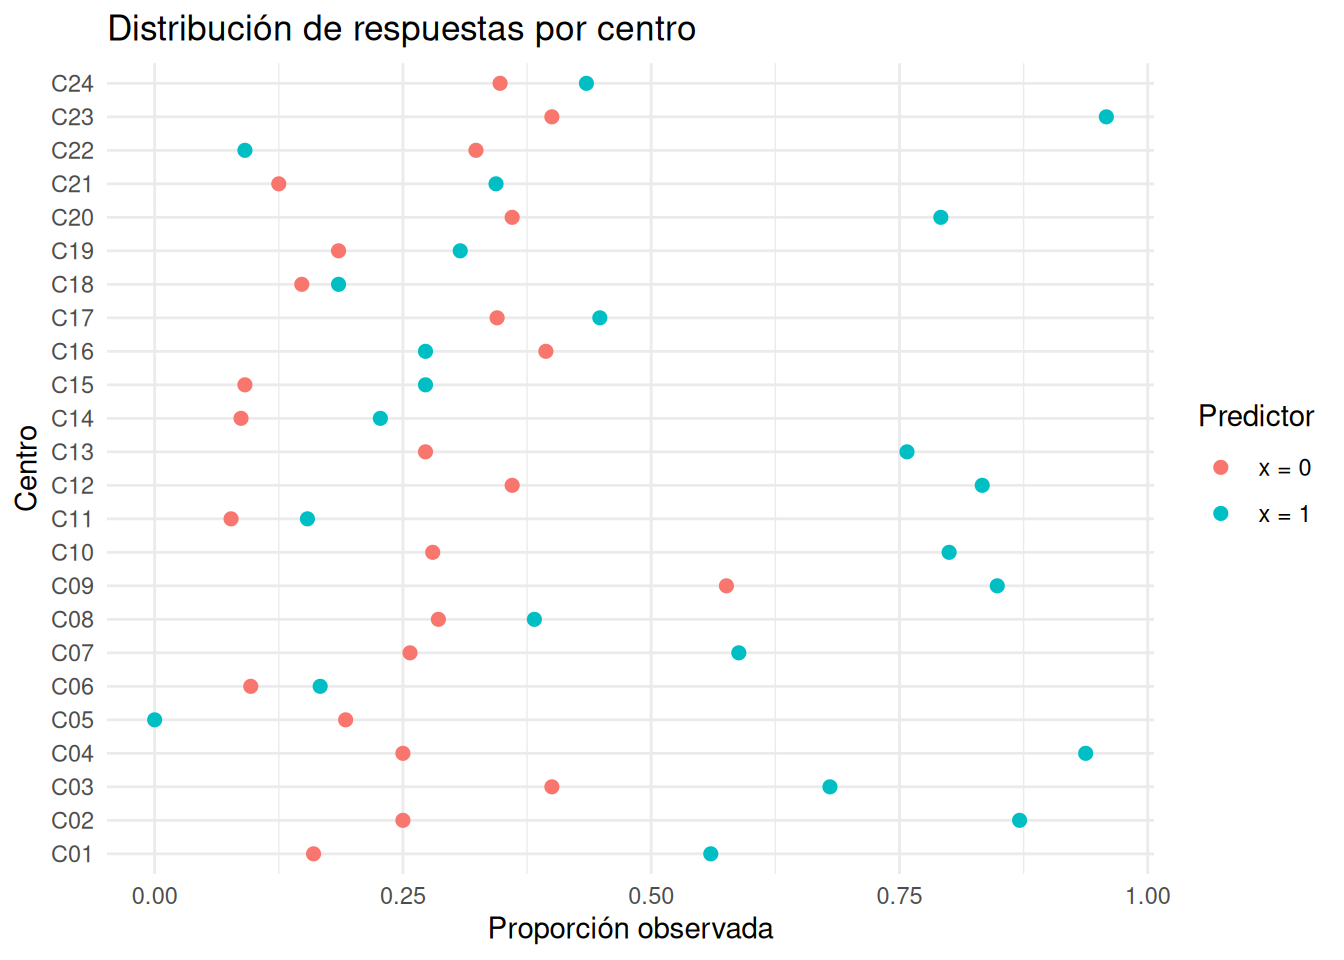
El siguiente gráfico muestra diferencias muestrales dentro de los centros. Antes de ajustar un modelo, todavía no sabemos qué parte de su dispersión puede atribuirse al tamaño muestral o a las implicaciones de una especificación de pendiente común.
resumen_observado_s13 <- datos_s13 |> dplyr::group_by(grupo, x) |> dplyr::summarise(prop =mean(y), n = dplyr::n(), .groups ="drop")ggplot2::ggplot( resumen_observado_s13, ggplot2::aes(x = grupo, y = prop, colour =factor(x), group = x)) + ggplot2::geom_point(size =2) + ggplot2::coord_flip() + ggplot2::scale_colour_discrete(name ="Predictor", labels =c("x = 0", "x = 1")) + ggplot2::labs(x ="Centro", y ="Proporción observada",title ="Distribución de respuestas por centro" ) + ggplot2::theme_minimal(base_size =11)
Proporciones observadas por centro y nivel del predictor. Datos simulados.
13.10.2 Dos modelos con una diferencia sustantiva
El modelo M1 mantiene un coeficiente común para \(x\):
No presentaremos M2 como una receta para corregir todo ajuste deficiente: es una extensión cuya necesidad se discutirá mediante una característica específica de los datos. En ambos modelos utilizaremos distribuciones previas propias y en escalas compatibles con el predictor logístico:
La distribución exponencial utiliza tasa\(1.5\). En las dos fórmulas de brms escribiremos 0 + Intercept para que el intercepto poblacional quede representado explícitamente como coeficiente de la matriz de diseño y su previa se aplique al intercepto en \(x=0\), sin el centrado interno habitual de los predictores de brms. En M2, \(\boldsymbol\Sigma=\operatorname{diag}(\tau_0,\tau_1)\mathbf R\operatorname{diag}(\tau_0,\tau_1)\). Los valores de las previas son decisiones pedagógicas, no estimaciones de los parámetros usados en la simulación. Antes de utilizar estas distribuciones con datos reales correspondería comprobar sus implicaciones predictivas previas, tal como se hizo en la semana 6.
prior_m1_s13 <-c( brms::prior(normal(-1, 1), class ="b", coef ="Intercept"), brms::prior(normal(0, 1.5), class ="b", coef ="x"), brms::prior(exponential(1.5), class ="sd"))fit_m1_s13 <- brms::brm(formula = y ~0+ Intercept + x + (1| grupo),data = datos_s13,family = brms::bernoulli(link ="logit"),prior = prior_m1_s13,backend ="cmdstanr",chains =4, cores = n_cores_s13,iter =1600, warmup =800,seed =1653132,control =list(adapt_delta =0.95),file ="_fits/modelo_comun_s13",file_refit ="on_change",refresh =0)
prior_m2_s13 <-c( brms::prior(normal(-1, 1), class ="b", coef ="Intercept"), brms::prior(normal(0, 1.5), class ="b", coef ="x"), brms::prior(exponential(1.5), class ="sd"), brms::prior(lkj(2), class ="cor"))fit_m2_s13 <- brms::brm(formula = y ~0+ Intercept + x + (1+ x | grupo),data = datos_s13,family = brms::bernoulli(link ="logit"),prior = prior_m2_s13,backend ="cmdstanr",chains =4, cores = n_cores_s13,iter =1600, warmup =800,seed =1653133,control =list(adapt_delta =0.95),file ="_fits/modelo_pendientes_s13",file_refit ="on_change",refresh =0)
13.10.3 Diagnóstico computacional: una pregunta independiente
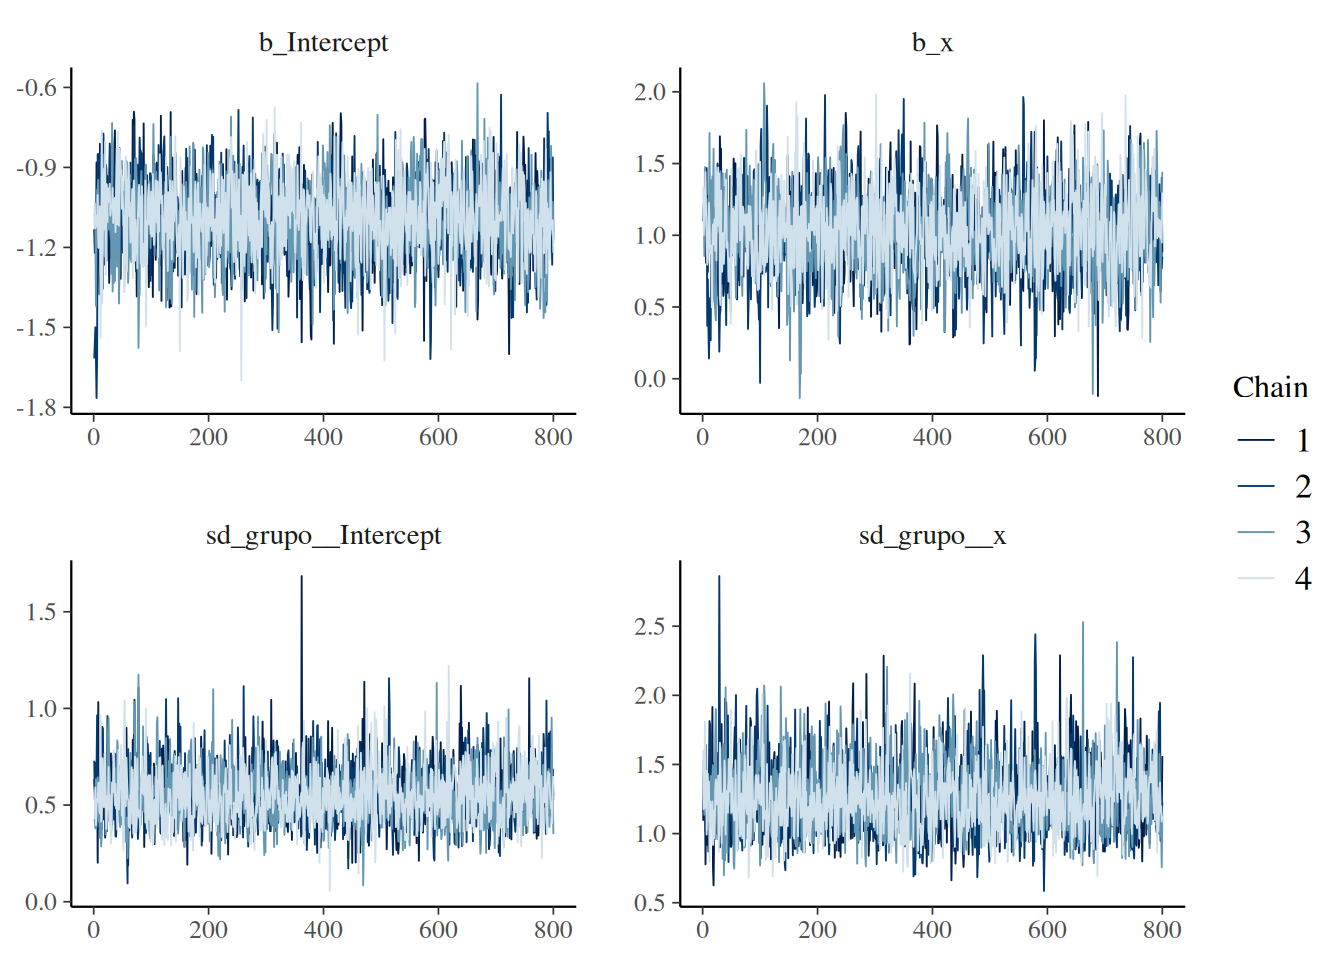
Revisaremos simultáneamente \(\widehat R\), ESS y las divergencias. Para evitar incompatibilidades entre la clase interna del ajuste de brms y un objeto ajustado directamente con cmdstanr, utilizamos posterior::as_draws_df() y brms::nuts_params().
Trazas de parámetros seleccionados del modelo de pendientes variables.
La lectura de los resultados debe ser condicional: si existen divergencias, \(\widehat R\) elevado, ESS muy bajos o trazas problemáticas, las simulaciones pueden resultar inadecuadas para evaluar las comprobaciones posteriores. En ese caso primero hay que investigar el ajuste; no debemos describir los diagnósticos como satisfactorios antes de inspeccionar la salida. Si no se detectan problemas relevantes, podemos pasar a la crítica predictiva, sin concluir que ninguno de los modelos sea estadísticamente correcto.
13.10.4 Funciones para estadísticas de discrepancia
Definimos las cantidades:
\[
\begin{aligned}
T_1(\mathbf y)&=\text{proporción global de éxitos},\\
T_2(\mathbf y)&=\operatorname{sd}_j(\overline y_j),\\
T_3(\mathbf y)&=\operatorname{sd}_j(\widehat\Delta_j),\\
T_4(\mathbf y)&=J^{-1}\sum_{j=1}^J\mathbb 1(\widehat\Delta_j<0).
\end{aligned}
\tag{13.17}\]
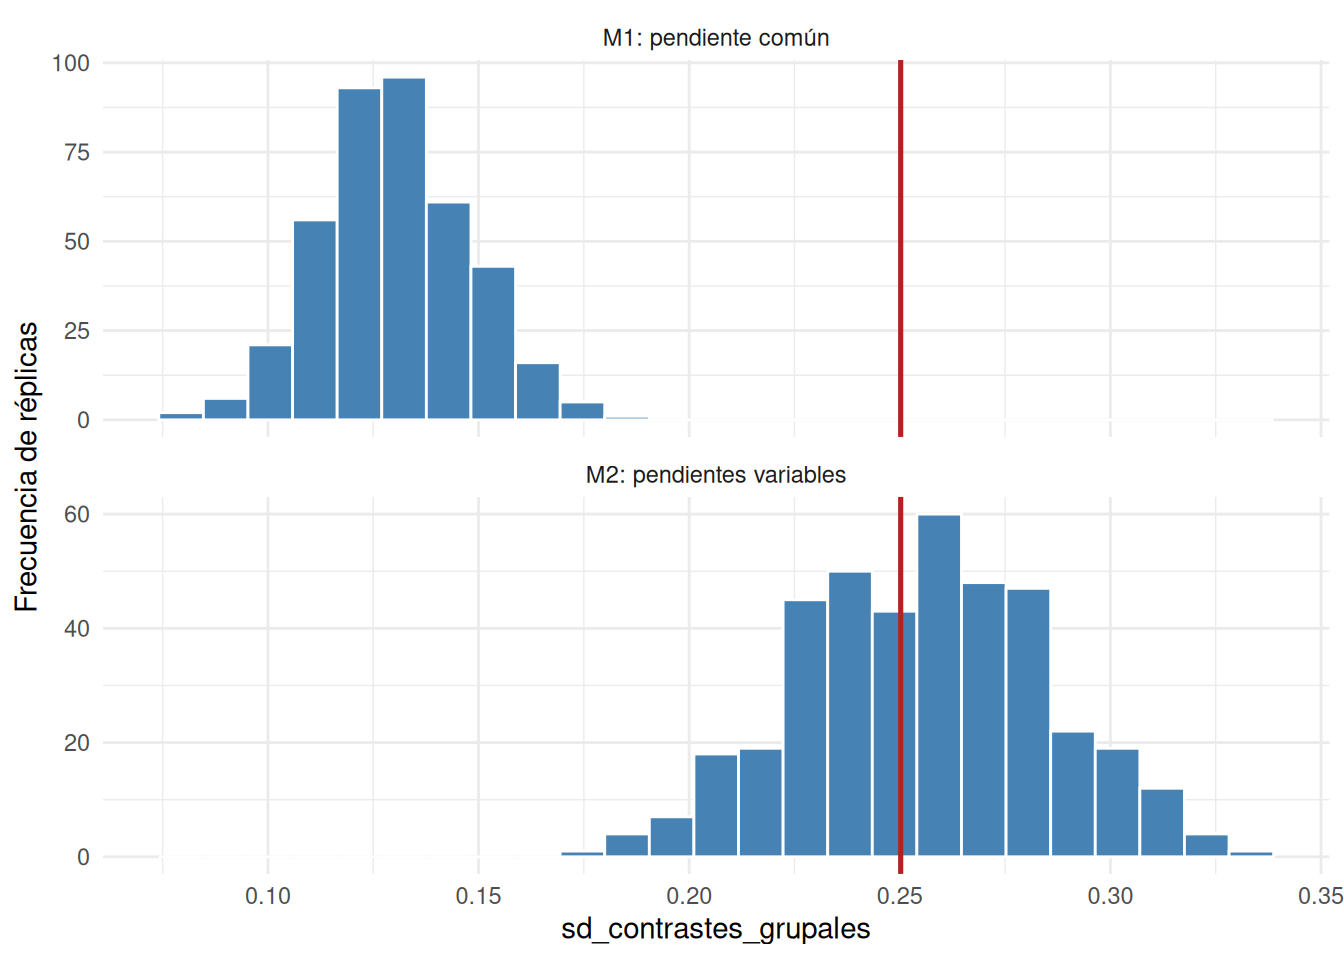
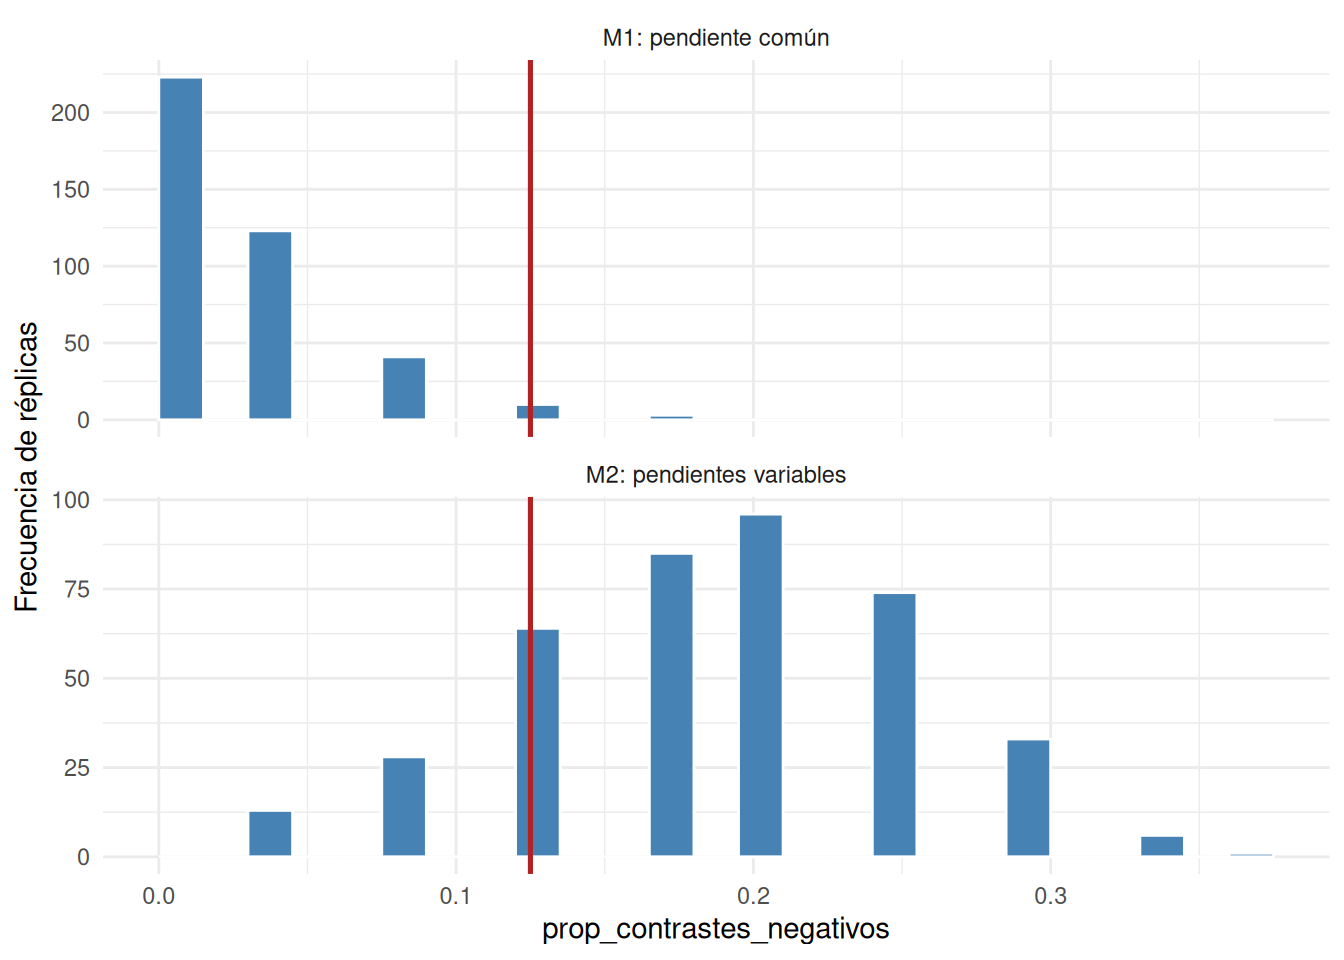
\(T_3\) es especialmente informativa: la dispersión de diferencias empíricas entre \(x=1\) y \(x=0\) pone a prueba la rigidez de una pendiente común sin suponer que las diferencias muestrales deberían ser exactamente iguales. \(T_4\) resume cuántos centros presentan una diferencia muestral negativa; por ser discreta y depender de tamaños grupales, la interpretaremos principalmente mediante una distribución predictiva gráfica.
Conservaremos cada fila de la matriz predictiva como un conjunto completo de respuestas simuladas. Las columnas corresponden a las observaciones originales en el mismo orden que datos_s13.
13.10.5 Primera comprobación: ¿se reproduce la proporción global?
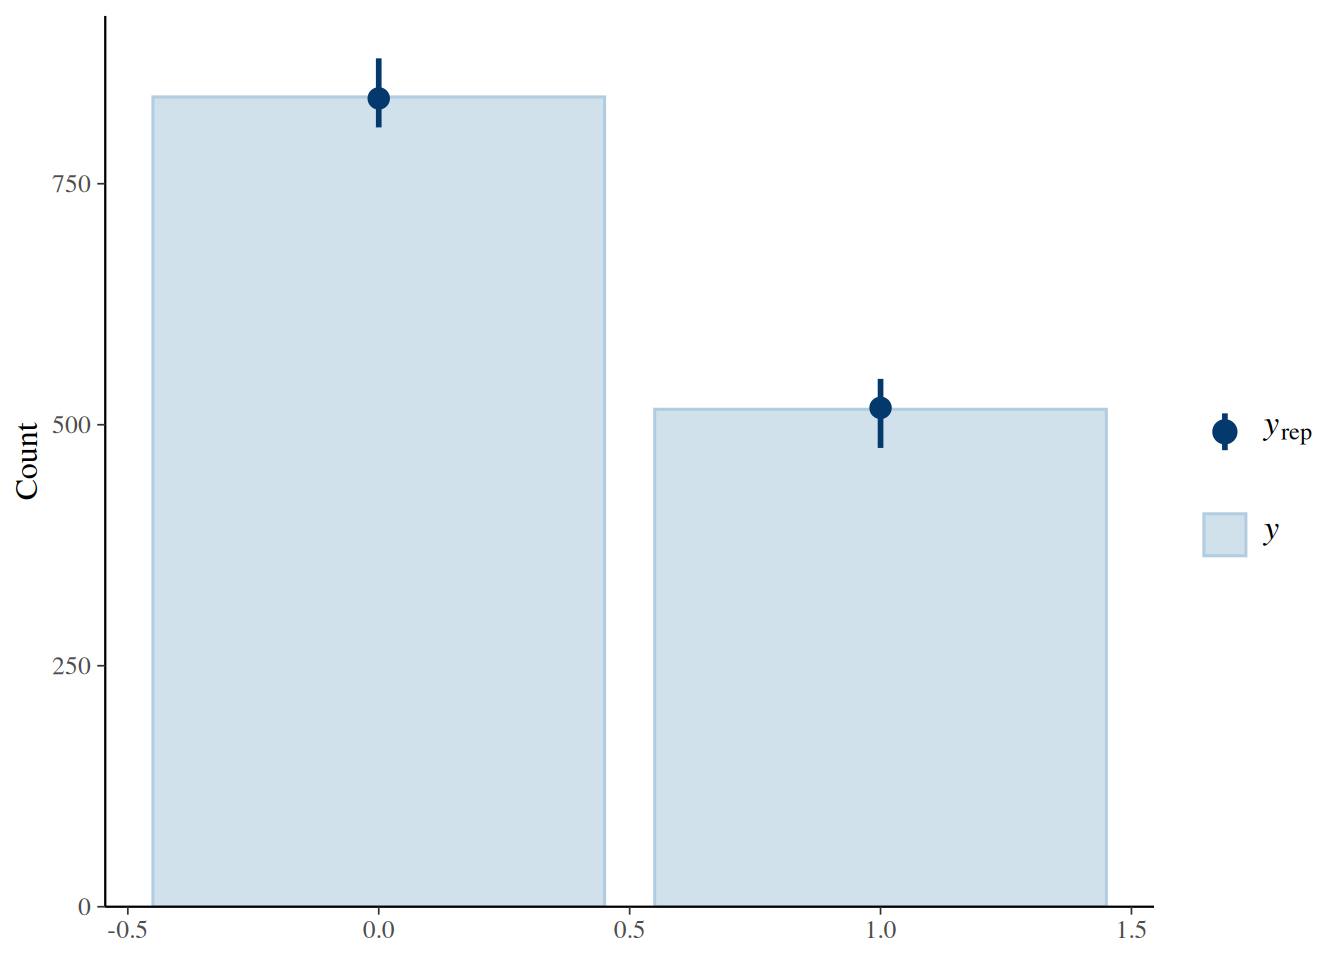
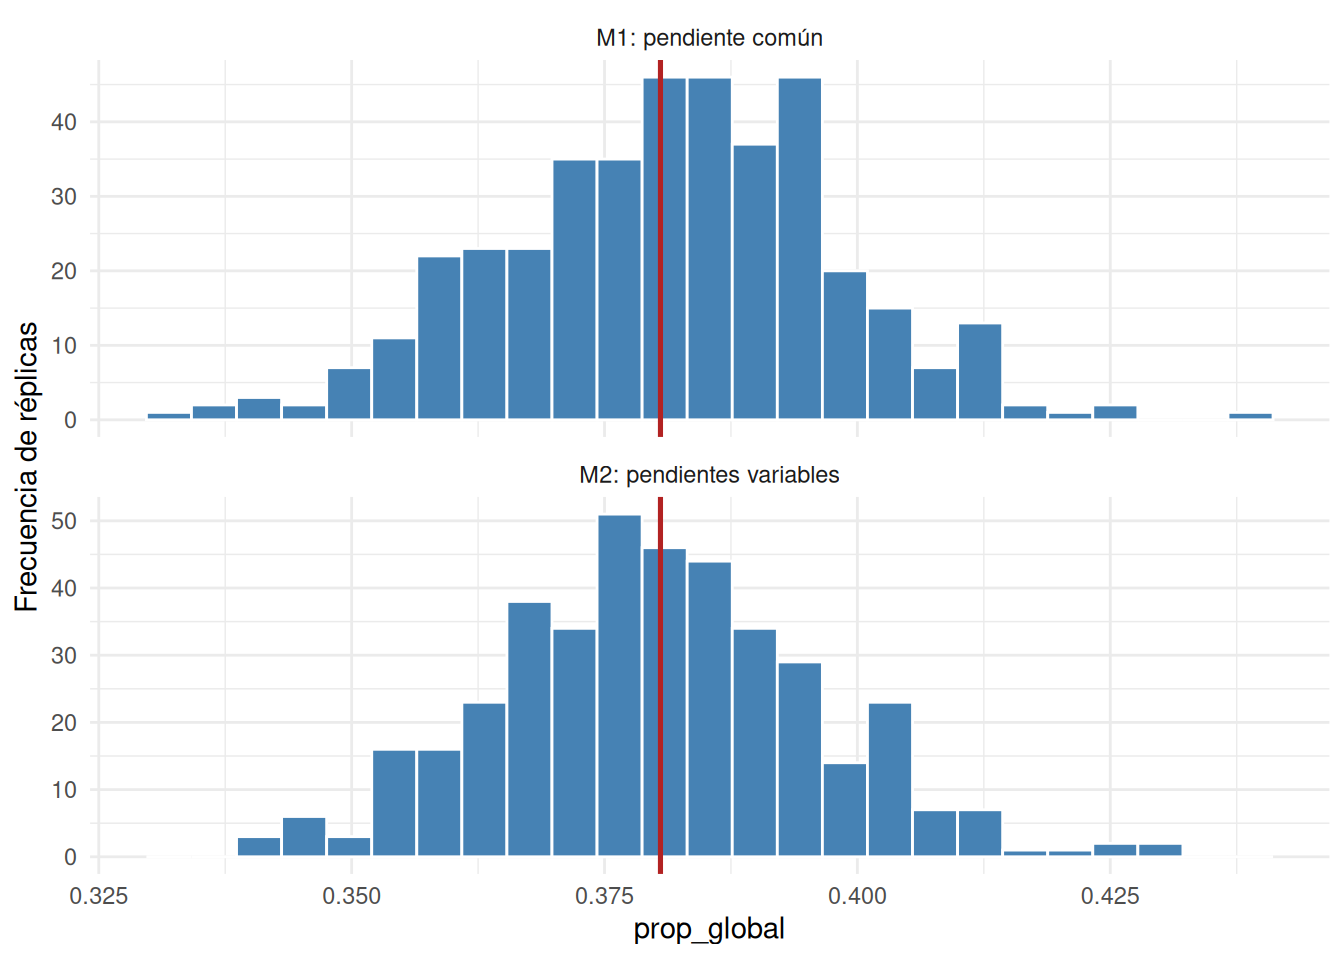
El resumen global puede ser razonable incluso cuando la estructura de asociaciones está mal representada. Mostramos tanto barras de respuestas binarias como la distribución de la proporción global.
bayesplot::ppc_bars(y = datos_s13$y,yrep = yrep_m1_s13[seq_len(80), , drop =FALSE])
Comprobación predictiva global de la respuesta binaria bajo M1.
Distribución predictiva posterior de la proporción global, con el valor observado señalado por una línea.
La línea roja marca el valor observado. Aunque una estadística global no presente una discrepancia evidente, todavía debemos preguntar si la relación entre el predictor y la respuesta queda representada dentro de cada centro.
13.10.6 Segunda comprobación: ¿se reproduce la heterogeneidad de asociaciones?
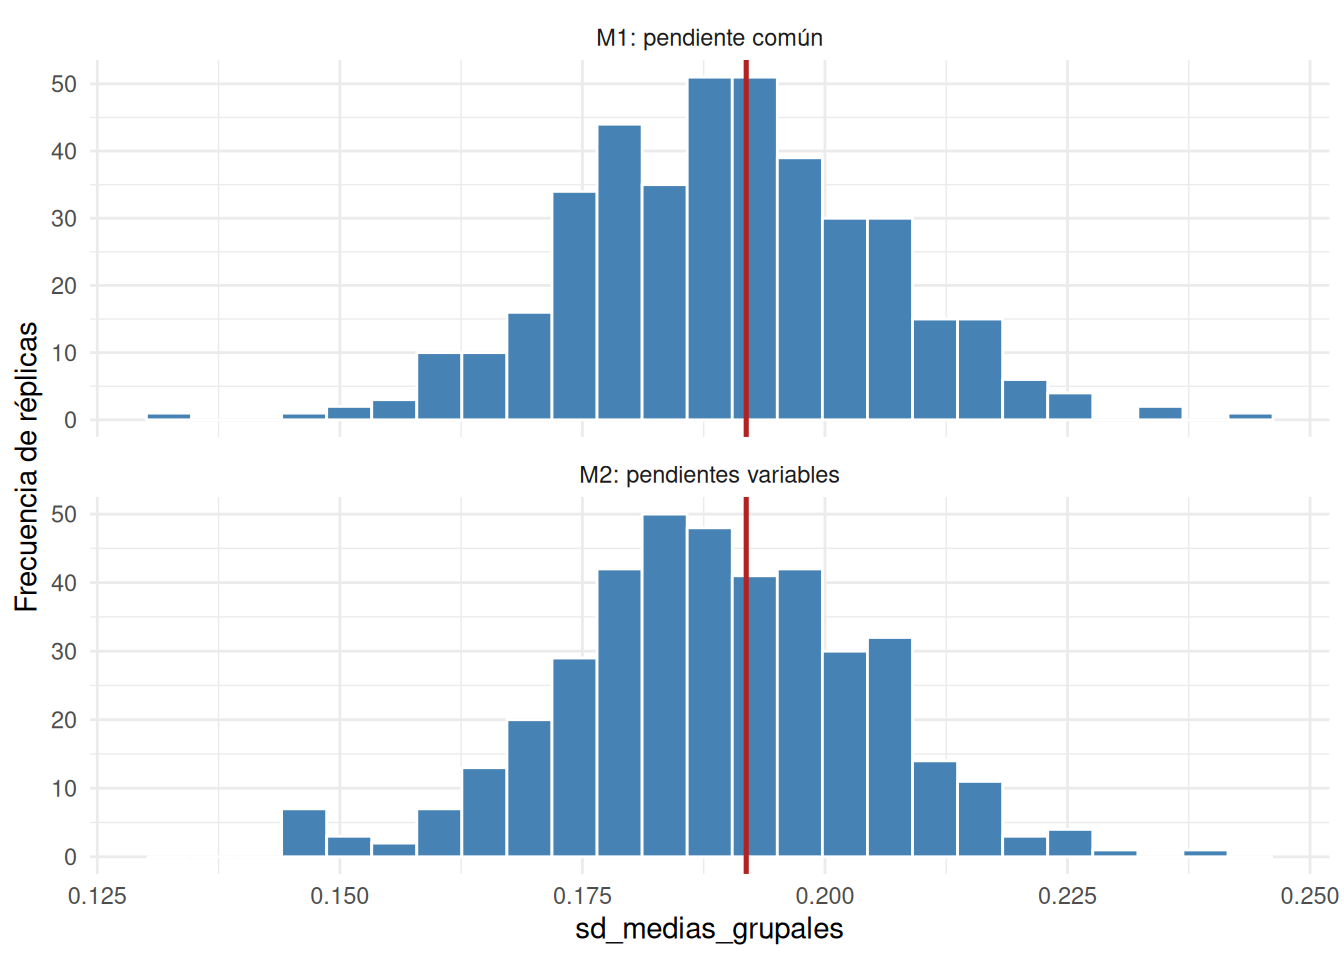
Ahora contrastamos las distribuciones replicadas de \(T_2\), \(T_3\) y \(T_4\). En particular, si las diferencias entre probabilidades por \(x\) cambian entre centros más de lo que M1 puede producir bajo su propia estructura, \(T_3\) lo hará visible. M2 incorpora una fuente adicional de variación, pero su adecuación deberá verificarse con los mismos criterios.
Variabilidad de medias de centros y proporción de contrastes negativos en réplicas posteriores.
Además de los gráficos, producimos una tabla reproducible que resume las distribuciones de las estadísticas. La proporción cola_superior se calcula con la convención \(\ge\) y está sujeta a error Monte Carlo; no debe usarse para seleccionar automáticamente el modelo.
Preguntas para discutir en clase. ¿Qué muestra M1 sobre la proporción total? ¿Qué indica la distribución de \(T_3\)? ¿Se debe a una discrepancia de media, de dispersión o de asociación? ¿Qué aspectos de los datos podrían seguir mal representados bajo M2 aun cuando \(T_3\) mejore?
13.10.7 Tercera comprobación: visualizar los centros sin perder la variación muestral
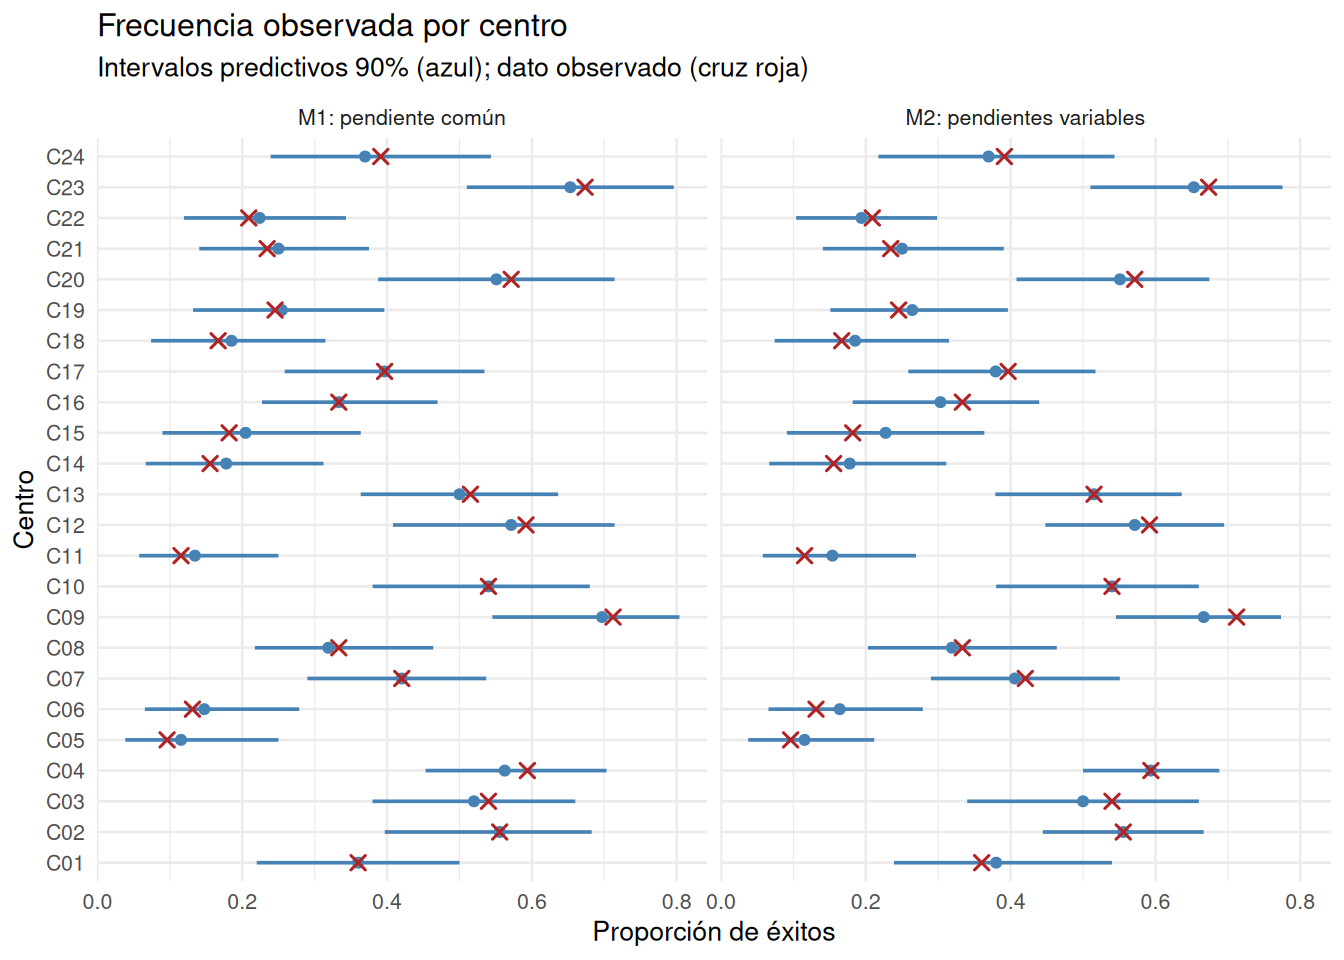
Las estadísticas agregadas no indican en cuáles centros se concentran las discrepancias. Calcularemos por separado la proporción de éxitos y el contraste \(\widehat\Delta_j\) en cada centro. Para cada resumen obtendremos los cuantiles 0.05, 0.50 y 0.95 bajo las réplicas, no intervalos de confianza de los valores observados ni intervalos posteriores de coeficientes.
Proporciones por centro, observadas y replicadas bajo M1 y M2.
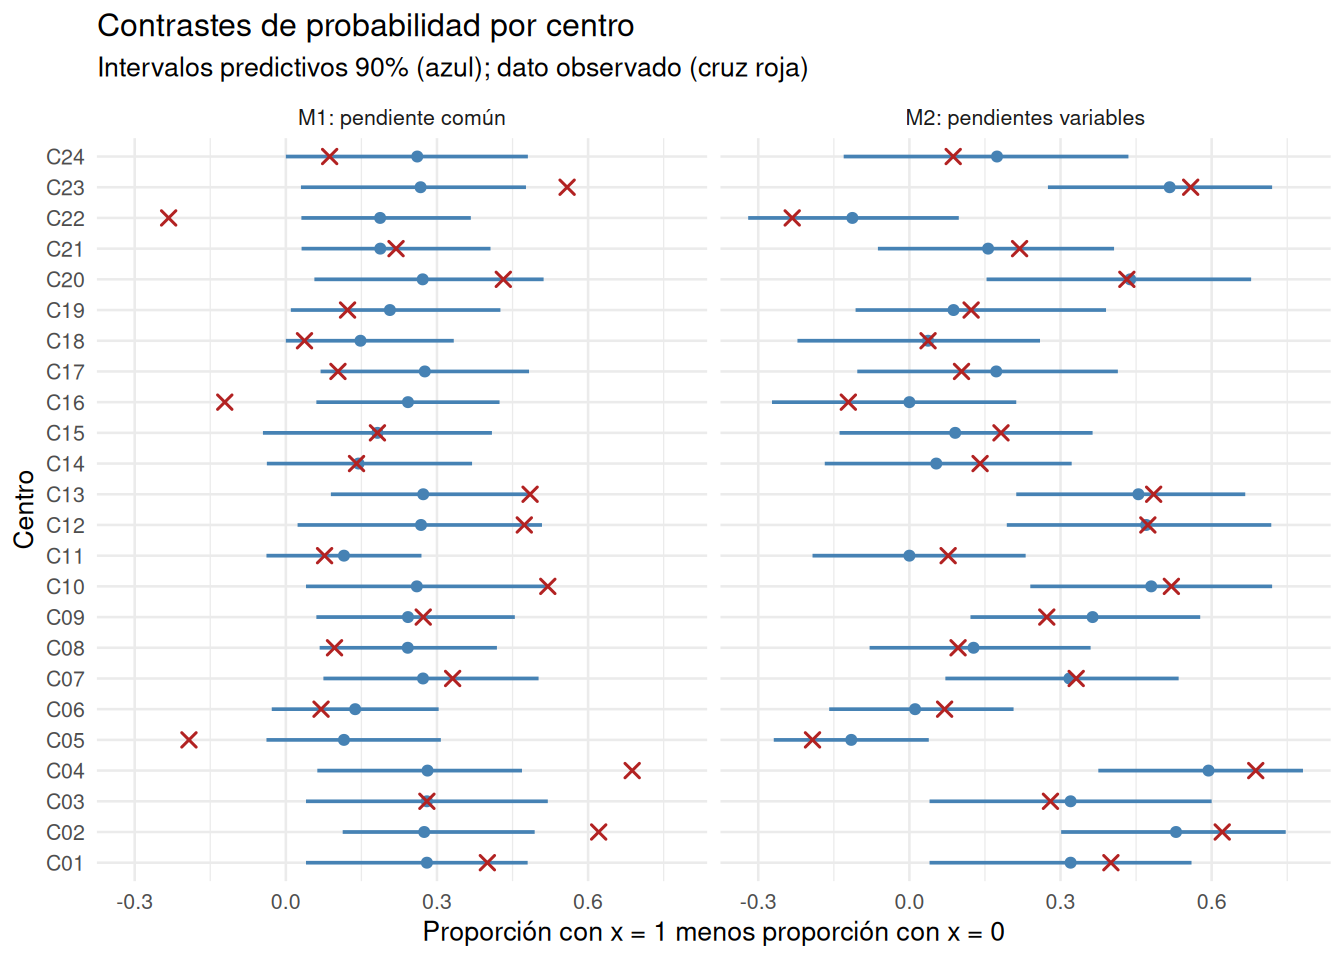
ppc_delta_centros_s13 <- dplyr::bind_rows(resumen_centro_predictivo_s13( yrep_m1_s13, datos_s13, indices_grupo_s13, "contraste" ) |> dplyr::mutate(modelo ="M1: pendiente común"),resumen_centro_predictivo_s13( yrep_m2_s13, datos_s13, indices_grupo_s13, "contraste" ) |> dplyr::mutate(modelo ="M2: pendientes variables"))plot_centros_s13( ppc_delta_centros_s13,"Contrastes de probabilidad por centro","Proporción con x = 1 menos proporción con x = 0")
Diferencias de proporciones (x = 1 menos x = 0) observadas y simuladas por centro.
Las proporciones globales y las proporciones por centro pueden ocultar una deficiencia relativa a los contrastes condicionales. Las cruces rojas, por su parte, son resúmenes muestrales: no deben tratarse como valores verdaderos de los efectos grupales. Además, al ajustar ambos modelos con todas las observaciones, las réplicas de estos mismos centros reflejan información utilizada en el ajuste. Para evaluar predicción fuera de la muestra necesitaremos validación cruzada apropiada.
13.10.8 ¿Qué habría que cambiar después de la comprobación?
La decisión no debe ser «M2 tiene un parámetro más, por tanto es mejor». La pregunta es si las discrepancias de M1 corresponden a un patrón para el cual una distribución de pendientes variables ofrece una representación sustantivamente plausible. Aun si M2 reproduce mejor la dispersión observada de contrastes, debemos volver a examinar diagnósticos computacionales, prevalencias globales, variación entre centros y posibles observaciones extremas.
Este laboratorio utiliza datos simulados desde M2 y por eso es razonable que las comprobaciones sean más compatibles con esa formulación. En una aplicación real la explicación puede ser menos clara: otra covariable, una interacción entre niveles o un mecanismo de selección también podrían generar heterogeneidad de contrastes. La mejora en un conjunto de datos usado para construir y revisar modelos no representa evidencia independiente de generalización.
13.10.9 Comunicar diferencias de probabilidad
Pasamos de los parámetros en la escala logit a cantidades en la escala de respuesta. Primero analizamos la diferencia esperada entre \(x=1\) y \(x=0\)fijando los efectos grupales en cero. Esta es una comparación condicional de referencia; no es un promedio sobre todos los centros posibles.
# A tibble: 1 × 6
  cantidad                             media   q05 mediana   q95 prob_mayor_cero
  <chr>                                <dbl> <dbl>   <dbl> <dbl>           <dbl>
1 Diferencia esperada para efectos gr… 0.231 0.113   0.230 0.349           0.999
La probabilidad posterior prob_mayor_cero indica qué proporción de extracciones del contraste es positiva bajo el modelo y sus supuestos. No equivale a un valor \(p\) clásico ni, sin supuestos de identificación causal adicionales, a la probabilidad de que una intervención produzca un efecto positivo.
También podemos estimar diferencias esperadas para cada centro existente, manteniendo sus coeficientes grupales posteriores. Para ello construiremos predicciones emparejadas con \(x=0\) y \(x=1\) en cada centro. No estamos generando respuestas binarias aquí: buscamos la posterior de un contraste de medias condicionales.
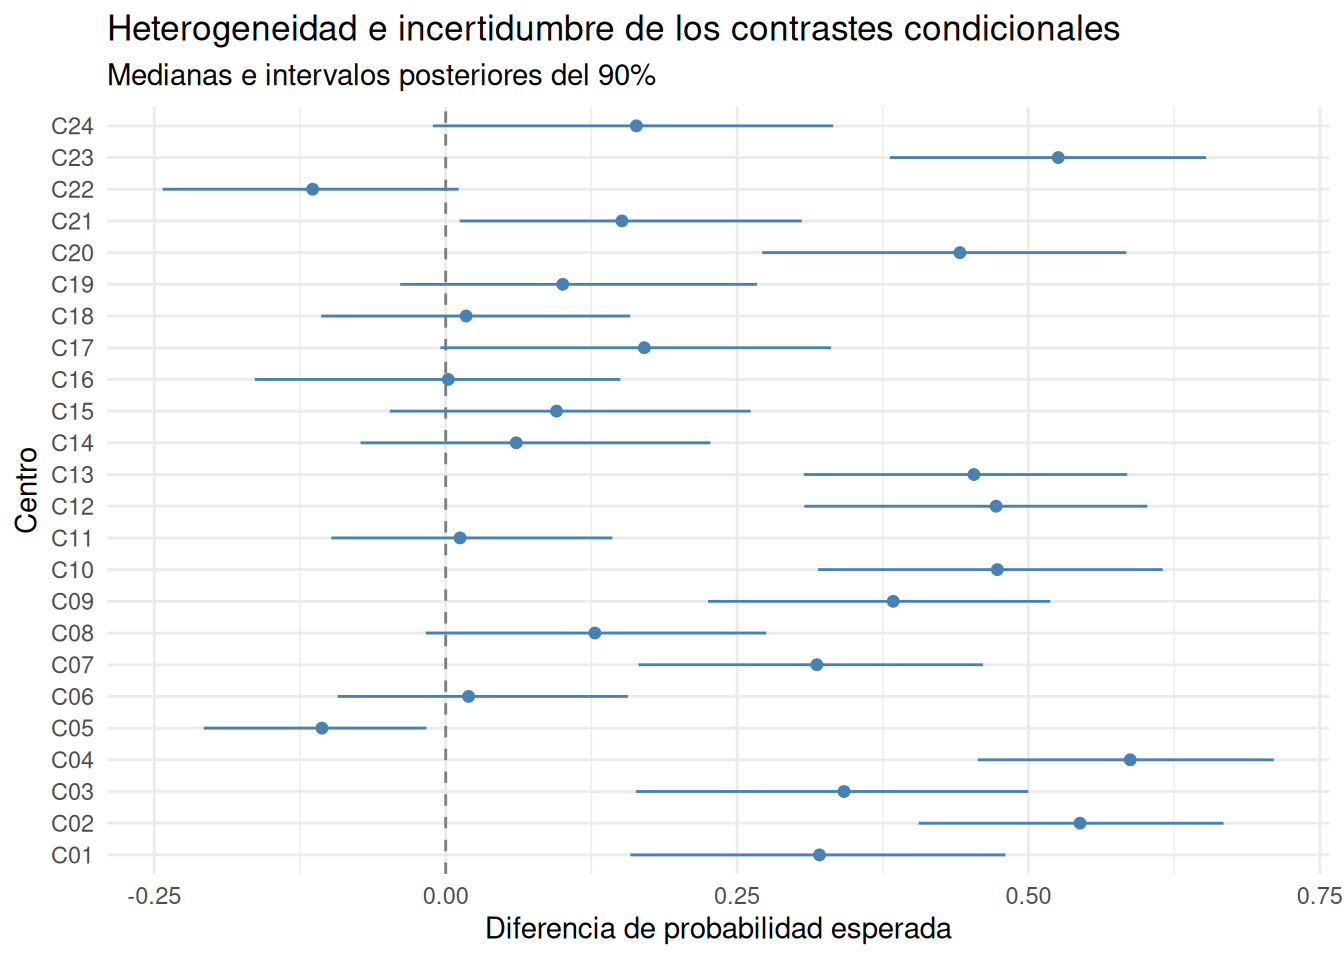
nuevos_centros_s13 <- tidyr::expand_grid(grupo =factor(niveles_grupo_s13, levels = niveles_grupo_s13),x =c(0L, 1L))p_centros_s13 <- brms::posterior_epred( fit_m2_s13,newdata = nuevos_centros_s13,re_formula =NULL)cols_x0_s13 <-seq.int(1L, 2L * J_s13, by =2L)cols_x1_s13 <- cols_x0_s13 +1Ldeltas_posteriores_s13 <- p_centros_s13[, cols_x1_s13, drop =FALSE] - p_centros_s13[, cols_x0_s13, drop =FALSE]contrastes_posteriores_centros_s13 <- tibble::tibble(grupo = niveles_grupo_s13,q05 =apply(deltas_posteriores_s13, 2L, stats::quantile, probs =0.05),mediana =apply(deltas_posteriores_s13, 2L, stats::median),q95 =apply(deltas_posteriores_s13, 2L, stats::quantile, probs =0.95),prob_positivo =colMeans(deltas_posteriores_s13 >0))ggplot2::ggplot( contrastes_posteriores_centros_s13, ggplot2::aes(x = grupo, y = mediana)) + ggplot2::geom_hline(yintercept =0, linetype =2, colour ="grey50") + ggplot2::geom_linerange( ggplot2::aes(ymin = q05, ymax = q95),colour ="steelblue" ) + ggplot2::geom_point(colour ="steelblue", size =1.6) + ggplot2::coord_flip() + ggplot2::labs(x ="Centro", y ="Diferencia de probabilidad esperada",title ="Heterogeneidad e incertidumbre de los contrastes condicionales",subtitle ="Medianas e intervalos posteriores del 90%" ) + ggplot2::theme_minimal(base_size =11)
Distribuciones posteriores resumidas de contrastes esperados por centro, en la escala de probabilidad.
Este gráfico tiene un propósito distinto: las figuras anteriores de comprobación muestran datos observados y réplicas de estadísticas muestrales; aquí mostramos distribuciones posteriores de parámetros derivados. La diferencia es conceptual. Un intervalo predictivo para una proporción empírica incluye variación binomial, mientras un intervalo posterior de diferencia esperada describe incertidumbre acerca de dos probabilidades condicionales.
Finalmente, veamos qué cambia al considerar un centro nuevo. En cada extracción posterior se generará un par coherente de coeficientes de un mismo centro nuevo, mediante la distribución poblacional de intercepto y pendiente.
# A tibble: 2 × 6
  cantidad                            media    q05 mediana   q95 prob_mayor_cero
  <chr>                               <dbl>  <dbl>   <dbl> <dbl>           <dbl>
1 Efectos grupales fijados en cero    0.231  0.113   0.23  0.349           0.999
2 Un centro nuevo simulado por extra… 0.221 -0.125   0.219 0.588           0.787
La segunda distribución incorpora heterogeneidad entre los posibles centros nuevos, además de la incertidumbre posterior. No debe identificarse con la posterior del contraste promedio marginal sobre la población de grupos; para estimar esta última cantidad necesitaríamos, para cada extracción de los parámetros poblacionales, aproximar la esperanza sobre muchos centros nuevos. La operación y el estimando deben describirse explícitamente.
13.11 Aplicación breve con datos reales: conteos de crisis epilépticas
Volvemos a MASS::epil, conjunto de datos de conteos repetidos de crisis epilépticas que utilizamos en la semana 9. La finalidad aquí no es volver a exponer la regresión Poisson o binomial negativa, sino diseñar comprobaciones en función de un fenómeno real: dispersión de los conteos, cantidad de observaciones con cero crisis, máximos y diferencias entre personas. La descripción del conjunto y las transformaciones detalladas pueden revisarse en la sección de aplicación de la semana 9 (Hox et al. 2018, sec. 7.2).
En esta sección ejecutamos la exploración del conjunto de datos. Como extensión opcional proporcionamos el código para ajustar un modelo de conteos y comprobarlo, desactivado de forma predeterminada para no duplicar los ajustes extensos de la semana 9 durante la compilación normal del libro.
epil_raw_s13 <- tibble::as_tibble(MASS::epil)variables_epil_s13 <-c("y", "subject", "trt", "base", "age", "period")faltantes_columnas_s13 <-setdiff(variables_epil_s13, names(epil_raw_s13))if (length(faltantes_columnas_s13) >0) {stop("Faltan columnas de MASS::epil: ",paste(faltantes_columnas_s13, collapse =", "))}if (anyNA(epil_raw_s13[variables_epil_s13])) {stop("Existen valores faltantes en variables de la aplicación.")}if (any(epil_raw_s13$y <0| epil_raw_s13$y %%1!=0)) {stop("La respuesta de MASS::epil debe ser un conteo no negativo.")}if (any(epil_raw_s13$base <=0)) {stop("Se requieren valores positivos de base para definir log(base).")}epil_s13 <- epil_raw_s13 |> dplyr::mutate(subject =factor(subject),trt =factor(trt),periodo =as.numeric(as.character(period)),log_base_c =log(base) -mean(log(base)),edad_z =as.numeric(scale(age)) )if (anyNA(epil_s13$periodo)) {stop("La variable period no pudo interpretarse como numérica.")}epil_s13 |> dplyr::summarise(observaciones = dplyr::n(),personas = dplyr::n_distinct(subject),media =mean(y),varianza = stats::var(y), proporción_ceros =mean(y ==0),maximo =max(y) )
# A tibble: 1 × 6
  observaciones personas media varianza proporción_ceros maximo
          <int>    <int> <dbl>    <dbl>            <dbl>  <dbl>
1           236       59  8.26     153.           0.0975    102
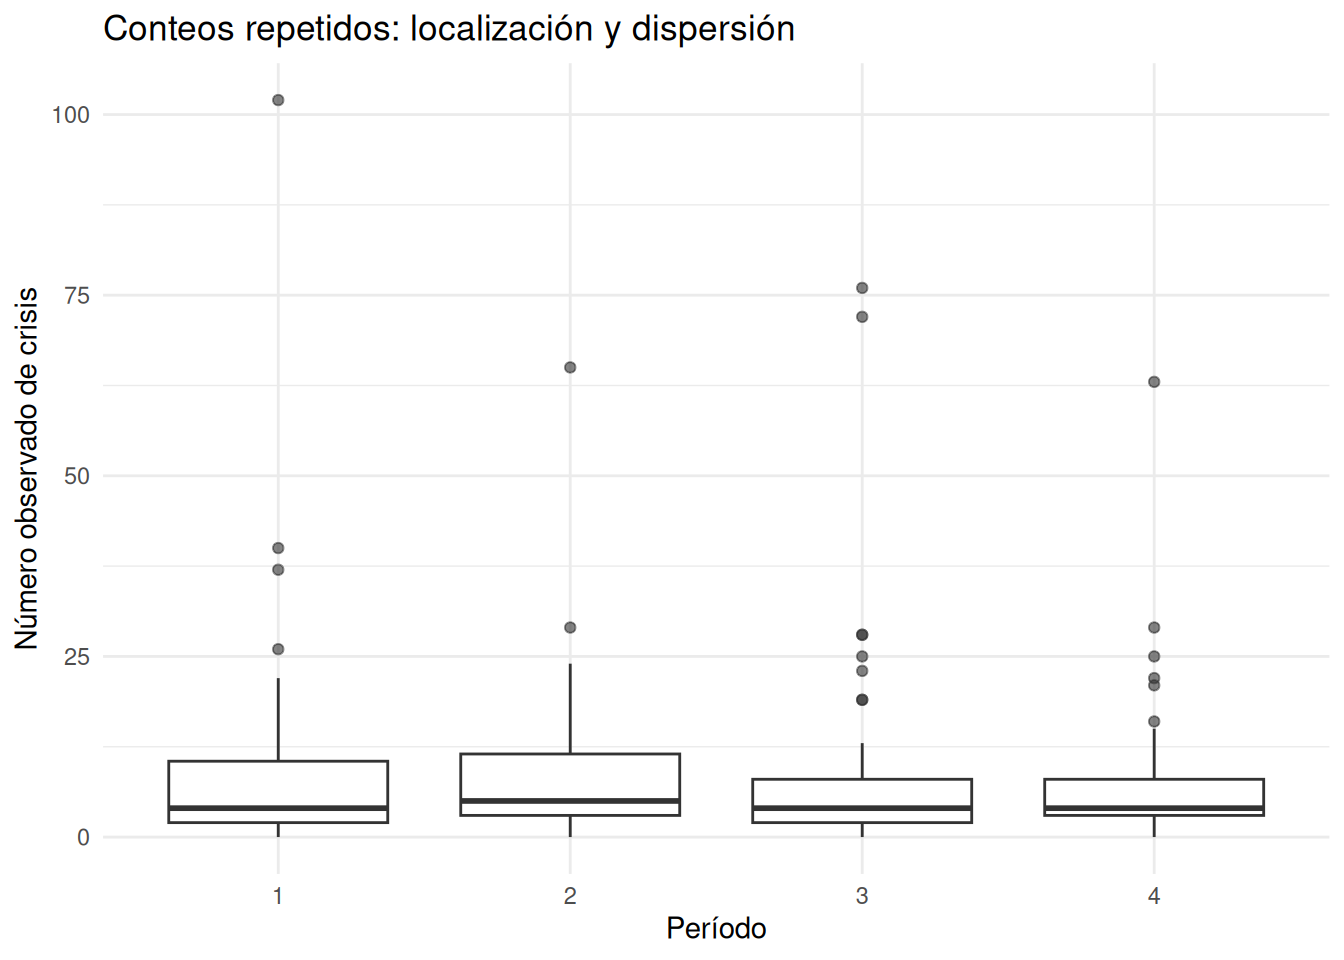
ggplot2::ggplot(epil_s13, ggplot2::aes(x =factor(periodo), y = y)) + ggplot2::geom_boxplot(outlier.alpha =0.6) + ggplot2::labs(x ="Período", y ="Número observado de crisis",title ="Conteos repetidos: localización y dispersión" ) + ggplot2::theme_minimal(base_size =11)
Distribución observada de conteos por período en MASS::epil.
El mero hecho de que la varianza marginal supere la media marginal no basta para invalidar un modelo Poisson condicional: la heterogeneidad entre personas y covariables también induce sobredispersión marginal. Por ello, en el ajuste opcional conservamos el agrupamiento y los predictores.
##| eval: false# Extensión opcional: habilitar la ejecución para estudiar la aplicación real.# La comparación de familias de conteo se desarrolló en la semana 9.prior_epil_s13 <-c( brms::prior(normal(1, 2), class ="Intercept"), brms::prior(normal(0, 1), class ="b"), brms::prior(exponential(1), class ="sd"))fit_epil_s13 <- brms::brm( y ~ trt + log_base_c + edad_z +factor(periodo) + (1| subject),data = epil_s13,family = stats::poisson(),prior = prior_epil_s13,backend ="cmdstanr",chains =4, cores = n_cores_s13,iter =1600, warmup =800,seed =1653137,control =list(adapt_delta =0.95),file ="_fits/modelo_epil_s13",file_refit ="on_change",refresh =0)print(resumen_diagnostico_s13(fit_epil_s13, "Poisson-epil"))
La extensión plantea una pregunta concreta: ¿un modelo Poisson con interceptos por persona reproduce al mismo tiempo ceros, extremos y dispersión de los promedios personales? Un resultado negativo no demostraría automáticamente que la familia correcta es binomial negativa. Habría que valorar dependencia temporal, covariables ausentes, exposición y variación condicional adicional. El ejercicio de la semana 14 permitirá evaluar también predicción fuera del conjunto ajustado.
13.12 Síntesis y errores frecuentes
La comprobación predictiva no es una etapa decorativa. Conecta la distribución de probabilidad del modelo con patrones de datos que podemos reconocer, resumir e interpretar. Para que sea científicamente informativa, la comprobación debe responder a una pregunta concreta sobre el comportamiento de las observaciones y mantenerse coherente con su estructura de agrupamiento.
Conviene evitar especialmente estos errores:
Confundir convergencia y adecuación.\(\widehat R\) y las divergencias evalúan la simulación MCMC, no la validez de las hipótesis observacionales.
Usar solamente la media global. Puede ocultar problemas entre grupos, períodos o niveles de un predictor.
Comparar estadísticas observadas con medias ajustadas en lugar de con datos replicados. Los dos objetos contienen componentes diferentes de variación.
Confundir intervalos posteriores de coeficientes con intervalos predictivos de estadísticas muestrales. Sus interpretaciones y fuentes de incertidumbre difieren.
Interpretar una diferencia muestral entre grupos como estimación exacta de una diferencia de parámetros. Las diferencias muestrales incorporan variación de muestreo.
Suponer que una pendiente común en logit produce igual diferencia de probabilidades en todos los grupos. La transformación logística es no lineal.
Interpretar probabilidades predictivas de cola como probabilidades de que el modelo sea correcto. No lo son; tampoco se debe utilizar automáticamente un umbral convencional de significación.
Concluir que un grupo aislado fuera de un intervalo predictivo implica falla global. Con muchos grupos pueden producirse varios extremos por azar.
Confundir un grupo con efectos fijados en cero y el promedio sobre grupos nuevos. La integración sobre efectos variables importa en enlaces no lineales.
Cambiar la familia o agregar efectos automáticamente ante una discrepancia. Una misma señal puede tener distintas explicaciones sustantivas.
Presentar una mejora después de reformular como validación independiente. Los mismos datos motivaron y evaluaron la modificación.
Ocultar dificultades o incertidumbre. Deben comunicarse tanto los patrones bien representados como las limitaciones del modelo y los diagnósticos computacionales pendientes.
En síntesis, una práctica defendible enlaza cuatro decisiones: qué modelo se formuló, qué característica del fenómeno se consideró importante, qué revelaron las simulaciones y por qué la conclusión o la reformulación propuesta es razonable.
13.13 Ejercicios
Ejercicio 1. Computación y adecuación estadística
Dos modelos logísticos de interceptos variables presentan \(\widehat R<1.01\), ESS elevados y ninguna divergencia. Para el primero, el 95% de las réplicas predictivas contiene una cantidad de ceros próxima a la observada, pero la variación de las proporciones entre centros es sustancialmente menor que en los datos. Para el segundo ocurre lo contrario.
a) Explique por qué no se puede declarar adecuado ninguno de los dos modelos solamente por sus diagnósticos de MCMC.
b) Especifique una estadística de discrepancia para la heterogeneidad entre centros. Distinga esa estadística de una desviación estándar posterior de interceptos.
c) Proponga qué información sustantiva y qué nuevas comprobaciones serían necesarias para orientar la siguiente revisión.
Ejercicio 2. Derivación de una probabilidad predictiva
Suponga \(Y_{ij}\mid\alpha_j,\sigma\sim\mathcal N(\alpha_j,\sigma^2)\), con \(\alpha_j\mid\mu,\tau\sim\mathcal N(\mu,\tau^2)\), y que se dispone de simulaciones de la posterior conjunta de \(\alpha_1,\ldots,\alpha_J,\mu,\tau,\sigma\).
a) Describa el procedimiento para simular una observación replicada para un grupo observado \(j\).
b) Describa el procedimiento para simular una observación de un grupo nuevo \(J+1\).
c) Para valores dados de \(\mu\), \(\tau\) y \(\sigma\), derive la varianza marginal de la observación nueva tras integrar \(\alpha_{J+1}\).
d) Explique por qué esa varianza condicional a los hiperparámetros no incluye todavía toda la incertidumbre predictiva posterior.
Ejercicio 3. Interpretación de probabilidades de cola
En una comprobación predictiva se calcula \(T(\mathbf y)=\max_i y_i\). De 1000 réplicas, 28 tienen un máximo igual o mayor que el observado.
a) Calcule la estimación Monte Carlo de la probabilidad predictiva de cola superior.
b) Interprete el resultado sin equipararlo con la probabilidad de que el modelo sea verdadero.
c) Explique por qué observar ese resultado no identifica de manera única una distribución alternativa para la respuesta.
d) ¿Qué comprobaría para distinguir una discrepancia de cola de una posible observación mal registrada?
Ejercicio 4. Una pendiente común no implica una diferencia constante de probabilidades
Para un modelo logístico \(p_j(x)=\operatorname{logit}^{-1}(\alpha_j+\beta x)\) con \(x\in\{0,1\}\):
depende, en general, de \(\alpha_j\) aunque \(\beta\) sea común.
b) Explique por qué encontrar diferencias empíricas de probabilidad distintas entre centros no basta para concluir que se requieren pendientes variables.
c) Formule una estadística de discrepancia que permita evaluar esa posibilidad mediante réplicas predictivas.
Ejercicio 5. Auditoría del laboratorio en R
Reproduzca los ajustes M1 y M2 y, a partir de las salidas efectivamente obtenidas:
a) Prepare una tabla de diagnósticos computacionales y describa cualquier advertencia del ajuste.
b) Repita la comprobación de la dispersión de contrastes con una semilla distinta para seleccionar réplicas de la posterior. Analice la estabilidad de la conclusión frente al error Monte Carlo.
c) Diseñe una cuarta comprobación predictiva que no repita las anteriores. Justifique cuál característica de los datos evalúa y qué modificación sugeriría una discrepancia.
d) Distinga gráficamente la posterior de una diferencia de probabilidades esperadas en un centro de la distribución de diferencias de proporciones observadas en muestras futuras del mismo tamaño.
Ejercicio 6. Aplicación con datos reales
Trabaje con MASS::epil y la familia de conteos que considere justificable. Utilice el código opcional de la sección de aplicación como punto de partida, o recupere el ajuste realizado en la semana 9.
a) Proponga tres comprobaciones predictivas, incluyendo al menos una por persona o por período. Explique por qué cada una se relaciona con una característica sustantiva.
b) Interprete si el modelo reproduce la cantidad de ceros, un resumen de colas y la variación entre personas.
c) Identifique una discrepancia que le parecería suficientemente relevante para investigar una modificación del modelo. Justifique la modificación sin basarse exclusivamente en un indicador escalar.
d) Escriba un párrafo de resultados que distinga diagnóstico computacional, comprobación predictiva e incertidumbre de una cantidad de interés.
13.14 Referencias y lecturas recomendadas
Lectura principal: Gelman et al. (Gelman et al. 2013, secs. 6.1–6.4, pp. 141–158), para la fundamentación de la distribución predictiva, estadísticas de discrepancia y comprobación gráfica; y Bayesian Workflow(Gelman et al. 2026, sec. 8.2, pp. 142–147), para la integración en un flujo de análisis.
Lecturas complementarias: Gelman y Hill (Gelman y Hill 2007, secs. 21.1, 21.3–21.4 y 24.1–24.2) para incertidumbre, contrastes y comprobaciones; Bayesian Workflow(Gelman et al. 2026, chap. 21) para el estudio de caso de comprobación y reformulación; y Hox et al. (Hox et al. 2018, sec. 13.3) para vincular comprobaciones predictivas con diagnóstico de supuestos en modelos multinivel.
La semana 14 profundizará en validación cruzada, elección de la unidad predictiva, PSIS-LOO, diagnósticos de importancia y sensibilidad. Por esa razón, aquí la crítica se fundamenta principalmente en las consecuencias observables de cada modelo, y no en la elección automática mediante un criterio numérico.
Gelman, Andrew, John B. Carlin, Hal S. Stern, David B. Dunson, Aki Vehtari, y Donald B. Rubin. 2013. Bayesian Data Analysis. 3.ª ed. Chapman & Hall/CRC.
Gelman, Andrew, y Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
Gelman, Andrew, Aki Vehtari, Richard McElreath, et al. 2026. Bayesian Workflow. Chapman & Hall/CRC.
Hox, Joop J., Mirjam Moerbeek, y Rens van de Schoot. 2018. Multilevel Analysis: Techniques and Applications. 3.ª ed. Routledge.
McElreath, Richard. 2020. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. 2.ª ed. Chapman & Hall/CRC.